Análisis Avanzado de Datos — 1. Regresión y regularización (Ridge y Lasso)
estadistica
regularizacion
ridge-lasso
Por qué la regresión lineal se queda corta ante el sobreajuste, y cómo Ridge (L2) y Lasso (L1) equilibran sesgo y varianza, con comparación visual entre los tres enfoques.
Author
Wilder Ramírez Delgado
Published
August 26, 2026
Análisis Avanzado de Datos — 1. Regresión y regularización (Ridge y Lasso)
👋 Sobre el autor
Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.
De la teoría a la práctica, un problema a la vez.
¿Por qué la regresión lineal se queda corta?
La regresión lineal es, probablemente, el primer modelo que aprendiste en ciencia de datos. Es simple, interpretable y funciona sorprendentemente bien en muchos problemas reales. Pero tiene puntos débiles que se vuelven críticos en la práctica:
Cuando hay muchas variables predictoras, algunas correlacionadas entre sí (multicolinealidad), los coeficientes se vuelven inestables: pequeños cambios en los datos producen coeficientes muy distintos.
Cuando el modelo tiene más flexibilidad de la necesaria (muchas variables, o términos polinomiales), tiende a memorizar el ruido del conjunto de entrenamiento en lugar de aprender el patrón real — esto se llama sobreajuste (overfitting).
No tienes forma de decirle al modelo qué variables no aportan, para que las ignore.
La solución a estos tres problemas tiene un nombre: regularización. En este artículo vas a construir la intuición completa, con código ejecutable de principio a fin, sobre las dos formas de regularización más usadas en regresión: Ridge y Lasso.
Repaso: regresión lineal múltiple
La regresión lineal múltiple modela una variable de respuesta \(y\) como una combinación lineal de \(p\) variables predictoras:
Para repasarla, vas a usar un dataset real: precios de vivienda en California, disponible directamente en scikit-learn. Cada fila es un bloque censal, con variables como ingreso medio, antigüedad de las viviendas, número de habitaciones, población y ubicación geográfica; el objetivo es predecir el precio medio de la vivienda.
import numpy as npimport pandas as pdfrom sklearn.datasets import fetch_california_housing# Dataset real: precios de vivienda en California (incluido en scikit-learn)housing = fetch_california_housing(as_frame=True)X = housing.datay = housing.target # precio medio de vivienda, en cientos de miles de USDprint(f"Observaciones: {X.shape[0]}")print(f"Variables predictoras: {list(X.columns)}")X.head()
Para evaluar el modelo de forma honesta, separa los datos en un conjunto de entrenamiento y uno de prueba: ajusta el modelo solo con el primero y evalúalo con el segundo, que nunca vio durante el entrenamiento.
import numpy as npimport pandas as pdfrom sklearn.datasets import fetch_california_housingfrom sklearn.model_selection import train_test_splitfrom sklearn.linear_model import LinearRegressionfrom sklearn.metrics import mean_squared_error, r2_scorehousing = fetch_california_housing(as_frame=True)X = housing.datay = housing.targetX_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=42)modelo_lineal = LinearRegression()modelo_lineal.fit(X_train, y_train)y_pred = modelo_lineal.predict(X_test)print(f"R² en test: {r2_score(y_test, y_pred):.3f}")print(f"RMSE en test: {np.sqrt(mean_squared_error(y_test, y_pred)):.3f}")coeficientes = pd.Series(modelo_lineal.coef_, index=X.columns).sort_values()print("\nCoeficientes del modelo:")print(coeficientes)print(f"\nCorrelación AveRooms-AveBedrms: {X['AveRooms'].corr(X['AveBedrms']):.2f}")
R² en test:   0.576
RMSE en test: 0.746

Coeficientes del modelo:
Longitude    -0.433708
Latitude     -0.419792
AveRooms     -0.123323
AveOccup     -0.003526
Population   -0.000002
HouseAge      0.009724
MedInc        0.448675
AveBedrms     0.783145
dtype: float64

Correlación AveRooms-AveBedrms: 0.85
Lectura del modelo sin regularizar
El modelo explica una parte razonable de la varianza del precio: R²=0.576 (RMSE=0.746, en cientos de miles de USD) — nada mal para un puñado de variables socioeconómicas y geográficas simples.
AveRooms y AveBedrms están correlacionadas 0.85 entre sí, y eso se nota directamente en los coeficientes impresos arriba: AveRooms sale con -0.12 (¿más habitaciones promedio, precio más bajo?) mientras AveBedrms sale con +0.78 — contraintuitivo si se leen por separado.
Ese par de signos opuestos no refleja una relación causal real: es el síntoma clásico de multicolinealidad, donde el modelo “reparte” de forma inestable el mismo efecto real entre dos variables que se mueven casi juntas.
El problema del sobreajuste y el compromiso sesgo-varianza
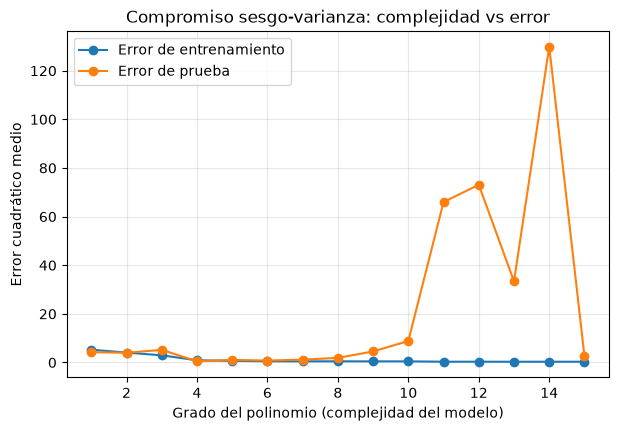
Para ver el sobreajuste con claridad, aléjate por un momento del dataset de 8 variables y mira un ejemplo con una sola variable, donde puedas graficar el ajuste directamente.
Imagina que la relación real entre \(x\) y \(y\) es una curva suave, pero solo tienes observaciones con ruido. Si ajustas:
Un modelo demasiado simple (una recta) va a subajustar (underfitting): no captura la curva real. Esto es alto sesgo.
Un modelo demasiado flexible (un polinomio de grado muy alto) va a memorizar el ruido de los puntos de entrenamiento. Esto es alta varianza: el modelo cambia mucho si cambian ligeramente los datos.
El objetivo es encontrar el punto intermedio donde el error en datos nuevos (no vistos durante el entrenamiento) es mínimo.
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.model_selection import train_test_splitfrom sklearn.linear_model import LinearRegressionfrom sklearn.metrics import mean_squared_errorfrom sklearn.preprocessing import PolynomialFeatures, StandardScalerfrom sklearn.pipeline import make_pipeline# Datos sintéticos: una curva real + ruidorng = np.random.default_rng(42)x = np.sort(rng.uniform(0, 10, 60))y_real = np.sin(x) *3+0.3* xy = y_real + rng.normal(scale=1.0, size=x.shape)X = x.reshape(-1, 1)X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.3, random_state=42)grados =range(1, 16)error_train, error_test = [], []for grado in grados:# Escalar x antes de generar las potencias evita que las columnas de alto grado# exploten en magnitud y hagan inestable la solución de mínimos cuadrados. modelo = make_pipeline(StandardScaler(), PolynomialFeatures(grado), LinearRegression()) modelo.fit(X_train, y_train) error_train.append(mean_squared_error(y_train, modelo.predict(X_train))) error_test.append(mean_squared_error(y_test, modelo.predict(X_test)))fig, ax = plt.subplots(figsize=(7, 4.5))ax.plot(list(grados), error_train, marker="o", label="Error de entrenamiento")ax.plot(list(grados), error_test, marker="o", label="Error de prueba")ax.set_xlabel("Grado del polinomio (complejidad del modelo)")ax.set_ylabel("Error cuadrático medio")ax.set_title("Compromiso sesgo-varianza: complejidad vs error")ax.legend()ax.grid(alpha=0.3)plt.show()grado_optimo =list(grados)[int(np.argmin(error_test))]print(f"Grado con menor error de prueba: {grado_optimo} (MSE_test={min(error_test):.2f}, MSE_train={error_train[np.argmin(error_test)]:.2f})")print(f"MSE de prueba en grado 12: {error_test[11]:.2f}")print(f"MSE de entrenamiento en grado 15: {error_train[-1]:.2f} (el más bajo de toda la curva)")
Grado con menor error de prueba: 4 (MSE_test=0.50, MSE_train=0.90)
MSE de prueba en grado 12: 73.09
MSE de entrenamiento en grado 15: 0.32 (el más bajo de toda la curva)
Lectura de la curva sesgo-varianza
El error de entrenamiento baja de forma monótona con la complejidad: pasa de 5.25 en grado 1 hasta 0.32 en grado 15 (el punto más bajo de toda la curva) — un polinomio de grado 15 tiene tanta flexibilidad que prácticamente memoriza los 42 puntos de entrenamiento.
El error de prueba cuenta otra historia: toca su mínimo en grado 4 (MSE=0.50, con MSE de entrenamiento de apenas 0.90 en ese mismo punto) y después empieza a subir. En grado 12 llega a 73.09 — casi 150 veces el mínimo alcanzado en grado 4.
Esa brecha entre “el entrenamiento sigue mejorando” y “la prueba se dispara” es la definición operativa de sobreajuste: pasado el grado 4, cada grado adicional solo ayuda a memorizar ruido del conjunto de entrenamiento, no a predecir mejor sobre datos nuevos.
Regularización Ridge (L2)
Ridge modifica la función de costo de la regresión lineal agregando una penalización proporcional a la suma de los coeficientes al cuadrado:
El hiperparámetro \(\alpha\) (alpha) controla la fuerza de la penalización:
\(\alpha = 0\) → Ridge es idéntico a la regresión lineal ordinaria.
\(\alpha \to \infty\) → todos los coeficientes se acercan a cero (el modelo se vuelve casi constante).
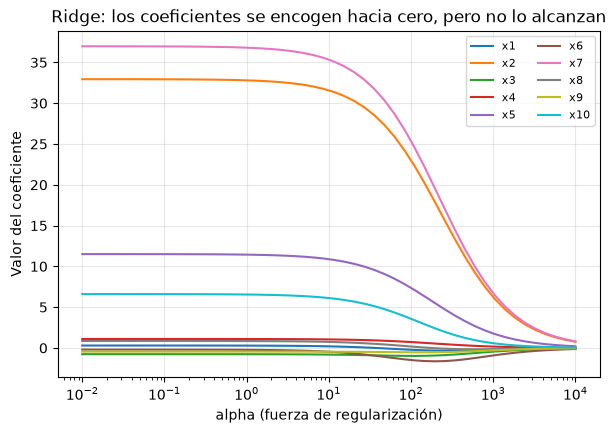
La intuición: Ridge encoge (shrinks) los coeficientes hacia cero, especialmente los de variables correlacionadas o poco informativas, sin llegar a eliminarlos por completo. Esto reduce la varianza del modelo a cambio de un poco de sesgo — justo el compromiso que viste arriba.
Para ver el efecto con claridad, genera un dataset sintético con variables informativas y variables que son puro ruido, y observa cómo cambian los coeficientes a medida que aumenta \(\alpha\).
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.datasets import make_regressionfrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import Ridge# Dataset sintético: 10 variables, solo 4 realmente informativasX, y, coef_real = make_regression( n_samples=200, n_features=10, n_informative=4, noise=10.0, coef=True, random_state=42,)X = StandardScaler().fit_transform(X) # estandarizar es clave para regularizaralphas = np.logspace(-2, 4, 50)coeficientes_ridge = []for alpha in alphas: modelo = Ridge(alpha=alpha) modelo.fit(X, y) coeficientes_ridge.append(modelo.coef_)coeficientes_ridge = np.array(coeficientes_ridge)fig, ax = plt.subplots(figsize=(7, 4.5))for i inrange(X.shape[1]): ax.plot(alphas, coeficientes_ridge[:, i], label=f"x{i+1}")ax.set_xscale("log")ax.set_xlabel("alpha (fuerza de regularización)")ax.set_ylabel("Valor del coeficiente")ax.set_title("Ridge: los coeficientes se encogen hacia cero, pero no lo alcanzan")ax.legend(loc="upper right", fontsize=8, ncol=2)ax.grid(alpha=0.3)plt.show()print(f"Variables realmente informativas (coeficiente ≠ 0 en la generación): {[f'x{i+1}'for i, c inenumerate(coef_real) ifabs(c) >0]}")print(f"\nSuma de |coeficientes| en alpha={alphas[0]:.2f}: {np.sum(np.abs(coeficientes_ridge[0])):.1f}")print(f"Suma de |coeficientes| en alpha={alphas[-1]:.0f}: {np.sum(np.abs(coeficientes_ridge[-1])):.1f}")print(f"Coeficiente de x7 (el más grande, informativo) — alpha bajo: {coeficientes_ridge[0][6]:.2f}, alpha alto: {coeficientes_ridge[-1][6]:.2f}")
Variables realmente informativas (coeficiente ≠ 0 en la generación): ['x2', 'x5', 'x7', 'x10']

Suma de |coeficientes| en alpha=0.01: 91.7
Suma de |coeficientes| en alpha=10000: 2.1
Coeficiente de x7 (el más grande, informativo) — alpha bajo: 36.97, alpha alto: 0.80
Lectura del camino de regularización Ridge
Las variables realmente informativas (x2, x5, x7 y x10) son justo las que parten con los coeficientes más grandes en alpha bajo — el modelo sí está capturando la señal real antes de regularizar.
A medida que alpha crece de 0.01 a 10000, la suma de |coeficientes| cae de 91.7 a 2.1 — un encogimiento de más de 40 veces, y afecta a todas las variables, no solo a las irrelevantes.
x7 (la variable con más peso real) pasa de 36.97 a apenas 0.80: se encoge muchísimo, pero en ningún punto del camino llega a cero exacto — la firma que distingue a Ridge de Lasso.
Regularización Lasso (L1)
Lasso (Least Absolute Shrinkage and Selection Operator) usa una penalización distinta: la suma de los valores absolutos de los coeficientes.
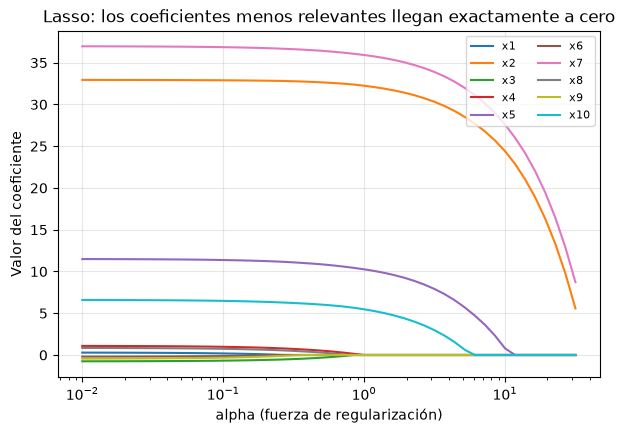
La diferencia con Ridge parece sutil (cuadrado vs. valor absoluto), pero tiene una consecuencia geométrica importante: la región de penalización de Lasso tiene esquinas (sobre los ejes, donde algún coeficiente es exactamente cero), mientras que la de Ridge es una esfera suave. Eso hace que la solución óptima de Lasso “aterrice” con frecuencia exactamente sobre uno de esos ejes.
En la práctica, esto significa que Lasso no solo encoge coeficientes: los apaga por completo. Es, de facto, un método de selección automática de variables.
Usa el mismo dataset sintético de antes (10 variables, solo 4 informativas) para comprobarlo.
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.datasets import make_regressionfrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import LassoX, y, coef_real = make_regression( n_samples=200, n_features=10, n_informative=4, noise=10.0, coef=True, random_state=42,)X = StandardScaler().fit_transform(X)alphas = np.logspace(-2, 1.5, 50)coeficientes_lasso = []for alpha in alphas: modelo = Lasso(alpha=alpha, max_iter=10000) modelo.fit(X, y) coeficientes_lasso.append(modelo.coef_)coeficientes_lasso = np.array(coeficientes_lasso)fig, ax = plt.subplots(figsize=(7, 4.5))for i inrange(X.shape[1]): ax.plot(alphas, coeficientes_lasso[:, i], label=f"x{i+1}")ax.set_xscale("log")ax.set_xlabel("alpha (fuerza de regularización)")ax.set_ylabel("Valor del coeficiente")ax.set_title("Lasso: los coeficientes menos relevantes llegan exactamente a cero")ax.legend(loc="upper right", fontsize=8, ncol=2)ax.grid(alpha=0.3)plt.show()print("Variables informativas reales (coeficiente ≠ 0 en la generación):")print([f"x{i+1}"for i, c inenumerate(coef_real) ifabs(c) >0])
Variables informativas reales (coeficiente ≠ 0 en la generación):
['x2', 'x5', 'x7', 'x10']
import numpy as npfrom sklearn.datasets import make_regressionfrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import LassoX, y, coef_real = make_regression( n_samples=200, n_features=10, n_informative=4, noise=10.0, coef=True, random_state=42,)X = StandardScaler().fit_transform(X)modelo_lasso = Lasso(alpha=1.0, max_iter=10000)modelo_lasso.fit(X, y)no_cero = np.sum(modelo_lasso.coef_ !=0)print(f"Variables con coeficiente distinto de cero: {no_cero} de {X.shape[1]}")print(f"Variables realmente informativas: {np.sum(np.abs(coef_real) >0)}")
Variables con coeficiente distinto de cero: 4 de 10
Variables realmente informativas: 4
Lectura de la selección de variables con Lasso
Con alpha=1.0, Lasso dejó exactamente 4 coeficientes distintos de cero de las 10 variables — y esas 4 son precisamente x2, x5, x7 y x10: las mismas 4 que realmente generaron la señal al construir el dataset sintético. Coincidencia perfecta entre lo que el modelo “eligió” y lo que era verdad.
Las 6 variables sin efecto real (x1, x3, x4, x6, x8, x9) quedaron en exactamente cero, no solo “chiquitas”: Lasso las apagó del todo.
En un problema real nunca vas a tener esta certeza (no conoces el coef_real de antemano), pero el mecanismo es el mismo: a un alpha suficientemente alto, Lasso deja activas solo las variables que más aportan y apaga el resto — de facto, selección automática de variables.
Comparación visual: sin regularizar vs. Ridge vs. Lasso
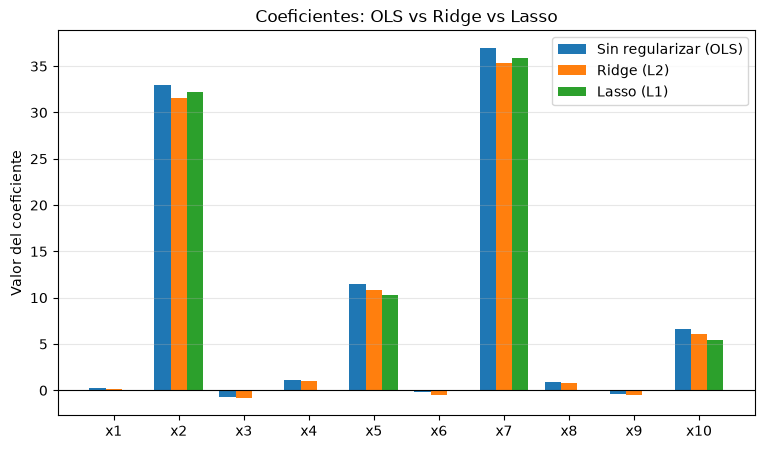
Ahora compara, lado a lado, los coeficientes que produce cada enfoque sobre el mismo dataset sintético, con un valor de \(\alpha\) fijo y razonable para cada uno.
OLS asigna coeficiente distinto de cero a las 10 variables, incluidas las 6 que no tienen ningún efecto real. x4, por ejemplo, sale con +1.10 pese a que su coeficiente real es 0 — puro ruido que el modelo interpreta como señal.
Ridge (alpha=10) reduce apenas un poco la magnitud total (91.7 a 87.6 en suma de |coeficientes|) y sigue dejando las 10 variables activas: a x4 lo baja de 1.10 a 1.05, un recorte mínimo.
Lasso (alpha=1.0) es el único que produce un modelo esparso: solo 4 de 10 coeficientes quedan distintos de cero, y x4 queda en 0.00 exacto — apagado por completo, no solo reducido.
Cierre técnico: ¿cuándo usar cada una?
Situación
Recomendación
Muchas variables correlacionadas entre sí (multicolinealidad)
Ridge — distribuye el “peso” entre variables correlacionadas en vez de elegir una de forma arbitraria
Sospechas que muchas variables son irrelevantes y quieres un modelo más simple e interpretable
Lasso — hace selección de variables automáticamente
Quieres lo mejor de ambos mundos (selección + manejo de correlación)
Elastic Net — combina las penalizaciones L1 y L2 (no cubierto en este artículo, disponible en sklearn.linear_model.ElasticNet)
No hay señales de sobreajuste y el modelo lineal simple ya generaliza bien
Regresión lineal ordinaria — no toda situación necesita regularización
En la práctica, el valor de \(\alpha\)no se elige a mano: se selecciona con validación cruzada (RidgeCV, LassoCV en scikit-learn), probando un rango de valores y quedándote con el que minimiza el error en datos de validación. Ese será tema de un próximo artículo de la serie, dedicado a evaluación de modelos y bootstrap.
Un último punto práctico: tanto Ridge como Lasso son sensibles a la escala de las variables — por eso, en todos los ejemplos de este artículo, se estandarizaron los datos con StandardScaler antes de ajustar el modelo. Si te saltas ese paso, las variables con escalas más grandes quedan penalizadas de forma desproporcionada respecto a las demás.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.
👉 El código completo está disponible para ejecutar directamente.