Ejemplo: flujo completo de un notebook publicado en el blog

ejemplo
machine-learning
Author

Wilder Ramírez Delgado

Published

August 23, 2026

Análisis ficticio de ventas: notebook de prueba para publicación

Open in Colab

Este notebook es una muestra compacta y realista para evaluar la conversión .ipynb → HTML y su publicación en distintos canales.

En esta demostración usamos datos sintéticos de ventas y una secuencia técnica típica:

  1. Carga y creación de datos
  2. Exploración inicial
  3. Transformación
  4. Estadísticas descriptivas
  5. Visualizaciones estáticas e interactivas

También incluimos elementos de formato: cursiva, negrita, listas y cita.

  • Tema: ventas mensuales por región y canal
  • Fuente: datos generados en Python (sin archivos externos)
  • Reproducibilidad: semilla fija

Más sobre buenas prácticas de visualización: Plotly Fundamentals.

Nota: este cuaderno incluye caracteres en español (á, é, í, ó, ú, ñ) y símbolos como ≥, ≤, %, $, → para validar renderizado.

URL de prueba visible: https://biitt.com/blog

Ecuación inline de margen: \(m = \frac{ingresos - costos}{ingresos}\).

👋 Sobre el autor

Wilder Ramírez Delgado es Científico de Datos, Arquitecto de IA, Ingeniero Electrónico y Magíster en Analítica de Datos. CEO y fundador de Business Innovation Technology (BIT), consultor y docente universitario, trabaja en la intersección entre Data Science, Inteligencia Artificial, Big Data e IoT, transformando problemas reales en soluciones aplicadas.

De la teoría a la práctica, un problema a la vez.

Datos

Generamos un dataset pequeño de ventas con variación por mes, región, canal y categoría.

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import plotly.express as px

np.random.seed(42)

meses = pd.date_range("2026-01-01", periods=8, freq="MS")
regiones = ["Norte", "Centro", "Sur"]
canales = ["Online", "Retail"]
categorias = ["Software", "Servicios", "Capacitación"]

rows = []
for mes in meses:
    for region in regiones:
        for canal in canales:
            for categoria in categorias:
                base_unidades = np.random.randint(60, 180)
                precio_unitario = np.random.uniform(45, 140)
                descuento_pct = np.random.choice([0.00, 0.05, 0.10, 0.15], p=[0.35, 0.30, 0.25, 0.10])

                ingreso_bruto = base_unidades * precio_unitario
                ingreso_neto = ingreso_bruto * (1 - descuento_pct)
                costo_estimado = ingreso_neto * np.random.uniform(0.52, 0.72)

                rows.append({
                    "mes": mes,
                    "region": region,
                    "canal": canal,
                    "categoria": categoria,
                    "unidades": int(base_unidades),
                    "precio_unitario": round(precio_unitario, 2),
                    "descuento_pct": float(descuento_pct),
                    "ingreso_neto": round(ingreso_neto, 2),
                    "costo_estimado": round(costo_estimado, 2)
                })

df = pd.DataFrame(rows)
print(f"Filas generadas: {len(df)}")
df.head()
Filas generadas: 144
mes region canal categoria unidades precio_unitario descuento_pct ingreso_neto costo_estimado
0 2026-01-01 Norte Online Software 162 120.67 0.00 19548.80 13213.78
1 2026-01-01 Norte Online Servicios 80 59.82 0.00 4785.74 2544.18
2 2026-01-01 Norte Online Capacitación 147 76.70 0.00 11275.24 7330.91
3 2026-01-01 Norte Retail Software 112 137.14 0.10 13823.86 7775.47
4 2026-01-01 Norte Retail Servicios 123 139.26 0.05 16272.54 10452.35

Exploración

Primero revisamos estructura, tipos y una tabla ancha para testear visualización en publicación.

print("Resumen rápido del dataset:")
print(df.info())

tabla_ancha = (
    df.pivot_table(
        index=["region", "canal"],
        columns="mes",
        values="ingreso_neto",
        aggfunc="sum"
    )
    .round(0)
)

tabla_ancha.columns = [c.strftime("%Y-%m") for c in tabla_ancha.columns]
tabla_ancha
Resumen rápido del dataset:
<class 'pandas.DataFrame'>
RangeIndex: 144 entries, 0 to 143
Data columns (total 9 columns):
 #   Column           Non-Null Count  Dtype         
---  ------           --------------  -----         
 0   mes              144 non-null    datetime64[us]
 1   region           144 non-null    str           
 2   canal            144 non-null    str           
 3   categoria        144 non-null    str           
 4   unidades         144 non-null    int64         
 5   precio_unitario  144 non-null    float64       
 6   descuento_pct    144 non-null    float64       
 7   ingreso_neto     144 non-null    float64       
 8   costo_estimado   144 non-null    float64       
dtypes: datetime64[us](1), float64(4), int64(1), str(3)
memory usage: 10.3 KB
None
2026-01 2026-02 2026-03 2026-04 2026-05 2026-06 2026-07 2026-08
region canal
Centro Online 35186.0 49554.0 42293.0 32025.0 42012.0 24524.0 48242.0 15813.0
Retail 18406.0 28715.0 33445.0 33557.0 27430.0 24748.0 43131.0 30073.0
Norte Online 35610.0 32800.0 26948.0 31399.0 34495.0 37233.0 36724.0 28596.0
Retail 37583.0 26243.0 38964.0 38199.0 29921.0 19354.0 28893.0 19668.0
Sur Online 23018.0 43835.0 30914.0 25818.0 20949.0 23586.0 23635.0 39535.0
Retail 26645.0 27783.0 29011.0 35379.0 45683.0 26238.0 36963.0 25284.0

Transformación

Creamos variables derivadas para análisis de margen y segmentación de desempeño.

def etiquetar_rendimiento(margen_pct, ingreso_neto):
    if (margen_pct >= 0.40) and (ingreso_neto >= 12000):
        return "Alto"
    if (margen_pct >= 0.30) and (ingreso_neto >= 9000):
        return "Medio"
    return "Bajo"

def preparar_dataset(df_base):
    df_t = df_base.copy()

    df_t["utilidad"] = df_t["ingreso_neto"] - df_t["costo_estimado"]
    df_t["margen_pct"] = np.where(
        df_t["ingreso_neto"] > 0,
        df_t["utilidad"] / df_t["ingreso_neto"],
        np.nan
    )

    df_t["ticket_promedio"] = np.where(
        df_t["unidades"] > 0,
        df_t["ingreso_neto"] / df_t["unidades"],
        np.nan
    )

    df_t["rendimiento"] = [
        etiquetar_rendimiento(m, i)
        for m, i in zip(df_t["margen_pct"], df_t["ingreso_neto"])
    ]

    df_t["mes_nombre"] = df_t["mes"].dt.strftime("%b")
    return df_t

df_t = preparar_dataset(df)

print("Transformación completada → columnas nuevas: utilidad, margen_pct, ticket_promedio, rendimiento")
df_t[["mes", "region", "canal", "ingreso_neto", "utilidad", "margen_pct", "rendimiento"]].head()
Transformación completada → columnas nuevas: utilidad, margen_pct, ticket_promedio, rendimiento
mes region canal ingreso_neto utilidad margen_pct rendimiento
0 2026-01-01 Norte Online 19548.80 6335.02 0.324062 Medio
1 2026-01-01 Norte Online 4785.74 2241.56 0.468383 Bajo
2 2026-01-01 Norte Online 11275.24 3944.33 0.349822 Medio
3 2026-01-01 Norte Retail 13823.86 6048.39 0.437533 Alto
4 2026-01-01 Norte Retail 16272.54 5820.19 0.357669 Medio

Estadísticas

Calculamos métricas agregadas y una tabla resumen con Pandas.

Ecuación en bloque para referencia: \[ ROI = \frac{\sum utilidad}{\sum costo} \times 100 \] Si \(ROI eq 20\%\), consideramos un desempeño saludable.

resumen_general = {
    "ingreso_total": df_t["ingreso_neto"].sum(),
    "costo_total": df_t["costo_estimado"].sum(),
    "utilidad_total": df_t["utilidad"].sum(),
    "margen_promedio": df_t["margen_pct"].mean(),
    "ticket_promedio": df_t["ticket_promedio"].mean()
}

roi = (resumen_general["utilidad_total"] / resumen_general["costo_total"]) * 100
print(f"Ingreso total: ${resumen_general['ingreso_total']:,.2f}")
print(f"Utilidad total: ${resumen_general['utilidad_total']:,.2f}")
print(f"Margen promedio: {resumen_general['margen_promedio']:.2%}")
print(f"ROI estimado: {roi:.2f}%")

tabla_resumen = (
    df_t.groupby(["region", "canal"], as_index=False)
    .agg(
        ingreso_total=("ingreso_neto", "sum"),
        utilidad_total=("utilidad", "sum"),
        margen_promedio=("margen_pct", "mean"),
        unidades_total=("unidades", "sum")
    )
    .sort_values(by="ingreso_total", ascending=False)
)

tabla_resumen
Ingreso total: $1,516,059.34
Utilidad total: $586,009.69
Margen promedio: 38.69%
ROI estimado: 63.01%
region canal ingreso_total utilidad_total margen_promedio unidades_total
0 Centro Online 289649.28 110873.94 0.380867 2886
2 Norte Online 263805.07 104656.98 0.400802 2857
5 Sur Retail 252984.68 95124.82 0.376046 2894
1 Centro Retail 239504.68 90415.85 0.382808 2800
3 Norte Retail 238826.14 95155.41 0.392284 2866
4 Sur Online 231289.49 89782.69 0.388458 2712

Visualizaciones

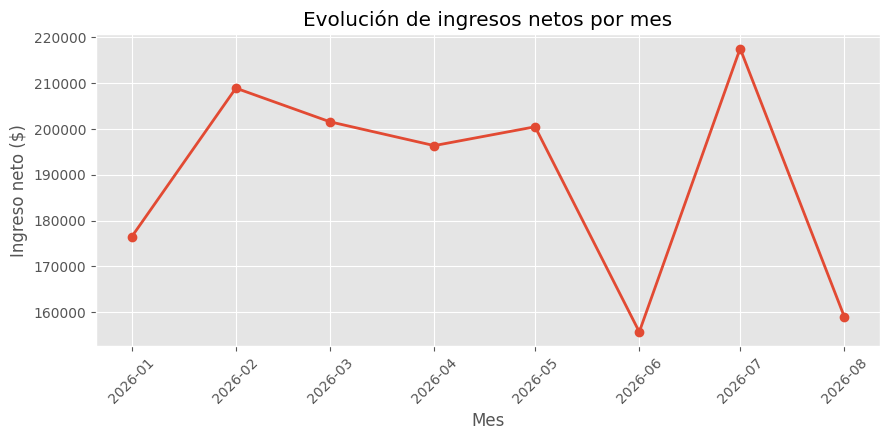
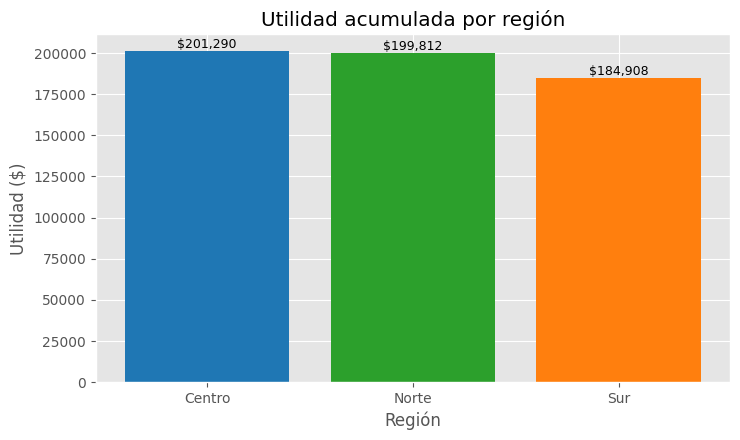
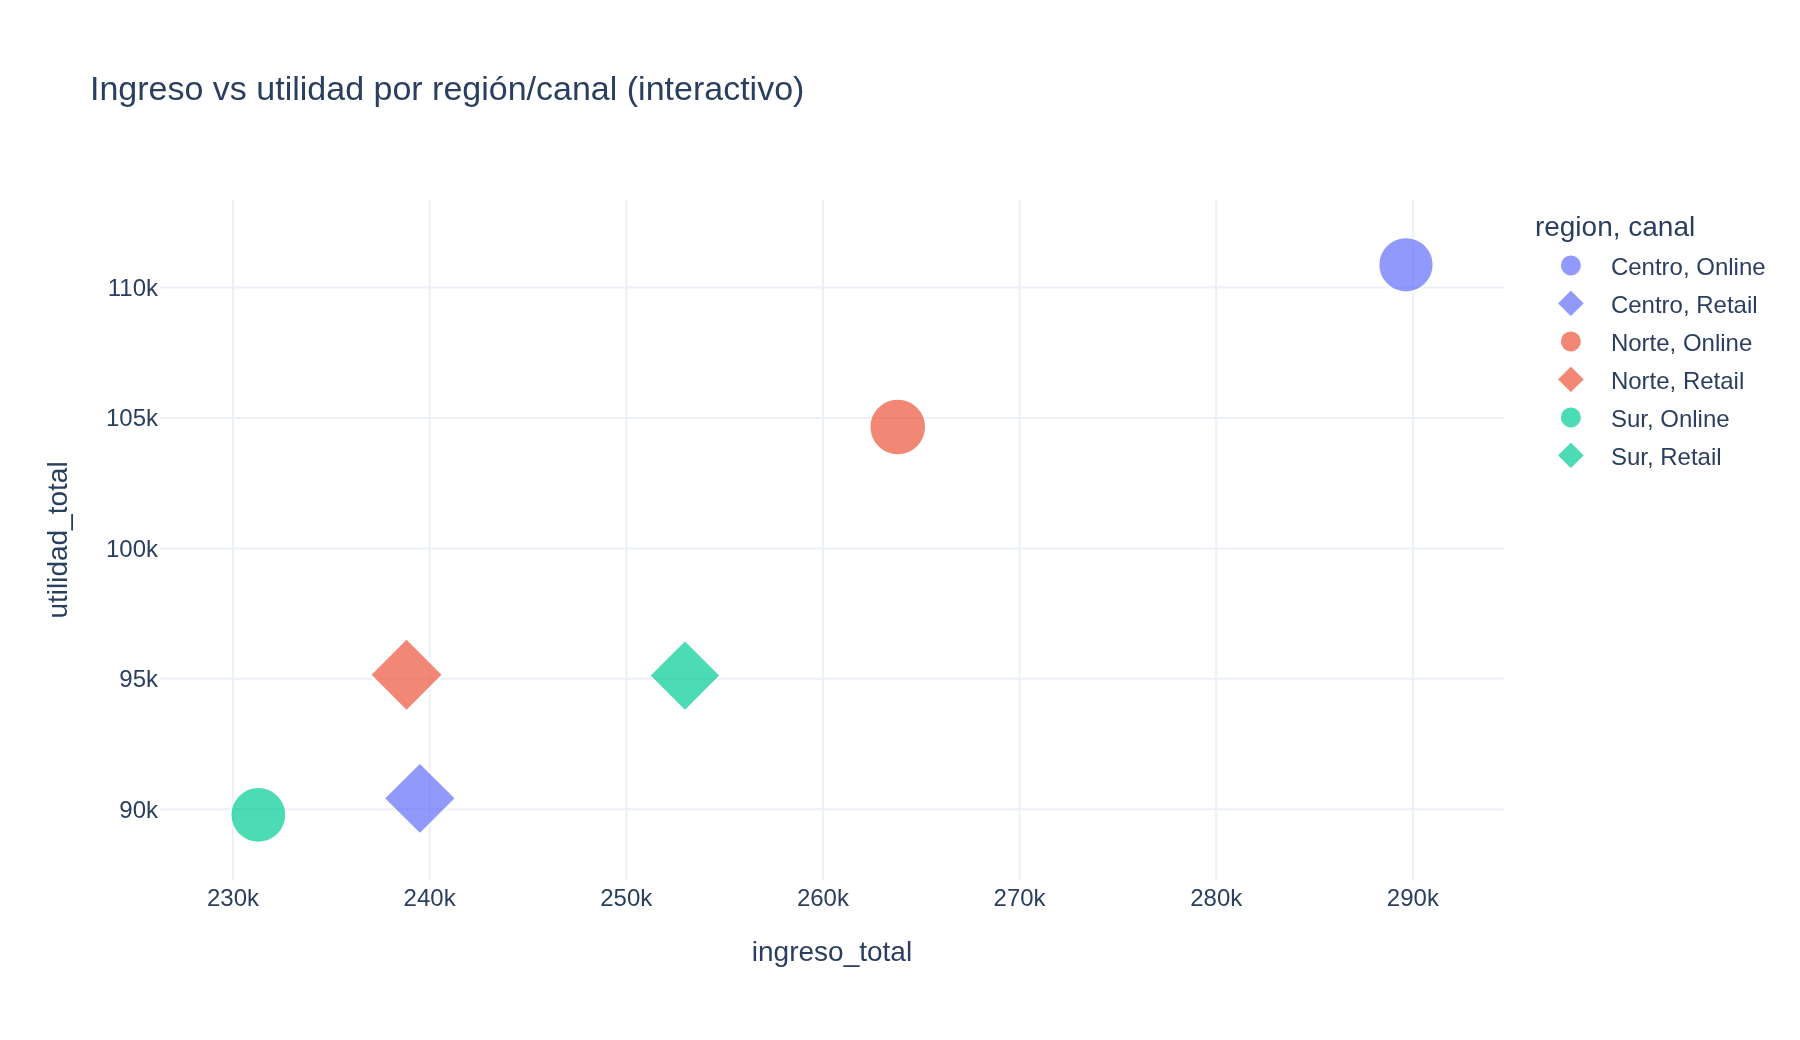
Incluimos dos gráficas con Matplotlib y una interactiva con Plotly.

ventas_mensuales = df_t.groupby("mes", as_index=False)["ingreso_neto"].sum()

plt.style.use("ggplot")
fig, ax = plt.subplots(figsize=(9, 4.5))
ax.plot(ventas_mensuales["mes"], ventas_mensuales["ingreso_neto"], marker="o", linewidth=2)
ax.set_title("Evolución de ingresos netos por mes")
ax.set_xlabel("Mes")
ax.set_ylabel("Ingreso neto ($)")
ax.tick_params(axis="x", rotation=45)
plt.tight_layout()
plt.show()

utilidad_region = df_t.groupby("region", as_index=False)["utilidad"].sum()

fig, ax = plt.subplots(figsize=(7.5, 4.5))
bars = ax.bar(utilidad_region["region"], utilidad_region["utilidad"], color=["#1f77b4", "#2ca02c", "#ff7f0e"])
ax.set_title("Utilidad acumulada por región")
ax.set_xlabel("Región")
ax.set_ylabel("Utilidad ($)")

for b in bars:
    y = b.get_height()
    ax.text(b.get_x() + b.get_width() / 2, y, f"${y:,.0f}", ha="center", va="bottom", fontsize=9)

plt.tight_layout()
plt.show()

scatter_df = (
    df_t.groupby(["region", "canal"], as_index=False)
    .agg(
        ingreso_total=("ingreso_neto", "sum"),
        utilidad_total=("utilidad", "sum"),
        margen_promedio=("margen_pct", "mean")
    )
)

fig = px.scatter(
    scatter_df,
    x="ingreso_total",
    y="utilidad_total",
    size="margen_promedio",
    color="region",
    symbol="canal",
    hover_data={"margen_promedio": ":.2%"},
    title="Ingreso vs utilidad por región/canal (interactivo)"
)
fig.update_layout(template="plotly_white")
fig.show()
Unable to display output for mime type(s): application/vnd.plotly.v1+json

Versión estática del gráfico interactivo

Medium (y otros importadores que no ejecutan JavaScript) no pueden mostrar el widget interactivo de Plotly de arriba. Por eso generamos también una versión estática (PNG) del mismo gráfico, para que sobreviva en plataformas sin soporte de JS.

from IPython.display import Image, display

# Exportamos el mismo gráfico de Plotly como imagen estática (requiere el paquete kaleido).
# Esta versión sí es un <img> normal en el HTML final, así que sobrevive al import de Medium.
fig.update_layout(width=900, height=520)
fig.write_image("plotly_scatter_static.png", scale=2)

display(Image(filename="plotly_scatter_static.png"))

Conclusiones

Este notebook cumple con una estructura técnica publicable: Título → Introducción → Datos → Exploración → Transformación → Estadísticas → Visualizaciones → Conclusiones.

Hallazgos ficticios: - El ingreso y la utilidad muestran variación moderada por mes. - Existen diferencias entre regiones y canales en margen promedio. - El formato incluye componentes útiles para validar exportación a HTML, blog y Medium.

Checklist visual rápida: - Caracteres especiales: á, é, í, ó, ú, ñ - Símbolos: ≥, ≤, %, $, → - Tabla ancha y bloque de código largo - Gráficas estáticas + gráfica interactiva

💬 ¿Te sirvió?

Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo análisis de datos.

👉 El código completo está disponible para ejecutar directamente.