5 HDFS: el sistema de archivos distribuido de Big Data
Dónde se guardan los datos cuando ya no caben en una sola máquina
En este capítulo vas a entender qué es un sistema de archivos, en qué se diferencia uno distribuido de uno en red y por qué Big Data necesita una capa capaz de repartir, replicar y servir datos desde varias máquinas. El centro del recorrido es HDFS (Hadoop Distributed File System): su relación con Google File System, su arquitectura basada en NameNode y DataNodes, sus flujos de lectura y escritura y los casos en los que conviene elegir otra tecnología. Este es el material teórico; la construcción práctica del clúster corresponde a Laboratorio: HDFS con Docker, desde la instalación hasta las réplicas.
Tiempo estimado de lectura: 28 minutos
Nivel: Intermedio
Conocimientos previos recomendados: - Manejo básico de la terminal Linux - Lectura de Ecosistema Hadoop: el mapa de una plataforma Big Data, el capítulo anterior - Fundamentos de Big Data: las cinco V, escalamiento horizontal y la idea de “llevar el cómputo a los datos”
Tecnologías mencionadas: - Sistemas de archivos locales, en red y distribuidos - Google File System (GFS) y Apache Hadoop / HDFS - YARN, MapReduce y Apache Spark (como puente al procesamiento)
En Ecosistema Hadoop construimos el mapa de la plataforma: HDFS almacena, YARN administra recursos y motores como MapReduce o Spark procesan. Ahora abriremos la primera de esas piezas: ¿cómo conserva HDFS los archivos entre muchas máquinas y permite recuperarlos cuando alguna falla? En Fundamentos vimos las razones para distribuir; aquí estudiaremos los bloques, las réplicas y los metadatos que hacen posible esa distribución. Antes de entrar en NameNodes y DataNodes, comenzaremos por la idea general de sistema de archivos.
Parte 1 — Sistemas de archivos, en general
Cuando guardas un archivo como /home/wilder/datos/ventas.csv, trabajas con una ruta que puedes reconocer y volver a abrir. El dispositivo de almacenamiento, en cambio, conserva los datos en bloques. Para recuperar ese archivo, el sistema debe relacionar su nombre con el lugar donde está su contenido, conocer su tamaño y comprobar si tienes permiso para leerlo. La capa que organiza estas operaciones es el sistema de archivos (file system, FS).
Podemos entender su función siguiendo la vida de ese mismo archivo. Al crearlo, el sistema de archivos registra el nombre ventas.csv dentro del directorio datos y asigna espacio para almacenar su contenido. Ese espacio no tiene que ser contiguo: distintas partes del archivo pueden ocupar regiones diferentes del dispositivo. El sistema mantiene la información necesaria para que una aplicación pueda leerlas en el orden correcto, sin tener que conocer su ubicación física.
Junto con el contenido se conserva información que permite administrarlo: el tamaño, las fechas que soporte el sistema, su propietario y los permisos de acceso, entre otros atributos. Estos datos se llaman metadatos, porque describen el archivo. La distinción se observa en la terminal de Linux: ls -l muestra nombres y atributos de las entradas de un directorio; cat ventas.csv permite leer el contenido. Ambas operaciones se apoyan en el sistema de archivos, pero consultan información diferente.
La organización en directorios permite reunir archivos relacionados y encontrarlos mediante rutas. Los permisos, en los sistemas que los admiten, regulan quién puede acceder a ellos y qué operaciones puede realizar. Cuando un archivo crece, el sistema de archivos gestiona el espacio adicional; cuando se elimina, gestiona la liberación del espacio que pueda recuperarse. Nombres, directorios, metadatos, control de acceso y asignación de espacio forman así una estructura que permite trabajar con archivos sin administrar directamente los bloques del dispositivo.
Distintas respuestas a una misma necesidad
Estas responsabilidades se han implementado de diferentes maneras a medida que han cambiado los dispositivos y las necesidades de los usuarios. FAT (File Allocation Table), asociado a los disquetes y al entorno DOS, organiza la ubicación del contenido mediante una tabla de unidades de almacenamiento. Su diseño sencillo favoreció la compatibilidad entre equipos, aunque ofrece menos posibilidades de protección y administración que otros sistemas posteriores.
Con el crecimiento de los equipos personales y los servidores cobraron mayor importancia el control de acceso y la recuperación ante interrupciones. En Windows, NTFS incorporó permisos detallados y un registro de cambios, conocido como journaling, que ayuda a recuperar la consistencia de las estructuras del sistema de archivos después de un fallo. Esto no garantiza que todo dato pendiente de escritura sobreviva a un apagón, pero facilita recuperar una estructura utilizable.
En Linux, ext4 también utiliza journaling y organiza la asignación mediante rangos de bloques llamados extents. En el entorno Apple, APFS adopta otras técnicas, como la copia en escritura y las instantáneas, para gestionar cambios y conservar estados del sistema de archivos. Son diseños con características propias: no constituyen una secuencia en la que cada uno sustituye al anterior. Todos permiten organizar archivos, pero responden a necesidades y entornos distintos.
De un dispositivo a varias máquinas
Hasta aquí hemos pensado en archivos administrados dentro de una máquina. Esa perspectiva será útil al estudiar HDFS, porque cada nodo sigue necesitando un sistema de archivos local, como ext4 o XFS, para guardar los datos en sus discos. HDFS añade una capa de organización sobre esos almacenamientos locales: presenta archivos y directorios al usuario, aunque su contenido esté repartido entre distintas máquinas.
Al ampliar el alcance aparecen preguntas nuevas. ¿Cómo encuentra un cliente las partes de un archivo? ¿Qué ocurre si la máquina que conserva una de ellas deja de responder? ¿Cómo se mantiene el acceso cuando aumentan los datos y los usuarios? Resolverlas exige coordinar el almacenamiento a través de la red. En la siguiente parte distinguiremos el acceso a archivos remotos de la distribución de sus datos entre varios nodos, y veremos dónde encaja HDFS.
Parte 2 — Sistemas de archivos en red y distribuidos
Cuando los datos salen de una sola máquina, el FS tiene que decidir algo nuevo: quién tiene qué, y cómo lo alcanzas por la red. Aquí se separan dos familias que la gente mezcla todo el tiempo.
Sistema de archivos en red versus sistema de archivos distribuido
Un sistema de archivos en red permite acceder a archivos remotos mediante un protocolo como NFS (Network File System). En una instalación sencilla, un servidor conserva los datos y los clientes montan sus directorios. Si ese servidor falla y no hay alta disponibilidad, el acceso se interrumpe; su capacidad depende del almacenamiento que tenga detrás.
Aunque en este ejemplo los archivos residen en un solo servidor, los clientes también pueden acceder mediante NFS a una plataforma que distribuye el almacenamiento entre varias máquinas y mantiene el servicio ante fallos. La extensión pNFS, incorporada en NFSv4.1, permite incluso que el cliente acceda en paralelo a datos ubicados en distintos servidores. Esto introduce una distinción que necesitamos para entender HDFS: una cosa es el protocolo que permite abrir archivos a través de la red y otra es la arquitectura que organiza y protege su contenido entre los nodos.
Un sistema de archivos distribuido parte los datos entre muchos nodos y, casi siempre, los replica: guarda copias en máquinas distintas. No hay un único disco de verdad detrás del árbol de directorios. El cliente habla con un servicio que le dice dónde está cada pedazo, y luego lee o escribe contra esos nodos. Si un nodo muere, el sistema sigue sirviendo el archivo desde otra copia. Escalar significa agregar máquinas: horizontal.
Para comparar arquitecturas hay que distinguir cómo accede el cliente de cómo se almacenan y protegen los datos. En HDFS estudiaremos explícitamente la distribución de bloques y réplicas; para un servicio NFS necesitamos conocer también su infraestructura de almacenamiento.
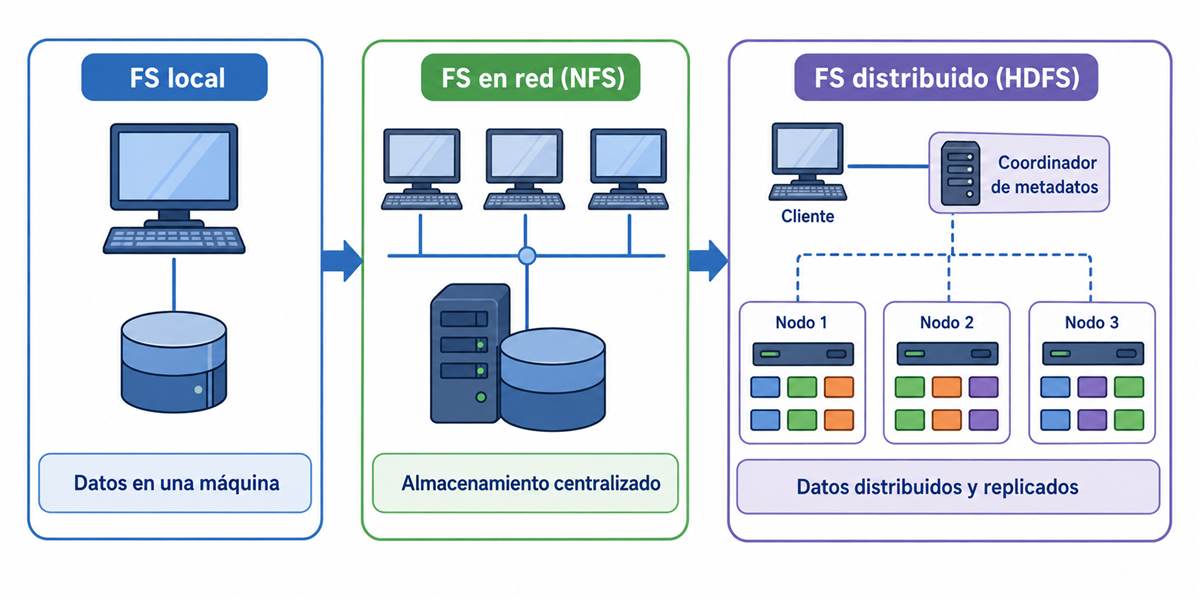
Figura 1. Ejemplos simplificados: almacenamiento local, NFS con un solo servidor y HDFS con bloques y réplicas entre varios nodos. El caso NFS ilustrado no representa las variantes en clúster o con alta disponibilidad.
¿Cuándo usar cada uno? NFS resulta útil para compartir directorios con aplicaciones que esperan acceso a archivos remotos. HDFS está orientado a archivos grandes, lecturas sostenidas y procesamiento distribuido en el ecosistema Hadoop. La elección depende del patrón de acceso, la capacidad, el rendimiento y las garantías de la implementación concreta.
Lo que pedimos de un sistema distribuido de archivos
Antes de poner nombres comerciales, conviene el checklist. Un FS distribuido “de verdad” persigue, con distintos matices, estas propiedades:
- Transparencia de ubicación. Tú abres
/datos/ventas/2024.csvsin saber en qué máquina está el byte 0. El sistema traduce el nombre a nodos concretos. - Concurrencia. Muchos clientes leen (y, según el diseño, escriben) a la vez sin corromper el espacio de nombres.
- Escalabilidad horizontal. Agregar nodos aumenta capacidad y, en un buen diseño, también ancho de banda de lectura.
- Tolerancia a fallos. Un disco, un nodo o incluso un rack entero puede morir sin que el archivo desaparezca. Aquí entra la réplica: una copia adicional de un mismo pedazo de datos, guardada en otro sitio.
- Consistencia. Después de una escritura, ¿qué ve el siguiente lector? Los FS distribuidos eligen un modelo (fuerte, eventual, “cierre del archivo”) y viven con él. HDFS, como verás, apuesta a un modelo simple: escribes, cierras, y a partir de ahí el archivo es inmutable para la mayoría de los usos.
Estas propiedades implican decisiones de diseño. Por ejemplo, durante una partición de red un sistema distribuido no puede garantizar al mismo tiempo consistencia fuerte y disponibilidad para todas las operaciones. HDFS prioriza la integridad del espacio de nombres y un modelo de escritura controlado, en lugar de permitir actualizaciones concurrentes y arbitrarias sobre cualquier parte de un archivo.
¿Para qué sirve este checklist? Para evaluar cualquier almacén —HDFS, Ceph, S3— con las mismas preguntas, no con marketing. “¿Dónde está el dato? ¿Qué pasa si cae un disco? ¿Cuántos clientes pueden leer a la vez? ¿Qué garantiza una escritura?”
Una clasificación con nombres que vas a ver en la industria
- NFS. Protocolo de acceso a archivos remotos. Puede exponerse desde un servidor sencillo o desde una plataforma de almacenamiento en clúster; su escala y disponibilidad dependen de esa implementación.
- Google File System (GFS). El paper de 2003 que cambió el tablero. FS distribuido interno de Google: archivos enormes, fallos como norma, un maestro de metadatos y muchos chunkservers. Es el abuelo conceptual de HDFS.
- HDFS. La implementación de código abierto, en el proyecto Hadoop, del mismo espíritu de GFS. Es el objeto de este capítulo.
- Ceph. FS distribuido (y también almacén de objetos y de bloques) sin un metadatos único tan pronunciado como el de HDFS. Muy usado como storage definido por software en nubes privadas.
- GlusterFS. FS distribuido por agregación de volúmenes. Más “POSIX de red” que “data lake de Hadoop”.
- Almacenamiento de objetos (Amazon S3 y similares). Ya no es un árbol POSIX clásico: son buckets y objetos direccionados por clave, vía HTTP. No montas un directorio; haces
GET/PUT. Es el modelo dominante en la nube, y más adelante lo contrastamos con HDFS.
¿Cuándo usar esta clasificación? Cuando te pidan “¿lo ponemos en NFS, en HDFS o en S3?”. No es una pregunta de marca: es una pregunta de modelo de acceso, de escala y de quién opera el hardware.
Tabla comparativa
| FS local (ext4, NTFS, APFS) | FS en red (NFS) | FS distribuido (HDFS, GFS, Ceph) | Almacenamiento de objetos (S3) | |
|---|---|---|---|---|
| Escala | Limitada por el equipo y sus volúmenes | Depende del servidor o del almacenamiento en clúster que lo respalda | Capacidad repartida entre nodos; depende del diseño | Capacidad elástica, sujeta a límites del servicio |
| Tolerancia a fallos | Depende del hardware y la protección de datos | Un servidor sencillo puede ser un punto único de fallo; existen despliegues con HA | Réplicas o codificación de borrado, según el sistema y la política | Protección a cargo del proveedor según el servicio contratado |
| Tipo de acceso | Operaciones de archivo; semántica según FS y sistema operativo | Operaciones de archivo remoto con semántica NFS | En HDFS: árbol de archivos, bloques grandes, sin edición aleatoria | HTTP/API: objetos, no POSIX nativo |
| Caso de uso típico | SO, apps, disco de un servidor | Compartir home y proyectos en una LAN | Data lake on-premise, batch masivo, Hadoop/Spark sobre disco local | Data lake en la nube, desacoplar cómputo y almacenamiento |
¿Para qué sirve esta tabla? Para elegir con criterio. Si los datos caben en un servidor y los comparte un equipo pequeño, NFS puede ser suficiente. Si operas un clúster Hadoop sobre infraestructura propia, HDFS es su sistema de archivos nativo. En arquitecturas de nube, el almacenamiento de objetos suele permitir separar la vida de los datos de la vida del clúster de procesamiento.
Parte 3 — Big Data y los sistemas de archivos distribuidos
Por qué distribuir el almacenamiento en Big Data
En Fundamentos hablamos de las cinco V. La que primero presiona el almacenamiento es el volumen: un conjunto de datos de 200 TB difícilmente cabe y se procesa de manera eficiente en una sola máquina. El escalamiento vertical —aumentar la capacidad de un servidor— tiene límites físicos y económicos. Hadoop adopta el escalamiento horizontal: agregar máquinas de propósito general y distribuir entre ellas los datos y el trabajo.
Cuando el volumen o el rendimiento requerido superan una máquina, distribuir el almacenamiento permite agregar capacidad y tolerar fallos. Esa función puede implementarse con un sistema de archivos distribuido o con almacenamiento de objetos. En la arquitectura Hadoop clásica, HDFS combina tres objetivos:
- Capacidad agregada. Los discos destinados a HDFS aportan capacidad bruta al conjunto. La capacidad útil es menor porque hay que descontar réplicas y reservar espacio para la operación y la recuperación.
- Tolerancia a fallos con hardware barato. Si usas discos y máquinas que van a fallar (no “si fallan”), el FS tiene que asumir la muerte de un nodo como operación normal. La réplica no es un extra: es el diseño.
- Localidad de los datos (data locality). En Fundamentos quedó la frase: llevar el cómputo a los datos, no los datos al cómputo. Un FS distribuido puede decirle al planificador: “el bloque que necesitas está en el nodo 17; corre el proceso ahí”. Mover 128 MB por la red de rack es caro; mover el código (unos KB o MB) es barato.
El mapa de bloques de HDFS permite a los motores solicitar recursos cerca de los datos. Esa localidad es una ventaja de compartir nodos de almacenamiento y cómputo. MapReduce y Spark también pueden procesar datos desde otros almacenes; cuando leen objetos remotos, el rendimiento depende de la red y de la organización de los datos, sin localidad de disco HDFS.
La pregunta de diseño es qué combinación de capacidad, tolerancia a fallos y cercanía al cómputo necesita la carga de trabajo. HDFS ofrece una respuesta adecuada para el clúster Hadoop clásico; el almacenamiento de objetos favorece otras formas de separar y escalar esos recursos.
El almacenamiento en una plataforma de datos
Una plataforma de datos, simplificada, se lee de izquierda a derecha:
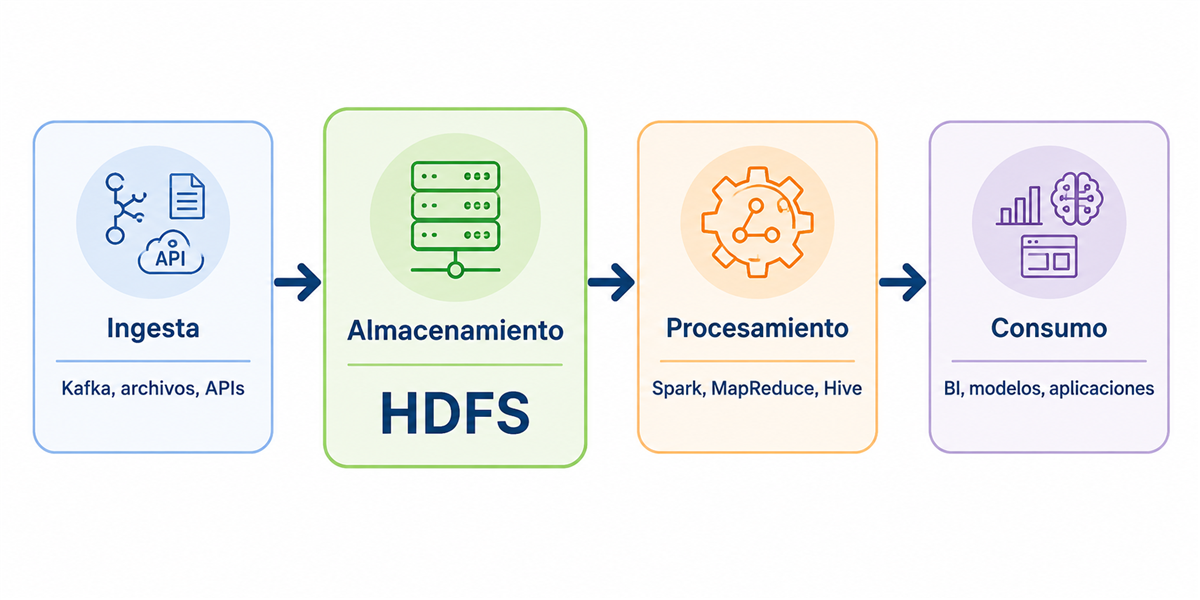
Figura 2. HDFS ocupa la capa de persistencia: recibe datos de la ingesta y los pone a disposición de los motores de procesamiento.
La ingesta trae eventos, archivos y tablas. El almacenamiento los persiste de forma duradera y barata, en un formato que el cómputo pueda leer en paralelo. El procesamiento transforma, agrega y entrena. El análisis consume el resultado.
HDFS ocupa —en una plataforma Hadoop clásica on-premise— esa segunda caja. No es el motor de consultas ni el gestor de recursos. Es el sistema de archivos sobre el que se conservan los archivos crudos, las tablas de Hive, los puntos de control y, con frecuencia, los resultados de los trabajos de procesamiento.
En la nube, esa misma caja suele ser un object store. El rol no cambia: sigue siendo la capa persistente del data lake. Cambia el producto y cambia la localidad (el cómputo ya no corre “encima” del disco), pero el lugar en el diagrama es el mismo.
¿Cuándo usar esta foto mental? Cada vez que te pregunten “¿dónde entra HDFS?”. Entre lo que llega y lo que se calcula. No es ingesta. No es Spark. Es el disco del clúster, elevado a sistema distribuido.
Parte 4 — HDFS a fondo
Historia y linaje: de GFS a Hadoop
En 2003, Sanjay Ghemawat, Howard Gobioff y Shun-Tak Leung publicaron The Google File System (GFS) en el simposio SOSP. El paper no describía un producto que pudieras instalar. Describía cómo Google almacenaba archivos enormes en miles de PCs ordinarias, asumiendo que los discos y las máquinas se romperían todo el tiempo, y optimizando para un patrón concreto: escribir una vez, leer muchas, en lotes, no en clics interactivos.
Poco después, Doug Cutting y Mike Cafarella, trabajando en el buscador Nutch, leyeron ese paper y el de MapReduce (2004) y construyeron equivalentes de código abierto. Eso se convirtió en Apache Hadoop. El sistema de archivos del proyecto se llamó HDFS: Hadoop Distributed File System. No es una copia línea a línea de GFS, pero sí un descendiente intelectual: maestro de metadatos, trabajadores que guardan chunks (en HDFS, bloques), replicación, y la falla como caso de diseño.
Yahoo, Facebook y otros operadores a escala adoptaron Hadoop cuando todavía no existía el menú actual de nubes y object stores. HDFS se volvió, durante más de una década, el disco del Big Data on-premise. Hoy convive con S3 y compañía, pero el modelo mental —archivo partido, réplicas, metadatos centralizados, localidad— sigue siendo el que necesitas para entender Spark, Hive y cualquier data lake que haya nacido en este ecosistema.
¿Para qué sirve conocer el linaje? Para leer HDFS como una respuesta a un paper, no como una lista de comandos. Cada principio de diseño de la siguiente sección es una frase que GFS ya había defendido en 2003.
Principios de diseño
HDFS no intenta ser un FS generalista. Declara, de entrada, para qué no está hecho, y eso lo hace bueno en lo suyo.
Archivos muy grandes. Hablamos de gigabytes a terabytes por archivo (o de muchos archivos grandes). El sistema está calibrado para pocos metadatos y mucho contenido. Un millón de archivos de 10 KB es un anti-patrón; cien archivos de 10 GB es el terreno nativo.
Write-once, read-many. El patrón write-once, read-many significa: escribes el archivo (o agregas datos al final, en versiones modernas), lo cierras y luego lo lees muchas veces. No hay edición aleatoria en el centro del archivo, como harías en un documento de Word. Los data lakes encajan aquí: un volcado diario, un log, una tabla particionada o un archivo Parquet generado por un trabajo. Una vez materializado, se lee en lote.
Hardware commodity. Servidores x86, discos SATA, Ethernet. Nada de SAN exótica como requisito. El software, no el hardware especial, pone la tolerancia a fallos.
La falla es la norma, no la excepción. Con miles de discos, la probabilidad de que algo esté roto tiende a 1. HDFS no “espera que no falle”: detecta el nodo muerto y re-replica (vuelve a copiar los bloques que quedaron por debajo del factor de replicación) de forma automática.
Throughput de lote por encima de latencia. HDFS prefiere empujar cientos de MB/s en una lectura secuencial larga. No está diseñado para devolver 1 KB en 2 milisegundos. Si tu caso es un API de usuario final, este no es tu almacén.
¿Cuándo usar estos principios como filtro? Antes de desplegar Hadoop. Si tus archivos son enormes, se escriben por lotes y se leen enteros o por grandes rangos, HDFS —o un almacén de objetos con el mismo patrón— es una opción adecuada. Si necesitas actualizar filas, baja latencia o millones de archivos pequeños, necesitas otra tecnología.
Arquitectura y componentes
HDFS separa la coordinación de los metadatos del almacenamiento de los bloques. El NameNode administra el espacio de nombres y el mapa lógico del sistema; los DataNodes conservan y sirven los datos.
El NameNode
El NameNode coordina el sistema. Mantiene en memoria el espacio de nombres (namespace), el árbol de directorios, los permisos y la relación entre archivos y bloques. Los cambios del espacio de nombres se persisten mediante FsImage y EditLog. Las ubicaciones actuales de las réplicas se reconstruyen a partir de los reportes enviados por los DataNodes.
El NameNode no sirve los bytes del archivo. Si lo hiciera, sería un cuello de botella y un punto único de transferencia. Solo responde: “tu archivo está en los bloques B1, B2, B3; B1 está en los nodos 4, 9 y 12”.
Los DataNodes
Un DataNode es el proceso de almacenamiento que normalmente se ejecuta en cada nodo del clúster. Recibe bloques, los guarda sobre el sistema de archivos local, atiende solicitudes de lectura y escritura y reporta su estado al NameNode. El contenido de los archivos vive aquí, distribuido y replicado entre varios DataNodes.
El bloque
Un bloque es la unidad lógica de partición y replicación de HDFS. Salvo el último, cada bloque puede alcanzar el tamaño configurado. Un archivo de 300 MB, con bloques de 128 MB, se representa mediante tres bloques: 128 + 128 + 44 MB. Cada uno se replica de manera independiente, por lo que un archivo puede estar distribuido entre varias máquinas sin que el usuario deba dividirlo manualmente.
El bloque grande (muy por encima de los 4 KB de un FS local) no es casualidad: menos metadatos en el NameNode, menos seeks, y un tamaño que tiene sentido mover o procesar como unidad de un map task.
Secondary NameNode y alta disponibilidad
El Secondary NameNode es una de las trampas de nombres más famosas de Hadoop. No es un NameNode de respaldo en caliente. Es un ayudante que, periódicamente, fusiona FsImage y EditLog para que el log no crezca sin límite y para que un reinicio del NameNode no tarde una eternidad aplicando ediciones. Si el NameNode muere en un clúster antiguo sin HA, el Secondary no toma el relevo mágicamente.
La alta disponibilidad (High Availability, HA) utiliza NameNodes redundantes: uno Active y al menos uno Standby. Con Quorum Journal Manager, comparten las ediciones mediante JournalNodes. En el failover automático, ZooKeeper y el ZKFailoverController participan en la detección y elección del activo; mecanismos de fencing independientes impiden que el NameNode anterior continúe prestando servicio de forma incorrecta.
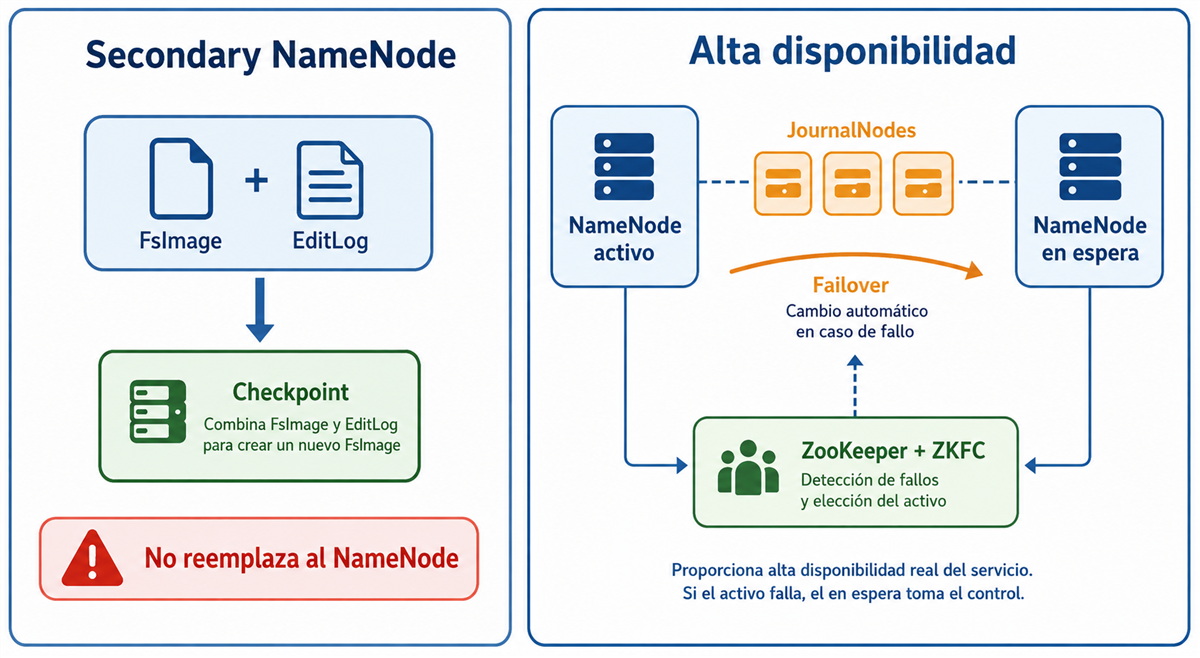
Figura 3. El Secondary NameNode crea puntos de control; la alta disponibilidad sí mantiene un NameNode en espera capaz de asumir el servicio.
Un archivo, sus bloques y sus réplicas
Imagina el archivo /logs/app.log partido en tres bloques (B1, B2, B3), con factor de replicación 3. El NameNode conoce el mapa; los DataNodes tienen los bytes.
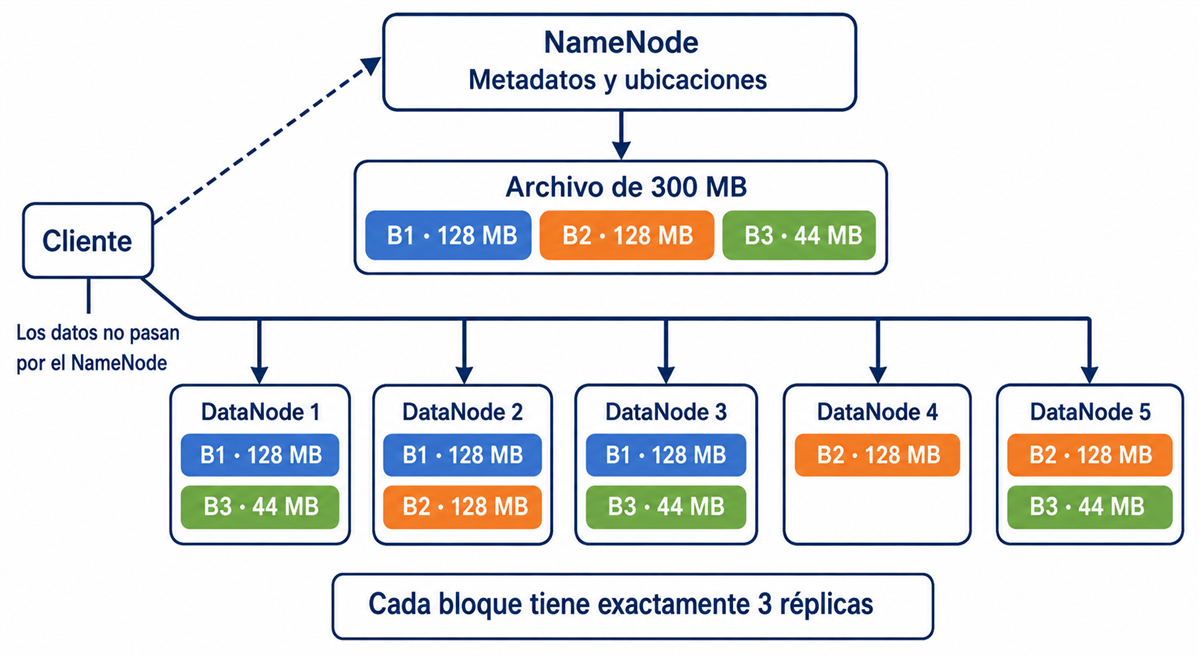
Figura 4. Un archivo de 300 MB se divide en tres bloques. Cada bloque conserva tres réplicas distribuidas entre los DataNodes.
Observa dos decisiones de arquitectura en el dibujo: (1) el tráfico de datos no pasa por el NameNode; (2) ningún DataNode tiene el archivo completo por obligación, y ningún bloque vive en un solo sitio.
¿Para qué sirve esta arquitectura? Para separar “saber dónde está” (NameNode: metadatos, poco volumen y función crítica) de “guardar y servir bytes” (DataNodes: gran volumen y reemplazo individual). Por eso la coordinación requiere protección especial, mientras que la capa de datos está diseñada para tolerar la pérdida de nodos.
Cómo funciona por dentro
Tamaño de bloque y factor de replicación
El tamaño de bloque por defecto en HDFS moderno (Hadoop 2.x en adelante, y Hadoop 3) es 128 MB. Se configura con dfs.blocksize. Un bloque grande reduce la presión de metadatos y encaja con tareas de procesamiento que leen secuencialmente.
El factor de replicación por defecto es 3: cada bloque se guarda en tres DataNodes. Se configura con dfs.replication, para todo el clúster o para archivos concretos. El valor tres equilibra durabilidad y costo: después de perder una réplica quedan dos copias disponibles mientras HDFS recupera el nivel configurado. Un factor de dos también puede soportar la pérdida de una copia, pero deja una sola durante la recuperación y ofrece menos opciones para distribuir las réplicas entre racks.
Rack awareness
Un rack es un armario de servidores que comparte switch, alimentación o ambos. Si las tres réplicas de un bloque viven en el mismo rack y se cae el switch, pierdes las tres a la vez.
Rack awareness (“conciencia de rack”) es la política por la que HDFS coloca las réplicas sabiendo la topología. La regla clásica de Hadoop para tres réplicas es:
- Primera réplica: en el nodo del escritor (o en uno cercano), si el cliente corre dentro del clúster.
- Segunda réplica: en un rack distinto.
- Tercera réplica: en otro nodo del mismo rack que la segunda.
Así, un fallo de máquina no te deja sin copias; un fallo de rack tampoco (sigue viva la primera). Y la escritura no cruza el backbone del datacenter tres veces: solo una de las copias iniciales viaja a otro rack, y la tercera se copia dentro de ese rack.
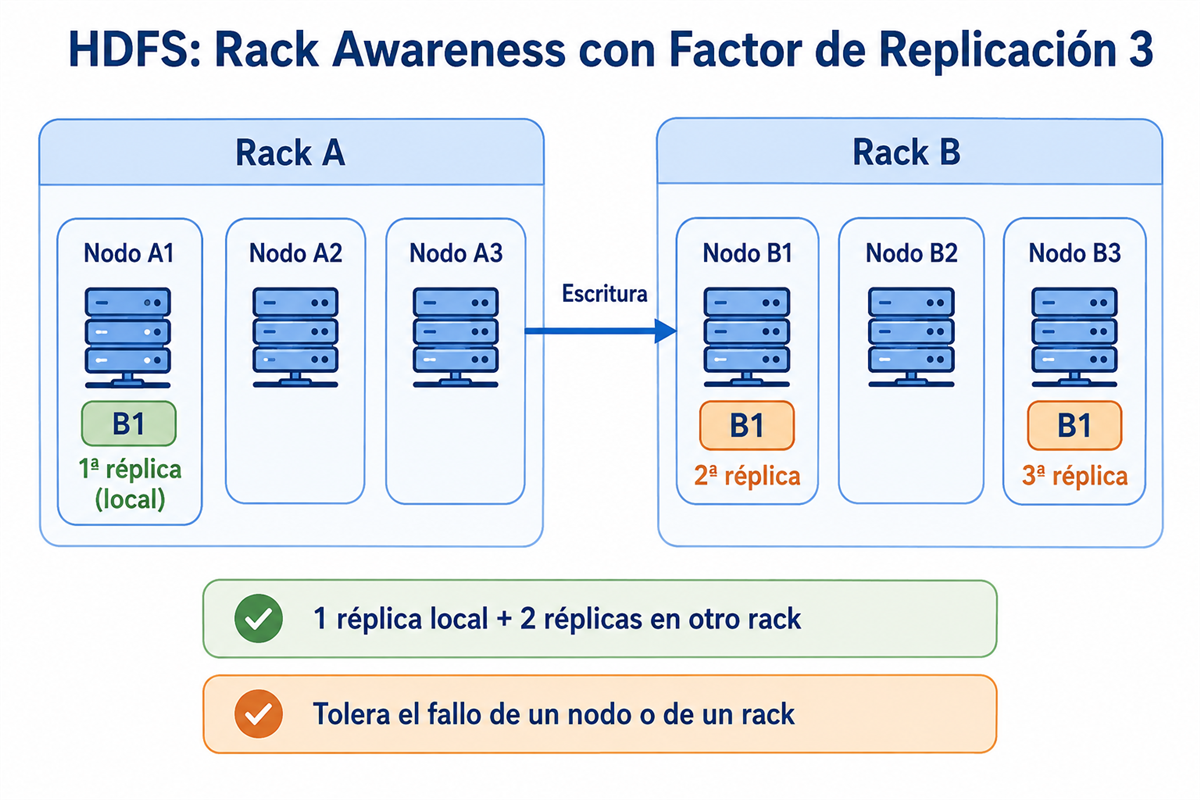
Figura 5. Con tres réplicas, HDFS combina tolerancia a la pérdida de un nodo con protección frente a la caída completa de un rack.
¿Para qué sirve el rack awareness? Para que “replicación 3” no sea “tres discos en el mismo armario”. Sin topología, la réplica te da falsa seguridad.
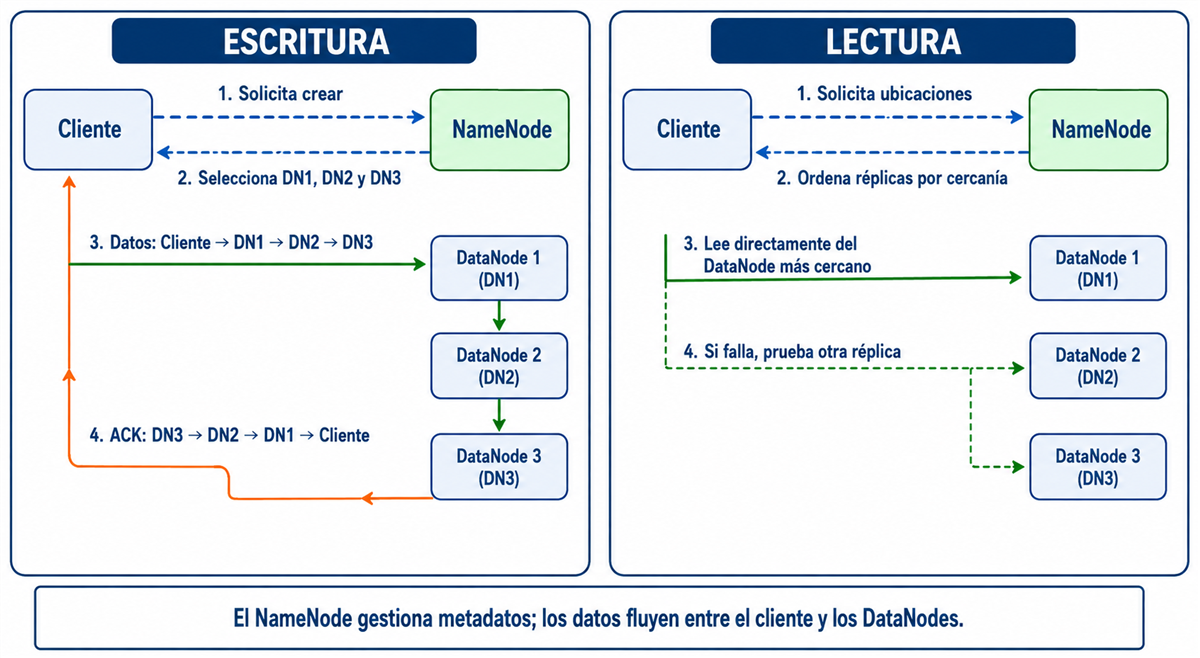
Figura 6. En la escritura, los datos recorren un pipeline de DataNodes; en la lectura, el cliente obtiene las ubicaciones y se conecta directamente con la réplica más conveniente.
Flujo de escritura
Cuando un cliente crea un archivo (por ejemplo, sube un log), la secuencia conceptual es esta:
- El cliente pide al NameNode crear el archivo en el namespace. El NameNode valida permisos y que el nombre no exista.
- Cuando necesita comenzar un bloque, el cliente solicita al NameNode su asignación y los DataNodes de destino. Organiza los datos en paquetes; no necesita acumular un bloque completo para empezar a transmitir.
- El NameNode selecciona los destinos según el factor de replicación y la política de colocación. En este ejemplo, el objetivo son tres réplicas.
- El cliente abre un pipeline: envía paquetes al primer DataNode; este los reenvía al segundo y el segundo al tercero, mientras continúa llegando contenido del archivo.
- Los ACK (confirmaciones) regresan por el pipeline en sentido inverso. El cliente conserva los paquetes pendientes de confirmación. Si falla un DataNode, intenta recuperar el pipeline, excluir el nodo fallido y reenviar los paquetes pendientes; no reinicia necesariamente todo el bloque. La incorporación de un reemplazo depende de la política y de los nodos disponibles. Si la recuperación no es posible, la escritura falla.
- Al completar un bloque, el cliente pasa al siguiente y repite el proceso de asignación y transferencia.
- Al cerrar el archivo, el cliente espera las confirmaciones pendientes y solicita al NameNode completar la operación. El nombre ya existía durante la escritura; el cierre finaliza el archivo bajo las condiciones de finalización y replicación mínima del sistema. HDFS puede recuperar después las réplicas que falten para alcanzar el factor objetivo.
Por eso HDFS tiene un costo desproporcionado para archivos pequeños y funciona mejor con archivos grandes: el protocolo está pensado para durabilidad y transferencia sostenida, no para operaciones diminutas e interactivas.
Flujo de lectura
La lectura es más directa, y es donde brilla la localidad:
- El cliente pregunta al NameNode por
/logs/app.log. - El NameNode responde con la lista de bloques y, para cada bloque, los DataNodes que tienen réplica, ordenados por cercanía al lector (el mismo nodo primero, luego el mismo rack, luego el resto).
- El cliente abre una conexión directa con el DataNode más cercano y lee el bloque. Si esa réplica falla, prueba la siguiente.
- Concatenando bloques en orden, reconstruye el archivo.
Ni el NameNode ni un “proxy” central bombean los terabytes. El ancho de banda de lectura escala con el número de discos.
Heartbeats y re-replicación
Un heartbeat (latido) es un mensaje periódico que el DataNode envía al NameNode para decir “sigo vivo, con esta capacidad libre”. Por defecto, aproximadamente cada 3 segundos. Además, el DataNode manda de vez en cuando un block report: la lista de bloques que realmente tiene en disco.
Si el NameNode deja de recibir latidos durante el intervalo de detección configurado, marca el DataNode como no disponible. Este tiempo no debe tratarse como una constante universal: depende de los parámetros y de la versión del clúster. Los bloques alojados allí quedan por debajo de su nivel esperado y el NameNode programa la re-replicación desde las copias que siguen disponibles.
Eso es “la falla como norma” en operación, no en un eslogan: nadie restaura cintas a las 3 a.m. para un disco. El sistema se repara solo, a costa de capacidad y de red mientras copia.
¿Para qué sirve conocer estos flujos? Para diagnosticar. Un NameNode saturado de archivos pequeños es un problema de metadatos. Un job lento “sin localidad” es un problema de dónde cayeron los bloques. Un DataNode que desaparece y un pico de red después es, muchas veces, re-replicación haciendo su trabajo.
Tecnología y modelo: Java, Linux, YARN
HDFS está implementado en Java. Por eso el dimensionamiento de la JVM y de la memoria del NameNode es importante: más archivos y bloques implican más metadatos en memoria. En producción suele ejecutarse sobre Linux, aprovechando discos locales y la red del clúster. Los contenedores pueden empaquetar algunos servicios o entornos de práctica, pero no cambian la función de la capa persistente: HDFS o un almacenamiento de objetos.
HDFS es la capa de almacenamiento y funciona independientemente de YARN. Puedes leer y escribir archivos mediante sus clientes sin lanzar un trabajo de procesamiento. YARN (Yet Another Resource Negotiator) administra recursos para las aplicaciones que se ejecutan sobre él. En ese modo de despliegue, motores como MapReduce o Spark solicitan recursos a YARN y acceden a HDFS. Spark también puede utilizar otros gestores, como Kubernetes o su modo standalone.
El reparto de papeles, en una frase cada uno:
- HDFS: dónde están los bytes y cómo sobreviven a un disco muerto.
- YARN: quién corre, en qué nodo y con cuánta memoria.
- MapReduce / Spark: qué cálculo se hace sobre esos bytes.
El cliente de HDFS (un proceso Java, un hdfs dfs, un executor de Spark) usa la misma abstracción FileSystem: rutas hdfs://namenode:8020/ruta. Esa abstracción es la que luego permite, con otro conector, hablar s3a:// sin reescribir el job.
Este mapa conserva la distinción del capítulo anterior: Apache Hadoop reúne Hadoop Common, HDFS, YARN y MapReduce; el ecosistema Hadoop incluye además proyectos relacionados como Hive, HBase y Spark. Al diseñar una plataforma, identifica por separado el almacenamiento, la gestión de recursos y el motor de procesamiento.
Interfaz y modo de uso (ilustrativo, no un laboratorio)
Lo que sigue no es una guía para instalar ni para ejecutar en tu máquina. Es cómo luce el contrato de HDFS cuando ya tienes un clúster: la misma idea de ls, cp y cat de Linux, apuntando a un árbol distribuido. Docker, contenedores y comandos en vivo van en Laboratorio: HDFS con Docker, desde la instalación hasta las réplicas.
Los comandos hdfs dfs y hadoop fs permiten utilizar la shell de sistemas de archivos de Hadoop; ambos siguen vigentes. Aquí usamos hdfs dfs y suponemos que el sistema de archivos predeterminado está configurado como HDFS. Bajo esa configuración, / es la raíz del namespace de HDFS, no la raíz de Linux del nodo donde estás trabajando.
Listar el raíz del clúster:
hdfs dfs -ls /Una salida típica se parece a la de ls -l: permisos, usuario, tamaño, fecha y ruta. Verías directorios como /user, /tmp o /warehouse, según cómo esté organizado el data lake.
Subir un archivo local al FS distribuido (-put) y traerlo de vuelta (-get):
hdfs dfs -put datos.csv /user/wilder/datos.csv
hdfs dfs -get /user/wilder/datos.csv datos_local.csv
Leer el contenido (solo es razonable para archivos pequeños que tengan sentido en pantalla):
hdfs dfs -cat /user/wilder/datos.csvOtros verbos que verás en cualquier cheatsheet —siempre como modelo, no como receta de instalación—: -mkdir, -rm, -rm -r, -du -h, -stat para inspeccionar réplicas y tamaño de bloque.
Además de la CLI:
- Web UI del NameNode. En Hadoop 3 suele exponerse en el puerto 9870 (en Hadoop 2 era el 50070). Desde el navegador ves el estado del FS, DataNodes vivos, capacidad, y puedes explorar el directorio. Es el “tablero” de metadatos, no un explorador de bytes a escala.
- APIs. Java
org.apache.hadoop.fs.FileSystem, WebHDFS/HttpFS (HTTP), libhdfs para C, y clientes en Python (pyarrow.fs, entre otros). Spark y Hive no “inventan” un protocolo: usan estas APIs.
La analogía útil: hdfs dfs -ls / es a HDFS lo que ls / es a ext4. Misma intención (nombrar y listar); distinta implementación (un NameNode y un ejército de DataNodes detrás).
¿Para qué sirve ver la interfaz así? Para anclar el modelo: tú hablas en rutas y archivos; el sistema traduce a bloques y nodos. Cuando en Laboratorio: HDFS con Docker, desde la instalación hasta las réplicas ejecutes estos comandos de verdad, ya sabrás qué pregunta le estás haciendo al clúster.
Cómo se ve el portal de HDFS
Las siguientes capturas proceden de la documentación de Arenadata sobre las interfaces de HDFS. Muestran un entorno de ejemplo con Hadoop 3.1.2, no el clúster de este libro. La apariencia y las opciones pueden variar según la versión y la distribución.
Vista general del NameNode: Overview
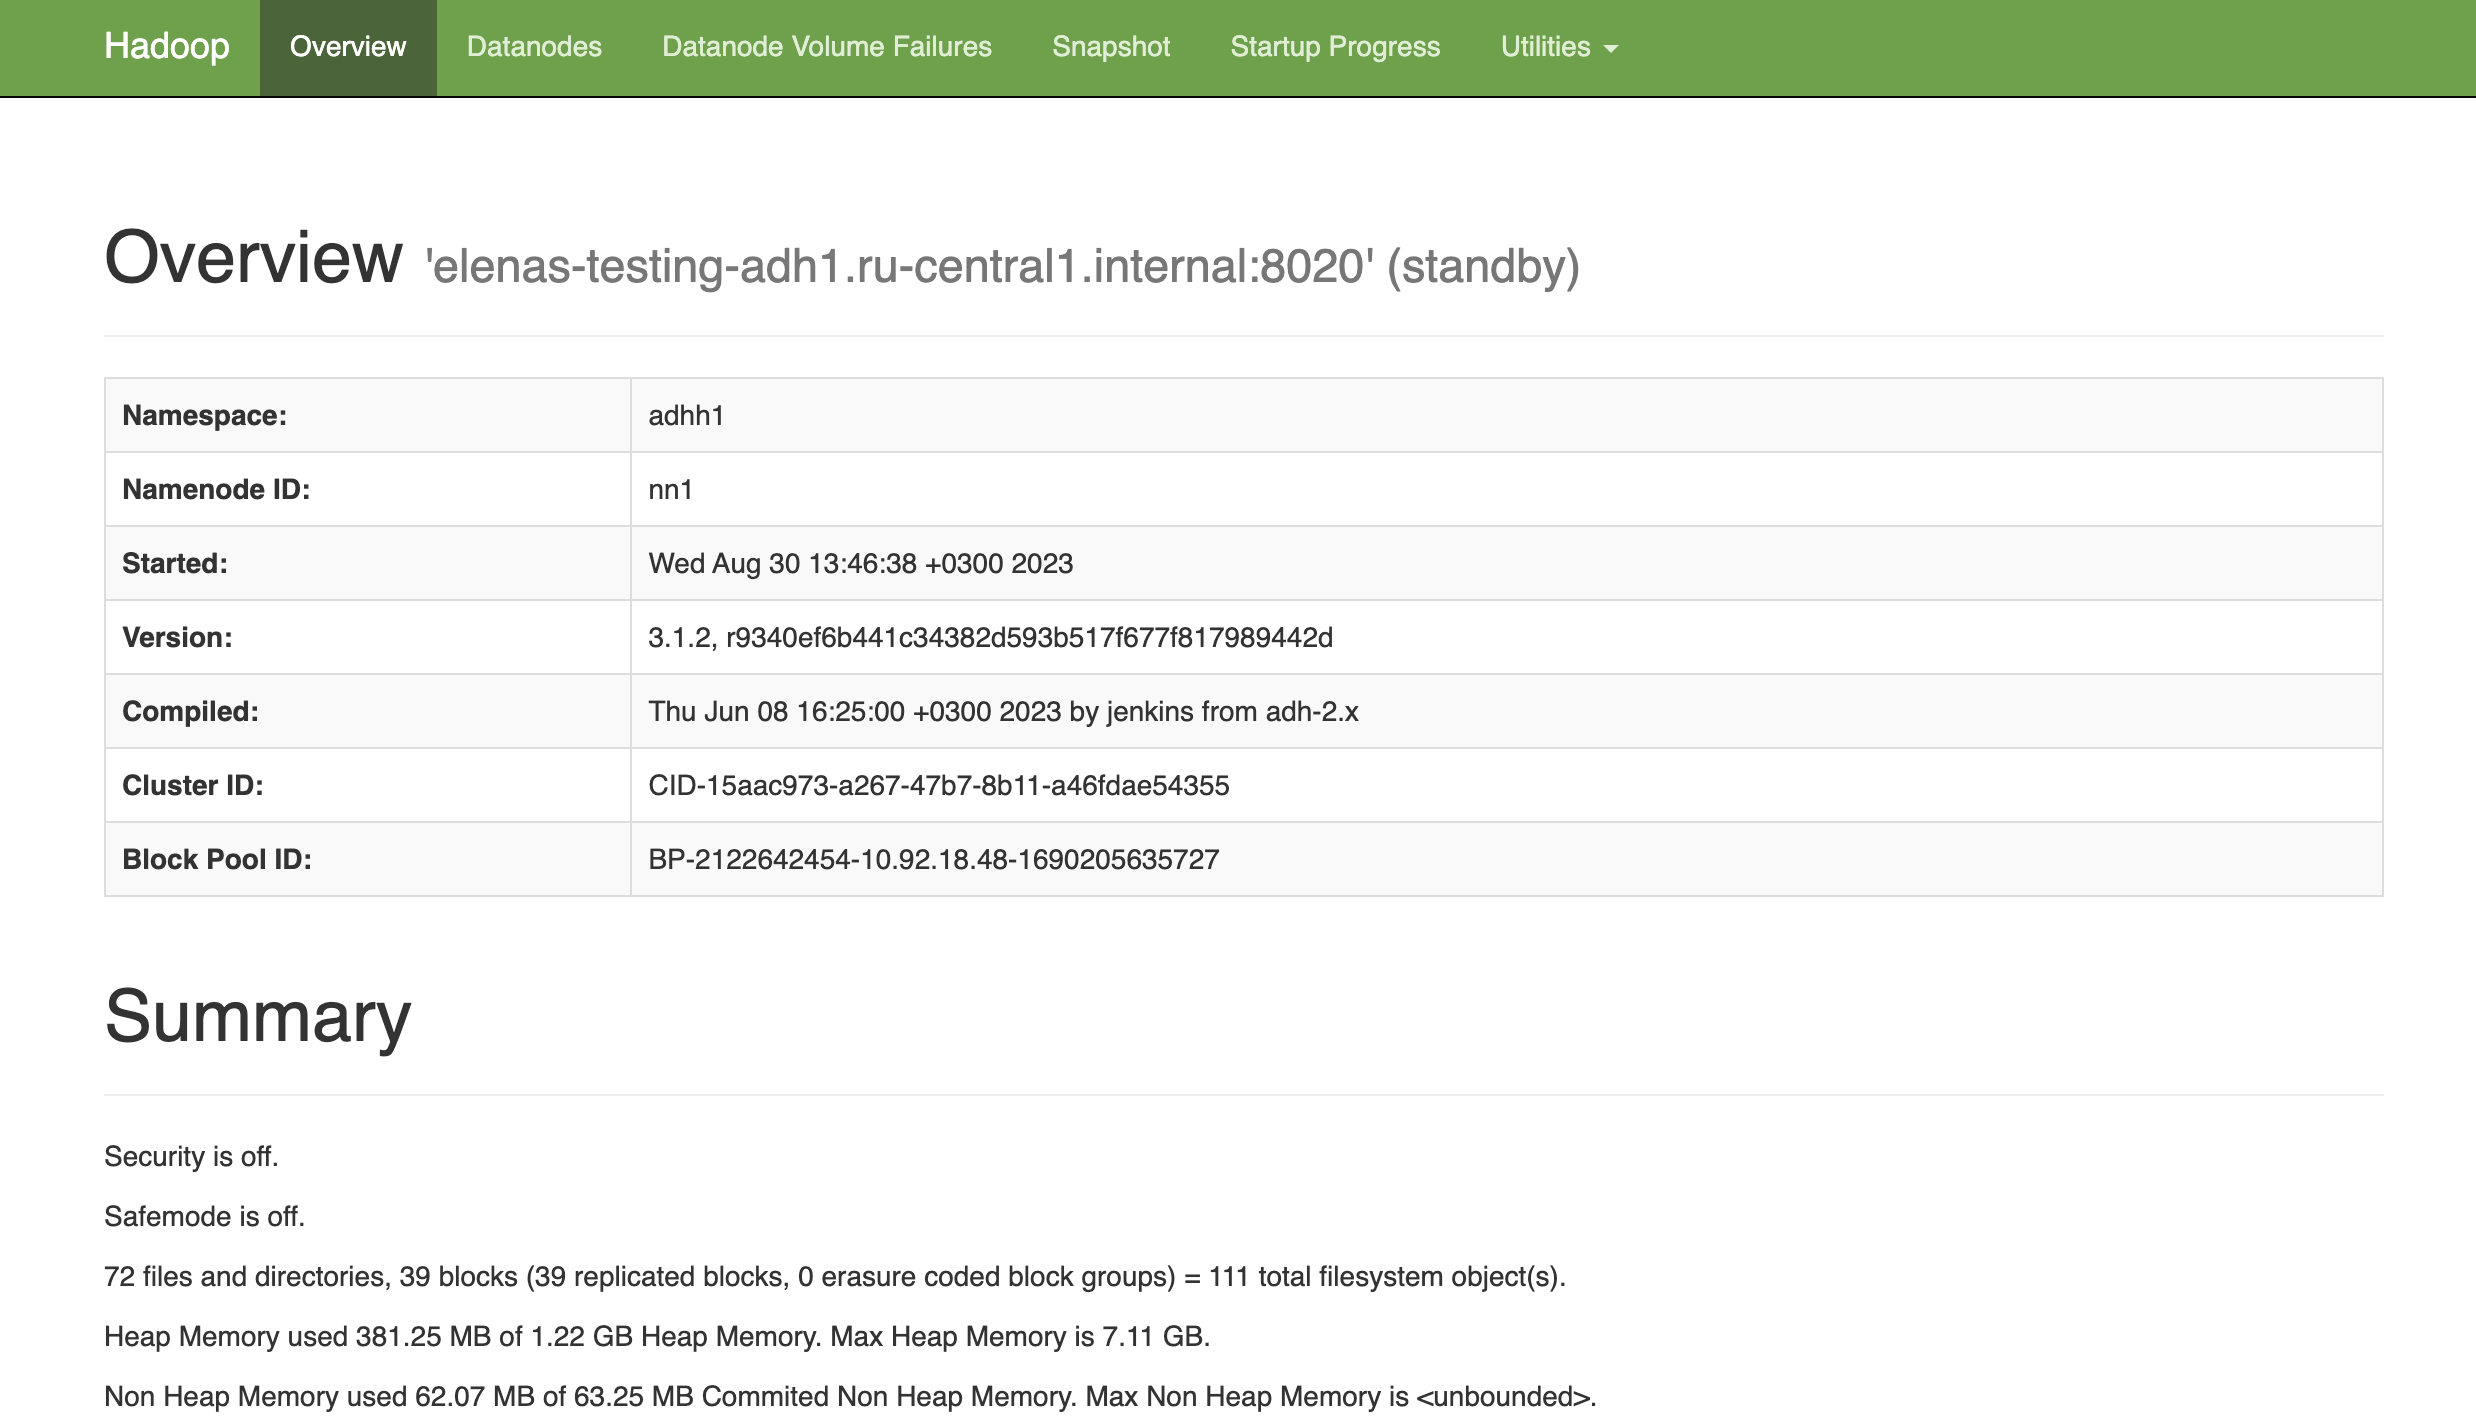
Captura A. Identificación del NameNode y resumen del sistema. Fuente: Arenadata, HDFS web interfaces.
El encabezado muestra standby: este NameNode está en espera dentro de una configuración de alta disponibilidad. En Summary aparecen cantidades de archivos, directorios y bloques, además del uso de memoria. El puerto 8020 del encabezado identifica el servicio RPC; no es el puerto HTTP usado para abrir el portal.
Estado de los nodos: Datanodes
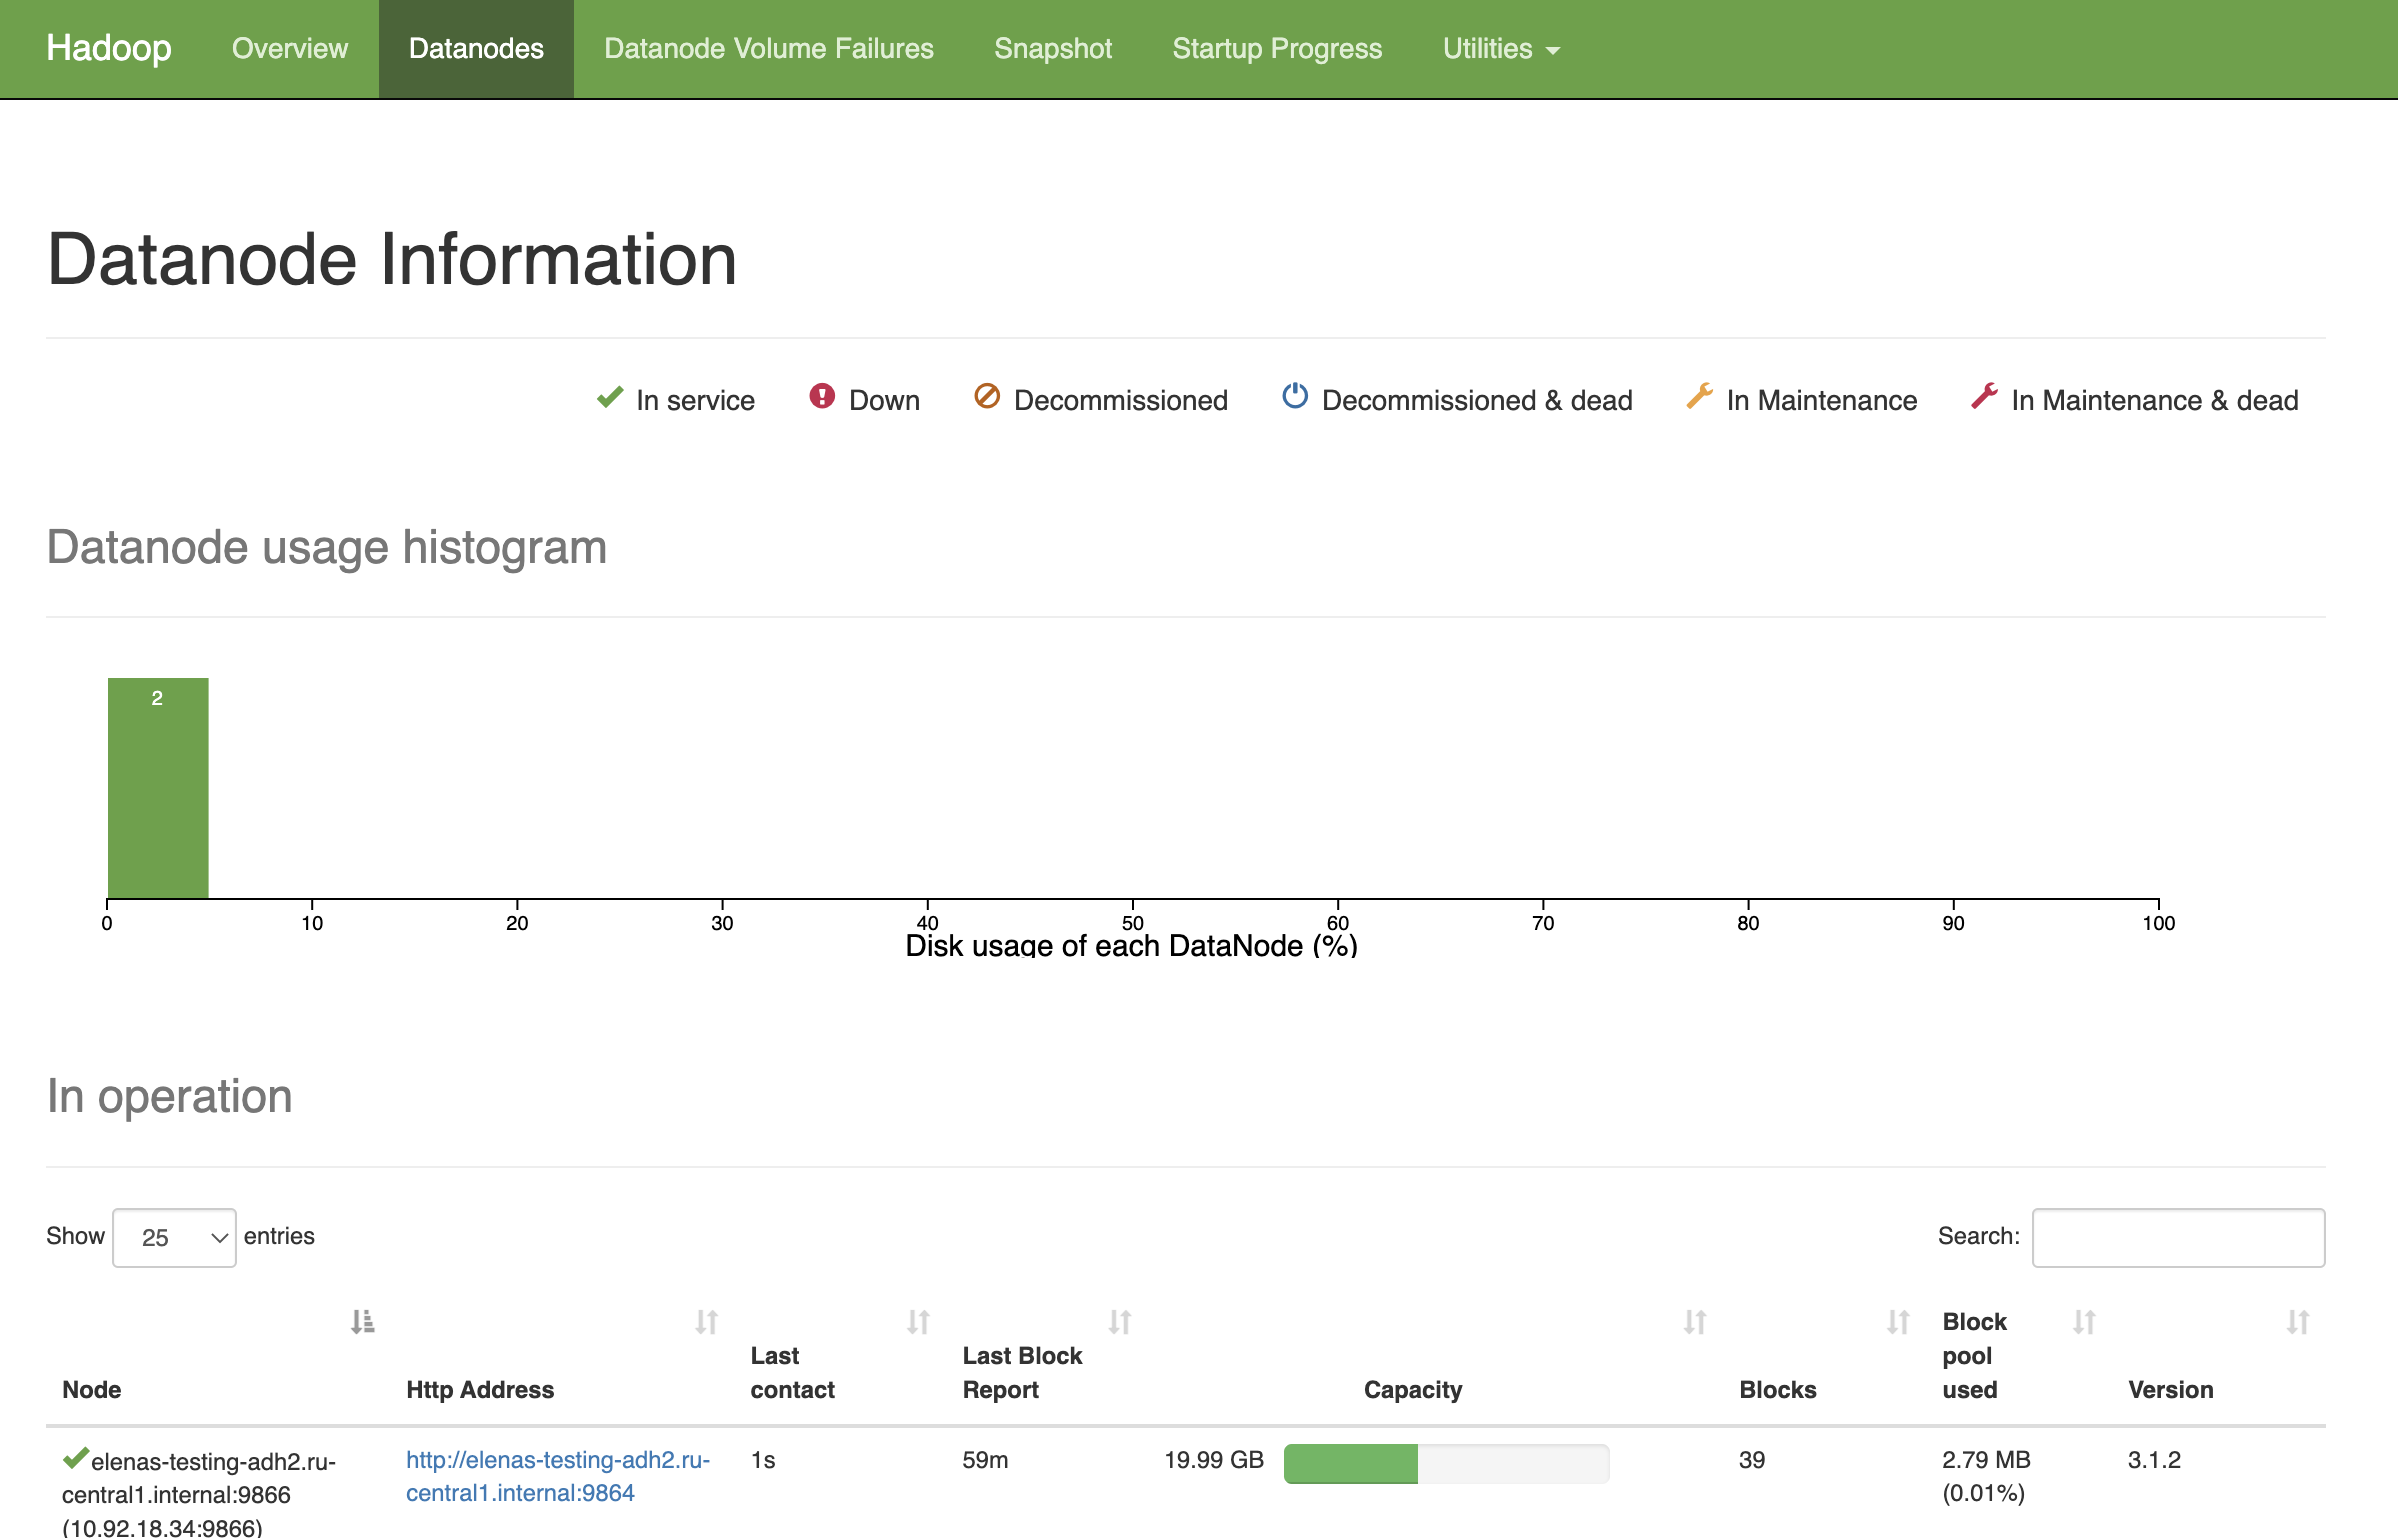
Captura B. Histograma de uso de disco y tabla de DataNodes. Fuente: Arenadata, HDFS web interfaces.
Esta vista permite relacionar la capacidad y los bloques con cada nodo. Last contact y Last Block Report corresponden a comunicaciones diferentes: el contacto reciente y el último reporte de bloques.
Archivos y directorios: Browse Directory
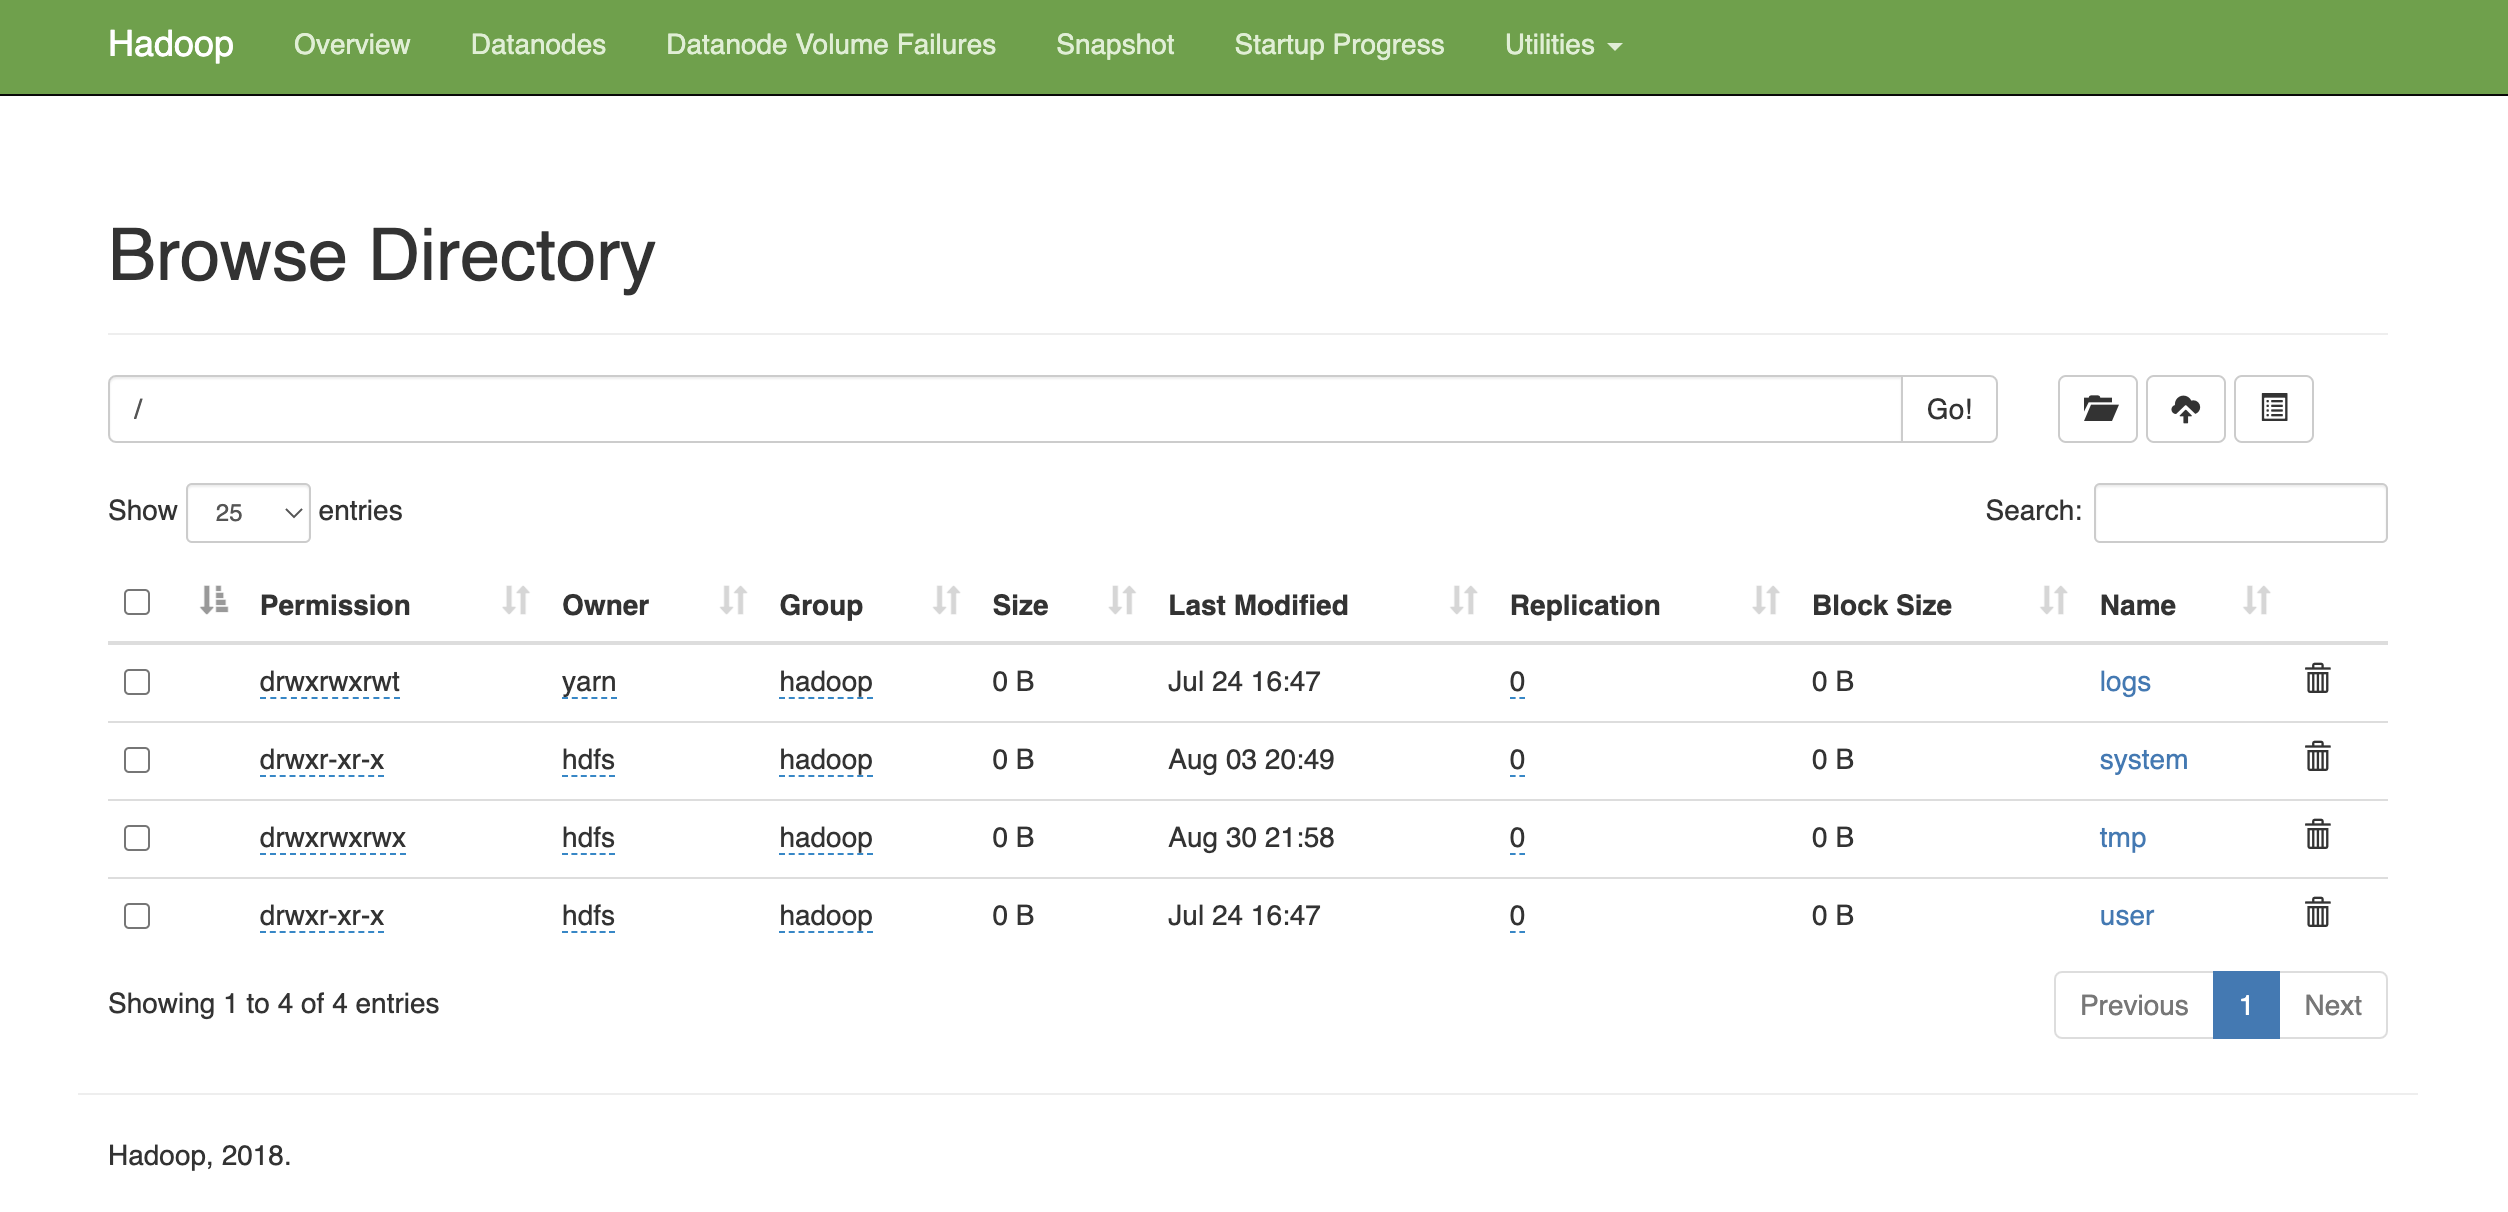
Captura C. Explorador del namespace de HDFS. Fuente: Arenadata, HDFS web interfaces.
Aquí se ve la raíz de HDFS. Las filas mostradas son directorios; los ceros en Replication y Block Size no indican archivos sin protección. Al explorar archivos, esas columnas permiten consultar sus atributos.
Usos, límites y cuándo no usar HDFS
HDFS es una herramienta excelente en un recuadro estrecho y una herramienta mediocre fuera de él. El criterio profesional es saber decir que no.
Úsalo cuando:
- Los archivos son grandes (cientos de MB o más) o se pueden compactar en pocos archivos grandes (Parquet, ORC, SequenceFile).
- El patrón es lote: ETL nocturno, reentrenamiento, agregaciones Hive/Spark, archivos de log rotados.
- Operas (o heredas) un clúster on-premise donde los discos locales son el data lake y quieres localidad.
- Necesitas un árbol de directorios con permisos estilo Hadoop y un ecosistema que ya habla
hdfs://.
No lo uses cuando:
- Tienes muchos archivos pequeños. Cada archivo y cada bloque agregan objetos de metadatos en la memoria del NameNode. Millones de archivos diminutos pueden agotar esa memoria mucho antes que los discos. Es el small files problem; la solución habitual es compactar o combinar datos en formatos adecuados, no escalar indefinidamente el NameNode.
- Necesitas baja latencia (una consulta de 10 ms para una app). HDFS está pensado para throughput. HBase nació, en parte, para poner acceso aleatorio encima de HDFS, no para convertir a HDFS en una base de datos.
- Necesitas edición aleatoria en el medio del archivo. El modelo es write-once (con append). Un FS POSIX de red o una base de datos son la respuesta honesta.
- Estás nativo en la nube y no quieres administrar NameNodes, discos y re-replicación. Ahí el almacenamiento de objetos —Amazon S3, GCS, Azure Data Lake Storage— es la alternativa moderna: capacidad elástica, durabilidad a cargo del proveedor, pago por uso, y conectores (
s3a://) que Spark ya da por sentados.
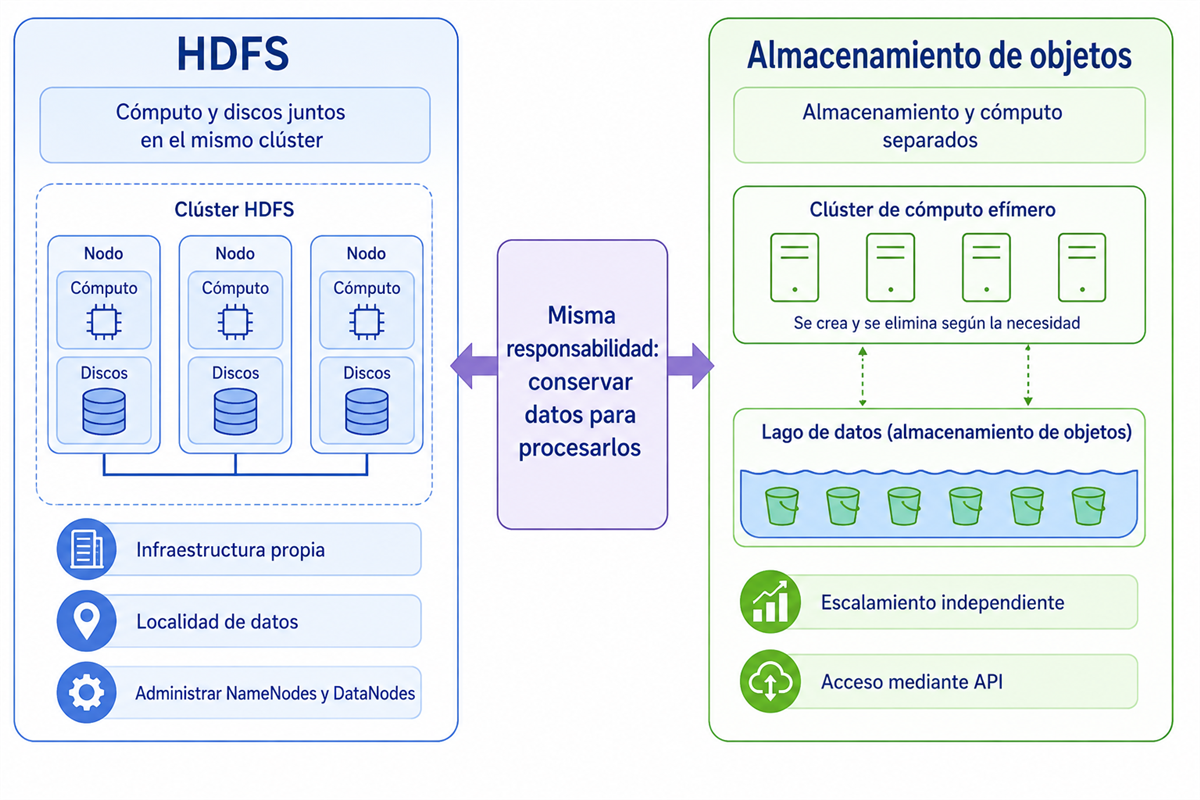
Figura 7. HDFS acopla almacenamiento y cómputo para aprovechar la localidad; un almacén de objetos permite que ambos escalen y evolucionen por separado.
HDFS frente a S3, en corto: HDFS ofrece un espacio de nombres jerárquico y semántica propia de Hadoop —no compatibilidad POSIX completa—, además de localidad cuando el cómputo comparte los nodos de datos. S3 desacopla el cómputo del almacenamiento, elimina la operación del NameNode y aplica un modelo de costos basado en capacidad y solicitudes. Por eso el almacenamiento de objetos es habitual en arquitecturas de nube, mientras HDFS conserva valor en plataformas sobre infraestructura propia.
¿Cuándo usar S3 (o equivalente) en lugar de HDFS? Cuando el clúster de cómputo puede ser efímero —lo levantas con Docker o con un servicio gestionado, procesas, lo apagas— y los datos deben sobrevivir fuera de esas máquinas. Eso es exactamente el giro que la nube le dio al “llevar el cómputo a los datos”: a veces el dato vive en un objeto y el cómputo se acerca por la red del proveedor, no por el disco local.
Puente al siguiente tema: del disco al cómputo
HDFS responde dónde se guardan los datos. No responde quién los procesa. Esa es la siguiente pieza del libro.
En MapReduce sobre YARN, la aplicación aprovecha las ubicaciones de los datos de entrada para solicitar recursos cerca de sus réplicas. La colocación final depende también de la disponibilidad de recursos. Spark utiliza ubicaciones preferidas para sus particiones cuando la fuente las proporciona y puede conservar datos en memoria si la aplicación lo solicita. HDFS sigue prestando el servicio de archivos independientemente del gestor que utilice el motor.
El recorrido conecta Fundamentos y Linux con el mapa de Ecosistema Hadoop y la arquitectura de HDFS. Antes de pasar a YARN, la gestión de recursos, el laboratorio siguiente pone en marcha un HDFS real con Docker. Después estudiaremos MapReduce y Spark como motores de procesamiento.
HDFS aporta persistencia y acceso distribuido a los archivos. Los motores aportan el cálculo y pueden conectarse a distintas fuentes. Entender esa separación permite cambiar una parte de la plataforma sin confundirla con el conjunto.
Comprueba el modelo: bloques, réplicas y capacidad
Ejercicio breve
Supón un archivo de 300 MiB, bloques de 128 MiB y factor de replicación 3, ya alcanzado. MiB significa 1 048 576 bytes; el valor habitual de dfs.blocksize, 134 217 728 bytes, equivale a 128 MiB, aunque suele escribirse informalmente como «128 MB».
- ¿Cuántos bloques lógicos tiene el archivo y cuánto mide cada uno?
- ¿Cuántas réplicas de bloque existen en total y cuánto contenido ocupan entre todos los DataNodes?
- Si el clúster dispone de 12 TiB de capacidad bruta destinada a HDFS, ¿qué capacidad lógica máxima teórica queda con replicación 3?
Para este cálculo, ignora checksums, metadatos, espacio reservado y otros gastos de almacenamiento. Supón replicación convencional, sin codificación de borrado.
Solución razonada
| Pregunta | Resultado | Razonamiento |
|---|---|---|
| Bloques lógicos | 3: 128 + 128 + 44 MiB | El último bloque contiene solo el resto del archivo. |
| Réplicas y contenido almacenado | 9 réplicas; 900 MiB de contenido | Cada uno de los tres bloques tiene tres copias: 300 × 3 = 900 MiB. El último bloque no reserva 128 MiB completos de contenido por copia. |
| Capacidad lógica teórica | 4 TiB | 12 TiB ÷ 3. La capacidad operativa debe ser menor para dejar margen de recuperación y crecimiento. |
La replicación multiplica el contenido almacenado, pero no crea tres archivos visibles para el usuario. Si falla un DataNode, las copias restantes permiten recuperar las réplicas perdidas siempre que existan recursos y destinos adecuados. Tener espacio libre forma parte de esa capacidad de recuperación.
Tres preguntas de comprensión
Intenta responder antes de leer las orientaciones:
- Los DataNodes conservan todas las réplicas, pero el NameNode deja de funcionar en un clúster sin HA. ¿Basta con tener los bloques para que los clientes sigan abriendo archivos normalmente?
- ¿Puede una aplicación leer un archivo de HDFS sin ejecutar un trabajo en YARN?
- Una plataforma necesita conservar sus datos mientras crea y elimina clústeres de cómputo. ¿Qué ventaja ofrece separar el almacenamiento de objetos del procesamiento?
Orientaciones para contrastar tus respuestas
- No. Conservar los bytes no garantiza la disponibilidad del servicio de metadatos. Las nuevas aperturas que requieren al NameNode quedan afectadas; por eso HA protege una responsabilidad distinta de la replicación de bloques.
- Sí. Un cliente HDFS puede leer directamente. YARN administra recursos de las aplicaciones desplegadas sobre él; no es un requisito para que HDFS atienda archivos.
- Los datos sobreviven al ciclo de vida del cómputo. El procesamiento puede escalar o desaparecer sin retirar el almacén persistente; a cambio, el acceso depende de la red y de una organización eficiente de los datos.
Referencias para profundizar
- Apache Hadoop, HDFS Architecture.
- Apache Hadoop, HDFS High Availability Using the Quorum Journal Manager.
- Apache Hadoop, HDFS Block Placement Policies.
- Apache Hadoop, File System Shell.
- IETF, NFSv4.1: acceso paralelo mediante pNFS.
- Sanjay Ghemawat, Howard Gobioff y Shun-Tak Leung, The Google File System.
Resumen
En este capítulo aprendiste:
- Qué problema resuelve un sistema de archivos —nombrado, jerarquía, metadatos, permisos, espacio— y por qué HDFS es esa misma idea extendida a un clúster.
- La diferencia entre una interfaz de archivos remotos como NFS y la distribución física de datos: NFS también puede apoyarse en almacenamiento en clúster.
- Por qué distribuir el almacenamiento ayuda a resolver problemas de volumen y tolerancia a fallos, y cómo HDFS aprovecha la localidad cuando comparte nodos con el cómputo.
- El linaje GFS 2003 → HDFS, y los principios: archivos grandes, write-once/read-many, falla como norma, throughput de lote.
- La arquitectura: NameNode (metadatos), DataNodes (bloques), bloque de 128 MB, replicación 3, rack awareness, Secondary versus HA de verdad.
- Cómo se escribe (pipeline de réplicas), cómo se lee (cliente directo al DataNode más cercano) y cómo se repara el clúster (heartbeats y re-replicación).
- El lugar de HDFS junto a Linux, Java y YARN, cómo luce la interfaz (
hdfs dfs, Web UI, APIs) y cuándo no usarlo (archivos pequeños, baja latencia, nube nativa con S3).
Ahora comprendes no solo “HDFS es el disco de Hadoop”, sino por qué está partido en bloques, por qué el NameNode no sirve los bytes, y por qué tres copias en racks distintos son una decisión de ingeniería y no un número mágico.
En el siguiente capítulo, Laboratorio: HDFS con Docker, pasarás del modelo a la práctica: levantarás un NameNode y tres DataNodes, cargarás archivos y verás en vivo sus bloques, sus réplicas y qué ocurre cuando un nodo se detiene. Después estudiaremos YARN: cómo asigna CPU y memoria a las aplicaciones.