8 Laboratorio: YARN con Docker, del ResourceManager a tu primer trabajo MapReduce
Este laboratorio es la continuación práctica del de HDFS con Docker. Sobre el mismo clúster (misma imagen apache/hadoop:3.4.1, mismos core-site.xml y hdfs-site.xml) añadimos la capa de recursos: un ResourceManager y varios NodeManagers. Con eso levantamos YARN, ejecutamos trabajos MapReduce reales y observamos en vivo cómo se reparten en contenedores entre los nodos, por consola y en la Web UI del ResourceManager.
Requisito: haber completado el laboratorio de HDFS. YARN no reemplaza a HDFS: lo necesita. MapReduce lee su entrada y escribe su salida en HDFS; YARN solo arbitra CPU y memoria. Por eso el clúster tendrá cuatro tipos de servicio corriendo a la vez: NameNode y DataNodes (almacenamiento) + ResourceManager y NodeManagers (recursos).
Convención de terminal: todos los comandos se ejecutan desde 🖥️ tu terminal del host, dentro de
~/hdfs-docker-lab, usandodocker compose exec <servicio> .... La Web UI se abre en el 🌐 navegador.
1. Punto de partida: el clúster HDFS arriba
Antes de tocar YARN, confirma que HDFS sigue operativo. Si el clúster está apagado, levántalo primero:
cd ~/hdfs-docker-lab
docker compose up -d
Espera unos segundos antes de consultar. El contenedor arranca de inmediato, pero el servicio del NameNode tarda un poco más en abrir su puerto RPC. Si consultas demasiado pronto verás Connection refused a namenode:9000 — no es un error, es que el servicio aún no está listo (recuerda: “Up” ≠ “listo”). Por eso esperamos:
sleep 20
docker compose exec namenode hdfs dfsadmin -report | grep -E "Live datanodes|Safe mode"
Salida esperada:
Live datanodes (3):Con los tres DataNodes vivos, la base de almacenamiento está lista y podemos montar YARN encima.
Nota sobre los datos: si en la sesión anterior apagaste con
docker compose down -v, los volúmenes se borraron y HDFS arranca vacío (reformateado). Es normal; los archivos de prueba se recrean en segundos.
2. Por qué YARN necesita a HDFS
Un trabajo MapReduce típico hace tres cosas: lee datos de HDFS, los procesa en tareas distribuidas y escribe el resultado en HDFS. YARN entra en el “procesa”: decide en qué nodo y con cuánta memoria/CPU corre cada tarea, y lanza esos procesos como contenedores dentro de los NodeManagers. Además, YARN usa HDFS para guardar archivos temporales del trabajo (el staging). Conclusión práctica: para este laboratorio, HDFS y YARN corren juntos.
Para que esa cooperación funcione, en los pasos 3 y 4 crearás dos archivos de configuración nuevos. Conviene entender qué hace cada uno antes de escribirlos:
yarn-site.xml — configura YARN, la capa de recursos. Le dice al clúster dónde vive el ResourceManager y cómo se comportan los NodeManagers. Sus parámetros más representativos son: yarn.resourcemanager.hostname (el nombre por el que los NodeManagers encuentran al maestro), yarn.nodemanager.aux-services (activa el servicio de shuffle que MapReduce necesita), yarn.nodemanager.resource.memory-mb y yarn.nodemanager.resource.cpu-vcores (cuánta memoria y CPU aporta cada nodo al clúster), yarn.scheduler.minimum-allocation-mb / yarn.scheduler.maximum-allocation-mb (el tamaño mínimo y máximo de un contenedor) y yarn.log-aggregation-enable (reúne los logs de todos los contenedores para poder consultarlos con yarn logs cuando el trabajo termina).
mapred-site.xml — configura MapReduce, el motor de procesamiento. Define cómo se ejecutan los trabajos MapReduce sobre el clúster. Su parámetro clave es mapreduce.framework.name: al ponerlo en yarn es, literalmente, lo que hace que MapReduce corra sobre YARN en lugar de en modo local. Los otros parámetros representativos son las variables de entorno yarn.app.mapreduce.am.env, mapreduce.map.env y mapreduce.reduce.env (indican a las tareas dónde está Hadoop mediante HADOOP_MAPRED_HOME), mapreduce.application.classpath (dónde encontrar los jars de MapReduce) y la memoria de cada pieza del trabajo (yarn.app.mapreduce.am.resource.mb para el ApplicationMaster, mapreduce.map.memory.mb y mapreduce.reduce.memory.mb para las tareas).
En resumen: yarn-site.xml gobierna la capa de recursos (YARN en sí) y mapred-site.xml gobierna cómo un trabajo MapReduce usa esa capa. Los dos primeros son los “sospechosos habituales” cuando un job de YARN no arranca, así que vale la pena conocerlos.
3. Configurar yarn-site.xml
Los tres archivos de los pasos 3, 4 y 5 (config/yarn-site.xml, config/mapred-site.xml y el compose.yaml completo, que reemplaza al del laboratorio de HDFS) están reunidos en yarn-lab-config.zip. Descárgalo y cópialo a ~/hdfs-docker-lab (desde WSL, la carpeta Descargas de Windows está en /mnt/c/Users/<tu-usuario>/Downloads/), descomprímelo allí con unzip -o yarn-lab-config.zip (si Ubuntu no tiene unzip: sudo apt install -y unzip) y sigue en el paso 6. Ojo: -o sobrescribe tu compose.yaml actual; si lo editaste, guarda antes una copia con cp compose.yaml compose.hdfs.yaml. El contenido es el de los bloques de estos tres pasos; léelos de todos modos, porque explican las dos trampas de YARN en contenedores.
Crea config/yarn-site.xml. Estas propiedades son el mínimo para que YARN funcione en un portátil y para esquivar las dos trampas clásicas de correr YARN en contenedores.
cat > config/yarn-site.xml <<'EOF'
<?xml version="1.0"?>
<configuration>
  <!-- Dónde vive el ResourceManager: los NodeManagers lo buscan por este nombre -->
  <property>
    <name>yarn.resourcemanager.hostname</name>
    <value>resourcemanager</value>
  </property>
  <!-- Que el RM escuche en todas las interfaces del contenedor -->
  <property>
    <name>yarn.resourcemanager.bind-host</name>
    <value>0.0.0.0</value>
  </property>
  <property>
    <name>yarn.resourcemanager.webapp.address</name>
    <value>0.0.0.0:8088</value>
  </property>
  <!-- Servicio auxiliar necesario para el shuffle de MapReduce -->
  <property>
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
  </property>
  <!-- Recursos que ofrece cada NodeManager (ajustados a un portátil) -->
  <property>
    <name>yarn.nodemanager.resource.memory-mb</name>
    <value>2048</value>
  </property>
  <property>
    <name>yarn.nodemanager.resource.cpu-vcores</name>
    <value>2</value>
  </property>
  <property>
    <name>yarn.scheduler.minimum-allocation-mb</name>
    <value>256</value>
  </property>
  <property>
    <name>yarn.scheduler.maximum-allocation-mb</name>
    <value>2048</value>
  </property>
  <!-- TRAMPA 1: en Docker el chequeo de memoria virtual mata los contenedores.
       Se desactiva para el laboratorio. -->
  <property>
    <name>yarn.nodemanager.vmem-check-enabled</name>
    <value>false</value>
  </property>
  <property>
    <name>yarn.nodemanager.pmem-check-enabled</name>
    <value>false</value>
  </property>
  <!-- Agregación de logs: permite usar `yarn logs -applicationId ...` -->
  <property>
    <name>yarn.log-aggregation-enable</name>
    <value>true</value>
  </property>
</configuration>
EOF
4. Configurar mapred-site.xml
Crea config/mapred-site.xml. Aquí está la segunda trampa: en Hadoop 3, si no defines HADOOP_MAPRED_HOME en el entorno del ApplicationMaster y de las tareas, el trabajo falla con “Could not find or load main class … MRAppMaster”.
cat > config/mapred-site.xml <<'EOF'
<?xml version="1.0"?>
<configuration>
  <!-- MapReduce se ejecuta sobre YARN -->
  <property>
    <name>mapreduce.framework.name</name>
    <value>yarn</value>
  </property>
  <!-- TRAMPA 2: sin estas tres variables, el AM y las tareas no encuentran
       las clases de MapReduce en Hadoop 3 -->
  <property>
    <name>yarn.app.mapreduce.am.env</name>
    <value>HADOOP_MAPRED_HOME=/opt/hadoop</value>
  </property>
  <property>
    <name>mapreduce.map.env</name>
    <value>HADOOP_MAPRED_HOME=/opt/hadoop</value>
  </property>
  <property>
    <name>mapreduce.reduce.env</name>
    <value>HADOOP_MAPRED_HOME=/opt/hadoop</value>
  </property>
  <property>
    <name>mapreduce.application.classpath</name>
    <value>$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/*:$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/lib/*</value>
  </property>
  <!-- Memoria pequeña y coherente con los NodeManagers -->
  <property>
    <name>yarn.app.mapreduce.am.resource.mb</name>
    <value>512</value>
  </property>
  <property>
    <name>mapreduce.map.memory.mb</name>
    <value>512</value>
  </property>
  <property>
    <name>mapreduce.reduce.memory.mb</name>
    <value>512</value>
  </property>
  <property>
    <name>yarn.app.mapreduce.am.command-opts</name>
    <value>-Xmx400m</value>
  </property>
  <property>
    <name>mapreduce.map.java.opts</name>
    <value>-Xmx400m</value>
  </property>
  <property>
    <name>mapreduce.reduce.java.opts</name>
    <value>-Xmx400m</value>
  </property>
</configuration>
EOF
Verifica que ya tienes los cuatro XML:
ls -la config/Debe aparecer: core-site.xml, hdfs-site.xml, yarn-site.xml, mapred-site.xml.
5. Reemplazar compose.yaml: ResourceManager y NodeManagers
Reemplaza tu compose.yaml por el archivo completo de abajo: es el compose de HDFS más el ResourceManager y dos NodeManagers. No fusiones a mano — duplicarías servicios. Los comentarios # NUEVO (YARN) marcan lo que se agrega respecto al laboratorio de HDFS.
name: hdfs-lab

x-hadoop: &hadoop
  image: apache/hadoop:3.4.1
  user: "0:0"
  entrypoint: ["/bin/bash", "-c"]
  environment:
    HADOOP_CONF_DIR: /opt/hadoop/etc/hadoop
    HADOOP_HEAPSIZE_MAX: "512"

services:
  namenode:
    <<: *hadoop
    hostname: namenode
    command:
      - |
        set -e
        if [ ! -f /data/name/current/VERSION ]; then
          hdfs namenode -format -nonInteractive
        fi
        exec hdfs namenode
    ports:
      - "127.0.0.1:9870:9870"
    volumes:
      - ./config/core-site.xml:/opt/hadoop/etc/hadoop/core-site.xml:ro
      - ./config/hdfs-site.xml:/opt/hadoop/etc/hadoop/hdfs-site.xml:ro
      # NUEVO (YARN): el namenode también monta los XML de YARN porque desde
      # aquí lanzaremos los trabajos MapReduce (necesita saber dónde está el RM)
      - ./config/yarn-site.xml:/opt/hadoop/etc/hadoop/yarn-site.xml:ro
      - ./config/mapred-site.xml:/opt/hadoop/etc/hadoop/mapred-site.xml:ro
      - namenode_data:/data/name

  datanode1:
    <<: *hadoop
    hostname: datanode1
    command: ["exec hdfs datanode"]
    depends_on:
      - namenode
    volumes:
      - ./config/core-site.xml:/opt/hadoop/etc/hadoop/core-site.xml:ro
      - ./config/hdfs-site.xml:/opt/hadoop/etc/hadoop/hdfs-site.xml:ro
      - datanode1_data:/data/data

  datanode2:
    <<: *hadoop
    hostname: datanode2
    command: ["exec hdfs datanode"]
    depends_on:
      - namenode
    volumes:
      - ./config/core-site.xml:/opt/hadoop/etc/hadoop/core-site.xml:ro
      - ./config/hdfs-site.xml:/opt/hadoop/etc/hadoop/hdfs-site.xml:ro
      - datanode2_data:/data/data

  datanode3:
    <<: *hadoop
    hostname: datanode3
    command: ["exec hdfs datanode"]
    depends_on:
      - namenode
    volumes:
      - ./config/core-site.xml:/opt/hadoop/etc/hadoop/core-site.xml:ro
      - ./config/hdfs-site.xml:/opt/hadoop/etc/hadoop/hdfs-site.xml:ro
      - datanode3_data:/data/data

  # ========================================================================
  # NUEVO (YARN): capa de gestión de recursos.
  # HDFS (arriba) almacena; YARN (abajo) decide quién procesa y con qué CPU/RAM.
  # ========================================================================

  # NUEVO (YARN): el ResourceManager es el "maestro" de recursos del clúster.
  resourcemanager:
    <<: *hadoop
    hostname: resourcemanager        # los NodeManagers lo buscan por este nombre
    command: ["exec yarn resourcemanager"]
    depends_on:
      - namenode
    ports:
      - "127.0.0.1:8088:8088"        # Web UI del ResourceManager -> http://localhost:8088
    volumes:
      - ./config/core-site.xml:/opt/hadoop/etc/hadoop/core-site.xml:ro
      - ./config/hdfs-site.xml:/opt/hadoop/etc/hadoop/hdfs-site.xml:ro
      - ./config/yarn-site.xml:/opt/hadoop/etc/hadoop/yarn-site.xml:ro
      - ./config/mapred-site.xml:/opt/hadoop/etc/hadoop/mapred-site.xml:ro

  # NUEVO (YARN): NodeManager 1. Agente que lanza y vigila contenedores en su nodo.
  # No lleva volumen de datos: no almacena bloques (eso es tarea de los DataNodes).
  nodemanager1:
    <<: *hadoop
    hostname: nodemanager1
    command: ["exec yarn nodemanager"]
    depends_on:
      - resourcemanager
    volumes:
      - ./config/core-site.xml:/opt/hadoop/etc/hadoop/core-site.xml:ro
      - ./config/hdfs-site.xml:/opt/hadoop/etc/hadoop/hdfs-site.xml:ro
      - ./config/yarn-site.xml:/opt/hadoop/etc/hadoop/yarn-site.xml:ro
      - ./config/mapred-site.xml:/opt/hadoop/etc/hadoop/mapred-site.xml:ro

  # NUEVO (YARN): NodeManager 2. Un segundo agente para que YARN reparta el
  # trabajo entre varios nodos (y para probar la caída de uno).
  nodemanager2:
    <<: *hadoop
    hostname: nodemanager2
    command: ["exec yarn nodemanager"]
    depends_on:
      - resourcemanager
    volumes:
      - ./config/core-site.xml:/opt/hadoop/etc/hadoop/core-site.xml:ro
      - ./config/hdfs-site.xml:/opt/hadoop/etc/hadoop/hdfs-site.xml:ro
      - ./config/yarn-site.xml:/opt/hadoop/etc/hadoop/yarn-site.xml:ro
      - ./config/mapred-site.xml:/opt/hadoop/etc/hadoop/mapred-site.xml:ro

volumes:
  namenode_data:
  datanode1_data:
  datanode2_data:
  datanode3_data:
  # NUEVO (YARN): los NodeManagers no necesitan volumen propio; solo los DataNodes almacenan.
Los NodeManagers no llevan volumen de datos (no almacenan bloques, solo lanzan contenedores). En un clúster real, cada máquina suele correr DataNode + NodeManager a la vez.
6. Validar e iniciar
docker compose config --quiet && echo "YAML OK"
docker compose up -d
docker compose ps
Compose levantará solo los servicios nuevos (resourcemanager, nodemanager1, nodemanager2) sin tocar HDFS. Igual que con HDFS, Up significa “el proceso arrancó”, no “YARN está listo”: dale ~20-30 segundos.
7. Verificar YARN
Por consola, lista los NodeManagers registrados:
sleep 20
docker compose exec namenode yarn node -list
Esperado: dos nodos en estado RUNNING (nodemanager1:... y nodemanager2:...), con su dirección HTTP y el número de contenedores en ejecución. La lista corta no muestra memoria ni vcores; eso está en la Web UI (Figura 1) o, si quieres el detalle por consola, en yarn node -list -showDetails.
Ahora abre la 🌐 Web UI del ResourceManager:
👉 http://localhost:8088
En el menú izquierdo, entra a Cluster → Nodes:
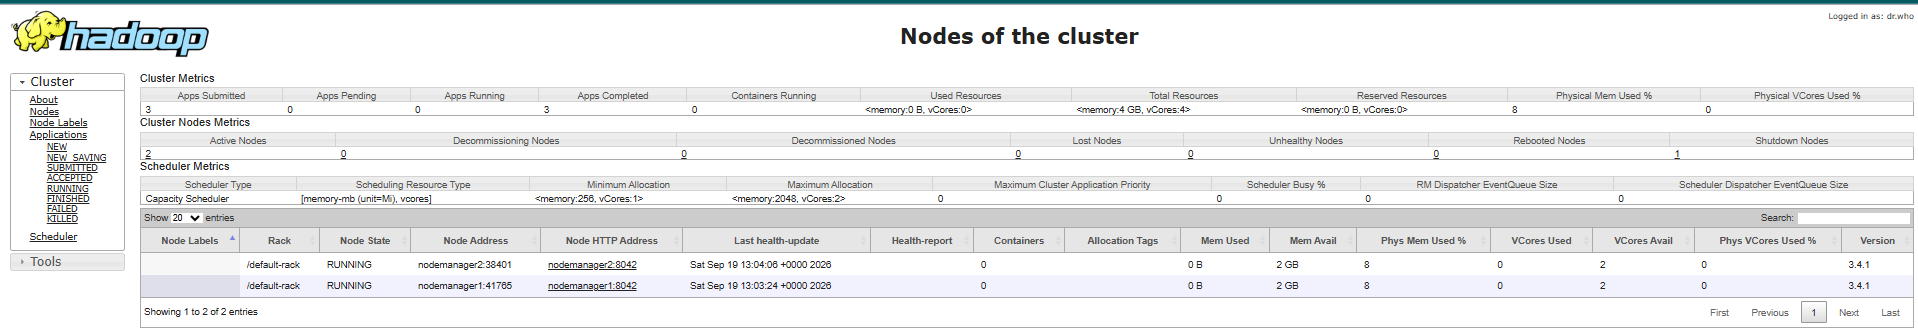
Figura 1. Pestaña Nodes. Los dos NodeManagers en estado RUNNING, ambos en /default-rack, cada uno con 2 GB de memoria y 2 vcores (los valores de yarn-site.xml), sobre Hadoop 3.4.1. Arriba, Total Resources: memory:4 GB, vCores:4 es la suma de los dos nodos. En esta primera visita no deberías ver nodos apagados; Shutdown Nodes aparece más adelante, si detienes un NodeManager.
8. Preparar la entrada en HDFS
Para el wordcount necesitamos un texto en HDFS. Genéralo y súbelo:
# Un texto de ejemplo con palabras repetidas
printf 'hadoop hdfs yarn\nhadoop mapreduce yarn\nspark hadoop datos\nyarn datos datos\n' > texto.txt
docker compose cp texto.txt namenode:/tmp/texto.txt
docker compose exec namenode hdfs dfs -mkdir -p /yarn/entrada
docker compose exec namenode hdfs dfs -put -f /tmp/texto.txt /yarn/entrada/texto.txt
docker compose exec namenode hdfs dfs -cat /yarn/entrada/texto.txt
9. Primer trabajo: estimar π
El ejemplo pi es el “hola mundo” de MapReduce sobre YARN. No necesita entrada en HDFS: lanza tareas map que tiran dardos al azar para estimar π. Perfecto para comprobar que la cadena RM → AM → contenedores funciona.
docker compose exec namenode yarn jar \
  /opt/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.4.1.jar \
pi 4 1000(4 = número de tareas map; 1000 = muestras por tarea.)
Esperado: verás en la salida el envío de la aplicación (Submitted application application_...), el progreso map 0% reduce 0% subiendo hasta 100%, y al final una línea tipo Estimated value of Pi is 3.14.... La estimación es aproximada; lo importante es que el trabajo completó sobre YARN. (Dato: el ejemplo pi aparece en el portal con el nombre interno QuasiMonteCarlo.)
10. Observar la aplicación en la Web UI
Vuelve a 🌐 http://localhost:8088 y entra a Applications:
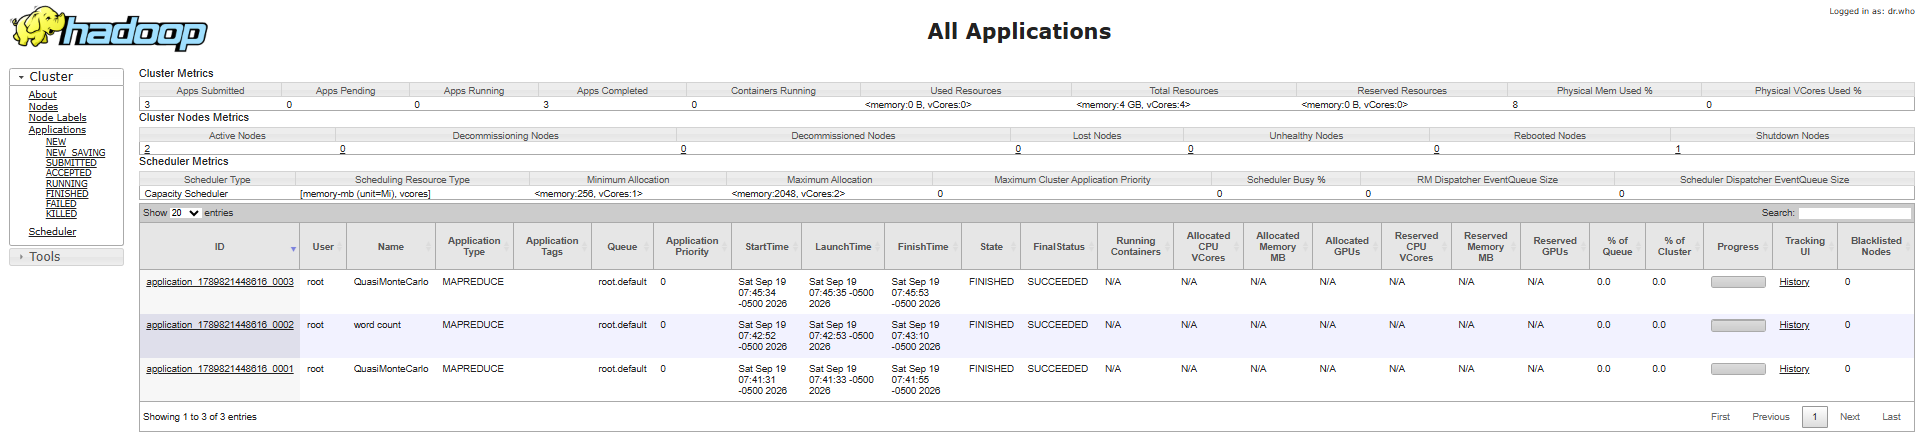
Figura 2. Pestaña Applications. Cada trabajo lanzado aparece con su ID, su Name (QuasiMonteCarlo = el ejemplo pi, word count = el wordcount), su cola (root.default) y su estado (FINISHED / SUCCEEDED). Arriba, Cluster Metrics resume apps enviadas/completadas y los recursos del clúster.
Haz clic en un Application ID para ver el detalle:
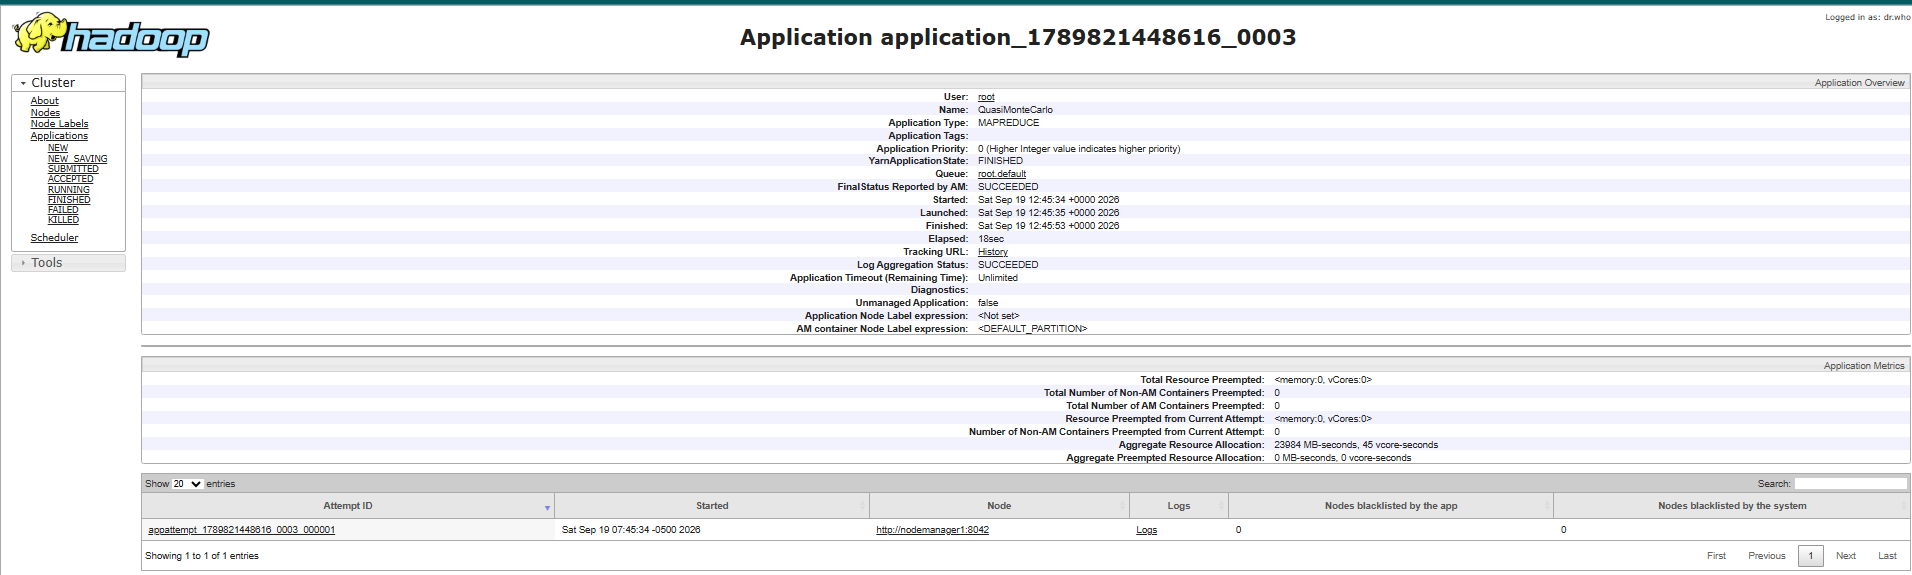
Figura 3. Detalle de la aplicación. Arriba, el Application Overview (usuario, tipo MAPREDUCE, estado, cola, tiempo transcurrido y Log Aggregation Status: SUCCEEDED). Abajo, el Attempt: el ApplicationMaster que coordinó el trabajo, corriendo en un contenedor de nodemanager1:8042, con enlace a sus Logs. El Aggregate Resource Allocation (MB-seconds y vcore-seconds) mide el consumo real de recursos del job.
Relaciónalo con la teoría: el cliente envió la app al ResourceManager, el RM lanzó un ApplicationMaster en un contenedor, el AM pidió contenedores para las tareas map/reduce, y los NodeManagers los ejecutaron. Lo que leíste en el artículo, ocurriendo de verdad.
11. Segundo trabajo: wordcount
Ahora un trabajo que sí lee y escribe en HDFS. Cuenta cuántas veces aparece cada palabra en el archivo del paso 8:
docker compose exec namenode yarn jar \
  /opt/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.4.1.jar \
  wordcount /yarn/entrada/texto.txt /yarn/salida_wc
Importante: el directorio de salida no debe existir antes; YARN lo crea. Si repites el job, usa otro nombre de salida o borra el anterior con
docker compose exec namenode hdfs dfs -rm -r /yarn/salida_wc.
Revisa el resultado. MapReduce escribe la salida en archivos part-r-*: uno por reducer. Con el wordcount por defecto hay un solo reducer, así que verás part-r-00000:
docker compose exec namenode hdfs dfs -ls /yarn/salida_wc
docker compose exec namenode hdfs dfs -cat /yarn/salida_wc/part-r-00000
Esperado: el conteo por palabra, por ejemplo datos 3, hadoop 3, yarn 3. Acabas de correr el “word count” —el ejemplo canónico de MapReduce— pero esta vez distribuido sobre YARN, no con tr | sort | uniq -c como en Dominando la terminal para Big Data.
12. Inspeccionar el trabajo por consola
Todo lo que viste en la Web UI también está por CLI:
# Lista de aplicaciones (todas)
docker compose exec namenode yarn application -list -appStates ALL

# Detalle de una aplicación (usa el appId real de la salida anterior)
docker compose exec namenode yarn application -status application_XXXX_0002

# Logs agregados de una aplicación terminada
docker compose exec namenode yarn logs -applicationId application_XXXX_0002 | head -40
Análisis: yarn logs funciona porque activaste la agregación de logs en yarn-site.xml. Sin ella, los logs quedarían solo en cada NodeManager y se perderían al limpiar los contenedores.
13. Detener un NodeManager y relanzar un trabajo
Comprueba que YARN reprograma el trabajo en los nodos que queden:
# Baja un NodeManager
docker compose stop nodemanager2
sleep 20
docker compose exec namenode yarn node -list
Esperado: ahora yarn node -list muestra un NodeManager RUNNING. Relanza el job de π:
docker compose exec namenode yarn jar \
  /opt/hadoop/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.4.1.jar \
  pi 4 1000
Esperado: el trabajo vuelve a terminar correctamente, pero ahora todos los contenedores se ejecutan en el único NodeManager vivo. YARN se adapta a los recursos disponibles.
Revive el nodo para el resto del laboratorio:
docker compose start nodemanager2Análisis: con un solo NodeManager el trabajo tardó más (menos paralelismo) pero completó. Si hubieras tumbado todos los NodeManagers, el job quedaría atascado en ACCEPTED esperando recursos — justo el síntoma de la tabla de diagnóstico.
14. El planificador
En 🌐 http://localhost:8088, entra a Scheduler (menú izquierdo):
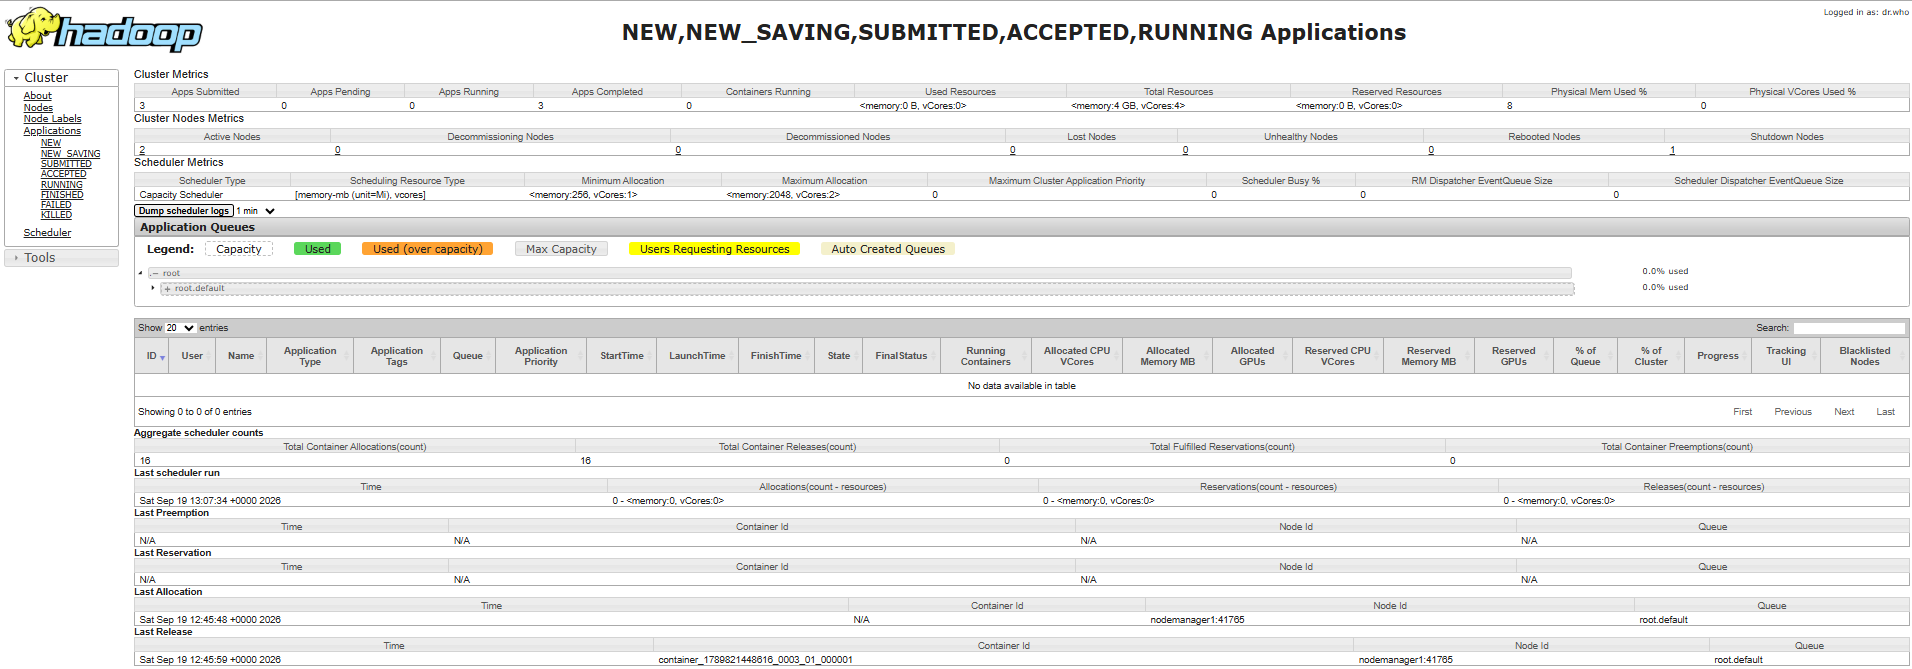
Figura 4. Pestaña Scheduler. YARN usa el Capacity Scheduler, con la jerarquía de colas root → root.default y una leyenda de capacidad (usado / sobre capacidad / máxima). Abajo, los contadores agregados del planificador (Total Container Allocations) resumen cuántos contenedores se han asignado en todas las corridas. Con un solo usuario y una cola no hay competencia, pero esta es la vista donde, en un clúster real con varios equipos, se configuran colas con capacidad garantizada. En Hadoop 3.4.1 el planificador predeterminado es Capacity; Fair ya no forma parte de esta versión.
Análisis: ¿qué porcentaje de la memoria total del clúster usó tu último job? Relaciónalo con la memoria que le diste a cada NodeManager (paso 3) y al AM/tareas (paso 4).
15. Apagar
Para apagar todo el clúster (HDFS + YARN) conservando los datos:
docker compose downPara borrar también los volúmenes (datos de HDFS incluidos):
docker compose down -vPara apagar solo YARN y dejar HDFS corriendo:
docker compose stop resourcemanager nodemanager1 nodemanager216. Diagnóstico de problemas habituales
| Síntoma | Causa probable | Solución |
|---|---|---|
Connection refused a namenode:9000 justo tras up -d |
Consultaste antes de que el servicio abriera el puerto | Espera unos segundos (sleep 20) y reintenta; “Up” ≠ “listo” |
El job se queda en ACCEPTED y no avanza |
No hay NodeManagers registrados, o no hay memoria suficiente para el AM | yarn node -list (¿hay nodos RUNNING?); revisa yarn.nodemanager.resource.memory-mb y la memoria del AM |
Could not find or load main class ... MRAppMaster |
Falta HADOOP_MAPRED_HOME en mapred-site.xml |
Verifica las tres variables *.env del paso 4 |
Contenedor killed ... exceeding virtual memory |
El chequeo de memoria virtual de YARN | yarn.nodemanager.vmem-check-enabled=false (paso 3) |
La Web UI :8088 muestra 0 nodos activos |
Los NodeManagers no alcanzan al RM | Revisa yarn.resourcemanager.hostname=resourcemanager y que el servicio se llame así |
Output directory ... already exists |
El directorio de salida del wordcount ya existía | Usa otro nombre de salida o borra el anterior con hdfs dfs -rm -r |
El AM muere por memoria (Container ... running beyond ... memory) |
AM o tareas más grandes que el contenedor | Baja *.java.opts a -Xmx400m o sube la memoria del contenedor |
yarn logs dice que no hay logs |
Agregación desactivada o job aún en curso | Activa yarn.log-aggregation-enable=true y espera a que el job termine |
17. Evidencias y preguntas de cierre
Capturas para tus evidencias (las cuatro vistas del portal, con material propio): - portal_01_nodes.png — los NodeManagers RUNNING (Figura 1). - portal_02_applications.png — las aplicaciones FINISHED / SUCCEEDED (Figura 2). - portal_03_app_detail.png — el detalle con el AM y los contenedores (Figura 3). - portal_04_scheduler.png — la cola y la capacidad (Figura 4). - La salida del wordcount (part-r-00000).
Preguntas de comprensión: 1. ¿Por qué este laboratorio necesita HDFS y YARN corriendo a la vez? 2. En el ciclo de una aplicación, ¿qué papel jugó el ResourceManager, cuál el ApplicationMaster y cuáles los contenedores? 3. En esta corrida el wordcount dejó un solo part-r-00000. ¿Qué representa ese archivo respecto a los reducers, y cuándo verías varios part-r-*? 4. Cuando tumbaste un NodeManager, ¿por qué el trabajo siguió completándose? ¿Qué habría pasado si tumbabas todos? 5. ¿Qué diferencia hay entre el “container” de YARN de este laboratorio y el contenedor de Docker sobre el que corre todo?
Referencias y estado de validación
- Imagen:
apache/hadoop:3.4.1(la misma del laboratorio de HDFS). - Documentación: Apache Hadoop — YARN y MapReduce (yarn-site.xml, mapred-site.xml, ejemplos de MapReduce).
- Estado de validación: laboratorio ejecutado y validado el 19 de septiembre de 2026 sobre Docker en Linux/WSL2 (Docker 29.x, Compose v2). Se levantó el clúster completo (NameNode + 3 DataNodes + ResourceManager + 2 NodeManagers), se ejecutaron correctamente los trabajos
pi(QuasiMonteCarlo) ywordcount(ambosFINISHED / SUCCEEDED), se comprobó la reprogramación al detener un NodeManager y se capturaron las cuatro vistas del portal (Figuras 1-4). Las dos correcciones para Hadoop 3 sobre Docker (HADOOP_MAPRED_HOMEy el chequeo de memoria virtual) resultaron necesarias y suficientes.