Serie MLOps y Producción · de la ingeniería de datos al monitoreo.
Módulo II — Feature engineering y pipelines
Un algoritmo de aprendizaje no observa el mundo: observa una matriz de características. Si esa matriz está mal diseñada, el modelo más sofisticado resuelve un problema distinto al que el negocio cree haber planteado. Esta sesión estudia precisamente eso: cómo se construye la representación de entrada.
El objeto de estudio no es el Pipeline de scikit-learn. Ese contrato de ejecución —quién ve qué, en qué orden, y cómo se serializa— pertenece a la sesión 5. Aquí respondemos una pregunta previa y más conceptual: qué transformación aplicar, por qué es matemáticamente razonable y qué clase de modelo la necesita.
Propósito académico
Tratar el feature engineering como una disciplina de diseño: justificar cada cambio de representación con un argumento estadístico o de sesgo inductivo, medirlo empíricamente y reconocer cuándo no conviene transformar.
Objetivos de aprendizaje
Al finalizar esta sesión, el estudiante estará en capacidad de:
Distinguir formalmente limpieza de datos (calidad) de feature engineering (representación).
Diagnosticar sesgo, escala y colinealidad, y elegir transformaciones numéricas con criterio.
Codificar variables categóricas sin introducir orden artificial ni fugas por target encoding.
Explicar por qué el escalamiento altera k-NN o la regresión regularizada, pero no necesariamente a un árbol.
Aplicar selección de características (filtro, envoltorio, embebida) y leer su efecto sobre el modelo.
Comparar un flujo base contra un flujo con ingeniería de características, interpretando métricas y no solo reportándolas.
Qué no cubre esta sesión
El pipeline como contrato de serialización y trazabilidad (sesión 5).
Búsqueda de hiperparámetros y validación cruzada sistemática (sesión 6).
Calidad de captura, nulos estructurales y contratos de dato (sesiones 3 y 3a).
Ruta de trabajo
Representación y sesgo inductivo.
Diagnóstico de un dataset persistente.
Transformaciones numéricas.
Escalamiento y sensibilidad del modelo.
Codificación categórica y fugas silenciosas.
Interacciones, polinomios y discretización.
Selección de características.
Ejemplo integrador y taller.
# Entorno reproducible de la sesión 4.import warningsimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport seaborn as snsfrom sklearn.compose import ColumnTransformerfrom sklearn.feature_selection import ( SelectKBest, VarianceThreshold, f_classif, mutual_info_classif,)from sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import accuracy_score, f1_score, precision_score, recall_scorefrom sklearn.model_selection import train_test_splitfrom sklearn.neighbors import KNeighborsClassifierfrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import ( KBinsDiscretizer, MinMaxScaler, OneHotEncoder, OrdinalEncoder, PolynomialFeatures, PowerTransformer, RobustScaler, StandardScaler,)from sklearn.tree import DecisionTreeClassifierwarnings.filterwarnings("ignore", category=FutureWarning)np.random.seed(42)sns.set_theme(style="whitegrid", context="notebook")pd.set_option("display.max_columns", 14)pd.set_option("display.width", 120)pd.set_option("display.float_format", lambda x: f"{x:,.4f}")print("Entorno listo. Semilla 42 fijada.")print("Esta sesión diseña T(x). El contrato de ejecución de T se estudia en la sesión 5.")
Entorno listo. Semilla 42 fijada.
Esta sesión diseña T(x). El contrato de ejecución de T se estudia en la sesión 5.
1) La representación como objeto de diseño
En una frase: el feature engineering es el diseño de una función \(T\) que convierte datos crudos \(x\) en un vector \(T(x)\) alineado con el sesgo inductivo del algoritmo.
Un modelo paramétrico \(f_\theta\) no aprende “la realidad”. Aprende una relación en el espacio en el que se le presenta el problema:
[ = f_(T(x)). ]
Si \(T\) es pobre, \(f_\theta\) puede ser óptimo en ese espacio y, aun así, inútil para el negocio. Invertir semanas en el algoritmo mientras \(T\) se improvisa en tres celdas es un error de asignación de esfuerzo, no un detalle de implementación.
Definición operativa
Llamamos feature engineering al conjunto de decisiones que:
eligen qué aspectos del fenómeno se vuelven columnas,
transforman esas columnas para que su geometría sea tratable,
descartan o combinan dimensiones redundantes,
documentan esas decisiones de modo que \(T\) pueda repetirse.
No es “crear columnas creativas”. Es ingeniería de representación: cada transformación debe tener una hipótesis (asimetría, no linealidad, escala, cardinalidad) y una forma de falsearla.
Limpieza de datos frente a transformación de variables
La frontera con las sesiones 3 y 3a debe quedar nítida. Confundir ambos oficios produce pipelines que “limpian” lo que en realidad están rediseñando, o que transforman valores inválidos como si fueran señal.
Pregunta
Limpieza / calidad
Feature engineering
¿Qué se repara?
Validez, consistencia, completitud
Forma, escala, codificación
Ejemplo
Un ingreso negativo, un duplicado, un nulo de captura
log1p(ingreso), one-hot de segmento
Criterio de éxito
El dato es el que el negocio midió
El modelo puede usar ese dato
Riesgo si se omite
Conclusiones sobre un mundo falso
Un mundo verdadero, mal representado
Un nulo puede ser, a la vez, un problema de calidad y una feature (indicador de no respuesta). Esa ambigüedad no autoriza a mezclar oficios: primero se decide qué es error; después se decide cómo se representa lo que queda.
Sesgo inductivo: por qué \(T\) depende del algoritmo
El sesgo inductivo es el conjunto de supuestos que un algoritmo impone antes de ver los datos. Un modelo lineal supone que la frontera es un hiperplano en el espacio de entrada. Un k-NN supone que la cercanía euclídea es semánticamente relevante. Un árbol supone que se pueden aislar regiones con cortes axis-aligned.
Eso implica una regla de diseño:
Si el algoritmo es sensible a escala o a linealidad (regresión, SVM lineal, k-NN, redes), \(T\) debe ocuparse de unidades, colas y no linealidades.
Si el algoritmo es invariante a transformaciones monótonas por columna (árboles, random forests en su forma estándar), muchas transformaciones de escala son irrelevantes y otras —como el one-hot de alta cardinalidad— pueden ser perjudiciales.
El mismo log(ingreso) puede ser decisivo para una regresión logística y casi inocuo para un árbol. Transformar “por costumbre” no es rigor: es un hábito que hay que justificar.
Ejemplo mínimo: una no linealidad que el modelo lineal no ve
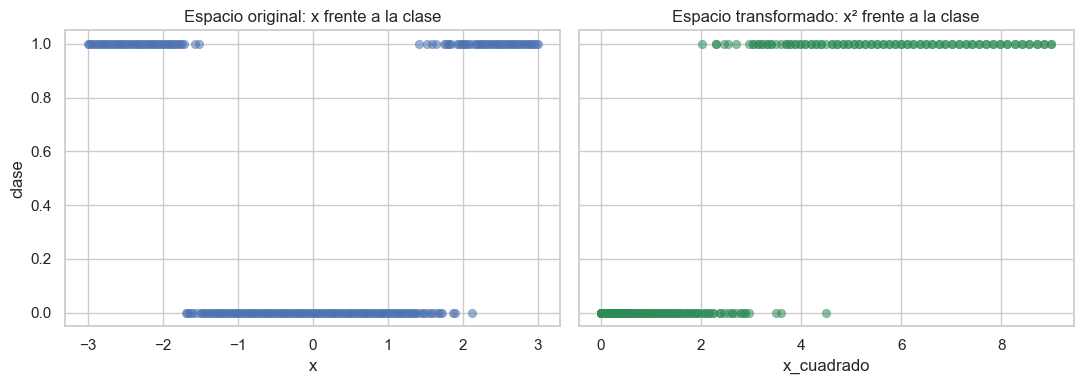
Considere una etiqueta que depende de \(x^2\), no de \(x\). En el eje original la clase se mezcla; en el eje \(x^2\) la separación se vuelve más lineal. No estamos “inventando información”: estamos eligiendo coordenadas en las que el sesgo del modelo coincide con la geometría del fenómeno.
La figura siguiente no pretende ser un caso de negocio. Es un argumento visual: \(T\) puede ser tan simple como un monomio, y aun así cambiar la dificultad del problema.
# Relación no lineal: la etiqueta depende de x^2, no de x.rng = np.random.default_rng(42)x = np.linspace(-3.0, 3.0, 240)ruido = rng.normal(0.0, 0.75, size=len(x))y = ((x**2+ ruido) >3.0).astype(int)df_intro = pd.DataFrame({"x": x, "x_cuadrado": x**2, "clase": y})fig, axes = plt.subplots(1, 2, figsize=(11, 4), sharey=True)sns.scatterplot(data=df_intro, x="x", y="clase", alpha=0.55, ax=axes[0], edgecolor=None)axes[0].set_title("Espacio original: x frente a la clase")sns.scatterplot(data=df_intro, x="x_cuadrado", y="clase", alpha=0.55, ax=axes[1], color="seagreen", edgecolor=None)axes[1].set_title("Espacio transformado: x² frente a la clase")plt.tight_layout()plt.show()print("Proporción de clase 1:", f"{y.mean():.3f}")print("La transformación no añade datos: cambia el sistema de coordenadas.")
Proporción de clase 1: 0.442
La transformación no añade datos: cambia el sistema de coordenadas.
Lectura de la figura. A la izquierda, valores de \(x\) próximos a cero y valores grandes pueden compartir etiqueta; un corte lineal sobre \(x\) no separa bien. A la derecha, la clase 1 se concentra en \(x^2\) alto. Un modelo lineal en esa coordenada tiene una tarea más fácil. Ese es el oficio de \(T\): no “mejorar el dato”, sino alinear geometría y algoritmo.
2) Un dataset persistente para diagnosticar, no para decorar
A partir de aquí todas las secciones trabajan sobre el mismo conjunto sintético. Así, el histograma de la sección 3, el mapa de correlación de la sección 7 y el comparativo final hablan del mismo fenómeno.
El diseño es deliberado:
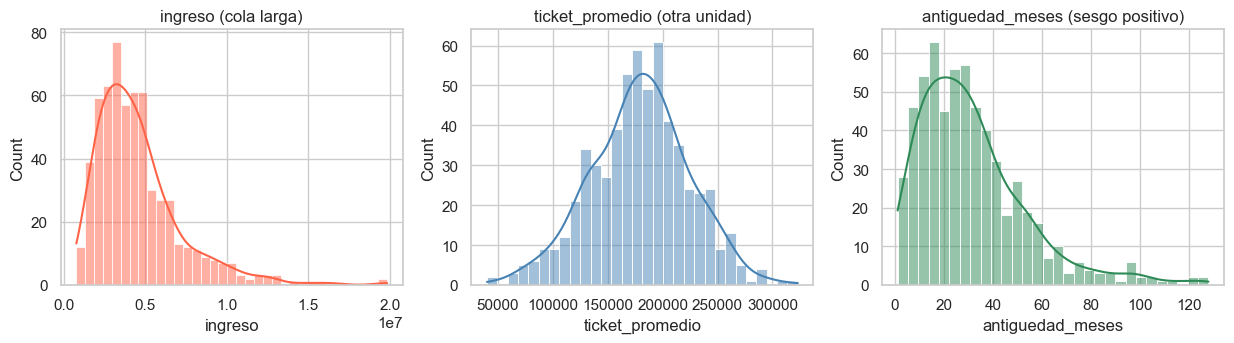
ingreso y antiguedad_meses tienen cola larga (sesgo positivo).
ticket_promedio está en otra unidad (miles frente a millones).
segmento es nominal; nivel_riesgo es ordinal.
ruido_constante casi no varía (candidata a filtro por varianza).
ingreso_duplicado es una copia ruidosa de ingreso (colinealidad).
La etiqueta alta_prioridad depende de ingreso, segmento corporativo y riesgo alto, con ruido.
No buscamos un F1 espectacular. Buscamos un laboratorio donde cada decisión de \(T\) deje huella interpretable.
Dimensión: (600, 10)

Tipos:
ingreso              float64
ticket_promedio      float64
antiguedad_meses     float64
visitas              float64
segmento              object
nivel_riesgo          object
canal                 object
ruido_constante      float64
ingreso_duplicado    float64
alta_prioridad         int64

Balance de la etiqueta:
alta_prioridad
0   0.8220
1   0.1780
Name: proportion, dtype: float64

Primeras filas:
       ingreso  ticket_promedio  antiguedad_meses  visitas    segmento nivel_riesgo  canal  ruido_constante  ingreso_duplicado  alta_prioridad
4,721,298.3499     203,193.4681            8.1209   5.0000      retail        medio    web           6.9980     4,623,552.6150               0
2,253,530.6939     154,010.7501           35.0235   8.0000      retail         bajo aliado           6.9943     2,349,400.6595               0
6,032,958.9774     237,350.1248           15.5602   7.0000      retail        medio    web           7.0158     6,041,204.4313               0
6,697,940.1314     151,758.5609           14.7388   8.0000 corporativo        medio    web           6.9884     6,917,204.9224               1
Diagnóstico descriptivo: lo que \(T\) debe resolver
Antes de transformar se mide. Asimetría, rango, cardinalidad y correlación no son trámites: son el argumento empírico que justifica (o rechaza) cada paso posterior.
# Diagnóstico numérico: escala, cola y colinealidad.num_cols = ["ingreso","ticket_promedio","antiguedad_meses","visitas","ruido_constante","ingreso_duplicado",]diag = pd.DataFrame( {"min": df[num_cols].min(),"mediana": df[num_cols].median(),"max": df[num_cols].max(),"std": df[num_cols].std(),"asimetria": df[num_cols].skew(),"curtosis": df[num_cols].kurt(), })print("Resumen de variables numéricas:")print(diag.round(3).to_string())print("\nCardinalidad de categóricas:")for c in ["segmento", "nivel_riesgo", "canal"]:print(f" {c}: {df[c].nunique()} niveles -> {df[c].value_counts().to_dict()}")print("\nCorrelación de Pearson entre ingreso e ingreso_duplicado:")print(f" {df['ingreso'].corr(df['ingreso_duplicado']):.4f}")
# Histogramas y mapa de correlación: la escala y la redundancia se ven.fig, axes = plt.subplots(1, 3, figsize=(12.5, 3.6))sns.histplot(df["ingreso"], bins=35, kde=True, ax=axes[0], color="tomato")axes[0].set_title("ingreso (cola larga)")sns.histplot(df["ticket_promedio"], bins=30, kde=True, ax=axes[1], color="steelblue")axes[1].set_title("ticket_promedio (otra unidad)")sns.histplot(df["antiguedad_meses"], bins=30, kde=True, ax=axes[2], color="seagreen")axes[2].set_title("antiguedad_meses (sesgo positivo)")plt.tight_layout()plt.show()fig, ax = plt.subplots(figsize=(7.2, 5.4))sns.heatmap(df[num_cols].corr(), annot=True, fmt=".2f", cmap="vlag", center=0, ax=ax)ax.set_title("Correlación de Pearson entre numéricas")plt.tight_layout()plt.show()
Lectura del diagnóstico. Tres hechos deben quedar registrados, porque las secciones siguientes los usan como premisa:
ingreso y antiguedad_meses tienen asimetría alta: una transformación de potencia es candidata, no automática.
ticket_promedio vive en otra magnitud: cualquier método basado en distancia o en regularización \(\ell_2\) verá esa columna como “pequeña” frente a ingreso.
ingreso_duplicado es casi un clon: no aporta información nueva y sí infla la colinealidad. ruido_constante no discrimina.
Un árbol puede ignorar (1) y (2). Una regresión logística o un k-NN no.
3) Transformaciones numéricas
En una frase: una transformación numérica cambia la métrica con la que el algoritmo percibe diferencias entre observaciones.
Por qué importan las colas
En una variable con sesgo positivo, la mayoría de las filas se concentran a la izquierda y unas pocas dominan la media, la varianza y —en modelos lineales— el gradiente. El estimador gasta capacidad en acomodar extremos. Eso no es “respetar outliers” necesariamente: a menudo es dejar que la unidad de medida (pesos, no log-pesos) dicte la geometría.
Para \(x > 0\),
[ (1 + x) ]
comprime magnitudes altas y convierte razones en diferencias aproximadas: un salto de 2 millones a 4 millones se parece más a un salto de 200 mil a 400 mil que a un salto aditivo de 2 millones. Esa es la lectura ingenieril, no cosmética, del logaritmo.
Familia de transformaciones de potencia
Box-Cox (para \(x > 0\)) y Yeo-Johnson (admite ceros y negativos) buscan un \(\lambda\) que estabilice la varianza y reduzca la asimetría:
El logaritmo es el caso \(\lambda = 0\). La raíz cuadrada corresponde a \(\lambda = 0.5\). No hay que memorizar la fórmula: hay que recordar que se estima un parámetro (\(\lambda\), o \(\mu\) y \(\sigma\) después) y que ese parámetro, si se calcula con el test, constituye una fuga. En esta sesión medimos el efecto sobre la distribución; en la sesión 5 se encapsula el fit.
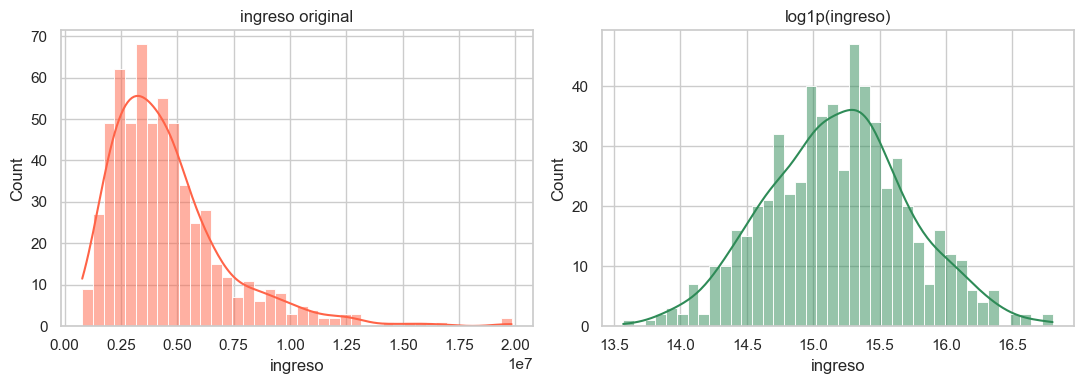
# Efecto de log1p sobre ingreso: asimetría y forma.ingreso_log = np.log1p(df["ingreso"])fig, axes = plt.subplots(1, 2, figsize=(11, 4))sns.histplot(df["ingreso"], bins=40, kde=True, ax=axes[0], color="tomato")axes[0].set_title("ingreso original")sns.histplot(ingreso_log, bins=40, kde=True, ax=axes[1], color="seagreen")axes[1].set_title("log1p(ingreso)")plt.tight_layout()plt.show()print(f"Asimetría original : {df['ingreso'].skew():.3f}")print(f"Asimetría log1p : {pd.Series(ingreso_log).skew():.3f}")
Asimetría original : 1.849
Asimetría log1p    : 0.059
El histograma derecho no es “más bonito”: es más compatible con un modelo que trata desviaciones de forma simétrica. La asimetría cae de forma material. Eso no implica que todo modelo deba usar log1p; implica que, si el modelo es lineal o métrico, ignorar la cola es una decisión, no un default inocente.
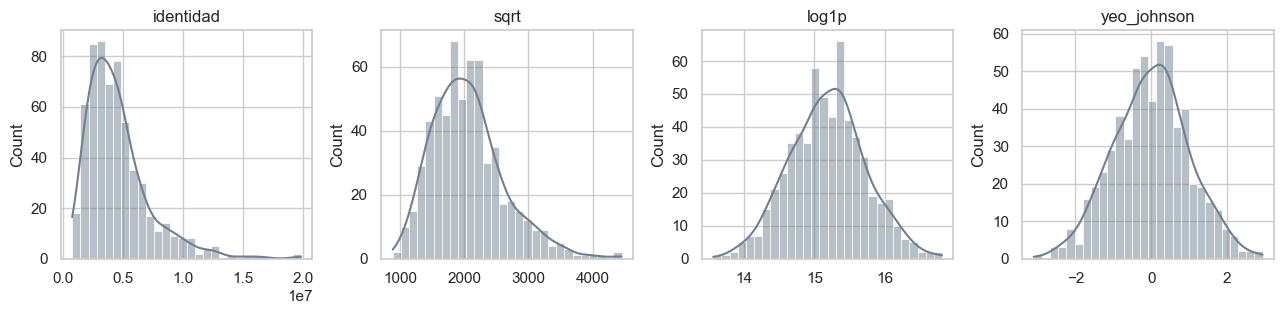
Momentos de ingreso bajo cuatro representaciones:
             asimetria  curtosis            std
identidad       1.8490    5.3120 2,649,201.8410
sqrt            0.8810    1.2120       564.6760
log1p           0.0590   -0.0380         0.5360
yeo_johnson     0.0000   -0.0480         1.0010
Cómo leer la tabla. La identidad deja una cola pesada. sqrt alivia; log1p y Yeo-Johnson suelen ir más lejos. Yeo-Johnson aprende\(\lambda\) y además estandariza: su desviación cercana a 1 no es magia, es parte del transformador. En producción ese \(\lambda\) debe congelarse sobre train (sesión 5). Aquí nos basta con ver que distintas \(T\) producen distintas geometrías.
Cuándo no transformar
Tres contraindicaciones frecuentes:
Árboles y ensembles de árboles. Un corte ingreso > 8e6 no mejora por escribir log(ingreso). La transformación monótona no cambia el orden de los valores.
Interpretación en unidades originales. Si el informe debe decir “por cada millón de pesos”, el logaritmo obliga a una traducción. A veces conviene modelar en log y reportar en pesos; a veces conviene no transformar.
Ceros estructurales y valores sentinela.log1p trata el 0 como un vecino de 1. Si el 0 significa “no aplica”, la representación correcta puede ser un indicador más una transformación solo en el soporte positivo.
La pregunta no es “¿queda más gaussiano?”. Es “¿el algoritmo y el usuario de la métrica se benefician de este cambio de unidades?”.
4) Escalamiento: igualar unidades, no “normalizar por estética”
En una frase: escalar es elegir una unidad común para que la regularización, la distancia o el gradiente no estén gobernados por la columna con mayor rango.
Tres transformaciones lineales canónicas
Sea \(x\) una columna y \(x_{(1)}, x_{(n)}\) sus extremos muestrales.
Estandarización (z-score):
[ z = ]
Centra en 0 y fija varianza 1. Es el default razonable para modelos lineales y redes. Es sensible a outliers: un extremo infla \(\sigma\) y comprime al resto.
Min-Max hacia \([0, 1]\):
[ u = ]
Útil cuando el algoritmo espera un cubo (ciertas redes, distancias acotadas). Un solo máximo nuevo en producción satura o rompe el rango aprendido.
RobustScaler:
[ r = ]
Usa estadísticos de orden. Prefiéralo cuando la cola no es señal, sino contaminación.
Ninguno de los tres añade información. Reescalan. El error conceptual es tratarlos como intercambiables o aplicarlos después de un one-hot (las dummies 0/1 ya tienen escala natural).
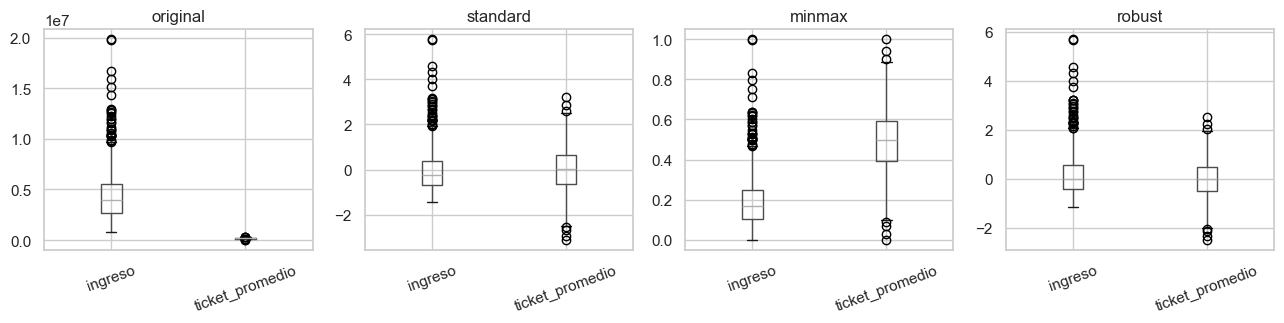
# Tres scalers sobre las mismas dos columnas de distinta magnitud.cols_escala = ["ingreso", "ticket_promedio"]X_esc = df[cols_escala]escalados = {"original": X_esc,"standard": pd.DataFrame(StandardScaler().fit_transform(X_esc), columns=cols_escala),"minmax": pd.DataFrame(MinMaxScaler().fit_transform(X_esc), columns=cols_escala),"robust": pd.DataFrame(RobustScaler().fit_transform(X_esc), columns=cols_escala),}resumen_escala = []for nombre, bloque in escalados.items(): fila = {"scaler": nombre}for c in cols_escala: fila[f"{c}_media"] = bloque[c].mean() fila[f"{c}_std"] = bloque[c].std() fila[f"{c}_min"] = bloque[c].min() fila[f"{c}_max"] = bloque[c].max() resumen_escala.append(fila)print(pd.DataFrame(resumen_escala).round(3).to_string(index=False))fig, axes = plt.subplots(1, 4, figsize=(13, 3.4), sharey=False)for ax, (nombre, bloque) inzip(axes, escalados.items()): bloque.boxplot(ax=ax) ax.set_title(nombre) ax.tick_params(axis="x", rotation=20)plt.tight_layout()plt.show()
En el panel original, ingreso aplasta visualmente a ticket_promedio. Tras StandardScaler, ambas oscilan en un rango comparable; el precio es la sensibilidad a extremos. MinMax fuerza el cubo \([0,1]\). RobustScaler reduce el peso de las colas. Elija el scaler por el algoritmo y la contaminación, no por la gráfica más simétrica.
Experimento: el mismo \(X\), dos sesgos inductivos
k-NN usa distancia. Un árbol de decisión usa cortes. Si escalamos, el vecindario de k-NN cambia; las particiones del árbol, si los cortes son monótonos por columna, no deberían cambiar de forma material. Ese contraste es la prueba de que \(T\) no es universal.
# Sensibilidad al escalamiento: k-NN frente a un árbol, misma partición.X_num = df[["ingreso", "ticket_promedio", "antiguedad_meses", "visitas"]]y_all = df["alta_prioridad"]Xtr, Xte, ytr, yte = train_test_split( X_num, y_all, test_size=0.30, random_state=42, stratify=y_all)knn_crudo = KNeighborsClassifier(n_neighbors=15).fit(Xtr, ytr)knn_esc = Pipeline( [("scaler", StandardScaler()), ("knn", KNeighborsClassifier(n_neighbors=15))]).fit(Xtr, ytr)arbol_crudo = DecisionTreeClassifier(max_depth=4, random_state=42).fit(Xtr, ytr)arbol_esc = Pipeline( [ ("scaler", StandardScaler()), ("arbol", DecisionTreeClassifier(max_depth=4, random_state=42)), ]).fit(Xtr, ytr)tabla_sens = pd.DataFrame( {"modelo": ["k-NN crudo", "k-NN + StandardScaler", "árbol crudo", "árbol + StandardScaler"],"accuracy": [ accuracy_score(yte, knn_crudo.predict(Xte)), accuracy_score(yte, knn_esc.predict(Xte)), accuracy_score(yte, arbol_crudo.predict(Xte)), accuracy_score(yte, arbol_esc.predict(Xte)), ],"f1": [ f1_score(yte, knn_crudo.predict(Xte)), f1_score(yte, knn_esc.predict(Xte)), f1_score(yte, arbol_crudo.predict(Xte)), f1_score(yte, arbol_esc.predict(Xte)), ], })print(tabla_sens.round(3).to_string(index=False))print("\nEl árbol apenas se mueve: sus cortes no dependen de la unidad.")print("k-NN sí se mueve: la distancia estaba dominada por ingreso.")
                modelo  accuracy     f1
            k-NN crudo    0.8330 0.3750
 k-NN + StandardScaler    0.8440 0.3000
           árbol crudo    0.8280 0.3400
árbol + StandardScaler    0.8280 0.3400

El árbol apenas se mueve: sus cortes no dependen de la unidad.
k-NN sí se mueve: la distancia estaba dominada por ingreso.
Interpretación. Si k-NN mejora al escalar, no “descubrimos un mejor modelo”: dejamos de medir distancia en pesos contra visitas. Si el árbol permanece estable, confirmamos la invariancia. Un notebook que escala “siempre, por si acaso” oculta esta distinción y, en árboles, añade un fit innecesario que luego hay que serializar.
Escalamiento y regularización \(\ell_2\)
En regresión logística con penalización \(\ell_2\), la función objetivo castiga \(\lVert \theta \rVert_2^2\). Si ingreso está en millones y visitas en unidades, el coeficiente de ingreso debe ser minúsculo para producir el mismo logit. El regularizador interpreta ese coeficiente pequeño como “ya está controlado” y castiga con más dureza a visitas. Escalar no es un truco numérico: es hacer que la penalización sea comparable entre columnas.
5) Codificación de variables categóricas
En una frase: una categoría es una etiqueta de clase de equivalencia; convertirla en número sin respetar esa semántica inventa una geometría que el fenómeno no tiene.
Nominal frente a ordinal
Nominal (segmento, canal): no hay orden. corporativo no es “mayor” que pyme en un eje numérico.
Ordinal (nivel_riesgo: bajo < medio < alto): el orden existe; la distancia entre niveles, en cambio, rara vez es uniforme.
Label encoding (enteros 0, 1, 2) sobre una nominal es un error clásico: el modelo lineal lee 2 > 1 y k-NN cree que retail está más cerca de pyme que de corporativo según el accidente del mapeo.
One-hot construye vectores ortogonales. Es la representación honesta para nominales de baja cardinalidad. El costo es dimensional: \(k\) niveles aportan \(k\) (o \(k-1\), si se evita la trampa de la dummy) columnas.
Ordinal encoding es legítimo para nivel_riesgosi el modelo puede aprovechar el orden (lineal, o un árbol que corte el eje). No lo es para canal.
# Contraste pedagógico: enteros arbitrarios frente a one-hot e encoding ordinal.muestra = df[["segmento", "nivel_riesgo"]].head(8).copy()muestra["segmento_entero"] = OrdinalEncoder().fit_transform(muestra[["segmento"]]).ravel()orden_riesgo = [["bajo", "medio", "alto"]]muestra["riesgo_ordinal"] = OrdinalEncoder(categories=orden_riesgo).fit_transform( muestra[["nivel_riesgo"]]).ravel()dummies = pd.get_dummies(muestra["segmento"], prefix="seg")print("Muestra con tres representaciones:")print(pd.concat([muestra, dummies], axis=1).to_string(index=False))print("\nEl entero de segmento no significa magnitud. El ordinal de riesgo sí respeta un orden declarado.")
Muestra con tres representaciones:
   segmento nivel_riesgo  segmento_entero  riesgo_ordinal  seg_corporativo  seg_pyme  seg_retail
     retail        medio           2.0000          1.0000            False     False        True
     retail         bajo           2.0000          0.0000            False     False        True
     retail        medio           2.0000          1.0000            False     False        True
corporativo        medio           0.0000          1.0000             True     False       False
     retail         alto           2.0000          2.0000            False     False        True
       pyme         bajo           1.0000          0.0000            False      True       False
       pyme        medio           1.0000          1.0000            False      True       False
     retail         bajo           2.0000          0.0000            False     False        True

El entero de segmento no significa magnitud. El ordinal de riesgo sí respeta un orden declarado.
Observe que el entero de segmento depende del orden en que el encoder vio las etiquetas. Ese orden no es una propiedad del negocio. El ordinal de riesgo, en cambio, se declaró. La diferencia entre ambos no está en la clase de scikit-learn: está en si el mapeo es un hecho del dominio o un accidente del software.
Cardinalidad, categorías raras y niveles no vistos
Si un nivel aparece tres veces, el one-hot correspondiente es una columna casi nula: alta varianza de estimador, poca señal. La práctica robusta es colapsar niveles raros en otrosusando frecuencias de train, y declarar handle_unknown="ignore" (o un nivel explícito) para categorías que solo existirán mañana.
Agrupar con frecuencias del archivo completo, otra vez, es una fuga: el test ayuda a decidir qué es “raro”.
# Categorías raras: colapsar por frecuencia de train, no del archivo completo.X_cat = df[["canal"]].copy()y_cat = df["alta_prioridad"]Xtr_c, Xte_c, _, _ = train_test_split( X_cat, y_cat, test_size=0.30, random_state=42, stratify=y_cat)# Insertamos a propósito un nivel raro solo en train y otro solo en test.Xtr_c = Xtr_c.copy()Xte_c = Xte_c.copy()Xtr_c.iloc[:4, 0] ="kiosko"Xte_c.iloc[:3, 0] ="app_nueva"freq = Xtr_c["canal"].value_counts()print("Frecuencias en train (incluye el kiosko artificial):")print(freq.to_string())umbral =10frecuentes =set(freq[freq >= umbral].index)def colapsar(s: pd.Series) -> pd.Series:return s.where(s.isin(frecuentes), other="otros")print("\nTrain colapsado:", colapsar(Xtr_c["canal"]).value_counts().to_dict())print("Test colapsado :", colapsar(Xte_c["canal"]).value_counts().to_dict())print("app_nueva no estaba en train: cae en 'otros'. Ese es el comportamiento deseado.")
Frecuencias en train (incluye el kiosko artificial):
canal
web         200
sucursal    153
aliado       63
kiosko        4

Train colapsado: {'web': 200, 'sucursal': 153, 'aliado': 63, 'otros': 4}
Test colapsado : {'web': 85, 'sucursal': 57, 'aliado': 35, 'otros': 3}
app_nueva no estaba en train: cae en 'otros'. Ese es el comportamiento deseado.
Target encoding y la fuga más elegante
El mean encoding (o target encoding) sustituye cada nivel \(c\) por una media suavizada de \(y\) en ese nivel:
[ (c) = ,{y}_c + ,{y}. ]
Es potente en alta cardinalidad. También es el mecanismo más limpio para filtrar la etiqueta hacia \(X\) si \(\bar{y}_c\) se calcula con el archivo completo, o sin suavizado, o sin validación cruzada interna.
La demostración siguiente no busca un encoding óptimo. Compara dos medias: una honesta (solo train) y una contaminada (todo \(X\)). Si no coinciden, el test ya escribió sobre \(T\).
# Target encoding: media de y por segmento, con y sin fuga.X_te = df[["segmento"]].copy()y_te = df["alta_prioridad"]Xtr_e, Xte_e, ytr_e, yte_e = train_test_split( X_te, y_te, test_size=0.30, random_state=7, stratify=y_te)media_global_train = ytr_e.mean()media_honesta = ytr_e.groupby(Xtr_e["segmento"]).mean()media_fuga = y_te.groupby(X_te["segmento"]).mean()tabla_te = pd.DataFrame( {"media_solo_train": media_honesta,"media_todo_X": media_fuga, })tabla_te["diferencia"] = tabla_te["media_todo_X"] - tabla_te["media_solo_train"]print("Media de la etiqueta por segmento:")print(tabla_te.round(4).to_string())print(f"\nMedia global de train (suavizado natural): {media_global_train:.4f}")print("Si 'diferencia' no es cero, el test influyó en el encoding.")
Media de la etiqueta por segmento:
             media_solo_train  media_todo_X  diferencia
segmento
corporativo            0.2951        0.2976      0.0025
pyme                   0.1579        0.1488     -0.0091
retail                 0.1594        0.1661      0.0067

Media global de train (suavizado natural): 0.1786
Si 'diferencia' no es cero, el test influyó en el encoding.
La diferencia puede ser de unos puntos porcentuales. Eso basta para que un modelo “memorice” un poco del examen. En producción, además, \(\bar{y}_c\) del archivo completo no existirá: solo existirá el histórico de train (o de una ventana). Un encoding contaminado no solo es inválido; es irreproducible mañana.
Regla: si \(T\) mira \(y\), \(y\) debe ser la de train, con suavizado, y de preferencia con esquema out-of-fold. Esta sesión deja enunciada la regla; la sesión 5 la convierte en un paso del contrato.
6) Interacciones, polinomios y discretización
Un modelo lineal en \(x_1\) y \(x_2\) no puede decir “el ingreso alto solo importa si el segmento es corporativo”, salvo que esa conjunción exista como columna. El término de interacción \(x_1 x_2\) (o una dummy de segmento multiplicada por ingreso) expande el espacio para que el sesgo lineal alcance un fenómeno no aditivo.
PolynomialFeatures genera monomios e interacciones hasta un grado \(d\). El costo es combinatorio: \(p\) variables y \(d=2\) producen del orden de \(p^2\) columnas. Sin selección posterior, el sobreajuste es el escenario por defecto, no la excepción.
# Expansión polinómica de grado 2 sobre dos numéricas ya en log-escala.base = pd.DataFrame( {"log_ingreso": np.log1p(df["ingreso"]),"antiguedad": df["antiguedad_meses"], })poly = PolynomialFeatures(degree=2, include_bias=False)X_poly = poly.fit_transform(base)nombres = poly.get_feature_names_out(base.columns)print("Columnas generadas:")print(list(nombres))print("\nForma:", X_poly.shape)print("La interacción log_ingreso×antiguedad no existía en el crudo: es una hipótesis de no aditividad.")
Columnas generadas:
['log_ingreso', 'antiguedad', 'log_ingreso^2', 'log_ingreso antiguedad', 'antiguedad^2']

Forma: (600, 5)
La interacción log_ingreso×antiguedad no existía en el crudo: es una hipótesis de no aditividad.
Discretización (binning)
Convertir una continua en intervalos (KBinsDiscretizer) es útil cuando la relación con \(y\) es por umbrales (tarifas, segmentos de riesgo) o cuando se quiere robustez a extremos. El precio es pérdida de resolución: dos clientes dentro del mismo bin se vuelven idénticos en esa coordenada.
El número y los bordes de los bins, si se estiman con cuantiles del archivo completo, son otro fit que debe vivir en train.
# Tres bins por cuantiles sobre antiguedad: la continua se vuelve ordinal.kbd = KBinsDiscretizer(n_bins=3, encode="ordinal", strategy="quantile")bins = kbd.fit_transform(df[["antiguedad_meses"]]).ravel()print("Bordes aprendidos (cuantiles de todo el dataset, solo didáctico):")print(np.round(kbd.bin_edges_[0], 2))print("\nConteo por bin:", pd.Series(bins).value_counts().sort_index().to_dict())print("En un flujo honesto, fit se haría solo con train (sesión 5).")
Bordes aprendidos (cuantiles de todo el dataset, solo didáctico):
[  1.15  19.12  35.26 127.75]

Conteo por bin: {0.0: 200, 1.0: 200, 2.0: 200}
En un flujo honesto, fit se haría solo con train (sesión 5).
7) Selección de características
En una frase: seleccionar es decidir qué dimensiones merecen capacidad del modelo, bajo un presupuesto de varianza, costo e interpretabilidad.
Más columnas no implican más información. Implican más parámetros, más colinealidad y más oportunidades de ajustar ruido. La selección es la contraparte de la expansión (polinomios, one-hot, interacciones).
Tres familias
Familia
Idea
Ejemplos
Limitación
Filtro
Mide \(X\) (y a veces \(y\)) sin entrenar el modelo final
Entrena el modelo muchas veces, añadiendo o quitando
RFE, forward/backward
Costoso; puede sobreajustar el criterio
Embebida
La penalización o el árbol ya eligen
Lasso (\(\ell_1\)), importancia de splits
La selección queda atada a ese modelo
No hay jerarquía moral. Hay ajuste al presupuesto computacional y al tipo de \(f\).
# Filtros simples: varianza casi nula y correlación alta con un par redundante.X_filtro = df[num_cols]vt = VarianceThreshold(threshold=0.05)vt.fit(X_filtro)print("Varianza por columna:")print(pd.Series(X_filtro.var().values, index=num_cols).round(4).to_string())print("\n¿Pasa el umbral 0.05?:")print(pd.Series(vt.get_support(), index=num_cols).to_string())corr_abs = X_filtro.corr().abs()pares = ( corr_abs.where(np.triu(np.ones(corr_abs.shape), k=1).astype(bool)) .stack() .sort_values(ascending=False))print("\nPares con |ρ| > 0.85:")print(pares[pares >0.85].round(4).to_string() if (pares >0.85).any() else" (ninguno)")
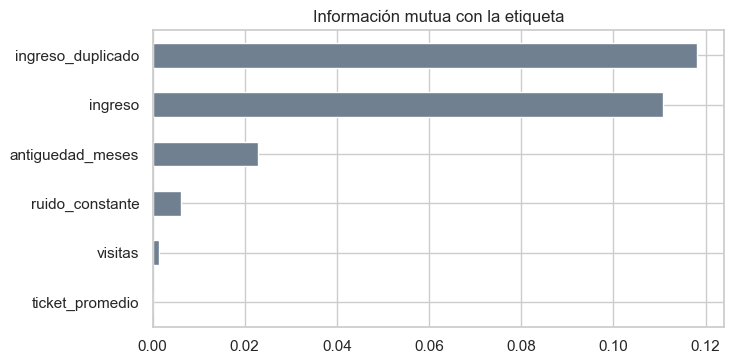
ruido_constante cae por varianza. ingreso e ingreso_duplicado caen (o deberían) por correlación. Esos filtros son baratos y, sobre todo, explicables ante un revisor: no dependemos de un ranking opaco para eliminar un clon.
La información mutua \(I(X_j; Y)\) mide dependencia no lineal, a diferencia de Pearson. Un \(F\) de ANOVA asume, en cambio, un contraste de medias más rígido. Conviene mirar ambos cuando se sospecha una relación en forma de U o de umbral.
# Rankings de filtro supervisado: F de ANOVA e información mutua.X_rank = df[num_cols]y_rank = df["alta_prioridad"]F_vals, _ = f_classif(X_rank, y_rank)mi_vals = mutual_info_classif(X_rank, y_rank, random_state=42)ranking = pd.DataFrame({"F_ANOVA": F_vals, "informacion_mutua": mi_vals}, index=num_cols)ranking = ranking.sort_values("informacion_mutua", ascending=False)print(ranking.round(4).to_string())fig, ax = plt.subplots(figsize=(7.5, 3.8))ranking["informacion_mutua"].plot(kind="barh", ax=ax, color="slategray")ax.set_title("Información mutua con la etiqueta")ax.invert_yaxis()plt.tight_layout()plt.show()
# Selección embebida: L1 empuja coeficientes a cero (tras escalar).X_emb = StandardScaler().fit_transform(df[num_cols])lasso = LogisticRegression( penalty="l1", solver="liblinear", C=0.15, random_state=42, max_iter=1000).fit(X_emb, df["alta_prioridad"])coefs = pd.Series(lasso.coef_.ravel(), index=num_cols).sort_values(key=np.abs)print("Coeficientes L1 (C=0.15). Cercanos a cero ≈ descartados por el propio modelo:")print(coefs.round(4).to_string())
Coeficientes L1 (C=0.15). Cercanos a cero ≈ descartados por el propio modelo:
ticket_promedio      0.0000
ruido_constante     -0.0953
visitas             -0.0994
ingreso              0.2022
antiguedad_meses    -0.4053
ingreso_duplicado    0.9613
d:\Users\wilde\anaconda3\Lib\site-packages\sklearn\linear_model\_logistic.py:1160: UserWarning: Inconsistent values: penalty=l1 with l1_ratio=0.0. penalty is deprecated. Please use l1_ratio only.
  warnings.warn(
Lectura conjunta. El filtro no supervisado elimina lo que no varía o lo que está duplicado. El filtro supervisado ordena por asociación con \(y\). L1 elige un subconjunto compatible con un modelo lineal regularizado. Si los tres coinciden en condenar ruido_constante y ingreso_duplicado, la decisión es robusta. Si discrepan, el conflicto es información: Pearson no ve no linealidades; L1 no ve lo que un árbol usaría.
7b) Tres problemas de representación que suelen disfrazarse de limpieza
El nulo como feature
Un valor faltante puede ser error de captura (sesión 3) o información: el cliente no declaró ingreso, el sensor no midió, el formulario se abandonó. La representación honesta, cuando el nulo es informativo, es un indicador \(1_{x=\mathrm{NA}}\) más una imputación solo para el modelo. Imputar y borrar la huella del nulo destruye señal. Imputar con la media del archivo completo, otra vez, es un fit fuera de sitio.
# Indicador de nulo + imputación: el hueco se vuelve columna, no se esconde.demo_nulos = df[["ingreso", "alta_prioridad"]].copy()rng_n = np.random.default_rng(7)mascara = rng_n.random(len(demo_nulos)) <0.12demo_nulos.loc[mascara, "ingreso"] = np.nandemo_nulos["ingreso_faltante"] = demo_nulos["ingreso"].isna().astype(int)mediana_obs = demo_nulos.loc[~mascara, "ingreso"].median()demo_nulos["ingreso_imputado"] = demo_nulos["ingreso"].fillna(mediana_obs)print("Nulos insertados:", int(mascara.sum()))print("Tasa de clase 1 si ingreso faltante :", f"{demo_nulos.loc[mascara, 'alta_prioridad'].mean():.3f}")print("Tasa de clase 1 si ingreso observado:", f"{demo_nulos.loc[~mascara, 'alta_prioridad'].mean():.3f}")print("El indicador existe aunque la imputación deje la columna 'completa'.")
Nulos insertados: 61
Tasa de clase 1 si ingreso faltante : 0.098
Tasa de clase 1 si ingreso observado: 0.187
El indicador existe aunque la imputación deje la columna 'completa'.
La trampa de la dummy
Si \(k\) niveles se codifican con \(k\) columnas 0/1, la suma de esas columnas es 1 para cada fila. En un modelo con intercepto, \(X\) es linealmente dependiente: los coeficientes no son identificables de forma única. La convención drop="first" (o \(k-1\) dummies) restaura rango pleno. Los árboles no sufren este problema; las regresiones sí. Omitir el debate “por comodidad” produce coeficientes que no se pueden interpretar, no un one-hot más moderno.
# Rango de la matriz one-hot con k y con k-1 columnas.ohe_k = OneHotEncoder(sparse_output=False, drop=None).fit_transform(df[["segmento"]])ohe_k1 = OneHotEncoder(sparse_output=False, drop="first").fit_transform(df[["segmento"]])print("Forma k dummies :", ohe_k.shape, "| rango:", np.linalg.matrix_rank(ohe_k))print("Forma k-1 :", ohe_k1.shape, "| rango:", np.linalg.matrix_rank(ohe_k1))print("Suma por fila (k dummies), valores únicos:", np.unique(ohe_k.sum(axis=1)))
Forma k dummies : (600, 3) | rango: 3
Forma k-1       : (600, 2) | rango: 2
Suma por fila (k dummies), valores únicos: [1.]
¿Train y test ya no se parecen?
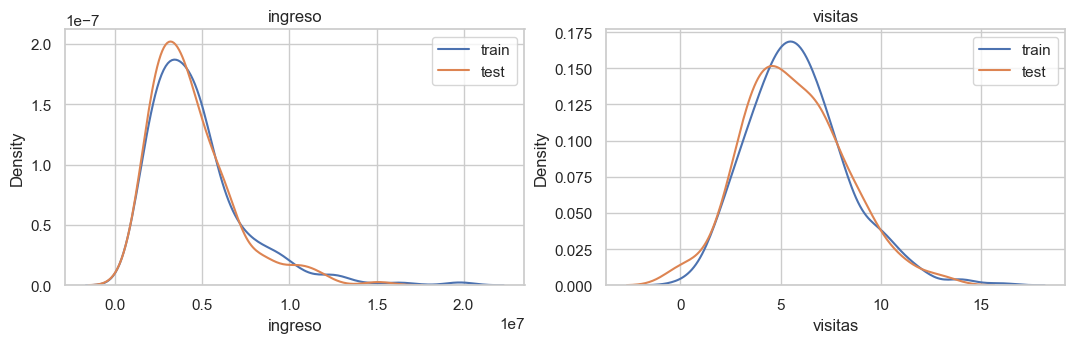
\(T\) se diseña en train. Si el test (o la producción) tiene otra cola de ingreso, el logaritmo sigue siendo aplicable, pero las conclusiones del laboratorio se debilitan. Un histograma comparativo no sustituye un test de estabilidad (sesión 12); sí evita el autoengaño de ajustar \(T\) a una muestra y evaluarla en otra que ya no es la misma población.
# Desplazamiento descriptivo: la misma columna, dos lados del split.Xa, Xb, _, _ = train_test_split( df[["ingreso", "visitas"]], df["alta_prioridad"], test_size=0.30, random_state=42, stratify=df["alta_prioridad"],)fig, axes = plt.subplots(1, 2, figsize=(11, 3.6))for ax, col inzip(axes, ["ingreso", "visitas"]): sns.kdeplot(Xa[col], ax=ax, label="train") sns.kdeplot(Xb[col], ax=ax, label="test") ax.set_title(col) ax.legend()plt.tight_layout()plt.show()print("Media ingreso train/test:", f"{Xa['ingreso'].mean():,.0f}", "/", f"{Xb['ingreso'].mean():,.0f}")print("Si las curvas divergen mucho, el delta de T en el integrador hay que leerlo con reserva.")
Media ingreso train/test: 4,628,651 / 4,358,780
Si las curvas divergen mucho, el delta de T en el integrador hay que leerlo con reserva.
8) Ejemplo integrador: misma partición, dos representaciones
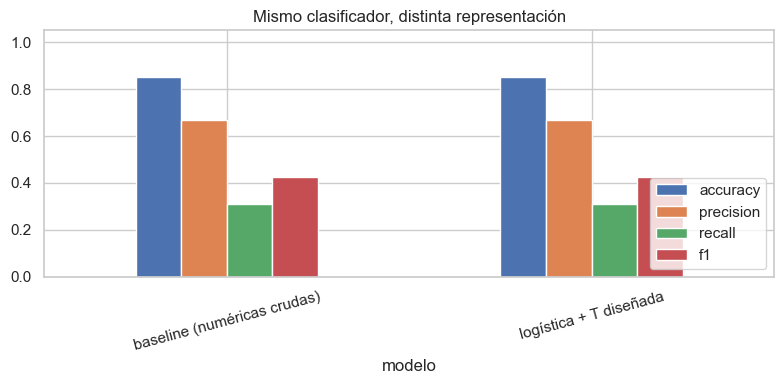
Comparamos un baseline (numéricas crudas, sin categóricas, sin escala) contra un flujo con \(T\) justificada:
log1p en variables de cola,
StandardScaler en numéricas,
one-hot en nominales,
ordinal declarado en nivel_riesgo,
eliminación de ruido_constante e ingreso_duplicado.
El modelo \(f\) se mantiene fijo: una regresión logística. Así, la diferencia de métricas se atribuye a \(T\), no a un cambio de algoritmo. Usamos Pipeline y ColumnTransformer como vehículo de comparación, no como tema: el contrato (serializar, auditar, recargar) es la sesión 5.
# Partición estratificada única para baseline y flujo con ingeniería.num_utiles = ["ingreso", "ticket_promedio", "antiguedad_meses", "visitas"]cat_nominales = ["segmento", "canal"]cat_ordinales = ["nivel_riesgo"]feats = num_utiles + cat_nominales + cat_ordinalesX_int = df[feats]y_int = df["alta_prioridad"]X_train, X_test, y_train, y_test = train_test_split( X_int, y_int, test_size=0.30, random_state=42, stratify=y_int)print("Train:", X_train.shape, "| Test:", X_test.shape)print("Tasa de clase 1 en train:", f"{y_train.mean():.3f}", "| en test:", f"{y_test.mean():.3f}")
Train: (420, 7) | Test: (180, 7)
Tasa de clase 1 en train: 0.179 | en test: 0.178
# Baseline: solo numéricas crudas. Sin escala, sin categóricas.baseline = LogisticRegression(max_iter=400, random_state=42)baseline.fit(X_train[num_utiles], y_train)pred_base = baseline.predict(X_test[num_utiles])print("Baseline entrenado. Columnas:", num_utiles)
Cómo discutir este resultado. Un F1 más alto no “prueba que el feature engineering funciona” en abstracto. Prueba que, para este \(f\) y este fenómeno sintético, la representación diseñada era más compatible con un hiperplano. Si el delta fuera nulo o negativo, la conclusión válida sería otra: \(T\) era innecesaria o dañina para este estimador (por ejemplo, un árbol profundo).
Tres lecturas obligatorias, gane quien gane:
El baseline no usó segmento ni nivel_riesgo: parte del delta es información que se había dejado fuera, no magia de Yeo-Johnson.
Accuracy en un problema desbalanceado puede mentir; F1 y recall de la clase rara son más honestos.
El flujo ganador aún no es un artefacto de producción: falta el contrato de la sesión 5.
# Coeficientes en el espacio de T: qué variables 'empujaron' al hiperplano.nombres_t = flujo_fe.named_steps["pre"].get_feature_names_out()coefs_t = pd.Series( flujo_fe.named_steps["clf"].coef_.ravel(), index=nombres_t).sort_values(key=np.abs)print("Coeficientes de la logística sobre T(x) (ordenados por |β|):")print(coefs_t.round(3).to_string())print("\nUn |β| grande no 'prueba causalidad'. Prueba peso en *esta* representación.")
Coeficientes de la logística sobre T(x) (ordenados por |β|):
nom__canal_sucursal         -0.0180
num__ticket_promedio         0.0600
nom__segmento_retail         0.0730
nom__canal_web              -0.0930
nom__canal_aliado            0.1200
ord__nivel_riesgo           -0.1230
num__visitas                -0.1630
nom__segmento_corporativo    0.3790
nom__segmento_pyme          -0.4440
num__antiguedad_meses       -0.5360
num__ingreso                 1.6230

Un |β| grande no 'prueba causalidad'. Prueba peso en *esta* representación.
9) Errores frecuentes (y el principio que los unifica)
Escalar o codificar antes de partir.\(T\) aprende con el test. La métrica deja de ser un examen.
Enteros sobre nominales. Se fabrica un orden. El modelo lo cree.
One-hot de alta cardinalidad sin colapsar. Se fabrica una matriz hueca.
Target encoding global. Se fabrica una fuga elegante.
Transformar árboles “por higiene”. Se fabrica complejidad sin sesgo que la justifique.
Seleccionar variables mirando todo \(X\). El selector es un fit más.
Confundir más columnas con más señal. Los polinomios y las dummies son hipótesis, no regalos.
Reportar solo accuracy. En etiquetas desbalanceadas, el modelo trivial ya es “bueno”.
El principio común: toda estadística que \(T\) necesite (media, \(\lambda\), vocabulario, bordes, frecuencias, importancias) es un parámetro, y los parámetros se aprenden en train.
10) Checklist de diseño de \(T\)
Antes de dar por cerrada una representación, responda por escrito:
¿Qué supuesto del algoritmo estoy sirviendo (linealidad, distancia, cortes)?
¿Qué evidencia descriptiva justifica cada transformación (asimetría, rango, cardinalidad)?
¿Qué columnas no transformé, y por qué esa omisión es deliberada?
¿Algún paso mira \(y\)? Si sí, ¿cómo evito la fuga?
¿Qué hará el sistema el día que aparezca un nivel nuevo o un ingreso fuera de rango?
¿Puedo explicarle \(T\) a alguien que no escribió el notebook?
Si la respuesta a (6) es un encogimiento de hombros, \(T\) aún no es ingeniería: es un conjunto de celdas.
11) Conclusiones
El feature engineering no es una etapa decorativa entre el CSV y el fit. Es el diseño del espacio en el que el algoritmo tiene permiso de aprender. En esta sesión se argumentó y se midió que:
la limpieza garantiza validez; \(T\) garantiza representabilidad;
logaritmos y potencias cambian la métrica de las colas;
el escalamiento es decisivo para distancias y para \(\ell_2\), y casi irrelevante para un árbol;
el encoding debe respetar si el dominio es nominal u ordinal;
la selección es la contraparte de la expansión;
comparar dos \(T\) exige fijar\(f\) y la partición.
La sesión 5 toma esta \(T\) ya justificada y la convierte en un objeto que se puede ajustar sin fuga, guardar y recargar. Sin esa encapsulación, el mejor diseño de features sigue siendo una receta de laboratorio.
12) Taller práctico
Trabaje sobre df (o regenérelo con la misma semilla). No se pide un F1 máximo; se pide un argumento.
A. Diagnóstico. Calcule asimetría de ticket_promedio y de visitas. ¿Alguna justifica log1p? Argumente con el sesgo del modelo que usaría.
B. Encoding. Codifique canal con one-hot y, por separado, con enteros. Entrene la misma logística sobre numéricas + cada encoding. ¿Cuál F1 es más creíble y por qué?
C. Rareza. Agrupe niveles de canal con umbral 50 usando solo train. ¿Cuántas filas de test cayeron en otros?
D. Selección. Aplique SelectKBest(f_classif, k=3) sobre las numéricas de train. ¿Coincide el trío con el ranking de información mutua de la sección 7?
E. Contrafactual. Repita el integrador sustituyendo la logística por DecisionTreeClassifier(max_depth=4). ¿El delta de \(T\) se mantiene? Interprete con sesgo inductivo.
# Espacio de taller. Use df, num_cols y la semilla 42.# A. print(df[["ticket_promedio", "visitas"]].skew())# B. compare OneHotEncoder frente a OrdinalEncoder sobre canal.# C. reutilice la función colapsar con umbral 50.# D. SelectKBest(f_classif, k=3).fit(X_train[num_utiles], y_train)# E. sustituya LogisticRegression por DecisionTreeClassifier en ambos flujos.print("Celda de taller. Resuelva A–E. El valor no está en el F1; está en la justificación de T.")print("Filas disponibles:", len(df), "| columnas:", list(df.columns))
Celda de taller. Resuelva A–E. El valor no está en el F1; está en la justificación de T.
Filas disponibles: 600 | columnas: ['ingreso', 'ticket_promedio', 'antiguedad_meses', 'visitas', 'segmento', 'nivel_riesgo', 'canal', 'ruido_constante', 'ingreso_duplicado', 'alta_prioridad']
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo arquitectura de IA.
👉 El código completo está disponible para ejecutar directamente.