Serie MLOps y Producción · de la ingeniería de datos al monitoreo.
Módulo III — Automatización y orquestación
La sesión 6 convirtió el entrenamiento en un protocolo. Ese protocolo, sin embargo, sigue viviendo en un notebook: alguien lo abre, ejecuta celdas, y si la celda 4 falla ya se corrió la 7. Un sistema de producción no se opera así.
Este artículo enseña a pensar el trabajo como un grafo de pasos. Cada paso tiene entradas, salidas y vecinos. El orden no es “como está en el cuaderno”; es el que imponen las dependencias. Si un paso falla, los que dependen de él no deberían correr como si nada. Eso es orquestar.
No instalamos Airflow ni Prefect. El concepto se entiende mejor cuando uno construye un DAG mínimo en Python: nodos, aristas, orden topológico, bitácora, reintento e idempotencia.
Objetivos de aprendizaje
Distinguir script, pipeline de ML (sesión 5) y workflow.
Definir un DAG, detectar ciclos y calcular un orden topológico.
Registrar logs estructurados y detener o reintentar cuando un paso falla.
Explicar idempotencia, fan-in/fan-out y la idea de backfill.
Qué no cubre esta sesión
Elegir hiperparámetros (sesión 6): aquí el entrenamiento es un nodo.
Versionar corridas en un registry (sesión 8).
Exponer el modelo como API (sesión 9).
Ruta de trabajo
Tres ideas que no hay que mezclar.
El DAG y la prohibición del ciclo.
Orden topológico (Kahn) y detección de ciclos.
Un flujo ETL + train simulado.
Fallos, reintentos e idempotencia.
Fan-in, fan-out y backfill.
Taller.
# Entorno: grafo, bitácora y artefactos del orquestador didáctico.import jsonimport loggingimport timefrom collections import defaultdict, dequefrom pathlib import Pathimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdfrom sklearn.linear_model import LogisticRegressionfrom sklearn.model_selection import train_test_splitfrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import StandardScalernp.random.seed(42)RUTA = Path("artefactos_sesion7")RUTA.mkdir(exist_ok=True)logging.basicConfig(level=logging.INFO, format="%(asctime)s | %(levelname)s | %(message)s")log = logging.getLogger("orquestador")print("Entorno listo. Semilla 42.")print("El pipeline de sklearn vivirá DENTRO de un nodo. El DAG es el mapa ENTRE nodos.")
Entorno listo. Semilla 42.
El pipeline de sklearn vivirá DENTRO de un nodo. El DAG es el mapa ENTRE nodos.
1) Orquestar no es “correr todo el notebook”
En una frase: orquestar es ejecutar pasos solo cuando sus dependencias están listas, y no ejecutarlos si esas dependencias fallaron.
Un notebook impone un orden espacial: de arriba hacia abajo. Un orquestador impone un orden lógico: “entrenar” no empieza hasta que “transformar” terminó bien. Esa diferencia importa el día en que alguien reordena celdas, o el día en que la extracción falla y el entrenamiento usa el CSV de ayer sin avisarlo.
Tres ideas que no hay que mezclar
Idea
Pregunta
Ejemplo
Script
¿Qué instrucciones van en secuencia?
Un .py de 200 líneas
Pipeline de ML (sesión 5)
¿Cómo \(T\) y \(f\) se aplican a una fila?
ColumnTransformer + modelo
Workflow (esta sesión)
¿Cómo se encadenan trabajos del sistema?
Extraer → transformar → entrenar → guardar
El pipeline de scikit-learn vive dentro de un paso. El workflow es el mapa entre pasos. Confundirlos es confundir la receta de un plato con el plan de la cocina entera.
2) El DAG: nodos, aristas y la prohibición del ciclo
En una frase: un DAG (Directed Acyclic Graph) es un grafo dirigido sin ciclos: las dependencias avanzan y nunca vuelven al punto de partida.
Nodo: un paso (extraer, validar, entrenar).
Arista\(A \rightarrow B\): \(B\) no puede empezar hasta que \(A\) termine bien.
Acíclico: no existe un camino que regrese.
¿Por qué prohibir ciclos? Porque el orquestador necesita un orden topológico: una lista tal que toda arista vaya de un nodo anterior a uno posterior. Si hay ciclo, esa lista no existe.
Dependencias de negocio, no capricho del software
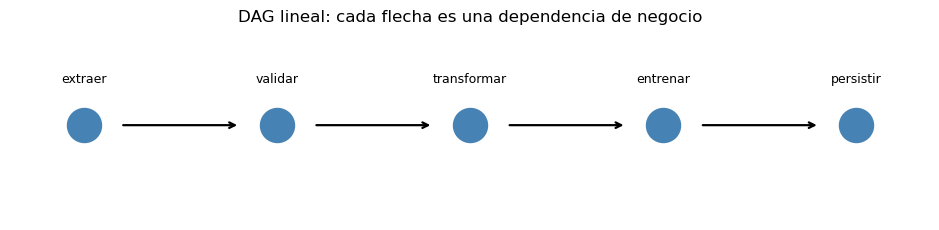
Un flujo típico de esta serie:
extraer — lee o fabrica la fuente.
validar — rechaza un esquema imposible (sesión 3a).
transformar — deja el esquema que el modelo espera.
entrenar — el protocolo de la sesión 6 (aquí, un fit simple).
persistir — escribe el artefacto.
No se persiste si no se entrenó. No se entrena si la validación falló. Esa es dependencia de negocio.
# El DAG de la sesión, declarado como lista de aristas.NODOS = ["extraer", "validar", "transformar", "entrenar", "persistir"]ARISTAS = [ ("extraer", "validar"), ("validar", "transformar"), ("transformar", "entrenar"), ("entrenar", "persistir"),]print("Nodos:", NODOS)print("Dependencias:")for a, b in ARISTAS:print(f" {a} → {b}")
Kahn cuenta, para cada nodo, cuántos predecesores le faltan. Empieza por los de grado 0, los “ejecuta” (los saca de la cola) y reduce el grado de sus vecinos. Si al final no se visitaron todos los nodos, había un ciclo.
# Kahn: orden legal o denuncia de ciclo.def orden_topologico(nodos, aristas): suc = defaultdict(list) grado = {n: 0for n in nodos}for a, b in aristas: suc[a].append(b) grado[b] +=1 cola = deque([n for n in nodos if grado[n] ==0]) orden = []while cola: u = cola.popleft() orden.append(u)for v in suc[u]: grado[v] -=1if grado[v] ==0: cola.append(v)iflen(orden) !=len(nodos): restantes = [n for n in nodos if n notin orden]raiseValueError(f"Ciclo detectado. Nodos atrapados: {restantes}")return ordenprint("Orden legal:", orden_topologico(NODOS, ARISTAS))
Orden legal: ['extraer', 'validar', 'transformar', 'entrenar', 'persistir']
Ese orden no es único si hay paralelismo posible. En un grafo lineal, sí lo es. La unicidad no es el valor: el valor es que cualquier orden topológico respeta las aristas.
# Un ciclo no se puede orquestar: el algoritmo debe fallar en voz alta.try:print(orden_topologico(["a", "b", "c"], [("a", "b"), ("b", "c"), ("c", "a")]))exceptValueErroras exc:print("Fallo esperado:")print(" ", exc)
Una figura no sustituye al algoritmo, pero evita el error de “yo me acuerdo del orden”.
# Dibujo lineal del DAG de la sesión.fig, ax = plt.subplots(figsize=(9.5, 2.4))xs = np.linspace(0.08, 0.92, len(NODOS))for x, nombre inzip(xs, NODOS): ax.scatter([x], [0.5], s=600, c="steelblue", zorder=3) ax.text(x, 0.72, nombre, ha="center", fontsize=9)for i inrange(len(xs) -1): ax.annotate("", xy=(xs[i +1] -0.04, 0.5), xytext=(xs[i] +0.04, 0.5), arrowprops=dict(arrowstyle="->", lw=1.6))ax.set_axis_off()ax.set_xlim(0, 1)ax.set_ylim(0, 1)ax.set_title("DAG lineal: cada flecha es una dependencia de negocio")plt.tight_layout()plt.show()
4) Estado de un nodo
Un orquestador no solo corre funciones. Guarda estado: pendiente, corriendo, ok, fallo, omitido. “Omitido” importa: si validar falla, entrenar no está pendiente: está omitido. Esa distinción es la que evita entrenar con el CSV de ayer.
# Tabla de estados: el plan, todavía sin ejecutar.estados = pd.DataFrame({"nodo": NODOS, "estado": "pendiente", "segundos": np.nan, "detalle": ""})print(estados.to_string(index=False))
       nodo    estado  segundos detalle
    extraer pendiente       NaN
    validar pendiente       NaN
transformar pendiente       NaN
   entrenar pendiente       NaN
  persistir pendiente       NaN
5) Las tareas: cada nodo es una función con contrato
Declaramos funciones que leen y escriben archivos en artefactos_sesion7. El orquestador no “sabe de pandas”: sabe de éxito o excepción. El protocolo de la sesión 6 cabe entero dentro de entrenar.
2026-09-26 07:15:51,043 | INFO | extraer → ok (280 filas extraídas)
2026-09-26 07:15:51,060 | INFO | validar → ok (esquema válido)
2026-09-26 07:15:51,069 | INFO | transformar → ok (280 filas transformadas)
2026-09-26 07:15:51,098 | INFO | entrenar → ok (holdout_acc=0.743)
2026-09-26 07:15:51,102 | INFO | persistir → ok (modelo.joblib)
       nodo estado  segundos                 detalle
    extraer     ok    0.0148     280 filas extraídas
    validar     ok    0.0157          esquema válido
transformar     ok    0.0079 280 filas transformadas
   entrenar     ok    0.0282       holdout_acc=0.743
  persistir     ok    0.0028           modelo.joblib

Holdout del nodo entrenar: 0.7428571428571429
Lectura. Los cinco nodos en ok no son “el notebook corrió”. Son cinco contratos cumplidos en orden legal, con tiempos y un contexto que viaja. persistir no adivinó el modelo: lo tomó de ctx.
7) El fallo es un caso de uso, no un accidente
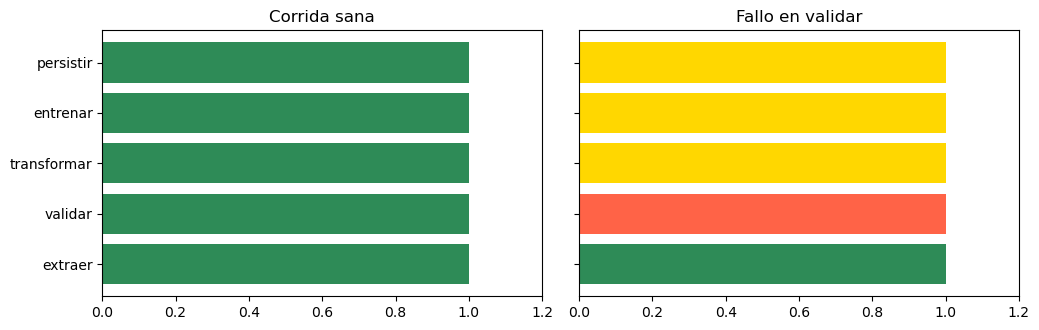
Inyectamos un error en validar. El motor debe omitir transformar, entrenar y persistir. Si persistiera, estaríamos en el escenario del CSV de ayer.
# Misma orquestación, fallo inyectado en validar.bitacora_ko, _ = orquestar(NODOS, ARISTAS, TAREAS, fallar_en="validar")print(bitacora_ko.to_string(index=False))print("\nNodos omitidos:", list(bitacora_ko.loc[bitacora_ko["estado"]=="omitido", "nodo"]))
2026-09-26 07:15:51,120 | INFO | extraer → ok (280 filas extraídas)
2026-09-26 07:15:51,121 | INFO | validar → fallo (fallo inyectado en validar)
       nodo  estado  segundos                     detalle
    extraer      ok    0.0028         280 filas extraídas
    validar   fallo    0.0000  fallo inyectado en validar
transformar omitido       NaN dependencia previa en fallo
   entrenar omitido       NaN dependencia previa en fallo
  persistir omitido       NaN dependencia previa en fallo

Nodos omitidos: ['transformar', 'entrenar', 'persistir']
El amarillo (omitido) es la lección: no es un éxito y no es un reintento. Es la consecuencia de una arista. Airflow llama a esto upstream failed. El nombre cambia; la semántica, no.
8) Reintentos: el fallo transitorio no es el fallo de negocio
Una API que no respondió a la primera no es un esquema inválido. El orquestador distingue:
Error transitorio: red, timeout. Tiene sentido reintentar con espera.
Error de negocio: y no binaria, columna faltante. Reintentar es pegarle a la misma pared.
Un max_reintentos ciego sobre todos los nodos es pereza. Se declara por nodo.
# Reintento solo en extraer (simula una fuente inestable).def extraer_inestable(ctx, caja={"n": 0}): caja["n"] +=1if caja["n"] <3:raiseConnectionError(f"fuente caída (intento {caja['n']})")return extraer(ctx)def correr_con_reintentos(fn, ctx, intentos=3, espera=0.05): ultimo =Nonefor i inrange(1, intentos +1):try:return fn(ctx)exceptConnectionErroras exc: ultimo = exc log.warning("reintento %s/%s: %s", i, intentos, exc) time.sleep(espera)raise ultimoctx_r = {}print(correr_con_reintentos(extraer_inestable, ctx_r))print("Crudo escrito:", ctx_r["crudo"].name)
Si el tercer intento falla, el nodo queda en fallo y el resto se omite. El reintento no autoriza a saltarse validar.
9) Idempotencia: correr dos veces no debe corromper
Un nodo es idempotente si ejecutarlo otra vez, con las mismas entradas, deja el mismo estado observable. extraer que añade filas al CSV no lo es. extraer que sobrescribe el archivo del día, sí (para este laboratorio).
Sin idempotencia, un reintento duplica datos y el modelo de la sesión 6 aprende una población falsa.
# Extraer dos veces: el archivo debe ser el mismo objeto de datos.ctx_a, ctx_b = {}, {}extraer(ctx_a)extraer(ctx_b)h1 = pd.read_csv(ctx_a["crudo"]).to_csv(index=False)h2 = pd.read_csv(ctx_b["crudo"]).to_csv(index=False)print("¿Misma extracción al repetir?:", h1 == h2)print("Filas:", pd.read_csv(ctx_a["crudo"]).shape[0])
¿Misma extracción al repetir?: True
Filas: 280
10) Fan-out y fan-in
Un grafo real se ramifica: tras extraer, perfilar y validar pueden correr en paralelo conceptual; ambas alimentan transformar (fan-in). El orden topológico admite que perfilar y validar estén al mismo “nivel”.
# Grafo con rama: extraer → {validar, perfilar} → transformar → ...NODOS2 = ["extraer", "validar", "perfilar", "transformar", "entrenar", "persistir"]ARISTAS2 = [ ("extraer", "validar"), ("extraer", "perfilar"), ("validar", "transformar"), ("perfilar", "transformar"), ("transformar", "entrenar"), ("entrenar", "persistir"),]print("Un orden legal:", orden_topologico(NODOS2, ARISTAS2))print("Observe que validar y perfilar pueden intercambiarse: no hay arista entre ellos.")
Un orden legal: ['extraer', 'validar', 'perfilar', 'transformar', 'entrenar', 'persistir']
Observe que validar y perfilar pueden intercambiarse: no hay arista entre ellos.
2026-09-26 07:15:51,935 | INFO | extraer → ok (280 filas extraídas)
2026-09-26 07:15:51,941 | INFO | validar → ok (esquema válido)
2026-09-26 07:15:51,947 | INFO | perfilar → ok ({"n": 280, "media_x": -0.02864318009312952, "tasa_y": 0.42142857142857143})
2026-09-26 07:15:51,955 | INFO | transformar → ok (280 filas transformadas)
2026-09-26 07:15:51,974 | INFO | entrenar → ok (holdout_acc=0.743)
2026-09-26 07:15:51,979 | INFO | persistir → ok (modelo.joblib)
       nodo estado  segundos                                                                    detalle
    extraer     ok    0.0031                                                        280 filas extraídas
    validar     ok    0.0049                                                             esquema válido
   perfilar     ok    0.0052 {"n": 280, "media_x": -0.02864318009312952, "tasa_y": 0.42142857142857143}
transformar     ok    0.0070                                                    280 filas transformadas
   entrenar     ok    0.0178                                                          holdout_acc=0.743
  persistir     ok    0.0032                                                              modelo.joblib
En un motor real esas dos ramas podrían ejecutarse en hilos o en máquinas distintas. Aquí se serializan. El concepto de paralelismo es el grado 0 simultáneo, no el threading.
11) Backfill: el mismo grafo, otra ventana de datos
Backfill es volver a correr el DAG sobre fechas pasadas (un mes que se corrigió en origen). El grafo no cambia; cambia el parámetro del nodo extraer (fecha=2024-03-01). Quien hardcodea “hoy” dentro de extraer no puede hacer backfill sin reescribir el flujo.
Eso conecta con la sesión 8: cada corrida de backfill es otro experimento si los datos cambian, y debe tener otro identificador.
# Extraer parametrizado por semilla-fecha: dos ventanas, dos archivos.def extraer_ventana(ctx, semilla): rng = np.random.default_rng(semilla) n =120 df = pd.DataFrame({"x": rng.normal(0, 1, n), "y": rng.integers(0, 2, n)}) ruta = RUTA /f"crudo_{semilla}.csv" df.to_csv(ruta, index=False) ctx["crudo"] = rutareturn ruta.nameprint(extraer_ventana({}, 202401))print(extraer_ventana({}, 202402))print("Dos ventanas = dos entradas. El DAG es el mismo.")
crudo_202401.csv
crudo_202402.csv
Dos ventanas = dos entradas. El DAG es el mismo.
12) Logs: lo que no se escribe no se puede auditar
print no es bitácora. Un log tiene tiempo, nivel y nodo. En producción iría a un agregador. Aquí basta un JSONL: una línea por nodo, apendible, legible por otra herramienta.
# Persistencia de la bitácora sana.ruta_log = RUTA /"bitacora.jsonl"with ruta_log.open("w", encoding="utf-8") as fh:for rec in bitacora_ok.to_dict(orient="records"): fh.write(json.dumps(rec, ensure_ascii=False) +"\n")print(ruta_log.read_text(encoding="utf-8"))
Tres síntomas de que un flujo “aún es un notebook”:
El orden se puede romper reordenando celdas.
Un fallo a mitad de camino deja artefactos a medio escribir y nadie lo registra.
No hay forma de decir “corre solo desde transformar” sin ejecutar a mano lo de arriba.
El DAG responde a los tres: orden legal, estados, y (en motores reales) clear + rerun de un subgrafo. Esta sesión no implementa el rerun parcial; deja enunciada la necesidad.
14) Relación con las sesiones vecinas
Sesión 6: el nodo entrenares el protocolo. El DAG no elige \(C\) mirando un test global.
Sesión 8: cada ejecución del DAG produce una corrida que hay que nombrar (hash de datos, bitácora).
Sesión 9:persistir deja el archivo que el servicio cargará. Sin este nodo, no hay deploy, hay un objeto en RAM.
14b) Camino crítico: dónde se va el tiempo
En un grafo lineal el camino crítico es el grafo entero. En uno con ramas, es el camino más largo. Optimizar un nodo que no está en el crítico no acorta la corrida. El orquestador serio mide; el notebook adivina.
# Tiempos de la corrida sana: el crítico, aquí, es la suma.print(bitacora_ok[["nodo", "segundos", "estado"]].to_string(index=False))print("Suma (camino lineal):", round(bitacora_ok["segundos"].sum(), 4), "s")
       nodo  segundos estado
    extraer    0.0148     ok
    validar    0.0157     ok
transformar    0.0079     ok
   entrenar    0.0282     ok
  persistir    0.0028     ok
Suma (camino lineal): 0.0694 s
14c) Política de fallo: fail-fast frente a best-effort
Fail-fast (lo que implementamos) detiene a los dependientes. Best-effort sigue con las ramas no afectadas: si perfilar falla pero validar no, transformar podría correr si la arista de perfilar se declaró opcional. Las aristas opcionales son una decisión de negocio (“el perfil es deseable, no constitutivo”). Mezclarlas sin declararlas produce workflows que “a veces entrenan”.
# Best-effort didáctico: perfilar falla; validar no. ¿Debe vivir transformar?print("Aristas actuales hacia transformar:", [a for a in ARISTAS2 if a[1] =="transformar"])print("Si perfilar es opcional, la arista perfilar→transformar no es constitutiva.")print("En este laboratorio todas las aristas son constitutivas: fail-fast.")
Aristas actuales hacia transformar: [('validar', 'transformar'), ('perfilar', 'transformar')]
Si perfilar es opcional, la arista perfilar→transformar no es constitutiva.
En este laboratorio todas las aristas son constitutivas: fail-fast.
14d) Dry-run: recorrer el orden sin efectos de lado
Un dry-run calcula el orden y lista artefactos esperados sin escribir. Sirve para revisar un DAG nuevo antes de tocar producción. El motor de esta sesión puede hacerlo: no llama a tareas[nombre].
 orden        nodo        accion
     1     extraer se ejecutaría
     2     validar se ejecutaría
     3    perfilar se ejecutaría
     4 transformar se ejecutaría
     5    entrenar se ejecutaría
     6   persistir se ejecutaría
14e) Contexto (XCom): lo que viaja entre nodos
ctx es un diccionario. En Airflow se llama XCom. El riesgo es usarlo como disco oculto: pasar un DataFrame de un millón de filas por contexto en lugar de escribir listo.csv. La regla: el contexto lleva punteros (rutas, hashes, métricas chicas), no poblaciones.
# El contexto sano de la primera corrida: punteros, no la matriz.punteros = {k: (str(v) ifnothasattr(v, "predict") elsetype(v).__name__) for k, v in ctx_ok.items()}print(json.dumps(punteros, indent=2, ensure_ascii=False))
14f) Timeout: un nodo que no termina también falla
Un entrenar colgado no es ok. Un orquestador real mata el proceso al superar un presupuesto de tiempo. Aquí solo enunciamos la métrica: si segundos > umbral, el estado debería ser fallo por timeout, no un kernel ocupado sin bitácora.
# Umbral didáctico sobre la bitácora ya medida.umbral =2.0tarde = bitacora_ok.loc[bitacora_ok["segundos"] > umbral, "nodo"]print(f"Umbral {umbral}s. Nodos que lo superarían:", list(tarde) or"(ninguno en este laboratorio)")
Umbral 2.0s. Nodos que lo superarían: (ninguno en este laboratorio)
14g) Rerun parcial: la promesa que el notebook no puede cumplir
“Corre desde transformar” exige que crudo.csv y el resultado de validar sigan vigentes. El DAG lo permite si los artefactos de upstream existen y sus estados son ok. Un notebook obliga a recordar qué celdas ya corrieron. El taller D, si se hizo mal, deja un CSV duplicado: un rerun parcial amplificaría el error. Por eso idempotencia y rerun van juntos.
14h) De este motor a Airflow / Prefect / Dagster
Concepto de esta sesión
Nombre habitual en un motor
Nodo
Task / operator
Arista
>> / dependency
Orden topológico
Scheduler
omitido
upstream failed
Reintento
retries
Bitácora
logs + metadata DB
ctx
XCom
Backfill
backfill / catchup
Instalar el motor sin estos conceptos produce YAML decorado. Con ellos, el motor es un detalle de implementación.
14i) Semántica de ‘ok’: el nodo terminó, no ‘el modelo es bueno’
Un entrenar en ok significa que el fit no lanzó. No significa que el F1 de la sesión 6 sea publicable. Mezclar ambos es cómo un DAG verde termina promoviendo un modelo inútil al registry (sesión 8). El orquestador certifica ejecución; el protocolo certifica elección.
14j) Contratos de artefacto entre nodos
# Lo que cada nodo deja en disco: el DAG también es un sistema de archivos.print("Esperado:")print(" extraer → crudo.csv")print(" validar → (nada, o un sello ok.json)")print(" transformar → listo.csv")print(" entrenar → (objeto en ctx)")print(" persistir → modelo.joblib")print("Presente:", sorted(p.name for p in RUTA.iterdir()))
Esperado:
  extraer     → crudo.csv
  validar     → (nada, o un sello ok.json)
  transformar → listo.csv
  entrenar    → (objeto en ctx)
  persistir   → modelo.joblib
Presente: ['bitacora.jsonl', 'crudo.csv', 'crudo_202401.csv', 'crudo_202402.csv', 'listo.csv', 'modelo.joblib', 'perfil.json']
Encadenar funciones con if sueltos y llamar a eso “Airflow”.
Reintentar un error de esquema.
Escribir en el mismo CSV con append y llamar a eso extraer.
Entrenar aunque validar haya fallado.
Meter el GridSearchCVfuera del nodo y “ya orquesté”.
Hardcodear “hoy” y no poder hacer backfill.
Confundir el orden de las celdas con un orden topológico.
16) Checklist
¿Cada arista es una dependencia de negocio, no un hábito?
¿Un ciclo se detecta (no se cuelga)?
¿Un fallo omite a los dependientes?
¿Los reintentos están acotados y tipados?
¿Repetir extraer no duplica filas?
¿La bitácora sobrevive al kernel?
16b) Una frase para el examen oral
“El pipeline predice una fila; el DAG decide si esa predicción tiene derecho a existir hoy.” Si el estudiante no puede decirla, aún confunde la sesión 5 con esta.
17) Conclusiones
Orquestar es imponer un orden legal y un estado explícito a trabajos que, en el laboratorio, eran celdas. El DAG no reemplaza el protocolo de la sesión 6: lo alojan. Extraer, validar, transformar, entrenar y persistir dejan de ser un relato y pasan a ser nodos con vecinos, tiempos y una bitácora.
La sesión 8 preguntará si esta ejecución del grafo es la misma que la del martes.
18) Taller práctico
A. Añada un nodo evaluar entre entrenar y persistir que escriba métricas en JSON. Actualice aristas y corra el motor.
B. Inyecte un fallo en transformar. Confirme que entrenar queda omitido.
C. Construya un ciclo a propósito (persistir → extraer) y capture el ValueError.
D. Haga extraer no idempotente (mode a de append) y muestre que la segunda corrida cambia \(n\). Luego corríjalo.
E. Declare perfilar y validar en paralelo conceptual. Escriba dos órdenes topológicos distintos y legales.
# Espacio de taller.print("Orden actual:", orden_topologico(NODOS, ARISTAS))print("Archivos:", sorted(p.name for p in RUTA.iterdir()))print("Resuelva A–E. Si el entrenamiento corre tras un validar en fallo, el DAG es decorativo.")
Orden actual: ['extraer', 'validar', 'transformar', 'entrenar', 'persistir']
Archivos: ['bitacora.jsonl', 'crudo.csv', 'crudo_202401.csv', 'crudo_202402.csv', 'listo.csv', 'modelo.joblib', 'perfil.json']
Resuelva A–E. Si el entrenamiento corre tras un validar en fallo, el DAG es decorativo.
💬 ¿Te sirvió?
Deja en los comentarios una duda o un caso donde aplicarías esto — respondo todos. Sígueme para no perderte el próximo artículo de la serie y comparte con alguien que esté aprendiendo arquitectura de IA.
👉 El código completo está disponible para ejecutar directamente.