5 Pipelines reproducibles
mlops
pipelines
reproducibilidad
joblib
Serie MLOps y Producción · de la ingeniería de datos al monitoreo.
El problema que vas a resolver
Una empresa de mensajería quiere saber, en el momento en que recibe un paquete, si ese envío va a llegar tarde. Con esa alerta puede cambiarlo de ruta o avisar al cliente antes de que reclame.
En el capítulo anterior aprendiste a preparar columnas: rellenar vacíos, escalar números y convertir categorías en columnas. Aquí aparece un problema distinto. Esas preparaciones viven hoy en celdas sueltas de un notebook. Funcionan el día que las escribes, pero:
- es fácil ejecutarlas en el orden equivocado y “colar” información del examen en el entrenamiento;
- cuando llega un envío nuevo, alguien tiene que repetir a mano cada paso, con los mismos valores;
- si otra persona abre el modelo en otro computador, no sabe qué pasos aplicar antes de predecir.
La solución es empaquetar todos los pasos y el modelo en un solo objeto: un pipeline. Lo vas a construir en dos tiempos. Primero con seis envíos y cuentas que puedes hacer con lápiz. Después con 600 envíos y scikit-learn, guardando el resultado en un archivo que cualquiera puede volver a abrir.
| Pregunta del capítulo | ¿Cómo garantizo que mi modelo se entrena sin trampa y se usa exactamente igual en producción? |
| Datos | 6 envíos de juguete y 600 envíos sintéticos (distancia, peso, tipo de servicio) |
| Herramientas | Python, pandas, scikit-learn, joblib |
| Lo que produces | Un archivo pipeline_envios.joblib y un registro registro_corrida.json |
Objetivos de aprendizaje
Al terminar este capítulo podrás:
- Explicar qué es un pipeline usando una analogía de línea de producción.
- Distinguir lo que un paso aprende (
fit) de lo que aplica (transform,predict). - Reconocer la fuga de datos y mostrar con números cómo cambia una predicción.
- Construir un
Pipelinede scikit-learn conColumnTransformerpara columnas numéricas y categóricas, y seguir un envío por cada estación. - Escribir un paso propio con
fitytransformy usarlo dentro del pipeline. - Guardar el pipeline completo con
joblib, recargarlo y obtener las mismas predicciones. - Validar los datos de entrada y dejar un registro mínimo de cada entrenamiento.
TipLo que necesitas recordar
- ETL: extraer, transformar y cargar datos en pasos ordenados. Lo viste en Fundamentos de ETL.
- Valores faltantes e imputación: rellenar un vacío con un valor razonable, como el promedio. Lo viste en Calidad del dato.
- Escalamiento, one-hot, partición entrenamiento/prueba, regresión logística y F1: los viste en Feature engineering.
Si alguno de estos términos no te suena, repásalo antes de seguir: el capítulo los usa sin volver a explicarlos.
1) Un pipeline es una línea de producción
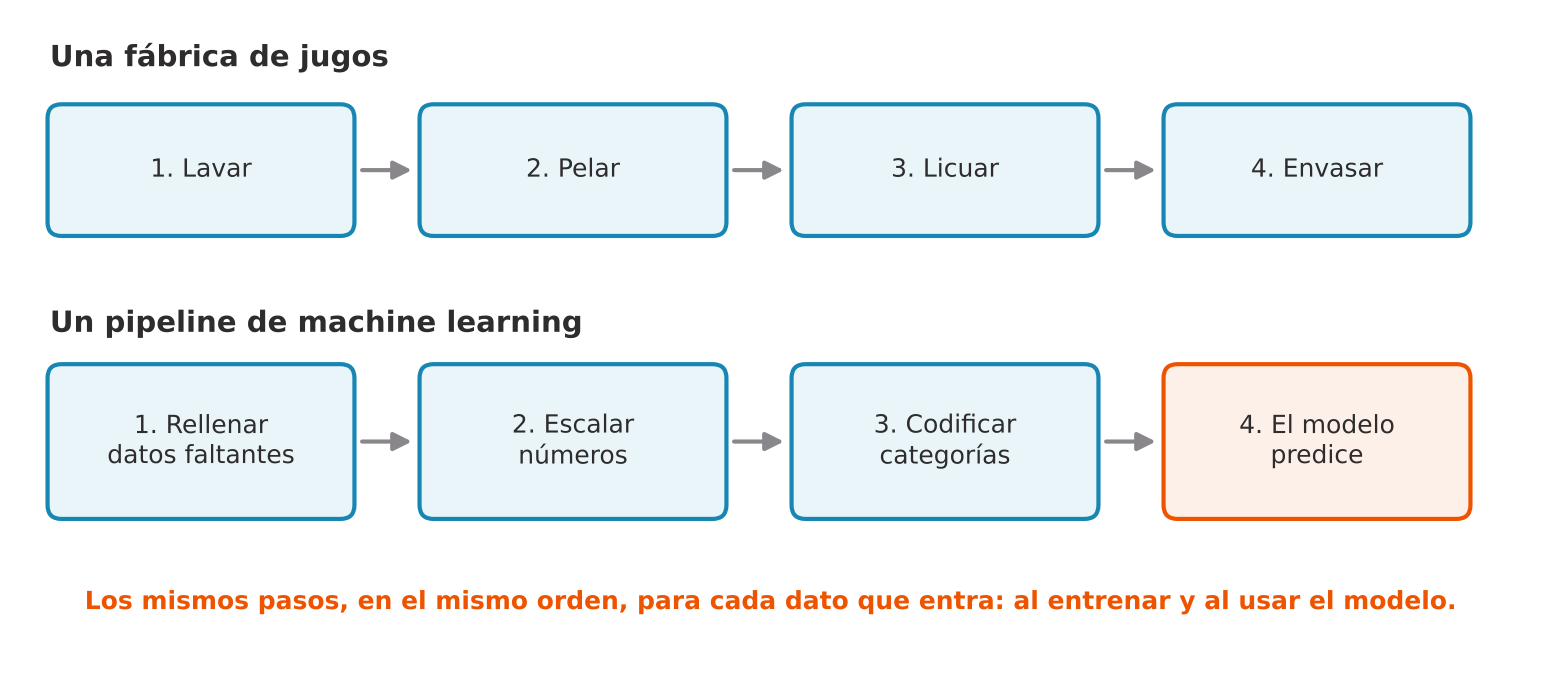
Piensa en una fábrica de jugos. La fruta entra por un extremo y pasa siempre por las mismas estaciones, en el mismo orden: lavar, pelar, licuar, envasar. Nadie licúa antes de pelar, y la fruta del martes recibe exactamente el mismo trato que la del lunes.
Un pipeline de machine learning hace lo mismo con los datos. Cada envío pasa por las mismas estaciones antes de llegar al modelo.
NotaPipeline
Una secuencia fija de pasos que transforma los datos y termina en un modelo. Se entrena como un solo objeto y se usa como un solo objeto: recibe datos crudos y devuelve una predicción.
NotaReproducibilidad
Que otra persona, otro día y en otro computador, pueda repetir tu trabajo y obtener los mismos resultados. Para lograrlo necesita los mismos datos, los mismos pasos, la misma semilla y las mismas versiones de las librerías.
Si ya conoces los ETL, vas por buen camino. Un pipeline de machine learning se parece mucho, con una diferencia importante:
| ETL | Pipeline de machine learning | |
|---|---|---|
| Qué hace cada paso | Aplica una regla fija (por ejemplo, convertir pesos a kilos) | Algunos pasos aprenden algo de los datos (por ejemplo, el peso promedio) |
| Qué produce | Una tabla limpia | Una predicción |
| Qué hay que guardar | El código | El código y lo que cada paso aprendió |
En pocas palabras: un pipeline de machine learning es un ETL en el que algunos pasos aprenden. Esa diferencia es la fuente de casi todos los problemas de este capítulo.
2) Un pipeline de juguete, a mano
Antes de usar cualquier librería, construyamos un pipeline con seis envíos y Python puro. Los números son pequeños a propósito para que puedas comprobar cada cuenta.
Cuatro envíos sirven para entrenar (A, B, C, D) y dos quedan para probar (E, F). Al envío C y al envío F les falta el peso.
import numpy as np
import pandas as pd

envios = pd.DataFrame({
    "envio": ["A", "B", "C", "D", "E", "F"],
    "distancia_km": [100, 300, 200, 400, 250, 200],
    "peso_kg": [2.0, 6.0, np.nan, 4.0, 20.0, np.nan],
    "grupo": ["entrenamiento"] * 4 + ["prueba"] * 2,
})
envios| envio | distancia_km | peso_kg | grupo | |
|---|---|---|---|---|
| 0 | A | 100 | 2.0 | entrenamiento |
| 1 | B | 300 | 6.0 | entrenamiento |
| 2 | C | 200 | NaN | entrenamiento |
| 3 | D | 400 | 4.0 | entrenamiento |
| 4 | E | 250 | 20.0 | prueba |
| 5 | F | 200 | NaN | prueba |
Nuestro pipeline de juguete tiene dos pasos:
- Rellenar el peso faltante con el peso promedio. Este paso aprende algo: el promedio.
- Decidir: calcular un puntaje
distancia / 100 + peso / 4. Si el puntaje es 4 o más, el envío se marca como “llega tarde”. Esta regla es fija; en un modelo real, la regla también se aprendería.
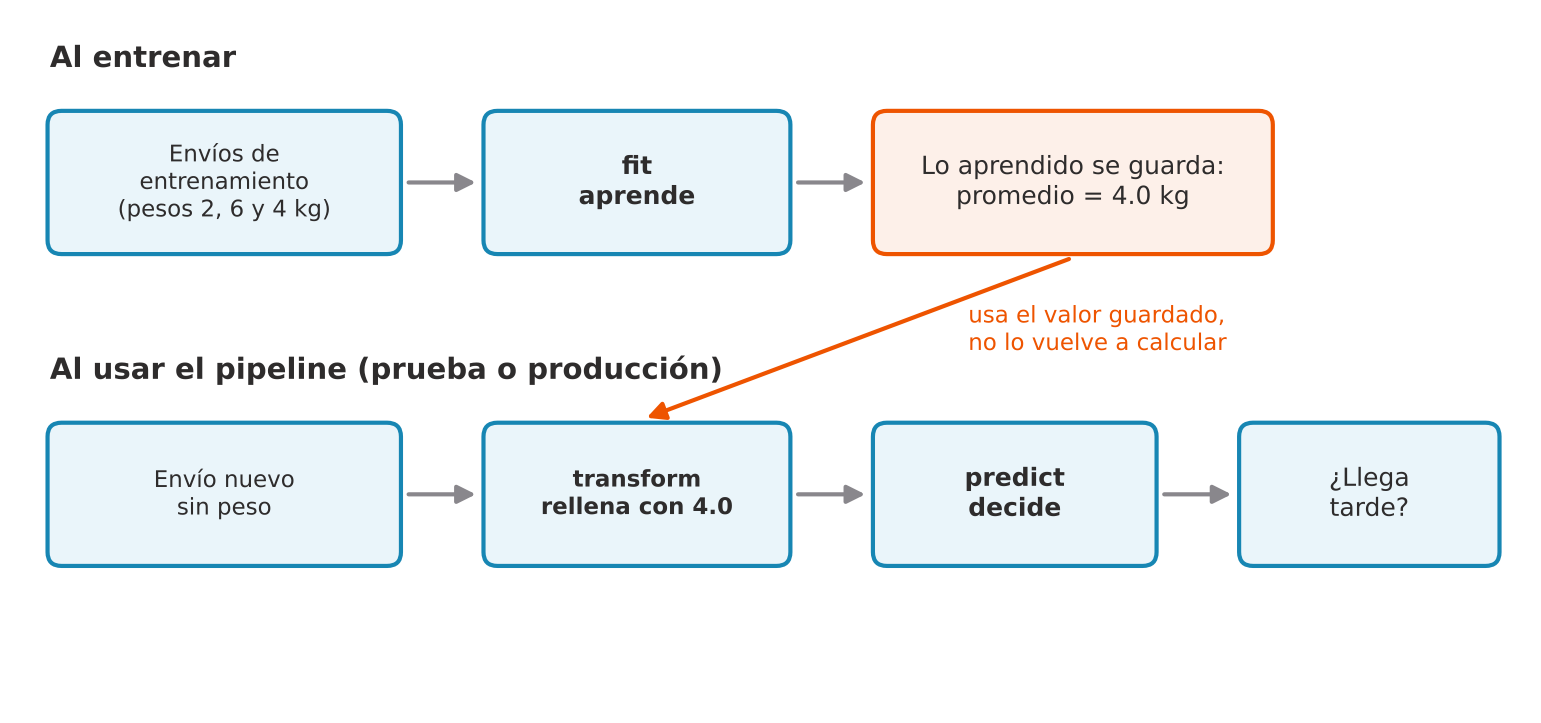
Escribamos el primer paso como una pequeña clase con dos métodos. fit mira los datos de entrenamiento y guarda el promedio. transform usa ese promedio guardado para rellenar vacíos en cualquier tabla que le pasen.
class RellenarConPromedio:
    """Paso que aprende el peso promedio y lo usa para rellenar vacíos."""

    def fit(self, tabla):
        # Aprende: calcula el promedio SOLO con la tabla que recibe
        self.promedio_ = tabla["peso_kg"].mean()
        return self

    def transform(self, tabla):
        # Aplica: rellena con el promedio que ya aprendió, sin recalcularlo
        copia = tabla.copy()
        copia["peso_kg"] = copia["peso_kg"].fillna(self.promedio_)
        return copia


def decidir(tabla):
    """Paso fijo: puntaje = distancia/100 + peso/4; tarde si el puntaje es 4 o más."""
    puntaje = tabla["distancia_km"] / 100 + tabla["peso_kg"] / 4
    return tabla.assign(puntaje=puntaje, llega_tarde=(puntaje >= 4).astype(int))


entrenamiento = envios[envios["grupo"] == "entrenamiento"]
prueba = envios[envios["grupo"] == "prueba"]

rellenar = RellenarConPromedio().fit(entrenamiento)
print("Promedio aprendido con A, B y D:", rellenar.promedio_, "kg")
decidir(rellenar.transform(prueba))
Promedio aprendido con A, B y D: 4.0 kg| envio | distancia_km | peso_kg | grupo | puntaje | llega_tarde | |
|---|---|---|---|---|---|---|
| 4 | E | 250 | 20.0 | prueba | 7.5 | 1 |
| 5 | F | 200 | 4.0 | prueba | 3.0 | 0 |
El paso aprendió un promedio de 4.0 kg con los envíos A, B y D: (2 + 6 + 4) / 3. El envío C no cuenta porque no tiene peso. Con ese valor, F recibe 4.0 kg, su puntaje queda en 200/100 + 4.0/4 = 3.0 y el pipeline dice que llega a tiempo. E pesa 20 kg y su puntaje de 7.5 lo marca como tardío sin necesidad de rellenar nada.
Notafit, transform y predict
Son los tres verbos de todo pipeline. fit significa “aprende de estos datos” y solo se usa con los datos de entrenamiento. transform significa “aplica lo que aprendiste” y se usa con cualquier dato: entrenamiento, prueba o producción. predict es el transform del último paso: el modelo devuelve su respuesta.
La trampa: aprender con los datos de prueba
Ahora repitamos todo con un error muy común: calcular el promedio con todos los envíos, incluidos E y F, que se suponía que eran el examen.
rellenar_con_trampa = RellenarConPromedio().fit(envios)  # incluye E y F
print("Promedio aprendido con A, B, D y E:", rellenar_con_trampa.promedio_, "kg")
decidir(rellenar_con_trampa.transform(prueba))
Promedio aprendido con A, B, D y E: 8.0 kg| envio | distancia_km | peso_kg | grupo | puntaje | llega_tarde | |
|---|---|---|---|---|---|---|
| 4 | E | 250 | 20.0 | prueba | 7.5 | 1 |
| 5 | F | 200 | 8.0 | prueba | 4.0 | 1 |
El promedio subió de 4.0 a 8.0 kg porque ahora incluye los 20 kg de E, un envío del examen. Con ese relleno, F pasa a pesar 8.0 kg, su puntaje sube a 4.0 y cambia la decisión: ahora “llega tarde”. Nada en el código dio error. Solo cambió el orden en que se aprendió el promedio, y eso bastó para cambiar una predicción.
NotaFuga de datos (data leakage)
Ocurre cuando información de los datos de prueba se cuela en el entrenamiento, aunque sea a través de algo tan inocente como un promedio. El modelo parece mejor de lo que es, porque en cierto modo ya vio el examen. En producción esa información no existe y el rendimiento cae.
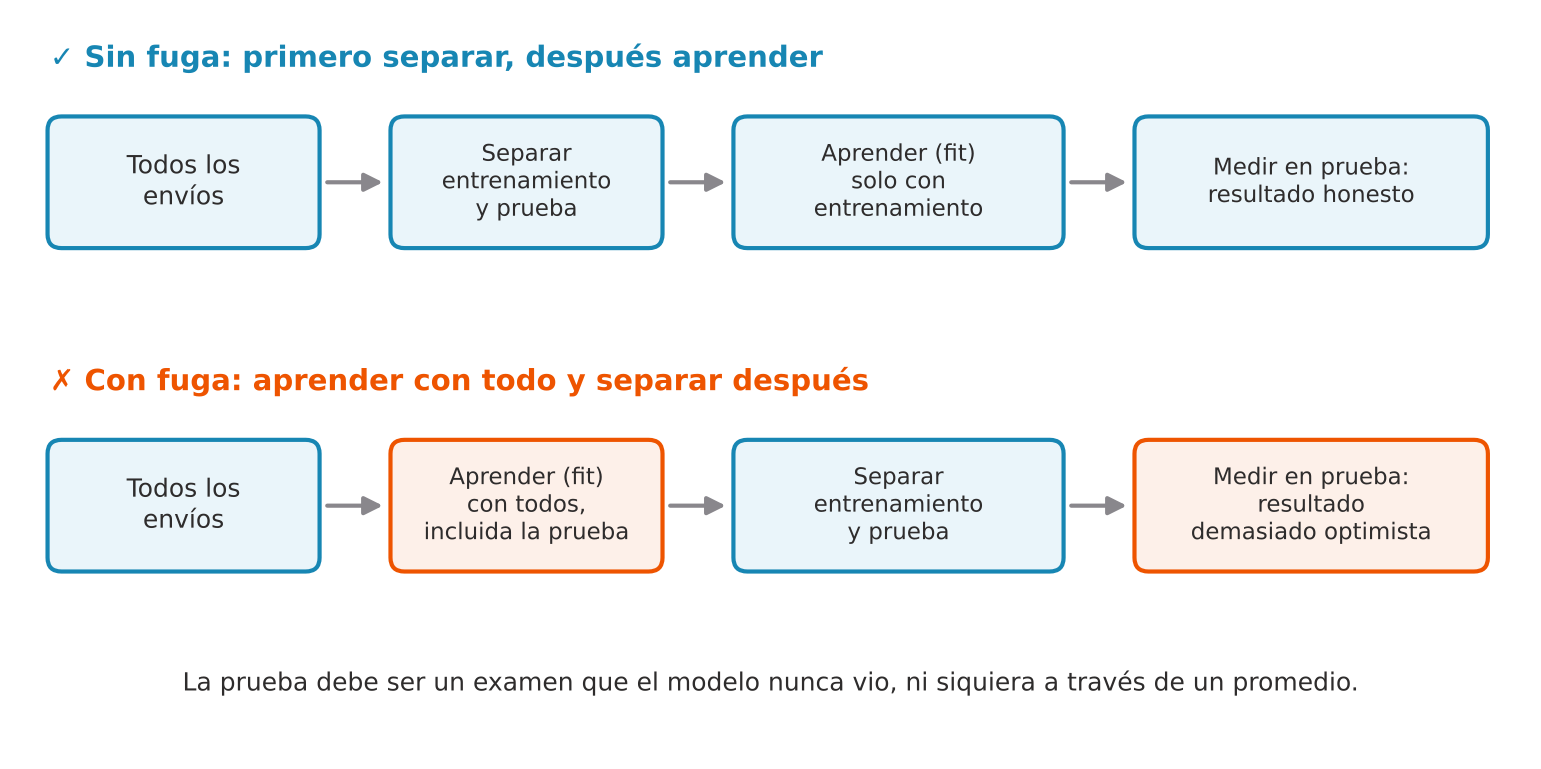
La regla que protege de la fuga es corta: primero separas, después haces fit, y fit solo ve entrenamiento. Un pipeline te ayuda a cumplirla sin pensar, porque todos los pasos aprenden juntos en una sola llamada a fit.
3) El mismo paso con scikit-learn
Nuestra clase RellenarConPromedio ya existe en scikit-learn: se llama SimpleImputer. Tiene los mismos dos métodos y guarda lo aprendido en un atributo que termina en guion bajo (statistics_), igual que nuestro promedio_.
from sklearn.impute import SimpleImputer

imputador = SimpleImputer(strategy="mean").fit(entrenamiento[["peso_kg"]])
print("Promedio aprendido por scikit-learn:", imputador.statistics_[0], "kg")
print("Pesos de prueba rellenados:", imputador.transform(prueba[["peso_kg"]]).ravel())
Promedio aprendido por scikit-learn: 4.0 kg
Pesos de prueba rellenados: [20. 4.]SimpleImputer aprendió el mismo 4.0 kg que calculamos a mano y rellenó el peso de F con ese valor; el de E, que sí tenía peso, se quedó en 20. A partir de aquí, cada paso de scikit-learn funciona igual que nuestra clase: fit guarda algo, transform lo usa.
4) El caso completo: 600 envíos
Pasemos a un conjunto más realista. Generamos 600 envíos sintéticos con tres columnas que la empresa conoce al recibir el paquete:
distancia_km: distancia hasta el destino;peso_kg: peso del paquete; falta en cerca del 10 % de los envíos porque la báscula no siempre registra;servicio:express,estándaroeconómico.
La columna llega_tarde vale 1 si el envío llegó tarde. En los datos simulados, los envíos largos, pesados y de servicio económico tienen más probabilidad de llegar tarde.
Todo el capítulo usa una única semilla, SEMILLA = 42. Una semilla fija los números “al azar” que genera el computador: con la misma semilla, los mismos datos y la misma partición en cualquier máquina.
import warnings
from importlib.metadata import version
import sklearn

warnings.filterwarnings("ignore", category=FutureWarning)

SEMILLA = 42
print("pandas", pd.__version__, "| scikit-learn", sklearn.__version__, "| joblib", version("joblib"))

rng = np.random.default_rng(SEMILLA)
n = 600
distancia = rng.gamma(2.0, 150, n).round(1)
peso = rng.lognormal(1.2, 0.6, n).round(2)
servicio = rng.choice(["express", "estándar", "económico"], size=n, p=[0.25, 0.5, 0.25])
efecto_servicio = pd.Series(servicio).map({"express": -1.0, "estándar": 0.0, "económico": 0.9}).to_numpy()
logit = -1.2 + 0.0035 * (distancia - 300) + 0.12 * (peso - 4) + efecto_servicio
llega_tarde = (rng.random(n) < 1 / (1 + np.exp(-logit))).astype(int)

peso_registrado = peso.copy()
peso_registrado[rng.random(n) < 0.10] = np.nan

datos = pd.DataFrame({
    "distancia_km": distancia,
    "peso_kg": peso_registrado,
    "servicio": servicio,
    "llega_tarde": llega_tarde,
})
print("Envíos:", len(datos), "| pesos faltantes:", datos["peso_kg"].isna().sum(),
      "| porcentaje que llega tarde:", round(100 * datos["llega_tarde"].mean(), 1), "%")
datos.head()
pandas 3.0.5 | scikit-learn 1.9.1 | joblib 1.6.0
Envíos: 600 | pesos faltantes: 67 | porcentaje que llega tarde: 24.3 %| distancia_km | peso_kg | servicio | llega_tarde | |
|---|---|---|---|---|
| 0 | 313.8 | 1.76 | express | 0 |
| 1 | 425.3 | 1.50 | estándar | 0 |
| 2 | 275.6 | 2.48 | estándar | 1 |
| 3 | 246.8 | 4.27 | estándar | 0 |
| 4 | 461.9 | 3.12 | estándar | 0 |
Hay 600 envíos, a 67 les falta el peso (poco más del 10 %) y el 24.3 % llega tarde. Eso significa que la mayoría llega a tiempo: un modelo que dijera siempre “a tiempo” acertaría tres de cada cuatro veces. Por eso, al medir, compararemos el modelo con esa línea base.
Separar antes de cualquier otra cosa
Siguiendo la regla de la sección 2, lo primero es separar. Usamos train_test_split con dos detalles:
random_state=SEMILLApara que la partición sea siempre la misma;stratify=ypara que entrenamiento y prueba tengan la misma proporción de envíos tardíos.
NotaPartición estratificada
Una forma de separar los datos que conserva la proporción de cada clase en ambos grupos. Si el 24 % de los envíos llega tarde, cerca del 24 % de entrenamiento y del 24 % de prueba también llegará tarde.
from sklearn.model_selection import train_test_split

X = datos[["distancia_km", "peso_kg", "servicio"]]
y = datos["llega_tarde"]

X_ent, X_pru, y_ent, y_pru = train_test_split(
    X, y, test_size=0.25, random_state=SEMILLA, stratify=y
)
print("Entrenamiento:", len(X_ent), "envíos | prueba:", len(X_pru), "envíos")
print("Proporción tarde en entrenamiento:", round(y_ent.mean(), 3))
print("Proporción tarde en prueba:       ", round(y_pru.mean(), 3))
Entrenamiento: 450 envíos | prueba: 150 envíos
Proporción tarde en entrenamiento: 0.244
Proporción tarde en prueba: 0.24Quedan 450 envíos para entrenar y 150 para probar. La proporción de envíos tardíos es casi idéntica en ambos grupos (0.244 y 0.240), que es justo lo que pide la estratificación.
¿Qué pasa si no estratificamos? Probemos 30 semillas distintas y miremos cuánto varía la proporción de envíos tardíos en prueba.
sin_estratificar, con_estratificar = [], []
for semilla in range(30):
    sin_estratificar.append(train_test_split(X, y, test_size=0.25, random_state=semilla)[3].mean())
    con_estratificar.append(train_test_split(X, y, test_size=0.25, random_state=semilla, stratify=y)[3].mean())

print(f"Sin estratificar: entre {min(sin_estratificar):.1%} y {max(sin_estratificar):.1%}")
print(f"Estratificando:   entre {min(con_estratificar):.1%} y {max(con_estratificar):.1%}")
Sin estratificar: entre 19.3% y 30.0%
Estratificando: entre 24.0% y 24.7%Sin estratificar, según la semilla, la prueba puede tener desde un 19.3 % hasta un 30.0 % de envíos tardíos: el examen sería más fácil o más difícil por pura suerte. Estratificando, la proporción se mantiene entre 24.0 % y 24.7 % con cualquier semilla.
TipCuando el tiempo importa
Aquí separamos al azar porque los envíos simulados no tienen fecha. Con datos reales conviene entrenar con los envíos más antiguos y probar con los más recientes, porque así es como se usará el modelo: aprenderá del pasado para predecir el futuro.
5) Tres formas de colar el examen en el entrenamiento
Con el ejemplo de juguete vimos la fuga en un promedio. Veámosla ahora en los tres pasos de preparación más comunes. En cada caso comparamos lo que el paso aprende con todos los datos (mal) y solo con entrenamiento (bien).
Escalar con todos los datos
from sklearn.preprocessing import OneHotEncoder, StandardScaler

media_todos = StandardScaler().fit(X[["distancia_km"]]).mean_[0]
media_ent = StandardScaler().fit(X_ent[["distancia_km"]]).mean_[0]
print(f"Media de distancia aprendida con todos:      {media_todos:.2f} km")
print(f"Media de distancia aprendida con entrenamiento: {media_ent:.2f} km")
Media de distancia aprendida con todos: 295.27 km
Media de distancia aprendida con entrenamiento: 300.92 kmCon todos los datos, el escalador aprende una media de 295.27 km; solo con entrenamiento, 300.92 km. Esa diferencia de casi 6 km viene únicamente de los 150 envíos de prueba, que el escalador no debería haber visto.
Rellenar faltantes con todos los datos
promedio_todos = SimpleImputer(strategy="mean").fit(X[["peso_kg"]]).statistics_[0]
promedio_ent = SimpleImputer(strategy="mean").fit(X_ent[["peso_kg"]]).statistics_[0]
print(f"Peso promedio aprendido con todos:         {promedio_todos:.3f} kg")
print(f"Peso promedio aprendido con entrenamiento: {promedio_ent:.3f} kg")
Peso promedio aprendido con todos: 3.878 kg
Peso promedio aprendido con entrenamiento: 3.882 kgAquí la diferencia es mínima: 3.878 kg frente a 3.882 kg. En el ejemplo de juguete fue de 4.0 a 8.0 kg porque un solo paquete de prueba muy pesado movió el promedio. El tamaño de la fuga depende de los datos, y eso es justo lo que la hace difícil de detectar.
Codificar categorías con todos los datos
Imaginemos que la empresa lanzó hace poco el servicio mismo día. Por eso solo aparece en los envíos más recientes, que quedaron en prueba. Simulamos ese caso cambiando cinco envíos de prueba.
X_pru_nuevo = X_pru.copy()
X_pru_nuevo.iloc[:5, X_pru_nuevo.columns.get_loc("servicio")] = "mismo día"

codificador_todos = OneHotEncoder().fit(pd.concat([X_ent, X_pru_nuevo])[["servicio"]])
codificador_ent = OneHotEncoder(handle_unknown="ignore").fit(X_ent[["servicio"]])

print("Categorías aprendidas con todos:         ", list(codificador_todos.categories_[0]))
print("Categorías aprendidas con entrenamiento: ", list(codificador_ent.categories_[0]))

ejemplo = X_pru_nuevo[["servicio"]].head(1)
print("\nEnvío con 'mismo día' codificado solo con lo aprendido en entrenamiento:")
print(pd.DataFrame(codificador_ent.transform(ejemplo).toarray(),
                   columns=codificador_ent.get_feature_names_out()))
Categorías aprendidas con todos: ['económico', 'estándar', 'express', 'mismo día']
Categorías aprendidas con entrenamiento: ['económico', 'estándar', 'express']
Envío con 'mismo día' codificado solo con lo aprendido en entrenamiento:
servicio_económico servicio_estándar servicio_express
0 0.0 0.0 0.0El codificador entrenado con todos conoce cuatro servicios, incluido mismo día, que solo existe en prueba: el modelo tendría una columna preparada para algo que nunca vio en entrenamiento. El codificador honesto conoce tres servicios y, gracias a handle_unknown="ignore", convierte el envío mismo día en una fila de tres ceros sin detenerse.
NotaCategoría no vista
Un valor de una columna categórica que no apareció en entrenamiento, como mismo día. Con handle_unknown="ignore", el codificador lo convierte en una fila de ceros en lugar de detener el programa: el modelo lo trata como “ninguno de los servicios que conozco”.
| Paso | Qué aprende | Cómo se cuela la prueba si haces fit con todo |
|---|---|---|
| Escalar | Media y desviación de cada número | La media incluye las distancias del examen |
| Rellenar | Promedio de cada columna | El valor de relleno incluye los pesos del examen |
| Codificar | Lista de categorías | El modelo “conoce” un servicio que solo existía en el examen |
Las diferencias en estos 600 envíos son pequeñas. El problema es que no sabes de antemano si en tus datos serán pequeñas o grandes, como en el ejemplo de juguete, donde cambiaron la decisión sobre el envío F. La única forma segura es no permitir la fuga nunca.
6) El pipeline completo con scikit-learn
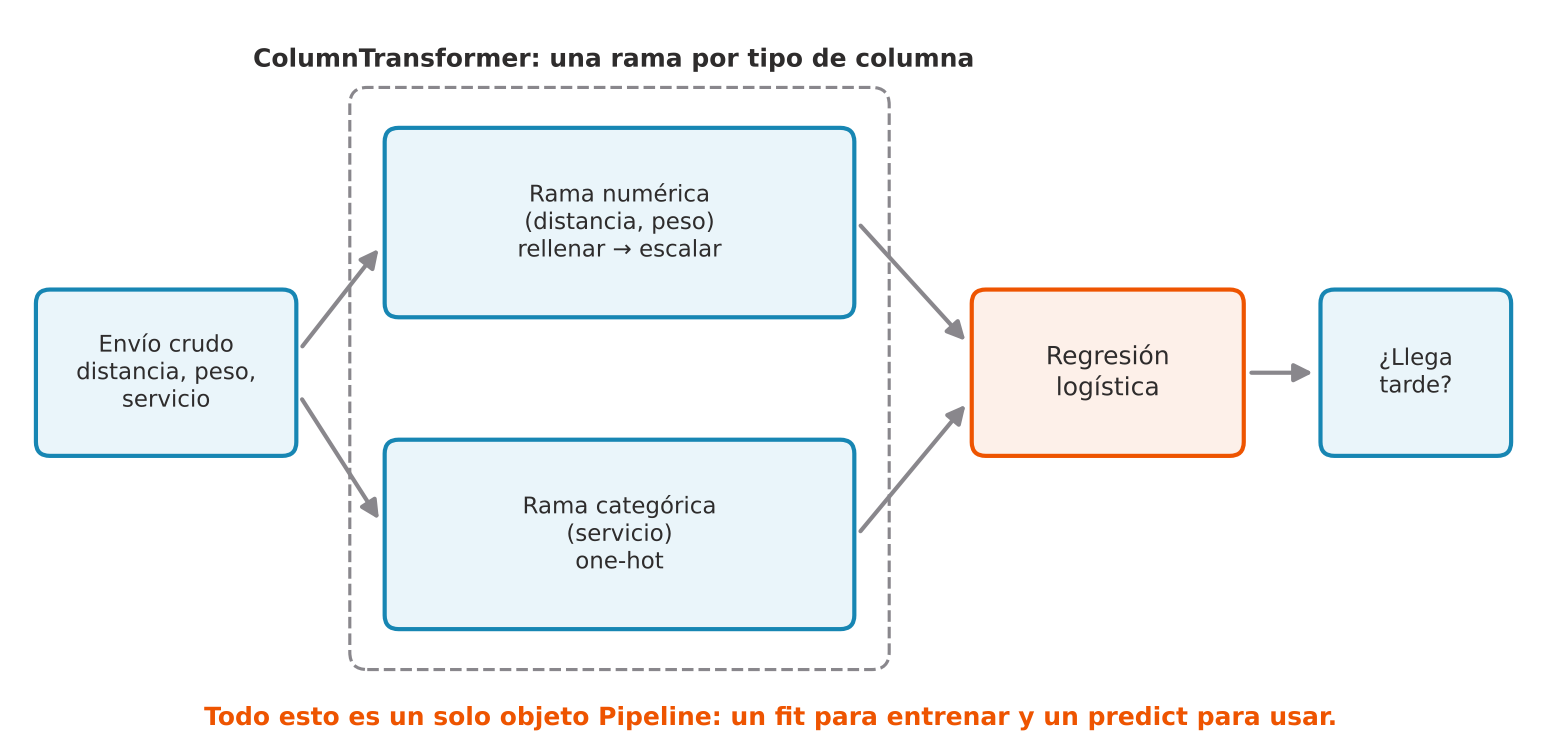
Las columnas de los envíos no son todas iguales. Las numéricas necesitan rellenar y escalar; la categórica necesita one-hot. ColumnTransformer resuelve esto: aplica una “rama” de pasos a cada grupo de columnas y une los resultados.
NotaColumnTransformer
Un paso de scikit-learn que reparte las columnas en grupos, aplica a cada grupo su propia preparación y vuelve a juntar todo en una sola tabla numérica para el modelo.
from sklearn.compose import ColumnTransformer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline

COLUMNAS_NUMERICAS = ["distancia_km", "peso_kg"]
COLUMNAS_CATEGORICAS = ["servicio"]

rama_numerica = Pipeline([
    ("rellenar", SimpleImputer(strategy="mean")),
    ("escalar", StandardScaler()),
])

preparar = ColumnTransformer([
    ("numericas", rama_numerica, COLUMNAS_NUMERICAS),
    ("categoricas", OneHotEncoder(handle_unknown="ignore"), COLUMNAS_CATEGORICAS),
])

pipeline = Pipeline([
    ("preparar", preparar),
    ("modelo", LogisticRegression(max_iter=1000)),
])

pipeline.fit(X_ent, y_ent)  # un solo fit: todos los pasos aprenden solo con entrenamiento
pipeline
Pipeline(steps=[('preparar',
ColumnTransformer(transformers=[('numericas',
Pipeline(steps=[('rellenar',
SimpleImputer()),
('escalar',
StandardScaler())]),
['distancia_km', 'peso_kg']),
('categoricas',
OneHotEncoder(handle_unknown='ignore'),
['servicio'])])),
('modelo', LogisticRegression(max_iter=1000))])In a Jupyter environment, please rerun this cell to show the HTML representation or trust the notebook. On GitHub, the HTML representation is unable to render, please try loading this page with nbviewer.org.
Parameters
Fitted attributes
Parameters
Fitted attributes
['distancia_km', 'peso_kg']
Parameters
Fitted attributes
2 features
| distancia_km |
| peso_kg |
Parameters
Fitted attributes
2 features
| x0 |
| x1 |
['servicio']
Parameters
Fitted attributes
3 features
| servicio_económico |
| servicio_estándar |
| servicio_express |
5 features
| numericas__distancia_km |
| numericas__peso_kg |
| categoricas__servicio_económico |
| categoricas__servicio_estándar |
| categoricas__servicio_express |
Parameters
Fitted attributes
Una sola llamada a fit entrenó los tres pasos de preparación y el modelo, en orden y solo con entrenamiento. Midamos en prueba.
from sklearn.metrics import accuracy_score, f1_score

prediccion = pipeline.predict(X_pru)
exactitud = accuracy_score(y_pru, prediccion)
f1 = f1_score(y_pru, prediccion)
linea_base = 1 - y_pru.mean()  # exactitud de decir siempre "no llega tarde"

print(f"Exactitud en prueba: {exactitud:.3f}")
print(f"F1 en prueba:        {f1:.3f}")
print(f"Exactitud de decir siempre 'a tiempo': {linea_base:.3f}")
Exactitud en prueba: 0.813
F1 en prueba: 0.462
Exactitud de decir siempre 'a tiempo': 0.760El pipeline acierta en el 81.3 % de los envíos de prueba, frente al 76.0 % de decir siempre “a tiempo”. El F1 de 0.462 muestra que todavía se le escapan muchos envíos tardíos: el modelo es sencillo y los datos tienen mucho azar. Mejorarlo no es el objetivo aquí; el objetivo es que este número sea honesto y repetible.
Qué aprendió cada paso
Todo lo aprendido queda guardado dentro del pipeline. Podemos inspeccionarlo por nombre:
pasos = pipeline.named_steps["preparar"].named_transformers_
print("Promedios para rellenar (distancia, peso):", pasos["numericas"].named_steps["rellenar"].statistics_.round(2))
print("Medias para escalar (distancia, peso):    ", pasos["numericas"].named_steps["escalar"].mean_.round(2))
print("Servicios conocidos:                      ", list(pasos["categoricas"].categories_[0]))

coeficientes = pd.Series(
    pipeline.named_steps["modelo"].coef_[0],
    index=pipeline.named_steps["preparar"].get_feature_names_out(),
).round(2)
coeficientes
Promedios para rellenar (distancia, peso): [300.92 3.88]
Medias para escalar (distancia, peso): [300.92 3.88]
Servicios conocidos: ['económico', 'estándar', 'express']numericas__distancia_km 0.70
numericas__peso_kg 0.52
categoricas__servicio_económico 0.77
categoricas__servicio_estándar 0.00
categoricas__servicio_express -0.76
dtype: float64El relleno usará 300.92 km y 3.88 kg, calculados solo con los 450 envíos de entrenamiento; el escalador aprendió esas mismas medias porque recibe los datos ya rellenados. Los coeficientes cuentan una historia coherente con los datos: más distancia (0.70) y más peso (0.52) empujan hacia “tarde”, el servicio económico también (0.77) y el express protege (-0.76).
Usar el pipeline con un envío nuevo
Este es el beneficio práctico. Llega un paquete de 520 km, sin peso registrado y con servicio económico. Le pasamos el dato crudo; el pipeline rellena, escala, codifica y predice.
envio_nuevo = pd.DataFrame([{"distancia_km": 520.0, "peso_kg": np.nan, "servicio": "económico"}])
probabilidad = pipeline.predict_proba(envio_nuevo)[0, 1]
print(f"Probabilidad de llegar tarde: {probabilidad:.1%}")
print("Decisión del pipeline:", "llega tarde" if pipeline.predict(envio_nuevo)[0] == 1 else "a tiempo")
Probabilidad de llegar tarde: 53.2%
Decisión del pipeline: llega tardeEl pipeline rellenó el peso con 3.88 kg, escaló la distancia, codificó económico y estimó una probabilidad de 53.2 %, apenas por encima del umbral de 50 %, así que lo marca como tardío. No tuvimos que repetir ningún paso a mano.
Seguir tres envíos por cada estación
Hasta aquí el pipeline parece una caja negra: entra un envío crudo y sale “llega tarde”. Abrámosla. Tomamos el envío nuevo y dos envíos de prueba, y miramos cómo se ven después de cada estación, igual que hicimos a mano con E y F.
Primero, los datos tal como llegan:
muestra = pd.concat([envio_nuevo, X_pru.head(2)], ignore_index=True)
muestra.index = ["nuevo", "prueba 1", "prueba 2"]
muestra| distancia_km | peso_kg | servicio | |
|---|---|---|---|
| nuevo | 520.0 | NaN | económico |
| prueba 1 | 578.5 | 2.18 | express |
| prueba 2 | 247.4 | 5.40 | express |
Estación 1: rellenar. Solo el envío nuevo tiene un vacío.
rama = pipeline.named_steps["preparar"].named_transformers_["numericas"]
rellenado = pd.DataFrame(
    rama.named_steps["rellenar"].transform(muestra[COLUMNAS_NUMERICAS]),
    columns=COLUMNAS_NUMERICAS, index=muestra.index,
)
rellenado| distancia_km | peso_kg | |
|---|---|---|
| nuevo | 520.0 | 3.881995 |
| prueba 1 | 578.5 | 2.180000 |
| prueba 2 | 247.4 | 5.400000 |
El envío nuevo recibe 3.88 kg, el promedio que el paso aprendió con los 450 envíos de entrenamiento; los otros dos conservan su peso. Es lo mismo que hicimos con F en la sección 2, solo que con un promedio calculado sobre más datos.
Estación 2: escalar. Cada número pasa a medir “cuántas desviaciones está por encima o por debajo del promedio de entrenamiento”.
escalado = pd.DataFrame(
    rama.named_steps["escalar"].transform(rellenado.to_numpy()),
    columns=COLUMNAS_NUMERICAS, index=muestra.index,
).round(2) + 0.0  # + 0.0 evita que aparezca "-0.00"
escalado| distancia_km | peso_kg | |
|---|---|---|
| nuevo | 1.02 | 0.00 |
| prueba 1 | 1.29 | -0.68 |
| prueba 2 | -0.25 | 0.61 |
La distancia de 520 km queda en 1.02: algo más de una desviación por encima del promedio de 300.92 km. El peso rellenado del envío nuevo queda en 0.00, porque es exactamente el promedio. El envío de prueba 2, con 247.4 km, queda por debajo del promedio y por eso su valor es negativo (-0.25).
Estación 3: codificar. El servicio se convierte en tres columnas de ceros y unos.
codificador = pipeline.named_steps["preparar"].named_transformers_["categoricas"]
codificado = pd.DataFrame(
    codificador.transform(muestra[["servicio"]]).toarray(),
    columns=codificador.get_feature_names_out(), index=muestra.index,
).astype(int)
codificado| servicio_económico | servicio_estándar | servicio_express | |
|---|---|---|---|
| nuevo | 1 | 0 | 0 |
| prueba 1 | 0 | 0 | 1 |
| prueba 2 | 0 | 0 | 1 |
Estación 4: el modelo. Recibe las cinco columnas juntas, que es justo lo que entrega el ColumnTransformer, y calcula la probabilidad.
preparado = pd.DataFrame(
    pipeline.named_steps["preparar"].transform(muestra),
    columns=pipeline.named_steps["preparar"].get_feature_names_out(), index=muestra.index,
).round(2) + 0.0
preparado["prob_tarde"] = pipeline.predict_proba(muestra)[:, 1].round(3)
preparado["decision"] = np.where(preparado["prob_tarde"] >= 0.5, "llega tarde", "a tiempo")
preparado| numericas__distancia_km | numericas__peso_kg | categoricas__servicio_económico | categoricas__servicio_estándar | categoricas__servicio_express | prob_tarde | decision | |
|---|---|---|---|---|---|---|---|
| nuevo | 1.02 | 0.00 | 1.0 | 0.0 | 0.0 | 0.532 | llega tarde |
| prueba 1 | 1.29 | -0.68 | 0.0 | 0.0 | 1.0 | 0.175 | a tiempo |
| prueba 2 | -0.25 | 0.61 | 0.0 | 0.0 | 1.0 | 0.122 | a tiempo |
La tabla final tiene las cinco columnas que ve el modelo y ninguna de ellas es texto ni tiene vacíos. Con esos números, el envío nuevo obtiene 0.532 y se marca como tardío; los dos de prueba, de servicio express, quedan en 0.175 y 0.122. El envío de prueba 1 recorre más distancia que el nuevo (578.5 km), pero el express lo protege, como anticipaba su coeficiente negativo.
Tu propio paso dentro del pipeline
Por dentro, SimpleImputer es una clase con fit y transform, igual que la RellenarConPromedio que escribiste en la sección 2. Para comprobarlo, reescribamos esa clase al estilo de scikit-learn y pongámosla en el lugar de SimpleImputer.
Solo hacen falta dos cambios:
- heredar de
BaseEstimatoryTransformerMixin, que le dan a la clase los métodos que el pipeline espera (por ejemplo,fit_transform); - trabajar con varias columnas a la vez, porque la rama numérica le entrega distancia y peso juntos.
NotaTransformador propio
Una clase escrita por ti que cumple las reglas de scikit-learn: fit aprende y devuelve self, transform aplica lo aprendido y devuelve los datos transformados. Si las cumple, se puede usar dentro de un Pipeline como cualquier paso de la librería, y queda protegida de la fuga igual que ellos.
from sklearn.base import BaseEstimator, TransformerMixin


class RellenarConPromedioSK(BaseEstimator, TransformerMixin):
    """Rellena vacíos con el promedio de cada columna, aprendido solo en fit."""

    def fit(self, X, y=None):
        self.promedios_ = np.nanmean(np.asarray(X, dtype=float), axis=0)
        return self

    def transform(self, X):
        X = np.asarray(X, dtype=float).copy()
        filas, columnas = np.where(np.isnan(X))
        X[filas, columnas] = self.promedios_[columnas]
        return X

    def get_feature_names_out(self, input_features=None):
        return np.asarray(input_features)  # no cambia los nombres de las columnas


pipeline_propio = Pipeline([
    ("preparar", ColumnTransformer([
        ("numericas", Pipeline([("rellenar", RellenarConPromedioSK()), ("escalar", StandardScaler())]),
         COLUMNAS_NUMERICAS),
        ("categoricas", OneHotEncoder(handle_unknown="ignore"), COLUMNAS_CATEGORICAS),
    ])),
    ("modelo", LogisticRegression(max_iter=1000)),
]).fit(X_ent, y_ent)

propio = pipeline_propio.named_steps["preparar"].named_transformers_["numericas"].named_steps["rellenar"]
print("Promedios aprendidos por tu clase:", propio.promedios_.round(2))
print("¿Mismas predicciones que con SimpleImputer?",
      (pipeline_propio.predict(X_pru) == pipeline.predict(X_pru)).all())
Promedios aprendidos por tu clase: [300.92 3.88]
¿Mismas predicciones que con SimpleImputer? TrueTu clase aprendió los mismos promedios que SimpleImputer (300.92 km y 3.88 kg) y el pipeline da exactamente las mismas 150 predicciones. Con estas pocas líneas ya sabes cómo funcionan por dentro los pasos de scikit-learn y cómo meter en el pipeline cualquier preparación que la librería no traiga.
AdvertenciaSi guardas un pipeline con un paso propio
El archivo guarda lo que aprendió tu clase, pero no su código. Quien lo cargue necesita tener definida RellenarConPromedioSK; si no, verá un error como Can't get attribute 'RellenarConPromedioSK'. En proyectos reales, estas clases se escriben en un archivo .py que se instala junto al modelo.
7) Guardar el pipeline y volver a abrirlo
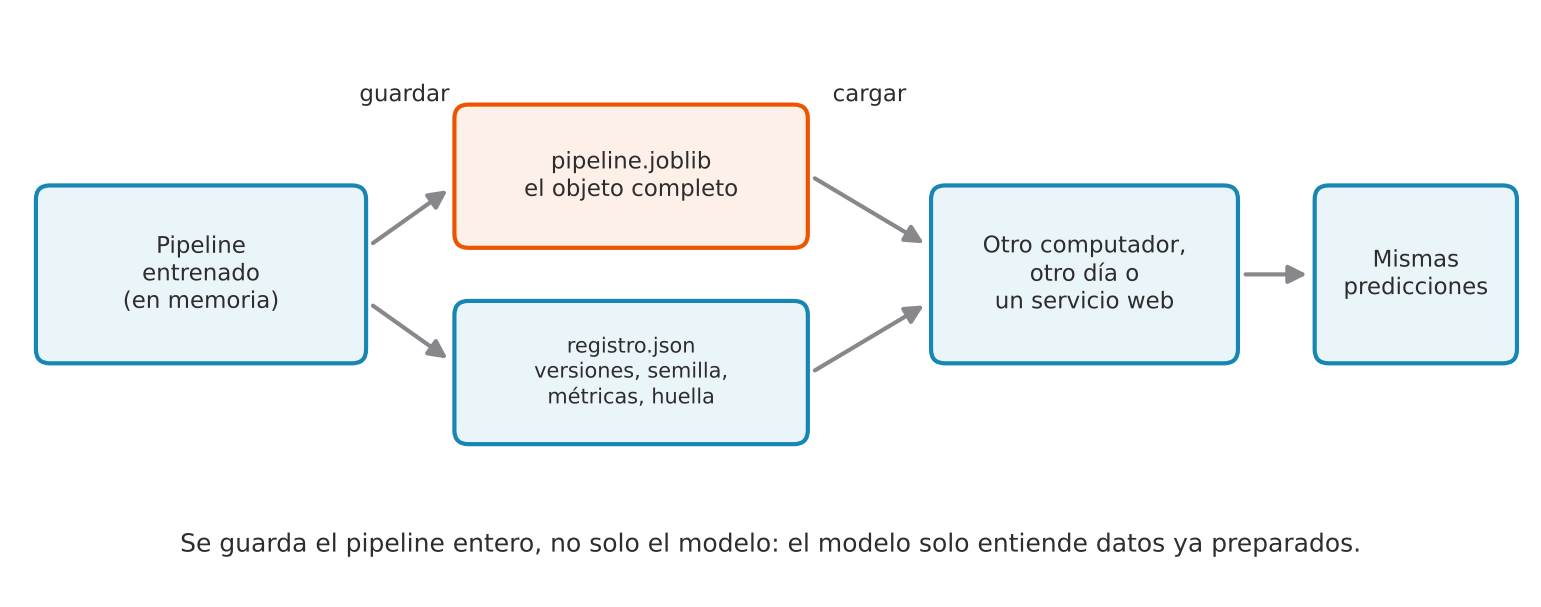
Laura, del equipo de operaciones, quiere usar el modelo desde mañana en el sistema que recibe los paquetes. El problema es que el pipeline entrenado vive en la memoria de tu computador: si cierras el notebook, desaparece. Hay que guardarlo en un archivo que Laura pueda abrir.
NotaSerializar
Convertir un objeto de Python, con todo lo que aprendió, en un archivo. Deserializar es el camino inverso: leer el archivo y recuperar el objeto tal como estaba. En scikit-learn se usa la librería joblib.
Primer intento: guardar solo el modelo
Lo más tentador es guardar la regresión logística, porque “es el modelo”. Hagámoslo y pongámonos en el lugar de Laura: carga el archivo y le pasa el envío nuevo tal como llega del sistema.
from pathlib import Path
import joblib

CARPETA = Path("artefactos")
CARPETA.mkdir(exist_ok=True)

_ = joblib.dump(pipeline.named_steps["modelo"], CARPETA / "solo_modelo.joblib")
modelo_de_laura = joblib.load(CARPETA / "solo_modelo.joblib")
try:
    with warnings.catch_warnings():
        warnings.simplefilter("ignore", UserWarning)
        modelo_de_laura.predict(envio_nuevo)
except ValueError as error:
    print("ValueError:", str(error).splitlines()[0])
ValueError: could not convert string to float: 'económico'Laura recibe could not convert string to float: 'económico'. El modelo nunca vio datos crudos: no sabe convertir el texto en columnas one-hot, ni rellenar el peso, ni escalar la distancia. Si en lugar de texto le llegaran solo números sin escalar, sería peor: no daría error y devolvería predicciones equivocadas.
Segundo intento: guardar el pipeline completo
Ahora guardamos el objeto pipeline entero, con sus tres pasos de preparación y el modelo.
RUTA_PIPELINE = CARPETA / "pipeline_envios.joblib"

_ = joblib.dump(pipeline, RUTA_PIPELINE)
pipeline_cargado = joblib.load(RUTA_PIPELINE)

iguales = (pipeline_cargado.predict(X_pru) == pipeline.predict(X_pru)).all()
print("Archivo guardado:", RUTA_PIPELINE.as_posix(), f"({RUTA_PIPELINE.stat().st_size / 1024:.1f} KB)")
print("¿Predicciones idénticas tras recargar?", iguales)
print(f"Envío nuevo con el pipeline recargado: {pipeline_cargado.predict_proba(envio_nuevo)[0, 1]:.1%}")
Archivo guardado: artefactos/pipeline_envios.joblib (3.6 KB)
¿Predicciones idénticas tras recargar? True
Envío nuevo con el pipeline recargado: 53.2%El archivo ocupa 3.6 KB y contiene todo: los promedios, las medias, la lista de servicios y los coeficientes. Al recargarlo, las 150 predicciones de prueba coinciden y el envío nuevo vuelve a dar 53.2 %.
AdvertenciaLas versiones también cuentan
Un archivo .joblib guarda objetos de una versión concreta de scikit-learn. Abrirlo con otra versión puede producir advertencias o resultados distintos. Por eso la siguiente sección registra las versiones junto al pipeline. Y nunca abras un .joblib de una fuente en la que no confías: al cargarlo se ejecuta código.
8) Revisar los datos antes de predecir
Dos semanas después, el sistema de Laura cambia: ahora envía la distancia en metros en lugar de kilómetros. Nadie avisa. Veamos qué hace el pipeline con el mismo envío de 520 km, que ahora llega como 520 000.
NotaEsquema
La descripción de qué columnas espera el pipeline y de qué tipo es cada una. Validar el esquema es comprobar que los datos que llegan coinciden con esa descripción.
envio_en_metros = envio_nuevo.assign(distancia_km=520_000.0)
print(f"Envío en kilómetros: {pipeline_cargado.predict_proba(envio_nuevo)[0, 1]:.1%} de llegar tarde")
print(f"Mismo envío en metros: {pipeline_cargado.predict_proba(envio_en_metros)[0, 1]:.1%} de llegar tarde")
Envío en kilómetros: 53.2% de llegar tarde
Mismo envío en metros: 100.0% de llegar tardeEl mismo paquete pasa de 53.2 % a 100.0 % de llegar tarde y el pipeline no muestra ningún error ni advertencia. Para el modelo, 520 000 es simplemente una distancia enorme. Este es el fallo más peligroso en producción, porque nadie se entera.
Otros cambios sí producen un error, pero con un mensaje que no explica qué pasó. Por ejemplo, si la columna peso_kg llega con el nombre peso:
try:
    pipeline_cargado.predict(envio_nuevo.rename(columns={"peso_kg": "peso"}))
except ValueError as error:
    print("ValueError:", str(error).splitlines()[0])
ValueError: columns are missing: {'peso_kg'}La solución es revisar la entrada antes de predecir, con una función que compare los datos contra lo que el pipeline espera y devuelva mensajes claros.
ESQUEMA = {"distancia_km": "número", "peso_kg": "número", "servicio": "texto"}
RANGOS = {"distancia_km": (0, 3000), "peso_kg": (0, 70)}  # valores plausibles para la empresa


def validar_entrada(tabla):
    """Devuelve la lista de problemas encontrados; vacía si la tabla cumple el esquema."""
    problemas = []
    for columna, tipo in ESQUEMA.items():
        if columna not in tabla.columns:
            problemas.append(f"falta la columna '{columna}'")
        elif tipo == "número" and not pd.api.types.is_numeric_dtype(tabla[columna]):
            problemas.append(f"'{columna}' debería ser numérica")
        elif columna in RANGOS:
            minimo, maximo = RANGOS[columna]
            fuera = tabla[columna].dropna().lt(minimo) | tabla[columna].dropna().gt(maximo)
            if fuera.any():
                problemas.append(f"'{columna}' fuera del rango {minimo}-{maximo}")
    sobrantes = set(tabla.columns) - set(ESQUEMA)
    if sobrantes:
        problemas.append(f"columnas inesperadas: {sorted(sobrantes)}")
    return problemas


casos = {
    "envío correcto": envio_nuevo,
    "columna renombrada": envio_nuevo.rename(columns={"peso_kg": "peso"}),
    "peso como texto": envio_nuevo.assign(peso_kg="3,5"),
    "distancia en metros": envio_en_metros,
}
for nombre, tabla in casos.items():
    problemas = validar_entrada(tabla)
    print(f"{nombre:21s} ->", "sin problemas" if not problemas else "; ".join(problemas))
envío correcto -> sin problemas
columna renombrada -> falta la columna 'peso_kg'; columnas inesperadas: ['peso']
peso como texto -> 'peso_kg' debería ser numérica
distancia en metros -> 'distancia_km' fuera del rango 0-3000El envío correcto pasa la revisión. Si alguien renombra peso_kg como peso, la función avisa de la columna que falta y de la que sobra. Si el peso llega como el texto "3,5", también lo detecta. Y la distancia de 520 000, que el pipeline aceptó sin protestar, ahora queda fuera del rango de 0 a 3 000 km. Cuatro mensajes claros antes de predecir.
9) Dejar registro de cada entrenamiento
Un mes después, alguien del equipo prueba rellenar el peso con la mediana en lugar del promedio y guarda su versión en la misma carpeta. Ahora hay dos archivos casi iguales. Laura pregunta cuál está usando.
pipeline_mediana = Pipeline([
    ("preparar", ColumnTransformer([
        ("numericas", Pipeline([("rellenar", SimpleImputer(strategy="median")), ("escalar", StandardScaler())]),
         COLUMNAS_NUMERICAS),
        ("categoricas", OneHotEncoder(handle_unknown="ignore"), COLUMNAS_CATEGORICAS),
    ])),
    ("modelo", LogisticRegression(max_iter=1000)),
]).fit(X_ent, y_ent)
_ = joblib.dump(pipeline_mediana, CARPETA / "pipeline_envios_v2.joblib")

for archivo in ["pipeline_envios.joblib", "pipeline_envios_v2.joblib"]:
    ruta = CARPETA / archivo
    prob = joblib.load(ruta).predict_proba(envio_nuevo)[0, 1]
    print(f"{archivo:26s} {ruta.stat().st_size / 1024:.1f} KB | envío nuevo: {prob:.1%}")
pipeline_envios.joblib 3.6 KB | envío nuevo: 53.2%
pipeline_envios_v2.joblib 3.6 KB | envío nuevo: 50.4%Los dos archivos pesan 3.6 KB y tienen nombres casi iguales, pero no predicen lo mismo: el envío nuevo da 53.2 % con uno y 50.4 % con el otro. Mirando el nombre y el tamaño no hay forma de saber cuál se entrenó con el promedio, con qué datos ni cuál tuvo mejor F1.
Un registro pequeño en JSON junto a cada pipeline responde esas preguntas: con qué datos, con qué semilla, con qué versiones y con qué resultados se entrenó. Incluye una huella (hash) del archivo: un código que cambia si el archivo cambia aunque sea en un byte. Si la huella del archivo que usa Laura coincide con la del registro, sabe exactamente qué modelo tiene.
NotaHuella (hash)
Un código de longitud fija que se calcula a partir del contenido de un archivo. Dos archivos idénticos tienen la misma huella; basta cambiar un byte para que la huella sea completamente distinta.
import hashlib
import json
import platform
from datetime import date

huella = hashlib.sha256(RUTA_PIPELINE.read_bytes()).hexdigest()

registro = {
    "fecha": date.today().isoformat(),
    "archivo_pipeline": RUTA_PIPELINE.as_posix(),
    "huella_sha256": huella,
    "semilla": SEMILLA,
    "datos": {"envios": len(datos), "entrenamiento": len(X_ent), "prueba": len(X_pru)},
    "columnas": ESQUEMA,
    "rangos": RANGOS,
    "metricas_prueba": {"exactitud": round(exactitud, 4), "f1": round(f1, 4)},
    "versiones": {
        "python": platform.python_version(),
        "pandas": pd.__version__,
        "scikit-learn": sklearn.__version__,
        "joblib": version("joblib"),
    },
}
RUTA_REGISTRO = CARPETA / "registro_corrida.json"
_ = RUTA_REGISTRO.write_text(json.dumps(registro, indent=2, ensure_ascii=False), encoding="utf-8")
print(RUTA_REGISTRO.read_text(encoding="utf-8"))
{
"fecha": "2026-10-23",
"archivo_pipeline": "artefactos/pipeline_envios.joblib",
"huella_sha256": "e4de46753a5e5b56daacf1c514dbec24d5c48dbc02fa88ce327a85f7aa3cc73d",
"semilla": 42,
"datos": {
"envios": 600,
"entrenamiento": 450,
"prueba": 150
},
"columnas": {
"distancia_km": "número",
"peso_kg": "número",
"servicio": "texto"
},
"rangos": {
"distancia_km": [
0,
3000
],
"peso_kg": [
0,
70
]
},
"metricas_prueba": {
"exactitud": 0.8133,
"f1": 0.4615
},
"versiones": {
"python": "3.13.16",
"pandas": "3.0.5",
"scikit-learn": "1.9.1",
"joblib": "1.6.0"
}
}El registro dice qué archivo se guardó, su huella, la semilla 42, cuántos envíos se usaron, las columnas y rangos esperados, la exactitud de 0.8133, el F1 de 0.4615 y las versiones exactas de Python y de cada librería. Las rutas son relativas a la carpeta del capítulo, para que el registro sirva en cualquier computador.
def comprobar(ruta, registro):
    return hashlib.sha256(ruta.read_bytes()).hexdigest() == registro["huella_sha256"]

print("¿pipeline_envios.joblib coincide con el registro?   ", comprobar(RUTA_PIPELINE, registro))
print("¿pipeline_envios_v2.joblib coincide con el registro?", comprobar(CARPETA / "pipeline_envios_v2.joblib", registro))
¿pipeline_envios.joblib coincide con el registro? True
¿pipeline_envios_v2.joblib coincide con el registro? FalseLa huella del archivo original coincide con la del registro y la de la versión 2 no. Si Laura recibe un archivo y su huella no está en ningún registro, sabe que no debe usarlo hasta averiguar de dónde salió.
Errores frecuentes
| Lo que ves | Qué pasó | Cómo se arregla |
|---|---|---|
| La métrica en prueba es muy buena y en producción cae | Algún paso hizo fit con datos de prueba |
Separar primero y meter toda la preparación dentro del pipeline |
ValueError: could not convert string to float al predecir |
Se guardó o se usó solo el modelo, sin la preparación | Guardar y cargar el pipeline completo |
ValueError: Found unknown categories |
Llegó una categoría que no estaba en entrenamiento | Usar OneHotEncoder(handle_unknown="ignore") |
| Las cifras cambian cada vez que ejecutas el notebook | No hay semilla, o hay una distinta en cada celda | Una sola SEMILLA usada en datos, partición y modelo |
Advertencias de versión al cargar el .joblib |
El archivo se creó con otra versión de scikit-learn | Revisar el registro y usar la misma versión |
| El pipeline predice cosas raras sin dar error | Cambiaron las unidades o el tipo de una columna | Validar columnas, tipos y rangos antes de predecir |
Can't get attribute 'MiClase' al cargar |
El pipeline tiene un paso propio cuyo código no está definido | Poner la clase en un .py e importarlo antes de cargar |
Hay varios .joblib y nadie sabe cuál es el bueno |
No hay registro de cada corrida | Guardar un JSON con huella, semilla, métricas y versiones |
Lista de verificación
Ejercicios
- A mano. En el ejemplo de juguete, cambia el peso del envío E de 20 kg a 4 kg y recalcula el promedio con trampa. ¿Sigue cambiando la decisión sobre F?
- Otra estrategia de relleno. Cambia
strategy="mean"porstrategy="median"en el pipeline. ¿Qué valor aprende ahora para el peso y cómo cambian la exactitud y el F1? - Un servicio nuevo. Pasa al pipeline un envío con servicio
mismo día. ¿Falla? ¿Qué probabilidad devuelve y por qué? - Romper la reproducibilidad. Quita
random_statedetrain_test_splity ejecuta la sección 4 tres veces. Anota el F1 de cada vez. - Tu propio paso. Escribe un transformador
PesoEnGramosque multiplique el peso por 1000 y ponlo antes de rellenar. ¿Cambian las predicciones? ¿Por qué?
TipOrientaciones
- El promedio con trampa pasa a ser (2 + 6 + 4 + 4) / 4 = 4.0, igual que el honesto, y F recibe el mismo puntaje. La fuga existe igual, pero esta vez no se nota: por eso es peligrosa.
- La mediana es menos sensible a paquetes muy pesados. El cambio en las métricas debería ser pequeño; lo importante es que solo cambias una línea dentro del pipeline.
- No falla gracias a
handle_unknown="ignore": las columnas de servicio quedan en cero y el modelo decide solo con distancia y peso. - Verás un F1 distinto en cada ejecución. Sin semilla, nadie puede repetir tu resultado.
- Las probabilidades no cambian: el relleno y el escalador aprenden del peso ya convertido a gramos, y el escalador lo expresa en desviaciones respecto al promedio, que no dependen de la unidad. Un cambio de unidad dentro del pipeline es inofensivo porque se aplica igual al entrenar y al predecir; uno antes del pipeline, como el de los metros, no lo es.
Glosario
| Término | Significado |
|---|---|
| Pipeline | Secuencia fija de pasos de preparación más un modelo, que se entrena y se usa como un solo objeto |
fit |
Aprender de los datos de entrenamiento |
transform |
Aplicar lo aprendido a cualquier dato |
predict |
Pedir la respuesta al último paso, el modelo |
| Fuga de datos | Información de prueba que se cuela en el entrenamiento |
| Partición estratificada | Separación que conserva la proporción de cada clase |
| Semilla | Número que fija el azar para repetir resultados |
ColumnTransformer |
Paso que aplica una preparación distinta a cada grupo de columnas |
| Categoría no vista | Valor categórico que no apareció en entrenamiento |
| Transformador propio | Clase escrita por ti con fit y transform que funciona como un paso del pipeline |
| Serializar | Guardar un objeto de Python, con lo que aprendió, en un archivo |
| Esquema | Columnas, tipos y rangos que espera el pipeline |
| Huella (hash) | Código que identifica el contenido exacto de un archivo |
Qué aprendiste
- Un pipeline es una línea de producción: los mismos pasos, en el mismo orden, para cada dato.
- Algunos pasos aprenden (
fit) y luego aplican lo aprendido (transform); el aprendizaje solo debe ver entrenamiento. - Los pasos de scikit-learn son clases como la que escribiste a mano, y puedes agregar los tuyos.
- La fuga de datos puede cambiar decisiones concretas, como la del envío F.
- Guardar el pipeline completo con
joblibpermite obtener las mismas predicciones en otro lugar. - Un pipeline no avisa cuando le cambian las unidades: hay que validar la entrada antes de predecir.
- Un registro con huella permite saber exactamente qué modelo está en uso.
En el siguiente capítulo, Automatización del entrenamiento, este pipeline pasa a entrenarse y evaluarse de forma automática, con validación cruzada en lugar de una sola partición.
Referencias
- scikit-learn. Pipelines and composite estimators. https://scikit-learn.org/stable/modules/compose.html
- scikit-learn. Common pitfalls and recommended practices. https://scikit-learn.org/stable/common_pitfalls.html
- scikit-learn. Model persistence. https://scikit-learn.org/stable/model_persistence.html
- Kaufman, S., Rosset, S., Perlich, C. y Stitelman, O. (2012). Leakage in data mining: formulation, detection, and avoidance. ACM Transactions on Knowledge Discovery from Data, 6(4), 1–21.