Serie MLOps y Producción · de la ingeniería de datos al monitoreo.
El problema que vas a resolver
Laura recibe un paquete de 520 kilómetros, sin peso registrado y con servicio económico. El modelo del capítulo 6 puede calcular su probabilidad de retraso. El registro del capítulo 8 identifica qué versión se eligió. Falta conectar esa combinación con la pantalla donde Laura registra el envío.
La pantalla necesita enviar los datos y recibir una respuesta en ese momento. Quien la utiliza conoce paquetes, no objetos de scikit-learn. Vas a construir una aplicación que reciba las medidas originales, compruebe la entrada y responda con una probabilidad, una alerta y la versión utilizada.
Ficha
En este capítulo
Pregunta
¿Cómo pide el sistema de Laura una predicción para cada paquete?
Datos
Los mismos 600 envíos sintéticos y la versión conocida como corrida_02
Herramientas
Python, scikit-learn, joblib, FastAPI, Pydantic, httpx y matplotlib
Lo que produces
Una aplicación comprobada localmente con peticiones y respuestas
Lectura y nivel
Unos 60 minutos; introducción a servicios de predicción
Condiciones
CPU, FastAPI y httpx ya instalados; sin abrir un puerto de red
Objetivos de aprendizaje
Al terminar este capítulo podrás:
Explicar quién pide y quién responde en un servicio de predicción.
Escribir el paquete de Laura como un mensaje JSON, con el peso faltante como null.
Validar cada envío con Pydantic antes de llamar al modelo.
Distinguir una entrada incorrecta (código 422) de un fallo interno (código 500).
Cargar el pipeline una sola vez al arrancar y devolver el umbral de Laura en cada respuesta.
Medir cuánto tarda en responder la aplicación.
Empezarás en una ventanilla que recibe un diccionario y devuelve otro. Después escribirás el mensaje que viajaría por la red, prepararás la versión elegida del modelo y definirás el servicio. Harás peticiones a la aplicación para observar respuestas correctas y errores provocados. Terminarás comparando el paquete de Laura con un lote pequeño atendido por el mismo modelo.
TipLo que necesitas recordar
Concepto
En una línea
Dónde se explica
Pipeline
Recibe columnas originales y aplica la preparación junto con el modelo.
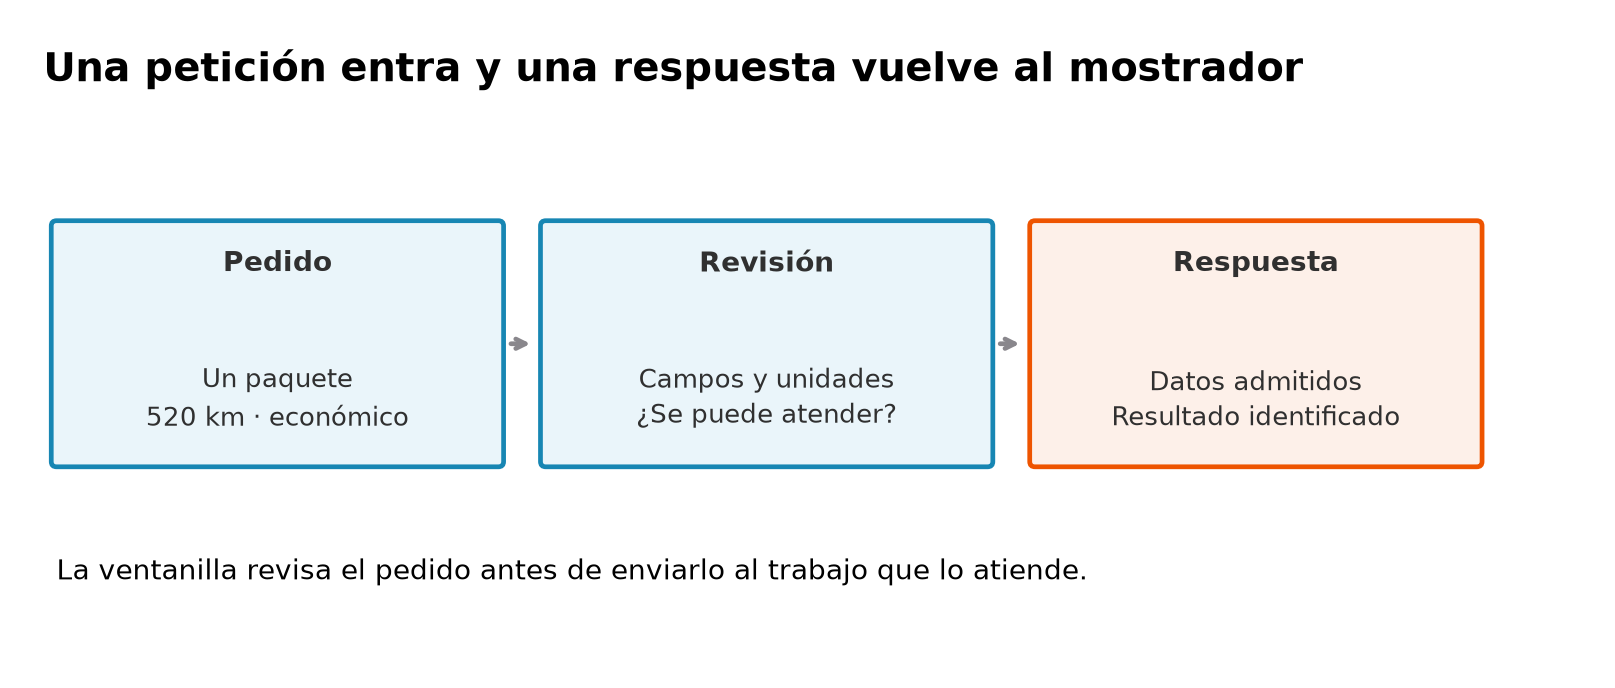
En un restaurante entregas un pedido en la ventanilla. La persona que lo recibe comprueba que puede atenderlo. Si falta el plato que quieres, te lo pregunta antes de enviarlo a la cocina. Si todo está claro, recibes una respuesta sin tener que conocer el interior de la cocina.
La ventanilla de los envíos puede empezar igual de pequeña. Recibe un diccionario con los datos del paquete y devuelve otro que indica si lo admite. Usará una regla de juguete: revisar los recorridos de 300 km o más. Es una decisión inventada para practicar la entrada y la salida; el modelo aprendido aparecerá después.
La ventanilla revisa el pedido antes de enviarlo al trabajo que lo atiende.
La primera celda registra las bibliotecas utilizadas. La carpeta de resultados tiene un nombre fijo y se vacía al empezar. Las peticiones que harás aquí se dirigen a una aplicación local de prueba y todos los envíos del ejemplo son sintéticos.
from pathlib import Pathfrom contextlib import ExitStackimport hashlibimport jsonimport platformimport shutilimport timeimport warningsimport joblibimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport sklearnimport fastapiimport httpximport pydanticfrom IPython.display import displayfrom starlette.exceptions import StarletteDeprecationWarning# Conservamos el cliente instalado; solo silenciamos su aviso de migración de httpx.warnings.filterwarnings("ignore", category=StarletteDeprecationWarning, message="Using `httpx` with `starlette.testclient` is deprecated.*")from fastapi.testclient import TestClientfrom pydantic import ValidationErrorfrom sklearn.compose import ColumnTransformerfrom sklearn.impute import SimpleImputerfrom sklearn.linear_model import LogisticRegressionfrom sklearn.model_selection import train_test_splitfrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import OneHotEncoder, StandardScalerfrom servicio_envios import crear_app, Envio, predecir_enviosSEMILLA =42CARPETA = Path("artefactos/servicio-envios")shutil.rmtree(CARPETA, ignore_errors=True)CARPETA.mkdir(parents=True)versiones = {"python": platform.python_version(), "pandas": pd.__version__,"scikit-learn": sklearn.__version__, "joblib": joblib.__version__,"numpy": np.__version__, "fastapi": fastapi.__version__,"httpx": httpx.__version__, "pydantic": pydantic.__version__}print(versiones)
Las versiones fastapi, httpx y pydantic identifican las herramientas que recibirán y comprobarán los mensajes. La semilla 42 permitirá reconstruir el mismo historial del modelo. Ahora puedes probar la ventanilla sin introducir todavía mensajes de red.
def ventanilla(paquete):"""Recibe un diccionario de juguete y devuelve recepción o error de campos."""if"distancia_km"notin paquete:return {"aceptado": False, "motivo": "Falta distancia_km"}return {"aceptado": True, "revisar_recorrido": paquete["distancia_km"] >=300}print(ventanilla({"distancia_km": 520, "peso_kg": None, "servicio": "económico"}))print(ventanilla({"peso_kg": 4, "servicio": "express"}))
El paquete de 520 km devuelve aceptado igual a True y revisar_recorrido igual a True. El segundo diccionario carece de distancia_km y devuelve aceptado igual a False con el motivo Falta distancia_km. Las 2 respuestas indican qué ocurrió antes de introducir comunicación HTTP.
En pocas palabras: primero se revisa el pedido y solo después se hace el trabajo. Si falta distancia, devuelve el nombre del campo que necesita. Con un paquete admitido aplica la regla de revisión. Mantendrás esa separación cuando cambies la regla de juguete por el pipeline ajustado.
2) Dar un nombre a quien pide y a quien responde
NotaCliente, servidor y servicio
El cliente es el programa que pide una operación, como la pantalla de recepción de Laura. El servidor es el proceso que recibe la petición y prepara la respuesta. Un servicio de predicción ofrece una forma acordada de solicitar resultados del modelo a otros programas.
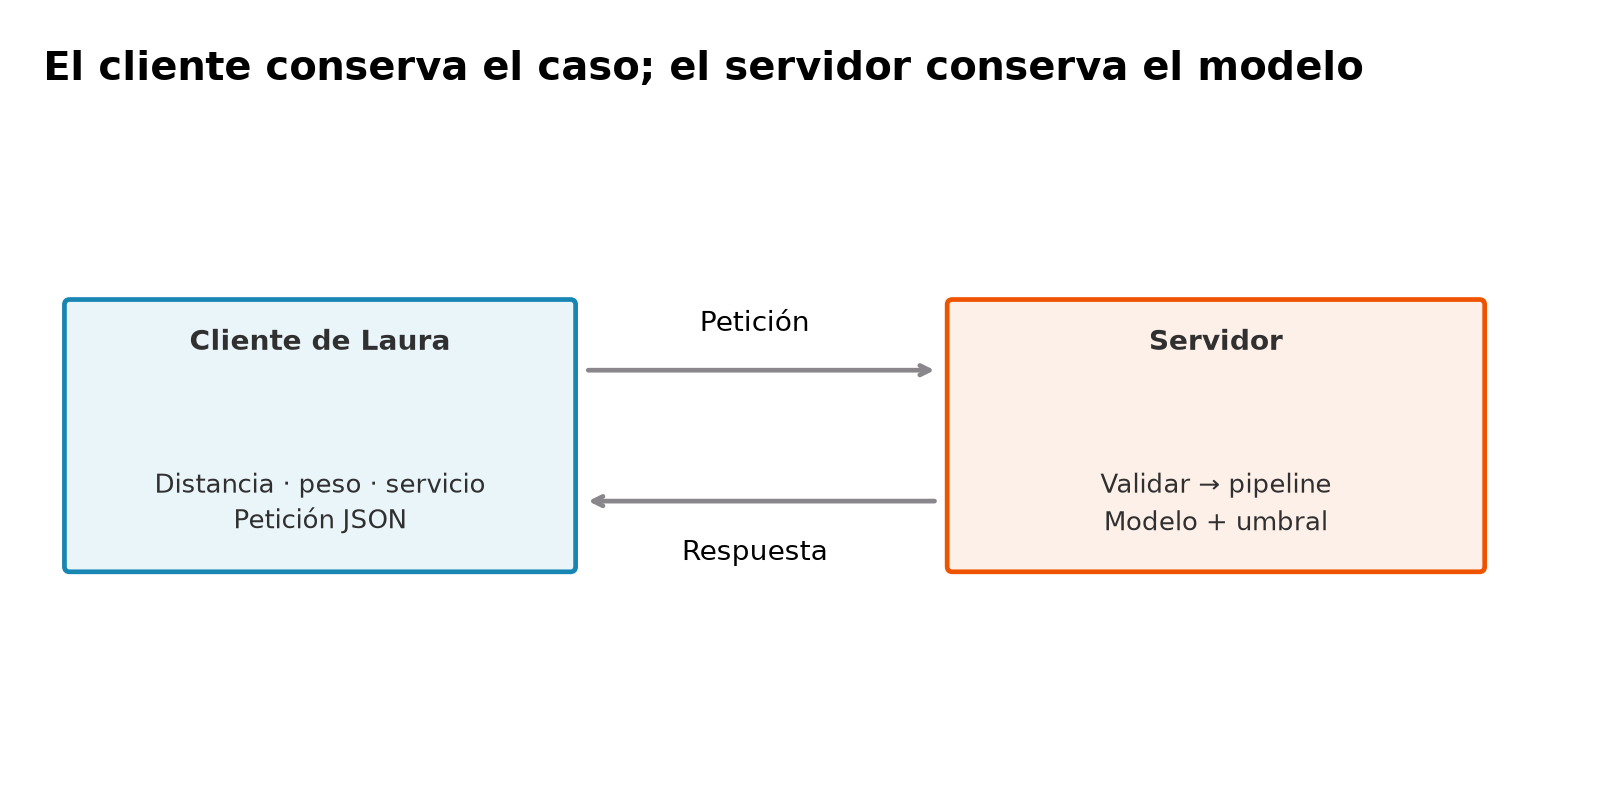
El cliente conoce distancia, peso y servicio. El servidor conserva el pipeline, su umbral y la versión elegida. Esa separación permite cambiar el archivo utilizado en el servidor sin pedirle a Laura que prepare nuevas columnas en su pantalla.
El cliente envía un caso y el servidor devuelve una decisión.
NotaPetición, respuesta y JSON
Una petición es el mensaje con el que un cliente solicita una operación. La respuesta es el mensaje que vuelve con el resultado o el problema encontrado. JSON es un formato de texto para intercambiar objetos con nombres y valores, listas, números, booleanos y valores nulos.
El diccionario de Python puede convertirse en JSON y recuperarse después. Hay un detalle importante para el paquete de Laura: el peso ausente se escribe null en JSON y se recupera como None en Python. Enviarás un valor nulo declarado, en lugar de una cadena vacía o el texto «desconocido» dentro de una medida numérica.
El mensaje contiene distancia_km de 520.0, peso_kg igual a null y servicio económico. Al recuperarlo, el peso aparece como None. Conservaste las 3 entradas del paquete y expresaste de manera explícita el dato ausente.
El cliente enviará las medidas originales, con distancia en kilómetros y peso en kilogramos. Escalar y rellenar siguen siendo responsabilidades del pipeline. Si el cliente enviase una distancia ya escalada bajo el nombre distancia_km, el servidor recibiría otra medida con un nombre incorrecto.
Qué aporta HTTP
NotaHTTP, ruta y API
HTTP es el protocolo de petición y respuesta que usarás para comunicar programas. Una ruta identifica una operación del servicio, como /v1/predecir. Una API es la interfaz que describe cómo puede un programa pedir esas operaciones. El método HTTP indica la acción: aquí POST envía un caso y GET consulta el estado.
El método y la ruta van acompañados de un cuerpo: el JSON del paquete. La respuesta tiene un código de estado y otro cuerpo. Puedes leerlos como el rótulo y el contenido de un sobre: primero identificas qué ocurrió y después revisas los detalles necesarios para continuar.
Las rutas serán GET /salud, POST /v1/predecir y POST /v1/predecir-lote. El segmento v1 identifica esta versión de la interfaz. La versión del modelo será otro dato de la respuesta: cambiar los coeficientes y cambiar los nombres de campos son cambios diferentes.
NotaCódigo de estado
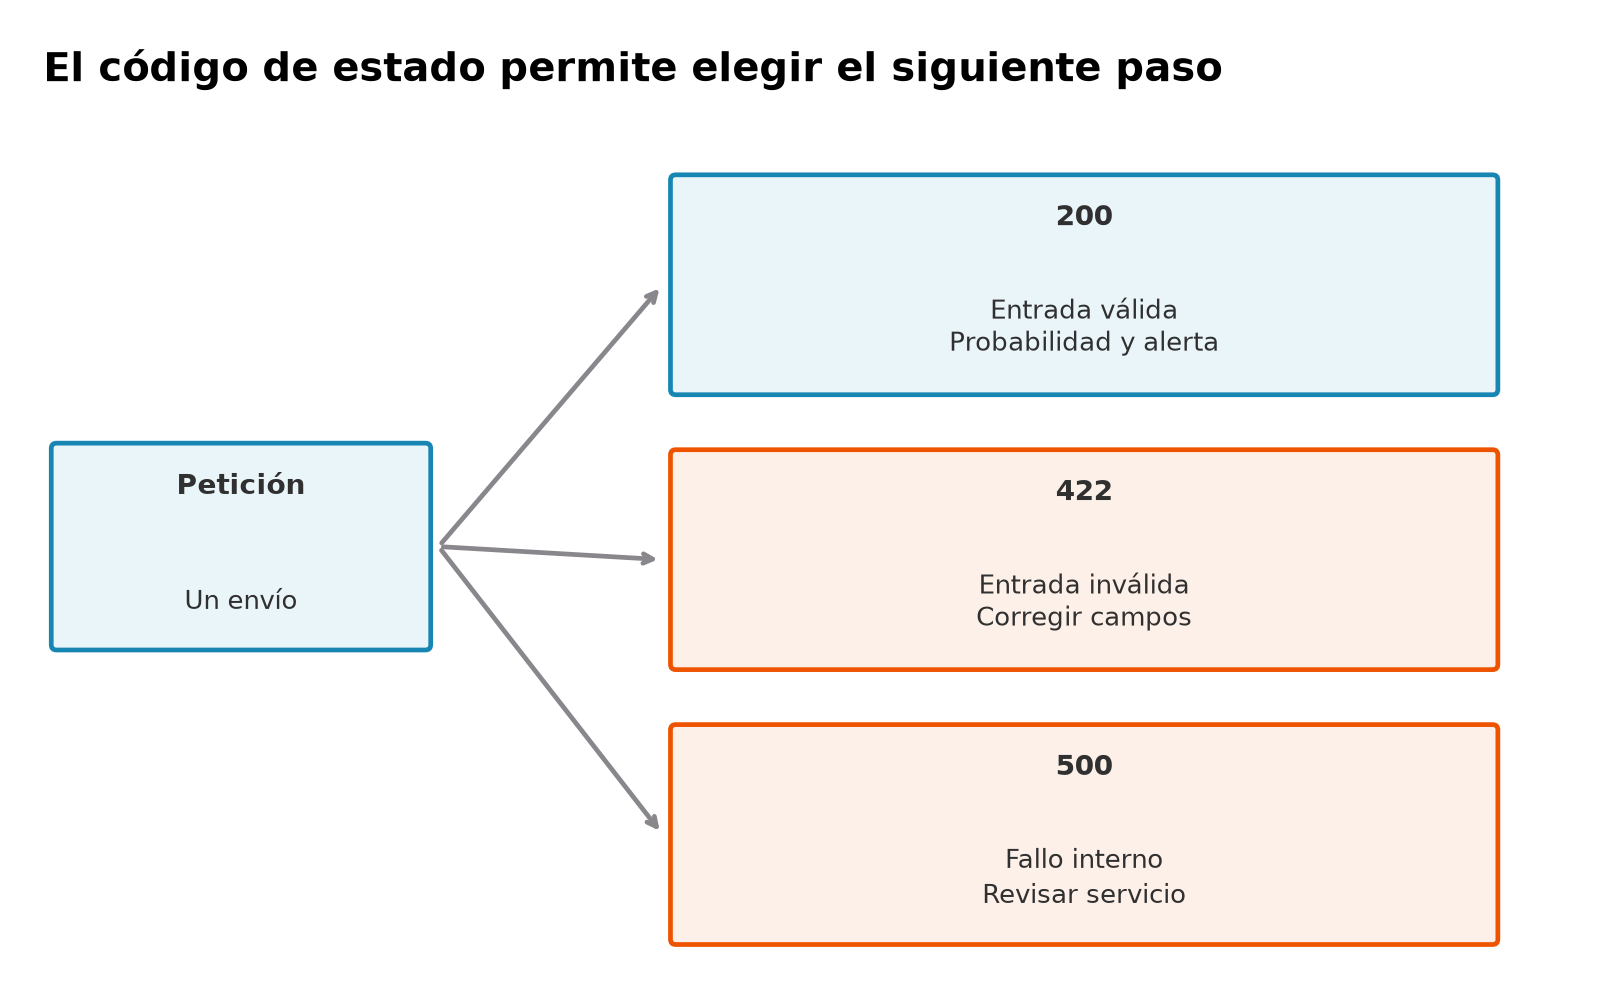
Un código de estado resume el resultado de una petición. En este servicio, 200 significa que la operación terminó correctamente; 422, que la entrada incumple el esquema; 500, que ocurrió un fallo inesperado dentro del servidor.
Código
Caso de Laura
Siguiente paso
200
El paquete se admite y existe una predicción.
Usar la respuesta identificada.
422
La distancia es negativa o falta un campo requerido.
Corregir la entrada indicada.
500
La entrada era válida, pero el componente de predicción falló.
Investigar el servicio y gestionar el fallo.
La misma entrada al servicio puede llevar a tres resultados distinguibles.
3) Preparar la versión que va a responder
El capítulo 8 eligió la referencia corrida_02. Para mantener este notebook independiente reconstruirás su pipeline con los mismos datos, separación y ajustes. El relleno utiliza mediana; la regresión tiene C igual a 10 y pesos equilibrados. El registro guarda el umbral 0.45 junto con el identificador de versión y la huella del archivo.
Esta reconstrucción forma parte de preparar la demostración. Una aplicación en operación recibiría el paquete de archivos ya seleccionado. Al atender un envío solamente tendría que cargarlo al arrancar y aplicarlo. Así mantienes separadas la producción del modelo y la atención de peticiones.
La fuente contiene 600 envíos, 67 pesos faltantes y 24.3 % de tardíos. El pipeline se ajustó con 450 y los otros 150 permanecieron sin consultar. El registro identifica corrida_02 y conserva el corte 0.45, que utilizará la aplicación al responder.
La prueba queda reservada sin calcular nuevas métricas. Aquí quieres comprobar que sirves la versión y la política conocidas, no volver a decidir qué configuración gana. La evaluación que justifica esa elección se encuentra en los capítulos 6 y 8.
Cargar una vez al iniciar
NotaArranque y carga única
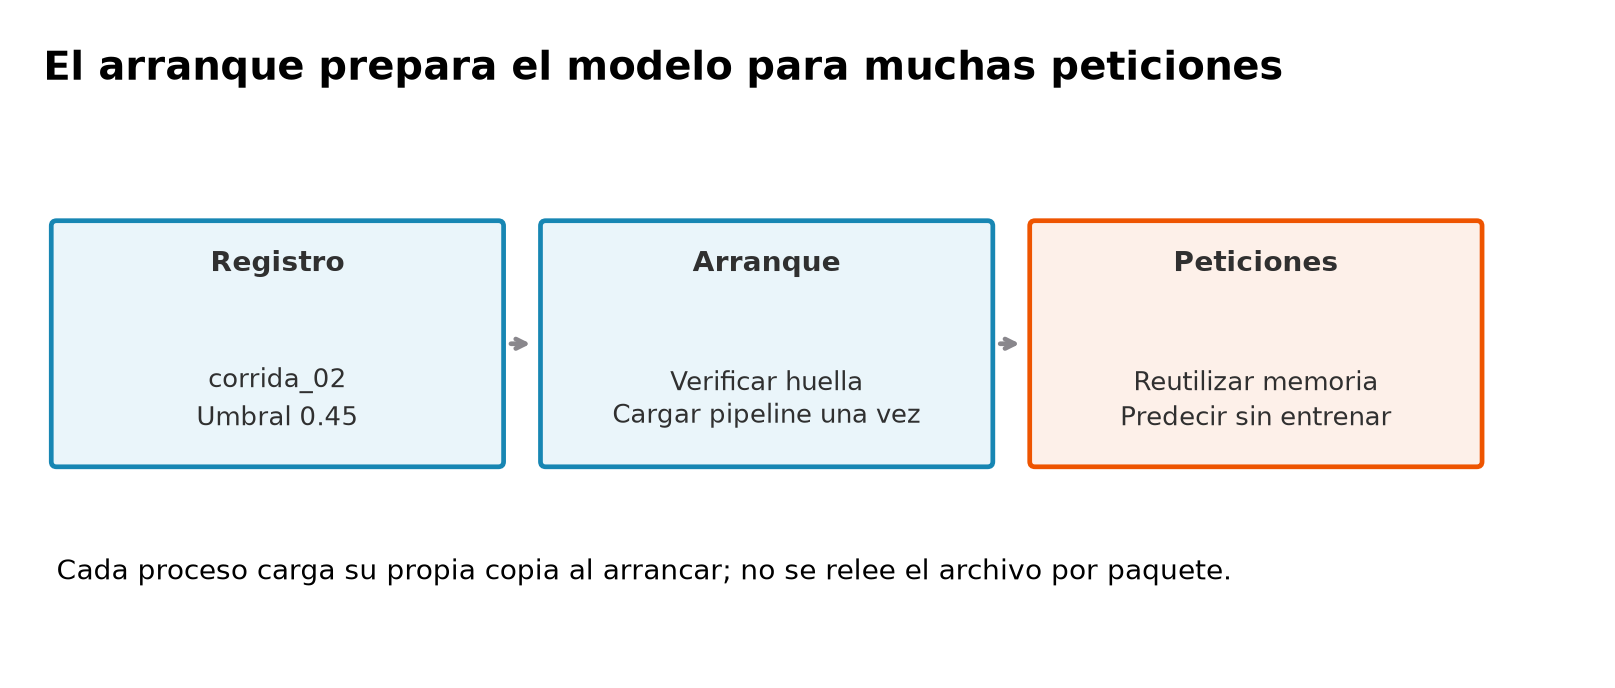
El arranque prepara lo que el proceso necesita antes de atender peticiones. La carga única recupera el pipeline en ese momento y conserva el objeto en memoria. Cada petición reutiliza ese objeto; no vuelve a entrenar ni abre el archivo del modelo por cada paquete.
El registro y el archivo se leen al iniciar y después se reutilizan en memoria.
La carga única es por proceso. Si una empresa ejecuta varias copias del servidor, cada copia necesita su objeto en memoria. Lo que evita el ejemplo es una lectura y una carga nueva por petición. El dato que viaja en cada mensaje sigue siendo el paquete de Laura.
El arranque también verifica la huella. Si el archivo no corresponde al registro, la aplicación falla antes de atender casos. Estar encendido no basta: el servicio solo está listo si cargó el modelo correcto.
4) Revisar la entrada con un esquema visible
NotaPydantic y validación de entrada
Pydantic comprueba datos frente a una descripción de campos y restricciones. La validación de entrada decide si una petición cumple esa descripción antes de llamar al modelo. Aquí exigirá tipos numéricos, unidades y rangos declarados, un servicio admitido y ausencia de campos adicionales.
El peso será requerido, pero puede valer null. Así distingues «el sistema informó que no hay peso» de «el sistema dejó de enviar ese campo». La distancia debe estar entre 0 y 3000 km; el peso observado, entre 0 y 70 kg. Son rangos operativos ilustrativos que retoman el capítulo 5.
El esquema admite express, estándar, económico y mismo día. Los tres primeros aparecieron en entrenamiento; mismo día es el caso nuevo que ya conoces. Lo admitimos de forma explícita y el codificador deja sus indicadores conocidos en cero. Otros nombres se rechazan hasta que se acuerde cómo recibirlos.
Los números deben llegar como números. El texto "3,5" requiere una conversión explícita en la captura, donde sabes qué separador se está utilizando. Una distancia de 520000 bajo el nombre distancia_km supera el rango declarado y puede revelar una confusión entre metros y kilómetros.
La entrada válida conserva los 3 campos y el peso None. El caso con distancia de −20 devuelve ValidationError: 1 validation error for Envio. Esa comprobación sucede antes de construir la tabla que recibe el pipeline.
El tipo del campo y su rango expresan decisiones diferentes. Una distancia negativa puede tener un tipo numérico correcto y aun así incumplir la regla de la empresa. Los mensajes de Pydantic conservarán el campo y la clase de problema para que el cliente pueda explicar qué necesita corregirse.
5) Leer la aplicación antes de hacer peticiones
NotaFastAPI y TestClient
FastAPI construye la aplicación HTTP a partir de funciones y esquemas. TestClient permite hacer peticiones a esa aplicación dentro del proceso de prueba: ejecuta sus rutas, validaciones y respuestas sin abrir un puerto de red. httpx es parte de las herramientas que utiliza este cliente de pruebas.
El archivo servicio_envios.py, situado junto al notebook, reúne el código que vas a ejecutar. Envio declara el paquete; Lote limita la cantidad de paquetes; Respuesta describe lo que recibirá Laura. Las tres rutas utilizan la misma función de predicción y el mismo estado cargado al iniciar.
Lee primero predecir_envios. Recibe entradas ya validadas, construye una tabla con las columnas originales y llama a predict_proba. Después compara con el umbral del registro. Cada respuesta conserva tanto la probabilidad como la decisión, para que la política sea visible.
En crear_app, el bloque de arranque ocurre antes de atender casos y libera el modelo al terminar. La función salud consulta si hay un objeto cargado. Las funciones asociadas a rutas atienden los paquetes. El manejador final convierte un error inesperado en una respuesta pública breve, sin enviar detalles internos al cliente.
"""Servicio local de envíos: esquema, carga única y rutas de predicción.crear_app recibe la ruta relativa del registro JSON y devuelve una aplicación.El arranque verifica la huella del pipeline y lo carga una vez por proceso."""from contextlib import asynccontextmanagerfrom pathlib import Pathfrom typing import Literalimport hashlibimport jsonimport joblibimport pandas as pdfrom fastapi import FastAPIfrom fastapi.responses import JSONResponsefrom pydantic import BaseModel, ConfigDict, Fieldclass Envio(BaseModel):"""Campos de un paquete: unidades explícitas y peso requerido pero anulable.""" model_config = ConfigDict(extra="forbid", allow_inf_nan=False) distancia_km: float= Field(ge=0, le=3000, strict=True) peso_kg: float|None= Field(ge=0, le=70, strict=True) servicio: Literal["express", "estándar", "económico", "mismo día"]class Lote(BaseModel):"""Recibe de uno a cien paquetes que se validan antes de predecir.""" model_config = ConfigDict(extra="forbid") envios: list[Envio] = Field(min_length=1, max_length=100)class Respuesta(BaseModel):"""Respuesta pública con probabilidad, política y versión utilizada.""" probabilidad_tarde: float= Field(ge=0, le=1) alerta: bool umbral: float= Field(ge=0, le=1) version_modelo: str version_api: strdef predecir_envios(envios, estado):"""Recibe casos ya validados y estado; devuelve una respuesta por paquete.""" tabla = pd.DataFrame([envio.model_dump() for envio in envios]) tabla["peso_kg"] = pd.to_numeric(tabla["peso_kg"]) probabilidades = estado.modelo.predict_proba(tabla)[:, 1] respuestas = []for probabilidad in probabilidades: respuestas.append({"probabilidad_tarde": float(probabilidad),"alerta": bool(probabilidad >= estado.registro["umbral"]),"umbral": estado.registro["umbral"],"version_modelo": estado.registro["version_modelo"], "version_api": "v1"})return respuestasdef crear_app(ruta_registro):"""Recibe la ruta del registro; devuelve FastAPI sin abrir un puerto.""" ruta_registro = Path(ruta_registro)@asynccontextmanagerasyncdef arranque(aplicacion):"""Carga y verifica al iniciar; libera el modelo al terminar.""" registro = json.loads(ruta_registro.read_text(encoding="utf-8")) ruta_modelo = ruta_registro.parent / registro["archivo_pipeline"]if hashlib.sha256(ruta_modelo.read_bytes()).hexdigest() != registro["huella_pipeline"]:raiseValueError("La huella del pipeline no coincide con el registro") aplicacion.state.modelo = joblib.load(ruta_modelo) aplicacion.state.registro = registro aplicacion.state.cargas =1yield aplicacion.state.modelo =None app = FastAPI(title="Alertas de envíos", version="1.0.0", lifespan=arranque)@app.get("/salud")def salud():"""Devuelve disponibilidad y versión de la instancia cargada."""return {"listo": app.state.modelo isnotNone,"version_modelo": app.state.registro["version_modelo"]}@app.post("/v1/predecir", response_model=Respuesta)def predecir(envio: Envio):"""Recibe un paquete validado y devuelve su respuesta identificada."""return predecir_envios([envio], app.state)[0]@app.post("/v1/predecir-lote", response_model=list[Respuesta])def predecir_lote(lote: Lote):"""Recibe un lote validado y devuelve respuestas en el mismo orden."""return predecir_envios(lote.envios, app.state)@app.exception_handler(Exception)asyncdef fallo_interno(peticion, error):"""Recibe un error inesperado y devuelve un mensaje público breve."""return JSONResponse(status_code=500, content={"detail": "Fallo interno de predicción"})return app
Mantendrás abierto un único cliente de pruebas durante las comprobaciones. ExitStack permite conservar su contexto entre las celdas y cerrarlo al finalizar el recorrido. Esa apertura ejecuta el arranque; las llamadas posteriores encuentran el pipeline en memoria.
La consulta de salud devuelve 200 y listo igual a True para corrida_02. La predicción devuelve 200, probabilidad 0.7626165643744094, alerta True y umbral 0.45. El contador muestra 1 carga del modelo. Al redondear a 6 decimales recuperas el 0.762617 de referencia del libro.
La respuesta conserva dos identidades: v1 para esta interfaz y corrida_02 para el archivo del modelo reconstruido. Si alguna vez cambia la probabilidad para el mismo paquete, esas identidades ayudarán a localizar qué se estaba usando. El corte 0.45 también queda a la vista.
6) Provocar entradas incorrectas y un fallo interno
Ahora envía cinco casos con problemas concretos. Falta el peso, la distancia llegó como metros, el peso es texto, aparece un servicio fuera del catálogo o sobra una columna. Cada caso debería terminar en 422 antes de llamar al pipeline. La tabla mostrará qué campo identifica la validación.
Después enviarás mismo día para comprobar la política que declaraste. Finalmente quitarás temporalmente el objeto del modelo de la memoria de prueba. Primero observarás la excepción de Python y después la respuesta HTTP correspondiente. La restauración ocurre en un bloque finally, para conservar el modelo sano incluso si una comprobación falla.
Mismo día: 200 {'probabilidad_tarde': 0.615655731347003, 'alerta': True, 'umbral': 0.45, 'version_modelo': 'corrida_02', 'version_api': 'v1'}
AttributeError: 'NoneType' object has no attribute 'predict_proba'
Fallo interno: 500 {'detail': 'Fallo interno de predicción'}
Restaurada: 200
Los 5 casos inválidos devolvieron 422. La tabla identifica peso_kg ausente, distancia_km fuera del límite, peso_kg con tipo incorrecto, servicio fuera del catálogo y peso como campo adicional. Mismo día sí devolvió 200, con probabilidad 0.615655731347003 y alerta True. Al retirar el modelo apareció AttributeError: 'NoneType' object has no attribute 'predict_proba'; la petición correspondiente recibió 500 y el mensaje público Fallo interno de predicción. Después de restaurarlo, la respuesta volvió a 200.
La entrada incorrecta necesita una corrección del caso recibido. El fallo interno necesita revisar el componente que predice. El cliente de pruebas se configuró para recibir la respuesta 500 en lugar de volver a lanzar la excepción dentro del notebook; por eso puedes examinar su código y cuerpo como lo haría otro programa.
La respuesta pública de 500 es breve. En una aplicación operativa registrarías por separado el detalle técnico y un identificador de petición, de modo que el equipo pudiera investigar sin mostrar rutas o información interna a Laura. La tabla final resume esa ampliación de operación.
7) Un paquete o varios conservan la misma preparación
NotaPredicción individual y por lote
Una predicción individual atiende un paquete. Una predicción por lote recibe varios y devuelve una respuesta por fila, en el mismo orden. Ambas utilizan el mismo pipeline y el mismo umbral; cambia cómo agrupas el trabajo, no lo que aprende la preparación.
Una recepción puede pedir la alerta al registrar cada paquete. Otra operación puede reunir los paquetes de un vehículo y pedir todas las alertas juntas. En la ruta de lote admitirás entre 1 y 100 envíos. Todos se validan antes de predecir: si una fila incumple el esquema, el lote se rechaza completo.
La comparación utiliza el paquete de Laura, un express de 100 km y 2 kg y un estándar de 300 km y 4 kg. Primero pide cada uno por separado y después los tres juntos. La igualdad de respuestas comprobará la misma preparación y política para las dos formas de solicitar el resultado.
paquetes = [paquete_laura, {"distancia_km": 100.0, "peso_kg": 2.0, "servicio": "express"}, {"distancia_km": 300.0, "peso_kg": 4.0, "servicio": "estándar"}]individuales = [cliente.post("/v1/predecir", json=p).json() for p in paquetes]respuesta_lote = cliente.post("/v1/predecir-lote", json={"envios": paquetes})print("Lote:", respuesta_lote.status_code, "Filas:", len(respuesta_lote.json()))display(pd.DataFrame(respuesta_lote.json()))print("Coinciden con peticiones individuales:", individuales == respuesta_lote.json())print("Lote vacío:", cliente.post("/v1/predecir-lote", json={"envios": []}).status_code)
Lote: 200 Filas: 3
probabilidad_tarde
alerta
umbral
version_modelo
version_api
0
0.762617
True
0.45
corrida_02
v1
1
0.109867
False
0.45
corrida_02
v1
2
0.455890
True
0.45
corrida_02
v1
Coinciden con peticiones individuales: True
Lote vacío: 422
El lote devolvió 200 y 3 respuestas, con probabilidades redondeadas de 0.762617, 0.109867 y 0.455890. Sus alertas son True, False y True con el mismo umbral 0.45. La igualdad con las peticiones individuales devuelve True. Un lote vacío devuelve 422 porque requiere al menos 1 envío.
La forma de agrupar puede reducir trabajo repetido de comunicación y construcción de tablas. El tamaño permitido limita cuánto puede contener una petición. El ejemplo conserva pocas filas para que puedas seguir la correspondencia entre cada envío y su respuesta.
8) Medir cuánto espera el cliente
NotaLatencia y percentil
La latencia es el tiempo transcurrido entre iniciar una petición y recibir su respuesta. Un percentil resume la distribución de esos tiempos: p50 es la mediana y p95 deja aproximadamente el 95 % de los tiempos por debajo de ese valor, según la convención de cálculo utilizada.
Medirás treinta peticiones después del arranque. El reloj rodea la llamada completa del cliente de pruebas, que incluye recorrido de la aplicación, validación y predicción. El tiempo de entrenamiento queda fuera de esta medida porque ocurrió al preparar el archivo, antes de atender casos.
El ejemplo utiliza TestClient dentro del computador. Una aplicación por red sumaría transporte y otros componentes de la infraestructura. Puedes usar esta medida local para comprobar el recorrido del programa y más adelante medir en el lugar donde realmente lo utiliza Laura.
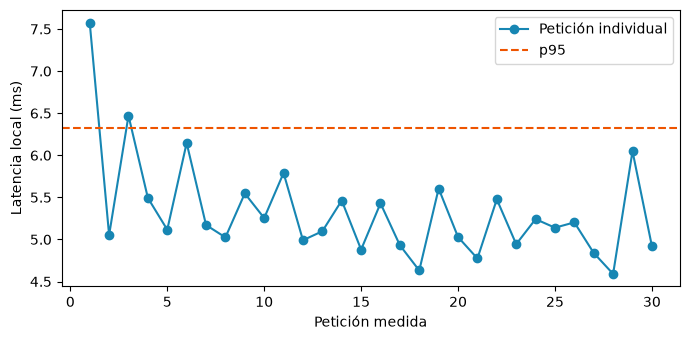
Las 30 peticiones tuvieron p50 de 5.156 ms y p95 de 6.324 ms en esta ejecución local. El contador de cargas continúa en 1. Estas cifras miden la llamada a la aplicación ya iniciada, con el mismo paquete y modelo en cada petición.
La gráfica conserva un punto por petición y la referencia p95. Los marcadores permiten localizar una petición más lenta sin depender del color. El valor medido puede cambiar al ejecutar en otro momento, aunque el modelo y las probabilidades se mantengan iguales.
Figura 9.1: Tiempo de respuesta de treinta peticiones locales
Modelo liberado al cerrar: True
Los 30 puntos conservan los tiempos individuales y la línea discontinua marca p95 de 6.324 ms. La salida final indica Modelo liberado al cerrar: True: el contexto terminó y el estado dejó de conservar el pipeline en memoria.
Cerrar el contexto libera el objeto cargado para esta aplicación de prueba. Los archivos de artefactos/servicio-envios permanecen para revisión. Si quieres retirar los resultados, puedes borrar únicamente esa carpeta cuando termines de inspeccionarla; el siguiente Restart + Run All la reconstruirá desde cero.
9) Qué necesita añadirse para una operación real
La aplicación que probaste ya tiene rutas ejecutables, esquemas y un modelo identificado. Una operación de empresa incorpora otras decisiones alrededor de ella. La tabla las presenta como preguntas concretas, para que puedas relacionarlas con las peticiones que acabas de observar.
Aspecto
Qué significa aquí
Pregunta para el sistema de Laura
Autenticación
Comprobar quién llama al servicio.
¿Qué aplicaciones están autorizadas?
CORS
Declarar qué orígenes de navegador pueden acceder.
¿Desde qué sitio web se hará la petición?
Tamaño máximo
Limitar la entrada admitida.
¿Bastan los 100 envíos permitidos por lote?
Observabilidad
Conservar señales para entender cómo funciona.
¿Guardas estado, versión y latencia sin datos innecesarios?
Prueba de humo
Comprobación breve de que el servicio responde.
¿Salud y un paquete conocido funcionan antes de recibir trabajo?
Los nombres describen responsabilidades que puedes asignar al equipo. La autenticación distingue clientes autorizados; CORS corresponde a restricciones del navegador entre sitios. La prueba de humo utiliza una entrada conocida para descubrir problemas al iniciar una versión nueva. El capítulo 11 incorporará comprobaciones de este tipo antes de cambiar la referencia operativa.
El modelo y el programa también dependen de las bibliotecas instaladas. Guardaste las versiones en el registro, pero todavía tienes que preparar el entorno donde se ejecutará la aplicación. En el siguiente capítulo prepararás ese entorno para ejecutar el servicio en otra máquina.
NotaAlcance del experimento
Los datos son sintéticos y la reconstrucción usa una configuración ya elegida; no es una nueva selección de modelo. Los rangos y el catálogo de servicios son decisiones ilustrativas que deben acordarse con operaciones. TestClient ejecuta la aplicación sin un servidor de red, por lo que las latencias son locales. La carga única se refiere a cada proceso, y una operación con varias copias carga una por copia. El fallo del modelo se provocó únicamente en memoria y se restauró. La aplicación queda preparada y probada para revisión, sin publicación ni conexión con sistemas externos.
Errores frecuentes
Lo que ves
Qué pasó
Cómo se arregla
422 por peso_kg ausente
El campo requerido desapareció del mensaje.
Envía el peso o null cuando no se registró.
422 por rango de distancia
Llegó una distancia fuera de las unidades o límites acordados.
Comprueba la captura y los kilómetros.
422 por servicio
La etiqueta está fuera del catálogo admitido.
Revisa el nombre o acuerda la nueva categoría.
500 con entrada válida
Falló un componente interno.
Investiga el servidor y conserva el registro técnico del error.
Cada petición abre el joblib
La carga está dentro de la función de predicción.
Carga el objeto durante el arranque.
Las alertas difieren del registro
Se aplicó otro corte, como 0.50.
Lee el umbral que acompaña al modelo.
Individual y lote producen decisiones distintas
Cambió el orden o la preparación entre rutas.
Comparte el pipeline y conserva el orden de filas.
Lista de verificación
El cliente envía distancia y peso en las unidades declaradas.
El peso faltante viaja como null y sigue siendo un campo requerido.
El esquema define rangos, tipos y servicios admitidos.
La aplicación carga el pipeline y su registro al iniciar.
La respuesta incluye umbral y versión del modelo.
Las respuestas 200, 422 y 500 se comprobaron con peticiones reales a la aplicación.
La ruta individual y la de lote aplican la misma política.
El cliente de pruebas se cierra al terminar.
Ejercicios
Escribe el JSON del paquete de Laura y explica la diferencia entre peso_kg ausente y peso_kg igual a null.
Propón un nuevo rango de peso y decide qué entrada de prueba permitiría comprobar ambos límites sin modificar el modelo.
Diseña un lote con una fila incorrecta. Predice su código de respuesta y explica qué ocurre con las otras filas bajo esta política.
Explica qué cambiaría si la aplicación utilizase predict a 0.50 en lugar de comparar las probabilidades con el umbral del registro.
Distingue cambiar corrida_02 por otro modelo compatible de renombrar distancia_km en la interfaz. Indica qué debe saber el cliente en cada caso.
TipOrientaciones
Usa distancia_km de 520.0, peso_kg igual a null y servicio económico. Un campo ausente incumple el esquema; null declara que el valor no está registrado.
Declara primero el rango y prueba un valor dentro, los extremos admitidos y valores apenas fuera. La comprobación pertenece al esquema, antes de predecir.
La respuesta es 422 para el lote completo. La aplicación valida todas las filas antes de llamar al modelo y evita una respuesta parcialmente aceptada.
Probabilidades entre 0.45 y 0.50 dejarían de activar alertas. La política de Laura cambiaría aunque los coeficientes fuesen idénticos.
Una nueva corrida puede conservar los campos y devolver otra versión de modelo. Renombrar un campo modifica lo que el cliente debe enviar y requiere planear compatibilidad o una nueva interfaz.
Glosario
Término
Significado
Cliente
Programa que solicita una operación.
Servidor
Proceso que atiende peticiones.
Servicio de predicción
Interfaz para obtener resultados de un modelo.
Petición y respuesta
Mensajes de solicitud y de resultado.
JSON
Formato de intercambio con nombres y valores.
HTTP
Protocolo de comunicación de peticiones y respuestas.
API y ruta
Interfaz del programa e identificación de una operación.
Código de estado
Resumen del resultado de una petición.
Arranque
Preparación previa a atender casos.
Carga única
Recuperar el pipeline una vez por proceso al iniciar.
Pydantic
Herramienta de validación de campos y restricciones.
FastAPI
Herramienta para construir la aplicación HTTP.
TestClient
Cliente de prueba que ejecuta la aplicación localmente.
Predicción por lote
Respuestas para varios paquetes en una operación.
Latencia
Tiempo de una petición hasta su respuesta.
Percentil
Valor que resume una posición en la distribución de tiempos.
Autenticación
Comprobación de quién llama al servicio.
CORS
Reglas para acceso entre orígenes desde un navegador.
Observabilidad
Señales que permiten entender el funcionamiento.
Prueba de humo
Comprobación breve del recorrido básico de la aplicación.
Qué aprendiste
Convertiste la ventanilla de un diccionario en una aplicación que valida paquetes y devuelve resultados identificados. El modelo se cargó durante el arranque y su política viajó en el registro. Las peticiones mostraron por separado una predicción correcta, una entrada que necesita corregirse y un fallo interno.
Laura ya tiene una forma de pedir la alerta desde su sistema. En Contenerización y portabilidad prepararás el entorno que necesita esa aplicación para ejecutarse en otra máquina con las versiones adecuadas.