21Métodos de kernel: estimación de densidades y regresión
estadistica
suavizacion
kernel
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
27 de septiembre de 2026
Del knot a la ventana
En el capítulo anterior construiste splines: elegías dónde poner los nodos (knots) y ajustabas polinomios por tramos que se conectan suavemente. Funciona muy bien, pero exige decidir una estructura. En este capítulo tomas otro camino, todavía dentro de la suavización, con una idea más directa: estimar el comportamiento en cada punto a partir de los datos que están cerca, sin construir ninguna base polinómica ni colocar knots.
Esa idea, una ventana alrededor de cada punto y un peso que decae con la distancia, da lugar a dos herramientas: la estimación de densidades, que dice cómo se distribuyen tus datos, y la regresión por kernel, que estima qué valor de \(y\) esperar para cada \(x\). Y trae de vuelta, con otro nombre, el compromiso sesgo-varianza que ya conoces.
Tiempo estimado de lectura: 65 minutos (unas 2 horas y media si ejecutas el código y respondes las preguntas)
Todos los datos son simulados con las fórmulas y semillas declaradas en el código: 600 desviaciones de entregas mezcladas de dos rutas, 12 000 vehículos repartidos con la curva de tráfico del capítulo anterior, una relación \(y=\sin(x)+0.3x\) con ruido en dos muestras independientes y una recta \(y=0.5x\) con ruido para el sesgo de frontera. No proceden de clientes. Todo corre en CPU, y las versiones se imprimen en la primera celda de código.
Objetivos
Al terminar este capítulo vas a ser capaz de:
definir una densidad de probabilidad, un kernel de suavización y el estimador de densidad por kernel (KDE), y reconocer los kernels más usados (gaussiano, Epanechnikov y uniforme);
explicar por qué un histograma depende del origen de sus intervalos y estimar una densidad con KDE;
aplicar la regresión por kernel (estimador de Nadaraya–Watson) para suavizar una relación no lineal;
interpretar el ancho de banda \(h\) como el parámetro del compromiso sesgo-varianza y seleccionarlo por validación cruzada;
reconocer el sesgo de frontera, reducirlo con una recta local y comparar el suavizado por kernel con el spline y la recta;
usar una densidad estimada para detectar valores inusuales y calibrar su umbral con datos separados.
Ejecuta las celdas en orden: las secciones comparten variables y generadores.
21.1 Preparación del entorno
La celda carga NumPy, Matplotlib, SciPy, scikit-learn y statsmodels, fija la semilla central y crea los generadores de cada parte del capítulo.
import numpy as npimport matplotlib.pyplot as pltfrom scipy.stats import gaussian_kdefrom sklearn.neighbors import KernelDensityfrom sklearn.preprocessing import SplineTransformerfrom sklearn.linear_model import LinearRegressionfrom sklearn.pipeline import make_pipelinefrom sklearn.model_selection import train_test_split, GridSearchCV, KFoldfrom sklearn.metrics import r2_score, mean_squared_errorfrom statsmodels.nonparametric.smoothers_lowess import lowessSEMILLA =2026plt.rcParams['figure.figsize'] = (8, 4)print("Librerías cargadas")# Generadores independientes configurados al inicio.rng_densidad = np.random.default_rng(SEMILLA)rng_avenida = np.random.default_rng(SEMILLA)rng_regresion = np.random.default_rng(SEMILLA)rng_frontera = np.random.default_rng(SEMILLA)rng_evaluacion = np.random.default_rng(SEMILLA +1)# Versiones del entorno usado para ejecutar este capítulo.import sysimport importlib.metadata as metadatosprint('Python:', sys.version.split()[0])for paquete in ['numpy', 'pandas', 'matplotlib', 'scipy', 'scikit-learn', 'statsmodels']:print(paquete +':', metadatos.version(paquete))import matplotlib.pyplot as pltfrom cycler import cyclerplt.rcParams['axes.prop_cycle'] = cycler(color=['#1786B3', '#EE5400', '#487A35', '#7851A9']) + cycler(linestyle=['-', '--', '-.', ':'])plt.rcParams['font.size'] =10
El entorno queda con Python 3.13.14, NumPy 2.5.1, SciPy 1.18.0, scikit-learn 1.9.0 y statsmodels 0.14.6.
En la primera parte estimas la distribución de las desviaciones de 600 entregas, medidas en horas. Es el terreno donde la idea del kernel se ve con más claridad.
21.3 Qué es una densidad (definición formal)
Cuando la variable es continua, como la desviación en horas de una entrega (el ejemplo que sigue), un valor exacto tiene probabilidad cero: \(P(X = -2.17) = 0\). Lo que sí tiene sentido es la probabilidad de un intervalo.
La función de densidad\(f\) es una función no negativa que convierte el área bajo la curva en probabilidad:
\[P(a \le X \le b) = \int_a^b f(x)\,dx, \qquad \int_{-\infty}^{\infty} f(x)\,dx = 1.\]
El número \(f(x)\)no es una probabilidad. Es cuánta probabilidad se concentra por unidad de \(x\) alrededor de ese punto (en este ejemplo, por hora). Por eso, en las figuras de más adelante, los puntos negros van sobre el eje: marcan dónde cayeron los datos. La altura de la curva es densidad, no un \(y\) observado.
Un histograma de conteos responde «¿cuántos cayeron en este intervalo?». El mismo histograma con el eje en densidad, y, más adelante, el estimador por kernel, responde «¿qué tan concentrada está la probabilidad ahí?». El objetivo de esta parte es estimar\(f\) a partir de una muestra, sin suponer de antemano que sea una gaussiana.
21.4 El histograma engaña más de lo que crees
El histograma es la primera herramienta para ver una distribución, pero su forma depende de decisiones arbitrarias: el ancho de los intervalos (bins) y dónde empiezan. La misma variable puede contar historias distintas.
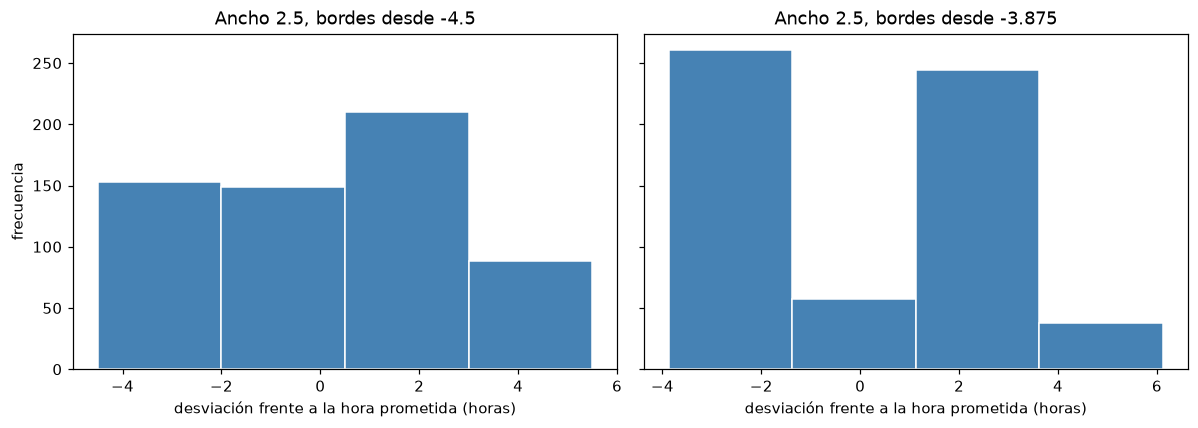
Generas una variable con dos grupos. Piensa, por ejemplo, en la desviación (en horas) frente a la hora prometida de entrega para envíos de dos rutas mezclados: los valores negativos son entregas que llegaron antes; los positivos, entregas tardías. La dibujas dos veces con el mismo ancho de bin, cambiando solo el punto donde empiezan los intervalos.
n =600comp = rng_densidad.random(n) <0.5datos = np.where(comp, rng_densidad.normal(-2, 0.6, n), rng_densidad.normal(2.5, 1.0, n))ancho =2.5bordes_a = np.arange(-4.5, 8.0, ancho) # intervalos que empiezan en -4.5bordes_b = bordes_a + ancho /4# mismos intervalos, corridos 0.625fig, ax = plt.subplots(1, 2, figsize=(11, 4), sharey=True)conteos_a, _, _ = ax[0].hist(datos, bins=bordes_a, color='steelblue', edgecolor='white')conteos_b, _, _ = ax[1].hist(datos, bins=bordes_b, color='steelblue', edgecolor='white')ax[0].set_title(f'Ancho {ancho}, bordes desde {bordes_a[0]}')ax[1].set_title(f'Ancho {ancho}, bordes desde {bordes_b[0]}')for a in ax: a.set_xlabel('desviación frente a la hora prometida (horas)')ax[0].set_ylabel('frecuencia')plt.tight_layout(); plt.show()print('Conteos, bordes desde -4.5 :', conteos_a.astype(int))print('Conteos, bordes desde -3.875:', conteos_b.astype(int))print('Media global:', round(datos.mean(), 2))
Conteos, bordes desde -4.5  : [153 149 210  88]
Conteos, bordes desde -3.875: [261  57 244  38]
Media global: 0.25
Los dos gráficos usan exactamente los mismos datos y el mismo ancho de bin; solo se corrieron los bordes 0.625 horas. A la izquierda, los conteos son 153, 149, 210 y 88: se ve una meseta irregular, sin un valle claro. A la derecha, 261, 57, 244 y 38: aparecen dos grupos nítidos separados por un valle. La conclusión cambió por una decisión de dibujo que nada tiene que ver con los datos.
Pasa porque, a la izquierda, un borde cae en −2, justo en el centro del primer grupo, y lo parte en dos barras de altura parecida. A la derecha, ese grupo cae casi entero dentro de un solo intervalo.
Fíjate además en la media global: 0.25, que cae en el valle entre los dos grupos, donde casi no hay envíos. Un resumen puede describir un punto que ningún dato ocupa. Para entender la variable necesitas su forma completa, y el histograma es demasiado frágil para dártela.
La misma trampa, en la avenida
En el capítulo anterior el flujo de esa avenida se grafica contra la hora, y se ven dos picos: uno a las 8 y otro cerca de las 18. Ese gráfico conserva la hora. El histograma hace otra pregunta: si anotas solo la hora a la que pasa cada vehículo, ¿siguen viéndose las dos horas pico?
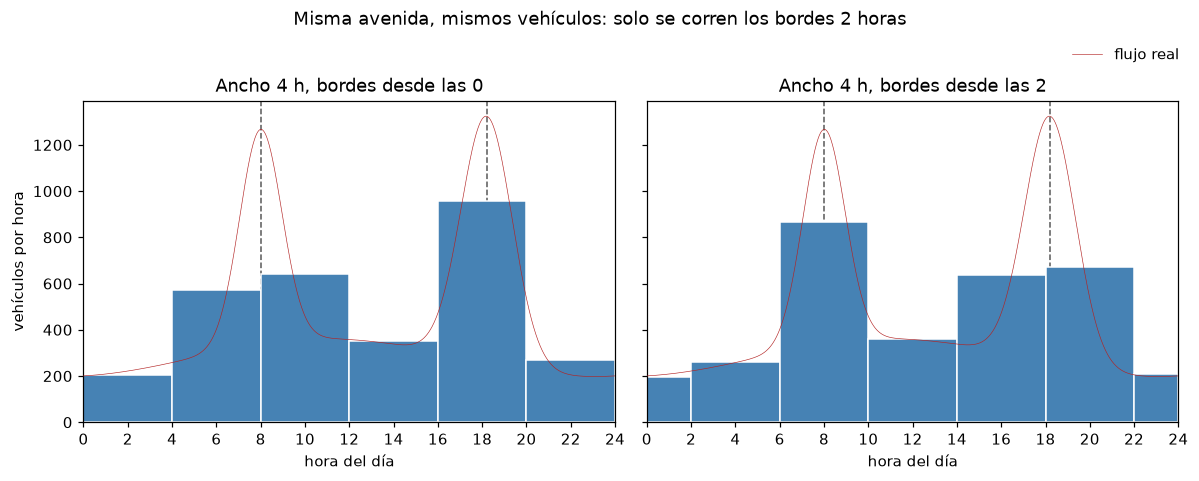
Abajo hay 12 000 vehículos repartidos con la misma curva de flujo: pasan más donde el flujo es más alto. Los dos paneles usan intervalos de 4 horas. Solo cambia dónde empiezan, a las 0 o a las 2. La línea roja es el flujo real, en vehículos por hora, para ver dónde cae cada corte. Las líneas punteadas marcan las 8:00 y las 18:12, el centro de cada pico.
def flujo_verdadero(hora):"""Vehículos por minuto según la hora. La misma curva del artículo anterior.""" ritmo_base =24+7* np.sin((hora -5) * np.pi /12) pico_manana =80* np.exp(-0.5* ((hora -8.0) /0.95) **2) pico_tarde =92* np.exp(-0.5* ((hora -18.2) /1.15) **2)return ritmo_base + pico_manana + pico_tardeminutos = np.linspace(0, 24, 24*60, endpoint=False)peso = np.clip(flujo_verdadero(minutos), 0, None)peso = peso / peso.sum()n_vehiculos =12000hora_paso = rng_avenida.choice(minutos, size=n_vehiculos, p=peso)t = np.linspace(0, 24, 1000)flujo = np.clip(flujo_verdadero(t), 0, None)curva = n_vehiculos * flujo / np.trapezoid(flujo, t)ancho =4inicios_a =list(range(0, 24, ancho)) # bordes en 0, 4, 8, 12, 16, 20inicios_b =list(range(-2, 24, ancho)) # los mismos intervalos, corridos 2 horasfig, ejes = plt.subplots(1, 2, figsize=(11, 4.2), sharey=True)paneles = ( (ejes[0], inicios_a, 'Ancho 4 h, bordes desde las 0'), (ejes[1], inicios_b, 'Ancho 4 h, bordes desde las 2'),)tasas = []for eje, inicios, titulo in paneles: tasas_panel = []for inicio in inicios: lo =max(inicio, 0) hi =min(inicio + ancho, 24)if hi <= lo:continue conteo = np.sum((hora_paso >= lo) & (hora_paso < hi)) tasa = conteo / (hi - lo) tasas_panel.append(round(tasa)) eje.bar( lo, tasa, width=hi - lo, align='edge', color='steelblue', edgecolor='white', zorder=2, ) eje.plot(t, curva, color='firebrick', lw=0.4, ls='-', zorder=3) eje.axvline(8.0, color='0.35', ls='--', lw=1, zorder=1) eje.axvline(18.2, color='0.35', ls='--', lw=1, zorder=1) eje.set_xlim(0, 24) eje.set_xticks(range(0, 25, 2)) eje.set_title(titulo) eje.set_xlabel('hora del día') tasas.append(tasas_panel)ejes[0].set_ylabel('vehículos por hora')fig.legend(['flujo real'], loc='upper right', frameon=False, bbox_to_anchor=(0.99, 0.98))fig.suptitle('Misma avenida, mismos vehículos: solo se corren los bordes 2 horas', y=1.03)plt.tight_layout()plt.show()print('Bordes desde las 0:', tasas[0])print('Bordes desde las 2:', tasas[1])
Bordes desde las 0: [206, 574, 642, 351, 958, 271]
Bordes desde las 2: [194, 261, 867, 361, 637, 673, 208]
A la izquierda, con bordes en 0, 4, 8, 12, 16 y 20, las tasas son 206, 574, 642, 351, 958 y 271 vehículos por hora. El corte de las 8 parte la mañana en dos barras parecidas, 574 y 642. La tarde cae entera entre las 16 y las 20 y queda en 958, la barra más alta. Se lee un pico de tarde y una meseta de mañana, de 4 a 12.
A la derecha, con los bordes corridos 2 horas, los intervalos completos de 4 horas dan 261, 867, 361, 637 y 673. La mañana cae entera entre las 6 y las 10: 867, la barra más alta. El corte de las 18 parte la tarde en 637 y 673. Se lee lo contrario: un pico de mañana y una meseta de tarde, de 14 a 22.
Los extremos del panel derecho, 194 y 208, cubren solo dos horas (de 0 a 2 y de 22 a 24) porque el día se acaba. Su altura ya está en vehículos por hora, así que se comparan con las demás.
Los vehículos son los mismos. Cambia sobre qué pico cae el borde.
21.5 Qué es un kernel (definición formal)
Un kernel\(K\) es una función de ponderación: asigna a cada punto un peso según su distancia. En este capítulo trabajas con kernels de suavización no negativos, normalizados y simétricos. Estas son las propiedades de los tres ejemplos siguientes; no son una definición universal para todos los métodos que usan la palabra kernel:
No negatividad:\(K(u) \ge 0\) para todo \(u\).
Integra uno:\(\int_{-\infty}^{\infty} K(u)\,du = 1\) (su área vale 1, como una densidad de probabilidad).
Simetría:\(K(-u) = K(u)\) (pesa igual a izquierda y derecha).
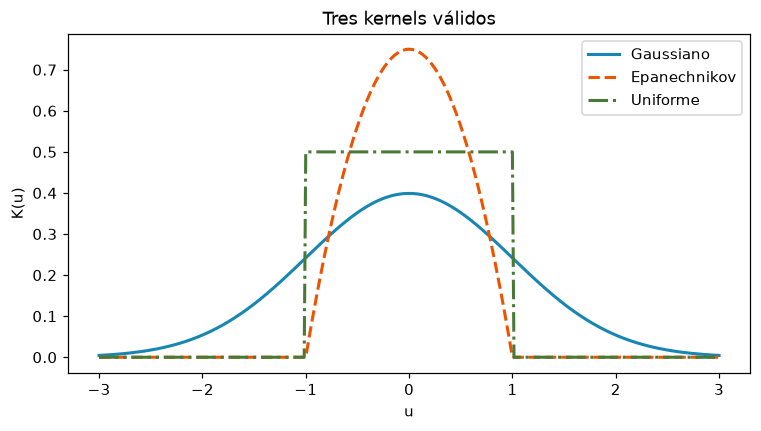
Hay muchos kernels válidos. Los tres más comunes:
Gaussiano:\(K(u) = \frac{1}{\sqrt{2\pi}} e^{-u^2/2}\). Suave, con soporte infinito (todo punto recibe algún peso).
Epanechnikov:\(K(u) = \frac{3}{4}(1-u^2)\) para \(|u|\le 1\). Tiene soporte finito y es óptimo en un sentido teórico preciso: entre los kernels no negativos y simétricos, y usando para cada uno su ancho de banda óptimo, minimiza el error integrado cuadrático medio asintótico (AMISE) en el marco habitual de estimación de densidades de segundo orden. Es un resultado asintótico bajo condiciones de regularidad, no una garantía de menor error en cualquier muestra.
Uniforme:\(K(u) = \frac{1}{2}\) para \(|u|\le 1\). Una caja: todos los vecinos dentro de la ventana pesan igual.
Los tres tienen la misma misión, dar más peso a lo cercano, pero con perfiles distintos. El gaussiano decae suavemente y nunca llega a cero: hasta los puntos lejanos aportan algo. El Epanechnikov y el uniforme tienen soporte finito: fuera de la ventana \(|u|\le 1\), el peso es exactamente cero. El uniforme es una caja (todos los vecinos pesan igual, como en un histograma móvil); el Epanechnikov es un compromiso suave con soporte acotado. Entre estos kernels habituales, la elección del ancho de banda suele influir más que la forma del kernel. La comparación teórica requiere optimizar el ancho para cada kernel y fijar un criterio de error; no significa que sean intercambiables con cualquier valor de h.
21.6 Qué es el KDE (definición formal)
La densidad \(f\) de la población no la observas. Observas una muestra \(x_1,\ldots,x_n\). El estimador de densidad por kernel (KDE, kernel density estimator) es una curva \(\hat f\) que estima esa \(f\) desconocida:
En palabras: colocas sobre cada dato una campana (el kernel \(K\)) de ancho \(h\), las sumas y divides por \(n\) para que el área siga siendo 1. \(\hat f(x)\) estima la densidad desconocida; depende de la muestra y del ancho de banda \(h\).
La diferencia con el histograma es que no partes el eje en intervalos fijos: cada observación lleva su propia campana centrada en ella.
21.7 Construir el KDE paso a paso
La muestra tiene 600 entregas. El KDE pone una campana sobre cada una, así que el estimador de verdad son 600 campanas promediadas. Si las dibujaras todas a la vez, se fundirían y no verías la pieza básica. Por eso vas en tres tomas, de menos a más:
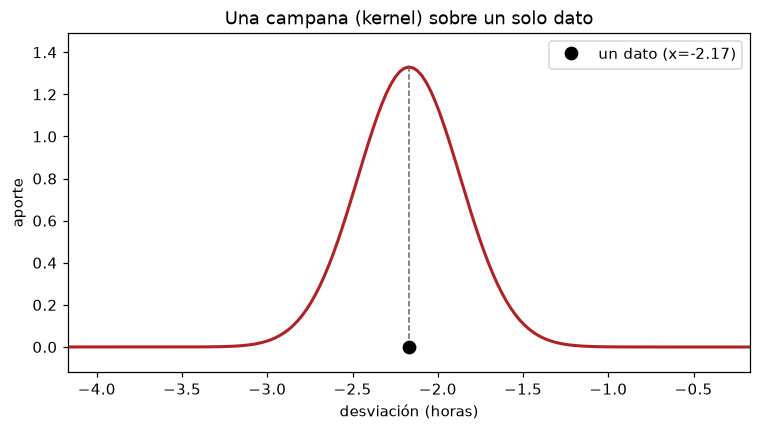
Un dato. Una sola campana, para ver la pieza básica: el kernel centrado en un punto.
Ocho datos. Los primeros 8 de la muestra (datos[:8]), cada uno con su campana, sin sumarlas. Es una lupa: se distinguen los solapes y los huecos. Este recorte permite distinguir los aportes antes de construir la densidad completa.
Los 600. Ahí sí se suman y se promedian todas las campanas. Esa curva ya es el KDE, en la misma escala que el histograma.
Para dibujar, evalúas cada campana en una malla de 500 valores de \(x\) entre \(-6\) y \(7\) horas (grid = np.linspace(-6, 7, 500)). Esas 500 columnas son puntos de dibujo, no observaciones: si pusieras 200 o 1000, la curva sería la misma idea, solo más tosca o más suave al trazarla.
La celda siguiente hace la primera toma.
def campana(x, centro, h):"""Kernel gaussiano centrado en 'centro' con ancho h (ya normalizado)."""return np.exp(-0.5* ((x - centro) / h) **2) / (h * np.sqrt(2* np.pi))grid = np.linspace(-6, 7, 500) # malla de dibujo: 500 valores de x, no 500 datospunto = datos[0]h =0.3altura = campana(punto, punto, h)plt.plot(grid, campana(grid, punto, h), color='firebrick', linewidth=2)plt.vlines(punto, 0, altura, colors='0.4', linestyles='--', linewidth=1)plt.plot([punto], [0], 'ko', markersize=8, clip_on=False, zorder=5, label=f'un dato (x={punto:.2f})')plt.xlim(punto -2, punto +2)plt.ylim(-0.12, altura *1.12)plt.xlabel('desviación (horas)'); plt.ylabel('aporte'); plt.legend()plt.title('Una campana (kernel) sobre un solo dato'); plt.show()
La figura muestra una campana de ancho 0.3 horas centrada en la primera entrega de la muestra. El punto negro vive sobre el eje porque es el dato, no el valor de la densidad. La línea punteada sube hasta el pico: ahí el aporte es máximo; a los lados, decae. Un solo punto genera un solo pico: la unidad básica con la que se construye toda la densidad.
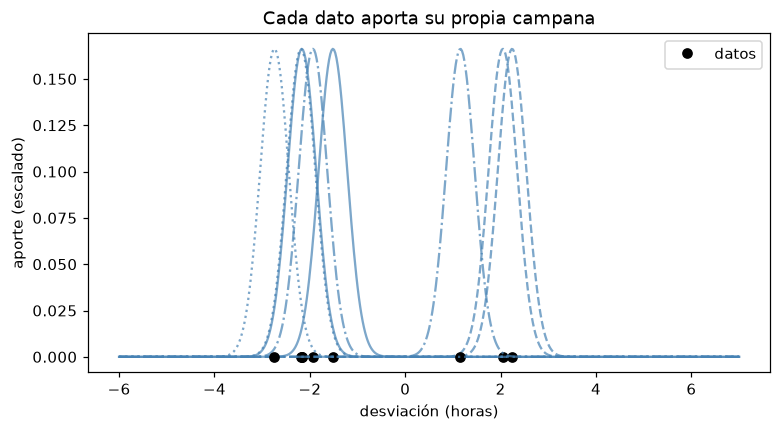
Esta celda repite la campana, pero ya no sobre un solo dato: toma los primeros 8 de la muestra de entregas y dibuja una por cada uno.
sub = datos[:8] se queda con esas ocho desviaciones, en horas.
Cada punto negro es uno de esos datos, puesto sobre el eje en altura 0. El primer plot solo sirve para que la leyenda diga «datos» una vez; el bucle dibuja el resto.
Para cada dato, campana(grid, xi, 0.3) es la misma gaussiana de antes, centrada en ese punto y con ancho \(h = 0.3\). Dividir por len(sub) (por 8) deja el aporte que ese dato tendría en el promedio: un octavo de la campana, no la campana entera. Por eso el eje se llama «aporte (escalado)».
Las ocho curvas se dibujan por separado, sin sumarlas. Donde dos datos están cerca, las campanas se cruzan; donde hay un hueco, queda espacio vacío. En el paso siguiente dejas este recorte y sumas las campanas de los 600 datos.
# Los primeros 8 datos de la muestra de entregas.sub = datos[:8]# Un solo punto con etiqueta, para que la leyenda no repita «datos» ocho veces.plt.plot([sub[0]], [0], 'ko', markersize=6, label='datos')for xi in sub:# Campana centrada en xi, ancho 0.3, dividida por 8: el aporte de un dato al promedio. plt.plot(grid, campana(grid, xi, 0.3) /len(sub), color='steelblue', alpha=0.7) plt.plot([xi], [0], 'ko', markersize=6)plt.xlabel('desviación (horas)'); plt.ylabel('aporte (escalado)'); plt.legend()plt.title('Cada dato aporta su propia campana'); plt.show()
Con varios puntos, cada uno pone su campana. Donde los datos se agolpan, las campanas se solapan y se apilan; donde hay huecos, apenas hay aporte. La figura siguiente suma los aportes de las 600 observaciones, manteniendo la normalización por su cantidad.
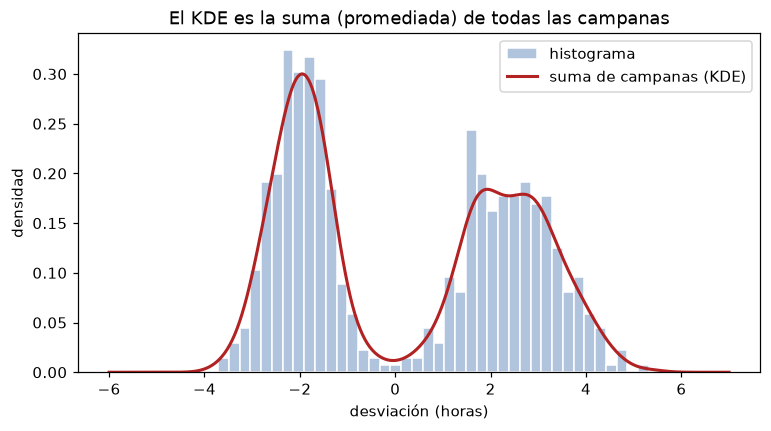
Esta celda termina la construcción: suma las campanas de los 600 datos y las dibuja junto al histograma.
Fija el ancho de cada campana en \(h = 0.3\) horas, el mismo de las figuras anteriores.
Recorre cada dato y evalúa campana sobre la malla grid de 500 valores de \(x\) (la misma de las figuras anteriores: np.linspace(-6, 7, 500)). Sale una matriz de 600 filas × 500 columnas: una fila por entrega, una columna por cada punto donde se dibuja la curva. Las 500 columnas corresponden a la malla de dibujo; las 600 filas representan las entregas observadas.
Promedia las filas. mean(axis=0) es \(\frac{1}{n}\) por la suma de las campanas. Como campana ya divide por \(h\), la curva integra uno: es una densidad. Esa curva es el KDE armado a mano.
Dibuja el histograma con density=True, para que el eje sea densidad y no conteos, y superpone la curva. Así las dos estimaciones se leen en la misma escala.
# h: ancho de cada campana, en horas. El mismo de las figuras anteriores.h =0.3# Una fila por cada uno de los 600 datos; 500 columnas = la malla de dibujo (grid), no 500 entregas.aportes = np.array([campana(grid, xi, h) for xi in datos])# Promedio de las 600 filas = (1/n) * suma. Eso es el KDE, y ya integra uno.kde_manual = aportes.mean(axis=0)# density=True pone el histograma en la misma escala que la curva (densidad, no conteos).plt.hist(datos, bins=40, density=True, color='lightsteelblue', edgecolor='white', label='histograma')plt.plot(grid, kde_manual, color='firebrick', linewidth=2, label='suma de campanas (KDE)')plt.xlabel('desviación (horas)'); plt.ylabel('densidad'); plt.legend()plt.title('El KDE es la suma (promediada) de todas las campanas'); plt.show()
Esa curva roja es el KDE: la suma de las 600 campanas, dividida por el número de datos para que integre uno. Cada campana está centrada en su propio dato, no en intervalos fijados de antemano, así que desaparece la arbitrariedad del punto de inicio que viste en el histograma, y la estructura real emerge sola: las dos modas de la mezcla simulada. Acabas de construir un estimador de densidad desde cero. Lo que sí sigue por decidir es el ancho de cada campana, \(h\), que cumple el papel del ancho del bin; a eso vuelves enseguida.
En el ejemplo de las entregas, esos dos picos serían dos rutas: una que suele llegar unas dos horas antes de lo prometido, muy concentrada, y otra que llega unas dos horas y media tarde, más dispersa. La media global (0.25) no describe a ninguna de las dos: cae en el valle, donde casi no hay envíos. Mezclarlas en un solo número borra justo lo que te importa: que hay dos operaciones distintas.
21.8 La fórmula del KDE, ahora en código
La definición de arriba es lo que acabas de armar a mano:
donde \(K\) es el kernel, \(n\) el número de datos y \(h\) el ancho de banda. En la práctica no la programas a mano: scipy y scikit-learn la traen lista. Pero no hacen lo mismo con \(h\). scipy.gaussian_kdeelige el ancho de banda por ti (regla de Scott por defecto, o Silverman si se lo pides con bw_method='silverman').
Las reglas de Scott y de Silverman son fórmulas cerradas para elegir \(h\) sin validar. En una dimensión las dos son del tipo \(h = c\,\hat\sigma\, n^{-1/5}\): miran el tamaño de muestra y la dispersión de los datos. El \(n^{-1/5}\) tiene una derivación asintótica: sale de minimizar el AMISE (asymptotic mean integrated squared error), un error teórico de toda la curva cuando \(n\) es grande, promedio, a lo largo de \(x\), de \((\hat f - f)^2\). Lo usan suponiendo que \(f\) se parece a una gaussiana (referencia normal). Scott, en scipy, usa el factor \(n^{-1/5}\) (\(c = 1\)). Silverman usa un factor distinto: en scipy es \((3n/4)^{-1/5}\); en la versión de los libros a veces entra también el rango intercuartílico, más resistente a valores extremos. Ninguna de las dos inspecciona si hay dos grupos o un pico raro: si la forma no es gaussiana, el \(h\) que entregan no es un óptimo para esa muestra, solo un atajo rápido. La fórmula del AMISE aparece desglosada en la sección del compromiso sesgo-varianza.
En sklearn normalmente fijas \(h\) tú, y si le pides una regla automática hay un detalle que conviene conocer, y la celda siguiente lo muestra.
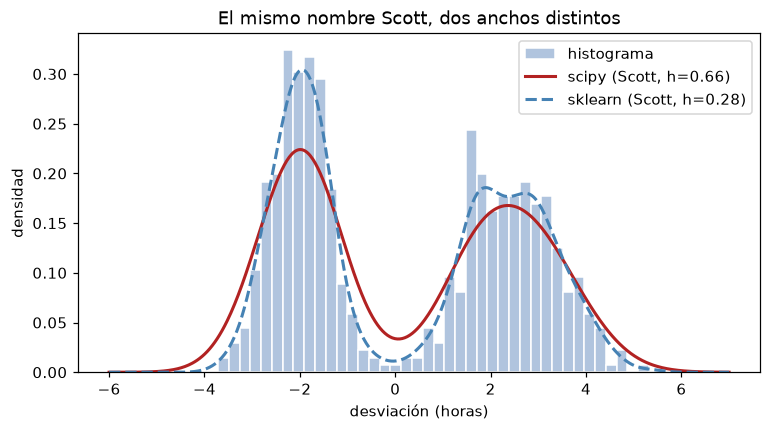
kde_scipy = gaussian_kde(datos) # bw_method='scott' por defectoh_scott =float(np.sqrt(np.asarray(kde_scipy.covariance).squeeze()))kde_sk_scott = KernelDensity(bandwidth='scott').fit(datos.reshape(-1, 1))h_sk =float(kde_sk_scott.bandwidth_)# score_samples devuelve log-densidad; exp la pasa a la misma escala que scipy.dens_sk = np.exp(kde_sk_scott.score_samples(grid.reshape(-1, 1)))print('scipy.gaussian_kde elige el ancho de banda solo (regla de Scott).')print(f' h de scipy: {h_scott:.3f}')print(f' h de sklearn con "scott": {h_sk:.3f}')print(f' desviación estándar datos: {datos.std(ddof=1):.3f}')plt.hist(datos, bins=40, density=True, color='lightsteelblue', edgecolor='white', label='histograma')plt.plot(grid, kde_scipy(grid), color='firebrick', linewidth=2, label=f'scipy (Scott, h={h_scott:.2f})')plt.plot(grid, dens_sk, color='steelblue', linewidth=2, label=f'sklearn (Scott, h={h_sk:.2f})')plt.xlabel('desviación (horas)'); plt.ylabel('densidad'); plt.legend()plt.title('El mismo nombre Scott, dos anchos distintos'); plt.show()
scipy.gaussian_kde elige el ancho de banda solo (regla de Scott).
  h de scipy:                  0.660
  h de sklearn con "scott":    0.278
  desviación estándar datos:   2.373
En el gráfico se ven las dos curvas con el mismo nombre «Scott». La roja (scipy, h = 0.660) es más ancha y aplana los dos grupos; la azul (sklearn, h = 0.278) se pega más a los datos y deja las dos modas más marcadas. No es que una librería «haga mejor Scott»: sklearn solo aplica el factor \(n^{-1/5}\) y no lo multiplica por la dispersión (desviación estándar de 2.373). \(0.278 \times 2.373 \approx 0.660\): el de scipy es el de sklearn por la escala de los datos. En una dimensión puedes hacer coincidir ambos anchos expresándolos en una escala de desviación muestral igual a uno.
Fíjate en lo que no tuviste que decidir: el ancho de banda. scipy.gaussian_kde aplicó la regla de Scott que acabas de ver. Ese 0.660 es más ancho que el 0.3 que usaste a mano. Es esperable: estas reglas son de referencia normal, una aproximación asintótica basada en una forma gaussiana, no un óptimo garantizado para esta muestra. Con dos grupos, esa suposición falla y tienden a suavizar de más.
Por eso, con sklearn, lo habitual es fijar bandwidth=... explícitamente y elegirlo por validación, como harás enseguida.
21.9 El ancho de banda y el compromiso sesgo-varianza
El KDE tiene un único parámetro crítico: el ancho de banda \(h\). Aquí el compromiso sesgo-varianza toma forma concreta:
Con \(h\)pequeño, cada campana es estrecha; la estimación se pega a cada dato y fluctúa mucho de una muestra a otra (varianza alta, sesgo bajo).
Con \(h\)grande, las campanas son anchas; la estimación es estable pero aplana los detalles reales (sesgo alto, varianza baja).
El error total se mide con el MISE (mean integrated squared error), \(\text{MISE}(h) = E\int (\hat f(x) - f(x))^2\,dx\). En una dimensión, para una densidad suficientemente suave y un kernel simétrico de segundo orden, con \(h \to 0\) y \(nh \to \infty\), su aproximación asintótica es
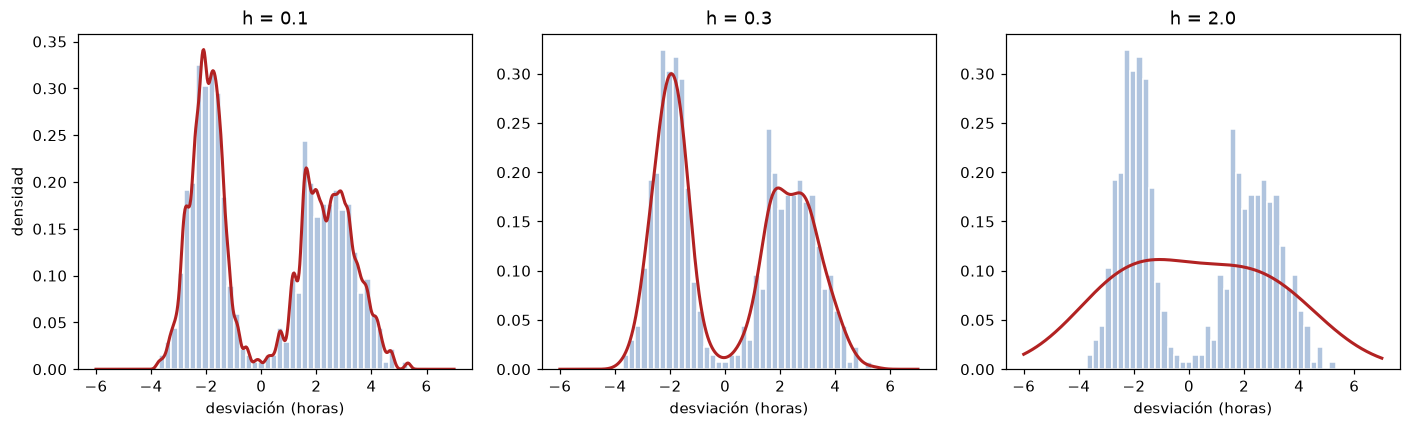
donde \(R(g) = \int g^2\) y \(\mu_2(K) = \int u^2 K(u)\,du\). El primer término baja cuando \(h\) crece; el segundo sube. El mínimo está en un punto intermedio, \(h^\ast \propto n^{-1/5}\), y de ahí sale el factor \(n^{-1/5}\) de la regla de Scott. Los anchos de 0.1, 0.3 y 2.0 permiten observar esos cambios sobre las mismas 600 entregas.
Con \(h = 0.1\) la curva es ruidosa y tiene picos artificiales, porque cada campana estrecha sigue el ruido de pocos datos: varianza alta. Con \(h = 0.3\) las dos modas se ven limpias, sin ruido espurio visible. Con \(h = 2.0\) las campanas anchas funden los dos grupos en una sola curva casi plana y borran la estructura: sesgo alto. Aumentar \(h\) reduce la flexibilidad, al revés que aumentar el número de knots de un spline.
21.10 Elegir el ancho de banda por validación (densidad)
No conviene elegir \(h\) a simple vista. Como el KDE es una densidad, puedes medir qué tan bien predice datos nuevos con la log-verosimilitud en validación cruzada (capítulo de enfoques frecuentista y bayesiano): buscas el \(h\) que hace más probables los datos que el modelo no vio. GridSearchCV ajusta cada candidato con sus folds de entrenamiento y compara sus log-verosimilitudes reservadas.
La verosimilitud es «qué tan creíbles se ven estos puntos si esta curva fuera la densidad verdadera»: se evalúa \(\hat f\) en cada dato y se multiplican esos valores. Como el producto de muchos números pequeños se va a cero, se toma el logaritmo y se suman: esa es la log-verosimilitud. Si es más alta, la curva coloca más densidad donde sí cayeron entregas nuevas; si es más baja, la puso en el lugar equivocado. En validación cruzada se calcula con puntos que no se usaron para armar el KDE, para no premiar a un \(h\) que solo memoriza la muestra.
params = {'bandwidth': np.linspace(0.1, 2.0, 40)}busqueda = GridSearchCV(KernelDensity(kernel='gaussian'), params, cv=5)busqueda.fit(datos.reshape(-1, 1))h_dens = busqueda.best_params_['bandwidth']print(f'Ancho de banda óptimo por validación: {h_dens:.3f}')
Ancho de banda óptimo por validación: 0.295
La validación elige un ancho de banda de 0.295, muy cerca del panel central (h = 0.3) que a simple vista se veía equilibrado, y menos de la mitad del 0.660 que proponía la regla de Scott. En este ejemplo, el criterio de validación favorece menos suavizado que la regla de Scott; no demuestra que ocurra así en toda distribución bimodal. Que el método basado en datos coincida con el juicio visual da confianza; además, a diferencia de la inspección visual, este procedimiento sigue un criterio explícito y reproducible. En este ejemplo usas 0.295 como ancho elegido para el KDE descriptivo de las entregas.
21.11 Parte B, Regresión por kernel
La misma idea de “mirar lo cercano” sirve para regresión. En vez de estimar una densidad, estimas la función de regresión \(m(x) = E[Y \mid X = x]\), es decir, el valor esperado de \(y\) para cada \(x\). Lo haces promediando los \(y\) de los puntos vecinos, con más peso para los más próximos.
21.12 La intuición: los pesos en un punto
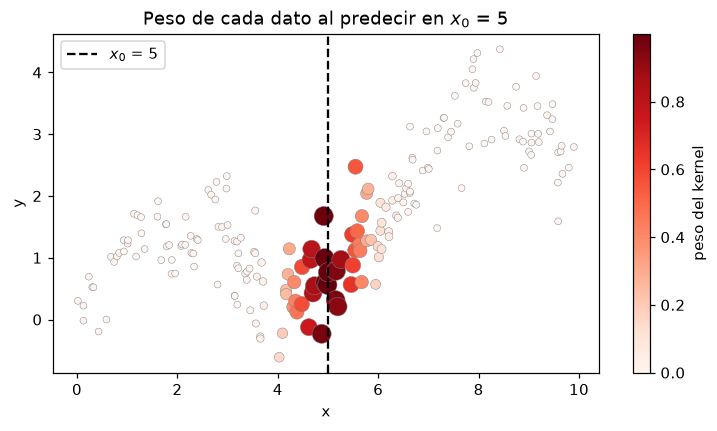
Antes de la fórmula, mira qué significa “promediar lo cercano”: fija un punto \(x_0\) y observa cuánto pesa cada dato según su distancia, usando el kernel gaussiano. Los cercanos deben pesar mucho; los lejanos, casi nada.
Esta primera muestra de 200 puntos, con \(y=\sin(x)+0.3x\) más ruido normal, es ilustrativa. También generas una segunda muestra independiente y reservas su prueba antes de examinarla. La selección de ancho de banda y la comparación final usarán solo esta segunda muestra. Los ajustes sobre la primera muestra describen la forma y no miden generalización.
n =200x = np.sort(rng_regresion.uniform(0, 10, n))m_true = np.sin(x) +0.3* xy = m_true + rng_regresion.normal(0, 0.5, n)# Evaluación independiente de las figuras de demostración.x_eval = np.sort(rng_evaluacion.uniform(0, 10, n))y_eval = np.sin(x_eval) +0.3* x_eval + rng_evaluacion.normal(0, 0.5, n)Xtr, Xte, ytr, yte, xtr, xte = train_test_split( x_eval.reshape(-1, 1), y_eval, x_eval, test_size=0.3, random_state=SEMILLA)x0 =5.0h =0.5pesos = np.exp(-0.5* ((x - x0) / h) **2)plt.scatter(x, y, c=pesos, cmap='Reds', s=20+140* pesos, edgecolor='gray', linewidth=0.3)plt.axvline(x0, color='black', linestyle='--', label=rf'$x_0$ = {x0:g}')plt.colorbar(label='peso del kernel')plt.xlabel('x'); plt.ylabel('y'); plt.legend()plt.title(r'Peso de cada dato al predecir en $x_0$ = 5'); plt.show()
El color muestra el peso: los puntos junto a la línea \(x_0=5\) están en rojo intenso (pesan mucho), y el peso se desvanece rápido al alejarse. La predicción en \(x_0\) será un promedio de los \(y\), pero uno donde dominan los vecinos inmediatos. Cambiar \(x_0\) mueve la ventana; recorrer todos los \(x_0\) traza la curva suavizada.
21.13 El estimador de Nadaraya–Watson
Esa idea tiene fórmula: la predicción en \(x\) es el promedio de los \(y_i\) ponderado por el kernel según la distancia a \(x\):
El numerador suma los \(y\) pesados; el denominador normaliza. No hay knots ni coeficientes: solo el ancho de banda \(h\). La función siguiente calcula explícitamente esos pesos normalizados para cada consulta.
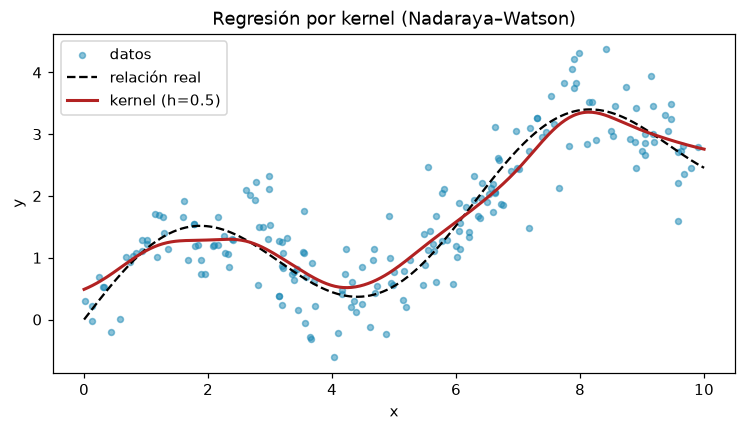
def _entradas_kernel(x_train, y_train, x_query, h):"""Validar datos unidimensionales y un ancho de banda positivo.""" x_train = np.asarray(x_train, dtype=float) y_train = np.asarray(y_train, dtype=float) x_query = np.atleast_1d(np.asarray(x_query, dtype=float))if x_train.ndim !=1or y_train.ndim !=1or x_query.ndim !=1:raiseValueError("Usa vectores unidimensionales; x_query también puede ser escalar.")if x_train.size ==0or x_train.size != y_train.size:raiseValueError("x_train e y_train deben tener la misma longitud no nula.")ifnotall(np.isfinite(v).all() for v in (x_train, y_train, x_query)):raiseValueError("Los datos y las consultas deben ser finitos.") h = np.asarray(h, dtype=float)if h.ndim !=0ornot np.isfinite(h) or h <=0:raiseValueError("h debe ser un escalar finito y positivo.")return x_train, y_train, x_query, float(h)def _pesos_gaussianos(x_train, xq, h):# Restar el mayor log-peso evita que todos los pesos se redondeen a cero.# El factor común se cancela al normalizar y no cambia el estimador.with np.errstate(over="ignore", invalid="ignore"): log_w =-0.5* ((x_train - xq) / h) **2ifnot np.isfinite(log_w).any():raiseValueError("La escala de distancias es extrema: reescala X o revisa h.")return np.exp(log_w - np.max(log_w))def nadaraya_watson(x_train, y_train, x_query, h): x_train, y_train, x_query, h = _entradas_kernel(x_train, y_train, x_query, h) pred = np.empty(len(x_query))for i, xq inenumerate(x_query): w = _pesos_gaussianos(x_train, xq, h) pred[i] = np.sum((w / w.sum()) * y_train)return predgrid_x = np.linspace(0, 10, 300)ajuste = nadaraya_watson(x, y, grid_x, h=0.5)plt.scatter(x, y, s=15, alpha=0.5, label='datos')plt.plot(grid_x, np.sin(grid_x) +0.3* grid_x, 'k--', label='relación real')plt.plot(grid_x, ajuste, color='firebrick', linewidth=2, label='kernel (h=0.5)')plt.xlabel('x'); plt.ylabel('y'); plt.legend()plt.title('Regresión por kernel (Nadaraya–Watson)'); plt.show()
La curva roja sigue de cerca la relación real, \(m(x) = \sin(x) + 0.3x\) (línea negra), sin que nadie le dijera que era un seno ni le ajustara un polinomio: solo promedió los \(y\) vecinos en cada punto. Eso es lo notable del suavizado por kernel: se adapta sin fijar una familia paramétrica global para la relación. El kernel y el ancho de banda sí introducen supuestos sobre la proximidad y la suavidad.
La implementación valida las entradas y estabiliza los pesos gaussianos para evitar divisiones 0/0 por redondeo numérico. Obtener una predicción finita lejos de los datos no vuelve confiable la extrapolación.
21.14 El ancho de banda controla la flexibilidad
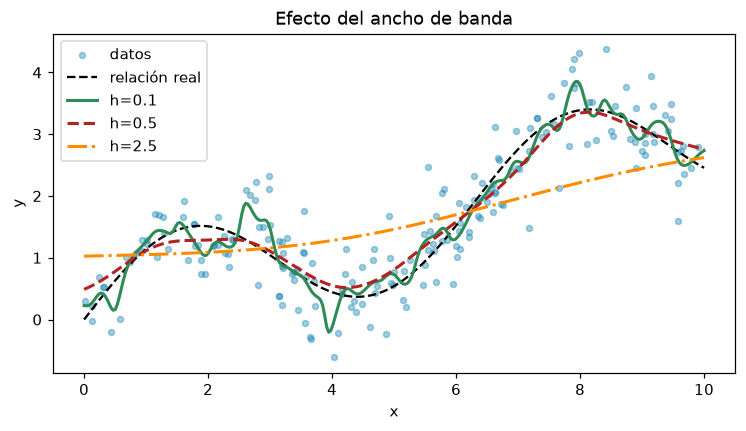
Igual que en densidades, \(h\) decide cuánto suaviza. Cumple el papel que tenía el número de knots en el spline, pero en sentido inverso: más knots dan una curva más flexible; un \(h\) más grande da una curva más rígida.
anchos = [0.1, 0.5, 2.5]plt.scatter(x, y, s=15, alpha=0.4, label='datos')plt.plot(grid_x, np.sin(grid_x) +0.3* grid_x, 'k--', label='relación real')colores = ['seagreen', 'firebrick', 'darkorange']for hb, c inzip(anchos, colores): plt.plot(grid_x, nadaraya_watson(x, y, grid_x, hb), color=c, linewidth=2, label=f'h={hb}')plt.xlabel('x'); plt.ylabel('y'); plt.legend()plt.title('Efecto del ancho de banda'); plt.show()
Con \(h = 0.1\) (verde) la curva zigzaguea persiguiendo el ruido de cada dato, un sobreajuste. Con \(h = 0.5\) (rojo) sigue las ondulaciones de \(\sin(x)+0.3x\) sin copiar el ruido. Con \(h = 2.5\) (naranja) aplana las ondas y casi vuelve a una recta, un subajuste. Es el mismo compromiso de la densidad: un \(h\) pequeño da varianza alta, y uno grande, sesgo alto. La configuración predictiva la eliges con validación cruzada sobre otra muestra, no mirando esta figura.
21.15 El sesgo de frontera (boundary bias)
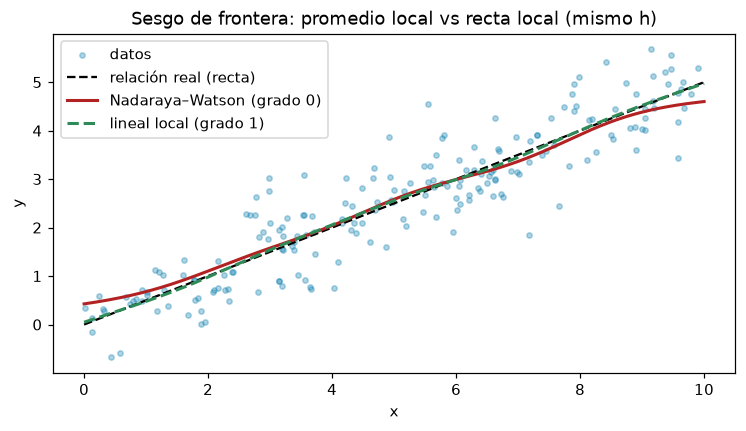
Nadaraya–Watson tiene una debilidad conocida en los extremos del rango. En el interior, cada punto tiene vecinos a ambos lados y el promedio queda centrado. Pero en la frontera (el primer y el último tramo de \(x\)) solo hay vecinos de un lado. Si la relación tiene pendiente, esos vecinos están todos más arriba (o más abajo) y el promedio se sesga hacia el interior: la curva se “dobla”.
La solución clásica es cambiar el promedio local por una recta local. Nadaraya–Watson es una regresión polinómica local de grado 0: en cada punto ajusta una constante (el promedio ponderado). La regresión lineal local es de grado 1: en cada punto ajusta una recta por mínimos cuadrados ponderados con el mismo kernel, y usa su valor en ese punto como predicción.
Para que la comparación sea justa, usas una relación lineal, \(y = 0.5x\) más ruido, y el mismo kernel gaussiano con el mismo \(h = 1\) en ambos métodos.
def lineal_local(x_train, y_train, x_query, h): x_train, y_train, x_query, h = _entradas_kernel(x_train, y_train, x_query, h) pred = np.empty(len(x_query))for i, xq inenumerate(x_query): w = _pesos_gaussianos(x_train, xq, h) # mismo kernel gaussiano estabilizado# recta ponderada centrada en xq: el intercepto es la predicción en xqif np.unique(x_train[w >0]).size <2:raiseValueError("La recta local necesita dos valores distintos de X con peso positivo.") pendiente, intercepto = np.polyfit(x_train - xq, y_train, deg=1, w=np.sqrt(w)) pred[i] = interceptoreturn predxb = np.sort(rng_frontera.uniform(0, 10, 200))mb =0.5* xbyb = mb + rng_frontera.normal(0, 0.6, 200)gx = np.linspace(0, 10, 300)fit_nw = nadaraya_watson(xb, yb, gx, h=1.0)fit_ll = lineal_local(xb, yb, gx, h=1.0)plt.scatter(xb, yb, s=12, alpha=0.35, label='datos')plt.plot(gx, 0.5* gx, 'k--', label='relación real (recta)')plt.plot(gx, fit_nw, color='firebrick', linewidth=2, label='Nadaraya–Watson (grado 0)')plt.plot(gx, fit_ll, color='seagreen', linewidth=2, label='lineal local (grado 1)')plt.xlabel('x'); plt.ylabel('y'); plt.legend()plt.title('Sesgo de frontera: promedio local vs recta local (mismo h)'); plt.show()
Fíjate en los extremos. Nadaraya–Watson (rojo) se separa de la recta real cerca de \(x\approx 0\) y \(x\approx 10\): en el borde solo hay vecinos de un lado, el promedio se sesga hacia el interior y la curva se dobla. En el interior, la curva Nadaraya–Watson queda más cerca de la recta generadora de este ejemplo.
La lineal local (verde) usa el mismo kernel y el mismo \(h\); la única diferencia es que ajusta una recta en lugar de una constante. Esa pendiente extra le permite seguir la tendencia hasta el borde. La tabla siguiente compara el RMSE frente a la función generadora, por separado en los bordes y en el interior.
Cuánto se equivoca cada método en el borde
Como aquí conoces la relación real, puedes medir el error de cada curva por zonas con la raíz del error cuadrático medio (RMSE, por sus siglas en inglés): los bordes (\(x < 1\) o \(x > 9\)) y el interior. Sumas un tercer método, LOWESS de statsmodels: es una regresión lineal local con tres cambios prácticos (kernel tricúbico, una ventana definida por la fracción frac de vecinos más cercanos en lugar de un \(h\) fijo, e iteraciones que restan peso a los datos atípicos). Es la implementación de uso cotidiano de la idea de la recta local.
fit_low_grid = lowess(yb, xb, frac=0.3, it=1, xvals=gx)borde = (gx <1) | (gx >9)m_grid =0.5* gxajustes = {'Nadaraya–Watson': fit_nw,'Lineal local': fit_ll,'LOWESS': fit_low_grid}print('RMSE frente a la relación real')print(f'{"método":<17}{"bordes":>8}{"interior":>10}')for nombre, f in ajustes.items(): rmse_borde = np.sqrt(np.mean((f[borde] - m_grid[borde]) **2)) rmse_int = np.sqrt(np.mean((f[~borde] - m_grid[~borde]) **2))print(f'{nombre:<17}{rmse_borde:>8.3f}{rmse_int:>10.3f}')
RMSE frente a la relación real
método             bordes  interior
Nadaraya–Watson     0.283     0.091
Lineal local        0.020     0.038
LOWESS              0.057     0.065
Frente a la función generadora, el RMSE de Nadaraya–Watson es 0.283 en los bordes y 0.091 en el interior. La recta local obtiene 0.020 y 0.038; LOWESS, evaluado directamente en la misma malla con xvals, obtiene 0.057 y 0.065.
La recta local reproduce una tendencia exactamente lineal sin sesgo condicional cuando el ruido tiene media condicional cero y el ajuste está definido. Este RMSE de una realización incluye variación aleatoria y no mide directamente sesgo. Con una relación curva puede persistir error de aproximación; en las fronteras también suele haber menos información. LOWESS usa otra ventana, kernel e iteración robusta, de modo que su comparación no aísla solo el grado local.
21.16 Elegir el ancho de banda por validación (regresión)
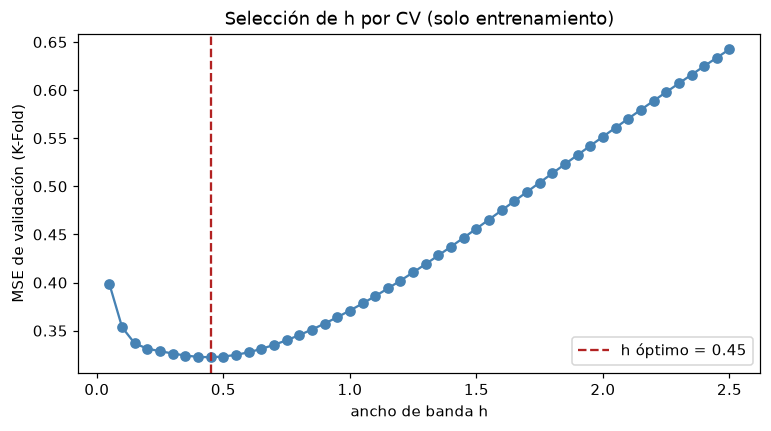
No conviene elegir \(h\) mirando el conjunto de prueba: dejaría de ser una medida honesta, porque habría participado en la decisión (una fuga de información). Reservas los datos de prueba y eliges \(h\) por validación cruzada (CV, por cross-validation) solo sobre el entrenamiento: el entrenamiento se divide en 5 partes (folds); cada una se usa por turnos para validar mientras las otras cuatro ajustan el modelo, y se promedia el error cuadrático medio (MSE). El conjunto de prueba solo se usa al final, para reportar.
# Usamos la muestra independiente cuya prueba se reservó al generarla.# K-Fold SOLO sobre el entrenamiento: el conjunto de prueba no entra a elegir hkf = KFold(n_splits=5, shuffle=True, random_state=SEMILLA)hs = np.linspace(0.05, 2.5, 50)errores_cv = []for h in hs: mse_folds = []for tr, va in kf.split(xtr): pred = nadaraya_watson(xtr[tr], ytr[tr], xtr[va], h) mse_folds.append(mean_squared_error(ytr[va], pred)) errores_cv.append(np.mean(mse_folds))h_opt = hs[int(np.argmin(errores_cv))]plt.plot(hs, errores_cv, marker='o', color='steelblue')plt.axvline(h_opt, color='firebrick', linestyle='--', label=f'h óptimo = {h_opt:.2f}')plt.xlabel('ancho de banda h')plt.ylabel('MSE de validación (K-Fold)')plt.legend()plt.title('Selección de h por CV (solo entrenamiento)')plt.show()print(f'h óptimo (CV en entrenamiento): {h_opt:.2f} | MSE de validación: {min(errores_cv):.3f}')
h óptimo (CV en entrenamiento): 0.45 | MSE de validación: 0.322
Sobre el entrenamiento de la segunda muestra, la CV selecciona h = 0.45 con MSE medio de 0.322. La muestra ilustrativa de las figuras anteriores no interviene en este cálculo.
La varianza del ruido generador es 0.25. Representa error irreducible en esperanza al predecir nuevas respuestas bajo este mecanismo, no un mínimo para cada MSE observado. Además, el valor 0.322 participó en la selección entre candidatos y puede ser optimista. La prueba reservada evalúa a continuación la configuración ya fijada.
21.17 Comparación: recta, spline y kernel
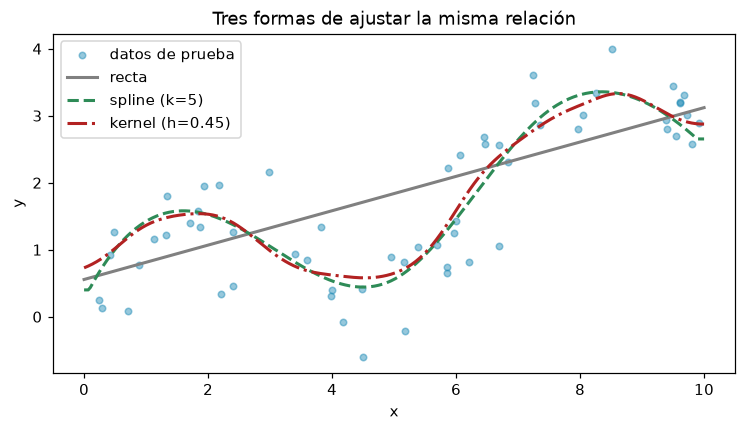
Para cerrar, pones a competir los tres enfoques sobre los mismos datos de prueba, que no se usaron para elegir nada. El spline elige su número de knots por el mismo K-Fold sobre el entrenamiento; el kernel ya trajo su \(h\). El gráfico y el \(R^2\) de la prueba reservada describen los tres modelos ya configurados.
candidatos_k =list(range(4, 16))errores_k = []for k in candidatos_k: mse_folds = []for tr, va in kf.split(Xtr): modelo_k = make_pipeline( SplineTransformer(n_knots=k, degree=3, include_bias=False), LinearRegression(), ).fit(Xtr[tr], ytr[tr]) mse_folds.append(mean_squared_error(ytr[va], modelo_k.predict(Xtr[va]))) errores_k.append(np.mean(mse_folds))k_opt = candidatos_k[int(np.argmin(errores_k))]recta = LinearRegression().fit(Xtr, ytr)spline = make_pipeline( SplineTransformer(n_knots=k_opt, degree=3, include_bias=False), LinearRegression(),).fit(Xtr, ytr)r2_lineal = r2_score(yte, recta.predict(Xte))r2_spline = r2_score(yte, spline.predict(Xte))r2_kernel = r2_score(yte, nadaraya_watson(xtr, ytr, xte, h_opt))plt.scatter(xte, yte, s=18, alpha=0.45, label='datos de prueba')plt.plot(grid_x, recta.predict(grid_x.reshape(-1, 1)), color='gray', linewidth=2, label='recta')plt.plot(grid_x, spline.predict(grid_x.reshape(-1, 1)), color='seagreen', linewidth=2, label=f'spline (k={k_opt})')plt.plot(grid_x, nadaraya_watson(xtr, ytr, grid_x, h_opt), color='firebrick', linewidth=2, label=f'kernel (h={h_opt:.2f})')plt.xlabel('x'); plt.ylabel('y'); plt.legend()plt.title('Tres formas de ajustar la misma relación')plt.show()print(f'n_knots óptimo (CV en entrenamiento): {k_opt}')print('R2 en prueba (no usado para elegir h ni knots)')print(f' Recta (lineal): {r2_lineal:.3f}')print(f' Spline cúbico: {r2_spline:.3f}')print(f' Kernel (NW, h opt): {r2_kernel:.3f}')
n_knots óptimo (CV en entrenamiento): 5
R2 en prueba (no usado para elegir h ni knots)
  Recta (lineal):     0.462
  Spline cúbico:      0.778
  Kernel (NW, h opt): 0.766
En las 60 observaciones de prueba de la muestra independiente, la recta obtiene \(R^2\) = 0.462, el spline con 5 knots obtiene 0.778 y Nadaraya–Watson con h = 0.45 obtiene 0.766. Knots y ancho de banda se seleccionaron únicamente por CV del entrenamiento.
Los dos procedimientos no lineales mejoran frente a la recta en esta prueba. La diferencia spline menos kernel es 0.012; una sola partición no permite establecer superioridad general ni equivalencia estadística. Para estudiar esa diferencia necesitarías una evaluación repetida o externa apropiada, sin ajustar decisiones a esta prueba.
El spline estima pesos sobre una base; Nadaraya–Watson conserva las observaciones para promediar localmente. Ambos dependen del soporte de entrenamiento. El tramo plano fuera de los knots extremos del spline procede de extrapolation="constant", no de evidencia de que la respuesta real permanezca constante.
21.18 Errores comunes al trabajar con kernels
Síntoma
Causa probable
Solución
La densidad se ve llena de picos
ancho de banda demasiado pequeño
súbelo; elígelo por validación
Se pierde una moda o la asimetría
ancho de banda demasiado grande
bájalo; desconfía de las reglas automáticas con datos multimodales
La curva se dobla en los extremos
sesgo de frontera
usa regresión lineal local (LOWESS); interpreta los bordes con cautela
La curva se vuelve errática o queda indefinida donde hay pocos datos
ventana sin vecinos suficientes; con soporte finito puede aparecer 0/0 y con un gaussiano los pesos pueden redondearse a cero
limita el rango de predicción; estabiliza los pesos gaussianos y revisa \(h\) mediante validación
Resultados raros con varias variables en escalas distintas
el kernel usa distancias
estandariza las variables antes
bandwidth='scott' en sklearn da un \(h\) muy distinto al de scipy
sklearn no reescala por la dispersión
estandariza antes o fija bandwidth y valídalo
Muy lento con muchos datos
el promedio recorre todos los puntos
usa implementaciones optimizadas (árboles, FFT)
Con muchas variables, casi ningún punto tiene vecinos cercanos
maldición de la dimensionalidad: al crecer el número de variables, las ventanas quedan vacías
reduce dimensiones antes, o usa un modelo con más estructura (aditivo, árboles)
21.19 Dónde aparece esto en inteligencia artificial y analítica de datos
Las dos herramientas de este capítulo, estimar una densidad y promediar por cercanía, están detrás de tareas muy comunes:
Detección de anomalías. Una densidad estimada dice dónde es normal que caigan los datos; lo que cae en una zona de densidad baja es inusual. Es uno de los métodos clásicos de detección de anomalías sin etiquetas, y el ejemplo que sigue.
Visualización en analítica. Los gráficos de densidad y de violín de las librerías de visualización son un KDE con el ancho de banda por defecto. La advertencia sobre las reglas automáticas aplica igual: con datos de varios grupos pueden suavizar de más y esconder una moda.
Líneas de tendencia. La curva suave que muchas herramientas dibujan sobre un diagrama de dispersión suele ser LOWESS, la recta local de la sección sobre el sesgo de frontera.
La palabra kernel en otros métodos. Las máquinas de soporte vectorial y los procesos gaussianos también usan kernels, con otro papel: allí el kernel mide la similitud entre dos observaciones. El más usado, el RBF, tiene la misma forma gaussiana y un parámetro que hace las veces del ancho de banda.
Mecanismos de atención. La operación central de los modelos de lenguaje actuales es un promedio ponderado: cada elemento recibe un peso según su similitud con la consulta, y los pesos suman uno. El promedio normalizado permite una analogía con Nadaraya–Watson. En atención se aprenden representaciones de consultas, claves y valores; sus puntuaciones no tienen que representar una distancia gaussiana ni cumplir las condiciones de un kernel de suavización. Esta relación algebraica no convierte ambos procedimientos en el mismo modelo.
En KDE y regresión local por distancias, aumentar el número de variables dificulta encontrar vecindades informativas con una muestra fija. Esta limitación no se traslada sin matices a SVM, procesos gaussianos ni atención, que usan otras estructuras y criterios de ajuste.
Ejemplo: detectar entregas inusuales con la densidad
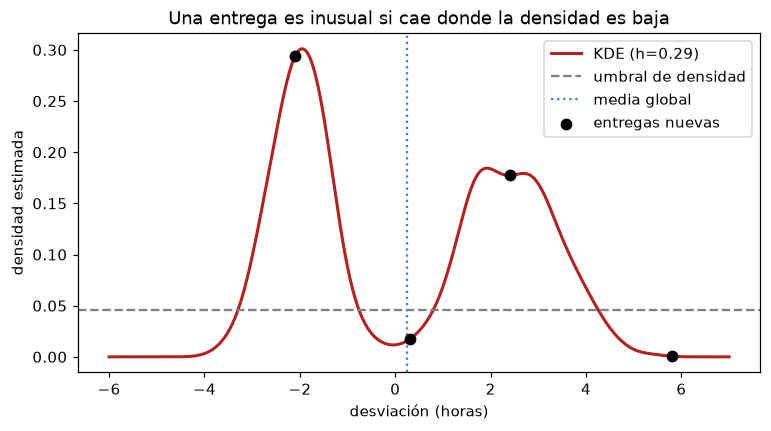
Vuelves a las 600 entregas de la primera parte y al ancho de banda que eligió la validación, con una regla simple: una entrega es inusual si la densidad estimada en su valor está por debajo del percentil 5 de las densidades de la muestra.
La comparas con la regla más conocida, el puntaje z: la distancia a la media medida en desviaciones estándar, que marca como inusual lo que se aleja más de 2. Pruebas las dos reglas con cuatro entregas nuevas.
# La densidad estimada como detector de entregas inusualeskde_final = KernelDensity(kernel='gaussian', bandwidth=h_dens).fit(datos.reshape(-1, 1))dens_muestra = np.exp(kde_final.score_samples(datos.reshape(-1, 1)))umbral = np.quantile(dens_muestra, 0.05) # regla: es inusual lo que cae en el 5% menos denso de la muestranuevas = np.array([-2.1, 0.3, 2.4, 5.8]) # cuatro entregas nuevas (desviación en horas)dens_nuevas = np.exp(kde_final.score_samples(nuevas.reshape(-1, 1)))z_nuevas = np.abs(nuevas - datos.mean()) / datos.std(ddof=1)plt.plot(grid, np.exp(kde_final.score_samples(grid.reshape(-1, 1))), color='firebrick', linewidth=2, label=f'KDE (h={h_dens:.2f})')plt.axhline(umbral, color='gray', linestyle='--', label='umbral de densidad')plt.axvline(datos.mean(), color='steelblue', linestyle=':', label='media global')plt.scatter(nuevas, dens_nuevas, color='black', s=45, zorder=3, label='entregas nuevas')plt.xlabel('desviación (horas)'); plt.ylabel('densidad estimada'); plt.legend()plt.title('Una entrega es inusual si cae donde la densidad es baja'); plt.show()print(f'Umbral de densidad (percentil 5 de la muestra): {umbral:.3f}\n')print(f'{"desviación":>10}{"densidad":>10}{"¿inusual (KDE)?":>18}{"puntaje z":>11}{"¿inusual (z > 2)?":>19}')for d, f, z inzip(nuevas, dens_nuevas, z_nuevas):print(f'{d:>10.1f}{f:>10.3f}{("sí"if f < umbral else"no"):>18}{z:>11.2f}{("sí"if z >2else"no"):>19}')
Umbral de densidad (percentil 5 de la muestra): 0.046

desviación  densidad   ¿inusual (KDE)?  puntaje z  ¿inusual (z > 2)?
      -2.1     0.294                no       0.99                 no
       0.3     0.017                sí       0.02                 no
       2.4     0.177                no       0.91                 no
       5.8     0.001                sí       2.34                 sí
En las entregas nuevas de −2.1 y 2.4 horas, ambas reglas indican valores habituales. Para 5.8 horas, la densidad es 0.001 y el puntaje z es 2.34: ambas reglas lo señalan. Para 0.3 horas, la densidad es 0.017, menor que el umbral de 0.046, aunque el puntaje z es solo 0.02.
El KDE detecta que 0.3 cae en una región poco frecuente de esta mezcla. Eso no implica un problema operativo: una desviación de 0.3 horas podría estar cerca de cumplir la promesa. Para atribuirla a una ruta o explicar su causa necesitarías la etiqueta de ruta y más contexto.
El puntaje z puede calcularse sin suponer normalidad. Lo que pierde aquí es la estructura de dos grupos al resumirlos con una sola media y desviación; interpretar |z| > 2 como una tasa de rareza normal requeriría supuestos adicionales.
El percentil 5 se calculó sobre la muestra del ajuste. Es una demostración descriptiva: su tasa de alertas futura no está garantizada. En la celda siguiente separas ajuste y calibración antes de fijar el umbral.
Calibrar las alertas con observaciones separadas
Divides las 600 entregas antes de ajustar un nuevo detector, eliges el ancho de banda solo con el grupo de ajuste y fijas el percentil 5 en el grupo de calibración. Este detector es un ejemplo separado del KDE descriptivo anterior. El porcentaje elegido expresa una regla de revisión; no demuestra una tasa exacta de falsas alarmas en producción.
datos_ajuste, datos_calibracion = train_test_split(datos, test_size=0.3, random_state=SEMILLA)cv_calibracion = KFold(5, shuffle=True, random_state=SEMILLA)busqueda_calibrada = GridSearchCV( KernelDensity(kernel='gaussian'), {'bandwidth': np.linspace(0.05, 2.5, 50)}, cv=cv_calibracion,).fit(datos_ajuste.reshape(-1, 1))if busqueda_calibrada.best_params_['bandwidth'] in (0.05, 2.5):raiseRuntimeError('Amplía la rejilla antes de fijar el detector.')detector = busqueda_calibrada.best_estimator_log_dens_cal = detector.score_samples(datos_calibracion.reshape(-1, 1))umbral_log_cal =float(np.quantile(log_dens_cal, 0.05))alertas_calibradas = detector.score_samples(nuevas.reshape(-1, 1)) < umbral_log_calprint(f'Ajuste: {len(datos_ajuste)} | calibración: {len(datos_calibracion)}')print(f'h elegido en ajuste: {detector.bandwidth:.3f}; umbral de log-densidad: {umbral_log_cal:.3f}')print('Entregas nuevas:', nuevas)print('Alertas calibradas:', alertas_calibradas)
Ajuste: 420 | calibración: 180
h elegido en ajuste: 0.300; umbral de log-densidad: -3.162
Entregas nuevas: [-2.1  0.3  2.4  5.8]
Alertas calibradas: [False  True False  True]
El detector se ajustó con 420 entregas y se calibró con 180. La CV del ajuste eligió h = 0.300, y el percentil 5 de la log-densidad de calibración fue -3.162. Las alertas para −2.1, 0.3, 2.4 y 5.8 horas fueron no, sí, no, sí, respectivamente.
Reservar la calibración evita definir el umbral sobre las mismas filas que construyen la densidad. Aun así, el percentil empírico no garantiza una tasa exacta de alertas o de falsas alarmas en entregas futuras: faltan etiquetas operativas y estabilidad de la población.
21.20 Preguntas de comprensión
En la figura del KDE de las 600 entregas, ¿cuántas modas reconoces, y dependió esa forma de dónde empezaban los intervalos, como pasaba con el histograma?
scipy.gaussian_kde eligió \(h=0.660\) y KernelDensity(bandwidth="scott"), \(h=0.278\), con el mismo nombre de regla. ¿Por qué difieren, y por qué ninguna de las dos es una buena elección para esta mezcla?
¿Por qué Nadaraya–Watson se dobla en los extremos, y qué cambia la regresión lineal local para corregirlo?
Una entrega nueva de 0.3 horas cae en el valle de la densidad y el KDE la marca como inusual. ¿Representa necesariamente un incumplimiento?
La predicción de Nadaraya–Watson sigue siendo un número finito lejos de los datos. ¿Qué garantiza eso?
TipOrientaciones
Dos modas, una cerca de −2 horas y otra cerca de +2.5. El KDE elimina la dependencia del origen de los intervalos, porque cada campana se centra en su dato, pero conserva una decisión equivalente al ancho del bin: el ancho de banda \(h\).
scikit-learn aplica solo el factor \(n^{-1/5}\) y no lo multiplica por la dispersión de los datos (desviación de 2.373), y \(0.278\times2.373\approx0.660\). Las dos reglas son de referencia normal y suponen una forma gaussiana; con dos grupos tienden a suavizar de más, y la validación cruzada eligió 0.295.
En el borde solo hay vecinos de un lado, así que el promedio ponderado se sesga hacia el interior cuando la relación tiene pendiente. La recta local ajusta en cada punto una recta por mínimos cuadrados ponderados en lugar de una constante, y esa pendiente le permite seguir la tendencia hasta el borde: su RMSE en los bordes fue 0.020, frente a 0.283 de Nadaraya–Watson.
No. Una densidad baja indica rareza respecto de la muestra de referencia (0.017 frente al umbral de 0.046); la promesa de entrega, la ruta y el costo operativo deciden si importa, y una desviación de 0.3 horas podría estar cerca de cumplir la promesa.
Nada estadístico. La estabilización numérica evita que todos los pesos gaussianos se redondeen a cero, pero no aporta soporte de datos ni vuelve confiable la extrapolación.
21.21 Referencias para profundizar
Textos y artículos clásicos
Silverman, B. W. (1986). Density Estimation for Statistics and Data Analysis. Chapman & Hall.
Wand, M. P. y Jones, M. C. (1995). Kernel Smoothing. Chapman & Hall.
Nadaraya, E. A. (1964). On estimating regression. Theory of Probability and Its Applications, 9(1), 141–142.
Watson, G. S. (1964). Smooth regression analysis. Sankhyā, Series A, 26(4), 359–372.
Cleveland, W. S. (1979). Robust locally weighted regression and smoothing scatterplots. Journal of the American Statistical Association, 74(368), 829–836. El artículo original de LOWESS.
Hastie, T., Tibshirani, R. y Friedman, J. (2009). The Elements of Statistical Learning (2.ª ed.). Springer. Capítulo 6, métodos de suavización por kernel.
Zhang, A., Lipton, Z. C., Li, M. y Smola, A. J. (2023). Dive into Deep Learning. Cambridge University Press. Presenta la atención como una regresión de Nadaraya–Watson.
statsmodels: LOWESS: ventana de vecinos, kernel tricúbico e iteraciones robustas.
NumPy: polyfit: convención de pesos usada para mínimos cuadrados ponderados.
21.22 Lo que debes llevarte de este capítulo
Un método de kernel estima en cada punto a partir de los datos cercanos, y el ancho de banda, que se elige por validación, decide cuánto suaviza.
El histograma depende del origen de sus intervalos: los mismos 600 datos dieron conteos 153, 149, 210 y 88 o 261, 57, 244 y 38 al correr los bordes 0.625 horas.
El KDE suma una campana por dato y elimina esa arbitrariedad; la forma del kernel importa menos que el ancho de banda.
Las reglas automáticas suponen una forma gaussiana: Scott dio 0.660 en SciPy, mientras que la validación cruzada eligió 0.295 y conservó las dos modas.
Nadaraya–Watson promedia los \(y\) vecinos y sufre sesgo de frontera (RMSE de 0.283 en los bordes frente a 0.020 de la recta local).
En la prueba reservada de 60 observaciones, el spline (\(R^2=0.778\)) y el kernel con \(h=0.45\) (0.766) superaron a la recta (0.462), con una diferencia entre ellos que una sola partición no permite interpretar.
Una densidad estimada detecta valores inusuales que el puntaje z no ve, como la entrega de 0.3 horas en el valle de la mezcla, y su umbral se calibra con datos separados.
Los métodos de kernel funcionan con pocas variables; con muchas, casi ningún punto tiene vecinos cercanos.
21.23 Puente hacia los siguientes capítulos
El caso de entregas con kernel lleva la regresión por kernel a dos dimensiones, con tiempos de entrega sobre un mapa, y compara cuatro modelos con varias semillas. Con eso cierras la suavización: splines y kernels, dos formas de modelar relaciones no lineales sin imponer de antemano una forma funcional.
El tema siguiente responde otra pregunta: qué hacer cuando la variable que quieres predecir es una categoría o un conteo en lugar de un número continuo. Ahí entran los modelos lineales generalizados, con la regresión logística y la de Poisson, y su extensión, los modelos aditivos, que combinan el GLM con suavizadores como los splines y, en su versión clásica, con suavizadores locales como los de este capítulo.