Un modelo no conoce el resultado de un caso nuevo: asigna números entre 0 y 1 a los resultados posibles. Esos números son probabilidades. Sin ellas no hay clasificación con grado de confianza, no hay intervalos y no hay forma precisa de decir que estás más seguro de A que de B.
En este capítulo construyes el lenguaje mínimo: experimento aleatorio, espacio muestral, evento, probabilidad condicional, independencia, probabilidad total y teorema de Bayes. La práctica es simular: cuentas frecuencias y compruebas que se acercan a la fórmula. El resultado más útil del capítulo es contraintuitivo: una prueba muy sensible no garantiza que un positivo sea casi seguro cuando el caso es raro.
Los ejemplos van de lo simple a lo aplicado: un dado y dos monedas para fijar las definiciones, dos líneas de producción, una prueba diagnóstica, una alerta de fraude y un filtro de correo. Todos los datos son simulados con NumPy a partir de probabilidades fijadas en el texto; ninguno viene de una población real.
Tiempo estimado de lectura: 45 minutos (unas 2 horas si ejecutas el código y resuelves los ejercicios)
Nivel: Básico
Conocimientos previos recomendados: el capítulo 1 (variables y datos simulados) y el capítulo 2 (proporciones y medias); NumPy al nivel de los capítulos anteriores.
Tecnologías mencionadas: Python 3.13, pandas 2.3, NumPy 2.3 y Matplotlib.
Objetivos
Al terminar este capítulo vas a ser capaz de:
distinguir experimento, espacio muestral\(\Omega\) y evento;
estimar una probabilidad por frecuencia relativa y compararla con la fórmula;
calcular una probabilidad condicional\(P(A\mid B)\) e interpretarla como un recorte del espacio;
decidir si dos eventos son independientes y no confundir independencia con «no pueden ocurrir a la vez»;
aplicar la probabilidad total y el teorema de Bayes, también en un problema de clasificación binaria;
reportar \(P(\text{clase}\mid \text{evidencia})\) sin invertir el condicional.
Ejecuta las celdas en orden: todas las simulaciones usan el mismo generador rng, creado al inicio, y sus resultados dependen de ese orden.
7.1 El lenguaje de lo incierto
Experimento aleatorio
Un experimento aleatorio es un procedimiento con más de un resultado posible, que se puede repetir en las mismas condiciones y cuyo resultado individual no se conoce de antemano. Lanzar un dado, recibir un correo o registrar si un cliente paga su crédito son experimentos aleatorios.
Espacio muestral
El espacio muestral\(\Omega\) es el conjunto de todos los resultados simples que consideras. Para un dado honesto, \(\Omega=\{1,2,3,4,5,6\}\). Cada elemento de \(\Omega\) es un resultado o punto muestral.
Definir \(\Omega\) es una decisión de modelado: si solo te importa par o impar, puedes trabajar con \(\Omega=\{\text{par},\text{impar}\}\). El espacio describe lo que elegiste observar.
Evento
Un evento\(A\) es un subconjunto de \(\Omega\). «Sacar par» es \(A=\{2,4,6\}\), y el evento ocurre si el resultado cae en \(A\). Con los eventos vas a usar todo el tiempo tres operaciones básicas de conjuntos:
Complemento\(A^c\): no ocurrió \(A\). \(P(A^c)=1-P(A)\).
Unión\(A\cup B\): ocurrió \(A\), \(B\) o ambos.
Intersección\(A\cap B\): ocurrieron los dos.
Dos eventos son disjuntos (mutuamente excluyentes) si \(A\cap B=\emptyset\), es decir, si no pueden ocurrir a la vez. Ser disjuntos y ser independientes son propiedades distintas.
Probabilidad y reglas de Kolmogorov
Una probabilidad \(P\) asigna a cada evento un número que cumple tres axiomas:
\(P(A)\ge 0\);
\(P(\Omega)=1\);
si \(A\) y \(B\) son disjuntos, \(P(A\cup B)=P(A)+P(B)\).
De ahí salen las reglas de trabajo: \(P(A^c)=1-P(A)\) y, en general,
\[
P(A\cup B)=P(A)+P(B)-P(A\cap B).
\]
En la lectura frecuentista, la que simulas en este capítulo, si repites el experimento \(n\) veces en las mismas condiciones,
\[
P(A) \approx \frac{\text{veces que ocurre }A}{n},
\]
y esa fracción se estabiliza cuando \(n\) crece. La simulación no demuestra los axiomas, pero te deja verlos funcionar.
Se lee: entre las veces en que ocurrió \(B\), qué fracción son también \(A\). El condicional recorta\(\Omega\) a \(B\) y vuelve a normalizar. No habla de un orden en el tiempo; cambia el denominador.
Independencia
\(A\) y \(B\) son independientes si saber que ocurrió uno no cambia la probabilidad del otro:
\[
P(A\mid B)=P(A) \iff P(A\cap B)=P(A)\,P(B).
\]
Disjuntos e independientes casi nunca coinciden: si \(A\) y \(B\) son disjuntos y los dos tienen probabilidad positiva, saber que ocurrió \(A\) obliga a \(P(B\mid A)=0\), distinto de \(P(B)\).
Probabilidad total y Bayes
Si \(H\) y \(H^c\) parten \(\Omega\) en dos grupos,
\[
P(E)=P(E\mid H)P(H)+P(E\mid H^c)P(H^c).
\]
El teorema de Bayes invierte el condicional:
\[
P(H\mid E)=\frac{P(E\mid H)\,P(H)}{P(E)}.
\]
Cada término tiene un nombre que vas a encontrar en machine learning:
Símbolo
Nombre
Pregunta
\(P(H)\)
Prior (probabilidad previa)
¿Qué tan frecuente es la clase antes de ver el dato?
\(P(E\mid H)\)
Verosimilitud
Si la clase es \(H\), ¿qué tan probable es el dato?
\(P(E)\)
Evidencia
¿Qué tan probable es el dato, sumando todas las clases?
\(P(H\mid E)\)
Posterior (probabilidad posterior)
Visto el dato, ¿qué tan probable es la clase?
Un clasificador binario compara \(P(H=1\mid x)\) con \(P(H=0\mid x)\); Bayes hace explícita esa comparación.
Pregunta
Herramienta
¿Qué resultados admito?
\(\Omega\)
¿Qué subconjunto me interesa?
Evento
¿Qué tan frecuente es, sin otra información?
\(P(A)\)
¿Y si ya sé que ocurrió \(B\)?
\(P(A\mid B)\)
¿Saber \(B\) cambia \(A\)?
Independencia
Tengo \(P(E\mid H)\) y quiero \(P(H\mid E)\)
Bayes
7.2 Por qué importa en IA y machine learning
Un buen modelo entrega una incertidumbre medida, además de una etiqueta:
En clasificación, la salida útil es \(P(y=1\mid x)\). La etiqueta sale después, al comparar esa probabilidad con un umbral.
Un falso positivo y un falso negativo pesan distinto cuando la clase positiva es rara, como el fraude o una enfermedad. Bayes obliga a poner la frecuencia base\(P(y=1)\) sobre la mesa (etapa 8).
Naive Bayes supone que las variables de entrada son independientes dentro de cada clase. Para entender esa hipótesis, y sus límites, necesitas entender la independencia (etapa 10).
En calibración, que un modelo diga 0.8 debería significar que, de cada 100 casos así, cerca de 80 son positivos: es una frecuencia relativa.
Cuando un modelo de lenguaje genera texto, elige cada palabra a partir de una probabilidad condicional sobre las anteriores; el mismo símbolo \(P(\cdot\mid\cdot)\) de este capítulo.
\(P(A\mid B)\) y \(P(B\mid A)\) son números distintos, y confundirlos convierte una prueba buena en una alarma inútil.
7.3 Flujo recomendado de trabajo
Escribe \(\Omega\) y los eventos con palabras y con conjuntos.
Decide si calculas o simulas. Lo pequeño se cuenta; lo compuesto se simula y se contrasta con la fórmula.
Mira qué queda a la derecha de la barra.\(P(A\mid B)\) condiciona a \(B\), no a \(A\).
Separa disjuntos de independientes antes de sumar o multiplicar.
Si inviertes un condicional, usa Bayes y escribe prior, verosimilitud y evidencia.
Traduce al problema: cuál es la clase, cuál es la evidencia y cuál es la frecuencia base.
Redacta el reporte con el posterior y la decisión:
«En [experimento], con prior [P(clase)], verosimilitud [P(evidencia | clase)] y evidencia [P(dato)], el posterior es [P(clase | dato)]. Se decide [acción] porque [umbral o costo]. Limitación: [frecuencia base, independencia o n pequeño].»
La etapa 11 llena esta plantilla con la prueba diagnóstica.
7.4 Preparar el entorno
La celda carga las librerías, fija un estilo de gráficos común y crea el generador aleatorio rng con la semilla 42. Todas las simulaciones del capítulo salen de ese generador, así que obtienes los mismos números si ejecutas las celdas en orden.
%matplotlib inline%config InlineBackend.figure_format ="retina"import sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as pltSEMILLA =42# semilla central del capítulorng = np.random.default_rng(SEMILLA)plt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25print("pandas:", pd.__version__, "| numpy:", np.__version__)
Python: 3.13.14
pandas: 3.0.5 | numpy: 2.5.1
El entorno queda con Python 3.13.9, pandas 2.3.3 y NumPy 2.3.5.
La siguiente celda define cuatro funciones de gráficos: la frecuencia relativa acumulada frente a la probabilidad teórica, barras que comparan fórmula y simulación, barras de prior frente a posterior y los conteos de una prueba diagnóstica. Cada etapa las llama en pocas líneas.
def graficar_estabilizacion(ocurrencias, p_teorica, titulo, etiqueta_p="P(A)"): n = np.arange(1, len(ocurrencias) +1) frec = np.cumsum(ocurrencias) / n fig, ax = plt.subplots(figsize=(8.2, 4.2)) ax.plot(n, frec, label="frecuencia relativa") ax.axhline(p_teorica, linestyle="--", color="C1", label=f"{etiqueta_p} = {p_teorica:.3f}") ax.set_xlabel("número de repeticiones n") ax.set_ylabel("fracción de éxitos") ax.set_title(titulo) ax.legend(fontsize=8) ax.set_ylim(-0.05, 1.05) plt.tight_layout() plt.show()def graficar_barras_probs(etiquetas, teoricas, estimadas, titulo): x = np.arange(len(etiquetas)) w =0.38 fig, ax = plt.subplots(figsize=(8.4, 4.2)) ax.bar(x - w /2, teoricas, w, label="fórmula") ax.bar(x + w /2, estimadas, w, label="simulación") ax.set_xticks(x, etiquetas) ax.set_ylim(0, 1) ax.set_ylabel("probabilidad") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_prior_vs_posterior(nombres, prior, posterior, titulo): x = np.arange(len(nombres)) w =0.38 fig, ax = plt.subplots(figsize=(7.6, 4.2)) ax.bar(x - w /2, prior, w, label="antes de la evidencia (prior)") ax.bar(x + w /2, posterior, w, label="después (posterior)") ax.set_xticks(x, nombres) ax.set_ylim(0, 1) ax.set_ylabel("probabilidad") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_conteos_prueba(enfermos_pos, sanos_pos, enfermos_neg, sanos_neg, titulo):"""Izquierda: toda la población. Derecha: solo los positivos (ahí se decide P(E | +)).""" fig, axes = plt.subplots(1, 2, figsize=(11, 4.4), constrained_layout=True) b1 = axes[0].bar([0, 1], [enfermos_pos, enfermos_neg], 0.4, label="enfermos") b2 = axes[0].bar([0.4, 1.4], [sanos_pos, sanos_neg], 0.4, label="sanos") axes[0].bar_label(b1, fontsize=8) axes[0].bar_label(b2, fontsize=8) axes[0].set_xticks([0.2, 1.2], ["prueba +", "prueba −"]) axes[0].set_ylabel("personas (simulación)") axes[0].set_title("Toda la población") axes[0].legend(fontsize=8) total_pos = enfermos_pos + sanos_pos b3 = axes[1].bar(["enfermos", "sanos"], [enfermos_pos, sanos_pos], color=["C0", "C1"]) axes[1].bar_label(b3, labels=[f"{enfermos_pos} ({enfermos_pos / total_pos:.0%})",f"{sanos_pos} ({sanos_pos / total_pos:.0%})"], fontsize=9) axes[1].set_ylabel("personas con prueba +") axes[1].set_title(f"Solo los {total_pos} positivos") fig.suptitle(titulo) plt.show()
7.5 Desarrollo por etapas
Empiezas con un dado y dos monedas, donde puedes listar \(\Omega\), y terminas aplicando Bayes a una fábrica, una prueba diagnóstica, una alerta de fraude y un filtro de correo. En cada etapa contrastas la simulación con la fórmula.
Etapa 1: Experimento, \(\Omega\) y eventos
Lanzas un dado de seis caras, con \(\Omega=\{1,2,3,4,5,6\}\), y defines tres eventos:
\(P\) = par \(=\{2,4,6\}\);
\(M\) = mayor que 4 \(=\{5,6\}\);
\(S\) = seis \(=\{6\}\).
La letra \(P\) nombra aquí al evento «par»; no la confundas con la función de probabilidad. Si el dado es honesto, cada cara tiene probabilidad \(1/6\), y entonces \(P(P)=3/6=1/2\), \(P(M)=2/6=1/3\) y \(P(S)=1/6\). En esta etapa todavía no simulas nada: solo cuentas los elementos de cada evento.
Omega = np.array([1, 2, 3, 4, 5, 6])print("Espacio muestral Ω =", Omega)def P_dado(evento):returnlen(evento) /len(Omega)par = Omega[Omega %2==0]mayor4 = Omega[Omega >4]seis = Omega[Omega ==6]print("P = par ", par, " P(P) =", P_dado(par))print("M = mayor que 4 ", mayor4, " P(M) =", P_dado(mayor4))print("S = seis ", seis, " P(S) =", P_dado(seis))print("Complemento de P (impar):", Omega[Omega %2==1], " P =", 1- P_dado(par))
Espacio muestral Ω = [1 2 3 4 5 6]
P = par          [2 4 6]   P(P) = 0.5
M = mayor que 4  [5 6]   P(M) = 0.3333333333333333
S = seis         [6]   P(S) = 0.16666666666666666
Complemento de P (impar): [1 3 5]   P = 0.5
Los tres conteos dan 0.5, 0.333 y 0.167, y el complemento de par, \(\{1,3,5\}\), tiene probabilidad \(1-0.5=0.5\). Listar \(\Omega\) fija el denominador: si alguien te da «la probabilidad de par» sin decir de qué experimento, el número no tiene ancla.
Etapa 2: La frecuencia se acerca a \(P\) cuando \(n\) crece
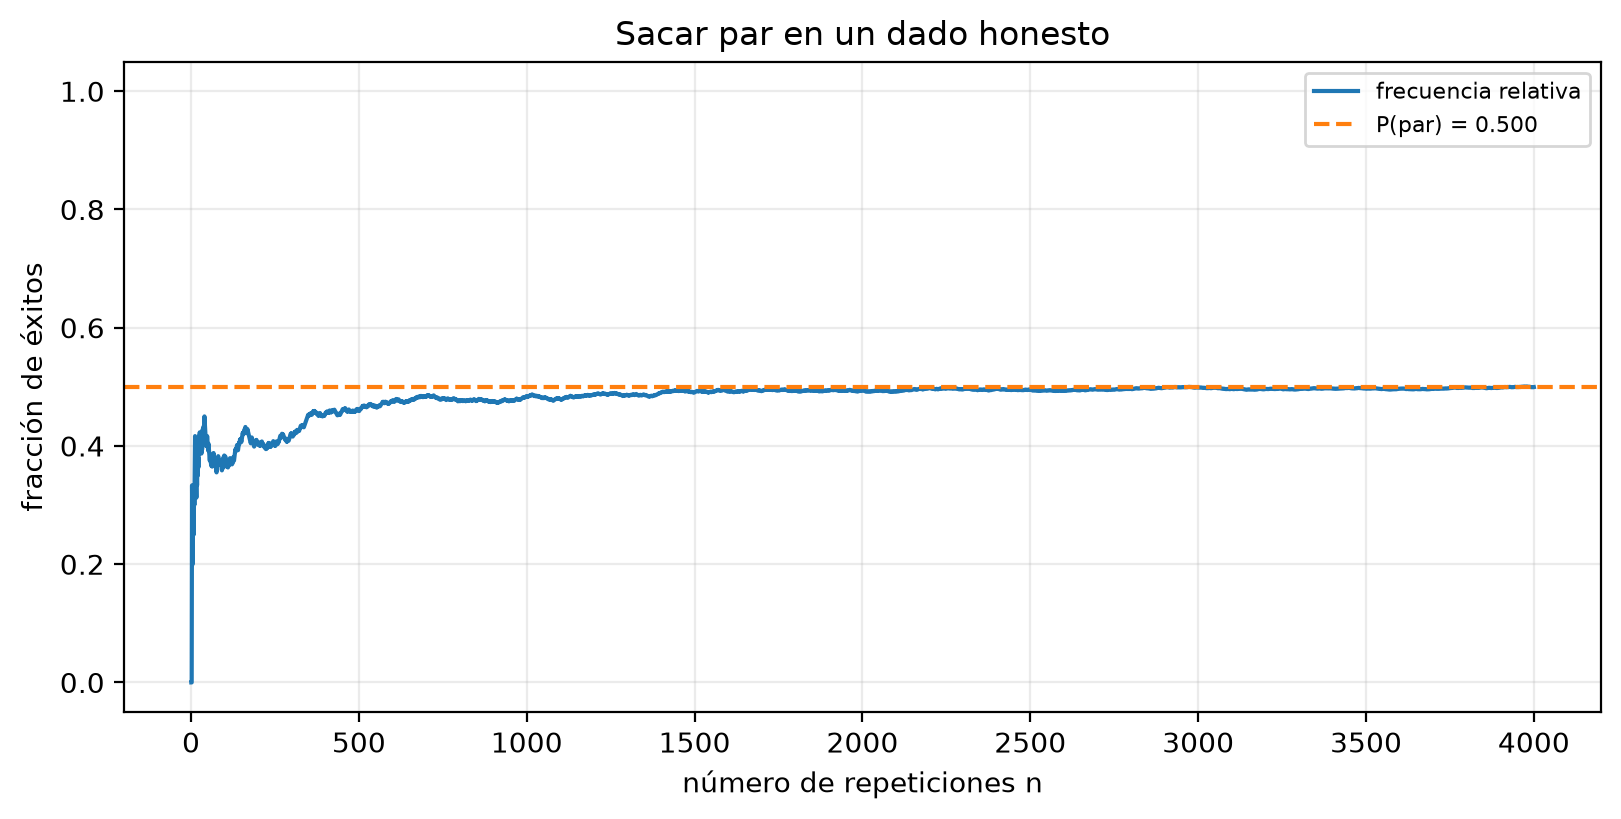
Simulas \(n=4000\) lanzamientos con rng.integers(1, 7), que da cada cara con probabilidad \(1/6\), y sigues la fracción acumulada de pares. Al principio la línea oscila; al final debería quedar pegada a la horizontal de 0.5. Esa estabilización es la ley de los grandes números, que el capítulo 8 presenta con detalle.
n =4000lanzamientos = rng.integers(1, 7, size=n)es_par = (lanzamientos %2==0).astype(int)print("Frecuencia relativa de par:", es_par.mean().round(4), " (teórica 0.5)")print("Frecuencia de mayor que 4:", (lanzamientos >4).mean().round(4), " (teórica 0.333)")graficar_estabilizacion(es_par, 0.5, "Sacar par en un dado honesto", "P(par)")
Frecuencia relativa de par: 0.4995   (teórica 0.5)
Frecuencia de mayor que 4: 0.3332   (teórica 0.333)
Tras 4000 lanzamientos, la fracción de pares es 0.4995 y la de mayores que 4 es 0.3332, frente a 0.5 y 0.333. En el gráfico, la curva arranca en 0 (el primer lanzamiento fue impar), oscila entre 0.35 y 0.45 durante los primeros cientos de lanzamientos y desde unos 1500 lanzamientos queda pegada a la línea de 0.5. En un dataset, una clase que aparece 7 veces de cada 10 no tiene una probabilidad estable de 0.7: con \(n\) tan chico, la fracción todavía oscila. Lo mismo vale para una métrica de clasificación calculada sobre una muestra corta.
Etapa 3: Unión e intersección
\[
P(P\cup M)=P(P)+P(M)-P(P\cap M)
\]
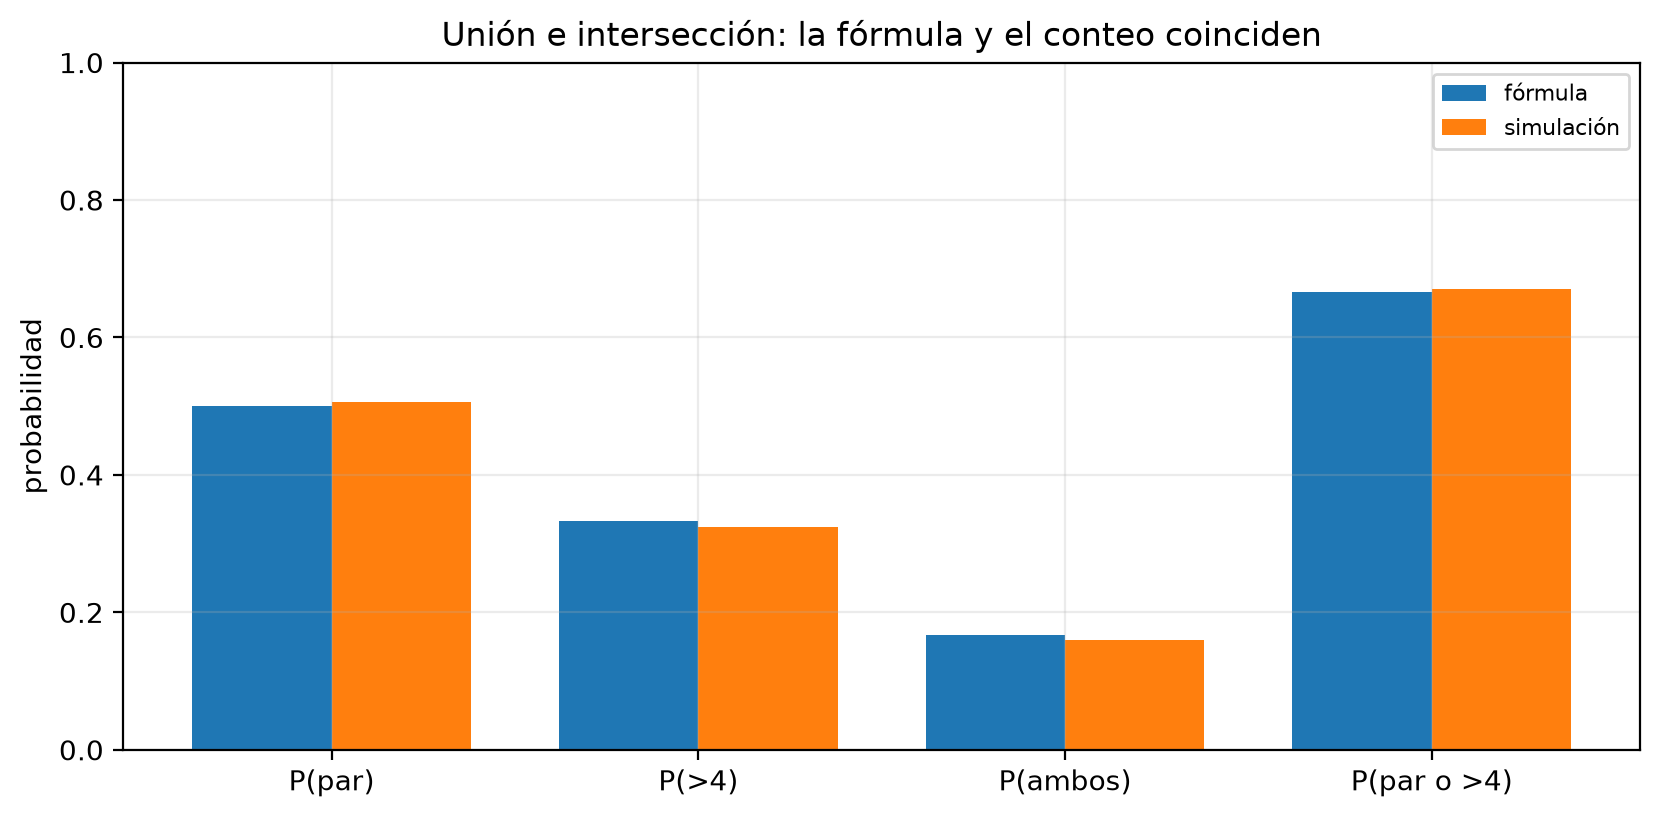
Como \(P\cap M=\{6\}\), la unión vale \(1/2+1/3-1/6=2/3\). Si sumaras \(P(P)+P(M)\) sin restar la intersección, contarías dos veces el 6. Simulas 8000 lanzamientos nuevos y comparas las cuatro probabilidades con la fórmula.
n =8000x = rng.integers(1, 7, size=n)f_union = np.mean((x %2==0) | (x >4))f_inter = np.mean((x %2==0) & (x >4))print("P(P ∪ M) teórica =", round(0.5+1/3-1/6, 4), " simulada =", round(f_union, 4))print("P(P ∩ M) teórica =", round(1/6, 4), " simulada =", round(f_inter, 4))print("P(P)+P(M) sin restar intersección =", round(0.5+1/3, 4), " (se pasa)")graficar_barras_probs( ["P(par)", "P(>4)", "P(ambos)", "P(par o >4)"], [0.5, 1/3, 1/6, 2/3], [np.mean(x %2==0), np.mean(x >4), f_inter, f_union],"Unión e intersección: la fórmula y el conteo coinciden",)
P(P ∪ M) teórica = 0.6667   simulada = 0.6701
P(P ∩ M) teórica = 0.1667   simulada = 0.1594
P(P)+P(M) sin restar intersección = 0.8333   (se pasa)
La unión simulada da 0.6701 frente a 0.6667, y la intersección 0.1594 frente a 0.1667. La suma sin restar llegaría a 0.8333, más de lo posible. En las barras, las cuatro parejas de fórmula y simulación casi coinciden. Restar \(P(A\cap B)\) evita contar dos veces a quien está en los dos conjuntos: en un tablero de indicadores, sumar el porcentaje de clientes con impago y el porcentaje con alerta sin restar el cruce infla el total.
Etapa 4: Probabilidad condicional, otro denominador
¿Cuál es la probabilidad de sacar un 6 si ya sabes que salió par?
Entre \(\{2,4,6\}\) solo una cara es el 6. El 6 no se volvió más frecuente: el universo se redujo a los pares. Simulas 9000 lanzamientos y calculas la fracción de seises entre los pares, y también la pregunta inversa.
De 9000 lanzamientos, 4444 fueron pares y 1469 de ellos seises: \(P(\text{seis}\mid \text{par})\) simulada es 0.3306, frente a 1/3. Sin recortar, la fracción de seises es 0.1632. La pregunta inversa da otro número: \(P(\text{par}\mid \text{seis})=1\), porque todo 6 es par. Invertir la barra cambia la probabilidad. En un modelo, \(P(\text{enfermedad}\mid +)\) y \(P(+\mid \text{enfermedad})\) son cantidades distintas, como verás en la etapa 8.
Etapa 5: Independencia con dos monedas
Lanzas dos monedas honestas. \(\Omega=\{CC,CS,SC,SS\}\) (cara o sello en cada una), y cada resultado tiene probabilidad \(1/4\).
\(A\) = la primera es cara \(=\{CC,CS\}\), con \(P(A)=1/2\).
\(B\) = la segunda es cara \(=\{CC,SC\}\), con \(P(B)=1/2\).
\(A\cap B=\{CC\}\), con \(P(A\cap B)=1/4=P(A)P(B)\): son independientes.
Ahora toma \(C\) = sale exactamente una cara \(=\{CS,SC\}\). Parece que \(A\) y \(C\) dependen, porque si la primera fue cara la segunda tiene que ser sello. La cuenta dice otra cosa: \(P(C)=1/2\) y \(P(C\mid A)=P(\text{segunda sello})=1/2\), así que son independientes. En cambio, \(E\) = salen dos caras \(=\{CC\}\) sí depende de \(A\): \(P(E)=1/4\) y \(P(E\mid A)=1/2\).
Simulas 10 000 lanzamientos de cada moneda con rng.integers(0, 2) y comparas.
n =10000m1 = rng.integers(0, 2, size=n) # 1 = caram2 = rng.integers(0, 2, size=n)A = m1 ==1B = m2 ==1C = (m1 + m2) ==1# exactamente una caraE = (m1 + m2) ==2# dos carasprint("P(A)P(B) =", round(A.mean() * B.mean(), 4), " P(A ∩ B) =", round(np.mean(A & B), 4))print("¿A y B independientes (aprox.)?", abs(np.mean(A & B) - A.mean() * B.mean()) <0.02)print()print("C = exactamente una cara: P(C) =", round(C.mean(), 4), " P(C | A) =", round(np.mean(C[A]), 4)," → independientes (parecía que no)")print("E = dos caras: P(E) =", round(E.mean(), 4), " P(E | A) =", round(np.mean(E[A]), 4)," → no independientes")# Disjuntos: A y "ambas sellos"D = (m1 ==0) & (m2 ==0)print()print("A y 'ambas sellos' son disjuntos: P(A ∩ D) =", round(np.mean(A & D), 6))print("P(D | A) =", round(np.mean(D[A]) if A.any() else0, 4), "≠ P(D) =", round(D.mean(), 4))
P(A)P(B) = 0.2555   P(A ∩ B) = 0.2557
¿A y B independientes (aprox.)? True

C = exactamente una cara:  P(C) = 0.4995   P(C | A) = 0.4941   → independientes (parecía que no)
E = dos caras:             P(E) = 0.2557   P(E | A) = 0.5059   → no independientes

A y 'ambas sellos' son disjuntos: P(A ∩ D) = 0.0
P(D | A) = 0.0 ≠ P(D) = 0.2448
\(P(A)P(B)=0.2555\) y \(P(A\cap B)=0.2557\): coinciden. \(P(C)=0.4995\) y \(P(C\mid A)=0.4941\), también casi iguales, aunque la intuición decía que no. En cambio, \(P(E)=0.2557\) sube a \(P(E\mid A)=0.5059\) cuando sabes que la primera fue cara. El último bloque muestra que \(A\) y «ambas sellos» (\(D\)) son disjuntos, con \(P(A\cap D)=0\), y por eso dependientes: \(P(D\mid A)=0\) frente a \(P(D)=0.2448\).
La independencia se comprueba con números. Independiente significa que saber uno no mueve al otro; disjunto, que los dos no caben a la vez. Si dos eventos con probabilidad positiva se excluyen, no los multipliques como si fueran independientes.
Etapa 6: Probabilidad total con dos líneas de producción
Una fábrica ficticia tiene dos líneas:
La línea \(H\) produce el 70% de las piezas, y el 2% sale defectuosa.
La línea \(H^c\) produce el 30%, y el 8% sale defectuosa.
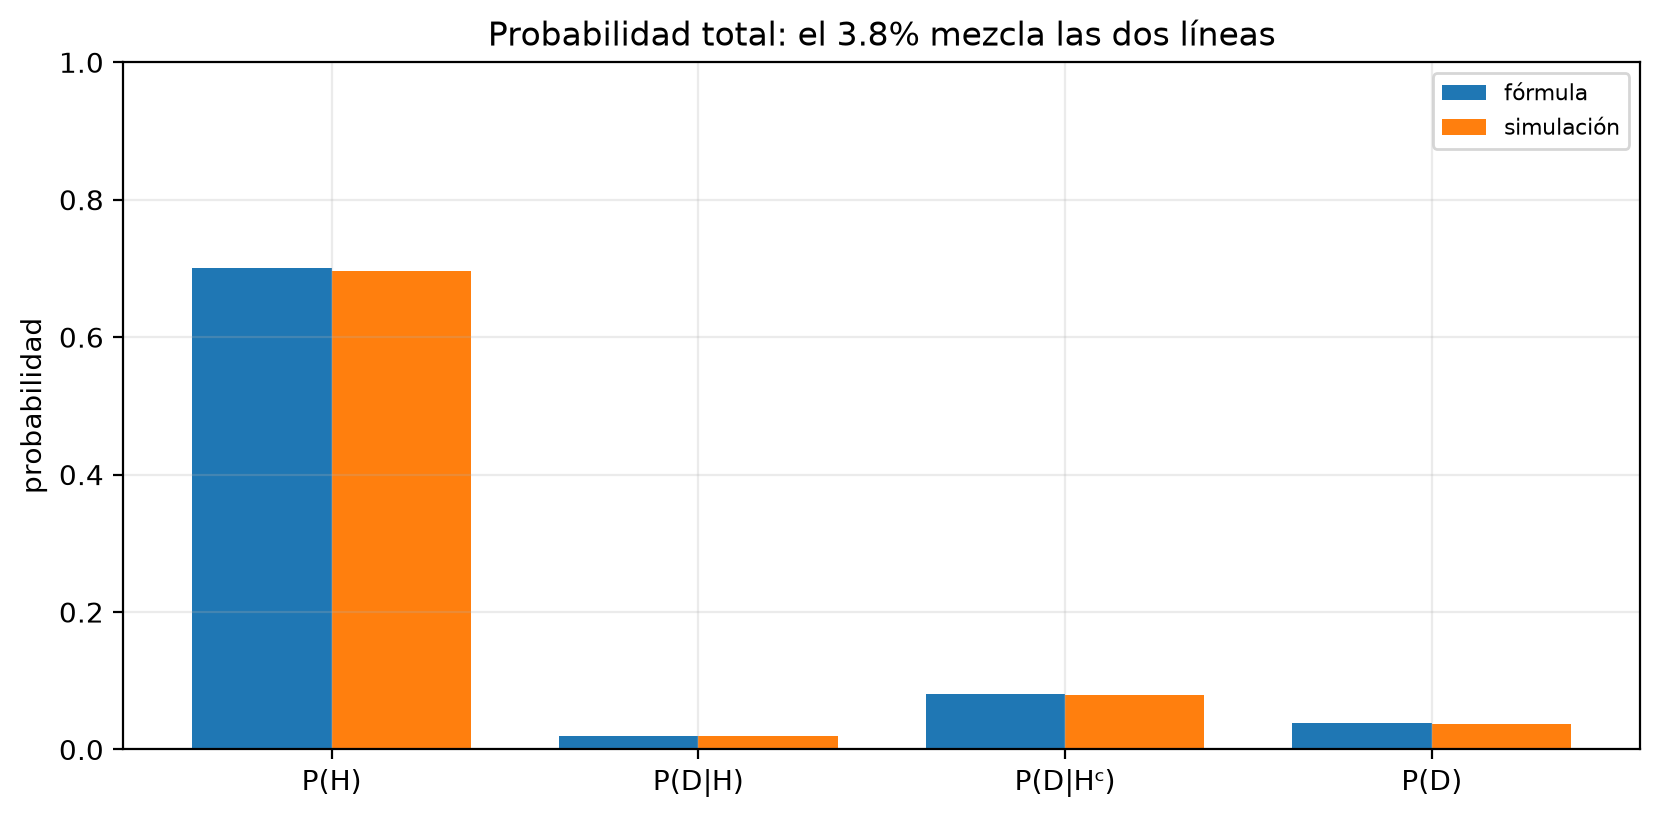
El 3.8% de todas las piezas es defectuoso: ni el 2% ni el 8%, sino el promedio ponderado por lo que produce cada línea. Simulas 20 000 piezas: cada una va a la línea \(H\) con probabilidad 0.70 y sale defectuosa con la probabilidad de su línea.
La simulación da \(P(D)=0.0376\), con 0.0194 de defectos en la línea \(H\) y 0.0794 en la \(H^c\), cerca de 0.038, 0.02 y 0.08. Las barras de fórmula y simulación coinciden en las cuatro cantidades. \(P(D)\) es la evidencia que irá al denominador de Bayes en la etapa 7. Si solo reportas que la línea principal tiene 2% de defectos, ocultas que un tercio de la producción sale de la línea con 8%.
Etapa 7: Bayes, ¿de qué línea salió la pieza defectuosa?
Encuentras una pieza defectuosa. ¿Cuál es \(P(H\mid D)\)?
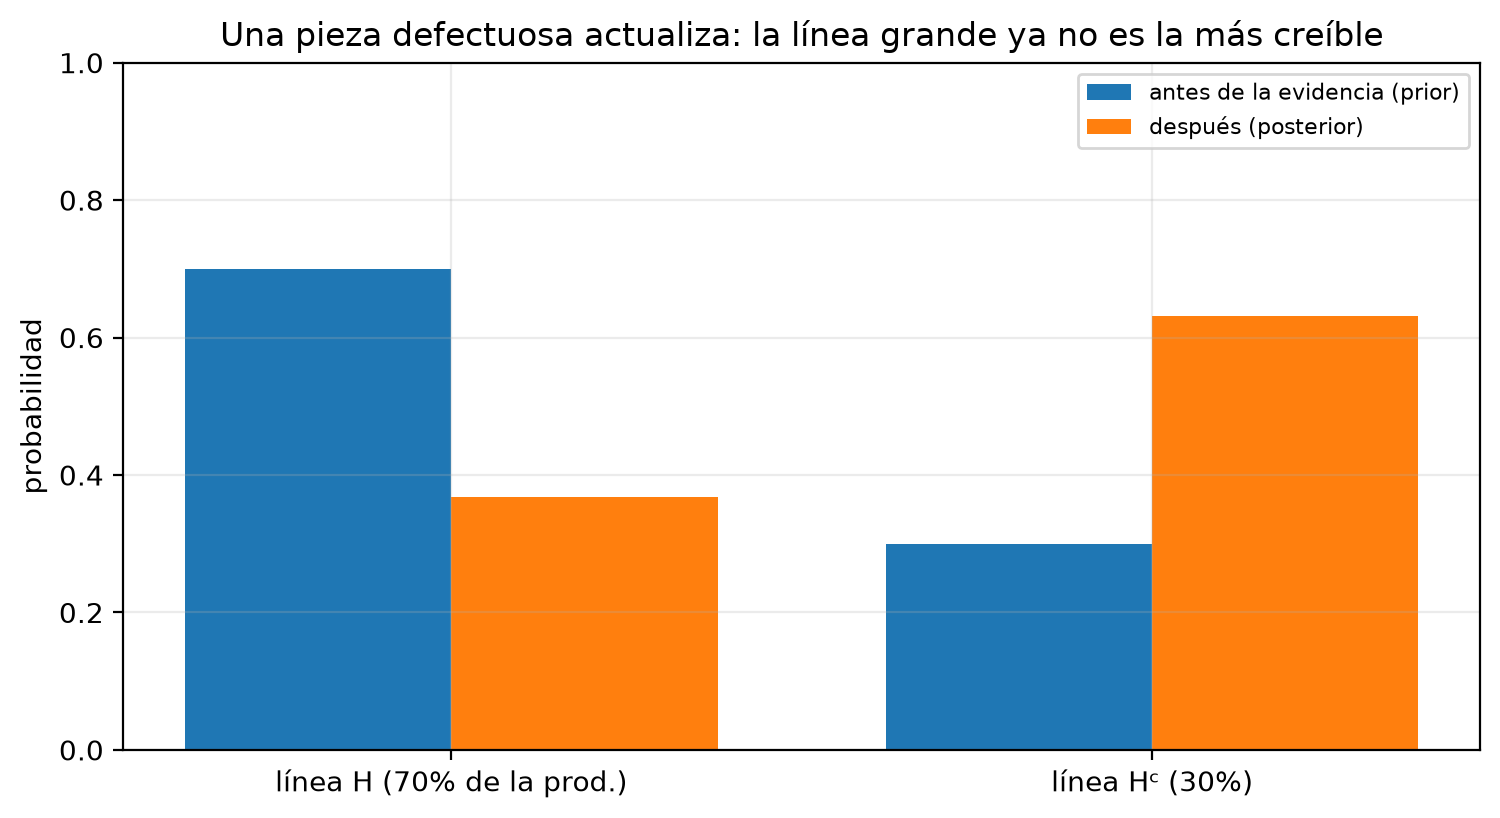
Aunque la línea \(H\) produce el 70% de las piezas, solo el 37% de los defectos sale de ella. La línea pequeña tiene una tasa de defectos cuatro veces mayor y aporta la mayoría.
p_h_dado_d = (0.02*0.70) /0.038print("P(H | D) teórica =", round(p_h_dado_d, 4))print("P(H | D) simulada =", round(linea[defectuosa].mean(), 4))print("P(H^c | D) =", round(1- p_h_dado_d, 4))graficar_prior_vs_posterior( ["línea H (70% de la prod.)", "línea Hᶜ (30%)"], [0.70, 0.30], [p_h_dado_d, 1- p_h_dado_d],"Una pieza defectuosa actualiza: la línea grande ya no es la más creíble",)
La fórmula da \(P(H\mid D)=0.3684\) y las piezas simuladas, 0.359; \(P(H^c\mid D)=0.6316\). En el gráfico, la línea \(H\) baja de 0.70 a 0.37 y la \(H^c\) sube de 0.30 a 0.63. El prior 0.70 se actualiza con las verosimilitudes 0.02 y 0.08: Bayes repondera lo que ya sabías con lo que observaste. Un clasificador hace lo mismo cuando combina \(P(y)\) con \(P(x\mid y)\).
Etapa 8: Prueba diagnóstica con una enfermedad rara
Simulas una población de 10 000 personas con estas probabilidades de diseño:
Prevalencia: \(P(E)=0.01\), 1 de cada 100.
Sensibilidad: \(P(+\mid E)=0.99\), casi ningún enfermo se escapa.
Tasa de falsos positivos: \(P(+\mid E^c)=0.05\), 5 de cada 100 sanos dan positivo.
Una pregunta frecuente es si un positivo es casi seguro enfermo, dado que la prueba acierta el 99% de las veces. La cantidad que responde a esa pregunta es \(P(E\mid +)\):
Un positivo es enfermo solo 1 de cada 6 veces. El 99% mide \(P(+\mid E)\), no \(P(E\mid +)\).
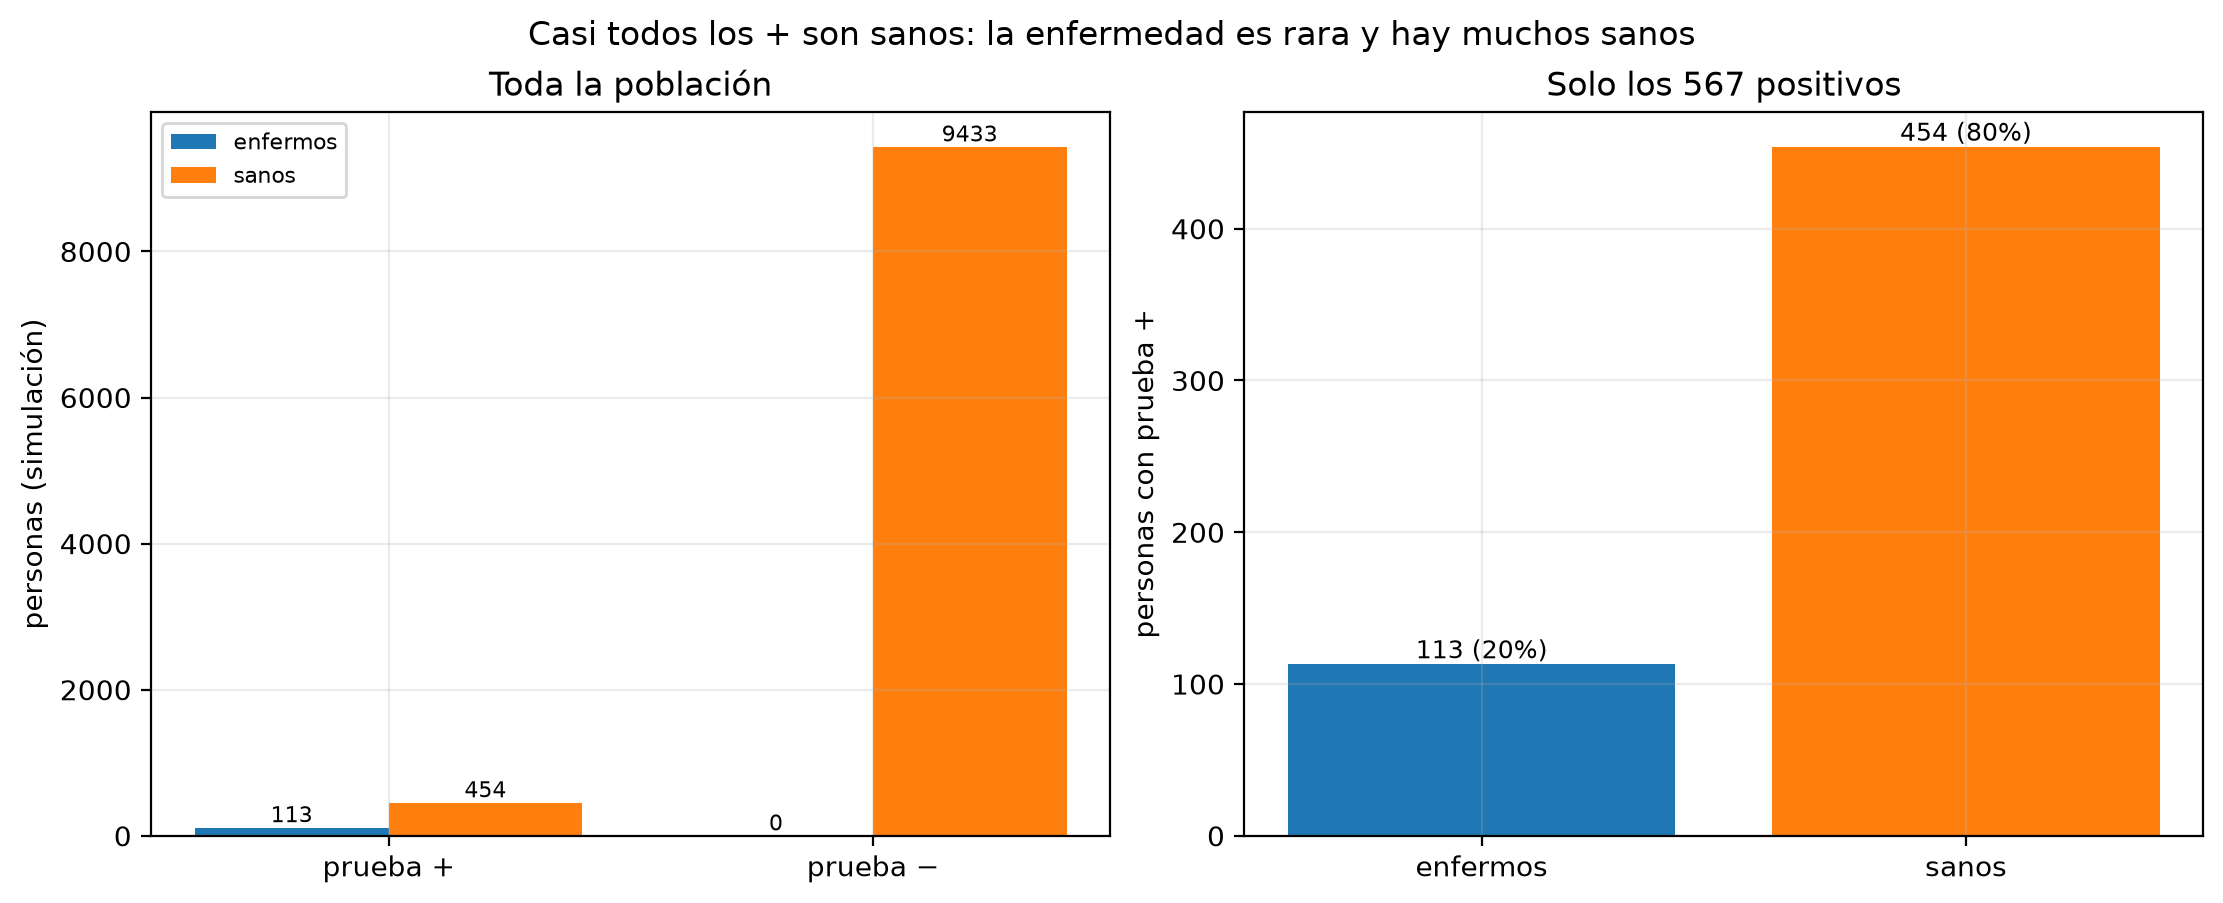
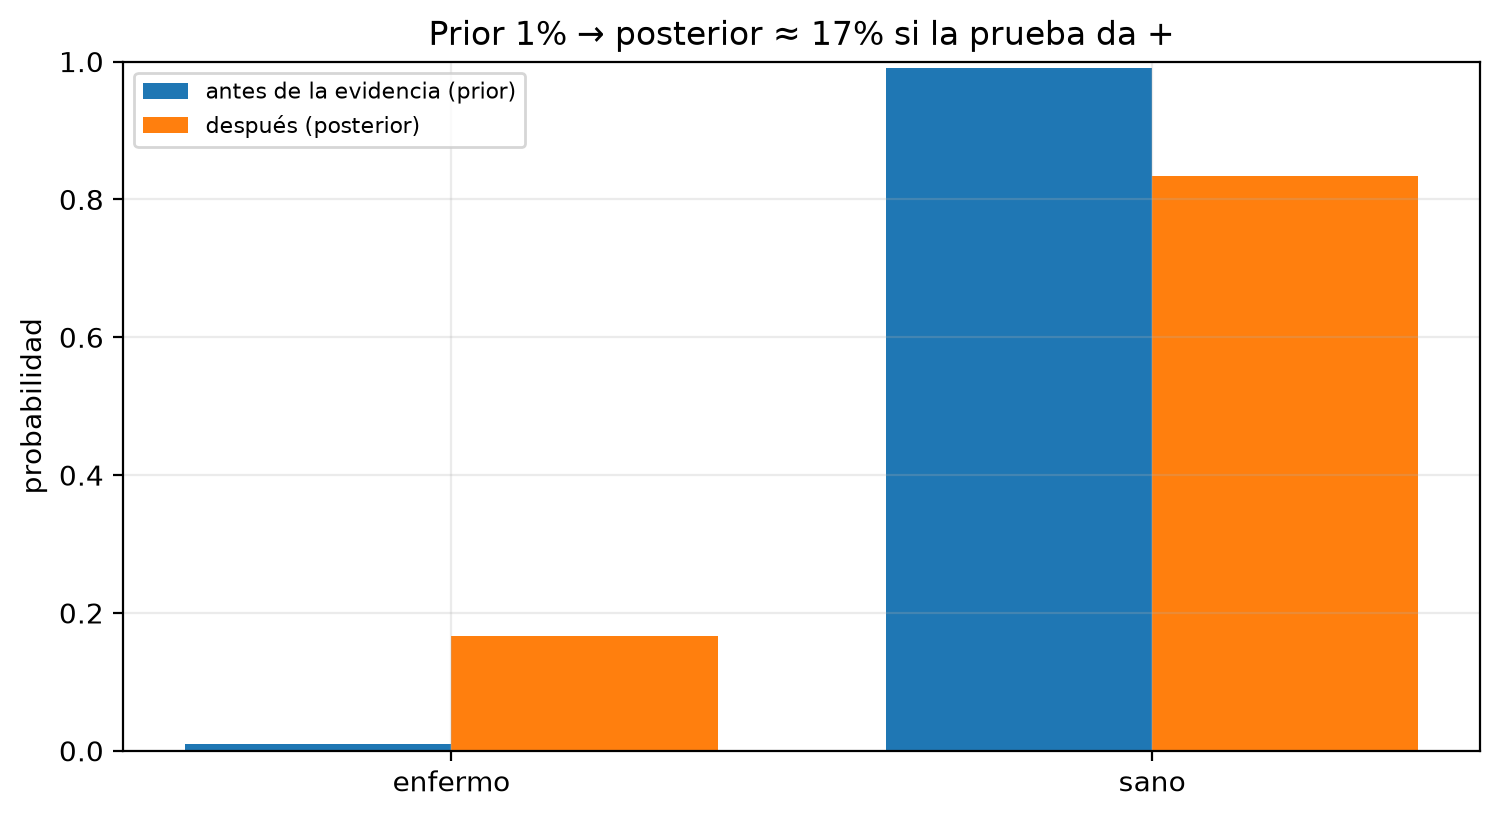
n =10000enfermo = rng.random(n) <0.01positivo = np.where(enfermo, rng.random(n) <0.99, rng.random(n) <0.05)n_e_pos =int((enfermo & positivo).sum())n_s_pos =int((~enfermo & positivo).sum())n_e_neg =int((enfermo &~positivo).sum())n_s_neg =int((~enfermo &~positivo).sum())print("Tabla de conteos:")print(pd.DataFrame( [[n_e_pos, n_e_neg], [n_s_pos, n_s_neg]], index=["enfermo", "sano"], columns=["prueba +", "prueba −"],))print()print("P(E | +) simulada =", round(n_e_pos / (n_e_pos + n_s_pos), 4), " teórica ≈ 0.167")print("P(+ | E) simulada =", round(n_e_pos / enfermo.sum(), 4), " (sensibilidad, ~0.99)")print("Entre los +, sanos / total + =", round(n_s_pos / (n_e_pos + n_s_pos), 4))graficar_conteos_prueba( n_e_pos, n_s_pos, n_e_neg, n_s_neg,"Casi todos los + son sanos: la enfermedad es rara y hay muchos sanos",)graficar_prior_vs_posterior( ["enfermo", "sano"], [0.01, 0.99], [0.99*0.01/0.0594, 1-0.99*0.01/0.0594],"Prior 1% → posterior ≈ 17% si la prueba da +",)
Tabla de conteos:
         prueba +  prueba −
enfermo       113         0
sano          454      9433

P(E | +) simulada = 0.1993   teórica ≈ 0.167
P(+ | E) simulada = 1.0   (sensibilidad, ~0.99)
Entre los +, sanos / total + = 0.8007
En la simulación salieron 113 enfermos, los 113 con prueba positiva, y 454 sanos con falso positivo. Entre los 567 positivos, solo el 20% está enfermo: \(P(E\mid +)\) simulada es 0.1993, frente al valor de diseño de 0.167. La diferencia es variación de muestreo: con tan pocos enfermos, unos más o unos menos mueven la fracción. La sensibilidad simulada es 1.0 porque, con 0.99 y 113 enfermos, lo esperable era perder apenas uno.
El posterior es bajo por la frecuencia base. En 10 000 personas esperas 9900 sanos, y el 5% de ellos son 495 falsos positivos; esperas 100 enfermos y unos 99 verdaderos positivos. En el grupo de positivos quedan 495 contra 99. La prueba es buena, pero la enfermedad es rara, y un modelo de fraude o de enfermedad poco frecuente trabaja en este régimen. En clasificación, esta situación se llama desbalance de clases: un 99% de sanos bien clasificados puede convivir con un posterior bajo para los positivos.
Ejercicio
Repite el cálculo con una prevalencia del 10%, como en un brote, manteniendo la sensibilidad (0.99) y la tasa de falsos positivos (0.05). ¿Cuánto vale ahora \(P(E\mid +)\)?
TipOrientaciones
\(P(+)=0.99\cdot 0.10+0.05\cdot 0.90=0.099+0.045=0.144\), y \(P(E\mid +)=0.099/0.144\approx 0.6875\). Con la misma prueba, el posterior sube de 0.167 a 0.69: la calidad de la prueba no cambió, cambió la frecuencia base. Por eso la misma prueba es más informativa en una población de alto riesgo.
Etapa 9: Clasificación binaria, alerta de fraude
Cada transacción es \(y=1\) (fraude) o \(y=0\) (legítima). Una regla simple dispara una alerta si el monto es alto y el país no es el habitual. Los números son de diseño, no de un banco real:
\(P(y=1)=0.02\);
\(P(\text{alerta}\mid y=1)=0.80\);
\(P(\text{alerta}\mid y=0)=0.10\).
Calculas \(P(y=1\mid \text{alerta})\) con la fórmula y después simulas 50 000 transacciones con esas probabilidades.
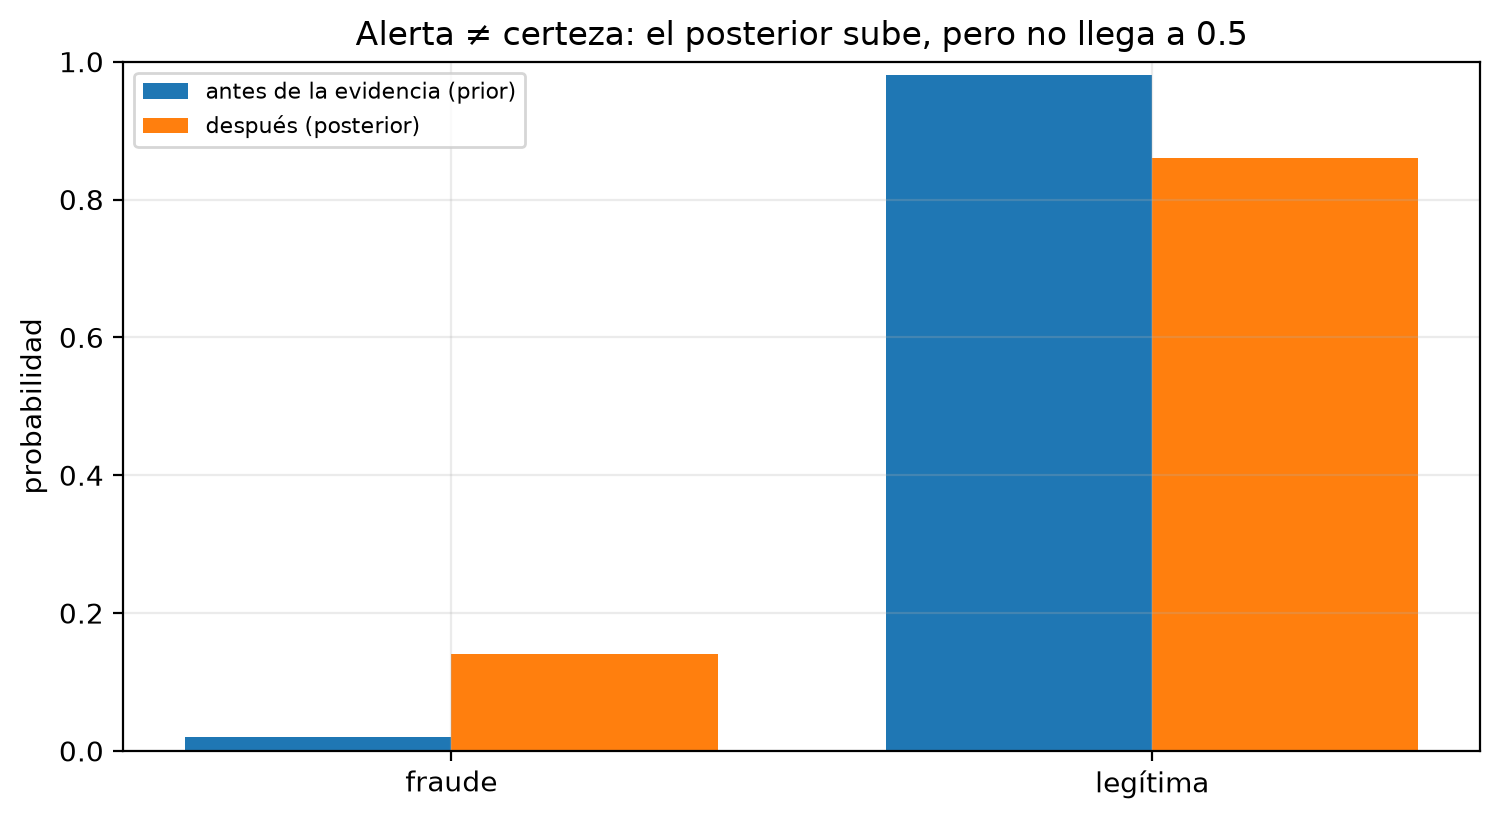
La fórmula da \(P(\text{alerta})=0.114\) y \(P(\text{fraude}\mid \text{alerta})=0.1404\); la simulación, 0.1431. En el gráfico, el fraude sube de 0.02 a 0.14 tras la alerta y lo legítimo baja de 0.98 a 0.86. \(P(y=1\mid \text{alerta})\) es la precisión de la alerta y \(P(\text{alerta}\mid y=1)\) es su sensibilidad o recall, 0.7892 en la simulación. Una alerta con recall de 80% y precisión de 14% sirve para elegir qué revisar a mano, pero no para bloquear automáticamente.
Un umbral de decisión de 0.5 no bloquearía ninguna transacción, porque \(0.14<0.5\). El umbral se elige con costos (cuánto cuesta molestar a un cliente honesto frente a dejar pasar un fraude), no con el 50% por costumbre; el capítulo 14 trata estas métricas y umbrales.
Etapa 10: Naive Bayes de una palabra
Un filtro de correo con dos clases, spam y correo legítimo (ham), y una evidencia: si el asunto contiene la palabra «premio».
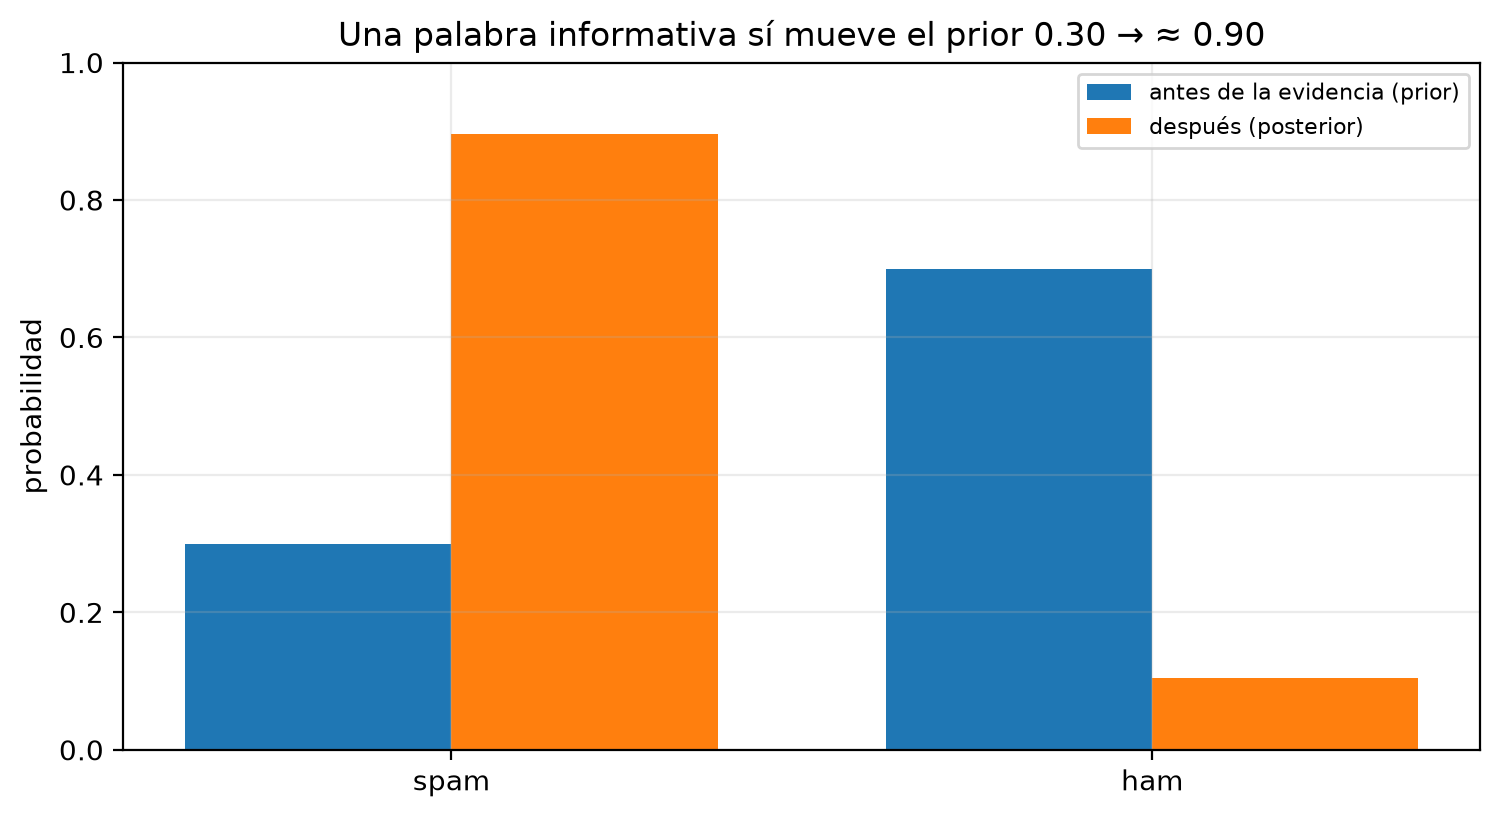
Con una sola palabra muy dispar entre clases, el posterior sí cruza 0.5. Naive Bayes con muchas palabras multiplica sus verosimilitudes, suponiendo que son independientes dentro de cada clase. Esa independencia es una hipótesis: «gratis» y «premio» suelen aparecer juntas en el spam real, y aun así el clasificador funciona bien como modelo de referencia. Para comprobar el número, simulas 20 000 correos con esas tres probabilidades.
La fórmula da \(P(\text{palabra})=0.134\) y \(P(\text{spam}\mid \text{palabra})=0.8955\); la simulación, 0.9014. En el gráfico, el spam pasa de 0.30 a cerca de 0.90.
Las etapas 8, 9 y 10 usan el mismo teorema; cambian la frecuencia base y cuánto separa la evidencia a las clases. En la prueba médica el prior es 1% y hay muchos falsos positivos; en el correo el prior es 30% y la palabra es rara en el correo legítimo (2%). En todos los casos, lo que reportas es \(P(\text{clase}\mid \text{dato})\), la probabilidad de la clase dado lo observado.
Etapa 11: Reportar un posterior
El reporte de un posterior sigue cinco pasos:
Experimento y \(\Omega\): qué observas y qué clases hay.
Prior:\(P(\text{clase})\) y de dónde sale (histórico, diseño o supuesto).
Verosimilitud:\(P(\text{evidencia}\mid \text{clase})\) para cada clase, como la sensibilidad o la tasa de alerta.
Evidencia:\(P(\text{dato})\) por probabilidad total.
Posterior y decisión:\(P(\text{clase}\mid \text{dato})\) y qué haces con él según el umbral.
Los aplicas a la prueba diagnóstica de la etapa 8.
Experimento. Una persona de la población; \(\Omega\) se parte en enfermo y sano, y la evidencia es la prueba, positiva o negativa.
Prior.\(P(E)=0.01\), una prevalencia de 1% fijada en el diseño.
Verosimilitud.\(P(+\mid E)=0.99\) y \(P(+\mid E^c)=0.05\).
Evidencia.\(P(+)=0.0594\): casi 6 de cada 100 personas dan positivo.
Posterior.\(P(E\mid +)\approx 0.167\).
En una población con 1% de prevalencia, una prueba con sensibilidad de 99% y 5% de falsos positivos produce \(P(\text{enfermedad}\mid +)\approx 16.7\%\). Se informa ese posterior, no la sensibilidad. Decisión: un positivo no justifica un tratamiento por sí solo; justifica una segunda prueba. Limitación: el 1% y el 5% son supuestos, y si la prevalencia sube (un brote), la misma prueba se vuelve más informativa.
Errores que conviene nombrar
Invertir el condicional. Reportar \(P(+\mid E)=0.99\) cuando la decisión pide \(P(E\mid +)\approx 0.167\).
Ignorar la frecuencia base. Una prueba excelente aplicada a una clase rara genera más falsos positivos que verdaderos positivos (454 frente a 113 en la etapa 8).
Confundir disjuntos con independientes. Que dos eventos no puedan ocurrir juntos no autoriza a multiplicar \(P(A)P(B)\).
Tratar una frecuencia de pocas repeticiones como una probabilidad estable. La etapa 2 muestra cuánto oscila al principio.
Usar el umbral 0.5 por costumbre. El umbral sale de los costos de cada error.
Decidir la independencia por intuición. «Primera cara» y «exactamente una cara» parecen ligados y son independientes; se comprueba con \(P(A\cap B)=P(A)P(B)\).
7.6 Guía rápida: ¿qué fórmula usar?
Situación
Qué usar
Por qué
Listar los resultados posibles
\(\Omega\)
Fija el denominador.
«No ocurrió A»
\(1-P(A)\)
Complemento.
A o B, que pueden solaparse
\(P(A)+P(B)-P(A\cap B)\)
No contar dos veces.
Ya sabes que ocurrió B
\(P(A\mid B)=P(A\cap B)/P(B)\)
Recorta \(\Omega\) a \(B\).
Saber B no cambia A
\(P(A\cap B)=P(A)P(B)\)
Independencia.
El dato puede venir de varios grupos
Probabilidad total
Promedio ponderado por el tamaño de cada grupo.
Tienes \(P(\text{dato}\mid \text{clase})\) y quieres la clase
Bayes
Invierte el condicional.
Clase rara y prueba imperfecta
Bayes con prior pequeño
El posterior suele quedar muy por debajo de la sensibilidad.
Al reportar, escribe el evento y lo que queda a la derecha de la barra.
7.7 Preguntas de comprensión
Un proveedor anuncia que su detector de fraude «acierta el 95% de los fraudes». ¿Qué probabilidad condicional describe ese 95% y qué dato te falta para saber cuántas alertas serán fraudes reales?
Dos eventos con probabilidad positiva son disjuntos. ¿Pueden ser independientes?
En la etapa 8, ¿por qué la simulación dio 0.1993 y la fórmula 0.167? ¿Cuál de los dos reportarías como propiedad de la prueba?
En la fábrica de la etapa 7, la línea \(H\) produce el 70% de las piezas. ¿Por qué no es la más probable como origen de una pieza defectuosa?
Un Naive Bayes supone independencia entre palabras dentro de cada clase. ¿Qué te dice la etapa 5 sobre cómo comprobar esa hipótesis con datos?
TipOrientaciones
Ese 95% es la sensibilidad, \(P(\text{alerta}\mid \text{fraude})\). Para obtener \(P(\text{fraude}\mid \text{alerta})\) te faltan la frecuencia base del fraude y la tasa de alertas entre transacciones legítimas; con los valores de la etapa 9 (2% y 10%), una sensibilidad de 0.95 daría un posterior de \(0.019/0.117\approx 0.16\).
No. Si son disjuntos, \(P(A\cap B)=0\), pero \(P(A)P(B)>0\); saber que ocurrió uno obliga a que el otro no ocurra, como \(A\) y «ambas sellos» en la etapa 5.
Por variación de muestreo: con unos 100 enfermos simulados, la fracción de enfermos entre los positivos oscila de una simulación a otra. El valor que describe la prueba con esa prevalencia es el de la fórmula, 0.167; la simulación sirve para comprobarlo y para ver cuánto puede variar en una muestra.
Porque su tasa de defectos (2%) es cuatro veces menor que la de la otra línea (8%). Aporta \(0.02\cdot 0.70=0.014\) de los 0.038 defectuosos, el 37%, frente a \(0.08\cdot 0.30=0.024\) de la otra.
Que se comprueba comparando \(P(A\cap B)\) con \(P(A)P(B)\), aquí dentro de cada clase: entre los correos spam, cuenta la fracción que tiene las dos palabras y compárala con el producto de las fracciones de cada una. La intuición no basta, como mostraron \(A\) y \(C\).
7.8 Referencias para profundizar
Blitzstein, J. K. y Hwang, J. (2019). Introduction to Probability (2.ª ed.). CRC Press. Capítulos 1 y 2: espacio muestral, probabilidad condicional, independencia y teorema de Bayes, con muchos ejemplos simulados.
Kolmogorov, A. N. (1956). Foundations of the Theory of Probability (2.ª ed. en inglés). Chelsea. La formulación axiomática original, publicada en alemán en 1933.
Gigerenzer, G. y Hoffrage, U. (1995). How to improve Bayesian reasoning without instruction: Frequency formats. Psychological Review, 102(4), 684–704. Por qué el problema de la prueba diagnóstica se entiende mejor contando personas que con porcentajes.
Una probabilidad solo tiene sentido con su evento escrito y con lo que queda a la derecha de la barra: \(P(A\mid B)\) y \(P(B\mid A)\) pueden ser 1/3 y 1, o 0.167 y 0.99.
El espacio muestral fija el denominador, y la frecuencia relativa se acerca a la probabilidad cuando \(n\) crece: 0.4995 de pares en 4000 lanzamientos.
La unión resta la intersección para no contar dos veces: \(1/2+1/3-1/6=2/3\).
Independencia y exclusión son distintas: dos eventos disjuntos con probabilidad positiva siempre son dependientes, y «primera cara» y «exactamente una cara» son independientes aunque no lo parezcan.
La probabilidad total pondera por el tamaño de cada grupo (3.8% de defectos), y Bayes invierte el condicional (37% de los defectos sale de la línea que produce el 70%).
Con una enfermedad del 1%, una prueba con sensibilidad de 99% deja un posterior de 16.7%; con una prevalencia de 10%, el mismo cálculo da 69%.
En clasificación, el posterior es la precisión y la sensibilidad es el recall; el umbral se decide con costos.
7.10 Puente hacia los siguientes capítulos
Hasta aquí hablaste de eventos. El capítulo 8 pasa a números: variables aleatorias, sus distribuciones y lo que ocurre al promediar muchas repeticiones, que explica por qué la frecuencia de la etapa 2 se estabiliza. La inferencia del capítulo 9 usa la misma barra para hablar de un parámetro desconocido a partir de una muestra, y el capítulo 12 aplica Bayes al propio parámetro. La clasificación del capítulo 14 y la validación del capítulo 15 vuelven a \(P(y\mid x)\), a la precisión, al recall y a los umbrales con costo.