Clasificar consiste en decidir, con un umbral, qué casos reciben la etiqueta positiva (fraude, enfermedad, spam), sabiendo que los dos errores no pesan igual y que la clase que importa suele ser la rara. Un clasificador que nunca alerta acierta el 95.4% de las veces si solo el 4.6% de los casos es positivo, y ese 95.4% es la frecuencia base de la clase mayoritaria, que no dice nada sobre los positivos.
En este capítulo construyes el lenguaje para leer un clasificador: matriz de confusión, exactitud (accuracy), precisión, recall (sensibilidad), F1, curva ROC, AUC, el desbalance de clase y de costo, y el cambio de prevalencia. El contraste central es el de la prueba diagnóstica del capítulo 7: \(P(+\mid E)\) y \(P(E\mid +)\) son cantidades distintas, que aquí se llaman recall y precisión.
Trabajas con dos conjuntos. El primero es un filtro de fraude con datos simulados por make_classification (4000 filas, 8 features, clase positiva cercana al 4.6%), donde la exactitud engaña. El segundo es el conjunto real Breast cancer Wisconsin de scikit-learn (569 masas mamarias, 37% malignas), para aplicar el mismo procedimiento cuando la prevalencia no es extrema.
Tiempo estimado de lectura: 70 minutos (unas 2 horas y media si ejecutas el código y resuelves el ejercicio)
Nivel: Básico
Conocimientos previos recomendados: el capítulo 7 (probabilidad condicional y teorema de Bayes), el capítulo 9 (intervalos de confianza para una proporción), el capítulo 12 (máxima verosimilitud) y el capítulo 13 (regresión lineal y MSE).
Tecnologías mencionadas: Python 3.13, NumPy, pandas, SciPy, Matplotlib y scikit-learn (LogisticRegression, DummyClassifier, Pipeline y sklearn.metrics).
Objetivos
Al terminar este capítulo vas a ser capaz de:
plantear la clasificación binaria como un score \(s(x)\) más un umbral\(\tau\);
construir y leer la matriz de confusión (VP, FP, FN y VN) en palabras;
calcular exactitud, precisión, recall y \(F_1\), y reconocer cuándo cada una deja de informar;
leer la curva ROC y el AUC, y contrastarlos con la curva precisión–recall cuando la clase es rara;
elegir el umbral según el costo de un falso positivo frente a un falso negativo;
acompañar las métricas de la clase rara con un intervalo de confianza y trasladar una precisión a otra prevalencia;
redactar un veredicto: el clasificador sirve o no sirve para un uso concreto.
Ejecuta las celdas en orden: las etapas comparten variables.
14.1 El clasificador es un umbral sobre una probabilidad
Clasificación binaria
Cada fila tiene una etiqueta \(y\in\{0,1\}\). El modelo entrega un score\(s(x)\in[0,1]\), un número que ordena las filas de menos a más sospechosas de ser positivas, y la etiqueta predicha sale de compararlo con un umbral:
\[
\hat y = \mathbf{1}\{s(x)\ge \tau\}.
\]
El valor \(\tau=0.5\) es una convención. Mover \(\tau\) cambia todos los conteos de la matriz, así que un modelo y un umbral forman un par, y unas métricas reportadas sin \(\tau\) están incompletas.
Matriz de confusión
Comparas \(\hat y\) con \(y\) en un conjunto de filas que no se usó para ajustar el modelo, y obtienes cuatro conteos:
Empieza a leer la matriz por la celda del error más costoso. En fraude, un FN es un cargo fraudulento que pasó y un FP es un cliente molesto; en cribado médico (pruebas a personas sin síntomas), un FN es un enfermo no detectado.
Las métricas se calculan sobre filas apartadas antes de ajustar, el conjunto de prueba (test); el resto es el conjunto de entrenamiento (train). El capítulo 15 desarrolla el porqué y las variantes; aquí basta la regla: lo que usaste para ajustar o para elegir algo no lo usas para medir.
Es la fracción de filas bien etiquetadas, una métrica simétrica que trata igual los dos errores y las dos clases. Se llama prevalencia a \(\pi=P(y=1)\), la fracción de positivos. Cuando \(\pi=0.046\), predecir siempre \(0\) da una exactitud de \(0.954\), y ese número no informa sobre el fraude.
La línea base de la exactitud es la frecuencia de la clase mayoritaria, \(1-\pi\) cuando el positivo es la clase rara. Un modelo que no la supera no gana nada en esa métrica, lo que no prueba que sea inútil: con clase rara, la exactitud suele ser la métrica equivocada.
La precisión es, entre las alertas, la fracción que era positiva. El recall (sensibilidad, exhaustividad) es, entre los positivos reales, la fracción que se alertó.
es la media armónica de las dos, baja cuando cualquiera de ellas es cercana a 0. No incorpora costos ni reemplaza la elección de \(\tau\). La especificidad es \(\mathrm{VN}/(\mathrm{VN}+\mathrm{FP})=P(\hat y=0\mid y=0)\), y la tasa de falsos positivos (FPR) es uno menos la especificidad, \(\mathrm{FP}/(\mathrm{FP}+\mathrm{VN})\).
ROC y AUC
Barres \(\tau\) de \(1\) a \(0\) y en cada umbral anotas
La curva ROC es TPR frente a FPR, y el AUC (area under the curve) es el área bajo esa curva. Equivale a la probabilidad de que un positivo tomado al azar tenga un score mayor que un negativo tomado al azar, con los empates contando medio (Fawcett, 2006). Un AUC de \(0.5\) corresponde a ordenar al azar y uno de \(1\) a una separación perfecta; un clasificador que da el mismo score a todas las filas solo produce empates y tiene AUC \(0.5\).
El AUC mide el ordenamiento que el score da a las filas y no elige umbral. Como TPR y FPR se calculan dentro de cada clase, el AUC no cambia con \(\pi\), y por eso, citado solo, engaña cuando la clase es rara: un FPR de \(0.01\) parece despreciable, pero sobre los 1145 negativos de la prueba de este capítulo son unas 11 falsas alertas, frente a 55 positivos posibles. Un AUC de 0.92 es compatible con una precisión de 0.08 en el \(\tau\) de operación si la clase es muy rara (cifras ilustrativas).
Con clase rara, la curva precisión–recall (PR) y su área, la precisión media (AP, average precision), suelen informar más (Saito y Rehmsmeier, 2015), porque su eje vertical es la precisión, lo que ve quien recibe las alertas. Su referencia es la prevalencia \(\pi\), la precisión de alertar al azar.
Desbalance de clase, desbalance de costo y cambio de prevalencia
Bajo la palabra “desbalance” se mezclan tres situaciones:
Situación
Qué ocurre
Qué deja de informar
Desbalance de clase
\(\pi\ll 0.5\) (fraude, enfermedad rara)
La exactitud; el AUC si se cita solo
Desbalance de costo
FN y FP no cuestan lo mismo
\(F_1\) y \(\tau=0.5\)
Cambio de prevalencia
La \(\pi\) del conjunto evaluado no es la del uso
La precisión medida en ese conjunto
El recall y la especificidad no dependen de \(\pi\) mientras las filas de cada clase se parezcan entre el conjunto evaluado y el de uso y \(\tau\) no cambie. La precisión sí depende:
Es el teorema de Bayes de la prueba diagnóstica: bajar \(P(E)\) baja \(P(E\mid +)\). Con recall \(0.80\) y FPR \(0.05\) (cifras ilustrativas), la precisión es \(0.80\) cuando \(\pi=0.20\) y \(0.25\) cuando \(\pi=0.02\); la etapa 9 lo comprueba con los datos del capítulo.
Protocolo: ¿el clasificador es aceptable?
¿Cuál es \(\pi\) en el conjunto que se reporta, y se parece a la del uso?
¿Qué cuesta un FP y qué cuesta un FN en este uso?
¿La exactitud supera a la de la clase mayoritaria? Si es la única cifra, no hay veredicto.
Precisión, recall y \(F_1\) en el \(\tau\) de operación, con su intervalo de confianza cuando los positivos son pocos.
ROC y, con clase rara, PR. El AUC no se cita solo.
¿El umbral se eligió con la prueba? Si fue así, la cifra deja de ser una medición independiente.
Pregunta
Métrica
¿Aciertos globales?
Exactitud (solo si clases y costos son simétricos)
¿Las alertas son confiables?
Precisión
¿Se escapan pocos positivos?
Recall
¿Un solo número de compromiso?
\(F_1\) (sin costos)
¿El score ordena bien las filas?
AUC-ROC
¿Qué calidad tienen las alertas con clase rara?
Curva PR y AP
14.2 Por qué importa en IA y machine learning
Casi todo clasificador de aprendizaje automático, desde una regresión logística hasta una red neuronal, entrega un score y deja el umbral a quien lo usa. El predict de scikit-learn usa \(\tau=0.5\), y el umbral que conviene a un uso concreto rara vez es ese:
el detector de fraude de este capítulo, a \(\tau=0.5\), tiene recall 0.218: deja pasar el 78% de los fraudes con una exactitud de 0.964;
un filtro de spam con precisión 0.40 (cifra ilustrativa) manda a cuarentena 6 correos legítimos por cada 10 que retiene, un costo que no aparece en un \(F_1\);
los conjuntos de evaluación de modelos (médicos, de moderación de contenido, de detección de anomalías) suelen estar enriquecidos con positivos, y una precisión medida allí no se traslada a producción sin la prevalencia (etapa 9);
calibrar \(s(x)\), es decir, que un score de 0.8 corresponda a 80 positivos de cada 100, es otra pregunta, y la etapa 8 muestra que reponderar las clases mejora el recall a costa de la calibración;
elegir \(\tau\) mirando la prueba y citar las métricas de esa misma prueba usa la prueba dos veces, y la cifra deja de ser una medición independiente.
La métrica adecuada es la que refleja el error más costoso; la exactitud refleja el error más frecuente.
14.3 Flujo recomendado de trabajo
El protocolo anterior, puesto en orden de ejecución:
Declara la clase positiva, la prevalencia y el costo relativo de un FN frente a un FP.
Reserva la prueba y ajusta el modelo en entrenamiento. Elige el umbral con los costos y en una tercera partición, distinta de la prueba.
Construye la matriz de confusión en la prueba, en el \(\tau\) de operación.
Compara la exactitud con la de la clase mayoritaria y calcula precisión, recall y \(F_1\), con intervalo si los positivos son pocos.
Dibuja ROC y PR; el AUC no se cita solo.
Redacta el veredicto para un uso (“sirve para priorizar revisión”, “no sirve para bloqueo automático”):
«Para [uso], positivo = [clase], \(\pi=\)[valor] en la prueba (\(n=\)[valor]). Modelo [nombre], \(\tau=\)[valor]. Matriz: VP = [ ], FN = [ ], FP = [ ], VN = [ ]. Exactitud = [valor] (dummy = [valor]). Precisión = [valor], recall = [valor] (IC 95%: [extremos]), \(F_1=\)[valor]. AUC = [valor], AP = [valor]. Veredicto: [se acepta para… / se rechaza para…]. Limitación: [una sola partición, τ elegido en la prueba, π distinta en el uso u otra].»
Un clasificador sin prevalencia, sin matriz y sin umbral declarado no se puede evaluar. La etapa 11 llena esta plantilla con el fraude y con Breast cancer.
14.4 Preparar el entorno
La celda carga NumPy, pandas, Matplotlib, SciPy y las piezas de scikit-learn que usa el capítulo (generador de datos, modelos, Pipeline y métricas), y fija un estilo de gráficos.
%matplotlib inline%config InlineBackend.figure_format ="retina"SEMILLA =42# simulación del fraude y particionesSEMILLA_LOCAL =0# generador independiente de la etapa localimport sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom scipy import statsfrom sklearn.datasets import make_classification, load_breast_cancerfrom sklearn.linear_model import LogisticRegressionfrom sklearn.dummy import DummyClassifierfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScalerfrom sklearn.pipeline import Pipelinefrom sklearn.metrics import ( confusion_matrix, accuracy_score, precision_score, recall_score, f1_score, roc_curve, roc_auc_score, precision_recall_curve, average_precision_score, brier_score_loss, classification_report,)plt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25print("sklearn:", __import__("sklearn").__version__)
Python: 3.13.14
sklearn: 1.9.0
Funciones de métricas y gráficos
El entorno queda con Python 3.13.14 y scikit-learn 1.9.0.
Además de los conteos y las figuras, la celda siguiente define dos funciones pequeñas:
ic_wilson(k, n) calcula un intervalo de confianza para una proporción \(\hat p=k/n\). Usa el intervalo de Wilson (Wilson, 1927), una variante del intervalo para una proporción del capítulo 9 que funciona bien con \(n\) pequeño y con \(\hat p\) cercana a 0 o a 1, donde el intervalo \(\hat p\pm z\sqrt{\hat p(1-\hat p)/n}\) se reduce a un punto:
\[
\frac{\hat p+\dfrac{z^2}{2n}\;\pm\; z\sqrt{\dfrac{\hat p(1-\hat p)}{n}+\dfrac{z^2}{4n^2}}}{1+\dfrac{z^2}{n}},\qquad z=1.96 \text{ para el } 95\%.
\]
precision_por_pi(recall, fpr, pi) aplica la fórmula de la precisión según la prevalencia y da la precisión esperada con otra \(\pi\).
Las etapas 1 a 9 trabajan el caso de fraude simulado, con prevalencia cercana al 4.6%, donde la exactitud no sirve como argumento. La etapa 10 repite el procedimiento con Breast cancer, de prevalencia más alta, y llega a un veredicto distinto; la etapa 11 reporta los dos casos con la plantilla del flujo.
Etapa 1: El dato y la frecuencia base
Generas \(n=4000\) filas con \(8\)features mediante make_classification (semilla 42). Pides un \(3\%\) de positivos con weights, y el ruido de etiquetas flip_y=0.03, que reasigna al azar la etiqueta de una parte de las filas, lo sube a cerca del \(4.6\%\). Reservas el \(30\%\) como prueba, estratificada, y antes de ajustar cualquier modelo calculas \(\pi=P(y=1)\).
X, y = make_classification( n_samples=4000, n_features=8, n_informative=5, n_redundant=1, n_clusters_per_class=1, weights=[0.97, 0.03], class_sep=0.62, flip_y=0.03, random_state=SEMILLA,)X_tr, X_te, y_tr, y_te = train_test_split( X, y, test_size=0.30, random_state=SEMILLA, stratify=y)print("n train =", len(y_tr), " n test =", len(y_te))print("P(y=1) train =", round(y_tr.mean(), 4), " P(y=1) test =", round(y_te.mean(), 4))print("Positivos en test =", int(y_te.sum()), "de", len(y_te))print("Negativos por positivo en train =", round((len(y_tr) - y_tr.sum()) / y_tr.sum(), 1))print()print("Baseline de exactitud (siempre ŷ=0) =", round(1- y_te.mean(), 4))
n train = 2800   n test = 1200
P(y=1) train = 0.0454   P(y=1) test = 0.0458
Positivos en test = 55 de 1200
Negativos por positivo en train = 21.0

Baseline de exactitud (siempre ŷ=0) = 0.9542
La prevalencia es 0.0454 en entrenamiento y 0.0458 en prueba, con unos 21 negativos por cada positivo, y en la prueba hay 55 positivos de 1200. El recall se calcula con esas 55 filas, la precisión con las filas que resulten alertadas y la exactitud con las 1200, y por eso la exactitud se ve estable aunque no informe sobre el fraude. La etapa 4 cuantifica con un intervalo de confianza cuánto pueden variar las métricas calculadas con 55 positivos.
Ya existe un clasificador, “nadie es fraude”, y su exactitud es \(1-\pi=0.9542\). Ese valor es el piso de comparación y no cuenta como logro de ningún modelo.
Etapa 2: La exactitud del clasificador que nunca alerta
DummyClassifier(strategy="most_frequent") predice siempre la clase mayoritaria sin usar \(x\), así que su exactitud en la prueba es la frecuencia de esa clase.
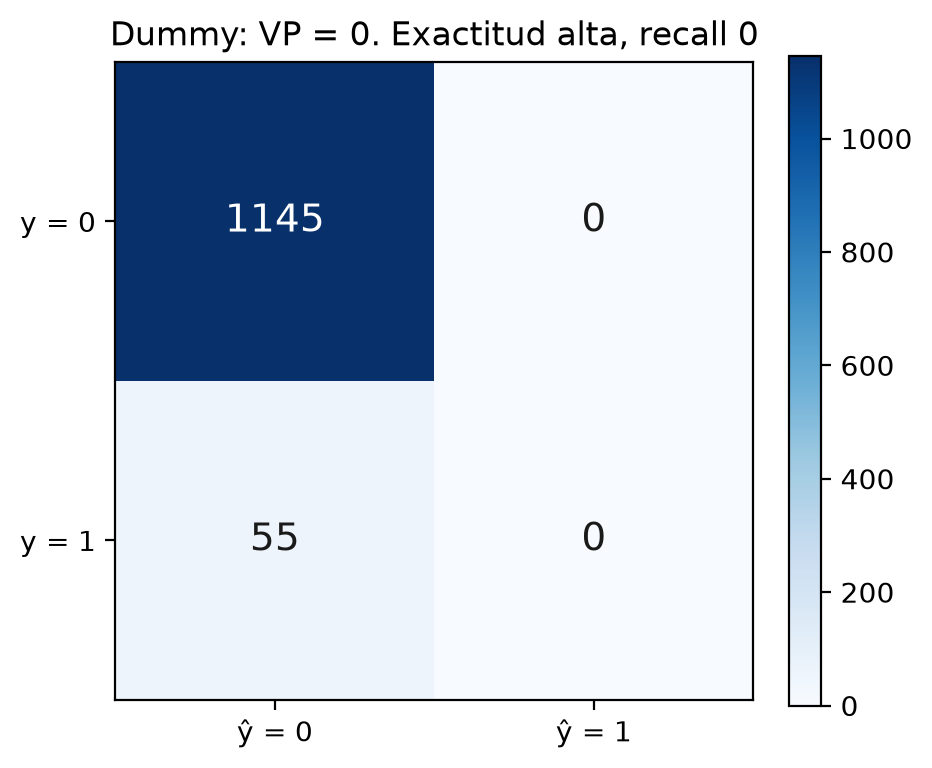
En la matriz, las 1145 transacciones legítimas están en VN y los 55 fraudes en FN; VP y FP valen 0, porque no hubo ninguna alerta, así que la precisión se reporta como \(0\) y el recall y el \(F_1\) también son \(0\). La exactitud es \(0.954\). Como el dummy da el mismo score a todas las filas, su AUC es \(0.5\) y su AP es la prevalencia, \(0.046\).
De aquí no se sigue que \(x\) no tenga información, porque el dummy no la usó. Lo que muestra es que la exactitud, sola, no distingue a este dummy de un detector útil: si un informe solo trae “accuracy 95.4%”, la primera pregunta es cuál es la prevalencia.
Etapa 3: Regresión logística, un modelo que sí usa \(x\)
La regresión logística calcula \(z=b_0+b_1x_1+\dots+b_Dx_D\), como la regresión lineal, y pasa ese valor por la función \(1/(1+e^{-z})\) para obtener un número entre 0 y 1 que se lee como estimación de \(P(y=1\mid x)\). Ese número es el score \(s(x)\). Los coeficientes se ajustan por máxima verosimilitud (capítulo 12), y el capítulo de modelos lineales generalizados del nivel Avanzado desarrolla el modelo.
Estandarizas las features porque LogisticRegression penaliza por defecto el tamaño de los coeficientes, y esa penalización depende de la escala de cada variable. El escalado va dentro de un Pipeline, de modo que sus medias y desviaciones se calculan solo con el entrenamiento. Usas el umbral por defecto, \(\tau=0.5\), y comparas con el dummy en la misma prueba.
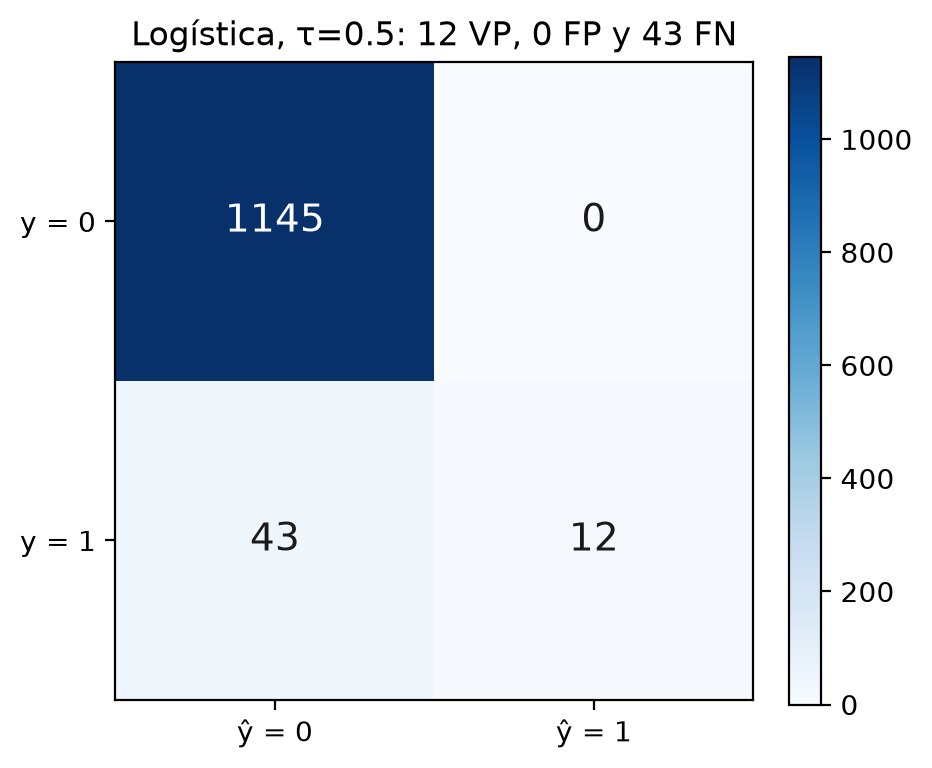
La exactitud sube de 0.954 a 0.964, que son los 12 fraudes detectados sobre 1200 filas. No hay falsas alertas (precisión 1.0), y el modelo deja pasar 43 de 55 fraudes (recall 0.218); un punto de diferencia en exactitud no deja ver ninguna de las dos cosas. El AUC pasa de 0.5 a 0.735 y el AP de 0.046 a 0.420, así que el score ordena las filas mejor que el azar. Lee en este orden: recall (cuántos fraudes se detectaron), precisión (qué fracción de las alertas era fraude) y, al final, exactitud contra su línea base.
Los dos clasificadores se evaluaron sobre las mismas 1200 filas, y para contrastar formalmente si difieren en aciertos usarías la prueba de McNemar del capítulo 10, que solo mira las filas donde uno acierta y el otro falla (aquí, los 12 fraudes que la logística detecta y el dummy no).
La logística supera al dummy en recall, \(F_1\), AUC y AP, así que \(x\) aporta información. Que \(\tau=0.5\) sea el corte de operación no está demostrado (la etapa 6 lo mueve), y con 43 fraudes sin detectar falta decidir para qué uso alcanza.
Etapa 4: Las cuatro celdas, en palabras
Tomas los conteos de la logística y los traduces a frases, que es la forma en que la matriz sirve para decidir, y agregas el intervalo de confianza de Wilson al 95% para el recall y la precisión.
c = conteos(y_te, yp)n =len(y_te)print(f"De {n} transacciones de prueba:")print(f" {c['VP']} fraudes bien alertados (VP)")print(f" {c['FN']} fraudes que pasaron (FN) ← costo de 'dejar pasar'")print(f" {c['FP']} legítimas alertadas (FP) ← costo de 'molestar'")print(f" {c['VN']} legítimas sin alerta (VN)")print()print("precisión = VP / (VP+FP) =", round(c["VP"] /max(c["VP"] + c["FP"], 1), 3))print("recall = VP / (VP+FN) =", round(c["VP"] /max(c["VP"] + c["FN"], 1), 3))print("exactitud = (VP+VN) / n =", round((c["VP"] + c["VN"]) / n, 3))print()li_r, ls_r = ic_wilson(c["VP"], c["VP"] + c["FN"])li_p, ls_p = ic_wilson(c["VP"], c["VP"] + c["FP"])print("Intervalos de confianza de Wilson al 95%:")print(f" recall {c['VP']}/{c['VP'] + c['FN']}: [{li_r:.3f}, {ls_r:.3f}]")print(f" precisión {c['VP']}/{c['VP'] + c['FP']}: [{li_p:.3f}, {ls_p:.3f}]")
De 1200 transacciones de prueba:
  12 fraudes bien alertados (VP)
  43 fraudes que pasaron (FN)  ← costo de 'dejar pasar'
  0 legítimas alertadas (FP)  ← costo de 'molestar'
  1145 legítimas sin alerta (VN)

precisión = VP / (VP+FP) = 1.0
recall    = VP / (VP+FN) = 0.218
exactitud = (VP+VN) / n  = 0.964

Intervalos de confianza de Wilson al 95%:
  recall    12/55: [0.129, 0.344]
  precisión 12/12: [0.758, 1.000]
“Se alertaron 12 fraudes y pasaron 43” es el recall (\(12/55=0.218\)) en lenguaje llano, y “las 12 alertas eran fraude” es la precisión (\(12/12=1.0\)). Quien decide entiende esas dos oraciones sin conocer las fórmulas, mientras que “\(F_1=0.358\)” necesita traducción.
Con 55 positivos y 12 alertas, el intervalo de Wilson al 95% es \([0.129,\ 0.344]\) para el recall y \([0.758,\ 1.000]\) para la precisión. Doce alertas sin ningún FP son compatibles con una precisión real de 0.758, así que haber acertado las 12 en esta prueba no garantiza cero falsas alertas en uso.
Etapa 5: El mismo modelo, dos usos, dos veredictos
No reentrenas: lees la misma matriz con dos estructuras de costo.
Uso A, bloqueo automático. Un FP sale caro (un cliente bloqueado), así que exiges precisión alta y toleras dejar pasar fraude.
Uso B, cola de revisión. Un FN sale caro (un fraude no visto), así que exiges recall alto y aceptas revisar falsas alertas.
print("Misma matriz, dos lecturas (τ = 0.5)")print(pd.Series(c).to_string())print()print("Uso A (bloqueo): precisión =", round(precision_score(y_te, yp, zero_division=0), 3),f" → {c['FP']} FP entre {c['VP'] + c['FP']} alertas.")print("Uso B (revisión): recall =", round(recall_score(y_te, yp, zero_division=0), 3),f" → llegan a la cola {c['VP']} de {c['VP'] + c['FN']} fraudes.")print()print("El F1 =", round(f1_score(y_te, yp, zero_division=0), 3),"combina las dos métricas y no distingue entre los dos usos.")
Misma matriz, dos lecturas (τ = 0.5)
VN    1145
FP       0
FN      43
VP      12

Uso A (bloqueo):  precisión = 1.0   → 0 FP entre 12 alertas.
Uso B (revisión): recall    = 0.218   → llegan a la cola 12 de 55 fraudes.

El F1 = 0.358 combina las dos métricas y no distingue entre los dos usos.
El modelo es el mismo y el veredicto cambia con el uso. Para el uso A, \(\tau=0.5\) es compatible con lo que se pide: 12 alertas y ninguna falsa en esta prueba, con el intervalo de la etapa 4 como advertencia. Para el uso B no alcanza, porque llegan a la cola 12 de 55 fraudes. El \(F_1\) (0.358) resume las dos métricas sin saber cuál importa: sirve para ordenar modelos cuando no hay costos y es insuficiente para decidir un despliegue. Con \(\tau=0.5\) este modelo no atiende los dos usos a la vez, y para el uso B hay que mover el umbral.
Etapa 6: Al mover \(\tau\), precisión y recall no se maximizan juntos
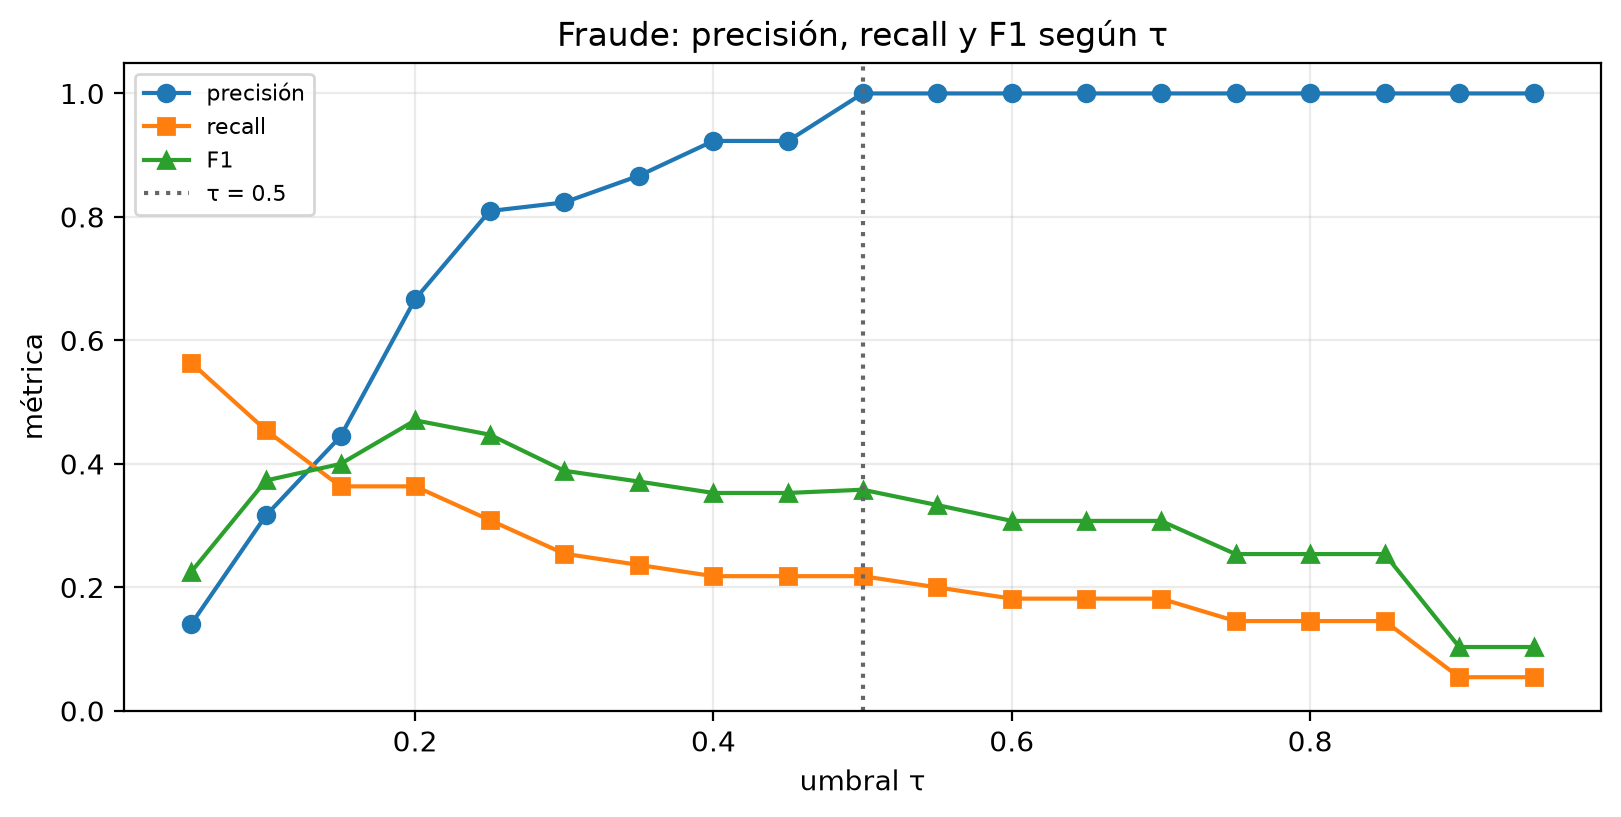
Barres el umbral. Subir \(\tau\) exige más certeza para alertar, de modo que el recall no puede subir y la precisión tiende a subir; bajar \(\tau\) hace lo contrario. A cada fila de la parrilla le calculas además el costo \(20\cdot\mathrm{FN}+\mathrm{FP}\), con el supuesto de que un FN cuesta 20 veces un FP.
df_tau = graficar_umbral(y_te, ys, "Fraude: precisión, recall y F1 según τ")df_tau["costo"] =20* df_tau["FN"] + df_tau["FP"]print(df_tau.round(3).to_string(index=False))print()fila_f1 = df_tau.loc[df_tau["F1"].idxmax()]fila_costo = df_tau.loc[df_tau["costo"].idxmin()]print(f"Máximo F1 en esta parrilla: τ = {fila_f1['τ']:.2f} (F1 = {fila_f1['F1']:.3f}, costo = {fila_f1['costo']:.0f})")print(f"Mínimo costo 20·FN + FP: τ = {fila_costo['τ']:.2f} (F1 = {fila_costo['F1']:.3f}, costo = {fila_costo['costo']:.0f})")print(f"Costo de no alertar nunca: {20*int(y_te.sum())}")
Cada fila es un clasificador distinto: el mismo \(s(x)\) con otro corte, y en la figura precisión y recall se cruzan entre \(\tau=0.10\) y \(\tau=0.15\). Desde \(\tau=0.10\) la exactitud queda entre 0.93 y 0.965 porque la dominan los VN; en \(\tau=0.10\) y \(\tau=0.15\) (0.930 y 0.950) ya está por debajo del dummy (0.954), y en \(\tau=0.05\) cae a 0.822, con 189 FP. El umbral de menor costo tiene menos exactitud que no alertar nunca.
Si un FN cuesta 20 veces un FP, dentro de esta parrilla el costo es mínimo en \(\tau=0.10\) (654), frente a 710 en \(\tau=0.20\), que es el umbral de mayor \(F_1\) (0.471), y 860 en \(\tau=0.5\); no alertar nunca cuesta 1100. El umbral de menor costo no coincide con el de mayor \(F_1\), porque el \(F_1\) no sabe cuánto vale cada error, y entre \(\tau=0.05\) y \(\tau=0.10\) la diferencia de costo es pequeña (669 y 654). Con otra razón entre FN y FP, el mínimo caería en otra fila: no existe un \(\tau\) correcto en general.
Los dos umbrales se eligieron mirando la prueba, así que sus métricas ya no son una medición independiente. En la práctica eliges el umbral en una tercera partición y reservas la prueba para confirmar, el procedimiento del capítulo 15. Reportar métricas implica reportar \(\tau\): “logística, \(\tau=0.5\)” y “logística, \(\tau=0.20\)” son clasificadores distintos.
Etapa 7: ROC y AUC miden el ordenamiento
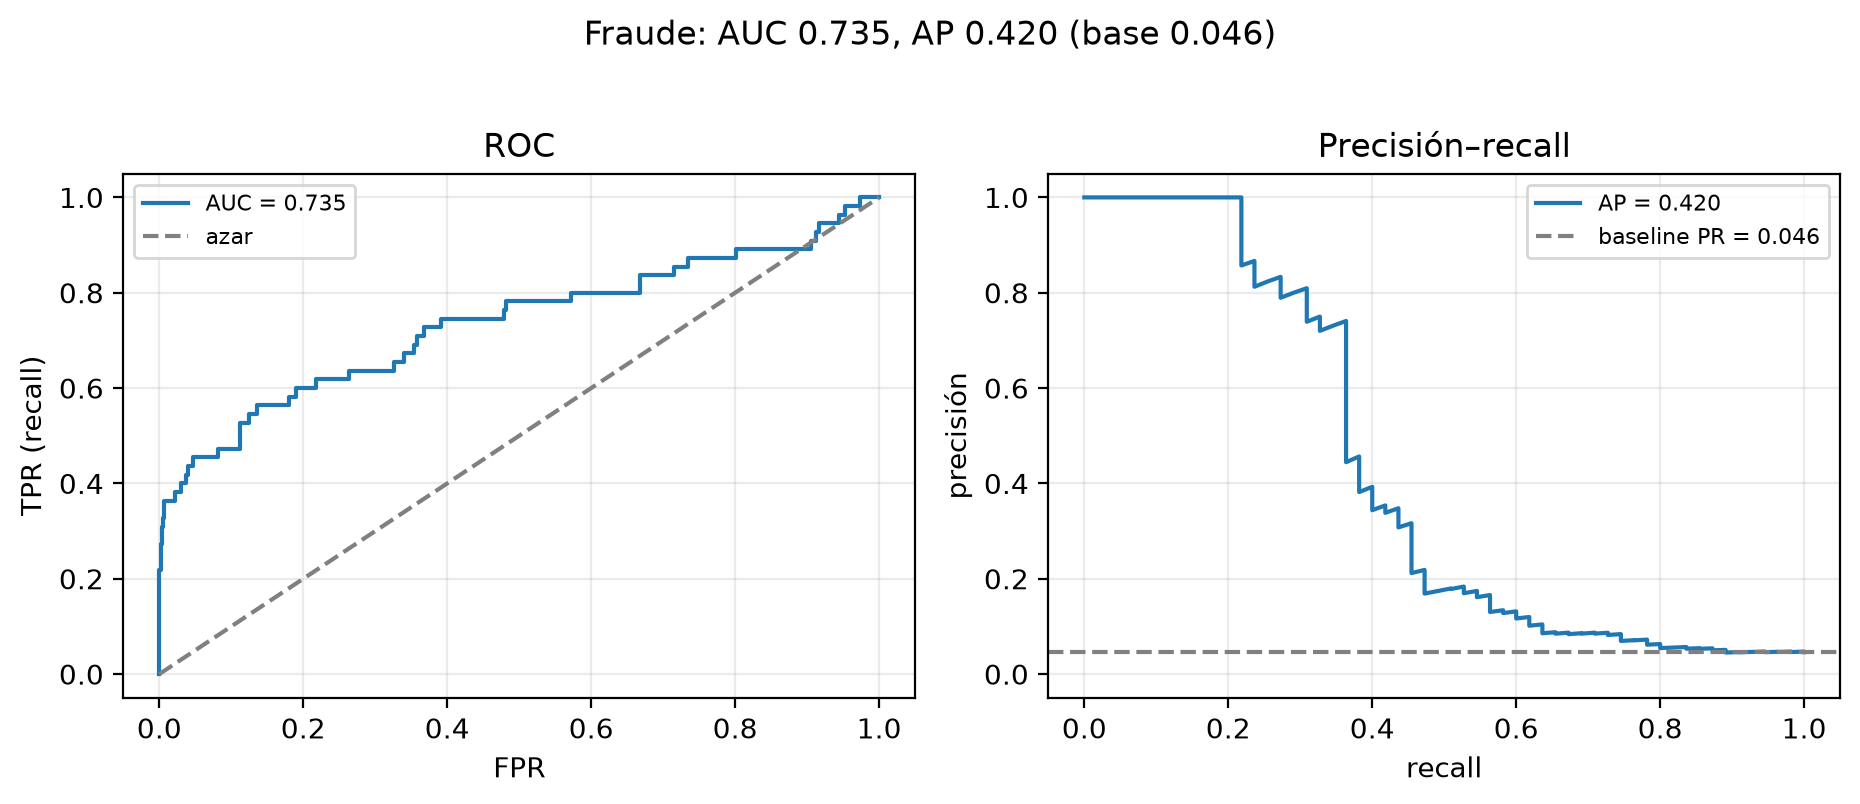
La ROC resume todos los umbrales, y el AUC dice con qué frecuencia un fraude recibe un \(s(x)\) mayor que una transacción legítima. Dibujas además la curva precisión–recall con su referencia en la prevalencia.
AUC-ROC = 0.735
AP (área bajo PR) = 0.42    baseline PR = prevalencia = 0.046
El AUC es 0.735: tomados al azar un fraude y una transacción legítima, el fraude recibe el score más alto cerca de 3 de cada 4 veces, un ordenamiento modesto. La curva PR de la figura muestra dónde se concentra: las alertas de mayor score son todas fraude (precisión 1.000 hasta recall 0.218, la fila \(\tau=0.5\) de la parrilla), y al ampliar la cobertura la precisión cae a 0.667 con recall 0.364 (\(\tau=0.20\)) y a 0.316 con recall 0.455 (\(\tau=0.10\)). El AP (0.420) se compara con la prevalencia (0.046), la precisión de alertar al azar, y no con \(0.5\): es unas 9 veces la base.
La ROC sola no deja ver el costo en alertas. En \(\tau=0.10\) el FPR es \(54/1145=0.047\), un punto pegado al eje vertical de la ROC, y esos 54 FP superan a los 25 VP. Un AUC alto no autoriza el bloqueo automático, porque no conoce \(\tau\) ni el costo. Cuando \(\pi\) es pequeña citas las dos curvas: la ROC describe el ordenamiento y no depende de \(\pi\), y la PR describe la calidad de las alertas con la \(\pi\) del conjunto evaluado (Davis y Goadrich, 2006; Saito y Rehmsmeier, 2015).
Etapa 8: Desbalance de clase y class_weight="balanced"
La logística sin pesos trata igual a todas las filas. Con unos 21 negativos por positivo en entrenamiento, casi todos sus scores son bajos y pocas filas pasan de 0.5; como estimación de probabilidad el ajuste es razonable, y lo inadecuado para detectar fraude es cortar en 0.5.
class_weight="balanced" da a cada fila un peso inversamente proporcional a la frecuencia de su clase, de modo que cada positivo pesa en el ajuste unas 21 veces lo que un negativo. Esperas que los scores suban y que, a \(\tau=0.5\), suba el recall y baje la precisión.
Para ver si un score se puede leer como probabilidad imprimes dos cosas: su media en la prueba, que debería parecerse a la prevalencia, y el puntaje de Brier (Brier, 1950), el promedio de \((s(x)-y)^2\). Es el MSE del capítulo 13 aplicado a probabilidades, y menor es mejor; como referencia, dar a todas las filas la prevalencia como score tiene un Brier de \(\pi(1-\pi)\approx 0.044\).
balanced a \(\tau=0.5\) es otro punto del mismo compromiso. El recall sube de 0.218 a 0.600 (33 de 55 fraudes), la precisión baja de 1.000 a 0.134 (214 FP) y la exactitud cae a 0.803, por debajo del dummy.
Con balanced el score deja de estimar \(P(y=1\mid x)\): promedia 0.358 cuando solo el 4.6% de las filas es fraude, y su Brier (0.152) es peor que el del modelo sin pesos (0.033), cuyo score medio (0.041) sí se parece a la prevalencia. El AUC casi no cambia (de 0.735 a 0.744), y el AP baja de 0.420 a 0.373, porque el AP pesa más las alertas de mayor score y esa parte de la lista queda algo peor ordenada con balanced.
El efecto se parece a bajar el umbral. Sin pesos y con \(\tau=0.05\) obtienes 31 VP y 189 FP; con balanced y \(\tau=0.5\), 33 VP y 214 FP. Con el costo de la etapa 6, balanced a \(\tau=0.5\) da 654, cerca de los 669 de la logística sin pesos a \(\tau=0.05\); que iguale el 654 de \(\tau=0.10\) es una coincidencia, porque ese es otro punto de operación (25 VP y 54 FP). Los pesos y el umbral son dos formas de mover el punto de operación con un AUC parecido. balanced conviene cuando el uso pide recall y no hace falta leer el score como probabilidad, y lo comparas en la métrica del uso, no en exactitud.
Etapa 9: Cambio de prevalencia
Es la tercera situación de la tabla del desbalance, con los datos del capítulo. Submuestreas los negativos de la prueba (con un generador propio, default_rng(0)) hasta dejar una prevalencia del 15%, conservas los 55 positivos y no tocas modelos ni umbrales.
Comparas tres puntos de operación: la logística a \(\tau=0.5\) (que no tiene FP), la logística a \(\tau=0.20\) y el modelo balanced a \(\tau=0.5\). La columna “precisión (fórmula)” es la que predice la fórmula de la precisión según la prevalencia, con el recall y el FPR medidos en la prueba completa y la \(\pi\) de cada conjunto; en las filas de la prueba completa coincide con la observada por construcción.
El recall es idéntico dentro de cada par de filas (0.218, 0.364 y 0.600), porque se conservaron los 55 positivos y el umbral no cambió. La precisión de la logística a \(\tau=0.5\) se queda en 1.000 porque no tiene FP, y en los otros dos puntos sube sin que cambien el modelo ni el umbral, al pasar \(\pi\) de 0.046 a 0.15: de 0.667 a 0.952 con \(\tau=0.20\) y de 0.134 a 0.367 con balanced.
La fórmula predice 0.880 y 0.362. Con balanced, que tiene 214 FP en la prueba completa, la coincidencia es estrecha. Con \(\tau=0.20\) solo hay 10 FP: se conservaron 311 de los 1145 negativos, se esperaba retener cerca de 3 de esos FP y quedó 1, y por eso la precisión observada supera a la predicha; con tan pocos FP, la cifra depende de qué negativos entraron en la submuestra.
El AUC casi no cambia (de 0.735 a 0.737 y de 0.744 a 0.748), porque TPR y FPR no dependen de \(\pi\). En la práctica, una precisión medida en un conjunto enriquecido con positivos no se observará en uso si allí la prevalencia es menor, y por eso toda precisión se publica con su prevalencia.
Etapa 10: Caso real, Breast cancer (Wisconsin)
Son \(n=569\) muestras de masas mamarias ya detectadas, cada una con \(D=30\) atributos de los núcleos celulares medidos sobre una imagen de la muestra (Street, Wolberg y Mangasarian, 1993). En load_breast_cancer la etiqueta 0 es malignant y la 1 es benign, así que inviertes\(y\) para que \(y=1\) sea maligno.
La prevalencia es cercana al 37%, lejos del 4.6% del fraude. Es un conjunto de diagnóstico: el 37% es la proporción de malignos entre masas que ya se estaban estudiando, no la de una población que se revisa sin síntomas.
Usas una partición estratificada con 30% de prueba, la logística estandarizada y \(\tau=0.5\), y repites el procedimiento: matriz, métricas con sus intervalos, ROC y PR, y parrilla de umbrales.
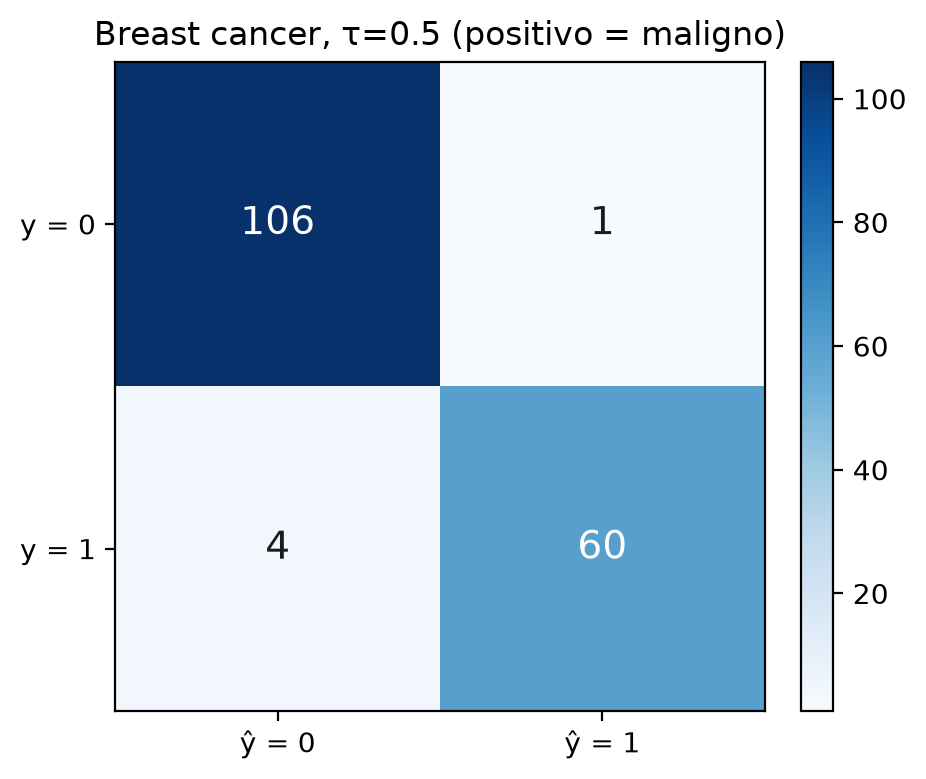
Con prevalencia 0.374, el dummy mayoritario tiene exactitud 0.626 y la logística 0.971, así que aquí la exactitud sí informa, como complemento de la matriz (60 VP, 4 FN, 1 FP y 106 VN). Ese 37% no es la prevalencia de una población: con el mismo recall (0.938) y el mismo FPR (1/107), la fórmula da una precisión de 0.503 con \(\pi=0.01\) y de 0.335 con \(\pi=0.005\), lejos del 0.984 medido. Es el cambio de prevalencia de la etapa 9, y además ese FPR se apoya en un solo FP.
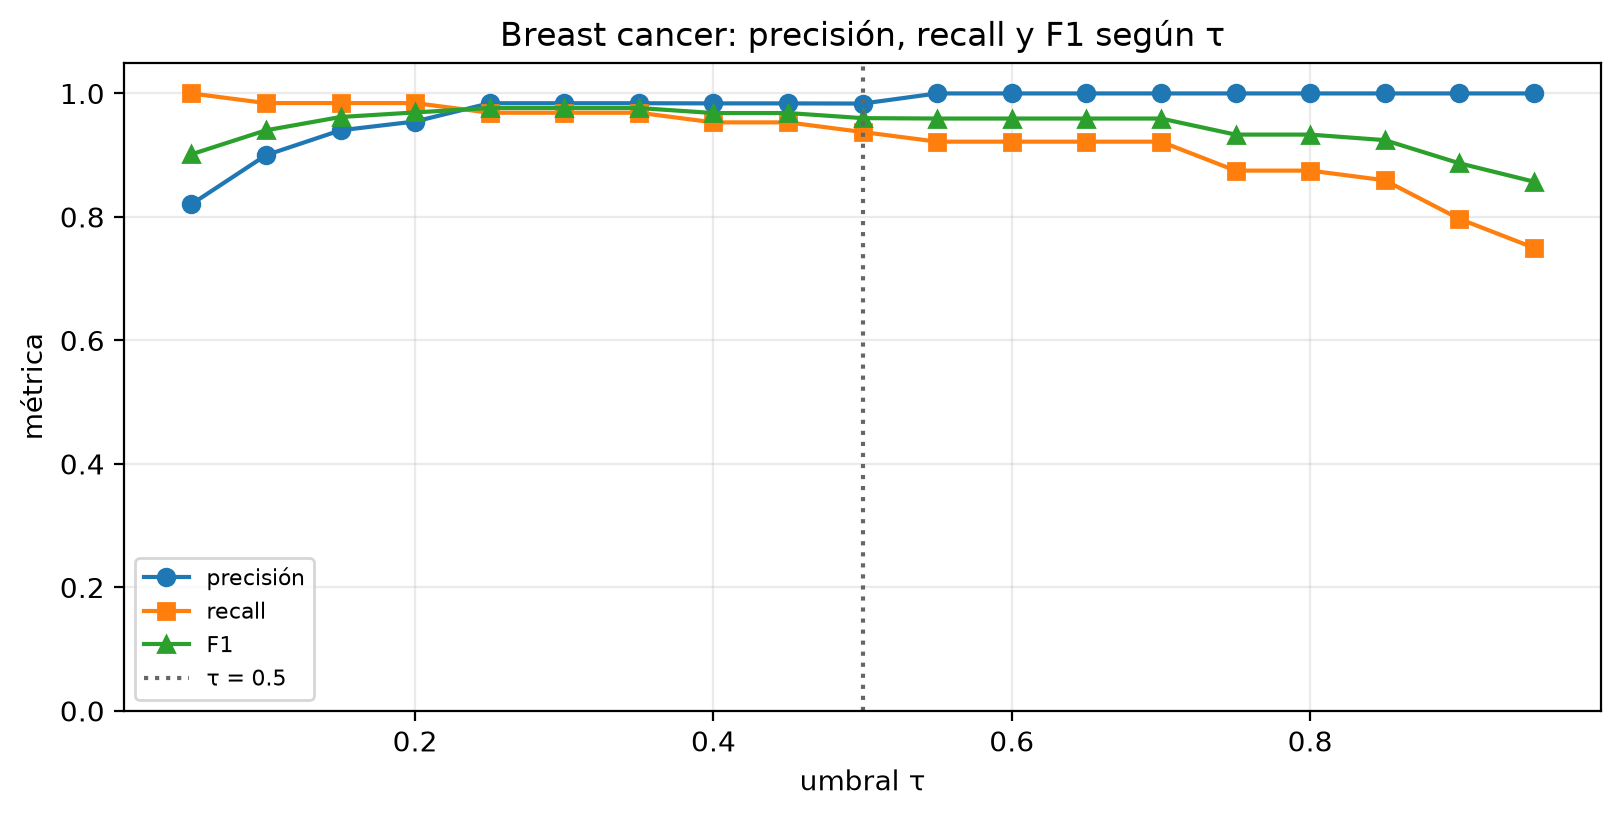
Un FN es un maligno no alertado, y en diagnóstico se suele bajar \(\tau\) para subir el recall a costa de FP (biopsias de más). La parrilla lo cuantifica: con \(\tau\) entre 0.25 y 0.35 hay 2 FN y 1 FP; con \(\tau\) entre 0.10 y 0.20, 1 FN y 7, 4 o 3 FP; con \(\tau=0.05\), 0 FN y 14 FP. Si aceptas como mucho 2 FN en esta prueba, lo cumple cualquier \(\tau\le 0.35\) de la parrilla, y el tramo con menos FP es el de 0.25 a 0.35.
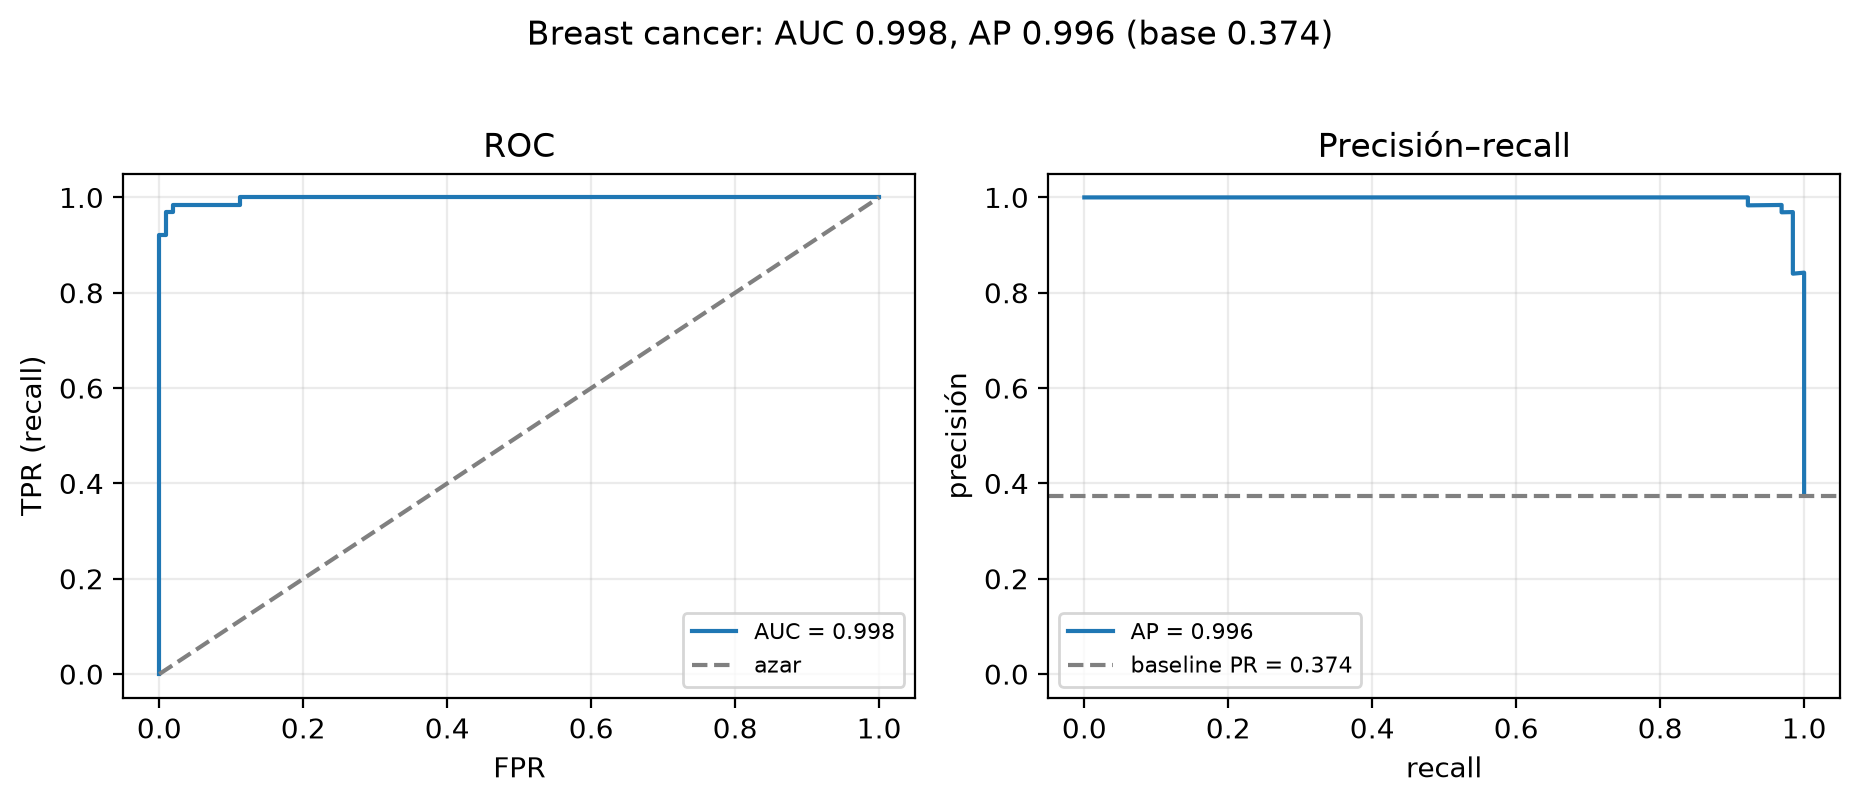
En la figura, ROC y PR se parecen porque \(\pi\) no es extrema: AUC 0.998 y AP 0.996, contra una base de 0.374. Aun así publicas las dos, y un AUC tan alto no autoriza a omitir la matriz, porque no dice cuántos malignos quedan sin alertar en el \(\tau\) elegido.
La muestra es pequeña: 171 filas de prueba y 64 malignos. Un recall de 0.938 son 60 de 64, y un FN más lo deja en 0.922 (fila \(\tau=0.55\)); el intervalo de Wilson al 95% es \([0.850,\ 0.975]\) para el recall y \([0.913,\ 0.997]\) para la precisión. Con estos conteos, el tercer decimal de las métricas no tiene respaldo. La figura de umbrales usa el mismo eje vertical (de 0 a 1.05) que la del fraude, y en ella las tres curvas se mantienen por encima de 0.8 en casi toda la parrilla.
Ejercicio
Con la parrilla de Breast cancer, calcula el costo \(20\cdot\mathrm{FN}+\mathrm{FP}\) de cada umbral y encuentra el de menor costo. ¿Coincide con el de mayor \(F_1\)? ¿Usarías ese \(\tau\) en el informe final?
TipOrientaciones
El costo es 14 en \(\tau=0.05\) (0 FN y 14 FP), 27 en \(\tau=0.10\), 24 en \(\tau=0.15\), 23 en \(\tau=0.20\), 41 entre \(\tau=0.25\) y \(0.35\), y 81 en \(\tau=0.5\); el mínimo está en \(\tau=0.05\). El mayor \(F_1\) (0.976) está en el tramo de 0.25 a 0.35, con costo 41, así que no coinciden. No lo usarías en el informe final, porque lo elegiste mirando la prueba: con 64 malignos, la diferencia entre 0 y 2 FN depende de unos pocos casos, y el umbral tiene que elegirse en una partición distinta y confirmarse en la prueba.
Etapa 11: Reportar un clasificador
El reporte organiza en seis pasos lo que pide el protocolo:
Uso y clase positiva: qué se alerta y qué cuesta un FN frente a un FP.
Prevalencia en el conjunto citado.
Protocolo: entrenamiento y prueba, \(\tau\), y si el umbral se eligió fuera de la prueba.
Matriz y sus cuatro frases (VP, FN, FP y VN).
Métricas: exactitud junto a la de la clase mayoritaria; precisión, recall y \(F_1\) con su intervalo; AUC y AP.
Decisión: aceptar para un uso, rechazar para otro, y las limitaciones.
Los aplicas primero al fraude de las etapas 1 a 9.
Uso. Alerta de transacción anómala. FN = fraude no visto; FP = revisión o bloqueo injusto. Dos usos posibles: bloqueo automático y cola de revisión.
Prevalencia.\(\pi=0.046\) en prueba (55 de 1200).
Protocolo. Logística estandarizada, prueba del 30% estratificada, \(\tau=0.5\) por defecto, sin elegir.
Matriz. 12 fraudes alertados, 43 que pasaron, 0 falsas alertas y 1145 legítimas sin alerta.
Métricas. Exactitud 0.964 frente a 0.954 del dummy (12 aciertos más en 1200). Precisión 1.0 (12 de 12, IC 95% \([0.758,\ 1.000]\)), recall 0.218 (IC 95% \([0.129,\ 0.344]\)), \(F_1=0.358\), AUC 0.735 y AP 0.420, que se compara con \(\pi=0.046\).
Decisión. A \(\tau=0.5\) el modelo sirve para priorizar un grupo pequeño de casos y no como único control: en esta prueba las 12 alertas eran fraude, pero con 12 casos la precisión real podría ser tan baja como 0.758, y 43 de los 55 fraudes no generan alerta. El dummy se rechaza pese a su exactitud.
En una prueba con prevalencia 4.6%, la logística a \(\tau=0.5\) supera al dummy en recall y \(F_1\); la exactitud se cita solo junto a la de la clase mayoritaria. El AUC (0.735) describe un ordenamiento modesto y la curva PR, cuánto cae la precisión al bajar \(\tau\). A \(\tau=0.5\) no hubo falsas alertas y quedaron 43 fraudes sin detectar. Se recomienda revisar las pocas alertas y no usar el modelo como único control. Si un FN cuesta 20 veces un FP, conviene un umbral bajo, entre 0.05 y 0.10, que debe elegirse en una partición distinta de la prueba. Limitaciones: datos simulados, una sola partición y costos supuestos, no medidos en dinero.
Breast cancer (etapa 10) se llena igual y la conclusión es otra. Uso: apoyo al diagnóstico de una masa ya detectada, donde el FN es el error caro. Prevalencia 0.374 en un conjunto de diagnóstico. Matriz a \(\tau=0.5\): 60 VP, 4 FN, 1 FP y 106 VN. Exactitud 0.971 frente a 0.626 del dummy; precisión 0.984, recall 0.938 (IC 95% \([0.850,\ 0.975]\)), AUC 0.998 y AP 0.996. Aquí \(x\) aporta información con claridad y la discusión pasa a ser qué umbral se acepta: bajar \(\tau\) al tramo 0.25–0.35 deja 2 FN con 1 FP en esta prueba. Limitaciones: 64 malignos en la prueba, una sola partición y una precisión que no se traslada a una población con prevalencia menor.
Errores que conviene nombrar
Citar solo la exactitud con clase rara o costos asimétricos: el dummy de la etapa 2 tenía 0.954.
Olvidar la prevalencia al publicar una precisión.
Tratar \(\tau=0.5\) como parte del modelo y no como una decisión.
Elegir \(\tau\) en la prueba y publicar esas métricas como si fueran independientes.
Tomar un AUC alto como permiso para desplegar. El AUC no describe las alertas en el \(\tau\) de operación.
Usar \(F_1\) como función de costo. No sabe cuánto vale un FN frente a un FP.
Invertir el positivo (benigno como \(1\)) y reportar un recall clínico al revés.
Comparar precisiones entre conjuntos con \(\pi\) distinta como si midieran la calidad del modelo.
Leer como probabilidad el score de un modelo ajustado con class_weight="balanced".
Dar tres decimales sin intervalo a una métrica calculada con decenas de positivos.
14.6 Guía rápida: ¿qué métrica usar?
Situación
Qué usar
Por qué
Clases y costos simétricos
Exactitud y matriz
La clase mayoritaria no domina el resultado
¿La alerta es confiable?
Precisión
\(P(y=1\mid \hat y=1)\)
¿Se escapan los positivos?
Recall
\(P(\hat y=1\mid y=1)\)
Ordenar modelos, sin costos
\(F_1\)
Es baja si precisión o recall son cercanos a 0
¿El score ordena bien las filas?
AUC-ROC
No depende de \(\tau\) ni de \(\pi\)
Clase rara, calidad de las alertas
Curva PR y AP
El eje vertical es la precisión
Elegir el corte
Barrido de \(\tau\) con un costo explícito
\(\tau=0.5\) es solo una convención
¿\(x\) aporta algo?
Dummy mayoritario
Piso de exactitud y de AP
Pocos positivos
Intervalo de Wilson
Cuantifica la incertidumbre de precisión y recall
¿El score es una probabilidad?
Score medio frente a \(\pi\) y puntaje de Brier
balanced mueve el score y deja de calibrarlo
Al reportar, incluye la clase positiva, \(\pi\), \(\tau\), la matriz, la precisión, el recall y el uso para el que se acepta.
14.7 Preguntas de comprensión
Un informe solo trae “accuracy 95.4%”. ¿Qué preguntas antes de aceptar el resultado?
En la etapa 4, las 12 alertas de la logística eran fraude. ¿Puedes afirmar que el modelo no produce falsas alertas?
Si cada FN cuesta 20 veces un FP, ¿miras primero el recall o la precisión, y por qué el umbral de menor costo no coincidió con el de mayor \(F_1\)?
El AUC no cambió al pasar la prevalencia de 0.046 a 0.15, y la precisión con \(\tau=0.20\) sí. ¿Por qué?
Un equipo reporta una precisión de 0.984 para detectar tumores malignos y propone usar el modelo en un programa de cribado con prevalencia del 1%. ¿Qué precisión esperarías?
TipOrientaciones
La prevalencia, el umbral, la matriz de confusión y el uso. Con \(\pi=0.046\), el dummy que nunca alerta ya tiene 95.4%, así que esa cifra sola no distingue entre un detector útil y uno que no detecta nada.
No. Con 12 alertas, el intervalo de Wilson al 95% para la precisión es \([0.758,\ 1.000]\): los datos son compatibles con que cerca de una de cada cuatro alertas sea falsa en uso.
El recall, porque el FN es el error caro. El \(F_1\) pesa igual precisión y recall y no conoce el costo: el mayor \(F_1\) (0.471) estuvo en \(\tau=0.20\), con costo 710, y el menor costo (654) en \(\tau=0.10\), donde la precisión baja a 0.316 pero se detectan 25 fraudes en lugar de 20.
TPR y FPR se calculan dentro de cada clase, así que no dependen de cuántas filas hay de cada una, y el AUC tampoco. La precisión mezcla las dos clases, \(\pi\,\mathrm{recall}/[\pi\,\mathrm{recall}+(1-\pi)\,\mathrm{FPR}]\), y sube cuando hay menos negativos que puedan generar falsas alertas: de 0.667 a 0.952 en la submuestra.
Mucho menor. Con el recall (0.938) y el FPR (1/107) de Breast cancer, la fórmula da 0.503 con \(\pi=0.01\): la mitad de las alertas serían falsas. Además, el FPR se apoya en un solo FP y el conjunto es de diagnóstico, no de cribado, así que la cifra real podría ser otra; haría falta evaluar en la población de destino.
14.8 Referencias para profundizar
Fawcett, T. (2006). An introduction to ROC analysis. Pattern Recognition Letters, 27(8), 861–874.
Davis, J. y Goadrich, M. (2006). The relationship between Precision-Recall and ROC curves. Proceedings of the 23rd International Conference on Machine Learning (ICML), 233–240.
Saito, T. y Rehmsmeier, M. (2015). The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets. PLoS ONE, 10(3), e0118432.
Elkan, C. (2001). The foundations of cost-sensitive learning. Proceedings of the 17th International Joint Conference on Artificial Intelligence (IJCAI), 973–978. Cómo elegir el umbral a partir de los costos.
Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212. El intervalo de las etapas 4 y 10.
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1–3. El puntaje de la etapa 8.
Street, W. N., Wolberg, W. H. y Mangasarian, O. L. (1993). Nuclear feature extraction for breast tumor diagnosis. Biomedical Image Processing and Biomedical Visualization, Proceedings of SPIE, vol. 1905, 861–870. El origen del conjunto Breast cancer Wisconsin (Diagnostic).
Un clasificador se evalúa con su matriz, su prevalencia, su umbral y el uso para el que se acepta; la exactitud sola no da un veredicto.
Con \(\pi=0.046\), el clasificador que nunca alerta tiene exactitud 0.954 y recall 0.
La logística a \(\tau=0.5\) detectó 12 de 55 fraudes sin falsas alertas (recall 0.218, precisión 1.0), y el intervalo de Wilson (\([0.758,\ 1.000]\)) mostró cuánto respaldan 12 alertas.
El mismo modelo sirve para un bloqueo automático y no para una cola de revisión: el veredicto depende del uso.
Mover \(\tau\) cambia el punto de operación: con un FN 20 veces más caro que un FP, el costo mínimo estuvo en \(\tau=0.10\) (654), lejos del mayor \(F_1\) en \(\tau=0.20\).
El AUC (0.735) mide el ordenamiento y no depende de \(\pi\); con clase rara se acompaña con la curva PR (AP de 0.420 frente a una base de 0.046).
class_weight="balanced" movió el recall a 0.600 y descalibró el score (Brier de 0.152 frente a 0.033).
La precisión depende de la prevalencia: subió de 0.667 a 0.952 al pasar \(\pi\) de 0.046 a 0.15, y la de Breast cancer (0.984) bajaría a 0.503 con \(\pi=0.01\).
14.10 Puente hacia los siguientes capítulos
Estas métricas cumplen para la clasificación el papel que el MSE cumplió en la regresión: miden el error, pero no son lo que el ajuste minimiza. El capítulo 15 trata la validación (particiones, pliegues y cómo elegir \(\tau\) sin tocar la prueba), el procedimiento que vuelve confiables estas cifras: un \(F_1\) calculado en entrenamiento vale tan poco como un RMSE calculado en entrenamiento.