Un modelo de machine learning no recibe resúmenes sueltos como la media de una columna: recibe la fila completa. Esa fila es un vector con una coordenada por variable, y el dataset entero es una matriz.
En este capítulo pasas de la tabla a ese lenguaje: el dataset como matriz, la vectorización, el producto punto, la norma, la distancia euclidiana, la similitud coseno y su interpretación geométrica.
Los datos son seis perfiles ficticios de hábitos de estudio, escritos a mano para que la geometría se lea a ojo: dos perfiles con la misma dirección y distinta magnitud, dos con magnitudes iguales y direcciones distintas, y una consulta cuyo vecino más cercano cambia según la medida que uses. No hay ningún paso aleatorio en el capítulo.
Tiempo estimado de lectura: 45 minutos (unas 2 horas si ejecutas el código y resuelves los ejercicios)
Nivel: Básico
Conocimientos previos recomendados: los capítulos 3 (desviación estándar), 4 (z-score y estandarización) y 5 (covarianza y correlación).
Tecnologías mencionadas: Python 3.13, pandas 2.3, NumPy 2.3 y Matplotlib.
Objetivos
Al terminar este capítulo vas a ser capaz de:
escribir un dataset como una matriz\(X\) con \(N\) filas y \(D\) columnas, separada del vector objetivo \(y\);
leer cada fila como un vector en \(\mathbb{R}^D\);
calcular e interpretar el producto punto, la norma (\(L_2\) y \(L_1\)) y el ángulo entre dos vectores;
distinguir la distancia euclidiana, que mide separación, de la similitud coseno, que mide orientación;
comprobar la desigualdad de Cauchy–Schwarz, construir el vector unitario y calcular la proyección ortogonal de un perfil sobre otro;
explicar por qué la escala de las variables cambia quién es cercano, y relacionar esta geometría con k vecinos más cercanos, los embeddings y el PCA.
Ejecuta las celdas en orden: las funciones de gráficos y la matriz de la etapa 1 se usan hasta el final.
6.1 De la tabla al espacio
Una tabla tiene filas (observaciones) y columnas (variables). En álgebra, esa misma tabla es una matriz \(X \in \mathbb{R}^{N \times D}\), con \(N\) observaciones y \(D\) variables de entrada (features). La fila \(i\) es el vector \(\mathbf{x}_i = (x_{i1},\ldots,x_{iD})\). Vectorizar no agrega información: cambia la forma de leerla, de celdas sueltas a un punto en el espacio.
Suma los productos coordenada a coordenada. Geométricamente combina magnitudes y alineación: con normas fijas, cuanto menor es el ángulo \(\theta\), mayor es el producto punto.
Es la longitud del vector: qué tan intenso es el perfil, sin importar hacia dónde apunta. Quien dedica el doble de horas en las mismas proporciones tiene la misma dirección y el doble de norma.
Mide la separación entre dos puntos. Es la medida por defecto de muchos métodos basados en vecindarios, como k vecinos más cercanos y k-means. Crece si cambia la magnitud o la dirección, y la domina la variable de mayor rango.
Vale entre \(-1\) y \(1\) e ignora el tamaño de los vectores: dos perfiles proporcionales tienen \(\cos\theta = 1\) aunque uno sea más intenso. Es la medida habitual para comparar textos y embeddings.
La igualdad se cumple si y solo si los vectores son linealmente dependientes, es decir, si uno es múltiplo del otro. Por esta desigualdad el coseno nunca sale del intervalo \([-1,1]\).
Tiene norma \(1\) y conserva la dirección. Dividir por la norma quita la intensidad y deja solo la orientación; es el paso algebraico que hay detrás de la similitud coseno.
Es la sombra de \(\mathbf{a}\) sobre la recta de \(\mathbf{b}\): la parte de \(\mathbf{a}\) que se explica por esa dirección. El residual \(\mathbf{a}-\mathrm{proj}_{\mathbf{b}}(\mathbf{a})\) es ortogonal a \(\mathbf{b}\). Esta descomposición sostiene la regresión lineal y el PCA.
Pregunta
Herramienta
¿Cómo guardo el dataset para un modelo?
Matriz \(X\) y vector \(y\)
¿Qué tan largo es un perfil?
Norma
¿Cuánto se alinean dos perfiles?
Producto punto o coseno
¿Qué tan lejos están dos observaciones?
Distancia euclidiana
¿Se parecen en proporción, aunque no en intensidad?
Similitud coseno
6.2 Por qué importa en IA y machine learning
Para un modelo, cada columna es solo una coordenada:
En regresión y en las redes neuronales, \(X\) es la entrada y cada capa lineal calcula productos punto \(\mathbf{w}\cdot\mathbf{x} + b\) entre unos pesos y cada fila.
En k vecinos más cercanos y clustering, «parecido» significa «cerca» según una distancia. Si no escalas, una variable medida en minutos aplasta a otra medida en horas (etapa 10).
En búsqueda de textos, recomendaciones y embeddings, dos documentos pueden tener longitudes distintas y el mismo tema; ahí suele importar más el ángulo que la distancia, y por eso los buscadores semánticos comparan embeddings con el coseno.
En PCA se buscan direcciones nuevas que capturen la mayor varianza en este mismo espacio.
Distancia y ángulo pueden ordenar distinto a las mismas observaciones. Dos perfiles pueden coincidir en dirección y estar lejos en magnitud, y el algoritmo decide según la medida que le des (etapa 11).
6.3 Flujo recomendado de trabajo
Escribe el dataset como \(X\): separa las variables de entrada del objetivo y anota \(N\) y \(D\).
Lee cada fila como un vector: qué significa cada coordenada y en qué unidad está.
Decide si importa la magnitud o la dirección: intensidad del perfil (norma, distancia euclidiana) o proporción entre sus partes (coseno).
Calcula las dos familias de medidas: primero producto punto y normas; con ellas obtienes la distancia y el coseno.
Revisa la escala: si las variables no comparten unidad ni rango, estandariza antes de medir distancias.
Mira el gráfico: un coeficiente sin flechas ni nube de puntos es fácil de malinterpretar.
Redacta el reporte con las variables, la medida y el escalamiento:
«En el espacio [variables], [caso A] y [caso B] tienen distancia ___ y coseno ___. Se reporta [medida] porque [pregunta]. Implicación para el modelo: [decisión].»
Por ejemplo, con los datos de este capítulo: «En el espacio (horas de lectura, horas de práctica), Ana y Bruno tienen distancia 5.66 y coseno 1.00. Se reporta el coseno porque la pregunta es quién estudia con la misma proporción de lectura y práctica, no quién dedica las mismas horas. Implicación para el modelo: un recomendador de rutinas debería usar el coseno; un modelo de k vecinos que prediga la puntuación debería usar la distancia, porque la cantidad de horas sí cambia el resultado».
6.4 Preparar el entorno
La celda carga NumPy, pandas y Matplotlib y fija un estilo de gráficos común. Los datos se escriben a mano en la etapa 1, así que el capítulo no usa números aleatorios.
%matplotlib inline%config InlineBackend.figure_format ="retina"import sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as pltSEMILLA =42# semilla central; este capítulo no genera datos aleatoriosrng = np.random.default_rng(SEMILLA)plt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25print("pandas:", pd.__version__, "| numpy:", np.__version__)
Python: 3.13.14
pandas: 3.0.5 | numpy: 2.5.1
El entorno queda con Python 3.13.9, pandas 2.3.3 y NumPy 2.3.5.
La siguiente celda define cuatro funciones de gráficos: flechas desde el origen, nube de puntos con una consulta, barras que comparan dos medidas y proyección de un vector sobre otro. Cada etapa las llama en una o dos líneas.
def graficar_vectores_2d(nombres, X2, titulo, query=None, query_nombre="Consulta"):"""Flechas desde el origen: cada fila es un perfil en (lectura, práctica).""" fig, ax = plt.subplots(figsize=(7.5, 7.5)) colores = plt.cm.tab10(np.linspace(0, 0.7, len(nombres))) desplazamiento = {"Ana": (0.25, -0.45), "Elena": (-0.65, 0.25)} # evita que choquen las etiquetas# Se dibuja de la flecha más larga a la más corta: así Bruno no tapa a Ana (misma recta)for rango, i inenumerate(np.argsort(-np.linalg.norm(X2, axis=1))): nombre, color = nombres[i], colores[i] x, y = X2[i] ax.arrow(0, 0, x, y, head_width=0.18, head_length=0.18, length_includes_head=True, color=color, linewidth=2, zorder=2+ rango) dx, dy = desplazamiento.get(nombre, (0.15, 0.15)) ax.text(x + dx, y + dy, nombre, fontsize=10, color=color)if query isnotNone: ax.arrow(0, 0, query[0], query[1], head_width=0.18, head_length=0.18, length_includes_head=True, color="black", linewidth=2, linestyle="--") ax.text(query[0] +0.15, query[1] -0.35, query_nombre, fontsize=10) ax.axhline(0, color="0.6", linewidth=0.8) ax.axvline(0, color="0.6", linewidth=0.8) ax.set_aspect("equal", adjustable="box") ax.set_xlabel("Horas de lectura / semana") ax.set_ylabel("Horas de práctica / semana") ax.set_title(titulo) plt.tight_layout() plt.show()def graficar_puntos_y_consulta(nombres, X2, query, vecinos, titulo):"""Nube 2D: consulta + segmentos hacia los vecinos elegidos por una métrica.""" fig, ax = plt.subplots(figsize=(7.2, 6.2)) ax.scatter(X2[:, 0], X2[:, 1], s=70)for i, nombre inenumerate(nombres): ax.annotate(nombre, (X2[i, 0], X2[i, 1]), textcoords="offset points", xytext=(-40, -4) if nombre =="Elena"else (6, 6), fontsize=9) ax.scatter(query[0], query[1], s=110, marker="*", zorder=3, label="Consulta") ax.annotate("Consulta", (query[0], query[1]), textcoords="offset points", xytext=(6, -12), fontsize=9)for idx, estilo, etiqueta in vecinos: ax.plot([query[0], X2[idx, 0]], [query[1], X2[idx, 1]], linestyle=estilo, linewidth=1.8, label=etiqueta) ax.set_xlabel("Horas de lectura / semana") ax.set_ylabel("Horas de práctica / semana") ax.set_title(titulo) ax.legend(fontsize=9) plt.tight_layout() plt.show()def graficar_barras_metricas(nombres, euclidiana, coseno, titulo):"""Comparar distancia (menor = más cerca) y coseno (mayor = más parecido).""" fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), constrained_layout=True) euclidiana, coseno = np.asarray(euclidiana), np.asarray(coseno) gana_d = np.isclose(euclidiana, euclidiana.min()) gana_c = np.isclose(coseno, coseno.max()) barras_d = axes[0].bar(nombres, euclidiana, color=np.where(gana_d, "C1", "C0")) axes[0].bar_label(barras_d, fmt="%.2f", fontsize=8) axes[0].set_ylabel("Distancia euclidiana") axes[0].set_title("Separación respecto a la consulta") axes[0].tick_params(axis="x", rotation=20) barras_c = axes[1].bar(nombres, coseno, color=np.where(gana_c, "C1", "C0")) axes[1].bar_label(barras_c, fmt="%.4f", fontsize=8) axes[1].set_ylim(0, 1.12) axes[1].set_ylabel("Similitud coseno") axes[1].set_title("Alineación respecto a la consulta") axes[1].tick_params(axis="x", rotation=20) fig.suptitle(titulo +" (naranja: el más cercano según cada medida)") plt.show()def graficar_proyeccion(a, b, nombre_a, nombre_b, titulo):"""Vector a, dirección b, proyección de a sobre b y residual.""" a = np.asarray(a, dtype=float) b = np.asarray(b, dtype=float) proj = (np.dot(a, b) / np.dot(b, b)) * b residual = a - proj fig, ax = plt.subplots(figsize=(7.2, 7.2))# La proyección va sobre la misma recta que b: se dibuja primero, ancha y translúcida ax.plot([0, proj[0]], [0, proj[1]], color="C1", linewidth=8, alpha=0.35, solid_capstyle="round", label=f"proj de {nombre_a} sobre {nombre_b}") ax.scatter(proj[0], proj[1], s=60, color="C1", zorder=4) ax.arrow(0, 0, b[0], b[1], head_width=0.18, head_length=0.18, length_includes_head=True, linewidth=2, color="C0", label=nombre_b, zorder=3) ax.arrow(0, 0, a[0], a[1], head_width=0.18, head_length=0.18, length_includes_head=True, linewidth=2, color="C2", label=nombre_a, zorder=3) ax.plot([a[0], proj[0]], [a[1], proj[1]], linestyle=":", linewidth=2, color="C3", label="residual") ax.axhline(0, color="0.6", linewidth=0.8) ax.axvline(0, color="0.6", linewidth=0.8) ax.set_aspect("equal", adjustable="box") ax.set_xlabel("Horas de lectura / semana") ax.set_ylabel("Horas de práctica / semana") ax.set_title(titulo) ax.legend(fontsize=8, loc="upper left") plt.tight_layout() plt.show()return proj, residual
6.5 Desarrollo por etapas
Avanzas en este orden: escribes la tabla como matriz, dibujas cada fila como un vector, calculas producto punto, norma, unitario, distancia y coseno a mano y con NumPy, descompones un perfil en proyección y residual, compruebas el efecto de la escala y terminas eligiendo el vecino de una consulta con dos medidas distintas.
Etapa 1: Dataset como matriz
Construyes seis perfiles ficticios. Las variables de entrada son horas_lectura y horas_practica por semana. La puntuación del examen queda fuera de \(X\): es el objetivo \(y\), no una coordenada más del espacio de entrada.
Los valores no se sortean; se eligen para que cada par muestre algo:
Ana\((4, 4)\) y Bruno\((8, 8)\) tienen la misma dirección; Bruno dedica el doble de horas.
Camila\((8, 2)\) lee mucho y practica poco; Diego\((2, 8)\) hace lo contrario.
Elena\((3.6, 3.8)\) está muy cerca de Ana en el plano.
Fabián\((1, 1.2)\) tiene un perfil de pocas horas, con una proporción parecida a la de Ana.
Como sabes de antemano qué debería salir en distancia y en coseno, puedes comprobarlo con NumPy.
nombres = ["Ana", "Bruno", "Camila", "Diego", "Elena", "Fabián"]X = np.array( [ [4.0, 4.0], # Ana: perfil equilibrado [8.0, 8.0], # Bruno: misma dirección, doble magnitud [8.0, 2.0], # Camila: lectora [2.0, 8.0], # Diego: práctica [3.6, 3.8], # Elena: cercana a Ana [1.0, 1.2], # Fabián: intensidad baja ])y = np.array([78.0, 91.0, 74.0, 80.0, 76.0, 58.0])df = pd.DataFrame(X, columns=["horas_lectura", "horas_practica"], index=nombres)df["puntuacion_examen"] = yprint("Tabla (lo que ve el analista):")display(df)print()print("Matriz X (lo que ve el modelo):")print(X)print("Forma de X:", X.shape, "→ n observaciones × p features")print("Vector y:", y)print("Forma de y:", y.shape)
Tabla (lo que ve el analista):
horas_lectura
horas_practica
puntuacion_examen
Ana
4.0
4.0
78.0
Bruno
8.0
8.0
91.0
Camila
8.0
2.0
74.0
Diego
2.0
8.0
80.0
Elena
3.6
3.8
76.0
Fabián
1.0
1.2
58.0
Matriz X (lo que ve el modelo):
[[4.  4. ]
 [8.  8. ]
 [8.  2. ]
 [2.  8. ]
 [3.6 3.8]
 [1.  1.2]]
Forma de X: (6, 2) → n observaciones × p features
Vector y: [78. 91. 74. 80. 76. 58.]
Forma de y: (6,)
df es la vista del analista: nombres, unidades y el objetivo. X es la vista del algoritmo: solo números, con forma \((6, 2)\), es decir, \(N = 6\) filas y \(D = 2\) columnas; y tiene forma \((6,)\). Vectorizar, en la práctica, es elegir qué columnas entran a \(X\) y en qué orden. Cambiar el orden de las columnas no cambia las distancias si lo aplicas a todas las filas; meter el objetivo dentro de \(X\) sí cambia la geometría, y suele ser un error. Entrenar un modelo es casi siempre modelo.fit(X, y): esta etapa nombra esos dos objetos.
Etapa 2: Vectorización, la fila como punto
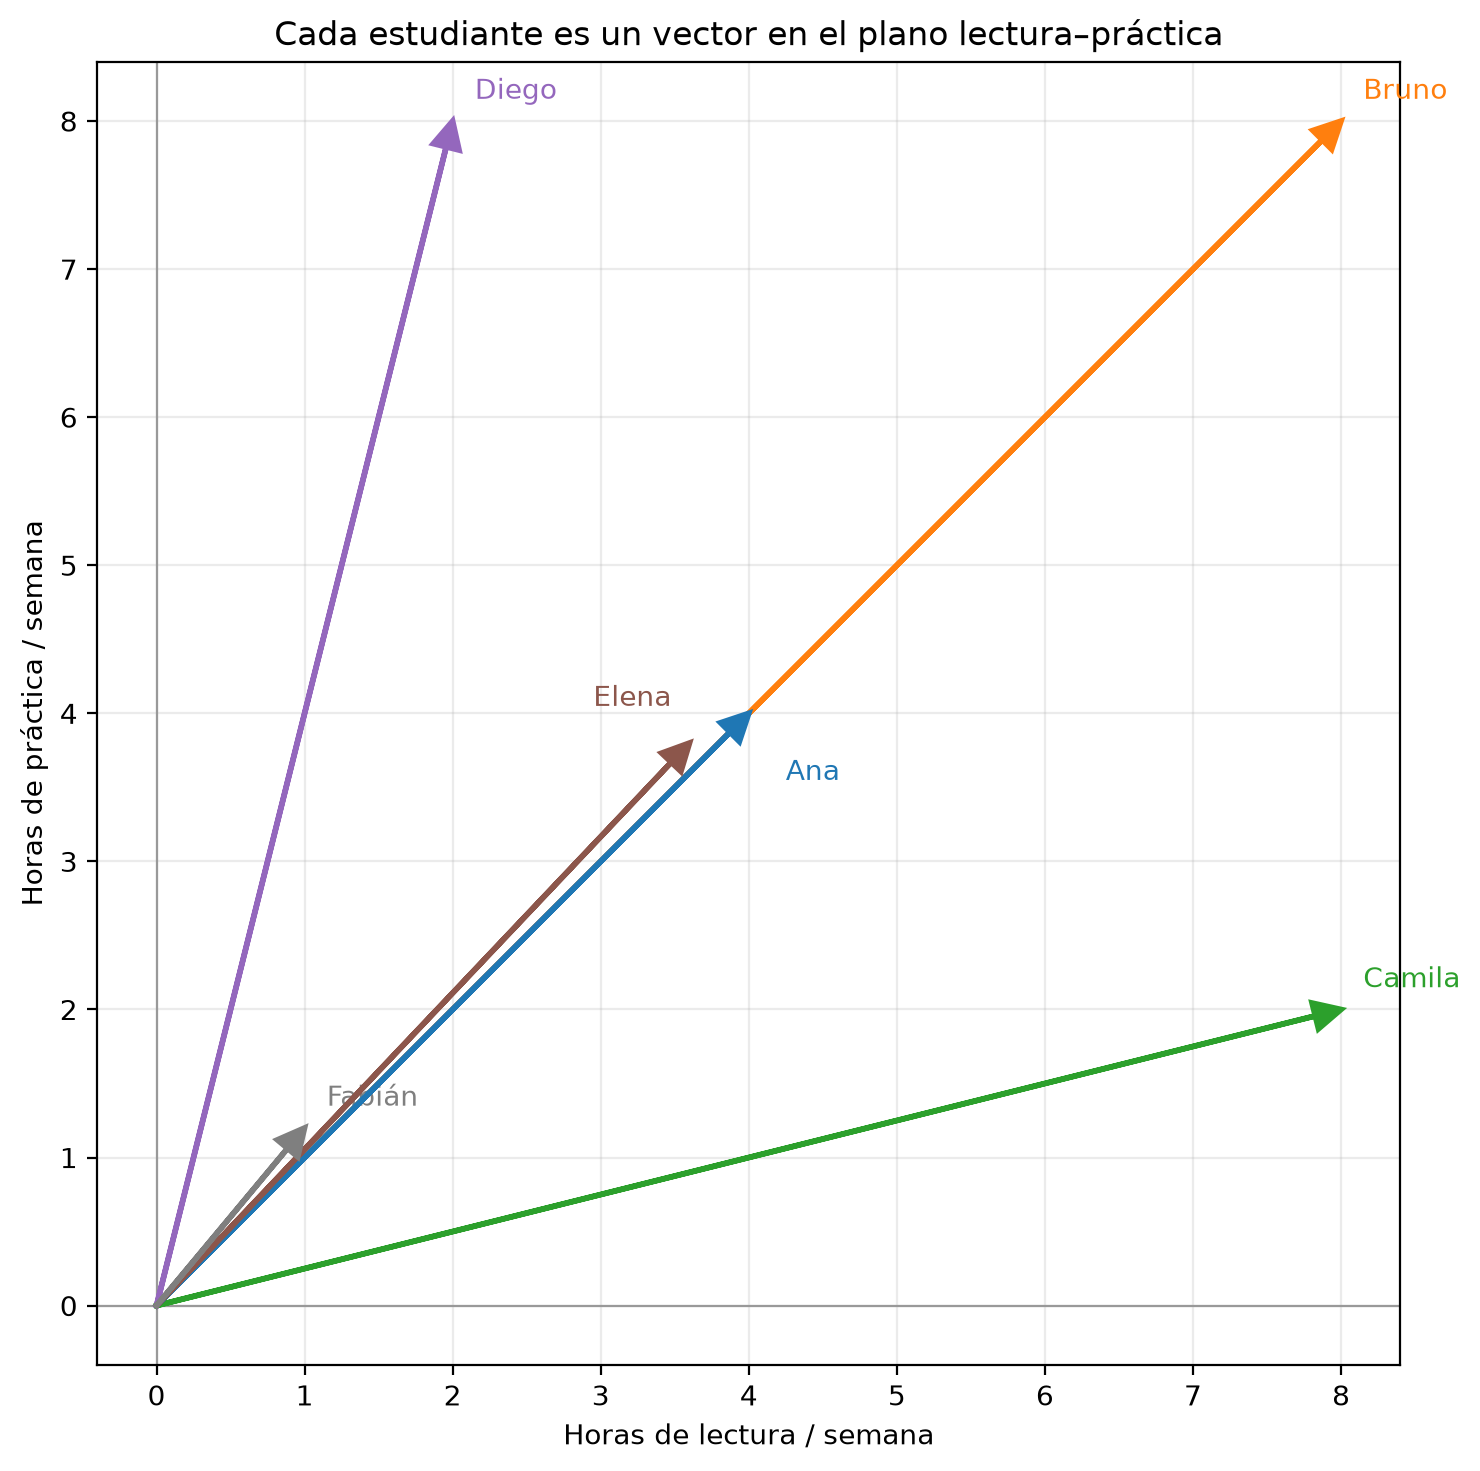
Dibujas cada fila \(\mathbf{x}_i\) como una flecha desde el origen. El origen \((0, 0)\) significa cero horas de lectura y cero de práctica; ningún perfil está ahí, pero sirve de ancla a la geometría. Al mirar la figura, fíjate qué flechas caen sobre la misma recta y cuáles apuntan a direcciones distintas aunque sumen muchas horas.
graficar_vectores_2d( nombres, X,"Cada estudiante es un vector en el plano lectura–práctica",)print("Normas (longitud de cada flecha):")for nombre, vec inzip(nombres, X):print(f" {nombre:8s} ||x|| = {np.linalg.norm(vec):.3f} x = {vec}")
Normas (longitud de cada flecha):
  Ana       ||x|| = 5.657   x = [4. 4.]
  Bruno     ||x|| = 11.314   x = [8. 8.]
  Camila    ||x|| = 8.246   x = [8. 2.]
  Diego     ||x|| = 8.246   x = [2. 8.]
  Elena     ||x|| = 5.235   x = [3.6 3.8]
  Fabián    ||x|| = 1.562   x = [1.  1.2]
Ana y Bruno están sobre la misma semirrecta, porque \((8, 8) = 2\cdot(4, 4)\), y la norma de Bruno (11.314) es el doble de la de Ana (5.657). Camila y Diego tienen exactamente la misma longitud, 8.246, con ángulos distintos. Elena (5.235) casi coincide con Ana. La flecha de Fabián es la más corta (1.562) y apunta cerca de la recta de Ana y Bruno.
La pregunta pasa a ser dónde está cada observación en el espacio y a quién se parece, más allá de la media de cada columna.
Ejercicio
Sin mirar el gráfico, decide si el vector np.array([6.0, 6.0]) queda sobre la recta de Ana y Bruno. Después compruébalo con su coseno respecto a Ana.
TipOrientaciones
Sí: \((6, 6) = 1.5\cdot(4, 4)\), así que es un múltiplo positivo de Ana. Su coseno con Ana es \(\frac{6\cdot 4 + 6\cdot 4}{\|(6,6)\|\,\|(4,4)\|} = \frac{48}{8.485 \cdot 5.657} = 1\). Su norma, 8.485, queda entre la de Ana y la de Bruno.
Etapa 3: Producto punto
El producto punto resume en un solo número cuánto apuntan dos vectores hacia el mismo lado, ponderado por su tamaño. Para Ana \(\mathbf{a}=(4,4)\) y Bruno \(\mathbf{b}=(8,8)\), coordenada a coordenada:
Si \(\cos\theta=1\), como en este par, el producto punto es exactamente el producto de las longitudes. La misma operación es la que hace cada neurona de una capa lineal, \(\mathbf{w}\cdot\mathbf{x} + b\); aquí la usas solo para describir.
def producto_punto(a, b):returnfloat(np.dot(a, b))ana, bruno, camila = X[0], X[1], X[2]print("A mano (Ana · Bruno):", 4*8+4*8)print("NumPy (Ana · Bruno):", producto_punto(ana, bruno))print("Ana · Camila:", producto_punto(ana, camila))print("Ana · Diego :", producto_punto(ana, X[3]))print()print("Verificación geométrica Ana · Bruno:")na, nb = np.linalg.norm(ana), np.linalg.norm(bruno)print(f" ||Ana|| = {na:.4f}, ||Bruno|| = {nb:.4f}")print(f" ||Ana|| × ||Bruno|| × cos(0) = {na * nb *1:.4f}")print()print("Matriz de Gram G = X Xᵀ (producto interno entre cada par de estudiantes):")G = X @ X.Tgram = pd.DataFrame(np.round(G, 2), index=nombres, columns=nombres)display(gram)print("Diagonal:", np.round(np.diag(G), 2))
A mano (Ana · Bruno): 64
NumPy  (Ana · Bruno): 64.0
Ana · Camila: 40.0
Ana · Diego : 40.0

Verificación geométrica Ana · Bruno:
  ||Ana|| = 5.6569, ||Bruno|| = 11.3137
  ||Ana|| × ||Bruno|| × cos(0) = 64.0000

Matriz de Gram G = X Xᵀ  (producto interno entre cada par de estudiantes):
Ana
Bruno
Camila
Diego
Elena
Fabián
Ana
32.0
64.0
40.0
40.0
29.60
8.80
Bruno
64.0
128.0
80.0
80.0
59.20
17.60
Camila
40.0
80.0
68.0
32.0
36.40
10.40
Diego
40.0
80.0
32.0
68.0
37.60
11.60
Elena
29.6
59.2
36.4
37.6
27.40
8.16
Fabián
8.8
17.6
10.4
11.6
8.16
2.44
Diagonal: [ 32. 128. 68. 68. 27.4 2.44]
Ana·Bruno \(= 64\) es grande porque los dos vectores están alineados y Bruno es largo. Ana·Camila \(= 40\) es menor: Camila también tiene muchas horas, pero buena parte de su vector apunta hacia la lectura, un eje en el que Ana no se concentra. Ana·Diego también da 40, por simetría. El producto punto mezcla tamaño y ángulo, así que no basta para decir que dos perfiles se parecen si sus normas difieren.
La matriz de Gram\(G=XX^{\top}\) reúne todos los productos punto entre filas: \(G_{ik}=\mathbf{x}_i\cdot\mathbf{x}_k\). Su diagonal contiene las normas al cuadrado (32 para Ana, 128 para Bruno, 68 para Camila y Diego). Es el objeto que reaparece en los métodos de kernel del nivel Avanzado. Su pariente \(X^{\top}X\), de tamaño \(D\times D\), compara columnas en lugar de filas: con las columnas centradas y dividida entre \(N-1\), es la matriz de covarianzas que usa el análisis de componentes principales.
Etapa 4: Norma, el tamaño del perfil
La norma euclidiana responde qué tan largo es el vector, sin decir hacia dónde va:
\[ \|\mathbf{x}\|_2 = \sqrt{x_1^2 + x_2^2} \]
Para Ana, \(\sqrt{16+16}=\sqrt{32}\approx 5.66\); para Bruno, \(\sqrt{64+64}=\sqrt{128}\approx 11.31\), el doble. Camila y Diego tienen la misma norma, \(\sqrt{68}\), con el reparto entre lectura y práctica invertido.
Además de \(L_2\), la norma \(L_1\) suma los valores absolutos:
\[ \|\mathbf{x}\|_1 = \sum_{j=1}^{D}|x_j| \]
\(L_2\) pesa más las coordenadas grandes, por el cuadrado; \(L_1\) trata cada unidad por igual. En regularización, la penalización \(L_2\) (Ridge) encoge los coeficientes y la \(L_1\) (Lasso) tiende a dejar algunos en cero.
Norma a mano (Ana): 5.656854249492381
Norma NumPy  (Ana): 5.656854249492381 | función propia: 5.656854249492381

Ana       norma = 5.657
Bruno     norma = 11.314
Camila    norma = 8.246
Diego     norma = 8.246
Elena     norma = 5.235
Fabián    norma = 1.562

Camila y Diego (normas parecidas, direcciones distintas):
  Camila [8. 2.] norma 8.246211251235321
  Diego  [2. 8.] norma 8.246211251235321

nombre    L2      L1      L1/L2
Ana        5.657   8.000   1.414
Bruno     11.314  16.000   1.414
Camila     8.246  10.000   1.213
Diego      8.246  10.000   1.213
Elena      5.235   7.400   1.414
Fabián     1.562   2.200   1.408
Bruno tiene el mismo perfil que Ana con más intensidad, y su norma (11.314) duplica la de Ana (5.657). Fabián apunta casi igual que Ana, pero su norma es 1.562; con la distancia euclidiana, quedará lejos de Ana aunque su proporción sea parecida (etapa 6).
El cociente \(L_1/L_2\) resume la forma del perfil: vale 1.414 (\(\sqrt{2}\)) cuando las dos coordenadas son iguales, como en Ana y Bruno, y baja a 1.213 en Camila y Diego, cuyos perfiles están desbalanceados. Camila y Diego empatan en \(L_2\) (8.246) y en \(L_1\) (\(8+2=10\)): su diferencia está en la dirección, no en el tamaño. La regularización \(L_2\), la normalización de embeddings y el weight decay trabajan con esta misma longitud.
Etapa 5: Vector unitario y Cauchy–Schwarz
El vector unitario de \(\mathbf{a}\) es \(\hat{\mathbf{a}}=\mathbf{a}/\|\mathbf{a}\|\). Dos vectores sobre la misma semirrecta, como Ana y Bruno, deben producir el mismo unitario; el de Camila debe ser distinto.
Cauchy–Schwarz afirma que \(|\mathbf{a}\cdot\mathbf{b}|\le\|\mathbf{a}\|\,\|\mathbf{b}\|\). El cociente entre los dos lados es \(|\cos\theta|\), que no puede superar 1, y la igualdad se da cuando un vector es múltiplo del otro. La celda calcula la holgura, la diferencia entre el lado derecho y el izquierdo.
def unitario(v): v = np.asarray(v, dtype=float) n = np.linalg.norm(v)if n ==0:raiseValueError("el vector nulo no tiene dirección")return v / nprint("Vectores unitarios (deben tener norma 1):")for nombre, vec inzip(nombres, X): u = unitario(vec)print(f" {nombre:8s} û = {np.round(u, 4)} ||û|| = {np.linalg.norm(u):.6f}")print()print("¿Ana y Bruno comparten dirección? ||û_Ana − û_Bruno|| =", np.linalg.norm(unitario(X[0]) - unitario(X[1])))print("¿Ana y Camila comparten dirección? ||û_Ana − û_Camila|| =", np.linalg.norm(unitario(X[0]) - unitario(X[2])))print()print("Cauchy–Schwarz: |a·b| ≤ ||a|| ||b||")pares = [("Ana", "Bruno", X[0], X[1]), ("Ana", "Camila", X[0], X[2]), ("Camila", "Diego", X[2], X[3])]for na, nb, a, b in pares: izq =abs(np.dot(a, b)) der = np.linalg.norm(a) * np.linalg.norm(b)print(f" {na}–{nb}: {izq:.4f} ≤ {der:.4f} holgura = {der - izq:.4f}")
Vectores unitarios (deben tener norma 1):
  Ana       û = [0.7071 0.7071]   ||û|| = 1.000000
  Bruno     û = [0.7071 0.7071]   ||û|| = 1.000000
  Camila    û = [0.9701 0.2425]   ||û|| = 1.000000
  Diego     û = [0.2425 0.9701]   ||û|| = 1.000000
  Elena     û = [0.6877 0.726 ]   ||û|| = 1.000000
  Fabián    û = [0.6402 0.7682]   ||û|| = 1.000000

¿Ana y Bruno comparten dirección?  ||û_Ana − û_Bruno|| = 0.0
¿Ana y Camila comparten dirección? ||û_Ana − û_Camila|| = 0.533867163791623

Cauchy–Schwarz: |a·b|  ≤  ||a|| ||b||
  Ana–Bruno:  64.0000  ≤  64.0000   holgura = 0.0000
  Ana–Camila:  40.0000  ≤  46.6476   holgura = 6.6476
  Camila–Diego:  32.0000  ≤  68.0000   holgura = 36.0000
Todos los unitarios tienen norma 1. Los de Ana y Bruno coinciden, \((0.7071, 0.7071)\), y la distancia entre ellos es 0; el de Camila, \((0.9701, 0.2425)\), queda a 0.534 del de Ana. En Cauchy–Schwarz, Ana–Bruno tiene holgura 0 (64 frente a 64), el caso de igualdad; Ana–Camila deja 6.648 y Camila–Diego, 36, porque no son múltiplos. Dividir por la norma quita la intensidad, y el coseno resulta ser el producto punto de dos unitarios:
Mide el segmento que une dos puntos, no el ángulo entre flechas. Antes de ver los números, piensa quién debería quedar más cerca de Ana: Bruno, con su misma dirección y el doble de horas, o Elena, que está casi en el mismo punto.
def distancia_euclidiana(a, b):returnfloat(np.linalg.norm(np.asarray(a) - np.asarray(b)))print("Distancia a Ana")d_ana = []for nombre, vec inzip(nombres, X): d = distancia_euclidiana(ana, vec) d_ana.append(d)print(f" {nombre:8s} d = {d:.3f}")orden = np.argsort(d_ana)print()print("Ranking (más cercana → más lejana):")for k, idx inenumerate(orden, start=1):if nombres[idx] =="Ana":continueprint(f" {k-1}. {nombres[idx]:8s} d = {d_ana[idx]:.3f}")
Distancia a Ana
  Ana       d = 0.000
  Bruno     d = 5.657
  Camila    d = 4.472
  Diego     d = 4.472
  Elena     d = 0.447
  Fabián    d = 4.104

Ranking (más cercana → más lejana):
  1. Elena     d = 0.447
  2. Fabián    d = 4.104
  3. Camila    d = 4.472
  4. Diego     d = 4.472
  5. Bruno     d = 5.657
Elena gana con amplitud: está a 0.447 de Ana. Bruno, con el mismo perfil, queda el más lejano de todos (5.657), por detrás de Fabián (4.104) y de Camila y Diego (4.472), porque el doble de horas lo desplaza por el plano. La distancia euclidiana penaliza la diferencia de intensidad.
Un modelo de un solo vecino con esta medida diría que el vecino de Ana es Elena, no Bruno. Eso es correcto si «parecido» significa dedicar las mismas horas, e incorrecto si significa repartirlas en la misma proporción.
Ana y Bruno van a tener \(\cos\theta = 1\) y, al mismo tiempo, la mayor distancia euclidiana. Ese es el contraste central del capítulo. Al ver el resultado, fíjate si Bruno sube al primer lugar y dónde queda Fabián, con su flecha tan corta.
def similitud_coseno(a, b): a = np.asarray(a, dtype=float) b = np.asarray(b, dtype=float) denom = np.linalg.norm(a) * np.linalg.norm(b)if denom ==0:return np.nanreturnfloat(np.dot(a, b) / denom)print("Coseno con Ana")c_ana = []for nombre, vec inzip(nombres, X): c = similitud_coseno(ana, vec) c_ana.append(c)print(f" {nombre:8s} cos = {c:.4f}")print()print("Verificación Ana–Bruno (deben ser 1):", similitud_coseno(ana, bruno))print("Ángulo Ana–Bruno (grados):", np.degrees(np.arccos(np.clip(similitud_coseno(ana, bruno), -1, 1))))print("Ángulo Ana–Camila (grados):", np.degrees(np.arccos(np.clip(similitud_coseno(ana, camila), -1, 1))))tabla = pd.DataFrame( {"distancia_a_Ana": d_ana,"coseno_con_Ana": c_ana, }, index=nombres,)print()display(tabla.round(3))
Coseno con Ana
  Ana       cos = 1.0000
  Bruno     cos = 1.0000
  Camila    cos = 0.8575
  Diego     cos = 0.8575
  Elena     cos = 0.9996
  Fabián    cos = 0.9959

Verificación Ana–Bruno (deben ser 1): 0.9999999999999998
Ángulo Ana–Bruno (grados): 1.2074182697257333e-06
Ángulo Ana–Camila (grados): 30.963756532073536
distancia_a_Ana
coseno_con_Ana
Ana
0.000
1.000
Bruno
5.657
1.000
Camila
4.472
0.857
Diego
4.472
0.857
Elena
0.447
1.000
Fabián
4.104
0.996
Bruno empata con Ana misma en el primer lugar del coseno (1.000) y es el más lejano en distancia (5.657). Elena (0.9996) y Fabián (0.9959) quedan casi en 1: el coseno reconoce que Fabián reparte sus horas como Ana, aunque la distancia lo aleje (4.104). Camila y Diego bajan a 0.8575, un ángulo de 31° con Ana, aunque tengan más horas que ella. Es el mismo par de personas con dos conclusiones, como la misma media con dispersiones distintas de los capítulos 2 a 4.
Hay además un vínculo directo con el capítulo 5: si centras dos columnas (les restas su media) y calculas el coseno entre ellas, obtienes su correlación de Pearson.
Ejercicio
Calcula a mano el coseno entre Camila \((8, 2)\) y Diego \((2, 8)\) y el ángulo que forman. Interpreta el resultado en una frase: ¿comparten intensidad, dirección, ambas o ninguna?
TipOrientaciones
El producto punto es \(8\cdot 2 + 2\cdot 8 = 32\) y las dos normas valen \(\sqrt{68}\), así que \(\cos\theta = 32/68 \approx 0.471\), un ángulo de unos 61.9°. Comparten intensidad (la misma norma y las mismas 10 horas en total) y no comparten dirección: uno se inclina hacia la lectura y el otro hacia la práctica. La distancia entre ellos es 8.485, la mayor de la tabla de la etapa 9.
Etapa 8: Ortogonalidad y proyección
Dos vectores son ortogonales si su producto punto es cero; en el plano, \((1,0)\) y \((0,1)\) son el ejemplo más simple. Camila \((8,2)\) y Diego \((2,8)\) no lo son, porque \(16+16=32\neq 0\). Sí puedes construir un vector ortogonal a Ana\((4,4)\), por ejemplo \(\mathbf{v}=(4,-4)\), porque \(16-16=0\).
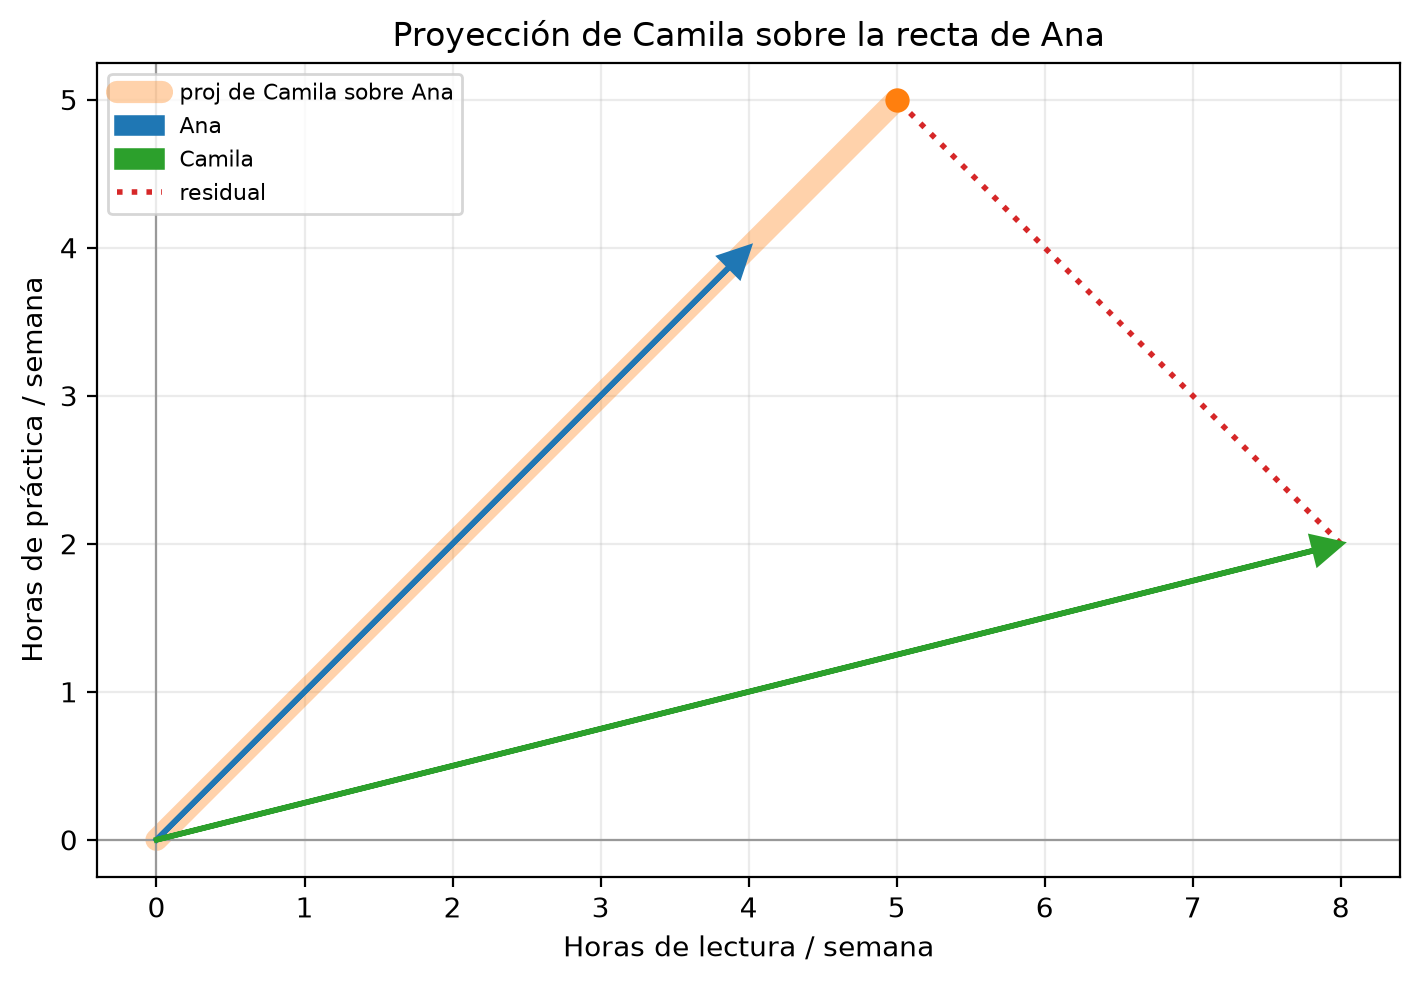
La proyección de Camila sobre la recta de Ana responde a esta pregunta: si el único eje permitido fuera el del equilibrio entre lectura y práctica, ¿qué parte del perfil de Camila quedaría?
El residual debe quedar perpendicular a Ana, con producto punto 0.
ana, camila = X[0], X[2]ortogonal_a_ana = np.array([4.0, -4.0])print("Ana · (4, −4) =", np.dot(ana, ortogonal_a_ana), " (ortogonal si es 0)")print("Camila · Diego =", np.dot(X[2], X[3]), " (no son ortogonales)")proj, residual = graficar_proyeccion( camila, ana, "Camila", "Ana","Proyección de Camila sobre la recta de Ana",)print("proj_Ana(Camila) =", np.round(proj, 4))print("residual =", np.round(residual, 4))print("Ana · residual =", np.round(np.dot(ana, residual), 10), " (debe ser ~0)")print("Teorema de Pitágoras: ||Camila||² = ||proj||² + ||residual||²")print(" ", np.dot(camila, camila), "=", np.dot(proj, proj) + np.dot(residual, residual))
Ana · (4, −4) = 0.0   (ortogonal si es 0)
Camila · Diego = 32.0   (no son ortogonales)
proj_Ana(Camila) = [5. 5.]
residual         = [ 3. -3.]
Ana · residual   = 0.0   (debe ser ~0)
Teorema de Pitágoras: ||Camila||² = ||proj||² + ||residual||²
   68.0 = 68.0
La proyección de Camila sobre Ana es \((5, 5)\), la banda naranja ancha que sigue la recta de Ana hasta el punto naranja: con \(\mathbf{c}\cdot\mathbf{a} = 40\) y \(\|\mathbf{a}\|^2 = 32\), es \(1.25\cdot(4,4)\). El residual, la línea roja punteada, es \((3, -3)\): el exceso de lectura sobre práctica. Como Ana·residual \(= 0\), esa parte no se ve desde la recta de Ana. Las longitudes cumplen el teorema de Pitágoras: \(68 = 50 + 18\).
En un modelo lineal, el residual es el error que la dirección elegida no explica. En el PCA, con los datos centrados (restando la media de cada columna), se elige el eje que maximiza la suma de las normas al cuadrado de las proyecciones, es decir, la varianza proyectada.
Etapa 9: Interpretación geométrica conjunta
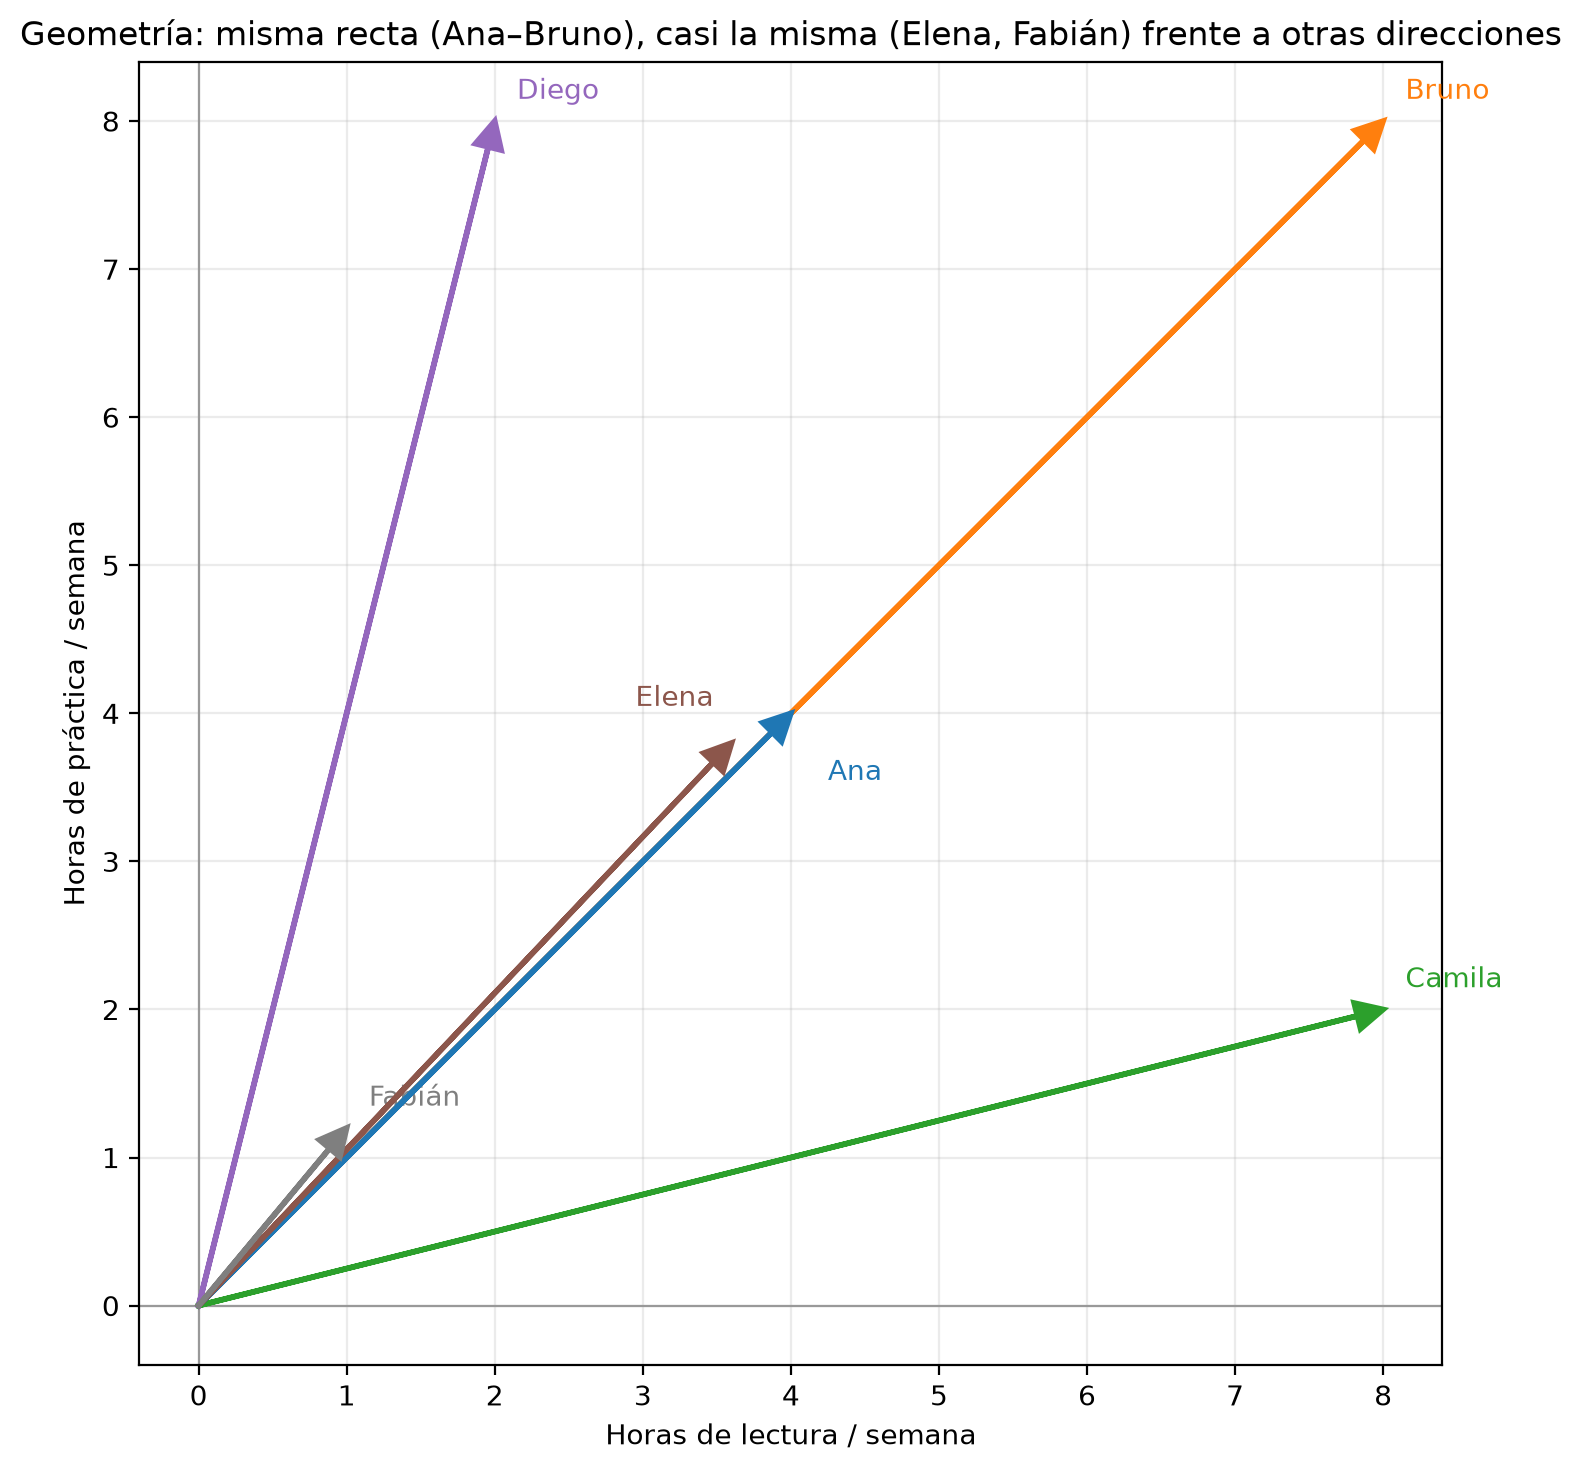
Vuelves a dibujar las flechas y resumes en una tabla la correspondencia visual: la longitud es la norma, la apertura entre flechas es el ángulo y el segmento entre las puntas es la distancia.
graficar_vectores_2d( nombres, X,"Geometría: misma recta (Ana–Bruno), casi la misma (Elena, Fabián) frente a otras direcciones",)resumen = pd.DataFrame( {"par": ["Ana–Bruno", "Ana–Elena", "Ana–Fabián", "Ana–Camila", "Camila–Diego"],"euclidiana": [ distancia_euclidiana(X[0], X[1]), distancia_euclidiana(X[0], X[4]), distancia_euclidiana(X[0], X[5]), distancia_euclidiana(X[0], X[2]), distancia_euclidiana(X[2], X[3]), ],"coseno": [ similitud_coseno(X[0], X[1]), similitud_coseno(X[0], X[4]), similitud_coseno(X[0], X[5]), similitud_coseno(X[0], X[2]), similitud_coseno(X[2], X[3]), ],"lectura": ["Misma dirección; distinta intensidad","Cercanos en el plano","Casi la misma dirección; Fabián es corto","Ángulo abierto; Camila es lectora","Trade-off opuesto lectura/práctica", ], })display(resumen.round(3))
par
euclidiana
coseno
lectura
0
Ana–Bruno
5.657
1.000
Misma dirección; distinta intensidad
1
Ana–Elena
0.447
1.000
Cercanos en el plano
2
Ana–Fabián
4.104
0.996
Casi la misma dirección; Fabián es corto
3
Ana–Camila
4.472
0.857
Ángulo abierto; Camila es lectora
4
Camila–Diego
8.485
0.471
Trade-off opuesto lectura/práctica
La tabla junta los dos casos extremos. Ana–Bruno tiene coseno 1.000 y distancia 5.657; Ana–Elena, coseno 1.000 y distancia 0.447. Camila–Diego tiene la mayor distancia (8.485) y el menor coseno (0.471). Si te preguntas quién estudia como Ana, aunque sea con más o menos horas, mira el coseno; si te preguntas quién tiene una carga horaria parecida a la de Ana, mira la distancia. Ninguna medida es mejor en general: la elección depende de la pregunta.
En búsqueda de documentos, dos textos del mismo tema y distinta longitud suelen recuperarse mejor con el coseno. Con sensores industriales, dos lecturas parecidas en valor absoluto se comparan mejor con la distancia, después de escalar.
Etapa 10: La escala de las variables cambia el espacio
Agregas una columna en otra unidad: minutos de pantalla al día. Ana y Elena siguen cerca en horas de estudio, pero Fabián, que en el plano original casi no se mueve, ahora tiene 240 minutos frente a 80–95 de los demás. Sin escalar, esa columna domina la distancia. La celda calcula las distancias a Ana con los datos crudos y después de estandarizar cada columna con su media y su desviación estándar, el z-score del capítulo 4.
minutos_pantalla = np.array([90.0, 95.0, 80.0, 85.0, 88.0, 240.0])X_crudo = np.column_stack([X, minutos_pantalla])df_crudo = pd.DataFrame( X_crudo, columns=["horas_lectura", "horas_practica", "minutos_pantalla"], index=nombres,)print("X sin escalar (unidades mezcladas):")display(df_crudo)print("Distancia euclidiana a Ana en R^3 sin escalar")d_crudo = [distancia_euclidiana(X_crudo[0], fila) for fila in X_crudo]for nombre, d inzip(nombres, d_crudo):print(f" {nombre:8s} d = {d:.3f}")# Estandarización: (x - media) / desv. de cada columna (estadísticos del conjunto)medias = X_crudo.mean(axis=0)desv = X_crudo.std(axis=0, ddof=1)X_std = (X_crudo - medias) / desvprint()print("Distancia euclidiana a Ana después de estandarizar columnas")d_std = [distancia_euclidiana(X_std[0], fila) for fila in X_std]for nombre, d inzip(nombres, d_std):print(f" {nombre:8s} d = {d:.3f}")
X sin escalar (unidades mezcladas):
horas_lectura
horas_practica
minutos_pantalla
Ana
4.0
4.0
90.0
Bruno
8.0
8.0
95.0
Camila
8.0
2.0
80.0
Diego
2.0
8.0
85.0
Elena
3.6
3.8
88.0
Fabián
1.0
1.2
240.0
Distancia euclidiana a Ana en R^3 sin escalar
  Ana       d = 0.000
  Bruno     d = 7.550
  Camila    d = 10.954
  Diego     d = 6.708
  Elena     d = 2.049
  Fabián    d = 150.056

Distancia euclidiana a Ana después de estandarizar columnas
  Ana       d = 0.000
  Bruno     d = 1.926
  Camila    d = 1.521
  Diego     d = 1.532
  Elena     d = 0.155
  Fabián    d = 2.779
Sin escalar, Fabián queda a 150.056 de Ana: sus 150 minutos de diferencia pesan mucho más que las horas de estudio. Los minutos también reordenan al resto: Camila (10.954) queda más lejos que Diego (6.708) y Bruno (7.550) solo porque tiene 10 minutos menos que Ana. Tras estandarizar, cada variable aporta en unidades de desviación estándar: Elena sigue primera (0.155), Camila y Diego empatan casi (1.521 y 1.532), y Fabián sigue último pero a 2.779, en la misma escala que los demás.
El coseno no resuelve este problema por sí solo: no cambia si multiplicas el vector entero por una constante, pero sí cuando una sola coordenada está en otra escala. Escalar es decidir que una hora de lectura y un minuto de pantalla no deben pesar lo mismo en la distancia.
Etapa 11: El vecino de una consulta
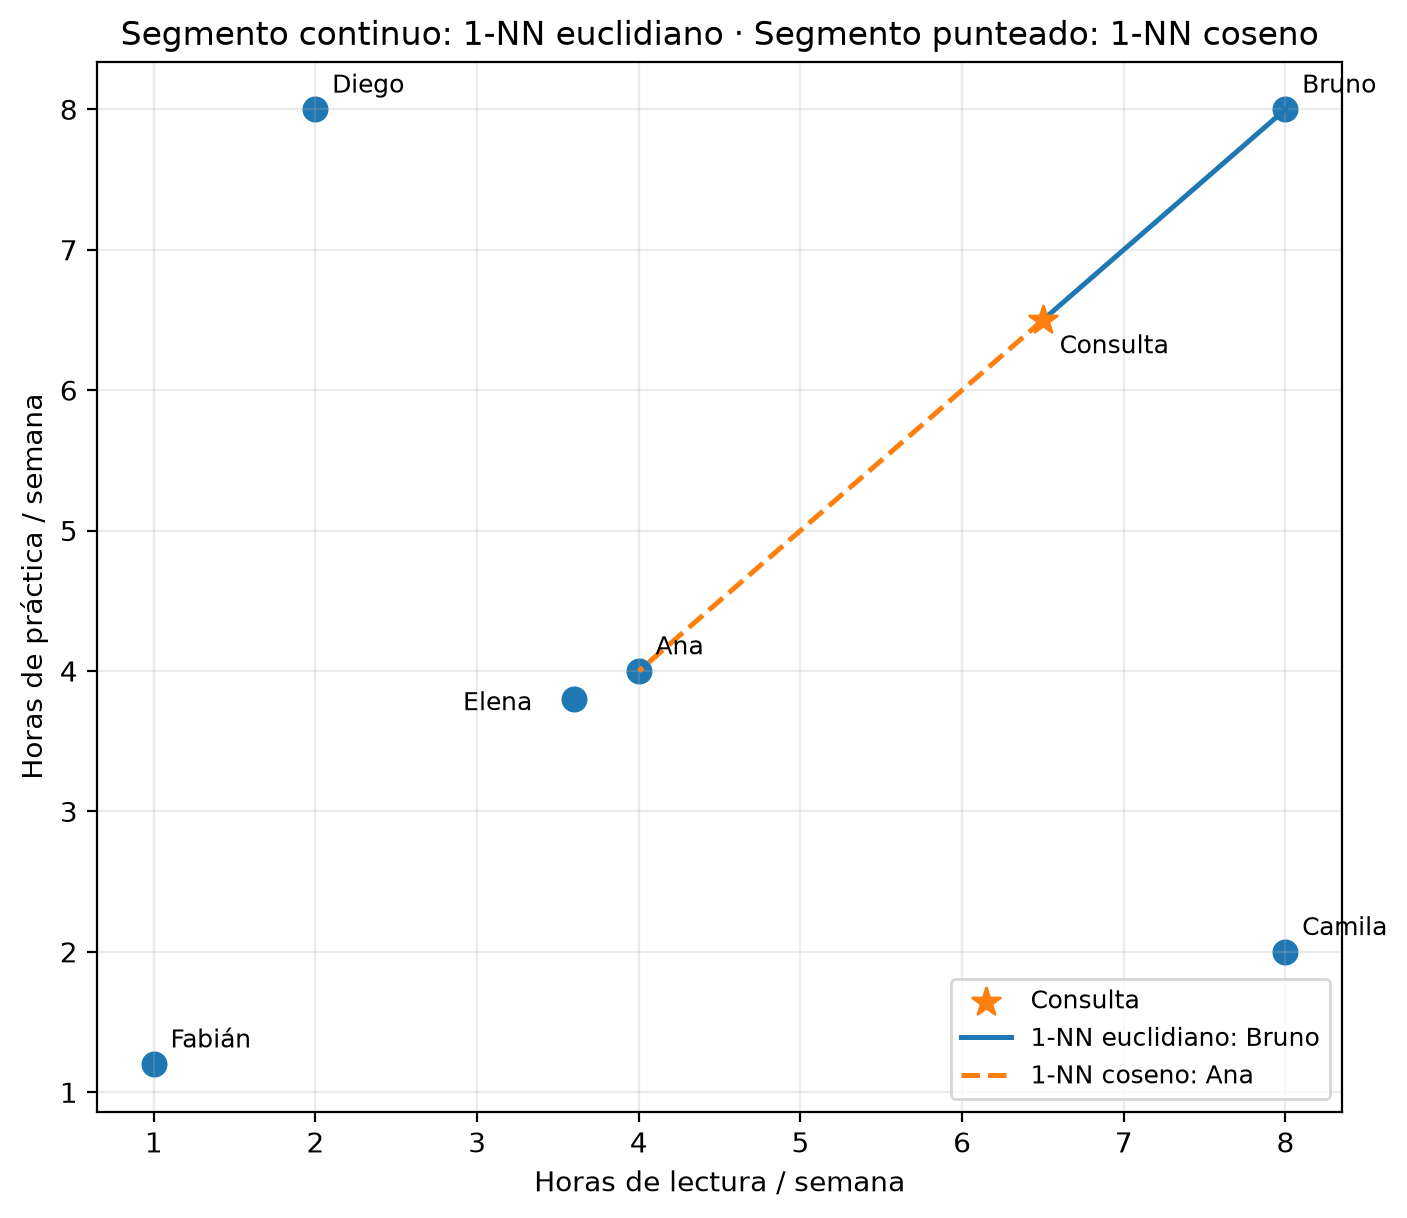
Llega un perfil nuevo, la consulta\(\mathbf{q}=(6.5,\,6.5)\): misma dirección que Ana y Bruno, con una magnitud más cercana a la de Bruno. Eliges su vecino más cercano entre las seis filas de \(X\), que no incluyen la consulta, una vez con la distancia euclidiana y otra con el coseno. Antes de ejecutar, anticipa quién gana con cada medida.
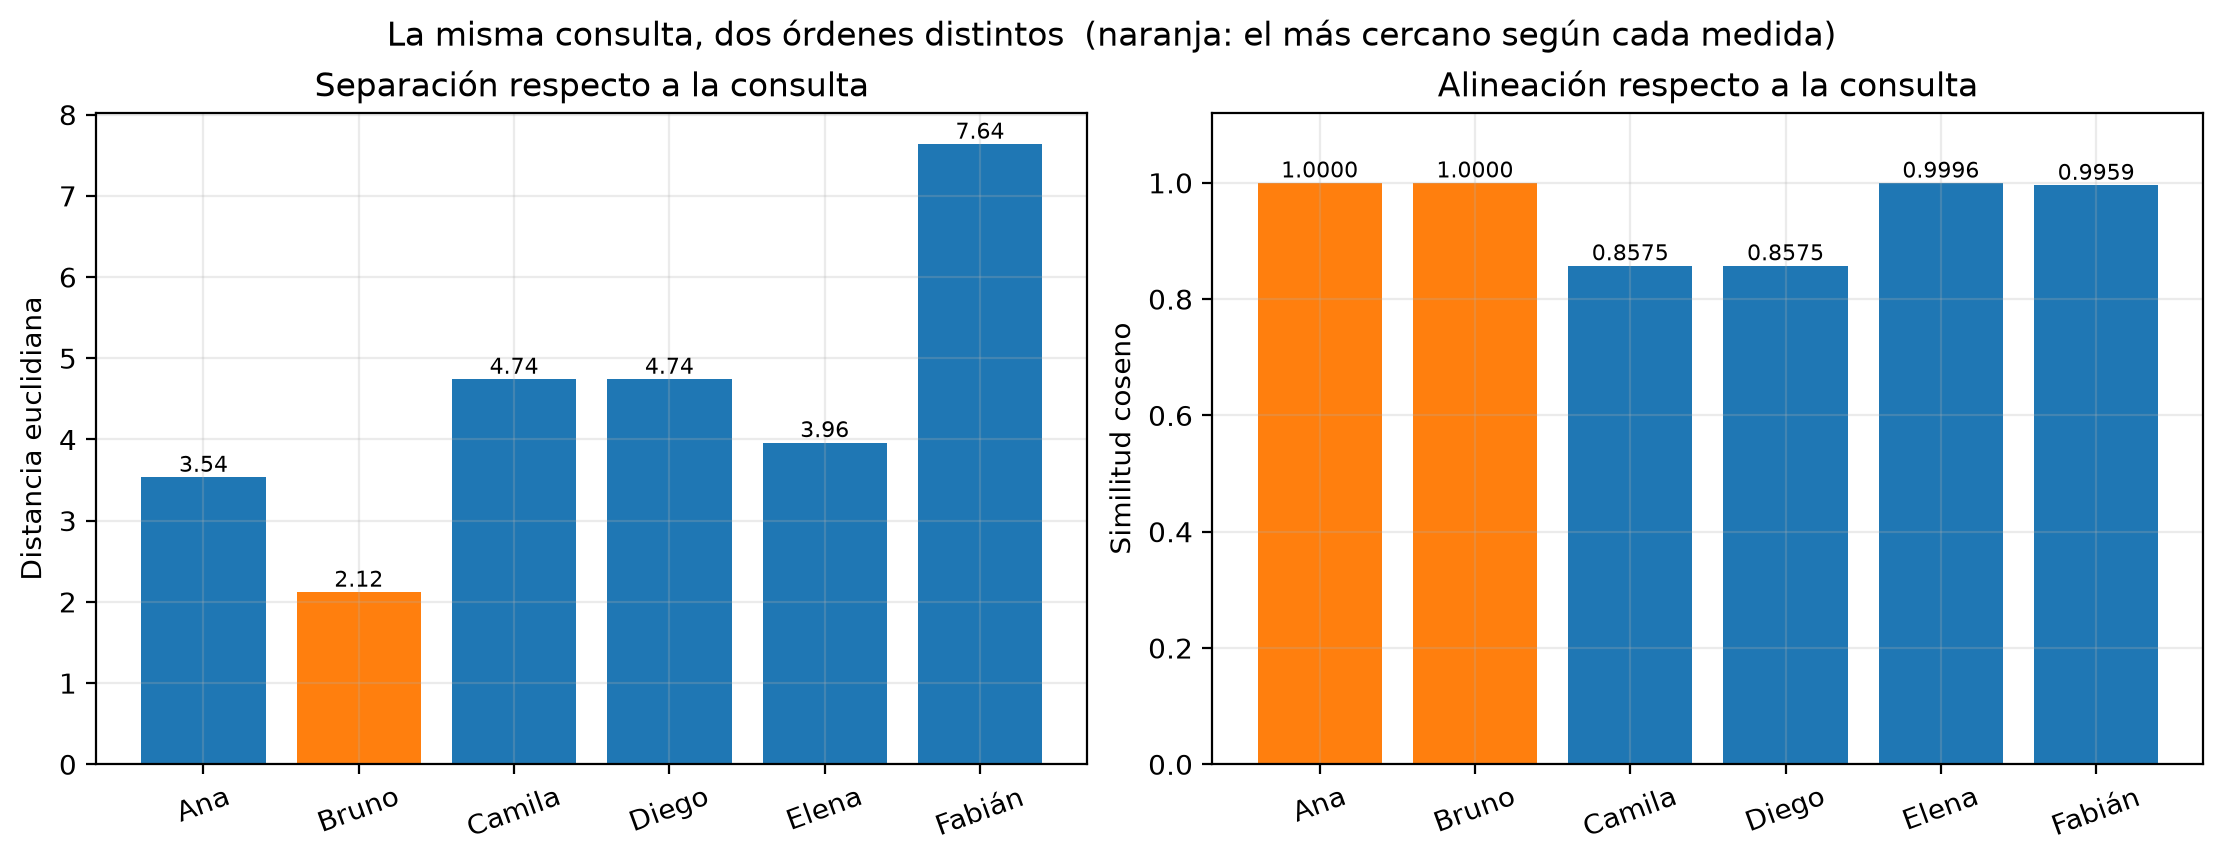
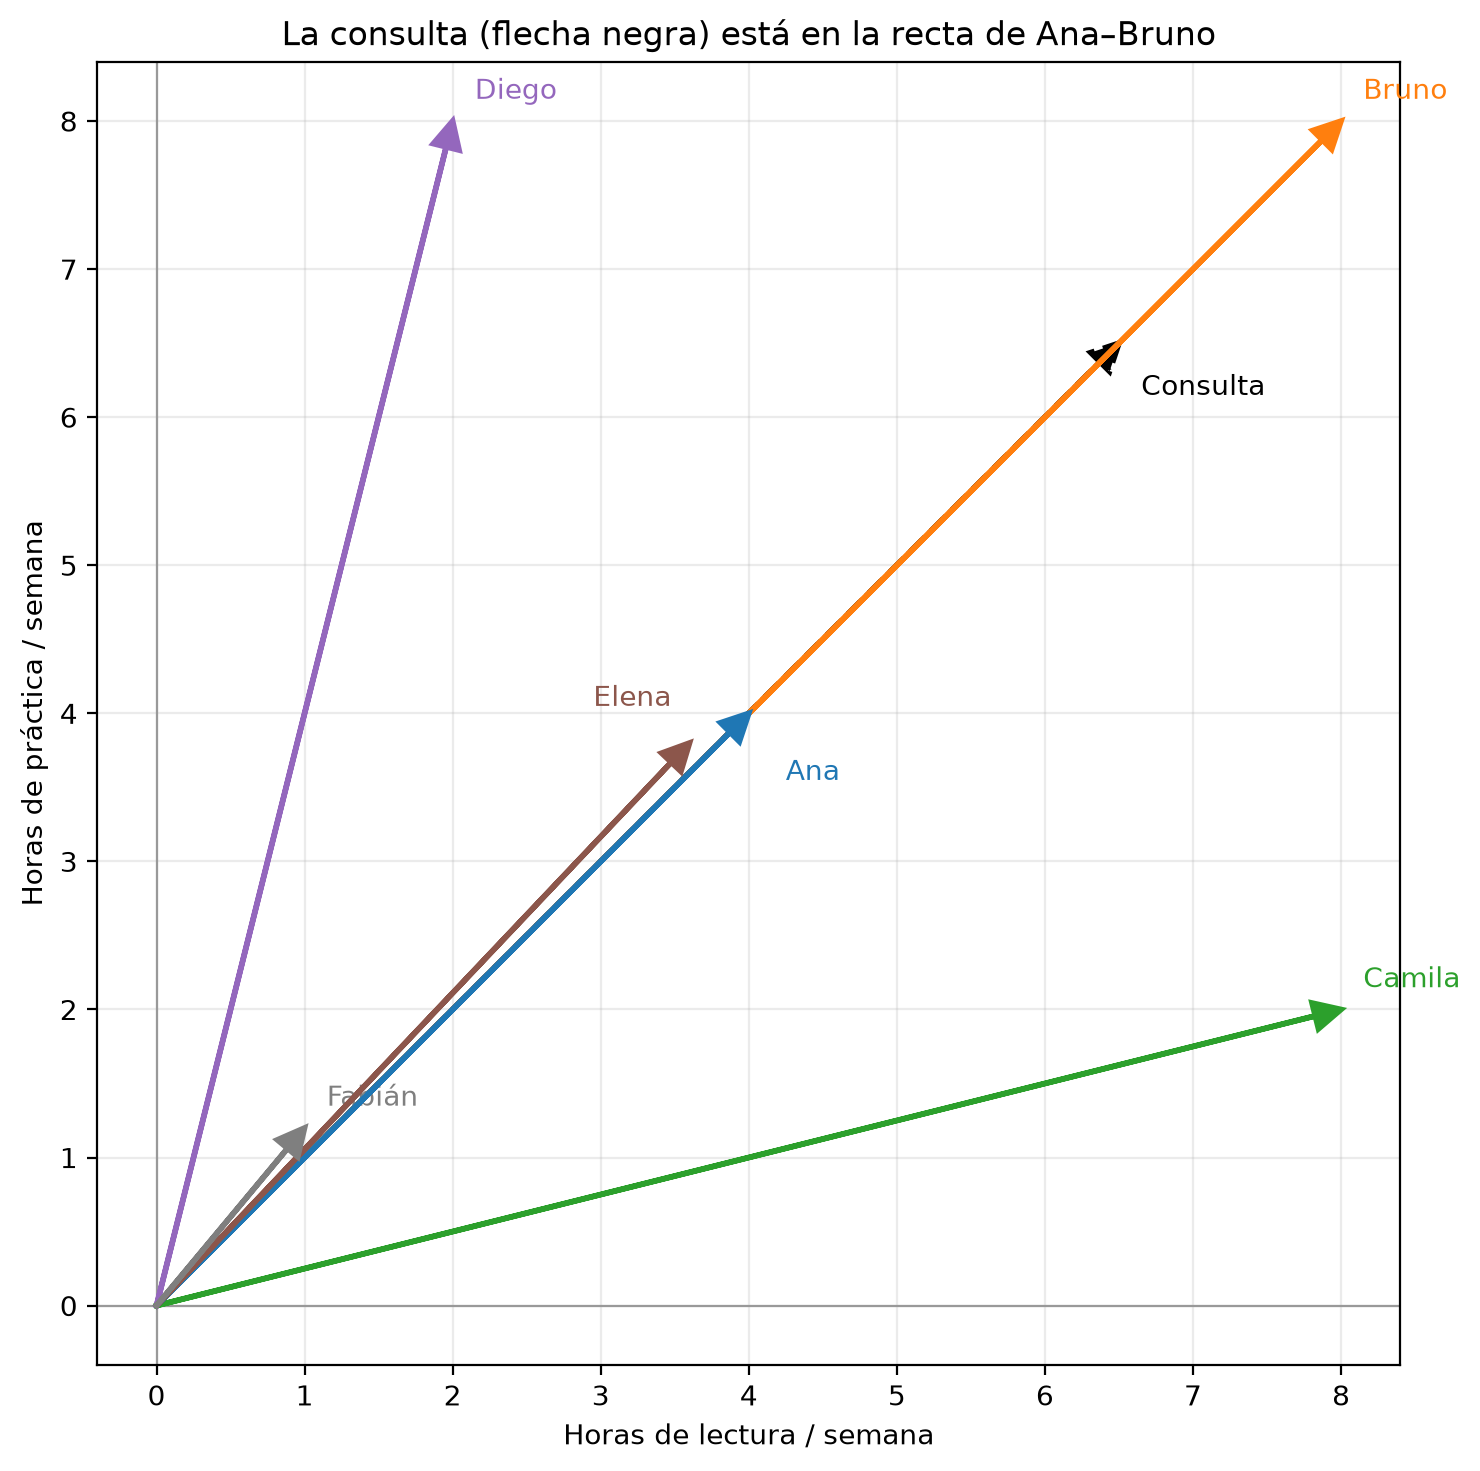
consulta = np.array([6.5, 6.5])d_q = np.array([distancia_euclidiana(consulta, fila) for fila in X])c_q = np.array([similitud_coseno(consulta, fila) for fila in X])idx_euc =int(np.argmin(d_q))idx_cos =int(np.argmax(c_q))print("Consulta q =", consulta)print()print("Ranking euclidiano (menor distancia):")for idx in np.argsort(d_q):print(f" {nombres[idx]:8s} d = {d_q[idx]:.3f}")print("Vecino 1-NN euclidiano:", nombres[idx_euc])print()print("Ranking coseno (mayor similitud):")for idx in np.argsort(-c_q):print(f" {nombres[idx]:8s} cos = {c_q[idx]:.4f}")print("Vecino 1-NN coseno:", nombres[idx_cos])graficar_barras_metricas( nombres, d_q, c_q,"La misma consulta, dos órdenes distintos",)graficar_puntos_y_consulta( nombres, X, consulta, [(idx_euc, "-", f"1-NN euclidiano: {nombres[idx_euc]}"), (idx_cos, "--", f"1-NN coseno: {nombres[idx_cos]}")],"Segmento continuo: 1-NN euclidiano · Segmento punteado: 1-NN coseno",)graficar_vectores_2d( nombres, X,"La consulta (flecha negra) está en la recta de Ana–Bruno", query=consulta,)
Consulta q = [6.5 6.5]

Ranking euclidiano (menor distancia):
  Bruno     d = 2.121
  Ana       d = 3.536
  Elena     d = 3.962
  Camila    d = 4.743
  Diego     d = 4.743
  Fabián    d = 7.638
Vecino 1-NN euclidiano: Bruno

Ranking coseno (mayor similitud):
  Ana       cos = 1.0000
  Bruno     cos = 1.0000
  Elena     cos = 0.9996
  Fabián    cos = 0.9959
  Diego     cos = 0.8575
  Camila    cos = 0.8575
Vecino 1-NN coseno: Ana
Por distancia, el vecino es Bruno (2.121), seguido de Ana (3.536). Por coseno, Ana y Bruno empatan en 1.0000 porque la consulta está sobre su recta, y argmax devuelve el primero de la lista: Ana. En las barras, Bruno es el único naranja a la izquierda y Ana y Bruno comparten el naranja a la derecha. En la última figura, la flecha negra de la consulta queda casi tapada por la de Bruno, porque las dos están sobre la misma recta. Las dos medidas eligen personas distintas: en un sistema de recomendación o en un modelo de k vecinos, cambiar la medida cambia el vecino y, con él, la predicción.
Ejercicio
Cambia la consulta a \((7.5,\,2.2)\), un perfil lector, y vuelve a calcular los dos rankings. ¿Coinciden el vecino euclidiano y el vecino por coseno? Escribe en dos líneas qué idea de «parecido» usas en cada caso.
TipOrientaciones
Esta vez coinciden: Camila gana en las dos medidas, a 0.539 de distancia y con coseno 0.9992. Los órdenes siguientes difieren: por distancia siguen Ana (3.936), Elena (4.215) y Bruno (5.822); por coseno, Ana y Bruno empatan en 0.8775, delante de Elena (0.8643). La distancia busca a quien dedica horas parecidas; el coseno, a quien las reparte en la misma proporción. Con una consulta cercana a un perfil en posición y en dirección, las dos ideas apuntan a la misma persona.
Errores que conviene nombrar
Meter el objetivo \(y\) dentro de \(X\). Cambia la geometría y filtra la respuesta hacia las variables de entrada.
Leer el producto punto como similitud. Mezcla tamaño y ángulo: Bruno tiene el mayor producto punto con todos porque es el vector más largo.
Usar la distancia euclidiana cuando la pregunta es la dirección, o el coseno cuando importa la magnitud.
Medir distancias con columnas en unidades distintas. En la etapa 10, los minutos de pantalla pusieron a Fabián a 150.056 de Ana.
Creer que el coseno corrige la escala. No cambia al escalar el vector entero, pero sí cuando cambia una sola coordenada.
Calcular el coseno con un vector nulo. No tiene dirección y el cociente no está definido.
Olvidar los empates. Con dos vecinos igual de similares, argmax elige el primero, y el resultado depende del orden de las filas.
6.6 Guía rápida: ¿qué medida usar?
Situación
Medida principal
Justificación
Guardar el dataset para un modelo
Matriz \(X\), vector \(y\)
Es la entrada de casi cualquier fit.
Qué tan intenso es un perfil
Norma
Mide longitud; no informa dirección.
Si dos perfiles apuntan igual
Coseno
No cambia al escalar el vector completo.
Si dos observaciones están cerca en valor
Distancia euclidiana
Penaliza magnitud y dirección.
Variables en unidades distintas
Estandarizar y después medir distancia
Si no, gana la columna de mayor rango.
Textos, embeddings, tema compartido
Coseno
La longitud del documento no debería decidir.
Capa lineal, proyección, alineación
Producto punto
Mezcla norma y ángulo; hay que leerlo con cuidado.
Si un vector es múltiplo de otro
Cauchy–Schwarz (holgura \(0\))
La igualdad equivale a dependencia lineal.
Quitar la intensidad y dejar la dirección
Vector unitario
\(\hat{\mathbf{x}}=\mathbf{x}/\|\mathbf{x}\|\); el coseno es \(\hat{\mathbf{a}}\cdot\hat{\mathbf{b}}\).
Qué parte de A está en la recta de B
Proyección ortogonal
El residual es perpendicular a la dirección de referencia.
Al reportar, indica qué variables entran a \(X\), qué medida usas y si escalaste.
6.7 Preguntas de comprensión
Un recomendador de rutinas de estudio debe sugerir a Fabián compañeros con hábitos parecidos. ¿Usarías la distancia euclidiana o el coseno? ¿Qué compañero obtendría con cada una?
¿Por qué el producto punto entre Ana y Bruno (64) es mayor que entre Ana y Elena (29.6), si Elena está mucho más cerca de Ana?
Agregas a un dataset una columna de ingresos en pesos junto a variables medidas en horas. ¿Qué le pasa a un modelo de k vecinos si no estandarizas?
¿Qué te dice que la holgura de Cauchy–Schwarz entre dos perfiles sea exactamente 0?
En la etapa 8, ¿qué representa el residual \((3, -3)\) de Camila respecto a la recta de Ana?
TipOrientaciones
El coseno, si «hábitos parecidos» significa la misma proporción entre lectura y práctica. Con coseno, el más parecido es Elena (0.998), seguida de Ana y Bruno empatados (0.9959). Con distancia también gana Elena (3.677) y sigue Ana (4.104), pero Bruno cae al último lugar (9.759) por su cantidad de horas. Las dos medidas coinciden en el primero y discrepan sobre Bruno: la decisión depende de si la intensidad importa para la recomendación.
Porque el producto punto crece con las normas: Bruno mide 11.314 y Elena 5.235, y los dos están casi alineados con Ana. Para comparar parecido sin el efecto del tamaño, divide por las normas (coseno) o mide la distancia.
La columna de ingresos, con un rango de miles o millones, domina la distancia y decide sola quién es vecino, como los minutos de pantalla con Fabián en la etapa 10 (150.056 sin escalar frente a 2.779 tras estandarizar).
Que uno es múltiplo del otro: están sobre la misma recta y su coseno es 1 o −1, como Ana y Bruno.
La parte del perfil de Camila que la dirección de Ana no explica: 3 horas más de lectura y 3 menos de práctica que su proyección \((5, 5)\). Es ortogonal a Ana, con producto punto 0, y es la misma idea del residual de una regresión lineal (capítulo 13).
6.8 Referencias para profundizar
Strang, G. (2023). Introduction to Linear Algebra (6.ª ed.). Wellesley-Cambridge Press. Capítulo 1: vectores, producto punto, longitud y ángulo.
Deisenroth, M. P., Faisal, A. A. y Ong, C. S. (2020). Mathematics for Machine Learning. Cambridge University Press. Capítulo 3 (Analytic Geometry): normas, producto interno, ángulos, ortogonalidad y proyecciones. Versión en PDF gratuita en https://mml-book.github.io/.
Manning, C. D., Raghavan, P. y Schütze, H. (2008). Introduction to Information Retrieval. Cambridge University Press. Capítulo 6: el modelo de espacio vectorial y la similitud coseno entre documentos.
Al vectorizar eliges un espacio, y en ese espacio «cerca» depende de la medida que uses: la distancia mide separación e intensidad, y el coseno mide proporción y dirección.
Un dataset es una matriz \(X\) con \(N\) filas y \(D\) columnas, más un objetivo \(y\) que no entra al espacio de entrada.
La norma mide el tamaño del perfil: Bruno (11.314) duplica a Ana (5.657) con la misma dirección.
El producto punto mezcla tamaño y ángulo; el coseno lo divide por las normas y queda entre −1 y 1 por la desigualdad de Cauchy–Schwarz.
Ana y Bruno tienen coseno 1 y distancia 5.657, la mayor desde Ana; Elena está a 0.447.
La proyección parte un vector en una componente explicada y un residual ortogonal: Camila \((8, 2)\) = \((5, 5)\) + \((3, -3)\).
Sin escalar, una columna en minutos puso a Fabián a 150.056 de Ana; estandarizada, a 2.779.
Con la consulta \((6.5, 6.5)\), el vecino por distancia es Bruno y el vecino por coseno es Ana: cambiar la medida cambia la predicción.
6.10 Puente hacia los siguientes capítulos
Con este capítulo termina la parte descriptiva del libro: centro, dispersión, forma, relación entre variables y geometría, todo sobre los datos que ya tienes. El capítulo 7 cambia la pregunta e introduce la probabilidad, el lenguaje para hablar de lo que todavía no has observado, y el capítulo 8 la lleva a variables aleatorias y sus distribuciones.
La geometría de este capítulo vuelve en la regresión lineal del capítulo 13, donde el ajuste es una proyección y el residual es ortogonal a las variables, y en el nivel Avanzado: el análisis de componentes principales busca en este mismo espacio ejes nuevos que conserven la mayor varianza posible, y los métodos de kernel trabajan con productos punto como los de la matriz de Gram.