Apéndice A — Caso aplicado: mapas de entrega con kernels
estadistica
suavizacion
kernel
caso-practico
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
27 de septiembre de 2026
El problema: estimar tiempos en un mapa
En este caso sintético hay 600 entregas distribuidas sobre una ciudad de 10 × 10 km. Estimas su tiempo medio según la posición y compararás un plano, un polinomio bidimensional, kNN y regresión por kernel. La simulación tiene dos elevaciones locales de tiempo: permite observar qué aproximaciones las representan y cómo cambia el error entre repartos.
Las coordenadas son cartesianas, no latitud y longitud geográficas. La distancia euclídea se mide en kilómetros sobre el plano simulado; el tiempo se expresa en minutos. Una ciudad real exigiría además considerar rutas, barreras, tráfico y fecha de la entrega.
Tiempo estimado de lectura: 35 minutos (algo más de una hora si ejecutas el código)
Los datos son simulados con la fórmula y la semilla (SEMILLA = 2026) declaradas en el código: 600 entregas con posiciones uniformes en la ciudad y un tiempo con dos elevaciones locales más ruido. No proceden de clientes. Todo corre en CPU, y las versiones se imprimen en la primera celda de código.
Objetivos
Al terminar este caso vas a ser capaz de:
reconocer la estructura espacial de esta simulación y las restricciones de los cuatro modelos evaluados (plano, polinomio bidimensional, kNN y kernel);
aplicar la regresión por kernel en dos dimensiones para construir un mapa de predicción;
interpretar el ancho de banda como la escala espacial de influencia en el mapa y elegirlo por validación cruzada;
comparar los cuatro modelos sin fuga de información y repitiendo el reparto de los datos con varias semillas.
Ejecuta las celdas en orden: las secciones comparten variables.
A.1 Preparación del entorno
La celda carga NumPy, Matplotlib y las piezas de scikit-learn que usa el caso, y fija la semilla central.
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.model_selection import train_test_split, KFoldfrom sklearn.linear_model import LinearRegressionfrom sklearn.preprocessing import PolynomialFeaturesfrom sklearn.pipeline import make_pipelinefrom sklearn.neighbors import KNeighborsRegressorfrom sklearn.metrics import r2_score, mean_squared_errorSEMILLA =2026rng = np.random.default_rng(SEMILLA)plt.rcParams['figure.figsize'] = (7, 6)print("librerias cargadas")# Versiones del entorno usado para ejecutar este capítulo.import sysimport importlib.metadata as metadatosprint('Python:', sys.version.split()[0])for paquete in ['numpy', 'pandas', 'matplotlib', 'scipy', 'scikit-learn', 'statsmodels']:print(paquete +':', metadatos.version(paquete))import matplotlib.pyplot as pltfrom cycler import cyclerplt.rcParams['axes.prop_cycle'] = cycler(color=['#1786B3', '#EE5400', '#487A35', '#7851A9']) + cycler(linestyle=['-', '--', '-.', ':'])plt.rcParams['font.size'] =10
El entorno queda con Python 3.13.14, NumPy 2.5.1 y scikit-learn 1.9.0.
Simulas una ciudad de 10×10 km. Cada entrega ocurre en una posición cartesiana (lon, lat), en kilómetros (los nombres cortos solo se usan en el código), y tarda un tiempo que depende de la zona: hay un centro congestionado y otra zona lenta al noroeste, y el resto es más rápido. El ruido simula la variabilidad de cada entrega (un día con más tráfico, un repartidor más ágil). En la práctica no conocerías la fórmula, solo los puntos; la celda reserva la prueba antes de dibujar el entrenamiento.
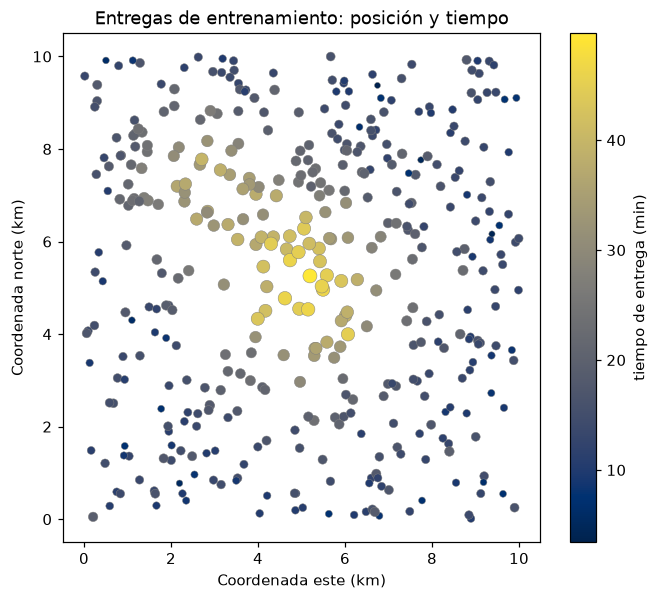
n =600lon = rng.uniform(0, 10, n)lat = rng.uniform(0, 10, n)def tiempo_real(lon, lat): base =12 centro =35* np.exp(-0.5* (((lon -5) /1.6) **2+ ((lat -5) /1.6) **2)) zona_lenta =22* np.exp(-0.5* (((lon -2.5) /1.1) **2+ ((lat -7.5) /1.1) **2))return base + centro + zona_lentatiempo = tiempo_real(lon, lat) + rng.normal(0, 3, n)X = np.column_stack([lon, lat])y = tiempo# Reservar la prueba antes de explorar las observaciones.Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=SEMILLA)plt.scatter(Xtr[:, 0], Xtr[:, 1], c=ytr, cmap='cividis', s=10+1.5*ytr, edgecolor='gray', linewidth=0.3)plt.colorbar(label='tiempo de entrega (min)')plt.xlabel('Coordenada este (km)'); plt.ylabel('Coordenada norte (km)')plt.title('Entregas de entrenamiento: posición y tiempo'); plt.show()print(f'{n} entregas | entrenamiento: {len(ytr)} | tiempo medio de entrenamiento: {ytr.mean():.1f} min | rango de entrenamiento: {ytr.min():.1f}-{ytr.max():.1f} min')
600 entregas | entrenamiento: 420 | tiempo medio de entrenamiento: 19.2 min | rango de entrenamiento: 3.5-49.7 min
La nube muestra solo las entregas de entrenamiento. Los puntos de mayor tiempo se concentran alrededor de (5, 5) km y hacia (2.5, 7.5) km. Son patrones sintéticos conocidos por el procedimiento de generación; en un proyecto real, atribuirlos a congestión requeriría información adicional.
A.3 Preparación para evaluar
La prueba se reservó antes de la primera figura; ahora defines los folds de entrenamiento y una malla que cubre toda la ciudad para dibujar los mapas de calor de cada modelo. El conjunto de prueba no se usará para elegir ningún parámetro: solo para medir, al final, qué modelo generaliza mejor.
# La prueba ya se reservó antes de mostrar la primera nube.kf = KFold(5, shuffle=True, random_state=SEMILLA)# Malla para pintar los mapas de calorgx = np.linspace(0, 10, 60)gy = np.linspace(0, 10, 60)GX, GY = np.meshgrid(gx, gy)malla = np.column_stack([GX.ravel(), GY.ravel()])def mapa(valores, titulo): niveles = np.linspace(-5, 55, 25) relleno = plt.contourf(GX, GY, valores.reshape(GX.shape), levels=niveles, cmap='cividis', extend='both') lineas = plt.contour(GX, GY, valores.reshape(GX.shape), levels=[0, 10, 20, 30, 40, 50], colors='black', linewidths=0.5) plt.clabel(lineas, fmt='%g min', fontsize=8) plt.colorbar(relleno, label='Tiempo estimado (min)') plt.scatter(Xtr[:, 0], Xtr[:, 1], c='black', s=4, alpha=0.25) plt.xlabel('Coordenada este (km)'); plt.ylabel('Coordenada norte (km)'); plt.title(titulo); plt.show()
A.4 Intento 1: regresión lineal
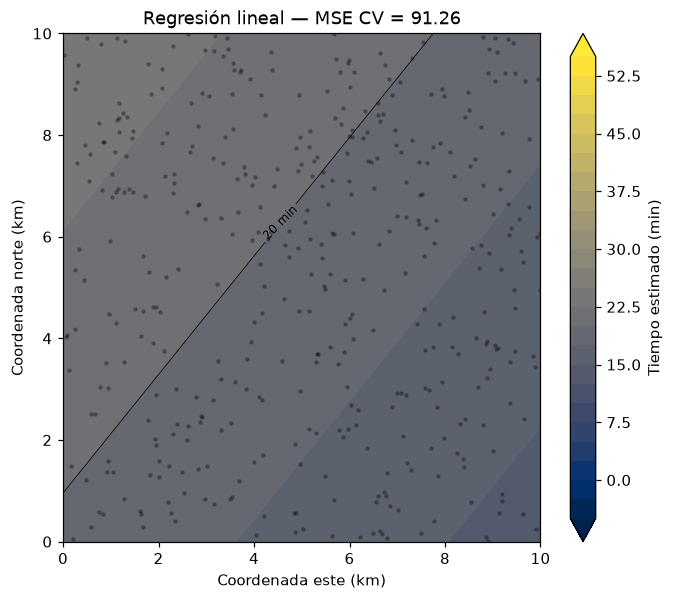
Empiezas por lo más simple, lo que ya conoces: una regresión lineal. Con las 420 entregas de entrenamiento y dos coordenadas, ajusta un plano, en el que el tiempo sube de forma constante en alguna dirección, y la pregunta es si un plano puede representar una ciudad con un centro lento rodeado de zonas rápidas.
lin = LinearRegression().fit(Xtr, ytr)errores_lineal_cv = []for idx_tr, idx_va in kf.split(Xtr): lineal_cv = LinearRegression().fit(Xtr[idx_tr], ytr[idx_tr]) errores_lineal_cv.append(mean_squared_error(ytr[idx_va], lineal_cv.predict(Xtr[idx_va])))mse_lineal_cv = np.mean(errores_lineal_cv)mapa(lin.predict(malla), f'Regresión lineal — MSE CV = {mse_lineal_cv:.2f}')print(f'MSE CV del plano: {mse_lineal_cv:.2f}; la prueba sigue reservada.')
MSE CV del plano: 91.26; la prueba sigue reservada.
El mapa es un gradiente plano: el modelo solo puede decir “el tiempo aumenta hacia tal esquina”, y pinta la ciudad con una rampa de color uniforme. No hay rastro de la mancha central ni de la zona noroeste. El MSE de CV de 91.26 muestra el error del plano sobre bloques reservados del entrenamiento; la prueba sigue cerrada. Es el fracaso esperado: la relación no es lineal ni monótona, y un plano no puede doblarse para envolver un punto caliente en el centro.
A.5 Intento 2: polinomio bidimensional
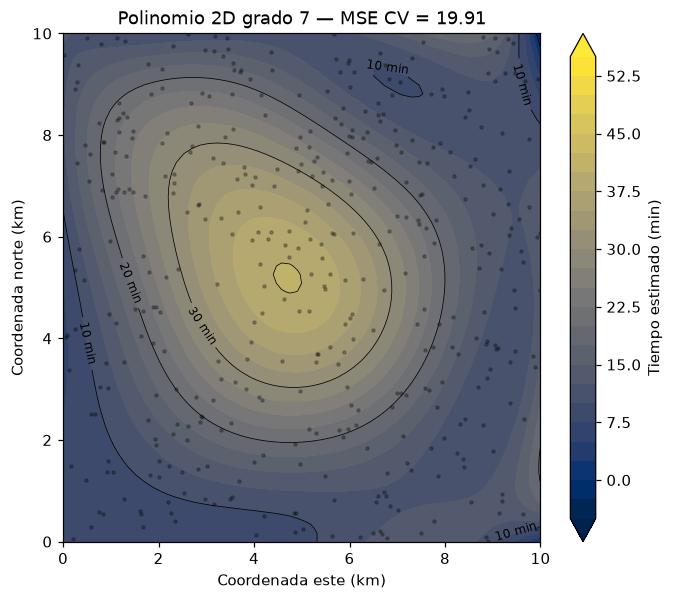
Si un plano no basta, subes la flexibilidad con un polinomio en dos variables (términos como \(lon^2\), \(lat^2\) y \(lon\cdot lat\)), y eliges el grado por validación cruzada sobre el entrenamiento.
grados =list(range(1, 11))kf = KFold(5, shuffle=True, random_state=SEMILLA)# Para cada grado candidato, medimos el error de validación en cada foldcv_g = []for g in grados: errores_folds = []for idx_tr, idx_va in kf.split(Xtr): modelo_g = make_pipeline(PolynomialFeatures(g), LinearRegression()) modelo_g.fit(Xtr[idx_tr], ytr[idx_tr]) pred_va = modelo_g.predict(Xtr[idx_va]) errores_folds.append(mean_squared_error(ytr[idx_va], pred_va)) cv_g.append(np.mean(errores_folds))g_opt = grados[int(np.argmin(cv_g))]print('MSE de validación por grado:')for g, e inzip(grados, cv_g):print(f' grado {g:2d}: {e:10.2f}')poli = make_pipeline(PolynomialFeatures(g_opt), LinearRegression()).fit(Xtr, ytr)# El candidato queda fijado sin abrir la prueba.mapa(poli.predict(malla), f'Polinomio 2D grado {g_opt} — MSE CV = {min(cv_g):.2f}')print(f'Grado elegido por CV: {g_opt} | MSE CV: {min(cv_g):.2f}')
MSE de validación por grado:
  grado  1:      91.26
  grado  2:      48.56
  grado  3:      45.90
  grado  4:      22.94
  grado  5:      21.84
  grado  6:      23.03
  grado  7:      19.91
  grado  8:      20.11
  grado  9:      20.63
  grado 10:      26.11
Grado elegido por CV: 7 | MSE CV: 19.91
La CV selecciona grado 7, con MSE de 19.91. Los grados 8 y 9 dan 20.11 y 20.63; el grado 10 sube a 26.11. El mínimo está dentro de la rejilla de 1 a 10.
El candidato queda fijado con MSE CV de 19.91; su evaluación de prueba se presenta junto a los otros modelos al final. Su expansión tiene 36 columnas incluyendo la constante. El mapa aproxima variación local, pero en la malla llega a unos −2.82 minutos, un valor imposible. Esa predicción alerta sobre comportamiento fuera de las zonas bien respaldadas por observaciones; este resultado no demuestra que todos los polinomios bidimensionales sean inadecuados.
A.6 La idea local: kernel en dos dimensiones
Vuelve a la intuición del problema: para estimar el tiempo en un punto del mapa, lo natural es promediar las entregas cercanas, dándoles más peso cuanto más cerca estén. Eso es la regresión por kernel, ahora con la distancia medida en el plano:
\[\hat{m}(x) = \frac{\sum_{i} K\!\left(\frac{\lVert x - x_i \rVert}{h}\right) y_i}{\sum_{i} K\!\left(\frac{\lVert x - x_i \rVert}{h}\right)}\]
donde \(\lVert x - x_i \rVert\) es la distancia entre dos puntos del mapa y \(h\) es el ancho de banda, en kilómetros. Para el gaussiano es una escala de distancia, no un radio de corte: todos los datos tienen peso matemáticamente positivo y los lejanos pesan menos. La distancia elegida también introduce una estructura sobre la cercanía.
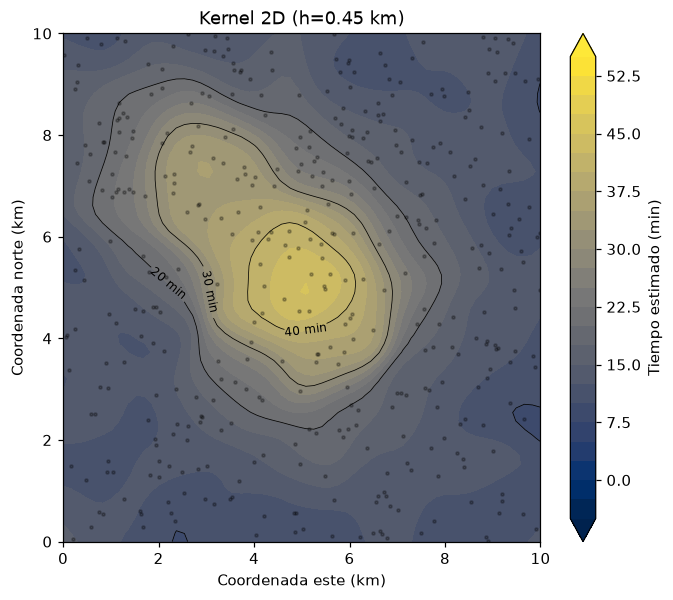
def kernel_2d(Xtr, ytr, Xq, h): Xtr = np.asarray(Xtr, dtype=float) ytr = np.asarray(ytr, dtype=float) Xq = np.asarray(Xq, dtype=float) h = np.asarray(h, dtype=float)if Xtr.ndim !=2or Xtr.shape[1] !=2or Xq.ndim !=2or Xq.shape[1] !=2:raiseValueError('Xtr y Xq deben tener dos columnas de coordenadas.')if ytr.ndim !=1orlen(ytr) !=len(Xtr) orlen(ytr) ==0:raiseValueError('ytr debe ser un vector no vacío, alineado con Xtr.')ifnotall(np.isfinite(a).all() for a in (Xtr, ytr, Xq)):raiseValueError('Las coordenadas y los tiempos deben ser finitos.')if h.ndim !=0ornot np.isfinite(h) or h <=0:raiseValueError('h debe ser un escalar finito y positivo.') out = np.empty(len(Xq))for i, q inenumerate(Xq):with np.errstate(over='ignore', invalid='ignore'): log_w =-0.5* np.sum(((Xtr - q) / h) **2, axis=1)ifnot np.isfinite(log_w).any():raiseValueError('Reescala las distancias o revisa h.') w = np.exp(log_w - np.max(log_w)) out[i] = np.sum((w / w.sum()) * ytr)return outmapa_kernel = kernel_2d(Xtr, ytr, malla, h=0.45)mapa(mapa_kernel, 'Kernel 2D (h=0.45 km)')
Con ancho de banda de 0.45 km, el mapa muestra una elevación central y otra contribución hacia el noroeste. Los contornos etiquetados expresan minutos y permiten leer los tiempos sin depender solo del color. El mapa es una estimación del promedio local; en regiones poco observadas su apariencia suave no garantiza predicciones confiables.
A.7 El ancho de banda regula la escala espacial
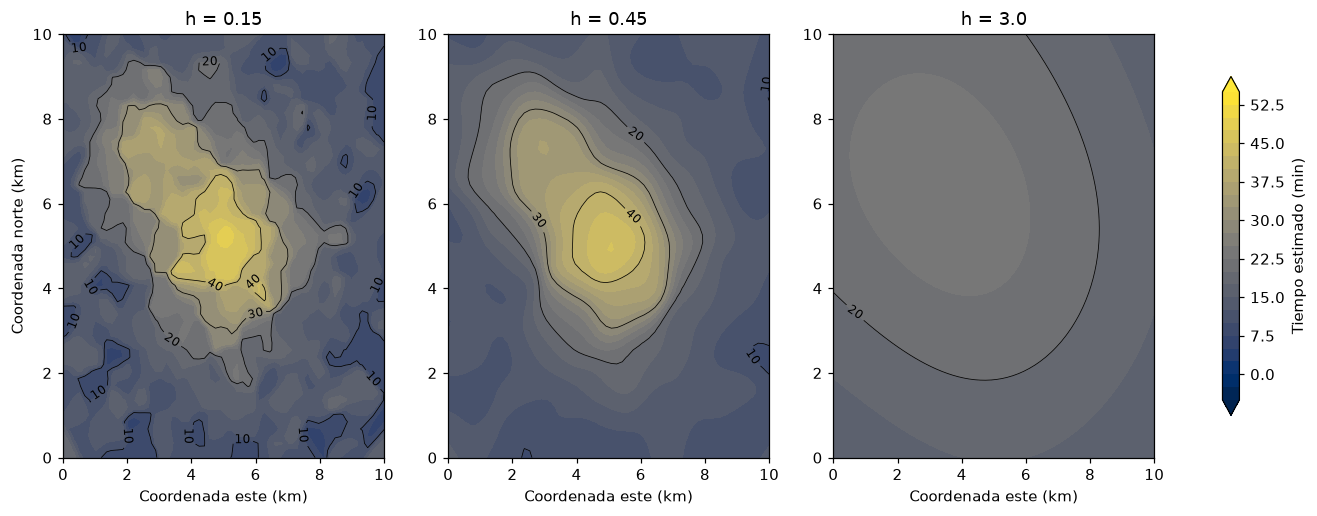
Compara 0.15, 0.45 y 3.0 km sobre el mismo entrenamiento. Con el kernel gaussiano no hay una frontera que deje fuera a todos los puntos lejanos: el peso decrece gradualmente. El valor 0.45 es una configuración ilustrativa; después se contrastará mediante CV.
Con \(h = 0.15\) km el mapa se ve manchado y lleno de parches sueltos, incluso donde no pasa nada, porque cada punto promedia muy pocos vecinos y el ruido pasa directo al mapa: es un sobreajuste. Con \(h = 0.45\) km la mancha central y el lóbulo del noroeste se ven limpios y suaves, sin parches espurios. Con \(h = 3.0\) km el promedio abarca buena parte de la ciudad y el mapa se reduce a una sola mancha borrosa, desplazada hacia el noroeste, donde ya no distingues el centro de la otra zona: es un subajuste. La validación cruzada de la sección siguiente decide entre estos extremos.
A.8 Elegir el radio por validación
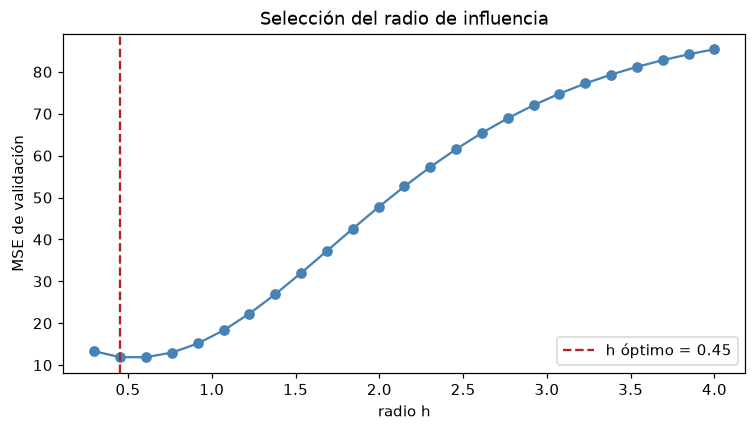
Como en el capítulo de métodos de kernel, no eliges \(h\) a simple vista: pruebas 25 valores entre 0.3 y 4.0 km por validación cruzada sobre el entrenamiento y te quedas con el de menor error.
hs = np.linspace(0.3, 4.0, 25)# Para cada radio candidato, medimos el error de validación en cada foldcv_h = []for h in hs: errores_folds = []for idx_tr, idx_va in kf.split(Xtr): pred_va = kernel_2d(Xtr[idx_tr], ytr[idx_tr], Xtr[idx_va], h) errores_folds.append(mean_squared_error(ytr[idx_va], pred_va)) cv_h.append(np.mean(errores_folds))h_opt = hs[int(np.argmin(cv_h))]plt.figure(figsize=(8, 4))plt.plot(hs, cv_h, marker='o', color='steelblue')plt.axvline(h_opt, color='firebrick', linestyle='--', label=f'h óptimo = {h_opt:.2f}')plt.xlabel('radio h'); plt.ylabel('MSE de validación'); plt.legend()plt.title('Selección del radio de influencia'); plt.show()print(f'h óptimo (validación cruzada): {h_opt:.2f} | MSE de validación: {min(cv_h):.2f}')
h óptimo (validación cruzada): 0.45 | MSE de validación: 11.89
La curva vuelve a tener forma de U: radios muy pequeños sobreajustan, radios muy grandes difuminan (el error sube sin parar), y el mínimo queda en h = 0.45, con un MSE de validación cercano a 12. Ese es el mismo valor que usaste como caso “equilibrado” en el panel de tres radios, así que lo que viste a simple vista coincide con lo que elige la validación. Fíjate también en que el fondo de la U es plano entre 0.45 y 0.6: valores cercanos rinden casi igual, de modo que no necesitas afinar el radio al milímetro. El punto de la izquierda (h = 0.3) ya sube, señal de que el mínimo es real y no un efecto del borde del rango. Ese es el radio de la comparación final.
A.9 Comparación final: los cuatro modelos, lado a lado
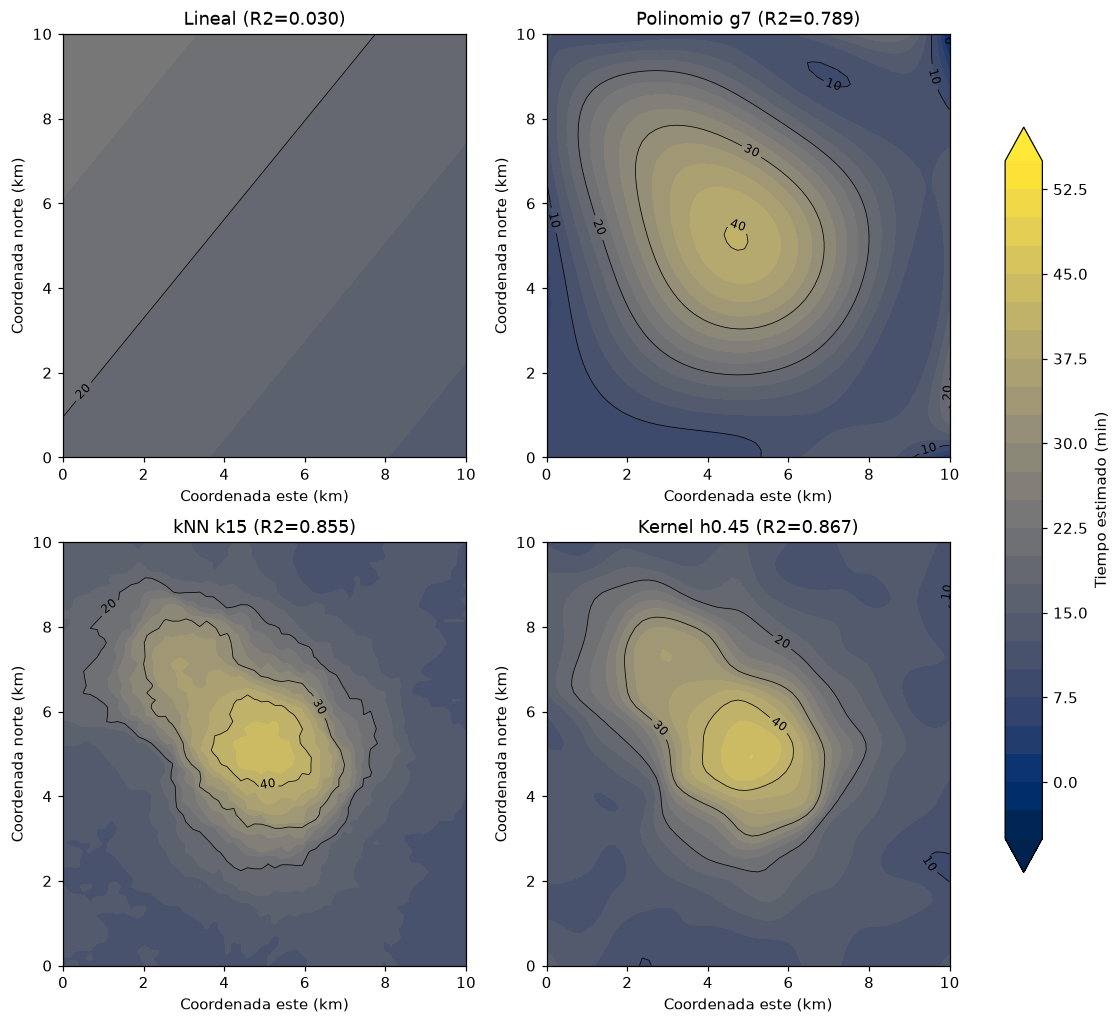
Pones a competir los cuatro enfoques sobre datos de prueba que no se usaron para elegir nada, y añades los k-vecinos (kNN), otro método local, con \(k\) elegido por validación cruzada entre 3 y 30. Primero miras los cuatro mapas de un mismo reparto de datos; después repites todo con varios repartos para ver cuánto de lo observado depende del azar de la partición.
ks =list(range(3, 31))# Para cada número de vecinos k, medimos el error de validación en cada foldcv_k = []for k in ks: errores_folds = []for idx_tr, idx_va in kf.split(Xtr): modelo_k = KNeighborsRegressor(n_neighbors=k) modelo_k.fit(Xtr[idx_tr], ytr[idx_tr]) pred_va = modelo_k.predict(Xtr[idx_va]) errores_folds.append(mean_squared_error(ytr[idx_va], pred_va)) cv_k.append(np.mean(errores_folds))k_opt = ks[int(np.argmin(cv_k))]knn = KNeighborsRegressor(n_neighbors=k_opt).fit(Xtr, ytr)r2_lin = r2_score(yte, lin.predict(Xte))r2_pol = r2_score(yte, poli.predict(Xte))r2_knn = r2_score(yte, knn.predict(Xte))r2_ker = r2_score(yte, kernel_2d(Xtr, ytr, Xte, h_opt))modelos = {f'Lineal (R2={r2_lin:.3f})': lin.predict(malla),f'Polinomio g{g_opt} (R2={r2_pol:.3f})': poli.predict(malla),f'kNN k{k_opt} (R2={r2_knn:.3f})': knn.predict(malla),f'Kernel h{h_opt:.2f} (R2={r2_ker:.3f})': kernel_2d(Xtr, ytr, malla, h_opt),}fig, ax = plt.subplots(2, 2, figsize=(13, 11))for a, (titulo, val) inzip(ax.ravel(), modelos.items()): cf = a.contourf(GX, GY, val.reshape(GX.shape), levels=np.linspace(-5, 55, 25), cmap='cividis', extend='both') lineas = a.contour(GX, GY, val.reshape(GX.shape), levels=[0, 10, 20, 30, 40, 50], colors='black', linewidths=0.5) a.clabel(lineas, fmt='%g', fontsize=8) a.set_title(titulo); a.set_xlabel('Coordenada este (km)'); a.set_ylabel('Coordenada norte (km)')fig.colorbar(cf, ax=ax.ravel().tolist(), label='Tiempo estimado (min)', shrink=0.8)plt.show()
La tabla siguiente reúne los cuatro R² de la prueba reservada con semilla 2026, después de fijar las configuraciones mediante CV del entrenamiento.
print(f'R2 en prueba, split con semilla {SEMILLA} (no usado para elegir parámetros)')print(f' Lineal: {r2_lin:.3f}')print(f' Polinomio 2D: {r2_pol:.3f}')print(f' kNN: {r2_knn:.3f}')print(f' Kernel 2D: {r2_ker:.3f}')
R2 en prueba, split con semilla 2026 (no usado para elegir parámetros)
  Lineal:          0.030
  Polinomio 2D:    0.789
  kNN:             0.855
  Kernel 2D:       0.867
A.10 ¿Y si cambia el reparto? La comparación con varias semillas
Los R² de la tabla anterior corresponden al reparto entrenamiento/prueba con semilla 2026. Otra semilla mandaría otros puntos al conjunto de prueba, y diferencias de un centésimo pueden ser puro azar del reparto.
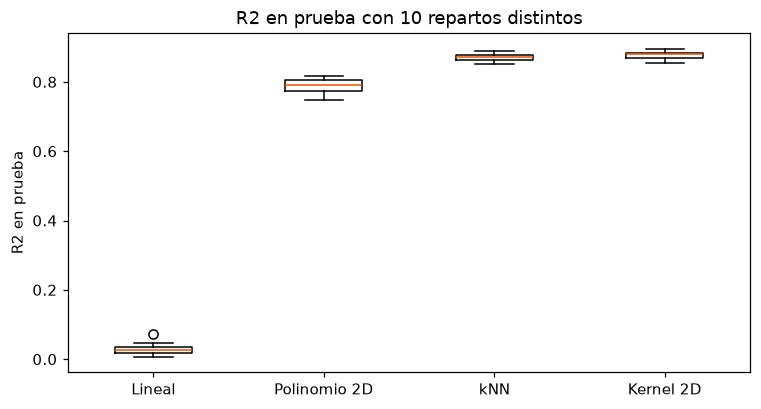
Para comprobarlo, repites todo el protocolo con 10 semillas distintas: en cada una separas, eliges \(g\), \(k\) y \(h\) por validación cruzada solo con el entrenamiento de esa semilla y mides el R² en su prueba. Al final reportas el promedio y la desviación de cada modelo. Para que no tarde demasiado, aquí usas rejillas de hiperparámetros algo más gruesas que en las secciones anteriores.
semillas =list(range(10))grados_m =list(range(1, 11))ks_m =list(range(3, 31, 3))hs_m = np.linspace(0.3, 2.0, 10)r2_por_modelo = {'Lineal': [], 'Polinomio 2D': [], 'kNN': [], 'Kernel 2D': []}for semilla in semillas: Xtr_s, Xte_s, ytr_s, yte_s = train_test_split(X, y, test_size=0.3, random_state=semilla) kf_s = KFold(5, shuffle=True, random_state=semilla)# Lineal: no tiene hiperparámetros lin_s = LinearRegression().fit(Xtr_s, ytr_s) r2_por_modelo['Lineal'].append(r2_score(yte_s, lin_s.predict(Xte_s)))# Polinomio: elegir el grado por validación cruzada cv_grados = []for g in grados_m: errores = []for i_tr, i_va in kf_s.split(Xtr_s): m = make_pipeline(PolynomialFeatures(g), LinearRegression()) m.fit(Xtr_s[i_tr], ytr_s[i_tr]) errores.append(mean_squared_error(ytr_s[i_va], m.predict(Xtr_s[i_va]))) cv_grados.append(np.mean(errores)) g_s = grados_m[int(np.argmin(cv_grados))]assert grados_m[0] < g_s < grados_m[-1], "Amplía la rejilla de grados." poli_s = make_pipeline(PolynomialFeatures(g_s), LinearRegression()).fit(Xtr_s, ytr_s) r2_por_modelo['Polinomio 2D'].append(r2_score(yte_s, poli_s.predict(Xte_s)))# kNN: elegir k por validación cruzada cv_ks = []for k in ks_m: errores = []for i_tr, i_va in kf_s.split(Xtr_s): m = KNeighborsRegressor(n_neighbors=k).fit(Xtr_s[i_tr], ytr_s[i_tr]) errores.append(mean_squared_error(ytr_s[i_va], m.predict(Xtr_s[i_va]))) cv_ks.append(np.mean(errores)) k_s = ks_m[int(np.argmin(cv_ks))]assert ks_m[0] < k_s < ks_m[-1], "Amplía la rejilla de vecinos." knn_s = KNeighborsRegressor(n_neighbors=k_s).fit(Xtr_s, ytr_s) r2_por_modelo['kNN'].append(r2_score(yte_s, knn_s.predict(Xte_s)))# Kernel: elegir el radio h por validación cruzada cv_hs = []for h in hs_m: errores = []for i_tr, i_va in kf_s.split(Xtr_s): pred = kernel_2d(Xtr_s[i_tr], ytr_s[i_tr], Xtr_s[i_va], h) errores.append(mean_squared_error(ytr_s[i_va], pred)) cv_hs.append(np.mean(errores)) h_s = hs_m[int(np.argmin(cv_hs))]assert hs_m[0] < h_s < hs_m[-1], "Amplía la rejilla de h." r2_por_modelo['Kernel 2D'].append(r2_score(yte_s, kernel_2d(Xtr_s, ytr_s, Xte_s, h_s)))print(f'R2 en prueba con {len(semillas)} semillas (promedio ± desviación)')for nombre, valores in r2_por_modelo.items():print(f' {nombre:<14s}{np.mean(valores):.3f} ± {np.std(valores, ddof=1):.3f}')# Diferencia kernel - kNN, semilla por semilla (mismo reparto para ambos)dif = np.array(r2_por_modelo['Kernel 2D']) - np.array(r2_por_modelo['kNN'])print(f'\nKernel - kNN: {dif.mean():+.3f} ± {dif.std(ddof=1):.3f} 'f'| el kernel gana en {int((dif >0).sum())} de {len(semillas)} semillas')dif_pol = np.array(r2_por_modelo['Kernel 2D']) - np.array(r2_por_modelo['Polinomio 2D'])print(f'Kernel - Polinomio: {dif_pol.mean():+.3f} ± {dif_pol.std(ddof=1):.3f} 'f'| el kernel gana en {int((dif_pol >0).sum())} de {len(semillas)} semillas')plt.figure(figsize=(8, 4))plt.boxplot(list(r2_por_modelo.values()))plt.xticks(range(1, 5), list(r2_por_modelo.keys()))plt.ylabel('R2 en prueba')plt.title(f'R2 en prueba con {len(semillas)} repartos distintos')plt.show()
R2 en prueba con 10 semillas (promedio ± desviación)
  Lineal         0.030 ± 0.018
  Polinomio 2D   0.788 ± 0.023
  kNN            0.871 ± 0.011
  Kernel 2D      0.876 ± 0.012

Kernel - kNN: +0.005 ± 0.005 | el kernel gana en 8 de 10 semillas
Kernel - Polinomio: +0.089 ± 0.026 | el kernel gana en 10 de 10 semillas
En los diez repartos de los mismos 600 datos, los resultados son:
Modelo
R² de prueba, media ± desviación entre repartos
Lineal
0.030 ± 0.018
Polinomio 2D
0.788 ± 0.023
kNN
0.871 ± 0.011
Kernel 2D
0.876 ± 0.012
La diferencia pareada kernel menos polinomio es +0.089 ± 0.026; el kernel obtiene mayor puntuación en 10 de 10 repartos. Frente a kNN la diferencia es +0.005 ± 0.005, con mayor puntuación en 8 de 10. Son descripciones de estos repartos dependientes, no pruebas de significancia ni demostraciones de equivalencia.
El kernel produce un mapa más suave que kNN con pesos uniformes. Esa propiedad puede facilitar la lectura, pero no demuestra mayor utilidad operativa. Para decidir necesitarías costos de error, cobertura espacial y análisis de los lugares con pocos datos.
Las diez semillas reutilizan la misma muestra. Su desviación resume sensibilidad a las particiones y no cuantifica toda la incertidumbre ante entregas nuevas.
A.11 Qué demuestra esta comparación bidimensional
El plano obtiene \(R^2\) medio de 0.030 porque una sola pendiente por coordenada representa mal las dos elevaciones locales simuladas. El polinomio de la rejilla mejora hasta 0.788 de media, y los métodos locales alcanzan 0.871 y 0.876. Estas diferencias corresponden a los datos, candidatos y distancias de este caso.
Dos dimensiones no hacen fracasar por definición a los modelos globales. También existen splines tensoriales, modelos aditivos y otros modelos espaciales que aquí no se evalúan. La fórmula del kernel se extiende a más coordenadas, pero con una muestra fija las vecindades pierden información al aumentar la dimensión: la simplicidad de la expresión no elimina esa dificultad.
A.12 Errores comunes en problemas espaciales con kernels
Síntoma
Causa probable
Solución
El mapa se ve manchado y ruidoso
radio h demasiado pequeño
súbelo; elígelo por validación
Las zonas se funden en una mancha
radio h demasiado grande
bájalo
Predicciones raras lejos de los datos
zonas del mapa sin entregas cercanas
no predigas donde no hay soporte
Una variable domina la distancia
coordenadas o unidades incompatibles
usa una proyección y distancia adecuadas; estandarizar no reemplaza la geometría geográfica
Muy lento con muchos datos
el promedio recorre todos los puntos
usa estructuras de vecindad (árboles KD)
En esta simulación las observaciones se generan de forma independiente y los repartos aleatorios evalúan interpolación bajo el mismo mecanismo. Para zonas nuevas usa bloques espaciales; para fechas nuevas, una partición temporal (capítulo de series temporales). No interpretes el R² aleatorio como evidencia de ambos usos.
A.13 Preguntas de comprensión
¿Por qué los cuatro mapas comparten la misma escala de color y contornos etiquetados?
El polinomio de grado 7 predice −2.82 minutos en una parte de la malla. ¿Qué te dice ese valor sobre el modelo?
Con 10 semillas, el kernel supera a kNN por 0.005 de \(R^2\) en 8 de 10 repartos. ¿Puedes concluir que el kernel es mejor?
¿Qué cambiarías en la evaluación para predecir tiempos en barrios sin antecedentes de entregas?
TipOrientaciones
Para que un mismo color exprese el mismo número de minutos en todos los paneles; los contornos etiquetados permiten comparar sin depender solo del color.
Que en zonas con poco respaldo de datos el polinomio global extrapola valores imposibles, como el polinomio de grado alto del capítulo de splines. No demuestra que todo polinomio bidimensional sea inadecuado, pero sí que su mapa no es confiable lejos de las observaciones.
No. Los diez repartos reutilizan los mismos 600 datos y no son independientes, y la diferencia (+0.005 ± 0.005) es del tamaño de su propia variación. Es una descripción de este caso, no una prueba de superioridad; la decisión depende también de costos de error, cobertura espacial y facilidad de lectura del mapa.
Evaluaría por bloques espaciales, dejando fuera zonas enteras de la ciudad en cada fold, conservaría una distancia física apropiada y comprobaría que hay soporte local antes de predecir. El reparto aleatorio mide interpolación entre entregas del mismo mecanismo, no predicción en zonas nuevas.
A.14 Referencias para profundizar
Hastie, T., Tibshirani, R. y Friedman, J. (2009). The Elements of Statistical Learning (2.ª ed.). Springer. El capítulo 6 trata los métodos de kernel en varias dimensiones y sus límites.
Roberts, D. R., Bahn, V., Ciuti, S., Boyce, M. S., Elith, J., Guillera-Arroita, G., et al. (2017). Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure. Ecography, 40(8), 913–929. Por qué los datos espaciales piden validación por bloques.
En un mapa, la regresión por kernel promedia las entregas cercanas y su ancho de banda fija la escala espacial; la ventaja de un método local se comprueba con varias particiones y con la evaluación que corresponde al uso.
El plano no puede representar dos elevaciones locales: \(R^2\) medio de 0.030 en diez repartos.
El polinomio de grado 7 mejoró a 0.788, pero predijo valores imposibles (−2.82 minutos) donde los datos no lo respaldan.
La validación cruzada eligió \(h=0.45\) km (MSE de 11.89), el mismo valor que a la vista parecía equilibrado; el kernel gaussiano usa ese ancho como escala, no como radio de corte.
Los métodos locales alcanzaron 0.871 (kNN) y 0.876 (kernel), con una diferencia de 0.005 entre ellos que no establece superioridad.
Los mapas comparan bien solo si comparten escala de minutos y contornos.
Con datos reales, interpolar, predecir en zonas nuevas y pronosticar fechas nuevas son objetivos distintos, cada uno con su partición.
A.16 Puente hacia los siguientes capítulos
Con este caso cierras la suavización: llevaste la regresión por kernel de una dimensión a un mapa, con una comparación que separa lo que dicen los datos de lo que depende del reparto. El tema siguiente cambia de pregunta: qué hacer cuando lo que quieres predecir es una categoría (entrega a tiempo, sí o no) o un conteo (número de incidencias). Ahí entran los modelos lineales generalizados y su extensión, los modelos aditivos, que combinan esas respuestas con suavizadores como los de estos capítulos.