import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA, FastICA

SEMILLA = 2026
rng = np.random.default_rng(SEMILLA)

plt.rcParams['figure.figsize'] = (9, 3.2)
plt.rcParams['axes.spines.top'] = False
plt.rcParams['axes.spines.right'] = False

NOMBRES_FUENTES = ['senoidal', 'cuadrada', 'diente de sierra']
NOMBRES_MICROS = ['micrófono 1', 'micrófono 2', 'micrófono 3']


def kurtosis_exceso(x):
    z = (x - np.mean(x)) / np.std(x)
    return np.mean(z ** 4) - 3


def graficar_senales(series, titulos, color, titulo_figura):
    n_senales = series.shape[1]
    fig, axes = plt.subplots(n_senales, 1, figsize=(9, 5.6), sharex=True)
    for i in range(n_senales):
        axes[i].plot(t, series[:, i], color=color, linewidth=0.85)
        axes[i].set_ylabel(titulos[i], fontsize=9)
        axes[i].set_xlim(t.min(), t.max())
    axes[-1].set_xlabel('tiempo')
    fig.suptitle(titulo_figura, y=1.01)
    plt.tight_layout()
plt.show()26 Variables latentes II: Análisis de Componentes Independientes (ICA)
estadistica
variables-latentes
ica
Cuando la varianza ya no es la pregunta correcta
En el capítulo anterior usaste PCA para encontrar direcciones nuevas: las de máxima varianza. Esa es la herramienta natural cuando quieres comprimir, visualizar o quitar redundancia entre columnas.
Ahora cambia la pregunta. Imagina una fiesta con tres conversaciones a la vez y tres micrófonos en sitios distintos. Cada grabación es una mezcla de las tres voces. Tú no oyes a nadie por separado: oyes un enredo. ¿Se puede recuperar cada voz si solo tienes las mezclas?
Eso es el problema del cóctel. PCA no lo resuelve: decorrelaciona y ordena por varianza, pero no separa fuentes. El análisis de componentes independientes (ICA) busca otra cosa: direcciones estadísticamente independientes. En este capítulo vas a ver el contraste que importa, con señales sintéticas que puedes reconocer a simple vista: PCA no recupera las fuentes; ICA sí.
Objetivos de aprendizaje
Al terminar este capítulo vas a ser capaz de:
- Plantear el problema del cóctel: recuperar fuentes independientes a partir de mezclas lineales.
- Escribir el modelo generativo \(\mathbf{x}(t) = A\mathbf{s}(t)\) y el papel de la matriz de separación \(W\).
- Explicar por qué ICA exige fuentes independientes y no gaussianas.
- Mostrar con datos por qué PCA decorrelaciona pero no separa las voces.
- Aplicar FastICA y comparar visualmente fuentes, componentes de PCA y señales recuperadas.
- Reconocer las ambigüedades de orden y de escala/signo, y el caso en el que ICA no es identificable.
- Decidir cuándo usar PCA y cuándo usar ICA.
Preparación del entorno
El problema del cóctel
Tres personas hablan al mismo tiempo. Tres micrófonos, colocados a distintas distancias, graban. El micrófono cercano a la primera voz la capta más fuerte, pero también capta las otras dos. Nadie te entrega las pistas por separado: solo tienes tres pistas mezcladas.
La pregunta de ICA no es “¿cuál combinación explica más varianza?”. Es esta: si las voces originales eran independientes, ¿puedo deshacer la mezcla y recuperar cada una?
Para poder juzgar a simple vista si el método funciona, vamos a fabricar las voces. En un problema real no las verías; aquí sí, y eso convierte el experimento en una prueba visible.
Tres fuentes que puedes reconocer
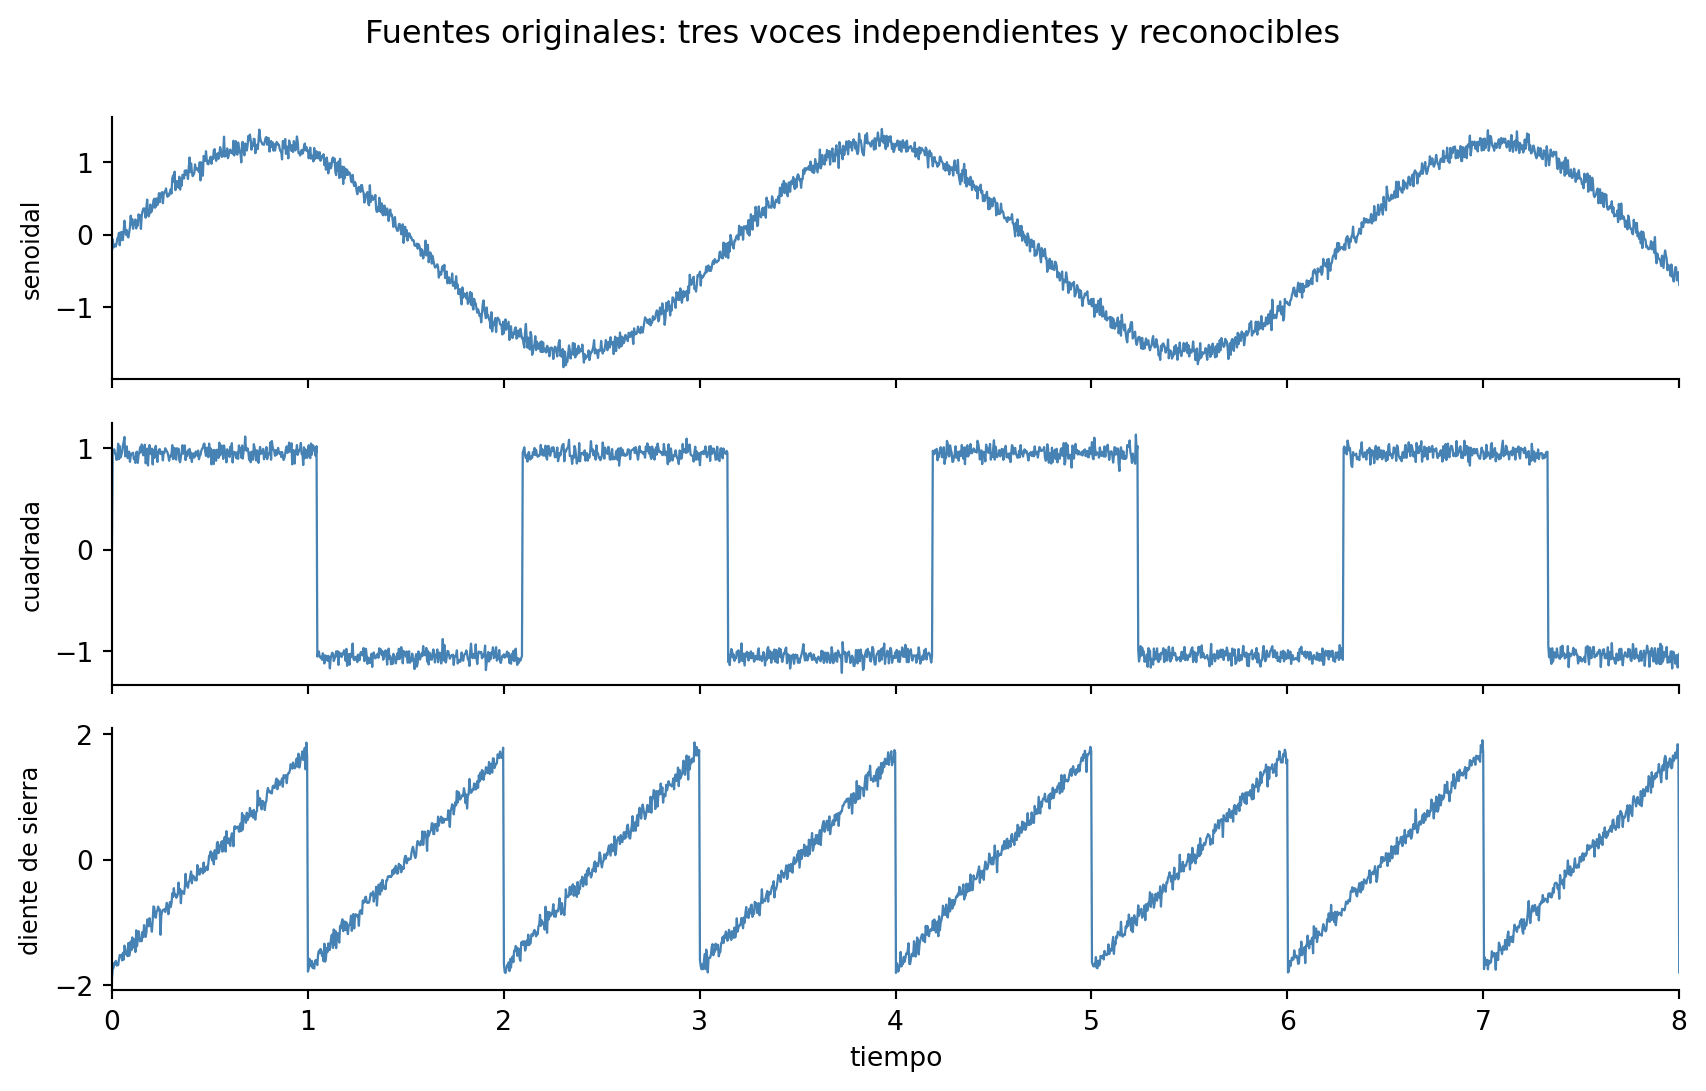
Generamos \(n = 2000\) instantes de tres señales construidas por separado —ninguna se obtiene a partir de otra— y muy distintas entre sí. Cada instante cuenta como una observación, y en ese sentido tratamos las tres señales como fuentes independientes:
- una senoidal suave,
- una cuadrada, que solo toma dos niveles,
- un diente de sierra, con subidas lineales y caídas bruscas.
Les añadimos un ruido de medición pequeño y las estandarizamos. La semilla queda fija para que el experimento sea reproducible.
n = 2000
t = np.linspace(0, 8, n)

senoidal = np.sin(2 * t)
cuadrada = np.sign(np.sin(3 * t))
diente = 2 * (np.mod(t, 1) - 0.5)

fuentes = np.column_stack([senoidal, cuadrada, diente])
fuentes = fuentes + 0.05 * rng.normal(size=fuentes.shape)
fuentes = (fuentes - fuentes.mean(axis=0)) / fuentes.std(axis=0)

print(f'{n} instantes | {fuentes.shape[1]} fuentes')
print('Media de cada fuente:', ', '.join(f'{round(float(m), 3):.3f}' for m in fuentes.mean(axis=0)))
print('Desviación de cada fuente:', ', '.join(f'{s:.3f}' for s in fuentes.std(axis=0)))
2000 instantes | 3 fuentes
Media de cada fuente: -0.000, 0.000, 0.000
Desviación de cada fuente: 1.000, 1.000, 1.000graficar_senales(
fuentes,
NOMBRES_FUENTES,
color='steelblue',
titulo_figura='Fuentes originales: tres voces independientes y reconocibles',
)
Cómo leer este resultado
Las tres trazas son distintas a simple vista. La senoidal oscila con suavidad, la cuadrada salta entre dos valores y el diente de sierra sube en rampa. Esas formas características son la referencia verdadera (ground truth) del experimento: más adelante vas a preguntarte si PCA o ICA te las devuelven.
Las medias quedan en 0.000 y las desviaciones en 1.000 porque estandarizamos. ICA (y PCA) trabajan con esa escala; la forma de cada señal es lo que importa, no su unidad original.
Lo que captan los micrófonos
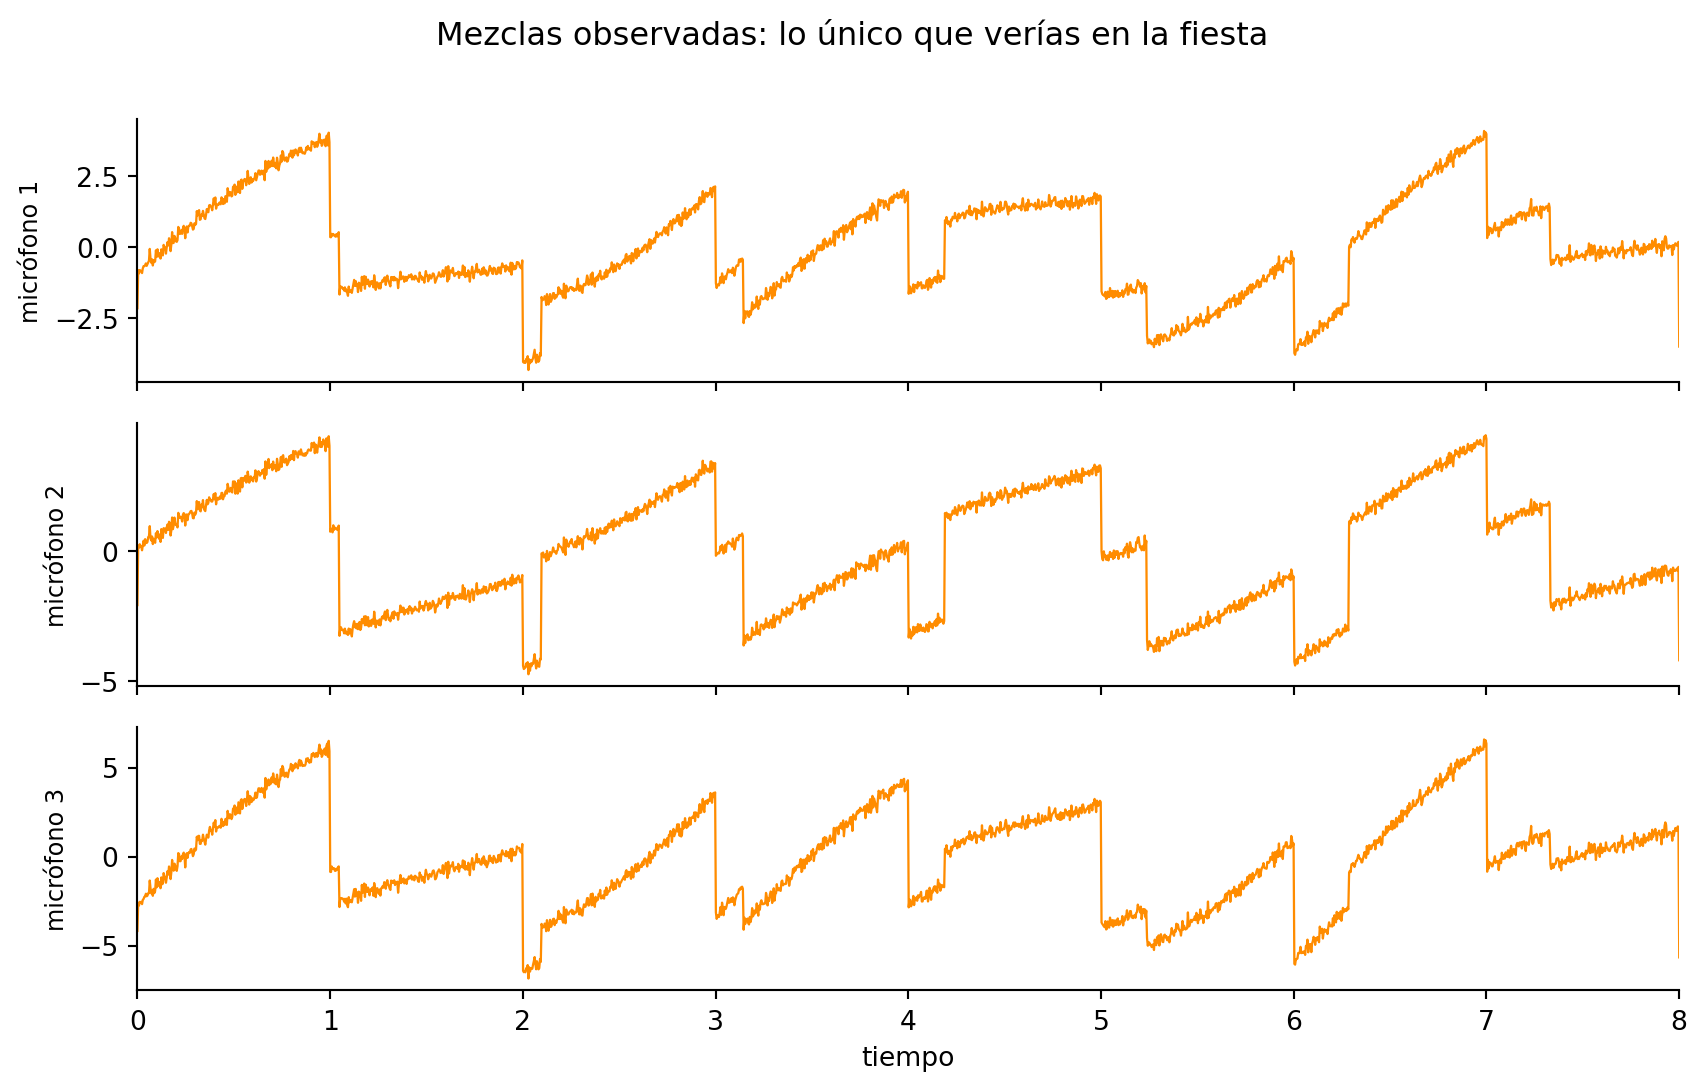
Cada micrófono graba una combinación lineal de las tres fuentes. Eso se resume en una matriz de mezcla \(A\): la fila \(i\) dice con qué peso entra cada voz en el micrófono \(i\).
En la fiesta no conoces \(A\). Aquí sí la fijamos, para fabricar las grabaciones y después olvidarla: PCA e ICA solo van a ver las mezclas.
A = np.array([
    [1.0, 1.0, 1.0],
    [0.5, 2.0, 1.0],
    [1.5, 1.0, 2.0],
])
mezclas = fuentes @ A.T

print('Matriz de mezcla A (filas = micrófonos, columnas = fuentes):')
print(pd.DataFrame(
    A,
    index=NOMBRES_MICROS,
    columns=NOMBRES_FUENTES,
))
print()
print('Forma de las mezclas:', mezclas.shape)
Matriz de mezcla A (filas = micrófonos, columnas = fuentes):
senoidal cuadrada diente de sierra
micrófono 1 1.0 1.0 1.0
micrófono 2 0.5 2.0 1.0
micrófono 3 1.5 1.0 2.0
Forma de las mezclas: (2000, 3)graficar_senales(
mezclas,
NOMBRES_MICROS,
color='darkorange',
titulo_figura='Mezclas observadas: lo único que verías en la fiesta',
)
Cómo leer este resultado
Fíjate en el cambio: ya no ves ninguna de las tres formas limpias. Las rampas del diente siguen asomando, pero mezcladas con los saltos de la cuadrada y la ondulación de la senoidal. Cada micrófono capta las tres voces con pesos distintos. El micrófono 2, por ejemplo, carga más la cuadrada (peso 2.0) que la senoidal (peso 0.5), pero aun así la pista sigue siendo un enredo.
Este es el dato de trabajo. A partir de aquí, finge que las fuentes azules desaparecieron. Solo existen las naranjas.
corr_mezclas = pd.DataFrame(
    np.corrcoef(mezclas.T).round(3),
    index=NOMBRES_MICROS,
    columns=NOMBRES_MICROS,
)
print('Correlación entre micrófonos:')
corr_mezclas
Correlación entre micrófonos:| micrófono 1 | micrófono 2 | micrófono 3 | |
|---|---|---|---|
| micrófono 1 | 1.000 | 0.891 | 0.963 |
| micrófono 2 | 0.891 | 1.000 | 0.778 |
| micrófono 3 | 0.963 | 0.778 | 1.000 |
Cómo leer este resultado
Las tres grabaciones están fuertemente correlacionadas: \(0.891\) entre los micrófonos 1 y 2, \(0.963\) entre 1 y 3, \(0.778\) entre 2 y 3. Eso es esperable: comparten las mismas voces, solo que con pesos distintos.
Correlación y dependencia no son lo mismo, pero una correlación tan alta ya te avisa de que hay redundancia. PCA va a aprovechar esa redundancia para comprimir. ICA va a intentar algo más ambicioso: desenredar las voces que produjeron esa redundancia.
El modelo generativo
El cóctel se escribe en una línea. En cada instante \(t\), el vector de micrófonos \(\mathbf{x}(t)\) es una mezcla lineal de las fuentes \(\mathbf{s}(t)\):
\[ \mathbf{x}(t) = A\mathbf{s}(t). \]
\(A\) es la matriz de mezcla (desconocida). Lo único observado es \(\mathbf{x}(t)\). ICA busca una matriz de separación \(W\) tal que
\[ \hat{\mathbf{s}}(t) = W\mathbf{x}(t) \]
recupere las fuentes. Si el modelo es identificable, \(W\) coincide con \(A^{-1}\) salvo una permutación de filas y un reescalado (incluido un cambio de signo). Esas dos ambigüedades no son un error del software: son parte del método, y las vamos a ver en los datos.
En forma matricial, con cada fila de \(S\) y de \(X\) como un instante,
\[ X = S A^{\top}. \]
Esa es exactamente la cuenta que usamos para fabricar mezclas.
El supuesto que PCA no usa
Dos condiciones hacen que ICA pueda deshacer la mezcla:
- Independencia estadística. Las fuentes no solo están incorrelacionadas; su densidad conjunta se factoriza:
\[ p(s_1, s_2, s_3) = p(s_1)\,p(s_2)\,p(s_3). \]
Incorrelación es más débil: \(\operatorname{Cov}(s_i, s_j) = 0\) para \(i \neq j\). Independencia implica incorrelación (si las varianzas existen); lo contrario no es cierto. PCA solo consigue incorrelación.
- No gaussianidad. Como máximo una fuente puede ser gaussiana. ICA se apoya en que una mezcla lineal de variables independientes tiende a parecerse más a una gaussiana que las fuentes originales (es el teorema del límite central trabajando en tu contra si miras las mezclas, y a tu favor si buscas proyecciones poco gaussianas). FastICA maximiza una aproximación de la negentropía (cuánto se aleja una variable de la gaussiana con su misma varianza; vale \(0\) solo para la gaussiana): busca las direcciones más no gaussianas después de blanquear los datos, es decir, de transformarlos para que queden incorrelacionados y con varianza 1 (en la práctica, PCA seguido de un reescalado de cada componente).
Si todas las fuentes son gaussianas, el modelo deja de ser identificable: después de blanquear, cualquier rotación sigue siendo una solución válida. Más adelante lo comprobamos.
Las mezclas se ven más gaussianas que las voces
Una forma concreta de medir no gaussianidad es el exceso de curtosis:
\[ \kappa = \mathbb{E}[Z^4] - 3, \]
donde \(Z\) está estandarizada. Vale \(0\) para una gaussiana, es negativo en distribuciones de colas más livianas que la campana (subgaussianas: senoidal, cuadrada, diente) y positivo en distribuciones de colas pesadas (supergaussianas).
fig, axes = plt.subplots(2, 3, figsize=(9, 5.2))

for j in range(3):
    axes[0, j].hist(fuentes[:, j], bins=40, color='steelblue', edgecolor='white')
    axes[0, j].set_title(NOMBRES_FUENTES[j], fontsize=10)
    axes[1, j].hist(mezclas[:, j], bins=40, color='darkorange', edgecolor='white')
    axes[1, j].set_title(NOMBRES_MICROS[j], fontsize=10)

axes[0, 0].set_ylabel('fuentes')
axes[1, 0].set_ylabel('mezclas')
fig.suptitle('Histogramas: las voces son menos gaussianas que los micrófonos', y=1.02)
plt.tight_layout()
plt.show()

print('Exceso de curtosis de las fuentes:')
for j in range(3):
    print(f'  {NOMBRES_FUENTES[j]:>18}: {kurtosis_exceso(fuentes[:, j]): .3f}')

print('Exceso de curtosis de las mezclas:')
for j in range(3):
    print(f'  {NOMBRES_MICROS[j]:>18}: {kurtosis_exceso(mezclas[:, j]): .3f}')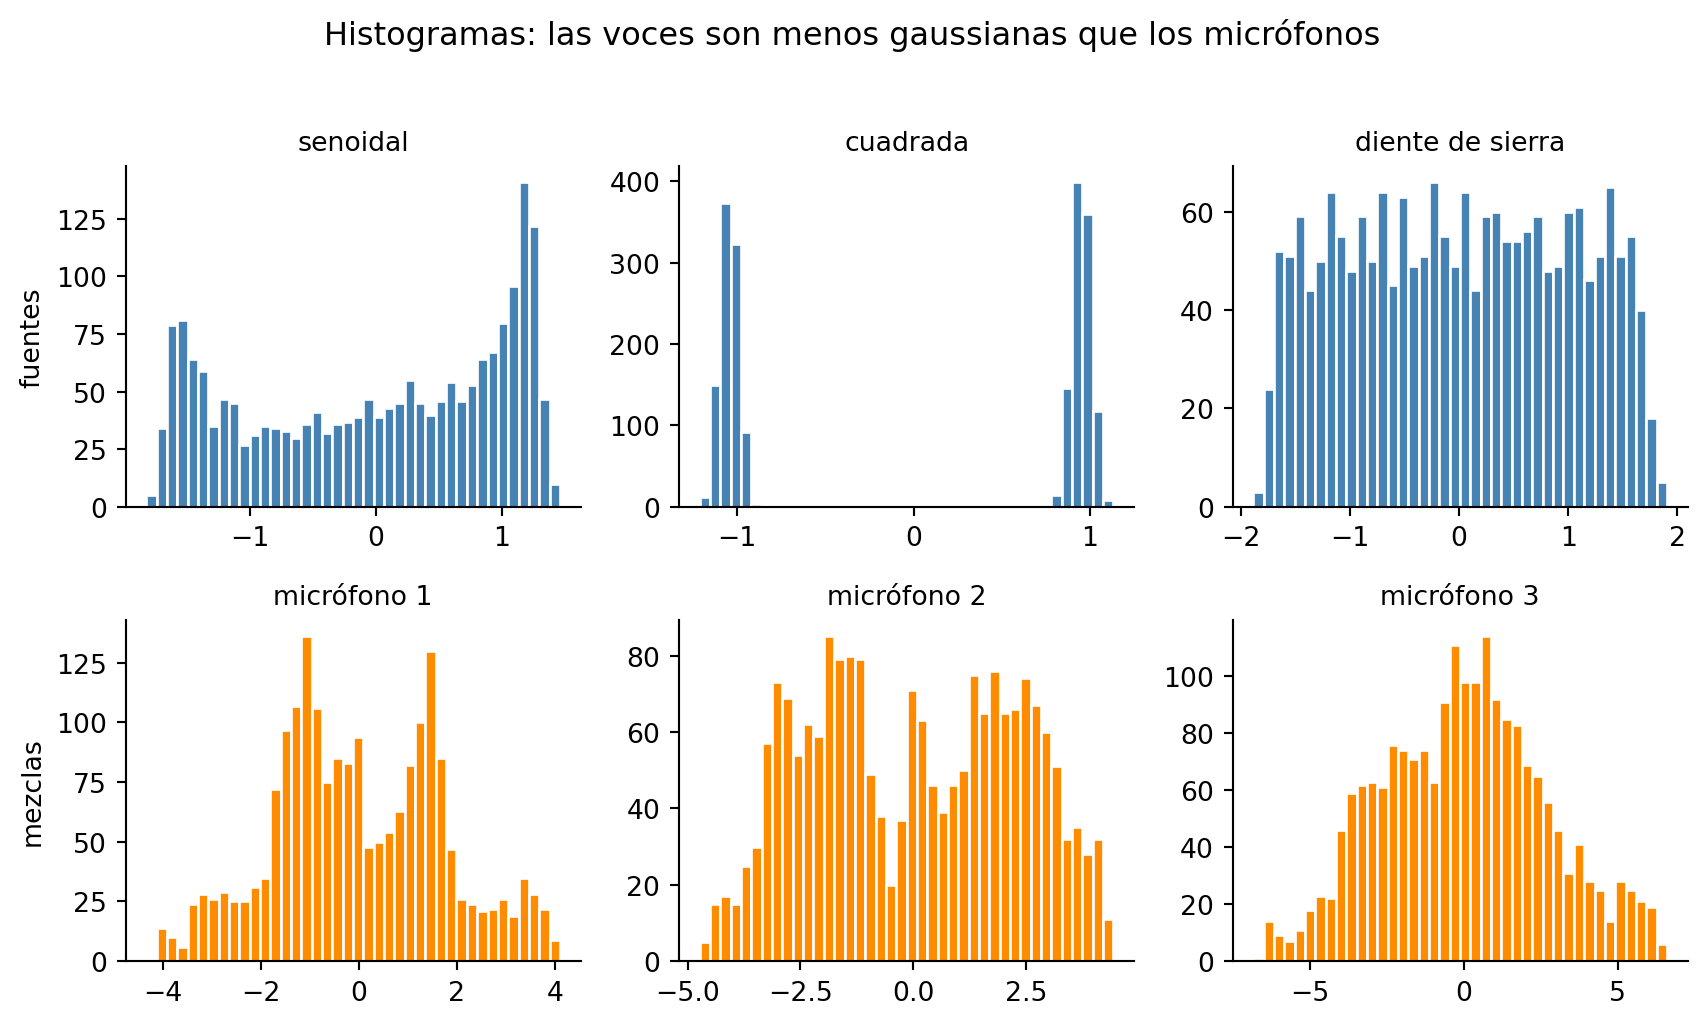
Exceso de curtosis de las fuentes:
            senoidal: -1.347
            cuadrada: -1.981
    diente de sierra: -1.174
Exceso de curtosis de las mezclas:
         micrófono 1: -0.494
         micrófono 2: -1.188
         micrófono 3: -0.422
Cómo leer este resultado
Las tres fuentes tienen curtosis negativa y marcada: -1.347 la senoidal, -1.981 la cuadrada y -1.174 el diente. Están lejos de \(0\), que sería el valor gaussiano.
Las mezclas se acercan a la campana: -0.494, -1.188 y -0.422. El micrófono 2 todavía hereda bastante de la cuadrada (la fuente más subgaussiana y la de mayor peso en esa fila de \(A\)): su -1.188 incluso queda por debajo del -1.174 del diente. Lo que se cumple siempre es otra cosa: para una mezcla \(\sum_i a_i s_i\) de fuentes independientes estandarizadas, el exceso de curtosis vale \(\sum_i a_i^4 \kappa_i / \left(\sum_i a_i^2\right)^2\), una combinación que diluye las curtosis de las fuentes, así que ninguna mezcla puede ser más no gaussiana que la fuente más no gaussiana. Es la idea del teorema del límite central a pequeña escala: mezclar independencias empuja hacia lo gaussiano. ICA va a buscar proyecciones que desandan ese camino.
Antes de seguir, pregúntate
Si PCA encuentra las direcciones de máxima varianza en las mezclas, ¿esperas que esas direcciones coincidan con las tres voces originales? ¿O solo con combinaciones que concentren energía?
Quédate con tu respuesta. En la siguiente sección la contrastamos con el gráfico: si PCA resolviera el cóctel, las componentes se verían como la senoidal, la cuadrada y el diente. Si no, verás otro enredo, quizá más ordenado, pero enredo al fin.
Por qué PCA no basta aquí
PCA centra los datos, los rota hacia ejes ortogonales y ordena esos ejes por varianza explicada. Eso decorrelaciona las pistas (blanquear sería, además, reescalar cada componente a varianza 1; con los valores por defecto de scikit-learn, PCA no lo hace). El cóctel pide más: las voces originales no son “las que más varían”, son las que son independientes. Nada en el criterio de PCA busca esa independencia.
Ajustamos PCA sobre las mezclas —sin usar las fuentes— y miramos las tres componentes.
pca = PCA(n_components=3, random_state=SEMILLA)
comp_pca = pca.fit_transform(mezclas)

print('Varianza explicada por PCA:')
for i, v in enumerate(pca.explained_variance_ratio_, 1):
    print(f'  PC{i}: {100 * v:.2f}%')

graficar_senales(
    comp_pca,
    ['PC1', 'PC2', 'PC3'],
    color='0.35',
    titulo_figura='Componentes de PCA: decorrelacionadas, pero no son las voces',
)
Varianza explicada por PCA:
PC1: 90.98%
PC2: 8.68%
PC3: 0.34%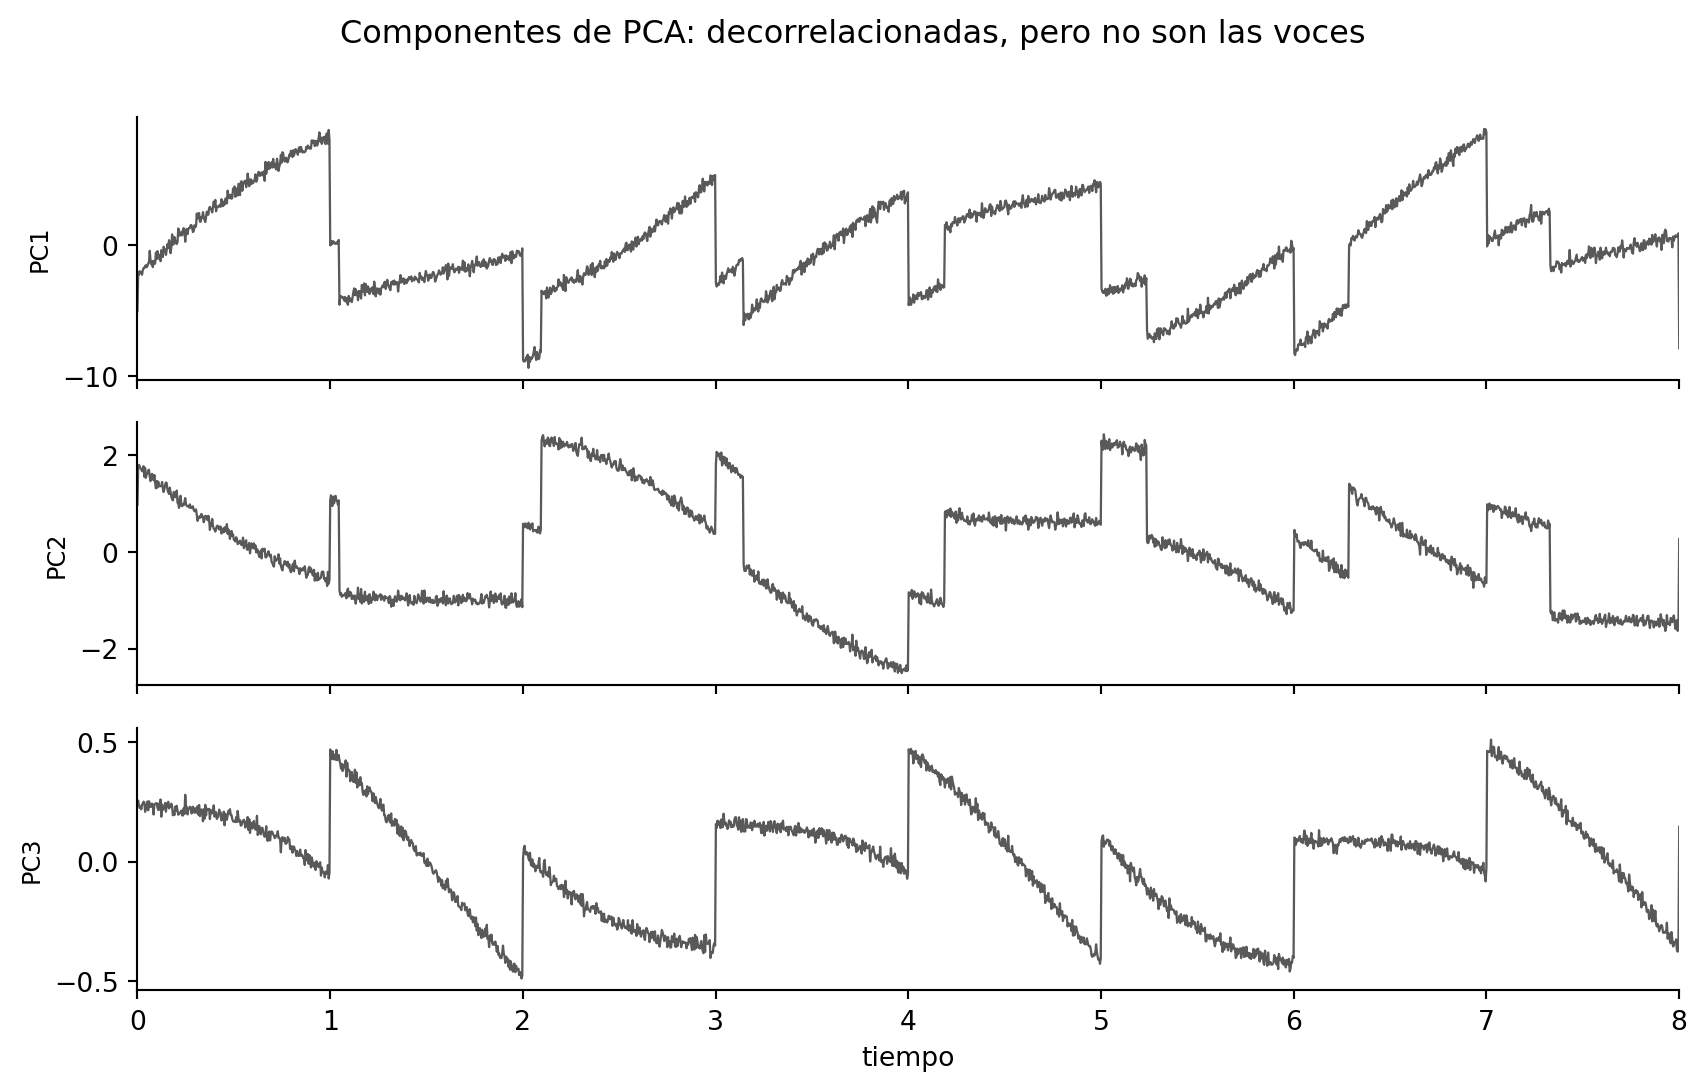
filas_pca = ['PC1', 'PC2', 'PC3']
corr_pca = pd.DataFrame(index=filas_pca, columns=NOMBRES_FUENTES, dtype=float)
for i in range(3):
    for j in range(3):
        corr_pca.iloc[i, j] = np.corrcoef(comp_pca[:, i], fuentes[:, j])[0, 1]

print('Correlación (con signo) entre componentes PCA y fuentes:')
display_corr_pca = corr_pca.round(3)
display_corr_pca
Correlación (con signo) entre componentes PCA y fuentes:| senoidal | cuadrada | diente de sierra | |
|---|---|---|---|
| PC1 | 0.515 | 0.614 | 0.604 |
| PC2 | -0.410 | 0.780 | -0.433 |
| PC3 | 0.753 | 0.119 | -0.670 |
Cómo leer este resultado
PC1 se queda con el 90.98% de la varianza; PC2 con el 8.68%; PC3 con el 0.34%. PCA está haciendo exactamente su trabajo: comprimir. El cóctel, sin embargo, no es un problema de compresión. Las tres voces importan, aunque una de las direcciones de mezcla tenga poca varianza.
Las correlaciones lo confirman. Ninguna componente se corresponde con una sola fuente: el mejor \(|r|\) es 0.780 (PC2 con la cuadrada), y PC1 se reparte entre las tres (0.515, 0.614, 0.604). Visualmente, las trazas grises no son la senoidal, ni la cuadrada, ni el diente. PCA desenredó la correlación, no las voces.
El mismo contraste, ahora en el plano
Otra manera de verlo: toma la senoidal contra la cuadrada. Como son independientes, su nube no tiene una dirección privilegiada de asociación. Las mezclas sí: al compartir voces, los micrófonos 1 y 2 se estiran en diagonal. PCA rota esa nube hacia los ejes de varianza —ortogonales—, pero no alinea los ejes con las voces.
fig, axes = plt.subplots(1, 3, figsize=(9.5, 3.1))
nubes = [
    (fuentes[:, 0], fuentes[:, 1], 'fuentes\n(senoidal vs cuadrada)', 'steelblue'),
    (mezclas[:, 0], mezclas[:, 1], 'mezclas\n(mic. 1 vs mic. 2)', 'darkorange'),
    (comp_pca[:, 0], comp_pca[:, 1], 'PCA\n(PC1 vs PC2)', '0.35'),
]
for ax, (x, y, titulo, color) in zip(axes, nubes):
    ax.scatter(x, y, s=4, alpha=0.25, c=color)
    ax.set_title(titulo, fontsize=9)
    ax.set_xticks([])
    ax.set_yticks([])
    ax.set_aspect('equal', adjustable='datalim')
fig.suptitle('Independencia (fuentes) frente a correlación (mezclas) y a la rotación de PCA', y=1.08)
plt.tight_layout()
plt.show()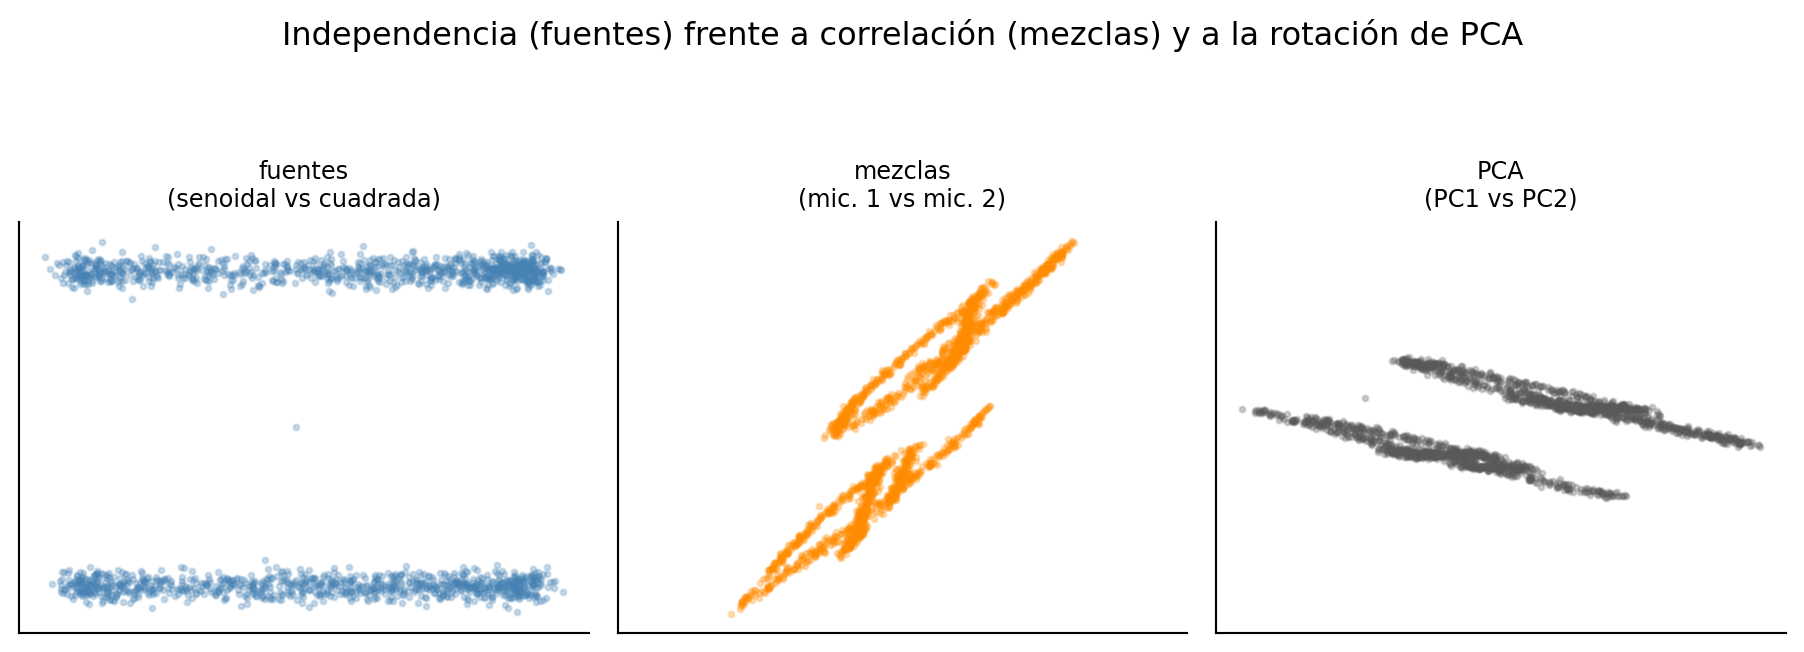
Cómo leer este resultado
La primera nube es la de dos fuentes independientes: dos bandas horizontales (los dos niveles de la cuadrada) que la senoidal recorre de extremo a extremo, sin diagonal dominante. Saber en qué punto de la senoidal estás no te dice en qué banda estás. La segunda nube se estira en diagonal porque los micrófonos comparten voces. PCA la rota hacia ejes ortogonales, pero la forma sigue siendo la de una mezcla: las bandas quedan inclinadas y no reaparece la forma de las fuentes.
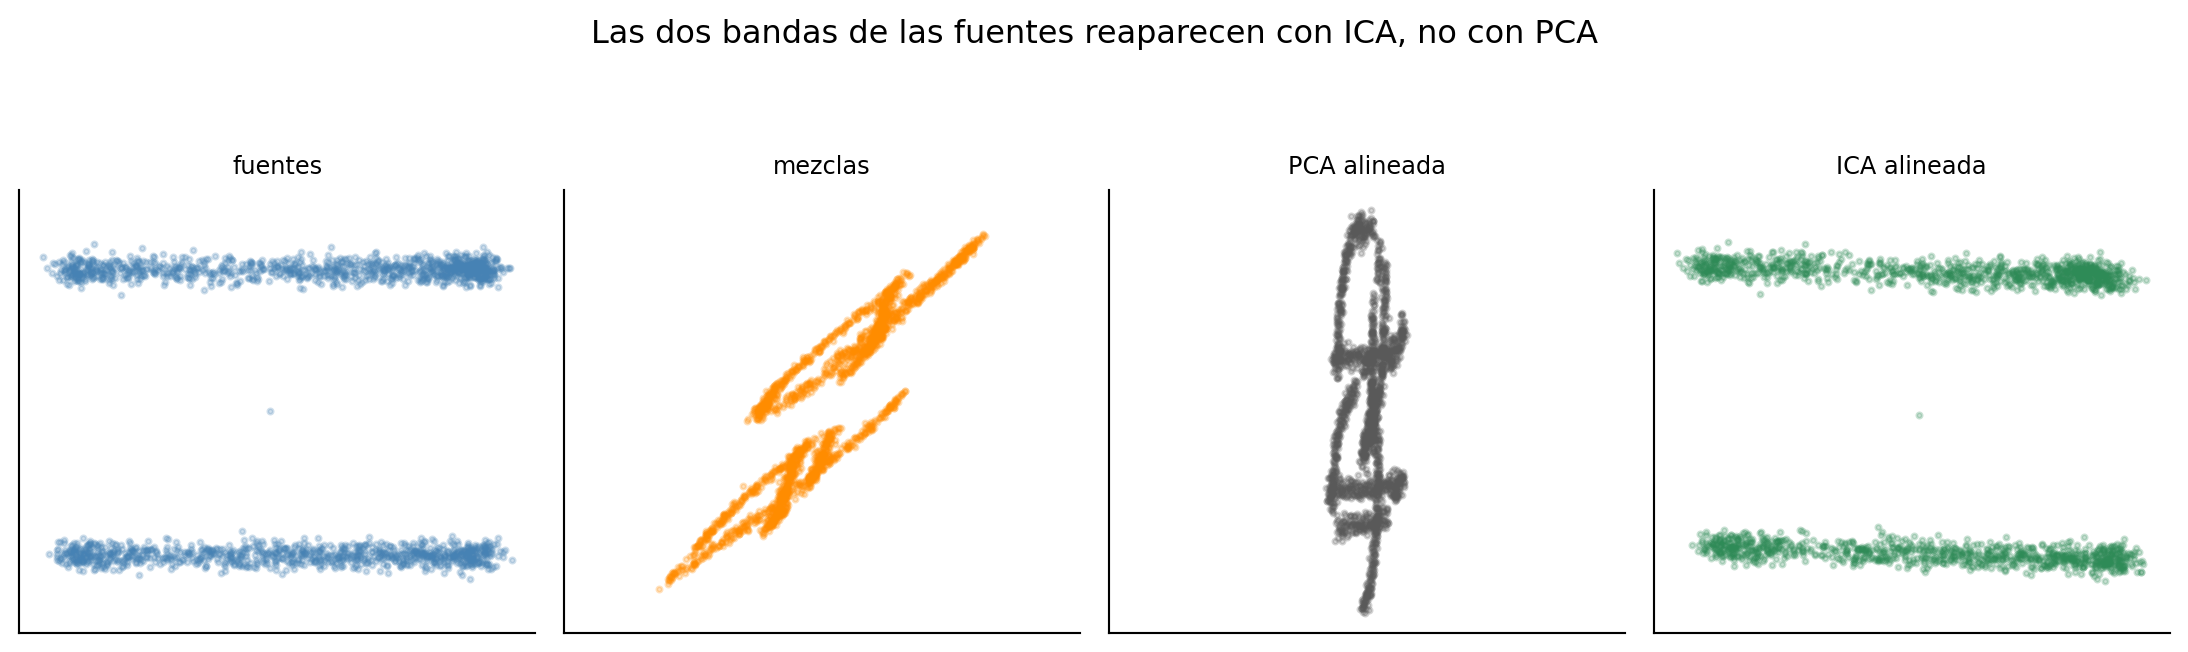
Si ICA hace lo que promete, más adelante esas dos bandas horizontales deberían volver. Primero, las señales en el tiempo.
ICA: separar por independencia
FastICA blanquea las mezclas (PCA seguido de un reescalado a varianza 1) y después rota buscando independencia: maximiza la no gaussianidad de las componentes. La llamada es la de scikit-learn; random_state fija la inicialización y whiten='unit-variance' deja cada componente con varianza 1 (es el valor por defecto en la versión instalada; lo escribimos para dejarlo explícito).
ica = FastICA(
    n_components=3,
    random_state=SEMILLA,
    whiten='unit-variance',
    max_iter=1000,
)
comp_ica = ica.fit_transform(mezclas)

print(f'Iteraciones hasta converger: {ica.n_iter_}')
print('Curtosis de las componentes ICA:')
for i in range(3):
    print(f'  IC{i + 1}: {kurtosis_exceso(comp_ica[:, i]): .3f}')

graficar_senales(
    comp_ica,
    ['IC1', 'IC2', 'IC3'],
    color='seagreen',
    titulo_figura='Componentes ICA tal como las entrega FastICA (aún sin reordenar)',
)
Iteraciones hasta converger: 3
Curtosis de las componentes ICA:
IC1: -1.976
IC2: -1.360
IC3: -1.158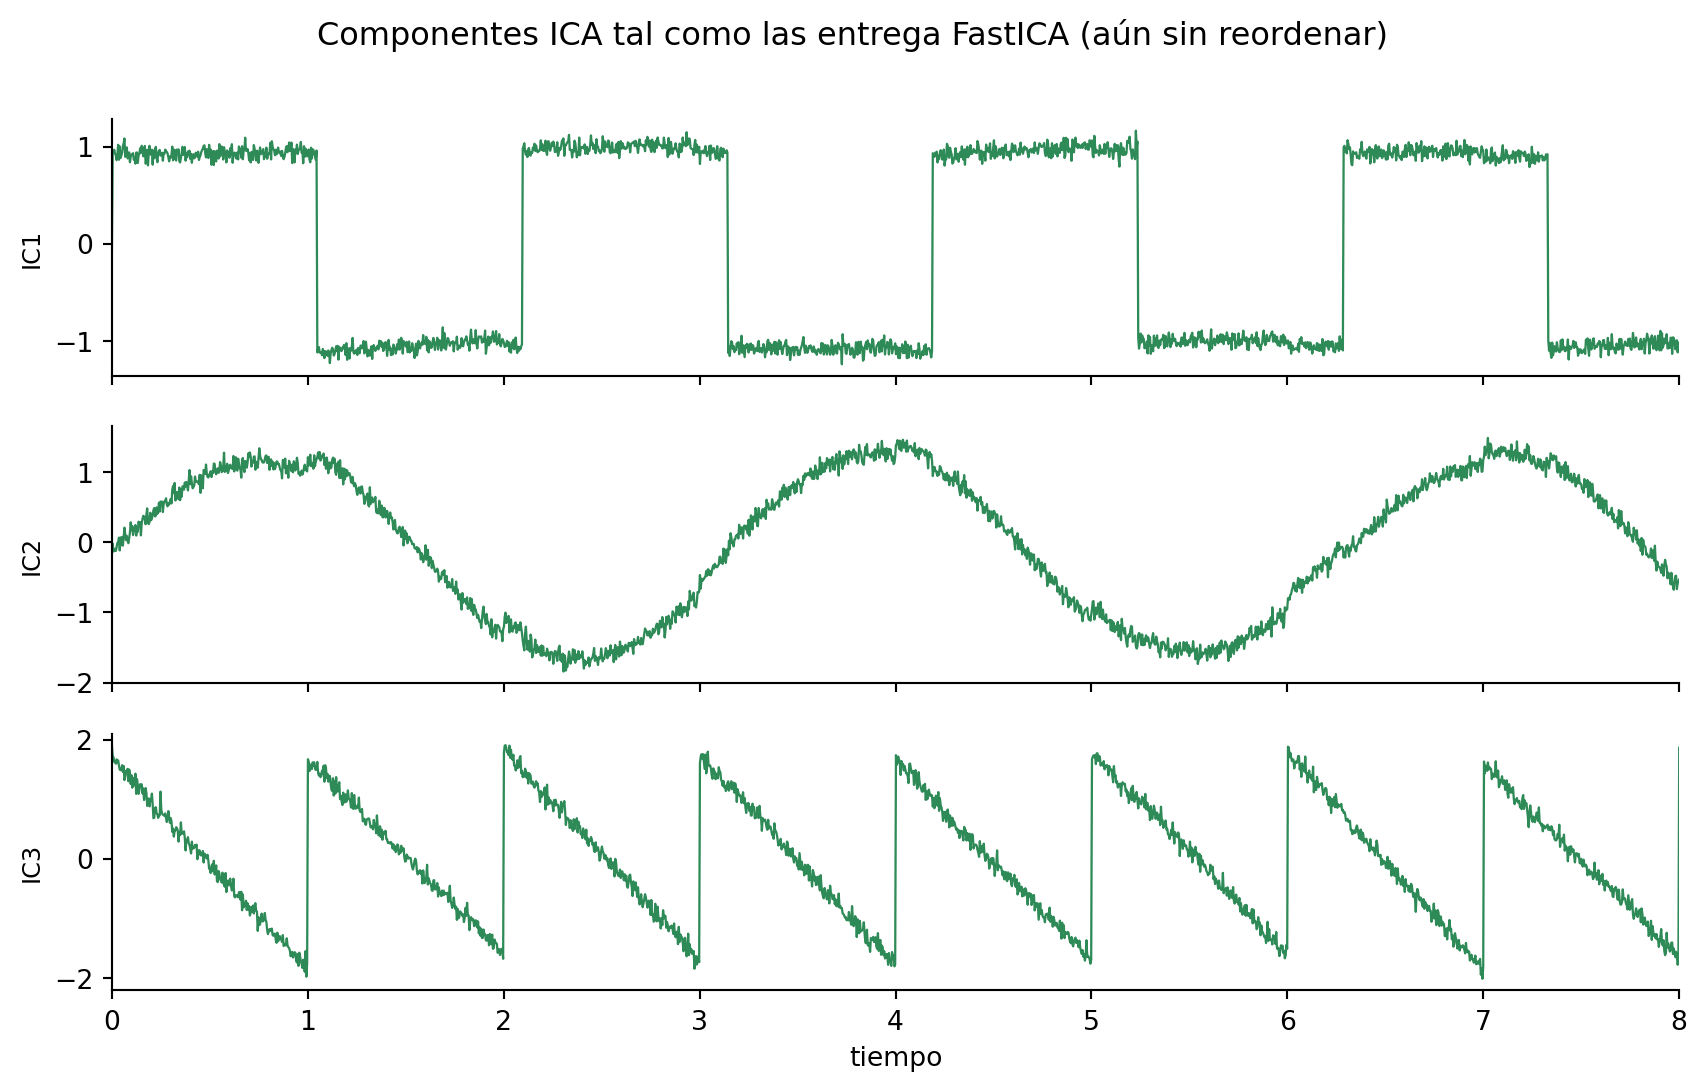
corr_ica = pd.DataFrame(index=['IC1', 'IC2', 'IC3'], columns=NOMBRES_FUENTES, dtype=float)
for i in range(3):
    for j in range(3):
        corr_ica.iloc[i, j] = np.corrcoef(comp_ica[:, i], fuentes[:, j])[0, 1]

print('Correlación (con signo) entre componentes ICA y fuentes:')
corr_ica.round(3)
Correlación (con signo) entre componentes ICA y fuentes:| senoidal | cuadrada | diente de sierra | |
|---|---|---|---|
| IC1 | 0.056 | 0.999 | -0.029 |
| IC2 | 0.997 | 0.031 | -0.071 |
| IC3 | -0.056 | 0.015 | -0.997 |
Cómo leer este resultado
Ahora sí reconoces las voces, con dos matices que no vamos a esconder. IC1 es la cuadrada (\(r = 0.999\)), IC2 es la senoidal (\(r = 0.997\)) e IC3 es el diente invertido (\(r = -0.997\)). El orden no coincide con el de las fuentes originales, y una componente salió con el signo cambiado.
Eso no es un fallo de recuperación: \(|r|\) vale 0.997, 0.999 y 0.997. PCA, en el mejor emparejamiento, no pasaba de 0.780. ICA separó las voces; PCA no.
Fuentes, ICA y PCA, lado a lado
Para comparar formas, recorremos las fuentes en orden, a cada una le asignamos la componente todavía libre con mayor \(|r|\) (un emparejamiento voraz) y corregimos el signo. ICA no te entrega ese alineamiento: lo hacemos nosotros, solo para que el ojo no tenga que perseguir permutaciones. El código deja explícito el emparejamiento.
def alinear_con_fuentes(componentes, fuentes, nombres=None):
    if nombres is None:
        nombres = NOMBRES_FUENTES
    n_comp = fuentes.shape[1]
    usadas = []
    alineadas = np.zeros_like(componentes)
    detalle = []
    for j in range(n_comp):
        mejor_i = None
        mejor_r = 0.0
        for i in range(n_comp):
            if i in usadas:
                continue
            r = np.corrcoef(componentes[:, i], fuentes[:, j])[0, 1]
            if mejor_i is None or abs(r) > abs(mejor_r):
                mejor_i = i
                mejor_r = r
        signo = 1.0 if mejor_r >= 0 else -1.0
        alineadas[:, j] = signo * componentes[:, mejor_i]
        usadas.append(mejor_i)
        detalle.append({
            'fuente': nombres[j],
            'componente': mejor_i + 1,
            'signo': int(signo),
            'r': mejor_r,
        })
    return alineadas, pd.DataFrame(detalle)


ica_alineada, detalle_ica = alinear_con_fuentes(comp_ica, fuentes)
pca_alineada, detalle_pca = alinear_con_fuentes(comp_pca, fuentes)

print('Emparejamiento ICA (después de alinear orden y signo):')
print(detalle_ica.assign(r=lambda d: d['r'].round(3)))
print()
print('Emparejamiento PCA (mismo criterio voraz):')
print(detalle_pca.assign(r=lambda d: d['r'].round(3)))
Emparejamiento ICA (después de alinear orden y signo):
fuente componente signo r
0 senoidal 2 1 0.997
1 cuadrada 1 1 0.999
2 diente de sierra 3 -1 -0.997
Emparejamiento PCA (mismo criterio voraz):
fuente componente signo r
0 senoidal 3 1 0.753
1 cuadrada 2 1 0.780
2 diente de sierra 1 1 0.604paneles = [
(fuentes, 'fuente original', 'steelblue'),
(ica_alineada, 'ICA alineada', 'seagreen'),
(pca_alineada, 'PCA alineada', '0.35'),
]
fig, axes = plt.subplots(3, 3, figsize=(10.5, 6.2), sharex=True)
for fila, (series, etiqueta, color) in enumerate(paneles):
for col in range(3):
ax = axes[fila, col]
ax.plot(t, series[:, col], color=color, linewidth=0.8)
if fila == 0:
ax.set_title(NOMBRES_FUENTES[col], fontsize=10)
if col == 0:
ax.set_ylabel(etiqueta, fontsize=9)
ax.set_xlim(t.min(), t.max())
axes[-1, 1].set_xlabel('tiempo')
fig.suptitle('Tres filas: originales, ICA (sí separa) y PCA (no separa)', y=1.02)
plt.tight_layout()
plt.show()
fig, axes = plt.subplots(1, 4, figsize=(11.5, 3.1))
nubes = [
(fuentes[:, 0], fuentes[:, 1], 'fuentes', 'steelblue'),
(mezclas[:, 0], mezclas[:, 1], 'mezclas', 'darkorange'),
(pca_alineada[:, 0], pca_alineada[:, 1], 'PCA alineada', '0.35'),
(ica_alineada[:, 0], ica_alineada[:, 1], 'ICA alineada', 'seagreen'),
]
for ax, (x, y, titulo, color) in zip(axes, nubes):
ax.scatter(x, y, s=4, alpha=0.25, c=color)
ax.set_title(titulo, fontsize=9)
ax.set_xticks([])
ax.set_yticks([])
ax.set_aspect('equal', adjustable='datalim')
fig.suptitle('Las dos bandas de las fuentes reaparecen con ICA, no con PCA', y=1.08)
plt.tight_layout()
plt.show()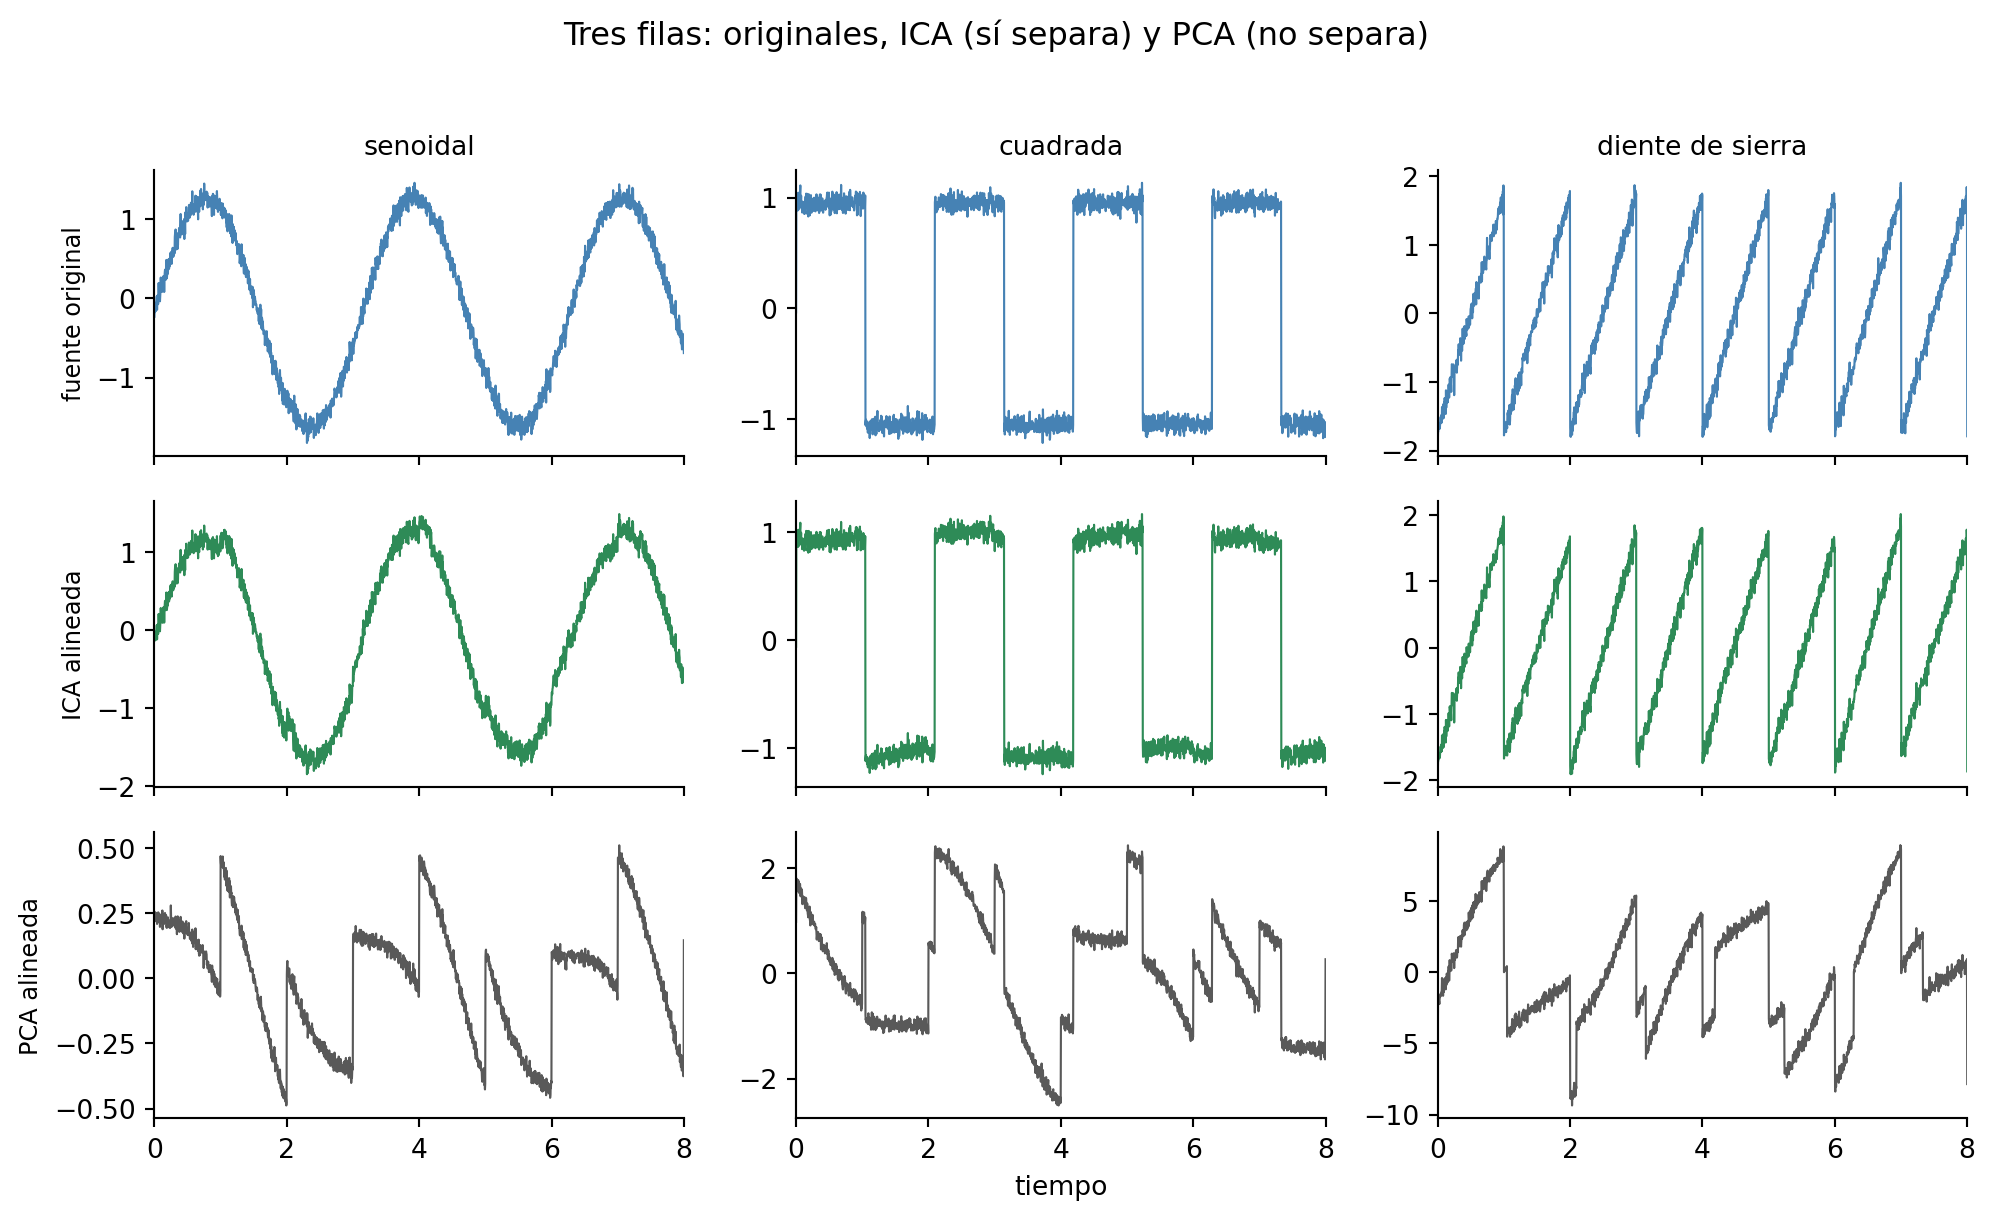
Cómo leer este resultado
Lee la figura de las series por columnas. En cada una, la fila verde (ICA) copia la forma azul (la fuente). La fila gris (PCA) no: incluso después de elegir la componente más parecida y de corregir el signo, las trazas siguen mezcladas.
Los \(|r|\) del emparejamiento exclusivo resumen lo mismo en un número: ICA queda en 0.997, 0.999 y 0.997; PCA, en 0.753, 0.780 y 0.604.
La nube de abajo cierra el argumento: las dos bandas horizontales de las fuentes reaparecen con ICA; la nube de PCA, en cambio, no se parece a la de las fuentes. El contraste del cóctel no es de matices. Es de método.
Matices honestos: orden, escala y signo
ICA recupera la forma de las fuentes, no su etiquetado ni su unidad. Hay dos ambigüedades inherentes:
- Orden. Nada en \(X = S A^{\top}\) dice cuál fuente es la primera. Permutar las columnas de \(S\) y las filas de \(A^{\top}\) deja las mezclas iguales. FastICA numera componentes según el camino de optimización, no según tu lista original.
- Escala y signo. Multiplicar una fuente por \(-c\) y dividir la columna correspondiente de \(A\) por \(-c\) tampoco cambia \(X\). Por eso IC3 salió como diente invertido (\(r = -0.997\)) y todas las componentes tienen varianza 1.
En la práctica eso rara vez es un problema grave: si recuperas una voz, la reconoces aunque suene un poco más baja o con la polaridad cambiada. Lo que no debes hacer es interpretar el índice IC1 como “la primera fuente que imaginabas”.
print('Varianza de cada componente ICA (deben ser 1 por el blanqueo):')
for i in range(3):
    print(f'  IC{i + 1}: {comp_ica[:, i].var():.3f}')
print()
print('Producto signo × |r| ya visto en el emparejamiento ICA:')
for fila in detalle_ica.itertuples(index=False):
    print(
        f'  {fila.fuente:>18} <- IC{fila.componente} '
        f'(signo {fila.signo:+d}, r = {fila.r:.3f})'
    )
Varianza de cada componente ICA (deben ser 1 por el blanqueo):
IC1: 1.000
IC2: 1.000
IC3: 1.000
Producto signo × |r| ya visto en el emparejamiento ICA:
senoidal <- IC2 (signo +1, r = 0.997)
cuadrada <- IC1 (signo +1, r = 0.999)
diente de sierra <- IC3 (signo -1, r = -0.997)Cómo leer este resultado
Las tres varianzas valen 1.000: ICA te entrega formas, no las amplitudes originales de cada fuente. El diente quedó asociado a IC3 con signo -1. Si graficas IC3 sin corregir, la rampa se ve hacia abajo; la señal es la misma.
Cuando reportes un ICA, reporta las formas y, si el dominio lo permite, reordena y voltea con un criterio externo (por ejemplo, correlacionar con una fuente piloto). No trates el orden del software como un hallazgo.
Cuando ICA no funciona: fuentes gaussianas
El supuesto de no gaussianidad no es cosmética. Si las tres voces fueran ruido blanco gaussiano independiente, cualquier rotación de las mezclas blanqueadas seguiría viéndose como “fuentes independientes”. El modelo deja de tener una solución única, y FastICA no tiene un criterio con el que preferir las voces verdaderas.
Repetimos el experimento con las mismas \(A\) y \(n\), pero reemplazando las tres señales reconocibles por gaussianas independientes.
fuentes_g = rng.normal(size=(n, 3))
fuentes_g = (fuentes_g - fuentes_g.mean(axis=0)) / fuentes_g.std(axis=0)
mezclas_g = fuentes_g @ A.T

ica_g = FastICA(
    n_components=3,
    random_state=SEMILLA,
    whiten='unit-variance',
    max_iter=1000,
)
comp_ica_g = ica_g.fit_transform(mezclas_g)
ica_g_alineada, detalle_ica_g = alinear_con_fuentes(
    comp_ica_g,
    fuentes_g,
    nombres=['fuente 1', 'fuente 2', 'fuente 3'],
)

print('Exceso de curtosis de las fuentes gaussianas:')
for j in range(3):
    print(f'  fuente {j + 1}: {kurtosis_exceso(fuentes_g[:, j]): .3f}')

print()
print('Mejor emparejamiento ICA frente a gaussianas:')
print(detalle_ica_g.assign(r=lambda d: d['r'].round(3)))
print()
print('|r| máximo por fuente (ICA en el cóctel original):', ', '.join(f'{abs(r):.3f}' for r in detalle_ica['r']))
print('|r| máximo por fuente (ICA con gaussianas):     ', ', '.join(f'{abs(r):.3f}' for r in detalle_ica_g['r']))
Exceso de curtosis de las fuentes gaussianas:
fuente 1: -0.070
fuente 2: -0.144
fuente 3: 0.047
Mejor emparejamiento ICA frente a gaussianas:
fuente componente signo r
0 fuente 1 3 -1 -0.706
1 fuente 2 1 1 0.793
2 fuente 3 2 -1 -0.501
|r| máximo por fuente (ICA en el cóctel original): 0.997, 0.999, 0.997
|r| máximo por fuente (ICA con gaussianas): 0.706, 0.793, 0.501fig, axes = plt.subplots(2, 3, figsize=(10.5, 4.4), sharex=True)
for col in range(3):
axes[0, col].plot(t, fuentes_g[:, col], color='steelblue', linewidth=0.7)
axes[0, col].set_title(f'fuente gaussiana {col + 1}', fontsize=10)
axes[1, col].plot(t, ica_g_alineada[:, col], color='seagreen', linewidth=0.7)
axes[1, col].set_xlim(t.min(), t.max())
axes[0, 0].set_ylabel('original', fontsize=9)
axes[1, 0].set_ylabel('ICA alineada', fontsize=9)
axes[-1, 1].set_xlabel('tiempo')
fig.suptitle('Con fuentes gaussianas, ICA ya no recupera las voces', y=1.03)
plt.tight_layout()
plt.show()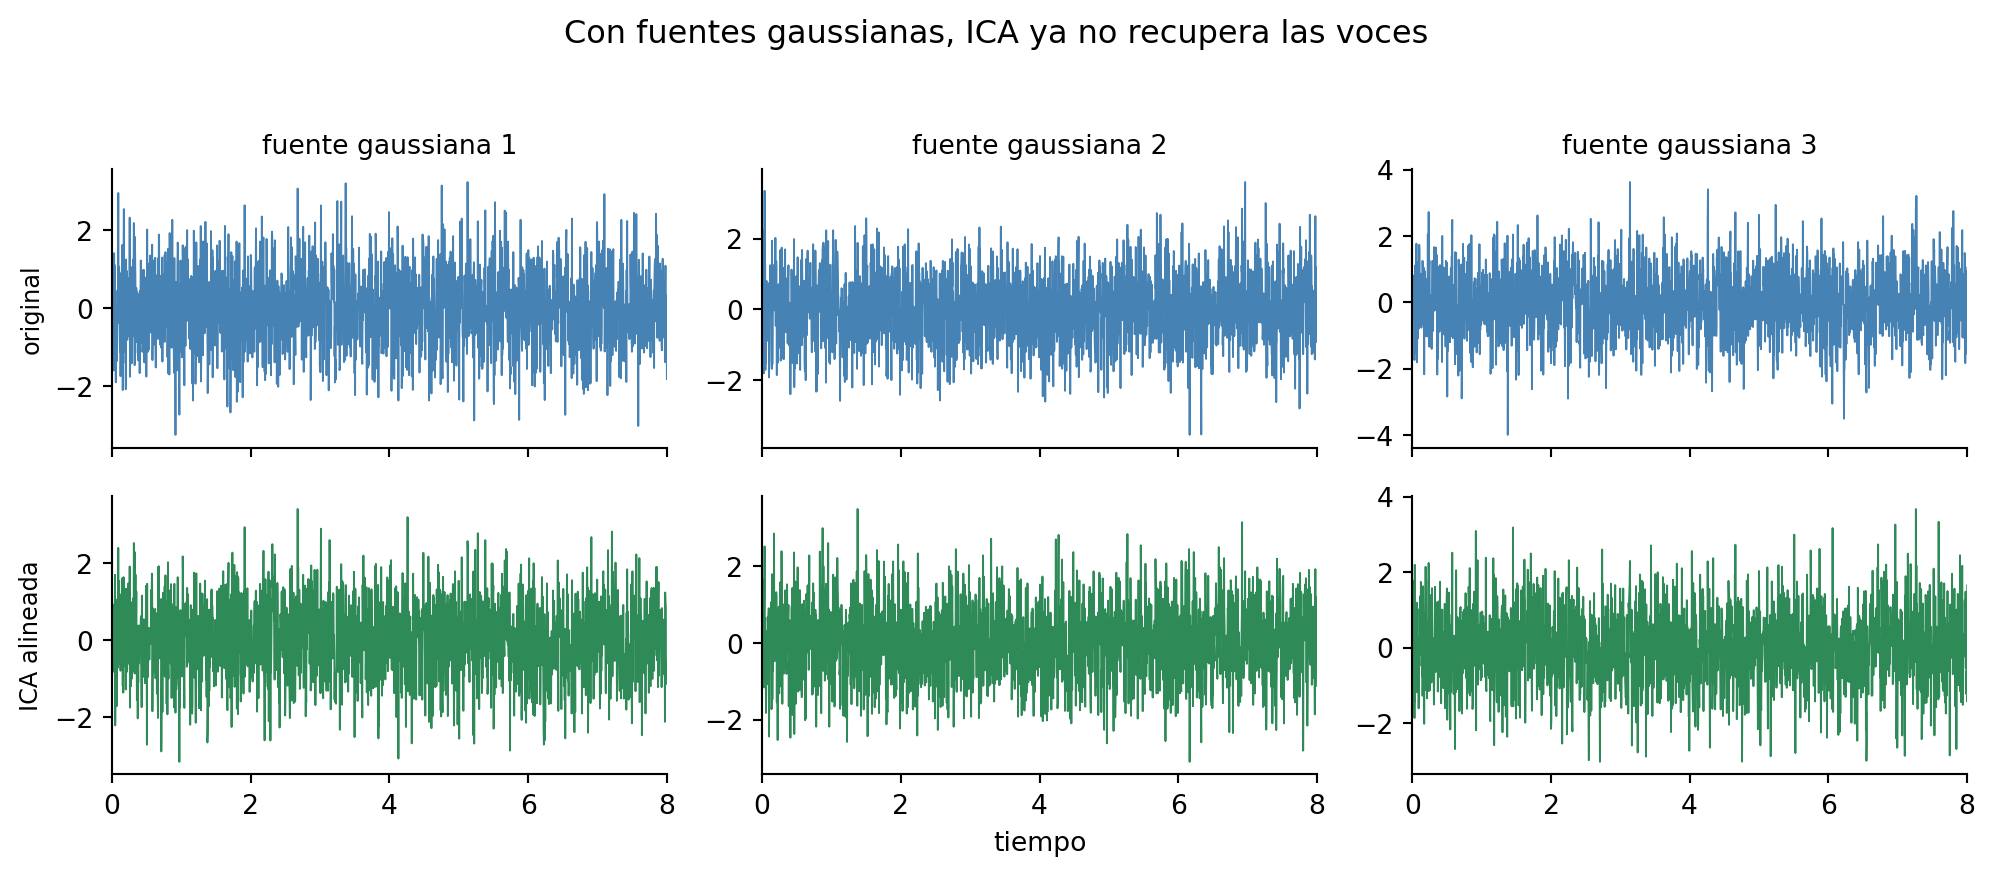
Cómo leer este resultado
Las curtosis de las fuentes gaussianas quedan cerca de cero (-0.070, -0.144, 0.047): son campanas, como corresponde. El mejor \(|r|\) de ICA cae a 0.706, 0.793 y 0.501. Compáralo con 0.997–0.999 del cóctel no gaussiano. En la figura, las dos filas se ven como ruido y la inspección visual no basta para compararlas: la evidencia está en los \(|r|\), que ya no se acercan a 1.
No es que FastICA “falle al optimizar”. Es que, con gaussianas, no hay una rotación correcta que el criterio pueda elegir. Si tus fuentes se parecen a una campana, ICA no es la herramienta.
PCA frente a ICA
| PCA | ICA | |
|---|---|---|
| Objetivo | Direcciones de máxima varianza | Componentes estadísticamente independientes |
| Criterio | Autovectores de la covarianza (momentos de orden 2) | No gaussianidad / independencia (momentos de orden superior) |
| Supuesto clave | La varianza concentra la información útil | Fuentes independientes y no gaussianas |
| Ortogonalidad | Direcciones (cargas) ortogonales; componentes incorrelacionadas | Componentes incorrelacionadas; la matriz de separación \(W\) no es ortogonal en el espacio original (solo la rotación posterior al blanqueo lo es) |
| Orden de las componentes | Decreciente en varianza explicada | Arbitrario |
| Escala / signo | Signo del autovector es arbitrario; la escala sigue a la varianza | Escala y signo son arbitrarios |
| Cuándo usarlo | Reducir dimensión, visualizar, quitar colinealidad | Separar señales mezcladas, desenredar fuentes latentes |
| Cuándo no | Cuando la dirección útil no es la de más varianza | Cuando las fuentes son gaussianas o la mezcla no es lineal |
No eliges el “más moderno”. Eliges el que responde a tu pregunta. Si quieres un plano que conserve energía, PCA. Si quieres las voces de la fiesta, ICA.
Incorrelación no es independencia
Un último control, para que el contraste no quede solo en el gráfico de las series. Tanto PCA como ICA producen componentes incorrelacionadas (la correlación entre componentes vale ~0). Esa condición la cumplen los dos. Lo que distingue a ICA es haber recuperado la no gaussianidad de las voces originales.
print('Correlación entre componentes PCA:')
print(pd.DataFrame(np.corrcoef(comp_pca.T).round(3) + 0.0, index=['PC1', 'PC2', 'PC3'], columns=['PC1', 'PC2', 'PC3']))
print()
print('Correlación entre componentes ICA:')
print(pd.DataFrame(np.corrcoef(comp_ica.T).round(3) + 0.0, index=['IC1', 'IC2', 'IC3'], columns=['IC1', 'IC2', 'IC3']))
print()
print('Curtosis | fuentes:', ', '.join(f'{kurtosis_exceso(fuentes[:, j]):.3f}' for j in range(3)))
print('Curtosis | PCA:    ', ', '.join(f'{kurtosis_exceso(comp_pca[:, j]):.3f}' for j in range(3)))
print('Curtosis | ICA:    ', ', '.join(f'{kurtosis_exceso(comp_ica[:, j]):.3f}' for j in range(3)))
Correlación entre componentes PCA:
PC1 PC2 PC3
PC1 1.0 0.0 0.0
PC2 0.0 1.0 0.0
PC3 0.0 0.0 1.0
Correlación entre componentes ICA:
IC1 IC2 IC3
IC1 1.0 0.0 0.0
IC2 0.0 1.0 0.0
IC3 0.0 0.0 1.0
Curtosis | fuentes: -1.347, -1.981, -1.174
Curtosis | PCA: -0.497, -0.769, -0.783
Curtosis | ICA: -1.976, -1.360, -1.158Cómo leer este resultado
Las dos matrices de correlación son la identidad: PCA e ICA decorrelacionan. Si te quedaras ahí, parecerían equivalentes.
La curtosis los separa. Las fuentes estaban en -1.347, -1.981, -1.174. ICA recupera valores del mismo orden (-1.976, -1.360, -1.158), permutados como las componentes. PCA se queda a medio camino (-0.497, -0.769, -0.783): más gaussiana, como las mezclas. Incorrelación lograda; independencia, no.
Lo que debes llevarte de este capítulo
PCA e ICA responden a la misma idea de fondo: las columnas que ves no son necesariamente las variables que importan. A veces el patrón útil está escondido en una combinación de las observadas.
- PCA comprime. Encuentra pocas direcciones que conserven la varianza. Es reducción de dimensionalidad.
- ICA separa. Encuentra direcciones que recuperen fuentes independientes. Es separación de señales.
Son dos caras de las variables latentes: factores no observados que organizan lo que mides. No compiten en abstracto. Compiten —o se complementan— según la pregunta. En el cóctel de este capítulo, la pregunta era separar voces, y el ganador no fue la máxima varianza.
¿Qué sigue?
Hasta aquí cada instante se podía tratar como un punto: el orden temporal no era el objeto de estudio, solo el soporte de las señales. El próximo tema cambia esa premisa. Los datos llegan en el tiempo, y lo que ocurrió antes informa lo que puede ocurrir después.
Ahí entran las series de tiempo y, en general, los datos dependientes: correlación serial, tendencias, estacionalidad y modelos que respetan el orden. La independencia entre observaciones, que ICA asume entre fuentes y que buena parte de lo anterior asume entre filas, deja de ser el caso por defecto.