25Variables latentes I: Análisis de Componentes Principales (PCA)
estadistica
variables-latentes
pca
Autor/a
Wilder Ramírez Delgado
Fecha de publicación
27 de septiembre de 2026
De predecir una respuesta a construir nuevas coordenadas
En los modelos de regresión anteriores tenías variables \(X\) y una respuesta \(y\). PCA plantea otra tarea: construir combinaciones lineales de las columnas de \(X\) que conserven la mayor varianza posible y permitan representar los datos con menos coordenadas.
Estas coordenadas suelen llamarse variables latentes, porque se calculan a partir de las mediciones y no se observan como columnas originales. Interpretarlas como factores físicos o causas subyacentes requiere evidencia adicional. PCA construye ejes según un criterio estadístico; no demuestra por sí solo que haya descubierto esos factores.
El Análisis de Componentes Principales (PCA) es no supervisado: ajusta sus componentes sin usar etiquetas. En el ejemplo de vinos reservas la prueba antes de explorar, y las etiquetas de entrenamiento solo se añaden después para interpretar las figuras; más adelante evaluarás una aplicación predictiva.
Tiempo estimado de lectura: 75 minutos para la lectura completa; entre 30 y 40 minutos para el primer recorrido
Los vinos proceden del conjunto Wine del UCI Machine Learning Repository (CC BY 4.0), en la copia que distribuye scikit-learn. Las dos tablas de cinco observaciones y el contraejemplo son sintéticos, generados con la semilla central SEMILLA = 2026 declarada en el código. Todo corre en CPU, sin GPU, y las versiones se imprimen en la primera celda de código. La SVD completa evita que las comprobaciones dependan de un método numérico aleatorio; los últimos decimales pueden variar con el entorno.
Objetivos
Al terminar este capítulo vas a ser capaz de:
explicar qué problema resuelve PCA y por qué sus componentes son ortogonales;
deducir por qué la dirección de máxima varianza es un vector propio de la matriz de covarianza;
calcular un PCA a mano con una tabla pequeña y comprobarlo por dos caminos: valores propios y descomposición en valores singulares (SVD);
estandarizar las variables antes de aplicar PCA cuando sus escalas difieren;
interpretar la varianza explicada, el gráfico de sedimentación (scree plot) y la varianza acumulada;
elegir un número razonable de componentes mediante un umbral y contrastarlo con validación cruzada;
leer una proyección y las cargas de sus primeros componentes;
reconocer cuándo la dirección de mayor varianza no es la que separa las clases;
medir el compromiso entre compresión y error de reconstrucción;
distinguir PCA de un método supervisado y anticipar su diferencia con ICA (Análisis de Componentes Independientes), el próximo tema del libro.
Si ejecutas el notebook, corre todas las celdas de código en orden, aunque dejes la lectura de las derivaciones para después: algunas variables se utilizan en secciones posteriores.
25.2 Una primera imagen: proyectar y reconstruir
Comienza con cinco observaciones sintéticas. Cada una tiene dos mediciones en escalas comparables:
Observación
Medición 1
Medición 2
A
1
1
B
2
2.5
C
3
2
D
4
4.5
E
5
4
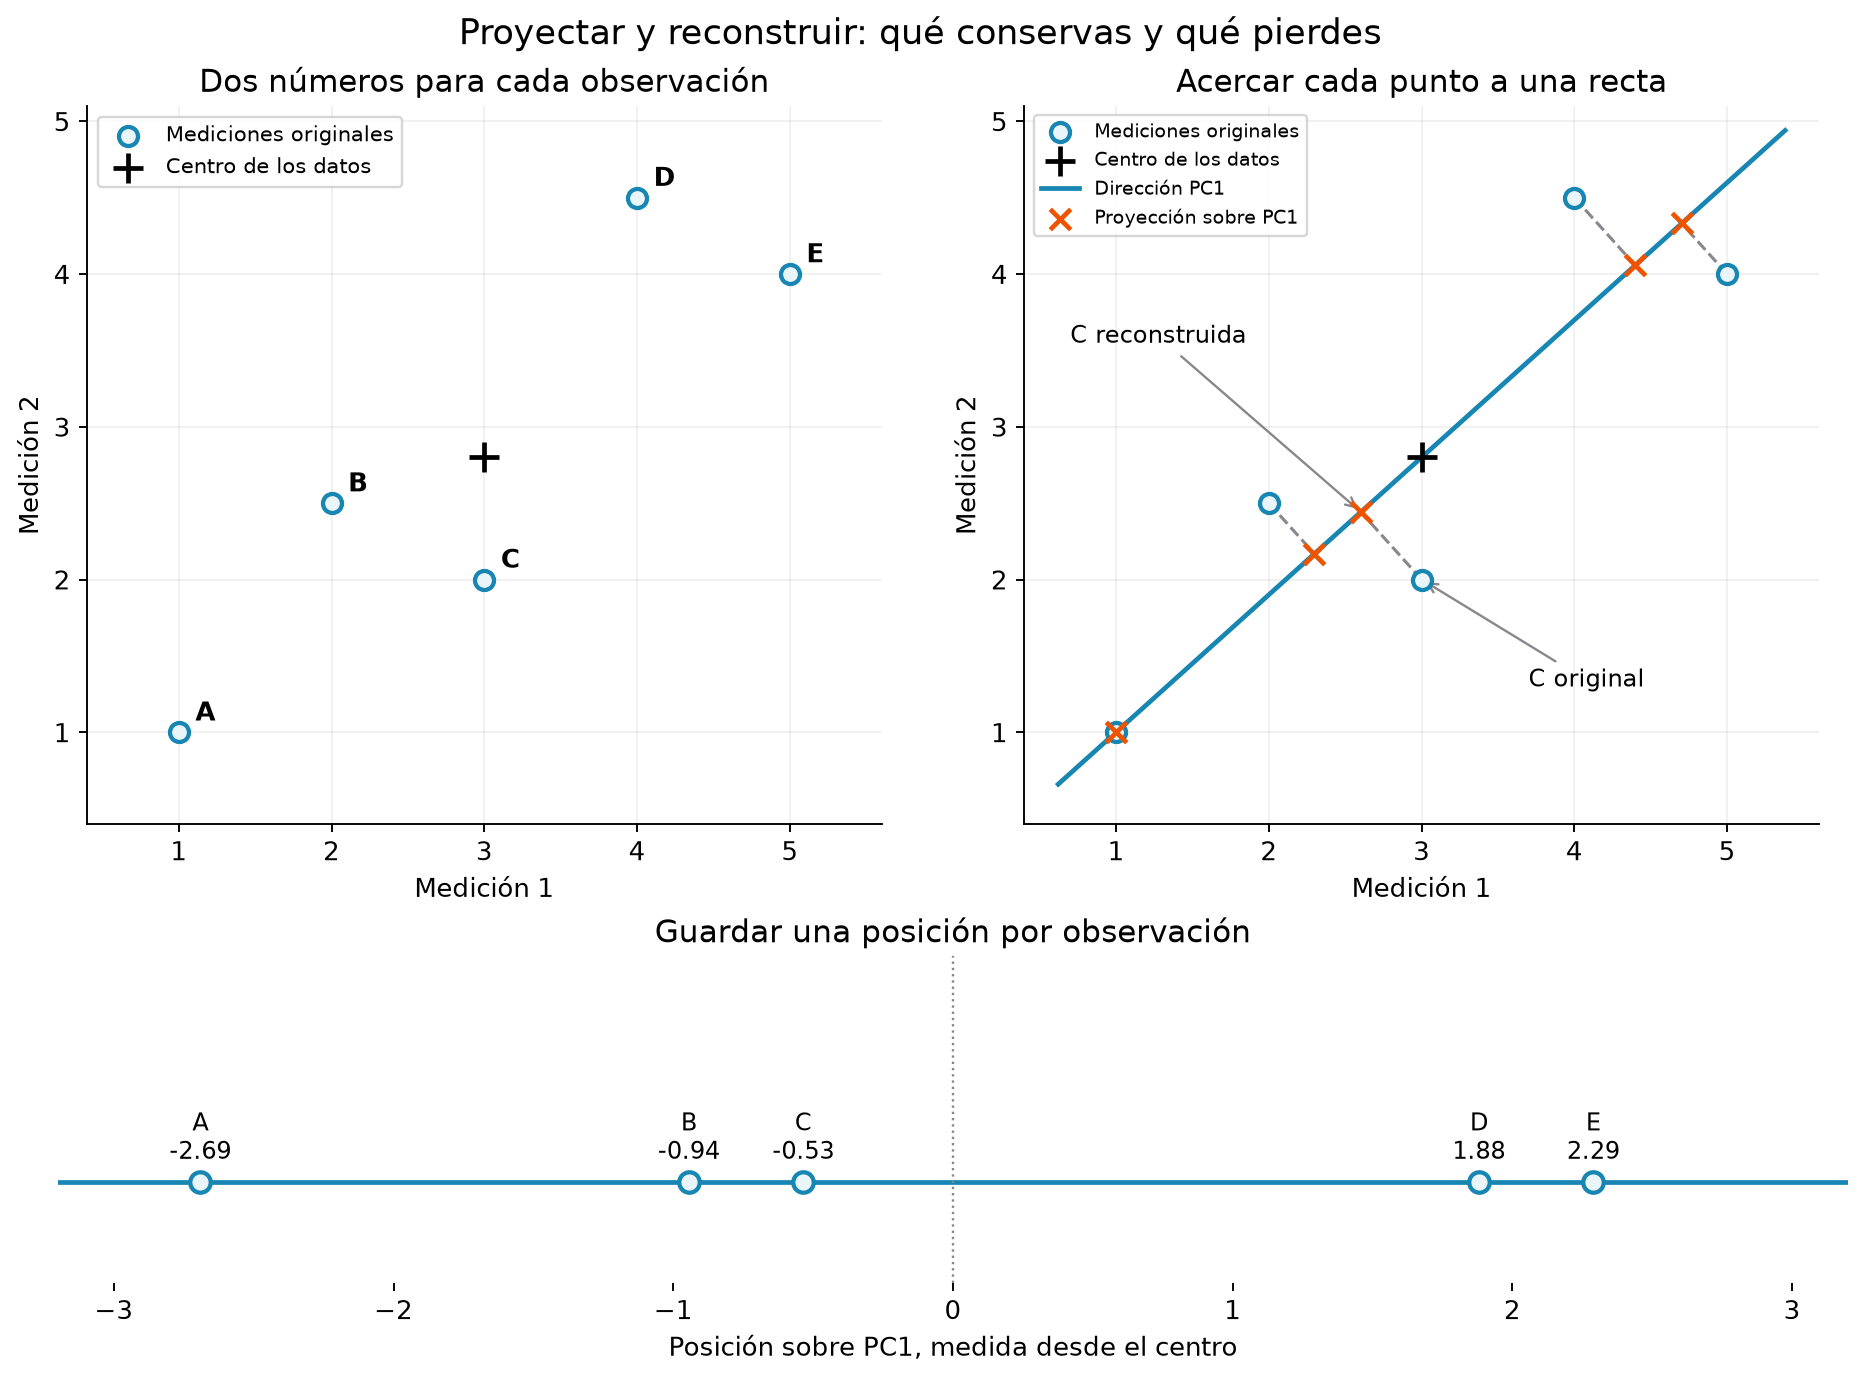
En el panel izquierdo, cada punto necesita dos números para localizarse. Los puntos tienden a extenderse en diagonal. PC1 es una dirección que sigue esa dispersión; sobre ella puedes guardar una posición por punto.
Proyectar consiste en llevar cada punto a la recta por el camino perpendicular más corto. Los círculos del panel superior derecho son las mediciones originales y las cruces, sus proyecciones. Los segmentos punteados muestran la distancia que se pierde al conservar solo esa dirección.
Tres vistas de cinco observaciones sintéticas: sus dos mediciones originales, la proyección perpendicular sobre PC1 y sus posiciones sobre ese eje. Los segmentos entre círculo y cruz muestran información descartada al reducir a una dimensión.
El panel inferior representa las proyecciones usando una sola coordenada. Esa coordenada se llama puntuación o score: es la posición sobre el componente, medida desde el centro. Un signo negativo indica un lado del centro y uno positivo, el otro; no expresan una valoración buena o mala.
Por ejemplo, C tenía mediciones (3, 2) y su puntuación sobre PC1 es -0.53. Para reconstruirla, vuelves a colocar esa puntuación sobre la recta y obtienes aproximadamente (2.60, 2.44). No recuperas exactamente (3, 2): la distancia perdida es 0.59 en las unidades de este plano. La figura muestra una compresión con pérdida, no un cálculo de predicción futura.
En estas cinco observaciones, PC1 conserva 93.96% de la varianza, una medida de cuánto se extienden los puntos. Ese porcentaje resume dispersión conservada; no significa que una clasificación vaya a acertar ese porcentaje de veces.
La representación reducida guarda una puntuación por observación. Para reconstruir también debes conservar el centro y la dirección del eje, compartidos por todo el conjunto. Más adelante volverás a esta idea con trece mediciones y comprobarás el error de reconstrucción.
Para esta primera lectura, retén cuatro relaciones: el componente es un eje nuevo; la puntuación sitúa el punto sobre él; la proyección reduce las coordenadas; y la reconstrucción permite ver cuánto detalle se descartó.
25.3 El problema formal: muchas coordenadas, estructura repetida
Cuando aumentan las variables, las observaciones se vuelven más dispersas y las distancias pierden contraste: es una cara de la maldición de la dimensionalidad. Además, si varias variables están correlacionadas, describen parte del mismo patrón y añaden redundancia.
PCA reemplaza las variables originales por nuevas coordenadas llamadas componentes principales. Cada componente es una combinación lineal de las variables; el primero busca la dirección de mayor dispersión, el segundo la mayor dispersión restante bajo la condición de ser perpendicular al primero, y así sucesivamente.
25.4 La optimización detrás de PCA
NotaProfundización matemática
Puedes dejar esta optimización y su deducción para una segunda lectura. Para seguir con la intuición, continúa en los datos de vinos. Si ejecutas código, mantén el orden de las celdas.
Sea \(X_c\) la matriz de datos centrada y sea \(w_1\) una dirección de longitud uno. La proyección de los datos sobre esa dirección es \(X_cw_1\). La dirección se obtiene mediante la siguiente optimización de la varianza proyectada:
\[
w_1=\underset{\lVert w\rVert_2=1}{\operatorname{arg\,max}}\;\operatorname{Var}(X_cw)
=\underset{\lVert w\rVert_2=1}{\operatorname{arg\,max}}\;w^\top S w,
\]
donde \(S=\frac{1}{n-1}X_c^\top X_c\) es la matriz de covarianza. Para el componente \(j\) se añade la restricción \(w_j^\top w_\ell=0\) para todo \(\ell<j\).
La solución conduce al problema de valores propios:
Como \(S\) es simétrica, sus vectores propios pueden elegirse ortonormales: \(W^\top W=I\). La deducción está en el apartado siguiente. Los vectores \(w_j\) son las direcciones; los valores propios \(\lambda_j\) indican cuánta varianza captura cada dirección. Las nuevas coordenadas son las puntuaciones o scores\(Z=X_cW\) y quedan no correlacionadas entre sí.
De dónde sale la ecuación de valores propios
La ecuación de valores propios se deduce del problema de optimización con norma unitaria. Se quiere maximizar \(f(w)=w^\top S w\) con la restricción \(w^\top w=1\). Sin esa restricción bastaría alargar \(w\) para aumentar la varianza sin límite. El método de los multiplicadores de Lagrange reúne objetivo y restricción en una sola función:
\[
\mathcal{L}(w,\lambda)=w^\top S w-\lambda\,(w^\top w-1).
\]
En el máximo, el gradiente respecto de \(w\) se anula:
\[
\nabla_w\mathcal{L}=2Sw-2\lambda w=0\quad\Longrightarrow\quad Sw=\lambda w.
\]
Es decir, toda dirección candidata es un vector propio de \(S\) (en otros textos, autovector), y \(\lambda\) es su valor propio (autovalor). Para saber cuál de los candidatos es el máximo, sustituye la condición en el objetivo:
\[
w^\top S w=w^\top(\lambda w)=\lambda\,w^\top w=\lambda .
\]
La varianza de los datos proyectados sobre un vector propio es exactamente su valor propio. La dirección de máxima varianza es, entonces, el vector propio con el mayor \(\lambda\). El segundo componente resuelve el mismo problema con una restricción más, \(w^\top w_1=0\), y su solución es el vector propio con el segundo mayor valor propio; así se obtienen todos.
Dos propiedades de \(S\) sostienen el resultado. Es simétrica, y por eso sus vectores propios pueden elegirse perpendiculares entre sí. Y es semidefinida positiva (ninguna dirección tiene varianza negativa), y por eso todos sus valores propios son mayores o iguales que cero.
PCA es no supervisado: encuentra direcciones de máxima varianza usando solo \(X\). No conoce las etiquetas, no intenta separar clases y una varianza grande no garantiza utilidad predictiva. Si luego coloreas una proyección por clase, el color solo sirve para interpretar una estructura que PCA encontró sin esa información.
25.5 Qué significa girar el sistema de coordenadas
La tabla sintética de cinco filas que usarás enseguida forma una nube alargada en diagonal. Los ejes horizontal y vertical no describen bien su forma. PCA gira los ejes: el primer eje queda sobre la dirección larga de la nube y el segundo, perpendicular, recoge la variación corta.
Este giro, por sí solo, no pierde información: con todos los ejes girados se recuperan exactamente los datos. La reducción ocurre cuando conservas las primeras \(k<p\) coordenadas y descartas las direcciones con poca varianza. Primero haces el cálculo completo a mano con una tabla de cinco filas; después ves la misma idea con dos mediciones de los vinos de entrenamiento y finalmente con las trece variables.
25.6 Preparación del entorno
La celda fija la semilla central SEMILLA = 2026, usa SVD completa como método numérico o solver y deja whiten=False: el whitening reescala las puntuaciones para que cada componente tenga varianza unitaria, y aquí interesa conservar sus varianzas relativas. Para la aplicación predictiva se usa la penalización L2, que añade al costo una suma de cuadrados de coeficientes, descrita en regularización.
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.datasets import load_winefrom sklearn.decomposition import PCAfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import accuracy_scorefrom sklearn.model_selection import StratifiedKFold, cross_val_score, train_test_splitfrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import StandardScalerSEMILLA =2026COLORES = ['#2A6F97', '#D97706', '#2D6A4F']plt.rcParams.update({'figure.figsize': (9, 5),'axes.spines.top': False,'axes.spines.right': False,'axes.titleweight': 'bold',})# Versiones y condiciones de referencia: CPU, sin GPU y datos incluidos en sklearn.import sysimport importlib.metadata as metadatosfrom sklearn.preprocessing import FunctionTransformerprint('Python:', sys.version.split()[0])for paquete in ['numpy','pandas','matplotlib','scipy','scikit-learn']:print(paquete +':', metadatos.version(paquete))print('PCA: SVD completa, sin whitening; regresión logística con penalización L2.')
25.7 Un cálculo completo a mano: cinco observaciones y dos variables
Ahora usarás otra tabla sintética de 5 filas para comprobar los cálculos. Es distinta de la del ejemplo visual inicial y permite seguir la media, la covarianza y las nuevas coordenadas con números pequeños. Con cinco filas y dos columnas se puede seguir cada número: la media, los datos centrados, la matriz de covarianza, sus valores y vectores propios, y las nuevas coordenadas. El propósito es comprobar que entre la tabla y el primer componente no hay ningún paso oculto.
En una primera lectura puedes observar la tabla y la salida sin resolver la ecuación. El desarrollo siguiente está pensado para volver sobre él después de comprender la proyección.
Con dos variables, la ecuación \(Sw=\lambda w\) se resuelve con álgebra de bachillerato. Tiene solución distinta de cero solo si \(\det(S-\lambda I)=0\), y para una matriz \(2\times 2\) esa condición es una ecuación de segundo grado:
donde \(\operatorname{tr}(S)\) es la traza (la suma de la diagonal, es decir, la varianza total) y \(\det(S)\) el determinante. Con cada \(\lambda\), el vector propio se despeja de la primera fila de \((S-\lambda I)w=0\) y se normaliza a longitud uno.
X_mini = np.array([ [2.0, 1.0], [3.0, 2.0], [4.0, 2.5], [5.0, 3.5], [6.0, 4.0],])n_mini = X_mini.shape[0]# 1. Centrarmedia_mini = X_mini.mean(axis=0)Xc_mini = X_mini - media_mini# 2. Matriz de covarianzaS_mini = Xc_mini.T @ Xc_mini / (n_mini -1)# 3. Valores propios: raíces de λ² − tr(S)·λ + det(S) = 0traza = S_mini[0, 0] + S_mini[1, 1]determinante = S_mini[0, 0] * S_mini[1, 1] - S_mini[0, 1] **2discriminante = np.sqrt(traza **2-4* determinante)lambda_1 = (traza + discriminante) /2lambda_2 = (traza - discriminante) /2# 4. Vectores propios: de la primera fila de (S − λI) w = 0, y se normalizanw1 = np.array([S_mini[0, 1], lambda_1 - S_mini[0, 0]])w1 = w1 / np.linalg.norm(w1)w2 = np.array([S_mini[0, 1], lambda_2 - S_mini[0, 0]])w2 = w2 / np.linalg.norm(w2)W_mini = np.column_stack([w1, w2])# 5. Nuevas coordenadas (scores)Z_mini = Xc_mini @ W_miniprint('Media de cada variable:', media_mini)print('Datos centrados:')print(Xc_mini)print('Matriz de covarianza S:')print(S_mini)print(f'Traza = {traza:.4f} Determinante = {determinante:.6f}')print(f'Valores propios: λ1 = {lambda_1:.4f} λ2 = {lambda_2:.4f} (suma = {lambda_1 + lambda_2:.4f})')print('w1 =', np.round(w1, 4), ' w2 =', np.round(w2, 4), f' w1·w2 = {w1 @ w2:.1e}')print(f'Proporción de varianza de PC1: {lambda_1 / traza:.2%}')print('Scores Z = Xc W:')print(np.round(Z_mini, 4))print('Covarianza de los scores (debe ser diagonal, con λ1 y λ2):')print(np.round(Z_mini.T @ Z_mini / (n_mini -1), 4))# Comprobación con las rutinas de NumPy y scikit-learnvalores_np, vectores_np = np.linalg.eigh(S_mini)pca_mini = PCA(n_components=2, svd_solver='full').fit(X_mini)print()print('np.linalg.eigh, valores propios (de menor a mayor):', np.round(valores_np, 4))print('scikit-learn, explained_variance_:', np.round(pca_mini.explained_variance_, 4))print('scikit-learn, primer componente:', np.round(pca_mini.components_[0], 4))
Media de cada variable: [4.  2.6]
Datos centrados:
[[-2.  -1.6]
 [-1.  -0.6]
 [ 0.  -0.1]
 [ 1.   0.9]
 [ 2.   1.4]]
Matriz de covarianza S:
[[2.5   1.875]
 [1.875 1.425]]
Traza = 3.9250   Determinante = 0.046875
Valores propios: λ1 = 3.9130   λ2 = 0.0120   (suma = 3.9250)
w1 = [0.7986 0.6018]   w2 = [ 0.6018 -0.7986]   w1·w2 = 0.0e+00
Proporción de varianza de PC1: 99.69%
Scores Z = Xc W:
[[-2.5602  0.0741]
 [-1.1597 -0.1227]
 [-0.0602  0.0799]
 [ 1.3403 -0.1169]
 [ 2.4398  0.0856]]
Covarianza de los scores (debe ser diagonal, con λ1 y λ2):
[[3.913 0.   ]
 [0.    0.012]]

np.linalg.eigh, valores propios (de menor a mayor): [0.012 3.913]
scikit-learn, explained_variance_: [3.913 0.012]
scikit-learn, primer componente: [0.7986 0.6018]
Las 5 observaciones permiten rehacer medias, covarianzas, valores propios y puntuaciones con lápiz.
Centro y covarianza. Las medias son 4 y 2.6. La matriz de covarianza tiene varianzas 2.5 y 1.425 en la diagonal y covarianza 1.875 fuera de ella. Su traza, 3.925, es la varianza total de la tabla.
Valores propios. La ecuación \(\lambda^2-3.925\,\lambda+0.046875=0\) tiene raíces \(\lambda_1=\)3.9130 y \(\lambda_2=\)0.0120. Suman 3.925: PCA no crea ni destruye varianza, la reparte entre los ejes nuevos. El primero se queda con 99.69%, porque los cinco puntos están casi sobre una recta.
Vectores propios.\(w_1=(0.7986,\,0.6018)\) es esa recta: por cada 0.80 que avanza la primera variable, la segunda avanza 0.60. \(w_2=(0.6018,\,-0.7986)\) es perpendicular (su producto punto con \(w_1\) es cero, salvo redondeo).
Scores. La primera columna de \(Z\) ubica cada observación a lo largo de la recta, de \(-2.56\) a \(2.44\); la segunda recoge lo poco que se apartan de ella, nunca más de \(0.13\). La covarianza de los scores es diagonal, con \(\lambda_1\) y \(\lambda_2\): las nuevas coordenadas no están correlacionadas y sus varianzas son los valores propios.
Esa última comprobación sirve como prueba de cualquier PCA hecho a mano. Si la covarianza de los scores no sale diagonal, o su diagonal no coincide con los valores propios, hay un error de centrado, de orden de los componentes o de divisor (\(n\) frente a \(n-1\)).
np.linalg.eigh y scikit-learn devuelven los mismos valores. Sobre el signo: una rutina puede entregar \((-0.7986,\,-0.6018)\) en lugar de \(w_1\). Es el mismo eje recorrido en sentido contrario, y los scores cambian de signo con él.
25.8 Datos y reserva inicial de la prueba
load_wine contiene 178 vinos y 13 mediciones químicas, procedentes de tres cultivares de una misma región italiana. La fuente es Wine, UCI Machine Learning Repository, con licencia CC BY 4.0. scikit-learn distribuye una copia que puede cargarse sin conexión; conserva esa atribución si reutilizas sus datos o figuras.
Antes de calcular correlaciones, escalas o componentes, reservas 30 % como prueba estratificada. Las siguientes descripciones y reconstrucciones usarán solo los 124 vinos de entrenamiento. Los 54 reservados se abrirán en la comparación final, después de fijar el número de componentes.
wine = load_wine(as_frame=True)nombres_clase = wine.target_namesX, X_reservado, y, y_reservado = train_test_split( wine.data, wine.target, test_size=0.30, random_state=SEMILLA, stratify=wine.target)X = X.copy()y = y.copy()print(f'Observaciones totales del conjunto: {len(wine.data)}')print(f'Entrenamiento para descripción y selección: {len(X)} | prueba reservada: {len(X_reservado)}')print(f'Variables numéricas: {X.shape[1]}')print('Observaciones de entrenamiento por clase:', y.value_counts().sort_index().to_dict())display(X.head().round(2))display(X.describe().loc[['mean','std','min','max']].round(2))
alcohol
malic_acid
ash
alcalinity_of_ash
magnesium
total_phenols
flavanoids
nonflavanoid_phenols
proanthocyanins
color_intensity
hue
od280/od315_of_diluted_wines
proline
15
13.63
1.81
2.70
17.2
112.0
2.85
2.91
0.30
1.46
7.30
1.28
2.88
1310.0
133
12.70
3.55
2.36
21.5
106.0
1.70
1.20
0.17
0.84
5.00
0.78
1.29
600.0
134
12.51
1.24
2.25
17.5
85.0
2.00
0.58
0.60
1.25
5.45
0.75
1.51
650.0
109
11.61
1.35
2.70
20.0
94.0
2.74
2.92
0.29
2.49
2.65
0.96
3.26
680.0
143
13.62
4.95
2.35
20.0
92.0
2.00
0.80
0.47
1.02
4.40
0.91
2.05
550.0
alcohol
malic_acid
ash
alcalinity_of_ash
magnesium
total_phenols
flavanoids
nonflavanoid_phenols
proanthocyanins
color_intensity
hue
od280/od315_of_diluted_wines
proline
mean
13.00
2.30
2.36
19.44
99.88
2.26
2.02
0.35
1.54
5.00
0.97
2.60
733.80
std
0.81
1.09
0.27
3.01
13.55
0.63
0.98
0.12
0.56
2.19
0.23
0.69
319.65
min
11.41
0.74
1.70
12.00
78.00
0.98
0.34
0.14
0.41
1.95
0.48
1.29
278.00
max
14.83
5.80
3.22
27.00
151.00
3.85
3.93
0.66
3.58
10.80
1.45
4.00
1680.00
Observaciones totales del conjunto: 178
Entrenamiento para descripción y selección: 124 | prueba reservada: 54
Variables numéricas: 13
Observaciones de entrenamiento por clase: {0: 41, 1: 50, 2: 33}
El entrenamiento contiene 124 vinos y 13 variables, con 41, 50 y 33 observaciones por cultivar. Sus etiquetas no forman parte de las columnas de PCA. En este grupo, nonflavanoid_phenols va de 0.14 a 0.66 y proline, de 278 a 1680; las unidades influyen en una optimización basada en varianza.
25.9 Detectar redundancia entre variables
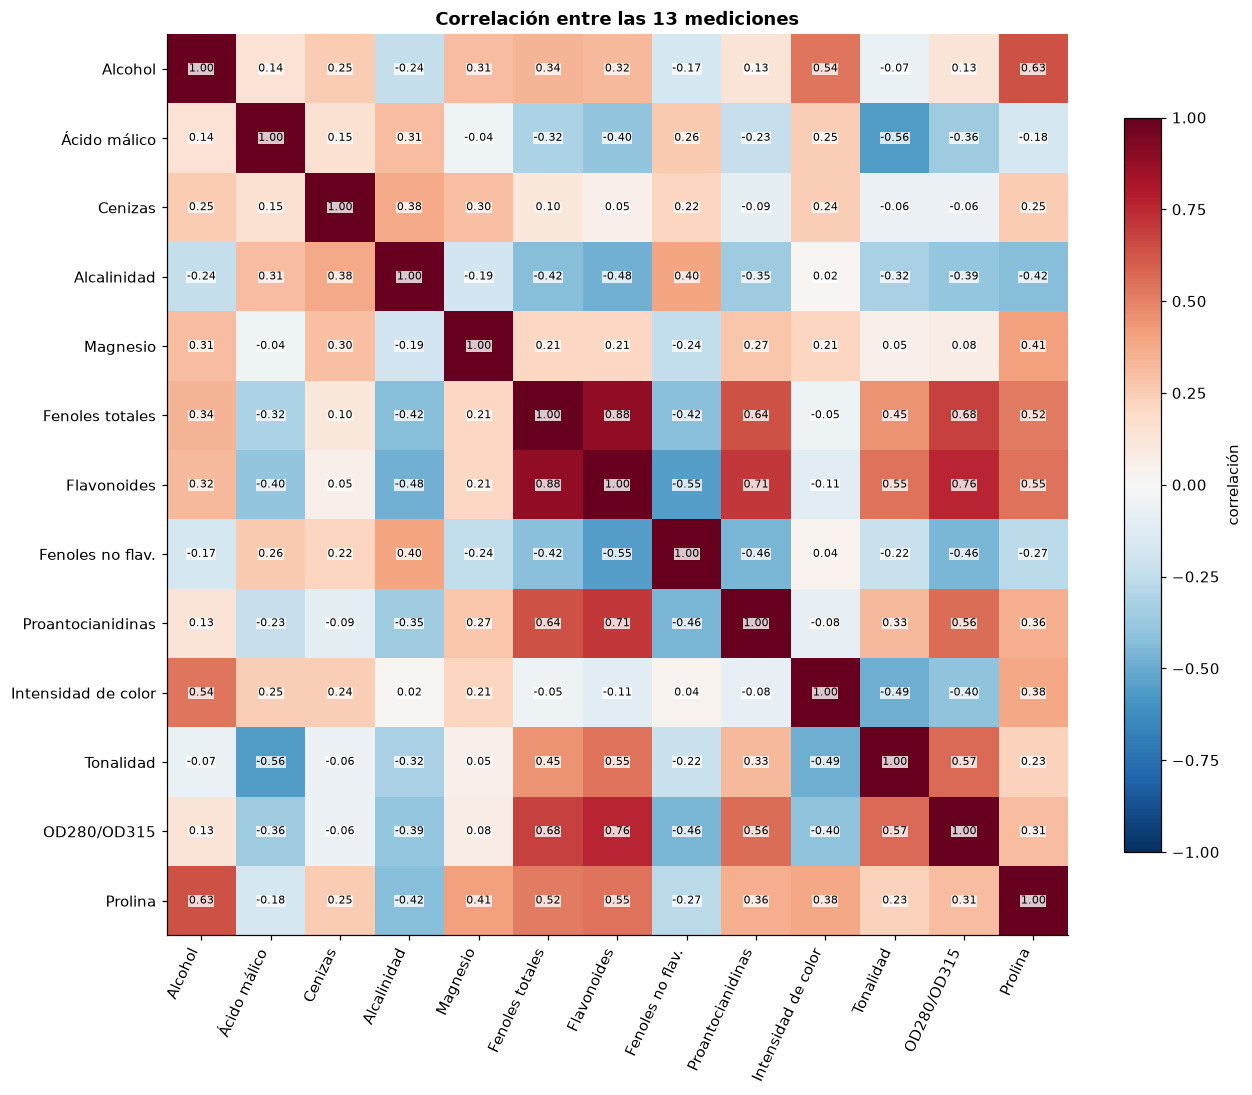
Trece variables no parecen demasiadas, pero ya dificultan una inspección conjunta. Una matriz de correlaciones permite detectar pares que se mueven de forma parecida. Si abundan correlaciones altas, existe información compartida que unas pocas direcciones podrían resumir.
En los 124 vinos de entrenamiento, total_phenols y flavanoids tienen correlación 0.883. flavanoids se relaciona también con od280/od315_of_diluted_wines (0.760) y proanthocyanins (0.706). El mapa anota los valores para que su interpretación no dependa solo del color. Estas asociaciones motivan resumir la variación compartida, sin establecer causalidad.
25.10 Estandarizar antes de PCA
PCA maximiza varianza. Si una variable está medida con números mucho mayores, puede dominar el resultado solo por sus unidades. Aquí la prolina usa centenas y miles, mientras otras mediciones se mantienen por debajo de 1.
Por eso la estandarización es obligatoria en este ejemplo. StandardScaler, que ya conoces, transforma cada columna como
Así, cada variable queda con media cercana a 0 y desviación estándar poblacional cercana a 1. PCA sobre datos estandarizados equivale a trabajar con la estructura de correlaciones, no con las unidades originales.
escalador = StandardScaler()X_std = escalador.fit_transform(X)pca_sin_escalar = PCA(svd_solver='full').fit(X)pca_estandarizado_previo = PCA(svd_solver='full').fit(X_std)variable_dominante = X.columns[np.argmax(np.abs(pca_sin_escalar.components_[0]))]print(f'Máxima media estandarizada en valor absoluto: {np.abs(X_std.mean(axis=0)).max():.2e}')print(f'Desviaciones estándar poblacionales: {X_std.std(axis=0).min():.3f} a {X_std.std(axis=0).max():.3f}')print(f'Sin escalar, PC1 explica: {pca_sin_escalar.explained_variance_ratio_[0]:.2%}')print(f'Variable dominante sin escalar: {variable_dominante}')print(f'Estandarizado, PC1 explica: {pca_estandarizado_previo.explained_variance_ratio_[0]:.2%}')
Máxima media estandarizada en valor absoluto: 2.46e-15
Desviaciones estándar poblacionales: 1.000 a 1.000
Sin escalar, PC1 explica: 99.84%
Variable dominante sin escalar: proline
Estandarizado, PC1 explica: 37.44%
Las columnas estandarizadas tienen media numéricamente próxima a cero y desviación poblacional 1.000. Sin escalar, PC1 explica 99.84%, dominada por proline; tras estandarizar explica 37.44%. El cambio corresponde a dar a cada medición una escala comparable, y no a una pérdida de rendimiento predictivo demostrada.
Para la comparación posterior, tanto el escalador como PCA se volverán a ajustar dentro de cada fold del entrenamiento. La prueba reservada no interviene en estos cálculos.
25.11 Intuición geométrica con dos variables
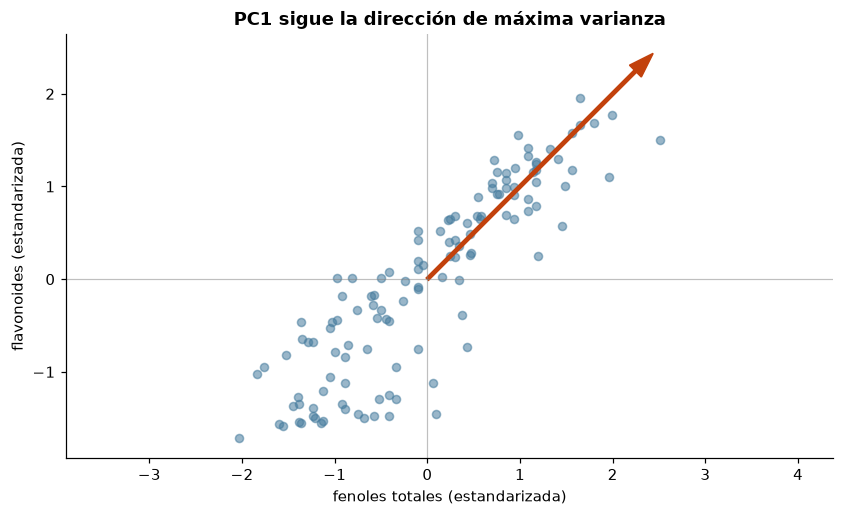
Toma las dos variables más correlacionadas. Después de estandarizarlas, una flecha mostrará el primer vector propio. Su orientación debe seguir el eje largo de la nube; una segunda dirección ortogonal recogería la dispersión restante.
variables_2d = ['total_phenols', 'flavanoids']X_2d = StandardScaler().fit_transform(X[variables_2d])pca_2d = PCA(n_components=2, svd_solver='full').fit(X_2d)direccion_pc1 = pca_2d.components_[0]longitud =2.5* np.sqrt(pca_2d.explained_variance_[0])plt.scatter(X_2d[:, 0], X_2d[:, 1], s=28, alpha=0.55, color='#457B9D')plt.arrow(0, 0, longitud * direccion_pc1[0], longitud * direccion_pc1[1], width=0.035, head_width=0.18, color='#C2410C', length_includes_head=True)plt.axhline(0, color='gray', lw=0.8, alpha=0.5)plt.axvline(0, color='gray', lw=0.8, alpha=0.5)plt.xlabel('fenoles totales (estandarizada)')plt.ylabel('flavonoides (estandarizada)')plt.title('PC1 sigue la dirección de máxima varianza')plt.axis('equal')plt.show()print(f'Correlación entre las variables: {X[variables_2d].corr().iloc[0, 1]:.3f}')print(f'Varianza explicada por PC1 en este plano: {pca_2d.explained_variance_ratio_[0]:.2%}')print('Dirección de PC1:', np.round(direccion_pc1, 3))
Correlación entre las variables: 0.883
Varianza explicada por PC1 en este plano: 94.17%
Dirección de PC1: [0.707 0.707]
La correlación entre total_phenols y flavanoids es 0.883 y PC1 conserva 94.17% de la varianza de este plano. La dirección es \((1,1)/\sqrt{2}\), con pesos 0.707 y 0.707 salvo un signo global.
Para dos variables estandarizadas con correlación positiva, la matriz de correlaciones tiene la forma \(R=\begin{pmatrix}1&r\\r&1\end{pmatrix}\) y ese vector propio tiene valor propio \(1+r\). La covarianza de las columnas que produce StandardScaler multiplica \(R\) por \(124/123\), porque usa otro divisor; las direcciones y proporciones se conservan. Por eso PC1 recoge \((1+r)/2\) de la varianza. Con trece variables, sus pesos dependen de toda la estructura de correlaciones.
Los scores son no correlacionados en la muestra de ajuste. Esa propiedad no demuestra independencia estadística; el capítulo de ICA aborda esa diferencia.
Antes de pasar a las trece variables, anticipa el resultado: si una dirección conserva 94.17 % del plano total_phenols–flavanoids, ¿bastarán dos componentes para retener el 90 % de la varianza de todo el conjunto?
25.12 Ajustar PCA completo
Ahora usas las 13 variables estandarizadas y ajustas todos los componentes para observar cómo se reparte la varianza antes de decidir cuántos conservar. La proporción de varianza explicada (PVE) por el componente \(j\) es
Error máximo en WᵀW = I: 1.44e-15
Máxima covarianza cruzada entre scores: 7.01e-16
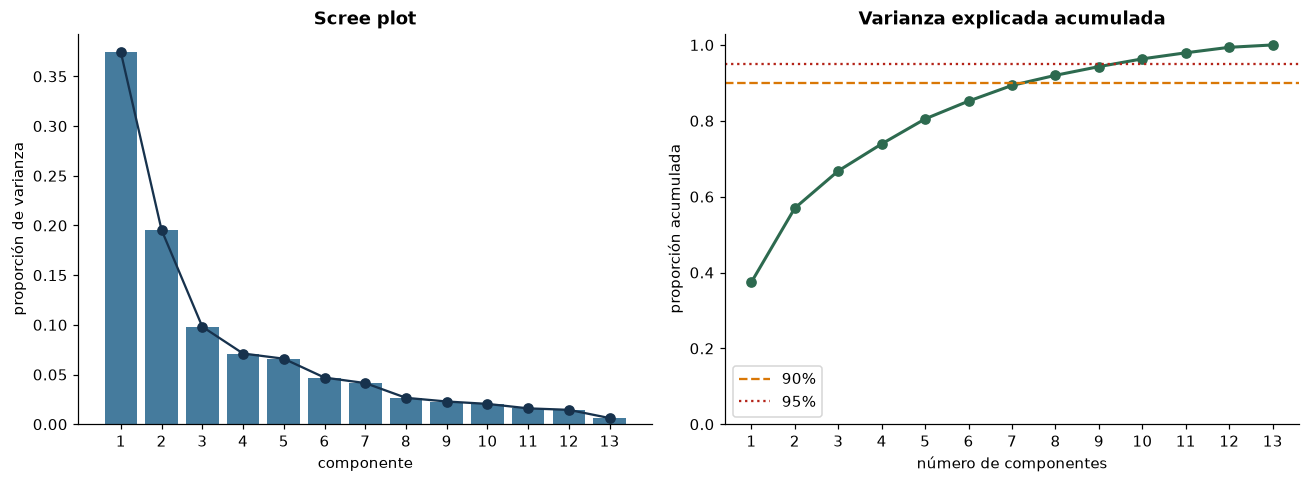
PC1 explica 37.44% y PC2, 19.54%. Juntas conservan 56.98% de la varianza de entrenamiento. PC3 añade 9.81% y lleva el acumulado a 66.79%. La respuesta a la pregunta anterior es negativa: la correlación de 0.883 en un par no se extiende a las trece columnas, y dos componentes quedan lejos del 90 %.
Las comprobaciones de ortogonalidad y covarianza cruzada de la celda muestran diferencias próximas a precisión numérica. La verificación se refiere a las direcciones y puntuaciones ajustadas con los 124 vinos; no demuestra que las variables sean independientes ni que esos ejes tengan una interpretación causal.
25.13 Dos caminos al mismo resultado: valores propios y SVD
NotaDetalle numérico para volver después
La SVD explica cómo calcular las direcciones de PCA. En el primer recorrido puedes continuar en cuántos componentes conservar, sin desarrollar esta factorización.
PCA de scikit-learn devolvió direcciones y varianzas, pero no mostró cómo las obtuvo. Hay dos caminos y conviene ver que llegan al mismo sitio.
Camino 1: valores propios de la matriz de covarianza. Es el de la teoría: se forma \(S=\frac{1}{n-1}X_c^\top X_c\) y se calculan sus valores y vectores propios, como en el ejemplo de cinco filas.
Camino 2: descomposición en valores singulares (SVD). Toda matriz se puede factorizar como
\[
X_c=U\,\Sigma\,V^\top,
\]
usando aquí la SVD reducida de una matriz con más filas que columnas, donde las columnas de \(U\) y de \(V\) son ortonormales y \(\Sigma\) es diagonal, con los valores singulares\(s_1\ge s_2\ge\cdots\ge 0\). Al sustituir en la covarianza, \(U\) desaparece porque \(U^\top U=I\):
Las columnas de \(V\) son los vectores propios de \(S\), los valores singulares al cuadrado (divididos por \(n-1\)) son sus valores propios, y \(U\Sigma\) son directamente los scores. La SVD entrega todo PCA sin construir \(S\).
n_obs = X_std.shape[0]Xc = X_std - X_std.mean(axis=0)# Camino 1: valores y vectores propios de la matriz de covarianzaS = Xc.T @ Xc / (n_obs -1)valores, vectores = np.linalg.eigh(S) # eigh los devuelve de menor a mayororden = np.argsort(valores)[::-1]valores, vectores = valores[orden], vectores[:, orden]# Camino 2: descomposición en valores singulares de los datos centradosU, s, Vt = np.linalg.svd(Xc, full_matrices=False)valores_svd = s **2/ (n_obs -1)comparacion_caminos = pd.DataFrame({'componente': np.arange(1, X.shape[1] +1),'valores propios de S': valores,'s² / (n − 1)': valores_svd,'scikit-learn': pca_completo.explained_variance_,})display(comparacion_caminos.head(5).round(4))print(f'Suma de los valores propios: {valores.sum():.4f} Traza de S: {np.trace(S):.4f}')print(f'Diferencia máxima entre caminos 1 y 2: {np.max(np.abs(valores - valores_svd)):.2e}')print(f'Diferencia máxima con scikit-learn: {np.max(np.abs(valores_svd - pca_completo.explained_variance_)):.2e}')# Las direcciones coinciden salvo el signo: el producto punto de cada par debe ser +1 o −1productos_eigh = np.sum(vectores * pca_completo.components_.T, axis=0)productos_svd = np.sum(Vt.T * pca_completo.components_.T, axis=0)print('Producto punto, vector propio · componente de scikit-learn (primeros 5):', np.round(productos_eigh[:5], 4))print('Producto punto, columna de V · componente de scikit-learn (primeros 5): ', np.round(productos_svd[:5], 4))# Los scores son U·Σscores_svd = U * ssignos = np.sign(productos_svd)signos[signos ==0] =1scores_svd_alineados = scores_svd * signosdiferencia_scores = np.max(np.abs(scores_svd_alineados - scores))print(f'Diferencia máxima entre UΣ alineado y los scores de scikit-learn: {diferencia_scores:.2e}')
componente
valores propios de S
s² / (n − 1)
scikit-learn
0
1
4.9063
4.9063
4.9063
1
2
2.5614
2.5614
2.5614
2
3
1.2859
1.2859
1.2859
3
4
0.9328
0.9328
0.9328
4
5
0.8640
0.8640
0.8640
Suma de los valores propios: 13.1057   Traza de S: 13.1057
Diferencia máxima entre caminos 1 y 2: 6.22e-15
Diferencia máxima con scikit-learn:    8.88e-16
Producto punto, vector propio · componente de scikit-learn (primeros 5): [-1. -1.  1. -1. -1.]
Producto punto, columna de V · componente de scikit-learn (primeros 5):   [-1.  1. -1.  1. -1.]
Diferencia máxima entre UΣ alineado y los scores de scikit-learn: 1.78e-14
Los cinco primeros valores propios son 4.9063, 2.5614, 1.2859, 0.9328, 0.8640. NumPy y PCA reproducen esas varianzas salvo redondeo. Su suma total es 13.1057, igual a la traza de la covarianza.
La suma supera 13 porque StandardScaler usa divisor \(n=124\) y la covarianza usa \(n-1=123\): cada columna estandarizada tiene varianza muestral \(124/123\), de modo que la traza es \(13\times124/123\). El factor se cancela en cada proporción de varianza explicada.
Los vectores calculados por distintas rutinas pueden cambiar un signo global. Antes de comparar los scores se alinea un signo por componente usando el producto punto de sus direcciones. Si hubiera valores propios repetidos, también podría cambiar la base dentro de su subespacio; en ese caso convendría comparar subespacios.
La descomposición de la covarianza ayuda a demostrar el resultado. La SVD completa trabaja directamente con la matriz centrada y evita formar esa covarianza. El capítulo fija svd_solver='full' en todos los ajustes para conservar el mismo procedimiento numérico; las implementaciones automáticas pueden elegir otro solver según tamaño y configuración.
25.14 Cuántos componentes conservar
Dos criterios habituales son:
Regla del codo: busca dónde las ganancias marginales del scree plot comienzan a aplanarse. Es visual y puede ser ambigua.
Umbral acumulado: elige el menor \(k\) que alcance, por ejemplo, 90% o 95% de varianza. Es reproducible, pero el umbral depende del costo de perder información.
Para una tarea predictiva, \(k\) es un hiperparámetro: conviene contrastarlo mediante validación cruzada sobre entrenamiento, no escogerlo mirando el conjunto de prueba.
Mínimo para alcanzar 90%: 8 componentes (92.00%)
Mínimo para alcanzar 95%: 10 componentes (96.33%)
En la curva de los 124 vinos, las mayores contribuciones están en los primeros componentes. El codo visual orienta una representación compacta y es ambiguo. Para un criterio explícito, 8 componentes conservan 92.00%, superando el 90 %, y 10 conservan 96.33%, superando el 95 %.
Un umbral de varianza responde a compresión. La selección para clasificación se evaluará por exactitud dentro del entrenamiento, porque una dirección poco variable puede contener información sobre el cultivar.
25.15 Proyectar los vinos en dos componentes
Para visualizar, conservas PC1 y PC2. Cada punto seguirá siendo un vino, pero sus coordenadas ya no serán alcohol o magnesio: serán dos combinaciones de las 13 variables.
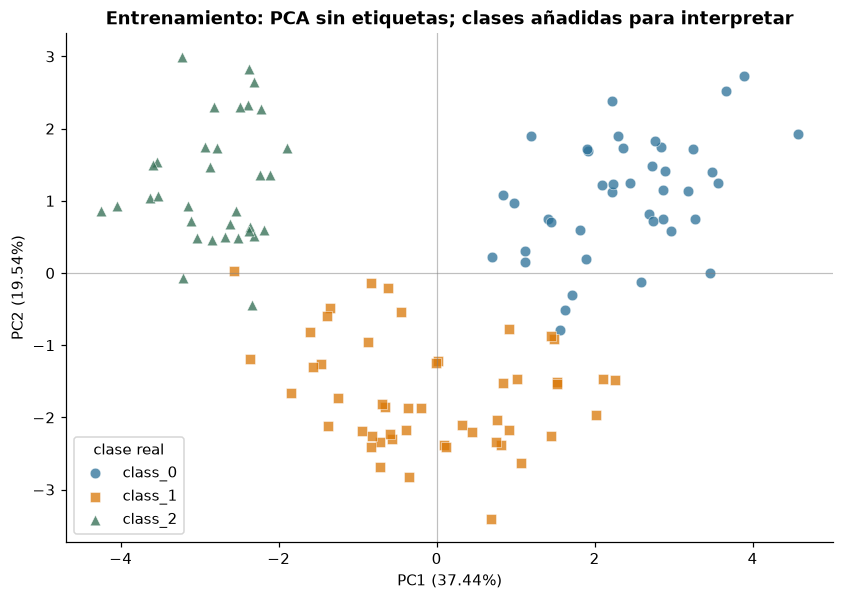
La figura colorea los puntos con la etiqueta real después de ajustar PCA. El color sirve para comprobar si la estructura no supervisada coincide con grupos conocidos; no participó en el cálculo de los ejes.
Las formas de los puntos identifican los cultivares además de sus colores. Los centroides de class_0, class_1 y class_2 tienen coordenadas PC1 2.375, -0.097 y -2.804, respectivamente. En PC2, el centro de class_1 está en -1.683.
La proyección de entrenamiento muestra una alineación entre varianza y etiquetas, añadidas después de ajustar los ejes. No demuestra que dos componentes sean suficientes para clasificar vinos nuevos. El contraejemplo siguiente construye una situación en que la dirección de baja varianza contiene la separación.
25.16 Un contraejemplo: cuando las clases se separan en la dirección de menor varianza
La advertencia anterior merece un ejemplo, porque es el error más frecuente al usar PCA antes de un modelo supervisado. Construyes dos variables medidas en la misma unidad:
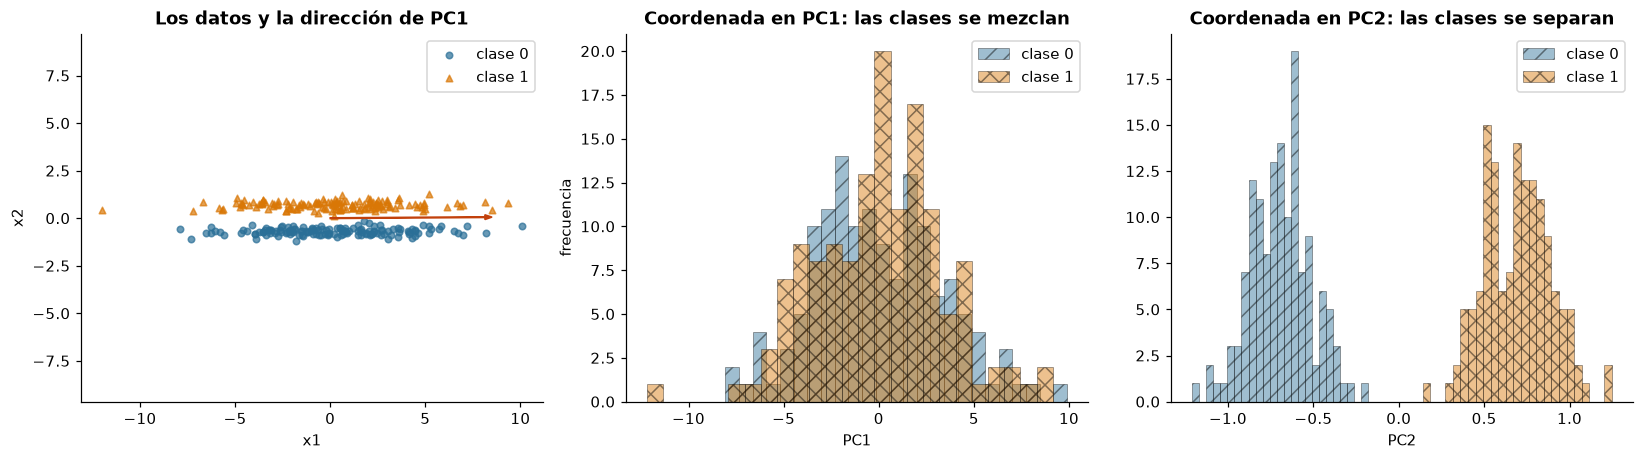
\(x_1\) varía mucho (desviación estándar 3.2) y no tiene relación con la clase;
\(x_2\) varía poco, pero es la que separa los dos grupos: uno está centrado en \(-0.7\) y el otro en \(0.7\).
PCA no conoce las clases. Pondrá PC1 sobre la dirección de mayor varianza, que aquí es \(x_1\). Para medir la consecuencia, entrenas la misma regresión logística con tres entradas distintas (solo PC1, solo PC2 y las dos variables originales) y comparas su exactitud con validación cruzada. Las variables no se estandarizan: ya comparten unidad, y la diferencia de varianza entre ellas es justamente lo que se quiere observar.
El PCA de las figuras describe la muestra sintética completa. Para medir exactitud, cada pipeline vuelve a ajustar PCA únicamente con las filas de entrenamiento de su fold, incluida la alternativa que selecciona PC2. La exactitud es la proporción global de observaciones correctamente clasificadas; las dos clases sintéticas tienen el mismo tamaño.
En este ejemplo binario se identifica la clase 1 como positiva. Se informa exactitud global sobre ambas clases; no se interpreta como precisión de la clase positiva.
rng_contra = np.random.default_rng(SEMILLA)n_contra =280mitad = n_contra //2x1 = rng_contra.normal(0, 3.2, size=n_contra) # mucha varianza, sin relación con la clasex2 = np.r_[rng_contra.normal(-0.7, 0.18, size=mitad), # poca varianza, separa las clases rng_contra.normal(0.7, 0.18, size=n_contra - mitad)]clase_contra = np.r_[np.zeros(mitad, dtype=int), np.ones(n_contra - mitad, dtype=int)]X_contra = np.column_stack([x1, x2])pca_contra = PCA(n_components=2, svd_solver='full').fit(X_contra)scores_contra = pca_contra.transform(X_contra)print('Varianza de x1 y de x2:', np.round(X_contra.var(axis=0, ddof=1), 3))print('Proporción de varianza explicada por PC1 y PC2:', np.round(pca_contra.explained_variance_ratio_, 4))print('Dirección de PC1 (pesos de x1 y x2):', np.round(pca_contra.components_[0], 3))print('Dirección de PC2 (pesos de x1 y x2):', np.round(pca_contra.components_[1], 3))cv_contra = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEMILLA)entradas = {'solo PC1': Pipeline([('pca', PCA(n_components=1, svd_solver='full')), ('clf', LogisticRegression())]),'las dos variables originales': Pipeline([('clf', LogisticRegression())]),}print()for nombre, modelo in entradas.items(): exactitud = cross_val_score(modelo, X_contra, clase_contra, cv=cv_contra, scoring='accuracy')print(f'Exactitud en validación cruzada, {nombre}: {exactitud.mean():.3f}')modelo_pc2 = Pipeline([ ('pca', PCA(n_components=2, svd_solver='full')), ('seleccionar_pc2', FunctionTransformer(lambda z: z[:, [1]])), ('clf', LogisticRegression()),])exactitud_pc2 = cross_val_score(modelo_pc2, X_contra, clase_contra, cv=cv_contra, scoring='accuracy')print(f'Exactitud en validación cruzada, solo PC2 (el componente descartado): {exactitud_pc2.mean():.3f}')fig, ax = plt.subplots(1, 3, figsize=(15, 4.3))for clase, color, forma, patron inzip([0, 1], COLORES[:2], ['o','^'], ['//','xx']): mascara = clase_contra == clase ax[0].scatter(X_contra[mascara, 0], X_contra[mascara, 1], s=18, alpha=0.7, color=color, marker=forma, label=f'clase {clase}') ax[1].hist(scores_contra[mascara, 0], bins=25, alpha=0.45, color=color, hatch=patron, edgecolor='black', linewidth=0.5, label=f'clase {clase}') ax[2].hist(scores_contra[mascara, 1], bins=25, alpha=0.45, color=color, hatch=patron, edgecolor='black', linewidth=0.5, label=f'clase {clase}')largo =2.5* np.sqrt(pca_contra.explained_variance_[0])ax[0].arrow(0, 0, largo * pca_contra.components_[0, 0], largo * pca_contra.components_[0, 1], width=0.04, head_width=0.25, color='#C2410C', length_includes_head=True)ax[0].set(title='Los datos y la dirección de PC1', xlabel='x1', ylabel='x2')ax[0].axis('equal')ax[0].legend()ax[1].set(title='Coordenada en PC1: las clases se mezclan', xlabel='PC1', ylabel='frecuencia')ax[2].set(title='Coordenada en PC2: las clases se separan', xlabel='PC2')ax[1].legend()ax[2].legend()plt.tight_layout()plt.show()
Varianza de x1 y de x2: [11.588  0.516]
Proporción de varianza explicada por PC1 y PC2: [0.9574 0.0426]
Dirección de PC1 (pesos de x1 y x2): [1.    0.007]
Dirección de PC2 (pesos de x1 y x2): [-0.007  1.   ]

Exactitud en validación cruzada, solo PC1: 0.457
Exactitud en validación cruzada, las dos variables originales: 1.000
Exactitud en validación cruzada, solo PC2 (el componente descartado): 1.000
PCA hizo bien su trabajo. La varianza de \(x_1\) es 11.59 y la de \(x_2\) es 0.52, así que PC1 apunta casi exactamente sobre \(x_1\) (pesos \(1.000\) y \(0.007\)) y explica 95.74% de la varianza. PC2 coincide con \(x_2\) y explica el 4.26% restante.
Un criterio de varianza acumulada conservaría solo PC1 y descartaría PC2. La consecuencia para la clasificación es total:
con solo PC1, la exactitud en validación cruzada es 0.457: cercana a la referencia de azar de 0.5 para dos clases equilibradas; una puntuación aislada no demuestra equivalencia estadística con el azar;
con solo PC2, el componente descartado, es 1.000;
con las dos variables originales, 1.000.
Los histogramas lo muestran: sobre PC1 las dos clases se superponen por completo; sobre PC2 quedan separadas sin un solo punto en común.
PCA respondió la pregunta que se le hizo, ¿dónde está la varianza?, y esa no es la pregunta de un clasificador, ¿dónde está la diferencia entre clases? En los vinos las dos coinciden en buena medida; aquí no coinciden en absoluto. Los datos de este ejemplo se construyeron para llevar el caso al extremo, y el resultado en datos reales dependerá de dónde esté la información predictiva y debe comprobarse mediante validación.
Dos consecuencias prácticas. La primera: cuando PCA precede a un modelo supervisado, el número de componentes se elige por el desempeño del modelo en validación cruzada, como en la utilidad práctica de este capítulo, y no por el porcentaje de varianza. La segunda: estandarizar no resuelve este problema por sí solo, porque cambia qué direcciones tienen más varianza pero no hace que PCA mire las etiquetas. Si lo que se busca es separar clases, existen métodos de reducción supervisados, como el análisis discriminante lineal, que sí las usan.
25.17 Qué representan PC1 y PC2: leer las cargas
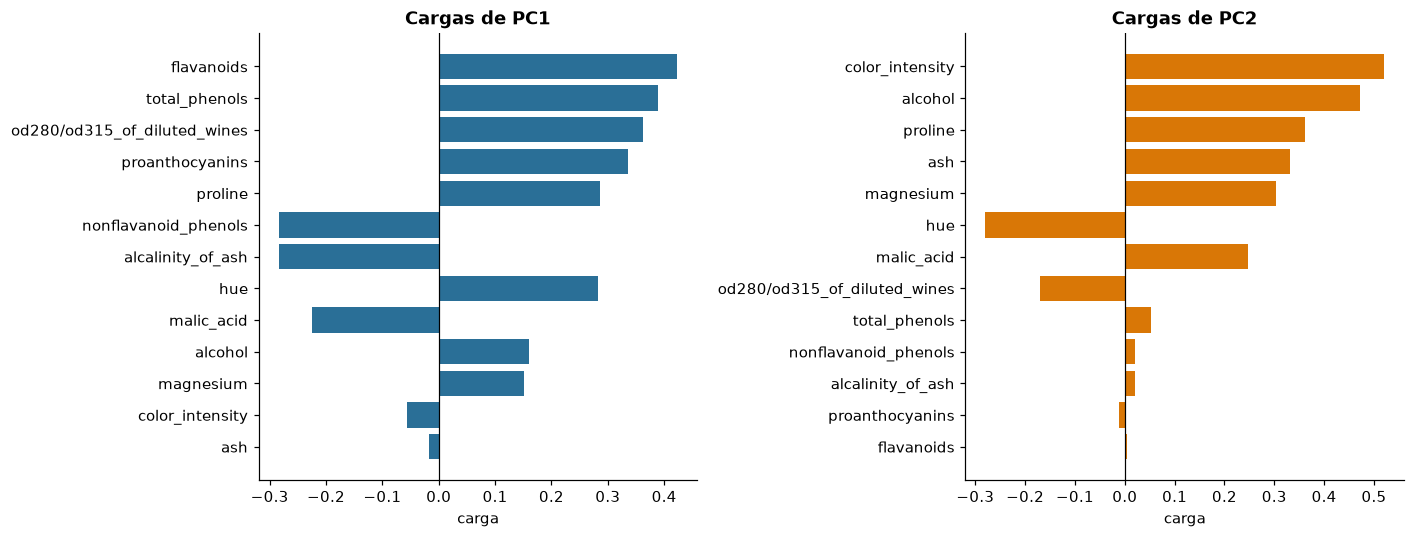
Cada coeficiente de PCA.components_ indica cuánto participa una variable estandarizada en la dirección de un componente. En este capítulo se llaman cargas esos coeficientes de los vectores propios unitarios: una magnitud grande implica mayor participación y el signo indica dirección relativa. En otros textos, “carga” puede referirse al coeficiente escalado por \(\sqrt{\lambda_j}\), que se relaciona con la correlación entre variable y componente.
El signo global es arbitrario: multiplicar un vector propio y sus scores por \(-1\) describe exactamente el mismo eje. Por eso interpreta patrones de magnitud y contraste, no etiquetas como “positivo” o “negativo” de forma aislada.
cargas = pd.DataFrame( pca_completo.components_[:2].T, index=X.columns, columns=['PC1', 'PC2'],)fig, ax = plt.subplots(1, 2, figsize=(13, 5))for eje, componente, color inzip(ax, ['PC1', 'PC2'], ['#2A6F97', '#D97706']): orden = cargas[componente].abs().sort_values().index eje.barh(orden, cargas.loc[orden, componente], color=color) eje.axvline(0, color='black', lw=0.8) eje.set_title(f'Cargas de {componente}') eje.set_xlabel('carga')plt.tight_layout()plt.show()for componente in ['PC1', 'PC2']: principales = cargas[componente].reindex(cargas[componente].abs().sort_values(ascending=False).index).head(5)print(f'Cinco mayores cargas absolutas de {componente}:') display(principales.to_frame('carga').round(3))
carga
flavanoids
0.423
total_phenols
0.390
od280/od315_of_diluted_wines
0.362
proanthocyanins
0.335
proline
0.286
carga
color_intensity
0.520
alcohol
0.472
proline
0.362
ash
0.332
magnesium
0.303
Cinco mayores cargas absolutas de PC1:
Cinco mayores cargas absolutas de PC2:
En PC1, flavanoids tiene peso 0.423, total_phenols0.390 y od280/od315_of_diluted_wines0.362. El contraste con nonflavanoid_phenols (-0.284) ayuda a describir ese patrón químico.
En PC2 destacan color_intensity (0.520), alcohol (0.472) y proline (0.362). Son pesos sobre variables estandarizadas, comparables en esta representación. El signo relativo entre variables informa sobre el contraste del eje; el signo global puede invertirse sin cambiar PCA.
Dos precauciones al interpretar
PCA describe variación, no causalidad. Una carga alta no demuestra que una variable origine el patrón.
Los componentes dependen del preprocesamiento. Cambiar variables, transformar distribuciones o no estandarizar puede rotar por completo la solución.
Las cargas son una traducción útil de los ejes, pero siempre deben leerse junto con el contexto de las mediciones.
25.18 Reconstrucción y compresión
Con \(k\) componentes guardas los scores\(Z_k=(X_{std}-\mu_{PCA})W_k\) en lugar de las 13 coordenadas originales, donde \(W_k\) reúne las primeras \(k\) columnas de \(W\) y \(\mu_{PCA}\) es la media que PCA resta (aquí prácticamente cero, porque los datos ya están estandarizados). Los datos estandarizados se aproximan mediante
\[
\widehat X_{std}=Z_kW_k^\top+\mu_{PCA}.
\]
pca_4.inverse_transform realiza esa reconstrucción en el espacio estandarizado e incorpora la media \(\mu_{PCA}\). Después, escalador.inverse_transform deshace la estandarización para volver a las unidades originales. Si \(k<13\), la reconstrucción pierde información; el error cuadrático medio (MSE) cuantifica cuánto. Para ilustrarlo usas \(k=4\), un valor dentro del codo visual de 3 a 5 componentes.
Las métricas de la siguiente celda son in-sample: reconstruyen los mismos 124 vinos con los que se ajustaron escalador y PCA. Miden compresión de entrenamiento y no estiman error de reconstrucción en vinos nuevos.
k_compresion =4pca_4 = PCA(n_components=k_compresion, svd_solver='full').fit(X_std)X_std_reconstruido_4 = pca_4.inverse_transform(pca_4.transform(X_std))X_reconstruido_4 = escalador.inverse_transform(X_std_reconstruido_4)mse_4 = np.mean((X_std - X_std_reconstruido_4) **2)comparacion = pd.DataFrame({'original': X.iloc[0],'reconstruido_con_4_PC': X_reconstruido_4[0],})comparacion['error_absoluto'] = (comparacion['original'] - comparacion['reconstruido_con_4_PC']).abs()display(comparacion.round(3))print(f'Varianza conservada con 4 componentes: {varianza_acumulada[3]:.2%}')print(f'MSE de reconstrucción en escala estandarizada: {mse_4:.4f}')print(f'Reducción de dimensiones: {X.shape[1]} -> {k_compresion}')
original
reconstruido_con_4_PC
error_absoluto
alcohol
13.63
13.931
0.301
malic_acid
1.81
1.292
0.518
ash
2.70
2.659
0.041
alcalinity_of_ash
17.20
17.591
0.391
magnesium
112.00
115.849
3.849
total_phenols
2.85
2.816
0.034
flavanoids
2.91
2.874
0.036
nonflavanoid_phenols
0.30
0.339
0.039
proanthocyanins
1.46
1.690
0.230
color_intensity
7.30
6.521
0.779
hue
1.28
1.163
0.117
od280/od315_of_diluted_wines
2.88
2.861
0.019
proline
1310.00
1257.519
52.481
Varianza conservada con 4 componentes: 73.91%
MSE de reconstrucción en escala estandarizada: 0.2609
Reducción de dimensiones: 13 -> 4
Con cuatro componentes conservas 73.91% de la varianza de los 124 vinos del ajuste y obtienes un MSE estandarizado de 0.2609. Son métricas in-sample de compresión, calculadas antes de abrir la prueba.
En este escalado, cada columna tiene varianza poblacional uno. Para las mismas filas del ajuste y sin whitening, el promedio del error cuadrático sobre filas y columnas coincide con la fracción de varianza descartada: \(\mathrm{MSE}_{ajuste}=1-\sum_{j=1}^k\mathrm{PVE}_j\). La identidad depende del escalado y del conjunto de ajuste; no es una fórmula general para reconstrucción de datos nuevos.
En el primer vino del entrenamiento, proline pasa de 1310 a 1257.519, con error absoluto de 52.481. En magnesium, el error es 3.849. La métrica estandarizada evita sumar sin ponderación errores medidos en unidades químicas diferentes.
25.19 Experimento: error frente a número de componentes
La celda repite la reconstrucción para \(k=1,\ldots,13\). Al añadir componentes, el subespacio disponible crece, así que el error no puede aumentar. Con los 13 componentes recuperas toda la información salvo precisión numérica.
errores_reconstruccion = []for k inrange(1, X.shape[1] +1): pca_k = PCA(n_components=k, svd_solver='full').fit(X_std) reconstruccion_k = pca_k.inverse_transform(pca_k.transform(X_std)) errores_reconstruccion.append(np.mean((X_std - reconstruccion_k) **2))fig, ax = plt.subplots(figsize=(9, 5))ax.plot(componentes, errores_reconstruccion, marker='o', color='#B42318', lw=2)ax.scatter([4, 8, 13], np.array(errores_reconstruccion)[[3, 7, 12]], s=90, color=['#D97706', '#2D6A4F', '#17324D'], zorder=3)ax.set(title='Más componentes, menor error de reconstrucción', xlabel='número de componentes', ylabel='MSE en escala estandarizada')ax.set_xticks(componentes)plt.show()for k in [1, 4, 8, 13]:print(f'k={k:>2}: MSE = {errores_reconstruccion[k -1]:.4f}')
El MSE de reconstrucción in-sample es 0.6256 con un componente, 0.2609 con cuatro y 0.0800 con ocho. Con trece queda por debajo de la precisión del formato 0.0000, conservando todas las direcciones.
Aumentar de cuatro a ocho componentes reduce la pérdida de reconstrucción en esta muestra, pero duplica la cantidad de coordenadas guardadas por vino. Para representar observaciones nuevas también necesitarás conservar el escalador, la media y la base de PCA; reducir dimensiones no equivale por sí solo a medir ahorro total de almacenamiento.
25.20 Utilidad práctica: un modelo predictivo de referencia
Los componentes pueden alimentar un clasificador. Compararás una regresión logística con las trece variables frente a otra con los primeros \(k\) componentes. Las decisiones usan exclusivamente los 124 vinos de entrenamiento que reservaste antes de explorar; los objetos descriptivos no se reutilizan en los pipelines predictivos.
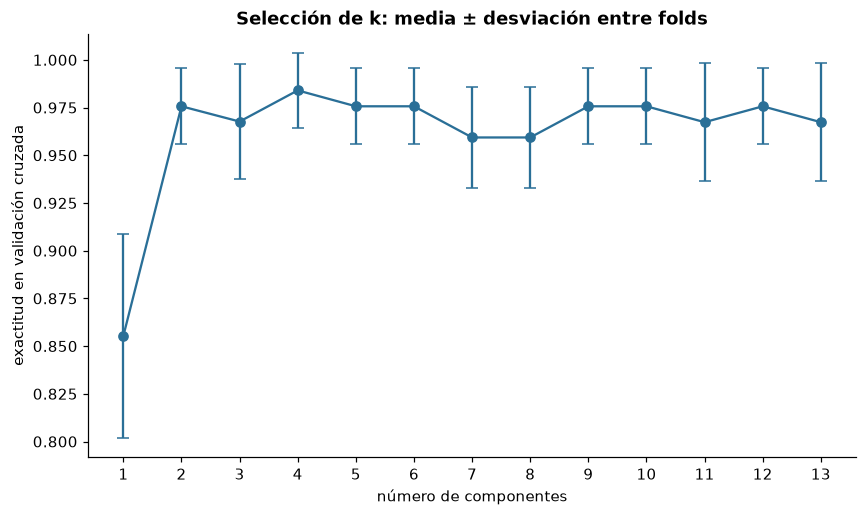
Pruebas todos los valores de \(k\) entre 1 y 13 mediante validación cruzada estratificada. En cada fold se ajustan de nuevo el escalador, PCA y el clasificador. La métrica es exactitud global, la proporción de vinos correctamente clasificados; la estratificación mantiene aproximadamente la composición por clase.
Con \(k=13\), PCA sin whitening conserva todas las coordenadas mediante una rotación ortogonal. Con la misma penalización L2 y el mismo clasificador, esa rotación conserva el problema de optimización salvo precisión numérica. La equivalencia no se extiende automáticamente a whitening, penalización L1 ni a clasificadores arbitrarios. La prueba de 54 vinos sigue reservada hasta fijar \(k\).
# Reutilizar la separación inicial: no crear una prueba después de explorar.X_train, y_train = X.copy(), y.copy()X_test, y_test = X_reservado.copy(), y_reservado.copy()cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=SEMILLA)candidatos_k =list(range(1, X.shape[1] +1))resultados_cv = []for k in candidatos_k: pipeline_pca = Pipeline([ ('escalador', StandardScaler()), ('pca', PCA(n_components=k, svd_solver='full')), ('clasificador', LogisticRegression(max_iter=2000)), ]) scores_cv = cross_val_score(pipeline_pca, X_train, y_train, cv=cv, scoring='accuracy') resultados_cv.append({'k': k,'exactitud_media_cv': scores_cv.mean(),'desviación_cv': scores_cv.std(), })tabla_cv = pd.DataFrame(resultados_cv)mejor_k =int(tabla_cv.loc[tabla_cv['exactitud_media_cv'].idxmax(), 'k'])representacion_elegida = Pipeline([ ('escalador', StandardScaler()), ('pca', PCA(n_components=mejor_k, svd_solver='full')),]).fit(X_train)varianza_mejor_k_train = representacion_elegida.named_steps['pca'].explained_variance_ratio_.sum()display(tabla_cv.round(3))print(tabla_cv.round(3).to_string(index=False))print(f'k elegido solo con entrenamiento: {mejor_k}')print(f'Varianza de entrenamiento conservada: {varianza_mejor_k_train:.2%}')plt.errorbar(tabla_cv['k'], tabla_cv['exactitud_media_cv'], yerr=tabla_cv['desviación_cv'], marker='o', capsize=4, color='#2A6F97')plt.xlabel('número de componentes')plt.ylabel('exactitud en validación cruzada')plt.title('Selección de k: media ± desviación entre folds')plt.xticks(candidatos_k)plt.show()
Entre los trece candidatos, la mayor exactitud media de CV es 0.984 con k=4. Con las trece coordenadas es 0.967. La diferencia respecto a k=2 es 0.008. Esa diferencia observada no demuestra superioridad general.
Las barras representan desviación de puntuaciones entre folds, no intervalos de confianza ni errores estándar del promedio: sus entrenamientos se solapan. El mínimo o máximo seleccionado entre varios candidatos puede ser optimista como estimación del procedimiento elegido.
Al reajustar únicamente con entrenamiento, k=4 conserva 73.91% de su varianza. Con esta configuración fijada, abres ahora los 54 vinos de prueba que quedaron separados antes de explorar.
25.21 Comparación final en datos no vistos
El modelo de referencia estandariza las 13 variables y ajusta regresión logística. La alternativa añade PCA con el \(k\) elegido. Ambos modelos usan la misma partición, el mismo clasificador y el mismo conjunto de prueba; así se aísla el efecto de reducir dimensiones.
En Wine la clasificación es multiclase, sin una clase positiva única. Después de la exactitud global se imprime la matriz de confusión: las filas son cultivares reales y las columnas, predichos. Se muestran también los errores del modelo reducido para describirlos sin reajustar a partir de la prueba.
                     modelo  dimensiones exactitud_test
13 variables estandarizadas           13         98.15%
  4 componentes principales            4         94.44%
Diferencia absoluta: 3.70%
Reducción dimensional: 69.23%
Matriz de confusión del modelo reducido; filas = clase real, columnas = predicción:
        predicho 0  predicho 1  predicho 2
real 0          18           0           0
real 1           3          18           0
real 2           0           0          15
Vinos de prueba mal clasificados por el modelo reducido:
 indice  cultivar_real  cultivar_predicho
     73              1                  0
     95              1                  0
    121              1                  0
El modelo con trece variables logra 98.15% de exactitud y el de cuatro componentes, 94.44%. La diferencia es de 3.70 puntos porcentuales: 53 frente a 51 aciertos entre 54 vinos. La representación de cuatro coordenadas reduce su dimensión en 69.23%.
En esta prueba el modelo completo acierta dos observaciones más, mientras que la CV favoreció la representación reducida. El tamaño pequeño y una única partición limitan la conclusión: este experimento no establece una superioridad general ni equivalencia estadística. La exactitud global tampoco describe por sí sola los errores por cultivar. Para una aplicación real convendría evaluar esos errores y su costo operativo antes de preferir compresión o desempeño.
La matriz del modelo reducido registra 18/18 aciertos en el cultivar 0, 18/21 en el 1 y 15/15 en el 2. Sus tres errores son vinos del cultivar 1 clasificados como 0: índices 73, 95 y 121 del conjunto público. Esta localización complementa la exactitud global, pero no se usa para cambiar el modelo después de evaluar la prueba.
25.22 Errores comunes al aplicar PCA
Síntoma
Causa probable
Solución
PC1 explica casi toda la varianza y coincide con una sola variable
escalas distintas sin estandarizar (sin escalar, proline lleva PC1 a 99.84 %)
estandariza cuando las unidades difieren
La validación da resultados optimistas
escalador y PCA ajustados antes de dividir los datos o fuera de los folds
ajústalos dentro de un Pipeline, solo con el entrenamiento de cada fold
El modelo reducido clasifica peor de lo esperado
\(k\) elegido por porcentaje de varianza
trata \(k\) como hiperparámetro y elígelo por validación cruzada; en el contraejemplo, PC1 dejó la exactitud en 0.457
Las cargas cambian de signo entre bibliotecas o ejecuciones
el signo global de cada vector propio es arbitrario
interpreta magnitudes y contrastes relativos; alinea signos antes de comparar
Una carga alta se lee como causa
PCA describe covariación, no mecanismos
busca evidencia adicional antes de una interpretación causal
El error de reconstrucción se reporta como error en datos nuevos
métrica in-sample (MSE de 0.2609 con \(k=4\))
aplica el escalador y PCA ya fijados a observaciones reservadas
Los scores se tratan como fuentes independientes
no correlación no implica independencia
usa ICA cuando el objetivo sea separar fuentes
25.23 Dónde aparece esto en inteligencia artificial y analítica de datos
PCA aparece en muchos sistemas de IA como paso de preprocesamiento, de visualización o de control de calidad:
Preprocesamiento en pipelines. El modelo reducido de este capítulo sigue el patrón habitual: escalador, PCA y clasificador encadenados y ajustados dentro de cada fold. Con cuatro componentes, la validación cruzada dio 0.984 de exactitud media, y en la prueba el modelo reducido acertó 51 de 54 vinos frente a 53 del modelo completo. Reducir dimensiones puede abaratar un modelo, pero su costo en desempeño se mide.
Visualizar representaciones aprendidas. Los embeddings de modelos de lenguaje o de imágenes tienen cientos de dimensiones, y proyectarlos sobre PC1 y PC2, como hiciste con los vinos, es una primera inspección. La advertencia del contraejemplo se mantiene: si la separación está en una dirección de baja varianza, la gráfica no la muestra.
Detección de anomalías por reconstrucción. Una observación que PCA reconstruye mucho peor que el resto (en estos vinos, el MSE típico con \(k=4\) es 0.2609) no sigue el patrón dominante. El umbral de alerta se calibra con datos separados, como en el capítulo de métodos de kernel.
Autoencoders lineales. Una red con una capa oculta lineal de \(k\) unidades, entrenada con error cuadrático sobre datos centrados, alcanza en su óptimo el mismo subespacio que los primeros \(k\) componentes. Sus pesos no tienen por qué ser ortogonales ni quedar ordenados por varianza, y los autoencoders con activaciones no lineales pierden esa equivalencia.
Whitening y aproximaciones de bajo rango. El whitening decorrelaciona las entradas de algunos modelos, y las aproximaciones de bajo rango con SVD comprimen matrices de pesos o de interacciones en sistemas de recomendación. Las condiciones de este capítulo siguen valiendo: el whitening cambia cómo actúa una penalización L2, y truncar componentes descarta información.
25.24 Ejercicios
En la tabla manual, ¿por qué sumar los valores propios recupera la traza de 3.925?
¿Puede PC1 conservar más del 95 % de la varianza y ser poco útil para clasificar?
¿Por qué la proyección del contraejemplo sobre PC2 debe ajustarse dentro de cada fold?
¿La reconstrucción in-sample con cuatro componentes estima el error en vinos nuevos?
¿Qué cambia si aplicas whitening antes de una regresión logística con penalización L2?
En la matriz de confusión final, ¿qué cultivares confunde el modelo reducido y por qué no debes modificarlo ahora usando esos mismos vinos de prueba?
En el ejemplo visual, ¿por qué C reconstruida no coincide con (3, 2), aunque conserves su puntuación?
TipOrientaciones
Los valores propios de una matriz simétrica suman su traza. En la tabla manual, 3.9130 + 0.0120 ≈ 3.925; la rotación distribuye la varianza entre ejes.
Sí. El contraejemplo coloca la clase en la coordenada de baja varianza; PCA no utiliza las etiquetas al elegir direcciones.
PCA aprende medias y direcciones de las observaciones. Ajustarlo antes de repartir informa al preprocesamiento sobre las filas reservadas; el pipeline mantiene ese ajuste dentro del entrenamiento.
No. La reconstrucción de las mismas filas mide compresión del entrenamiento. Una evaluación nueva debe aplicar el escalador y PCA ya fijados a observaciones reservadas, sin volver a ajustarlos.
Whitening reescala las direcciones y modifica cómo actúa la penalización. La equivalencia de una rotación completa sin whitening ya no se aplica automáticamente.
Las celdas fuera de la diagonal y la tabla de errores identifican esos cultivares y observaciones. Cambiar componentes o clasificador a partir de ellos convertiría la prueba en parte de la selección; una versión revisada necesitaría otra evaluación independiente.
Al guardar una sola dirección se descarta la separación perpendicular entre el punto original y la recta. Centro, eje y puntuación permiten reconstruir la cruz proyectada; para recuperar exactamente el punto original haría falta conservar también la coordenada de la segunda dirección.
25.25 Referencias para profundizar
Jolliffe, I. T. y Cadima, J. (2016). Principal component analysis: a review and recent developments. Philosophical Transactions of the Royal Society A, 374(2065), 20150202. DOI 10.1098/rsta.2015.0202.
Baldi, P. y Hornik, K. (1989). Neural networks and principal component analysis: learning from examples without local minima. Neural Networks, 2(1), 53–58. Relación entre autoencoders lineales y PCA.
scikit-learn: PCA: centrado, solvers, componentes, varianza e inversión de la transformación.
PCA gira los ejes para ordenar la varianza de mayor a menor; conservar varianza no equivale a predecir bien, y el número de componentes para un modelo se elige por validación.
En la tabla de cinco observaciones, PC1 conserva 93.96 % de la varianza y C (3, 2) se reconstruye como (2.60, 2.44): proyectar es comprimir con pérdida.
Los valores propios de la covarianza son las varianzas de los componentes y suman la traza (3.925 en la tabla manual); valores propios y SVD llegan al mismo resultado, salvo un signo global.
Las escalas mandan: sin estandarizar, proline domina y PC1 explica 99.84 %; con las variables estandarizadas, 37.44 %.
Con cuatro componentes conservas 73.91 % de la varianza de entrenamiento y el MSE in-sample es 0.2609; alcanzar el 90 % exige 8 componentes.
En el contraejemplo, PC1 conserva 95.74 % de la varianza y deja la exactitud en 0.457, mientras PC2, el componente descartado, llega a 1.000.
La validación cruzada eligió \(k=4\) (0.984); en la prueba de 54 vinos el modelo completo acertó 53 y el reducido 51, una diferencia que una sola partición no permite generalizar.
PCA produce direcciones ortogonales y scores no correlacionados, pero no fuentes independientes ni causas.
25.27 Puente hacia los siguientes capítulos
El último límite de la lista abre el capítulo de ICA. El Análisis de Componentes Independientes no busca máxima varianza ni solo ausencia de correlación: intenta recuperar componentes independientes, una meta más fuerte y especialmente útil cuando lo que observas son mezclas de señales.
Después, la reducción de dimensionalidad pasa de los ejes lineales a métodos que preservan vecindades, y el caso de comparación entre PCA, t-SNE y UMAP pone las tres proyecciones frente a los mismos datos, con la misma pregunta que aquí: qué conserva cada representación y qué descarta.