2  Medidas de tendencia central

estadistica
media
mediana
Autor/a

Wilder Ramírez Delgado

Fecha de publicación

18 de septiembre de 2026

¿Cuál es el ingreso típico?

¿Cuál es el “ingreso típico” de un grupo de personas? La respuesta cambia según uses la media, la mediana o la moda, y elegir mal lleva a conclusiones equivocadas sobre un negocio, una política pública o un modelo de IA.

En este capítulo trabajas media, mediana y moda de forma aplicada: las defines, las calculas, las comparas, mides cuánto las mueve un valor extremo y terminas con un criterio para decidir cuál reportar. También ves dónde reaparecen al entrenar un modelo: en la función de pérdida, en el modelo base y en la imputación de faltantes.

Los datos son sintéticos: 60 personas con ingreso mensual, edad, ciudad y segmento de cliente, generados con NumPy dentro del capítulo. El ingreso sigue una distribución lognormal, así que trae una cola de ingresos altos que separa la media de la mediana.

  • Tiempo estimado de lectura: 40 minutos (unas 2 horas si ejecutas el código)
  • Nivel: Básico
  • Conocimientos previos recomendados: el capítulo 1 (tipos de variables, dtype frente a tipo estadístico, faltantes) y Python básico con pandas.
  • Tecnologías mencionadas: Python 3.13, pandas 3.0, NumPy 2.5 y Matplotlib.

Objetivos

Al terminar este capítulo vas a ser capaz de:

  • definir e interpretar la media aritmética, la mediana y la moda;
  • calcularlas a mano y con pandas y NumPy;
  • explicar qué minimiza cada medida y su relación con las pérdidas MSE y MAE;
  • medir la sensibilidad a valores atípicos de cada medida y su punto de ruptura;
  • usar la media recortada y la media ponderada cuando el problema lo pide;
  • comparar las medidas según el tipo de variable, el grupo y el contexto;
  • reconocer el efecto de imputar faltantes con la media o con la mediana antes de entrenar un modelo;
  • decidir qué medida de tendencia central reportar en una situación concreta.

Ejecuta las celdas en orden: cada etapa usa variables de las anteriores.

2.1 Media, mediana y moda: tres ideas de “centro”

Media aritmética

\[ \bar{x} = \frac{1}{n} \sum_{i=1}^{n} x_i \]

La media es el centro de gravedad: la suma de las desviaciones respecto a ella es cero (\(\sum (x_i - \bar{x}) = 0\)). Tiene sentido en variables cuantitativas; no puedes calcularla sobre categorías nominales.

Mediana

Es el valor que queda en la posición central una vez ordenados los datos. Si \(n\) es impar, es el valor en la posición \(\frac{n+1}{2}\); si es par, el promedio de los dos valores centrales. Coincide con el percentil 50 (P50).

Solo depende de qué valor ocupa la posición central, no de la magnitud de los extremos. Por eso es robusta ante valores atípicos y es la medida preferida para variables ordinales o distribuciones asimétricas. En una variable ordinal con \(n\) par no se promedian categorías: si las dos centrales difieren, reportas ambas.

Moda

Es el valor (o la categoría) de mayor frecuencia, y la única medida de tendencia central con sentido para variables cualitativas nominales. Una distribución puede ser unimodal, bimodal o multimodal. En variables continuas la moda exacta suele decir poco; conviene hablar de intervalo modal.

Tipo de variable Media Mediana Moda
Cuantitativa (simétrica, sin valores atípicos) ✓ Resumen principal ✓ Complemento Opcional
Cuantitativa (asimétrica o con valores atípicos) Sensible ✓ Preferible Opcional
Ordinal Poco recomendable ✓ Preferible ✓ Útil
Nominal No tiene sentido No tiene sentido ✓ Única opción

Qué minimiza cada medida

Cada medida es el valor \(c\) que mejor resume los datos según una forma distinta de medir el error:

\[ \bar{x} = \arg\min_{c} \frac{1}{n}\sum_{i=1}^{n} (x_i - c)^2 \qquad\qquad \text{mediana} = \arg\min_{c} \frac{1}{n}\sum_{i=1}^{n} |x_i - c| \]

La media minimiza el error cuadrático medio (MSE); la mediana, el error absoluto medio (MAE). Como el cuadrado castiga mucho los errores grandes, la media se desplaza hacia los extremos para no quedar lejos de ellos. Estas dos pérdidas reaparecen como métricas de error en el capítulo 13 (regresión lineal) y el capítulo 15 (validación).

Media ponderada

\[ \bar{x}_w = \frac{\sum_{i} w_i\, x_i}{\sum_{i} w_i} \]

La usas cuando las observaciones no pesan lo mismo; por ejemplo, al combinar las medias de grupos de tamaños distintos (\(w_i = n_i\)).

Media recortada

Ordenas los datos, descartas una proporción \(\alpha\) en cada extremo (por ejemplo, el 10%) y promedias el resto. Queda a medio camino: usa más información que la mediana y es menos sensible que la media.

Sensibilidad a valores atípicos

La media incluye todos los valores: un solo dato muy grande puede arrastrar el promedio hacia arriba. La mediana depende de las posiciones centrales de los datos ordenados y cambia mucho menos ante un valor extremo.

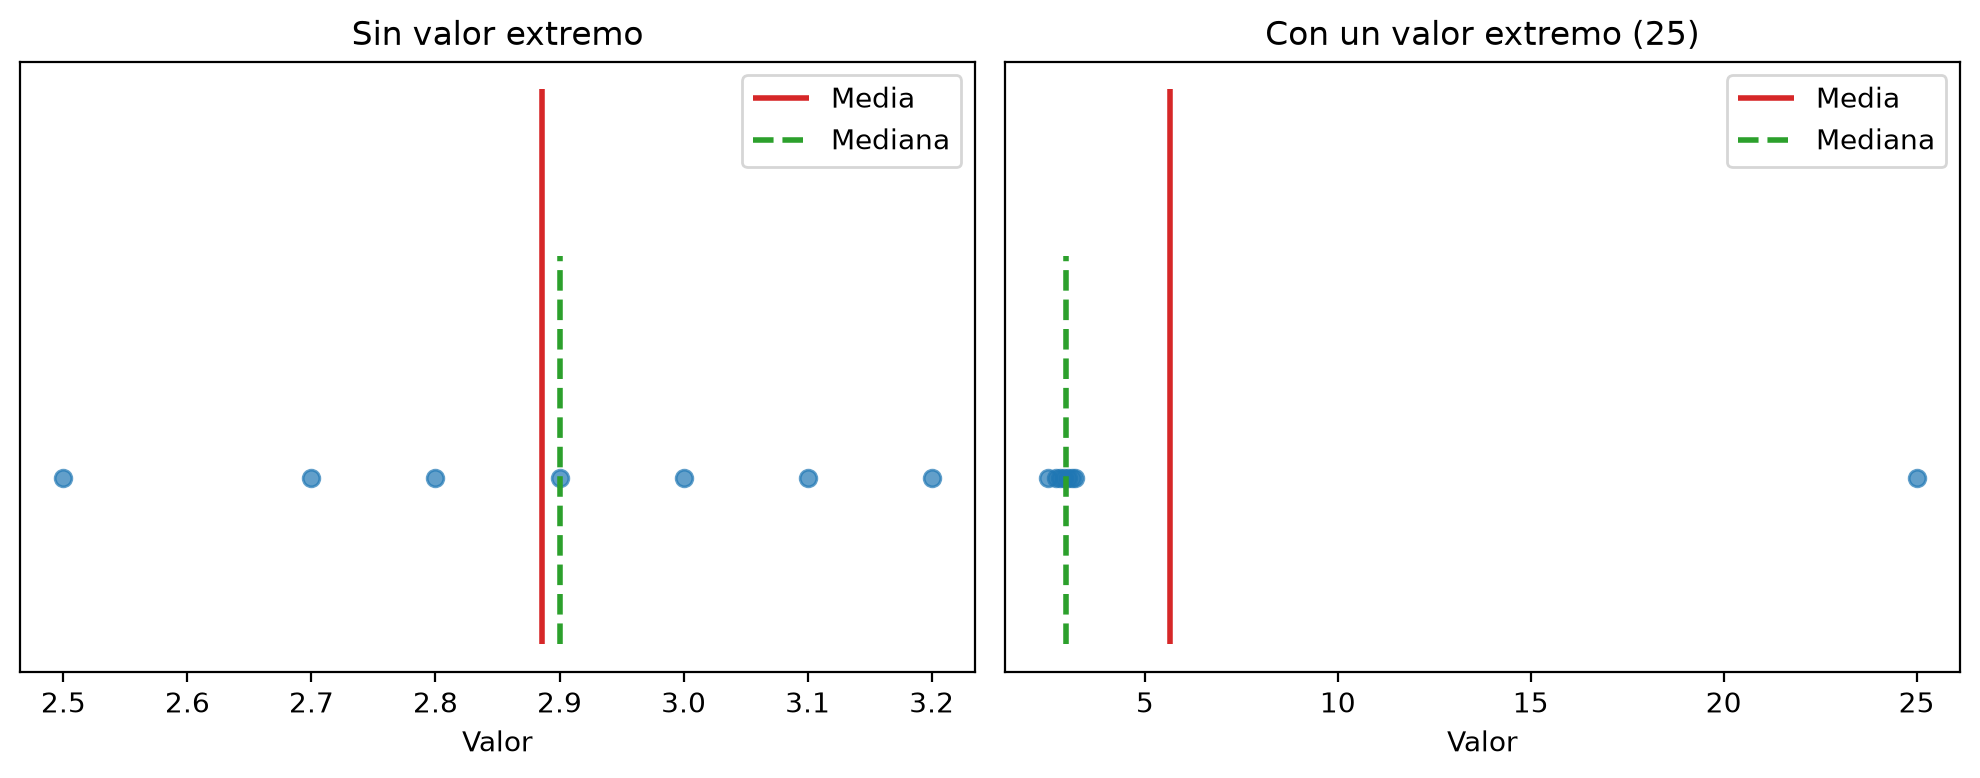
Toma los datos [2.5, 2.7, 2.8, 2.9, 3.0, 3.1, 3.2]. Su media y su mediana están cerca de 2.9. Si agregas el valor 25, la media sube de forma marcada y la mediana apenas cambia (lo compruebas en la etapa 7).

Un valor extremo puede ser un error de captura o una observación real; aquí te interesa su efecto sobre las medidas de centro. En los capítulos 3 y 4 vas a cuantificar la dispersión, describir la forma de la distribución y detectar anomalías.

El punto de ruptura formaliza esta idea: es la fracción de datos contaminados a partir de la cual una medida puede tomar cualquier valor. Para la media es \(1/n\) (basta un dato); para la mediana, el 50%.

2.2 Por qué importa en IA y machine learning

Las medidas de tendencia central aparecen dentro de los modelos, no solo en los reportes:

  • Funciones de pérdida: un modelo que minimiza MSE aprende, en cada región, algo parecido a una media; uno que minimiza MAE, algo parecido a una mediana. Con valores atípicos en el objetivo, la elección de la pérdida cambia las predicciones (etapa 4).
  • Modelo base (baseline): el primer modelo contra el que se compara cualquier regresión predice siempre la media (o la mediana) del entrenamiento.
  • Imputación: rellenar faltantes con la media o la mediana es un paso de preprocesamiento habitual, y elegir mal desplaza la distribución (etapa 11).
  • Clasificación: el modelo base de un clasificador predice siempre la moda, la clase más frecuente.
  • Métricas agregadas: si promedias métricas de grupos de tamaños distintos sin ponderar, obtienes un número que no describe a ningún grupo (etapa 10).

Idea central: ninguna medida es la mejor en todos los casos. La elección depende del tipo de variable, de los datos y de la pregunta, y esa misma elección reaparece al entrenar y evaluar modelos.

2.3 Flujo recomendado de trabajo

  1. Identifica el tipo de variable. ¿Es cuantitativa, ordinal o nominal? Así descartas las medidas que no tienen una interpretación válida.
  2. Calcula las medidas aplicables. En una variable cuantitativa, compara media y mediana; en una nominal, revisa la moda y sus frecuencias.
  3. Interpreta en contexto. Di qué representa el número, en qué unidad está y qué pregunta responde.
  4. Observa el efecto de los valores extremos. Compara las medidas antes y después de introducir o retirar un valor extremo para ver cuál es más sensible.
  5. Elige qué medida reportar:
    • media, si la variable es cuantitativa y sus valores representan razonablemente al conjunto;
    • mediana, si la variable es cuantitativa con valores extremos, o si es ordinal;
    • moda, si la variable es nominal o te interesa el valor más frecuente.
  6. Redacta el reporte con la variable, el valor, la unidad y la razón de la elección:

“Para [variable], la media es ___ y la mediana es ___. Se reporta [medida] como medida principal porque [justificación contextual].”

2.4 Preparar el entorno

%matplotlib inline
%config InlineBackend.figure_format = "retina"
import sys
print("Python:", sys.version.split()[0])
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
print("pandas:", pd.__version__, "| numpy:", np.__version__)

SEMILLA = 7  # semilla central del capítulo
rng = np.random.default_rng(SEMILLA)
Python: 3.13.14
pandas: 3.0.5 | numpy: 2.5.1

Funciones de visualización (definidas una sola vez)

Para no interrumpir la lectura de cada etapa con bloques largos de matplotlib, aquí defines una sola vez todas las funciones de graficación. En cada etapa solo llamas a la que corresponde.

from matplotlib.ticker import MaxNLocator


def graficar_centro(x, titulo, xlabel, bins=20, ax=None):
    """Histograma con líneas verticales en la media y la mediana."""
    standalone = ax is None
    if standalone:
        fig, ax = plt.subplots(figsize=(9, 4))
    x = np.asarray(x, dtype=float)
    ax.hist(x, bins=bins, alpha=0.75, edgecolor="white")
    ax.axvline(np.mean(x), color="C3", linestyle="--", linewidth=2, label=f"Media = {np.mean(x):,.0f}")
    ax.axvline(np.median(x), color="C2", linewidth=2, label=f"Mediana = {np.median(x):,.0f}")
    ax.set_xlabel(xlabel)
    ax.set_ylabel("Frecuencia")
    ax.set_title(titulo)
    ax.legend(fontsize=9)
    if standalone:
        plt.tight_layout()
        plt.show()


def graficar_perdidas(x):
    """MSE(c) y MAE(c) al resumir los datos con una constante c: sus mínimos son la media y la mediana."""
    x = np.asarray(x, dtype=float)
    c = np.unique(np.concatenate([np.linspace(np.min(x), np.percentile(x, 95), 400),
                                  x, [np.mean(x), np.median(x)]]))
    c = c[c <= np.percentile(x, 95)]
    mse = ((x[None, :] - c[:, None]) ** 2).mean(axis=1)
    mae = np.abs(x[None, :] - c[:, None]).mean(axis=1)
    fig, axes = plt.subplots(1, 2, figsize=(12, 4), constrained_layout=True)
    for ax, curva, nombre, centro, color, etiqueta in [
        (axes[0], mse, "MSE(c)", np.mean(x), "C3", "Media"),
        (axes[1], mae, "MAE(c)", np.median(x), "C2", "Mediana"),
    ]:
        ax.plot(c, curva)
        en_minimo = c[curva <= curva.min() * (1 + 1e-12)]
        if en_minimo.max() > en_minimo.min():
            ax.axvspan(en_minimo.min(), en_minimo.max(), color="0.6", alpha=0.35,
                       label=f"Tramo mínimo = [{en_minimo.min():,.0f}, {en_minimo.max():,.0f}]")
        else:
            ax.plot(en_minimo, [curva.min()], "ko", label=f"Mínimo de la curva = {en_minimo[0]:,.0f}")
        ax.axvline(centro, color=color, linestyle="--", label=f"{etiqueta} = {centro:,.0f}")
        ax.set_xlabel("Constante c usada como resumen")
        ax.set_ylabel(nombre)
        ax.set_title(f"{nombre}: el mínimo está en la {etiqueta.lower()}")
        ax.legend(fontsize=8)
    plt.show()


def graficar_frecuencias(series, ordenes=None):
    """Barras de frecuencia; la moda se resalta. Una variable ordinal se dibuja en su orden natural."""
    ordenes = ordenes or [None] * len(series)
    fig, axes = plt.subplots(1, len(series), figsize=(5.5 * len(series), 3.8), constrained_layout=True)
    for ax, s, orden in zip(np.atleast_1d(axes), series, ordenes):
        conteo = s.value_counts() if orden is None else s.value_counts().reindex(orden)
        colores = ["C1" if v == conteo.max() else "C0" for v in conteo.values]
        barras = ax.bar(conteo.index.astype(str), conteo.values, color=colores)
        for barra, v in zip(barras, conteo.values):
            if v == conteo.max():
                barra.set_hatch("//")
        tipo = "nominal, ordenada por frecuencia" if orden is None else "ordinal, en su orden natural"
        ax.set_title(f"{s.name} ({tipo})\nla moda es la barra resaltada", fontsize=10)
        ax.set_ylabel("Frecuencia")
    plt.show()


def graficar_moda_discreta_continua(discreta, continua, ancho_intervalo):
    """Moda en una variable discreta (barras) frente a intervalo modal en una continua (histograma)."""
    fig, axes = plt.subplots(1, 2, figsize=(12, 4), constrained_layout=True)
    conteo = discreta.value_counts().sort_index()
    colores = ["C1" if v == conteo.max() else "C0" for v in conteo.values]
    barras = axes[0].bar(conteo.index, conteo.values, color=colores)
    for barra, v in zip(barras, conteo.values):
        if v == conteo.max():
            barra.set_hatch("//")
    axes[0].set_title(f"{discreta.name} (discreta): moda(s) resaltada(s)")
    axes[0].set_xlabel(discreta.name)
    axes[0].set_ylabel("Frecuencia")

    bordes = np.arange(0, continua.max() + ancho_intervalo, ancho_intervalo)
    frec, bordes, parches = axes[1].hist(continua, bins=bordes, edgecolor="white")
    parches[int(np.argmax(frec))].set_facecolor("C1")
    parches[int(np.argmax(frec))].set_hatch("//")
    axes[1].set_title(f"{continua.name} (continua): intervalo modal resaltado")
    axes[1].set_xlabel(f"{continua.name} (intervalos de {ancho_intervalo:,})")
    axes[1].set_ylabel("Frecuencia")
    for ax in axes:
        ax.yaxis.set_major_locator(MaxNLocator(integer=True))
    plt.show()


def graficar_ruptura(porcentajes, medias, medianas, recortadas, referencia):
    """Cómo cambian media, mediana y media recortada al contaminar una fracción creciente de datos."""
    fig, ax = plt.subplots(figsize=(9, 4.2))
    ax.plot(porcentajes, medias, marker="o", color="C3", label="Media")
    ax.plot(porcentajes, recortadas, marker="^", color="C1", label="Media recortada 10%")
    ax.plot(porcentajes, medianas, marker="s", color="C2", label="Mediana")
    ax.axhline(referencia, color="0.3", linestyle=":", label=f"Mediana sin contaminar = {referencia:,.0f}")
    ax.set_yscale("log")
    ax.set_xlabel("% de datos reemplazados por valores extremos")
    ax.set_ylabel("Valor de la medida (escala log)")
    ax.set_title("Punto de ruptura: cuántos datos malos aguanta cada medida")
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_centro_por_grupo(tabla, mediana_global):
    """Media y mediana por grupo, con la mediana global como referencia."""
    x = np.arange(len(tabla))
    w = 0.38
    fig, ax = plt.subplots(figsize=(9, 4))
    ax.bar(x - w / 2, tabla["media"], width=w, color="C3", alpha=0.8, label="Media")
    ax.bar(x + w / 2, tabla["mediana"], width=w, color="C2", alpha=0.8, hatch="//", edgecolor="white", label="Mediana")
    for xi, n_i in zip(x, tabla["n"]):
        ax.text(xi, 150, f"n={n_i}", ha="center", color="white", fontsize=9)
    ax.axhline(mediana_global, color="0.3", linestyle=":", label=f"Mediana global = {mediana_global:,.0f}")
    ax.set_xticks(x)
    ax.set_xticklabels(tabla.index)
    ax.set_ylabel("Ingreso mensual")
    ax.set_title("Centro por ciudad: media y mediana")
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_imputacion(observado, imputado_media, imputado_mediana, bins):
    """Distribución observada frente a la distribución tras imputar con media o mediana."""
    fig, axes = plt.subplots(1, 2, figsize=(12, 4), sharey=True, constrained_layout=True)
    for ax, imputado, nombre, color in [
        (axes[0], imputado_media, "media", "C3"),
        (axes[1], imputado_mediana, "mediana", "C2"),
    ]:
        ax.hist(imputado, bins=bins, color=color, alpha=0.55, label=f"Tras imputar con la {nombre}")
        ax.hist(observado, bins=bins, histtype="step", color="black", linewidth=1.5, label="Solo valores observados")
        ax.set_title(f"Imputación con la {nombre}: un pico artificial")
        ax.set_xlabel("Ingreso mensual")
        ax.yaxis.set_major_locator(MaxNLocator(integer=True))
        ax.legend(fontsize=8)
    axes[0].set_ylabel("Frecuencia")
    plt.show()


def graficar_salarios(salarios, etiquetas):
    """Salarios ordenados con media y mediana: ¿cuántas personas ganan 'el promedio'?"""
    orden = np.argsort(salarios)
    s = np.asarray(salarios)[orden]
    fig, ax = plt.subplots(figsize=(10, 4))
    barras = ax.bar(np.arange(len(s)), s / 1e6, color=["C1" if e != "Equipo" else "C0" for e in np.asarray(etiquetas)[orden]])
    for barra, e in zip(barras, np.asarray(etiquetas)[orden]):
        if e != "Equipo":
            barra.set_hatch("//")
    ax.axhline(np.mean(s) / 1e6, color="C3", linestyle="--", linewidth=2, label=f"Media = {np.mean(s)/1e6:.2f} M")
    ax.axhline(np.median(s) / 1e6, color="C2", linewidth=2, label=f"Mediana = {np.median(s)/1e6:.2f} M")
    ax.set_xlabel("25 empleados ordenados por salario (azul: equipo; naranja con trama: directivos y fundador)")
    ax.set_ylabel("Salario mensual (millones)")
    ax.set_title("¿Cuántas personas ganan el 'salario promedio'?")
    ax.set_xticks([])
    ax.legend(fontsize=9)
    plt.tight_layout()
    plt.show()
2.5 Desarrollo por etapas

Avanzas en este orden: construyes los datos, calculas las medidas de centro, ves qué minimiza cada una, estudias la moda en variables cualitativas, discretas y continuas, mides la sensibilidad y el punto de ruptura, comparas grupos y, al final, llevas la elección de la medida a dos decisiones de machine learning: la imputación y la función de pérdida.

Etapa 1: Dataset sintético de ingresos mensuales por ciudad

Generas 60 registros con una semilla fija: ciudad (Bogotá 40%, Medellín 25%, Cali 20%, Barranquilla 15%), segmento (Básico 50%, Estándar 30%, Premium 20%), edad entera entre 21 y 55 años e ingreso mensual lognormal con mediana teórica de 2,750 y dispersión 0.62 en escala logarítmica, redondeado a decenas.

n = 60

ciudad = rng.choice(
    ["Bogotá", "Medellín", "Cali", "Barranquilla"],
    size=n, p=[0.40, 0.25, 0.20, 0.15]
)
segmento = rng.choice(
    ["Básico", "Estándar", "Premium"],
    size=n, p=[0.50, 0.30, 0.20]
)
edad = rng.integers(21, 56, size=n)

# La generación incluye algunos ingresos altos para comparar media y mediana
ingreso_mensual = np.round(rng.lognormal(mean=np.log(2750), sigma=0.62, size=n), -1)

df = pd.DataFrame({
    "ingreso_mensual": ingreso_mensual,
    "edad": edad,
    "ciudad": ciudad,
    "segmento": segmento,
})

print(f"Dataset: {len(df)} registros")
display(df.head(10))
Dataset: 60 registros
ingreso_mensual edad ciudad segmento
0 2770.0 54 Medellín Estándar
1 1790.0 21 Barranquilla Estándar
2 2250.0 51 Cali Estándar
3 1940.0 42 Bogotá Básico
4 2760.0 37 Bogotá Básico
5 2180.0 48 Barranquilla Básico
6 2280.0 54 Bogotá Básico
7 1170.0 38 Cali Básico
8 1670.0 24 Cali Premium
9 7670.0 46 Medellín Básico

Tienes 60 registros con ingreso, edad, ciudad y segmento.

  • ciudad es cualitativa nominal (las ciudades no tienen orden); segmento es cualitativa ordinal (Básico < Estándar < Premium); ingreso_mensual y edad son cuantitativas.
  • Ya en las 10 primeras filas aparece un ingreso de 7,670 junto a otros entre 1,170 y 2,770. Con valores así vas a ver si media, mediana y moda describen igual el centro.
  • Antes de calcular cualquier medida, identifica el tipo de cada variable y su unidad.

Etapa 2: Media, mediana y moda de ingreso_mensual: a mano, con NumPy y con pandas

valores = df["ingreso_mensual"].to_numpy()
n_valores = len(valores)

media_manual = valores.sum() / n_valores
media_numpy = np.mean(valores)

ordenados = np.sort(valores)
mediana_manual = (
    (ordenados[(n_valores - 1) // 2] + ordenados[n_valores // 2]) / 2
    if n_valores % 2 == 0 else ordenados[n_valores // 2]
)
mediana_numpy = np.median(valores)

moda_ingreso = df["ingreso_mensual"].mode().tolist()

print("Media (manual):", round(media_manual, 2))
print("Media (NumPy):", round(media_numpy, 2))
print("Mediana (manual):", round(mediana_manual, 2))
print("Mediana (NumPy):", round(mediana_numpy, 2))
print("Moda (pandas):", moda_ingreso[:6], "..." if len(moda_ingreso) > 6 else "")
print("\nDiferencia media - mediana:", round(media_numpy - mediana_numpy, 2))
print("Diferencia relativa:", round((media_numpy - mediana_numpy) / mediana_numpy * 100, 1), "%")
Media (manual): 3189.33
Media (NumPy): 3189.33
Mediana (manual): 2605.0
Mediana (NumPy): 2605.0
Moda (pandas): [1170.0, 1940.0, 2010.0, 2280.0, 2520.0] 

Diferencia media - mediana: 584.33
Diferencia relativa: 22.4 %

El cálculo a mano y el de NumPy coinciden: la media es 3,189.33 y la mediana 2,605, una diferencia de 584.33 (22.4%). Los ingresos altos suben la media porque esta usa la magnitud de todas las observaciones.

  • La moda devuelve varios valores empatados (1,170, 1,940, 2,010…). En una variable cuantitativa con pocos valores repetidos, la moda puntual dice menos que la media o la mediana.
  • Para comunicar el ingreso típico de este grupo, la mediana representa mejor a la persona del centro: divide los datos ordenados en dos mitades y cambia menos ante los ingresos altos.
  • Cuál medida conviene depende de la pregunta. Si te interesa el total que suma el grupo (una nómina, un presupuesto), la media es la que se relaciona con él: 60 × 3,189.33.

Etapa 3: Ver el centro: media y mediana sobre la distribución

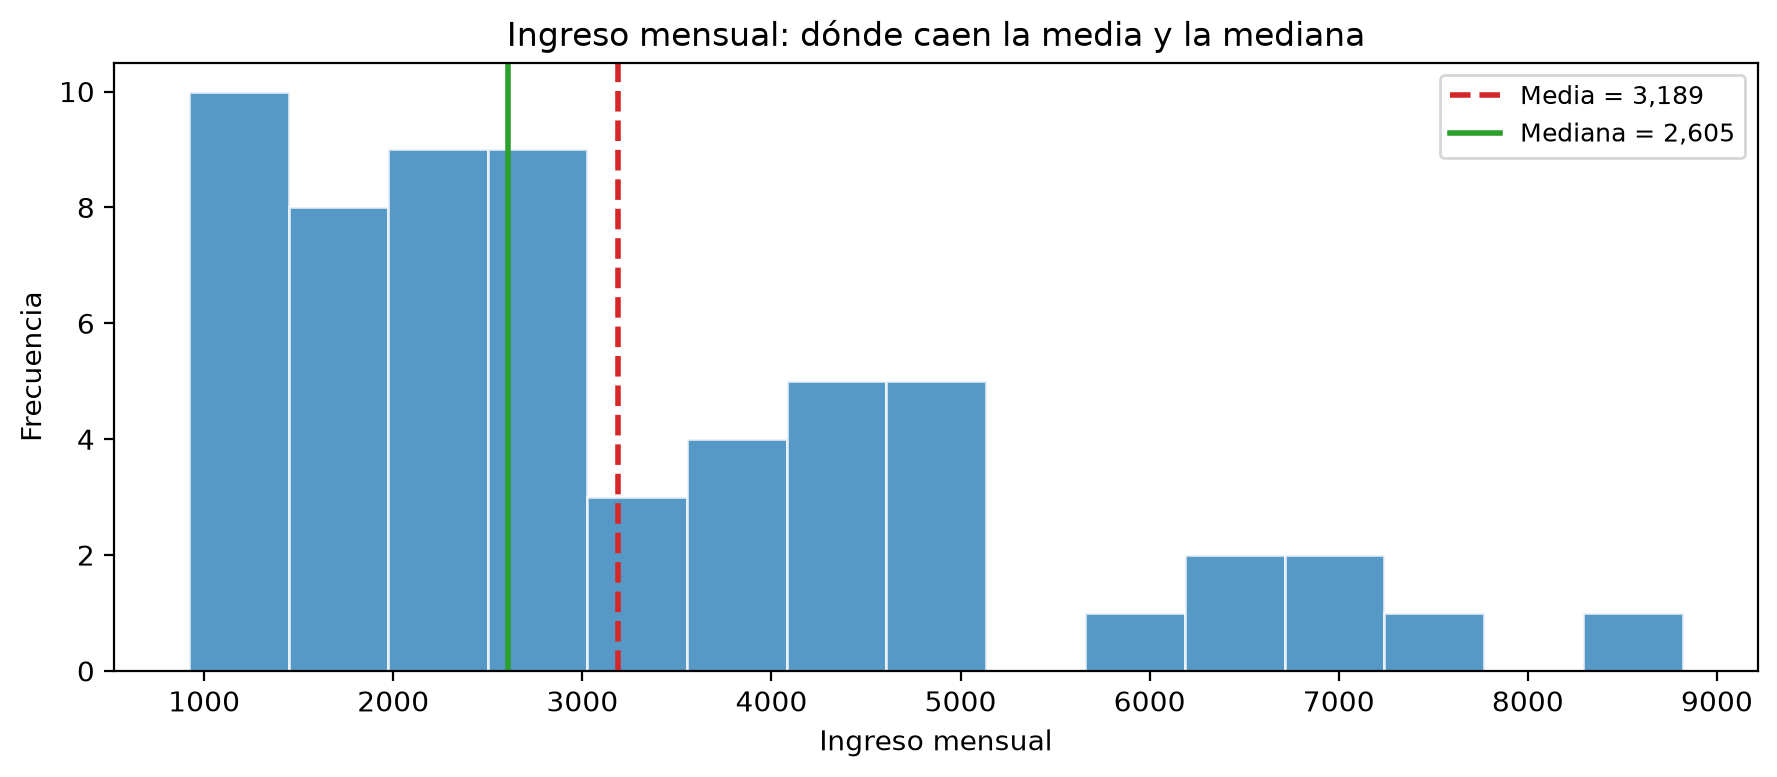
Los números de la etapa 2 se entienden mejor sobre el histograma: ¿hacia dónde se inclina la distribución y dónde queda cada medida?

graficar_centro(df["ingreso_mensual"], "Ingreso mensual: dónde caen la media y la mediana", "Ingreso mensual", bins=15)

por_debajo_media = (df["ingreso_mensual"] < df["ingreso_mensual"].mean()).mean() * 100
print(f"Registros por debajo de la media:   {por_debajo_media:.1f}%")
print(f"Registros por debajo de la mediana: {(df['ingreso_mensual'] < df['ingreso_mensual'].median()).mean() * 100:.1f}%")

Histograma del ingreso mensual de 60 personas, con la mayoría entre 1,000 y 3,000 y una cola hacia la derecha hasta cerca de 8,800. Una línea verde continua marca la mediana en 2,605 y una roja discontinua la media en 3,189, desplazada hacia la cola.

Registros por debajo de la media:   60.0%
Registros por debajo de la mediana: 50.0%

La mayoría de los ingresos se concentra entre 1,000 y 3,000, y unos pocos valores altos (hasta cerca de 8,800) forman una cola hacia la derecha.

  • La media (línea roja discontinua, 3,189) queda a la derecha de la mediana (línea verde continua, 2,605): la cola la arrastra.
  • El 60% de los registros está por debajo de la media. Si llamaras a la media “el ingreso típico”, la mayoría del grupo ganaría menos que lo típico.
  • La mediana deja exactamente el 50% de los registros a cada lado.

Etapa 4: Qué minimiza cada medida: la media, la mediana y las pérdidas MSE y MAE

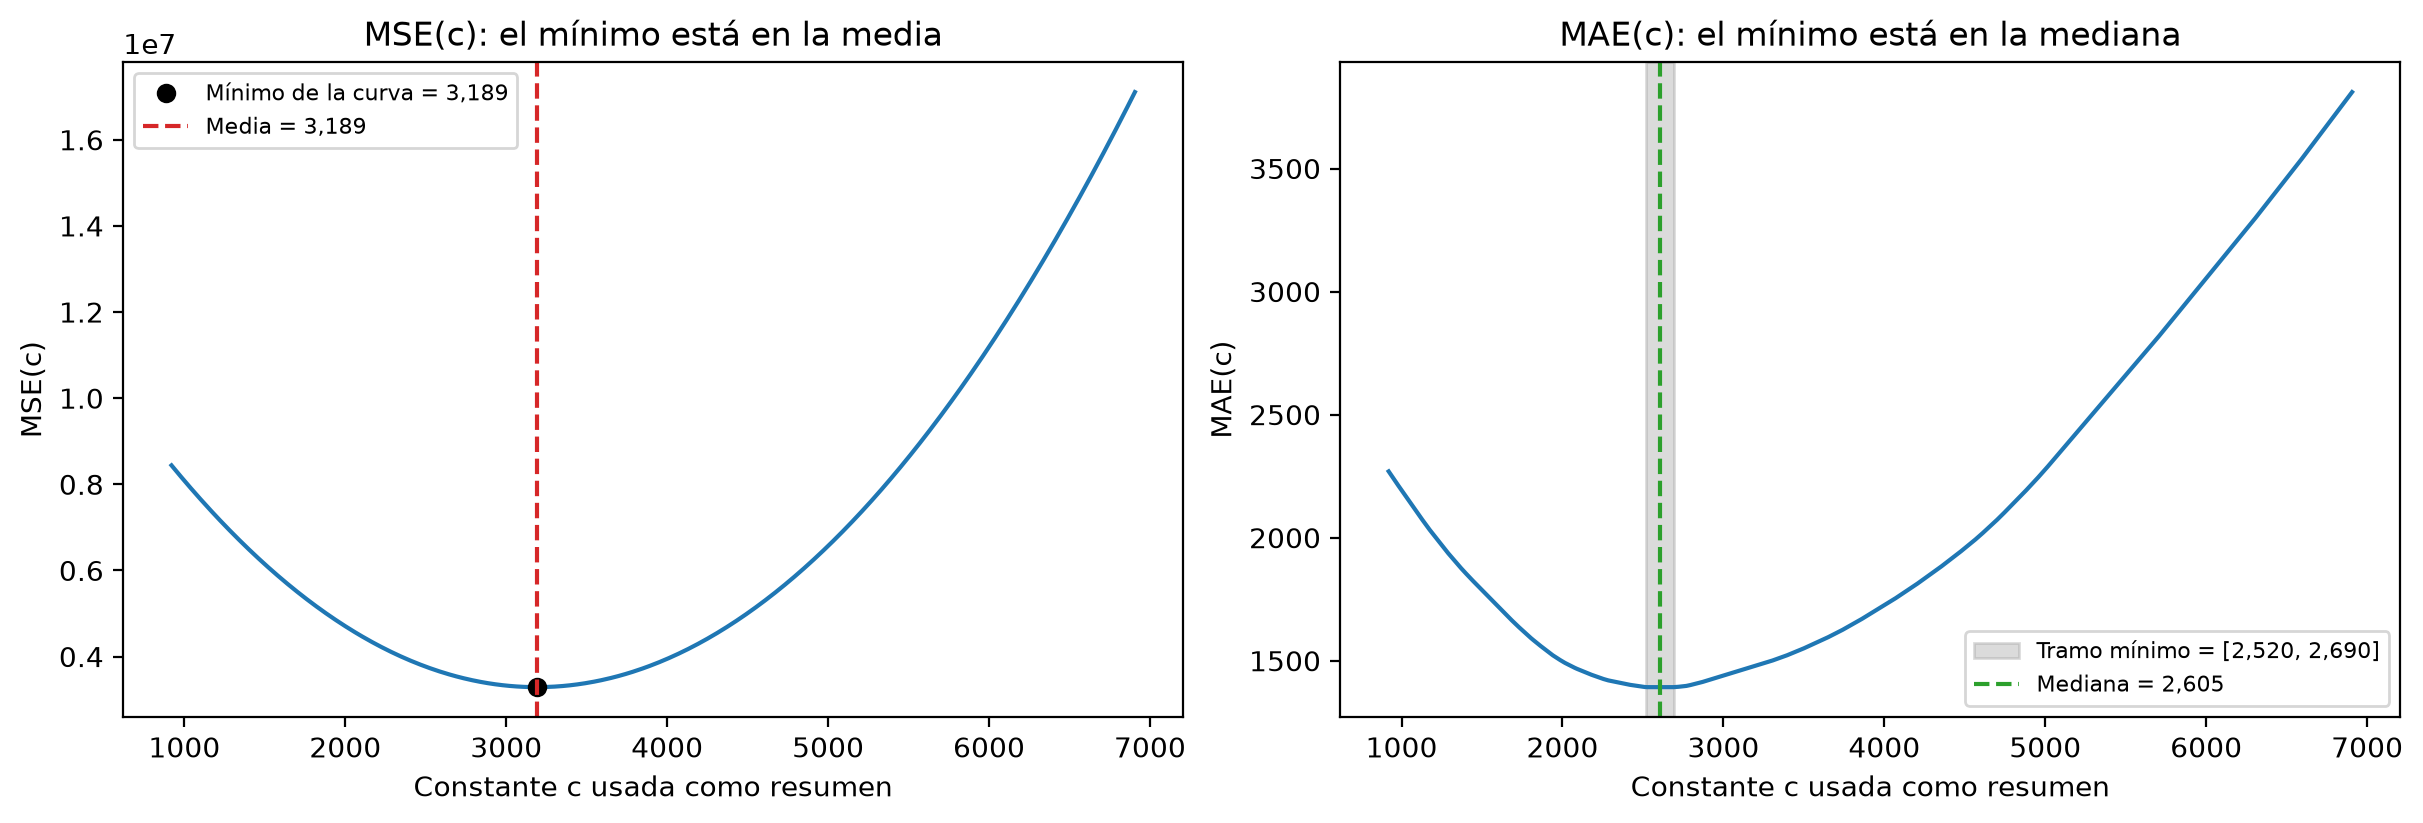
Si tuvieras que resumir los 60 ingresos con un solo número \(c\), ¿cuál elegirías? Depende de cómo midas el error. Evalúas todos los \(c\) posibles con dos pérdidas:

\[ \text{MSE}(c) = \frac{1}{n}\sum_i (x_i - c)^2 \qquad \text{MAE}(c) = \frac{1}{n}\sum_i |x_i - c| \]

x_ing = df["ingreso_mensual"].to_numpy()
print("Suma de desviaciones respecto a la media:", round(np.sum(x_ing - x_ing.mean()), 6) + 0.0)
print("Suma de desviaciones respecto a la mediana:", round(np.sum(x_ing - np.median(x_ing)), 2))

graficar_perdidas(x_ing)
Suma de desviaciones respecto a la media: 0.0
Suma de desviaciones respecto a la mediana: 35060.0

Dos curvas en forma de cuenco. A la izquierda, el MSE según la constante c, con su mínimo en la media, 3,189. A la derecha, el MAE, con un tramo plano entre 2,520 y 2,690 que contiene a la mediana, 2,605.

Las desviaciones respecto a la media suman 0: la media es el punto de equilibrio. Respecto a la mediana suman +35,060, que es \(n\,(\bar{x} - \text{mediana}) = 60 \times 584.33\): los valores altos pesan por su magnitud, no solo por su posición.

  • La curva de MSE alcanza su mínimo en la media (3,189) y la de MAE, en la mediana. Es la definición de cada medida como mejor resumen bajo cada pérdida, ahora vista en los datos.
  • Con \(n\) par, la curva de MAE es plana entre los dos valores centrales (2,520 y 2,690): cualquier \(c\) de ese tramo da el mismo error. La mediana (2,605) es, por convención, su punto medio.
  • Conexión con ML: un modelo de regresión entrenado con MSE persigue medias condicionales y se deja arrastrar por los valores extremos del objetivo; uno entrenado con MAE persigue medianas y es más robusto. Al elegir la pérdida eliges, en la práctica, qué medida de centro aprende el modelo.

Etapa 5: Moda en variables cualitativas (ciudad y segmento)

print("Moda de ciudad:", df["ciudad"].mode().tolist())
print("Moda de segmento:", df["segmento"].mode().tolist())

print("\nFrecuencias por ciudad:")
print(df["ciudad"].value_counts())
print("\nFrecuencias por segmento:")
print(df["segmento"].value_counts())
Moda de ciudad: ['Bogotá']
Moda de segmento: ['Básico']

Frecuencias por ciudad:
ciudad
Bogotá          25
Medellín        18
Cali             9
Barranquilla     8
Name: count, dtype: int64

Frecuencias por segmento:
segmento
Básico      28
Estándar    18
Premium     14
Name: count, dtype: int64
# segmento es ordinal: además de la moda admite la mediana (la categoría en la posición central)
orden_segmento = ["Básico", "Estándar", "Premium"]
codigos_seg = np.sort(pd.Categorical(df["segmento"], categories=orden_segmento, ordered=True).codes)
n_seg = len(codigos_seg)
centrales = [orden_segmento[codigos_seg[n_seg // 2 - 1]], orden_segmento[codigos_seg[n_seg // 2]]]
print(f"segmento ordenado: categorías en las posiciones {n_seg // 2} y {n_seg // 2 + 1} ->", centrales)

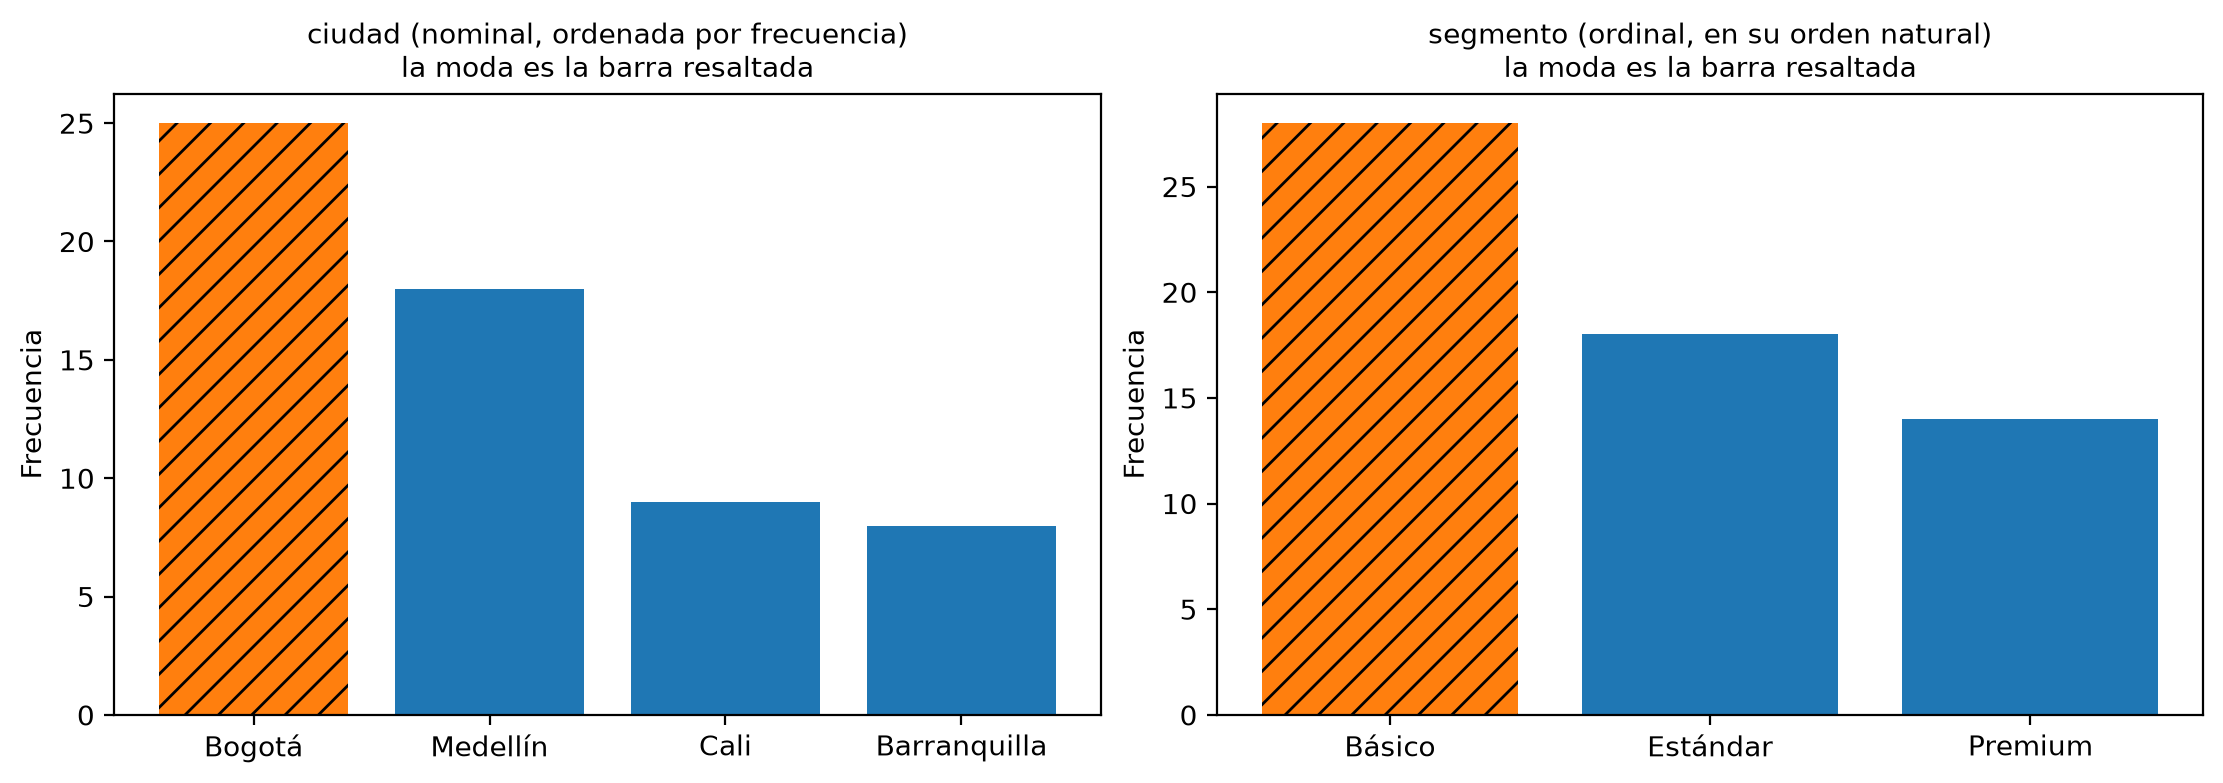
graficar_frecuencias([df["ciudad"], df["segmento"]], ordenes=[None, orden_segmento])
segmento ordenado: categorías en las posiciones 30 y 31 -> ['Estándar', 'Estándar']

Dos gráficos de barras. Ciudad, ordenada por frecuencia: Bogotá 25, Medellín 18, Cali 9 y Barranquilla 8, con Bogotá resaltada como moda. Segmento, en su orden natural: Básico 28, Estándar 18 y Premium 14, con Básico resaltado como moda.

La moda de ciudad es Bogotá (25 de 60 registros, 42%) y la de segmento es Básico (28 de 60, 47%). En el gráfico, la moda es la barra naranja y también la más alta.

  • En ciudad (nominal) la moda es la única medida de centro válida: no existe una “media” ni una “mediana” de ciudades, codifiques como codifiques las categorías.
  • segmento es ordinal, así que además admite la mediana: al ordenar los 60 registros, las posiciones 30 y 31 caen en Estándar. Moda y mediana responden cosas distintas: el segmento más frecuente es Básico, pero 32 de los 60 clientes (53%) están en Estándar o por encima. Por eso el gráfico de segmento respeta el orden Básico → Estándar → Premium en lugar de ordenar por frecuencia.
  • El tipo de variable decide qué medida es válida antes de que te preguntes cuál conviene.

Etapa 6: Moda en variables discretas y en variables continuas

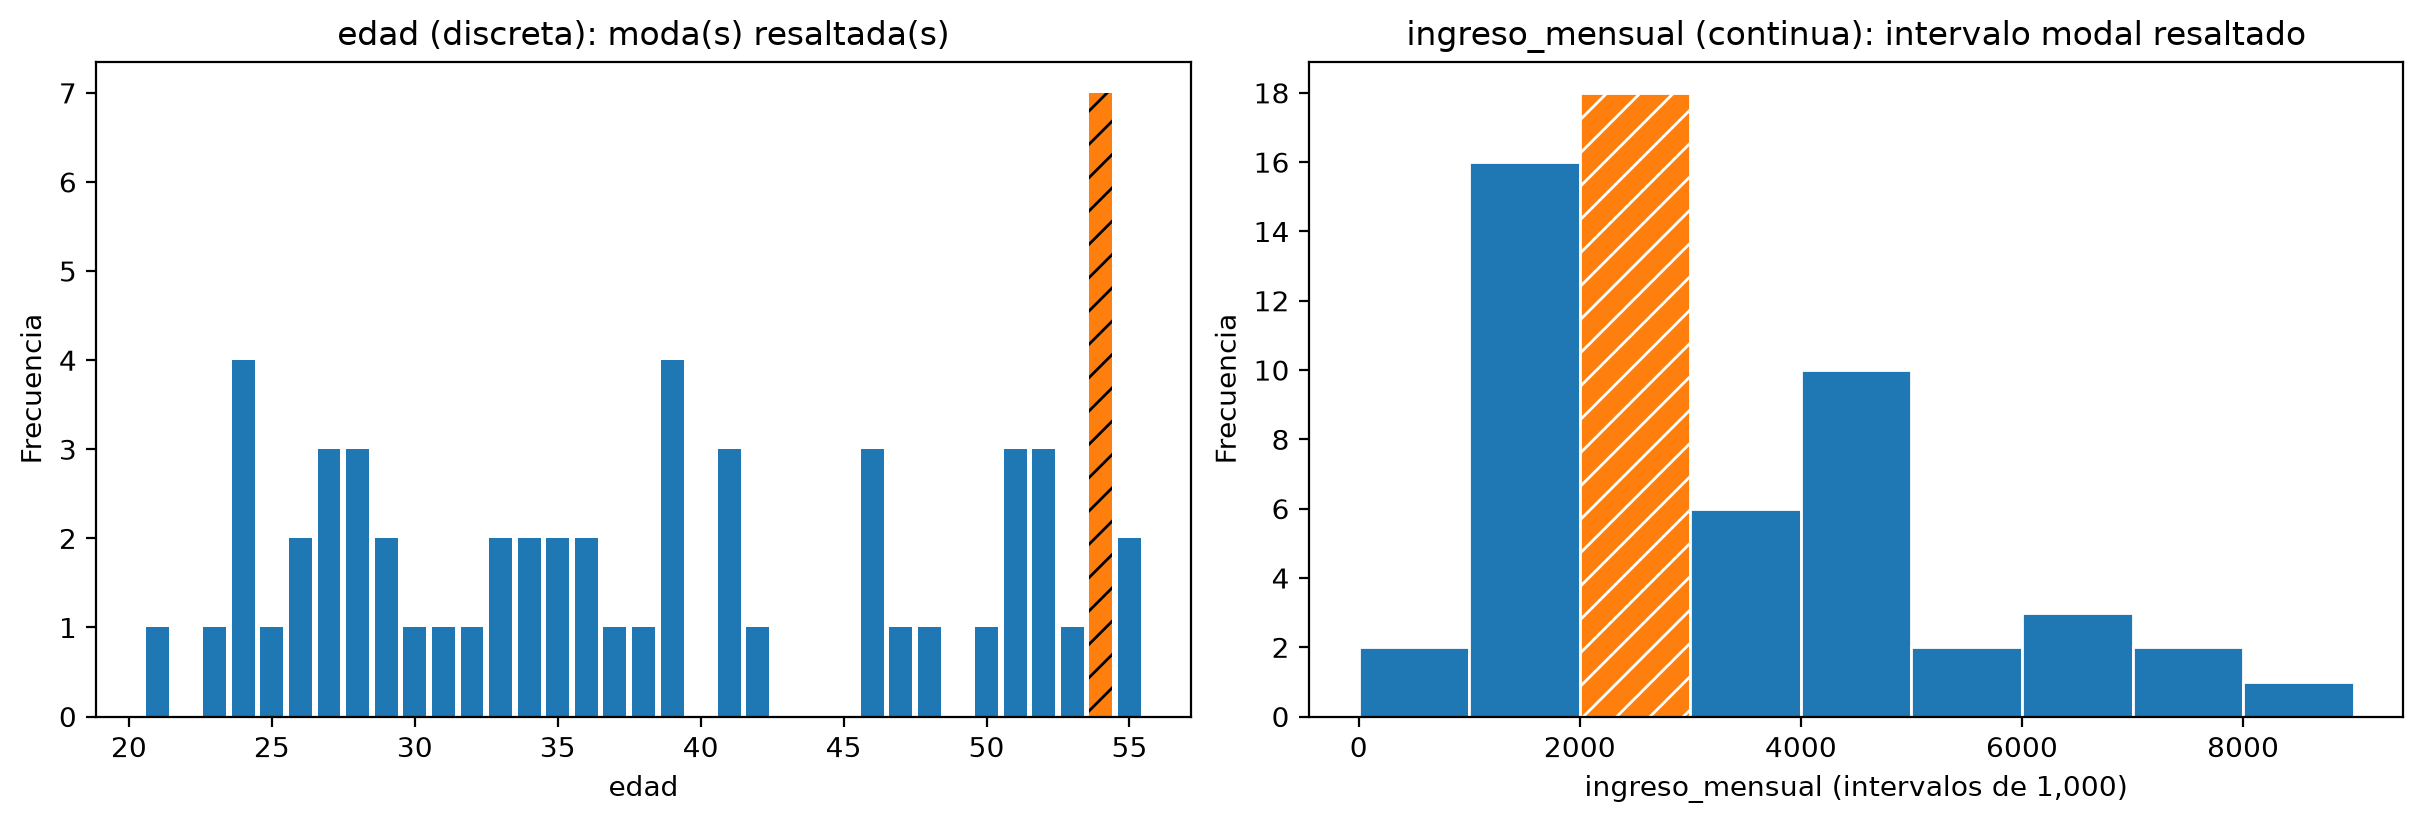
En una variable discreta, la moda informa cuando hay pocos valores posibles y muchos registros (número de hijos, número de compras). La edad en años cumplidos es discreta (capítulo 1), pero tiene 35 valores posibles para 60 registros: vas a ver qué tan informativa resulta. En una variable continua (ingreso) casi ningún valor se repite y la moda exacta depende del redondeo. Lo útil es el intervalo modal: el intervalo del histograma con más observaciones.

print("Moda(s) de edad:", df["edad"].mode().tolist())
print("Frecuencia de la moda de edad:", df["edad"].value_counts().max(), "de", len(df))

ancho = 1000
intervalos = pd.cut(df["ingreso_mensual"], bins=np.arange(0, df["ingreso_mensual"].max() + ancho, ancho))
conteo_int = intervalos.value_counts().sort_index()
print("\nIngreso mensual agrupado en intervalos de", ancho)
print(conteo_int[conteo_int > 0])
print("\nIntervalo modal:", conteo_int.idxmax(), "con", conteo_int.max(), "registros")
print("Moda exacta de ingreso (pandas):", df["ingreso_mensual"].mode().tolist()[:5], "...")

graficar_moda_discreta_continua(df["edad"], df["ingreso_mensual"], ancho)
Moda(s) de edad: [54]
Frecuencia de la moda de edad: 7 de 60

Ingreso mensual agrupado en intervalos de 1000
ingreso_mensual
(0.0, 1000.0]        2
(1000.0, 2000.0]    16
(2000.0, 3000.0]    18
(3000.0, 4000.0]     6
(4000.0, 5000.0]    10
(5000.0, 6000.0]     2
(6000.0, 7000.0]     3
(7000.0, 8000.0]     2
(8000.0, 9000.0]     1
Name: count, dtype: int64

Intervalo modal: (2000.0, 3000.0] con 18 registros
Moda exacta de ingreso (pandas): [1170.0, 1940.0, 2010.0, 2280.0, 2520.0] ...

A la izquierda, barras de frecuencia por edad de 21 a 55 años, casi todas con 1 a 4 personas y la moda resaltada en 54 años con 7. A la derecha, histograma del ingreso en intervalos de 1,000, con el intervalo modal de 2,000 a 3,000 (18 personas) resaltado.

En edad, la moda es 54 años, con 7 de 60 registros: un valor en el extremo superior del rango (21 a 55), lejos del centro del grupo. Con 60 registros y 35 edades posibles, la moda describe poco: es el valor que más se repitió por azar.

  • En ingreso_mensual, la moda exacta devuelve varios valores empatados (etapa 2) y ninguno representa al grupo. El intervalo modal (2,000–3,000], con 18 de 60 registros, sí responde una pregunta útil: ¿dónde se concentra la mayoría?
  • El intervalo modal depende del ancho elegido (aquí, 1,000); repórtalo junto con ese ancho.

Etapa 7: Sensibilidad de la media y la mediana ante un valor extremo

Usas los siete datos de la sección de sensibilidad (Sección 2.1) y les agregas un 25.

datos_sin_extremo = np.array([2.5, 3.0, 2.8, 3.2, 2.9, 3.1, 2.7])
datos_con_extremo = np.append(datos_sin_extremo, 25.0)

fig, axes = plt.subplots(1, 2, figsize=(10, 4))

ax = axes[0]
ax.vlines(np.mean(datos_sin_extremo), 0, 1, colors="C3", label="Media", linewidth=2)
ax.vlines(np.median(datos_sin_extremo), 0, 0.7, colors="C2", linestyles="--", label="Mediana", linewidth=2)
ax.scatter(datos_sin_extremo, np.zeros_like(datos_sin_extremo) + 0.3, alpha=0.7)
ax.set_title("Sin valor extremo")
ax.set_yticks([])  # el eje vertical no representa ninguna magnitud
ax.legend()
ax.set_xlabel("Valor")

ax = axes[1]
ax.vlines(np.mean(datos_con_extremo), 0, 1, colors="C3", label="Media", linewidth=2)
ax.vlines(np.median(datos_con_extremo), 0, 0.7, colors="C2", linestyles="--", label="Mediana", linewidth=2)
ax.scatter(datos_con_extremo, np.zeros_like(datos_con_extremo) + 0.3, alpha=0.7)
ax.set_title("Con un valor extremo (25)")
ax.set_yticks([])
ax.legend()
ax.set_xlabel("Valor")

plt.tight_layout()
plt.show()
print("Sin valor extremo — Media:", round(np.mean(datos_sin_extremo), 2), "| Mediana:", np.median(datos_sin_extremo))
print("Con valor extremo — Media:", round(np.mean(datos_con_extremo), 2), "| Mediana:", round(np.median(datos_con_extremo), 2))

Dos paneles con siete puntos entre 2.5 y 3.2. Sin el valor extremo, las líneas de media y mediana coinciden cerca de 2.9. Al agregar un punto en 25, la línea de la media se desplaza a 5.65 y la de la mediana se queda en 2.95, junto al grupo.

Sin valor extremo — Media: 2.89 | Mediana: 2.9
Con valor extremo — Media: 5.65 | Mediana: 2.95

Al añadir el valor 25, cuando los demás datos están entre 2.5 y 3.2, la media pasa de 2.89 a 5.65 y la mediana de 2.90 a 2.95.

  • La media usa la magnitud de todas las observaciones; por eso el 25 la desplaza casi al doble.
  • La mediana depende de las posiciones centrales después de ordenar; con un dato más, solo pasa a promediar 2.9 y 3.0.
  • Si los valores extremos son reales, la mediana describe mejor a una observación típica; si son errores de captura, conviene corregirlos en origen. En ambos casos, justifica la medida con el contexto.

Etapa 8: Media recortada, un compromiso entre media y mediana

La media recortada al 10% descarta el 10% más bajo y el 10% más alto de los datos ordenados y promedia el resto. La comparas con la media y la mediana sobre el ingreso, antes y después de agregar un ingreso extremo de 250,000.

def media_recortada(x, proporcion=0.10):
    x = np.sort(np.asarray(x, dtype=float))
    k = int(np.floor(proporcion * len(x)))
    return x[k:len(x) - k].mean()

ingreso_con_extremo = np.append(x_ing, 250_000)

comparacion = pd.DataFrame({
    "sin extremo": [np.mean(x_ing), np.median(x_ing), media_recortada(x_ing)],
    "con un ingreso de 250,000": [np.mean(ingreso_con_extremo), np.median(ingreso_con_extremo),
                                  media_recortada(ingreso_con_extremo)],
}, index=["media", "mediana", "media recortada 10%"])
comparacion["cambio"] = comparacion.iloc[:, 1] - comparacion.iloc[:, 0]
print(comparacion.round(1))
                     sin extremo  con un ingreso de 250,000  cambio
media                     3189.3                     7235.4  4046.1
mediana                   2605.0                     2690.0    85.0
media recortada 10%       2946.9                     3015.1    68.2

Un solo ingreso de 250,000 entre 60 registros mueve la media en +4,046.1 (de 3,189.3 a 7,235.4). La mediana cambia +85 y la media recortada +68.2.

  • La media recortada descarta los extremos sin que decidas a mano cuáles son “errores”: aplica la misma regla a todos los datos.
  • Te sirve cuando quieres un promedio que use la mayoría de los valores pero no dependa de unos pocos casos extremos, por ejemplo al resumir tiempos de respuesta o puntuaciones de jueces.

Etapa 9: Punto de ruptura: cuántos datos malos aguanta cada medida

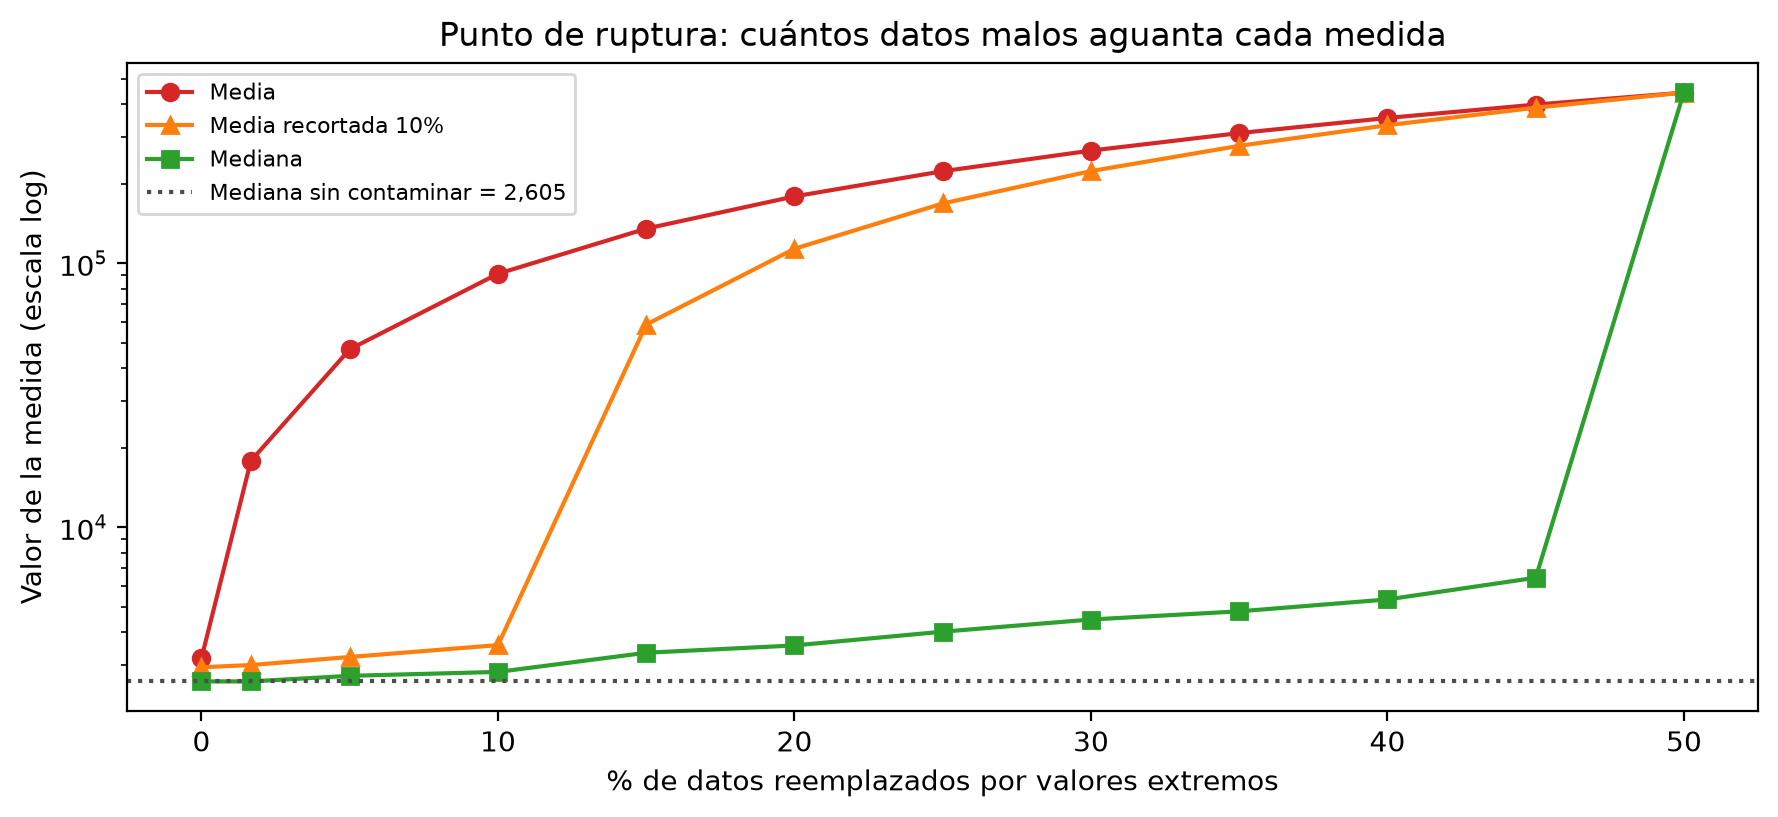
Reemplazas una fracción creciente de los ingresos por un valor absurdo (100 veces el máximo, como un error de captura con ceros de más) y sigues cada medida.

rng_rup = rng  # mismo generador central
orden_contaminacion = rng_rup.permutation(len(x_ing))
valor_malo = x_ing.max() * 100

porcentajes, medias, medianas, recortadas = [], [], [], []
for k in [0, 1] + list(range(3, len(x_ing) // 2 + 1, 3)):
    x_cont = x_ing.copy()
    x_cont[orden_contaminacion[:k]] = valor_malo
    porcentajes.append(100 * k / len(x_ing))
    medias.append(np.mean(x_cont))
    medianas.append(np.median(x_cont))
    recortadas.append(media_recortada(x_cont))

tabla_ruptura = pd.DataFrame({"%_contaminado": porcentajes, "media": medias,
                              "media_recortada_10%": recortadas, "mediana": medianas})
print(f"Máximo de los datos buenos: {x_ing.max():,.0f} | valor contaminante: {valor_malo:,.0f}\n")
print(tabla_ruptura.round(1).to_string(index=False))

graficar_ruptura(porcentajes, medias, medianas, recortadas, np.median(x_ing))
Máximo de los datos buenos: 8,820 | valor contaminante: 882,000

 %_contaminado    media  media_recortada_10%  mediana
           0.0   3189.3               2946.9   2605.0
           1.7  17831.2               3005.2   2605.0
           5.0  47183.0               3223.3   2735.0
          10.0  91173.0               3575.8   2830.0
          15.0 135150.7              58544.2   3345.0
          20.0 179035.7             113400.4   3565.0
          25.0 222975.5             168325.2   4020.0
          30.0 266916.8             223251.9   4470.0
          35.0 310936.5             278274.8   4800.0
          40.0 354833.8             333146.5   5325.0
          45.0 398662.8             387932.7   6435.0
          50.0 442648.2             442914.4 444835.0

Valor de la media, la media recortada al 10% y la mediana, en escala logarítmica, según el porcentaje de datos contaminados de 0 a 50%. La media (círculos) se dispara desde el primer dato; la media recortada (triángulos) se mantiene hasta el 10% y salta en el 15%; la mediana (cuadrados) sube despacio y solo salta en el 50%.

La media se dispara con un solo dato contaminado (1.7% de 60): pasa de 3,189 a 17,831, el doble del ingreso máximo real (8,820). Su punto de ruptura es un dato.

  • La media recortada al 10% descarta 6 valores por lado: aguanta mientras los datos malos caben en ese recorte (hasta 6 datos, el 10%: 3,575.8) y se rompe en el paso siguiente (15%: 58,544.2).
  • La mediana se mueve a medida que crece la contaminación (2,605 → 3,565 con el 20% → 6,435 con el 45%), pero siempre queda dentro del rango de los datos buenos (máximo 8,820). Con el 50% salta a 444,835: solo cuando la mitad de los datos es basura deja de describir a los buenos. Eso significa que su punto de ruptura sea del 50%.
  • La gráfica usa escala logarítmica porque la media y la mediana contaminadas quedan separadas por varios órdenes de magnitud. Cada medida tiene además su marcador (círculo, triángulo, cuadrado).

Etapa 10: Centro por grupos y el promedio de promedios

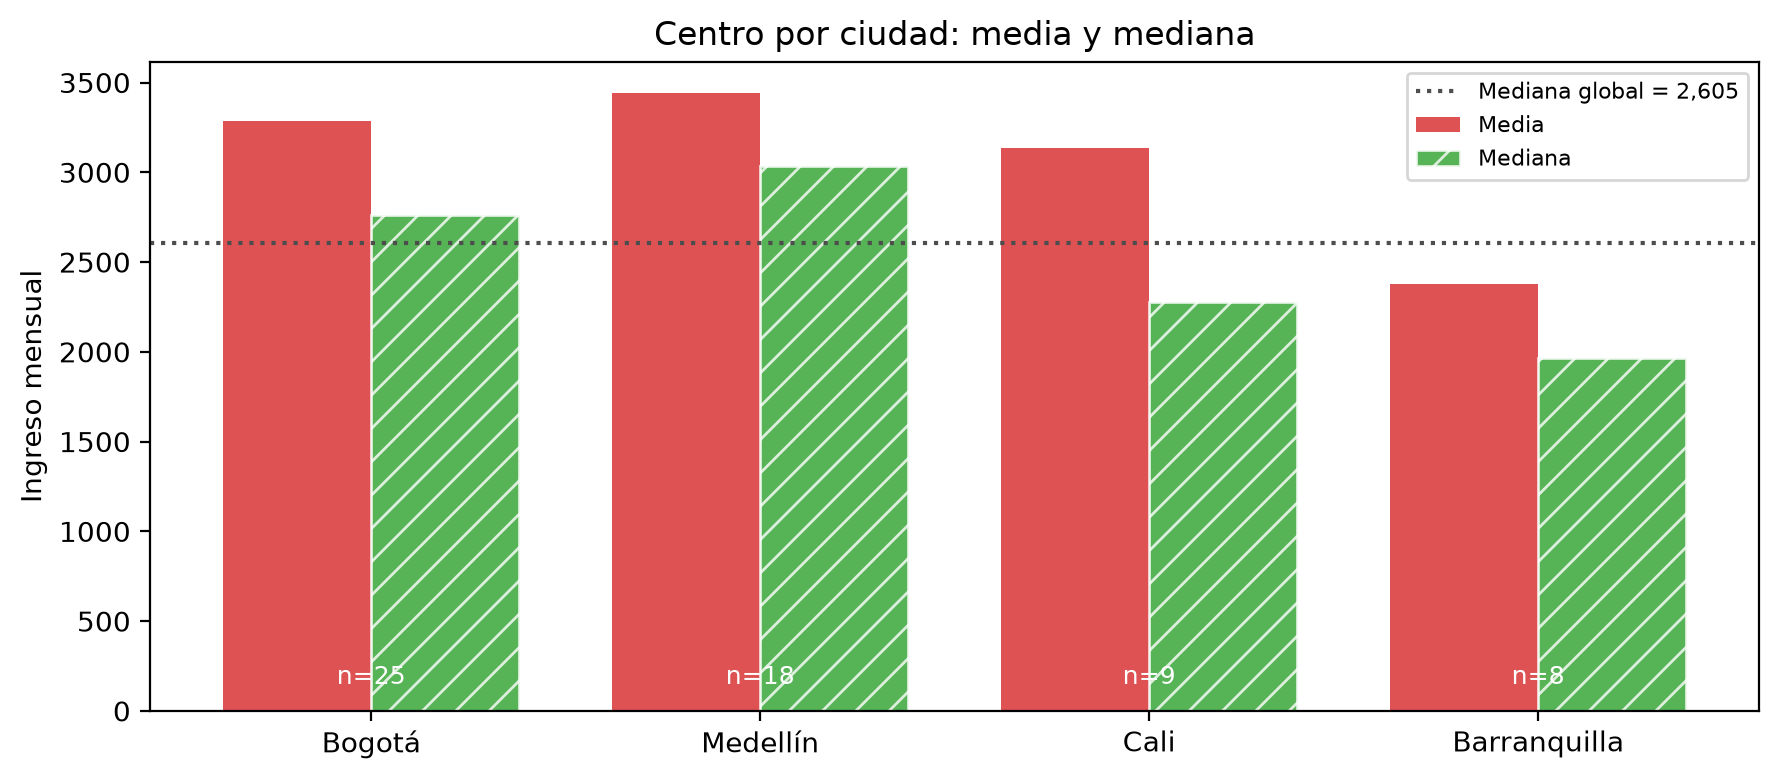
Al comparar ciudades aparece un error frecuente: promediar las medias de cada grupo como si todos los grupos tuvieran el mismo tamaño.

por_ciudad = (df.groupby("ciudad")["ingreso_mensual"]
                .agg(n="count", media="mean", mediana="median")
                .sort_values("n", ascending=False))
print(por_ciudad.round(1))

promedio_de_promedios = por_ciudad["media"].mean()
media_ponderada = np.average(por_ciudad["media"], weights=por_ciudad["n"])
print(f"\nPromedio simple de las medias por ciudad: {promedio_de_promedios:,.1f}")
print(f"Media ponderada por n:                    {media_ponderada:,.1f}")
print(f"Media global de los 60 registros:         {df['ingreso_mensual'].mean():,.1f}")

graficar_centro_por_grupo(por_ciudad, df["ingreso_mensual"].median())
               n   media  mediana
ciudad                           
Bogotá        25  3283.6   2760.0
Medellín      18  3443.9   3035.0
Cali           9  3137.8   2280.0
Barranquilla   8  2380.0   1965.0

Promedio simple de las medias por ciudad: 3,061.3
Media ponderada por n:                    3,189.3
Media global de los 60 registros:         3,189.3

Barras de media y mediana del ingreso por ciudad, con una línea punteada en la mediana global de 2,605. En las cuatro ciudades la barra de la media es más alta que la de la mediana; Medellín tiene los valores más altos y Barranquilla los más bajos. Cada ciudad indica su tamaño: 25, 18, 9 y 8 personas.

Barranquilla tiene el centro más bajo (mediana 1,965) y Medellín el más alto (mediana 3,035). En todas las ciudades la media supera a la mediana: la cola de ingresos altos aparece dentro de cada grupo.

  • El promedio simple de las medias (3,061.3) no coincide con la media global (3,189.3): trata a Barranquilla, con 8 registros, igual que a Bogotá, con 25.
  • La media ponderada por el tamaño de cada grupo recupera exactamente la media global, 3,189.3. Cuando combines medias de grupos de distinto tamaño, pondera.
  • Conexión con ML: lo mismo pasa al promediar una métrica entre lotes, clientes o clases de tamaños distintos.

Etapa 11: Machine learning: imputar faltantes con la media o con la mediana

Antes de entrenar un modelo, los faltantes suelen rellenarse con una medida de centro. Simulas que el 25% de los ingresos (15 de 60) no se registró y comparas las dos opciones más comunes.

rng_imp = rng  # mismo generador central
ingreso_obs = df["ingreso_mensual"].copy()
faltan = rng_imp.choice(len(ingreso_obs), size=15, replace=False)
ingreso_obs.iloc[faltan] = np.nan

observados = ingreso_obs.dropna()
imp_media = ingreso_obs.fillna(observados.mean())
imp_mediana = ingreso_obs.fillna(observados.median())

def resumen_centro(s):
    return pd.Series({"media": s.mean(), "mediana": s.median(),
                      "valor_mas_repetido": s.value_counts().index[0],
                      "repeticiones": s.value_counts().iloc[0]})

resumen_imp = pd.DataFrame({
    "completo (referencia)": resumen_centro(df["ingreso_mensual"]),
    "imputado con media": resumen_centro(imp_media),
    "imputado con mediana": resumen_centro(imp_mediana),
}).T
resumen_imp["repeticiones"] = resumen_imp["repeticiones"].astype(int)
print(f"Faltantes: {ingreso_obs.isna().sum()} de {len(ingreso_obs)}")
print(f"Valor usado — media: {observados.mean():,.1f} | mediana: {observados.median():,.1f}")
print()
print(resumen_imp.round(1))

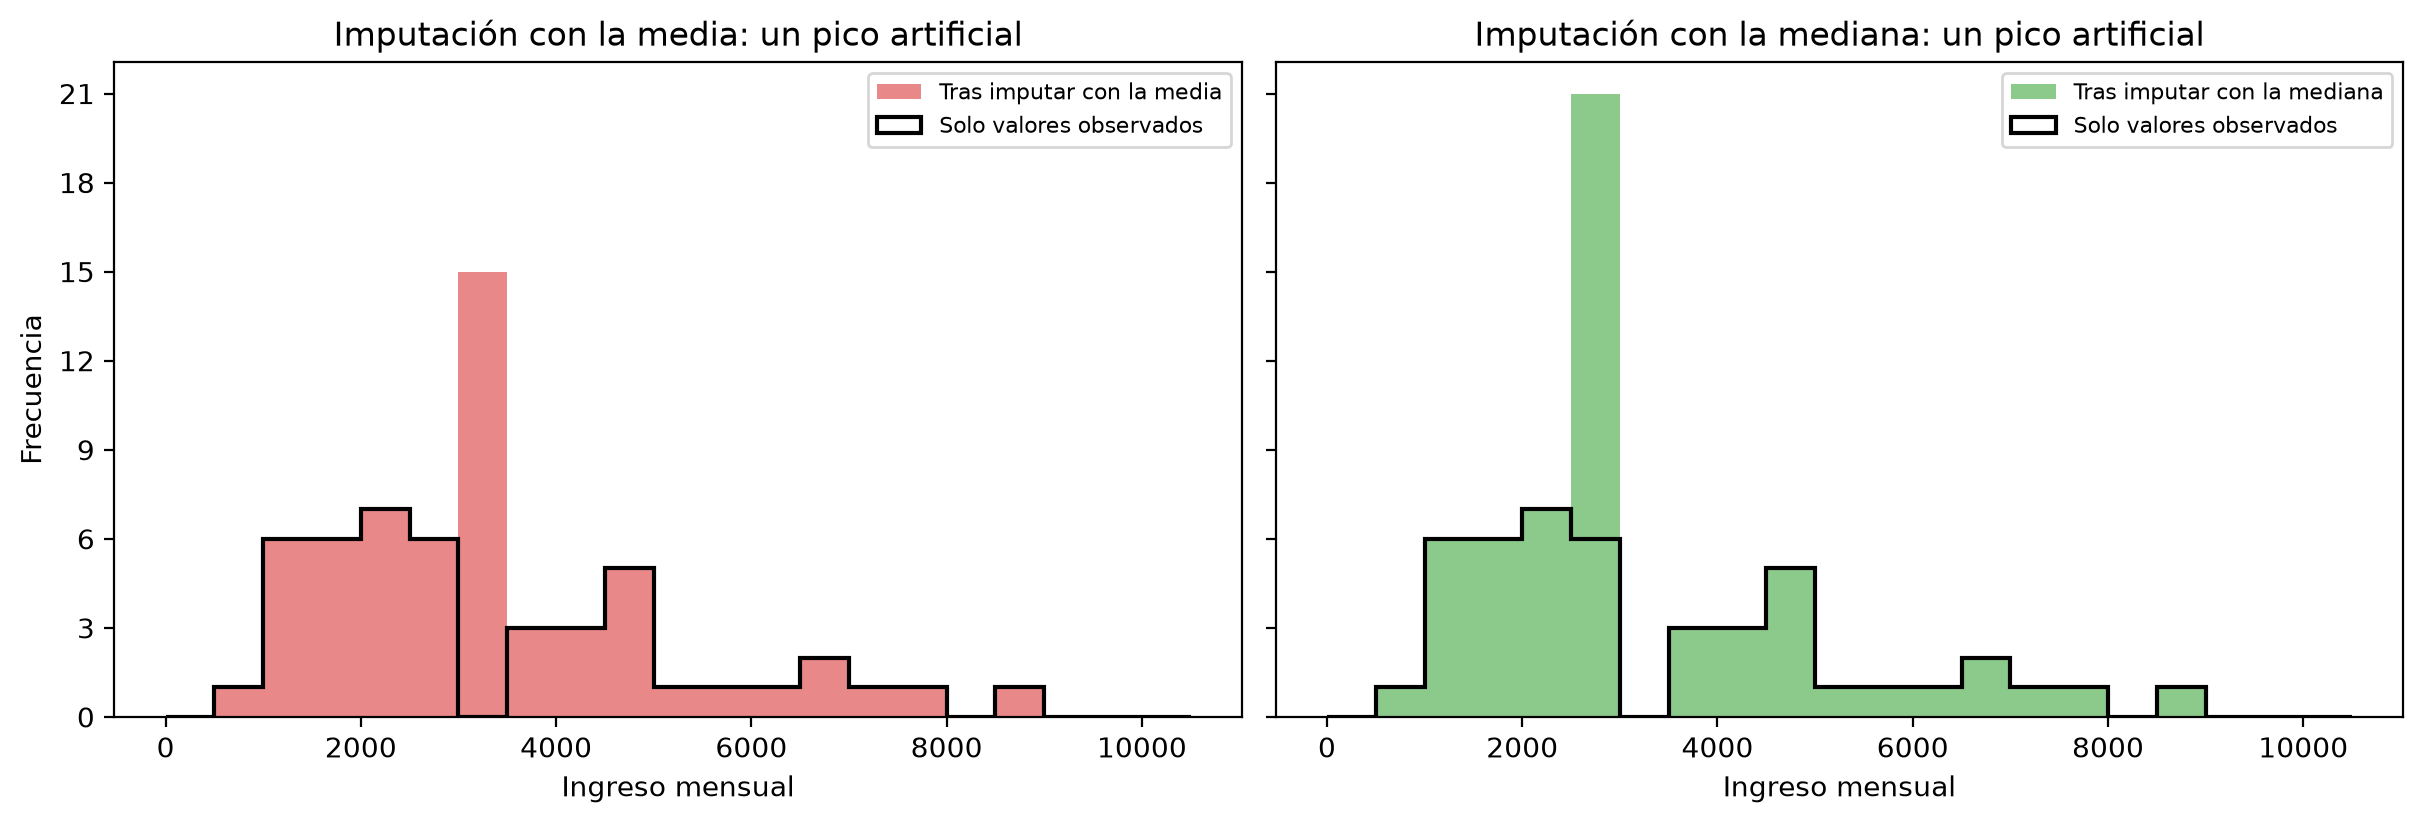
graficar_imputacion(observados, imp_media, imp_mediana, bins=np.arange(0, 11000, 500))
Faltantes: 15 de 60
Valor usado — media: 3,391.1 | mediana: 2,760.0

                        media  mediana  valor_mas_repetido  repeticiones
completo (referencia)  3189.3   2605.0              1940.0             2
imputado con media     3391.1   3391.1              3391.1            15
imputado con mediana   3233.3   2760.0              2760.0            16

Dos histogramas del ingreso tras imputar 15 faltantes. En ambos, el contorno negro de los datos observados se mantiene y aparece una barra mucho más alta que las demás: entre 3,000 y 3,500 al imputar con la media, y entre 2,500 y 3,000 al imputar con la mediana.

Las dos imputaciones crean un pico artificial: en los datos completos ningún ingreso se repite más de 2 veces; tras imputar, un mismo valor aparece 15 veces (media) o 16 (mediana, porque 2,760 ya existía). La moda del ingreso pasa a ser el valor imputado, un valor que nadie reportó.

  • Imputar con la media arrastra la mediana: pasa de 2,605 (datos completos) a 3,391.1, justo el valor imputado, porque 15 valores idénticos quedan en el centro de los datos ordenados. Imputar con la mediana la deja en 2,760, cerca de la referencia.
  • La mediana imputada (2,760) cae dentro del intervalo modal (2,000–3,000] de la etapa 6, donde está la mayoría de los datos; la media (3,391.1) cae fuera, arrastrada por la cola.
  • Juntar 15 valores idénticos en el centro hace que los datos parezcan menos dispersos de lo que son; en el capítulo 3 mides ese efecto con la desviación estándar.
  • Imputar con una medida de centro supone que los faltantes ocurren al azar. Si faltan justamente los ingresos altos, ninguna medida lo corrige: es el sesgo de selección del capítulo 1.
  • En un modelo, la imputación es una decisión que documentas. Cuando el porcentaje de faltantes es alto, agrega una columna indicadora (“faltaba ingreso”) para que el modelo no confunda el valor imputado con un dato real.

Etapa 12: Caso ilustrativo: el “salario promedio” de una oferta de empleo

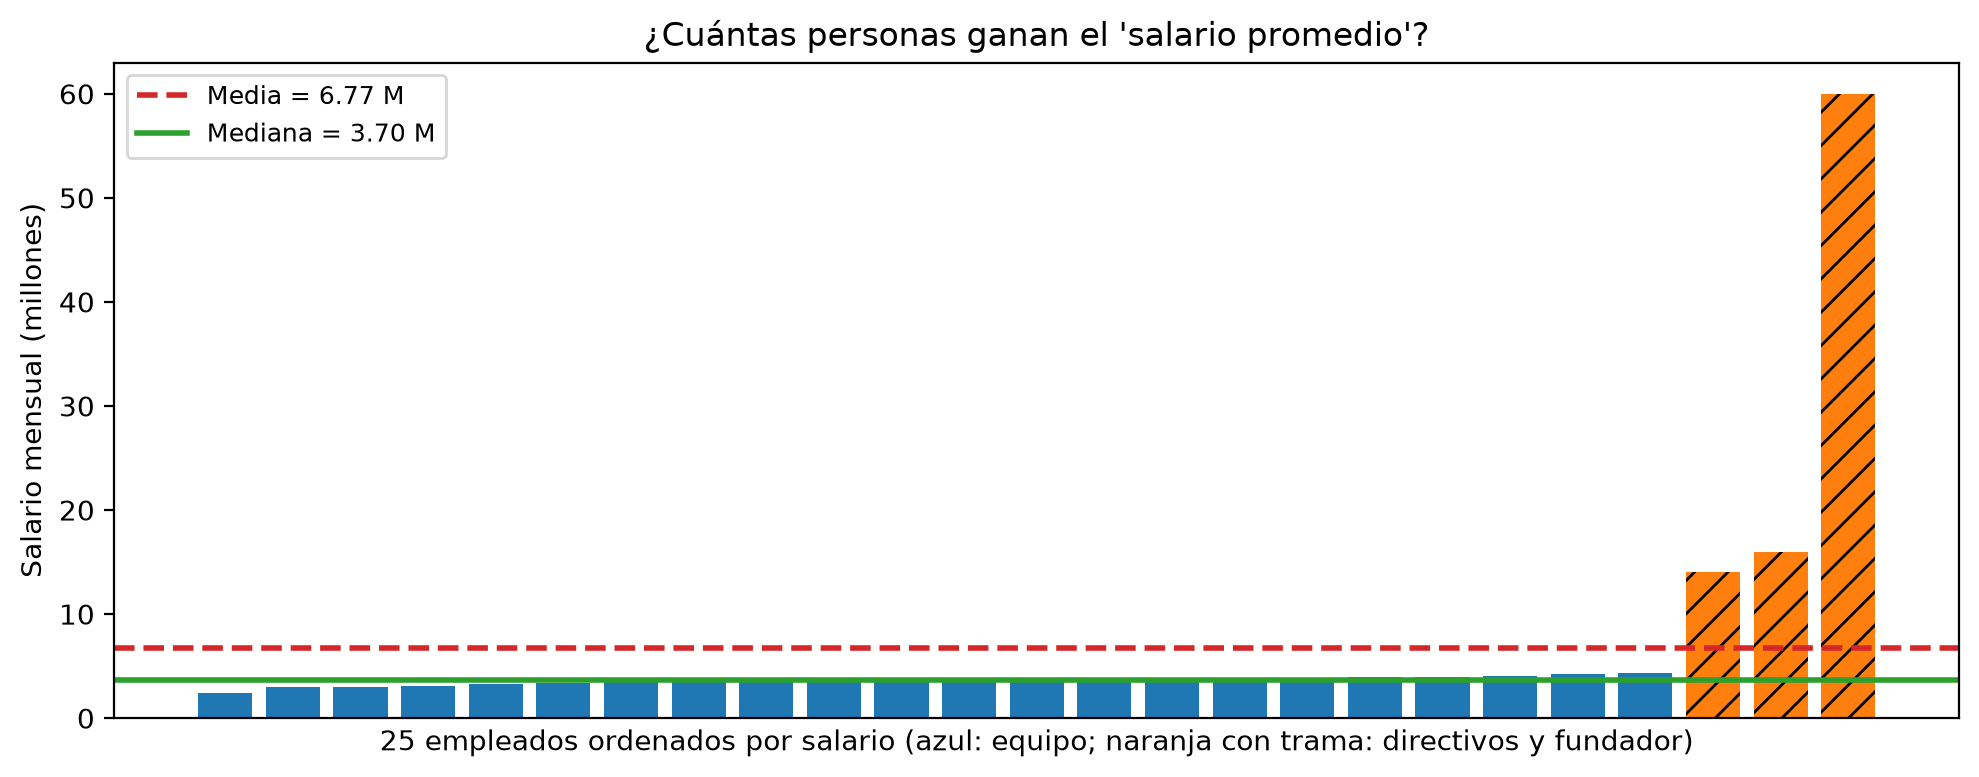
Una empresa ficticia de 25 personas publica una oferta: “salario promedio del equipo: más de 6 millones”. Los salarios son simulados: 22 personas del equipo con salarios alrededor de 3.6 millones, dos directivos con 14 y 16 millones y un fundador con 60 millones. La frase es verdadera; la pregunta es si describe lo que ganará quien entre.

rng_sal = rng  # mismo generador central
equipo = np.round(rng_sal.normal(3_600_000, 450_000, size=22), -4)
directivos = np.array([14_000_000, 16_000_000])
fundador = np.array([60_000_000])
salarios = np.concatenate([equipo, directivos, fundador])
etiquetas = ["Equipo"] * len(equipo) + ["Directivo"] * 2 + ["Fundador"]

media_sal, mediana_sal = salarios.mean(), np.median(salarios)
print(f"Media:   {media_sal:,.0f}")
print(f"Mediana: {mediana_sal:,.0f}")
print(f"Personas que ganan más que la media: {(salarios > media_sal).sum()} de {len(salarios)}")
print(f"Media sin el fundador: {salarios[:-1].mean():,.0f}")

graficar_salarios(salarios, etiquetas)
Media:   6,771,200
Mediana: 3,700,000
Personas que ganan más que la media: 3 de 25
Media sin el fundador: 4,553,333

Barras con los salarios de 25 empleados ordenados de menor a mayor. Los 22 del equipo están entre 2.4 y 4.4 millones; dos directivos tienen 14 y 16 millones y el fundador 60 millones. La línea de la media (6.77 millones) queda por encima de todo el equipo; la de la mediana (3.70 millones), a su altura.

La media (6,771,200) es correcta y engañosa: solo 3 de 25 personas, los dos directivos y el fundador, ganan más que ella. Las 22 personas del equipo están por debajo.

  • La mediana (3,700,000) describe lo que gana la persona típica del equipo, que es lo que un candidato necesita saber.
  • Un solo salario, el del fundador, explica buena parte de la diferencia: sin él, la media baja a 4,553,333.
  • Cuando una cifra de centro se usa para decidir (aceptar una oferta, fijar una política, entrenar un modelo), pregunta qué medida es y cómo se distribuyen los datos a su alrededor.

Caso aplicado: reportar la tendencia central del ingreso

Aplicas el flujo de Sección 2.3 al ingreso mensual del dataset de este capítulo.

media_i, mediana_i = df["ingreso_mensual"].mean(), df["ingreso_mensual"].median()
dif_rel = (media_i - mediana_i) / mediana_i * 100
medida = "mediana" if abs(dif_rel) > 10 else "media"

print("Variable: ingreso_mensual (cuantitativa continua, unidades monetarias)")
print(f"n = {df['ingreso_mensual'].count()} | media = {media_i:,.1f} | mediana = {mediana_i:,.1f} | "
      f"media recortada 10% = {media_recortada(df['ingreso_mensual']):,.1f}")
print(f"Diferencia relativa media vs mediana: {dif_rel:.1f}%")
print(f"Medida principal sugerida: {medida}")
Variable: ingreso_mensual (cuantitativa continua, unidades monetarias)
n = 60 | media = 3,189.3 | mediana = 2,605.0 | media recortada 10% = 2,946.9
Diferencia relativa media vs mediana: 22.4%
Medida principal sugerida: mediana

La diferencia relativa de 22.4% supera el umbral de 10% que usa el código, así que la medida sugerida es la mediana. Con eso redactas el reporte:

“Para ingreso_mensual (\(n=60\)), la media es 3,189.3 y la mediana es 2,605; la media está un 22.4% por encima porque la distribución tiene una cola de ingresos altos. Se reporta la mediana como medida principal, acompañada de la media recortada al 10% (2,946.9) como referencia. Por ciudad, se reportan medianas con el tamaño de cada grupo, y cualquier combinación de medias entre ciudades se pondera por \(n\). Limitación: datos sintéticos, 60 registros; con grupos de 8 o 9 personas, las medianas por ciudad son inestables.”

El umbral del 10% es una regla práctica de este capítulo; en un reporte real, lo que cuenta es la razón de la elección.

Errores que conviene nombrar

  1. Llamar “típico” a la media de una variable asimétrica. La mayoría de los datos puede estar por debajo de ella.
  2. Calcular la media de una variable nominal (o de sus códigos numéricos).
  3. Reportar la moda exacta de una variable continua. Es un accidente del redondeo; se usa el intervalo modal.
  4. Promediar medias de grupos de distinto tamaño sin ponderar.
  5. Eliminar valores extremos para “arreglar” la media sin saber si son errores o datos reales.
  6. Imputar sin documentar. El valor imputado crea un pico, se vuelve la moda y, si es la media, arrastra la mediana.
  7. Entrenar con MSE sin mirar el objetivo. Si tiene valores extremos, el modelo persigue la media condicional y se deja arrastrar por ellos.
  8. Reportar una sola medida sin la otra. Media y mediana juntas muestran si hay asimetría o extremos.

2.6 Guía rápida: ¿qué medida usar?

Situación Medida principal Justificación
Variable nominal (ciudad) Moda Identifica la categoría más frecuente; media y mediana no tienen interpretación.
Variable ordinal (segmento, escala de satisfacción) Mediana o moda Conservan el orden sin suponer distancias iguales entre categorías.
Variable cuantitativa sin valores extremos relevantes Media Usa todas las observaciones y representa el promedio aritmético.
Variable cuantitativa con valores extremos Mediana, acompañada por la media La mediana es menos sensible; comparar ambas muestra el efecto de los extremos.
Variable continua, pregunta “¿dónde se concentran?” Intervalo modal La moda exacta depende del redondeo.
Un promedio que no dependa de unos pocos extremos Media recortada Usa la mayoría de los datos y descarta los extremos con una regla fija.
Combinar medias de grupos de distinto tamaño Media ponderada El promedio simple de medias sobrerrepresenta a los grupos pequeños.

Regla de comunicación: indica siempre la variable, el valor, la unidad y la razón por la que elegiste esa medida.

2.7 Preguntas de comprensión

  1. Un reporte dice “el tiempo promedio de entrega es de 2 días”, y sabes que unos pocos envíos tardan semanas. ¿Qué medida pedirías y por qué?
  2. Tienes la satisfacción, en escala de 1 a 5, de 40 clientes. ¿Qué medidas de centro son válidas? Si las dos posiciones centrales caen en 3 y en 4, ¿qué reportas?
  3. ¿Por qué la media recortada al 10% aguantó hasta el 10% de datos contaminados y se rompió en el 15%?
  4. Un modelo que predice el valor de reclamaciones de seguros se entrena con MSE, y en los datos hay unos pocos siniestros enormes. ¿Qué esperas de sus predicciones y qué alternativa tienes?
  5. Calculas la exactitud de un modelo en cuatro sucursales con 25, 18, 9 y 8 clientes. ¿Cómo combinas las cuatro cifras en una sola?
  1. La mediana, acompañada de la media. Como en la etapa 3, una cola larga arrastra la media: allí el 60% de los registros quedó por debajo de ella. La mediana te dice cuánto tarda el envío típico; la media sigue siendo útil si te importa el tiempo total acumulado.
  2. Mediana y moda; la media supone distancias iguales entre categorías. Si las posiciones centrales caen en 3 y en 4, reportas ambas categorías (“la mediana está entre 3 y 4”), no 3.5.
  3. Con 60 datos, recortar el 10% descarta 6 valores por lado. Hasta 6 datos contaminados (10%), todos caen en el recorte (3,575.8); con 9 (15%), 3 quedan dentro del promedio y lo disparan a 58,544.2.
  4. El modelo persigue la media condicional, así que sus predicciones se desplazan hacia arriba por los siniestros grandes. Si te importa el caso típico, una pérdida absoluta (MAE, que persigue la mediana) es más robusta; si te importa el costo total esperado, la media es la que lo representa. Decide según la pregunta.
  5. Ponderando por el número de clientes de cada sucursal. En la etapa 10, el promedio simple de las medias dio 3,061.3 y la media ponderada 3,189.3, que coincide con la global.

2.8 Referencias para profundizar

  • Hampel, F. R. (1971). A general qualitative definition of robustness. The Annals of Mathematical Statistics, 42(6), 1887–1896. Introduce el punto de ruptura como medida de robustez.
  • Huber, P. J. y Ronchetti, E. M. (2009). Robust Statistics (2.ª ed.). Wiley. Estimadores robustos de localización, entre ellos la mediana y la media recortada.
  • Wilcox, R. R. (2021). Introduction to Robust Estimation and Hypothesis Testing (5.ª ed.). Academic Press. Tratamiento aplicado de la media recortada y de sus errores estándar.
  • Little, R. J. A. y Rubin, D. B. (2019). Statistical Analysis with Missing Data (3.ª ed.). Wiley. Por qué imputar con una constante distorsiona la distribución y bajo qué supuestos sobre los faltantes.
  • Documentación de scikit-learn, Imputation of missing values: SimpleImputer con las estrategias mean, median y most_frequent, y el indicador de faltantes (add_indicator).

2.9 Lo que debes llevarte de este capítulo

Media, mediana y moda responden preguntas distintas: la media es el punto de equilibrio y minimiza el error cuadrático; la mediana es la posición central y minimiza el error absoluto; la moda es lo más frecuente y es la única válida para categorías nominales.

  • Con una cola de ingresos altos, la media (3,189.3) quedó un 22.4% por encima de la mediana (2,605), y el 60% de las personas ganaba menos que la media.
  • El tipo de variable decide qué medida es válida: en ciudad solo la moda (Bogotá); en segmento, moda (Básico) y mediana (Estándar), que responden cosas distintas. En una variable continua, el intervalo modal reemplaza a la moda exacta.
  • Un solo dato contaminado rompe la media; la media recortada al 10% aguanta hasta el 10% de contaminación y la mediana hasta el 50%.
  • Para combinar medias de grupos de distinto tamaño, ponderas por \(n\): el promedio simple dio 3,061.3 frente a 3,189.3.
  • Imputar con una medida de centro crea un pico artificial (15 o 16 valores idénticos), cambia la moda y, si usas la media, arrastra la mediana.
  • Al elegir la pérdida de un modelo (MSE o MAE), eliges qué medida de centro persigue.

2.10 Puente hacia los siguientes capítulos

Viste que los valores extremos afectan más a la media que a la mediana y que imputar con una medida de centro concentra artificialmente los datos. Queda una pregunta abierta: dos conjuntos pueden tener la misma media y la misma mediana y comportarse de forma muy distinta, porque el centro no dice qué tan separados están los datos. En el capítulo 3 mides esa separación con el rango, la varianza, la desviación estándar y el coeficiente de variación; en el capítulo 4 estudias la forma de las distribuciones, la asimetría y la detección de anomalías.