Cuando dos grupos independientes y una prueba \(t\) no alcanzan
La prueba \(t\) de dos muestras del capítulo 9 responde una pregunta precisa: si dos grupos independientes, con datos aproximadamente normales, tienen la misma media. Las comparaciones que vas a encontrar en un equipo de datos rara vez llegan tan ordenadas. Envías los mismos prompts a las dos versiones del modelo. El servicio corre en cuatro regiones y no en dos. Las latencias tienen una cola larga y algunos timeouts. El tablero del experimento trae veinte métricas y no una.
Cada una de esas situaciones rompe algo de la prueba \(t\) y tiene su propia herramienta. En este capítulo las recorres en orden y completas el mapa de pruebas que abrió el capítulo 10 con los datos categóricos.
El contexto sigue siendo el servicio de inferencia: latencias en milisegundos, la versión actual (A) frente a la cuantizada (B) y varias regiones de despliegue. Los datos son simulados: cada etapa declara la distribución de la que salen (normal, log-normal o \(t\) de Student, generadas con rng) y los parámetros que usa, para que puedas juzgar qué tan bien recupera cada prueba lo que se puso por diseño. El ejemplo de la etapa 11 es una tabla pequeña escrita a mano.
Tiempo estimado de lectura: 90 minutos (unas 3 horas si ejecutas el código y resuelves el ejercicio)
Nivel: Básico
Conocimientos previos recomendados: el capítulo 9 (hipótesis, p-value, errores tipo I y II, prueba \(t\) e intervalos), el capítulo 10 (los cinco pasos de una prueba y la distribución chi-cuadrado) y el capítulo 8 (normal y teorema del límite central).
Tecnologías mencionadas: Python 3.13, NumPy, pandas, SciPy (scipy.stats), statsmodels y Matplotlib; scikit-learn aparece solo como referencia (f_classif).
Objetivos
Al terminar este capítulo vas a ser capaz de:
distinguir un diseño pareado de uno independiente y aplicar la prueba \(t\) pareada;
revisar los supuestos de normalidad y de varianzas iguales, y decidir qué hacer cuando no se cumplen;
explicar por qué no se comparan varios grupos con muchas pruebas \(t\);
calcular a mano un ANOVA de un factor (sumas de cuadrados, estadístico \(F\) y p-value) y verificarlo con SciPy;
ubicar qué grupos difieren con comparaciones posteriores;
aplicar las pruebas de Mann–Whitney y Kruskal–Wallis cuando hay asimetría o valores extremos;
construir una prueba de permutación para un estadístico sin fórmula, como el percentil 95;
corregir por comparaciones múltiples con Bonferroni, Holm y Benjamini–Hochberg.
Ejecuta las celdas en orden: las etapas comparten variables y el generador aleatorio rng.
11.1 El lenguaje de la comparación de grupos
Repaso: los cinco pasos y el mapa
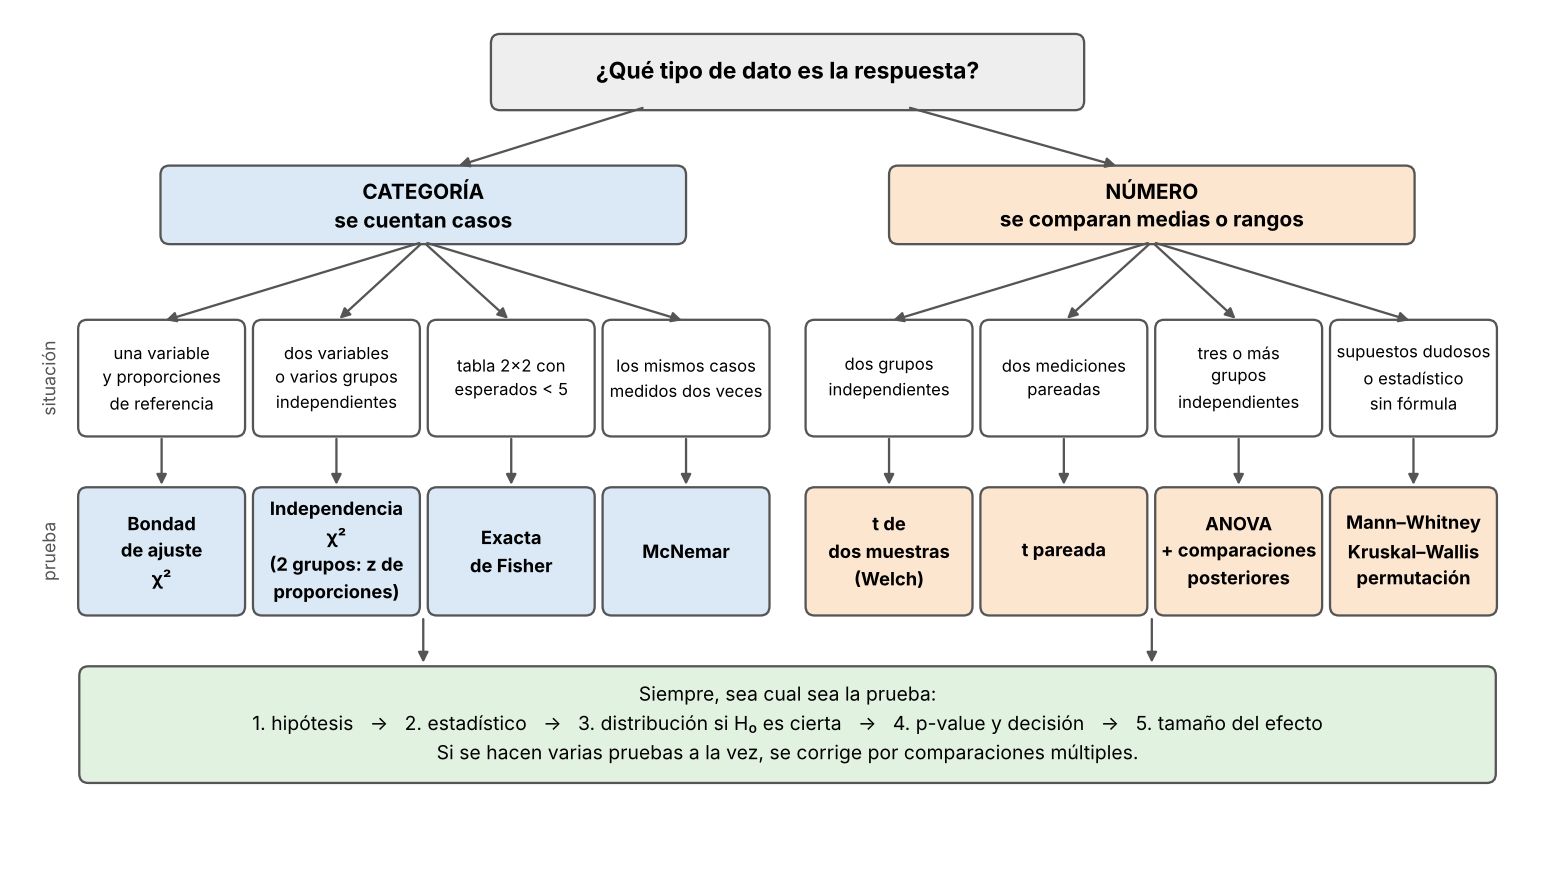
Toda prueba recorre los mismos cinco pasos que viste en el capítulo 10: hipótesis, estadístico, distribución de referencia si \(H_0\) es cierta, p-value y decisión, y tamaño del efecto. Cambian el estadístico y su distribución. En este capítulo recorres la rama del mapa en la que la respuesta es un número.
Mapa de pruebas de hipótesis según el tipo de dato y el diseño. Este capítulo recorre la rama de datos numéricos.
Muestras independientes y muestras pareadas
Dos muestras son independientes cuando cada observación de un grupo no tiene relación con ninguna en particular del otro: usuarios distintos, requests distintos. Son pareadas cuando cada observación de un grupo tiene una pareja natural en el otro: el mismo prompt enviado a las dos versiones, el mismo usuario antes y después.
En el ejemplo de prompts, parte de la variación corresponde a la longitud de cada prompt, que comparten las dos versiones. Al restar las dos mediciones eliminas ese componente común. La ganancia depende de cuánto covarían las mediciones; el pareo por sí solo no la garantiza.
Supón que un prompt tarda 310 ms en A y 303 ms en B, y otro tarda 95 ms en A y 90 ms en B. Las latencias difieren mucho entre prompts (310 frente a 95), mientras que las diferencias dentro de cada prompt se parecen (\(-7\) y \(-5\)).
La prueba \(t\) pareada
Es una prueba \(t\) de una muestra aplicada a las diferencias\(d_i=x_{B,i}-x_{A,i}\):
donde \(n\) es el número de parejas, \(\bar d\) la media de las diferencias y \(s_d\) su desviación estándar.
El numerador es la misma diferencia de medias que usaría la prueba de dos muestras. Cambia el denominador, que usa la variabilidad de las diferencias, por lo general mucho menor que la de las mediciones originales.
Los supuestos y cómo se revisan
La prueba \(t\) clásica de dos muestras y el ANOVA comparten tres supuestos. La \(t\) pareada y la de Welch no necesitan el tercero.
Supuesto
Qué pide
Cómo lo revisas
Si no se cumple
Independencia
Las observaciones (o las parejas) no se influyen entre sí
Con el diseño; ningún gráfico lo arregla
Otro modelo u otro diseño
Normalidad
Los datos de cada grupo, o las diferencias, son aproximadamente normales
Gráfico Q–Q, prueba de Shapiro–Wilk
Transformar, usar rangos o permutación
Varianzas iguales
Los grupos tienen dispersión parecida
Desviaciones por grupo, prueba de Levene
Versión de Welch
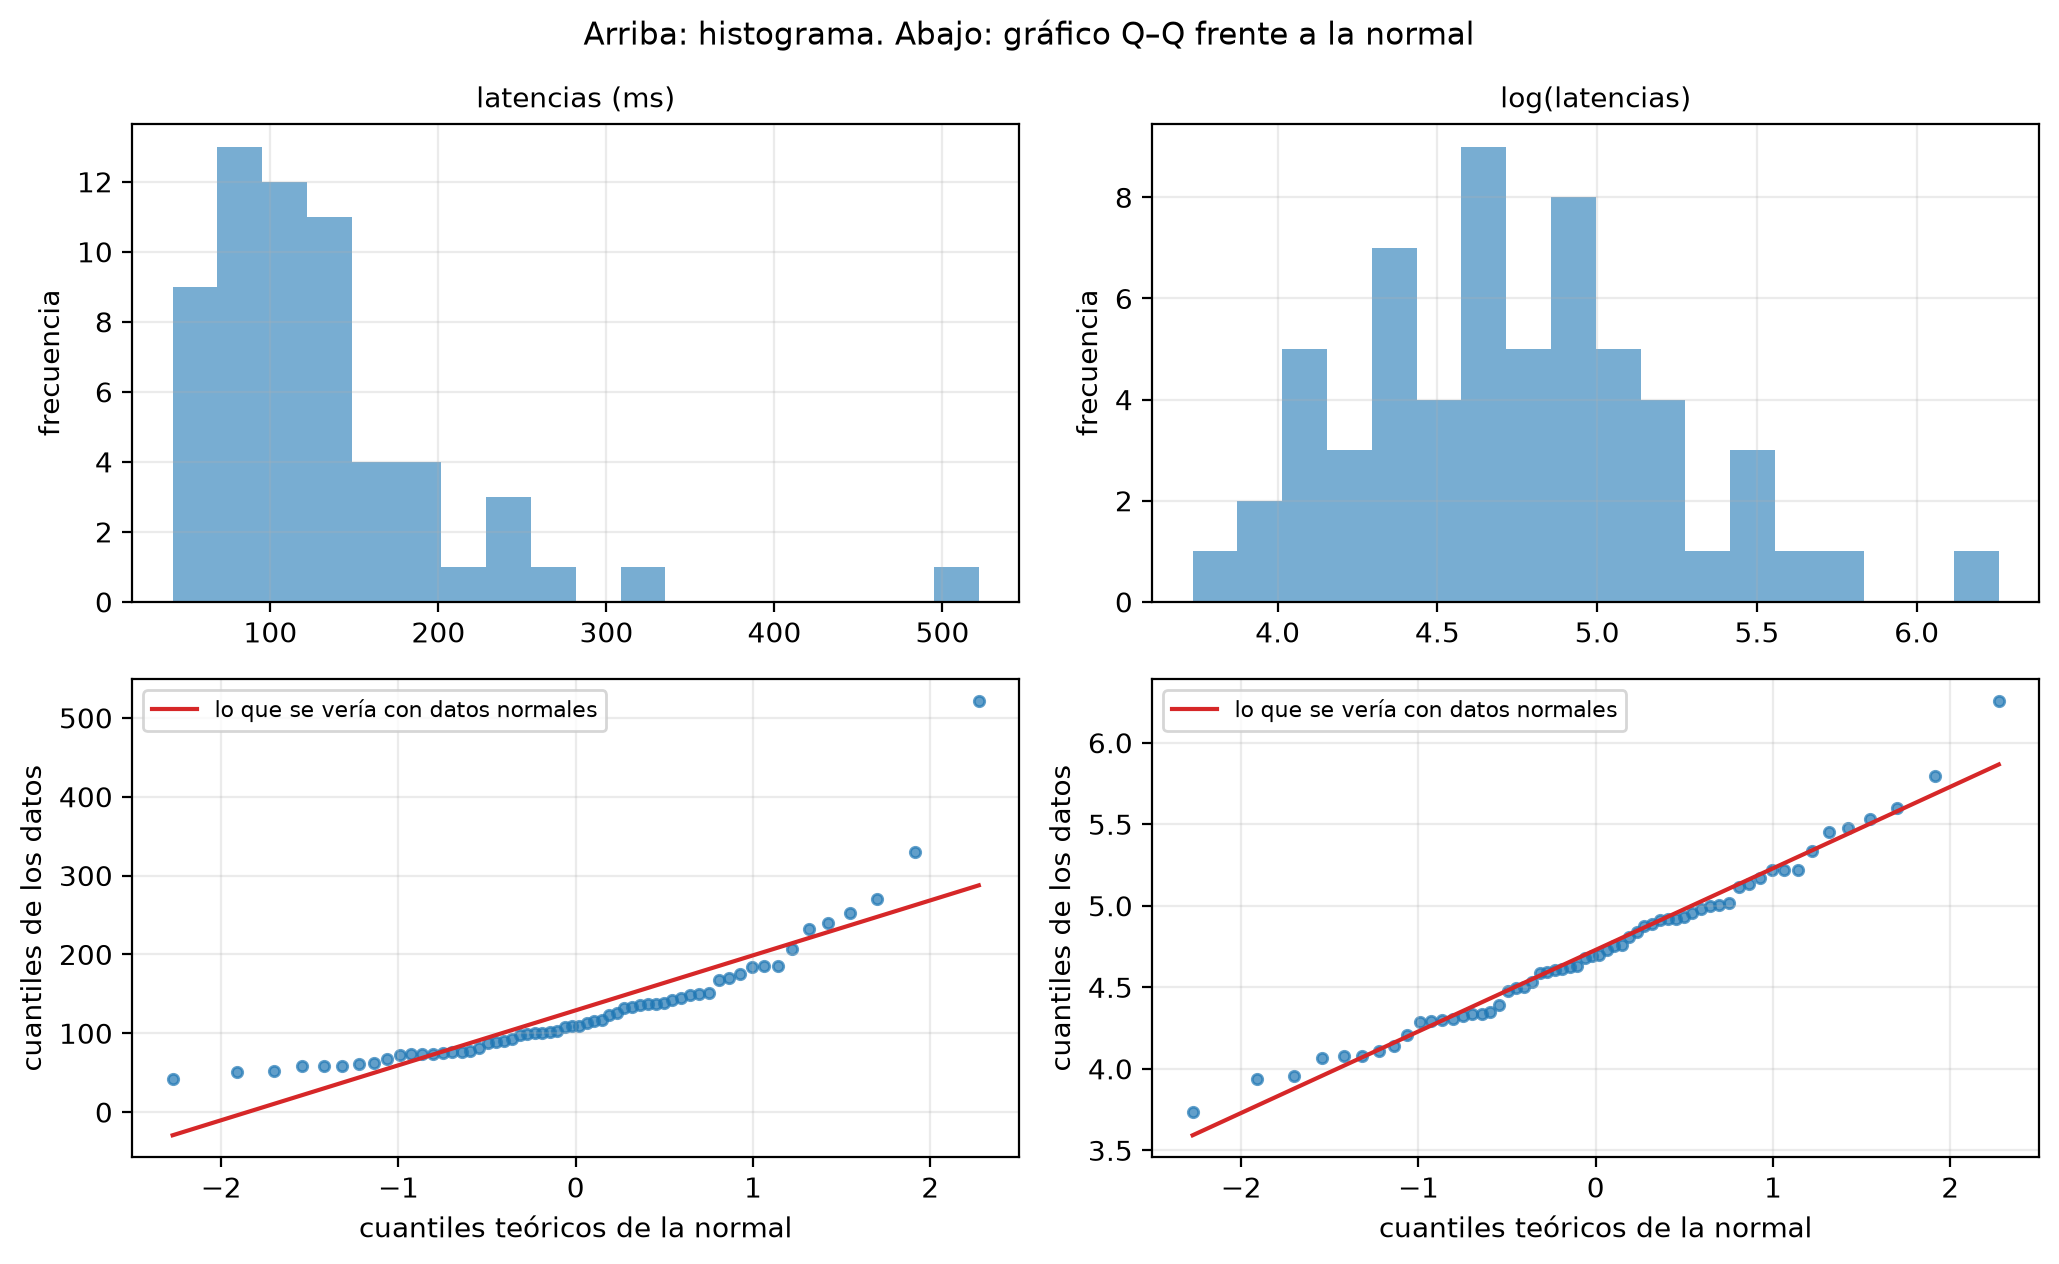
El gráfico Q–Q compara los cuantiles de los datos con los de una normal: si los datos son normales, los puntos caen sobre una recta, y si se despegan en los extremos, las colas son distintas de las normales. La prueba de Shapiro–Wilk tiene como \(H_0\) que los datos provienen de una normal, y un p-value pequeño indica que no lo parecen. La prueba de Levene tiene como \(H_0\) que los grupos tienen la misma varianza.
Ten en cuenta dos advertencias. Estas pruebas tienen la lógica invertida: lo deseable es no rechazar, y no rechazar no demuestra el supuesto. Además dependen de \(n\): con pocos datos no detectan violaciones graves y con muchos detectan desviaciones que no afectan la conclusión. Por eso el gráfico pesa más que el p-value. La normalidad importa menos cuando \(n\) es grande, porque las medias tienden a la normal (teorema del límite central); la independencia importa siempre.
El problema de las comparaciones múltiples
Cada prueba hecha con \(\alpha=0.05\) tiene 5% de probabilidad de dar una falsa alarma cuando \(H_0\) es cierta. Si haces \(m\) pruebas independientes y todas las \(H_0\) son ciertas, la probabilidad de al menos una falsa alarma es
\[
1-(1-\alpha)^m .
\]
Esa probabilidad se llama tasa de error por familia (FWER, por family-wise error rate). Con \(m=6\) pruebas vale \(1-0.95^6=0.265\); con \(m=20\), \(0.642\).
ANOVA de un factor
El análisis de varianza (ANOVA) compara las medias de \(k\) grupos con una sola prueba:
\[
H_0:\mu_1=\mu_2=\dots=\mu_k,\qquad H_1:\text{al menos una media es distinta}.
\]
Para eso parte la variación total de los datos en dos componentes:
Si \(H_0\) es cierta, las medias de los grupos solo difieren por azar y los dos cuadrados medios estiman la misma varianza \(\sigma^2\), así que \(F\) ronda 1. Si alguna media es distinta, el numerador crece y \(F\) se aleja de 1 hacia arriba. De ahí viene el nombre “análisis de varianza”: comparas medias mirando varianzas.
La distribución \(F\)
Es la distribución del cociente de dos variables chi-cuadrado independientes, cada una dividida por sus grados de libertad:
Tiene dos números de grados de libertad: los del numerador (\(k-1\)) y los del denominador (\(N-k\)). Solo toma valores positivos y, como en la prueba chi-cuadrado, miras solo la cola derecha. Con dos grupos, el ANOVA y la prueba \(t\) de varianzas iguales son la misma prueba: \(F=t^2\).
Comparaciones posteriores
El ANOVA dice que alguna media difiere, no cuál. Las comparaciones posteriores (post hoc) comparan los grupos de a pares controlando la tasa de error por familia.
Tukey HSD compara todos los pares. Suele presentarse después del ANOVA, aunque no depende de que este rechace, y los dos resultados no siempre coinciden.
Bonferroni multiplica cada p-value por el número de comparaciones. Sirve para cualquier familia de pruebas y, con el mismo error estándar, es algo más conservadora que Tukey.
Pruebas basadas en rangos
En lugar de los valores, estas pruebas usan su posición al ordenarlos de menor a mayor. Un timeout de 2 000 ms y uno de 20 000 ms ocupan el mismo rango, el último.
Mann–Whitney compara dos grupos independientes.
Kruskal–Wallis compara tres o más; es el análogo del ANOVA con rangos.
Su \(H_0\) es que las distribuciones son iguales, y son sensibles a que los valores de un grupo tiendan a ser mayores que los del otro. El estadístico \(U\) de Mann–Whitney tiene una lectura directa: cuenta en cuántas de las \(n_A n_B\) parejas posibles la observación del primer grupo supera a la del segundo (un empate vale medio). Por eso \(U/(n_A n_B)\) estima la probabilidad de que una observación tomada al azar de un grupo supere a una tomada al azar del otro. Solo puedes leerlas como una comparación de medianas si las dos distribuciones tienen la misma forma.
Para datos pareados existe el análogo con rangos de la \(t\) pareada, la prueba de Wilcoxon de rangos con signo, que trabaja con los rangos de las diferencias. No se desarrolla en este capítulo y figura en la guía rápida.
Prueba de permutación
Es una forma de obtener la distribución de referencia sin fórmula. Si \(H_0\) es cierta y los grupos no difieren, las etiquetas “A” y “B” son intercambiables. Barajas las etiquetas muchas veces, recalculas el estadístico en cada barajada y cuentas en qué proporción resulta tan extremo como el observado. Esa proporción es el p-value, y el procedimiento sirve para cualquier estadístico: una diferencia de medianas, de percentiles 95 o de exactitudes.
Correcciones por comparaciones múltiples
Método
Qué controla
Cómo decide (con \(m\) pruebas)
Bonferroni
FWER: probabilidad de al menos una falsa alarma
Rechaza si \(p\le\alpha/m\)
Holm
FWER, con más potencia
Ordena los p-values; compara el menor con \(\alpha/m\), el siguiente con \(\alpha/(m-1)\), y se detiene en el primero que no pasa
Benjamini–Hochberg
FDR: proporción esperada de falsas alarmas entre los rechazos
Ordena los p-values; busca el mayor \(i\) con \(p_{(i)}\le \frac{i}{m}\alpha\) y rechaza hasta ese
Bonferroni y Holm valen con cualquier dependencia entre las pruebas. La garantía de Benjamini–Hochberg se establece para pruebas independientes y ciertas formas de dependencia positiva (PRDS), y que las métricas estén correlacionadas no demuestra esa condición. Ante una dependencia que no puedes justificar, Benjamini–Yekutieli ofrece un control más conservador.
Controlar la FWER es exigente, porque buscas no equivocarte ni una vez. Controlar la tasa de descubrimientos falsos (FDR) es más permisivo: aceptas que una fracción pequeña de los hallazgos sea falsa a cambio de detectar más. La elección depende del costo de una falsa alarma.
Tamaño del efecto
La diferencia en las unidades del problema, con su intervalo de confianza, es siempre la primera opción.
La \(d\) de Cohen divide la diferencia de medias por una desviación estándar. En grupos independientes se usa la desviación combinada de los grupos; en datos pareados suele usarse la de las diferencias (\(d_z\)), que no es comparable con la anterior.
El \(\eta^2\) (eta cuadrado) del ANOVA es \(SC_{\text{entre}}/SC_{\text{total}}\), la fracción de la variación total asociada al grupo.
\(P(B<A)\) acompaña a Mann–Whitney: la probabilidad de que una observación de B sea menor que una de A.
11.2 Por qué importa en IA y machine learning
Comparar es la operación más frecuente al construir y operar modelos:
Comparar modelos sobre los mismos datos es un diseño pareado: los mismos casos de prueba, los mismos prompts, los mismos pliegues de validación cruzada. Con pliegues aparece una complicación, porque comparten datos de entrenamiento, las parejas dejan de ser independientes y la \(t\) pareada rechaza de más; existen versiones corregidas (Nadeau y Bengio, 2003).
Comparar varias configuraciones (hiperparámetros, arquitecturas, regiones, tipos de hardware) es una comparación de más de dos grupos.
Las métricas de sistemas rara vez son normales. Latencias, tiempos de espera y costos tienen colas largas y valores extremos.
Las métricas que importan no siempre tienen fórmula. El percentil 95 de la latencia o una diferencia de AUC se prueban por permutación o remuestreo.
Un experimento produce muchas pruebas. Decenas de métricas, segmentos y variantes multiplican las falsas alarmas.
La selección de variables por filtro calcula una prueba por variable, con cientos o miles de pruebas a la vez (etapa 12).
La prueba la eliges por el diseño (pareado o independiente, dos grupos o varios), por la forma de los datos y por cuántas pruebas vas a hacer, antes de mirar los resultados.
11.3 Flujo recomendado de trabajo
Identifica la unidad de observación y si los grupos son pareados o independientes.
Cuenta cuántos grupos y cuántas pruebas habrá.
Escribe \(H_0\), \(H_1\) y \(\alpha\), la prueba prevista y la alternativa si los supuestos fallan, antes de calcular.
Grafica los datos por grupo: centro, dispersión, asimetría, valores extremos.
Revisa los supuestos con gráficos y, como apoyo, con pruebas.
Aplica la prueba prevista o, si los supuestos fallan, la alternativa ya decidida: \(t\) pareada, Welch, ANOVA, rangos o permutación.
Si hay varios grupos y rechazas, haz comparaciones posteriores.
Si hay varias pruebas, corrige.
Reporta el efecto en unidades del problema, con su intervalo, y redacta la conclusión:
«Se comparó [variable, unidades] entre [k] grupos ([n] por grupo, [independientes / pareados]). [Supuestos revisados y resultado]. [Prueba]: [estadístico(gl)] = [valor], p = [valor]; tamaño del efecto [η² / d / diferencia] = [valor]. Comparaciones posteriores con [método]: [pares que difieren, con diferencia e IC]. Se hicieron [m] pruebas en total. Limitación: [n, supuestos o diseño observacional].»
El diseño del estudio decide la prueba, y los datos solo confirman si sus supuestos son razonables. La etapa 10 llena esta plantilla con las cuatro regiones.
11.4 Preparar el entorno
La celda carga NumPy, pandas, Matplotlib, el módulo stats de SciPy y statsmodels, fija un estilo de gráficos y crea el generador rng con la semilla central SEMILLA = 42, del que salen todas las simulaciones. Los ejemplos corren en CPU; con otras versiones de las bibliotecas pueden aparecer diferencias pequeñas en los últimos decimales.
%matplotlib inline%config InlineBackend.figure_format ="retina"import sysprint("Python:", sys.version.split()[0])from itertools import combinationsimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom scipy import statsSEMILLA =42rng = np.random.default_rng(SEMILLA)plt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25import scipyimport matplotlibimport statsmodelsimport statsmodels.api as smfor nombre, modulo in [("NumPy", np), ("pandas", pd), ("Matplotlib", matplotlib), ("SciPy", scipy), ("statsmodels", statsmodels)]:print(f"{nombre}: {modulo.__version__}")
El entorno queda con Python 3.13.14, NumPy 2.5.1, pandas 3.0.5, SciPy 1.18.0 y statsmodels 0.14.6.
La siguiente celda, plegada en la versión web, define las funciones de gráficos de las etapas. Solo dibujan: las tablas, las diferencias de medias y los p-values los calculas a la vista en cada etapa.
Funciones de visualización
def graficar_pareado(lat_a, lat_b, titulo): d = lat_b - lat_a fig, axes = plt.subplots(1, 3, figsize=(12, 3.8)) ax = axes[0] ax.boxplot([lat_a, lat_b], widths=0.5) ax.set_xticks([1, 2]) ax.set_xticklabels(["A (actual)", "B (cuantizado)"]) ax.set_ylabel("latencia (ms)") ax.set_title("como grupos independientes", fontsize=10) ax = axes[1]for a, b inzip(lat_a, lat_b): ax.plot([0, 1], [a, b], color="C0"if b < a else"C3", linestyle="-"if b < a else"--", marker="o"if b < a else"s", markersize=2, alpha=0.55, linewidth=1) ax.set_xticks([0, 1]) ax.set_xticklabels(["A (actual)", "B (cuantizado)"]) ax.set_xlim(-0.25, 1.25) ax.set_title("cada línea es un prompt", fontsize=10) ax = axes[2] ax.hist(d, bins=12, alpha=0.6) ax.axvline(0, color="0.3", linestyle="--", label="sin diferencia") ax.axvline(d.mean(), color="C3", label=f"media = {d.mean():.2f} ms") ax.set_xlabel("diferencia B − A (ms)") ax.set_title("las diferencias", fontsize=10) ax.legend(fontsize=8) fig.suptitle(titulo, fontsize=11) plt.tight_layout() plt.show()def graficar_normalidad(datos, etiquetas, titulo): fig, axes = plt.subplots(2, len(datos), figsize=(5.2*len(datos), 6.4))for j, (x, etiqueta) inenumerate(zip(datos, etiquetas)): axes[0, j].hist(x, bins=18, alpha=0.6) axes[0, j].set_title(etiqueta, fontsize=10) axes[0, j].set_ylabel("frecuencia") (teo, obs), (pend, inter, _) = stats.probplot(x, dist="norm") axes[1, j].scatter(teo, obs, s=14, alpha=0.7) axes[1, j].plot(teo, pend * teo + inter, color="C3", label="lo que se vería con datos normales") axes[1, j].set_xlabel("cuantiles teóricos de la normal") axes[1, j].set_ylabel("cuantiles de los datos") axes[1, j].legend(fontsize=8) fig.suptitle(titulo, fontsize=11) plt.tight_layout() plt.show()def graficar_fwer(resumen, titulo, alpha=0.05): fig, ax = plt.subplots(figsize=(7.8, 4)) ax.plot(resumen["grupos"], resumen["simulada"], "o-", label="simulación: al menos una falsa alarma") ax.plot(resumen["grupos"], resumen["si fueran independientes"], "s--", color="0.5", label=r"$1-(1-\alpha)^m$(pruebas independientes)") ax.axhline(alpha, color="C3", linestyle=":", label=fr"$\alpha$ = {alpha:g}") ax.set_xlabel("número de grupos (todos con la misma media)") ax.set_ylabel("probabilidad de al menos un rechazo") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_grupos(grupos, nombres, titulo, ylabel="latencia (ms)"): fig, ax = plt.subplots(figsize=(8.2, 4.2)) media_general = np.concatenate(grupos).mean()for j, x inenumerate(grupos): desplazamiento = np.linspace(-0.18, 0.18, len(x)) ax.scatter(j + desplazamiento, x, s=16, alpha=0.5) ax.hlines(x.mean(), j -0.3, j +0.3, color="0.1", linewidth=2.5) ax.hlines([], 0, 0, color="0.1", linewidth=2.5, label="media del grupo") ax.axhline(media_general, color="C3", linestyle="--", label=f"media general = {media_general:.1f}") ax.set_xticks(range(len(nombres))) ax.set_xticklabels(nombres) ax.set_ylabel(ylabel) ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_cola_f(estadistico, gl1, gl2, titulo, alpha=0.05): critico = stats.f.ppf(1- alpha, gl1, gl2) tope =max(estadistico, critico) *1.3+1 xs = np.linspace(0.01, tope, 500) fx = stats.f.pdf(xs, gl1, gl2) fig, ax = plt.subplots(figsize=(8, 3.8)) ax.plot(xs, fx, label=fr"$F_{{{gl1},{gl2}}}$(si $H_0$ es cierta)") ax.fill_between(xs, fx, where=xs >= critico, alpha=0.3, color="C3", label=fr"zona de rechazo ($\alpha$ = {alpha:g})") ax.axvline(critico, color="C3", linestyle=":", label=f"valor crítico = {critico:.2f}") ax.axvline(estadistico, color="0.15", linestyle="--", label=f"observado = {estadistico:.2f}") ax.set_xlabel("estadístico F") ax.set_ylabel("densidad") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()def graficar_pvalores_h0(listas, etiquetas, titulo, alpha=0.05): fig, axes = plt.subplots(1, len(listas), figsize=(5.4*len(listas), 3.6), sharey=True)for ax, p, etiqueta inzip(axes, listas, etiquetas): ax.hist(p, bins=20, range=(0, 1), density=True, alpha=0.6) ax.axhline(1, color="0.3", linestyle="--", label="uniforme (prueba bien calibrada)") ax.axvline(alpha, color="C3", linestyle=":", label=fr"$\alpha$ = {alpha:g}") ax.set_title(etiqueta, fontsize=10) ax.set_xlabel("p-value con H0 cierta") ax.legend(fontsize=8) axes[0].set_ylabel("densidad") fig.suptitle(titulo, fontsize=11) plt.tight_layout() plt.show()def graficar_pares(pares, titulo): fig, ax = plt.subplots(figsize=(8.2, 3.8))for i, fila inenumerate(pares.itertuples()): fuera = fila.ic_inf >0or fila.ic_sup <0 ax.hlines(i, fila.ic_inf, fila.ic_sup, color="C3"if fuera else"C0", linewidth=3) ax.plot(fila.diferencia, i, "o", color="C3"if fuera else"C0") ax.axvline(0, color="0.3", linestyle="--") ax.set_yticks(range(len(pares))) ax.set_yticklabels(pares["par"]) ax.invert_yaxis() ax.set_xlabel("diferencia de medias (ms) con intervalo simultáneo de Tukey al 95%") ax.set_title(titulo) plt.tight_layout() plt.show()def graficar_colas(a, b, titulo): fig, axes = plt.subplots(1, 2, figsize=(11, 3.8)) tope = np.quantile(np.concatenate([a, b]), 0.97) bins = np.linspace(0, tope, 28) axes[0].hist(a, bins=bins, alpha=0.55, label="A (actual)") axes[0].hist(b, bins=bins, alpha=0.55, hatch="//", edgecolor="0.3", label="B (cuantizado)") axes[0].set_xlabel("latencia (ms), sin los valores extremos") axes[0].set_ylabel("frecuencia") axes[0].set_title("el cuerpo de la distribución", fontsize=10) axes[0].legend(fontsize=8) axes[1].boxplot([a, b], widths=0.5) axes[1].set_xticks([1, 2]) axes[1].set_xticklabels(["A (actual)", "B (cuantizado)"]) axes[1].set_yscale("log") axes[1].set_ylabel("latencia (ms), escala logarítmica") axes[1].set_title("con los timeouts", fontsize=10) fig.suptitle(titulo, fontsize=11) plt.tight_layout() plt.show()def graficar_permutacion(listas, observados, etiquetas, titulo): fig, axes = plt.subplots(1, len(listas), figsize=(5.6*len(listas), 3.7))for ax, perm, obs, etiqueta inzip(axes, listas, observados, etiquetas): ax.hist(perm, bins=40, alpha=0.6, label="etiquetas barajadas (H0)") ax.axvline(obs, color="C3", label=f"observado = {obs:.1f} ms") ax.axvline(-obs, color="C3", linestyle=":", label="mismo valor, signo opuesto") ax.set_xlabel(etiqueta) ax.legend(fontsize=8) axes[0].set_ylabel("frecuencia") fig.suptitle(titulo, fontsize=11) plt.tight_layout() plt.show()def graficar_pvalores_ordenados(p, titulo, alpha=0.05, reales=None, max_mostrar=None): orden = np.argsort(p) m =len(p) k = m if max_mostrar isNoneelsemin(m, max_mostrar) pos = np.arange(1, k +1) colores ="C0"if reales isNoneelse ["C2"if orden[i] in reales else"0.55"for i inrange(k)] fig, ax = plt.subplots(figsize=(8.4, 4.2))if reales isNone: ax.scatter(pos, p[orden][:k], c=colores, s=28, zorder=3)else: mascara_real = np.array([orden[i] in reales for i inrange(k)]) ax.scatter(pos[mascara_real], p[orden][:k][mascara_real], c="C2", marker="o", s=32, zorder=3) ax.scatter(pos[~mascara_real], p[orden][:k][~mascara_real], c="0.55", marker="x", s=32, zorder=3) ax.axhline(alpha, color="C3", linestyle="--", label=fr"sin corrección: $\alpha$ = {alpha:g}") ax.axhline(alpha / m, color="C1", linestyle=":", label=fr"Bonferroni: $\alpha/m$ = {alpha / m:.4f}") ax.plot(pos, pos / m * alpha, color="C4", linestyle="-.", label=r"Benjamini–Hochberg: $\frac{i}{m}\alpha$")if reales isnotNone: ax.scatter([], [], c="C2", s=28, label="efecto real (por diseño)") ax.scatter([], [], c="0.55", marker="x", s=28, label="sin efecto (por diseño)") ax.set_yscale("log") ax.xaxis.set_major_locator(plt.MaxNLocator(integer=True)) ax.set_xlabel("posición del p-value al ordenarlos de menor a mayor") ax.set_ylabel("p-value (escala logarítmica)") ax.set_title(titulo) ax.legend(fontsize=8) plt.tight_layout() plt.show()
11.5 Desarrollo por etapas
Las 12 etapas siguen el orden en que aparecen las complicaciones: primero el diseño (pareado), después los supuestos, luego más de dos grupos (ANOVA y comparaciones posteriores), después datos que no se dejan resumir con una media (rangos y permutación) y al final muchas pruebas a la vez. Las tres últimas aplican todo a un reporte, a un ANOVA a mano y a la selección de variables de un modelo.
Etapa 1: Los mismos prompts en las dos versiones, la prueba \(t\) pareada
Tomas 30 prompts y envías cada uno a la versión A y a la versión B. La latencia depende sobre todo del prompt, porque uno largo tarda varias veces más que uno corto. La simulación lo reproduce así: cada prompt tiene una latencia base normal con media 200 ms y desviación 45 ms, y cada versión le suma un ruido normal con desviación 6 ms; por diseño, B es 5 ms más rápida en promedio.
Analizas los mismos datos de dos maneras: como si fueran dos grupos independientes (incorrecto para este diseño) y como parejas.
n_prompts =30base = rng.normal(200, 45, size=n_prompts) # lo que tarda cada prompt por su longitudlat_a = base + rng.normal(0, 6, size=n_prompts)lat_b = base -5+ rng.normal(0, 6, size=n_prompts)d = lat_b - lat_aprint("A: x̄ =", round(lat_a.mean(), 2), " s =", round(lat_a.std(ddof=1), 2))print("B: x̄ =", round(lat_b.mean(), 2), " s =", round(lat_b.std(ddof=1), 2))print("Correlación entre A y B =", round(np.corrcoef(lat_a, lat_b)[0, 1], 3))print()# Incorrecto para este diseño: tratar las dos columnas como grupos independientest_ind = stats.ttest_ind(lat_b, lat_a, equal_var=False)se_ind = np.sqrt(lat_a.var(ddof=1) / n_prompts + lat_b.var(ddof=1) / n_prompts)print("Como independientes: B − A =", round(lat_b.mean() - lat_a.mean(), 2), "ms SE =", round(se_ind, 2)," t =", round(t_ind.statistic, 3), " p =", round(t_ind.pvalue, 4))# Correcto: una prueba t de una muestra sobre las diferenciasse_d = d.std(ddof=1) / np.sqrt(n_prompts)t_manual = d.mean() / se_dp_manual =2* stats.t.sf(abs(t_manual), df=n_prompts -1)ic_d = stats.t.interval(0.95, df=n_prompts -1, loc=d.mean(), scale=se_d)t_par = stats.ttest_rel(lat_b, lat_a)print("Como parejas: d̄ =", round(d.mean(), 2), "ms s_d =", round(d.std(ddof=1), 2), " SE =", round(se_d, 2))print(" t a mano =", round(t_manual, 3), " p =", f"{p_manual:.2e}")print("SciPy ttest_rel: t =", round(t_par.statistic, 3), " p =", f"{t_par.pvalue:.2e}")print("IC 95% para la diferencia media: [", round(ic_d[0], 2), ",", round(ic_d[1], 2), "] ms")print("d de Cohen de las diferencias (d̄ / s_d) =", round(d.mean() / d.std(ddof=1), 2))graficar_pareado(lat_a, lat_b, "Treinta prompts medidos en las dos versiones")
A: x̄ = 201.44   s = 34.6
B: x̄ = 195.15   s = 34.42
Correlación entre A y B = 0.98

Como independientes:  B − A = -6.29 ms   SE = 8.91   t = -0.706   p = 0.4829
Como parejas:         d̄ = -6.29 ms   s_d = 6.83   SE = 1.25
                      t a mano = -5.044   p = 2.25e-05
SciPy ttest_rel:      t = -5.044   p = 2.25e-05
IC 95% para la diferencia media: [ -8.84 , -3.74 ] ms
d de Cohen de las diferencias (d̄ / s_d) = -0.92
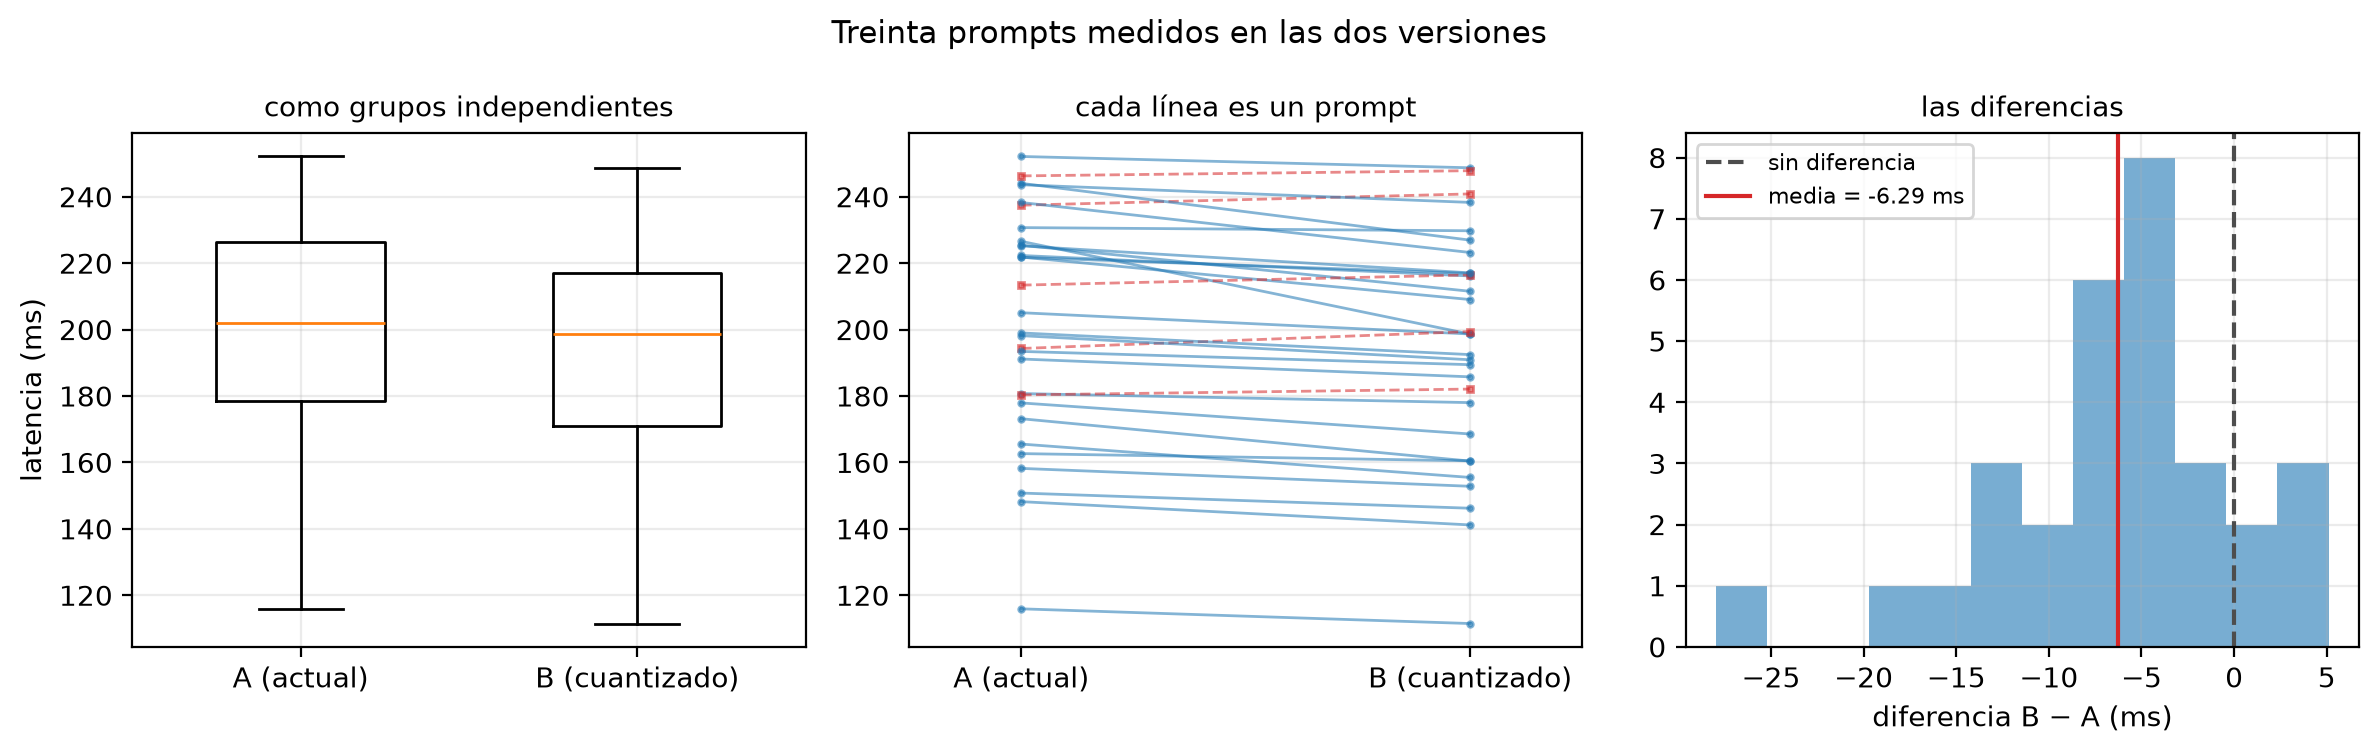
La diferencia de medias es la misma en los dos análisis, \(-6.29\) ms. Cambia el error estándar contra el que se compara:
como grupos independientes, el SE vale \(8.91\) ms, \(t=-0.71\) y \(p=0.48\), y no rechazarías \(H_0\);
como parejas, el SE vale \(1.25\) ms, \(t=-5.04\) y \(p=2.2\times10^{-5}\), y rechazas \(H_0\). El IC 95% de la diferencia media va de \(-8.84\) a \(-3.74\) ms y contiene los \(-5\) ms del diseño.
El error estándar es siete veces menor en el análisis pareado, y la razón está en el panel central de la figura: las latencias van de unos 112 a 252 ms según el prompt, y las dos versiones se mueven juntas (correlación \(0.98\)). Esa variación entre prompts, con desviación estándar cercana a 35 ms, es ruido para la prueba de dos muestras. Al restar dentro de cada prompt queda solo la variación de las diferencias, \(s_d=6.83\) ms, que el histograma de la derecha muestra centrada en \(-6.29\).
La diferencia equivale a \(0.92\) desviaciones estándar de las diferencias (\(d_z\)) y solo a unas \(0.18\) desviaciones de la latencia entre prompts (\(6.29/34.5\)). Es un cambio consistente de un prompt a otro y pequeño frente a lo que varía un prompt respecto de otro.
Usas el análisis pareado porque corresponde al diseño, y la ganancia de potencia es una consecuencia de eso. Si los 60 valores vinieran de 60 prompts distintos, la prueba correcta sería la de dos muestras y la conclusión sería la del primer renglón.
El diseño pareado exige que las parejas sean independientes entre sí y supone que las diferencias son aproximadamente normales. Aquí hay 30 diferencias, y el histograma, con valores entre \(-28\) y \(+5\) ms, no muestra nada alarmante, aunque con 30 datos tampoco podría mostrar mucho.
Etapa 2: Revisar la normalidad antes de confiar en una media
Las latencias reales no son simétricas: no pueden ser negativas y tienen una cola larga hacia la derecha. Generas 60 latencias con esa forma a partir de una log-normal (rng.lognormal con media 4.8 y desviación 0.5 en escala logarítmica) y las revisas de dos maneras, tal como vienen y después de aplicar logaritmo.
Como advertencia aparte, aplicas la misma prueba a 5 000 valores de una distribución muy parecida a la normal: una \(t\) de Student con 10 grados de libertad, con colas algo más pesadas, difíciles de ver en un histograma.
lat_sesgada = rng.lognormal(mean=4.8, sigma=0.5, size=60)lat_log = np.log(lat_sesgada)print("Latencias (ms): media =", round(lat_sesgada.mean(), 1), " mediana =", round(np.median(lat_sesgada), 1)," asimetría =", round(stats.skew(lat_sesgada), 2))sw = stats.shapiro(lat_sesgada)sw_log = stats.shapiro(lat_log)print("Shapiro–Wilk, latencias: W =", round(sw.statistic, 3), " p =", f"{sw.pvalue:.2e}")print("Shapiro–Wilk, log(latencias): W =", round(sw_log.statistic, 3), " p =", round(sw_log.pvalue, 4)," asimetría =", round(stats.skew(lat_log), 2))casi_normal = rng.standard_t(10, size=5000)sw_grande = stats.shapiro(casi_normal)print()print("n = 5 000, t de Student con 10 gl: W =", round(sw_grande.statistic, 4), " p =", f"{sw_grande.pvalue:.2e}")graficar_normalidad([lat_sesgada, lat_log], ["latencias (ms)", "log(latencias)"],"Arriba: histograma. Abajo: gráfico Q–Q frente a la normal")
Latencias (ms):  media = 129.1   mediana = 109.2   asimetría = 2.56
Shapiro–Wilk, latencias:        W = 0.773   p = 3.03e-08
Shapiro–Wilk, log(latencias):   W = 0.981   p = 0.4726   asimetría = 0.51

n = 5 000, t de Student con 10 gl:  W = 0.9935   p = 2.72e-14
Las latencias tienen media \(129.1\) ms y mediana \(109.2\) ms. Esa distancia ya anuncia la asimetría (\(2.56\)), y el gráfico Q–Q de la figura la confirma: los puntos del extremo derecho se despegan de la recta hacia arriba. Shapiro–Wilk rechaza la normalidad de estas latencias con \(p=3\times10^{-8}\).
Después del logaritmo, los puntos siguen la recta, la asimetría baja a \(0.51\) y Shapiro–Wilk no rechaza (\(p=0.47\)). Eso no demuestra que los logaritmos sean normales; dice que 60 datos no muestran evidencia en contra.
Con 5 000 valores de una \(t\) con 10 grados de libertad, una distribución simétrica y casi indistinguible de la normal a simple vista, la prueba rechaza con \(p=2.7\times10^{-14}\), aunque el estadístico \(W=0.9935\) está muy cerca de 1. Con \(n\) grande, una desviación mínima resulta estadísticamente significativa, y para una comparación de medias con miles de datos esa desviación no tiene consecuencias.
Con datos asimétricos tienes cuatro caminos, y eliges antes de mirar los p-values:
Con \(n\) grande, comparar medias de todos modos: el teorema del límite central protege a la media, salvo que haya valores extremos muy alejados.
Transformar (logaritmo) y comparar en la nueva escala. La conclusión pasa a ser sobre el cociente de latencias típicas (medias geométricas), del tipo “la latencia típica de B es un 20% menor” en lugar de “B tarda 25 ms menos”, y deja de ser una afirmación sobre la media aritmética.
Usar una prueba de rangos (etapa 7).
Usar una prueba de permutación (etapa 8).
Etapa 3: ¿Por qué no hacer muchas pruebas \(t\)?
El servicio corre en varias regiones y quieres saber si la latencia media difiere entre ellas. La tentación es comparar todas las parejas con pruebas \(t\). Con \(k\) grupos hay \(m=k(k-1)/2\) parejas: 6 con cuatro regiones, 28 con ocho.
Simulas el peor escenario para ese plan: todas las regiones tienen la misma media (normales con media 120 ms y desviación 15 ms, 30 observaciones por grupo). Cualquier rechazo es una falsa alarma, y cuentas en qué proporción de 2 000 experimentos aparece al menos una.
def alguna_falsa_alarma(k, n=30, n_rep=2000, alpha=0.05): x = rng.normal(120, 15, size=(n_rep, k, n)) # todos los grupos con la misma media rechaza = np.zeros(n_rep, dtype=bool)for i, j in combinations(range(k), 2): rechaza |= stats.ttest_ind(x[:, i], x[:, j], axis=1).pvalue < alphareturn rechaza.mean()filas = []for k in (2, 3, 4, 5, 6, 8): m = k * (k -1) //2 filas.append({"grupos": k, "pruebas t": m, "simulada": alguna_falsa_alarma(k),"si fueran independientes": 1-0.95** m})resumen_fwer = pd.DataFrame(filas)print(resumen_fwer.round(3).to_string(index=False))graficar_fwer(resumen_fwer, "Probabilidad de al menos una falsa alarma al comparar todas las parejas")
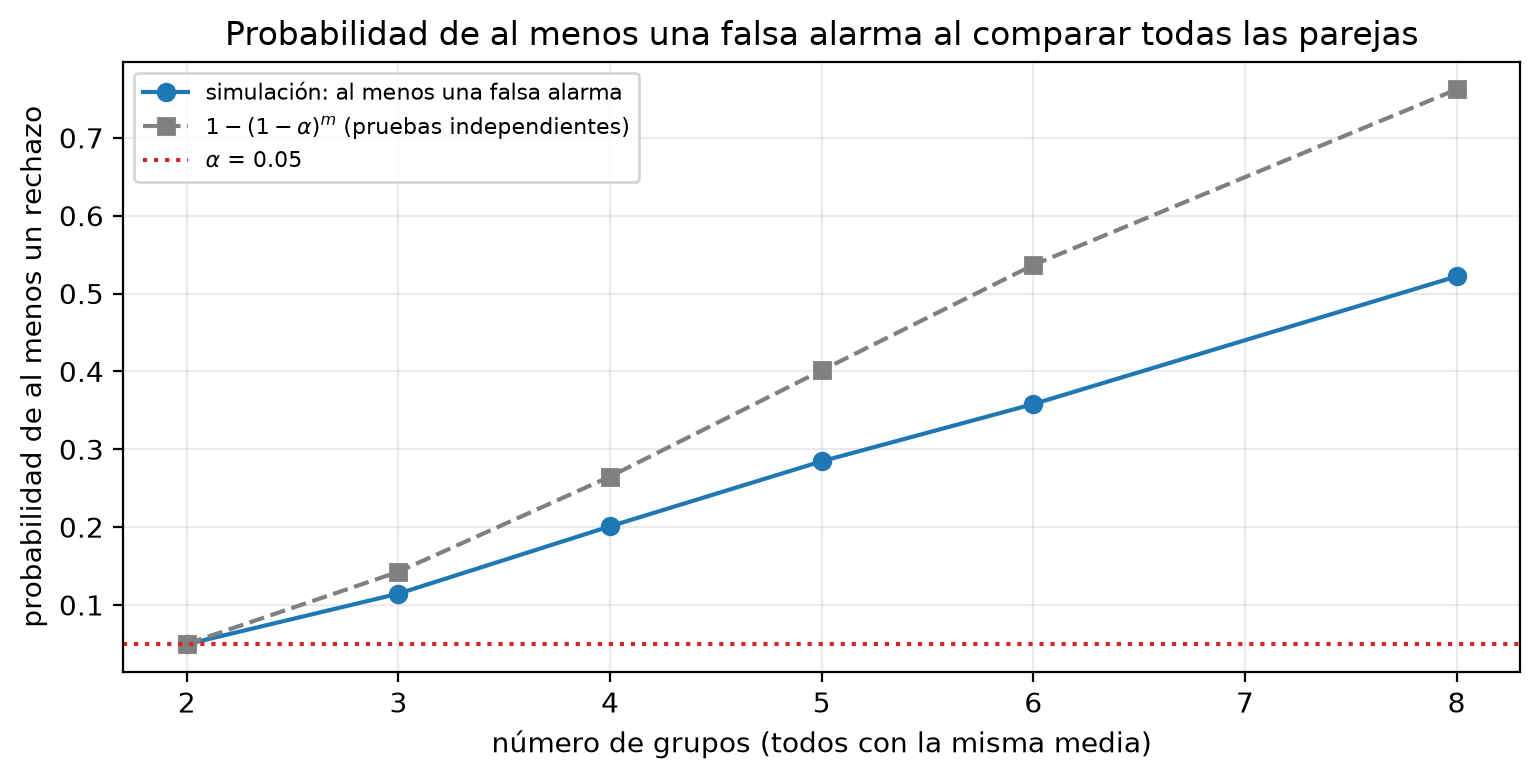
Con dos grupos hay una sola prueba y la tasa de falsas alarmas es la nominal, \(0.050\). Con cuatro grupos (6 pruebas) sube a \(0.201\), y con ocho grupos (28 pruebas) llega a \(0.522\): aunque todas las regiones sean idénticas, en más de la mitad de los estudios aparecería alguna diferencia “significativa”.
En la figura, la curva simulada queda por debajo de la fórmula \(1-(1-\alpha)^m\), que da \(0.265\) y \(0.762\) para esos dos casos. La fórmula supone pruebas independientes, y estas no lo son: la comparación de la región 1 con la 2 y la de la región 1 con la 3 comparten los datos de la región 1. Para estas comparaciones la fórmula funciona como un techo, y la probabilidad real, aunque menor, queda muy por encima del 5%.
Tienes dos respuestas y las usas juntas. La primera es hacer una sola prueba que pregunte si alguna media difiere, el ANOVA. La segunda es corregir las comparaciones de a pares cuando las haces (etapa 6).
Etapa 4: ANOVA de un factor, latencia en cuatro regiones
Mides 30 latencias en cada una de cuatro regiones. La simulación usa normales con desviación 15 ms: por diseño, tres regiones tienen medias casi iguales (120, 122 y 121 ms) y sa-east es más lenta (133 ms). Quien analiza no conoce esos valores; aquí te sirven para juzgar después qué tan bien los recupera cada prueba.
\[
H_0:\mu_1=\mu_2=\mu_3=\mu_4,\qquad H_1:\text{al menos una media es distinta},\qquad \alpha=0.05.
\]
Con \(k=4\) grupos y \(N=120\) observaciones, los grados de libertad son \(k-1=3\) y \(N-k=116\). Primero revisas los supuestos; después calculas la tabla de ANOVA a mano y la verificas con SciPy y con statsmodels. La normalidad la revisas sobre los residuos, cada observación menos la media de su grupo, para que los 120 datos entren en una sola revisión en lugar de cuatro pruebas con 30 datos cada una.
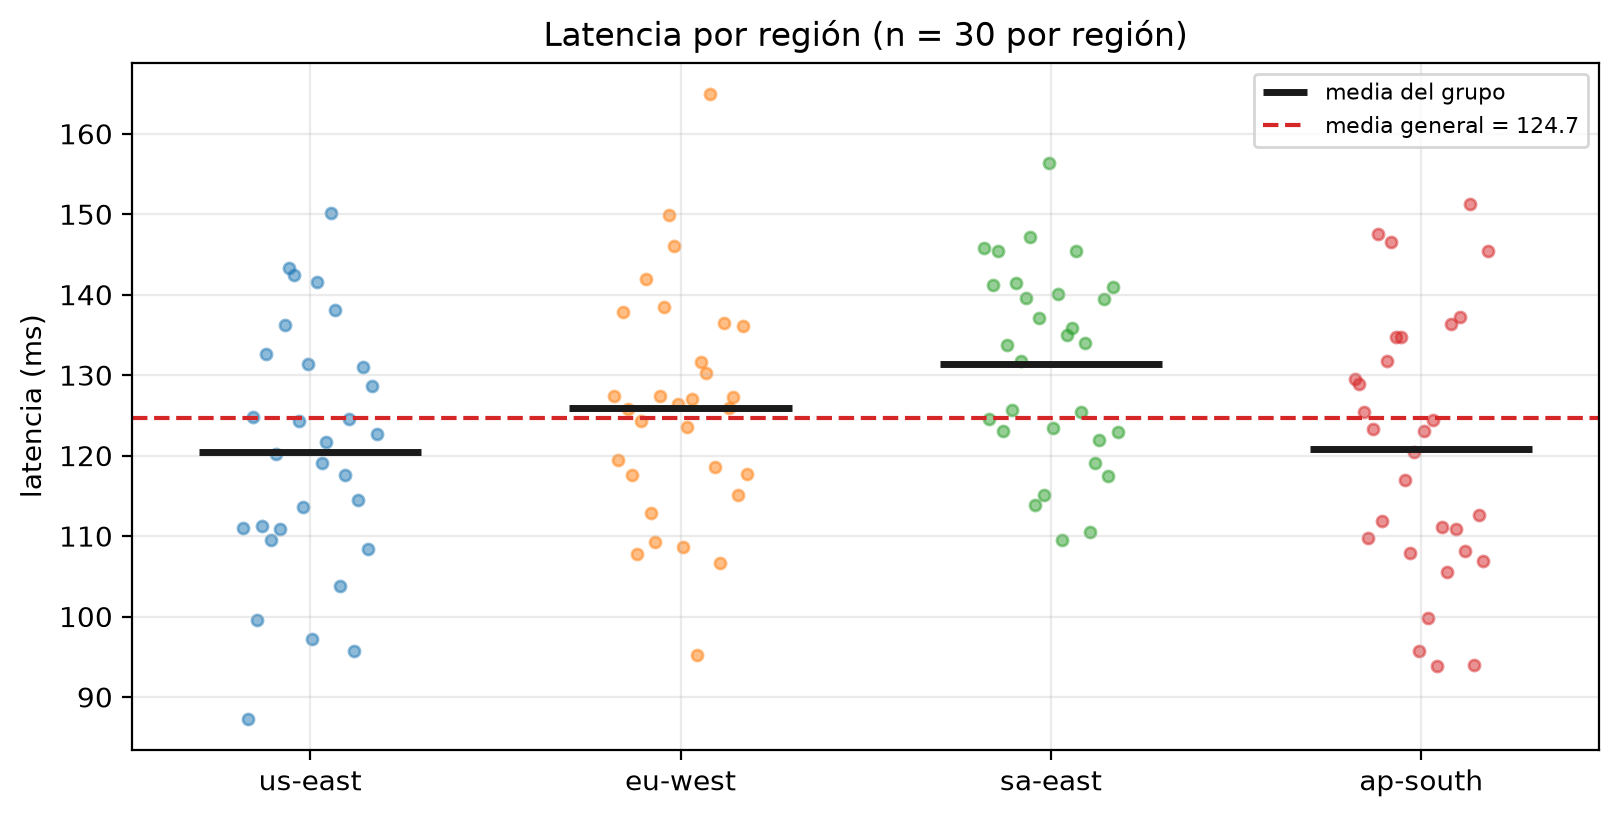
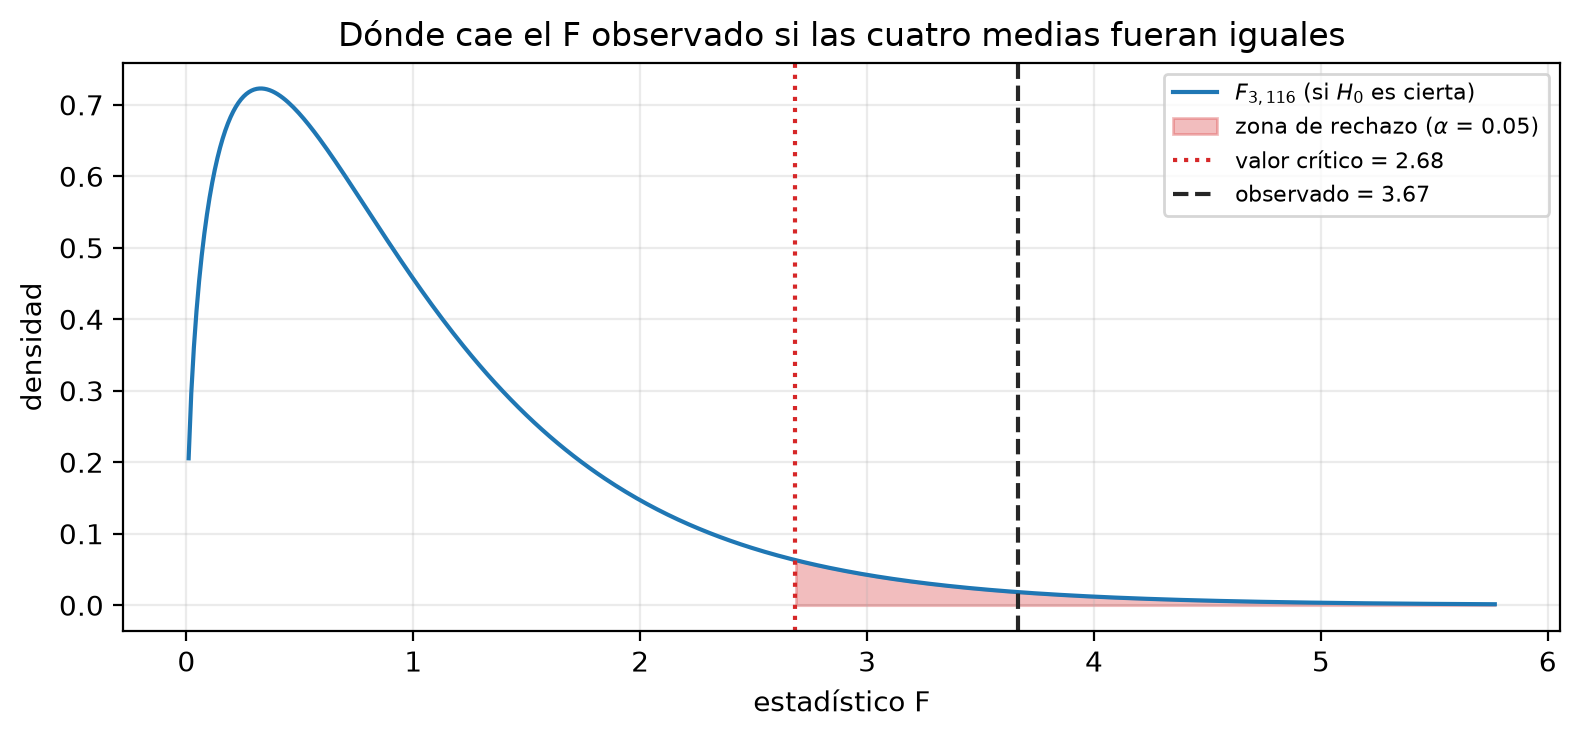
Las dos figuras que siguen a la tabla muestran las latencias por región con sus medias y dónde cae el \(F\) observado en la distribución \(F_{3,116}\).
regiones = ["us-east", "eu-west", "sa-east", "ap-south"]medias_diseno = [120, 122, 133, 121]grupos = [rng.normal(mu, 15, size=30) for mu in medias_diseno]descriptivos = pd.DataFrame({"n": [len(g) for g in grupos],"media": [g.mean() for g in grupos],"desv. est.": [g.std(ddof=1) for g in grupos]}, index=regiones)print(descriptivos.round(2).to_string())# Supuestosresiduos = np.concatenate([g - g.mean() for g in grupos])print()print("Shapiro–Wilk sobre los residuos: p =", round(stats.shapiro(residuos).pvalue, 4))print("Levene (varianzas iguales): p =", round(stats.levene(*grupos).pvalue, 4))# Tabla de ANOVA a manotodos = np.concatenate(grupos)media_general = todos.mean()k, N =len(grupos), len(todos)sc_entre =sum(len(g) * (g.mean() - media_general) **2for g in grupos)sc_dentro =sum(((g - g.mean()) **2).sum() for g in grupos)sc_total = ((todos - media_general) **2).sum()cm_entre, cm_dentro = sc_entre / (k -1), sc_dentro / (N - k)F_obs = cm_entre / cm_dentrop_F = stats.f.sf(F_obs, k -1, N - k)tabla_anova = pd.DataFrame({"SC": [sc_entre, sc_dentro, sc_total],"gl": [k -1, N - k, N -1],"CM": [cm_entre, cm_dentro, np.nan],"F": [F_obs, np.nan, np.nan]}, index=["entre regiones", "dentro de regiones", "total"])print()print(tabla_anova.round(2).to_string(na_rep=""))print()print("Media general =", round(media_general, 2), " SC entre + SC dentro =", round(sc_entre + sc_dentro, 2))print("F a mano =", round(F_obs, 3), " valor crítico F(3, 116) al 5% =", round(stats.f.ppf(0.95, k -1, N - k), 3)," p =", f"{p_F:.2e}")anova = stats.f_oneway(*grupos)print("SciPy f_oneway: F =", round(anova.statistic, 3), " p =", f"{anova.pvalue:.2e}")print("η² = SC entre / SC total =", round(sc_entre / sc_total, 3))print("Raíz del CM dentro =", round(np.sqrt(cm_dentro), 2), "ms (desviación estándar común estimada)")# Verificación inferencial con statsmodels, sobre las mismas 120 latencias.from statsmodels.formula.api import olsfrom statsmodels.stats.anova import anova_lmdatos_anova = pd.DataFrame({"latencia": todos,"region": np.repeat(regiones, [len(grupo) for grupo in grupos])})modelo_anova_sm = ols("latencia ~ C(region)", data=datos_anova).fit()anova_sm = anova_lm(modelo_anova_sm, typ=2)print("statsmodels ANOVA: F =", round(float(anova_sm.loc["C(region)", "F"]), 3)," p =", f'{anova_sm.loc["C(region)", "PR(>F)"]:.2e}')assert np.isclose(anova_sm.loc["C(region)", "F"], F_obs)assert np.isclose(anova_sm.loc["C(region)", "PR(>F)"], p_F)
           n   media  desv. est.
us-east   30  120.44       15.52
eu-west   30  125.93       14.49
sa-east   30  131.43       12.16
ap-south  30  120.85       16.46

Shapiro–Wilk sobre los residuos: p = 0.8437
Levene (varianzas iguales):      p = 0.3435

                          SC   gl      CM     F
entre regiones       2391.14    3  797.05  3.67
dentro de regiones  25216.87  116  217.39
total               27608.00  119

Media general = 124.66   SC entre + SC dentro = 27608.0
F a mano = 3.666   valor crítico F(3, 116) al 5% = 2.683   p = 1.44e-02
SciPy f_oneway: F = 3.666   p = 1.44e-02
η² = SC entre / SC total = 0.087
Raíz del CM dentro = 14.74 ms  (desviación estándar común estimada)
statsmodels ANOVA: F = 3.666  p = 1.44e-02
graficar_grupos(grupos, regiones, "Latencia por región (n = 30 por región)")
graficar_cola_f(F_obs, k -1, N - k, "Dónde cae el F observado si las cuatro medias fueran iguales")
Las medias muestrales son \(120.4\), \(125.9\), \(131.4\) y \(120.9\) ms, y las desviaciones estándar van de \(12.2\) a \(16.5\) ms. En la primera figura, sa-east queda por encima de la media general de 124.7 ms y las nubes de puntos se superponen mucho.
Shapiro–Wilk sobre los residuos da \(p=0.84\) y Levene da \(p=0.34\). Ninguna rechaza, y la figura no muestra asimetría ni un grupo mucho más disperso. Con 30 datos por grupo, eso es ausencia de evidencia en contra, lo máximo que estas pruebas pueden dar.
La variación total (\(27\,608\)) se parte en \(2\,391\) entre regiones y \(25\,217\) dentro de ellas, y la suma coincide. Divididas por sus grados de libertad dan \(CM_{\text{entre}}=797.05\) y \(CM_{\text{dentro}}=217.39\). El cociente es \(F=3.67\): la variación entre las medias de las regiones es 3.7 veces la que esperarías solo por el ruido interno.
El valor crítico de \(F_{3,116}\) al 5% es \(2.68\), y en la segunda figura el \(F\) observado queda dentro de la zona de rechazo, con un p-value de \(0.014\). Rechazas \(H_0\): los datos son poco compatibles con cuatro medias iguales.
El tamaño del efecto es \(\eta^2=0.087\): la región se asocia con el 8.7% de la variación de la latencia en esta muestra. El 91% restante es variación entre requests de una misma región, con una desviación estándar común estimada de \(14.7\) ms. En las unidades del problema, la mayor distancia entre medias es de unos 11 ms sobre una base de 120.
El ANOVA no dice cuál región difiere, ni que todas difieran entre sí. La figura sugiere que sa-east es la más lenta, y falta comprobarlo con una prueba (etapa 6).
La tabla de ANOVA de statsmodels reproduce el \(F=3.666\) y el p-value de \(0.0144\) calculados con las sumas de cuadrados. La comprobación usa las mismas 120 latencias y no representa evidencia independiente.
Etapa 5: ¿Cuándo puedes confiar en el ANOVA?
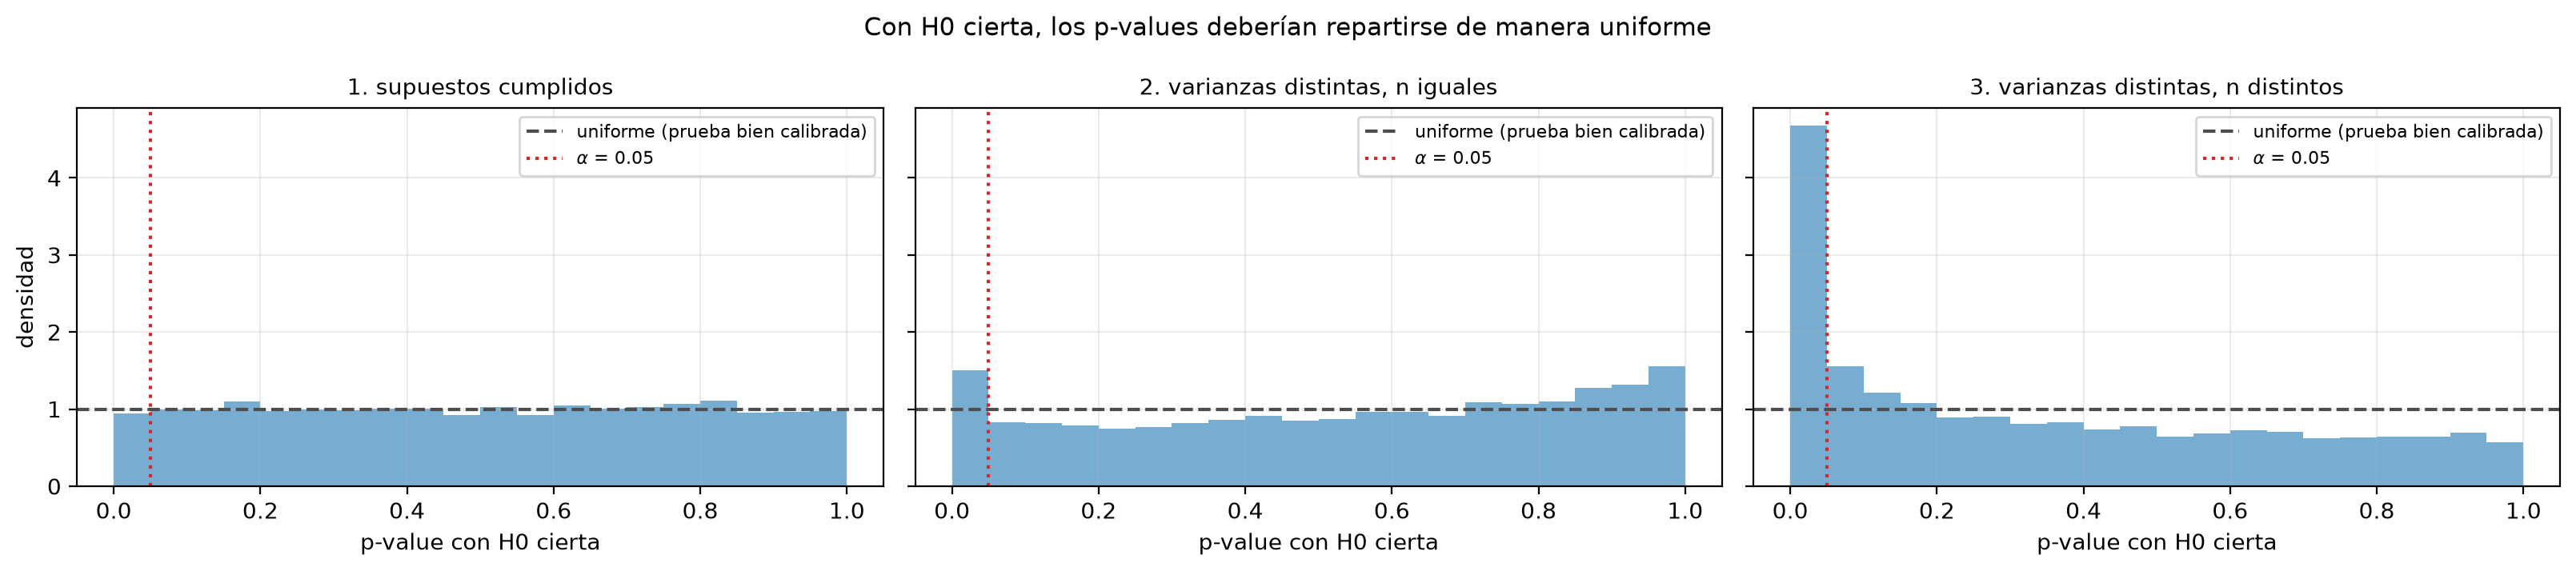
Igual que con la prueba chi-cuadrado del capítulo 10, compruebas un supuesto simulando con \(H_0\) cierta y viendo si la prueba rechaza el 5% de las veces. Si la prueba está bien calibrada, sus p-values se reparten de manera uniforme.
Simulas 10 000 veces tres escenarios, todos con cuatro grupos normales de igual media (120 ms):
Supuestos cumplidos: 30 observaciones por grupo, misma desviación estándar (15 ms).
Varianzas distintas con tamaños iguales: desviaciones de 30, 15, 15 y 8 ms, 30 observaciones por grupo.
Varianzas distintas con tamaños distintos: las mismas desviaciones, con 10, 30, 30 y 50 observaciones, de modo que el grupo más pequeño es el más variable.
Con los supuestos cumplidos, la prueba rechaza en el 4.71% de las simulaciones y el histograma de la izquierda es plano: está bien calibrada.
Con varianzas distintas y tamaños iguales, rechaza en el 7.54%, la mitad por encima de la tasa nominal. En esta configuración el deterioro es moderado, aunque las desviaciones van de 8 a 30 ms, y no lo tomes como garantía general: el efecto depende del número de grupos, de sus tamaños y de cuánto difieran las varianzas.
Con varianzas distintas y tamaños distintos, rechaza en el 23.4%, casi cinco veces la tasa nominal. El histograma de la derecha muestra los p-values acumulados cerca de 0, como si hubiera un efecto que no existe.
La causa está en el denominador de \(F\), que promedia las varianzas de los grupos dándoles más peso a los grupos grandes. En el escenario 3 los grupos grandes son los menos variables, así que el ruido queda subestimado; la media del grupo pequeño y variable se mueve mucho por azar, y la prueba toma ese movimiento por señal. Si el grupo pequeño fuera el menos variable, el sesgo iría en la otra dirección y la prueba perdería potencia.
Los grupos de tamaño parecido reducen mucho el problema. Cuando los tamaños y las dispersiones son muy distintos, el ANOVA clásico deja de ser confiable y conviene la versión de Welch del ANOVA, una prueba de rangos o una de permutación.
Etapa 6: Comparaciones posteriores, ¿cuál región es distinta?
El ANOVA de la etapa 4 rechazó la igualdad de las cuatro medias, y falta saber entre cuáles regiones está la diferencia. Comparas las seis parejas de dos maneras: con la prueba de Tukey HSD y con pruebas \(t\) corregidas por Bonferroni (cada p-value multiplicado por 6). Para que las dos sean comparables, las pruebas \(t\) usan el mismo ruido que el ANOVA: el \(CM_{\text{dentro}}\) de la etapa 4, con sus 116 grados de libertad.
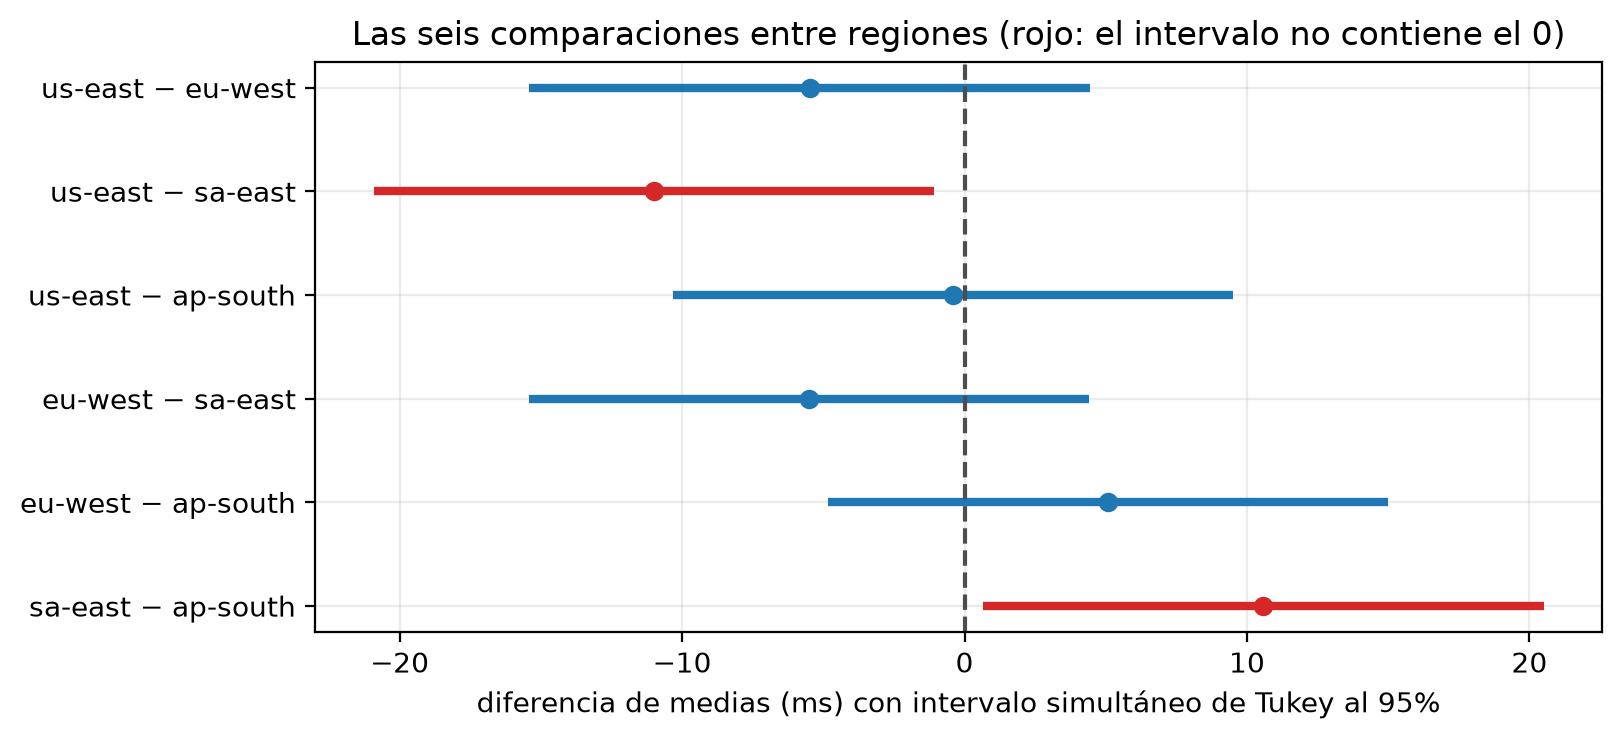
tukey = stats.tukey_hsd(*grupos)ic_tukey = tukey.confidence_interval(confidence_level=0.95)filas = []for i, j in combinations(range(len(grupos)), 2):# t con la varianza común del ANOVA (CM dentro, N − k grados de libertad) diferencia = grupos[i].mean() - grupos[j].mean() se_par = np.sqrt(cm_dentro * (1/len(grupos[i]) +1/len(grupos[j]))) p_t =2* stats.t.sf(abs(diferencia / se_par), df=N - k) filas.append({"par": f"{regiones[i]} − {regiones[j]}","diferencia": diferencia,"ic_inf": ic_tukey.low[i, j],"ic_sup": ic_tukey.high[i, j],"p Tukey": tukey.pvalue[i, j],"p de t sin corregir": p_t,"p Bonferroni": min(1.0, p_t *6), })pares = pd.DataFrame(filas)print(pares.round({"diferencia": 2, "ic_inf": 2, "ic_sup": 2, "p Tukey": 4, "p de t sin corregir": 4, "p Bonferroni": 4}) .to_string(index=False))print()print("Pares con p < 0.05: sin corregir =", int((pares["p de t sin corregir"] <0.05).sum())," Tukey =", int((pares["p Tukey"] <0.05).sum())," Bonferroni =", int((pares["p Bonferroni"] <0.05).sum()))graficar_pares(pares, "Las seis comparaciones entre regiones (rojo: el intervalo no contiene el 0)")
               par  diferencia  ic_inf  ic_sup  p Tukey  p de t sin corregir  p Bonferroni
 us-east − eu-west       -5.48  -15.41    4.44   0.4769               0.1524        0.9146
 us-east − sa-east      -10.99  -20.91   -1.06   0.0237               0.0047        0.0279
us-east − ap-south       -0.41  -10.33    9.51   0.9995               0.9142        1.0000
 eu-west − sa-east       -5.50  -15.43    4.42   0.4738               0.1510        0.9059
eu-west − ap-south        5.07   -4.85   15.00   0.5443               0.1853        1.0000
sa-east − ap-south       10.58    0.65   20.50   0.0319               0.0064        0.0383

Pares con p < 0.05:  sin corregir = 2   Tukey = 2   Bonferroni = 2
Dos de las 6 comparaciones resultan significativas con ambos métodos, y en la figura son las dos con el intervalo en rojo:
us-east frente a sa-east: diferencia de \(-10.99\) ms, intervalo de Tukey de \(-20.91\) a \(-1.06\), \(p=0.024\) (Bonferroni: \(0.028\));
sa-east frente a ap-south: diferencia de \(10.58\) ms, intervalo de \(0.65\) a \(20.50\), \(p=0.032\) (Bonferroni: \(0.038\)).
En las dos interviene sa-east, que resulta más lenta que us-east y que ap-south.
La media muestral de eu-west (\(125.9\) ms) queda a mitad de camino. No se distingue de sa-east (\(p=0.47\)) ni de las otras dos (\(p=0.48\) y \(p=0.54\)). Eso no significa que eu-west sea igual a todas, lo que sería contradictorio porque sa-east y us-east sí difieren entre sí. Significa que con 30 observaciones por región una diferencia observada de 5 ms no se puede separar del azar.
Como los datos son simulados, aquí puedes comprobarlo. Por diseño, sa-east es 11 ms más lenta que eu-west; la muestra dio 5.5 ms y la prueba no lo detectó, un error tipo II. Las comparaciones separaron a sa-east de dos de las otras tres regiones, y con datos reales no tendrías forma de saber que faltó la tercera.
Los p-values sin corregir de esas dos comparaciones eran \(0.005\) y \(0.006\); corregidos son entre cinco y seis veces mayores. La conclusión no cambia, pero los intervalos muestran lo ajustado del resultado, porque los dos rozan el 0. El orden de magnitud de la diferencia (unos 11 ms) informa más que cualquiera de los p-values.
En este ejemplo Tukey y Bonferroni dan resultados parecidos, con p-values algo mayores en Bonferroni (\(0.028\) y \(0.038\) frente a \(0.024\) y \(0.032\)). Tukey está pensada para comparar todos los pares y da además intervalos simultáneos. Bonferroni es general y conviene cuando solo te interesan unas pocas comparaciones definidas de antemano.
Etapa 7: Colas largas y timeouts, pruebas basadas en rangos
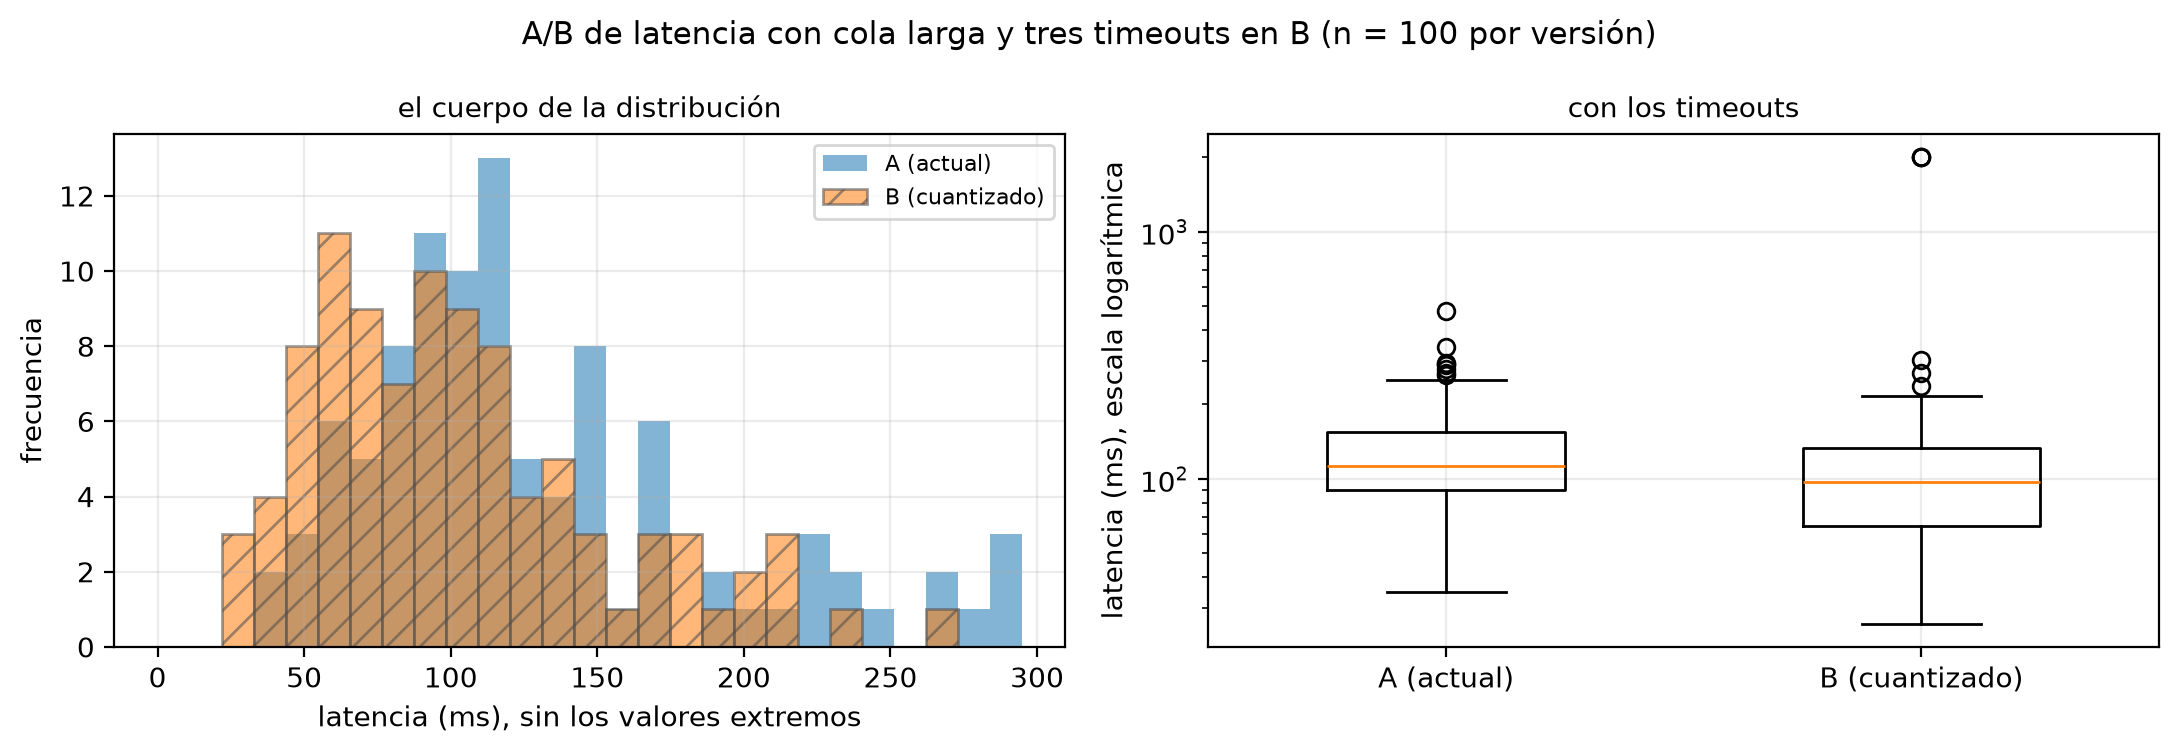
Haces un A/B de latencia con 100 requests por versión. Las latencias salen de dos log-normales con desviación 0.5 en escala logarítmica y medias 4.80 (A) y 4.50 (B), así que por diseño B es más rápida: su latencia típica es alrededor de 26% menor (\(e^{-0.3}=0.74\)). En B, además, 3 requests elegidos al azar terminan en timeout y quedan registrados con 2 000 ms.
Comparas la prueba \(t\) de Welch con la de Mann–Whitney, con y sin los timeouts. Después repites la idea con las cuatro regiones de la etapa 4: reemplazas dos latencias de eu-west por valores extremos y comparas el ANOVA con Kruskal–Wallis.
n_col =100cola_a = rng.lognormal(mean=4.80, sigma=0.5, size=n_col)cola_b = rng.lognormal(mean=4.50, sigma=0.5, size=n_col)cola_b_to = cola_b.copy()cola_b_to[rng.choice(n_col, size=3, replace=False)] =2000.0# tres timeoutsresumen_colas = pd.DataFrame({"media": [cola_a.mean(), cola_b.mean(), cola_b_to.mean()],"mediana": [np.median(cola_a), np.median(cola_b), np.median(cola_b_to)],"desv. est.": [cola_a.std(ddof=1), cola_b.std(ddof=1), cola_b_to.std(ddof=1)]}, index=["A", "B sin timeouts", "B con 3 timeouts"])print(resumen_colas.round(1).to_string())print()for nombre, b_datos in (("sin timeouts", cola_b), ("con 3 timeouts", cola_b_to)): welch = stats.ttest_ind(b_datos, cola_a, equal_var=False) mw = stats.mannwhitneyu(b_datos, cola_a, alternative="two-sided")# mannwhitneyu(b, a) devuelve la U de B: parejas en que B > A. Por eso P(B < A) = 1 − U/(nA·nB) p_b_menor =1- mw.statistic / (n_col * n_col)print(f"B {nombre}: Welch p = {welch.pvalue:.4f} Mann–Whitney U = {mw.statistic:.0f}, p = {mw.pvalue:.4f}"f" P(B < A) estimada = {p_b_menor:.3f}")# Varios grupos: las regiones de la etapa 4, con dos valores extremos en eu-westgrupos_ext = [g.copy() for g in grupos]grupos_ext[1][:2] = [900.0, 1100.0]print()print("Regiones originales: ANOVA p =", round(stats.f_oneway(*grupos).pvalue, 4)," Kruskal–Wallis p =", round(stats.kruskal(*grupos).pvalue, 4))print("Con 2 extremos en eu-west: ANOVA p =", round(stats.f_oneway(*grupos_ext).pvalue, 4)," Kruskal–Wallis p =", round(stats.kruskal(*grupos_ext).pvalue, 4))graficar_colas(cola_a, cola_b_to, "A/B de latencia con cola larga y tres timeouts en B (n = 100 por versión)")
                  media  mediana  desv. est.
A                 133.4    113.3        72.9
B sin timeouts    104.3     95.3        54.0
B con 3 timeouts  161.3     96.8       329.4

B sin timeouts:  Welch p = 0.0016   Mann–Whitney U = 3674, p = 0.0012   P(B < A) estimada = 0.633
B con 3 timeouts:  Welch p = 0.4105   Mann–Whitney U = 3867, p = 0.0057   P(B < A) estimada = 0.613

Regiones originales:        ANOVA p = 0.0144   Kruskal–Wallis p = 0.0228
Con 2 extremos en eu-west:  ANOVA p = 0.0919   Kruskal–Wallis p = 0.0192
Sin timeouts las dos pruebas coinciden: Welch da \(p=0.0016\) y Mann–Whitney \(p=0.0012\). La media de B es 29 ms menor (\(104.3\) frente a \(133.4\)) y la mediana, 18 ms menor.
Con tres timeouts de 2 000 ms en B, las pruebas se separan:
Welch da \(p=0.41\). Tres valores entre cien llevan la media de B de \(104.3\) a \(161.3\) ms, por encima de la de A, y multiplican su desviación estándar por seis (de \(54\) a \(329\) ms), así que la prueba ya no detecta nada.
Mann–Whitney da \(p=0.006\). Los tres timeouts pasan a ocupar los tres rangos más altos, sin importar si valen 2 000 o 20 000 ms, y la probabilidad estimada de que un request de B sea más rápido que uno de A pasa de \(0.633\) a \(0.613\).
En la figura, el panel izquierdo muestra el cuerpo de las dos distribuciones, con B desplazada hacia la izquierda, y el derecho, en escala logarítmica, deja ver los tres timeouts de B arriba de todo, muy lejos del resto.
Con las regiones originales, el ANOVA (\(p=0.014\)) y Kruskal–Wallis (\(p=0.023\)) coinciden en rechazar. Al reemplazar dos latencias de eu-west por 900 y 1 100 ms, el ANOVA deja de rechazar (\(p=0.092\)) y Kruskal–Wallis casi no se mueve (\(p=0.019\)).
Las dos pruebas contestan preguntas distintas y ambas son legítimas:
la de rangos pregunta si los requests de B tienden a ser más rápidos, y la respuesta es sí, en alrededor del 61% de las comparaciones entre un request de B y uno de A;
la de medias pregunta por el promedio, que es lo que determina el costo total de cómputo. Con los timeouts, el promedio de B supera al de A en esta muestra, y la prueba no permite afirmar nada en ninguna dirección.
Un servicio que suele responder más rápido y que falla el 3% de las veces no es claramente mejor. La prueba de rangos vuelve menos influyentes los timeouts sin hacerlos desaparecer, y por eso mismo no debe ser lo único que reportes. La tasa de timeouts es un resultado categórico y se analiza con las pruebas del capítulo 10.
Etapa 8: Una prueba sin fórmula, la permutación
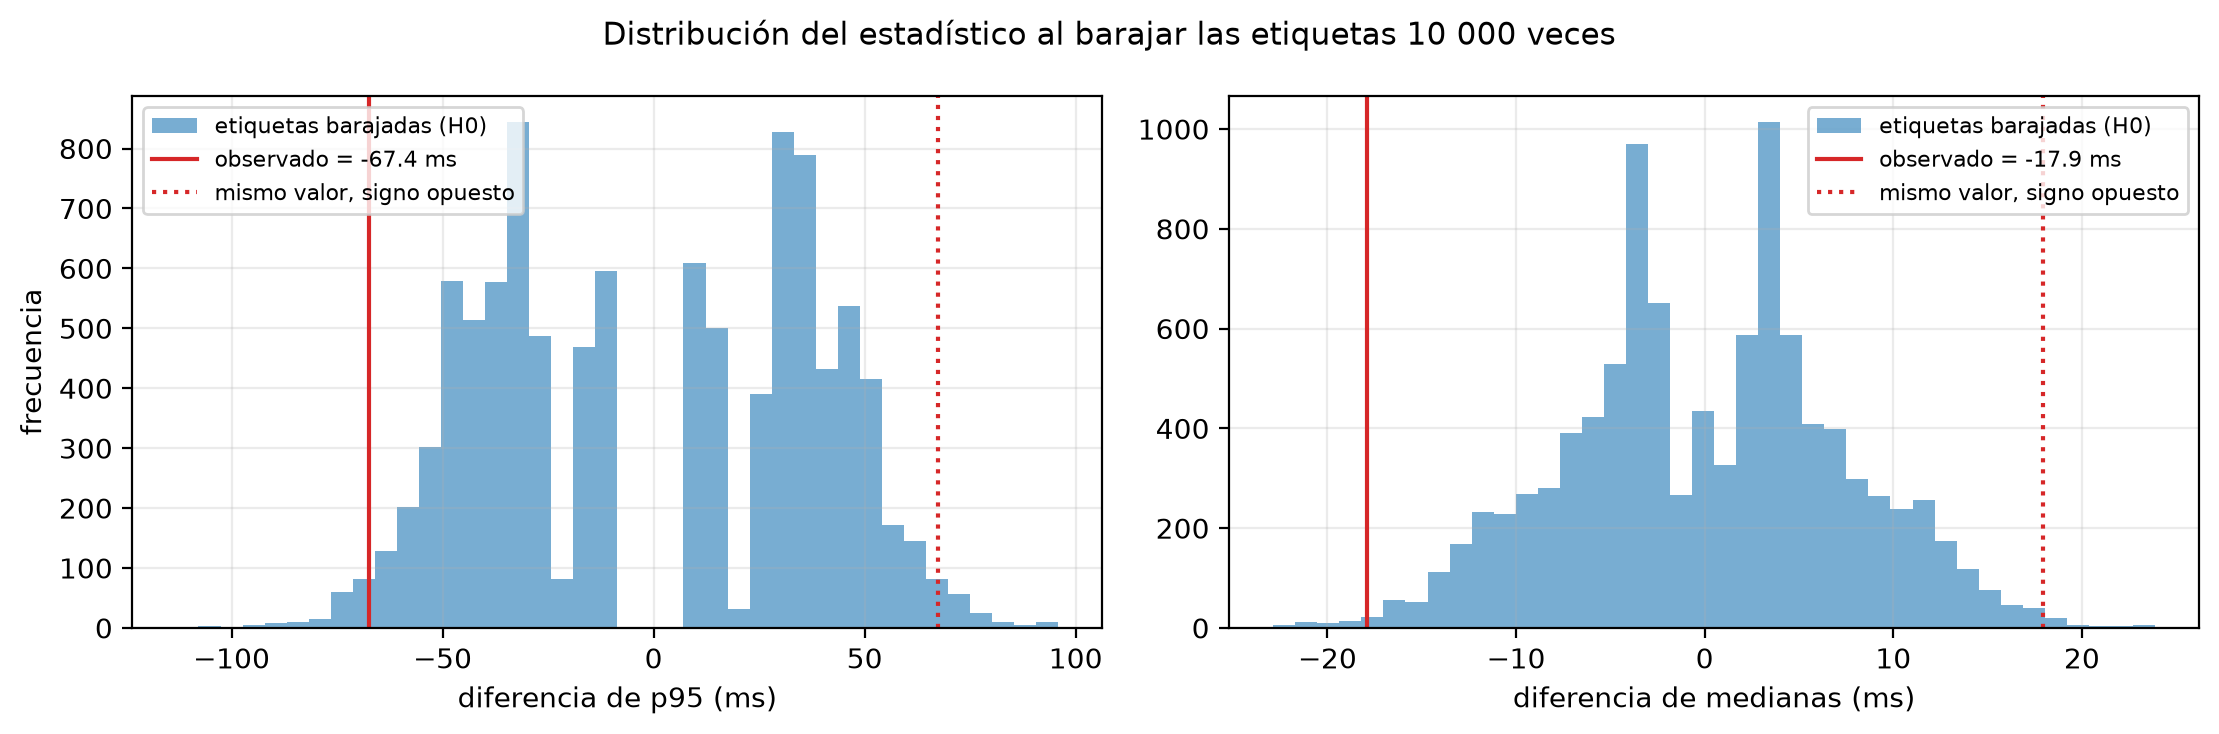
En un servicio, la métrica que suele figurar en los acuerdos de nivel de servicio es el percentil 95 (abreviado p95), la latencia que solo el 5% de los requests supera; el nombre no tiene relación con el p-value. No hay una prueba clásica sencilla para una diferencia de percentiles 95, así que construyes la distribución de referencia con este procedimiento:
Calculas el estadístico observado: p95 de B menos p95 de A.
Juntas las 200 latencias y barajas las etiquetas: 100 al azar se llaman “A” y las otras 100, “B”.
Recalculas el estadístico con las etiquetas barajadas.
Repites 10 000 veces.
El p-value es la proporción de barajadas con un estadístico tan extremo como el observado, en valor absoluto.
Usas los datos de la etapa 7 sin timeouts, y haces lo mismo con la mediana para comparar.
def prueba_permutacion(a, b, estadistico, n_perm=10_000): observado = estadistico(b) - estadistico(a) junto = np.concatenate([a, b]) simulados = np.empty(n_perm)for i inrange(n_perm): barajado = rng.permutation(junto) simulados[i] = estadistico(barajado[len(a):]) - estadistico(barajado[:len(a)])# se suma 1 arriba y abajo: la muestra observada cuenta como una de las permutaciones p = (np.sum(np.abs(simulados) >=abs(observado)) +1) / (n_perm +1)return observado, simulados, pdef p95(x):return np.quantile(x, 0.95)obs_p95, sim_p95, p_p95 = prueba_permutacion(cola_a, cola_b, p95)obs_med, sim_med, p_med = prueba_permutacion(cola_a, cola_b, np.median)print("p95: A =", round(p95(cola_a), 1), " B =", round(p95(cola_b), 1)," B − A =", round(obs_p95, 1), "ms p de permutación =", round(p_p95, 4))print("mediana: A =", round(np.median(cola_a), 1), " B =", round(np.median(cola_b), 1)," B − A =", round(obs_med, 1), "ms p de permutación =", round(p_med, 4))print("Desviación estándar del estadístico al barajar: p95 =", round(sim_p95.std(), 1),"ms mediana =", round(sim_med.std(), 1), "ms")graficar_permutacion([sim_p95, sim_med], [obs_p95, obs_med], ["diferencia de p95 (ms)", "diferencia de medianas (ms)"],"Distribución del estadístico al barajar las etiquetas 10 000 veces")
p95:      A = 279.1   B = 211.7   B − A = -67.4 ms   p de permutación = 0.0323
mediana:  A = 113.3   B = 95.3   B − A = -17.9 ms   p de permutación = 0.0085
Desviación estándar del estadístico al barajar:  p95 = 38.5 ms   mediana = 7.3 ms
El p95 es \(279.1\) ms en A y \(211.7\) ms en B, 67.4 ms menos. Al barajar las etiquetas, una diferencia de ese tamaño o mayor en valor absoluto aparece en el 3.2% de las barajadas, \(p=0.032\). Para la mediana, la diferencia es de \(-17.9\) ms y \(p=0.0085\).
Las dos diferencias son significativas a \(\alpha=0.05\), pero la evidencia es más débil para el p95 aunque su diferencia en milisegundos sea casi cuatro veces mayor. La última línea de la salida lo explica: al barajar, la diferencia de p95 varía con una desviación estándar de \(38.5\) ms y la de medianas con \(7.3\) ms. El p95 de 100 observaciones depende de las 5 o 6 más altas, y por eso es un estadístico ruidoso. El histograma de la izquierda de la figura lo muestra irregular y con huecos, porque el resultado cambia a saltos según en qué grupo caigan esos pocos valores altos.
En la práctica, las métricas de cola necesitan muestras mucho mayores que las de centro para detectar diferencias con la misma seguridad.
La prueba no supone normalidad. Supone que, si \(H_0\) es cierta, las observaciones son intercambiables entre grupos: la \(H_0\) que pones a prueba es que las dos distribuciones son iguales, de modo que un rechazo puede deberse a una diferencia en cualquier aspecto al que el estadístico sea sensible. Además, el p-value tiene una resolución limitada: con 10 000 barajadas, el menor valor posible ronda \(0.0001\).
Etapa 9: Veinte métricas en un tablero, comparaciones múltiples
El tablero de un A/B muestra 20 métricas numéricas: latencia media, uso de memoria, longitud de la respuesta, tokens por segundo y otras. Para simplificar, las simulas como 20 métricas independientes entre sí, normales estándar (en unidades de desviación estándar), y comparas cada una entre A y B con una prueba \(t\), con 200 observaciones por versión.
Respondes tres preguntas, en orden:
Si B fuera idéntica a A en las 20 métricas, ¿cuántas saldrían “significativas”?
¿Con qué frecuencia un tablero así muestra al menos una falsa alarma?
Si 3 de las 20 métricas sí cambian (en 0.45, 0.35 y 0.28 desviaciones), ¿qué detecta cada corrección?
m_metricas, n_obs =20, 200# 1. Un tablero donde ninguna métrica cambiap_nulas = stats.ttest_ind(rng.normal(0, 1, size=(m_metricas, n_obs)), rng.normal(0, 1, size=(m_metricas, n_obs)), axis=1).pvalueprint("1. Tablero sin ningún efecto real: métricas con p < 0.05 =", int((p_nulas <0.05).sum())," p-values más pequeños:", np.sort(p_nulas)[:3].round(4))# 2. Dos mil tableros sin ningún efecto realp_sim = stats.ttest_ind(rng.normal(0, 1, size=(2000, m_metricas, n_obs)), rng.normal(0, 1, size=(2000, m_metricas, n_obs)), axis=2).pvalueprint("2. Tableros con al menos una falsa alarma:")print(" sin corrección =", round((p_sim <0.05).any(axis=1).mean(), 3), " (teoría: 1 − 0.95^20 =", round(1-0.95**20, 3), ")")print(" con Bonferroni =", round((p_sim <0.05/ m_metricas).any(axis=1).mean(), 3))# 3. Un tablero donde las tres primeras métricas sí cambian (en desviaciones estándar)efecto = np.zeros(m_metricas)efecto[:3] = [0.45, 0.35, 0.28]p_mixto = stats.ttest_ind(rng.normal(0, 1, size=(m_metricas, n_obs)), rng.normal(efecto[:, None], 1, size=(m_metricas, n_obs)), axis=1).pvalueorden = np.argsort(p_mixto)p_ord = p_mixto[orden]p_bonf = np.minimum(1, p_ord * m_metricas)p_holm = np.minimum(1, np.maximum.accumulate(p_ord * (m_metricas - np.arange(m_metricas))))p_bh = stats.false_discovery_control(p_mixto, method="bh")[orden]correcciones = pd.DataFrame({"métrica": orden +1,"efecto real": np.where(efecto[orden] >0, "sí", "no"),"p": p_ord, "Bonferroni": p_bonf, "Holm": p_holm, "Benjamini–Hochberg": p_bh})print()print("3. Las seis métricas con menor p-value (p-values ajustados por cada método)")print(correcciones.head(6).round(4).to_string(index=False))print()for nombre, columna in (("sin corrección", "p"), ("Bonferroni", "Bonferroni"), ("Holm", "Holm"), ("Benjamini–Hochberg", "Benjamini–Hochberg")): sel = correcciones[correcciones[columna] <0.05]print(f" {nombre:<20} rechaza {len(sel)}: {int((sel['efecto real'] =='sí').sum())} con efecto real,"f" {int((sel['efecto real'] =='no').sum())} sin efecto")graficar_pvalores_ordenados(p_mixto, "Veinte métricas: p-values ordenados y umbral de cada método", reales={0, 1, 2})
1. Tablero sin ningún efecto real:  métricas con p < 0.05 = 0   p-values más pequeños: [0.0506 0.123  0.2711]
2. Tableros con al menos una falsa alarma:
     sin corrección = 0.646   (teoría: 1 − 0.95^20 = 0.642 )
     con Bonferroni = 0.054

3. Las seis métricas con menor p-value (p-values ajustados por cada método)
 métrica efecto real      p  Bonferroni   Holm  Benjamini–Hochberg
       2          sí 0.0000      0.0000 0.0000              0.0000
       3          sí 0.0007      0.0132 0.0125              0.0066
       1          sí 0.0041      0.0826 0.0744              0.0275
       8          no 0.1832      1.0000 1.0000              0.6830
      11          no 0.2340      1.0000 1.0000              0.6830
      15          no 0.2347      1.0000 1.0000              0.6830

   sin corrección       rechaza 3:  3 con efecto real, 0 sin efecto
   Bonferroni           rechaza 2:  2 con efecto real, 0 sin efecto
   Holm                 rechaza 2:  2 con efecto real, 0 sin efecto
   Benjamini–Hochberg   rechaza 3:  3 con efecto real, 0 sin efecto
En este tablero sin efectos reales ninguna de las 20 métricas pasó el umbral, aunque una quedó en \(p=0.0506\). Un solo tablero dice poco, porque en promedio esperas una falsa alarma por cada 20 pruebas.
Al repetir el tablero 2 000 veces, el 64.6% muestra al menos una métrica con \(p<0.05\), muy cerca del \(64.2\%\) teórico: dos de cada tres experimentos en los que no pasó nada tendrían algo que reportar. Con Bonferroni (umbral \(0.05/20=0.0025\)) la proporción baja a 5.4%, compatible con el 5% buscado, ya que con 2 000 tableros la simulación tiene un margen cercano a un punto. En un tablero real las métricas están correlacionadas y la proporción sin corregir sería algo menor, como en la etapa 3.
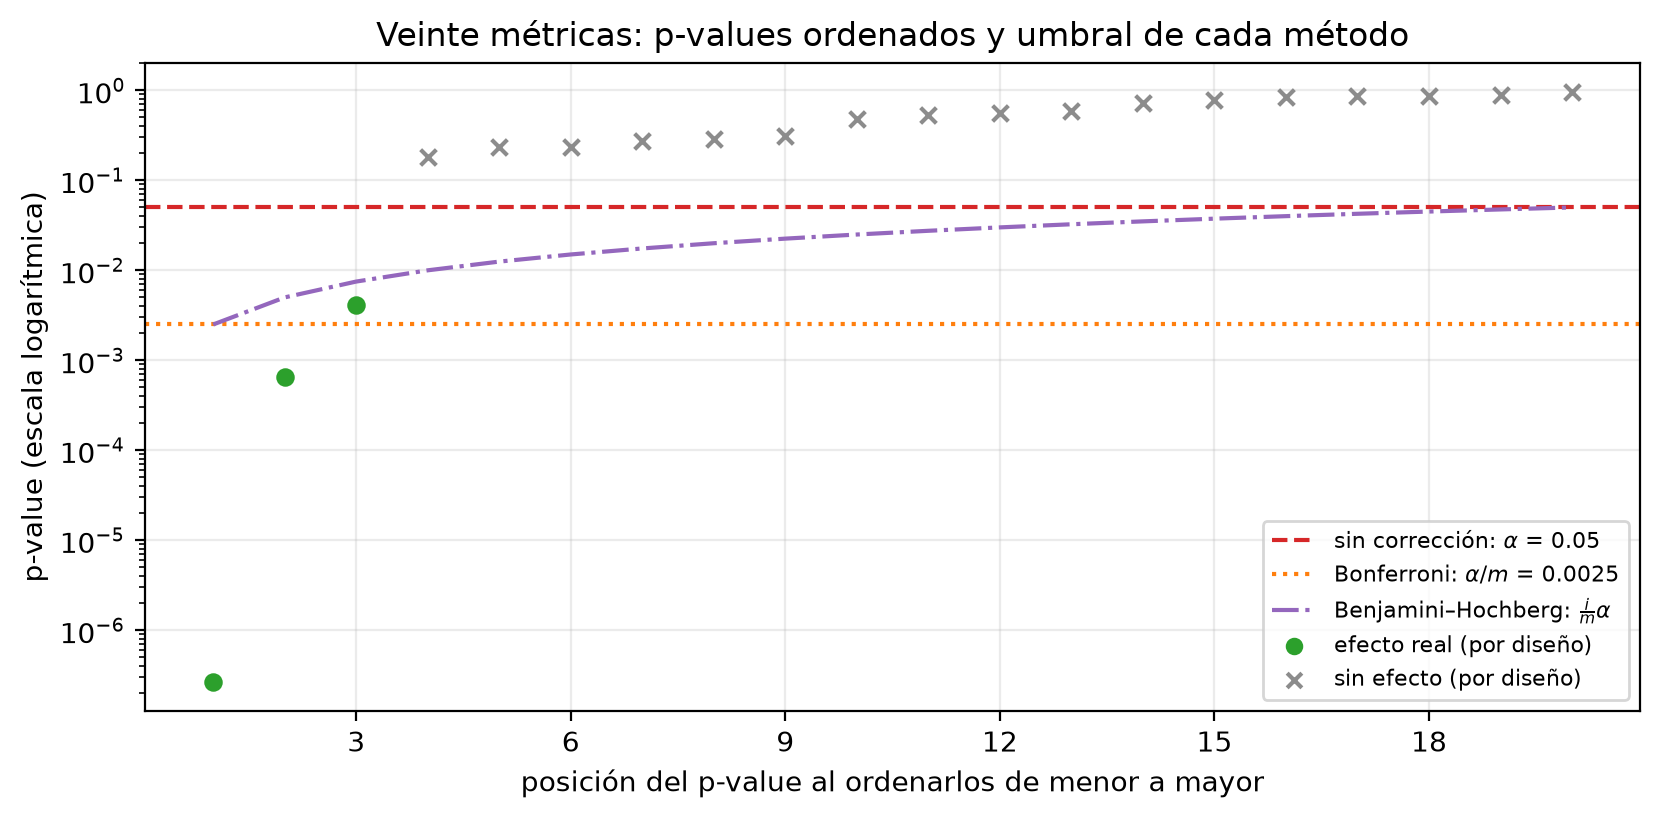
Con tres efectos reales, cada criterio rechaza algo distinto:
sin corrección detectas las tres métricas; en este tablero no hubo falsas alarmas, pero la pregunta 2 dice con qué frecuencia las habría;
Bonferroni y Holm detectan dos. La métrica 1 tiene \(p=0.0041\), mayor que el umbral de Bonferroni (\(0.0025\)) y que el de Holm para el tercer lugar (\(0.05/18=0.0028\)); ajustado, da \(p=0.083\) con Bonferroni y \(0.074\) con Holm. Es un efecto real que la corrección no detecta;
Benjamini–Hochberg detecta las tres, porque compara el tercer p-value con \(\frac{3}{20}\times0.05=0.0075\), un umbral menos exigente que el de Bonferroni.
Holm nunca rechaza menos que Bonferroni y a veces rechaza más; aquí coinciden. La diferencia de fondo está entre controlar la FWER y controlar la FDR, y la figura la muestra: la línea de Bonferroni es horizontal y la de Benjamini–Hochberg sube con la posición.
La métrica 1 tenía el efecto real más grande (\(0.45\) desviaciones) y quedó en tercer lugar. En una muestra, el orden de los p-values puede diferir del orden de los efectos reales.
Si una falsa alarma es costosa (desplegar un modelo, publicar un resultado), controla la FWER con Holm. Si estás explorando y vas a confirmar los hallazgos después, controla la FDR. En ambos casos lo que más ayuda ocurre antes del experimento: declarar una métrica principal y tratar las demás como secundarias.
Etapa 10: Reportar una comparación de varios grupos
El reporte sigue ocho pasos, los del capítulo 9 con dos propios de los grupos (supuestos y comparaciones posteriores):
Población y variable: qué mides, en qué unidades, en qué grupos.
Diseño:\(n\) por grupo, independientes o pareados, \(\alpha\) y cuántas comparaciones.
Descripción: media y desviación estándar por grupo.
Supuestos: qué revisaste y con qué resultado.
Prueba global:\(H_0\), estadístico con sus grados de libertad y p-value.
Comparaciones posteriores: método de corrección, pares que difieren e intervalos.
Tamaño del efecto: en unidades del problema y como proporción de la variación.
Relevancia y límites: qué significa para la decisión y qué amenaza la lectura.
Los aplicas a las cuatro regiones de las etapas 4 y 6.
Población y variable. Latencia (ms) de requests de un servicio de inferencia en cuatro regiones.
Diseño. 30 requests por región, muestras independientes, \(\alpha=0.05\); una prueba global y seis comparaciones posteriores.
Descripción. Medias: us-east 120.4, eu-west 125.9, sa-east 131.4 y ap-south 120.9 ms. Desviaciones estándar entre 12.2 y 16.5 ms.
Supuestos. Residuos sin desviación apreciable de la normal (Shapiro–Wilk \(p=0.84\)), varianzas parecidas (Levene \(p=0.34\)) y tamaños iguales.
Prueba global. ANOVA de un factor: \(F(3,116)=3.67\), \(p=0.014\). Se rechaza la igualdad de medias.
Comparaciones posteriores. Tukey HSD: sa-east es más lenta que us-east (11.0 ms; IC 95%: 1.1 a 20.9) y que ap-south (10.6 ms; IC 95%: 0.7 a 20.5). Las demás comparaciones no son concluyentes.
Tamaño del efecto.\(\eta^2=0.087\). La mayor diferencia entre medias es de unos 11 ms sobre una base de 120 ms.
Relevancia y límites. Una diferencia cercana al 9% de la latencia puede justificar revisar la capacidad de sa-east. Limitaciones: datos simulados, intervalos anchos que rozan el 0 y ninguna información sobre la causa.
Se comparó la latencia entre cuatro regiones con 30 requests por región. Hay evidencia de que las medias difieren (ANOVA: \(F(3,116)=3.67\), \(p=0.014\), \(\eta^2=0.09\)), sin evidencia en contra de los supuestos de normalidad y de varianzas iguales. Con la prueba de Tukey, sa-east resulta más lenta que us-east y que ap-south, por unos 11 ms (intervalos al 95% entre 1 y 21 ms). La posición de eu-west no se puede establecer con estos datos. La diferencia es moderada y su estimación es imprecisa; antes de actuar conviene una muestra mayor.
Etapa 11: Un ANOVA completo a mano
Con un ejemplo pequeño y números redondos puedes hacer todo a mano y dejar el código como verificación. Quieres saber si el tamaño de lote (batch size) con que se agrupan los requests cambia la latencia media. Pruebas tres tamaños y tomas 4 mediciones independientes con cada uno, en ms; la tabla está escrita a mano:
lote
mediciones
suma
media
8
10, 12, 11, 11
44
11
16
13, 15, 14, 14
56
14
32
12, 11, 13, 12
48
12
Hipótesis.\(H_0:\mu_8=\mu_{16}=\mu_{32}\). \(H_1\): al menos una media es distinta. \(\alpha=0.05\).
Media general.\(\bar x=(44+56+48)/12=148/12=12.33\).
Variación entre grupos. Cada media de grupo frente a la media general, ponderada por el tamaño del grupo:
Decisión. El valor crítico de \(F_{2,9}\) al 5% es \(4.26\). Como \(14.0>4.26\), rechazas \(H_0\) al nivel de 0.05 que fijaste antes del cálculo.
Tamaño del efecto.\(SC_{\text{total}}=18.67+6=24.67\) y \(\eta^2=18.67/24.67=0.757\).
La celda siguiente verifica cada número y agrega lo que a mano sería tedioso: el p-value exacto y las comparaciones posteriores.
lotes = ["lote 8", "lote 16", "lote 32"]ej = [np.array([10, 12, 11, 11.0]), np.array([13, 15, 14, 14.0]), np.array([12, 11, 13, 12.0])]todos_ej = np.concatenate(ej)mg = todos_ej.mean()sc_e =sum(len(g) * (g.mean() - mg) **2for g in ej)sc_d =sum(((g - g.mean()) **2).sum() for g in ej)F_ej = (sc_e /2) / (sc_d /9)print("Media general =", round(mg, 3))print("SC entre =", round(sc_e, 3), " SC dentro =", round(sc_d, 3), " SC total =", round(sc_e + sc_d, 3))print("CM entre =", round(sc_e /2, 3), " CM dentro =", round(sc_d /9, 3))print("F a mano =", round(F_ej, 3), " valor crítico F(2, 9) al 5% =", round(stats.f.ppf(0.95, 2, 9), 3))print("p-value =", round(stats.f.sf(F_ej, 2, 9), 4))print("SciPy f_oneway:", "F =", round(stats.f_oneway(*ej).statistic, 3), " p =", round(stats.f_oneway(*ej).pvalue, 4))print("η² =", round(sc_e / (sc_e + sc_d), 3))tk_ej = stats.tukey_hsd(*ej)ic_ej = tk_ej.confidence_interval(0.95)print()print("Comparaciones posteriores (Tukey HSD)")for i, j in combinations(range(3), 2):print(f" {lotes[i]} − {lotes[j]}: diferencia = {ej[i].mean() - ej[j].mean():+.1f} ms"f" IC 95% [{ic_ej.low[i, j]:+.2f}, {ic_ej.high[i, j]:+.2f}] p = {tk_ej.pvalue[i, j]:.4f}")print()print("Kruskal–Wallis sobre los mismos datos: p =", round(stats.kruskal(*ej).pvalue, 4))
Media general = 12.333
SC entre = 18.667   SC dentro = 6.0   SC total = 24.667
CM entre = 9.333   CM dentro = 0.667
F a mano = 14.0   valor crítico F(2, 9) al 5% = 4.256
p-value = 0.0017
SciPy f_oneway: F = 14.0   p = 0.0017
η² = 0.757

Comparaciones posteriores (Tukey HSD)
  lote 8 − lote 16:  diferencia = -3.0 ms   IC 95% [-4.61, -1.39]   p = 0.0015
  lote 8 − lote 32:  diferencia = -1.0 ms   IC 95% [-2.61, +0.61]   p = 0.2461
  lote 16 − lote 32:  diferencia = +2.0 ms   IC 95% [+0.39, +3.61]   p = 0.0176

Kruskal–Wallis sobre los mismos datos: p = 0.0159
El código reproduce el cálculo a mano: \(SC_{\text{entre}}=18.67\), \(SC_{\text{dentro}}=6\) y \(F=14.0\). El p-value es \(0.0017\): si los tres tamaños de lote tuvieran la misma latencia media, un \(F\) de 14 o mayor aparecería en menos de 2 de cada 1 000 experimentos.
Las comparaciones posteriores ubican la diferencia en el lote de 16:
lote 8 frente a lote 16: \(-3.0\) ms (IC 95%: \(-4.61\) a \(-1.39\)), \(p=0.0015\);
lote 16 frente a lote 32: \(+2.0\) ms (IC 95%: \(0.39\) a \(3.61\)), \(p=0.018\);
lote 8 frente a lote 32: \(-1.0\) ms (IC 95%: \(-2.61\) a \(0.61\)), \(p=0.25\), no concluyente.
El \(\eta^2=0.757\) dice que el tamaño de lote se asocia con tres cuartas partes de la variación de estas 12 mediciones. Es un valor muy alto y debes leerlo con cuidado: con tan pocos datos, \(\eta^2\) tiende a sobrestimar el efecto, y las mediciones varían muy poco dentro de cada lote.
Con 4 mediciones por grupo no puedes revisar los supuestos, porque ni un gráfico Q–Q ni una prueba de Shapiro–Wilk dicen algo con 4 puntos. La prueba de Kruskal–Wallis, que no supone normalidad, llega a la misma decisión (\(p=0.016\)). Ese p-value es solo orientativo, porque SciPy lo calcula con una aproximación para muestras grandes y aquí hay 4 datos por grupo con empates. Los números redondos sirven para seguir el cálculo; un estudio real necesitaría más mediciones por lote.
Se midió la latencia con tres tamaños de lote, 4 mediciones por tamaño. Las medias fueron 11, 14 y 12 ms para lotes de 8, 16 y 32. ANOVA de un factor: \(F(2,9)=14.0\), \(p=0.002\). Con la prueba de Tukey, el lote de 16 es más lento que el de 8 (3.0 ms; IC 95%: 1.4 a 4.6) y que el de 32 (2.0 ms; IC 95%: 0.4 a 3.6). Con 4 mediciones por grupo los supuestos no se pueden verificar; una prueba de Kruskal–Wallis apunta en la misma dirección.
Ejercicio
Cambia la última medición del lote 16 de 14 a 18 ms y recalcula a mano \(SC_{\text{entre}}\), \(SC_{\text{dentro}}\), \(F\) y \(\eta^2\). ¿Sigues rechazando \(H_0\)? ¿Por qué un valor más alejado de los demás aumenta la diferencia entre medias y, aun así, baja el \(F\)?
TipOrientaciones
La suma del lote 16 pasa a 60 y su media a 15, y la media general a \(152/12=12.67\). Entonces \(SC_{\text{entre}}=4\,[(11-12.67)^2+(15-12.67)^2+(12-12.67)^2]=4\times 8.667=34.67\). Dentro del lote 16 las desviaciones son \(-2,\ 0,\ -1,\ +3\), con suma de cuadrados 14, así que \(SC_{\text{dentro}}=2+14+2=18\). Los cuadrados medios son \(34.67/2=17.33\) y \(18/9=2.0\), y \(F=8.67\), todavía mayor que el valor crítico de 4.26 (\(p=0.008\) con stats.f_oneway). El \(\eta^2\) baja a \(34.67/52.67=0.66\). El valor de 18 sube la media del lote, y por eso crece la señal, pero también agrega ruido dentro del grupo: \(SC_{\text{dentro}}\) se triplica (de 6 a 18) mientras \(SC_{\text{entre}}\) menos que se duplica.
Etapa 12: Elegir variables antes de modelar, un ANOVA por variable
Un conjunto de datos puede traer cientos de variables, de las que solo unas pocas se relacionan con lo que quieres predecir. Una estrategia habitual, la selección por filtro, calcula para cada variable un puntaje de su relación con la etiqueta y conserva las mejores.
Cuando la etiqueta es una clase y la variable es numérica, el puntaje estándar es el estadístico \(F\) del ANOVA de un factor: los grupos son las clases y la pregunta es si la media de la variable cambia entre clases. Es exactamente lo que calcula f_classif en scikit-learn, la función que usa SelectKBest por defecto. Juntas así dos temas de este capítulo: un ANOVA por variable y, como hay muchas variables, comparaciones múltiples.
Generas 300 ejemplos de tres clases (asignadas al azar con rng.integers) con 60 variables normales estándar. Por diseño, solo las cinco primeras (x1 a x5) tienen medias desplazadas según la clase: un efecto grande en x1 (0.9 desviaciones en una clase) y cuatro moderados y parecidos entre sí en x2 a x5 (entre 0.25 y 0.5). Las otras 55 no tienen relación con la clase y sirven para medir cuántas selecciona el filtro por azar.
n_ej, n_var =300, 60y = rng.integers(0, 3, size=n_ej) # tres clasesX = rng.normal(size=(n_ej, n_var))# desplazamiento de la media de cada variable informativa en cada clasedesplazamientos = np.array([[0.0, 0.9, 0.0], [0.0, 0.5, 0.5], [0.45, 0.0, 0.0], [0.0, 0.0, 0.40], [0.3, 0.0, -0.25]])for j inrange(5): X[:, j] += desplazamientos[j][y]# Un ANOVA de un factor por variable: los grupos son las clasesresultados = [stats.f_oneway(*[X[y == clase, j] for clase inrange(3)]) for j inrange(n_var)]F_var = np.array([r.statistic for r in resultados])p_var = np.array([r.pvalue for r in resultados])p_bh_var = stats.false_discovery_control(p_var, method="bh")ranking = pd.DataFrame({"variable": [f"x{j +1}"for j inrange(n_var)],"informativa": ["sí"if j <5else"no"for j inrange(n_var)],"F": F_var, "p": p_var,"p Bonferroni": np.minimum(1, p_var * n_var),"p Benjamini–Hochberg": p_bh_var}).sort_values("p")print("Tamaño de cada clase:", np.bincount(y).tolist())print()print("Las diez variables con mayor F")print(ranking.head(10).to_string(index=False, formatters={"F": "{:.2f}".format, "p": "{:.2e}".format, "p Bonferroni": "{:.4f}".format, "p Benjamini–Hochberg": "{:.4f}".format}))print()print("Las cinco variables informativas")print(ranking[ranking["informativa"] =="sí"].sort_values("variable").to_string(index=False, formatters={"F": "{:.2f}".format, "p": "{:.2e}".format, "p Bonferroni": "{:.4f}".format, "p Benjamini–Hochberg": "{:.4f}".format}))print()for nombre, columna in (("p < 0.05 sin corrección", "p"), ("Bonferroni", "p Bonferroni"), ("Benjamini–Hochberg", "p Benjamini–Hochberg")): sel = ranking[ranking[columna] <0.05]print(f"{nombre:<26} selecciona {len(sel):>2}: {int((sel['informativa'] =='sí').sum())} informativas,"f" {int((sel['informativa'] =='no').sum())} de ruido")graficar_pvalores_ordenados(p_var, "Sesenta variables: p-value del ANOVA de cada una (se muestran las 25 menores)", reales=set(range(5)), max_mostrar=25)
Tamaño de cada clase: [105, 100, 95]

Las diez variables con mayor F
variable informativa     F        p p Bonferroni p Benjamini–Hochberg
      x1          sí 43.38 2.97e-17       0.0000               0.0000
      x5          sí 13.15 3.36e-06       0.0002               0.0001
      x2          sí 10.25 4.95e-05       0.0030               0.0010
     x33          no  6.01 2.76e-03       0.1654               0.0413
     x44          no  4.77 9.18e-03       0.5510               0.1102
      x3          sí  3.70 2.59e-02       1.0000               0.2593
     x36          no  3.19 4.25e-02       1.0000               0.3643
     x39          no  2.71 6.85e-02       1.0000               0.4151
     x18          no  2.70 6.91e-02       1.0000               0.4151
      x8          no  2.69 6.96e-02       1.0000               0.4151

Las cinco variables informativas
variable informativa     F        p p Bonferroni p Benjamini–Hochberg
      x1          sí 43.38 2.97e-17       0.0000               0.0000
      x2          sí 10.25 4.95e-05       0.0030               0.0010
      x3          sí  3.70 2.59e-02       1.0000               0.2593
      x4          sí  2.06 1.29e-01       1.0000               0.5164
      x5          sí 13.15 3.36e-06       0.0002               0.0001

p < 0.05 sin corrección    selecciona  7:  4 informativas, 3 de ruido
Bonferroni                 selecciona  3:  3 informativas, 0 de ruido
Benjamini–Hochberg         selecciona  4:  3 informativas, 1 de ruido
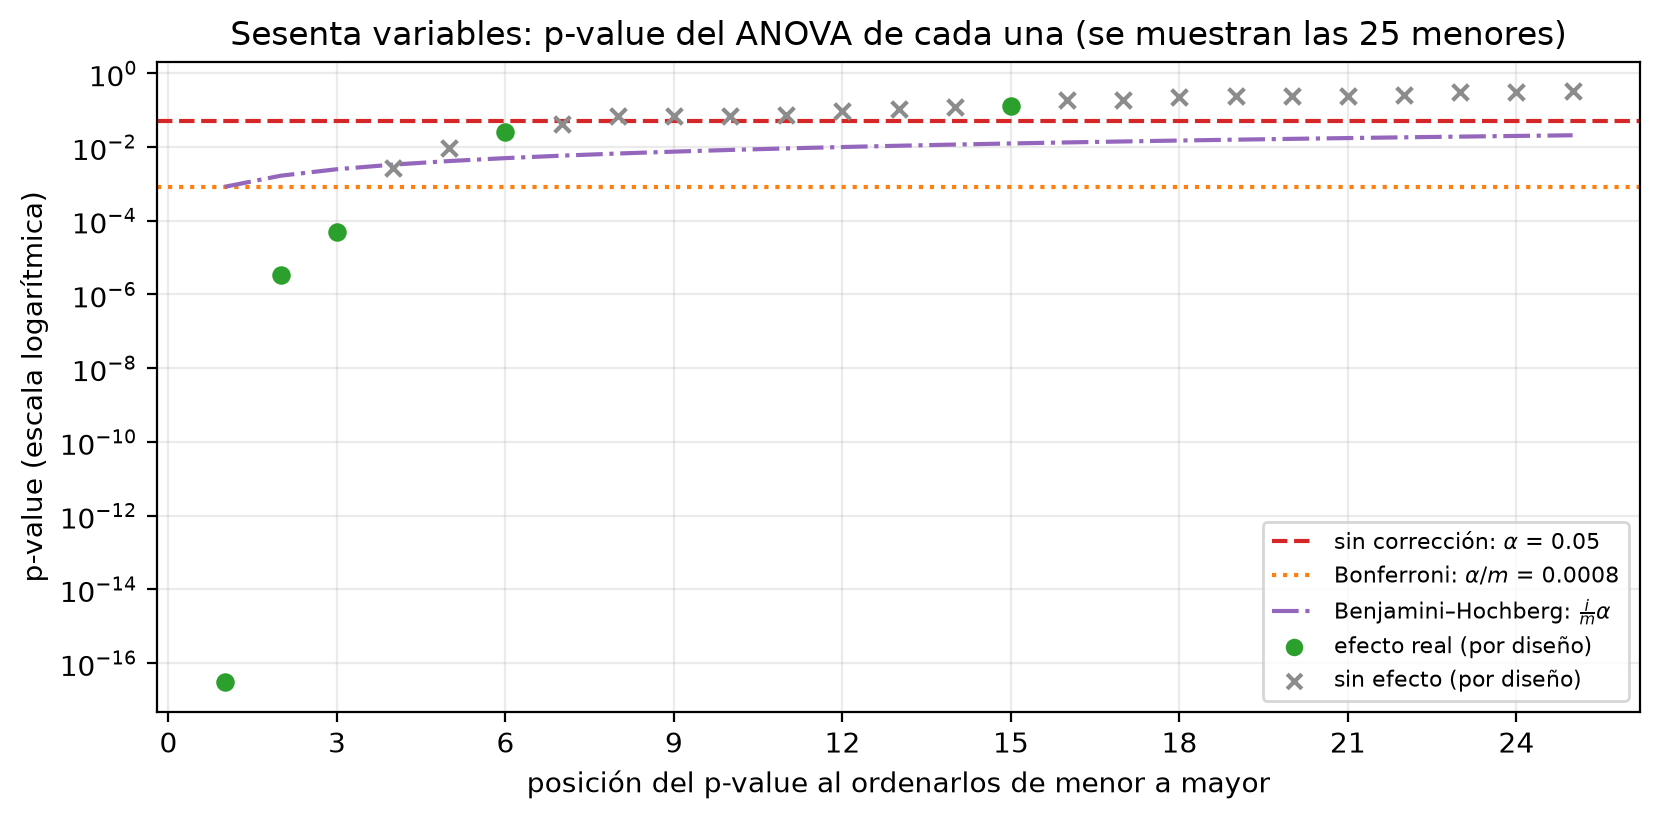
El ANOVA ordena bien lo más fuerte: x1 (\(F=43.4\)), x5 (\(F=13.2\)) y x2 (\(F=10.3\)) ocupan los tres primeros lugares. A partir de ahí el ruido se mezcla con la señal: x33 y x44, que no tienen relación con la clase, quedan por delante de x3 (\(p=0.026\)), que sí la tiene, y x4, informativa por diseño, da \(p=0.13\) y no aparece entre las diez primeras. En la figura, x4 es el círculo verde en la posición 15, rodeado de cruces de ruido.
Los tres criterios dan tres selecciones distintas:
Criterio
Selecciona
Informativas
De ruido
Informativas que pierde
\(p<0.05\) sin corrección
7
4
3
1
Bonferroni
3
3
0
2
Benjamini–Hochberg
4
3
1
2
Sin corrección entran 3 variables de ruido, lo esperable: con 55 variables sin relación y \(\alpha=0.05\), esperas \(55\times0.05=2.75\) falsas alarmas. Bonferroni no deja entrar ninguna de ruido y pierde dos informativas. Benjamini–Hochberg agrega una selección más, que en esta muestra resultó ser de ruido (x33, con \(p\) ajustado de 0.041). Eso no contradice el control de la FDR al 5%, porque la FDR es un promedio sobre muchas repeticiones y no una garantía para cada muestra; en una muestra dada, la proporción de selecciones falsas puede ser 0 o, como aquí, 1 de 4.
Ningún criterio recupera las cinco. Los efectos de x2 a x5 se diseñaron parecidos, y aun así sus p-values van de \(3\times10^{-6}\) a \(0.13\), una dispersión que es variación de muestreo. x4 no pasó ni siquiera sin corrección, y x3 pasó sin corrección y quedó fuera al exigir \(0.05/60=0.0008\), un umbral que pide mucha más evidencia; ese es el precio de controlar las falsas alarmas entre 60 pruebas. Una variable que no pasa el filtro no queda demostrada como inútil.
Al usar este filtro, ten presentes tres cautelas:
Mira una variable a la vez. Una variable puede no separar las clases por sí sola y ser útil combinada con otra, y dos variables muy correlacionadas pasan ambas el filtro aunque aporten lo mismo.
Solo detecta diferencias de medias. Una variable cuya dispersión cambia entre clases, con la misma media, pasa inadvertida.
La selección es parte del entrenamiento. Si eliges las variables con todos los datos y después evalúas el modelo con validación cruzada sobre esos mismos datos, la evaluación sale optimista, porque la etiqueta de los casos de validación ya intervino al elegir las variables. Haz la selección dentro de cada pliegue, solo con los datos de entrenamiento (el capítulo 14 trata la validación cruzada).
f_classif repite el ANOVA de la etapa 4 una vez por variable: las clases ocupan el lugar de las regiones, y el problema de la etapa 9 aparece porque las pruebas son 60 en lugar de una.
Errores que conviene nombrar
Usar la prueba de dos muestras con datos pareados. Desperdicias el diseño y el p-value no corresponde a los datos: en la etapa 1, \(p=0.48\) en lugar de \(2.2\times10^{-5}\).
Comparar varios grupos con muchas pruebas \(t\) sin corregir. La probabilidad de alguna falsa alarma crece con cada pareja, hasta 0.52 con ocho grupos.
Detenerte en el ANOVA. Un \(F\) significativo indica que alguna media difiere y deja sin responder cuál y cuánto.
Leer “Shapiro no rechaza” como “los datos son normales”. Con \(n\) pequeño la prueba casi no detecta nada.
Abandonar la prueba \(t\) con \(n\) grande porque Shapiro rechaza. Con miles de datos rechaza desviaciones que no afectan a las medias.
Decir que Mann–Whitney compara medianas. Compara distribuciones, y solo equivale a medianas si las formas son iguales.
Eliminar los valores extremos para que la prueba dé. Un timeout es un dato del servicio; si lo excluyes, lo dices y lo justificas antes de ver el resultado.
Probar varias pruebas y reportar la que da significativo. Elegir la prueba después de ver los p-values es otra forma de comparaciones múltiples.
Reportar solo las métricas significativas de un tablero. Tienes que decir cuántas miraste.
Corregir de más. Bonferroni con cientos de pruebas no detecta muchos efectos reales; cuando exploras, controlar la FDR suele ser más razonable.
11.6 Guía rápida: ¿qué prueba usar?
Situación
Qué usar
En SciPy
Dos grupos independientes, datos aproximadamente normales
\(t\) de Welch
stats.ttest_ind(a, b, equal_var=False)
Las mismas unidades medidas dos veces
\(t\) pareada
stats.ttest_rel(a, b)
Tres o más grupos independientes, dispersión parecida
ANOVA de un factor
stats.f_oneway(g1, g2, g3)
Tres o más grupos, dispersiones y tamaños distintos
ANOVA de Welch
stats.f_oneway(..., equal_var=False) (SciPy 1.16 o posterior) o statsmodels.stats.oneway.anova_oneway(..., use_var="unequal")
¿Cuáles grupos difieren después del ANOVA?
Tukey HSD
stats.tukey_hsd(g1, g2, g3)
Dos grupos, cola larga o valores extremos
Mann–Whitney
stats.mannwhitneyu(a, b)
Tres o más grupos, cola larga o valores extremos
Kruskal–Wallis
stats.kruskal(g1, g2, g3)
Parejas con diferencias aproximadamente simétricas y valores extremos
Al reportar, sigue este orden: diseño, descripción por grupo, supuestos revisados, prueba con sus grados de libertad, corrección usada y efecto en unidades del problema.
La prueba de Wilcoxon de rangos con signo supone diferencias simétricas para leerla como un contraste de localización. Si esa simetría no es razonable, considera una prueba de signos o un método adecuado al diseño, en lugar de cambiar de prueba solo porque una da un p-value menor.
11.7 Preguntas de comprensión
Comparas dos modelos de lenguaje enviando las mismas 50 preguntas a cada uno y midiendo el tiempo de respuesta. Un colega aplica ttest_ind y obtiene \(p=0.30\). ¿Qué le dirías?
Un ANOVA sobre cinco configuraciones da \(F(4,95)=1.1\). Sin hacer cuentas, ¿esperas un p-value grande o pequeño, y por qué?
Con 30 000 latencias por grupo, Shapiro–Wilk rechaza la normalidad con \(p<10^{-10}\). ¿Debes abandonar la prueba \(t\)?
En un A/B, Mann–Whitney da \(p=0.004\) y Welch \(p=0.35\). ¿Cómo es posible y qué reportas?
Un tablero de 40 métricas muestra 2 con \(p<0.05\). ¿Qué número de falsas alarmas esperarías si nada hubiera cambiado, y qué harías antes de anunciar un hallazgo?
TipOrientaciones
Que el diseño es pareado: cada pregunta pasó por los dos modelos, y la longitud de la pregunta afecta a ambos. La prueba correcta es ttest_rel (o Wilcoxon de rangos con signo si las diferencias tienen valores extremos). En la etapa 1, el mismo error llevó de \(p=2.2\times10^{-5}\) a \(p=0.48\).
Grande. Si \(H_0\) es cierta, \(F\) ronda 1, porque los dos cuadrados medios estiman la misma varianza; un \(F\) de 1.1 con 4 y 95 grados de libertad queda muy por debajo del valor crítico al 5%, cercano a 2.5, y su p-value ronda 0.36.
No. Con \(n\) tan grande, Shapiro detecta desviaciones mínimas (en la etapa 2, \(W=0.9935\) dio \(p=2.7\times10^{-14}\)), y el teorema del límite central protege a la media. Antes revisa el gráfico Q–Q y si hay valores extremos muy alejados, que sí afectan a la media.
Las dos pruebas responden preguntas distintas. Unos pocos valores extremos (timeouts, por ejemplo) inflan la media y la desviación de un grupo y dejan a Welch sin potencia, mientras que Mann–Whitney solo ve que ocupan los rangos más altos (etapa 7). Reporta las dos con su lectura: B tiende a ser más rápida, pero su promedio no es claramente menor, y analiza aparte la tasa de valores extremos.
Con 40 métricas y \(\alpha=0.05\) esperarías \(40\times0.05=2\) falsas alarmas, justo lo que viste. Antes de anunciar nada, aplica una corrección (Holm si una falsa alarma es costosa, Benjamini–Hochberg si estás explorando), di cuántas métricas miraste y, si es posible, confirma el hallazgo con un experimento nuevo con una métrica principal declarada de antemano.
11.8 Referencias para profundizar
Fisher, R. A. (1925). Statistical Methods for Research Workers. Oliver and Boyd. El origen del análisis de varianza.
Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114.
Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. El ANOVA para varianzas distintas.
Mann, H. B. y Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. Annals of Mathematical Statistics, 18(1), 50–60.
Kruskal, W. H. y Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621.
Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
Benjamini, Y. y Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B, 57(1), 289–300.
Benjamini, Y. y Yekutieli, D. (2001). The control of the false discovery rate in multiple testing under dependency. The Annals of Statistics, 29(4), 1165–1188. https://doi.org/10.1214/aos/1013699998
Good, P. I. (2005). Permutation, Parametric, and Bootstrap Tests of Hypotheses (3.ª ed.). Springer.
Nadeau, C. y Bengio, Y. (2003). Inference for the generalization error. Machine Learning, 52, 239–281. La corrección de la \(t\) pareada cuando los pliegues de validación cruzada comparten datos.
Demšar, J. (2006). Statistical comparisons of classifiers over multiple data sets. Journal of Machine Learning Research, 7, 1–30. Pruebas pareadas y de rangos para comparar algoritmos de aprendizaje.
Hastie, T., Tibshirani, R. y Friedman, J. (2009). The Elements of Statistical Learning (2.ª ed.). Springer. La sección 7.10.2 explica el error de seleccionar variables antes de la validación cruzada, y el capítulo 18 trata las pruebas múltiples con muchas variables.
Kohavi, R., Tang, D. y Xu, Y. (2020). Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing. Cambridge University Press. Comparaciones múltiples y métricas con colas largas en experimentos de producto.
statsmodels. Documentación de anova_lm, usada para verificar la tabla de ANOVA. scikit-learn. Documentación de f_classif.
11.9 Lo que debes llevarte de este capítulo
La prueba la decide el diseño, la forma de los datos y el número de comparaciones, y lo decides antes de mirar los p-values: pareado o independiente, medias o rangos o permutación, y cuánta evidencia exigir a cada resultado.
El pareo cambia el error estándar contra el que comparas: los mismos 30 prompts dieron \(p=0.48\) como grupos independientes y \(p=2.2\times10^{-5}\) como parejas, con SE de 8.91 frente a 1.25 ms.
Las pruebas de supuestos dependen de \(n\): con 60 latencias asimétricas Shapiro rechazó (\(p=3\times10^{-8}\)), y con 5 000 valores casi normales también (\(W=0.9935\)).
El ANOVA compara medias con una sola prueba: en las cuatro regiones, \(F(3,116)=3.67\), \(p=0.014\) y \(\eta^2=0.087\), y Tukey ubicó la diferencia en sa-east, unos 11 ms más lenta que dos de las otras tres.
Con varianzas y tamaños distintos, el ANOVA clásico rechazó el 23.4% de las veces bajo \(H_0\); con tamaños iguales, el 7.54%.
Tres timeouts entre cien llevaron a Welch de \(p=0.0016\) a \(0.41\), y a Mann–Whitney solo de \(0.0012\) a \(0.006\).
La permutación prueba cualquier estadístico: la diferencia de p95 (67.4 ms) dio \(p=0.032\), con un ruido de 38.5 ms frente a 7.3 ms de la mediana.
Sin corrección, dos de cada tres tableros de 20 métricas sin efecto real (64.6%) muestran algo “significativo”; Bonferroni lo baja a 5.4%, y Benjamini–Hochberg conserva más potencia a cambio de controlar la FDR.
La selección por filtro es un ANOVA repetido: entre 60 variables, ningún criterio recuperó las cinco informativas.
11.10 Puente hacia los siguientes capítulos
Con este capítulo queda recorrido el mapa básico de pruebas: categorías o números, grupos independientes o pareados, dos grupos o varios, una prueba o muchas. Todo lo anterior es inferencia frecuentista, en la que el parámetro es fijo y la probabilidad describe lo que pasaría al repetir el muestreo.
El capítulo 12 presenta la otra lectura, la bayesiana, que trata al parámetro como incierto y actualiza esa incertidumbre con los datos.
Dos ideas de aquí reaparecen en la regresión lineal del capítulo 13. El ANOVA es un caso particular de la regresión con una variable categórica como predictor, y la partición de la variación en una parte explicada y una residual es la base del \(R^2\). El estadístico \(F\) vuelve cada vez que comparas dos modelos anidados, y la validación cruzada de la etapa 12 se desarrolla en el capítulo 14.