Ajustar un modelo es la parte fácil; lo difícil es decidir si el ajuste sirve. Un RMSE de 0.04, por ejemplo, medido en las mismas filas que entrenaron el modelo dice poco sobre el siguiente lote de usuarios. Esa cifra puede deberse a que el modelo memorizó la muestra, a una partición afortunada o a que se usó el conjunto de prueba para elegir el grado, con lo que dejó de servir como prueba.
En este capítulo construyes las herramientas para medir fuera de la muestra y para leer lo que sale: sobreajuste, subajuste, sesgo y varianza, partición en entrenamiento y prueba, validación cruzada y bootstrap. El modelo que gana en entrenamiento es a menudo el que pierde con datos nuevos. El producto del capítulo es un veredicto con evidencia: aceptar, iterar o rechazar un modelo para un uso concreto, con cifras medidas fuera de la muestra.
Trabajas con dos conjuntos. El primero es una curva simulada, \(y=\sin(1.2x)+0.12x\) con ruido normal de desviación 0.28 y \(x\) uniforme en \([0,8]\), donde conoces la función verdadera y el sobreajuste se ve. El segundo es el conjunto real Diabetes de scikit-learn, el mismo del capítulo 13, para aplicar el protocolo cuando la función verdadera es desconocida.
Tiempo estimado de lectura: 80 minutos (unas 3 horas si ejecutas el código y resuelves el ejercicio)
Nivel: Básico
Conocimientos previos recomendados: el capítulo 13 (regresión lineal, MSE y RMSE), el capítulo 14 (entrenamiento, prueba y elección del umbral) y el capítulo 9 (intervalos de confianza).
distinguir el error de entrenamiento, el error de prueba y el error de generalización;
reconocer el sobreajuste y el subajuste en una tabla y en una figura;
explicar el compromiso sesgo–varianza con las cifras de una simulación;
partir en entrenamiento y prueba sin reutilizar la prueba para elegir el modelo, y medir cuánto se equivoca la prueba cuando sí se reutiliza;
implementar la validación cruzada de \(k\) pliegues a mano y con scikit-learn, y leer la dispersión entre pliegues además de la media;
usar el bootstrap para dar un intervalo de la métrica de prueba y de la diferencia con el baseline;
aplicar un protocolo de seis preguntas para aceptar, iterar o rechazar un modelo.
Ejecuta las celdas en orden: las etapas comparten variables.
15.1 Qué mides cuando dices “el modelo es bueno”
Tres errores distintos
Sea \(L\) una pérdida, aquí casi siempre el error cuadrático. Hay tres promedios distintos:
Nombre
Sobre qué filas
Qué afirma
Error de entrenamiento
Las que usó el ajuste
Qué tan bien memorizó o resumió esta muestra
Error de prueba
Filas no usadas para ajustar ni para elegir complejidad
Una estimación honesta de \(L\) en datos de la misma población
Error de generalización
La población (no se observa)
La cifra que importa, que solo se estima
El error de entrenamiento se calcula con las mismas observaciones que fijaron los coeficientes, y por eso está sesgado hacia abajo. Tratarlo como desempeño es el error más frecuente al evaluar un modelo.
Sobreajuste y subajuste
En este capítulo regulas la flexibilidad del modelo con el grado de un polinomio, \(\hat y=b_0+b_1x+\dots+b_gx^g\): el grado 1 es la recta del capítulo 13, y cada grado adicional añade un coeficiente.
Hay sobreajuste (overfitting) cuando el modelo es tan flexible que captura ruido de la muestra: el error de entrenamiento baja, el de prueba sube y la curva pasa cerca de cada punto y oscila entre ellos. Hay subajuste (underfitting) cuando el modelo es demasiado rígido, como una recta sobre un seno: entrenamiento y prueba quedan altos y parecidos, y más datos no convierten una recta en un seno, así que tienes que cambiar la clase de modelo.
Diagnóstico
Entrenamiento
Prueba
Hueco entrenamiento–prueba
Lectura
Subajuste
Alto
Alto
Pequeño
El modelo no puede representar \(f\)
Ajuste razonable
Bajo o medio
Cercano al de entrenamiento
Pequeño
Candidato
Sobreajuste
Muy bajo
Alto
Grande
El modelo memorizó la muestra
Partición ruidosa
Cualquiera
Cualquiera
Inestable entre semillas
\(n\) de prueba pequeño; todavía no decides
El hueco es la diferencia entre el error de prueba y el de entrenamiento. “Alto” y “bajo” se miden contra un baseline, el predictor ingenuo que devuelve la media de \(y\), y contra las unidades del problema: un RMSE de 6 ms pesa distinto en una latencia de 120 ms que en una de 6 000 ms.
Sesgo y varianza
Imagina el experimento repetido: muchas muestras del mismo tamaño, y cada una produce su propio ajuste \(\hat f\).
El sesgo es \(E[\hat f(x)]-f(x)\): un modelo simple se equivoca siempre en la misma dirección.
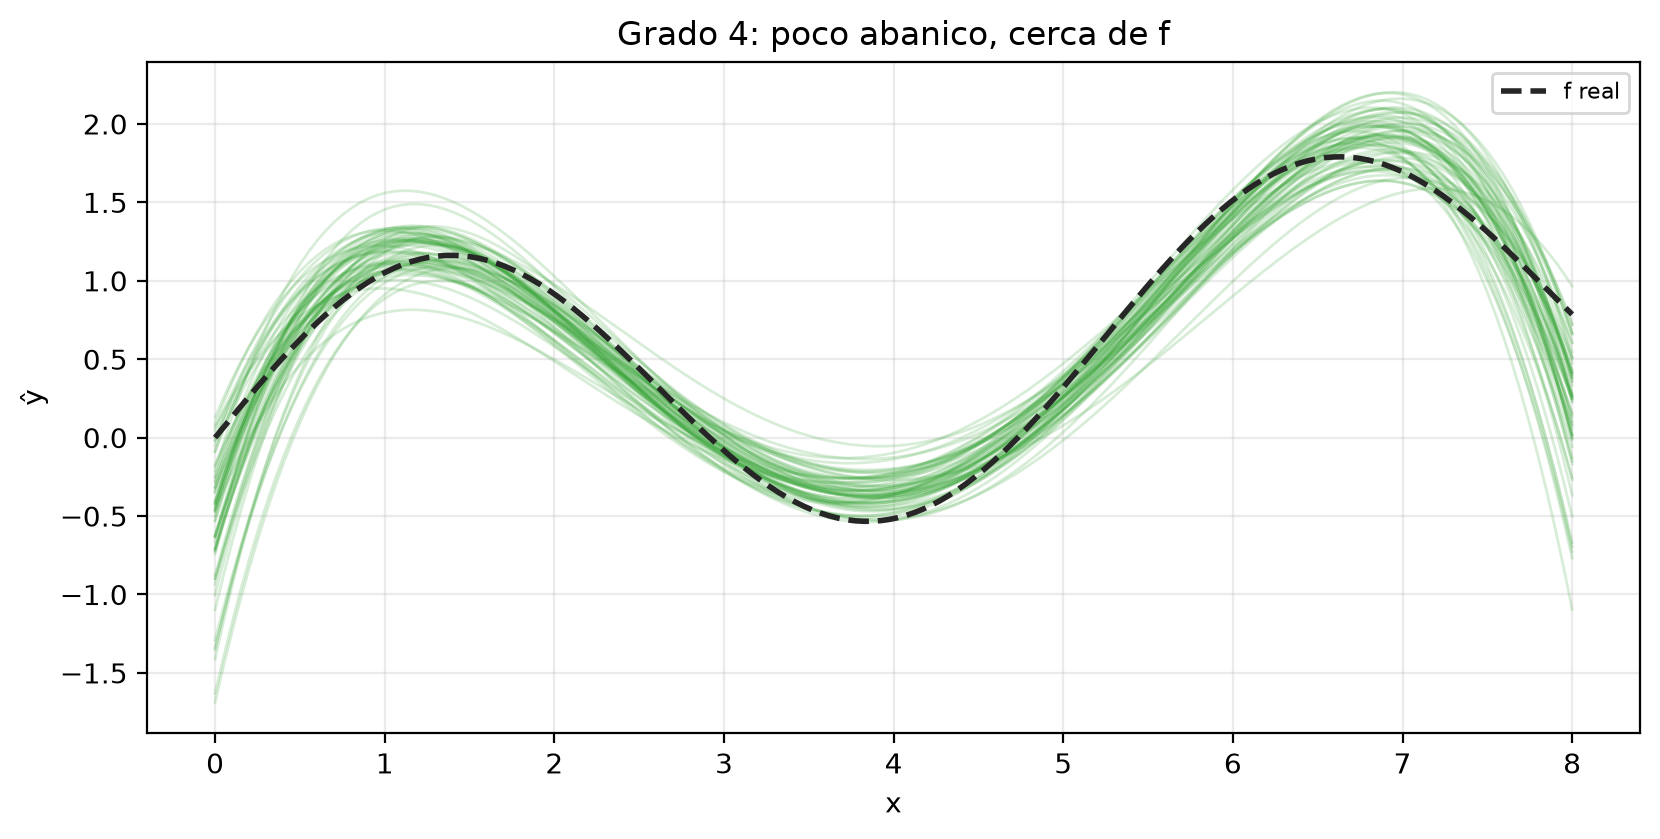
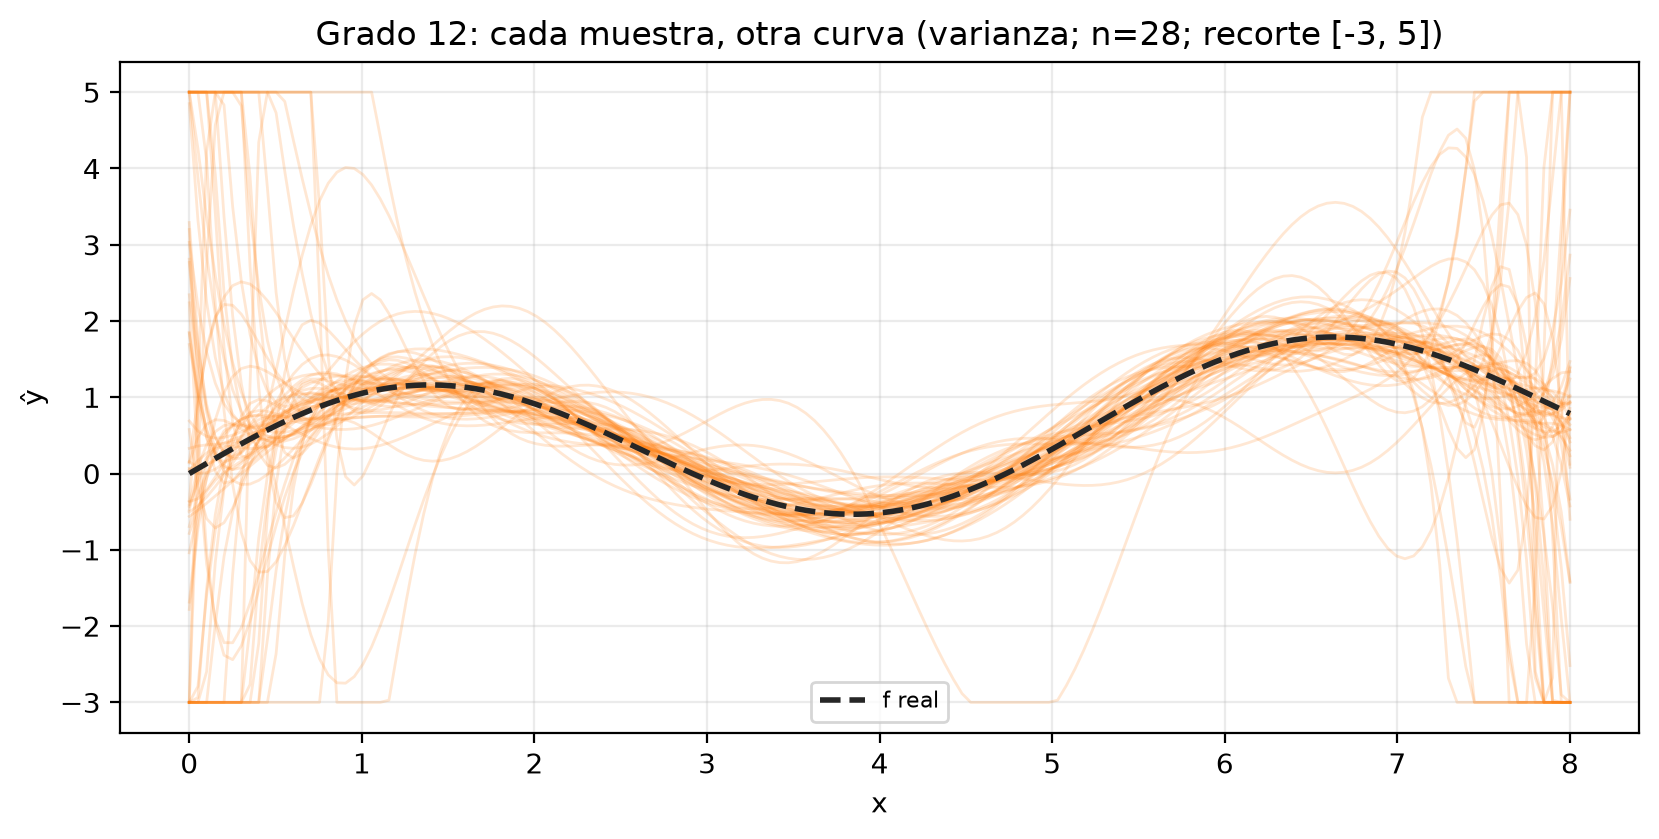
La varianza mide cuánto cambia\(\hat f\) cuando cambia la muestra: un polinomio de grado alto dibuja un abanico, con una curva distinta por muestra.
En un punto \(x\), promediando sobre las muestras de entrenamiento y sobre el ruido, el error cuadrático esperado se descompone en
La prueba estima el error del modelo ya ajustado, mientras que la descomposición habla del promedio sobre muchos entrenamientos. Más flexibilidad suele bajar el sesgo y subir la varianza, y la validación te permite elegir el punto con cifras.
El \(\sigma^2\) no se reduce con un modelo más grande. Si el ruido tiene desviación 0.28, como en la simulación de este capítulo, un RMSE de prueba de 0.05 es señal de fuga, de una evaluación mal hecha o de una prueba demasiado pequeña, mientras que un RMSE de entrenamiento de 0.05 es la firma del sobreajuste.
Entrenamiento y prueba
Reservas una fracción (típicamente del 20 al 30%) que no entra al ajuste, y el resto entrena. La métrica de prueba es la primera cifra honesta, siempre que se cumplan tres condiciones:
Las filas de prueba no se usaron para elegir el grado, el umbral ni las variables.
Prueba y entrenamiento vienen de la misma población (si la prueba es de otro mes, lo declaras).
El \(n\) de prueba es suficiente: un RMSE calculado con 12 filas cambia mucho de una partición a otra.
Si pruebas el grado 1, luego el 2 y así hasta el 20, y eliges el que ganó en prueba, esa cifra de prueba queda sesgada hacia abajo, igual que un error de entrenamiento. Eso es fuga de información: la prueba se filtró hacia la decisión.
Validación cruzada
Con \(n\) pequeño, un solo corte desperdicia datos y da una cifra inestable. La validación cruzada de \(k\) pliegues (\(k\)-fold, en adelante CV, por cross-validation) parte los datos en \(k\) bloques (por ejemplo, \(k=5\) o \(10\)), entrena en \(k-1\), evalúa en el que queda, rota \(k\) veces y reporta la media y la desviación de las \(k\) métricas.
La desviación estándar (DE) entre pliegues es parte del resultado. Con un ejemplo ilustrativo: una media de RMSE de 8.6 con pliegues \(\{4,\,7,\,8,\,18,\,6\}\) se reporta con sus pliegues, porque uno llegó a 18 y la media sola lo oculta. La precisión de la media se aproxima con el error estándar, \(\mathrm{DE}/\sqrt{k}\), una aproximación porque los pliegues comparten filas de entrenamiento y no son independientes.
Los hiperparámetros (aquí, el grado del polinomio) se eligen con CV dentro del conjunto que queda tras reservar la prueba, que en este capítulo se llama desarrollo, y la prueba final se toca una vez, al final.
Bootstrap
El bootstrap remuestrea con reemplazo la muestra (o las filas de prueba) muchas veces y recalcula el estadístico. Produce una distribución empírica del RMSE o del \(R^2\), con un histograma y un intervalo, por ejemplo entre los percentiles 2.5 y 97.5.
El bootstrap estima qué tan precisa es la métrica dada esta muestra, y no añade observaciones nuevas ni sustituye una prueba no vista. Con cifras ilustrativas, un modelo con RMSE 7.0 y bootstrap \((6.6,\,7.5)\) tiene una métrica estable, y otro con 7.0 y \((3.1,\,14.8)\) no autoriza un despliegue.
Protocolo: ¿el modelo es aceptable?
Seis preguntas, en este orden. Si alguna falla, la respuesta no es “sí” aunque el \(R^2\) de entrenamiento sea 0.99.
¿Respecto a qué? ¿Gana al baseline (la media de \(y\), el modelo en producción, una regla de negocio)?
¿En qué conjunto? La cifra que citas es de prueba o de CV, nunca de entrenamiento.
¿El hueco entre entrenamiento y prueba es razonable? Un \(R^2\) de 0.99 en entrenamiento y de 0.40 en prueba indica sobreajuste.
¿El error en unidades del problema es tolerable? Un RMSE de 12 ms en una latencia de 80 ms merece otro juicio que un RMSE de 12 en una escala de 0 a 10 000.
¿Es estable? Dispersión de pliegues, intervalo bootstrap, otro random_state.
¿Hubo fuga? ¿Elegiste el modelo mirando la prueba?
Pregunta
Herramienta
¿Memorizó la muestra?
Entrenamiento frente a prueba; residuos de la prueba
¿Es demasiado rígido?
Entrenamiento y prueba altos; gráfico del ajuste
¿La partición engaña?
Varias particiones o \(k\) pliegues
¿Qué complejidad elegir?
CV dentro del desarrollo
¿Cuánto varía la métrica?
Bootstrap de la prueba; en CV, la DE entre pliegues y \(\mathrm{DE}/\sqrt{k}\) como error estándar aproximado de la media
¿Se despliega?
Las seis preguntas juntas; un \(R^2\) o un p-value solos no bastan
15.2 Por qué importa en IA y machine learning
Llegar a \(R^2=1\) en entrenamiento es fácil, y el costo aparece cuando esa cifra se toma como desempeño. Todo el aprendizaje automático moderno descansa en el protocolo de este capítulo:
Las tablas de resultados. Un ranking de modelos hecho sobre el conjunto de prueba elige al que más se adaptó a esas filas, y con datos de la semana siguiente deja de ganar; la etapa 9 mide ese optimismo (en 200 réplicas, el error del ganador quedó subestimado en el 74% de los casos).
Los modelos de varianza alta. Las redes neuronales y los polinomios de grado alto sobreajustan sin validación; las curvas de aprendizaje de la etapa 11 dicen si faltan datos o falla la clase de modelo.
La búsqueda de hiperparámetros.GridSearchCV y sus variantes son la CV de la etapa 8 aplicada a muchos candidatos, y la regla de un error estándar es una forma de no decidir por diferencias que la CV no distingue.
La decisión de producto. “El modelo es bueno” es una decisión de riesgo: se puede desplegar un modelo que no sirve o descartar uno útil por una partición desafortunada, y el baseline fija la referencia: si el modelo no gana a predecir la media, sus variables no aportan.
Validar consiste en argumentar, con conjuntos distintos y con incertidumbre, que el error será aceptable la próxima vez; imprimir score es solo el primer paso.
15.3 Flujo recomendado de trabajo
Fija la pérdida y el baseline: el RMSE (o la métrica del negocio) y el predictor ingenuo.
Reserva una prueba y no la toques; el resto es el conjunto de desarrollo.
Ajusta los candidatos solo en desarrollo, con complejidad distinta (aquí, el grado).
Elige con CV, mirando la media y la dispersión de los pliegues.
Mide una vez en prueba. Esa es la cifra que citas.
Cuantifica la variabilidad (IC bootstrap de la prueba o, si solo hay CV, media \(\pm\,\mathrm{DE}/\sqrt{k}\) declarada como aproximada) y traduce a unidades.
Redacta el veredicto con las seis preguntas y sus límites (población, rango de \(x\), \(n\)):
«Para [uso], \(y=\)[variable, unidad]. Baseline [nombre] en prueba = [métrica]. El modelo [nombre] se eligió por [CV de k pliegues] en desarrollo (\(n=\)[valor]). En prueba (\(n=\)[valor]), la métrica es [valor] (IC 95% [extremos]). Diferencia con el baseline: [valor] (IC [extremos]). Hueco entre entrenamiento y prueba: [valor]. Residuos: [banda / patrón]. Veredicto: [rechazar / iterar / aceptar para este uso]; no se acepta para [uso que la cifra no sostiene]. Limitación: [partición única, D alto, sin validación temporal u otra].»
Un modelo sin baseline, sin conjunto no visto y sin intervalo de la métrica todavía no se puede aceptar. La etapa 13 llena esta plantilla con Diabetes.
15.4 Preparar el entorno
La celda carga NumPy, pandas, Matplotlib y las piezas de scikit-learn que usa el capítulo (modelos lineales, transformaciones polinómicas, particiones, validación cruzada, curvas de aprendizaje y el conjunto Diabetes), y fija un estilo de gráficos.
%matplotlib inline%config InlineBackend.figure_format ="retina"SEMILLA =42# datos simulados, partición principal y caso DiabetesSEMILLA_SESGO_VARIANZA =5# experimento de sesgo y varianzaSEMILLA_DESARROLLO =7# separación desarrollo / prueba finalSEMILLA_CORTE_A =3# primer corte de la etapa de dos particionesSEMILLA_CORTE_B =4# segundo corteSEMILLA_POBLACION =2024# población grande de referencia (20 000 filas)SEMILLA_BOOTSTRAP =10# remuestreo bootstrapSEMILLA_DIABETES =12# generador auxiliar del caso Diabetesimport sysprint("Python:", sys.version.split()[0])import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.linear_model import LinearRegressionfrom sklearn.dummy import DummyRegressorfrom sklearn.preprocessing import PolynomialFeatures, StandardScaler, MinMaxScalerfrom sklearn.pipeline import Pipelinefrom sklearn.model_selection import train_test_split, KFold, cross_val_score, learning_curvefrom sklearn.metrics import mean_squared_error, r2_scorefrom sklearn.datasets import load_diabetesplt.rcParams["figure.figsize"] = (8, 5)plt.rcParams["axes.grid"] =Trueplt.rcParams["grid.alpha"] =0.25print("sklearn:", __import__("sklearn").__version__)
Python: 3.13.14
sklearn: 1.9.0
Funciones de ajuste, métricas y gráficos
El entorno queda con Python 3.13.14 y scikit-learn 1.9.0.
La función pipe_poli(grado) encadena tres pasos en un Pipeline: reescala \(x\) al intervalo \([-1,1]\), construye las columnas \(1,x,x^2,\dots,x^g\) y ajusta los coeficientes por mínimos cuadrados. Al estar encadenados, los tres pasos se calculan solo con las filas que recibe fit, de modo que nada de la prueba entra al ajuste. El reescalado no cambia las predicciones del polinomio; mantiene las potencias entre \(-1\) y \(1\) para que el cálculo sea numéricamente estable hasta el grado 12. generar_curva produce los datos simulados de las etapas 1 a 11, y ficha reúne RMSE, MSE y \(R^2\) de un par (observado, predicho).
Las 13 etapas van de la curva simulada, donde conoces \(f\) y el sobreajuste se ve, a Diabetes, donde \(f\) es desconocida y tienes que decidir. Las etapas 1 a 4 comparan entrenamiento y prueba; la 5 muestra el sesgo y la varianza; las 6 a 8, la variación de una partición y la validación cruzada; la 9, la fuga; la 10, el bootstrap; la 11, las curvas de aprendizaje; y las 12 y 13 aplican el protocolo a datos reales.
Etapa 1: Sin baseline no hay “bueno”
Generas \(n=70\) puntos con generar_curva (semilla 42):
Apartas el 35% como prueba. El predictor más simple ignora \(x\) y devuelve el \(\bar y\) del entrenamiento (DummyRegressor), y todo modelo que tomes en serio debe ganar a esa cifra en prueba; si no gana, \(x\) no aporta o la partición fue desafortunada.
x, y, f = generar_curva(70, seed=SEMILLA)x_tr, x_te, y_tr, y_te = train_test_split(x, y, test_size=0.35, random_state=SEMILLA)print(f"Filas: {len(x_tr)} de entrenamiento y {len(x_te)} de prueba")dummy = DummyRegressor(strategy="mean")dummy.fit(x_tr.reshape(-1, 1), y_tr)base_tr = ficha(y_tr, dummy.predict(x_tr.reshape(-1, 1)), "baseline (media) / entrenamiento")base_te = ficha(y_te, dummy.predict(x_te.reshape(-1, 1)), "baseline (media) / prueba")print(pd.DataFrame([base_tr, base_te]).round(3).to_string(index=False))print()print(f"R² del baseline en prueba, con cinco decimales = {base_te['R2']:.5f}")print("DE de y (toda la muestra) =", round(y.std(ddof=1), 3))
Filas: 45 de entrenamiento y 25 de prueba
                          modelo  RMSE   MSE   R2
baseline (media) / entrenamiento 0.838 0.703  0.0
       baseline (media) / prueba 0.804 0.647 -0.0

R² del baseline en prueba, con cinco decimales = -0.00001
DE de y (toda la muestra) = 0.832
Con 45 filas de entrenamiento y 25 de prueba, el \(R^2\) del baseline en entrenamiento es \(0\) por construcción, porque predice la media de esas mismas filas. En prueba queda apenas por debajo de 0 (\(-0.00001\), que la tabla redondea a \(-0.0\)) porque la media de entrenamiento no coincide exactamente con la de la prueba, y su RMSE de prueba, 0.804, queda cerca de la DE de \(y\) (0.832).
Todavía no hay modelo, sino un piso de referencia: desde aquí, “bueno” quiere decir mejor que 0.804 en prueba, por un margen que importe, y un modelo reportado sin esta fila no permite afirmar ninguna mejora.
Etapa 2: El espejismo del error de entrenamiento
Un polinomio de grado \(g\) predice
\[
\hat y=b_0+b_1x+b_2x^2+\dots+b_gx^g .
\]
Sigue siendo mínimos cuadrados, como en el capítulo 13: a la columna \(x\) le agregas las columnas \(x^2,\dots,x^g\) y buscas los coeficientes que dan el menor MSE en las filas de entrenamiento. El grado mide la flexibilidad: el grado 1 es la recta (2 coeficientes) y el grado 12 tiene 13.
Ajustas tres polinomios solo en entrenamiento (45 filas): grado 1 (rígido), grado 4 (flexible y razonable para un seno suave) y grado 12 (muy flexible), e imprimes únicamente el RMSE de entrenamiento, la cifra que tienta a desplegar.
grados = [1, 4, 12]modelos = {}solo_train = []for g in grados: m = pipe_poli(g) m.fit(x_tr.reshape(-1, 1), y_tr) modelos[f"grado {g}"] = m solo_train.append(ficha(y_tr, m.predict(x_tr.reshape(-1, 1)), f"grado {g}"))print(pd.DataFrame(solo_train).round(3).to_string(index=False))
  modelo  RMSE   MSE    R2
 grado 1 0.742 0.550 0.217
 grado 4 0.289 0.084 0.881
grado 12 0.171 0.029 0.958
El RMSE de entrenamiento baja con el grado, 0.742, 0.289 y 0.171, y tiene que ser así: el grado 12 contiene al grado 4 como caso particular (basta poner en cero los coeficientes sobrantes), de modo que en las filas de entrenamiento nunca puede ajustar peor. El grado 1 queda arriba porque una recta no puede seguir un seno.
Si eligieras por esta columna, ganaría el grado 12. Todavía no miraste ninguna fila ajena al ajuste, y esta tabla sola no dice nada sobre datos nuevos; la etapa 3 pone a prueba esa elección.
Etapa 3: El primer número honesto, la prueba
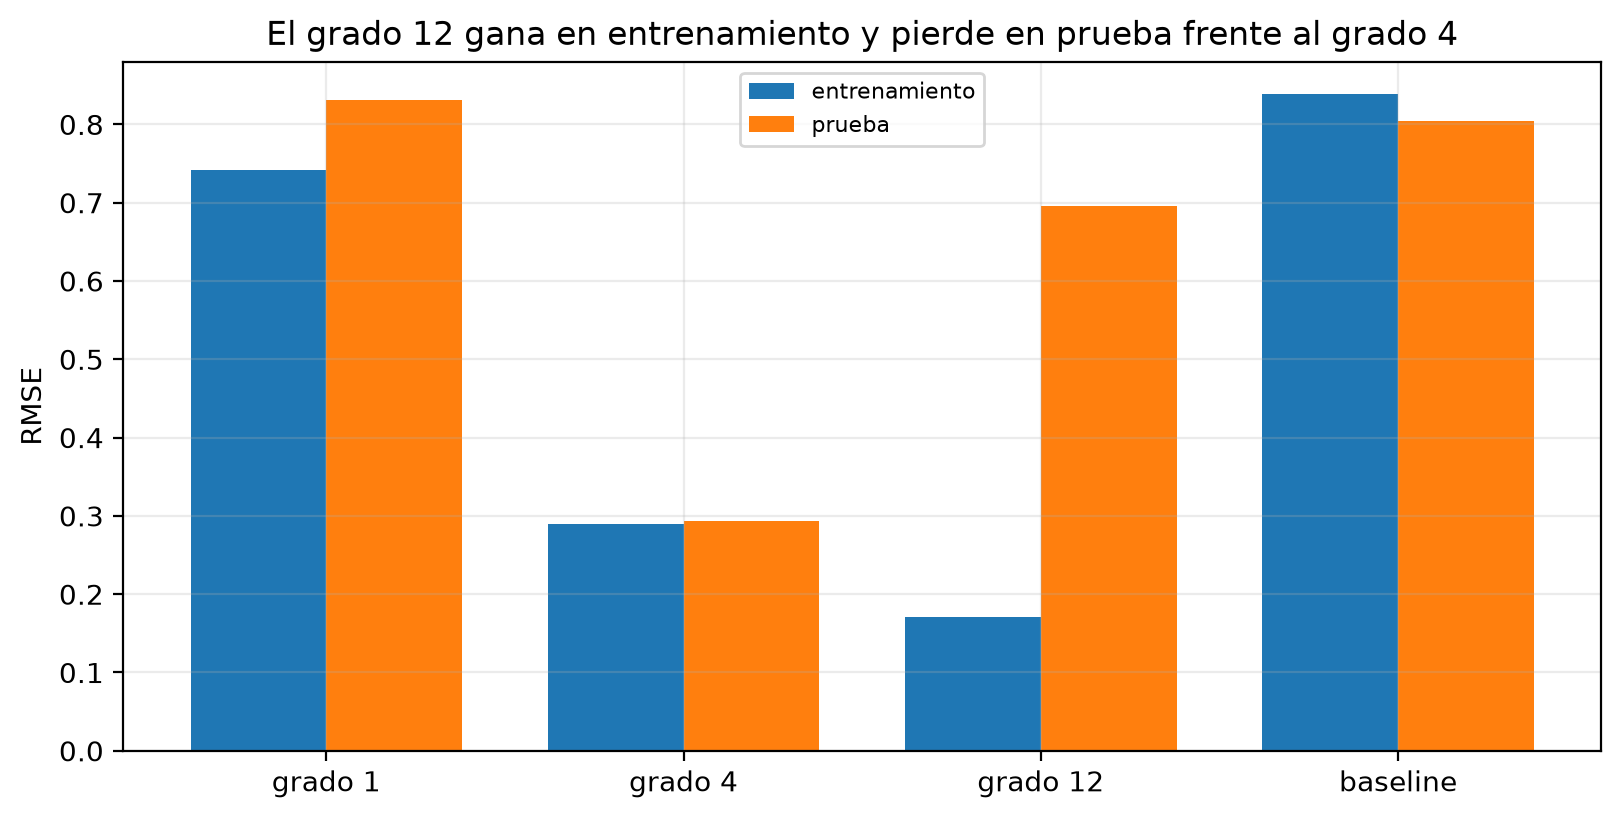
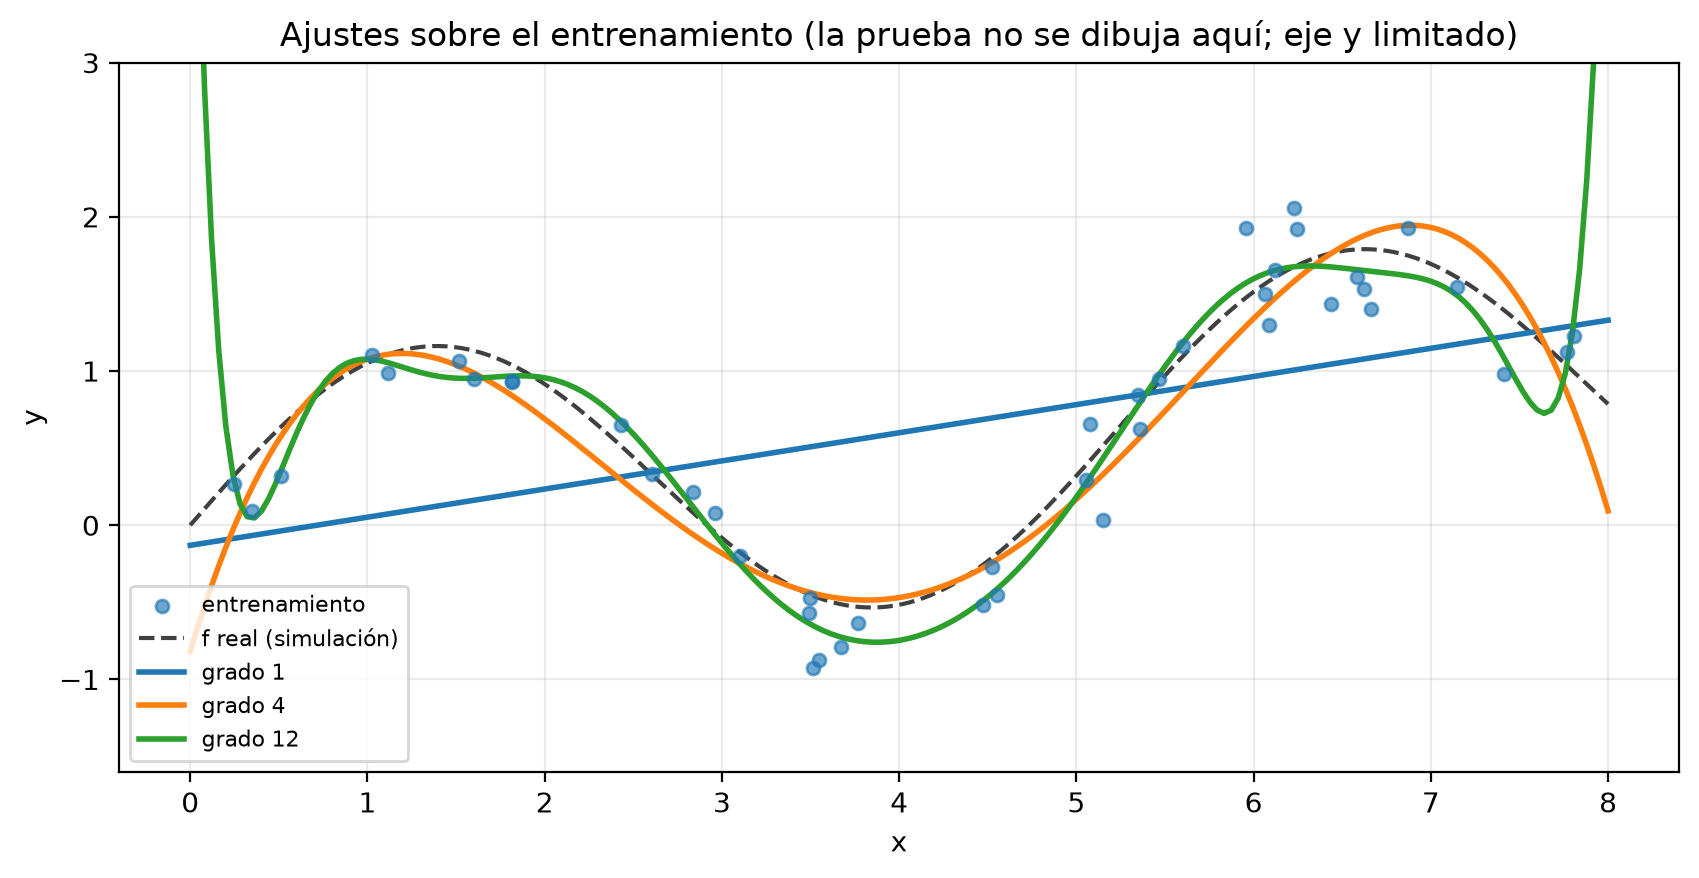
Evalúas los mismos tres modelos en el 35% que no entrenó (25 filas). La columna hueco es el RMSE de prueba menos el de entrenamiento, y las dos figuras muestran las barras de los dos errores y las tres curvas sobre el entrenamiento.
filas_tt = []for g in grados: m = modelos[f"grado {g}"] filas_tt.append( {"modelo": f"grado {g}","RMSE_train": rmse(y_tr, m.predict(x_tr.reshape(-1, 1))),"RMSE_test": rmse(y_te, m.predict(x_te.reshape(-1, 1))),"R2_train": r2_score(y_tr, m.predict(x_tr.reshape(-1, 1))),"R2_test": r2_score(y_te, m.predict(x_te.reshape(-1, 1))),"hueco": rmse(y_te, m.predict(x_te.reshape(-1, 1))) - rmse(y_tr, m.predict(x_tr.reshape(-1, 1))), } )filas_tt.append( {"modelo": "baseline","RMSE_train": base_tr["RMSE"],"RMSE_test": base_te["RMSE"],"R2_train": base_tr["R2"],"R2_test": base_te["R2"],"hueco": base_te["RMSE"] - base_tr["RMSE"], })tab_tt = pd.DataFrame(filas_tt)print(tab_tt.round(3).to_string(index=False))graficar_barras_train_test(filas_tt, "El grado 12 gana en entrenamiento y pierde en prueba frente al grado 4")graficar_ajustes( x_tr, y_tr, f, modelos,"Ajustes sobre el entrenamiento (la prueba no se dibuja aquí; eje y limitado)", ylim=(-1.6, 3.0),)
Tres columnas deciden juntas. Frente al baseline (0.804), el grado 1 ni siquiera gana: 0.831, con \(R^2\) de prueba \(-0.069\), mientras que los grados 4 y 12 sí ganan (0.294 y 0.696). En el hueco, el grado 1 tiene los dos errores altos (0.742 y 0.831) y un hueco pequeño, que es subajuste; el grado 4, 0.289 y 0.294, con hueco de 0.004; y el grado 12, 0.171 y 0.696, con hueco de 0.525, que es sobreajuste. Y frente al ruido, el 0.294 del grado 4 está cerca de \(\sigma=0.28\), el mínimo alcanzable en promedio; una cifra de prueba mucho menor que el ruido sería sospechosa.
El orden se invirtió respecto de la etapa 2: el grado 12 tenía el menor error de entrenamiento y en prueba su RMSE es más del doble que el del grado 4, con \(R^2\) de 0.251 frente a 0.867, como muestran las barras de la primera figura. En la segunda, la curva del grado 12 sale del eje en los dos bordes, y la etapa 4 muestra qué parte del 0.696 viene de ahí.
Rechazas el grado 12 por el hueco y el grado 1 por subajuste, y el grado 4 queda como candidato. Es una partición, y la etapa 6 muestra que ese RMSE de prueba se mueve al cambiar la semilla, así que todavía no lo despliegas.
Etapa 4: Ver el diagnóstico, no solo la tabla
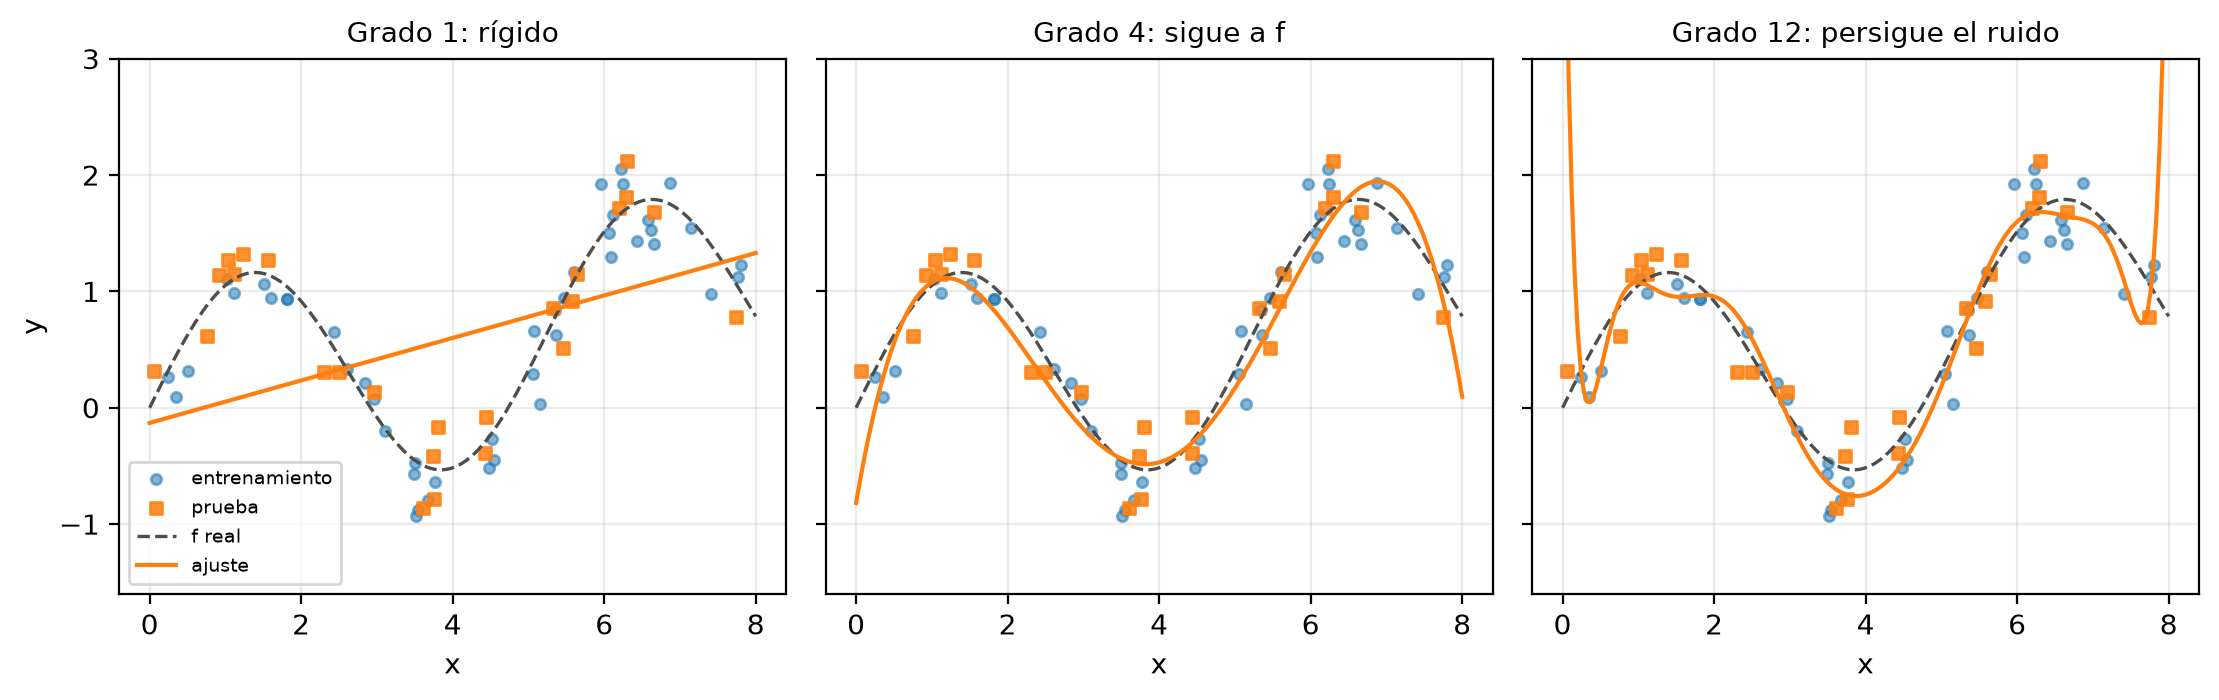
La segunda figura de la etapa 3 ya mostraba las tres curvas sobre el entrenamiento; aquí agregas las filas de prueba para ver dónde falla cada modelo. El eje vertical se limita a \([-1.6,\,3]\) para que las tres viñetas sean comparables.
xs = np.linspace(0, 8, 200)fig, axes = plt.subplots(1, 3, figsize=(11.2, 3.6), sharey=True)for ax, g, tit inzip( axes, [1, 4, 12], ["Grado 1: rígido", "Grado 4: sigue a f", "Grado 12: persigue el ruido"],): ax.scatter(x_tr, y_tr, s=14, alpha=0.55, label="entrenamiento") ax.scatter(x_te, y_te, s=18, alpha=0.85, marker="s", label="prueba") ax.plot(xs, np.sin(1.2* xs) +0.12* xs, color="0.3", linestyle="--", linewidth=1.2, label="f real") ax.plot(xs, modelos[f"grado {g}"].predict(xs.reshape(-1, 1)), color="C1", label="ajuste") ax.set_ylim(-1.6, 3.0) ax.set_title(tit, fontsize=10) ax.set_xlabel("x")axes[0].set_ylabel("y")axes[0].legend(fontsize=7, loc="lower left")plt.tight_layout()plt.show()print()m4, m12 = modelos["grado 4"], modelos["grado 12"]pred4_te = m4.predict(x_te.reshape(-1, 1))pred12_te = m12.predict(x_te.reshape(-1, 1))i_peor =int(np.argmax(np.abs(y_te - pred12_te)))resto = np.arange(len(x_te)) != i_peorprint(f"Rango de x en entrenamiento: [{x_tr.min():.2f}, {x_tr.max():.2f}]")print(f"Mayor error de prueba del grado 12: x = {x_te[i_peor]:.2f}, y = {y_te[i_peor]:.2f}, ŷ = {pred12_te[i_peor]:.2f}")print(f"RMSE de prueba sin esa fila: grado 4 = {rmse(y_te[resto], pred4_te[resto]):.3f}, "f"grado 12 = {rmse(y_te[resto], pred12_te[resto]):.3f}")
Rango de x en entrenamiento: [0.25, 7.80]
Mayor error de prueba del grado 12: x = 0.06, y = 0.32, ŷ = 3.51
RMSE de prueba sin esa fila: grado 4 = 0.234, grado 12 = 0.282
En la viñeta del grado 1, la recta corta el seno, y entrenamiento y prueba se equivocan en las mismas zonas (crestas y valles): es sesgo. En la del grado 4, la curva sigue a \(f\) sin perseguir cada residuo, y los cuadrados de la prueba quedan repartidos a ambos lados. En la del grado 12, la curva se pega a los puntos de entrenamiento y oscila entre ellos, y los cuadrados quedan lejos donde la curva se aparta de \(f\) (por ejemplo, cerca de \(x=3.8\)).
El fallo mayor del grado 12 está en el borde izquierdo. El entrenamiento empieza en \(x=0.25\) y la prueba tiene una fila en \(x=0.06\), donde \(y=0.32\) y el grado 12 predice 3.51, fuera del eje: un polinomio de grado alto se dispara en cuanto sale del rango donde tuvo datos. Esa sola fila explica buena parte del 0.696; sin ella, el RMSE de prueba del grado 12 es 0.282 y el del grado 4, 0.234, así que el grado 12 sigue perdiendo con un error de entrenamiento mucho menor (0.171 frente a 0.289). El sobreajuste tiene aquí dos componentes, la oscilación entre puntos y la extrapolación en el borde.
Etapa 5: Sesgo y varianza se ven al repetir la muestra
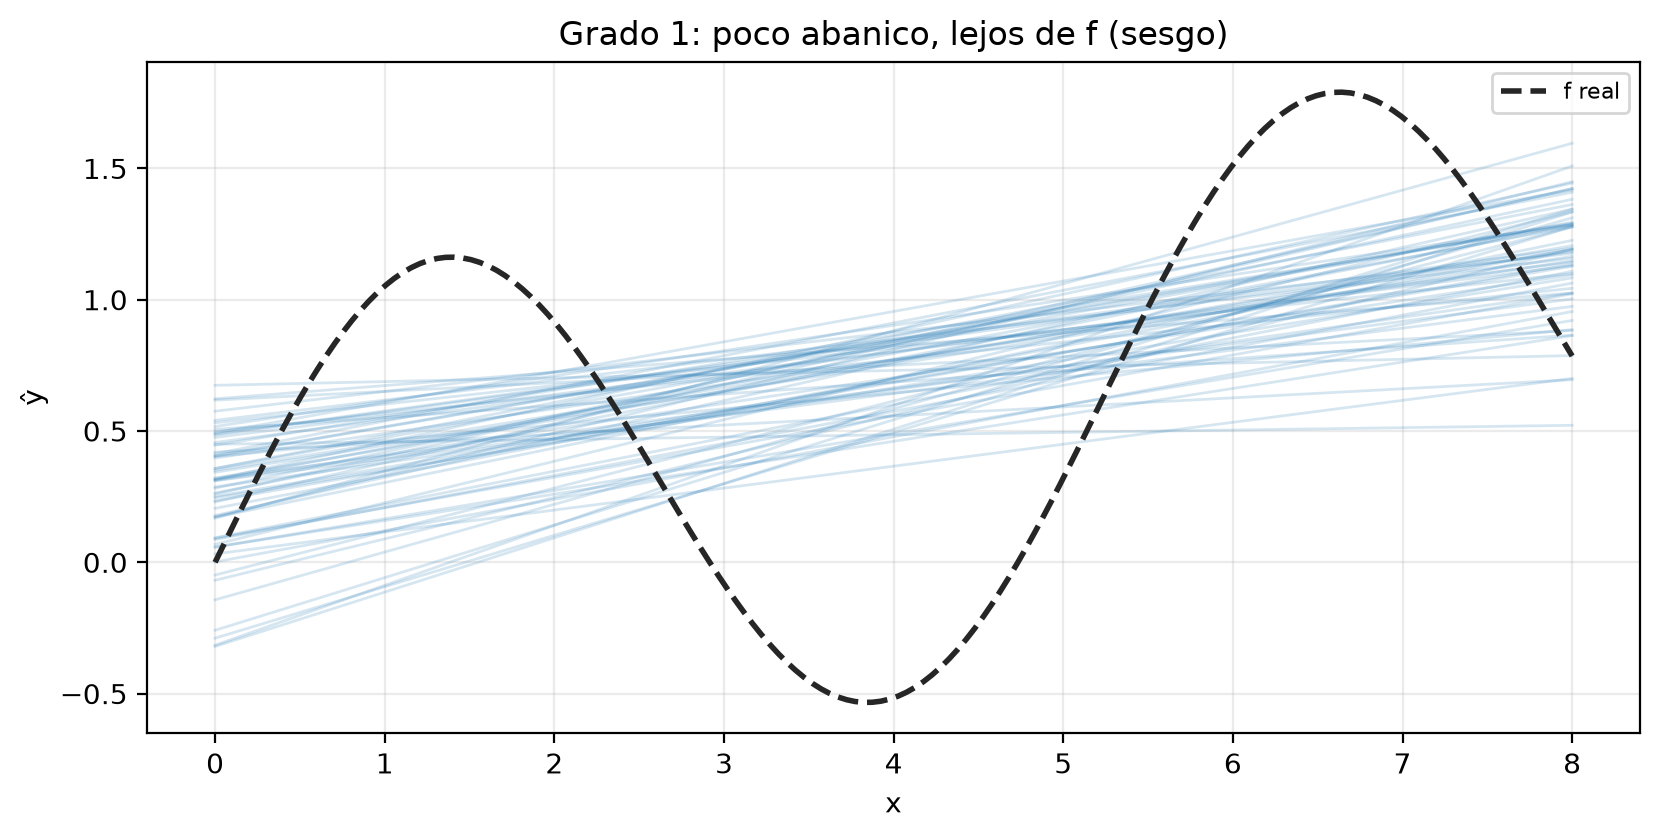
Generas \(60\) muestras de \(n=28\), pequeñas a propósito, ajustas en cada una los grados 1, 4 y 12 y dibujas las 60 curvas de cada grado. Como conoces \(f\), calculas en una rejilla de \(x\) el sesgo² (la distancia entre la curva promedio y \(f\)) y la varianza (la dispersión de las 60 curvas), y compruebas que sesgo² + varianza + \(\sigma^2\) coincide con el MSE medido sobre observaciones nuevas.
Con \(n=28\), el grado 12 se dispara en los bordes en algunas muestras, así que, para que el abanico sea legible, todas las predicciones se recortan al intervalo \([-3,\,5]\). El recorte no altera los grados 1 y 4, cuyas curvas nunca salen de ese intervalo, pero sí cambia las cifras del grado 12, y por eso la celda las imprime con recorte y sin él.
xs = np.linspace(0, 8, 160)f_xs = np.sin(1.2* xs) +0.12* xssigma =0.28grados_sv = [1, 4, 12]curvas = {g: [] for g in grados_sv} # predicciones recortadas a [-3, 5]curvas_sin = {g: [] for g in grados_sv} # predicciones sin recortarmse_nuevo = {g: [] for g in grados_sv} # MSE frente a observaciones nuevas (con recorte)rng_sv = np.random.default_rng(SEMILLA_SESGO_VARIANZA)for i inrange(60): xi, yi, _ = generar_curva(28, seed=100+ i) y_nuevo = f_xs + rng_sv.normal(0, sigma, size=len(xs))for g in grados_sv: pred = pipe_poli(g).fit(xi.reshape(-1, 1), yi).predict(xs.reshape(-1, 1)) curvas_sin[g].append(pred) pred_rec = np.clip(pred, -3, 5) curvas[g].append(pred_rec) mse_nuevo[g].append(np.mean((y_nuevo - pred_rec) **2))graficar_abanico(xs, curvas[1], f_xs, "Grado 1: poco abanico, lejos de f (sesgo)", color="C0")graficar_abanico(xs, curvas[4], f_xs, "Grado 4: poco abanico, cerca de f", color="C2")graficar_abanico(xs, curvas[12], f_xs, "Grado 12: cada muestra, otra curva (varianza; n=28; recorte [-3, 5])", color="C1")def sesgo2_varianza(lista): c = np.array(lista)returnfloat(np.mean((c.mean(axis=0) - f_xs) **2)), float(np.mean(c.var(axis=0)))filas_sv = []for g in grados_sv: s2, v = sesgo2_varianza(curvas[g]) filas_sv.append( {"grado": g,"sesgo²": s2,"varianza": v,"σ²": sigma**2,"suma": s2 + v + sigma**2,"MSE simulado": float(np.mean(mse_nuevo[g])), } )print("Promedios sobre la rejilla de x, 60 muestras de n=28, predicciones recortadas a [-3, 5]")print(pd.DataFrame(filas_sv).round(3).to_string(index=False))print()s2_sin, v_sin = sesgo2_varianza(curvas_sin[12])fuera =sum(bool(np.any((c <-3) | (c >5))) for c in curvas_sin[12])print(f"Grado 12 sin recorte: sesgo² = {s2_sin:.1f}, varianza = {v_sin:.0f}")print(f"Curvas del grado 12 que salen de [-3, 5] en algún punto: {fuera} de 60")print("Curvas de los grados 1 y 4 que salen de [-3, 5]:",sum(bool(np.any((c <-3) | (c >5))) for g in (1, 4) for c in curvas_sin[g]))
Promedios sobre la rejilla de x, 60 muestras de n=28, predicciones recortadas a [-3, 5]
 grado  sesgo²  varianza    σ²  suma  MSE simulado
     1   0.447     0.029 0.078 0.555         0.555
     4   0.025     0.026 0.078 0.129         0.131
    12   0.021     0.872 0.078 0.972         0.974

Grado 12 sin recorte: sesgo² = 4.0, varianza = 496
Curvas del grado 12 que salen de [-3, 5] en algún punto: 40 de 60
Curvas de los grados 1 y 4 que salen de [-3, 5]: 0
El primer abanico (grado 1) es una cinta estrecha que no cubre las crestas de \(f\): se equivoca igual en todas las muestras. El segundo (grado 4) es una cinta estrecha que sí sigue a \(f\) y solo se abre un poco en los bordes. El tercero (grado 12) sigue a \(f\) en promedio, pero cada muestra da una curva distinta, y en los extremos las curvas se disparan hasta el recorte: 40 de las 60 salen de \([-3,\,5]\) en algún punto.
La suma sesgo² + varianza + \(\sigma^2\) reproduce el MSE simulado en los tres grados (0.555 y 0.555; 0.129 y 0.131; 0.972 y 0.974), como dice la descomposición. De grado 1 a grado 4, el sesgo² cae de 0.447 a 0.025 y la varianza casi no cambia (0.029 y 0.026), así que en ese tramo la flexibilidad adicional sale gratis. De grado 4 a grado 12, la varianza pasa de 0.026 a 0.872, más de treinta veces mayor. El sesgo² impreso apenas cambia (0.025 y 0.021), pero la cifra del grado 12 está inflada: con solo 60 curvas tan dispersas, unas 0.015 de esas 0.021 son ruido de la propia simulación (varianza/60). En cualquier caso, lo que el grado 12 gana en sesgo es mucho menos de lo que pierde en varianza, y el error total sube de 0.129 a 0.972. El grado intermedio tiene el menor error total porque ninguno de los dos términos domina.
Sin el recorte, la varianza media del grado 12 sale cerca de 500 y el sesgo² cerca de 4, dos cifras inestables que fijan unas pocas curvas disparadas en los bordes; el sesgo² de 4 es ruido del promedio de 60 curvas, no una desviación sistemática. La frase “el grado alto tiene poco sesgo” vale para las predicciones recortadas, y sin recorte lo que observas es que el grado 12 con 28 filas es inservible en los bordes. Esto no dice que el grado 4 sea el mejor para cualquier \(n\) (el punto se elige con CV en la etapa 8), pero explica por qué la CV va a penalizar los grados altos cuando \(n\) es pequeño.
Etapa 6: Un solo corte entre entrenamiento y prueba varía
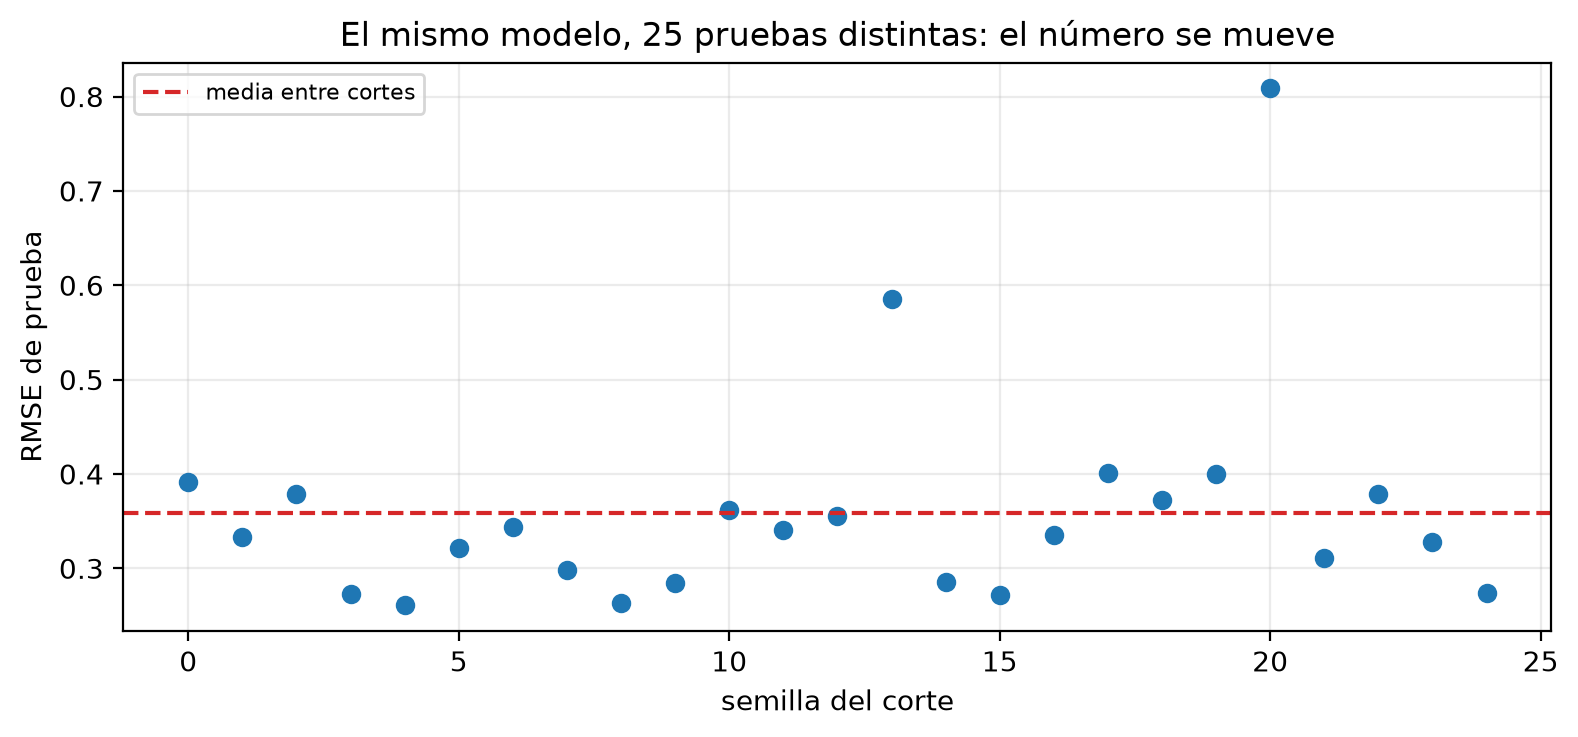
Calculas el RMSE de prueba del grado 4 con 25 cortes distintos de las mismas 70 filas (45 de entrenamiento y 25 de prueba cada vez). Si la conclusión cambia de un corte a otro, untrain_test_split no basta.
rmses_split, rangos_tr = [], []for seed inrange(25): xa, xb, ya, yb = train_test_split(x, y, test_size=0.35, random_state=seed) m = pipe_poli(4).fit(xa.reshape(-1, 1), ya) rmses_split.append(rmse(yb, m.predict(xb.reshape(-1, 1)))) rangos_tr.append((xa.min(), xa.max()))rmses_split = np.array(rmses_split)print("RMSE de prueba (grado 4) en 25 cortes")print(" media =", round(rmses_split.mean(), 3), " DE =", round(rmses_split.std(ddof=1), 3))print(" min =", round(rmses_split.min(), 3), " max =", round(rmses_split.max(), 3))print(" rango =", round(rmses_split.max() - rmses_split.min(), 3))print()print(f"Rango de x en la muestra completa: [{x.min():.2f}, {x.max():.2f}]")altos = np.where(rmses_split >0.5)[0]for s in altos:print(f" semilla {s}: RMSE = {rmses_split[s]:.3f}; x de entrenamiento en [{rangos_tr[s][0]:.2f}, {rangos_tr[s][1]:.2f}]")sin_altos = np.delete(rmses_split, altos)print(f"Sin esos {len(altos)} cortes: DE = {sin_altos.std(ddof=1):.3f}, max = {sin_altos.max():.3f}")fig, ax = plt.subplots(figsize=(8.0, 3.8))ax.plot(rmses_split, marker="o", linestyle="none")ax.axhline(rmses_split.mean(), color="C3", linestyle="--", label="media entre cortes")ax.set_xlabel("semilla del corte")ax.set_ylabel("RMSE de prueba")ax.set_title("El mismo modelo, 25 pruebas distintas: el número se mueve")ax.legend(fontsize=8)plt.tight_layout()plt.show()
RMSE de prueba (grado 4) en 25 cortes
  media = 0.358   DE = 0.116
  min  = 0.261   max = 0.809
  rango = 0.548

Rango de x en la muestra completa: [0.06, 7.80]
  semilla 13: RMSE = 0.586; x de entrenamiento en [0.25, 7.41]
  semilla 20: RMSE = 0.809; x de entrenamiento en [0.51, 6.87]
Sin esos 2 cortes: DE = 0.046, max = 0.401
Cada punto del gráfico es un “RMSE de prueba” que se habría publicado con esa semilla, y van de 0.261 a 0.809, con media 0.358. Esa distancia mide el efecto de qué filas cayeron en la prueba; el fenómeno es el mismo en los 25 cortes.
Dos cortes (semillas 13 y 20, con 0.586 y 0.809) concentran casi todo el rango. En los dos, el entrenamiento no cubre los extremos de \(x\): va de 0.25 a 7.41 en uno y de 0.51 a 6.87 en el otro, cuando la muestra completa va de 0.06 a 7.80, así que las filas de los extremos cayeron en la prueba y el polinomio tuvo que extrapolar. Sin esos dos cortes, la DE baja de 0.116 a 0.046 y el máximo es 0.401; aun así, con 25 filas de prueba el RMSE va de 0.26 a 0.40.
La partición en entrenamiento y prueba sirve como una medición, pero no como la medición si de ella depende un despliegue: hace falta promediar varios pliegues o declarar un intervalo. El 0.294 de la etapa 3 fue un corte favorable, por debajo de la media de los 25 (0.358).
Etapa 7: Validación cruzada a mano y con scikit-learn
Con \(k=5\), en cada pliegue entrenas en 4/5 y mides el RMSE en 1/5. Primero implementas el bucle a mano y después lo contrastas con cross_val_score; las dos vías deben coincidir porque usan la misma partición.
scikit-learn maximiza puntuaciones, así que entrega el RMSE con signo negativo (scoring="neg_root_mean_squared_error"), y el signo menos delante de cross_val_score lo devuelve a positivo. Esta etapa usa las 70 filas, incluidas las que fueron prueba en la etapa 3, solo para comparar las dos vías y aprender a leer los pliegues; la elección de modelo con una prueba reservada empieza en la etapa 8. Al final repites la CV de los grados 4 y 12 con ocho semillas distintas de la partición.
def rmse_kfold(grado, X, y, k=5, seed=0): kf = KFold(n_splits=k, shuffle=True, random_state=seed) puntos = []for tr, te in kf.split(X): m = pipe_poli(grado).fit(X[tr], y[tr]) puntos.append(rmse(y[te], m.predict(X[te])))return np.array(puntos)X_all = x.reshape(-1, 1)manual = {g: rmse_kfold(g, X_all, y, k=5, seed=0) for g in grados}kf = KFold(n_splits=5, shuffle=True, random_state=0)sk = {}for g in grados: scores =-cross_val_score( pipe_poli(g), X_all, y, cv=kf, scoring="neg_root_mean_squared_error" ) sk[g] = scoresfilas_cv = []for g in grados: filas_cv.append( {"grado": g,"RMSE_pliegues (mano)": np.round(manual[g], 3),"media_mano": manual[g].mean(),"DE_mano": manual[g].std(ddof=1),"media_sklearn": sk[g].mean(),"¿coinciden?": np.allclose(manual[g], sk[g]), } )print(pd.DataFrame(filas_cv).round(3).to_string(index=False))print()print("Pliegues grado 4: ", np.round(manual[4], 3))print("Pliegues grado 12:", np.round(manual[12], 3))print(f"Grado 4: media de los RMSE por pliegue = {manual[4].mean():.3f}; "f"raíz del MSE medio = {np.sqrt(np.mean(manual[4] **2)):.3f}")print()print("Misma CV con ocho semillas de partición (media de los 5 pliegues y peor pliegue)")filas_sem = []for seed inrange(8): p4 = rmse_kfold(4, X_all, y, k=5, seed=seed) p12 = rmse_kfold(12, X_all, y, k=5, seed=seed) filas_sem.append( {"semilla": seed,"media grado 4": p4.mean(),"peor grado 4": p4.max(),"media grado 12": p12.mean(),"peor grado 12": p12.max(), } )print(pd.DataFrame(filas_sem).round(3).to_string(index=False))
 grado                RMSE_pliegues (mano)  media_mano  DE_mano  media_sklearn  ¿coinciden?
     1   [1.02, 0.648, 0.752, 0.63, 0.841]       0.778    0.160          0.778         True
     4 [0.362, 0.411, 0.313, 0.311, 0.222]       0.324    0.070          0.324         True
    12 [0.271, 0.328, 0.709, 0.199, 0.236]       0.349    0.207          0.349         True

Pliegues grado 4:  [0.362 0.411 0.313 0.311 0.222]
Pliegues grado 12: [0.271 0.328 0.709 0.199 0.236]
Grado 4: media de los RMSE por pliegue = 0.324; raíz del MSE medio = 0.330

Misma CV con ocho semillas de partición (media de los 5 pliegues y peor pliegue)
 semilla  media grado 4  peor grado 4  media grado 12  peor grado 12
       0          0.324         0.411           0.349          0.709
       1          0.319         0.384           0.328          0.651
       2          0.353         0.461           0.427          1.074
       3          0.322         0.368           0.385          0.781
       4          0.311         0.451           0.575          1.905
       5          0.294         0.372           0.396          0.860
       6          0.308         0.359           0.346          0.655
       7          0.310         0.333           0.472          0.748
La media ordena candidatos, y la DE y el peor pliegue dicen si esa media resume cinco cifras parecidas o esconde un pliegue malo. El grado 1 tiene media 0.778, cerca del baseline, el mismo subajuste de la etapa 3. El grado 4 tiene media 0.324, DE 0.070 y pliegues entre 0.222 y 0.411. El grado 12 tiene media 0.349 y DE 0.207: cuatro pliegues quedan entre 0.199 y 0.328, mejores o parecidos a los del grado 4, y uno sube a 0.709.
Con la semilla 0, las medias de los grados 4 y 12 difieren poco (0.324 y 0.349); lo que separa a los dos modelos es la dispersión, con una DE del grado 12 casi el triple de la del grado 4. La tabla de ocho semillas confirma que no es un accidente de la partición: la media del grado 4 se queda entre 0.29 y 0.35 y su peor pliegue por debajo de 0.5, mientras que la media del grado 12 va de 0.33 a 0.58 y en todas las semillas tiene algún pliegue por encima de 0.6, con uno que llega a 1.9. Descartas el grado 12 por inestabilidad.
La media de los RMSE por pliegue (0.324 en el grado 4) no es la raíz del MSE medio (0.330). Las dos son válidas, siempre que digas cuál reportas; en este capítulo se usa la primera. Tampoco \(k=5\) es obligatorio: con \(k=10\) cada ronda entrena con más filas y evalúa en pliegues más pequeños y más ruidosos, y \(k=n\) (leave-one-out) es el otro extremo. Reportar solo cross_val_score(...).mean() recorta la evidencia; la lista de pliegues, o al menos la DE y el peor pliegue, acompaña a la media.
Ejercicio
Con los cinco RMSE por pliegue del grado 4 (\(0.362,\ 0.411,\ 0.313,\ 0.311,\ 0.222\)), calcula a mano la media, la DE (con divisor \(k-1\)), el error estándar aproximado de la media y la raíz del MSE medio. ¿Por qué la raíz del MSE medio es mayor que la media de los RMSE?
TipOrientaciones
La media es \(1.619/5=0.324\). Las desviaciones respecto de la media son \(0.038\), \(0.087\), \(-0.011\), \(-0.013\) y \(-0.102\); la suma de sus cuadrados es 0.0197, y la DE es \(\sqrt{0.0197/4}=0.070\), como imprime la celda. El error estándar aproximado es \(0.070/\sqrt5=0.031\). Los cuadrados de los RMSE suman 0.544, su promedio es 0.109 y su raíz, 0.330. Es mayor porque la raíz cuadrada es cóncava: promediar primero los cuadrados da más peso a los pliegues con error grande (aquí, el de 0.411), y la raíz de un promedio es mayor o igual que el promedio de las raíces.
Etapa 8: Elegir la complejidad dentro del desarrollo
Reservas una prueba final (30%, 21 filas) y no la tocas. Sobre el 70% restante, el conjunto de desarrollo (49 filas), recorres los grados 1 a 12 con CV de \(k=5\).
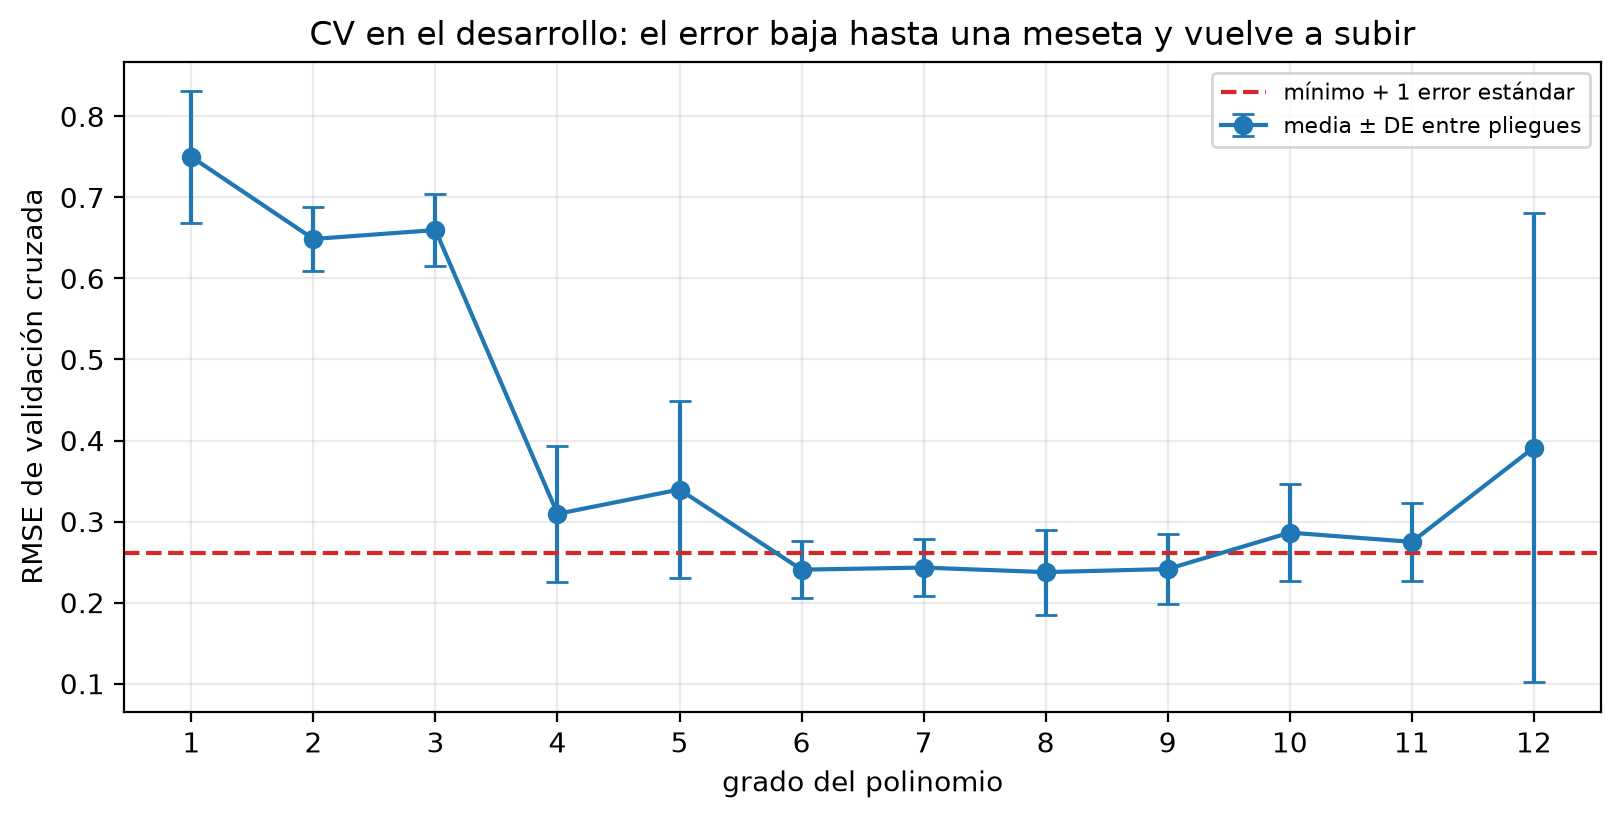
Para elegir usas la regla de un error estándar (Breiman et al., 1984): localizas el grado de menor RMSE medio de CV, calculas su error estándar (\(\mathrm{DE}/\sqrt{k}\)) y eliges el grado más simple cuyo RMSE medio no supere el mínimo más un error estándar. La regla evita decidir por diferencias que la propia CV no distingue. Después mides una sola vez en la prueba final, y la celda repite además la selección con 20 semillas de CV para ver cuánto depende el grado elegido de la partición en pliegues.
x_dev, x_final, y_dev, y_final = train_test_split(x, y, test_size=0.30, random_state=SEMILLA_DESARROLLO)print(f"Filas: {len(x_dev)} de desarrollo y {len(x_final)} de prueba final")grilla =list(range(1, 13))k_cv =5def cv_por_grado(seed): medias, desvs = [], []for g in grilla: sc = rmse_kfold(g, x_dev.reshape(-1, 1), y_dev, k=k_cv, seed=seed) medias.append(sc.mean()) desvs.append(sc.std(ddof=1))return np.array(medias), np.array(desvs)def elegir(medias, desvs):"""Devuelve (grado del mínimo, umbral, grados dentro de un error estándar).""" ee = desvs / np.sqrt(k_cv) i_min =int(np.argmin(medias)) umbral = medias[i_min] + ee[i_min] dentro = [g for g, m_ inzip(grilla, medias) if m_ <= umbral]return grilla[i_min], umbral, dentromedias, desvs = cv_por_grado(seed=1)g_min, umbral, dentro = elegir(medias, desvs)g_star =min(dentro)print(pd.DataFrame({"grado": grilla,"RMSE_CV": medias.round(3),"DE_pliegues": desvs.round(3),"error_estándar": (desvs / np.sqrt(k_cv)).round(3),}).to_string(index=False))print()print("Grado de menor RMSE medio de CV:", g_min, f"(RMSE_CV = {medias[g_min -1]:.3f})")print(f"Umbral = mínimo + 1 error estándar = {umbral:.3f}")print("Grados dentro de un error estándar del mínimo:", dentro)print("Grado elegido (el más simple de ellos):", g_star)m_star = pipe_poli(g_star).fit(x_dev.reshape(-1, 1), y_dev)print()print("RMSE desarrollo (reajuste en todo el 70%) =", round(rmse(y_dev, m_star.predict(x_dev.reshape(-1, 1))), 3))print("RMSE PRUEBA FINAL (una vez) =", round(rmse(y_final, m_star.predict(x_final.reshape(-1, 1))), 3))print("RMSE baseline en prueba final =", round(rmse(y_final, np.full_like(y_final, y_dev.mean())), 3))graficar_cv_grados( grilla, medias, desvs,"CV en el desarrollo: el error baja hasta una meseta y vuelve a subir", umbral=umbral,)minimos, simples = [], []for seed inrange(20): med_s, des_s = cv_por_grado(seed) g_min_s, _, dentro_s = elegir(med_s, des_s) minimos.append(g_min_s) simples.append(min(dentro_s))print("Repetición con 20 semillas de CV (grado: número de semillas)")print(" grado del mínimo: ", pd.Series(minimos).value_counts().sort_index().to_dict())print(" grado por un error estándar: ", pd.Series(simples).value_counts().sort_index().to_dict())
Filas: 49 de desarrollo y 21 de prueba final
 grado  RMSE_CV  DE_pliegues  error_estándar
     1    0.750        0.081           0.036
     2    0.649        0.039           0.017
     3    0.660        0.045           0.020
     4    0.310        0.083           0.037
     5    0.340        0.110           0.049
     6    0.241        0.035           0.016
     7    0.243        0.035           0.016
     8    0.238        0.052           0.023
     9    0.241        0.043           0.019
    10    0.286        0.060           0.027
    11    0.275        0.048           0.021
    12    0.391        0.290           0.130

Grado de menor RMSE medio de CV: 8 (RMSE_CV = 0.238)
Umbral = mínimo + 1 error estándar = 0.261
Grados dentro de un error estándar del mínimo: [6, 7, 8, 9]
Grado elegido (el más simple de ellos): 6

RMSE desarrollo (reajuste en todo el 70%) = 0.197
RMSE PRUEBA FINAL (una vez)             = 0.249
RMSE baseline en prueba final           = 0.943
Repetición con 20 semillas de CV (grado: número de semillas)
  grado del mínimo:              {6: 11, 8: 7, 9: 1, 10: 1}
  grado por un error estándar:   {6: 19, 10: 1}
La curva de la figura no tiene forma de U limpia: baja en escalones, se aplana y vuelve a subir. A la izquierda manda el sesgo, con los grados 1 a 3 entre 0.65 y 0.75. Entre los grados 6 y 9 hay una meseta (0.241, 0.243, 0.238 y 0.241, con DE entre pliegues de 0.035 a 0.052): el mínimo está en el grado 8, pero su ventaja sobre el 6 es de 0.003, muy por debajo del error estándar (0.023), así que la CV no distingue entre esos cuatro grados. A la derecha manda la varianza: el grado 12 sube a 0.391 con una DE de 0.290, porque algún pliegue falla mucho.
Con la regla de un error estándar, el umbral es \(0.238+0.023=0.261\), y dentro de él quedan los grados 6, 7, 8 y 9; ante el empate prefieres el más simple, el grado 6. La repetición con 20 semillas muestra por qué conviene la regla: el grado del mínimo salta entre 6, 8, 9 y 10 según la semilla (el 6 gana en 11 de 20 y el 8 en 7), mientras que la regla elige el 6 en 19 de 20.
El grado 4, el candidato a ojo de la etapa 3, queda atrás con 0.310, por encima del umbral: el dibujo sugería un candidato y la CV, con una rejilla completa, lo corrige. Que el grado 6 gane no lo convierte en el “verdadero” orden de \(f\), que ni siquiera es un polinomio; es el grado más simple que, con este\(n\) y este ruido, generaliza tan bien como el mejor según la CV.
La cifra que publicas es el RMSE de la prueba final, 0.249, junto al grado, la curva de CV y el baseline en esas mismas filas (0.943). El RMSE del desarrollo reajustado (0.197) no se publica como desempeño, porque es un error de entrenamiento.
Etapa 9: Fuga, elegir el grado mirando la prueba
Haces lo prohibido: entrenas cada grado del 1 al 12 en un conjunto A y eliges el de menor RMSE en la prueba B. Después comparas ese RMSE de B con el error real del mismo modelo, que en una simulación puedes medir pidiéndole al generador una muestra nueva y grande, que no participó ni en el ajuste ni en la elección.
La celda hace dos cosas. Primero, un ejemplo con la muestra del capítulo: 35 filas entrenan (A), 17 hacen de prueba (B) y el error real se mide en 20 000 puntos nuevos. Después, 200 réplicas del mismo procedimiento con muestras nuevas, para saber con qué frecuencia y en cuánto el RMSE de B del ganador subestima su error real; como control registras también el grado 4 fijado de antemano. Llamas optimismo a la diferencia entre el error real y el RMSE de B.
# 1) Un ejemplo con la muestra del capítulox_a, x_rest, y_a, y_rest = train_test_split(x, y, test_size=0.50, random_state=SEMILLA_CORTE_A)x_b, _, y_b, _ = train_test_split(x_rest, y_rest, test_size=0.50, random_state=SEMILLA_CORTE_B)x_nueva, y_nueva, _ = generar_curva(20000, seed=SEMILLA_POBLACION)rmse_b, rmse_real = [], []for g in grilla: m = pipe_poli(g).fit(x_a.reshape(-1, 1), y_a) rmse_b.append(rmse(y_b, m.predict(x_b.reshape(-1, 1)))) rmse_real.append(rmse(y_nueva, m.predict(x_nueva.reshape(-1, 1))))i_fuga =int(np.argmin(rmse_b))g_fuga = grilla[i_fuga]print(f"Ejemplo: A = {len(x_a)} filas, B = {len(x_b)} filas, muestra nueva = {len(x_nueva)} puntos")print(pd.DataFrame({"grado": grilla, "RMSE_B": np.round(rmse_b, 3), "RMSE_real": np.round(rmse_real, 3)}).to_string(index=False))print()print(f"Grado que 'gana' en B: {g_fuga} RMSE_B = {rmse_b[i_fuga]:.3f} error real = {rmse_real[i_fuga]:.3f}"f" optimismo = {rmse_real[i_fuga] - rmse_b[i_fuga]:.3f}")# 2) El mismo procedimiento, 200 veces, con muestras nuevasR =200optimismo, optimismo_g4, ganadores = [], [], []for r inrange(R): xa, ya, _ = generar_curva(35, seed=5000+3* r) xb, yb, _ = generar_curva(17, seed=5001+3* r) xn, yn, _ = generar_curva(5000, seed=5002+3* r) en_b, real = [], []for g in grilla: m = pipe_poli(g).fit(xa.reshape(-1, 1), ya) en_b.append(rmse(yb, m.predict(xb.reshape(-1, 1)))) real.append(rmse(yn, m.predict(xn.reshape(-1, 1)))) j =int(np.argmin(en_b)) ganadores.append(grilla[j]) optimismo.append(real[j] - en_b[j]) optimismo_g4.append(real[3] - en_b[3])optimismo, optimismo_g4 = np.array(optimismo), np.array(optimismo_g4)print()print(f"{R} réplicas. Optimismo = error real − RMSE_B")print(f" Grado elegido con B: subestima en el {100* np.mean(optimismo >0):.0f}% de las réplicas;"f" mediana = {np.median(optimismo):.3f}; media = {np.mean(optimismo):.3f}")print(f" Grado 4 fijado antes: subestima en el {100* np.mean(optimismo_g4 >0):.0f}% de las réplicas;"f" mediana = {np.median(optimismo_g4):.3f}; media = {np.mean(optimismo_g4):.3f}")print(f" Réplicas con optimismo mayor que 0.5 (grado elegido): {int(np.sum(optimismo >0.5))}")print(" Grados elegidos (grado: réplicas):", pd.Series(ganadores).value_counts().sort_index().to_dict())
Ejemplo: A = 35 filas, B = 17 filas, muestra nueva = 20000 puntos
 grado  RMSE_B  RMSE_real
     1   0.708      0.731
     2   0.686      0.657
     3   0.682      0.654
     4   0.308      0.325
     5   0.311      0.327
     6   0.221      0.309
     7   0.225      0.308
     8   0.227      0.322
     9   0.236      0.310
    10   0.221      0.316
    11   0.305      0.418
    12   0.716      1.487

Grado que 'gana' en B: 6   RMSE_B = 0.221   error real = 0.309   optimismo = 0.088

200 réplicas. Optimismo = error real − RMSE_B
  Grado elegido con B:   subestima en el 74% de las réplicas; mediana = 0.038; media = 0.097
  Grado 4 fijado antes:  subestima en el 56% de las réplicas; mediana = 0.012; media = 0.009
  Réplicas con optimismo mayor que 0.5 (grado elegido): 7
  Grados elegidos (grado: réplicas): {4: 29, 5: 21, 6: 60, 7: 33, 8: 21, 9: 11, 10: 11, 11: 9, 12: 5}
En B, el menor RMSE es el del grado 6, 0.221 (el grado 10 queda a menos de una milésima, 0.2210 frente a 0.2207), y medido en 20 000 puntos nuevos ese mismo modelo tiene un RMSE de 0.309. Quien publique 0.221 está publicando el mínimo de doce intentos, y el mínimo de varios errores de prueba está sesgado hacia abajo: parte de lo que lo hizo ganar fue que el ruido de esas 17 filas le favoreció. En este ejemplo, el RMSE de B queda por debajo del error real en diez de los doce grados.
Un ejemplo podría ser casualidad, y por eso repites 200 veces. Cuando eliges el grado con B, su RMSE subestima el error real en el 74% de las réplicas, con una mediana del optimismo de 0.038. La media es mayor, 0.097, porque en 7 de las 200 réplicas el grado ganador extrapola muy mal en los bordes y su error real se dispara (optimismo mayor que 0.5). El control muestra que el problema es la selección y no el tamaño de B: con el grado 4 fijado de antemano, el RMSE de B subestima en el 56% de las réplicas y la mediana del optimismo es 0.012. El sesgo es modesto en este ejemplo, y crece con el número de candidatos comparados y con una prueba más pequeña.
El grado elegido con B puede ser un modelo razonable; lo que queda invalidado es la cifra, porque el RMSE de B ya no es independiente de la decisión. Si elegiste el grado (o el umbral, o las variables) con la prueba, ya no hay cifra de prueba, y tienes que reservar otro conjunto o declarar el sesgo.
Etapa 10: Bootstrap, cuánto varía el RMSE de prueba
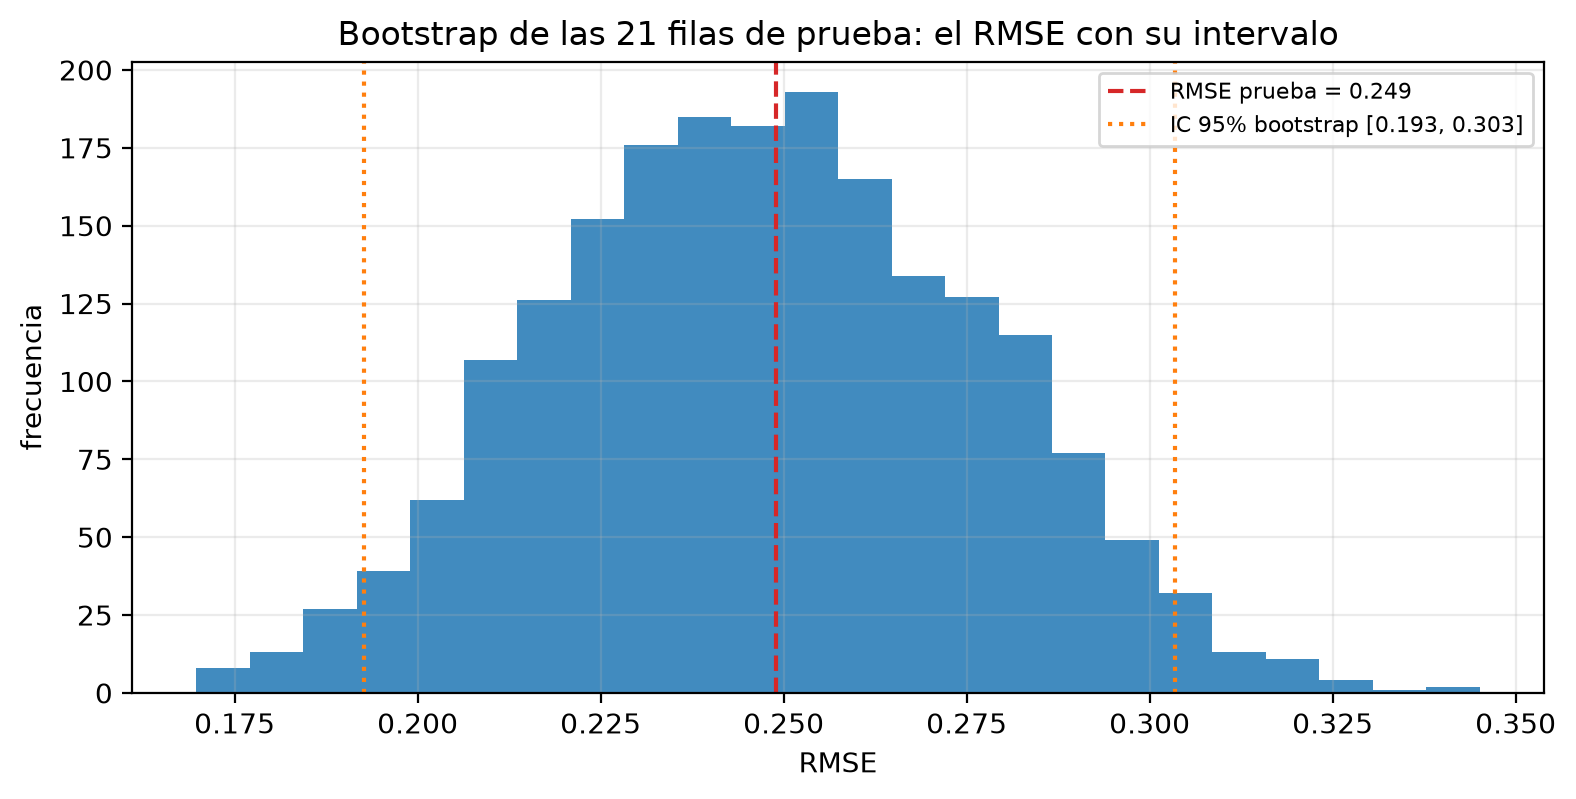
Tomas el grado 6 elegido en la etapa 8, ya ajustado en el desarrollo, y remuestreas las 21 filas de la prueba final con reemplazo \(B=2000\) veces, recalculando el RMSE en cada remuestra. El intervalo va de los percentiles 2.5 a 97.5 y responde una pregunta: si la prueba hubiera sido otra muestra de este tamaño y de esta población, en qué rango caería el RMSE de este modelo.
En el mismo bucle calculas la diferencia entre el RMSE del baseline y el del modelo sobre las mismas filas remuestreadas. Como los dos se evalúan en las mismas filas, la comparación correcta es el intervalo de esa diferencia (comparación pareada): si excluye el 0, el modelo gana al baseline más allá del azar de la prueba. Al final haces dos comprobaciones que solo permite una simulación, el RMSE del ruido en esas 21 filas y el error del modelo en 20 000 puntos nuevos.
yhat_final = m_star.predict(x_final.reshape(-1, 1))base_final = np.full_like(y_final, y_dev.mean())rmse_puntual = rmse(y_final, yhat_final)rmse_base_final = rmse(y_final, base_final)B =2000rng_boot = np.random.default_rng(SEMILLA_BOOTSTRAP)boot, boot_dif = [], []for _ inrange(B): idx = rng_boot.integers(0, len(y_final), size=len(y_final)) r_modelo = rmse(y_final[idx], yhat_final[idx]) boot.append(r_modelo) boot_dif.append(rmse(y_final[idx], base_final[idx]) - r_modelo)boot, boot_dif = np.array(boot), np.array(boot_dif)lo_b, hi_b = graficar_hist_bootstrap( boot, rmse_puntual,f"Bootstrap de las {len(y_final)} filas de prueba: el RMSE con su intervalo",)lo_dif, hi_dif = np.percentile(boot_dif, [2.5, 97.5])print(f"RMSE puntual (prueba final, n = {len(y_final)}) = {rmse_puntual:.3f}")print(f"IC 95% bootstrap (B = {B}) = [{lo_b:.3f}, {hi_b:.3f}] anchura = {hi_b - lo_b:.3f}")print(f"Baseline en esa prueba = {rmse_base_final:.3f}")print(f"Diferencia baseline − modelo = {rmse_base_final - rmse_puntual:.3f} IC 95% [{lo_dif:.3f}, {hi_dif:.3f}]")print()f_final = np.sin(1.2* x_final) +0.12* x_finalx_nueva, y_nueva, _ = generar_curva(20000, seed=SEMILLA_POBLACION)print("Comprobaciones posibles solo en la simulación (σ = 0.28)")print(f" RMSE del ruido en las {len(y_final)} filas de prueba (y − f real) = {rmse(y_final, f_final):.3f}")print(f" RMSE del mismo modelo en 20 000 puntos nuevos = {rmse(y_nueva, m_star.predict(x_nueva.reshape(-1, 1))):.3f}")
RMSE puntual (prueba final, n = 21) = 0.249
IC 95% bootstrap (B = 2000)            = [0.193, 0.303]   anchura = 0.111
Baseline en esa prueba               = 0.943
Diferencia baseline − modelo         = 0.694   IC 95% [0.477, 0.882]

Comprobaciones posibles solo en la simulación (σ = 0.28)
  RMSE del ruido en las 21 filas de prueba (y − f real) = 0.251
  RMSE del mismo modelo en 20 000 puntos nuevos       = 0.301
El RMSE puntual, 0.249, es el de esta prueba, y el intervalo bootstrap del 95% va de 0.193 a 0.303 (el histograma marca los dos extremos): con 21 filas, la cifra tiene una holgura de unas cinco centésimas hacia cada lado, y una exigencia de “RMSE \(<0.30\)” no queda asegurada, porque el límite superior está en torno a 0.30. La diferencia con el baseline es 0.694, con un intervalo de 0.477 a 0.882, muy lejos de 0, así que el modelo gana al baseline sin ambigüedad.
Este intervalo solo mide el azar de qué 21 filas cayeron en la prueba, con el modelo fijo. No incluye lo que cambiaría con otro conjunto de entrenamiento ni con otra elección de grado, y con tan pocas filas tiende a quedar corto, como ilustran las dos comprobaciones. El 0.249 está por debajo de \(\sigma=0.28\), porque el ruido de estas 21 filas resultó algo menor que el promedio (su RMSE es 0.251): a la prueba le tocaron filas favorables. Y en 20 000 puntos nuevos, el mismo modelo tiene un RMSE de 0.301, prácticamente en el límite superior del intervalo y lejos del 0.249 puntual.
El bootstrap no aporta datos nuevos, no reemplaza una prueba de otro mes ni corrige un sesgo de fuga. Lo que citas es RMSE \(=0.249\) (IC bootstrap 95% \([0.193,\,0.303]\)), \(n_{\mathrm{prueba}}=21\); baseline 0.943, porque sin el intervalo el 0.249 aparenta más precisión de la que tiene.
Etapa 11: Curvas de aprendizaje, ¿falta modelo o faltan filas?
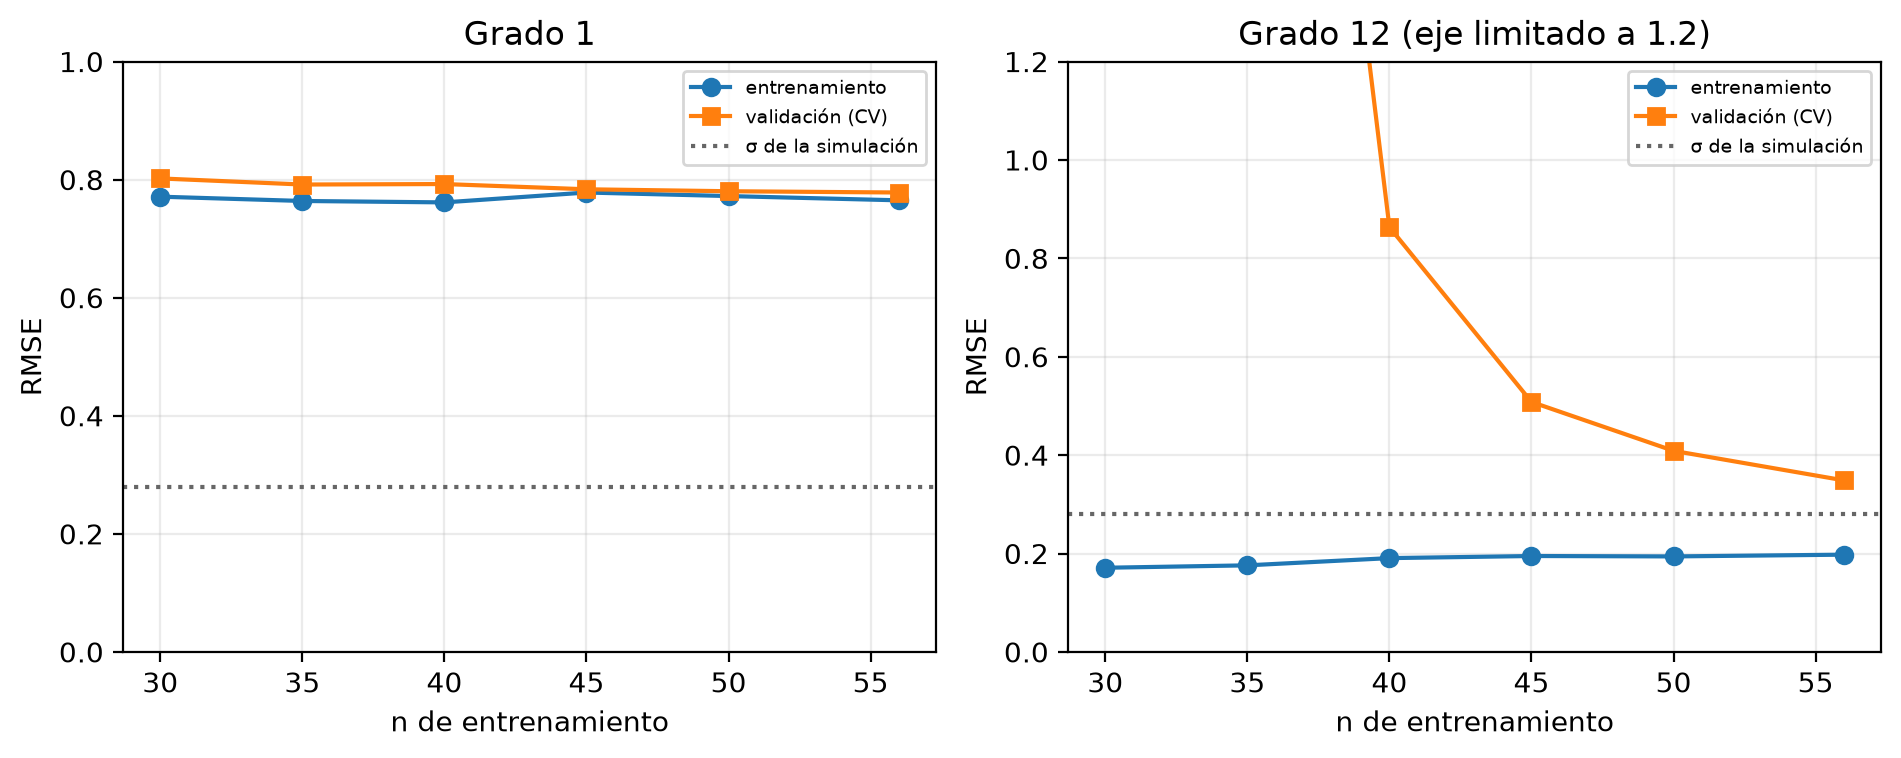
Variar el tamaño del entrenamiento y mirar el RMSE de entrenamiento y el de validación (CV de 5 pliegues sobre las 70 filas) separa tres patrones. Si el entrenamiento es bajo, la validación alta y las dos se acercan al crecer \(n\), hay un sobreajuste que más datos pueden cerrar. Si las dos son altas y ya están juntas, hay subajuste, y más filas no arreglan la clase de modelo. Si el error de entrenamiento sube, el de validación baja y se juntan cerca de \(\sigma\), el régimen es sano.
Comparas el grado 1 y el grado 12 con tamaños de entrenamiento de 30 a 56 filas. Con menos de unas 30 filas, el grado 12 (13 coeficientes) dispone de apenas una o dos filas por coeficiente y su error de validación se dispara, así que la curva empieza en \(n=30\). Cada panel tiene su propio eje vertical, y el del grado 12 se limita a 1.2; los puntos de validación que quedan por encima se leen en la tabla.
 n de entrenamiento  grado 1 entrenamiento  grado 1 validación  grado 12 entrenamiento  grado 12 validación
                 30                  0.771               0.802                   0.171                2.477
                 35                  0.764               0.792                   0.176                3.233
                 40                  0.761               0.793                   0.191                0.863
                 45                  0.778               0.784                   0.195                0.508
                 50                  0.772               0.780                   0.194                0.409
                 56                  0.765               0.778                   0.198                0.349
En el panel del grado 1, las dos curvas están altas y juntas en todo el rango: el error de entrenamiento se queda entre 0.76 y 0.78 y el de validación entre 0.78 y 0.80, casi tres veces \(\sigma\). Pasar de 30 a 56 filas no mueve ninguna de las dos: es subajuste, y más datos no lo arreglan.
En el del grado 12, el error de entrenamiento es bajo y sube despacio con \(n\), de 0.17 a 0.20, siempre por debajo de \(\sigma\). El de validación arranca fuera del eje (2.477 con 30 filas y 3.233 con 35), baja a 0.863 con 40 y a 0.349 con 56. El hueco se cierra a medida que entran filas: es sobreajuste por falta de datos, y con \(n=56\) todavía queda un hueco de unas quince centésimas.
La pregunta de producto “¿conviene conseguir más datos o cambiar el modelo?” se responde con esta figura. Si las curvas ya se juntaron por encima del error tolerable, la limitación es el modelo; si hay un hueco que se estrecha con \(n\), la limitación es el tamaño de muestra.
Etapa 12: Caso real, Diabetes
Son \(n=442\) pacientes con \(D=10\) variables clínicas numéricas, e \(y\) es un índice de progresión de la enfermedad a un año. Es el conjunto de Efron, Hastie, Johnstone y Tibshirani (2004) del capítulo 13, y aquí no conoces \(f\): lo que puedes hacer bien es el protocolo.
Este capítulo salda una deuda del capítulo 13. Allí ajustaste una recta con una sola variable, el índice de masa corporal (IMC), sobre los 442 pacientes, y publicaste RMSE \(=62.4\) y \(R^2=0.344\) con una advertencia: se midieron en las mismas filas del ajuste. El capítulo 13 cargó los datos con load_diabetes(scaled=False) (IMC en kg/m²), y aquí load_diabetes() entrega las variables centradas y reescaladas; para una recta de mínimos cuadrados, ese cambio de escala modifica los coeficientes y deja iguales las predicciones, así que las cifras son comparables.
Comparas cuatro candidatos:
Baseline: la media de \(y\).
Recta con solo IMC: el modelo del capítulo 13.
Lineal con las 10 variables:\(\hat y=b_0+b_1x_1+\dots+b_{10}x_{10}\), la regresión lineal múltiple con la que empieza el nivel Avanzado; aquí la usas como caja cerrada y solo importa su error fuera de la muestra.
Polinomio de grado 2: las 10 variables, sus cuadrados y todos los productos de dos variables, 65 columnas con riesgo de varianza.
Todos llevan un StandardScaler dentro del pipeline, ajustado solo con las filas de entrenamiento. En mínimos cuadrados sin regularización estandarizar no altera las predicciones, pero lo dejas en el pipeline porque es el hábito correcto y será indispensable con regularización. Separas una prueba del 25%, una vez; eliges entre candidatos con CV de \(k=5\)en el 75% de desarrollo, y después haces el bootstrap del RMSE de prueba del modelo elegido.
diab = load_diabetes()Xd, yd = diab.data, diab.targetcol_imc = [diab.feature_names.index("bmi")]print("n =", Xd.shape[0], " p =", Xd.shape[1], " y: min/mediana/max =",int(yd.min()), int(np.median(yd)), int(yd.max()))recta_442 = LinearRegression().fit(Xd[:, col_imc], yd)pred_442 = recta_442.predict(Xd[:, col_imc])print(f"Recta con solo IMC, ajustada y medida en los 442 pacientes (capítulo 13): "f"RMSE = {rmse(yd, pred_442):.1f}, R² = {r2_score(yd, pred_442):.3f}")Xd_dev, Xd_te, yd_dev, yd_te = train_test_split(Xd, yd, test_size=0.25, random_state=SEMILLA)print(f"Filas: {len(yd_dev)} de desarrollo y {len(yd_te)} de prueba")def pipe_lin():return Pipeline([("esc", StandardScaler()), ("lin", LinearRegression())])def pipe_poly2():return Pipeline( [ ("esc", StandardScaler()), ("poli", PolynomialFeatures(2, include_bias=False)), ("lin", LinearRegression()), ] )kf = KFold(n_splits=5, shuffle=True, random_state=SEMILLA)def cv_rmse(estimator, X, y): sc =-cross_val_score(estimator, X, y, cv=kf, scoring="neg_root_mean_squared_error")return sccv_imc = cv_rmse(pipe_lin(), Xd_dev[:, col_imc], yd_dev)cv_lin = cv_rmse(pipe_lin(), Xd_dev, yd_dev)cv_p2 = cv_rmse(pipe_poly2(), Xd_dev, yd_dev)print()print("CV en desarrollo (no se tocó la prueba); EE = DE/√5")for nombre, sc in [("recta IMC", cv_imc), ("lineal ", cv_lin), ("poli-2 ", cv_p2)]:print(f" {nombre} pliegues = {np.round(sc, 2)} media = {sc.mean():.2f} DE = {sc.std(ddof=1):.2f}"f" EE = {sc.std(ddof=1) / np.sqrt(5):.2f}")print(" columnas del poli-2 =", pipe_poly2().fit(Xd_dev, yd_dev).named_steps["poli"].n_output_features_)
n = 442   p = 10   y: min/mediana/max = 25 140 346
Recta con solo IMC, ajustada y medida en los 442 pacientes (capítulo 13): RMSE = 62.4, R² = 0.344
Filas: 331 de desarrollo y 111 de prueba

CV en desarrollo (no se tocó la prueba); EE = DE/√5
  recta IMC pliegues = [63.53 65.13 56.26 64.26 67.32]   media = 63.30   DE = 4.18   EE = 1.87
  lineal    pliegues = [57.28 58.26 49.9  57.24 57.91]   media = 56.12   DE = 3.50   EE = 1.57
  poli-2    pliegues = [70.69 58.28 54.61 72.93 64.66]   media = 64.23   DE = 7.84   EE = 3.50
  columnas del poli-2 = 65
Antes de mirar la prueba, la CV en las 331 filas de desarrollo ordena a los candidatos así: lineal con 10 variables 56.12, recta con solo IMC 63.30 y poli-2 64.23. El lineal tiene la menor media y los pliegues más parejos (de 49.90 a 58.26, DE 3.50, error estándar aproximado 1.57). El poli-2 usa 65 columnas contra 331 filas, y su media es peor que la del lineal con una DE más del doble (7.84) y pliegues de 54.61 a 72.93: es el mismo patrón del grado 12, ahora por número de columnas. La recta con IMC queda 7 puntos por encima del lineal, y la regla de un error estándar no cambia la elección, porque el umbral es \(56.12+1.57=57.69\) y ningún candidato más simple queda por debajo.
La celda siguiente elige el de menor media de CV, lo evalúa una vez en prueba junto al baseline y a los otros candidatos (solo como referencia) y hace el bootstrap con \(B=2000\), remuestreando en el mismo bucle las diferencias de RMSE entre cada alternativa y el modelo elegido sobre las mismas filas.
medias_cv = {"recta IMC": cv_imc.mean(), "lineal": cv_lin.mean(), "poli-2": cv_p2.mean()}elegido_nombre =min(medias_cv, key=medias_cv.get)print("Elegido por CV:", elegido_nombre, "(menor RMSE medio en desarrollo)")todas =list(range(Xd.shape[1]))candidatos = {"recta IMC": (pipe_lin(), col_imc),"lineal": (pipe_lin(), todas),"poli-2": (pipe_poly2(), todas),}dummy_d = DummyRegressor(strategy="mean").fit(Xd_dev, yd_dev)pred_dev = {"baseline": dummy_d.predict(Xd_dev)}pred_te = {"baseline": dummy_d.predict(Xd_te)}for nombre, (modelo, cols) in candidatos.items(): modelo.fit(Xd_dev[:, cols], yd_dev) pred_dev[nombre] = modelo.predict(Xd_dev[:, cols]) pred_te[nombre] = modelo.predict(Xd_te[:, cols])filas_d = []for nombre in pred_te: filas_d.append(ficha(yd_dev, pred_dev[nombre], f"{nombre} / desarrollo")) filas_d.append(ficha(yd_te, pred_te[nombre], f"{nombre} / prueba"))print(pd.DataFrame(filas_d).round(2).to_string(index=False))yhat_te = pred_te[elegido_nombre]rmse_te = rmse(yd_te, yhat_te)otros = [nombre for nombre in pred_te if nombre != elegido_nombre]B =2000rng_d = np.random.default_rng(SEMILLA_DIABETES)boot_d = []boot_dif_d = {nombre: [] for nombre in otros}for _ inrange(B): idx = rng_d.integers(0, len(yd_te), size=len(yd_te)) r_elegido = rmse(yd_te[idx], yhat_te[idx]) boot_d.append(r_elegido)for nombre in otros: boot_dif_d[nombre].append(rmse(yd_te[idx], pred_te[nombre][idx]) - r_elegido)boot_d = np.array(boot_d)lo_d, hi_d = graficar_hist_bootstrap( boot_d, rmse_te,f"Diabetes: bootstrap del RMSE de prueba ({elegido_nombre})",)# residuos de pruebafig, axes = plt.subplots(1, 2, figsize=(9.2, 3.7))axes[0].scatter(yhat_te, yd_te - yhat_te, s=18, alpha=0.7)axes[0].axhline(0, color="C3", linestyle="--")axes[0].set_xlabel("ŷ (prueba)")axes[0].set_ylabel("residuo")axes[0].set_title("Residuos en prueba")axes[1].scatter(yd_te, yhat_te, s=18, alpha=0.7)mn, mx = yd_te.min(), yd_te.max()axes[1].plot([mn, mx], [mn, mx], color="C3", linestyle="--")axes[1].set_xlabel("y (prueba)")axes[1].set_ylabel("ŷ")axes[1].set_title("Predicho frente a observado (diagonal = acierto)")plt.tight_layout()plt.show()print(f"RMSE de prueba, {elegido_nombre} (n = {len(yd_te)}) = {rmse_te:.2f} IC bootstrap 95% [{lo_d:.1f}, {hi_d:.1f}]")print(f"R² de prueba, {elegido_nombre} = {r2_score(yd_te, yhat_te):.3f}")print(f"Diferencias de RMSE en prueba respecto a {elegido_nombre} (mismas filas, B = {B}):")for nombre in otros: lo, hi = np.percentile(boot_dif_d[nombre], [2.5, 97.5])print(f" {nombre:9s} − {elegido_nombre}: {rmse(yd_te, pred_te[nombre]) - rmse_te:6.2f} IC 95% [{lo:.1f}, {hi:.1f}]")print("DE de y (desarrollo) =", round(yd_dev.std(ddof=1), 2), " → el baseline queda cerca de esa cifra")bajos, altos_y = yd_te <100, yd_te >200print(f"Residuo medio en prueba (y − ŷ): y < 100 → {np.mean((yd_te - yhat_te)[bajos]):.1f} (n = {int(bajos.sum())});"f" y > 200 → {np.mean((yd_te - yhat_te)[altos_y]):.1f} (n = {int(altos_y.sum())})")
Elegido por CV: lineal (menor RMSE medio en desarrollo)
                modelo  RMSE     MSE    R2
 baseline / desarrollo 77.75 6044.62  0.00
     baseline / prueba 74.88 5607.20 -0.01
recta IMC / desarrollo 62.70 3930.99  0.35
    recta IMC / prueba 61.45 3775.62  0.32
   lineal / desarrollo 53.92 2907.26  0.52
       lineal / prueba 53.37 2848.31  0.48
   poli-2 / desarrollo 48.87 2388.74  0.60
       poli-2 / prueba 56.42 3183.76  0.42
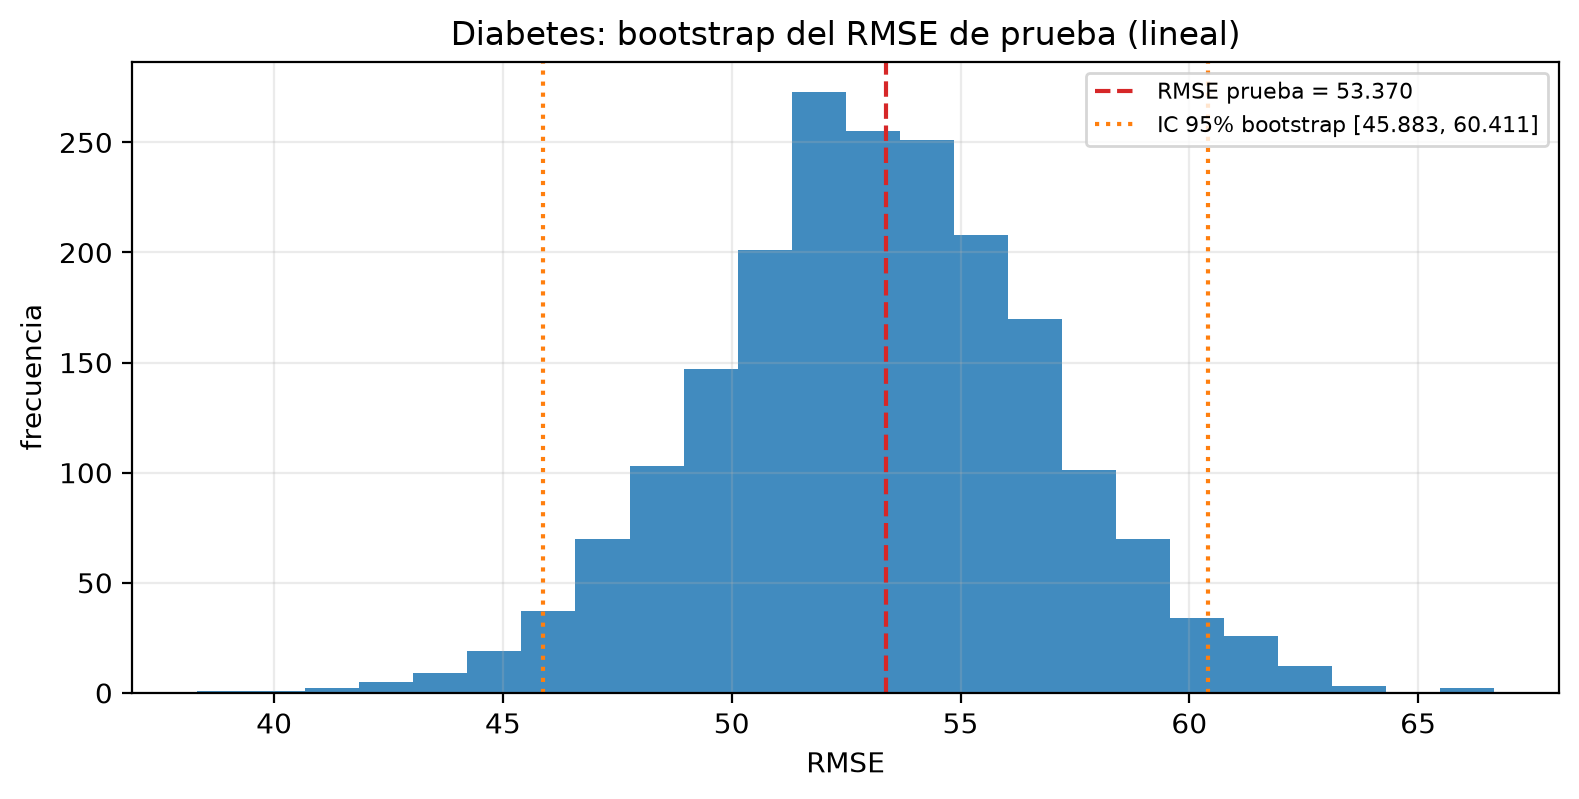
RMSE de prueba, lineal (n = 111) = 53.37   IC bootstrap 95% [45.9, 60.4]
R² de prueba, lineal = 0.485
Diferencias de RMSE en prueba respecto a lineal (mismas filas, B = 2000):
  baseline  − lineal:  21.51   IC 95% [13.4, 29.1]
  recta IMC − lineal:   8.08   IC 95% [2.0, 14.7]
  poli-2    − lineal:   3.06   IC 95% [-2.0, 9.3]
DE de y (desarrollo) = 77.86   → el baseline queda cerca de esa cifra
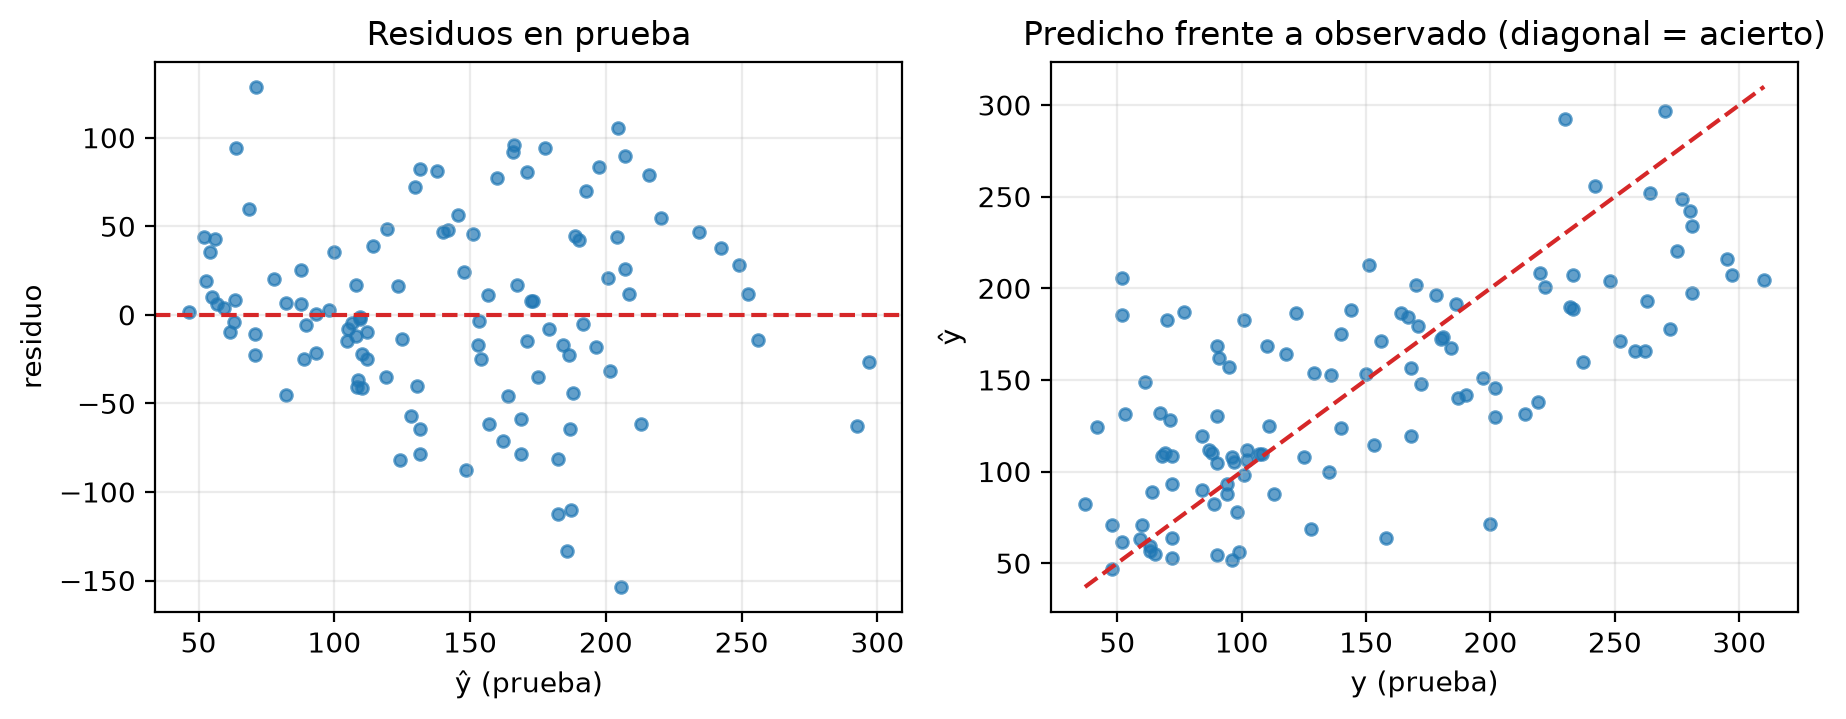
Residuo medio en prueba (y − ŷ): y < 100 → -30.4 (n = 43);   y > 200 → 50.9 (n = 28)
El índice va de 25 a 346, con mediana 140, así que un RMSE de 53.4 es un error típico de unos 53 puntos de ese índice, sin relación con un “53% de error”; si 53 puntos importan clínicamente lo decide quien conoce el dominio, y la estadística entrega la cifra y su incertidumbre.
Predecir la media da un RMSE de 74.88 en prueba, cerca de la DE de \(y\) en desarrollo (77.86), y el lineal baja a 53.37: la diferencia es 21.51, con IC del 95% \([13.4,\,29.1]\), que excluye el 0 con holgura. La recta con solo IMC, que en el capítulo 13 daba RMSE 62.4 y \(R^2\) 0.344 sobre los mismos datos del ajuste, da 61.45 y 0.32 ajustada en desarrollo y medida en prueba: aquella cifra sin validar no era engañosa, porque una recta con dos coeficientes y cientos de filas apenas puede sobreajustar, y ahora está comprobado. Con las diez variables, el RMSE de prueba baja de 61.45 a 53.37, una diferencia de 8.08 con IC del 95% \([2.0,\,14.7]\).
El lineal tiene 53.92 en desarrollo y 53.37 en prueba, sin hueco. El poli-2 tiene el mejor error de desarrollo de la tabla (48.87) y 56.42 en prueba, un hueco de más de 7 puntos, la firma del sobreajuste que la CV había anticipado. Frente al lineal en prueba, la diferencia es 3.06 a favor del lineal con IC \([-2.0,\,9.3]\), que incluye el 0: la prueba sola no distingue a los dos modelos, y la decisión de preferir el lineal descansa en la CV (56.12 frente a 64.23, con pliegues más parejos) y en que es más simple. Los pliegues del lineal (de 49.9 a 58.3) y el IC bootstrap de su RMSE de prueba (de 45.9 a 60.4, en el histograma) coinciden en el orden de magnitud, entre 45 y 60 puntos, así que citar el RMSE con decimales aparenta una precisión que la muestra no da.
En los residuos de prueba, la nube se reparte a ambos lados de 0 sin una curva visible, con algo más de dispersión para \(\hat y\) entre 150 y 220, en línea con la heterocedasticidad que el capítulo 13 encontró para la recta con IMC. En el panel de predicho frente a observado, las predicciones quedan comprimidas hacia el centro: para los 43 pacientes con \(y<100\) el residuo medio es \(-30.4\) (el modelo predice de más) y para los 28 con \(y>200\) es \(+50.9\) (predice de menos), lo esperable con un \(R^2\) de prueba de 0.485, que explica cerca de la mitad de la varianza en pacientes que el modelo no vio.
Eso es evidencia de señal lineal y una referencia para modelos posteriores, insuficiente para un sistema de decisión clínica. No se sigue que el lineal “falle” por tener \(R^2<0.9\) (ese umbral no pertenece a este problema), ni que el poli-2 sea superior por tener más parámetros, ni que los coeficientes digan qué causa la progresión: los datos son observacionales y aquí solo evaluaste la predicción.
Etapa 13: Ficha de veredicto
La ficha se llena con cifras, en seis pasos:
Problema y unidad: qué es \(y\) y qué sería un error tolerable.
Baseline: la cifra de referencia y su conjunto.
Candidatos y protocolo: qué comparaste y dónde elegiste (CV en desarrollo, sin la prueba).
Cifra que citas: la métrica de prueba, \(n_{\mathrm{prueba}}\) y el IC bootstrap; si solo hay CV, media \(\pm\,\mathrm{DE}/\sqrt{k}\), declarada como aproximada.
Hueco y residuos: si hay sobreajuste y si los residuos muestran una forma mal especificada.
Decisión: rechazar, iterar o aceptar con límites, con una frase de límite (población, \(D\), uso no clínico).
La aplicas a Diabetes.
Problema. Predecir el índice de progresión a un año (escala continua, de 25 a 346). El error tolerable lo fija el clínico; aquí usas la DE de \(y\) (77.9 en desarrollo) como ancla.
Baseline. La media de \(y\) en desarrollo: RMSE de prueba de 74.9.
Candidatos. Recta con solo IMC, lineal con 10 variables y poli-2, todos con StandardScaler dentro del pipeline. Elección por RMSE de CV con \(k=5\) en el 75% de desarrollo (56.1, frente a 63.3 de la recta y 64.2 del poli-2); la prueba (25%) no participó.
Cifra. Lineal: RMSE de prueba 53.4, IC bootstrap 95% \([45.9,\,60.4]\), \(R^2\) de prueba 0.485, \(n_{\mathrm{prueba}}=111\).
Hueco. Lineal: 53.9 en desarrollo y 53.4 en prueba, sin hueco. Poli-2: 48.9 y 56.4, sobreajuste por exceso de columnas. Residuos de prueba del lineal centrados en 0, sin curva visible, con predicciones comprimidas hacia la media.
Decisión.Aceptar como referencia estadística, no como herramienta clínica. Gana al baseline con un IC de la diferencia que excluye el 0, no hay hueco entre desarrollo y prueba, el \(R^2\) es moderado y el IC del RMSE tiene unos 15 puntos de ancho. Para iterar: más variables de dominio, otra clase de modelo o más pacientes. El poli-2 queda descartado por la CV.
En \(n=442\) pacientes (\(D=10\)), un modelo lineal con las diez variables se eligió por CV frente a una recta con solo IMC y a un polinomio de grado 2. En la prueba (\(n=111\)) su RMSE es \(53.4\), con IC bootstrap 95% \([45.9,\,60.4]\) y \(R^2=0.485\). Supera al baseline de la media (RMSE \(74.9\)): diferencia \(21.5\), IC 95% \([13.4,\,29.1]\). También mejora a la recta con solo IMC (RMSE \(61.5\); diferencia \(8.1\), IC 95% \([2.0,\,14.7]\)). El \(R^2\) de prueba es moderado: hay señal predictiva, insuficiente para una decisión médica. Limitaciones: una sola partición, \(y\) es un índice sin traducción a unidades clínicas en este capítulo, sin validación temporal ni en otra población.
El modelo es aceptable para un fin (referencia, comparación, enseñanza) y no es aceptable para otro (tratar a un paciente): la pregunta “¿es bueno?” solo tiene respuesta cuando dices para qué.
Errores que conviene nombrar
Publicar el error de entrenamiento como desempeño: el grado 12 tenía 0.171 en entrenamiento y 0.696 en prueba.
Elegir el modelo con la prueba y citar esa misma prueba: en la etapa 9, el ganador quedó subestimado en el 74% de las réplicas.
Declarar un ganador sin baseline.
Ignorar la dispersión de los pliegues o del bootstrap y tratar la media como exacta.
Usar la DE entre pliegues como si fuera un intervalo de confianza de la media.
Confundir un \(R^2\) alto con utilidad. El \(R^2\) no conoce el costo de un error de 50 puntos.
Proponer más flexibilidad cuando las curvas de aprendizaje ya se juntaron arriba (subajuste).
Proponer más datos cuando el modelo es una recta sobre un seno, porque la clase está mal elegida.
Tratar el bootstrap como si añadiera datos. Remuestrea las filas que ya hay.
15.6 Guía rápida: ¿qué protocolo usar?
Situación
Qué usar
Qué mirar
¿Hay alguna señal?
Baseline (media o modelo actual)
El candidato debe ganar en prueba
Primera cifra honesta
Entrenamiento y prueba, una vez
Hueco y unidades
\(n\) pequeño o partición inestable
CV de \(k\) pliegues
Media y DE o peor pliegue
Elegir grado o hiperparámetro
CV en desarrollo
La prueba no participa; ante un empate, el más simple
¿Qué tan precisa es la cifra?
Bootstrap de la métrica de prueba
Anchura del IC
¿Gana a otro modelo en la misma prueba?
Bootstrap de la diferencia (mismas filas)
Si el IC excluye el 0
¿Más datos u otro modelo?
Curvas de aprendizaje
Si se juntan arriba o queda un hueco
¿Memorizó?
Entrenamiento \(\ll\) prueba
Sobreajuste
¿No puede aprender \(f\)?
Entrenamiento ≈ prueba, ambos altos
Subajuste
Al reportar, incluye la métrica, el conjunto (prueba o CV), \(n\), el intervalo o la DE, el baseline y el uso para el que aceptas o rechazas.
15.7 Preguntas de comprensión
Un colega reporta \(R^2=0.96\) con un polinomio de grado 12 y 45 filas. ¿Qué le pides antes de aceptarlo?
En la etapa 6, el RMSE de prueba del mismo modelo fue de 0.261 a 0.809 según la semilla. ¿Qué te dice eso sobre reportar un solo train_test_split?
En la etapa 8, el mínimo de la CV estuvo en el grado 8 y elegiste el 6. ¿Por qué, y qué habría pasado con otra semilla de CV?
¿Por qué el RMSE de B del grado elegido con B subestima el error real, si B no se usó para ajustar?
En Diabetes, la diferencia de RMSE entre el poli-2 y el lineal en prueba tiene IC \([-2.0,\,9.3]\). ¿Con qué argumento prefieres el lineal?
TipOrientaciones
El error en filas que no usó para ajustar, con un baseline. En la etapa 3, el grado 12 tenía \(R^2\) de 0.958 en entrenamiento y 0.251 en prueba, con un hueco de 0.525 en RMSE; un \(R^2\) de entrenamiento no dice nada sobre datos nuevos.
Que una sola partición es una medición ruidosa: con 25 filas de prueba, la cifra depende de qué filas cayeron en cada lado, sobre todo si los extremos de \(x\) quedan fuera del entrenamiento. Conviene promediar con CV o acompañar la cifra con un intervalo.
Porque la ventaja del grado 8 sobre el 6 (0.003) era mucho menor que el error estándar (0.023), y ante diferencias que la CV no distingue prefieres el modelo más simple. Con otras semillas, el mínimo saltó entre 6, 8, 9 y 10, mientras que la regla de un error estándar eligió el 6 en 19 de 20.
Porque B sí se usó para elegir: entre doce candidatos, el que gana en B es el que mejor se adaptó al ruido de esas 17 filas, y el mínimo de varios errores está sesgado hacia abajo. B no participó en los coeficientes, pero sí en la decisión.
Con la CV en desarrollo, que no usó la prueba: 56.12 frente a 64.23, con pliegues más parejos (DE de 3.50 frente a 7.84). A eso se suma el principio de preferir el modelo más simple cuando la prueba no distingue, y el hueco de más de 7 puntos del poli-2 entre desarrollo y prueba.
15.8 Referencias para profundizar
Hastie, T., Tibshirani, R. y Friedman, J. (2009). The Elements of Statistical Learning (2.ª ed.). Springer. El capítulo 7 trata el sesgo y la varianza, la validación cruzada, la regla de un error estándar y el bootstrap.
James, G., Witten, D., Hastie, T. y Tibshirani, R. (2021). An Introduction to Statistical Learning (2.ª ed.). Springer. El capítulo 5 presenta la validación cruzada y el bootstrap con el mismo nivel de este capítulo.
Geman, S., Bienenstock, E. y Doursat, R. (1992). Neural networks and the bias/variance dilemma. Neural Computation, 4(1), 1–58. La descomposición sesgo–varianza aplicada a modelos de aprendizaje automático.
Breiman, L., Friedman, J. H., Olshen, R. A. y Stone, C. J. (1984). Classification and Regression Trees. Wadsworth. El origen de la regla de un error estándar.
Stone, M. (1974). Cross-validatory choice and assessment of statistical predictions. Journal of the Royal Statistical Society: Series B, 36(2), 111–147.
Efron, B. y Tibshirani, R. J. (1993). An Introduction to the Bootstrap. Chapman & Hall.
Varma, S. y Simon, R. (2006). Bias in error estimation when using cross-validation for model selection. BMC Bioinformatics, 7, 91. El optimismo de reutilizar la evaluación que eligió el modelo, como en la etapa 9.
Efron, B., Hastie, T., Johnstone, I. y Tibshirani, R. (2004). Least angle regression. The Annals of Statistics, 32(2), 407–499. Origen del conjunto Diabetes.
Un modelo es aceptable solo respecto a un baseline, un conjunto no visto, una unidad de error y un uso; el error de entrenamiento, una partición afortunada o un grado que ganó en la prueba no cuentan como evidencia.
El grado 12 ganó en entrenamiento (RMSE 0.171) y perdió en prueba (0.696) frente al grado 4 (0.294).
El abanico de 60 muestras hizo visibles el sesgo y la varianza, y sesgo² + varianza + \(\sigma^2\) reprodujo el error simulado (0.129 frente a 0.131 en el grado 4).
Una sola partición es inestable: el RMSE de prueba del grado 4 fue de 0.261 a 0.809 en 25 cortes.
La CV en desarrollo, con la regla de un error estándar, eligió el grado 6 sin tocar la prueba final, donde el RMSE fue 0.249.
Elegir con la prueba vuelve optimista la cifra: el error del ganador quedó subestimado en el 74% de 200 réplicas.
El bootstrap convirtió el 0.249 en un intervalo, de 0.193 a 0.303, que no incluye la variación del entrenamiento.
Las curvas de aprendizaje separaron “faltan filas” (grado 12) de “falla la clase de modelo” (grado 1).
En Diabetes, el lineal con diez variables dejó un RMSE de prueba de 53.4 frente a 74.9 del baseline y 61.5 de la recta con IMC, y se aceptó como referencia, no como herramienta clínica.
15.10 Puente hacia los siguientes capítulos
Con este capítulo termina el nivel Básico. Validar convierte un ajuste, como la recta del capítulo 13 o el clasificador del capítulo 14, en una afirmación sobre datos no vistos, y si la métrica cambia (F1, AUC) el protocolo es el mismo: solo cambia la pérdida \(L\).
El nivel Avanzado empieza con la regresión lineal múltiple, donde el modelo de diez variables que aquí usaste como caja cerrada se abre coeficiente por coeficiente. La regularización agrega un hiperparámetro que se elige con la CV de este capítulo, y los capítulos de evaluación y bootstrap y de validación cruzada k-fold vuelven sobre estas herramientas con más detalle. Cada modelo que venga se medirá igual: con un párrafo de veredicto que incluya baseline, conjunto no visto e incertidumbre.