8  Variables aleatorias y distribuciones de probabilidad

estadistica
probabilidad
distribuciones
Autor/a

Wilder Ramírez Delgado

Fecha de publicación

9 de octubre de 2026

Del evento al número

En el capítulo anterior la probabilidad hablaba de eventos: sale cara, la pieza es defectuosa, el correo es spam. Los datos de un sistema real son números: cuántos requests fallaron hoy, cuántos llegaron en el último minuto, cuántos milisegundos tardó una respuesta. Para llevar la probabilidad a esos números necesitas la variable aleatoria y una descripción de cómo se reparte su probabilidad, la distribución.

En este capítulo trabajas la variable aleatoria, la función de masa y la densidad, la esperanza y la varianza, cuatro distribuciones que aparecen en todo el libro (Bernoulli, binomial, Poisson y normal) y los dos resultados que sostienen la inferencia: la ley de los grandes números y el teorema del límite central. En cada etapa simulas y comparas con la fórmula.

Empiezas con dados para fijar las definiciones y sigues con un servicio de inferencia ficticio: sus requests fallidos, sus llegadas por minuto y sus latencias. Todos los datos son simulados con el generador de NumPy a partir de distribuciones y parámetros que el texto declara en cada etapa.

  • Tiempo estimado de lectura: 75 minutos (unas 3 horas si ejecutas el código y resuelves los ejercicios)
  • Nivel: Básico
  • Conocimientos previos recomendados: el capítulo 7 (probabilidad, condicional e independencia), el capítulo 3 (varianza y desviación estándar) y el capítulo 4 (asimetría, colas y z-score).
  • Tecnologías mencionadas: Python 3.13, NumPy, pandas, SciPy (scipy.stats) y Matplotlib.

Objetivos

Al terminar este capítulo vas a ser capaz de:

  • definir una variable aleatoria y distinguir una discreta de una continua;
  • leer una función de masa y una densidad, y explicar por qué la altura de una densidad no es una probabilidad;
  • calcular la esperanza y la varianza de una variable aleatoria, a mano y por simulación;
  • reconocer cuándo un dato se describe con una Bernoulli, una binomial, una Poisson o una normal, y qué supone cada una;
  • estandarizar una normal y calcular probabilidades y percentiles con SciPy;
  • explicar qué afirman la ley de los grandes números y el teorema del límite central, y cuándo no aplican.

Ejecuta las celdas en orden: las etapas comparten variables y el generador aleatorio rng.

8.1 El lenguaje de las variables aleatorias

Variable aleatoria

Una variable aleatoria es una regla que asigna un número a cada resultado de un experimento aleatorio. Se escribe con mayúscula, \(X\), y un valor observado con minúscula, \(x\). Antes de observar, \(X\) es incierta y solo puedes hablar de la probabilidad de sus valores; después queda un dato fijo. Cada columna numérica de una tabla es una colección de valores observados de una variable aleatoria.

Si lanzas dos dados, el resultado es un par, como \((3,5)\), y la variable aleatoria «suma de los dos dados» le asigna el número 8.

Discreta y continua

  • Una variable discreta toma valores que se pueden contar: 0, 1, 2, … Por ejemplo, el número de requests fallidos en una hora.
  • Una variable continua puede tomar cualquier valor de un intervalo. Por ejemplo, la latencia de una respuesta, 183.27 ms.

La diferencia decide cómo describes la probabilidad: con una función de masa o con una densidad.

Función de masa de probabilidad

Para una variable discreta, la función de masa da la probabilidad de cada valor:

\[ p(x)=P(X=x),\qquad p(x)\ge 0,\qquad \sum_x p(x)=1 . \]

Es la tabla de frecuencias relativas que obtendrías si repitieras el experimento indefinidamente. En un dado equilibrado, \(p(x)=1/6\) para \(x=1,\dots,6\).

Densidad y función de distribución acumulada

Una variable continua tiene infinitos valores posibles, y la probabilidad de acertar uno exacto es cero. La probabilidad se asigna a intervalos, como el área bajo una curva llamada densidad, \(f(x)\):

\[ P(a\le X\le b)=\text{área bajo } f \text{ entre } a \text{ y } b=\int_a^b f(x)\,dx,\qquad \text{área total}=1 . \]

La altura de la densidad indica dónde se concentra la probabilidad, pero no es una probabilidad: puede valer más de 1 siempre que el área total sea 1. Es la versión teórica de un histograma dibujado con área total 1.

La función de distribución acumulada reúne el caso discreto y el continuo en una sola definición:

\[ F(x)=P(X\le x). \]

Con ella, \(P(a<X\le b)=F(b)-F(a)\). Su inversa da los percentiles: el percentil 95 es el valor \(x\) con \(F(x)=0.95\) (en una variable discreta, el menor \(x\) con \(F(x)\ge 0.95\)).

Esperanza

La esperanza es el promedio de los valores de \(X\) ponderado por su probabilidad, y se escribe también \(\mu\):

\[ E[X]=\sum_x x\,p(x)\quad\text{(discreta)},\qquad E[X]=\int x\,f(x)\,dx\quad\text{(continua)}. \]

Es el valor al que tiende el promedio de muchas observaciones, y no tiene por qué ser un valor posible de \(X\): la esperanza de un dado es 3.5.

Varianza y desviación estándar

La varianza es la esperanza de la desviación al cuadrado respecto de \(\mu\):

\[ \mathrm{Var}(X)=E\big[(X-\mu)^2\big]=\sigma^2,\qquad \sigma=\sqrt{\mathrm{Var}(X)} . \]

Son la varianza y la desviación estándar del capítulo 3, ahora como propiedades del modelo y no de una muestra. La media \(\bar x\) y la desviación \(s\) de tus datos son estimaciones de \(\mu\) y \(\sigma\).

Reglas para combinar variables

Para constantes \(a\) y \(b\):

\[ E[aX+b]=a\,E[X]+b,\qquad \mathrm{Var}(aX+b)=a^2\,\mathrm{Var}(X). \]

Para una suma:

\[ E[X+Y]=E[X]+E[Y]\quad\text{(siempre)},\qquad \mathrm{Var}(X+Y)=\mathrm{Var}(X)+\mathrm{Var}(Y)\quad\text{(si son independientes)}. \]

Las varianzas se suman; las desviaciones estándar no.

Cuatro distribuciones con nombre

Una distribución con nombre es una familia de funciones de masa o de densidad que depende de uno o dos parámetros.

Distribución Qué cuenta o mide Parámetros Esperanza Varianza
Bernoulli Un ensayo con dos resultados (1 = éxito, 0 = fracaso) \(p\) \(p\) \(p(1-p)\)
Binomial Número de éxitos en \(n\) ensayos independientes con la misma \(p\) \(n\), \(p\) \(np\) \(np(1-p)\)
Poisson Número de eventos en un intervalo, con tasa constante y eventos independientes \(\lambda\) \(\lambda\) \(\lambda\)
Normal Una magnitud continua simétrica alrededor de su centro \(\mu\), \(\sigma\) \(\mu\) \(\sigma^2\)

Sus fórmulas:

\[ \text{Binomial: } P(X=k)=\binom{n}{k}p^k(1-p)^{n-k},\qquad \text{Poisson: } P(X=k)=\frac{e^{-\lambda}\lambda^k}{k!},\qquad \text{Normal: } f(x)=\frac{1}{\sigma\sqrt{2\pi}}\,e^{-\frac{(x-\mu)^2}{2\sigma^2}} . \]

En la binomial, \(\binom{n}{k}\) cuenta de cuántas maneras puedes ubicar \(k\) éxitos entre \(n\) ensayos:

\[ \binom{n}{k}=\frac{n!}{k!\,(n-k)!},\qquad k!=k\cdot(k-1)\cdots 1,\qquad 0!=1 . \]

Por ejemplo, \(\binom{5}{2}=\dfrac{5\cdot 4}{2\cdot 1}=10\). En la Poisson, \(e\approx 2.718\) es la base de los logaritmos naturales.

Estandarizar una normal

Si \(X\sim\mathcal N(\mu,\sigma^2)\), la variable

\[ Z=\frac{X-\mu}{\sigma} \]

es una normal estándar, con media 0 y desviación 1: el z-score del capítulo 4. Toda pregunta sobre \(X\) se traduce a una pregunta sobre \(Z\). Con \(\mu=200\) ms y \(\sigma=40\) ms, preguntar qué tan probable es superar 260 ms equivale a preguntar qué tan probable es estar a más de 1.5 desviaciones sobre la media. De ahí sale la regla 68–95–99.7: una normal cae a menos de 1, 2 y 3 desviaciones de su media con esas probabilidades aproximadas.

Ley de los grandes números

Si \(X_1,\dots,X_n\) son observaciones independientes de una misma distribución con esperanza \(\mu\), el promedio \(\bar X_n\) se acerca a \(\mu\) cuando \(n\) crece. Esta ley justifica estimar una esperanza con un promedio y una probabilidad con una frecuencia. Dice hacia dónde va el promedio, pero no qué tan rápido.

Teorema del límite central

Con las mismas condiciones y una varianza \(\sigma^2\) finita, para \(n\) grande el promedio se distribuye aproximadamente como una normal, sea cual sea la forma de la distribución original:

\[ \bar X_n\ \approx\ \mathcal N\!\left(\mu,\ \frac{\sigma^2}{n}\right). \]

El promedio de muchas observaciones tiene forma de campana aunque los datos no la tengan, y su desviación estándar es \(\sigma/\sqrt n\). Esa cantidad se llama error estándar y es el punto de partida del capítulo 9. Lo mismo vale para la suma de las \(n\) observaciones: es aproximadamente normal, con media \(n\mu\) y desviación \(\sigma\sqrt n\).

8.2 Por qué importa en IA y machine learning

  • La salida de un clasificador es el parámetro de una distribución. Un modelo que responde 0.8 afirma que la etiqueta es una Bernoulli con \(p=0.8\).
  • Entrenar un modelo es elegir una distribución. La medida de error con que entrenas un modelo equivale a suponer una distribución para la respuesta: normal para magnitudes continuas (error cuadrático), Bernoulli para respuestas de sí o no (pérdida logarítmica), Poisson para conteos.
  • Los conteos de un sistema (errores, llegadas, clics) se describen con binomiales y Poisson, y de ahí salen los umbrales de alerta (etapas 3 y 4).
  • Las métricas son promedios. La proporción de aciertos de un modelo y la latencia media de un servicio heredan del teorema del límite central su forma aproximadamente normal y su error estándar.
  • Simular es sortear valores de una distribución. Los datos sintéticos de este libro, y los que se usan para probar modelos, salen de estas mismas funciones.
  • Vigilar un modelo en producción es comparar lo que anuncian sus probabilidades con lo que ocurre; la etapa 13 lo hace con la esperanza y la varianza de una suma.

Elegir una distribución es declarar qué tipo de número modelas y qué supones de él; de esa elección dependen las probabilidades, las alertas y la función de pérdida.

8.3 Flujo recomendado de trabajo

  1. Di qué número observas y si es un conteo o una magnitud continua.
  2. Elige una distribución candidata y escribe qué supone: independencia, tasa constante, simetría.
  3. Fija sus parámetros, por diseño o estimándolos de los datos.
  4. Calcula la probabilidad, la esperanza o el percentil que responde la pregunta.
  5. Compara el modelo con los datos: frecuencias frente a función de masa, histograma frente a densidad.
  6. Declara qué supuesto es más dudoso y qué pasaría si falla.
  7. Redacta el reporte:

«[Variable, unidad] se modela como [distribución(parámetros)], suponiendo [supuestos]. Con ese modelo, [probabilidad, esperanza o percentil] = [valor]. En [n] observaciones, la frecuencia correspondiente fue [valor]. El supuesto más dudoso es [supuesto]; si falla, [consecuencia].»

Una distribución es un modelo: antes de usar sus probabilidades, revisa si sus supuestos son razonables para tu dato. La etapa 11 llena esta plantilla con los fallos por lote.

8.4 Preparar el entorno

La celda carga NumPy, pandas, Matplotlib y el módulo stats de SciPy, fija un estilo de gráficos y crea el generador rng con la semilla 42. Todas las simulaciones salen de ese generador.

%matplotlib inline
%config InlineBackend.figure_format = "retina"
import sys
print("Python:", sys.version.split()[0])

from math import comb

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

SEMILLA = 42  # semilla central del capítulo
rng = np.random.default_rng(SEMILLA)
plt.rcParams["figure.figsize"] = (8, 5)
plt.rcParams["axes.grid"] = True
plt.rcParams["grid.alpha"] = 0.25
Python: 3.13.14

El entorno queda con Python 3.13.14.

La siguiente celda, plegada en la versión web, define las funciones de gráficos que usan las etapas. Solo dibujan; los cálculos se hacen a la vista en cada etapa.

Funciones de visualización
def graficar_masa(valores, masa, frecuencias, titulo, xlabel, esperanza=None):
    fig, ax = plt.subplots(figsize=(8, 3.9))
    ax.bar(np.asarray(valores) - 0.2, masa, width=0.4, label="función de masa (teoría)")
    ax.bar(np.asarray(valores) + 0.2, frecuencias, width=0.4, color="0.65", label="frecuencia simulada")
    if esperanza is not None:
        ax.axvline(esperanza, color="C3", linestyle="--", label=f"esperanza = {esperanza:g}")
    ax.set_xticks(valores)
    ax.set_xlabel(xlabel)
    ax.set_ylabel("probabilidad")
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_promedio_dado(tiradas, esperanza, titulo):
    n = np.arange(1, len(tiradas) + 1)
    fig, ax = plt.subplots(figsize=(8, 3.6))
    ax.plot(n, np.cumsum(tiradas) / n, linewidth=1)
    ax.axhline(esperanza, color="C3", linestyle="--", label=f"E[X] = {esperanza:g}")
    ax.set_xscale("log")
    ax.set_xlabel("número de tiradas (escala logarítmica)")
    ax.set_ylabel("promedio acumulado")
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_dos_masas(k, masa_a, masa_b, etiqueta_a, etiqueta_b, titulo, xlabel):
    fig, ax = plt.subplots(figsize=(8, 3.8))
    ax.bar(k - 0.2, masa_a, width=0.4, label=etiqueta_a)
    ax.bar(k + 0.2, masa_b, width=0.4, color="C1", label=etiqueta_b)
    ax.set_xticks(k)
    ax.set_xlabel(xlabel)
    ax.set_ylabel("probabilidad")
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_densidad_area(mu, sigma, a, b, datos, titulo):
    xs = np.linspace(mu - 4 * sigma, mu + 4 * sigma, 500)
    fx = stats.norm.pdf(xs, mu, sigma)
    fig, axes = plt.subplots(1, 2, figsize=(11.5, 3.9))
    ax = axes[0]
    ax.hist(datos, bins=60, density=True, alpha=0.35, label="histograma (área total 1)")
    ax.plot(xs, fx, color="C3", label="densidad")
    ax.fill_between(xs, fx, where=(xs >= a) & (xs <= b), color="C3", alpha=0.35, label=f"P({a:g} ≤ X ≤ {b:g})")
    ax.set_xlabel("latencia (ms)")
    ax.set_ylabel("densidad")
    ax.set_title("la probabilidad es un área", fontsize=10)
    ax.legend(fontsize=8)
    ax = axes[1]
    ax.plot(xs, stats.norm.cdf(xs, mu, sigma))
    for v in (a, b):
        ax.plot([v, v], [0, stats.norm.cdf(v, mu, sigma)], color="0.4", linestyle=":")
        ax.plot([xs[0], v], [stats.norm.cdf(v, mu, sigma)] * 2, color="0.4", linestyle=":")
    ax.set_xlabel("latencia (ms)")
    ax.set_ylabel("F(x) = P(X ≤ x)")
    ax.set_title("la misma probabilidad como F(b) − F(a)", fontsize=10)
    fig.suptitle(titulo, fontsize=11)
    plt.tight_layout()
    plt.show()


def graficar_normal_bandas(mu, sigma, umbral, percentil, titulo):
    xs = np.linspace(mu - 4 * sigma, mu + 4 * sigma, 500)
    fx = stats.norm.pdf(xs, mu, sigma)
    fig, ax = plt.subplots(figsize=(8.6, 4))
    ax.plot(xs, fx, color="0.2")
    for k, alfa in ((3, 0.12), (2, 0.2), (1, 0.3)):
        ax.fill_between(xs, fx, where=(xs >= mu - k * sigma) & (xs <= mu + k * sigma), color="C0", alpha=alfa,
                        label=fr"$\mu \pm {k}\sigma$")
    ax.fill_between(xs, fx, where=xs >= umbral, color="C3", alpha=0.6, label=f"P(X > {umbral:g})")
    ax.axvline(percentil, color="C1", linestyle="--", label=f"percentil 95 = {percentil:.1f}")
    ax.set_xlabel("latencia (ms)")
    ax.set_ylabel("densidad")
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    plt.tight_layout()
    plt.show()


def graficar_trayectorias(promedios, referencia, titulo, etiqueta_ref, ylim=None):
    n = np.arange(1, promedios.shape[1] + 1)
    fig, ax = plt.subplots(figsize=(8.4, 3.9))
    for fila in promedios:
        ax.plot(n, fila, linewidth=0.9, alpha=0.8)
    if referencia is not None:
        ax.axhline(referencia, color="0.1", linestyle="--", label=etiqueta_ref)
        ax.legend(fontsize=8)
    ax.set_xscale("log")
    if ylim is not None:
        ax.set_ylim(*ylim)
    ax.set_xlabel("número de observaciones (escala logarítmica)")
    ax.set_ylabel("promedio acumulado")
    ax.set_title(titulo)
    plt.tight_layout()
    plt.show()


def graficar_tlc(datos, medias_por_n, mu, sigma, titulo):
    fig, axes = plt.subplots(1, len(medias_por_n) + 1, figsize=(3.6 * (len(medias_por_n) + 1), 3.5))
    axes[0].hist(datos, bins=60, range=(0, np.quantile(datos, 0.995)), density=True, alpha=0.6)
    axes[0].set_title("una latencia (n = 1)", fontsize=10)
    axes[0].set_ylabel("densidad")
    for ax, (n, medias) in zip(axes[1:], medias_por_n.items()):
        se = sigma / np.sqrt(n)
        xs = np.linspace(mu - 4 * se, mu + 4 * se, 300)
        ax.hist(medias, bins=60, density=True, alpha=0.6, label="medias simuladas")
        ax.plot(xs, stats.norm.pdf(xs, mu, se), color="C3", label="normal del TLC")
        ax.set_title(f"media de n = {n}", fontsize=10)
        ax.legend(fontsize=7)
    for ax in axes:
        ax.set_xlabel("ms")
    fig.suptitle(titulo, fontsize=11)
    plt.tight_layout()
    plt.show()


def graficar_calibracion(tabla, esperado, desviacion, observados, etiquetas, titulo):
    fig, axes = plt.subplots(1, 2, figsize=(11.5, 3.9))
    ax = axes[0]
    ax.plot([0, 0.7], [0, 0.7], color="0.4", linestyle="--", label="calibración perfecta")
    ax.errorbar(tabla["probabilidad media"], tabla["frecuencia observada"], yerr=2 * tabla["error estándar"],
                fmt="o-", capsize=3, label="modelo (± 2 errores estándar)")
    ax.set_xlabel("probabilidad que anunció el modelo")
    ax.set_ylabel("frecuencia observada de positivos")
    ax.set_title("¿el 0.3 del modelo ocurre el 30% de las veces?", fontsize=10)
    ax.legend(fontsize=8)
    ax = axes[1]
    xs = np.linspace(esperado - 5 * desviacion, max(observados) + 2 * desviacion, 400)
    ax.plot(xs, stats.norm.pdf(xs, esperado, desviacion), color="0.2")
    ax.fill_between(xs, stats.norm.pdf(xs, esperado, desviacion),
                    where=(xs >= esperado - 2 * desviacion) & (xs <= esperado + 2 * desviacion),
                    alpha=0.3, label="esperado ± 2 desviaciones")
    for obs, etiqueta, color in zip(observados, etiquetas, ("C2", "C3")):
        ax.axvline(obs, color=color, label=f"{etiqueta}: {obs}")
    ax.set_xlabel("número de positivos en el día")
    ax.set_yticks([])
    ax.set_title("conteo observado frente al que el modelo anuncia", fontsize=10)
    ax.legend(fontsize=8)
    fig.suptitle(titulo, fontsize=11)
    plt.tight_layout()
    plt.show()
8.5 Desarrollo por etapas

Avanzas en 13 etapas, de lo discreto a lo continuo y de una observación a muchas: primero qué es una variable aleatoria y cómo se resume, después las cuatro distribuciones con nombre y al final qué ocurre al promediar. Las tres últimas etapas aplican todo a un reporte, a un cálculo a mano y a la vigilancia de un clasificador.

Etapa 1: Del resultado al número, la suma de dos dados

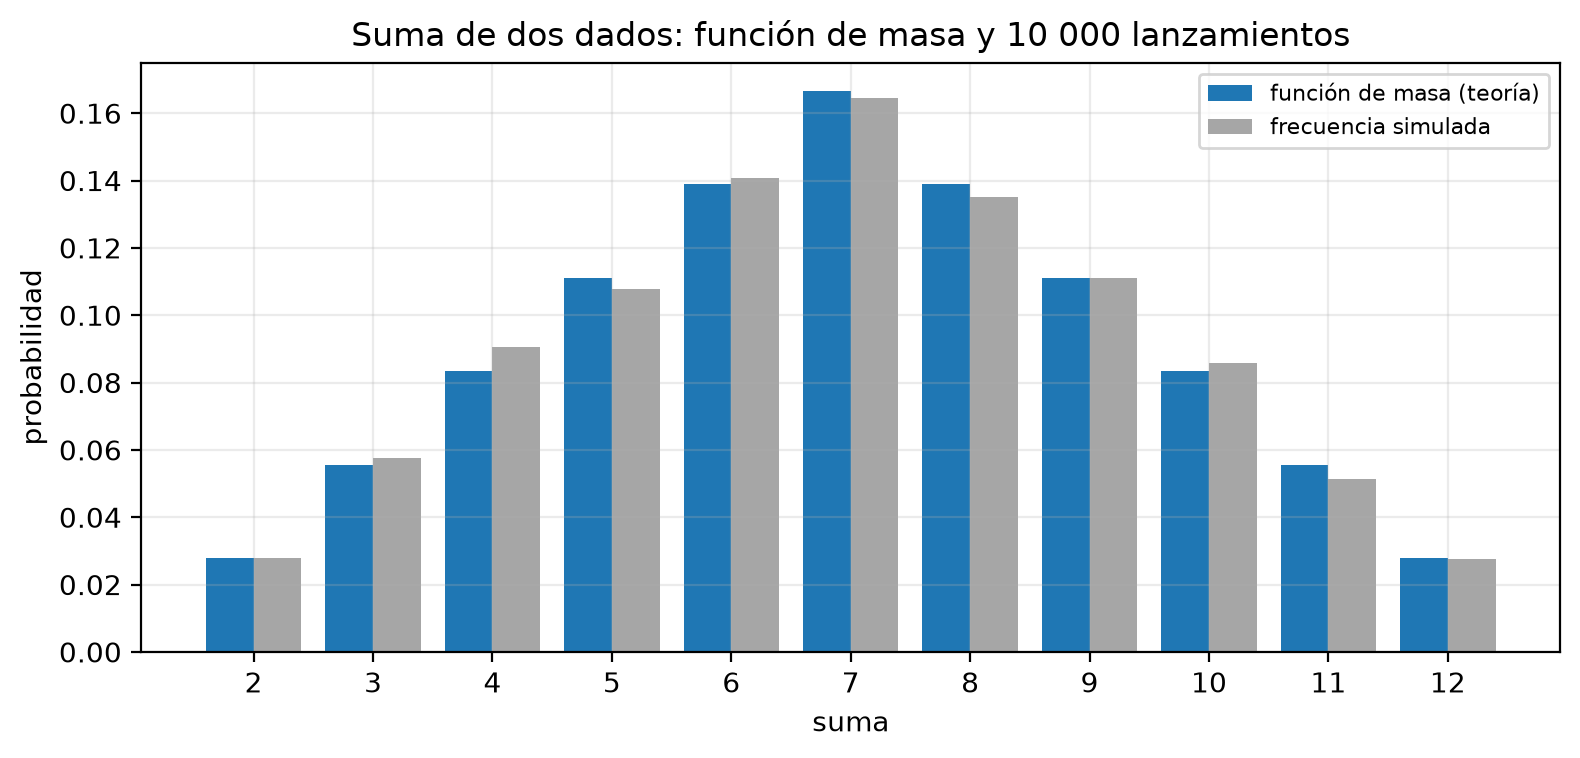
Lanzas dos dados. El espacio muestral tiene 36 resultados igualmente probables, y la variable aleatoria \(X\) = «suma de los dos dados» los agrupa: hay una sola forma de sumar 2 y seis formas de sumar 7. Obtienes su función de masa contando y la comparas con 10 000 lanzamientos simulados con rng.integers(1, 7).

caras = np.arange(1, 7)
sumas_posibles = pd.Series([a + b for a in caras for b in caras])
casos = sumas_posibles.value_counts().sort_index()
masa_suma = casos / 36

lanzamientos = rng.integers(1, 7, size=(10_000, 2)).sum(axis=1)
frecuencia_suma = pd.Series(lanzamientos).value_counts(normalize=True).sort_index()

tabla_suma = pd.DataFrame({"casos de 36": casos, "P(X = x)": masa_suma, "frecuencia simulada": frecuencia_suma})
tabla_suma.index.name = "x"
print(tabla_suma.round(4).to_string())
print()
print("Suma de la función de masa =", round(masa_suma.sum(), 4))
print("Mayor diferencia entre teoría y simulación =", round((masa_suma - frecuencia_suma).abs().max(), 4))
print("P(X ≥ 10) = F(12) − F(9) =", round(masa_suma[masa_suma.index >= 10].sum(), 4))

graficar_masa(masa_suma.index.values, masa_suma.values, frecuencia_suma.values,
              "Suma de dos dados: función de masa y 10 000 lanzamientos", "suma")
    casos de 36  P(X = x)  frecuencia simulada
x                                             
2             1    0.0278               0.0279
3             2    0.0556               0.0575
4             3    0.0833               0.0906
5             4    0.1111               0.1079
6             5    0.1389               0.1408
7             6    0.1667               0.1645
8             5    0.1389               0.1351
9             4    0.1111               0.1109
10            3    0.0833               0.0858
11            2    0.0556               0.0514
12            1    0.0278               0.0276

Suma de la función de masa = 1.0
Mayor diferencia entre teoría y simulación = 0.0073
P(X ≥ 10) = F(12) − F(9) = 0.1667

Barras de la función de masa de la suma de dos dados junto a las frecuencias de 10 000 lanzamientos simulados. Ambas forman un triángulo que sube desde 0.028 en la suma 2 hasta 0.167 en la suma 7 y baja simétricamente hasta 0.028 en la suma 12.

La función de masa sale de contar: 6 de los 36 resultados suman 7, así que \(P(X=7)=6/36=0.1667\); solo uno suma 2, y \(P(X=2)=1/36=0.0278\). Las once probabilidades suman 1. La simulación reproduce la forma triangular, y la mayor diferencia entre una frecuencia y su probabilidad es 0.0073 con 10 000 lanzamientos. Con la función de masa respondes cualquier pregunta sobre \(X\) sumando barras: \(P(X\ge 10)=(3+2+1)/36=0.1667\).

En el capítulo anterior la unidad era el evento («la suma es 7»). Aquí tienes una variable con todos sus valores y sus probabilidades a la vez; los 36 resultados siguen debajo, pero ya no necesitas volver a ellos.

Etapa 2: Esperanza y varianza, el promedio que esperas

Para un solo dado calculas la esperanza y la varianza con la función de masa, multiplicando cada valor por su probabilidad. Después compruebas que el promedio de 100 000 tiradas simuladas se acerca a esa esperanza, y que la suma de dos dados cumple las reglas de la suma.

masa_dado = np.full(6, 1 / 6)
esperanza_dado = (caras * masa_dado).sum()
varianza_dado = ((caras - esperanza_dado) ** 2 * masa_dado).sum()

print("E[X]   = Σ x·p(x)        =", round(esperanza_dado, 4))
print("Var(X) = Σ (x − μ)²·p(x) =", round(varianza_dado, 4), "  desviación estándar =", round(np.sqrt(varianza_dado), 4))

tiradas = rng.integers(1, 7, size=100_000)
print()
for n in (10, 100, 1000, 100_000):
    print(f"Promedio de las primeras {n:>7} tiradas = {tiradas[:n].mean():.4f}")
print("Varianza de las 100 000 tiradas =", round(tiradas.var(), 4))

# La suma de dos dados independientes: se suman las esperanzas y las varianzas
esperanza_suma = (masa_suma.index * masa_suma).sum()
varianza_suma = ((masa_suma.index - esperanza_suma) ** 2 * masa_suma).sum()
print()
print("Suma de dos dados:  E =", round(esperanza_suma, 4), " (2 × 3.5)   Var =", round(varianza_suma, 4),
      " (2 ×", round(varianza_dado, 4), ")")

graficar_promedio_dado(tiradas, esperanza_dado, "El promedio de las tiradas se acerca a la esperanza")
E[X]   = Σ x·p(x)        = 3.5
Var(X) = Σ (x − μ)²·p(x) = 2.9167   desviación estándar = 1.7078

Promedio de las primeras      10 tiradas = 3.0000
Promedio de las primeras     100 tiradas = 3.4600
Promedio de las primeras    1000 tiradas = 3.4900
Promedio de las primeras  100000 tiradas = 3.5062
Varianza de las 100 000 tiradas = 2.9185

Suma de dos dados:  E = 7.0  (2 × 3.5)   Var = 5.8333  (2 × 2.9167 )

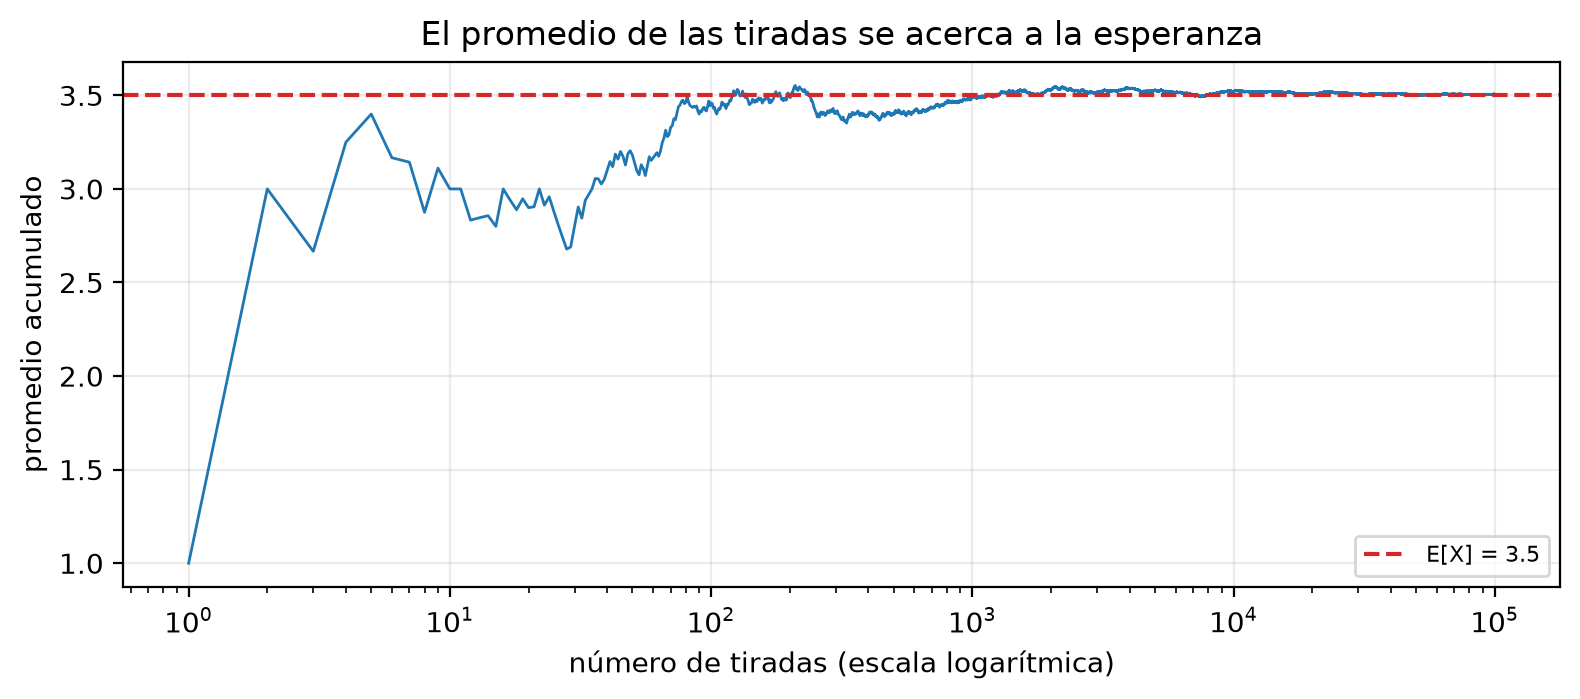
Promedio acumulado de 100 000 tiradas de un dado con el eje horizontal en escala logarítmica. La línea oscila en las primeras decenas de tiradas y se estabiliza sobre la línea discontinua de E[X] = 3.5.

La esperanza de un dado es 3.5 y su varianza 2.9167, con desviación estándar 1.71. El promedio de las tiradas se acerca a ese valor a medida que se acumulan: 3.00 con 10 tiradas, 3.46 con 100, 3.49 con 1000 y 3.506 con 100 000. La varianza de las 100 000 tiradas, 2.9185, queda junto a la teórica. En la figura, con el eje horizontal en escala logarítmica, el promedio acumulado oscila al principio y termina sobre la línea de 3.5.

  • La esperanza no tiene por qué ser un valor posible. Ningún dado muestra 3.5: la esperanza describe el promedio a la larga, no la próxima tirada. En un dado, además, todos los valores son igual de probables, así que no hay un valor más probable que coincida con ella.
  • Las reglas de la suma se cumplen. La suma de dos dados tiene esperanza \(7=2\times3.5\) y varianza \(5.8333=2\times2.9167\). Las calculaste con la función de masa de la etapa 1, sin usar la regla, y coinciden con ella porque los dos dados son independientes.

Etapa 3: Bernoulli y binomial, requests fallidos

Cada request al servicio falla con probabilidad \(p=0.03\). Un request es una Bernoulli: vale 1 si falla y 0 si no. En un lote de \(n=50\) requests independientes, el número de fallos \(X\) es una binomial:

\[ X\sim\text{Binomial}(n=50,\ p=0.03). \]

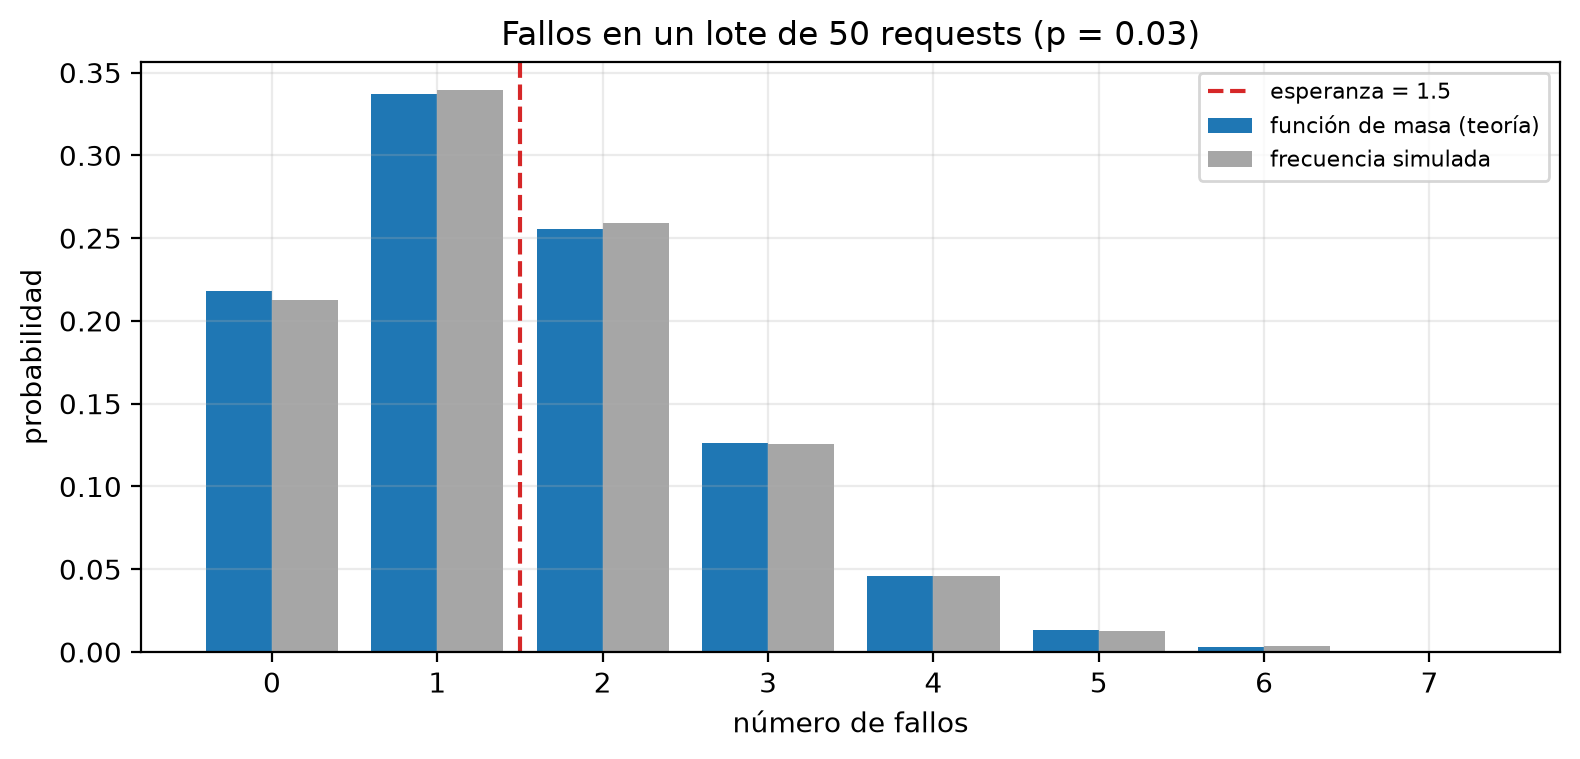
Calculas la función de masa con la fórmula, la verificas con SciPy y con 20 000 lotes simulados con rng.binomial, y respondes una pregunta de operación: qué tan raro es ver 4 fallos o más en un lote.

n_lote, p_fallo = 50, 0.03
k = np.arange(0, 8)

masa_formula = np.array([comb(n_lote, i) * p_fallo ** i * (1 - p_fallo) ** (n_lote - i) for i in k])
masa_scipy = stats.binom.pmf(k, n_lote, p_fallo)
fallos_sim = rng.binomial(n_lote, p_fallo, size=20_000)
frecuencia_fallos = np.array([(fallos_sim == i).mean() for i in k])

print(pd.DataFrame({"fórmula": masa_formula, "SciPy": masa_scipy, "simulación": frecuencia_fallos}, index=k)
      .rename_axis("fallos").round(4).to_string())
print()
print("E[X] = n·p =", n_lote * p_fallo, "   media simulada =", round(fallos_sim.mean(), 4))
print("Var(X) = n·p·(1 − p) =", round(n_lote * p_fallo * (1 - p_fallo), 4), "   varianza simulada =", round(fallos_sim.var(), 4))
print("P(X = 0) = 0.97^50 =", round(0.97 ** 50, 4))
print("P(X ≥ 4) = 1 − F(3) =", round(stats.binom.sf(3, n_lote, p_fallo), 4),
      "   frecuencia simulada =", round((fallos_sim >= 4).mean(), 4))

graficar_masa(k, masa_formula, frecuencia_fallos, "Fallos en un lote de 50 requests (p = 0.03)",
              "número de fallos", esperanza=n_lote * p_fallo)
        fórmula   SciPy  simulación
fallos                             
0        0.2181  0.2181      0.2128
1        0.3372  0.3372      0.3396
2        0.2555  0.2555      0.2593
3        0.1264  0.1264      0.1256
4        0.0459  0.0459      0.0461
5        0.0131  0.0131      0.0126
6        0.0030  0.0030      0.0034
7        0.0006  0.0006      0.0004

E[X] = n·p = 1.5    media simulada = 1.5072
Var(X) = n·p·(1 − p) = 1.455    varianza simulada = 1.442
P(X = 0) = 0.97^50 = 0.2181
P(X ≥ 4) = 1 − F(3) = 0.0628    frecuencia simulada = 0.0628

Barras de la función de masa binomial de los fallos en un lote de 50 requests con p = 0.03, junto a las frecuencias simuladas. La barra más alta está en 1 fallo (0.34), seguida de 2 (0.26) y 0 (0.22); desde 4 fallos las barras son casi nulas. Una línea discontinua marca la esperanza en 1.5.

Las tres columnas coinciden: la fórmula y SciPy dan lo mismo, y la simulación se aparta en el tercer decimal. En un lote de 50 requests con \(p=0.03\):

  • Lo más probable es un fallo (0.337), seguido de dos (0.256) y de ninguno (0.218).
  • Esperas \(np=1.5\) fallos por lote, con varianza 1.455; la simulación da 1.507 y 1.442.
  • \(P(X\ge 4)=0.0628\): alrededor de 1 de cada 16 lotes tendrá cuatro fallos o más sin que nada haya cambiado en el servicio.

Con ese número fijas un umbral de alerta: una alerta que se dispare con 4 fallos por lote sonará en el 6% de los lotes normales. La binomial te deja elegir el umbral sabiendo cuántas falsas alarmas produce.

El modelo supone que los 50 requests son independientes y que todos fallan con la misma probabilidad. Si un fallo vuelve más probable el siguiente, por ejemplo porque una réplica caída afecta a varios requests seguidos, los fallos llegan en rachas, la varianza real supera \(np(1-p)\) y los lotes con muchos fallos son más frecuentes de lo que dice el modelo.

Etapa 4: Poisson, llegadas por minuto

Al servicio llegan, en promedio, 4 requests por minuto. El número de llegadas en un minuto se describe con una Poisson de tasa \(\lambda=4\). A diferencia de la binomial, no hay un número fijo de ensayos: el conteo puede ser 0, 1, 2, … sin tope.

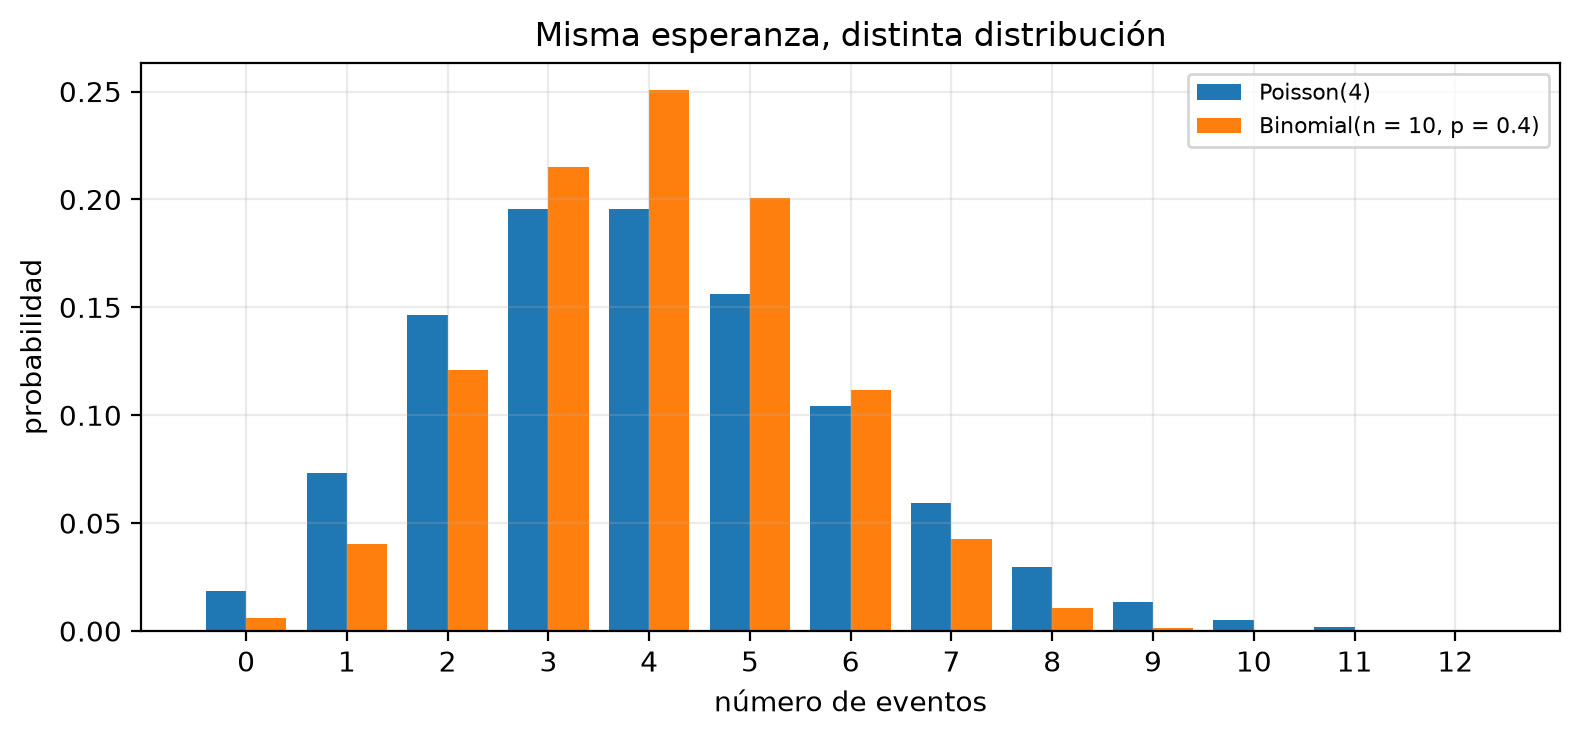
La Poisson aparece como límite de la binomial cuando hay muchos ensayos y cada uno tiene probabilidad pequeña, con \(np=\lambda\). Lo compruebas comparando la Poisson(4) con dos binomiales de esperanza 4: una con \(n=1000\) y \(p=0.004\), y otra con \(n=10\) y \(p=0.4\). También simulas 20 000 minutos con rng.poisson.

tasa = 4
llegadas = rng.poisson(tasa, size=20_000)
k_p = np.arange(0, 13)
masa_poisson = stats.poisson.pmf(k_p, tasa)

print("Media simulada =", round(llegadas.mean(), 4), "   varianza simulada =", round(llegadas.var(), 4), "   (teoría: ambas valen λ = 4)")
print("P(X = 0) =", round(stats.poisson.pmf(0, tasa), 4), "   P(X = 4) =", round(stats.poisson.pmf(4, tasa), 4))
print("P(X ≥ 9) =", round(stats.poisson.sf(8, tasa), 4), "   frecuencia simulada =", round((llegadas >= 9).mean(), 4))

binom_muchos = stats.binom.pmf(k_p, 1000, 0.004)
binom_pocos = stats.binom.pmf(k_p, 10, 0.4)
print()
print("Mayor diferencia con la Poisson(4):")
print("  Binomial(n = 1000, p = 0.004):", round(np.abs(binom_muchos - masa_poisson).max(), 4),
      "   varianza =", round(1000 * 0.004 * 0.996, 3))
print("  Binomial(n = 10,   p = 0.4):  ", round(np.abs(binom_pocos - masa_poisson).max(), 4),
      "   varianza =", round(10 * 0.4 * 0.6, 3))

graficar_dos_masas(k_p, masa_poisson, binom_pocos, "Poisson(4)", "Binomial(n = 10, p = 0.4)",
                   "Misma esperanza, distinta distribución", "número de eventos")
Media simulada = 3.9917    varianza simulada = 3.9437    (teoría: ambas valen λ = 4)
P(X = 0) = 0.0183    P(X = 4) = 0.1954
P(X ≥ 9) = 0.0214    frecuencia simulada = 0.0212

Mayor diferencia con la Poisson(4):
  Binomial(n = 1000, p = 0.004): 0.0004    varianza = 3.984
  Binomial(n = 10,   p = 0.4):   0.0555    varianza = 2.4

Barras de la función de masa de una Poisson(4) junto a una Binomial(10, 0.4), ambas con esperanza 4. La binomial es más alta en el centro, entre 3 y 5, y más baja en las colas, y no tiene probabilidad más allá de 10; la Poisson se extiende hasta 12.

En la simulación, la media (3.99) y la varianza (3.94) son casi iguales, como corresponde a una Poisson: su único parámetro \(\lambda\) es a la vez esperanza y varianza. Con \(\lambda=4\), la probabilidad de un minuto sin llegadas es 0.018 y la de nueve llegadas o más, 0.021.

Las tres distribuciones comparadas tienen esperanza 4, pero no se parecen igual:

  • La binomial con \(n=1000\) y \(p=0.004\) es casi idéntica a la Poisson: la mayor diferencia entre sus probabilidades es 0.0004, y su varianza es 3.98.
  • La binomial con \(n=10\) y \(p=0.4\) se aparta: la mayor diferencia es 0.056 y su varianza es 2.4. En la figura se ve más estrecha, y no puede pasar de 10.

La Poisson describe conteos que resultan de muchas oportunidades poco probables, como miles de usuarios con una probabilidad pequeña de enviar un request en un minuto dado. Supone una tasa constante y eventos independientes. La igualdad entre media y varianza te da una revisión rápida: si en datos reales la varianza del conteo es bastante mayor que su media, la tasa cambia con el tiempo (horas pico) o los eventos llegan agrupados, y la Poisson subestima los conteos extremos.

Etapa 5: Variables continuas, la densidad no es una probabilidad

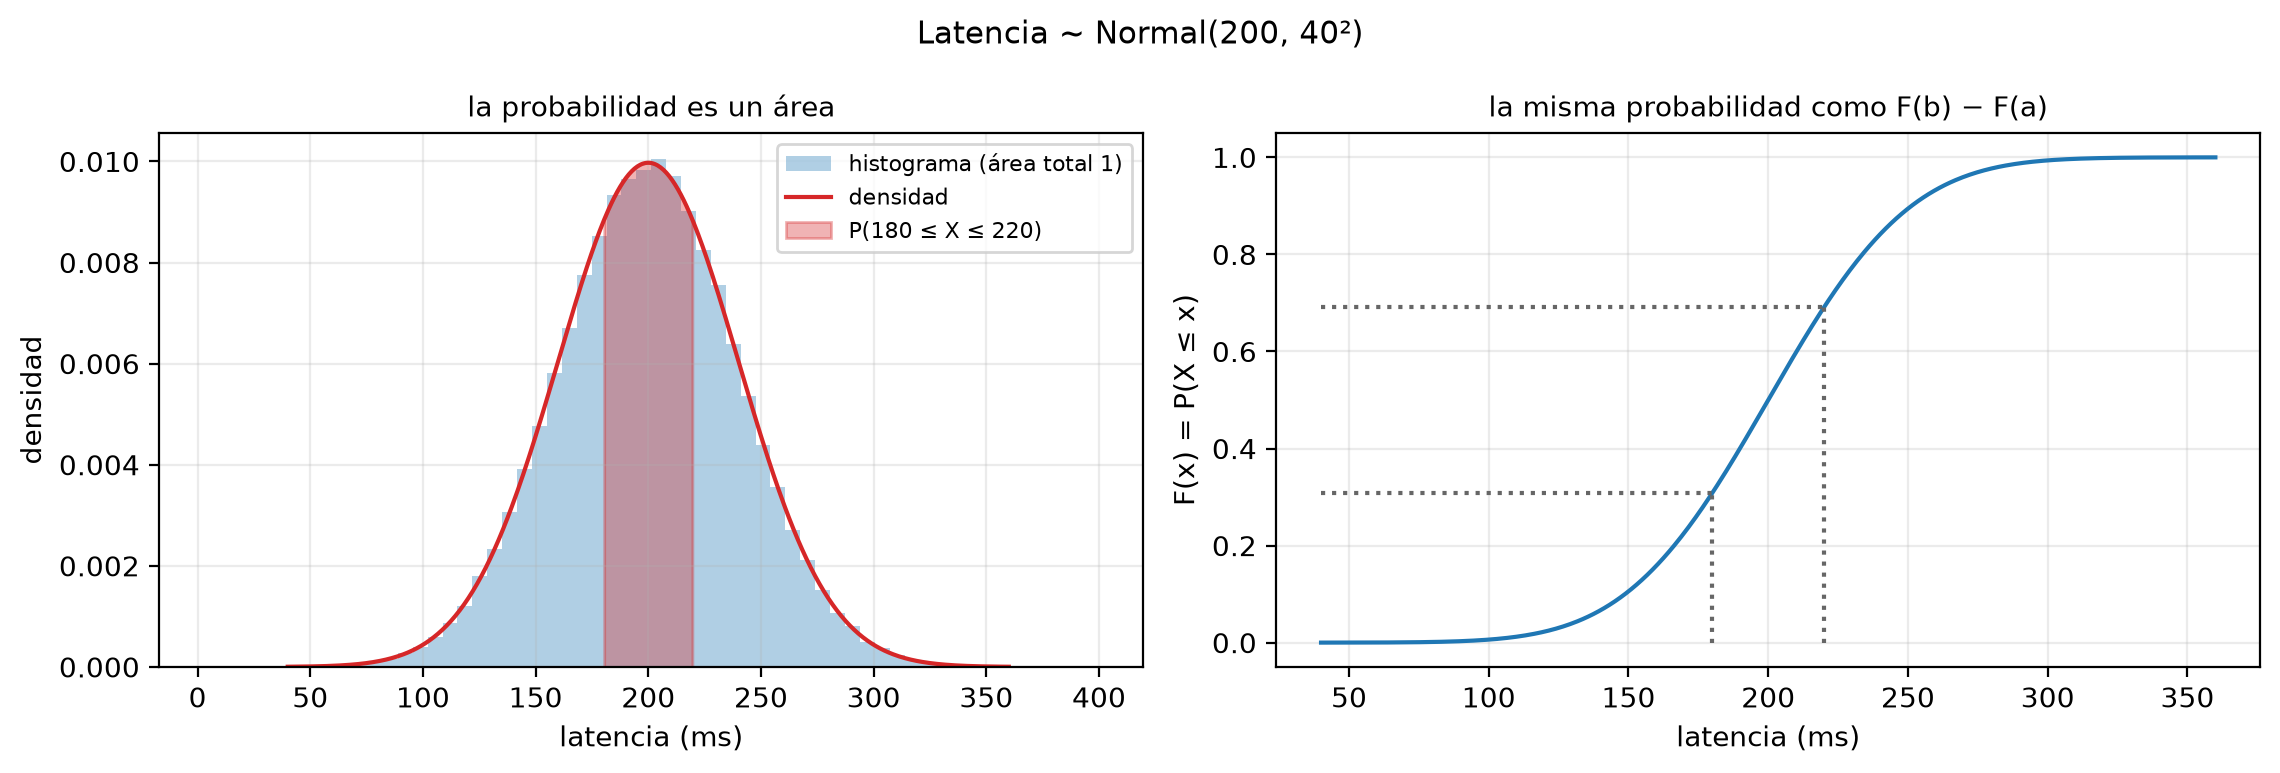
La latencia es continua. Por ahora la modelas con una normal de media 200 ms y desviación 40 ms, y simulas 100 000 latencias con rng.normal. La celda responde tres preguntas: la probabilidad de que una latencia valga exactamente 200 ms, la de que caiga entre 180 y 220 ms, y si una densidad puede valer más que 1.

mu_lat, sigma_lat = 200.0, 40.0
latencias = rng.normal(mu_lat, sigma_lat, size=100_000)

print("1. Latencias simuladas exactamente iguales a 200:", int((latencias == 200).sum()), "de", len(latencias))
print("   Altura de la densidad en 200 ms: f(200) =", round(stats.norm.pdf(200, mu_lat, sigma_lat), 5), " (no es una probabilidad)")

p_intervalo = stats.norm.cdf(220, mu_lat, sigma_lat) - stats.norm.cdf(180, mu_lat, sigma_lat)
print()
print("2. P(180 ≤ X ≤ 220) = F(220) − F(180) =", round(p_intervalo, 4),
      "   frecuencia simulada =", round(((latencias >= 180) & (latencias <= 220)).mean(), 4))

print()
print("3. Una normal con σ = 0.1:  f(μ) =", round(stats.norm.pdf(0, 0, 0.1), 3),
      "   y aun así P(μ − σ ≤ X ≤ μ + σ) =", round(stats.norm.cdf(0.1, 0, 0.1) - stats.norm.cdf(-0.1, 0, 0.1), 4))

graficar_densidad_area(mu_lat, sigma_lat, 180, 220, latencias, "Latencia ~ Normal(200, 40²)")
1. Latencias simuladas exactamente iguales a 200: 0 de 100000
   Altura de la densidad en 200 ms: f(200) = 0.00997  (no es una probabilidad)

2. P(180 ≤ X ≤ 220) = F(220) − F(180) = 0.3829    frecuencia simulada = 0.3844

3. Una normal con σ = 0.1:  f(μ) = 3.989    y aun así P(μ − σ ≤ X ≤ μ + σ) = 0.6827

Dos paneles. A la izquierda, el histograma de 100 000 latencias simuladas con la densidad normal de media 200 ms y desviación 40 ms superpuesta, y el área entre 180 y 220 ms sombreada. A la derecha, la función de distribución acumulada, una curva en S, con líneas punteadas que marcan F(180) y F(220).

  1. Ninguna de las 100 000 latencias simuladas vale exactamente 200: en una variable continua, la probabilidad de un valor exacto es cero. La altura de la densidad en ese punto, 0.00997, tiene unidades de probabilidad por milisegundo; multiplicada por el ancho de un intervalo pequeño, aproxima la probabilidad de caer en él.
  2. \(P(180\le X\le 220)=0.3829\), y la frecuencia simulada es 0.3844. Es el área sombreada del panel izquierdo y también la diferencia de alturas \(F(220)-F(180)\) en el panel derecho.
  3. Con \(\sigma=0.1\), la densidad en el centro vale 3.99, casi cuatro veces 1, y la probabilidad de caer a menos de una desviación de la media sigue siendo 0.6827. Una curva alta y estrecha encierra la misma área que una baja y ancha.

En consecuencia, con variables continuas da igual escribir \(\le\) o \(<\), porque el borde tiene probabilidad cero, y toda pregunta con sentido es sobre un intervalo: menos de 250 ms, entre 180 y 220, más de 300.

Etapa 6: La normal, estandarizar y leer percentiles

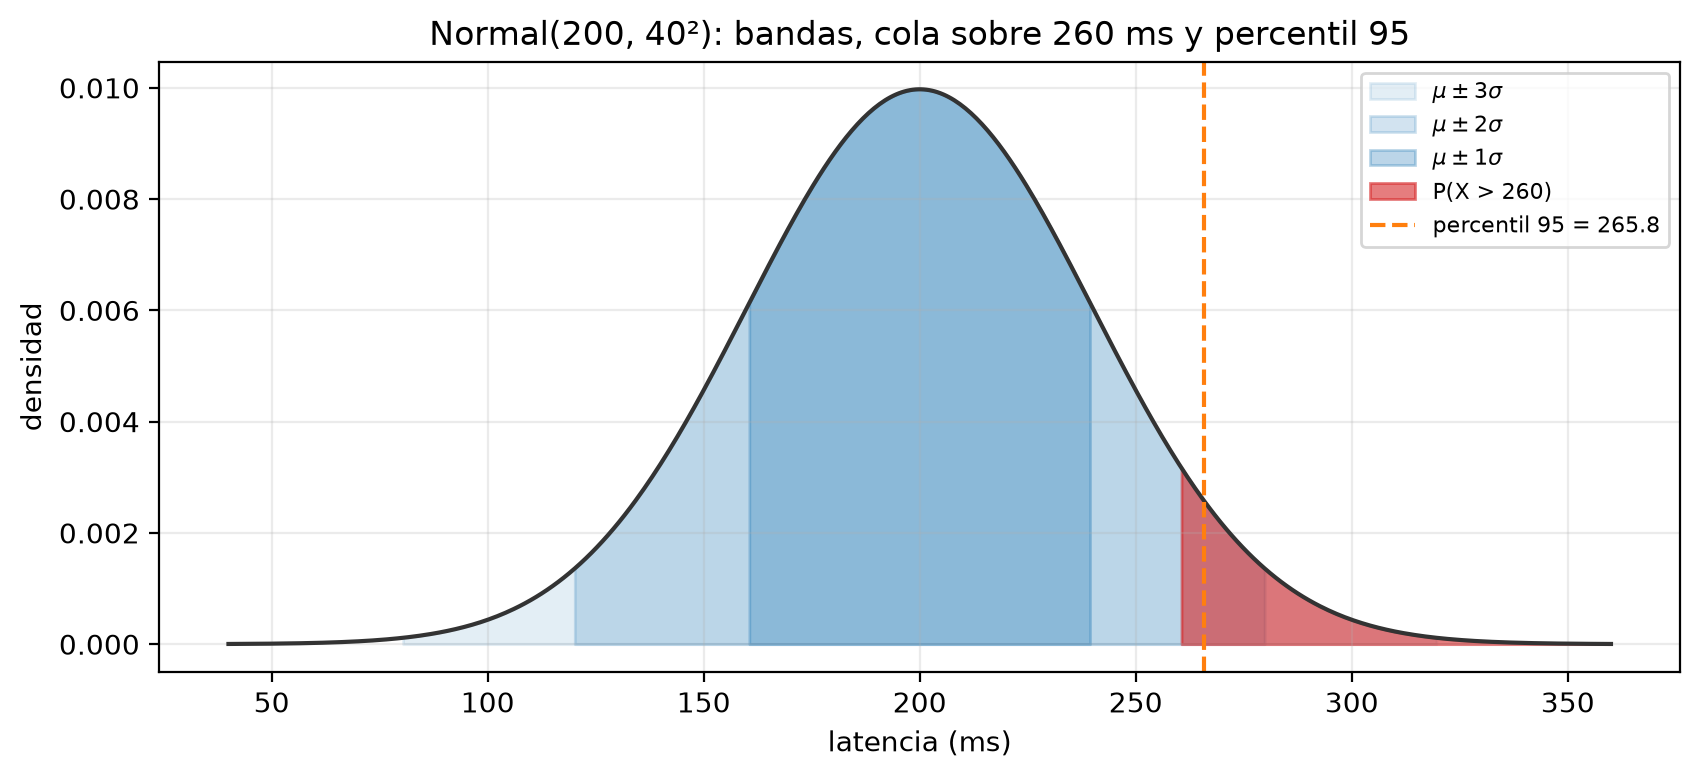
Con el mismo modelo, \(X\sim\mathcal N(200,\,40^2)\), respondes tres preguntas habituales:

  • qué proporción de requests supera los 260 ms;
  • qué proporción cae a menos de 1, 2 y 3 desviaciones de la media;
  • cuál es el percentil 95, el valor que solo supera el 5% de los requests.

La primera se resuelve estandarizando: \(z=(260-200)/40=1.5\).

umbral = 260.0
z = (umbral - mu_lat) / sigma_lat
print("z =", z)
print("P(X > 260) = P(Z > 1.5) =", round(stats.norm.sf(z), 4),
      "   directo con SciPy =", round(stats.norm.sf(umbral, mu_lat, sigma_lat), 4),
      "   frecuencia simulada =", round((latencias > umbral).mean(), 4))

print()
for banda in (1, 2, 3):
    teorica = stats.norm.cdf(banda) - stats.norm.cdf(-banda)
    simulada = (np.abs(latencias - mu_lat) <= banda * sigma_lat).mean()
    print(f"P(|X − μ| ≤ {banda}σ) = {teorica:.4f}   frecuencia simulada = {simulada:.4f}")

p95_normal = stats.norm.ppf(0.95, mu_lat, sigma_lat)
print()
print("Percentil 95 de Z =", round(stats.norm.ppf(0.95), 4))
print("Percentil 95 de X = μ + 1.645·σ =", round(p95_normal, 1), "ms   en la simulación =", round(np.quantile(latencias, 0.95), 1))
p_300 = stats.norm.sf(300, mu_lat, sigma_lat)
print("P(X > 300) =", round(p_300, 5), "  → 1 de cada", int(round(1 / p_300)), "requests, según este modelo")

graficar_normal_bandas(mu_lat, sigma_lat, umbral, p95_normal, "Normal(200, 40²): bandas, cola sobre 260 ms y percentil 95")
z = 1.5
P(X > 260) = P(Z > 1.5) = 0.0668    directo con SciPy = 0.0668    frecuencia simulada = 0.0666

P(|X − μ| ≤ 1σ) = 0.6827   frecuencia simulada = 0.6841
P(|X − μ| ≤ 2σ) = 0.9545   frecuencia simulada = 0.9547
P(|X − μ| ≤ 3σ) = 0.9973   frecuencia simulada = 0.9973

Percentil 95 de Z = 1.6449
Percentil 95 de X = μ + 1.645·σ = 265.8 ms   en la simulación = 265.8
P(X > 300) = 0.00621   → 1 de cada 161 requests, según este modelo

Densidad normal de media 200 ms y desviación 40 ms con tres bandas sombreadas de 1, 2 y 3 desviaciones alrededor de la media, la cola por encima de 260 ms en rojo y una línea discontinua en el percentil 95, 265.8 ms.

  • Cola sobre 260 ms. \(z=1.5\) y \(P(Z>1.5)=0.0668\): el 6.7% de los requests supera los 260 ms. El cálculo directo y la simulación (0.0666) coinciden.
  • Bandas. Las probabilidades de caer a menos de 1, 2 y 3 desviaciones son 0.6827, 0.9545 y 0.9973, la regla 68–95–99.7. La simulación da 0.6841, 0.9547 y 0.9973.
  • Percentil 95. Es \(\mu+1.645\,\sigma=265.8\) ms: el 5% de los requests tarda más. En la figura es la línea discontinua, justo a la derecha del inicio de la cola sombreada sobre 260 ms.

Al estandarizar te basta una sola tabla, la de \(Z\), para cualquier normal: 260 ms en este servicio y 1.5 desviaciones sobre la media en cualquier otro son la misma pregunta.

Ten cuidado con las colas. Según este modelo, \(P(X>300)=0.0062\), uno de cada 161 requests, y esa cifra depende por completo de que la cola sea la de una normal. Las latencias reales suelen tener colas más pesadas, y en la etapa 8 la normal subestima una cola por un factor de 14. Para el centro de la distribución el modelo normal es tolerante; para las colas, donde se fijan los acuerdos de nivel de servicio, tienes que comprobarlo con datos.

Etapa 7: Sumar variables, media y desviación de una suma

La latencia total de un request tiene dos partes independientes, el tiempo de red y el tiempo del modelo:

  • red: normal de media 30 ms y desviación 10 ms;
  • modelo: normal de media 170 ms y desviación 38 ms.

Simulas 100 000 requests de cada parte, los sumas y comparas la media y la desviación de la suma con las reglas.

red = rng.normal(30, 10, size=100_000)
modelo = rng.normal(170, 38, size=100_000)
total = red + modelo

print("Correlación entre red y modelo en la simulación =", round(np.corrcoef(red, modelo)[0, 1], 4))
print()
print("Media:      30 + 170 =", 30 + 170, "            simulada =", round(total.mean(), 2))
print("Varianza:   10² + 38² =", 10 ** 2 + 38 ** 2, "          simulada =", round(total.var(), 1))
print("Desviación: √(10² + 38²) =", round(np.sqrt(10 ** 2 + 38 ** 2), 2), "     simulada =", round(total.std(), 2))
print("Sumar las desviaciones daría 10 + 38 =", 10 + 38, " ← incorrecto")
print()
print("Parte de la varianza total que aporta cada componente:  red =", round(10 ** 2 / 1544 * 100, 1), "%   modelo =",
      round(38 ** 2 / 1544 * 100, 1), "%")
Correlación entre red y modelo en la simulación = -0.002

Media:      30 + 170 = 200             simulada = 199.91
Varianza:   10² + 38² = 1544           simulada = 1543.4
Desviación: √(10² + 38²) = 39.29      simulada = 39.29
Sumar las desviaciones daría 10 + 38 = 48  ← incorrecto

Parte de la varianza total que aporta cada componente:  red = 6.5 %   modelo = 93.5 %

La media de la suma es \(30+170=200\) ms, y la simulación da 199.91. La varianza es \(10^2+38^2=1544\) y la desviación estándar \(\sqrt{1544}=39.29\) ms, igual que en la simulación. Sumar las desviaciones daría 48 ms, un 22% de más: como los dos tiempos no se desvían siempre hacia el mismo lado, cuando la red va lenta el modelo puede ir rápido, y parte de la variación se compensa.

El modelo aporta el 93.5% de la varianza total y la red el 6.5%, aunque sus desviaciones estén en proporción de 38 a 10: como las varianzas dependen del cuadrado, domina el componente más variable. Eliminar por completo la variación de la red solo bajaría la desviación total de 39.3 a 38 ms.

La regla de las varianzas exige independencia; en la simulación, la correlación entre los dos tiempos es −0.002, prácticamente cero por construcción. Si los dos crecieran juntos, por ejemplo porque los requests grandes tardan más en la red y en el modelo, la varianza de la suma superaría 1544. La regla de las esperanzas vale siempre.

Etapa 8: Ley de los grandes números, el promedio se estabiliza

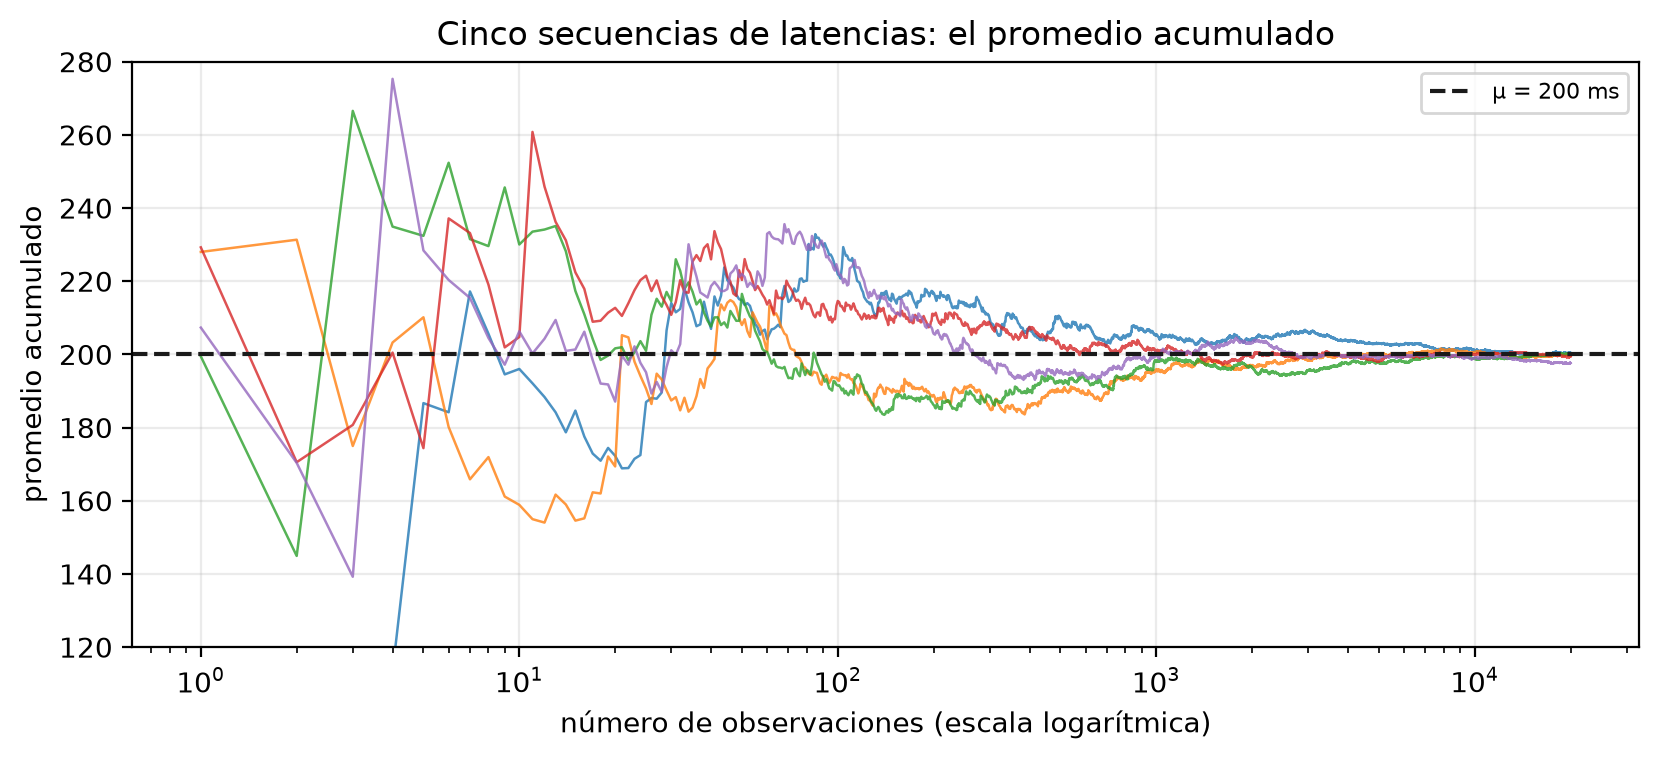
Las latencias reales no son simétricas: no pueden ser negativas y tienen una cola larga a la derecha. Cambias el modelo por una log-normal: una variable es log-normal cuando su logaritmo es normal. Si \(\ln X\sim\mathcal N(m,\,s^2)\), entonces \(X\) es siempre positiva, tiene cola larga a la derecha, mediana \(e^{m}\), media \(e^{m+s^2/2}\) y desviación igual a la media por \(\sqrt{e^{s^2}-1}\) (fórmulas que se dan sin demostración). Eliges \(s=0.6\) y el \(m\) que hace la media igual a 200 ms; la desviación resulta de unos 132 ms. Los dos números que recibe rng.lognormal son \(m\) y \(s\), los del logaritmo, no la media y la desviación de \(X\).

Generas cinco secuencias independientes de 20 000 latencias y sigues el promedio acumulado de cada una.

sigma_log = 0.6
m_log = np.log(200) - sigma_log ** 2 / 2          # se elige para que la media sea 200 ms
mu_asim = np.exp(m_log + sigma_log ** 2 / 2)
sigma_asim = mu_asim * np.sqrt(np.exp(sigma_log ** 2) - 1)

secuencias = rng.lognormal(m_log, sigma_log, size=(5, 20_000))
promedios = np.cumsum(secuencias, axis=1) / np.arange(1, 20_001)

print("Modelo log-normal:  media =", round(mu_asim, 1), "ms   desviación =", round(sigma_asim, 1),
      "ms   mediana =", round(np.exp(m_log), 1), "ms")
print()
print("Promedio acumulado de cada secuencia")
for n in (10, 100, 1000, 20_000):
    fila = promedios[:, n - 1]
    print(f"  n = {n:>6}:  {np.round(fila, 1)}   distancia máxima a 200 = {np.abs(fila - 200).max():.1f}")

# Misma media y misma desviación, otra cola: ¿qué tan probable es superar 600 ms?
p_cola_lognormal = stats.lognorm.sf(600, s=sigma_log, scale=np.exp(m_log))
p_cola_normal = stats.norm.sf(600, mu_asim, sigma_asim)
print()
print("P(X > 600 ms):  log-normal =", round(p_cola_lognormal, 4), "   normal con la misma media y desviación =",
      round(p_cola_normal, 4), "   cociente =", round(p_cola_lognormal / p_cola_normal, 1))

graficar_trayectorias(promedios, mu_asim, "Cinco secuencias de latencias: el promedio acumulado", "μ = 200 ms", ylim=(120, 280))
Modelo log-normal:  media = 200.0 ms   desviación = 131.7 ms   mediana = 167.1 ms

Promedio acumulado de cada secuencia
  n =     10:  [196.  158.9 230.  204.7 206.3]   distancia máxima a 200 = 41.1
  n =    100:  [221.9 192.9 191.5 214.6 223.2]   distancia máxima a 200 = 23.2
  n =   1000:  [205.4 195.9 198.  200.9 200. ]   distancia máxima a 200 = 5.4
  n =  20000:  [200.4 199.7 200.2 199.4 197.7]   distancia máxima a 200 = 2.3

P(X > 600 ms):  log-normal = 0.0165    normal con la misma media y desviación = 0.0012    cociente = 13.9

Cinco curvas del promedio acumulado de latencias log-normales con el eje horizontal en escala logarítmica. Oscilan entre 140 y 275 ms en las primeras decenas de observaciones y desde unas 3000 quedan pegadas a la línea discontinua de 200 ms.

El modelo asimétrico tiene media 200 ms, desviación 131.7 ms y mediana 167.1 ms. Las cinco secuencias empiezan dispersas y terminan juntas: con 10 observaciones, el promedio más alejado está a 41.1 ms de la media; con 100, a 23.2; con 1000, a 5.4; con 20 000, a 2.3. En la figura, las cinco curvas oscilan entre 140 y 275 ms en las primeras decenas de observaciones y desde unas 3000 quedan pegadas a la línea de 200. Esa es la ley de los grandes números, y vale aunque los datos sean asimétricos.

  • El promedio se acerca a la media, no a la mediana. Converge a 200 y no a 167. En una distribución con cola larga, la mayoría de las observaciones individuales queda por debajo del valor al que converge su promedio.
  • La ley no dice qué tan rápido. En esta corrida, multiplicar las observaciones por 200 (de 100 a 20 000) redujo la mayor distancia de unos 23 ms a unos 2 ms: diez veces menos, no doscientas. Otra semilla daría cifras distintas; la etapa siguiente da la regla general.

Con la misma media y la misma desviación, la cola cambia. La probabilidad de superar 600 ms es 0.0165 con este modelo y 0.0012 con una normal de media 200 y desviación 131.7, catorce veces menor. Dos distribuciones pueden coincidir en sus dos primeros resúmenes y discrepar por un orden de magnitud en la cola: es la advertencia que quedó pendiente en la etapa 6.

Etapa 9: Teorema del límite central, la forma del promedio

La ley de los grandes números dice a dónde va el promedio; el teorema del límite central dice cómo se reparte alrededor de ese valor para un \(n\) dado.

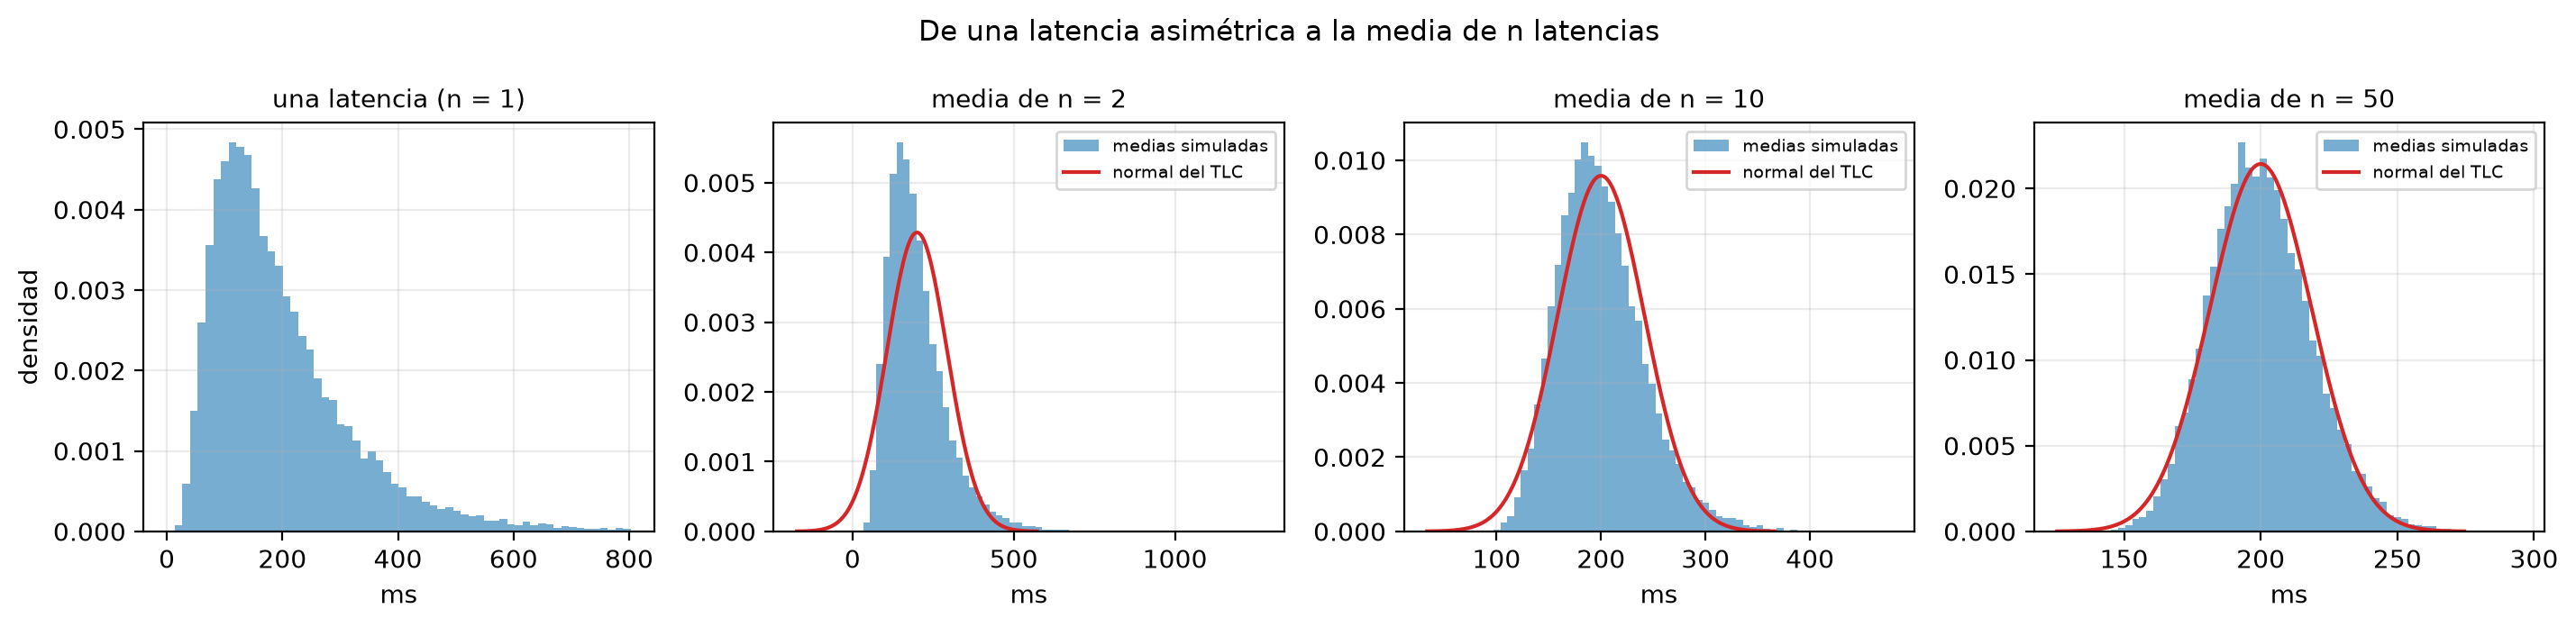
Con el mismo modelo log-normal tomas 20 000 muestras de tamaño \(n\) y guardas la media de cada una, para \(n=2\), 10, 50 y 200. Las reglas para combinar variables ya dan dos resultados exactos para cualquier \(n\): la media de las medias es \(\mu=200\) y su desviación es \(\sigma/\sqrt n\). El teorema añade el tercero: la forma se acerca a una normal.

Para revisar la forma miras dos cosas: la asimetría, que vale 0 en una distribución simétrica, y las colas. En una normal queda el 2.5% de los valores a cada lado de \(\mu\pm1.96\) desviaciones (1.96 es el percentil 97.5 de \(Z\)).

medias_por_n = {}
filas = []
for n in (2, 10, 50, 200):
    medias = rng.lognormal(m_log, sigma_log, size=(20_000, n)).mean(axis=1)
    medias_por_n[n] = medias
    se = sigma_asim / np.sqrt(n)
    filas.append({
        "n": n,
        "media de las medias": medias.mean(),
        "desviación de las medias": medias.std(),
        "σ/√n": se,
        "asimetría": stats.skew(medias),
        "bajo μ − 1.96·σ/√n": np.mean(medias < mu_asim - 1.96 * se),
        "sobre μ + 1.96·σ/√n": np.mean(medias > mu_asim + 1.96 * se),
    })

asimetria_modelo = (np.exp(sigma_log ** 2) + 2) * np.sqrt(np.exp(sigma_log ** 2) - 1)
print("Asimetría de una latencia:  modelo =", round(asimetria_modelo, 2), "   en 20 000 simuladas =", round(stats.skew(secuencias[0]), 2))
print("Asimetría del modelo dividida por √n:", {n: round(float(asimetria_modelo / np.sqrt(n)), 2) for n in (2, 10, 50, 200)})
print()
print(pd.DataFrame(filas).round({"media de las medias": 2, "desviación de las medias": 2, "σ/√n": 2, "asimetría": 2,
                                 "bajo μ − 1.96·σ/√n": 4, "sobre μ + 1.96·σ/√n": 4}).to_string(index=False))

graficar_tlc(secuencias[0], {n: medias_por_n[n] for n in (2, 10, 50)}, mu_asim, sigma_asim,
             "De una latencia asimétrica a la media de n latencias")
Asimetría de una latencia:  modelo = 2.26    en 20 000 simuladas = 2.14
Asimetría del modelo dividida por √n: {2: 1.6, 10: 0.71, 50: 0.32, 200: 0.16}

  n  media de las medias  desviación de las medias  σ/√n  asimetría  bajo μ − 1.96·σ/√n  sobre μ + 1.96·σ/√n
  2               200.13                     93.37 93.09       1.60              0.0000               0.0466
 10               200.11                     41.63 41.63       0.73              0.0061               0.0396
 50               200.18                     18.53 18.62       0.32              0.0146               0.0332
200               200.05                      9.33  9.31       0.13              0.0220               0.0288

Cuatro histogramas. El primero, de una latencia, es asimétrico con cola larga hasta 800 ms. Los otros tres muestran la media de 2, 10 y 50 latencias con la curva normal del teorema del límite central: con n = 2 el histograma está corrido a la izquierda y la normal no lo describe, con n = 10 casi coinciden y con n = 50 la normal cubre el histograma, centrado en 200 ms.

La tabla de los cuatro tamaños de muestra, de \(n=2\) a \(n=200\), permite revisar las tres afirmaciones:

  • Centro. La media de las medias queda entre 200.05 y 200.18 para todo \(n\).
  • Dispersión. La desviación de las medias coincide con \(\sigma/\sqrt n\): 93.4 frente a 93.1 con \(n=2\), 41.6 frente a 41.6 con \(n=10\), 18.5 frente a 18.6 con \(n=50\) y 9.3 frente a 9.3 con \(n=200\). Para reducir a la mitad la incertidumbre de un promedio necesitas cuadruplicar los datos.
  • Asimetría. La del modelo es 2.26 (2.14 en 20 000 latencias simuladas). Dividida por \(\sqrt n\) da 1.60, 0.71, 0.32 y 0.16, y las medias simuladas tienen 1.60, 0.73, 0.32 y 0.13: la asimetría del promedio baja como \(1/\sqrt n\), con lentitud.
  • Colas. En una normal habría 2.5% de las medias a cada lado. Con \(n=2\) no hay ninguna en la cola baja y el 4.7% está en la alta; con \(n=50\), el reparto es 1.5% y 3.3%; con \(n=200\), 2.2% y 2.9%. En la figura, con \(n=2\) la curva normal no describe el histograma, que está corrido a la izquierda y tiene cola a la derecha, y con \(n=50\) casi lo cubre.

Por eso la regla práctica que se cita a menudo, «con \(n\ge 30\) basta», no es universal: el \(n\) necesario depende de qué tan asimétricos sean los datos. Con este modelo, 50 observaciones dejan todavía una asimetría visible, y las colas siguen desiguales con 200. Ten presente también que el teorema habla del promedio: una latencia individual conserva su asimetría de 2.26 por muchos datos que juntes.

Etapa 10: Cuando promediar no ayuda, la distribución de Cauchy

Los dos teoremas tienen condiciones. La ley de los grandes números necesita que exista la esperanza, y el teorema del límite central, que la varianza sea finita. La distribución de Cauchy es el contraejemplo clásico: tiene forma de campana, pero sus colas son tan pesadas que no tiene esperanza ni varianza.

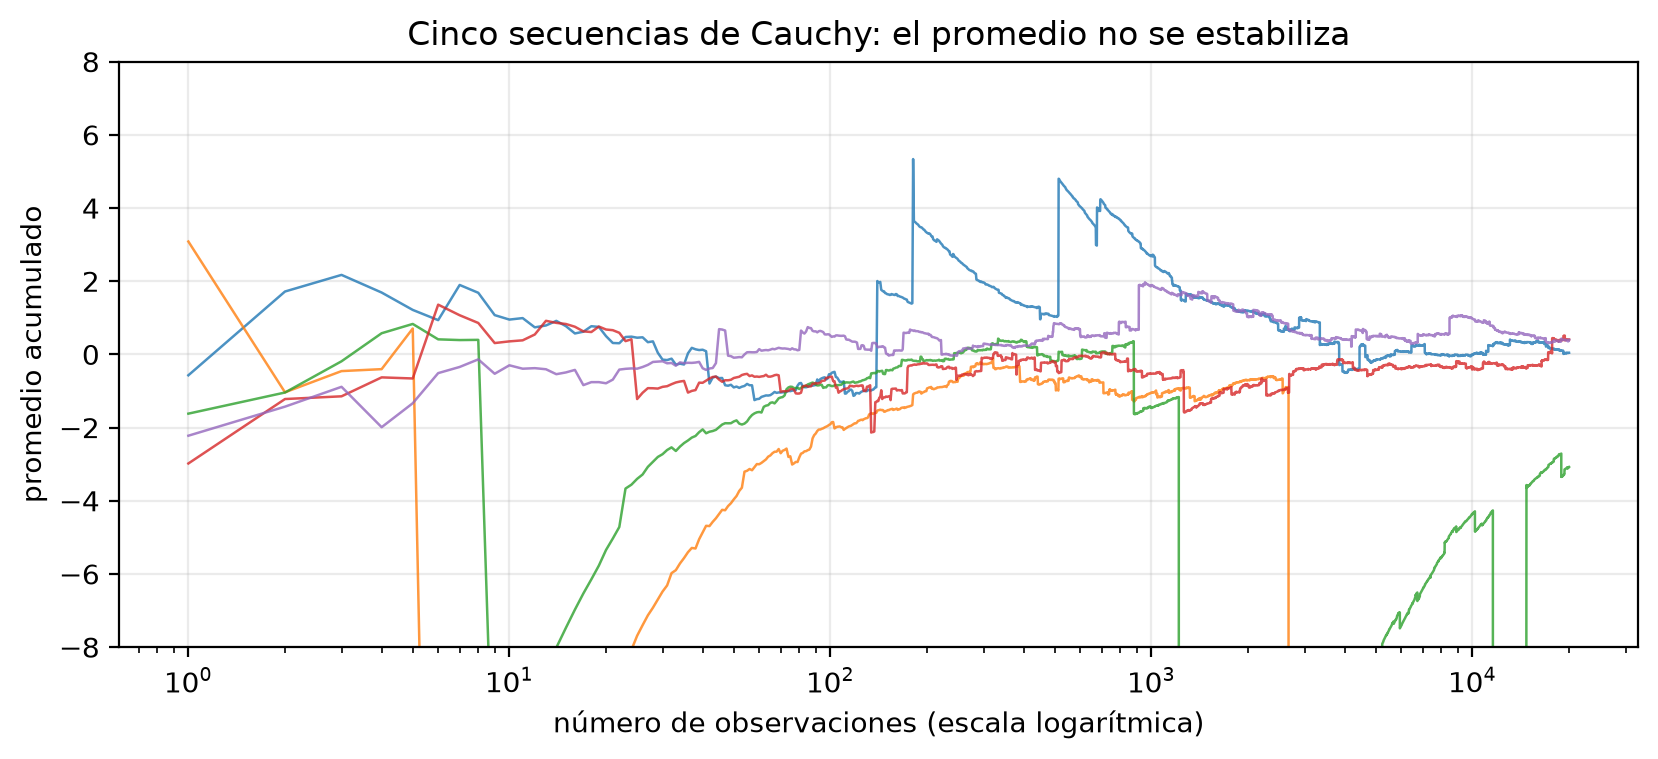
Repites el experimento de la etapa 8 con cinco secuencias de 20 000 valores de rng.standard_cauchy, y comparas la dispersión de una Cauchy con la de la media de 50.

cauchy = rng.standard_cauchy(size=(5, 20_000))
promedios_cauchy = np.cumsum(cauchy, axis=1) / np.arange(1, 20_001)

print("Promedio acumulado de cada secuencia de Cauchy")
for n in (100, 1000, 20_000):
    print(f"  n = {n:>6}:  {np.round(promedios_cauchy[:, n - 1], 2)}")

# La media de 50 Cauchy es tan dispersa como una sola
una = rng.standard_cauchy(size=20_000)
medias_cauchy = rng.standard_cauchy(size=(20_000, 50)).mean(axis=1)
print()
print("Cuartiles 1 y 3 de una Cauchy:           ", np.round(np.quantile(una, [0.25, 0.75]), 2))
print("Cuartiles 1 y 3 de la media de 50 Cauchy:", np.round(np.quantile(medias_cauchy, [0.25, 0.75]), 2))
extremo = cauchy.flat[np.abs(cauchy).argmax()]
print("Observación más extrema entre las 100 000:", int(round(extremo)),
      "  (secuencia", int(np.abs(cauchy).argmax() // cauchy.shape[1]) + 1, ")")

graficar_trayectorias(promedios_cauchy, None, "Cinco secuencias de Cauchy: el promedio no se estabiliza", "", ylim=(-8, 8))
Promedio acumulado de cada secuencia de Cauchy
  n =    100:  [-0.55 -1.91 -0.85 -0.61  0.51]
  n =   1000:  [ 2.69 -1.04 -1.45 -0.53  1.89]
  n =  20000:  [  0.04 -31.38  -3.08   0.41   0.4 ]

Cuartiles 1 y 3 de una Cauchy:            [-0.98  1.  ]
Cuartiles 1 y 3 de la media de 50 Cauchy: [-0.99  1.  ]
Observación más extrema entre las 100 000: -621747   (secuencia 2 )

Cinco curvas del promedio acumulado de valores de Cauchy con el eje horizontal en escala logarítmica y el vertical entre −8 y 8. Las curvas saltan de golpe cada cierto tiempo; una sale por debajo de −8 cerca de la observación 2700 y no vuelve, y otra baja y se recupera solo hasta −3 al final.

Con las latencias log-normales, 20 000 observaciones dejaban los cinco promedios a 2.3 ms o menos de la media. Con la Cauchy, tras 20 000 observaciones los promedios son 0.04, −31.38, −3.08, 0.41 y 0.40: no se juntan, y una secuencia está más lejos al final que al principio. En la figura, cada cierto tiempo una curva salta de golpe, porque aparece una observación tan grande que arrastra el promedio de todas las anteriores; la segunda secuencia sale por debajo de −8 cerca de la observación 2700 y no vuelve. La observación más extrema de las 100 000 vale −621 747 y está justo en esa secuencia: ella sola explica su promedio final (\(-621\,747/20\,000\approx-31\)), en una distribución cuya mitad central cabe entre −1 y 1.

Como la Cauchy no tiene varianza, mides la dispersión con los cuartiles. Los cuartiles 1 y 3 de una sola Cauchy son −0.98 y 1.00; los de la media de 50, −0.99 y 1.00. Promediar 50 observaciones no redujo la dispersión.

Ninguna latencia real es una Cauchy, pero sí ocurre una versión moderada del mismo fenómeno. Cuando unos pocos valores extremos concentran buena parte de la suma (timeouts, pagos muy grandes, sesiones larguísimas), el promedio se estabiliza con mucha lentitud y la aproximación normal de la etapa 9 necesita muchos más datos de los que sugiere la intuición. La señal práctica es un promedio que cambia de forma apreciable al agregar o quitar una sola observación.

Etapa 11: Reportar un modelo de probabilidad

El reporte sigue los seis primeros pasos del flujo de trabajo:

  1. Variable: qué número observas, en qué unidad, y si es discreto o continuo.
  2. Distribución y supuestos: qué familia propones y qué supone.
  3. Parámetros: cuánto valen y de dónde salen.
  4. Cálculo: la probabilidad, la esperanza o el percentil que responde la pregunta.
  5. Contraste con datos: qué tan bien describe el modelo lo observado.
  6. Límite: qué supuesto es más dudoso y qué pasaría si falla.

Los aplicas a los fallos por lote de la etapa 3.

  1. Variable. \(X\) = número de requests fallidos en un lote de 50. Discreta, con valores posibles de 0 a 50.
  2. Distribución y supuestos. Binomial. Supone que los 50 requests son independientes y que todos fallan con la misma probabilidad.
  3. Parámetros. \(n=50\) por diseño del lote; \(p=0.03\), fijada en el enunciado (en un caso real sería la tasa histórica de fallos).
  4. Cálculo. \(E[X]=1.5\) fallos por lote, con desviación estándar \(\sqrt{1.455}=1.21\). \(P(X=0)=0.218\) y \(P(X\ge 4)=0.0628\).
  5. Contraste con datos. En 20 000 lotes simulados, la media fue 1.507, la varianza 1.442 y la frecuencia de lotes con 4 fallos o más 0.0628. Aquí el acuerdo es por construcción; con datos reales, este paso es el que dice si el modelo sirve.
  6. Límite. El supuesto más dudoso es la independencia. Si los fallos vienen en rachas, los lotes con muchos fallos serán más frecuentes que el 6.3% calculado, y un umbral basado en la binomial producirá más alarmas de las previstas.

El número de fallos en un lote de 50 requests se modela como Binomial(50, 0.03), suponiendo requests independientes con la misma probabilidad de fallo. Se esperan 1.5 fallos por lote; el 21.8% de los lotes no tendrá ninguno y el 6.3% tendrá cuatro o más sin que el servicio haya cambiado. Un umbral de alerta en 4 fallos produce, por tanto, una falsa alarma cada 16 lotes aproximadamente. El supuesto de independencia debe comprobarse con datos reales: si los fallos se agrupan, ese porcentaje será mayor.

Etapa 12: Un cálculo completo a mano

Con números pequeños puedes hacer todo el cálculo a mano. Un servicio en pruebas falla en el 20% de los requests, de forma independiente. Envías 5 requests, y \(X\) es el número de fallos.

  1. Variable y distribución. \(X\) cuenta éxitos (aquí, fallos) en \(n=5\) ensayos independientes con la misma probabilidad \(p=0.2\): es una Binomial(5, 0.2).
  2. Función de masa. Aplicas \(P(X=k)=\binom{5}{k}\,0.2^k\,0.8^{5-k}\):
\(k\) \(\binom{5}{k}\) \(0.2^k\) \(0.8^{5-k}\) \(P(X=k)\)
0 1 1 0.32768 0.32768
1 5 0.2 0.4096 0.40960
2 10 0.04 0.512 0.20480
3 10 0.008 0.64 0.05120
4 5 0.0016 0.8 0.00640
5 1 0.00032 1 0.00032

Las seis probabilidades suman 1.

  1. Esperanza. Con la definición: \(0(0.32768)+1(0.4096)+2(0.2048)+3(0.0512)+4(0.0064)+5(0.00032)=1.0\). Con la fórmula: \(np=5\times 0.2=1\).
  2. Varianza. Con la fórmula: \(np(1-p)=5\times 0.2\times 0.8=0.8\), y la desviación estándar es \(\sqrt{0.8}=0.894\).
  3. Una probabilidad de interés, la de 2 fallos o más:

\[ P(X\ge 2)=1-P(X=0)-P(X=1)=1-0.32768-0.4096=0.26272 . \]

La celda siguiente verifica cada número.

n_ej, p_ej = 5, 0.2
k_ej = np.arange(0, n_ej + 1)
masa_ej = np.array([comb(n_ej, i) * p_ej ** i * (1 - p_ej) ** (n_ej - i) for i in k_ej])

print(pd.DataFrame({"combinaciones": [comb(n_ej, i) for i in k_ej], "P(X = k)": masa_ej,
                    "SciPy": stats.binom.pmf(k_ej, n_ej, p_ej)}, index=k_ej).rename_axis("k").round(5).to_string())
print()
print("Suma de probabilidades =", round(masa_ej.sum(), 5))
esperanza_ej = (k_ej * masa_ej).sum()
varianza_ej = ((k_ej - esperanza_ej) ** 2 * masa_ej).sum()
print("E[X] por definición =", round(esperanza_ej, 4), "   n·p =", n_ej * p_ej)
print("Var(X) por definición =", round(varianza_ej, 4), "   n·p·(1 − p) =", round(n_ej * p_ej * (1 - p_ej), 4),
      "   desviación =", round(np.sqrt(varianza_ej), 3))
print("P(X ≥ 2) =", round(1 - masa_ej[0] - masa_ej[1], 5), "   SciPy =", round(stats.binom.sf(1, n_ej, p_ej), 5))
print("Valor más probable:", int(k_ej[masa_ej.argmax()]), "fallo(s), con probabilidad", round(masa_ej.max(), 4))
   combinaciones  P(X = k)    SciPy
k                                  
0              1   0.32768  0.32768
1              5   0.40960  0.40960
2             10   0.20480  0.20480
3             10   0.05120  0.05120
4              5   0.00640  0.00640
5              1   0.00032  0.00032

Suma de probabilidades = 1.0
E[X] por definición = 1.0    n·p = 1.0
Var(X) por definición = 0.8    n·p·(1 − p) = 0.8    desviación = 0.894
P(X ≥ 2) = 0.26272    SciPy = 0.26272
Valor más probable: 1 fallo(s), con probabilidad 0.4096

El código reproduce la tabla y los cinco pasos: las probabilidades suman 1, la esperanza es 1 fallo, la varianza 0.8 y \(P(X\ge 2)=0.26272\). Con números tan pequeños se ven mejor tres cosas:

  • De dónde sale cada probabilidad. Para \(k=2\) hay \(\binom{5}{2}=10\) maneras de ubicar los dos fallos entre los cinco requests, y cada una tiene probabilidad \(0.2^2\times0.8^3=0.02048\); diez veces eso es 0.2048.
  • Aquí la esperanza coincide con el valor más probable, pero no siempre. Lo más probable es exactamente un fallo (0.4096), igual que la esperanza. Aun así, el 59% de las veces el resultado es otro: ningún fallo el 32.8% y dos o más el 26.3%.
  • La definición y la fórmula dan lo mismo. Sumar \(k\,P(X=k)\) da 1.0, igual que \(np\): la fórmula es un atajo para esa suma.

El número de fallos en 5 requests se modela como Binomial(5, 0.2), suponiendo requests independientes. Se espera 1 fallo, con desviación estándar 0.89. La probabilidad de no tener fallos es 0.328 y la de tener dos o más, 0.263.

Ejercicio

Con el mismo servicio (falla el 20% de los requests), envías ahora 10 requests. Calcula la esperanza, la desviación estándar y la probabilidad de que no falle ninguno. ¿Es más o menos probable que en el lote de 5?

\(X\sim\text{Binomial}(10, 0.2)\): \(E[X]=10\times 0.2=2\) fallos, varianza \(10\times0.2\times0.8=1.6\) y desviación \(\sqrt{1.6}\approx 1.26\). \(P(X=0)=0.8^{10}\approx 0.107\), menos de la tercera parte del 0.328 con 5 requests: cada request adicional debe salir bien para que no haya fallos. Puedes comprobarlo con stats.binom.pmf(0, 10, 0.2).

Etapa 13: Vigilar un clasificador en producción

Un clasificador en producción asigna a cada caso una probabilidad: 0.03 a una transacción, 0.61 a otra. Las etiquetas verdaderas llegan después, a veces días después. Cuando llegan, la primera comprobación no exige revisar caso por caso: basta comparar cuántos positivos hubo con cuántos debería haber habido si el modelo dice la verdad.

Cada caso es una Bernoulli con su propia probabilidad \(p_i\). El número total de positivos es una suma de Bernoullis independientes, y las reglas para combinar variables dan su esperanza y su varianza:

\[ E\Big[\sum_i Y_i\Big]=\sum_i p_i,\qquad \mathrm{Var}\Big(\sum_i Y_i\Big)=\sum_i p_i(1-p_i). \]

El teorema del límite central se enunció para observaciones de una misma distribución, y aquí cada caso tiene su propia \(p_i\). Una versión más general cubre sumas de variables independientes con distribuciones distintas, siempre que ninguna domine la varianza total; con miles de casos que aportan a lo sumo 0.25 cada uno a la varianza, la condición se cumple. El total es entonces aproximadamente normal, con la esperanza y la varianza de arriba, y con eso construyes una banda: si el conteo observado cae lejos de ella, las probabilidades del modelo no describen lo que está pasando.

La misma idea sirve por tramos. Entre los casos a los que el modelo dio una probabilidad cercana a \(p\), la frecuencia de positivos debería rondar \(p\), con un error estándar de \(\sqrt{p(1-p)/n}\): es \(\sigma/\sqrt n\) con la varianza de una Bernoulli.

Un modelo de fraude ficticio puntúa 2000 transacciones en un día. Simulas las probabilidades que anuncia con una distribución beta(1.2, 6), sesgada hacia valores bajos, y comparas dos escenarios:

  • Día normal: cada transacción resulta fraudulenta con la probabilidad que el modelo anunció.
  • Día con cambio: la tasa real de fraude es 35% mayor que la anunciada.
n_casos = 2000
p_modelo = rng.beta(1.2, 6, size=n_casos)                 # probabilidades que anuncia el modelo

esperado = p_modelo.sum()
desviacion = np.sqrt((p_modelo * (1 - p_modelo)).sum())
banda = (esperado - 2 * desviacion, esperado + 2 * desviacion)

y_normal = rng.random(n_casos) < p_modelo                                  # el modelo dice la verdad
y_cambio = rng.random(n_casos) < np.clip(1.35 * p_modelo, 0, 1)            # la tasa real subió 35%

print("Probabilidad media anunciada =", round(p_modelo.mean(), 4))
print("Positivos esperados = Σ p_i =", round(esperado, 1))
print("Desviación estándar = √Σ p_i(1 − p_i) =", round(desviacion, 2))
print("Banda de ± 2 desviaciones: [", round(banda[0], 1), ",", round(banda[1], 1), "]")
print()
for nombre, y in (("Día normal", y_normal), ("Día con cambio", y_cambio)):
    print(f"{nombre:<15} positivos observados = {int(y.sum())}   z = {(y.sum() - esperado) / desviacion:+.2f}")

# Calibración por tramos en el día normal
tramos = pd.cut(p_modelo, [0, 0.05, 0.1, 0.2, 0.3, 0.5, 1.0])
tabla_cal = (pd.DataFrame({"p": p_modelo, "y": y_normal})
             .groupby(tramos, observed=True)
             .agg(casos=("y", "size"), **{"probabilidad media": ("p", "mean"), "frecuencia observada": ("y", "mean")}))
tabla_cal["error estándar"] = np.sqrt(tabla_cal["probabilidad media"] * (1 - tabla_cal["probabilidad media"]) / tabla_cal["casos"])
print()
print("Día normal, por tramos de probabilidad anunciada")
print(tabla_cal.round(3).to_string())

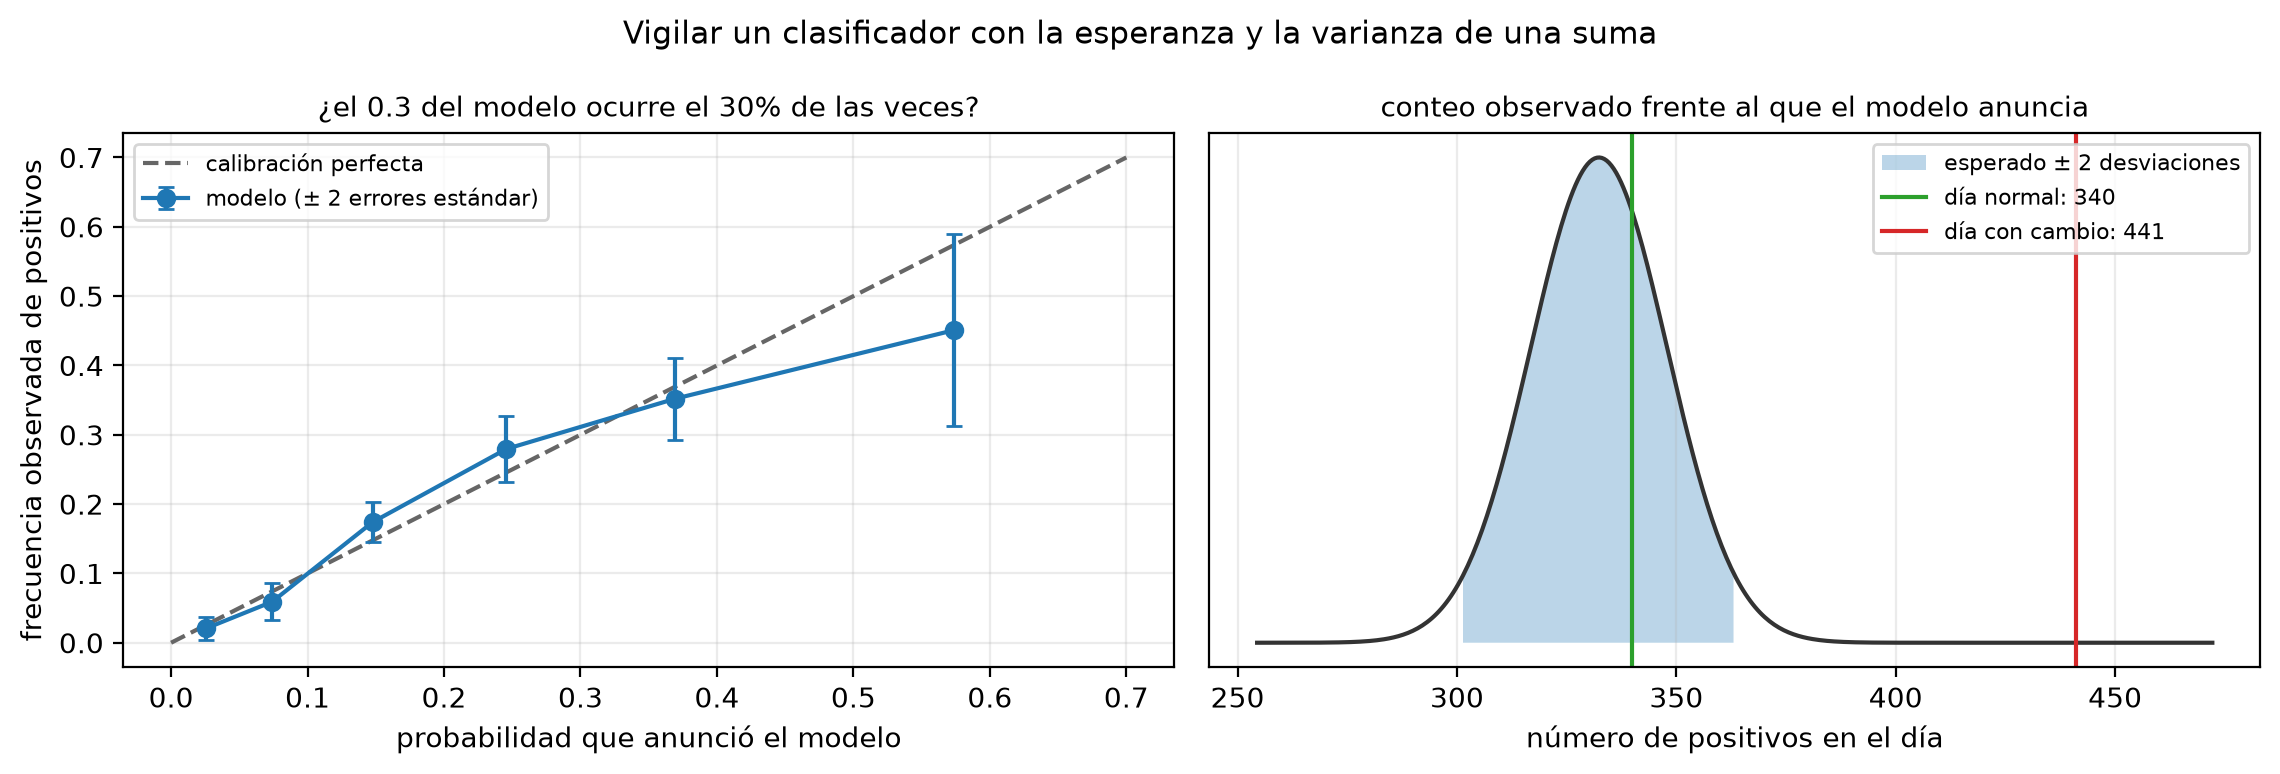
graficar_calibracion(tabla_cal, esperado, desviacion, [int(y_normal.sum()), int(y_cambio.sum())],
                     ["día normal", "día con cambio"], "Vigilar un clasificador con la esperanza y la varianza de una suma")
Probabilidad media anunciada = 0.1662
Positivos esperados = Σ p_i = 332.4
Desviación estándar = √Σ p_i(1 − p_i) = 15.58
Banda de ± 2 desviaciones: [ 301.2 , 363.5 ]

Día normal      positivos observados = 340   z = +0.49
Día con cambio  positivos observados = 441   z = +6.97

Día normal, por tramos de probabilidad anunciada
             casos  probabilidad media  frecuencia observada  error estándar
(0.0, 0.05]    385               0.026                 0.021           0.008
(0.05, 0.1]    389               0.074                 0.059           0.013
(0.1, 0.2]     586               0.148                 0.174           0.015
(0.2, 0.3]     322               0.246                 0.280           0.024
(0.3, 0.5]     267               0.370                 0.352           0.030
(0.5, 1.0]      51               0.574                 0.451           0.069

Dos paneles. A la izquierda, la frecuencia observada de positivos frente a la probabilidad media anunciada en seis tramos, con barras de dos errores estándar, cerca de la diagonal de calibración perfecta; el último tramo, en 0.57, queda en 0.45 con la barra más larga. A la derecha, la campana del conteo esperado de positivos con la banda de 301 a 364 sombreada, una línea verde en 340 (día normal) dentro de la banda y una roja en 441 (día con cambio) muy a la derecha.

El modelo anuncia una probabilidad media de 0.166. Sumando las 2000 probabilidades esperas 332.4 positivos, con desviación estándar 15.6, y la banda de dos desviaciones va de 301 a 364.

  • Día normal: 340 positivos, a +0.49 desviaciones de lo esperado y dentro de la banda; el conteo es compatible con lo que anuncia el modelo.
  • Día con cambio: 441 positivos, a +6.97 desviaciones. Si las probabilidades del modelo fueran correctas y los casos independientes, un resultado así sería prácticamente imposible. El conteo revela el cambio sin analizar caso por caso; en el panel derecho, la línea roja de 441 queda muy a la derecha de la campana.

La tabla por tramos revisa lo mismo con más detalle: entre las transacciones a las que el modelo dio alrededor de 0.25, ¿fue fraudulenta cerca del 25%? En el día normal las frecuencias observadas siguen a las anunciadas (0.021 frente a 0.026, 0.280 frente a 0.246, 0.352 frente a 0.370), y los seis tramos quedan a menos de dos errores estándar; el más alejado, a 1.8. El último tramo es el más ruidoso, 0.451 frente a 0.574, porque solo tiene 51 casos y su error estándar es 0.069: en el panel izquierdo es el punto con la barra de error más larga. Un modelo cuyas probabilidades se cumplen así se llama calibrado.

Aquí el acuerdo es por construcción, porque las etiquetas del día normal se simularon con las probabilidades del modelo. Lo que la tabla te enseña es cuánto se apartan las frecuencias de un modelo perfecto solo por azar: con seis tramos, incluso un modelo perfecto dejará alguno fuera de la banda de dos errores estándar con cierta frecuencia, así que un tramo aislado fuera no basta para declararlo descalibrado.

Este método tiene tres límites:

  1. La independencia entre casos es el supuesto débil. El fraude suele llegar en oleadas, con muchas transacciones de un mismo ataque. Entonces la varianza real del conteo supera \(\sum p_i(1-p_i)\), la banda queda estrecha y habrá más alarmas de las previstas.
  2. El conteo total solo detecta errores que no se compensan. Un modelo que sobrestima en unos tramos y subestima en otros puede acertar el total; por eso miras también la tabla por tramos.
  3. Necesitas la etiqueta verdadera. El conteo de positivos se conoce cuando llegan las confirmaciones. Lo que aporta este capítulo es saber cuánta diferencia entre lo anunciado y lo observado es solo azar.

Errores que conviene nombrar

  1. Leer la altura de una densidad como una probabilidad. La probabilidad es el área sobre un intervalo; con \(\sigma=0.1\), la densidad llega a 3.99.
  2. Confundir la esperanza con el valor más probable. La esperanza de un dado es 3.5, que nunca sale.
  3. Sumar desviaciones estándar. Para variables independientes se suman las varianzas: 39.29 ms, no 48.
  4. Usar la binomial con ensayos dependientes o con probabilidad cambiante. Los fallos de un servicio suelen venir en rachas.
  5. Usar la Poisson sin revisar que media y varianza se parezcan. Si la varianza es mucho mayor, la tasa no es constante o los eventos llegan agrupados.
  6. Suponer normalidad porque el histograma parece una campana. Las colas son lo último que se ve y lo que más pesa en una alerta: en la etapa 8, la normal subestimó por 14 la probabilidad de superar 600 ms.
  7. Creer que el teorema del límite central vuelve normales los datos. Vuelve aproximadamente normal al promedio; los datos conservan su forma.
  8. Aplicar el teorema del límite central con pocas observaciones muy asimétricas o con valores extremos dominantes. Con \(n=50\) log-normales, la asimetría del promedio seguía en 0.32.
  9. Confundir \(\sigma\) con \(\sigma/\sqrt n\). La primera describe una observación; la segunda, un promedio.

8.6 Guía rápida: ¿qué distribución usar?

El dato es… Distribución candidata Supuestos que hay que revisar En SciPy
Un resultado de sí o no Bernoulli(\(p\)) Que \(p\) sea la misma para los casos que agrupas stats.bernoulli(p)
Número de éxitos en \(n\) ensayos Binomial(\(n\), \(p\)) Ensayos independientes, misma \(p\) stats.binom(n, p)
Número de eventos en un intervalo Poisson(\(\lambda\)) Tasa constante, eventos independientes, media ≈ varianza stats.poisson(lam)
Magnitud continua simétrica Normal(\(\mu\), \(\sigma^2\)) Simetría, colas ligeras stats.norm(mu, sigma) (recibe la desviación, no la varianza)
Magnitud positiva con cola larga Log-normal u otra asimétrica Que el logaritmo sea aproximadamente normal stats.lognorm(s, scale=np.exp(m))
El promedio de muchas observaciones Normal(\(\mu\), \(\sigma^2/n\)) Independencia, varianza finita, \(n\) suficiente stats.norm(mu, sigma / n**0.5)
Pregunta Método de SciPy
\(P(X=k)\) en una discreta .pmf(k)
Altura de la densidad .pdf(x)
\(P(X\le x)\) .cdf(x)
\(P(X>x)\) .sf(x)
Percentil .ppf(q)
Simular .rvs(size) o el generador de NumPy

Al reportar, sigue este orden: variable y unidad, distribución con sus parámetros, supuestos, resultado y qué tan bien coincide con los datos.

8.7 Preguntas de comprensión

  1. Un tablero muestra que la densidad de las latencias en 150 ms vale 0.012. ¿Significa que el 1.2% de los requests tarda exactamente 150 ms?
  2. Un servicio recibe en promedio 4 requests por minuto, pero en los datos de una semana la varianza del conteo por minuto es 11. ¿Qué te dice sobre usar una Poisson(4) para fijar alertas?
  3. La latencia total suma tres etapas independientes con desviaciones de 5, 12 y 30 ms. ¿Cuál es la desviación de la suma, y qué etapa conviene optimizar primero para reducirla?
  4. Tienes 25 latencias y su promedio. ¿Cuántas necesitarías para que el error estándar del promedio se reduzca a la mitad? ¿Y si las latencias tienen una cola muy larga?
  5. Un modelo de clasificación anuncia probabilidades que suman 500 positivos esperados en un día, con desviación 20. Observas 470. ¿Hay motivo de alarma?
  1. No. En una variable continua la probabilidad de un valor exacto es cero. La densidad tiene unidades de probabilidad por milisegundo: 0.012 por ms significa que, en un intervalo pequeño alrededor de 150, por ejemplo de 149.5 a 150.5, cae cerca del 1.2% de los requests.
  2. Que la Poisson no describe esos datos: en una Poisson la varianza es igual a la media, y aquí casi la triplica. La tasa cambia a lo largo del día o los requests llegan agrupados, y una alerta calibrada con Poisson(4) sonará mucho más de lo previsto. Conviene modelar por franja horaria o usar una distribución con más dispersión.
  3. \(\sqrt{5^2+12^2+30^2}=\sqrt{1069}\approx 32.7\) ms. La etapa de 30 ms aporta \(900/1069\approx 84\%\) de la varianza; eliminar por completo la de 5 ms apenas bajaría la desviación a 32.3 ms. Conviene empezar por la más variable, como en la etapa 7.
  4. Cuatro veces más, 100 latencias, porque el error estándar es \(\sigma/\sqrt n\). Con una cola muy larga, esa regla sigue valiendo para la desviación del promedio si la varianza es finita, pero la forma tarda más en volverse normal (etapa 9), y si la varianza no existe, como en la Cauchy, promediar no ayuda.
  5. No por el total: 470 está a \((470-500)/20=-1.5\) desviaciones, dentro de la banda de ±2. Antes de descartar un problema, revisa la tabla por tramos, porque errores que se compensan pueden dejar intacto el total, y ten en cuenta que si los casos llegan agrupados la banda real es más ancha.

8.8 Referencias para profundizar

  • Blitzstein, J. K. y Hwang, J. (2019). Introduction to Probability (2.ª ed.). CRC Press. Variables aleatorias, esperanza y distribuciones con muchas simulaciones e intuición.
  • Wasserman, L. (2004). All of Statistics: A Concise Course in Statistical Inference. Springer. Capítulos 2 a 5: variables aleatorias, esperanza, desigualdades y convergencia.
  • DeGroot, M. H. y Schervish, M. J. (2012). Probability and Statistics (4.ª ed.). Pearson. Tratamiento clásico de las distribuciones con nombre y del teorema del límite central.
  • Murphy, K. P. (2022). Probabilistic Machine Learning: An Introduction. MIT Press. Capítulo 2 (Probability: Univariate Models): las distribuciones vistas desde el aprendizaje automático.
  • Niculescu-Mizil, A. y Caruana, R. (2005). Predicting good probabilities with supervised learning. Proceedings of the 22nd International Conference on Machine Learning, 625–632. Calibración de las probabilidades de un clasificador.
  • SciPy. Documentación de scipy.stats: https://docs.scipy.org/doc/scipy/reference/stats.html. Las distribuciones binom, poisson, norm y lognorm usadas en el capítulo.

8.9 Lo que debes llevarte de este capítulo

Una distribución convierte una pregunta sobre números inciertos en un cálculo, y lo que supone sobre el dato importa tanto como sus parámetros.

  • La función de masa reparte la probabilidad entre valores contables; la densidad la reparte como área, y su altura puede pasar de 1 (3.99 con \(\sigma=0.1\)).
  • La esperanza es el promedio a la larga (3.5 en un dado) y la varianza mide la dispersión; para variables independientes se suman las varianzas, no las desviaciones (39.29 ms, no 48).
  • La binomial cuenta éxitos en ensayos independientes: con 50 requests y \(p=0.03\), el 6.3% de los lotes tiene 4 fallos o más sin que nada cambie. La Poisson cuenta eventos con tasa constante y tiene media igual a varianza.
  • La normal se estandariza con \(z\): el 6.7% de las latencias supera 260 ms y el percentil 95 es 265.8 ms. En las colas, una log-normal con la misma media y desviación dio una probabilidad 14 veces mayor.
  • El promedio se acerca a la esperanza (ley de los grandes números) y toma forma de campana con desviación \(\sigma/\sqrt n\) (teorema del límite central), más despacio cuanto más asimétricos son los datos y nunca si no existe la varianza, como en la Cauchy.
  • La esperanza y la varianza de una suma de Bernoullis permiten vigilar un clasificador: 441 positivos frente a 332.4 esperados están a casi 7 desviaciones.

8.10 Puente hacia los siguientes capítulos

Este capítulo termina en una idea: el promedio de \(n\) observaciones independientes es aproximadamente normal, con desviación \(\sigma/\sqrt n\). El capítulo 9, de inferencia estadística, empieza ahí y usa ese resultado al revés: en lugar de partir de una \(\mu\) conocida y preguntar cómo se comporta el promedio, parte de un promedio observado y pregunta qué puedes decir de \(\mu\). De ahí salen el error estándar, el intervalo de confianza y la prueba de hipótesis.

Los capítulos 10 y 11 usan otras distribuciones construidas a partir de la normal (la chi-cuadrado, la \(t\) de Student y la \(F\)) como referencia de las pruebas. Y las cuatro de este capítulo vuelven como modelos de la respuesta: la normal en la regresión lineal del capítulo 13, la Bernoulli en la clasificación del capítulo 14 y la Poisson en los modelos de conteo del nivel Avanzado, dentro de los modelos lineales generalizados.