3  Variabilidad y dispersión

estadistica
varianza
dispersion
Autor/a

Wilder Ramírez Delgado

Fecha de publicación

18 de septiembre de 2026

Misma media, comportamiento distinto

Dos conjuntos de datos pueden tener casi la misma media y comportarse de forma muy distinta: en uno los valores están concentrados; en otro, separados, con más extremos y más incertidumbre. Esa diferencia es la dispersión.

En este capítulo trabajas rango, varianza, desviación estándar y coeficiente de variación: los defines, los calculas, comparas conjuntos en gráficos y ves cómo la dispersión de los datos cambia el error de un modelo y una decisión entre dos proveedores.

Los datos son sintéticos: grupos de seis notas de examen (escala 0–100) escritos a mano para contrastar baja y alta dispersión, seis tiempos de respuesta en milisegundos con un valor extremo y, en varias etapas, muestras más grandes simuladas con NumPy.

  • Tiempo estimado de lectura: 45 minutos (unas 2 horas si ejecutas el código y resuelves los ejercicios)
  • Nivel: Básico
  • Conocimientos previos recomendados: el capítulo 1 (escalas de medición) y el capítulo 2 (media, mediana e imputación con la media).
  • Tecnologías mencionadas: Python 3.13, pandas 3.0, NumPy 2.5 y Matplotlib.

Objetivos

Al terminar este capítulo vas a ser capaz de:

  • explicar qué mide la dispersión y por qué la media sola no basta;
  • calcular e interpretar el rango, la varianza, la desviación estándar y el coeficiente de variación;
  • comparar conjuntos con media parecida y variabilidad distinta;
  • relacionar la dispersión con el ruido, la estabilidad de un modelo y las decisiones de preprocesamiento;
  • reconocer cómo cambia el error de un ajuste simple cuando aumenta el ruido de los datos;
  • decidir qué medida de dispersión reportar según la escala y la pregunta, y comprobar antes que los datos sean válidos.

Ejecuta las celdas en orden: cada etapa usa variables de las anteriores.

3.1 Dispersión: el ancho de los datos

La media resume el centro. La dispersión resume el ancho: cuánto se separan los valores alrededor de ese centro.

Rango

\[ \text{Rango} = \max(x_i) - \min(x_i) \]

Es la medida más simple: solo usa dos valores. Un solo extremo puede inflarlo, así que no describe la dispersión típica del conjunto.

Varianza

\[ s^2 = \frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2 \]

Promedia los cuadrados de las desviaciones respecto a la media. Sus unidades quedan al cuadrado, por eso es poco intuitiva cuando la lees sola.

Desviación estándar

\[ s = \sqrt{s^2} \]

Es la raíz de la varianza y se expresa en las mismas unidades que los datos. Te dice cuánto suelen alejarse los valores de la media.

Coeficiente de variación

\[ \text{CV} = \frac{s}{\bar{x}} \]

Es una medida relativa: compara la desviación estándar con la media. Sirve para contrastar variables de escalas distintas (notas frente a milisegundos), con precaución si la media está cerca de cero. Solo tiene sentido en variables con cero absoluto (escala de razón, capítulo 1): no lo calcules sobre °C ni sobre datos estandarizados.

Pregunta Medida preferible
¿Cuál es la amplitud total? Rango
¿Cuánto se alejan, en promedio, de la media? Desviación estándar
¿Qué tan inestable es una variable respecto a su magnitud? Coeficiente de variación
¿Hay que comparar dos escalas distintas? Coeficiente de variación

3.2 Por qué importa en IA y machine learning

Un modelo aprende patrones a partir de los datos. Si la variable que predice cambia mucho de un caso a otro por causas que el modelo no ve (ruido de medición, factores no registrados), su error tiene un piso que ningún ajuste elimina; lo compruebas en la etapa 8, donde el mismo modelo pasa de un \(R^2\) de 0.98 a 0.63 solo porque el ruido es mayor.

La dispersión también decide el preprocesamiento:

  • Escalamiento: en métodos basados en distancias (k vecinos más cercanos, clustering), una variable con desviación estándar grande domina el cálculo si no se estandariza.
  • Estandarización: el z-score divide por la desviación estándar; las redes neuronales suelen optimizarse de forma más estable con entradas en escalas comparables.
  • Imputación: rellenar faltantes con la media reduce artificialmente la desviación estándar (lo mides en la etapa 4).
  • Calidad de datos: una desviación estándar inflada puede venir de mediciones inválidas, no del fenómeno (caso de los proveedores).

Idea central: cada medida avisa de algo distinto. El rango avisa extremos; la desviación estándar describe el alejamiento típico; el CV compara escalas distintas.

3.3 Flujo recomendado de trabajo

  1. Mira el centro y el ancho. Además de la media, pregúntate cuánto se mueven los datos alrededor de ella.
  2. Calcula las medidas de dispersión. Rango, varianza, desviación estándar y, si las escalas difieren, coeficiente de variación.
  3. Compara conjuntos con media parecida. Si dos grupos tienen un centro similar y anchos distintos, la diferencia relevante está en la variabilidad.
  4. Valida los datos antes de concluir. Revisa de dónde viene cada valor extremo: una medición inválida infla la desviación estándar tanto como un fenómeno real.
  5. Interpreta en contexto. Indica la unidad, si la medida es absoluta o relativa y si un extremo está inflando el rango.
  6. Decide las implicaciones para el modelado:
    • rango o desviación alta: revisa extremos y, en algoritmos por distancia, escala;
    • CV alto: la variable es inestable respecto a su magnitud;
    • misma media y distinta dispersión: el mismo modelo puede funcionar bien en un caso y mal en el otro.
  7. Redacta el reporte:

“Para [variable], la media es ___ y la desviación estándar es ___. Se reporta [medida] como medida principal porque [justificación contextual].”

3.4 Preparar el entorno

%matplotlib inline
%config InlineBackend.figure_format = "retina"
import sys
print("Python:", sys.version.split()[0])
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
print("pandas:", pd.__version__, "| numpy:", np.__version__)

SEMILLA = 42  # semilla central del capítulo
rng = np.random.default_rng(SEMILLA)
Python: 3.13.14
pandas: 3.0.5 | numpy: 2.5.1

Funciones de visualización (definidas una sola vez)

Para no interrumpir la lectura de cada etapa con bloques largos de matplotlib, aquí defines una sola vez todas las funciones de graficación. En cada etapa solo llamas a la que corresponde.

def histograma_doble_notas(ax, a, b, etiqueta_a, etiqueta_b, titulo):
    """Histograma superpuesto de dos grupos, con líneas verticales en cada media."""
    bins = np.linspace(0, 100, 21)  # intervalos de 5 puntos
    ax.hist(a, bins=bins, alpha=0.65, color="C0", label=etiqueta_a)
    ax.hist(b, bins=bins, alpha=0.65, color="C1", hatch="//", edgecolor="white", label=etiqueta_b)
    ax.axvline(np.mean(a), color="C0", linestyle="--", linewidth=1.5)
    ax.axvline(np.mean(b), color="C1", linestyle=":", linewidth=1.5)
    ax.set_xlim(30, 100)
    ax.set_xlabel("Nota (0–100)")
    ax.set_ylabel("Frecuencia")
    ax.set_title(titulo)
    ax.legend(fontsize=9)

def graficar_panorama_inicial(notas_baja_hist, notas_alta_hist, media_baja_hist, media_alta_hist,
                                tiempos_ms):
    """Panorama de Etapa 1: histogramas de notas (misma media, distinta dispersión;
    medias similares, formas distintas) y de tiempos de respuesta."""
    fig, axes = plt.subplots(3, 1, figsize=(9, 8), constrained_layout=True)

    histograma_doble_notas(
        axes[0], notas_baja_hist, notas_alta_hist,
        "Baja dispersión (muestra amplia)", "Alta dispersión (muestra amplia)",
        "Histogramas: misma media aproximada, distinta dispersión",
    )
    histograma_doble_notas(
        axes[1], media_baja_hist, media_alta_hist,
        "Media similar · baja var.", "Media similar · alta var.",
        "Histogramas: medias cercanas (rayas), formas distintas",
    )

    axes[2].hist(tiempos_ms, bins=8, alpha=0.75, edgecolor="black")
    media_t = float(np.mean(tiempos_ms))
    axes[2].axvline(media_t, linestyle="--", linewidth=1.5, label=f"Media = {media_t:.1f} ms")
    axes[2].set_xlabel("Tiempo (ms)")
    axes[2].set_ylabel("Frecuencia")
    axes[2].set_title("Tiempos de respuesta: histograma y valor extremo")
    axes[2].legend(fontsize=9)

    plt.show()

def graficar_rango(a, b, etiqueta_a="Baja dispersión", etiqueta_b="Alta dispersión"):
    """Segmentos horizontales entre mínimo y máximo de dos grupos (Etapa 2: Rango)."""
    fig, ax = plt.subplots(figsize=(9, 3.5))
    min_a, max_a = np.min(a), np.max(a)
    min_b, max_b = np.min(b), np.max(b)

    ax.hlines(y=1, xmin=min_a, xmax=max_a, linewidth=6, color="C0", label=etiqueta_a)
    ax.hlines(y=2, xmin=min_b, xmax=max_b, linewidth=6, color="C1", label=etiqueta_b)
    ax.scatter([min_a, max_a], [1, 1], s=80, color="C0")
    ax.scatter([min_b, max_b], [2, 2], s=80, color="C1")
    ax.set_ylim(0.5, 2.5)

    ax.set_yticks([1, 2])
    ax.set_yticklabels([etiqueta_a, etiqueta_b])
    ax.set_xlabel('Nota')
    ax.set_title('Rango: longitud entre mínimo y máximo')
    ax.grid(axis='x', alpha=0.3)
    ax.legend(fontsize=9)
    plt.show()

    print(f"Rango {etiqueta_a.lower()}: {max_a - min_a}")
    print(f"Rango {etiqueta_b.lower()}: {max_b - min_b}")

def graficar_desviaciones(x, titulo, ax=None):
    """Distancia de cada punto a la media (base visual de la varianza, Etapa 3)."""
    standalone = ax is None
    if standalone:
        fig, ax = plt.subplots(figsize=(6, 4))
    m = np.mean(x)
    idx = np.arange(1, len(x) + 1)
    ax.scatter(idx, x, s=55, label='Datos')
    ax.hlines(m, 0.5, len(x) + 0.5, linestyle='--', linewidth=1.5, label=f'Media = {m:.2f}')
    for i, xi in zip(idx, x):
        ax.plot([i, i], [m, xi], color="C3", linewidth=2, alpha=0.8)
    ax.set_xticks(idx)
    ax.set_xlabel('Observación')
    ax.set_ylabel('Valor')
    ax.set_title(titulo)
    ax.legend(fontsize=8)
    if standalone:
        plt.show()

def graficar_desviaciones_comparadas(a, b, titulo_a, titulo_b):
    # sharey=True: misma escala vertical; si no, las distancias chicas se verían tan largas como las grandes
    fig, axes = plt.subplots(1, 2, figsize=(11, 4), sharey=True, constrained_layout=True)
    graficar_desviaciones(a, titulo_a, ax=axes[0])
    graficar_desviaciones(b, titulo_b, ax=axes[1])
    plt.show()

def graficar_bandas_std(a, b, titulo_a="Baja desviación estándar", titulo_b="Alta desviación estándar"):
    """Bandas ±1σ alrededor de la media, comparando dos grupos (Etapa 4)."""
    fig, axes = plt.subplots(1, 2, figsize=(11, 4.5), sharey=True, constrained_layout=True)

    for ax, x, titulo in [(axes[0], a, titulo_a), (axes[1], b, titulo_b)]:
        idx = np.arange(1, len(x) + 1)
        m, s = np.mean(x), np.std(x, ddof=1)
        ax.plot(idx, x, marker='o', linewidth=2, label='Datos')
        ax.axhline(m, linestyle='--', linewidth=1.5, label=f'Media = {m:.2f}')
        ax.axhline(m + s, linestyle=':', linewidth=1.5, label=f'+1 s = {m+s:.2f}')
        ax.axhline(m - s, linestyle='-.', linewidth=1.5, label=f'−1 s = {m-s:.2f}')
        ax.set_title(titulo)
        ax.set_xlabel('Observación')
        ax.set_ylabel('Valor')
        ax.set_xticks(idx)
        ax.grid(alpha=0.25)
        ax.legend(fontsize=8)

    plt.show()

def graficar_comparacion_distribuciones(dist_a, dist_b, titulo, etiqueta_a, etiqueta_b,
                                          bins_orig=None):
    """Histograma comparativo de dos distribuciones simuladas, con lectura de medias
    y desviaciones estándar impresas debajo. Se reutiliza tanto para 'misma media,
    distinta varianza' como para 'misma varianza, distinta media'."""
    if bins_orig is None:
        lo = min(dist_a.min(), dist_b.min())
        hi = max(dist_a.max(), dist_b.max())
        bins_orig = np.linspace(lo, hi, 26)

    fig, ax = plt.subplots(figsize=(8, 4))
    ax.hist(dist_a, bins=bins_orig, alpha=0.6, color='C0', label=etiqueta_a)
    ax.hist(dist_b, bins=bins_orig, alpha=0.6, color='C1', hatch='//', edgecolor='white', label=etiqueta_b)
    ax.axvline(np.mean(dist_a), color='C0', linestyle='--', linewidth=1.5)
    ax.axvline(np.mean(dist_b), color='C1', linestyle=':', linewidth=1.5)
    ax.set_title(titulo)
    ax.set_xlabel('Valor')
    ax.set_ylabel('Frecuencia')
    ax.legend(fontsize=9)
    plt.show()

    print(f"Media {etiqueta_a}: {np.mean(dist_a):.2f} | Desv. estándar: {np.std(dist_a, ddof=1):.2f}")
    print(f"Media {etiqueta_b}: {np.mean(dist_b):.2f} | Desv. estándar: {np.std(dist_b, ddof=1):.2f}")

def graficar_cv_barras(labels, valores):
    """Barras de coeficiente de variación (%) para varios conjuntos (Etapa 5)."""
    fig, ax = plt.subplots(figsize=(10, 4))
    ax.bar(labels, valores)
    ax.set_ylabel('CV (%)')
    ax.set_title('Coeficiente de variación: dispersión relativa')
    ax.tick_params(axis='x', rotation=20)
    ax.grid(axis='y', alpha=0.25)
    plt.tight_layout()
    plt.show()

def graficar_hist_boxplot(a, b, etiqueta_a, etiqueta_b, bins_a=None, bins_b=None):
    """Histograma + boxplot lado a lado para comparar dos grupos con media similar
    y dispersión distinta (Etapa 6)."""
    fig, axes = plt.subplots(1, 2, figsize=(10, 4))
    media_a, media_b = np.mean(a), np.mean(b)

    # Con 6 datos por grupo se dibuja cada nota (un histograma de 6 valores dice poco)
    for y, x, color, media in [(1, a, "C0", media_a), (2, b, "C1", media_b)]:
        axes[0].scatter(x, np.full(len(x), y), s=70, color=color, alpha=0.8)
        axes[0].vlines(media, y - 0.3, y + 0.3, color=color, linestyle="--", label=f"Media = {media:.2f}")
    axes[0].set_yticks([1, 2])
    axes[0].set_yticklabels([etiqueta_a, etiqueta_b])
    axes[0].set_ylim(0.4, 2.6)
    axes[0].set_xlabel("Nota")
    axes[0].set_title("Cada punto es una nota (rayas: medias)")
    axes[0].legend(fontsize=8)

    axes[1].boxplot([a, b], positions=[1, 2], orientation="horizontal")
    axes[1].set_yticks([1, 2])
    axes[1].set_yticklabels([etiqueta_a, etiqueta_b])
    axes[1].set_xlabel("Nota")
    axes[1].set_title("Boxplot: la caja contiene el 50% central")
    axes[1].set_xlim(axes[0].get_xlim())

    plt.tight_layout()
    plt.show()

def graficar_comparacion_modelos(x_test, y_test_dict, y_pred_dict):
    """Dispersión + línea de predicción para dos escenarios de ruido (Etapa 8)."""
    fig, axes = plt.subplots(1, 2, figsize=(12, 4.5), sharey=True, constrained_layout=True)
    orden = np.argsort(x_test)
    for ax, (nombre, y_test) in zip(axes, y_test_dict.items()):
        ax.scatter(x_test, y_test, alpha=0.6, label='Datos test')
        ax.plot(x_test[orden], y_pred_dict[nombre][orden], color='C3', linewidth=2, label='Predicción modelo')
        ax.set_title(f'ML con {nombre.lower()}')
        ax.set_xlabel('x')
        ax.set_ylabel('y')
        ax.legend(fontsize=8)
    plt.show()

def graficar_caso_real_validacion(tiempos_crudo, tiempos_validado, etiqueta_proveedor):
    """Boxplot comparando la métrica de dispersión antes/después de validar los datos
    (Caso real de cierre)."""
    fig, ax = plt.subplots(figsize=(7, 4))
    ax.boxplot([tiempos_crudo, tiempos_validado], positions=[1, 2])
    ax.set_xticks([1, 2])
    ax.set_xticklabels(["Sin validar", "Validado"])
    ax.set_ylabel("Tiempo de respuesta (ms)")
    ax.set_title(f"{etiqueta_proveedor}: efecto de validar los datos sobre la dispersión")
    plt.tight_layout()
    plt.show()
3.5 Desarrollo por etapas

Avanzas en este orden: construyes los datos, calculas cada medida de dispersión, comparas visualmente los conjuntos, mides el efecto del ruido sobre un modelo simple y terminas con un caso en que validar los datos cambia una decisión.

Etapa 1: Dataset sintético de notas y tiempos

Escribes a mano cuatro grupos de seis notas de examen (escala 0–100): dos con baja y alta dispersión, y dos con media parecida y variabilidad distinta. Agregas seis tiempos de respuesta en milisegundos, con un valor de 400 entre otros de 120 a 142, para comparar escalas con el coeficiente de variación.

# Notas de examen: grupo A (poca dispersión) y grupo B (mucha dispersión)
notas_baja_dispersion = np.array([74, 76, 75, 73, 77, 75])
notas_alta_dispersion = np.array([40, 95, 60, 88, 52, 90])

# Dos grupos con media similar pero variabilidad distinta (ambos en escala 0-100)
notas_media_similar_baja_var = np.array([70, 72, 71, 73, 70, 74])
notas_media_similar_alta_var = np.array([55, 85, 60, 90, 65, 80])

# Tiempos de respuesta (ms) — otra escala, para comparar con CV
tiempos_ms = np.array([120, 135, 128, 400, 142, 130])

df = pd.DataFrame({
    "notas_baja_disp": notas_baja_dispersion,
    "notas_alta_disp": notas_alta_dispersion,
    "sim_media_baja_var": notas_media_similar_baja_var,
    "sim_media_alta_var": notas_media_similar_alta_var,
    "tiempo_ms": tiempos_ms,
})
print(df)
print("\nMedias (columnas):")
print(df.mean())
   notas_baja_disp  notas_alta_disp  sim_media_baja_var  sim_media_alta_var  \
0               74               40                  70                  55   
1               76               95                  72                  85   
2               75               60                  71                  60   
3               73               88                  73                  90   
4               77               52                  70                  65   
5               75               90                  74                  80   

   tiempo_ms  
0        120  
1        135  
2        128  
3        400  
4        142  
5        130  

Medias (columnas):
notas_baja_disp        75.000000
notas_alta_disp        70.833333
sim_media_baja_var     71.666667
sim_media_alta_var     72.500000
tiempo_ms             175.833333
dtype: float64

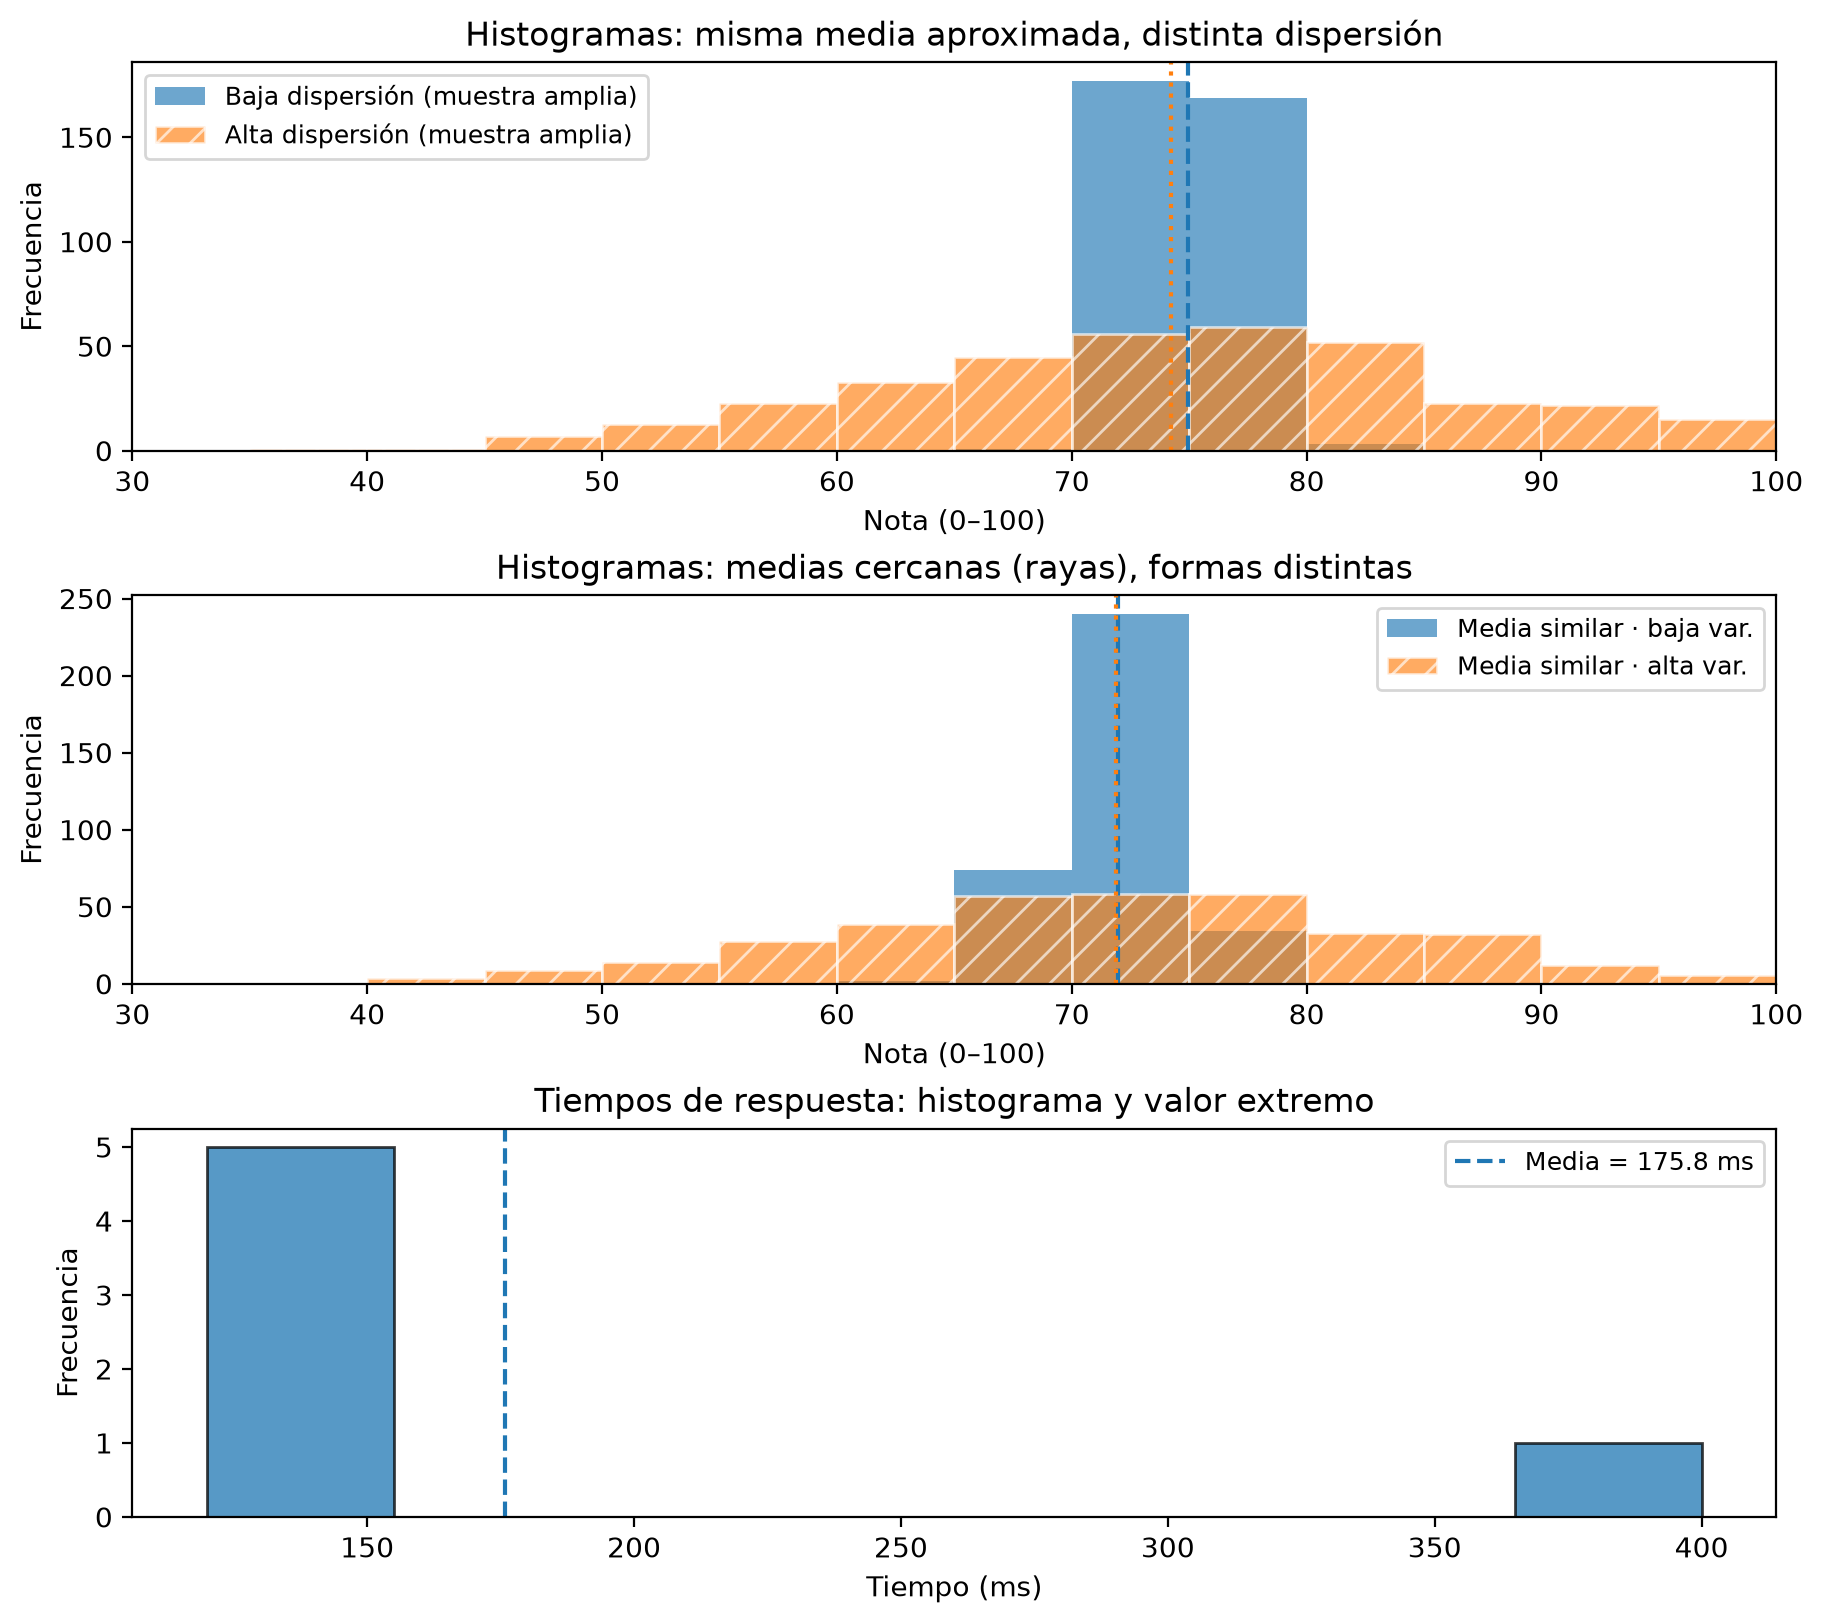
Las medias de los cuatro grupos de notas van de 70.83 a 75, y la de los tiempos es 175.83 ms, arrastrada por el 400. Con seis datos por grupo un histograma no muestra forma, así que para la figura simulas 350 notas por grupo con NumPy: centros de 75 y 72, y desviaciones de 2 frente a 12 y de 2.5 frente a 11. Es el mismo contraste de la tabla, no sus valores exactos. Los tiempos sí son los seis de la tabla.

En cada histograma, la altura de una barra indica cuántas observaciones caen en un intervalo, y las líneas verticales marcan la media de cada grupo (discontinua y punteada).

# Muestra más amplia (solo para que el histograma tenga forma más clara)
notas_baja_dispersion_hist = np.clip(rng.normal(loc=75, scale=2.0, size=350), 0, 100)
notas_alta_dispersion_hist = np.clip(rng.normal(loc=75, scale=12.0, size=350), 0, 100)
notas_media_similar_baja_var_hist = np.clip(rng.normal(loc=72, scale=2.5, size=350), 0, 100)
notas_media_similar_alta_var_hist = np.clip(rng.normal(loc=72, scale=11.0, size=350), 0, 100)

graficar_panorama_inicial(
    notas_baja_dispersion_hist, notas_alta_dispersion_hist,
    notas_media_similar_baja_var_hist, notas_media_similar_alta_var_hist,
    tiempos_ms,
)

Tres histogramas apilados. Arriba, dos grupos simulados de 350 notas con media cercana a 75: uno concentrado entre 70 y 81 y otro extendido de 39 a 100. En medio, dos grupos con media cercana a 72 con el mismo contraste. Abajo, los seis tiempos de respuesta: cinco entre 120 y 155 ms y uno aislado en 400, con la media en 175.8 ms.

En los dos primeros paneles las medias casi coinciden (las dos líneas verticales quedan juntas cerca de 75 y de 72), pero los histogramas naranjas se extienden de unos 40 hasta 100 y los azules se concentran en unos 10 a 15 puntos. En el tercer panel, cinco tiempos caen entre 120 y 155 ms y uno queda solo en 400: la media (175.8 ms) no coincide con ninguno de los seis.

  • Datos más estables: los valores se agrupan cerca unos de otros y hay menos sorpresas extremas.
  • Datos más variables: hay más diferencia entre casos, por diversidad real, por ruido de medición o por mezcla de subgrupos.

La media resume el centro, pero no el ancho de la nube. Antes de entrenar un modelo, además de “¿cuál es el valor típico?”, pregúntate “¿cuánto se mueve la variable alrededor de ese valor?”.

Etapa 2: Rango

El rango es la diferencia entre el máximo y el mínimo (Sección 3.1). Como solo depende de esos dos valores, no incorpora cómo se reparten los demás entre ellos, y un solo valor extremo puede inflarlo.

En machine learning, el rango te avisa rápido si una variable tiene una escala muy distinta de otra. En algoritmos basados en distancia (como k vecinos más cercanos o varios métodos de clustering), las variables con rangos grandes dominan el cálculo si no las escalas.

A mano, para notas_baja_disp: máximo 77, mínimo 73, rango = 77 − 73 = 4.

def rango_datos(x):
    return np.max(x) - np.min(x)

r_baja = rango_datos(notas_baja_dispersion)
r_alta = rango_datos(notas_alta_dispersion)
print(f"Rango notas baja dispersión: {r_baja}")
print(f"Rango notas alta dispersión: {r_alta}")
Rango notas baja dispersión: 4
Rango notas alta dispersión: 55

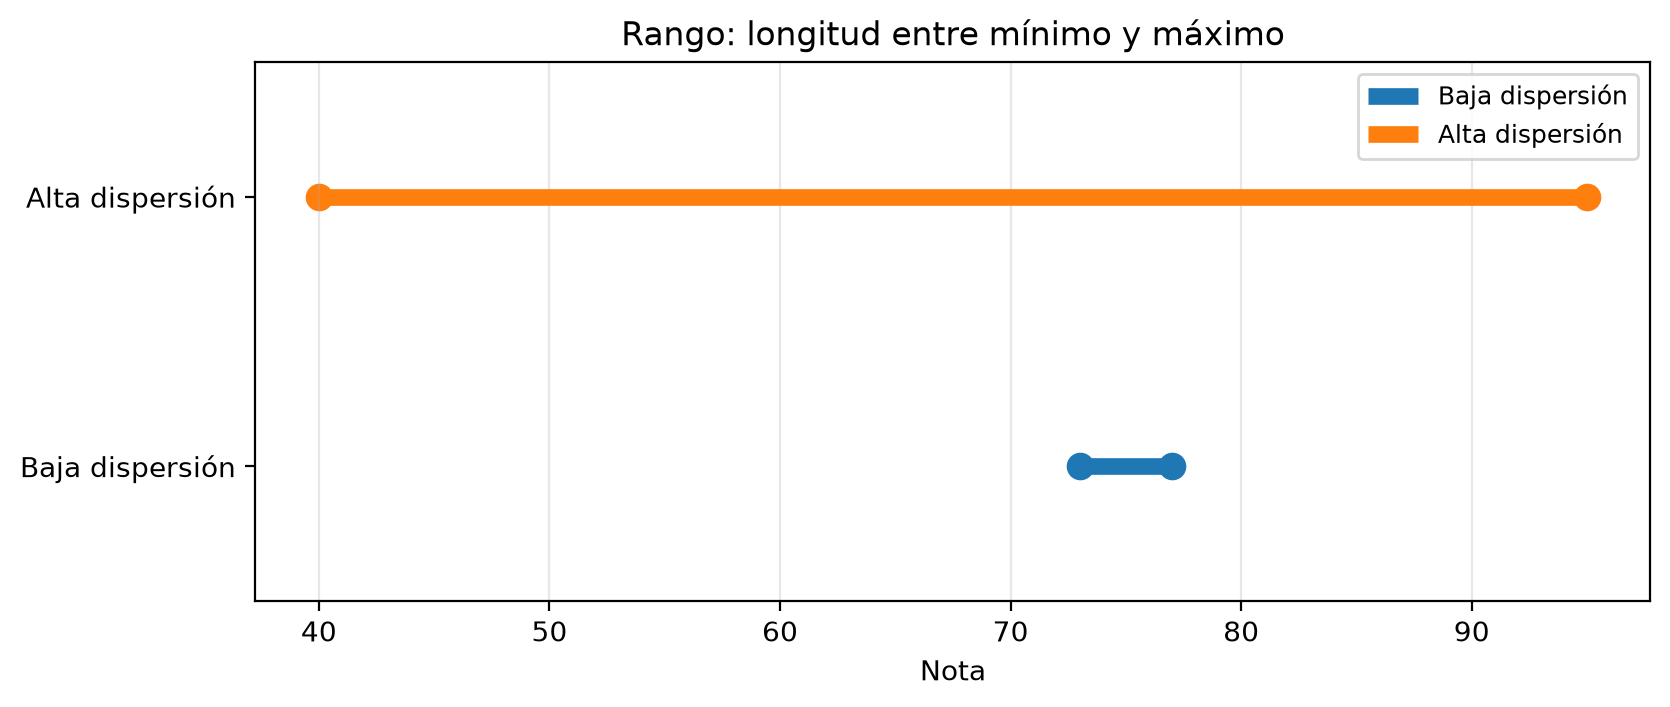
El rango pasa de 4 puntos en el grupo de baja dispersión a 55 en el de alta: el segundo grupo ocupa más de la mitad de la escala 0–100. En la figura, cada segmento va del mínimo al máximo de su grupo.

graficar_rango(notas_baja_dispersion, notas_alta_dispersion)

Dos segmentos horizontales del mínimo al máximo de cada grupo de notas. El de baja dispersión va de 73 a 77; el de alta dispersión, de 40 a 95.

Rango baja dispersión: 4
Rango alta dispersión: 55

El segmento naranja va de 40 a 95 y el azul de 73 a 77. Esa diferencia la deciden dos notas en cada grupo: el rango no dice nada de las otras cuatro.

Ejercicio

En el grupo de alta dispersión, cambia el 40 por un 10 sin tocar las otras cinco notas. ¿Qué pasa con el rango? ¿Ese cambio dice algo sobre cómo se comporta la mayoría de los datos?

El rango pasa de 55 a 85: sube un 55% por un solo dato. La mediana sigue en 74 porque las cuatro notas centrales no cambian, y la desviación estándar sube de 23.10 a 32.46. El rango solo describe los extremos; para saber cómo se reparte la mayoría necesitas una medida que use todos los datos o las posiciones centrales.

Etapa 3: Varianza

La varianza se entiende mejor en pasos cortos.

Paso 1: ¿por qué no basta sumar las desviaciones?

Las desviaciones \((x_i - \bar{x})\) son positivas y negativas, y su suma siempre da 0 (lo viste en el capítulo 2). Sumarlas no mide nada.

Paso 2: ¿por qué se elevan al cuadrado?

Al elevar cada desviación al cuadrado, todos los términos quedan positivos y las desviaciones grandes pesan más. El resultado crece con la variabilidad total.

Paso 3: fórmula

Fórmula muestral, la que usas con datos observados:

\[ s^2 = \frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2 \]

Fórmula poblacional, cuando tienes toda la población:

\[ \sigma^2 = \frac{1}{N} \sum_{i=1}^{N} (x_i - \mu)^2 \]

¿Por qué dividir entre \(n-1\) y no entre \(n\)? La media muestral \(\bar{x}\) se calcula con los mismos datos, así que queda “ajustada” a la muestra: en promedio, los datos están un poco más cerca de \(\bar{x}\) que de la media poblacional \(\mu\), que no conoces. Dividir entre \(n\) subestimaría la varianza de forma sistemática; dividir entre \(n-1\) (la corrección de Bessel) hace que \(s^2\) sea, en promedio, igual a \(\sigma^2\).

Paso 4: cálculo a mano

Datos: 70, 80 y 90. Media \(\bar{x} = 80\). Desviaciones: −10, 0 y 10. Cuadrados: 100, 0 y 100. Suma: 200. Con \(n = 3\):

\[ s^2 = \frac{200}{3-1} = 100 \]

Paso 5: cálculo en Python

Calculas la varianza muestral con np.var(x, ddof=1).

Cuidado con el valor por defecto: np.var y np.std usan ddof=0 (poblacional), mientras que .var() y .std() de pandas usan ddof=1 (muestral). La misma columna da dos números distintos si no indicas ddof. En este capítulo siempre se escribe explícito.

Relación con machine learning

Muchos modelos de regresión, y muchas redes neuronales, se entrenan minimizando el error cuadrático medio (MSE): el promedio de los cuadrados de los errores. Es la misma idea de la varianza aplicada a los errores: los desvíos grandes pesan más.

Cuando la variable que quieres predecir tiene mucha variación que el modelo no puede explicar, el error crece y las predicciones se vuelven más sensibles a qué datos tocaron en el entrenamiento. Un modelo muy flexible puede además ajustarse al ruido: es la intuición del sobreajuste, que el capítulo 15 trata con el equilibrio entre sesgo y varianza del modelo.

# Varianza muestral (ddof=1) y poblacional (ddof=0)
v_baja = np.var(notas_baja_dispersion, ddof=1)
v_alta = np.var(notas_alta_dispersion, ddof=1)

print(f"Varianza muestral notas baja dispersión: {v_baja:.4f}")
print(f"Varianza muestral notas alta dispersión: {v_alta:.4f}")

# Misma media aproximada, distinta varianza
m1 = notas_media_similar_baja_var
m2 = notas_media_similar_alta_var
print(f"Medias: {m1.mean():.2f} vs {m2.mean():.2f}")
print(f"Varianzas: {np.var(m1, ddof=1):.4f} vs {np.var(m2, ddof=1):.4f}")
Varianza muestral notas baja dispersión: 2.0000
Varianza muestral notas alta dispersión: 533.7667
Medias: 71.67 vs 72.50
Varianzas: 2.6667 vs 207.5000

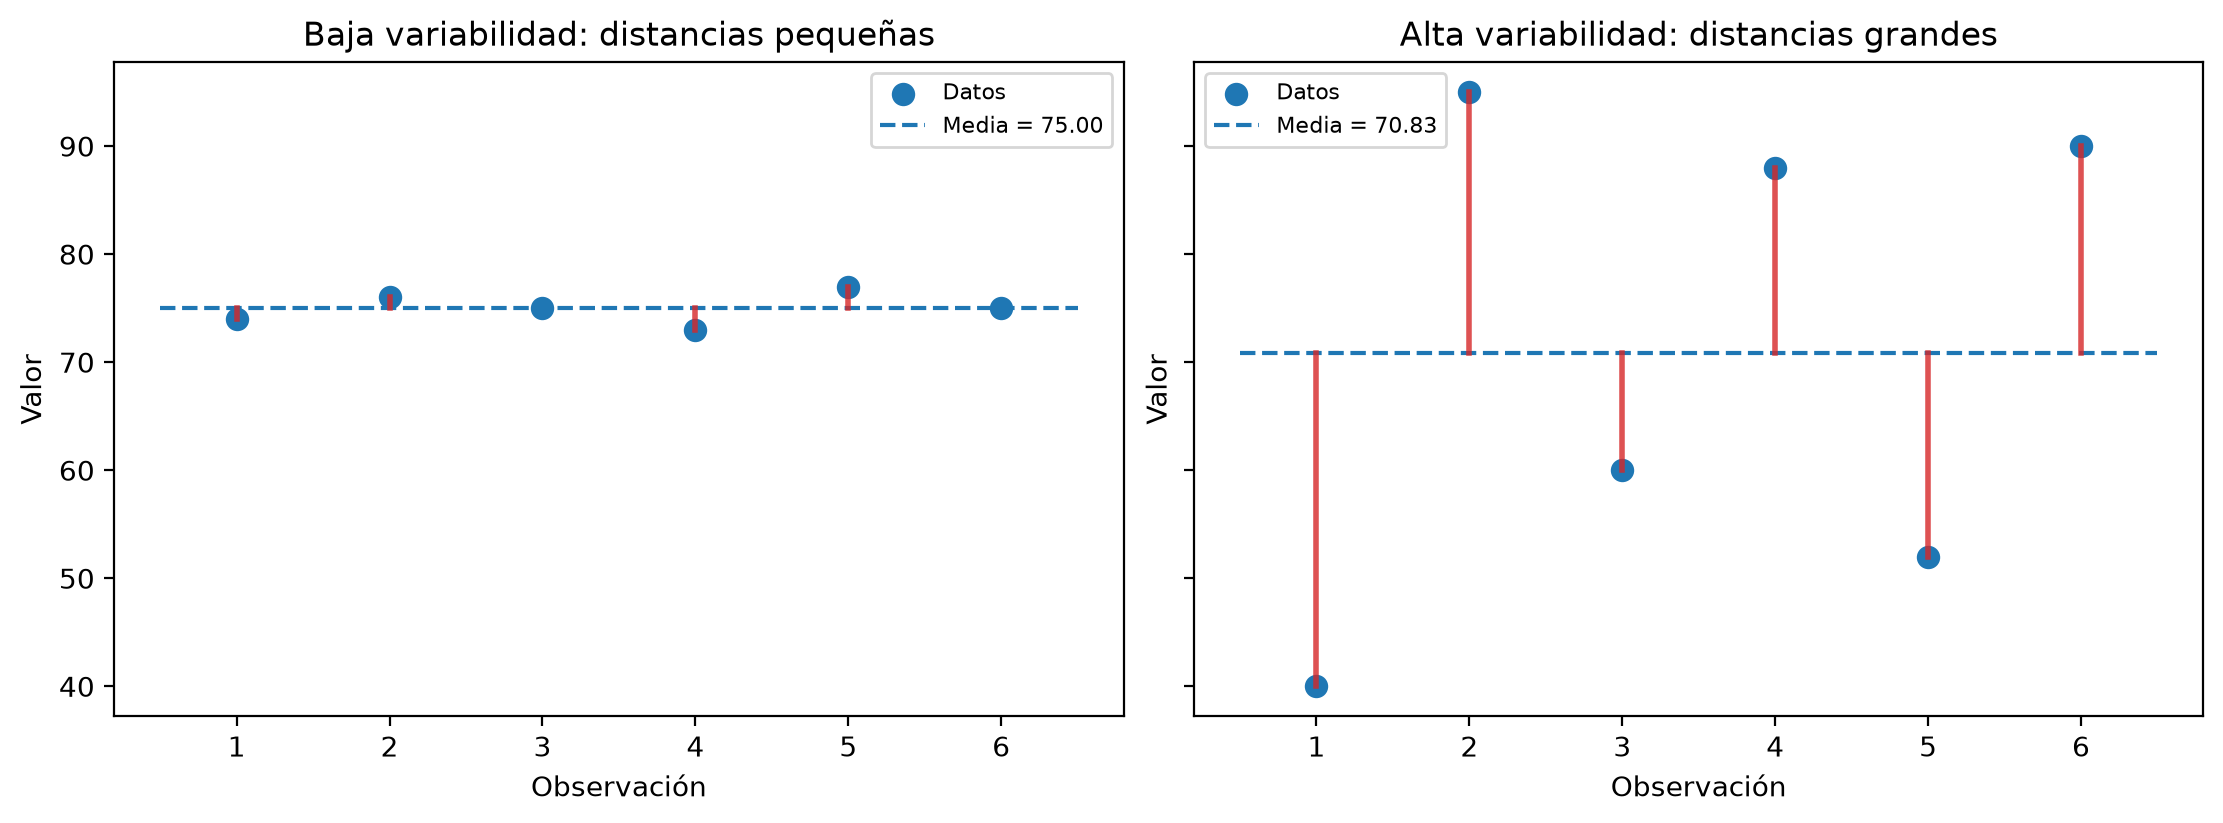
La varianza muestral es 2.00 en el grupo de baja dispersión y 533.77 en el de alta: unas 267 veces más. Los dos grupos de media parecida (71.67 y 72.50) tienen varianzas de 2.67 y 207.50. En la figura, cada segmento rojo es la distancia de una nota a la media de su grupo; los dos paneles comparten escala vertical.

graficar_desviaciones_comparadas(
    notas_baja_dispersion, notas_alta_dispersion,
    'Baja variabilidad: distancias pequeñas', 'Alta variabilidad: distancias grandes',
)

Dos paneles con seis notas cada uno y una línea discontinua en la media. A la izquierda, media 75 y distancias de no más de 2 puntos; a la derecha, media 70.83 y distancias de hasta unos 30 puntos, marcadas con segmentos rojos.

En el panel de baja variabilidad, las seis distancias no pasan de 2 puntos; en el de alta, la del 40 mide más de 30. La varianza promedia esos cuadrados, así que queda en puntos al cuadrado, una unidad difícil de leer. Por eso la siguiente etapa usa la desviación estándar.

Etapa 4: Desviación estándar

Es la raíz cuadrada de la varianza, \(s = \sqrt{s^2}\), y vuelve a las mismas unidades que los datos (puntos de examen, milisegundos). Se lee como el alejamiento típico respecto a la media.

Dónde la vas a usar en machine learning:

  • Estandarización: el z-score \(z_i = \frac{x_i - \bar{x}}{s}\) expresa cada valor en desviaciones estándar respecto a su media.
  • Valores atípicos: un \(|z|\) grande marca un valor lejano para su grupo.
  • Entrenamiento de redes neuronales: entradas en escalas comparables suelen dar una optimización más estable.
s_baja = np.std(notas_baja_dispersion, ddof=1)
s_alta = np.std(notas_alta_dispersion, ddof=1)

print(f"Desviación estándar (notas baja dispersión): {s_baja:.4f} puntos")
print(f"Desviación estándar (notas alta dispersión): {s_alta:.4f} puntos")

# Z-score del primer dato del grupo de alta dispersión
x0 = notas_alta_dispersion[0]
z0 = (x0 - notas_alta_dispersion.mean()) / s_alta
print(f"\nEjemplo z-score para nota {x0}: {z0:.3f}")
Desviación estándar (notas baja dispersión): 1.4142 puntos
Desviación estándar (notas alta dispersión): 23.1034 puntos

Ejemplo z-score para nota 40: -1.335

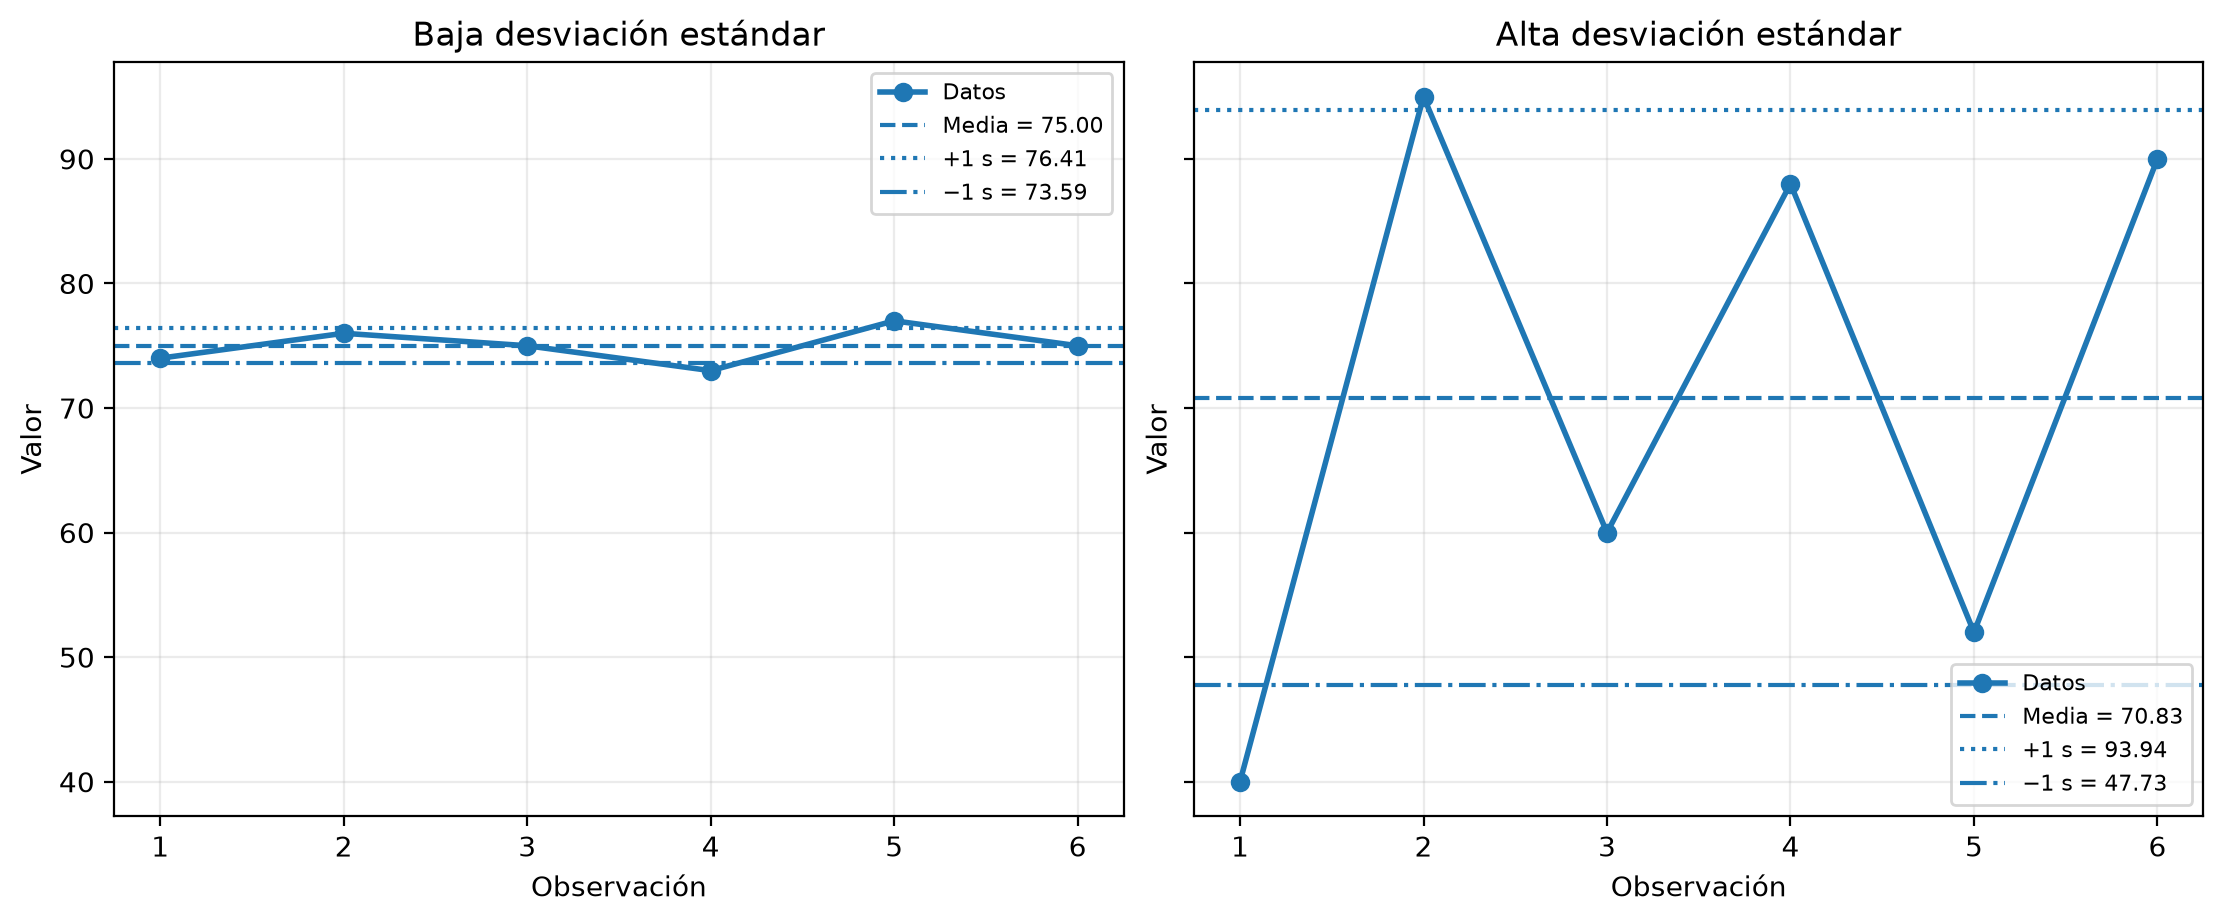
La desviación estándar es 1.41 puntos en el grupo de baja dispersión y 23.10 en el de alta. La nota 40 del segundo grupo tiene un z-score de −1.335: está a poco más de una desviación estándar por debajo de la media (70.83). En la figura, las líneas punteadas marcan la media ± 1 desviación estándar.

graficar_bandas_std(notas_baja_dispersion, notas_alta_dispersion)

Dos paneles con las seis notas unidas por una línea, la media y las bandas de más y menos una desviación estándar. A la izquierda, la banda va de 73.59 a 76.41 y solo las notas 73 y 77 quedan apenas fuera; a la derecha, de 47.73 a 93.94, y las notas 40 y 95 quedan fuera.

En el grupo de baja dispersión, la banda va de 73.59 a 76.41: cuatro notas quedan dentro y el 73 y el 77 apenas fuera. En el de alta va de 47.73 a 93.94 y deja fuera al 40 y al 95, aunque es 16 veces más ancha. El z-score dice cuán extremo es un valor en unidades de la dispersión de su grupo, no en puntos.

Conexión con el capítulo 2: imputar con la media reduce la dispersión. En el capítulo 2 viste que rellenar faltantes con la media crea un pico artificial. Ahora puedes medir su efecto con la desviación estándar: simulas 60 notas, borras 15 y las rellenas con la media de las 45 restantes.

rng_imp = rng  # mismo generador central
notas_completas = rng_imp.normal(70, 10, size=60).round(1)
faltan = rng_imp.choice(60, size=15, replace=False)
notas_imputadas = notas_completas.copy()
notas_imputadas[faltan] = np.nan
notas_imputadas[faltan] = np.nanmean(notas_imputadas)

print(f"Desv. estándar con los 60 datos reales:       {np.std(notas_completas, ddof=1):.2f}")
print(f"Desv. estándar tras imputar 15 con la media:  {np.std(notas_imputadas, ddof=1):.2f}")
Desv. estándar con los 60 datos reales:       10.51
Desv. estándar tras imputar 15 con la media:  9.50

La desviación estándar baja de 10.51 a 9.50 (un 9.6% menos), aunque los 45 valores observados no cambiaron. Los 15 valores imputados quedan exactamente en la media, a distancia cero de ella: no suman nada a los cuadrados y la desviación estándar baja. Un modelo entrenado con esos datos trata la variable como más estable de lo que es.

Ejercicio

Una nota de 40 parece muy baja, pero su z-score en el grupo de alta dispersión es −1.34. En el grupo de baja dispersión (media 75, \(s \approx 1.41\)), ese mismo 40 tendría un z-score cercano a −25. ¿Por qué el mismo valor es corriente en un grupo y absurdo en el otro? ¿Qué te dice esto sobre juzgar valores atípicos solo por su magnitud?

El z-score mide la distancia en unidades de la dispersión del grupo: \((40 - 75)/1.41 \approx -24.7\) frente a \((40 - 70.83)/23.10 \approx -1.34\). Un valor es atípico respecto a la variabilidad de los datos con que lo comparas, no por su tamaño. Por eso los criterios de atípicos del capítulo 4 se expresan en desviaciones estándar o en rangos intercuartílicos, nunca en unidades absolutas.

Dos combinaciones que conviene distinguir: media y varianza son independientes

Media y varianza describen cosas distintas y pueden variar por separado. Lo compruebas con 400 valores simulados por grupo en dos casos:

  1. Misma media, distinta varianza: el centro es igual, pero un grupo está mucho más disperso.
  2. Misma varianza, distinta media: el ancho de la nube es igual, pero está centrada en lugares distintos.

Al final estandarizas los cuatro grupos con el z-score para verlos en una escala común (media 0, desviación 1).

# Caso 1: misma media, distinta varianza
dist_misma_media_var_baja = rng.normal(loc=70, scale=2.0, size=400)
dist_misma_media_var_alta = rng.normal(loc=70, scale=10.0, size=400)

graficar_comparacion_distribuciones(
    dist_misma_media_var_baja, dist_misma_media_var_alta,
    "Caso 1 — Misma media (≈70), distinta varianza",
    "Baja varianza", "Alta varianza",
)

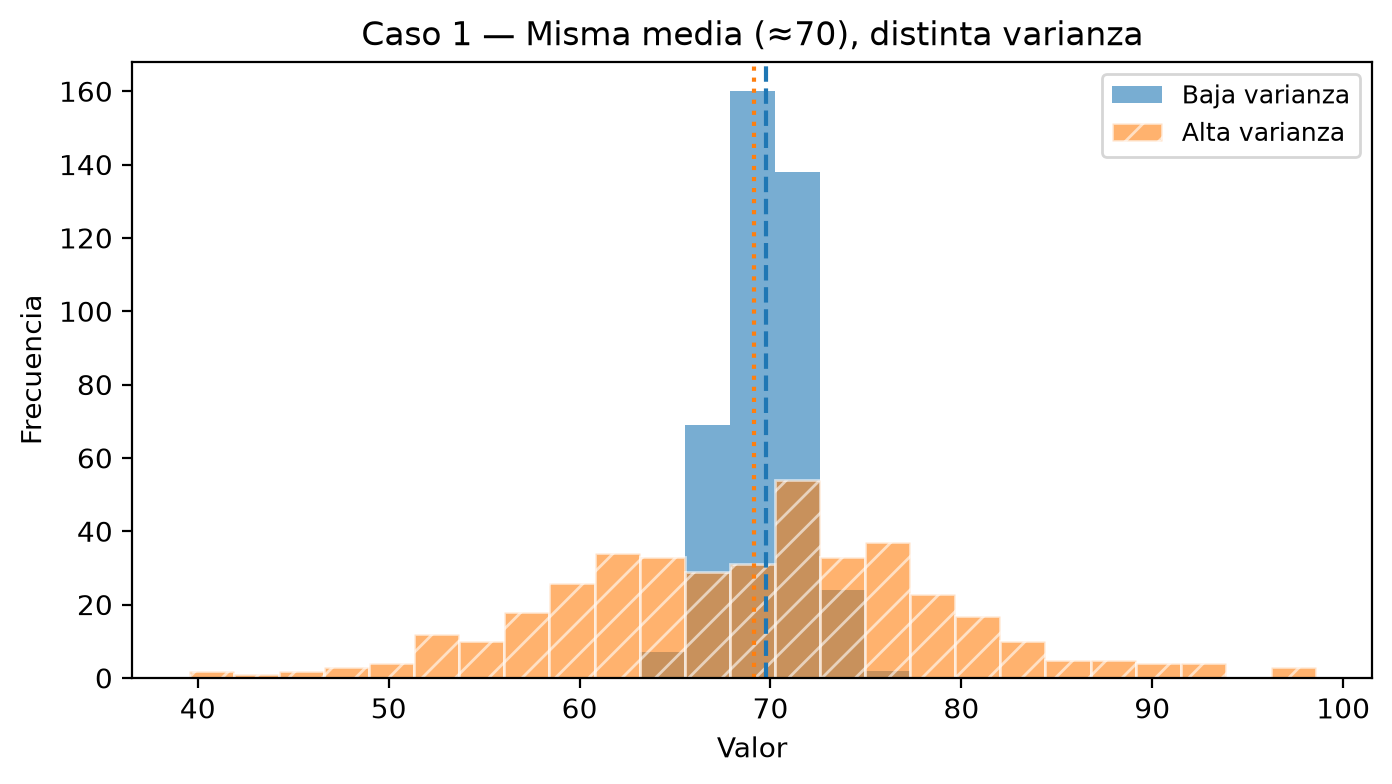
Histogramas superpuestos de dos grupos simulados de 400 valores con media cercana a 70: el de baja varianza se concentra entre 64 y 76 y el de alta varianza se extiende de 39 a 99. Las líneas de las medias casi coinciden.

Media Baja varianza: 69.75 | Desv. estándar: 1.98
Media Alta varianza: 69.14 | Desv. estándar: 9.73
# Caso 2: misma varianza, distinta media
dist_media_baja = rng.normal(loc=55, scale=6.0, size=400)
dist_media_alta = rng.normal(loc=85, scale=6.0, size=400)

graficar_comparacion_distribuciones(
    dist_media_baja, dist_media_alta,
    "Caso 2 — Misma varianza (≈6²), distinta media",
    "Media baja (≈55)", "Media alta (≈85)",
)

# Z-score de ambos casos para verlos en escala común
z1a = (dist_misma_media_var_baja - dist_misma_media_var_baja.mean()) / dist_misma_media_var_baja.std(ddof=1)
z1b = (dist_misma_media_var_alta - dist_misma_media_var_alta.mean()) / dist_misma_media_var_alta.std(ddof=1)
z2a = (dist_media_baja - dist_media_baja.mean()) / dist_media_baja.std(ddof=1)
z2b = (dist_media_alta - dist_media_alta.mean()) / dist_media_alta.std(ddof=1)

print(f"\nCaso 1 tras z-score — medias: {z1a.mean():.3f}, {z1b.mean():.3f} | desv. est.: {z1a.std(ddof=1):.3f}, {z1b.std(ddof=1):.3f}")
print(f"Caso 2 tras z-score — medias: {z2a.mean():.3f}, {z2b.mean():.3f} | desv. est.: {z2a.std(ddof=1):.3f}, {z2b.std(ddof=1):.3f}")

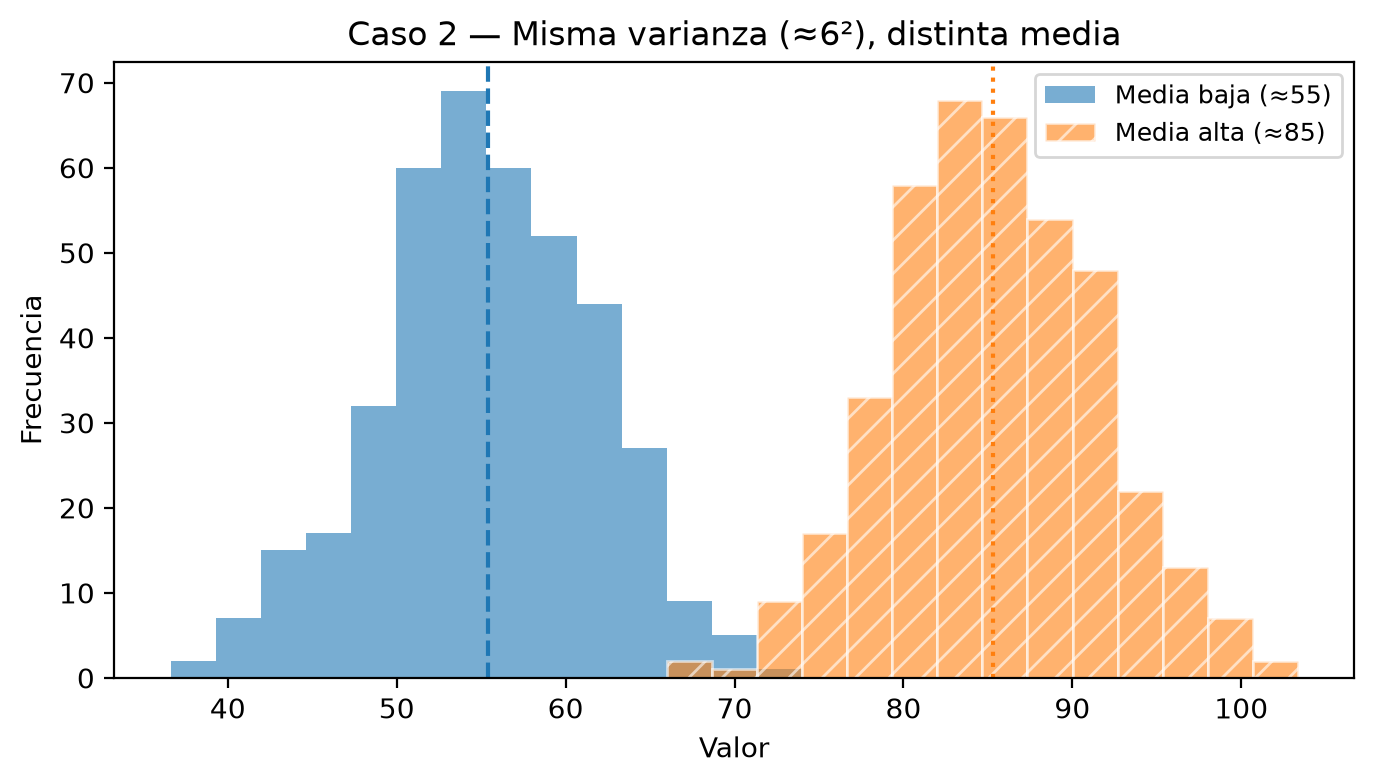
Histogramas de dos grupos simulados con el mismo ancho y medias separadas: uno centrado cerca de 55 y otro cerca de 85, apenas superpuestos entre 68 y 72.

Media Media baja (≈55): 55.37 | Desv. estándar: 6.32
Media Media alta (≈85): 85.29 | Desv. estándar: 6.10

Caso 1 tras z-score — medias: -0.000, 0.000 | desv. est.: 1.000, 1.000
Caso 2 tras z-score — medias: -0.000, -0.000 | desv. est.: 1.000, 1.000
# Ejemplo equivalente en pandas: creación de una variable estandarizada
df_estandar = pd.DataFrame({'puntaje': dist_misma_media_var_alta})
df_estandar['z_puntaje'] = (df_estandar['puntaje'] - df_estandar['puntaje'].mean()) / df_estandar['puntaje'].std(ddof=1)

print("Primeras filas (pandas):")
print(df_estandar.head())
print(f"Media de z_puntaje: {df_estandar['z_puntaje'].mean():.4f}")
print(f"Desv. estándar de z_puntaje: {df_estandar['z_puntaje'].std(ddof=1):.4f}")
Primeras filas (pandas):
     puntaje  z_puntaje
0  51.716047  -1.790822
1  77.298288   0.838323
2  88.089145   1.947324
3  84.253289   1.553104
4  53.739155  -1.582903
Media de z_puntaje: 0.0000
Desv. estándar de z_puntaje: 1.0000

En el caso 1, las medias son 69.75 y 69.14 y las desviaciones 1.98 y 9.73: los histogramas comparten centro y uno es unas cinco veces más ancho. En el caso 2, las desviaciones son parecidas (6.32 y 6.10) y las medias quedan 30 puntos separadas (55.37 y 85.29). Tras el z-score (con NumPy y con pandas), los cuatro grupos tienen media 0 y desviación 1: la estandarización borra tanto la diferencia de centro como la de escala, y conserva solo la forma.

Etapa 5: Coeficiente de variación (CV)

El CV es la dispersión relativa al tamaño típico de la variable, y suele darse en porcentaje:

\[\text{CV} = 100 \cdot \frac{s}{\bar{x}} \quad (\text{si } \bar{x} > 0)\]

Te sirve para comparar la inestabilidad relativa de variables medidas en unidades distintas (notas frente a milisegundos). Exige que la variable tenga cero absoluto (escala de razón, capítulo 1) y media positiva: con °C, con datos estandarizados (media 0) o con medias cercanas a cero no tiene interpretación.

En el análisis exploratorio, el CV te ayuda a ver qué variables son relativamente más inestables, lo que orienta el preprocesamiento.

def coef_variacion(x, porcentaje=True):
    media = np.mean(x)
    s = np.std(x, ddof=1)
    if media == 0:
        return np.nan
    cv = s / media
    return 100 * cv if porcentaje else cv

cv_notas = coef_variacion(notas_baja_dispersion)
cv_tiempos = coef_variacion(tiempos_ms)

print(f"CV% notas (baja dispersión): {cv_notas:.2f}%")
print(f"CV% tiempos (ms): {cv_tiempos:.2f}%")
# Aunque la desviación en ms sea "grande" en valor absoluto, el CV compara con la media.
CV% notas (baja dispersión): 1.89%
CV% tiempos (ms): 62.59%

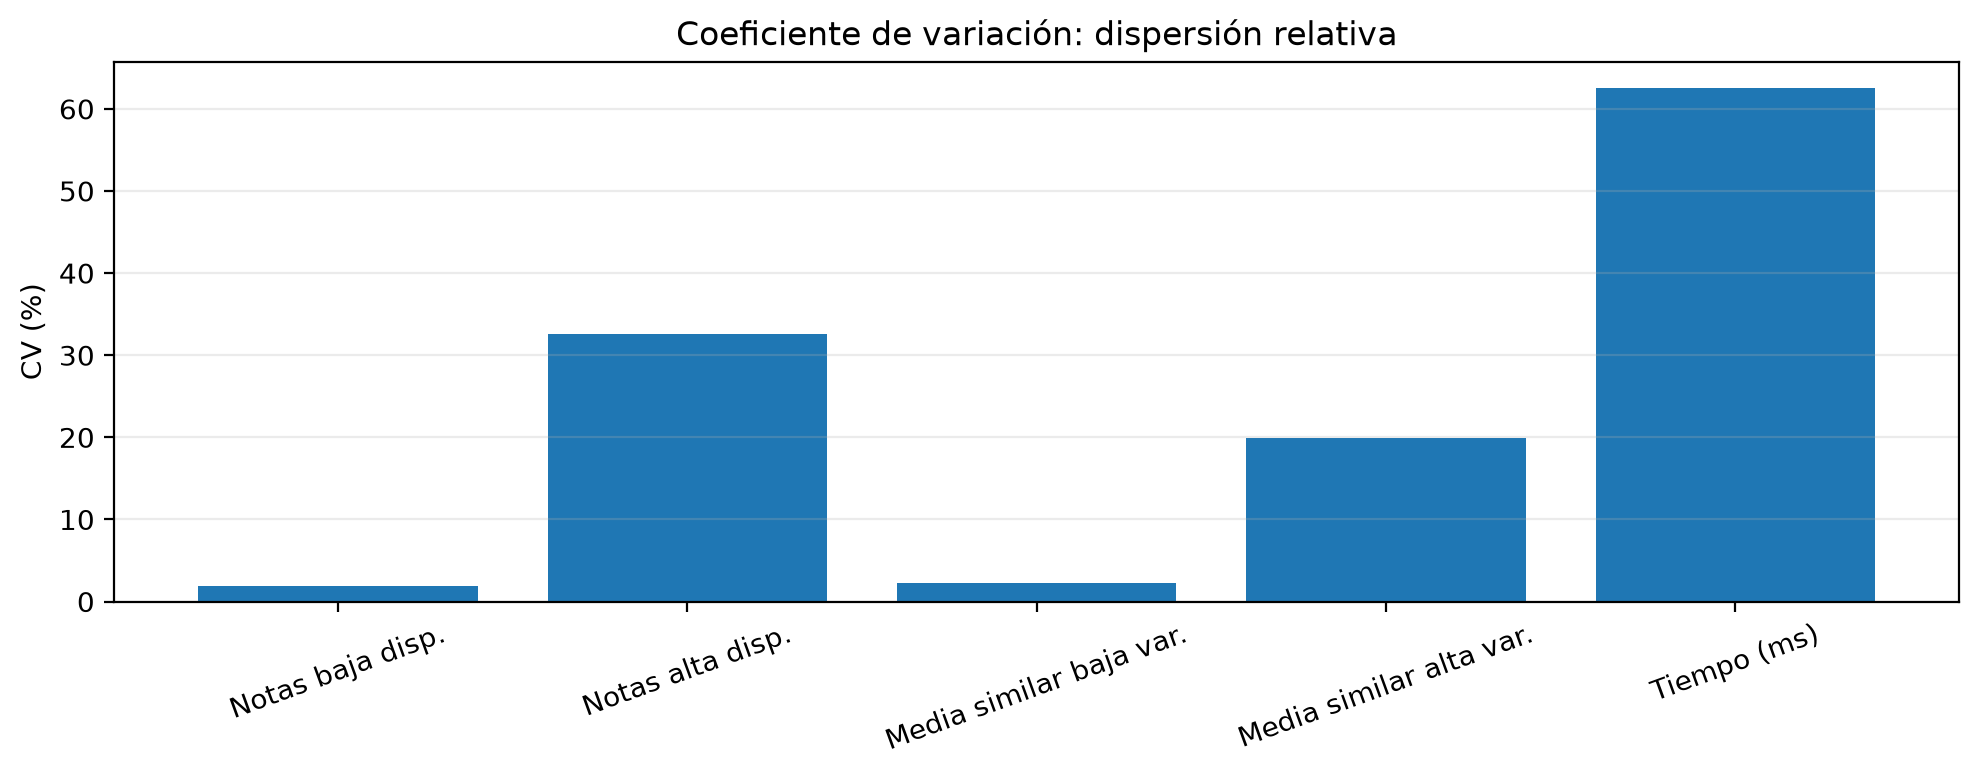
El CV de las notas de baja dispersión es 1.89% y el de los tiempos 62.59%: en relación con su media, los tiempos varían unas 33 veces más. Ese 62.59% se debe casi por completo al 400: sin él, los cinco tiempos restantes (120 a 142 ms) tienen media 131, desviación 8.19 y CV 6.25%. La figura compara los cinco conjuntos.

cv_labels = ['Notas baja disp.', 'Notas alta disp.', 'Media similar baja var.', 'Media similar alta var.', 'Tiempo (ms)']
cv_vals = [
    coef_variacion(notas_baja_dispersion),
    coef_variacion(notas_alta_dispersion),
    coef_variacion(notas_media_similar_baja_var),
    coef_variacion(notas_media_similar_alta_var),
    coef_variacion(tiempos_ms),
]
graficar_cv_barras(cv_labels, cv_vals)

Barras del coeficiente de variación de cinco conjuntos: notas de baja dispersión 1.9%, notas de alta dispersión 32.6%, media similar con baja variabilidad 2.3%, media similar con alta variabilidad 19.9% y tiempos en milisegundos 62.6%.

Las barras van de 1.89% (notas de baja dispersión) a 62.59% (tiempos). Las notas de alta dispersión quedan en 32.6% y las de media parecida en 2.3% y 19.9%. El CV te dice si la variabilidad es grande o pequeña en relación con la media, y así puedes comparar, con cautela, magnitudes en escalas distintas.

Etapa 6: Comparación visual entre distribuciones

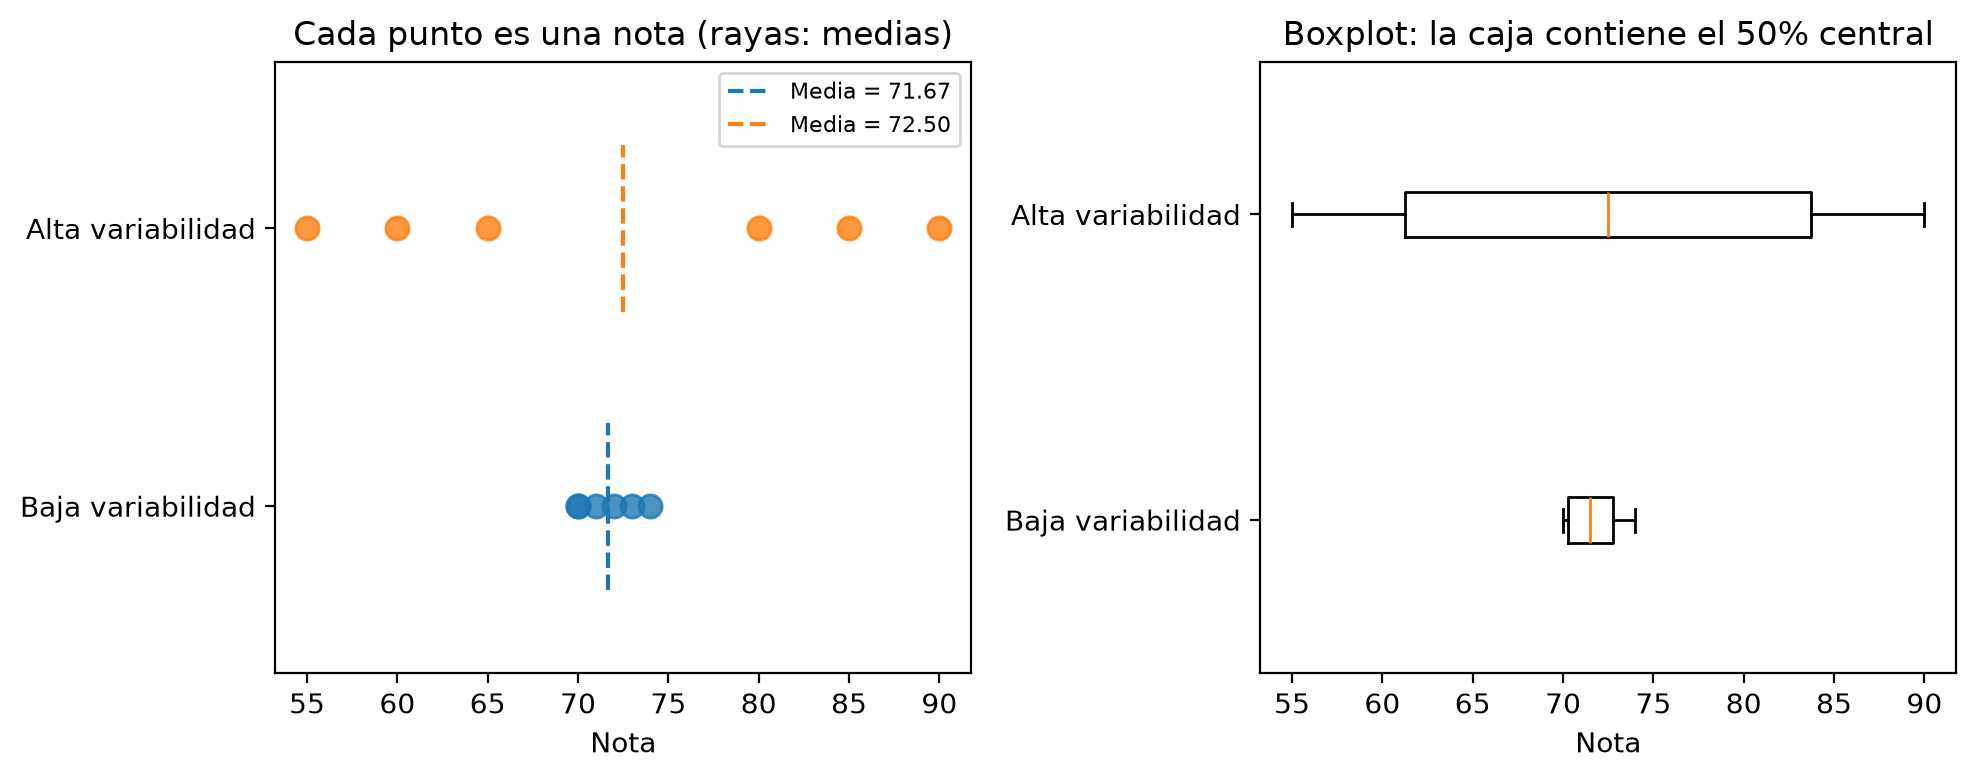
Si dos grupos tienen medias parecidas, ¿cómo distingues en un gráfico cuál es más estable? Comparas los dos grupos de media parecida con dos vistas: cada nota como un punto y un boxplot.

El boxplot resume una variable con cinco números: la línea central es la mediana, la caja contiene el 50% central de los datos y los bigotes llegan hasta los valores no atípicos. Sus cuartiles se estudian en el capítulo 4; aquí basta leer el ancho de la caja.

graficar_hist_boxplot(
    notas_media_similar_baja_var, notas_media_similar_alta_var,
    "Baja variabilidad", "Alta variabilidad",
    bins_a=np.arange(68, 76) - 0.5, bins_b=np.arange(50, 95, 5) - 2.5,
)

media_baja = notas_media_similar_baja_var.mean()
media_alta = notas_media_similar_alta_var.mean()
print(f"Medias: {media_baja:.2f} vs {media_alta:.2f}")
print(f"Desv. est.: {np.std(notas_media_similar_baja_var, ddof=1):.2f} vs {np.std(notas_media_similar_alta_var, ddof=1):.2f}")

A la izquierda, las seis notas de cada grupo como puntos: el grupo de baja variabilidad entre 70 y 74 con media 71.67, y el de alta variabilidad entre 55 y 90 con media 72.50. A la derecha, los boxplots: la caja del grupo de alta variabilidad va de 61.25 a 83.75 y la del grupo de baja variabilidad, de 70.25 a 72.75.

Medias: 71.67 vs 72.50
Desv. est.: 1.63 vs 14.40

Las medias son 71.67 y 72.50 y las desviaciones estándar 1.63 y 14.40. En el panel de puntos, las seis notas del grupo estable caben entre 70 y 74, mientras las del otro van de 55 a 90 y ninguna cae cerca de su media. En el boxplot, la caja del grupo variable va de 61.25 a 83.75 (22.5 puntos); la del estable, de 70.25 a 72.75 (2.5 puntos).

Tabla resumen comparativa

Reúnes en una tabla la media y las cuatro medidas de dispersión de los cuatro grupos de notas.

def resumen_metricas(nombre, x):
    media = np.mean(x)
    rango = np.max(x) - np.min(x)
    varianza = np.var(x, ddof=1)
    desv = np.std(x, ddof=1)
    cv = (desv / media) * 100 if media != 0 else np.nan
    return {
        "conjunto": nombre,
        "media": media,
        "rango": rango,
        "varianza": varianza,
        "desviación_estándar": desv,
        "coef_variación_%": cv,
    }

resumen = pd.DataFrame([
    resumen_metricas("notas_baja_disp", notas_baja_dispersion),
    resumen_metricas("notas_alta_disp", notas_alta_dispersion),
    resumen_metricas("sim_media_baja_var", notas_media_similar_baja_var),
    resumen_metricas("sim_media_alta_var", notas_media_similar_alta_var),
]).set_index("conjunto")

print(resumen.round(3))
                     media  rango  varianza  desviación_estándar  \
conjunto                                                           
notas_baja_disp     75.000      4     2.000                1.414   
notas_alta_disp     70.833     55   533.767               23.103   
sim_media_baja_var  71.667      4     2.667                1.633   
sim_media_alta_var  72.500     35   207.500               14.405   

                    coef_variación_%  
conjunto                              
notas_baja_disp                1.886  
notas_alta_disp               32.617  
sim_media_baja_var             2.279  
sim_media_alta_var            19.869  

La tabla confirma lo que mostraron los gráficos: notas_alta_disp tiene rango 55, desviación 23.10 y CV 32.6%; sim_media_alta_var, rango 35, desviación 14.40 y CV 19.9%. Los dos grupos estables no pasan de rango 4 ni de CV 2.3%.

  • Rango: aviso rápido de escala y extremos; no resume la dispersión de la mayoría.
  • Varianza: misma información que la desviación estándar, pero en unidades al cuadrado.
  • Desviación estándar: la medida para comparar grupos en la misma escala; aquí, 1.63 frente a 14.40 con medias casi iguales.
  • CV: la medida para comparar variables de escalas distintas, siempre que tengan cero absoluto.

Ejercicios

  1. Para comparar sim_media_baja_var con sim_media_alta_var, ¿qué medida usarías: rango, desviación estándar o coeficiente de variación? Justifícalo en una frase.
  2. Si usaras las notas y los tiempos en milisegundos como variables de un algoritmo de k vecinos más cercanos sin escalarlas, ¿cuál dominaría las distancias?
  1. La desviación estándar: los dos grupos están en la misma escala (0–100) y tienen medias casi iguales, así que 1.63 frente a 14.40 se lee directamente en puntos. El CV daría la misma conclusión (2.3% frente a 19.9%), pero no hace falta pasar a una medida relativa.
  2. Los tiempos. Su desviación estándar es de 110 ms, frente a 1.41 puntos en las notas de baja dispersión y 23.10 en las de alta: una diferencia típica entre dos tiempos pesa decenas de veces más que una diferencia típica entre dos notas. Estandarizar cada variable (dividir por su desviación estándar) pone las dos en la misma escala.

Etapa 7: Dispersión y estabilidad en modelos

Alta dispersión no es mala por sí sola: a veces refleja diversidad real. Pero suele implicar más dificultad para encontrar un patrón simple, o más ruido si las mediciones son inestables.

  • k vecinos más cercanos: decide por proximidad; una variable con rango enorme pesa demasiado sin escalado (ejercicio anterior).
  • Clustering: los grupos pueden verse estirados o mezclados si no tienes en cuenta la escala y la dispersión.
  • Regresión: los errores cuadráticos grandes pueden venir de zonas muy variables o de valores atípicos.
  • Redes neuronales: suelen entrenarse mejor con entradas estandarizadas.

Medir y visualizar la dispersión es parte del análisis exploratorio, antes de entrenar y junto con la limpieza, el escalamiento, el manejo de atípicos y la validación.

Etapa 8: Ejemplo final en machine learning

Ajustas una recta por mínimos cuadrados a 300 puntos simulados con la misma relación \(y = 4 + 3x\), en dos escenarios:

  • Escenario A (baja dispersión): ruido normal con desviación 1.5 alrededor de la recta.
  • Escenario B (alta dispersión): ruido normal con desviación 8 alrededor de la misma recta.

Separas al azar el 80% para entrenar y el 20% para evaluar, de modo que la prueba cubra todo el rango de \(x\) (el capítulo 15 explica por qué). Comparas tres métricas en la prueba:

  • MSE (error cuadrático medio): menor es mejor.
  • MAE (error absoluto medio): menor es mejor.
  • \(R^2\) (coeficiente de determinación): mayor es mejor.

Estas métricas se estudian a fondo en los capítulos 13 a 15; aquí basta leer su dirección.

# 1) Generación de datos sintéticos
n = 300
x = np.linspace(0, 10, n)
y_real = 4 + 3 * x  # relación real subyacente

# Dos niveles de dispersión (ruido)
ruido_bajo = rng.normal(0, 1.5, n)
ruido_alto = rng.normal(0, 8.0, n)
y_baja_disp = y_real + ruido_bajo
y_alta_disp = y_real + ruido_alto

# 2) Separación aleatoria train/test (80/20): la prueba cubre todo el rango de x
idx = rng.permutation(n)
corte = int(0.8 * n)
tr, te = idx[:corte], idx[corte:]
x_train, x_test = x[tr], x[te]
yb_train, yb_test = y_baja_disp[tr], y_baja_disp[te]
ya_train, ya_test = y_alta_disp[tr], y_alta_disp[te]

# 3) Ajuste de regresión lineal por mínimos cuadrados (numpy.polyfit)
mb, bb = np.polyfit(x_train, yb_train, 1)
ma, ba = np.polyfit(x_train, ya_train, 1)
yb_pred = mb * x_test + bb
ya_pred = ma * x_test + ba

# 4) Métricas
def metricas(y_true, y_pred):
    mse = np.mean((y_true - y_pred) ** 2)
    mae = np.mean(np.abs(y_true - y_pred))
    sst = np.sum((y_true - np.mean(y_true)) ** 2)
    sse = np.sum((y_true - y_pred) ** 2)
    r2 = 1 - (sse / sst)
    return mse, mae, r2

mse_b, mae_b, r2_b = metricas(yb_test, yb_pred)
mse_a, mae_a, r2_a = metricas(ya_test, ya_pred)

comparacion_ml = pd.DataFrame({
    'escenario': ['Baja dispersión', 'Alta dispersión'],
    'MSE': [mse_b, mse_a], 'MAE': [mae_b, mae_a], 'R2': [r2_b, r2_a],
})
print(comparacion_ml.round(4))

# 5) Visualización comparativa
graficar_comparacion_modelos(
    x_test,
    {'Baja dispersión': yb_test, 'Alta dispersión': ya_test},
    {'Baja dispersión': yb_pred, 'Alta dispersión': ya_pred},
)
         escenario      MSE     MAE      R2
0  Baja dispersión   1.9478  1.1571  0.9758
1  Alta dispersión  57.2116  5.9698  0.6305

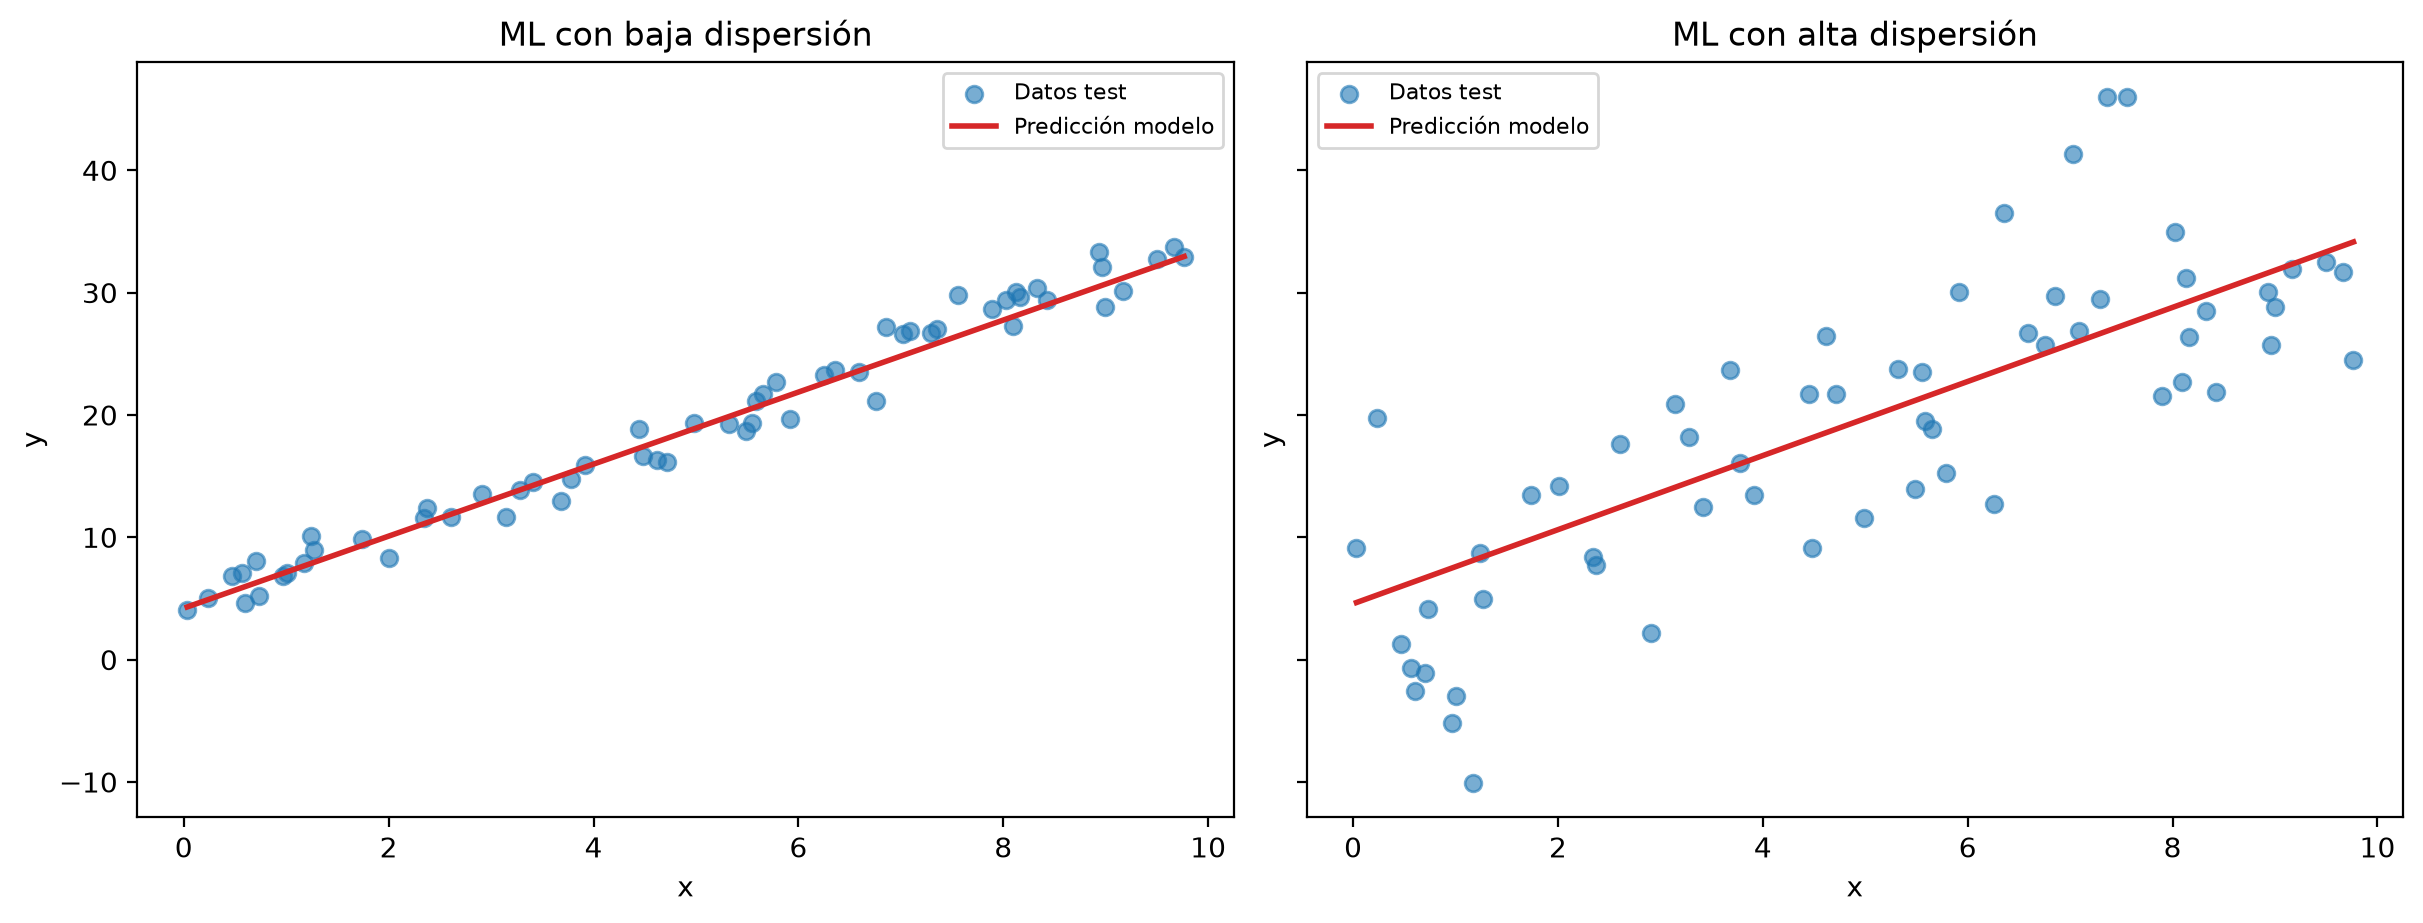
Dos diagramas de dispersión de los datos de prueba con la recta ajustada en rojo. Con baja dispersión, los puntos siguen de cerca la recta; con alta dispersión, se alejan de ella hasta unas 19 unidades, aunque la recta es casi la misma.

El \(R^2\) pasa de 0.98 a 0.63, y el MSE se multiplica por 29 (1.95 frente a 57.21). La recta ajustada es prácticamente la misma en los dos paneles, que comparten escala vertical; lo que cambia es la nube alrededor de ella. El MSE de prueba queda del orden de la varianza del ruido que inyectaste (\(1.5^2 = 2.25\) y \(8^2 = 64\)): esa parte del error no depende del modelo, sino de la dispersión de los datos.

Caso ilustrativo: cuando validar los datos cambia la decisión

Un equipo compara dos proveedores de un servicio (por ejemplo, dos API de pago) por el tiempo de respuesta, para quedarse con el más estable. Los datos son simulados: 200 mediciones del proveedor A alrededor de 180 ms y 180 del proveedor B alrededor de 185 ms. Al proveedor B se le suman 20 mediciones inválidas alrededor de 900 ms, producidas por un error de monitoreo durante una ventana de mantenimiento.

La primera lectura se hace sobre los datos tal como llegaron.


# Proveedor A: tiempos de respuesta estables
tiempos_proveedor_a = rng.normal(loc=180, scale=15, size=200)

# Proveedor B "sin validar": tiempos normales + un grupo de mediciones duplicadas/infladas
# por un error de monitoreo durante una ventana de mantenimiento
tiempos_proveedor_b_real = rng.normal(loc=185, scale=20, size=180)
mediciones_erroneas = rng.normal(loc=900, scale=50, size=20)  # duplicadas por el bug
tiempos_proveedor_b_sin_validar = np.concatenate([tiempos_proveedor_b_real, mediciones_erroneas])

print("=== Antes de validar ===")
print(f"Proveedor A — media: {tiempos_proveedor_a.mean():.1f} ms | desv. estándar: {tiempos_proveedor_a.std(ddof=1):.1f} ms")
print(f"Proveedor B — media: {tiempos_proveedor_b_sin_validar.mean():.1f} ms | desv. estándar: {tiempos_proveedor_b_sin_validar.std(ddof=1):.1f} ms")
=== Antes de validar ===
Proveedor A — media: 178.6 ms | desv. estándar: 14.2 ms
Proveedor B — media: 258.5 ms | desv. estándar: 216.1 ms

Sin validar, el proveedor B tiene media 258.5 ms y desviación 216.1 ms, unas 15 veces la del proveedor A (14.2 ms). Con esa lectura descartarías a B.

Al revisar el origen de cada medición, y no solo el número final, identificas las 20 mediciones de la ventana de mantenimiento como inválidas. Las excluyes y vuelves a calcular la dispersión sobre los datos validados.

# Después de validar: se excluyen las mediciones del error de monitoreo
tiempos_proveedor_b_validado = tiempos_proveedor_b_real

print("=== Después de validar ===")
print(f"Proveedor A — media: {tiempos_proveedor_a.mean():.1f} ms | desv. estándar: {tiempos_proveedor_a.std(ddof=1):.1f} ms")
print(f"Proveedor B — media: {tiempos_proveedor_b_validado.mean():.1f} ms | desv. estándar: {tiempos_proveedor_b_validado.std(ddof=1):.1f} ms")

graficar_caso_real_validacion(tiempos_proveedor_b_sin_validar, tiempos_proveedor_b_validado, "Proveedor B")

diferencia_pct = 100 * (tiempos_proveedor_b_validado.std(ddof=1) - tiempos_proveedor_a.std(ddof=1)) / tiempos_proveedor_a.std(ddof=1)
print(f"\nUna vez validados los datos, la desviación estándar del Proveedor B queda {diferencia_pct:+.1f}% respecto a la del Proveedor A.")
=== Después de validar ===
Proveedor A — media: 178.6 ms | desv. estándar: 14.2 ms
Proveedor B — media: 187.1 ms | desv. estándar: 20.6 ms

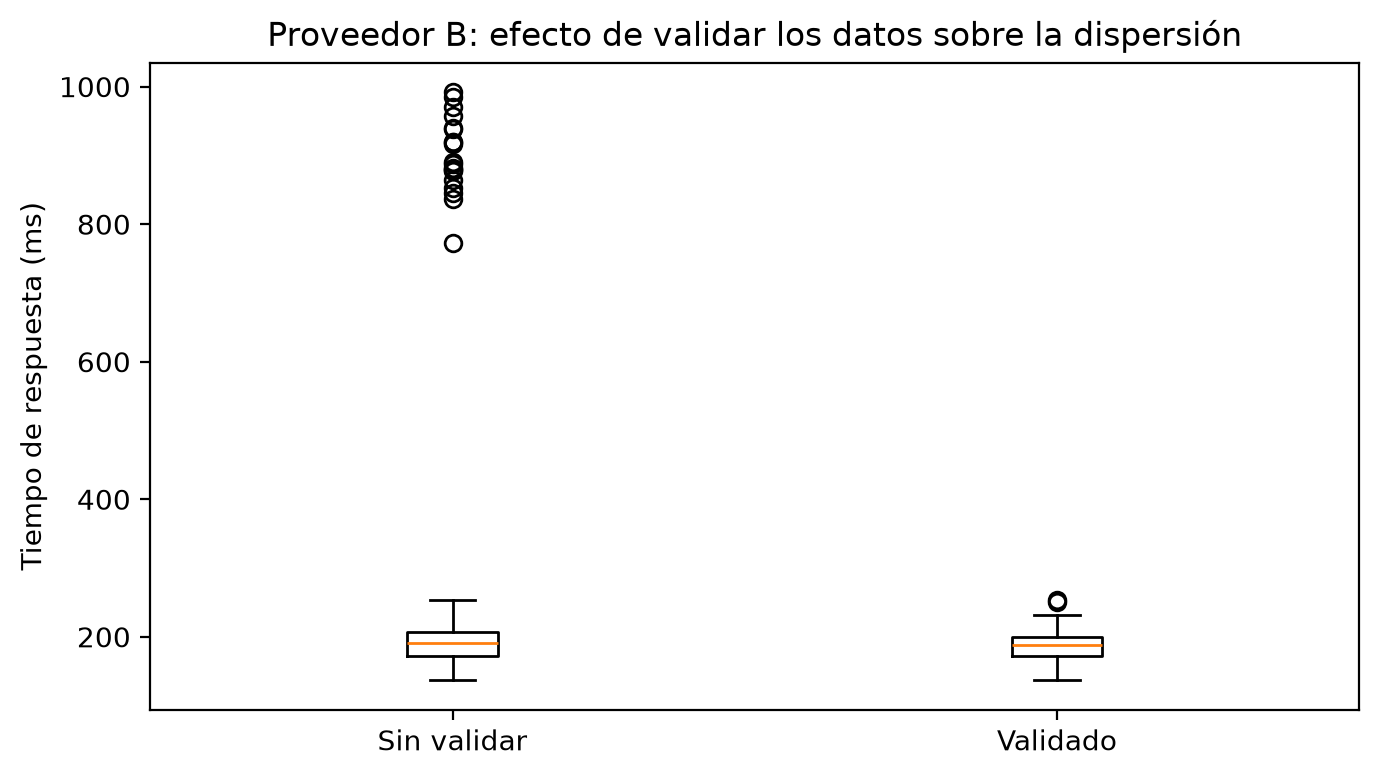
Boxplots del tiempo de respuesta del proveedor B antes y después de validar. Las cajas y las medianas, cerca de 185 ms, son casi iguales; antes de validar aparecen 20 puntos atípicos entre unos 770 y 990 ms, que desaparecen al validar.


Una vez validados los datos, la desviación estándar del Proveedor B queda +44.9% respecto a la del Proveedor A.

Con los datos validados, el proveedor B queda en 187.1 ms de media y 20.6 ms de desviación: un 44.9% más dispersión que A, no quince veces más. En el boxplot, la caja y la mediana casi no cambian al validar; lo que inflaba la desviación estándar eran los 20 puntos sueltos entre unos 770 y 990 ms. La decisión ya no es obvia y puede depender de otros factores, como el costo, el soporte o el acuerdo de nivel de servicio.

Calcular varianza, desviación estándar o CV sobre datos sin validar puede llevarte a la conclusión contraria. Antes de reportar una medida de dispersión, y sobre todo antes de decidir con ella, pregúntate de dónde vino cada dato y si hay un proceso, un error de captura o un evento puntual que esté inflando los números. El reporte queda así:

“Para el tiempo de respuesta del proveedor B (datos validados, \(n=180\)), la media es 187.1 ms y la desviación estándar 20.6 ms (CV 11.0%). Se reporta la desviación estándar porque ambos proveedores se miden en la misma unidad: B es algo menos estable que A (14.2 ms, CV 8.0%), pero la diferencia es mucho menor que la que sugerían los datos sin validar (216.1 ms).”

Errores que conviene nombrar

  1. Reportar la media sin una medida de dispersión. Dos grupos con la misma media pueden ser muy distintos.
  2. Usar el rango como dispersión típica. Depende de solo dos valores; un extremo lo infla.
  3. Leer la varianza en las unidades de los datos. Está al cuadrado; para interpretar, usa la desviación estándar.
  4. Mezclar ddof. np.std usa ddof=0 y .std() de pandas usa ddof=1: la misma columna da dos números distintos.
  5. Comparar desviaciones estándar de variables en escalas distintas. Para eso está el CV.
  6. Calcular el CV sin cero absoluto o con media cercana a cero. El cociente pierde sentido.
  7. Calcular la dispersión sobre datos sin validar. En el caso de los proveedores cambió la decisión.
  8. Comparar gráficos con escalas distintas. Si cada panel ajusta su propio eje, una dispersión pequeña se ve tan ancha como una grande.

3.6 Guía rápida: ¿qué medida usar?

Situación Medida principal Justificación
Aviso rápido de amplitud o extremos Rango Solo usa mínimo y máximo; es simple, pero sensible a un solo valor atípico.
Variable cuantitativa en una sola escala Desviación estándar Describe el alejamiento típico en las mismas unidades que los datos.
Comparar variables o grupos de distinta magnitud Coeficiente de variación Relaciona la dispersión con la media y permite comparar escalas distintas.
Misma media y comportamiento distinto Desviación estándar o CV El centro no distingue los conjuntos; el ancho sí.

Regla de comunicación: indica siempre la variable, el valor, la unidad y si la medida es absoluta o relativa.

3.7 Preguntas de comprensión

  1. Dos sucursales tienen un tiempo medio de entrega de 3 días; en una la desviación estándar es de 0.5 días y en la otra de 2. ¿Cuál elegirías para prometer una fecha al cliente y por qué?
  2. ¿Por qué la varianza muestral divide entre \(n-1\) y no entre \(n\)?
  3. Un sensor registra temperaturas con media 10 °C y desviación 2 °C. ¿Tiene sentido decir que su CV es 20%?
  4. En la etapa 4, imputar 15 notas con la media bajó la desviación estándar de 10.51 a 9.50. ¿Qué consecuencia tiene eso sobre los z-scores de las notas reales?
  5. En el caso de los proveedores, ¿qué parte del boxplot casi no cambió al validar los datos? ¿Qué te dice eso sobre la desviación estándar?
  1. La de desviación 0.5. La media no las distingue; la desviación estándar sí: en la segunda, muchas entregas se alejan días de la media, así que cualquier fecha prometida falla más a menudo.
  2. Porque \(\bar{x}\) se calcula con los mismos datos y queda más cerca de ellos que la media poblacional. Dividir entre \(n\) subestima la varianza de forma sistemática; \(n-1\) corrige ese sesgo (corrección de Bessel).
  3. No. Los °C tienen cero arbitrario: la misma medición en °F (media 50, desviación 3.6) da un CV de 7.2%. El CV solo tiene sentido en escala de razón.
  4. Con la desviación estándar más pequeña, cada nota real queda a más desviaciones de la media: sus z-scores crecen en valor absoluto y los valores parecen más atípicos de lo que son.
  5. La caja y la mediana: las 20 mediciones inválidas quedaron como puntos sueltos por encima de 770 ms. La desviación estándar, en cambio, pasó de 20.6 a 216.1 ms, unas 10 veces más. Es sensible a pocos valores extremos; en el capítulo 4 vas a usar medidas robustas, como el rango intercuartílico.

3.8 Referencias para profundizar

  • Freedman, D., Pisani, R. y Purves, R. (2007). Statistics (4.ª ed.). W. W. Norton. Explicación intuitiva de la desviación estándar y de su lectura como alejamiento típico.
  • Hastie, T., Tibshirani, R. y Friedman, J. (2009). The Elements of Statistical Learning (2.ª ed.). Springer. Sección 7.3, “The Bias-Variance Decomposition”: cómo la varianza del ruido fija un piso para el error de predicción.
  • Documentación de NumPy, numpy.var: el parámetro ddof y la diferencia entre varianza poblacional y muestral.
  • Documentación de scikit-learn, Preprocessing data: StandardScaler y por qué escalar antes de usar estimadores basados en distancias.

3.9 Lo que debes llevarte de este capítulo

El centro no basta: la dispersión dice cuánto se mueven los datos alrededor de él, y esa diferencia cambia tanto la lectura de un conjunto como el error de un modelo.

  • Dos grupos con medias de 71.67 y 72.50 tuvieron desviaciones de 1.63 y 14.40: la media no los distingue.
  • El rango depende de dos valores; la varianza está en unidades al cuadrado; la desviación estándar se lee en las unidades de los datos; el CV compara escalas distintas y exige cero absoluto.
  • El z-score mide la distancia en unidades de dispersión: el mismo 40 está a −1.34 desviaciones en un grupo y a unas −25 en otro.
  • Imputar con la media reduce la desviación estándar (de 10.51 a 9.50 en la etapa 4) y hace que la variable parezca más estable.
  • Con la misma recta y más ruido, el \(R^2\) cayó de 0.98 a 0.63: la dispersión no explicada fija un piso para el error.
  • Una medida de dispersión es tan confiable como los datos: validar las mediciones bajó la desviación del proveedor B de 216.1 a 20.6 ms y cambió la decisión.

3.10 Puente hacia los siguientes capítulos

Ya mides el centro y el ancho de una variable. En el capítulo 4 estudias su forma: asimetría, colas, cuartiles, el rango intercuartílico que resistió a las mediciones inválidas del proveedor B y los criterios para detectar anomalías. En el capítulo 5 pasas de una variable a la relación entre dos.