2.1 De una matriz de datos a un modelo que aprende
En el artículo anterior representaste observaciones mediante vectores y matrices. Ahora queremos usar esa representación para calcular predicciones, medir sus errores y modificar los parámetros que las producen. Antes de construir redes profundas, conviene entender qué operaciones está realizando la herramienta.
Trabajaremos con PyTorch y un caso pequeño de entregas: estimar una duración a partir de la distancia y el peso del paquete. El ejemplo es sintético y su relación generadora es conocida. Eso permite separar tres preguntas: ¿los datos tienen la forma correcta?, ¿el gradiente corresponde a la pérdida que escribimos? y ¿las predicciones mejoran frente a una referencia sencilla?
El recorrido empieza con operaciones que puedes comprobar a mano. Después aparece autograd, el sistema de diferenciación automática, y finalmente un ciclo de entrenamiento completo. No necesitamos una red profunda para comprobar estas piezas: un modelo lineal permite seguir cada cálculo.
2.2 Qué vas a poder comprobar
Al terminar este capítulo vas a poder:
Interpretar la forma, el tipo de dato y el dispositivo de un tensor.
Distinguir producto matricial, producto elemento a elemento y broadcasting.
Detectar una pérdida que se calcula sin errores de ejecución, pero compara observaciones equivocadas.
Verificar un gradiente mediante una fórmula y diferencias finitas.
Explicar por qué se acumulan los gradientes y cuándo conviene separar un tensor del grafo.
Entrenar un modelo pequeño y leer sus curvas, métricas y residuos sin confundir ajuste con generalización.
Se asumen operaciones matriciales básicas, la idea de derivada y familiaridad con Python. La regla de la cadena se retoma aquí en un ejemplo; su desarrollo para redes multicapa queda en Pérdida y backpropagation.
2.3 Preparación del entorno
Necesitas numpy, pandas, matplotlib y torch. Si falta alguna biblioteca, instálala en el entorno que utiliza el notebook antes de ejecutar las celdas. Los ejemplos se ejecutan en CPU y no descargan datasets.
Fijamos una semilla para la simulación y usamos precisión de 64 bits en las comprobaciones numéricas. Es una decisión de este experimento: permite comparar implementaciones con errores de redondeo pequeños. No implica que todas las redes deban entrenarse con esa precisión.
import platformimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport sklearnimport torchfrom torch import nnSEMILLA =2026TIPO = torch.float64torch.manual_seed(SEMILLA)torch.set_num_threads(1)plt.rcParams.update({"figure.figsize": (8, 4), "font.size": 11,"axes.spines.top": False, "axes.spines.right": False})pd.set_option("display.max_columns", 12)pd.set_option("display.width", 120)comprobaciones = {}print(f"Python {platform.python_version()} | PyTorch {torch.__version__}")print(f"NumPy {np.__version__} | pandas {pd.__version__}")print("Dispositivo: CPU | Precisión de comprobación: float64")
Python 3.13.9 | PyTorch 2.14.1+cpu
NumPy 2.3.5 | pandas 2.3.3
Dispositivo: CPU | Precisión de comprobación: float64
2.4 Parte A — Formas y operaciones
2.4.1 Qué contiene un tensor
En estas bibliotecas, un tensor es un arreglo de valores con uno o más ejes, o un escalar sin ejes. Aquí usamos esa acepción computacional; no necesitamos introducir las leyes de transformación de los tensores de la física.
La forma (shape) indica cuántos valores hay en cada eje. El número de dimensiones (ndim) cuenta los ejes, no las observaciones. Una matriz de 300 filas y 2 columnas tiene dos dimensiones. El tipo de dato (dtype) determina cómo se representan los valores; el dispositivo (device) indica dónde se almacenan y operan.
Objeto
Forma posible
Interpretación
Escalar
()
Una duración
Vector
(4,)
Cuatro duraciones
Matriz
(4, 2)
Cuatro entregas con dos variables
Lote de imágenes
(B, C, H, W)
Lote, canales, alto y ancho en la convención usual de CNN de PyTorch
El significado de cada eje lo define el problema. El tensor no sabe que una columna representa kilómetros.
    objeto  shape  ndim  elementos         dtype device
   escalar     ()     0          1 torch.float64    cpu
duraciones   (4,)     1          4 torch.float64    cpu
  entregas (4, 2)     2          8 torch.float64    cpu
Primera entrega [distancia_km, peso_kg]: [10.0, 2.0]
Todas las distancias: [10.0, 20.0, 30.0, 40.0]
2.4.2 Cómo leer las formas
entregas tiene forma (4, 2) y contiene 8 valores. Sus filas son entregas y sus columnas son variables. entregas[0] selecciona una observación; entregas[:, 0], una variable en todas las observaciones. Ambos resultados son vectores, pero representan cosas distintas.
La tabla también muestra que el escalar tiene cero ejes y un elemento. Esta distinción importa cuando una función devuelve una pérdida escalar: contiene un número, aunque no sea un vector de longitud uno.
2.4.3 El producto que produce una predicción
Para una entrega con distancia \(d\) y peso \(p\), proponemos
\[\hat y = 0.06d + 0.12p + 1.5.\]
Los coeficientes tienen unidades de horas por kilómetro y horas por kilogramo; el término independiente está en horas. Por ahora son valores elegidos para ilustrar el cálculo, no parámetros estimados.
Si \(X\) tiene forma \((B,2)\) y \(w\) forma \((2,1)\), entonces \(Xw\) tiene forma \((B,1)\): una predicción por fila. En PyTorch, @ representa este producto matricial. * multiplica elemento a elemento; puede servir para construir la misma suma, pero requiere indicar después qué eje se suma.
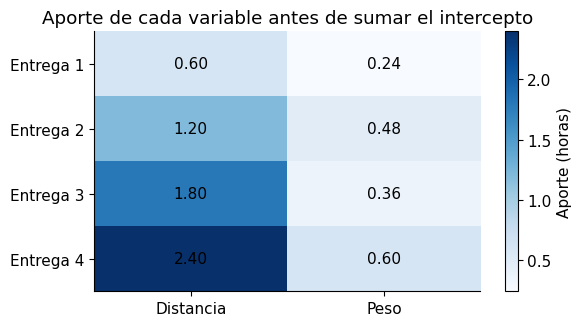
pesos_ejemplo = torch.tensor([[0.06], [0.12]], dtype=TIPO)pred_matricial = entregas @ pesos_ejemplo +1.5aportes = entregas * pesos_ejemplo.reshape(1, 2)pred_por_aportes = aportes.sum(dim=1, keepdim=True) +1.5print("X @ w:", tuple((entregas @ pesos_ejemplo).shape))print("X * w por variable:", tuple(aportes.shape))print("Predicciones (horas):", np.round(pred_matricial.flatten().numpy(), 2).tolist())print("Diferencia máxima entre ambas formas:", (pred_matricial - pred_por_aportes).abs().max().item())fig, ax = plt.subplots(figsize=(6, 3.4))imagen = ax.imshow(aportes.numpy(), cmap="Blues", aspect="auto")for i inrange(4):for j inrange(2): ax.text(j, i, f"{aportes[i,j].item():.2f}", ha="center", va="center", color="black")ax.set_xticks([0, 1], ["Distancia", "Peso"])ax.set_yticks(range(4), ["Entrega 1", "Entrega 2", "Entrega 3", "Entrega 4"])ax.set_title("Aporte de cada variable antes de sumar el intercepto")fig.colorbar(imagen, ax=ax, label="Aporte (horas)")plt.tight_layout(); plt.show()
X @ w: (4, 1)
X * w por variable: (4, 2)
Predicciones (horas): [2.34, 3.18, 3.66, 4.5]
Diferencia máxima entre ambas formas: 0.0
2.4.4 Cómo leer este resultado
Para la primera entrega, la distancia aporta 0.60 horas y el peso 0.24 horas. Al sumar el intercepto de 1.50 horas, la predicción es 2.34 horas. La salida muestra 2.34, 3.18, 3.66 y 4.50 horas, y las dos implementaciones coinciden en la precisión utilizada.
El gráfico conserva los aportes antes de sumarlos. Que la distancia aporte más en estas cuatro filas depende de los valores y de los coeficientes elegidos; no demuestra una importancia causal de esa variable. La comprobación responde a una pregunta más concreta: ambas operaciones calculan la misma fórmula.
2.4.5 Broadcasting: una operación útil y un error silencioso
El broadcasting permite operar arreglos con formas compatibles sin escribir una repetición explícita. Los ejes se comparan desde el último: sus tamaños deben ser iguales, o uno de ellos debe ser uno; los ejes ausentes se tratan como tamaño uno. Así puedes restar un vector de dos medias a cada fila de una matriz \((B,2)\).
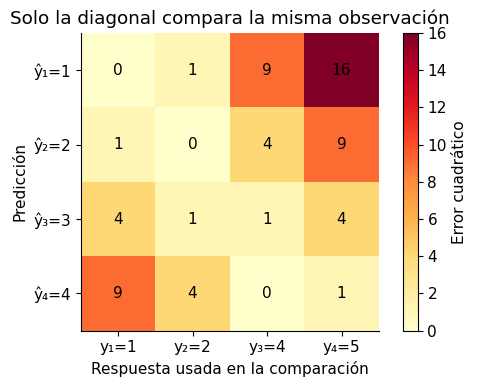
La misma regla puede producir una comparación equivocada. Supón que las predicciones tienen forma \((4,1)\), pero las respuestas forma \((4,)\). Al restarlas, PyTorch obtiene una matriz \((4,4)\): compara cada predicción con todas las respuestas. El programa sigue funcionando, aunque ya no mida el error de cada entrega.
La pérdida cuadrática media que queremos es
\[L=\frac{1}{B}\sum_{i=1}^{B}(\hat y_i-y_i)^2.\]
La comparación cruzada calcula otra cantidad, con \(B^2\) pares. Comprobemos ambas antes de entrenar.
Forma equivocada: (4, 4)
Forma pareada: (4, 1)
MSE cruzado: 4.000 | MSE correcto: 0.500
2.4.6 Antes de seguir, pregúntate
Si cambia la pérdida de 0.500 a 4.000 sin cambiar una sola predicción, ¿puedes concluir que el modelo empeoró?
2.4.7 Cómo leer este resultado
El MSE correcto es 0.500: los errores cuadrados por observación son 0, 0, 1 y 1. La comparación cruzada produce 4.000 al promediar las 16 comparaciones del mapa de calor. Solo cuatro, las de la diagonal, corresponden a las observaciones que debían compararse.
Las predicciones son las mismas. Cambió la definición que implementa el código. Antes de interpretar una métrica, revisa que sus operandos representen las mismas observaciones y tengan la misma forma. Este error también modificaría el gradiente: autograd derivaría correctamente la pérdida equivocada.
2.4.8 Reformar, transponer y elegir precisión
reshape reorganiza la forma conservando el orden lógico de los elementos; no intercambia por sí solo los ejes. transpose sí intercambia ejes. Para pasar de observaciones en filas a observaciones en columnas, necesitas transponer. Una reorganización que conserve todos los valores puede alterar su significado.
La precisión también afecta al cálculo. En torno a \(10^8\), un float32 no distingue todos los enteros consecutivos. Evaluaremos \((10^8+1)-10^8\), cuyo resultado matemático es uno, con dos tipos de dato.
tabla = torch.tensor([[10., 2.], [20., 4.], [30., 3.]], dtype=TIPO)print("Tabla original:\n", tabla)print("reshape(2, 3):\n", tabla.reshape(2, 3))print("transpose(0, 1):\n", tabla.transpose(0, 1))for tipo in [torch.float32, torch.float64]: grande = torch.tensor(1e8, dtype=tipo)print(f"{str(tipo):>13}: (1e8 + 1) - 1e8 = {((grande +1) - grande).item():.1f}")
Después de reshape(2,3), la primera fila queda [10, 2, 20]. Mezcla valores de dos entregas. Con la transposición, la primera fila queda [10, 20, 30] y conserva todas las distancias. La forma compatible por sí sola no garantiza el significado correcto.
El cálculo numérico devuelve 0.0 con float32 y 1.0 con float64. Esto ilustra pérdida de precisión al sumar cantidades de escalas muy diferentes; no significa que float32 sea inadecuado para todo entrenamiento. La escala de las variables, las operaciones y la tolerancia requerida determinan si la diferencia importa. Mantén también datos y parámetros en tipos y dispositivos compatibles.
2.5 Parte B — De la pérdida al gradiente
2.5.1 Una derivada que puedes comprobar a mano
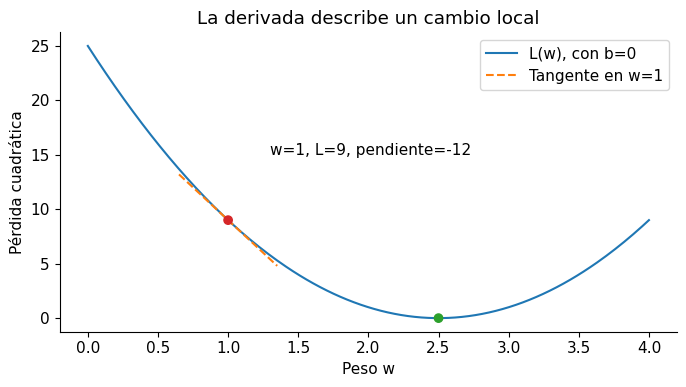
Considera una sola observación: \(x=2\), \(y=5\), predicción \(\hat y=wx+b\) y pérdida \(L=(\hat y-y)^2\). Con \(w=1\) y \(b=0\), la predicción es \(2\) y la pérdida \(9\).
Un grafo computacional registra las operaciones que conectan entradas y parámetros con la salida. En este caso: multiplicar \(w\) por \(x\), sumar \(b\), restar \(y\) y elevar al cuadrado. La regla de la cadena permite recorrerlo hacia atrás:
La diferenciación automática aplica reglas de derivación a las operaciones ejecutadas y evalúa sus derivadas en los valores actuales. No necesita aproximar la pendiente mediante perturbaciones ni producir una fórmula simbólica completa. Sigue limitada por la precisión numérica y por las reglas disponibles para cada operación.
requires_grad=True solicita seguimiento de los parámetros. Un tensor hoja que requiere gradientes es uno creado directamente, como nuestros pesos, sin proceder de otra operación seguida por el grafo. backward() calcula los gradientes de esta salida escalar y los acumula en .grad de esas hojas. Los intermedios tienen conexiones al grafo, pero sus .grad no se guardan por defecto.
Predicción: 2.0 | Pérdida: 9.0
dL/dw: -12.0 | dL/db: -6.0
w es hoja: True | predicción tiene grad_fn: True
2.5.2 Cómo leer este resultado
autograd devuelve −12 para el peso y −6 para el intercepto, igual que las derivadas manuales. La pendiente negativa indica que aumentar ligeramente el peso reduce la pérdida si mantenemos el intercepto fijo. La figura muestra esa sección de la pérdida, no toda la superficie de dos parámetros.
La tangente aproxima la curva cerca de \(w=1\). Su pendiente no garantiza que cualquier salto grande mejore el ajuste. Con \(b=0\), el mínimo de esta sección está en \(w=2.5\), donde la predicción coincide con cinco. Una sola observación tampoco identifica de manera única dos parámetros: muchos pares \((w,b)\) producen la misma predicción.
2.5.3 Comparar con diferencias finitas
Podemos aproximar la misma derivada mediante
\[g_h=\frac{L(w+h)-L(w-h)}{2h}.\]
Es una diferencia finita central. Comparamos su valor con \(g=-12\) y usamos el error relativo \(|g_h-g|/|g|\). Aquí el denominador es distinto de cero; cerca de un gradiente nulo conviene revisar también errores absolutos.
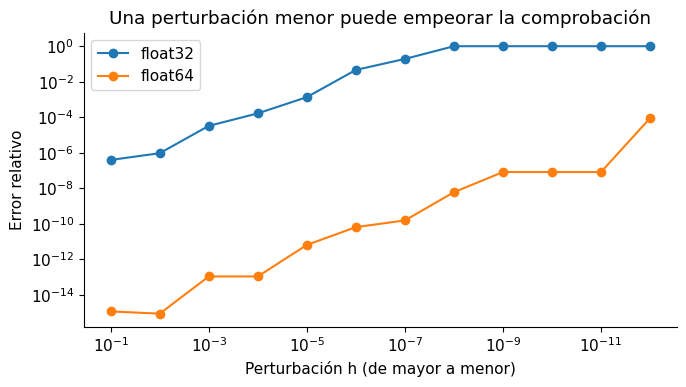
En aritmética exacta, esta diferencia central es exacta para la función cuadrática del ejemplo. Por eso la figura siguiente aísla principalmente efectos de representación y cancelación numérica. No es una demostración del error de truncamiento de una función general, donde también interviene la elección de \(h\).
pasos_h = np.logspace(-1, -12, 12)filas_fd = []for tipo in [torch.float32, torch.float64]:for h in pasos_h: centro = torch.tensor(1., dtype=tipo) incremento = torch.tensor(float(h), dtype=tipo) arriba = (2* (centro + incremento) -5) **2 abajo = (2* (centro - incremento) -5) **2 estimacion = ((arriba - abajo) / (2* incremento)).item() filas_fd.append({"tipo": str(tipo).replace("torch.", ""), "h": h,"gradiente": estimacion, "error_relativo": abs(estimacion +12) /12})tabla_fd = pd.DataFrame(filas_fd)seleccion_fd = tabla_fd[tabla_fd["h"].apply(lambda h: any(np.isclose(h, v, rtol=1e-10, atol=0) for v in [1e-1, 1e-5, 1e-9, 1e-12]))]print(seleccion_fd.to_string(index=False, formatters={"h": lambda v: f"{v:.3e}","gradiente": lambda v: f"{v:.6f}", "error_relativo": lambda v: f"{v:.3e}"}))fig, ax = plt.subplots(figsize=(7, 4))for nombre in ["float32", "float64"]: parte = tabla_fd[tabla_fd["tipo"] == nombre] ax.loglog(parte["h"], np.maximum(parte["error_relativo"], 1e-18), "o-", label=nombre)ax.invert_xaxis()ax.set(xlabel="Perturbación h (de mayor a menor)", ylabel="Error relativo", title="Una perturbación menor puede empeorar la comprobación")ax.legend(); plt.tight_layout(); plt.show()comprobaciones["fd32_pequeno"] =float(tabla_fd.query("tipo == 'float32'").iloc[-1]["gradiente"])comprobaciones["fd64_pequeno"] =float(tabla_fd.query("tipo == 'float64'").iloc[-1]["gradiente"])
Con \(h=10^{-12}\), la aproximación es 0.000 en float32 y -12.001067 en float64, frente al gradiente exacto −12. En float32, las perturbaciones tan pequeñas dejan de distinguirse del valor central; al restar pérdidas iguales, la aproximación se vuelve cero.
El gráfico recorre \(h\) de mayor a menor. Para mostrar una escala logarítmica, los errores exactamente nulos se dibujan en \(10^{-18}\); ese piso solo afecta al dibujo y no a la tabla. La conclusión no es elegir el \(h\) más pequeño: necesitamos una perturbación que conserve cambios numéricamente distinguibles. El gradiente automático evita esta perturbación, aunque sus propias operaciones también usan precisión finita.
2.5.5 Los gradientes se acumulan
Cada llamada a backward() suma su contribución al gradiente almacenado. Para comprobarlo, recalculamos la misma pérdida dos veces, con parámetros fijos. Después borramos .grad y repetimos una sola vez.
Recalcular la pérdida construye un grafo nuevo. No estamos reutilizando un grafo ya liberado ni necesitamos conservarlo con retain_graph=True. Acumular deliberadamente puede ser útil para combinar varios lotes; aquí permite reconocer qué ocurriría si olvidáramos limpiar los gradientes entre actualizaciones independientes.
Pasada 1: grad_w=-12.0, grad_b=-6.0
Pasada 2: grad_w=-24.0, grad_b=-12.0
Tras limpiar y recalcular: grad_w=-12.0, grad_b=-6.0
2.5.6 Cómo leer las dos pasadas
La primera llamada produce (−12, −6); la segunda deja (−24, −12). Los parámetros no cambiaron: se sumó dos veces el mismo gradiente. Al limpiar y recalcular, recuperamos (−12, −6).
En el ciclo de entrenamiento usaremos optimizer.zero_grad(set_to_none=True) antes de cada cálculo. Eso inicia una nueva acumulación. Si quieres combinar varios lotes, también debes controlar la escala de la pérdida: sumar medias de lotes no equivale siempre a la media conjunta, especialmente cuando sus tamaños son diferentes.
2.5.7 Separar una salida del grafo
Para inspeccionar una predicción, puede convenir usar detach(), que devuelve un tensor sin la conexión de diferenciación de esa salida. Sus datos pueden compartir almacenamiento con el original: no lo uses como si fuera una copia independiente que puedas modificar sin efectos.
torch.no_grad() desactiva el seguimiento de operaciones en un bloque, útil al evaluar o actualizar parámetros a mano. Por otra parte, model.eval() cambia el comportamiento de capas como dropout y batch normalization, pero no desactiva por sí mismo los gradientes. En el modelo lineal de este capítulo no hay capas que cambien su comportamiento entre esos modos.
Veamos qué sucede cuando se corta la conexión antes de construir la pérdida.
w_corte = torch.tensor(1., dtype=TIPO, requires_grad=True)salida_conectada =2* w_cortesalida_cortada = salida_conectada.detach()print("Salida original requires_grad:", salida_conectada.requires_grad)print("Salida separada requires_grad:", salida_cortada.requires_grad)try: ((salida_cortada -5) **2).backward()exceptRuntimeError:print("La pérdida separada no tiene un grafo diferenciable hacia w.")print("Gradiente de w tras el intento:", w_corte.grad)((salida_conectada -5) **2).backward()print("Gradiente con la conexión preservada:", w_corte.grad.item())
Salida original requires_grad: True
Salida separada requires_grad: False
La pérdida separada no tiene un grafo diferenciable hacia w.
Gradiente de w tras el intento: None
Gradiente con la conexión preservada: -12.0
2.5.8 Cómo leer este resultado
Después de separar la salida, el gradiente del peso sigue siendo None: esa pérdida no tiene un camino de diferenciación hacia él. Al preservar la conexión, el gradiente vuelve a ser −12. Si una pérdida tiene otras ramas conectadas, puede calcular gradientes para ellas sin actualizar la rama que cortaste; que backward() termine no garantiza que todos los parámetros reciban información.
Usa detach() al convertir resultados para dibujarlos, y no_grad() cuando quieras evaluar sin construir ese seguimiento. Cortar la predicción antes de calcular la pérdida de entrenamiento impediría aprender los parámetros que la produjeron.
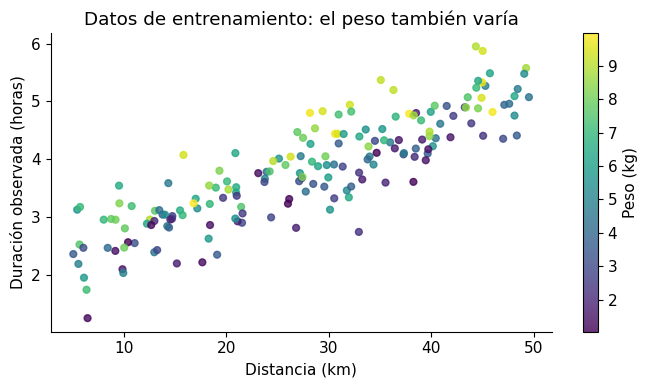
Las distancias están entre 5 y 50 kilómetros y los pesos entre 1 y 10 kilogramos. El ruido es independiente de las variables. La expresión sin ruido es la media condicional \(m(d,p)\); la respuesta observada añade variabilidad.
Antes de ajustar reservamos 180 observaciones para entrenamiento, 60 para validación y 60 para prueba. Estimamos medias y desviaciones de las variables solo con el entrenamiento, usando desviación con divisor \(n\) (ddof=0). Aplicamos esa misma transformación a las otras particiones. Las respuestas permanecen en horas.
La tasa de aprendizaje y el número de pasos se fijan para demostrar el mecanismo: 0.08 y 250. No se buscan candidatos ni se elige una época por prueba. La validación permite observar la trayectoria; la prueba se utiliza después para el reporte final.
Entrenamiento: X=(180, 2), y=(180, 1)
Validación: X=(60, 2), y=(60, 1)
Prueba: X=(60, 2), y=(60, 1)
Media de X estandarizada en entrenamiento: [0. 0.]
Desviación en entrenamiento: [1. 1.]
Varianza generadora del ruido: 0.1225 horas²
2.6.2 Cómo leer los datos y la transformación
Las formas son (180,2) para las entradas y (180,1) para las respuestas de entrenamiento. La estandarización deja medias cercanas a 0 y desviaciones 1 en ese conjunto. No obliga a que validación y prueba tengan exactamente esos valores.
En la figura, cada punto corresponde a una entrega de entrenamiento y el color representa el peso. Parte de la dispersión vertical depende de esa segunda variable y parte del ruido. Mirar solo la distancia mezcla ambos efectos. Conocemos su separación porque nosotros generamos los datos; en un problema real necesitaríamos justificarla.
El valor 0.1225 horas² es la varianza del ruido generador. Más adelante será una referencia para el MSE esperado de la media verdadera, no una cota que toda muestra de prueba deba superar.
2.6.3 Un gradiente sobre el lote completo
Para entradas estandarizadas \(X\), predicción \(\hat y=Xw+b\) y \(n\) observaciones, definimos
\[L=\frac{1}{n}\|Xw+b\mathbf 1-y\|^2.\]
Si \(r=\hat y-y\) es el vector de errores, la derivada manual es
El factor dos corresponde a esta definición de MSE. Si usáramos \(L=\frac{1}{2n}\sum r_i^2\), desaparecería. Inicializamos pesos e intercepto en cero y comparamos fórmula, autodiferenciación y diferencias finitas en ese mismo punto.
La diferencia máxima entre fórmula y autograd es 2.220e-16; con diferencias finitas es 2.176e-10. Los tres cálculos usan los mismos datos, la misma pérdida y los mismos parámetros iniciales. Esta correspondencia comprueba el gradiente de esta función en este punto.
La prueba no certifica cualquier red ni cualquier entrada. Por ejemplo, funciones con puntos no diferenciables requieren interpretar la regla adoptada por el framework. La ventaja práctica es tener una comprobación independiente cuando sospechas que una pérdida o una operación está mal implementada.
2.6.5 Construir la capa y actualizar sus parámetros
Un nn.Module agrupa parámetros y define el cálculo de salida mediante forward. nn.Linear(2,1) implementa dos entradas y una salida, sin activación: \(Xw+b\). Sigue siendo un modelo lineal, aunque utilicemos las mismas herramientas que servirán para una red profunda.
El descenso por gradiente actualiza \(\theta\leftarrow\theta-\eta\nabla L\). Aquí usamos el lote completo en cada paso y un optimizador SGD sin momentum ni penalización. No hay muestreo estocástico de lotes en este ejemplo.
En cada paso: limpiamos gradientes, calculamos predicciones y MSE, aplicamos backward() y actualizamos con step(). Guardamos las pérdidas después de la actualización, tanto en entrenamiento como en validación. También registramos el estado inicial como paso cero. En paralelo repetimos las actualizaciones con la fórmula manual, partiendo de los mismos ceros.
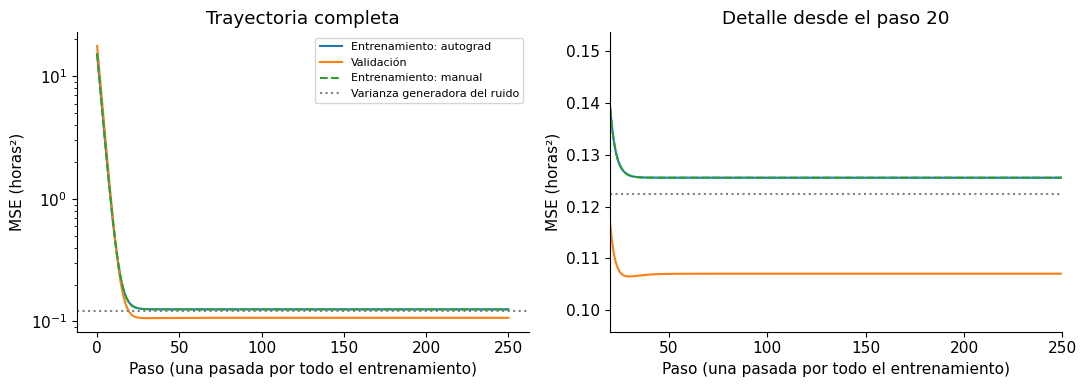
El MSE de entrenamiento pasa de 15.281559 a 0.125559 horas². El inicial corresponde a predecir cero horas, porque todos los parámetros parten de cero; todavía no es el baseline que usaremos para evaluar utilidad predictiva.
Al final, el MSE de validación es 0.107041 horas². Las predicciones manuales y automáticas difieren como máximo 0.000e+00 horas en esa partición. autograd no mejoró la predicción frente a la derivada manual: automatizó el cálculo del mismo gradiente. La correspondencia sería más difícil de verificar a mano en un modelo con muchas capas.
La tabla permite comparar pasos concretos. Dibujemos también la trayectoria completa: una mejora rápida al comienzo puede ocultar cambios pequeños después si usamos una sola escala.
fig, axes = plt.subplots(1, 2, figsize=(11, 4))for ax in axes: ax.plot(historia["paso"], historia["mse_train"], label="Entrenamiento: autograd") ax.plot(historia["paso"], historia["mse_val"], label="Validación") ax.plot(historia["paso"], historia["mse_manual"], "--", label="Entrenamiento: manual") ax.axhline(0.35**2, color="gray", ls=":", label="Varianza generadora del ruido") ax.set(xlabel="Paso (una pasada por todo el entrenamiento)", ylabel="MSE (horas²)")axes[0].set_title("Trayectoria completa")axes[0].set_yscale("log")axes[1].set_title("Detalle desde el paso 20")axes[1].set_xlim(20, 250)sub_hist = historia[historia["paso"] >=20]axes[1].set_ylim(max(0, min(sub_hist["mse_train"].min(), sub_hist["mse_val"].min(), 0.35**2) *.9),max(sub_hist["mse_train"].max(), sub_hist["mse_val"].max(), 0.35**2) *1.1)axes[0].legend(fontsize=8)plt.tight_layout(); plt.show()
2.6.7 Qué permiten concluir las curvas
Las curvas de entrenamiento manual y automático se superponen a la resolución de la figura. El panel izquierdo usa una escala logarítmica para mostrar la caída inicial; el derecho amplía la región posterior. Una curva casi horizontal indica cambios pequeños de esta pérdida, no una prueba de que cualquier parámetro o problema haya alcanzado su mejor solución posible.
La diferencia entre entrenamiento y validación depende de las muestras y del ajuste. Que sean próximas en este caso sencillo es compatible con una generalización razonable bajo el mismo generador, pero no demuestra rendimiento fuera de él. La línea punteada de 0.1225 es una referencia en esperanza; una pérdida de una muestra puede quedar a cualquiera de sus lados.
No usamos esta figura para cambiar el número de pasos. Si la usáramos para elegir una época, estaríamos realizando selección por validación y tendríamos que describir ese procedimiento. La prueba todavía no ha intervenido.
2.6.8 Recuperar los coeficientes en sus unidades
Los pesos entrenados multiplican variables estandarizadas. Para compararlos con 0.06 horas/km y 0.12 horas/kg, volvemos a la escala original:
También ajustamos mínimos cuadrados por una solución numérica directa sobre el entrenamiento. Es una referencia de optimización para esta misma pérdida sin penalización: compara el descenso iterativo con el mínimo cuadrático, no dos familias predictivas diferentes.
El ajuste estima 0.063046 horas/km, 0.109958 horas/kg y un intercepto de 1.478739 horas. Los valores difieren de los del generador porque ajustamos una muestra con ruido. Coincidir exactamente con la relación verdadera no es un requisito del aprendizaje.
La diferencia máxima con mínimos cuadrados es 6.661e-16 en la escala numérica de la tabla. Es una comprobación de convergencia en este problema lineal, no una garantía para redes no convexas. El intercepto expresa la extrapolación a distancia y peso cero, valores que no están en el rango simulado; evita darle una interpretación operativa como si lo hubiéramos observado.
2.6.10 Evaluación final: ¿qué mejora respecto a una referencia?
Un baseline predice siempre la duración media del entrenamiento. No conoce la distancia ni el peso de la nueva entrega. Comparamos esa referencia con el modelo entrenado y con la media verdadera del simulador, disponible únicamente porque los datos son sintéticos.
Usamos tres métricas sobre las 60 respuestas de prueba:
MAE y RMSE están en horas; RMSE penaliza más los errores grandes. El \(R^2\) compara con la media de la prueba en su denominador. Ese comparador matemático no es el baseline desplegable, cuya media se calculó con entrenamiento. Por eso el \(R^2\) del baseline no tiene que ser exactamente cero.
                       modelo  MAE_h  RMSE_h  MSE_h2      R2
       Media de entrenamiento 0.6760  0.8026  0.6441 -0.0215
          Lineal con autograd 0.2684  0.3463  0.1199  0.8098
Media verdadera del simulador 0.2628  0.3385  0.1146  0.8183
Reducción relativa de RMSE frente al baseline: 56.8%
2.6.11 Cómo leer las métricas de prueba
El baseline obtiene un RMSE de 0.8026 horas y el modelo lineal 0.3463 horas: una reducción relativa de 56.8 % en esta partición. El MAE del modelo es 0.2684 horas. Son errores medidos en datos que no participaron en el ajuste ni en la normalización.
El \(R^2\) del modelo es 0.8098 y el del baseline -0.0215. El primero cuantifica la reducción del error cuadrático frente al comparador de la fórmula en esta muestra; no representa la proporción de entregas acertadas. Tampoco MAE y RMSE describen por sí solos el porcentaje de entregas dentro de una tolerancia operativa.
La media verdadera produce un RMSE de 0.3385 horas. Su error frente a respuestas observadas persiste porque estas contienen ruido. El MSE del modelo, 0.1199 horas², se interpreta junto a la referencia generadora 0.1225, sin exigir que sea mayor: esa referencia describe una esperanza sobre nuevas respuestas.
Todos estos resultados corresponden a una única simulación y partición. No hemos calculado intervalos ni demostrado superioridad estadística. La mejora es descriptiva y la relación lineal está favorecida por el diseño del generador; no permite anticipar su rendimiento en datos reales ni justificar una red más compleja.
2.6.12 Ver dónde se producen los errores
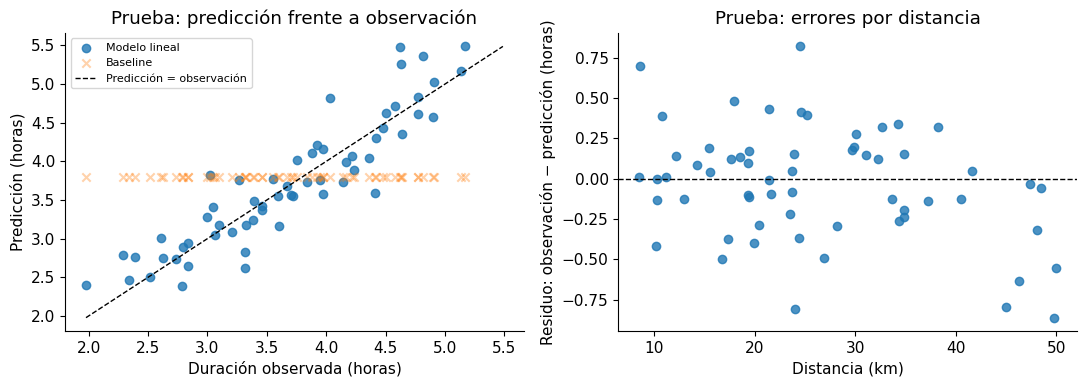
La tabla resume los errores, pero puede ocultar un patrón. En el primer panel compararemos predicción y observación; la diagonal marca igualdad. En el segundo, dibujaremos el residuo\(y-\hat y\) frente a la distancia: un residuo positivo indica que la duración observada superó la predicción.
El gráfico usa la prueba solo como diagnóstico final. Si después cambiáramos el modelo por lo que vemos aquí, necesitaríamos una evaluación independiente para el modelo revisado.
Residuo medio en prueba: -0.0363 horas
Mayor error absoluto en prueba: 0.8617 horas
2.6.13 Cómo leer los errores
El baseline forma una línea horizontal porque ignora las variables. El modelo lineal sigue la diagonal con dispersión: la diferencia vertical respecto a ella corresponde al error de cada entrega. Esa dispersión no desaparece al automatizar las derivadas.
El residuo medio de prueba es -0.0363 horas y el mayor error absoluto observado 0.8617 horas. El promedio puede compensar errores positivos y negativos; no sustituye al MAE. El máximo depende de estas 60 entregas y no es una garantía sobre el peor caso futuro.
El segundo panel permite buscar curvatura o cambios de dispersión con la distancia. Esta figura y una muestra de 60 puntos no bastan para demostrar normalidad, independencia ni varianza constante. En el experimento esas propiedades proceden del generador declarado, no de una certificación visual.
2.7 Errores que conviene reconocer
Síntoma
Qué revisar
Comprobación útil
La pérdida se calcula, pero resulta inesperada
Broadcasting entre (B,) y (B,1)
Verificar formas y errores por observación
Los valores cambian de significado
Confusión entre reshape y transposición
Seguir una fila conocida antes y después
El gradiente aumenta sin cambiar parámetros
Acumulación entre llamadas
Limpiar y recalcular una pérdida
Un parámetro conserva .grad=None
Conexión al grafo, requires_grad y limpieza
Comprobar si participa en la pérdida
Una comprobación numérica falla con perturbaciones diminutas
Precisión y cancelación
Probar varios tamaños de perturbación
Entrenamiento funciona y evaluación falla
Tipos, dispositivos y transformaciones distintas
Aplicar el mismo contrato de entrada
La curva cae, pero el modelo aporta poco
Ausencia de una referencia predictiva
Comparar con un baseline en prueba
None indica ausencia de un gradiente almacenado; un gradiente numéricamente cero indica otra situación. Como zero_grad(set_to_none=True) también usa None para limpiar, interpreta ese estado en el momento correcto del ciclo.
2.8 Ejercicios para comprobar el mecanismo
Repite la comparación cruzada con tres observaciones. Calcula primero a mano el MSE pareado y explica qué pares adicionales introduce el broadcasting.
Mantén \(b=0\) en el ejemplo de una observación y prueba dos actualizaciones desde \(w=1\): tasas de aprendizaje 0.05 y 0.50. Compara la pérdida antes y después; relaciona el resultado con la tangente y la curvatura.
Sustituye la pérdida por la mitad del MSE. Deriva el gradiente y comprueba su factor de escala antes de entrenar. ¿Qué cambiaría si duplicaras también la tasa de aprendizaje?
Modifica la distancia mediante una relación cuadrática en el generador. Conserva el modelo lineal y describe el patrón de residuos que aparece. Usa una simulación nueva para el ejercicio, no ajustes decisiones sobre la prueba ya reportada.
Repite el ajuste con cinco semillas fijadas antes de observar resultados. Reporta la distribución de RMSE y coeficientes. No interpretes su dispersión como un intervalo de confianza sin definir un procedimiento inferencial.
Explica por qué una sola entrega no identifica de manera única el peso y el intercepto. Da dos pares que produzcan la misma predicción.
2.9 Qué queda preparado para los siguientes artículos
Ya puedes revisar el significado de los ejes, reconocer una pérdida mal emparejada y comprobar un gradiente antes de confiar en un entrenamiento. En el caso de entregas, la derivada manual y autograd llevaron al mismo ajuste, y la utilidad predictiva se evaluó después frente a una referencia independiente del cálculo de derivadas.
Los siguientes artículos desarrollan datasets y generación de datos. Cuando llegues a Perceptrón y MLP, estos mismos tensores y ciclos se extenderán a modelos con activaciones y varias capas. La transformación de datos y la evaluación conservarán el mismo cuidado por las particiones.
2.10 Guardar el contrato sin cambiar el experimento
El modelo de este capítulo conserva 250 pasos SGD prefijados y precisión float64 para comparar derivadas. No se sustituye ese objetivo didáctico por early stopping. Guardamos el estado final junto con media y desviación ajustadas en entrenamiento, y comprobamos las predicciones recargadas en validación. Los tensores de entrada siguen siendo (N,2) y la salida (N,1); la normalización forma parte del contrato.
from pathlib import Pathimport json,hashlibartefactos=Path('artefactos_pytorch');artefactos.mkdir(exist_ok=True)torch.save({'state_dict':modelo.state_dict(),'media':torch.tensor(media_X),'desviacion':torch.tensor(desv_X),'dtype':'float64'},artefactos/'duracion-lineal.pt')recarga=DuracionLineal();recarga.load_state_dict(torch.load(artefactos/'duracion-lineal.pt',weights_only=True)['state_dict']);recarga.eval()with torch.inference_mode():torch.testing.assert_close(modelo(X_val),recarga(X_val),rtol=1e-12,atol=1e-12)pd.DataFrame(reportes).to_csv(artefactos/'metricas-prueba.csv',index=False)(artefactos/'contrato.json').write_text(json.dumps({'entrada':[None,2],'salida':[None,1],'dtype':'float64','dispositivo':'CPU','seleccion':'presupuesto fijo, comparación manual/autograd','normalizacion':'solo train','recarga_logits_validacion':True,'sha256':hashlib.sha256((artefactos/'duracion-lineal.pt').read_bytes()).hexdigest()},indent=2),encoding='utf-8')print('Estado y normalización conservados; recarga verificada en validación.')
Estado y normalización conservados; recarga verificada en validación.
2.10.1 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
Se conservaron las operaciones, las comprobaciones de gradiente y los 250 pasos SGD del ejemplo de entregas. La armonización añade persistencia del estado final y de la normalización ajustada solo en entrenamiento; las predicciones recargadas se comprobaron en validación con tolerancia 1e-12. La evaluación mantuvo RMSE de prueba 0,3463 h frente a 0,8026 h de la media de entrenamiento. No se cambió el modelo ni su presupuesto para mejorar estas cifras.
2.11 Referencias para profundizar
PyTorch: Tensors. Creación y operaciones de tensores, formas y almacenamiento.
Las referencias describen las API; las simulaciones, comparaciones numéricas y análisis de resultados de este capítulo se construyeron para el ejemplo de entregas.