Tienes fotografías de margaritas, dientes de león, rosas, girasoles y tulipanes. Quieres que un programa reciba una fotografía y elija una de esas cinco categorías. Ya sabes programar en Python; aquí aprenderás qué puedes reutilizar de una red que otra persona entrenó antes y qué debes adaptar a tus flores.
En los capítulos anteriores entrenaste redes modificando sus pesos. Ahora cuentas con otra posibilidad: empezar con pesos que ya aprendieron a trabajar con imágenes. Primero entenderás esa idea; después compararás tres estrategias con las mismas flores.
Tiempo estimado: 70 minutos de lectura; reserva tiempo adicional para ejecutar. En CPU, el entrenamiento completo tarda unos 20 minutos, además de las descargas iniciales.
Nivel: introducción a transferencia para quien ya maneja Python.
Herramientas: PyTorch y torchvision para las redes; NumPy, pandas, Pillow, matplotlib y scikit-learn para datos, imágenes y evaluación. La primera celda registra versiones y dispositivo.
Al terminar podrás explicar qué se transfiere entre tareas, distinguir una base congelada del ajuste fino, preparar imágenes para una red preentrenada y comparar resultados sin elegir con los datos de prueba. También podrás guardar la red junto con la información necesaria para usarla después.
TipLo que necesitas recordar
Este capítulo usa conceptos que ya se explicaron antes. Si alguno no te suena, sigue el enlace antes de continuar.
Concepto
En una línea
Dónde se explica
Tensor y forma
Caja de números; la forma dice cuántos hay en cada dimensión
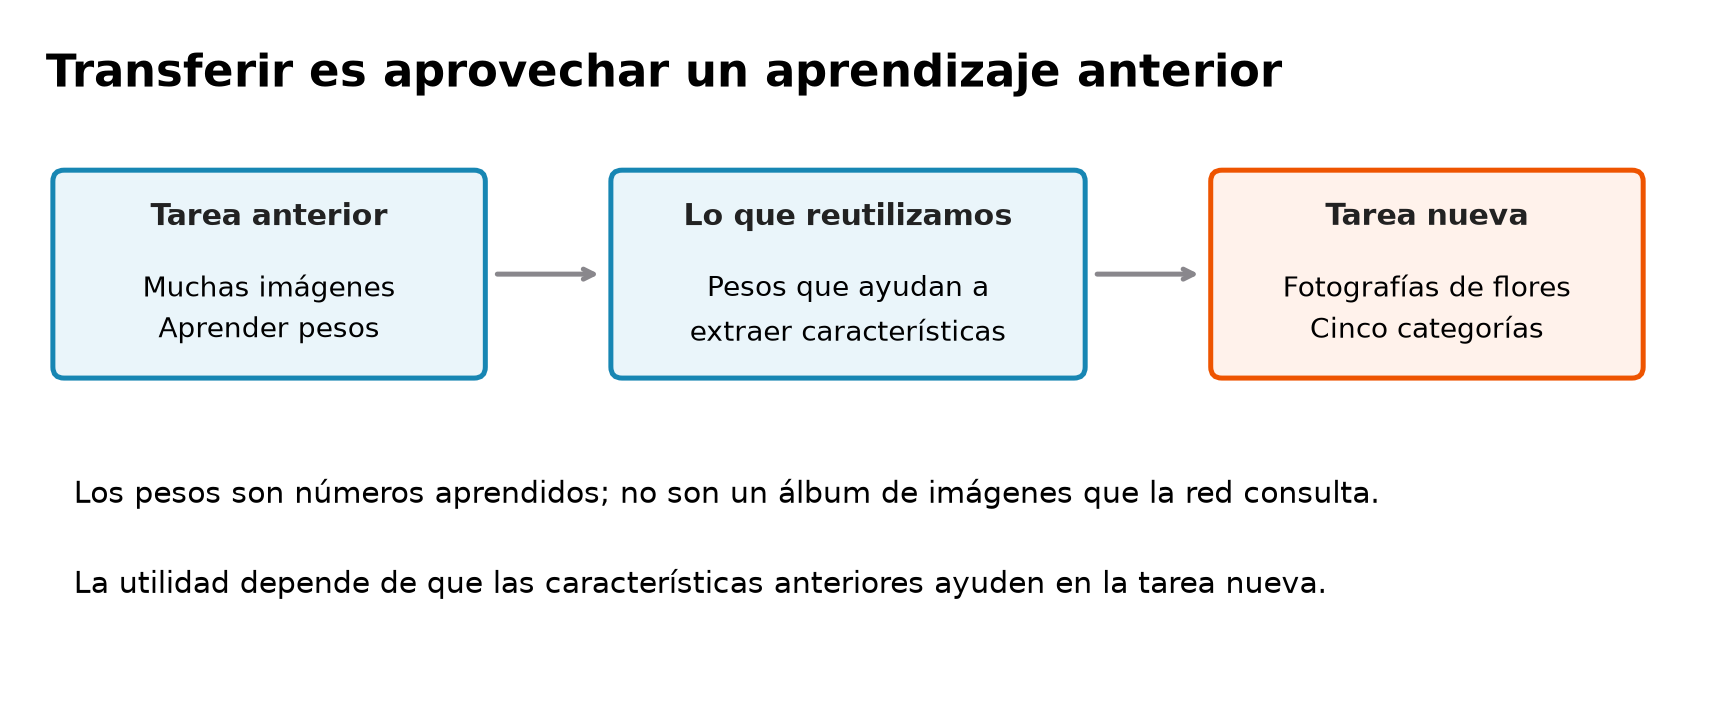
Transferencia de aprendizaje o transfer learning. Consiste en aprovechar lo aprendido por un modelo en una tarea anterior para trabajar en una tarea nueva. En este capítulo reutilizas sus pesos, los números que el entrenamiento ajustó para transformar entradas en predicciones.
Piensa en una persona que ya distingue contornos, texturas y formas al dibujar animales y ahora aprende a dibujar flores. No vuelve a aprender cada destreza desde el comienzo. La analogía ayuda a entender el punto de partida, pero una red no razona como esa persona: aplica operaciones numéricas con los pesos que recibió.
NotaRed preentrenada
Red preentrenada. Es una red cuyos pesos ya fueron ajustados con un conjunto anterior. Preentrenamiento nombra esa etapa previa. Aquí usarás MobileNetV2, una red convolucional o CNN, que busca patrones en regiones cercanas de las imágenes, con pesos aprendidos para clasificar imágenes de ImageNet, un conjunto de imágenes de muchas categorías.
La nueva tarea tiene cinco tipos de flores. El modelo anterior se entrenó para otras categorías; por eso no basta con descargarlo y asumir que ya resuelve nuestro problema. Debes adaptar la parte que toma la decisión final y comprobar si lo aprendido antes resulta útil. Si las imágenes o la tarea son muy diferentes, transferir puede no ayudar e incluso perjudicar.
La transferencia reutiliza pesos aprendidos en una tarea anterior como punto de partida para clasificar cinco tipos de flores; la utilidad debe comprobarse en la tarea nueva.
15.3 Una base que describe y una cabeza que decide
NotaCaracterística, base y cabeza
Característica aprendida. Es una representación numérica construida por la red a partir de los píxeles. Puede responder a patrones de forma, textura u otras regularidades; no debemos atribuir un significado concreto a cada número sin estudiarlo.
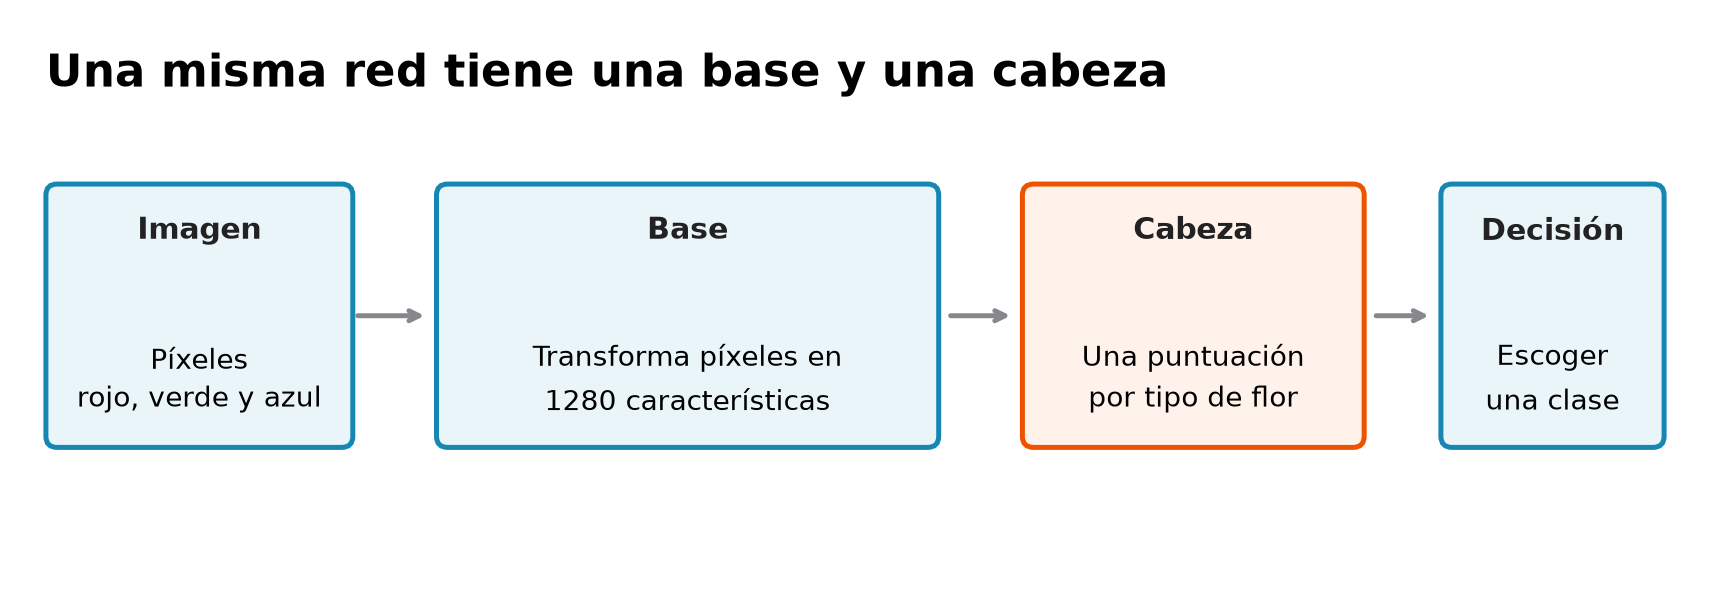
Base. Es la parte de la red que convierte la imagen en esas características.
Cabeza de clasificación. Es la parte final que convierte las características en puntuaciones para las categorías que queremos reconocer.
La arquitectura es la organización de las capas y sus conexiones. En MobileNetV2, la base entrega 1280 números por imagen después de resumir sus posiciones espaciales mediante un promedio. La cabeza nueva utilizará esos números para producir cinco puntuaciones, una por tipo de flor. Cambiar la cabeza permite cambiar las categorías de salida sin reconstruir toda la base.
Una imagen RGB pasa por una base que produce 1280 características y por una cabeza nueva que produce cinco puntuaciones para escoger una clase.
Antes de continuar: si sustituimos la cabeza, ¿estamos borrando también lo aprendido por la base? No: cambiar la cabeza modifica la decisión final; los pesos de la base se conservan hasta que decidamos entrenarlos.
15.4 El recorrido del experimento
NotaDesde cero, congelar y ajuste fino
Entrenar desde cero. Empezar con pesos inicializados sin reutilizar un entrenamiento anterior y ajustarlos con nuestros datos.
Congelar. Mantener fijos ciertos parámetros —los números ajustables de la red— mientras entrenamos otros.
Ajuste fino o fine tuning. Continuar el entrenamiento de una red preentrenada para adaptarla a la tarea nueva. Aquí ajustaremos solo sus últimos bloques y la cabeza.
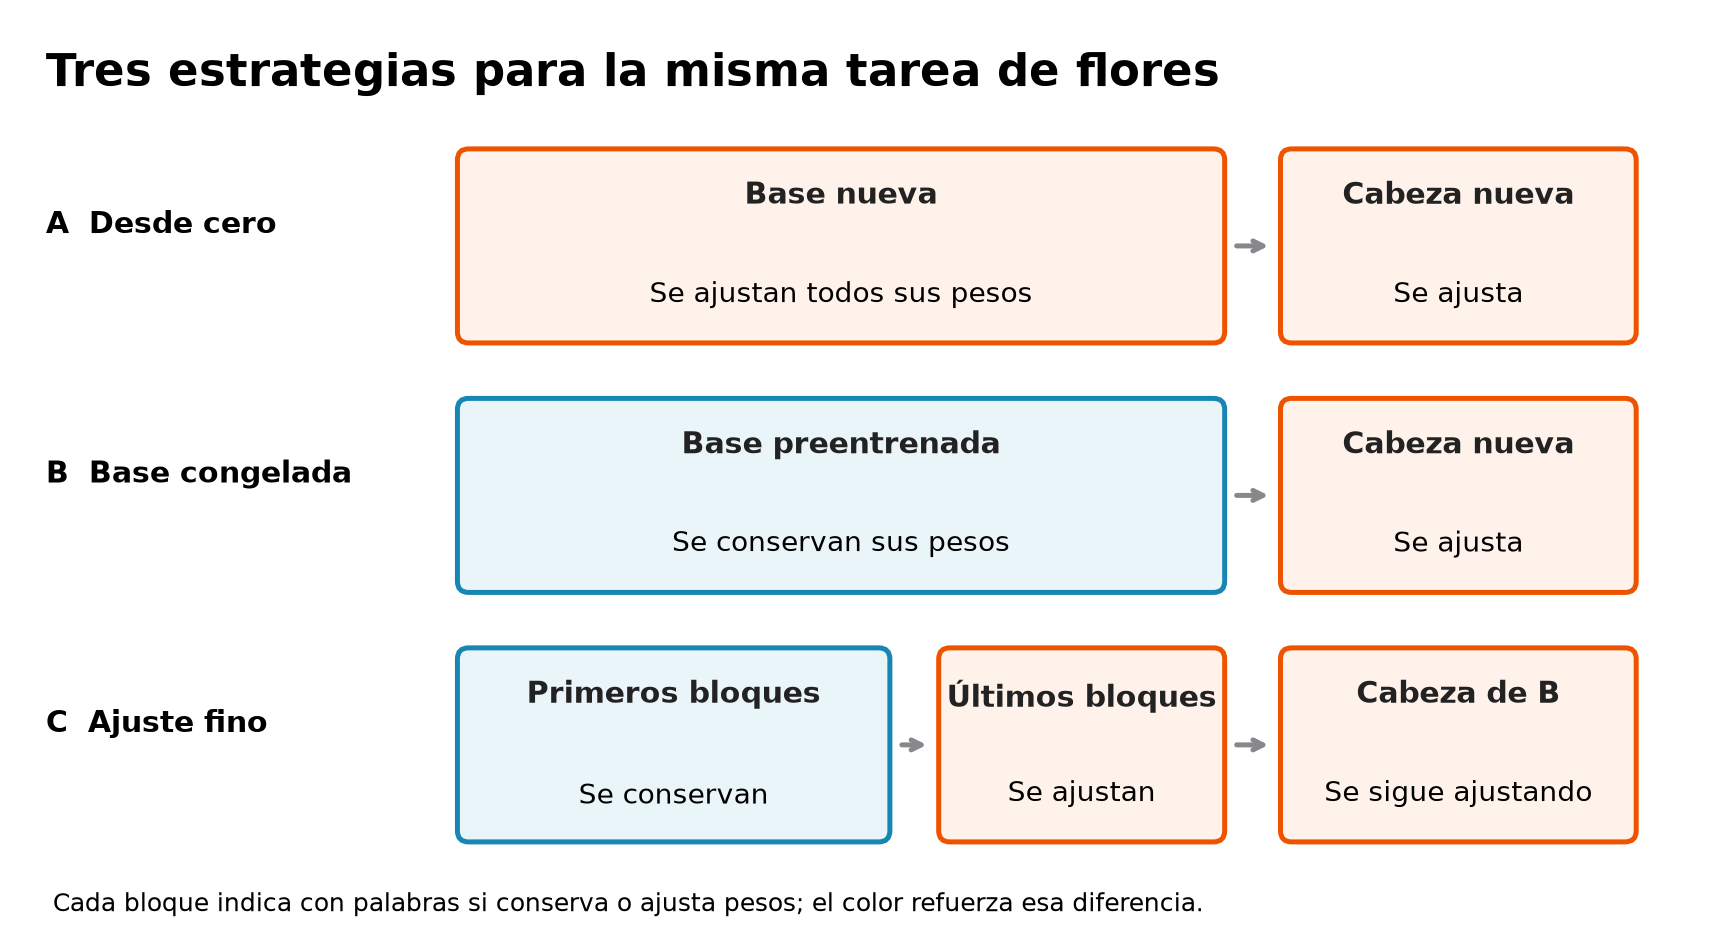
Una capa transforma los números recibidos y entrega otros a la siguiente. Un bloque es un grupo de capas que realiza una transformación dentro de la red. Compararás A, una CNN pequeña desde cero; B, MobileNetV2 con base fija y cabeza nueva; y C, que parte de B y permite adaptar sus tres últimos bloques. Así podrás observar qué cambia al reutilizar y después al adaptar.
Tres estrategias para las mismas flores: A ajusta una red nueva completa; B conserva la base preentrenada y ajusta la cabeza; C conserva los primeros bloques y adapta los últimos y la cabeza.
La comparación A–B combina arquitectura y preentrenamiento: A es una CNN pequeña y B es MobileNetV2. No aísla únicamente el efecto de usar pesos anteriores. Para aislarlo necesitarías, además, la misma arquitectura entrenada con y sin pesos preentrenados. B–C sí permite estudiar la adaptación desde el mismo punto de partida.
Trabajarás en este orden: conocer las flores, reservar datos, preparar imágenes, entrenar A, entrenar B, adaptar C, elegir con validación y abrir la prueba. Cada estrategia responderá a una pregunta concreta del mismo problema.
15.5 Preparar las herramientas
Las imágenes viajarán por la red como tensores de forma (N, 3, 128, 128): N imágenes, tres canales de color (rojo, verde y azul), 128 filas y 128 columnas.
Puedes descargar el capítulo con sus archivos de apoyo para trabajar en una misma carpeta. El archivo apoyo_transferencia.py, incluido junto al notebook, reúne funciones de carga, entrenamiento y gráficos. Aquí verás las decisiones que tomas y qué recibe cada función; al final del capítulo puedes desplegar su código completo, con cada función explicada. Ejecuta las celdas en orden. Los datos y pesos se descargarán de sus fuentes oficiales si aún no están guardados en tu equipo.
# Configura herramientas, versiones y una única semilla para toda la ejecución.from pathlib import Pathimport json, time, copy, hashlib, platformimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom PIL import Imagefrom IPython.display import display, Markdownimport torchfrom torch import nnfrom torch.nn import functional as Ffrom torch.utils.data import DataLoader, TensorDataset, Datasetfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import f1_scoreimport sklearn, torchvisionimport apoyo_transferencia as apoyoSEMILLA =42np.random.seed(SEMILLA)torch.manual_seed(SEMILLA)torch.set_num_threads(2)DEVICE = torch.device('cuda'if torch.cuda.is_available() else'cpu')ARTEFACTOS = Path('artefactos_pytorch')ARTEFACTOS.mkdir(exist_ok=True)apoyo.SEMILLA, apoyo.DEVICE, apoyo.ARTEFACTOS = (SEMILLA, DEVICE, ARTEFACTOS)plt.style.use('seaborn-v0_8-whitegrid')plt.rcParams.update({'figure.dpi': 110, 'font.size': 10})print({'python': platform.python_version(), 'sistema': platform.system(), 'torch': str(torch.__version__), 'torchvision': torchvision.__version__, 'numpy': np.__version__, 'pandas': pd.__version__, 'matplotlib': plt.matplotlib.__version__, 'sklearn': sklearn.__version__, 'Pillow': Image.__version__, 'dispositivo': str(DEVICE), 'hilos_cpu': torch.get_num_threads(), 'semilla': SEMILLA})
La salida registra las columnas de información python, torch, torchvision y dispositivo de esta ejecución. Se usan dos hilos de CPU cuando corresponde. Una semilla reduce la variación, pero cambiar versiones o dispositivo puede modificar las cifras. Los tiempos que compararás excluyen descargas iniciales. Se usa una única semilla al comenzar; para repetir el experimento completo, reinicia el entorno y ejecuta desde la primera celda.
15.6 Conocer las flores y reservar la prueba
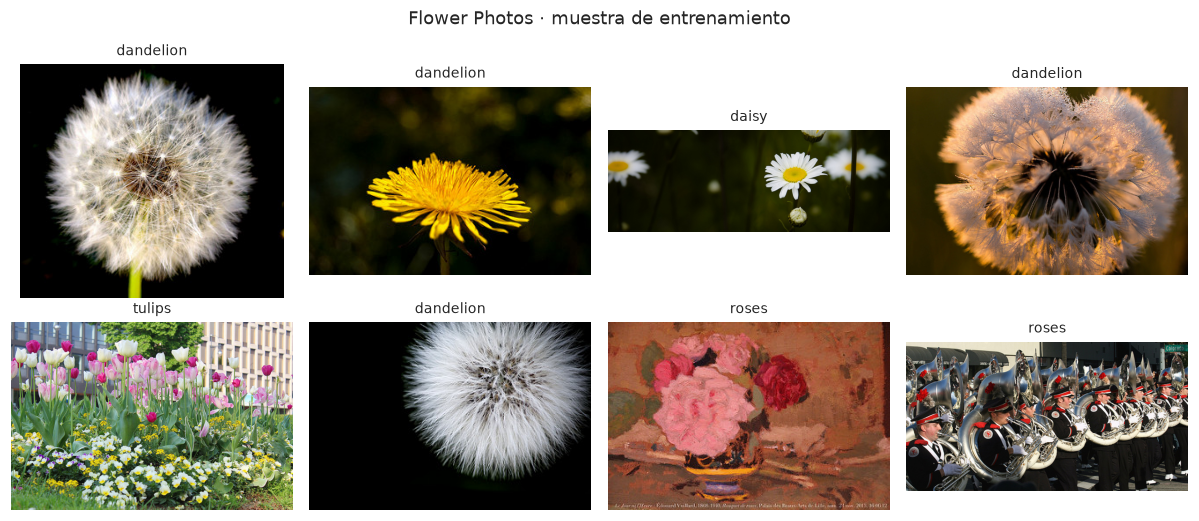
Una etiqueta indica la categoría correcta de una imagen. El conjunto Flower Photos contiene 3670 fotografías y cinco etiquetas. En el código conservamos sus nombres originales: daisy, dandelion, roses, sunflowers y tulips. Corresponden a margarita, diente de león, rosa, girasol y tulipán.
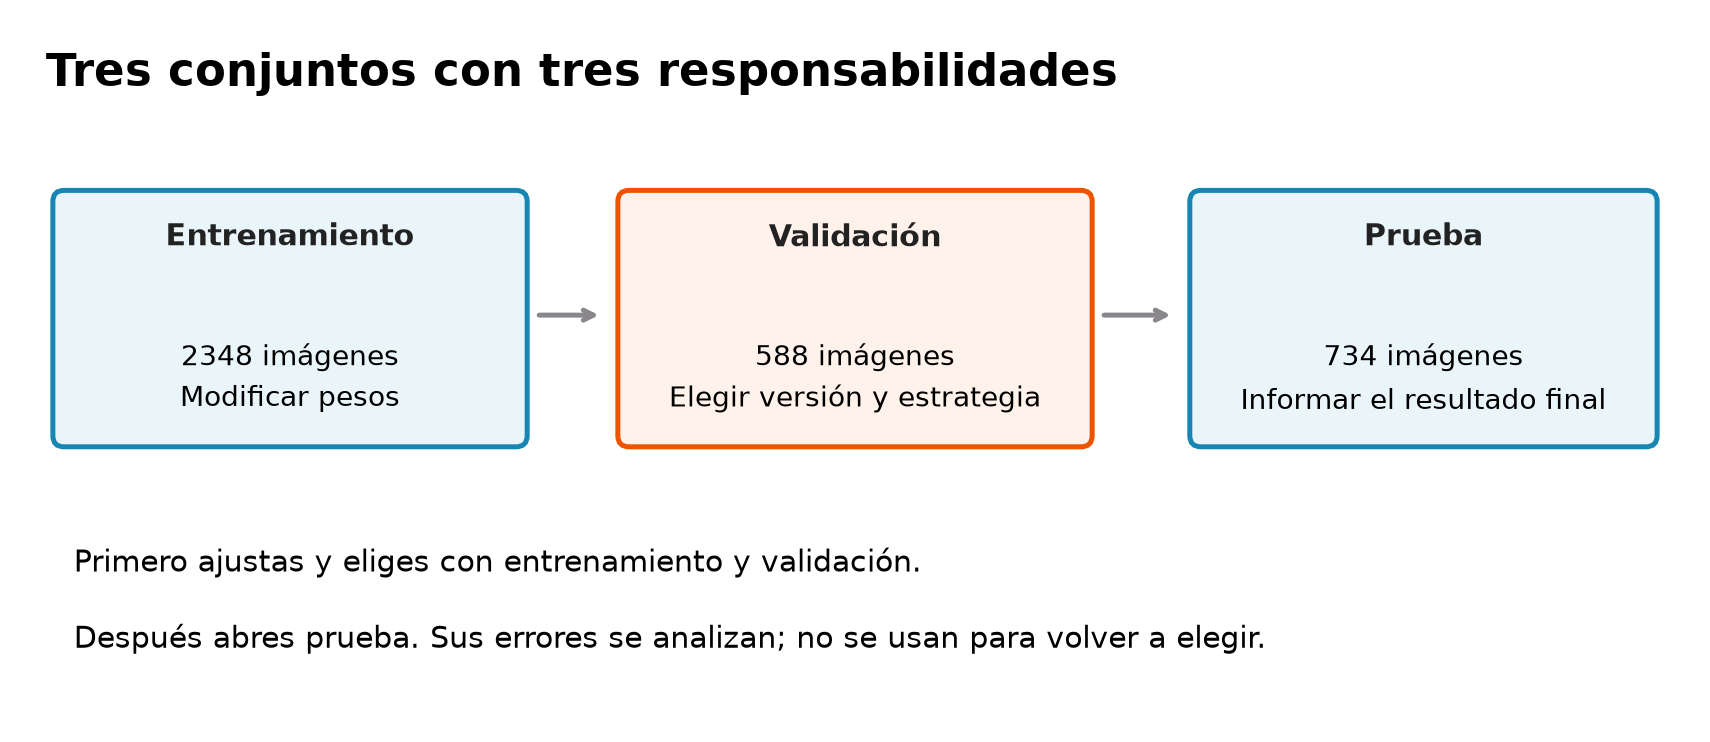
Como en el capítulo de evaluación de modelos, separamos tres grupos con funciones distintas: entrenamiento modifica los pesos, validación elige la versión del modelo y la estrategia, y prueba se abre una sola vez, al final, para informar el resultado.
La partición estratificada mantiene aproximadamente la proporción de cada clase. Reservamos 20 % para prueba y 20 % del resto para validación. Ordenar archivos y fijar la semilla hace repetible esta división; no garantiza que dos fotografías de una misma planta sean independientes.
Entrenamiento tiene 2348 imágenes para ajustar pesos; validación tiene 588 para elegir; prueba tiene 734 para el informe final.
Las imágenes tienen licencia CC BY 2.0. El archivo atribuciones de las fotografías conserva autor y enlace por imagen del paquete original. Se mostrarán recortes o redimensionamientos de algunas fotos. El conjunto procede de Flower Photos; no necesitas TensorFlow para cargarlo aquí.
La siguiente celda muestra los conteos por clase y algunas fotografías de entrenamiento. El archivo flowers-manifiesto.csv registra qué imagen pertenece a cada grupo. Su SHA-256 es una huella del archivo que permite detectar cambios de contenido.
# Carga las fotografías y divide sus índices sin compartir imágenes entre grupos.from torchvision import models, transformsimport torchvisionfrom torchvision.datasets.utils import download_and_extract_archiveraiz = Path.home() /'.keras'/'datasets'/'flower_photos'if (raiz /'flower_photos').is_dir(): raiz = raiz /'flower_photos'ifnot (raiz /'daisy').is_dir(): destino = Path.home() /'.cache'/'bit-datasets' download_and_extract_archive('https://storage.googleapis.com/download.tensorflow.org/example_images/flower_photos.tgz', str(destino)) raiz = destino /'flower_photos'clases =sorted((p.name for p in raiz.iterdir() if p.is_dir()))rutas = []yf = []for i, clase inenumerate(clases): archivos =sorted((p for p in (raiz / clase).iterdir() if p.suffix.lower() in ['.jpg', '.jpeg', '.png'])) rutas.extend(archivos) yf.extend([i] *len(archivos))yf = np.array(yf)indices = np.arange(len(yf))dev, ite = train_test_split(indices, test_size=0.2, stratify=yf, random_state=SEMILLA)itr, iva = train_test_split(dev, test_size=0.2, stratify=yf[dev], random_state=SEMILLA)assertnot (set(itr) &set(iva) orset(itr) &set(ite) orset(iva) &set(ite))particion = np.full(len(yf), 'train', dtype='<U5')particion[iva] ='val'particion[ite] ='test'manifiesto = pd.DataFrame({'ruta': [str(p.relative_to(raiz)) for p in rutas], 'clase': [clases[i] for i in yf], 'etiqueta': yf, 'particion': particion, 'sha256': [hashlib.sha256(p.read_bytes()).hexdigest() for p in rutas]})manifiesto.to_csv(ARTEFACTOS /'flowers-manifiesto.csv', index=False)display(pd.crosstab(manifiesto.clase, manifiesto.particion))print('Torchvision:', torchvision.__version__)fig, axes = plt.subplots(2, 4, figsize=(11, 5))for ax, j inzip(axes.flat, itr[:8]):with Image.open(rutas[j]) as im: ax.imshow(im.convert('RGB')) ax.set_title(clases[yf[j]], fontsize=9) ax.axis('off')fig.suptitle('Flower Photos · muestra de entrenamiento')fig.tight_layout()plt.show()
Torchvision: 0.29.1+cpu
particion
test
train
val
clase
daisy
127
405
101
dandelion
179
575
144
roses
128
410
103
sunflowers
140
447
112
tulips
160
511
128
(a) Fotografías de entrenamiento de Flower Photos
(b)
Figura 15.1
La tabla suma 2348 imágenes de entrenamiento, 588 de validación y 734 de prueba. La muestra permite ver variaciones de fondo, encuadre y aspecto dentro de una categoría. Identifica una flor en primer plano y otra cuya forma resulte más difícil de distinguir; esas diferencias anticipan posibles errores, pero no explican por sí solas su causa.
15.7 Preparar cada imagen para la red
NotaRedimensionar, recortar y normalizar
Redimensionar y recortar. Redimensionar cambia el tamaño conservando aquí la proporción; recortar selecciona una región. Normalizar transforma los valores con una media y una desviación de referencia: (valor − media) / desviación.
Los pesos preentrenados se usaron con una preparación determinada. Para aprovecharlos debes mantener una entrada compatible. Es parecido a utilizar siempre la misma unidad al medir: cambiar la escala sin avisar cambia el significado de los números recibidos.
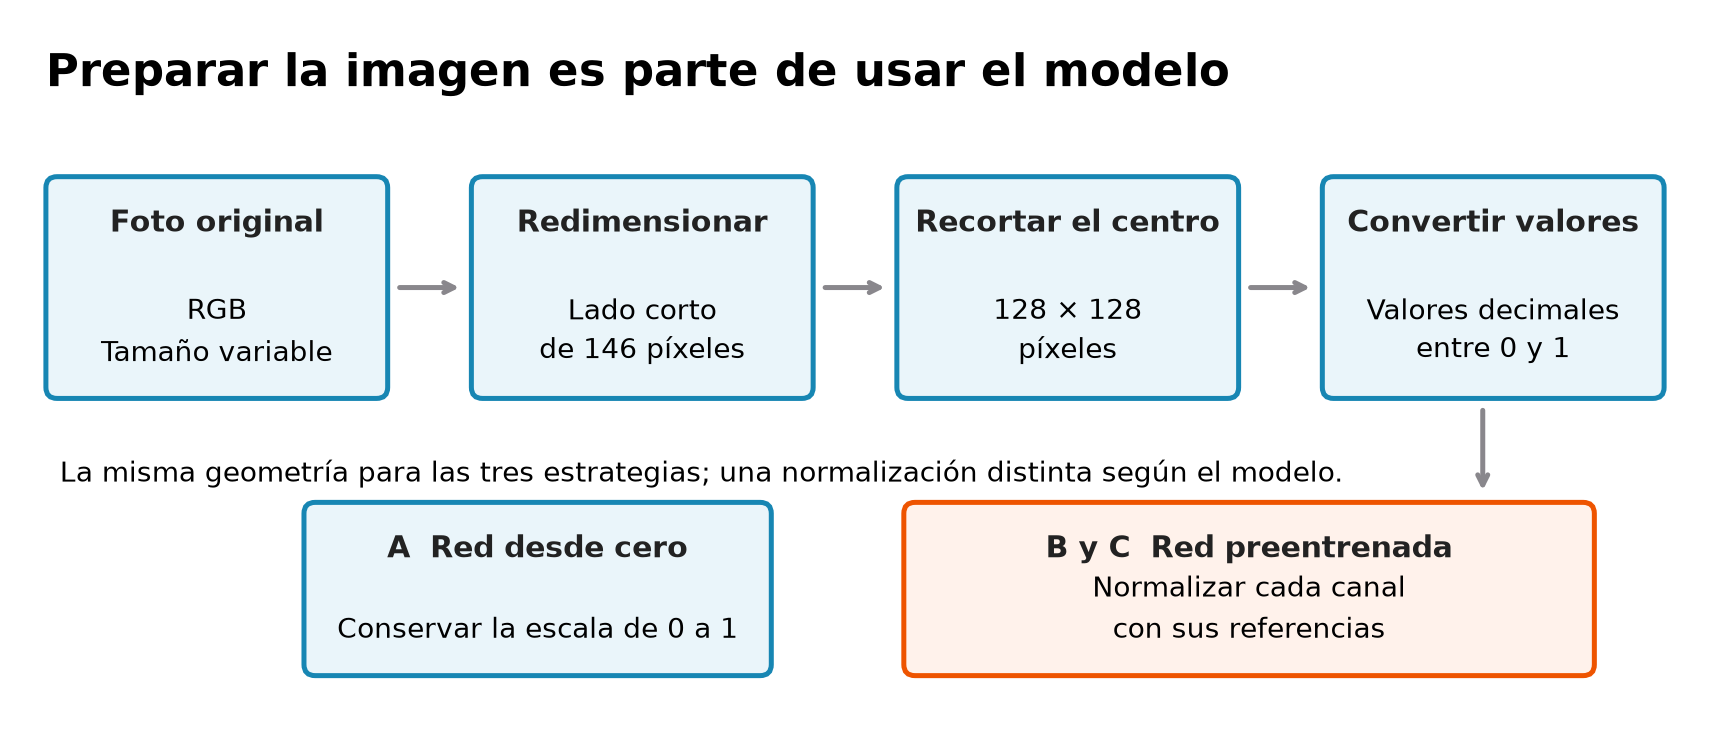
En las tres estrategias redimensionamos el lado corto a 146 píxeles y recortamos el centro a 128 × 128. Convertimos los enteros de 0 a 255 en decimales de 0 a 1. B y C añaden la normalización de ImageNet por canal; A conserva la escala de 0 a 1.
La imagen se convierte a RGB, se redimensiona, se recorta a 128 por 128 y se transforma a números; B y C añaden normalización por canal.
Para B y C, las medias RGB son [0.485, 0.456, 0.406] y las desviaciones [0.229, 0.224, 0.225]. Por ejemplo, un valor rojo de 0.8 pasa a (0.8−0.485)/0.229 ≈ 1.376. Que el resultado supere 1 es normal: ya cambiaste de escala.
Este tamaño de 128 es una adaptación para reducir el trabajo del equipo; no es el tamaño del ejemplo estándar de los pesos ni promete reproducir su puntuación original de ImageNet. Guardamos una copia temporal de las imágenes ya preparadas, llamada caché, para no decodificarlas en cada época.
# Prepara una copia de las imágenes y dos escalas de entrada: A y B/C.PESOS = models.MobileNet_V2_Weights.IMAGENET1K_V2preset = PESOS.transforms(crop_size=128, resize_size=146)geometria = transforms.Compose([transforms.Resize(146, interpolation=transforms.InterpolationMode.BILINEAR), transforms.CenterCrop(128), transforms.PILToTensor()])inicio = time.perf_counter()imagenes = []for p in rutas:with Image.open(p) as im: imagenes.append(geometria(im.convert('RGB')).numpy())imagenes = np.stack(imagenes)preparacion_s = time.perf_counter() - inicioMEDIA = torch.tensor(preset.mean)[:, None, None]DESV = torch.tensor(preset.std)[:, None, None]class Flores(Dataset):def__init__(self, indices, normalizar):self.indices = np.array(indices)self.normalizar = normalizardef__len__(self):returnlen(self.indices)def__getitem__(self, i): j =self.indices[i] x = torch.from_numpy(imagenes[j].copy()).float() /255ifself.normalizar: x = (x - MEDIA) / DESVreturn (x, torch.tensor(yf[j], dtype=torch.long))tra, vla, tea = [Flores(i, False) for i in [itr, iva, ite]]trm, vlm, tem = [Flores(i, True) for i in [itr, iva, ite]]with Image.open(rutas[0]) as im: referencia = preset(im.convert('RGB'))torch.testing.assert_close(Flores([0], True)[0][0], referencia, rtol=1e-05, atol=1e-06)print('Preparación:', round(preparacion_s, 2), 's · caché uint8:', round(imagenes.nbytes /2**20, 1), 'MiB')preparacion = {'pesos': 'MobileNet_V2_Weights.IMAGENET1K_V2', 'entrada': 'NCHW RGB float32', 'forma': [3, 128, 128], 'resize_lado_corto': 146, 'recorte_central': 128, 'media': preset.mean, 'desviacion': preset.std, 'clases': clases, 'seleccion': 'min CE validacion', 'preparacion_s': preparacion_s}_ = (ARTEFACTOS /'preprocesamiento.json').write_text(json.dumps(preparacion, indent=2), encoding='utf-8')
Preparación: 7.38 s · caché uint8: 172.0 MiB
Cada imagen tiene ahora tres canales de 128 × 128. El código comprueba que nuestra normalización coincide con la transformación definida por torchvision para esos tamaños. El tiempo de preparación y la memoria de las imágenes se muestran aparte del entrenamiento.
15.8 Cómo sabrás si el entrenamiento mejora
Cada lote repite las cinco acciones del bucle que viste en el Apéndice A: borrar gradientes, predecir, medir la pérdida, calcular gradientes y corregir. Aquí la pérdida es la entropía cruzada (CE) y el optimizador es Adam. Seguiremos dos números por época: la CE, que es la que se usa para elegir, y la exactitud, que es más fácil de interpretar.
F.cross_entropy, usada en la función de entrenamiento, recibe logits y etiquetas enteras; calcula internamente la pérdida sin que añadas softmax antes. Softmax se utiliza al interpretar las predicciones. Para las cinco flores, cada fila de salida contiene cinco logits.
Durante el entrenamiento guardamos un checkpoint, una copia del modelo, cada vez que mejora la CE de validación. Al final nos quedamos con el mejor, aunque no sea el de la última época. Si la validación no mejora durante varias épocas seguidas (la paciencia), el entrenamiento se detiene: es la parada temprana.
Las curvas de entrenamiento y validación se calculan al terminar cada época, con los mismos pesos y en modo de evaluación. Así puedes compararlas. Si entrenamiento mejora y validación empeora, hay una señal para investigar posible sobreajuste, es decir, adaptación excesiva a las imágenes conocidas. La curva no identifica por sí sola una causa.
15.9 Estrategia A: aprender desde cero
La primera pregunta es: ¿qué consigue una red pequeña sin pesos anteriores con este presupuesto? Será nuestra línea base, la referencia con que compararemos las otras estrategias.
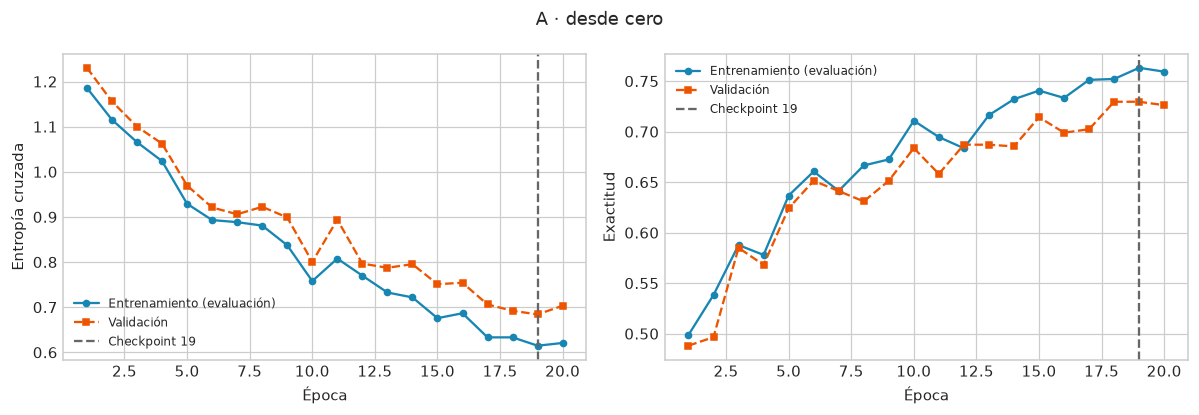
En estas curvas también se medirán las imágenes del ajuste; sus métricas describen datos conocidos por el modelo. La CNN pequeña contiene tres convoluciones y una cabeza de cinco salidas. Se ajustan todos sus parámetros. crear_cero() define la red; apoyo.entrenar() recibe modelo, entrenamiento y validación, con un máximo de 20 épocas, lotes de 32, tasa 0.001 y paciencia 3. No recibe prueba. Las capas y sus dimensiones se pueden seguir en el código; los fundamentos están en el capítulo de CNN.
Cuántas épocas. Cada estrategia tiene un máximo de épocas, y el entrenamiento se detiene antes si la CE de validación no mejora durante varias épocas seguidas: eso es la paciencia. Los máximos son amplios a propósito: 20 para A, 30 para B y 6 para C. Si la mejor época coincidiera con el máximo, la red todavía estaría mejorando cuando la detuvimos y la comparación sería injusta. Por eso, después de cada entrenamiento, el código imprime si la mejor época quedó en el límite.
Predice antes de ejecutar: si la mejor validación estuviera en la última época permitida, ¿significaría que la red ya terminó de aprender? No: significaría que la detuvimos mientras todavía mejoraba.
# Define la red nueva y aprende sus pesos con entrenamiento; validación elige la versión.def crear_cero():return nn.Sequential( nn.Conv2d(3, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2), nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2), nn.Conv2d(64, 64, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2), nn.AdaptiveAvgPool2d(1), nn.Flatten(), nn.Linear(64, 128), nn.ReLU(), nn.Dropout(0.3), nn.Linear(128, 5), )MAX_EPOCAS_A =20a = apoyo.inicializar(crear_cero())ha, ra = apoyo.entrenar(a, tra, vla, MAX_EPOCAS_A, lote=32, paciencia=3, nombre='A-cero')apoyo.curvas(ha, 'A · desde cero', ra['mejor_epoca'])print(f"Mejor época: {ra['mejor_epoca']} · épocas ejecutadas: {len(ha)} de {MAX_EPOCAS_A} · "f"¿la mejor quedó en el límite?: {'sí'if ra['mejor_epoca'] == MAX_EPOCAS_A else'no'}")
A-cero 1/20: CE val=1.2304, acc val=0.4881
A-cero 2/20: CE val=1.1558, acc val=0.4966
A-cero 3/20: CE val=1.1001, acc val=0.5850
A-cero 4/20: CE val=1.0624, acc val=0.5680
A-cero 5/20: CE val=0.9695, acc val=0.6241
A-cero 6/20: CE val=0.9211, acc val=0.6514
A-cero 7/20: CE val=0.9059, acc val=0.6412
A-cero 8/20: CE val=0.9224, acc val=0.6310
A-cero 9/20: CE val=0.8989, acc val=0.6514
A-cero 10/20: CE val=0.8004, acc val=0.6837
A-cero 11/20: CE val=0.8940, acc val=0.6582
A-cero 12/20: CE val=0.7966, acc val=0.6871
A-cero 13/20: CE val=0.7873, acc val=0.6871
A-cero 14/20: CE val=0.7953, acc val=0.6854
A-cero 15/20: CE val=0.7510, acc val=0.7143
A-cero 16/20: CE val=0.7541, acc val=0.6990
A-cero 17/20: CE val=0.7061, acc val=0.7024
A-cero 18/20: CE val=0.6920, acc val=0.7296
A-cero 19/20: CE val=0.6841, acc val=0.7296
A-cero 20/20: CE val=0.7032, acc val=0.7262
Figura 15.2: Evolución de A: red pequeña desde cero
Mejor época: 19 · épocas ejecutadas: 20 de 20 · ¿la mejor quedó en el límite?: no
En esta ejecución, A alcanza su menor CE de validación en la época 19 de 20, con 0.6841; en la época 20 sube a 0.7032, así que el mejor resultado no quedó en el límite. Aun así, la curva todavía bajaba despacio (en la época 10 valía 0.8004), de modo que A podría mejorar un poco con más épocas. Lee las dos curvas: la pérdida penaliza asignar poca probabilidad a la etiqueta real; la exactitud cuenta cuántas categorías se acertaron. No tienen que mejorar de forma idéntica. La selección de esta época utiliza únicamente las imágenes de validación.
15.10 Estrategia B: conservar la base y aprender la cabeza
La segunda pregunta es: ¿pueden las características anteriores ayudar a distinguir nuestras flores sin cambiar la base? Cargamos los pesos de MobileNetV2, sustituimos su clasificador por una cabeza de cinco salidas y congelamos la base con requires_grad=False.
NotaActivación, BatchNorm y modos de la red
Una activación es un valor producido dentro de la red al transformar una entrada.
BatchNorm. Capa que normaliza activaciones y conserva estadísticas de entrenamiento, como medias. Esas estadísticas son parte del estado del modelo y no son los mismos objetos que los pesos que ajusta el optimizador.
Modo de entrenamiento y modo de evaluación.train() activa comportamientos de entrenamiento, como dropout y actualización de estadísticas de BatchNorm. eval() cambia esos comportamientos para evaluar o predecir. inference_mode() evita además construir el cálculo de gradientes.
Por eso congelamos dos cosas: los parámetros de la base y sus estadísticas de BatchNorm. features.eval() mantiene esas estadísticas fijas. El código comprueba que la base no cambió después de entrenar la cabeza.
Como la base está fija y no aplicamos cambios aleatorios a las fotos, calculamos sus características una vez y entrenamos la cabeza con esa copia temporal. Después comprobamos que usarla produce las mismas puntuaciones que volver a pasar la imagen por la base. Esa reutilización dejaría de ser válida si cambiaran los pesos de la base o la preparación de las imágenes. Como cada época solo entrena la cabeza sobre esos 1280 números por imagen, es muy rápida; por eso B admite hasta 30 épocas, con paciencia 5.
Predice antes de ejecutar: ¿tener pocos parámetros entrenables significa que la red completa ocupa poco? No necesariamente: la base sigue siendo necesaria para procesar cada imagen nueva.
# Mantén fija la base, extrae características y aprende únicamente la nueva cabeza.inicio = time.perf_counter()b = models.mobilenet_v2(weights=PESOS).to(DEVICE)b.classifier = nn.Sequential(nn.Dropout(0.2), nn.Linear(1280, 5)).to(DEVICE)nn.init.xavier_uniform_(b.classifier[1].weight)nn.init.zeros_(b.classifier[1].bias)for p in b.features.parameters(): p.requires_grad =Falseb.features.eval()descarga_construccion_s = time.perf_counter() - inicioestado_base = {k: v.cpu().clone() for k, v in b.features.state_dict().items()}@torch.inference_mode()def extraer(modelo, ds): modelo.eval() xx = [] yy = []for x, y in apoyo.cargador(ds, 32): xx.append(modelo.features(x.to(DEVICE)).mean((2, 3)).cpu()) yy.append(y)return TensorDataset(torch.cat(xx), torch.cat(yy))inicio = time.perf_counter()trf = extraer(b, trm)vlf = extraer(b, vlm)extraccion_s = time.perf_counter() - inicioMAX_EPOCAS_B =30hb, rb = apoyo.entrenar(b.classifier, trf, vlf, MAX_EPOCAS_B, lote=32, paciencia=5, nombre='B-congelada')b.eval()with torch.inference_mode(): xb, yb =next(iter(apoyo.cargador(vlm, 16))) torch.testing.assert_close(b(xb.to(DEVICE)), b.classifier(vlf.tensors[0][:16].to(DEVICE)), rtol=0.0001, atol=1e-05)assertall((torch.equal(v.cpu(), estado_base[k]) for k, v in b.features.state_dict().items()))rb['segundos_cabeza'] = rb['segundos']rb['segundos'] += extraccion_srb['extraccion_s'] = extraccion_srb['parametros'] = apoyo.parametros(b)rb['entrenables'] = apoyo.parametros(b.classifier)print('Base congelada: pesos y estadísticas internas intactos · equivalencia de puntuaciones comprobada')apoyo.curvas(hb, 'B · cabeza con base fija', rb['mejor_epoca'])print(f"Mejor época: {rb['mejor_epoca']} · épocas ejecutadas: {len(hb)} de {MAX_EPOCAS_B} · "f"¿la mejor quedó en el límite?: {'sí'if rb['mejor_epoca'] == MAX_EPOCAS_B else'no'}")
B-congelada 1/30: CE val=0.5287, acc val=0.8231
B-congelada 2/30: CE val=0.4553, acc val=0.8503
B-congelada 3/30: CE val=0.4209, acc val=0.8554
B-congelada 4/30: CE val=0.4023, acc val=0.8639
B-congelada 5/30: CE val=0.3992, acc val=0.8707
B-congelada 6/30: CE val=0.3915, acc val=0.8673
B-congelada 7/30: CE val=0.3815, acc val=0.8724
B-congelada 8/30: CE val=0.3730, acc val=0.8776
B-congelada 9/30: CE val=0.3745, acc val=0.8810
B-congelada 10/30: CE val=0.3783, acc val=0.8690
B-congelada 11/30: CE val=0.3710, acc val=0.8810
B-congelada 12/30: CE val=0.3818, acc val=0.8759
B-congelada 13/30: CE val=0.3714, acc val=0.8861
B-congelada 14/30: CE val=0.3820, acc val=0.8707
B-congelada 15/30: CE val=0.3815, acc val=0.8759
B-congelada 16/30: CE val=0.3723, acc val=0.8793
Base congelada: pesos y estadísticas internas intactos · equivalencia de puntuaciones comprobada
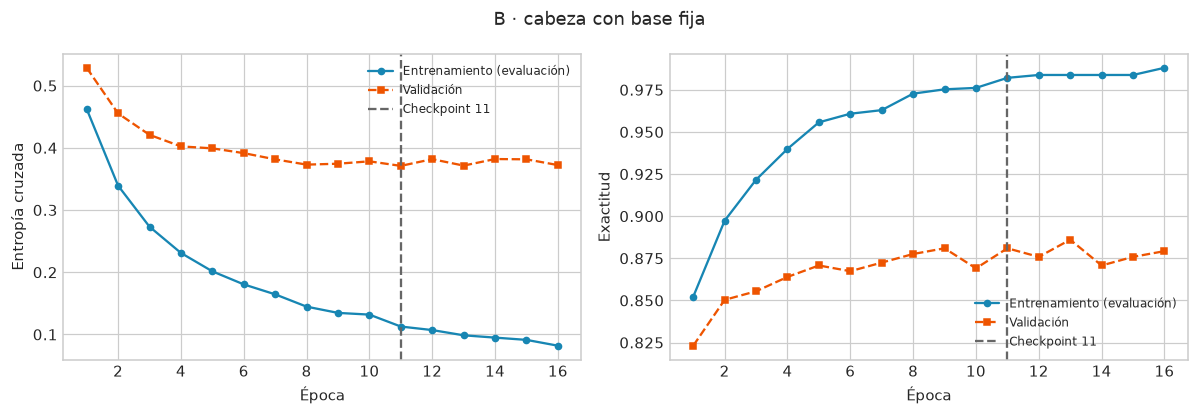
Figura 15.3: Evolución de B: cabeza con base fija
Mejor época: 11 · épocas ejecutadas: 16 de 30 · ¿la mejor quedó en el límite?: no
B alcanza su menor CE de validación en la época 11, con 0.3710, y se detiene en la 16 porque pasan cinco épocas seguidas sin mejora. A necesitó 19 épocas para llegar a 0.6841. En este ensayo, reutilizar la base ayuda mucho: B consigue una pérdida mucho menor y tarda 17 segundos en total, incluida la extracción de características, frente a 835 segundos de A. Recuerda que cambió también la arquitectura; estas cifras no cuantifican por separado el efecto del preentrenamiento.
15.11 Estrategia C: adaptar los últimos bloques
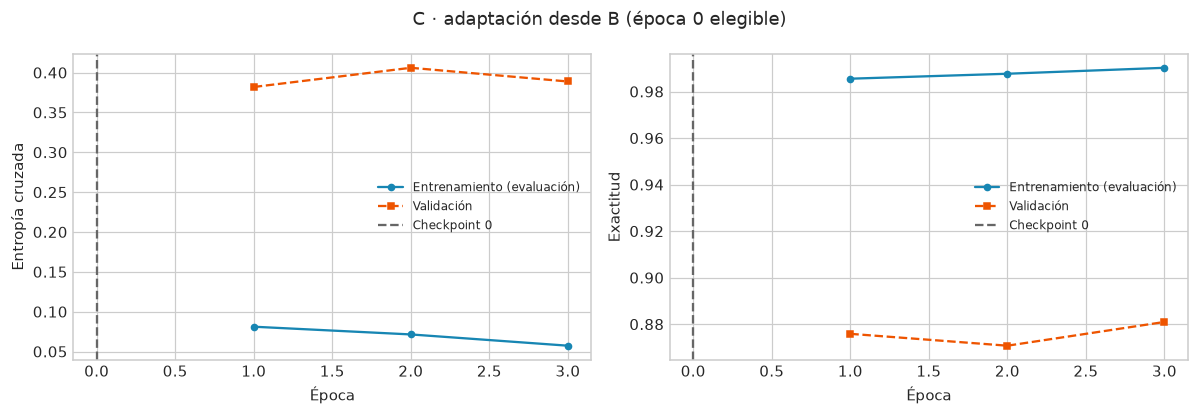
La tercera pregunta es: ¿mejora B si permitimos que parte de su base se adapte a las flores? C comienza con la mejor versión de B, incluida su cabeza. Abre los tres últimos bloques de features y sigue ajustando la cabeza. Los primeros bloques conservan los pesos que tenía la mejor versión de B.
Una analogía es retocar los últimos pasos de una receta que ya funciona para un ingrediente nuevo, conservando su preparación inicial. En la red, la decisión concreta consiste en habilitar gradientes solo en los parámetros elegidos. Aquí mantenemos BatchNorm en evaluación y sus parámetros fijos, incluso dentro de los bloques abiertos.
Usamos una tasa de 0.00001, menor que la de A y B, para limitar el tamaño de los cambios. Creamos un optimizador Adam nuevo para los parámetros habilitados. El máximo es seis épocas, con paciencia 3. La utilidad de esa tasa se comprueba comparando la CE de validación con la obtenida por B.
La versión inicial de B cuenta como época 0 de C. Si ninguna actualización reduce su CE de validación, C conserva B. Establecemos esa regla antes de abrir la prueba. El código imprime qué parámetros se habilitaron y verifica que ningún otro peso ni estadística se modificó.
# Parte de B; habilita los últimos bloques y conserva las estadísticas de BatchNorm.c_model = copy.deepcopy(b)for p in c_model.parameters(): p.requires_grad =Falseindices_abiertos =list(range(len(c_model.features) -3, len(c_model.features)))for j in indices_abiertos:for p in c_model.features[j].parameters(): p.requires_grad =Truefor p in c_model.classifier.parameters(): p.requires_grad =Truefor mod in c_model.modules():ifisinstance(mod, nn.modules.batchnorm._BatchNorm): mod.eval()for p in mod.parameters(): p.requires_grad =Falsedef fijar_bn(m):for mod in m.modules():ifisinstance(mod, nn.modules.batchnorm._BatchNorm): mod.eval()nombres_entrenables = [n for n, p in c_model.named_parameters() if p.requires_grad]antes = {k: v.cpu().clone() for k, v in c_model.state_dict().items()}print('Bloques abiertos:', indices_abiertos)print('Parámetros habilitados:', nombres_entrenables)MAX_EPOCAS_C =6hc, rc = apoyo.entrenar(c_model, trm, vlm, MAX_EPOCAS_C, lote=32, lr=1e-05, paciencia=3, nombre='C-ajuste-fino', modo_train=fijar_bn, incluir_inicial=True)permitidos =set(nombres_entrenables)cambiados = [k for k, v in c_model.state_dict().items() ifnot torch.equal(v.cpu(), antes[k])]assertall((k in permitidos for k in cambiados)), 'Cambió un parámetro o buffer congelado'assertall((not m.training for m in c_model.modules() ifisinstance(m, nn.modules.batchnorm._BatchNorm)))print('Cambios del checkpoint:', len(cambiados), '· sólo parámetros habilitados; BN intacta')rc['segundos_fase_C'] = rc['segundos']rc['segundos'] += rb['segundos']apoyo.curvas(hc, 'C · adaptación desde B (época 0 elegible)', rc['mejor_epoca'])print(f"Mejor época: {rc['mejor_epoca']} (0 = punto de partida B) · épocas ejecutadas: {len(hc)} de {MAX_EPOCAS_C} · "f"¿la mejor quedó en el límite?: {'sí'if rc['mejor_epoca'] == MAX_EPOCAS_C else'no'}")_ = (ARTEFACTOS /'configuracion-congelacion.json').write_text(json.dumps({'B_base_intacta': True, 'C_bloques': indices_abiertos, 'C_entrenables': nombres_entrenables, 'C_cambiados_checkpoint': cambiados, 'BN_buffers_intactos': True, 'descarga_construccion_s': descarga_construccion_s}, indent=2), encoding='utf-8')
Bloques abiertos: [16, 17, 18]
Parámetros habilitados: ['features.16.conv.0.0.weight', 'features.16.conv.1.0.weight', 'features.16.conv.2.weight', 'features.17.conv.0.0.weight', 'features.17.conv.1.0.weight', 'features.17.conv.2.weight', 'features.18.0.weight', 'classifier.1.weight', 'classifier.1.bias']
C-ajuste-fino 1/6: CE val=0.3819, acc val=0.8759
C-ajuste-fino 2/6: CE val=0.4060, acc val=0.8707
C-ajuste-fino 3/6: CE val=0.3888, acc val=0.8810
Cambios del checkpoint: 0 · sólo parámetros habilitados; BN intacta
Figura 15.4: Evolución de C: ajuste fino desde B
Mejor época: 0 (0 = punto de partida B) · épocas ejecutadas: 3 de 6 · ¿la mejor quedó en el límite?: no
En esta ejecución, ninguna época de C mejoró a B. La CE de validación fue 0.3819, 0.4060 y 0.3888, siempre por encima del 0.3710 de partida, y el entrenamiento se detuvo en la época 3 por la paciencia. Según la regla fijada, C conserva su época 0, que es el mismo modelo B.
Mira la curva de entrenamiento de C: su CE baja hasta cerca de 0.06 mientras la de validación no mejora. Al abrir 1 201 285 parámetros para 2348 imágenes, la red se ajusta cada vez mejor a las fotos que ya conoce sin ganar en las nuevas, que es la señal de sobreajuste que viste antes. Este resultado no prueba que el ajuste fino nunca ayude: con otra tasa de aprendizaje, más imágenes o menos bloques abiertos podría cambiar.
15.12 Elegir una estrategia antes de abrir prueba
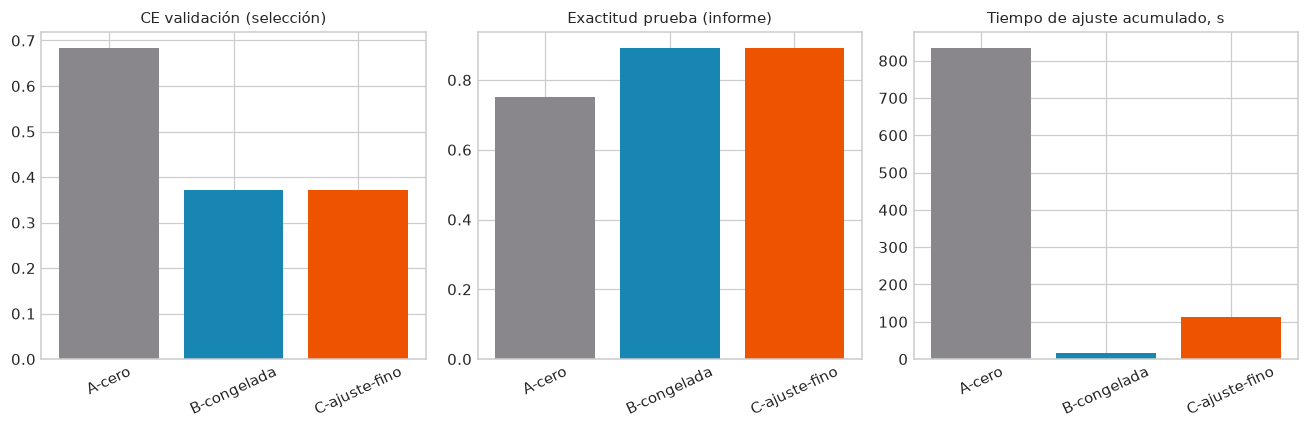
La selección utiliza la menor CE de validación. En caso de empate entre B y una C que conserva su época 0, se mantiene B para evitar una fase adicional sin mejora. Después se informa el resultado en las 734 fotos reservadas. No cambiamos la selección si otra estrategia acierta más en prueba.
La tabla compara CE de validación, exactitud de prueba, macro F1, parámetros y tiempo. El macro F1 promedia el F1 de las cinco clases dando el mismo peso a cada una; el F1 y las demás métricas por clase se explican en evaluación de modelos. Los parámetros totales pertenecen a toda la red; los entrenables son los que permitimos ajustar. El tiempo de B incluye extraer características y entrenar su cabeza. El de C incluye obtener B y realizar su adaptación. Los tiempos incluyen las evaluaciones al cerrar cada época. No se incluyen descargas, preparación inicial ni evaluación de prueba; tampoco es una medida de cuánto tarda una predicción individual.
# Elige por validación antes de calcular las métricas finales de prueba.modelos = {'A-cero': a, 'B-congelada': b, 'C-ajuste-fino': c_model}resumenes = {'A-cero': ra, 'B-congelada': rb, 'C-ajuste-fino': rc}ganador =min(resumenes, key=lambda k: resumenes[k]['ce_val'])print('Elegido con validación, antes de mirar la prueba:', ganador)resultados = {}filas = []for nombre, m in modelos.items(): rr = apoyo.evaluar(m, tea if nombre =='A-cero'else tem, lote=32) resultados[nombre] = rr filas.append({**resumenes[nombre], 'ce_test': rr['ce'], 'acc_test': rr['exactitud'], 'macro_f1': f1_score(rr['y'], rr['logits'].argmax(1), average='macro')})tabla = pd.DataFrame(filas)display(tabla)tabla.to_csv(ARTEFACTOS /'comparacion.csv', index=False)fig, axes = plt.subplots(1, 3, figsize=(12, 4))for ax, col, t inzip(axes, ['ce_val', 'acc_test', 'segundos'], ['CE validación (selección)', 'Exactitud prueba (informe)', 'Tiempo de ajuste acumulado, s']): ax.bar(tabla.modelo, tabla[col], color=['#89878C', '#1786B3', '#EE5400']) ax.set_title(t, fontsize=10) ax.tick_params(axis='x', rotation=25)fig.tight_layout()plt.show()clase_mayoritaria = np.bincount(yf[itr]).argmax()referencia_mayoritaria = np.mean(yf[ite] == clase_mayoritaria)print(f'Referencia mayoritaria ({clases[clase_mayoritaria]}): {referencia_mayoritaria:.2%}')
Elegido con validación, antes de mirar la prueba: B-congelada
Referencia mayoritaria (dandelion): 24.39%
modelo
mejor_epoca
epocas
ce_val
segundos
parametros
entrenables
ce_test
acc_test
macro_f1
segundos_cabeza
extraccion_s
segundos_fase_C
0
A-cero
19
20
0.684078
834.672442
65285
65285
0.692138
0.752044
0.746609
NaN
NaN
NaN
1
B-congelada
11
16
0.370983
17.160122
2230277
6405
0.316383
0.892371
0.890929
2.242457
14.917664
NaN
2
C-ajuste-fino
0
3
0.370983
111.974555
2230277
1201285
0.316383
0.892371
0.890929
NaN
NaN
94.814434
(a) Comparación de estrategias bajo el presupuesto fijado
(b)
Figura 15.5
La regla eligió B-congelada. B y C empatan en 0.3710 porque C conservó su punto de partida, y ante un empate se mantiene B. Las exactitudes de prueba fueron 75.20 % para A y 89.24 % para B; C da exactamente lo mismo que B porque es el mismo modelo. Son resultados de esta partición y estos presupuestos. Como referencia, adivinar al azar entre cinco clases acierta en promedio el 20 %, y elegir siempre la clase más frecuente (dandelion) acierta el 24.39 %, como muestra la salida.
El tiempo también cuenta en la decisión: B necesitó 17 segundos de ajuste, C sumó 112 (los de B más su propia fase) y A, 835. Una sola ejecución no demuestra que B supere siempre a C ni que la ventaja sobre A tenga exactamente este tamaño. Para una decisión posterior podrías repetir con otras semillas dentro del desarrollo y reservar una evaluación nueva.
15.13 Mirar qué flores se confunden
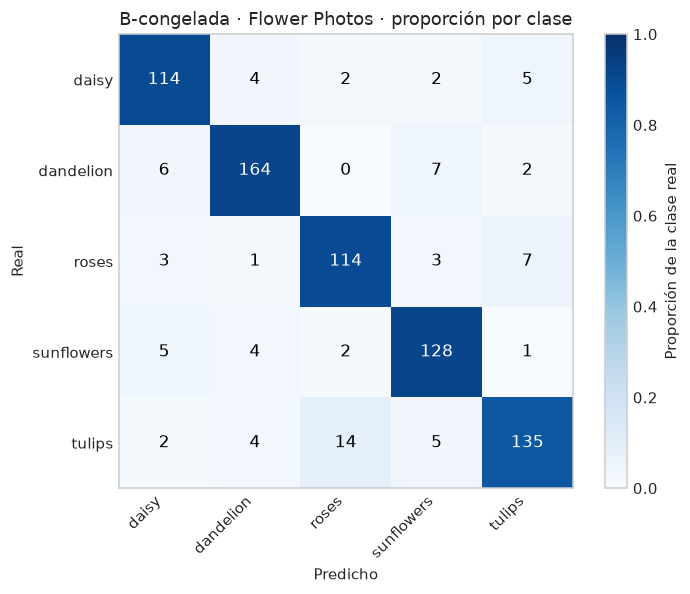
Además del total de aciertos, examina las filas de la matriz: cada fila corresponde a una flor real y sus columnas a las categorías predichas. Una celda fuera de la diagonal cuenta una confusión. Las cifras escritas permiten leerla sin depender solo del color.
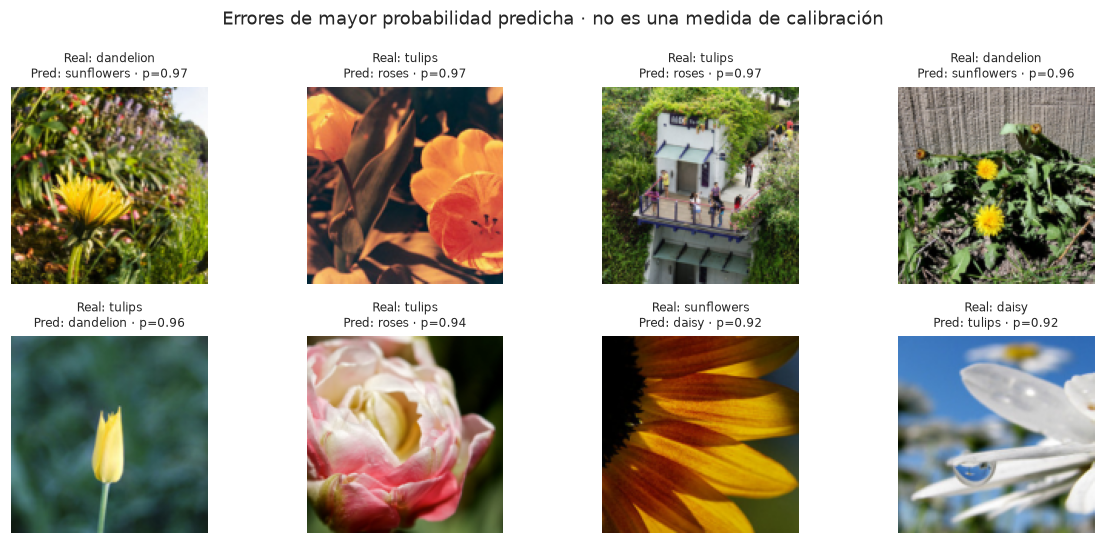
La galería siguiente muestra errores con probabilidades predichas altas. Una probabilidad alta expresa confianza del modelo, pero no demuestra que esa confianza esté bien ajustada a la frecuencia de aciertos; esa correspondencia se llama calibración.
# Examina los errores del modelo ya elegido; no cambies la elección con esta salida.seleccionado = resultados[ganador]matriz = apoyo.diagnostico(seleccionado, clases, imagenes[ite].astype(np.float32) /255, ganador +' · Flower Photos')
(a) Errores de la estrategia elegida por validación
(b)
Figura 15.6
El modelo elegido cometió 79 errores en las 734 imágenes de prueba. La clase con menor sensibilidad fue tulips, con 84.38 %: de 160 tulipanes reales reconoció 135. La confusión más frecuente fue tulips → roses (14 casos); ninguna otra celda fuera de la diagonal pasa de 7. Describe qué observas en las imágenes, pero evita atribuir el error a fondo, color o etiqueta sin investigarlo. Estas fotos ayudan a formular hipótesis, no a volver a seleccionar con prueba.
15.14 Qué cambia al continuar desde B
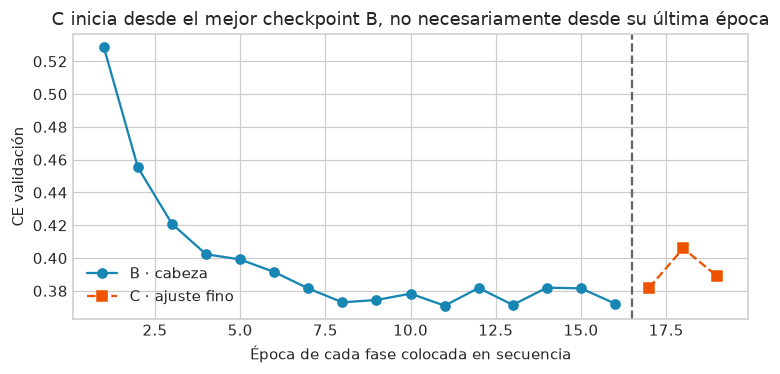
El siguiente gráfico coloca las épocas de B y C en secuencia para seguir el recorrido. C empieza desde la mejor versión de B, no necesariamente desde su última época. La línea vertical marca el cambio de fase; el estilo de línea identifica cada fase además del color.
# Coloca ambas fases en secuencia para comparar sus pérdidas de validación.fig, ax = plt.subplots(figsize=(7, 3.5))ax.plot(hb.epoca, hb.ce_val, '-o', color='#1786B3', label='B · cabeza')ax.plot(len(hb) + hc.epoca, hc.ce_val, '--s', color='#EE5400', label='C · ajuste fino')ax.axvline(len(hb) +0.5, color='.4', ls='--')ax.set(xlabel='Época de cada fase colocada en secuencia', ylabel='CE validación', title='C inicia desde el mejor checkpoint B, no necesariamente desde su última época')ax.legend()fig.tight_layout()plt.show()
Figura 15.7: Continuación de B hacia el ajuste fino
B llega a su mínimo de 0.3710 en la época 11 y se mantiene cerca de ese valor hasta la 16. Las tres épocas de C quedan por encima (0.3819, 0.4060 y 0.3888): en este ensayo, abrir los últimos bloques no mejoró la validación. Las dos fases usan las mismas 588 imágenes de validación y el mismo criterio.
15.15 Guardar lo aprendido y volver a usarlo
NotaMetadatos
Metadatos. Información que acompaña al estado del modelo (el state_dict que viste en el Apéndice A): arquitectura, orden de las clases y preparación de la entrada. En esta red, el estado incluye también las estadísticas de BatchNorm.
Para reutilizar la red debes conservar sus pesos y saber cómo interpretar una imagen y una salida. Guarda el orden de las cinco clases, tamaño, canales, normalización y arquitectura. De lo contrario, podrías cargar los números correctos y preparar mal la fotografía o asignar la puntuación a la flor equivocada.
La celda guarda la estrategia seleccionada, crea una red con la misma estructura y recarga su estado. En las transferidas usa weights=None: el archivo guardado ya contiene la base, por lo que no necesita descargar sus pesos otra vez. Comprueba en validación que las puntuaciones antes y después de guardar coinciden.
# Guarda el estado y los metadatos; comprueba la recarga con validación.def crear_transfer_sin_descarga(): m = models.mobilenet_v2(weights=None) m.classifier = nn.Sequential(nn.Dropout(0.2), nn.Linear(1280, 5))return mmetadatos_finales =dict(preparacion, estrategia=ganador)if ganador =='A-cero': metadatos_finales.update(pesos='desde cero', media=None, desviacion=None, escala='uint8 /255')recargado = apoyo.guardar(modelos[ganador], crear_cero if ganador =='A-cero'else crear_transfer_sin_descarga, 'flowers-seleccionado', metadatos_finales, vla if ganador =='A-cero'else vlm)
La comprobación de flowers-seleccionado.pt confirma que las puntuaciones de validación coinciden antes y después de recargar el estado guardado. Este archivo no contiene todo lo necesario para reanudar exactamente la optimización: para eso también guardarías el estado del optimizador y otra información de la ejecución. Usar para predecir y reanudar entrenamiento son objetivos diferentes.
15.16 Ejercicios para comprobar que entendiste
Explica, sin código, qué se conserva y qué cambia en B. ¿Por qué la cabeza tiene cinco salidas?
Localiza las líneas de requires_grad y features.eval(). Explica por qué una no sustituye a la otra.
En esta ejecución, ninguna época de C mejoró la CE de validación de B. ¿Qué modelo se conserva y por qué? Si una época de C hubiera acertado más imágenes de prueba, ¿podrías elegirla?
Compara parámetros entrenables y totales de B. ¿Qué componentes necesitas para clasificar una foto nueva?
Diseña un experimento que aísle mejor el efecto del preentrenamiento. Indica qué mantendrías igual y qué datos usarías para elegir.
Propón una ampliación con otra tasa de ajuste fino. Escribe antes qué compararás, con qué conjunto decidirás y qué evaluación nueva necesitarías si ya examinaste esta prueba.
15.16.1 Orientaciones
Se conserva la base y se ajusta una cabeza nueva. Hay cinco salidas porque las etiquetas nuevas tienen cinco categorías.
requires_grad=False impide ajustar parámetros con gradientes. eval() controla comportamientos como la actualización de estadísticas de BatchNorm. En B necesitamos ambas decisiones para conservar la base.
Conservarías B, la época 0 elegible para C, bajo la regla definida. Mirar la prueba para cambiar esa decisión la convierte en parte de la selección.
Necesitas base y cabeza, aunque solo hayas entrenado la cabeza. Congelar no elimina el costo de procesar cada imagen con la base.
Compara la misma arquitectura con inicialización nueva y con pesos anteriores. Mantén particiones y preparación compatibles, y declara presupuesto y selección en validación. La comparación original con una CNN pequeña responde otra pregunta.
Elige con validación dentro del desarrollo. Si el nuevo estudio se originó tras inspeccionar los errores de esta prueba, necesita una evaluación independiente para un informe final nuevo.
15.17 Glosario de consulta
Término
Significado en este capítulo
Transferencia de aprendizaje
Reutilizar lo aprendido antes como punto de partida de una tarea nueva.
Red preentrenada y preentrenamiento
Red cuyos pesos ya se ajustaron en otra tarea, y ese entrenamiento anterior.
ImageNet
Conjunto de imágenes de categorías diversas con el que se aprendieron los pesos elegidos.
MobileNetV2
Arquitectura convolucional utilizada como base preentrenada.
Arquitectura, capa y bloque
Organización de la red, cada transformación que la integra y un grupo de capas.
Característica
Representación numérica de la imagen construida por la red.
Base y cabeza
Partes que extraen características y que producen las puntuaciones de las clases.
Entrenar desde cero
Ajustar una red sin reutilizar pesos de otra tarea.
Congelar
Mantener fijos parámetros; aquí también las estadísticas de BatchNorm de la base.
Ajuste fino
Continuar el entrenamiento de parte de una red preentrenada para adaptarla.
Normalización de ImageNet
Cambio de escala con las medias y desviaciones con que se entrenaron los pesos.
BatchNorm
Capa de normalización con parámetros y estadísticas que deben tratarse por separado.
Modo de entrenamiento y de evaluación
train() y eval(): cambian el comportamiento de capas como dropout y BatchNorm.
Caché
Copia temporal que evita repetir una preparación o un cálculo cuyo resultado no cambia.
Calibración
Correspondencia entre la confianza predicha y la frecuencia observada de aciertos.
Metadatos
Información para preparar las entradas e interpretar las salidas del modelo guardado.
Los términos generales (tensor, lote, época, pérdida, gradiente, optimizador, logits, métricas…) están en el cuadro «Lo que necesitas recordar» del inicio, con el enlace al capítulo donde se explica cada uno, y en el glosario del Apéndice A.
15.18 Qué aprendiste y cómo continúa el libro
Transferir aprendizaje significa empezar con pesos anteriores y comprobar si ayudan en una tarea nueva. En las flores, B conserva la base y aprende la cabeza; C parte de B y adapta solo los últimos bloques. Las tres estrategias comparten particiones y geometría de entrada, pero A no usa la misma arquitectura que B y C.
El resultado de referencia eligió B-congelada por validación: el ajuste fino de C no mejoró su punto de partida. Sus cifras describen este experimento; no sustituyen evaluar nuevos contextos. Conservar una base requiere controlar tanto sus parámetros como sus estadísticas, y reutilizar una red exige guardar también cómo preparar las imágenes y leer las clases.
En evaluación y robustez en visión, la pregunta será qué ocurre cuando cambian las condiciones de las imágenes y qué errores conserva un modelo que aquí parece funcionar bien.
15.19 El código de apoyo completo
Este es el contenido de apoyo_transferencia.py, el archivo que el notebook importa al comenzar. No necesitas leerlo para seguir el capítulo; está aquí para quien quiera ver por dentro cada apoyo.…. Cada función empieza con una explicación de qué hace, qué recibe y qué devuelve, y el bucle de entrenar() numera los mismos cinco pasos del Apéndice A.
TipVer el código de apoyo_transferencia.py
"""Funciones de apoyo del capítulo «Transferencia de aprendizaje y ajuste fino».El notebook del capítulo importa este archivo con ``import apoyo_transferencia as apoyo``.Aquí está el código largo o repetitivo (el bucle de entrenamiento, la evaluación, lasgráficas, el diagnóstico de errores y el guardado), para que el notebook muestre solo lasdecisiones del experimento: qué red se usa, qué se congela, cuántas épocas y cómo se elige.Funciones:- ``parametros``: cuenta los parámetros de un modelo.- ``inicializar``: da valores iniciales a los pesos de una red nueva.- ``conjunto``: convierte arreglos de NumPy en un conjunto de datos de PyTorch.- ``cargador``: entrega un conjunto de datos por lotes.- ``evaluar``: calcula pérdida, exactitud y probabilidades sobre un conjunto.- ``entrenar``: entrena un modelo y conserva la versión con menor pérdida de validación.- ``curvas``: dibuja la pérdida y la exactitud por época.- ``diagnostico``: informe por clase, matriz de confusión y galería de errores.- ``guardar``: guarda el modelo con sus metadatos y comprueba que se recarga igual.Las tres variables globales (``SEMILLA``, ``DEVICE`` y ``ARTEFACTOS``) tienen un valor pordefecto, pero el notebook las reemplaza al comenzar para que todo el capítulo use la mismasemilla, el mismo dispositivo y la misma carpeta de resultados.Si modificas este archivo con el notebook abierto, reinicia el kernel antes de volver aejecutar: Python conserva en memoria la versión que importó la primera vez."""from pathlib import Pathimport json, time, copy, hashlib, platform, gzip, struct, urllib.requestimport numpy as npimport pandas as pdimport sklearnfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import classification_report, confusion_matrix, f1_scoreimport matplotlib.pyplot as pltfrom PIL import Imageimport torchfrom torch import nnfrom torch.nn import functional as Ffrom torch.utils.data import DataLoader, TensorDataset, Dataset# Valores por defecto; el notebook los reemplaza en su primera celda.SEMILLA =42# semilla para el orden de los lotesDEVICE = torch.device('cuda'if torch.cuda.is_available() else'cpu') # GPU si existe; si no, CPUARTEFACTOS = Path('artefactos_pytorch') # carpeta donde se guardan resultadosdef parametros(modelo):"""Cuenta todos los parámetros de un modelo (entrenables y congelados). Ejemplo: una capa ``nn.Linear(1280, 5)`` tiene 1280 × 5 pesos + 5 sesgos = 6405. """returnsum(p.numel() for p in modelo.parameters())def inicializar(modelo):"""Da valores iniciales a los pesos de una red nueva y la mueve al dispositivo. Se usa solo en la estrategia A, la red que aprende desde cero. - Capas convolucionales y lineales: inicialización de He (``kaiming_normal_``), pensada para capas seguidas de ReLU. Los sesgos empiezan en cero. - Última capa lineal (la que produce las puntuaciones de las clases): se reinicializa con Xavier (``xavier_uniform_``), porque no la sigue una ReLU. Devuelve el mismo modelo, ya en ``DEVICE``. """for m in modelo.modules():ifisinstance(m, (nn.Conv2d, nn.Linear)): nn.init.kaiming_normal_(m.weight, nonlinearity='relu')if m.bias isnotNone: nn.init.zeros_(m.bias) lineales = [m for m in modelo.modules() ifisinstance(m, nn.Linear)]if lineales: nn.init.xavier_uniform_(lineales[-1].weight)return modelo.to(DEVICE)def conjunto(x, y):"""Convierte imágenes ``x`` y etiquetas ``y`` de NumPy en un ``TensorDataset``. Las imágenes quedan como ``float32`` y las etiquetas como enteros ``long``, que es lo que espera la entropía cruzada de PyTorch. """return TensorDataset(torch.as_tensor(np.ascontiguousarray(x), dtype=torch.float32), torch.as_tensor(np.asarray(y), dtype=torch.long))def cargador(ds, lote=128, mezclar=False):"""Entrega el conjunto ``ds`` en lotes de ``lote`` filas. Con ``mezclar=True`` el orden cambia en cada época (se usa al entrenar). El generador con ``SEMILLA`` hace que ese orden sea el mismo en cada ejecución. """return DataLoader(ds, batch_size=lote, shuffle=mezclar, num_workers=0, generator=torch.Generator().manual_seed(SEMILLA))@torch.inference_mode()def evaluar(modelo, ds, lote=128):"""Mide un modelo sobre un conjunto sin modificar sus pesos. Pone el modelo en modo de evaluación (``eval()``) y no construye el cálculo de gradientes (``inference_mode``). Devuelve un diccionario con: - ``ce``: entropía cruzada media (menor es mejor). - ``exactitud``: proporción de imágenes clasificadas correctamente. - ``logits``: puntuaciones de salida, una fila por imagen y una columna por clase. - ``y``: etiquetas reales. - ``probabilidades``: los logits convertidos con softmax (cada fila suma 1). """ modelo.eval() perdidas =0. aciertos =0 logits = [] etiquetas = []for x, y in cargador(ds, lote): x = x.to(DEVICE) y = y.to(DEVICE) z = modelo(x)# Suma (no media) para poder dividir al final por el total de imágenes. perdidas += F.cross_entropy(z, y, reduction='sum').item() aciertos += (z.argmax(1) == y).sum().item() logits.append(z.cpu()) etiquetas.append(y.cpu()) z = torch.cat(logits) y = torch.cat(etiquetas)assert torch.isfinite(z).all(), 'Logits no finitos'return {'ce': perdidas /len(ds), 'exactitud': aciertos /len(ds),'logits': z.numpy(), 'y': y.numpy(), 'probabilidades': z.softmax(1).numpy()}def entrenar(modelo, train, val, epocas, lote=128, lr=1e-3, paciencia=None, nombre='modelo', modo_train=None, incluir_inicial=False):"""Entrena ``modelo`` y le deja cargada la versión con menor pérdida de validación. Parámetros: - ``train``, ``val``: conjuntos de entrenamiento y de validación. La prueba nunca entra aquí. - ``epocas``: número máximo de épocas. - ``lote``: imágenes por lote. - ``lr``: tasa de aprendizaje del optimizador Adam. - ``paciencia``: si la pérdida de validación no mejora durante este número de épocas seguidas, el entrenamiento se detiene antes del máximo. ``None`` la desactiva. - ``nombre``: nombre de la estrategia; se usa en los mensajes y en los archivos. - ``modo_train``: función opcional que se aplica al modelo después de ``train()``. En la estrategia C mantiene BatchNorm en modo de evaluación. - ``incluir_inicial``: si es ``True``, el modelo de partida cuenta como «época 0» y puede resultar elegido si ninguna época lo mejora (se usa en C, que parte de B). En cada época ejecuta el bucle de cinco pasos del Apéndice A (borrar gradientes, predecir, medir la pérdida, calcular gradientes y corregir) sobre todos los lotes. Al cerrar la época mide entrenamiento y validación en modo de evaluación, para que las dos curvas sean comparables. Guarda el historial en ``<nombre>-historial.csv`` y un resumen en ``<nombre>-entrenamiento.json``. Devuelve ``(historial, resumen)``: el historial es una tabla con una fila por época; el resumen incluye la mejor época, su pérdida de validación, el tiempo y los parámetros totales y entrenables. """# El optimizador se crea después de decidir qué parámetros se entrenan# (requires_grad): solo recibe esos. optimizador = torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad], lr=lr) dl = cargador(train, lote, True) historial = [] mejor =float('inf') # menor pérdida de validación vista hasta ahora pesos =None# copia del estado del modelo en esa mejor época espera =0# épocas seguidas sin mejorar (para la paciencia) inicio = time.perf_counter() epoca_mejor =Noneif incluir_inicial: inicial = evaluar(modelo, val, lote) mejor = inicial['ce'] pesos = copy.deepcopy(modelo.state_dict()) epoca_mejor =0for epoca inrange(1, epocas +1): modelo.train()if modo_train isnotNone: modo_train(modelo) suma =0. aciertos =0for x, y in dl: x = x.to(DEVICE) y = y.to(DEVICE) optimizador.zero_grad(set_to_none=True) # 1. borrar gradientes anteriores z = modelo(x) # 2. predecir (logits) perdida = F.cross_entropy(z, y) # 3. medir el errorifnot torch.isfinite(perdida):raiseFloatingPointError(nombre +' pérdida no finita') perdida.backward() # 4. calcular gradientes optimizador.step() # 5. corregir los parámetros suma += perdida.item() *len(y) aciertos += (z.argmax(1) == y).sum().item()# Medir entrenamiento y validación en el MISMO modo (eval) al cierre de la época. tr = evaluar(modelo, train, lote) va = evaluar(modelo, val, lote) historial.append({'epoca': epoca, 'ce_online': suma /len(train),'acc_online': aciertos /len(train), 'ce_train': tr['ce'], 'ce_val': va['ce'],'acc_train': tr['exactitud'], 'acc_val': va['exactitud']})if va['ce'] < mejor:# Nueva mejor versión: se guarda una copia y se reinicia la cuenta de paciencia. mejor = va['ce'] pesos = copy.deepcopy(modelo.state_dict()) epoca_mejor = epoca espera =0else: espera +=1print(f"{nombre}{epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}", flush=True)if paciencia isnotNoneand espera >= paciencia:break# Al terminar, el modelo vuelve a la mejor versión, no a la última época. modelo.load_state_dict(pesos) modelo.eval() h = pd.DataFrame(historial) h.to_csv(ARTEFACTOS /f'{nombre}-historial.csv', index=False) resumen = {'modelo': nombre, 'mejor_epoca': epoca_mejor, 'epocas': len(h), 'ce_val': mejor,'segundos': time.perf_counter() - inicio, 'parametros': parametros(modelo),'entrenables': sum(p.numel() for p in modelo.parameters() if p.requires_grad)} (ARTEFACTOS /f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen, indent=2), encoding='utf-8')return h, resumendef curvas(h, titulo, mejor=None):"""Dibuja dos gráficas por época: pérdida (entropía cruzada) y exactitud. ``h`` es el historial que devuelve ``entrenar``. Entrenamiento se dibuja con línea continua y círculos; validación, con línea discontinua y cuadrados, para que se distingan también sin color. Si se indica ``mejor``, una línea vertical marca la época elegida. """ fig, axes = plt.subplots(1, 2, figsize=(11, 3.8))for ax, a, b, t in [(axes[0], 'ce_train', 'ce_val', 'Entropía cruzada'), (axes[1], 'acc_train', 'acc_val', 'Exactitud')]: ax.plot(h.epoca, h[a], '-o', color='#1786B3', label='Entrenamiento (evaluación)', ms=4) ax.plot(h.epoca, h[b], '--s', color='#EE5400', label='Validación', ms=4)if mejor isnotNone: ax.axvline(mejor, color='.4', ls='--', label=f'Checkpoint {mejor}') ax.set(xlabel='Época', ylabel=t) ax.legend(fontsize=8) fig.suptitle(titulo) fig.tight_layout() plt.show()def diagnostico(resultado, nombres, imagenes=None, titulo='Prueba'):"""Muestra en qué se equivoca un modelo ya elegido. ``resultado`` es lo que devuelve ``evaluar``; ``nombres``, la lista de clases. Imprime precisión, sensibilidad (recall) y F1 por clase, y dibuja la matriz de confusión: cada fila es la clase real y cada columna la predicha; el número de cada celda es la cantidad de imágenes y el color, la proporción dentro de la fila. Si se pasan ``imagenes``, muestra además los ocho errores con mayor probabilidad predicha. Devuelve la matriz de confusión. Sirve para analizar errores; no debe usarse para volver a elegir la estrategia. """ y = resultado['y'] p = resultado['probabilidades'] pred = p.argmax(1) k =len(nombres)print(classification_report(y, pred, labels=np.arange(k), target_names=nombres, digits=4, zero_division=0)) cm = confusion_matrix(y, pred, labels=np.arange(k)) normal = cm / np.maximum(cm.sum(1, keepdims=True), 1) # proporción por fila (clase real) fig, ax = plt.subplots(figsize=(7, 5.5)) im = ax.imshow(normal, vmin=0, vmax=1, cmap='Blues') ax.set_xticks(range(k), nombres, rotation=45, ha='right', fontsize=10) ax.set_yticks(range(k), nombres, fontsize=10) ax.set(xlabel='Predicho', ylabel='Real', title=titulo +' · proporción por clase')for i inrange(k):for j inrange(k): ax.text(j, i, str(cm[i, j]), ha='center', va='center', fontsize=11, color='white'if normal[i, j] >.5else'black') ax.grid(False) fig.colorbar(im, ax=ax, label='Proporción de la clase real') fig.tight_layout() plt.show() err = np.flatnonzero(y != pred) # posiciones de las imágenes mal clasificadasif imagenes isnotNoneandlen(err): confianza = p.max(1) orden = err[np.argsort(-confianza[err])][:8] # los 8 errores más «seguros» fig, axes = plt.subplots(2, 4, figsize=(11, 5))for ax, idx inzip(axes.flat, orden): img = np.asarray(imagenes[idx])# Las imágenes vienen como (canales, alto, ancho); matplotlib espera (alto, ancho, canales). img = np.moveaxis(img, 0, -1) if img.ndim ==3and img.shape[0] in [1, 3] else img ax.imshow(img.squeeze(), cmap='gray'if img.squeeze().ndim ==2elseNone) ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}', fontsize=8) ax.axis('off')for ax inlist(axes.flat)[len(orden):]: ax.axis('off') fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración') fig.tight_layout() plt.show()return cmdef guardar(modelo, fabrica, nombre, metadatos, val):"""Guarda el modelo elegido y comprueba que se puede volver a cargar. - ``fabrica``: función sin argumentos que crea una red vacía con la misma estructura; se usa para recargar el archivo. - ``metadatos``: información para usar el modelo después (clases, tamaño de la imagen, normalización, arquitectura). - ``val``: conjunto de validación con el que se comprueba la recarga. Crea ``<nombre>.pt`` con el estado del modelo y los metadatos, lo recarga en una red nueva y verifica que ambas dan las mismas puntuaciones en un lote de validación. Después escribe ``<nombre>-metadatos.json`` con los metadatos, la huella SHA-256 y el tamaño del archivo. Devuelve el modelo recargado. """ ruta = ARTEFACTOS /f'{nombre}.pt' estado = {k: v.detach().cpu().clone() for k, v in modelo.state_dict().items()} torch.save({'state_dict': estado, 'metadatos': metadatos, 'torch': str(torch.__version__)}, ruta) cargado = fabrica().to(DEVICE) paquete = torch.load(ruta, map_location=DEVICE, weights_only=True) cargado.load_state_dict(paquete['state_dict']) cargado.eval()# Comprobar la recarga con validación; la prueba nunca se usa para elegir. muestra =next(iter(cargador(val, 32)))[0].to(DEVICE) modelo.eval()with torch.inference_mode(): torch.testing.assert_close(modelo(muestra), cargado(muestra), rtol=1e-5, atol=1e-6) metadatos =dict(metadatos, sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(), bytes=ruta.stat().st_size) (ARTEFACTOS /f'{nombre}-metadatos.json').write_text(json.dumps(metadatos, indent=2, ensure_ascii=False), encoding='utf-8')print('Recarga verificada:', ruta, 'bytes:', ruta.stat().st_size)return cargado
TensorFlow Datasets. tf_flowers. Descripción del conjunto. Las atribuciones originales por fotografía se conservan en el archivo enlazado junto a los datos.