Una nube de puntos puede ser fácil de separar y, sin embargo, parecer complicada en una proyección. Una exactitud alta puede ocultar que el modelo ignora la clase minoritaria. Una curva suave puede fallar cuando cambia el nivel de una serie. Para estudiar estas situaciones conviene construir datos cuyo mecanismo conozcamos.
Los datos sintéticos permiten cambiar una condición y observar sus consecuencias. Aquí construirás problemas de clasificación, regresión, series temporales e imágenes; también aprenderás a interpretar sus resultados. Los ejemplos sirven tanto para métodos clásicos de machine learning como para redes neuronales. La elección del modelo dependerá de la estructura del problema y de la evidencia de validación.
Necesitas manejar arreglos de NumPy, tablas de pandas y la separación entre entrenamiento, validación y prueba. Si quieres revisar primero los tipos de datos y sus formatos, consulta Datasets. Las formas de los tensores se desarrollan en Tensores y autodiferenciación.
Para interpretar los ejemplos: entrenamiento ajusta; validación selecciona; prueba evalúa la decisión fijada. Exactitud es fracción de aciertos; recall mide qué fracción de positivos se recupera. Las definiciones completas están en Evaluación; no es necesario adelantar todo ese capítulo para seguir el experimento.
La función \(f\) describe la señal. El término \(\sigma(\mathbf{x})\) controla la dispersión de la respuesta alrededor de esa señal. Conocer ambas partes permite distinguir un error del modelo de la variabilidad que introdujimos deliberadamente.
En clasificación podemos generar primero una clase y después sus características, o asignar clases según una regla geométrica. El ruido en las características mueve los puntos; el ruido en las etiquetas modifica la respuesta asignada. Sus efectos no son equivalentes.
Una semilla hace repetible una realización. Para comparar niveles de ruido conservaremos además los mismos puntos y la misma perturbación base: \(\mathbf{X}_\sigma=\mathbf{X}_0+\sigma\mathbf{Z}\). Esto evita atribuir al ruido diferencias que proceden de haber sorteado otra muestra. Una sola semilla no representa todos los resultados posibles; más adelante repetiremos un experimento con varias.
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom IPython.display import displayfrom sklearn.datasets import ( make_moons, make_circles, make_blobs, make_classification, make_gaussian_quantiles, make_multilabel_classification, make_regression, make_friedman1, make_swiss_roll, make_s_curve)from sklearn.model_selection import train_test_splitfrom sklearn.pipeline import make_pipelinefrom sklearn.preprocessing import StandardScalerfrom sklearn.linear_model import LogisticRegression, LinearRegression, HuberRegressorfrom sklearn.svm import SVCfrom sklearn.base import BaseEstimator, ClassifierMixinimport torchfrom torch import nnfrom torch.nn import functional as Ftorch.set_num_threads(2)from sklearn.ensemble import RandomForestRegressorfrom sklearn.dummy import DummyClassifierfrom sklearn.metrics import ( accuracy_score, balanced_accuracy_score, precision_score, recall_score, mean_squared_error, mean_absolute_error, confusion_matrix, ConfusionMatrixDisplay)SEMILLA =42plt.rcParams.update({'figure.dpi': 110, 'font.size': 10, 'axes.spines.top': False,'axes.spines.right': False, 'figure.constrained_layout.use': True})COLORES = ['#276FBF', '#E87524', '#339966', '#9B59B6']comprobaciones = {}def nube(ax, X, y, titulo):for etiqueta in np.unique(y): grupo = y == etiqueta ax.scatter(X[grupo, 0], X[grupo, 1], s=12, alpha=.65, color=COLORES[int(etiqueta) %len(COLORES)], label=f'Clase {etiqueta}') ax.set(title=titulo, xlabel='$x_1$', ylabel='$x_2$') ax.set_aspect('equal', adjustable='box')def dividir(X, y, clasificacion=False): indices = np.arange(len(y)) entrenar, resto = train_test_split(indices, test_size=.4, random_state=SEMILLA, stratify=y if clasificacion elseNone) validar, probar = train_test_split(resto, test_size=.5, random_state=SEMILLA, stratify=y[resto] if clasificacion elseNone)return entrenar, validar, probardef rmse(y, pred):returnfloat(np.sqrt(mean_squared_error(y, pred)))print('Entorno preparado. Los gráficos comparten colores de clase y los experimentos separan 60/20/20.')
Entorno preparado. Los gráficos comparten colores de clase y los experimentos separan 60/20/20.
4.2 Un catálogo visual de clasificación
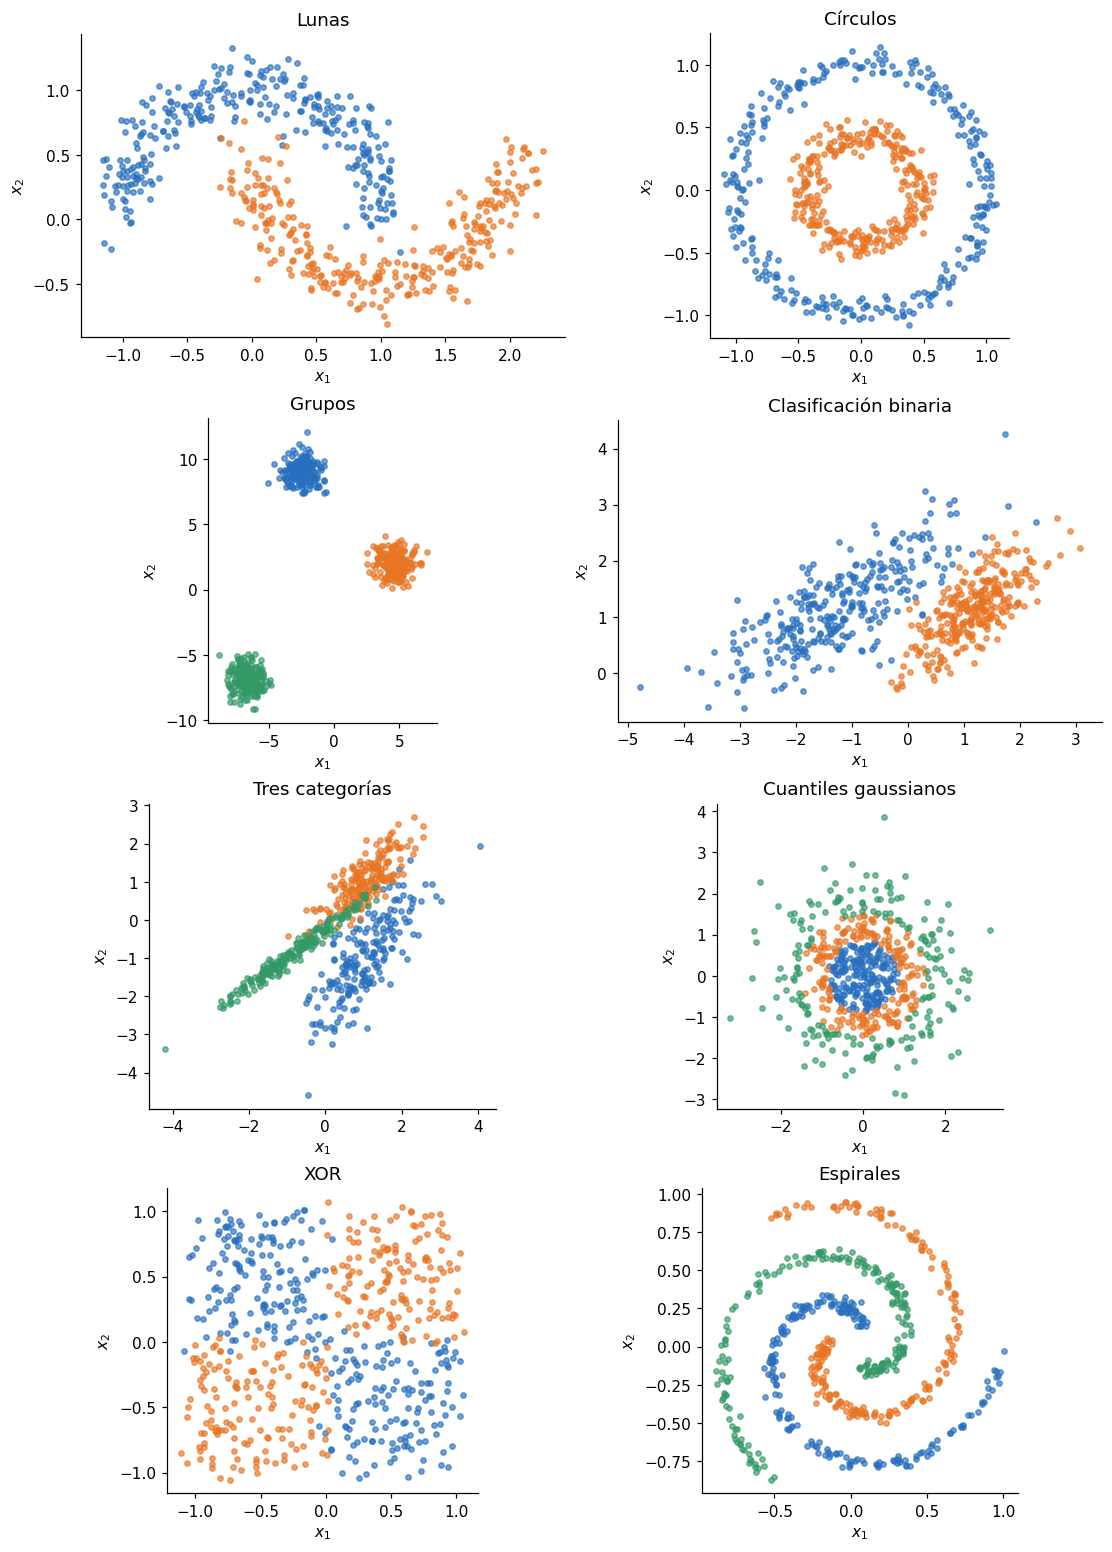
Los siguientes generadores producen problemas distintos. Las lunas exigen seguir dos bandas curvas; los círculos exigen distinguir radios. Los grupos de make_blobs permiten estudiar separación, dispersión y densidad. make_classification construye características con funciones diferentes dentro de un problema de clasificación. Las etiquetas de make_gaussian_quantiles dependen de regiones definidas mediante cuantiles de una distribución gaussiana; no equivalen a varias nubes con centros diferentes.
Añadiremos dos reglas explícitas. En XOR, dos puntos pertenecen a la misma clase si comparten el signo del producto \(x_1x_2\) antes de añadir ruido. En las espirales, cada clase ocupa un brazo. Son útiles para probar fronteras no lineales, aunque su geometría artificial no mide por sí sola la capacidad de un modelo para resolver un problema real.
Las funciones propias del capítulo también están disponibles en generadores.py. Se presentan aquí para que puedas ejecutar el notebook completo sin importar archivos adicionales.
Ver funciones reutilizables
import numpy as npdef generar_xor(n=600, ruido=0.05, semilla=42):"""X (n,2), y binario. La etiqueta depende de los signos antes de perturbar X."""if n <1or ruido <0:raiseValueError('n debe ser positivo y ruido no negativo') rng = np.random.default_rng(semilla) limpio = rng.uniform(-1, 1, size=(n, 2)) y = (limpio[:, 0] * limpio[:, 1] >0).astype(np.int64)return limpio + rng.normal(0, ruido, limpio.shape), ydef generar_espirales(n_por_clase=200, clases=3, vueltas=1.5, ruido=0.08, semilla=42):"""Brazos entrelazados; ruido gaussiano en las dos coordenadas."""if n_por_clase <1or clases <2or vueltas <=0or ruido <0:raiseValueError('Revisar tamaño, clases, vueltas y ruido') rng = np.random.default_rng(semilla) grupos, etiquetas = [], []for k inrange(clases): r = rng.uniform(.15, 1, n_por_clase) angulo =2* np.pi * vueltas * r +2* np.pi * k / clases X = np.column_stack([r * np.cos(angulo), r * np.sin(angulo)]) grupos.append(X + rng.normal(0, ruido, X.shape)) etiquetas.append(np.full(n_por_clase, k, dtype=np.int64)) X, y = np.vstack(grupos), np.concatenate(etiquetas) orden = rng.permutation(len(y))return X[orden], y[orden]def generar_regresion(n=400, relacion='seno', ruido=.3, heterocedastico=False, semilla=42):"""Devuelve X (n,1), y, media conocida y desviación condicional sigma."""if n <1or ruido <0:raiseValueError('Revisar n y ruido') rng = np.random.default_rng(semilla) x = rng.uniform(-3, 3, n) funciones = {'lineal': lambda v: 1+2*v,'cuadratica': lambda v: .6*v**2-1,'seno': lambda v: np.sin(2*v) +.4*v,'por_tramos': lambda v: np.where(v <0, -.5*v, 1.5*v)}if relacion notin funciones:raiseValueError('Relación no disponible') media = funciones[relacion](x) sigma = ruido * (1+ np.abs(x)) if heterocedastico else np.full(n, ruido) y = media + sigma * rng.normal(size=n)return x[:, None], y, media, sigmadef invertir_etiquetas(y, proporcion=.1, semilla=42):"""Invierte exactamente round(proporcion*n) etiquetas binarias, sin modificar y.""" original = np.asarray(y)ifnot0<= proporcion <=1ornot np.isin(original, [0, 1]).all():raiseValueError('Se requieren etiquetas binarias y proporción entre 0 y 1') rng = np.random.default_rng(semilla) mascara = np.zeros(len(original), dtype=bool) mascara[rng.choice(len(original), round(proporcion*len(original)), replace=False)] =True cambiado = original.copy() cambiado[mascara] =1- cambiado[mascara]return cambiado, mascaradef agregar_faltantes(X, proporcion=.1, semilla=42):"""Ausencia independiente por celda (MCAR); devuelve copia float y máscara."""ifnot0<= proporcion <=1:raiseValueError('Proporción fuera de [0,1]') rng = np.random.default_rng(semilla) copia = np.asarray(X, dtype=float).copy() mascara = rng.random(copia.shape) < proporcion copia[mascara] = np.nanreturn copia, mascaradef generar_serie(n=480, periodo=24, pendiente=.003, amplitud=1.2, ruido=.2, rho=.6, cambio=None, salto=0., semilla=42):"""Serie, media conocida y componentes. ruido es sigma de las innovaciones AR(1)."""if n <2or periodo <2or ruido <0orabs(rho) >=1:raiseValueError('Revisar n, periodo, ruido y estacionariedad del componente AR')if cambio isnotNoneandnot0<= cambio < n:raiseValueError('El cambio debe estar dentro de la serie') rng = np.random.default_rng(semilla) t = np.arange(n) tendencia = pendiente * t estacional = amplitud * np.sin(2*np.pi*t/periodo) nivel = np.where(t >= cambio, salto, 0.) if cambio isnotNoneelse np.zeros(n) innovaciones = rng.normal(0, ruido, n) error = np.empty(n) error[0] = rng.normal(0, ruido / np.sqrt(1-rho**2))for j inrange(1, n): error[j] = rho*error[j-1] + innovaciones[j] media = tendencia + estacional + nivelreturn {'t': t, 'y': media + error, 'media': media, 'tendencia': tendencia,'estacional': estacional, 'nivel': nivel, 'error': error}def generar_imagenes(n_por_clase=40, lado=32, ruido=.15, semilla=42):"""Cuatro formas. X float32 (N,1,H,W) en [0,1], y int64, orden aleatorio."""if n_por_clase <1or lado <16or ruido <0:raiseValueError('Revisar cantidad, tamaño y ruido') rng = np.random.default_rng(semilla) yy, xx = np.mgrid[:lado, :lado] imagenes, etiquetas = [], []for k inrange(4):for _ inrange(n_por_clase): cx, cy = rng.uniform(.35*lado, .65*lado, 2) grosor = rng.uniform(.035*lado, .08*lado)if k ==0: forma = np.abs(xx-cx) <= grosorelif k ==1: forma = np.abs(yy-cy) <= grosorelif k ==2: forma = np.abs((xx-cx)-(yy-cy))/np.sqrt(2) <= grosorelse: radio = rng.uniform(.18*lado, .26*lado) forma = np.abs(np.hypot(xx-cx, yy-cy)-radio) <= grosor imagenes.append(np.clip(forma.astype(float) + rng.normal(0, ruido, (lado, lado)), 0, 1)) etiquetas.append(k) X = np.asarray(imagenes, dtype=np.float32)[:, None] y = np.asarray(etiquetas, dtype=np.int64) orden = rng.permutation(len(y))return X[orden], y[orden]def generar_tabla_categorica(n=600, semilla=42):"""Devuelve columnas mixtas, y binario y probabilidad conocida de una simulación."""if n <1:raiseValueError('n debe ser positivo') rng = np.random.default_rng(semilla) canal = rng.choice(['web', 'tienda', 'telefono'], size=n, p=[.5,.3,.2]) segmento = rng.choice(['nuevo', 'recurrente'], size=n, p=[.6,.4]) intensidad = rng.normal(size=n) efecto_canal = np.select([canal =='web', canal =='tienda'], [.5, -.3], default=0.) logit =-1+.8*intensidad + efecto_canal +.7*(segmento =='recurrente') probabilidad =1/ (1+ np.exp(-logit)) y = rng.binomial(1, probabilidad).astype(np.int64)return {'canal': canal, 'segmento': segmento, 'intensidad': intensidad}, y, probabilidadprint('Disponibles: XOR, espirales, regresión, etiquetas ruidosas, faltantes, series, imágenes y tablas mixtas.')
En las lunas, los colores siguen bandas que una recta no puede separar por completo. En los círculos, la distancia al centro aporta una representación útil: una característica como \(x_1^2+x_2^2\) puede simplificar la separación. En XOR, la interacción \(x_1x_2\) conecta directamente con la regla generadora. Una red neuronal puede aprender representaciones, pero estos ejemplos también muestran por qué el diseño de características merece atención.
Los grupos parecen un problema de agrupamiento porque conocemos el grupo que produjo cada punto. Puedes omitir y al entrenar un algoritmo de clustering y conservarlo únicamente para evaluar la recuperación de los grupos simulados. La etiqueta generada nunca debe entrar como característica.
En las espirales hay puntos cercanos de distintas clases, especialmente hacia el centro. Aumentar la complejidad del modelo puede ayudar a seguir los brazos; también puede hacerlo más sensible al ruido. El gráfico plantea esa posibilidad, pero la comparación de validación tendrá que comprobarla.
Para la galería usamos una vuelta y ruido \(0.025\) en las espirales. Prueba después vueltas=1.5 y ruido=0.08: los brazos quedarán más próximos y menos visibles. En make_classification, verifica también la restricción n_classes * n_clusters_per_class <= 2**n_informative; no todas las combinaciones de parámetros son válidas.
4.3 Lunas: cuánto mueve el ruido cada observación
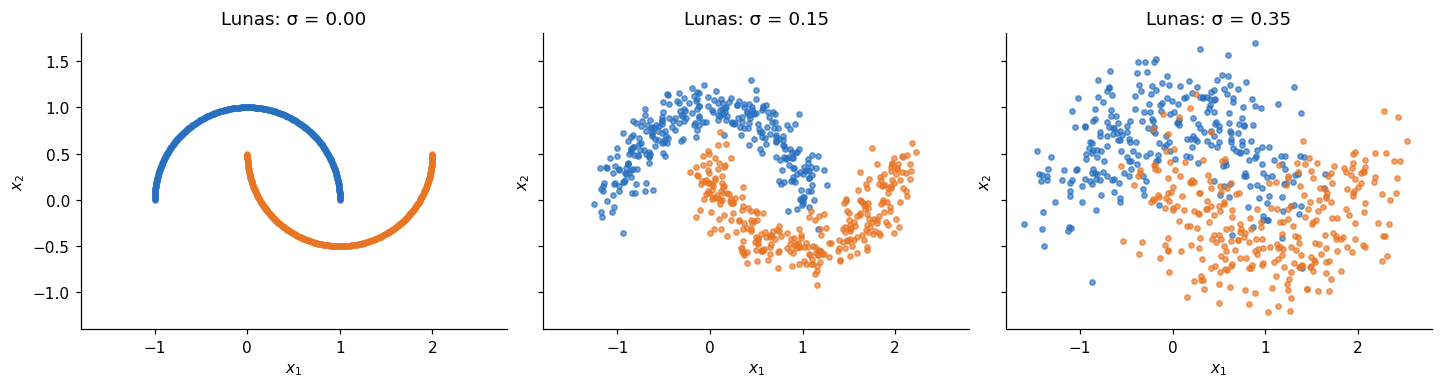
make_moons(noise=...) añade perturbaciones gaussianas a las coordenadas. Para aislar su efecto, generaremos las lunas limpias una sola vez y multiplicaremos la misma perturbación por tres valores de \(\sigma\). Las etiquetas se conservan. El desplazamiento puede hacer que puntos de distintas clases ocupen posiciones muy cercanas.
X_limpio, y_lunas = make_moons(n_samples=600, noise=None, random_state=SEMILLA)Z = np.random.default_rng(7).normal(size=X_limpio.shape)fig, axes = plt.subplots(1, 3, figsize=(13, 4), sharex=True, sharey=True)for ax, sigma inzip(axes, [0., .15, .35]): nube(ax, X_limpio + sigma*Z, y_lunas, f'Lunas: σ = {sigma:.2f}')for ax in axes: ax.set(xlim=(-1.8, 2.8), ylim=(-1.4, 1.8))plt.show()print('Mismos 600 puntos, mismas etiquetas y misma perturbación base en los tres paneles.')
Mismos 600 puntos, mismas etiquetas y misma perturbación base en los tres paneles.
4.3.1 Decisión a partir del gráfico
Con \(\sigma=0\) distinguimos las bandas. Con \(\sigma=0.15\) aparecen puntos próximos a la otra banda; con \(\sigma=0.35\) el solapamiento se vuelve más amplio. Una frontera cada vez más sinuosa podría memorizar estos desplazamientos sin resolver la ambigüedad de observaciones nuevas.
La escala importa: \(0.15\) se expresa en las unidades de estas coordenadas. No representa un «15 % de ruido» ni se compara directamente con un ruido de respuesta de \(15\) en una regresión. Antes de transferir una configuración, observa la amplitud de las características y cómo se define la perturbación.
4.4 Círculos: separación radial y ruido
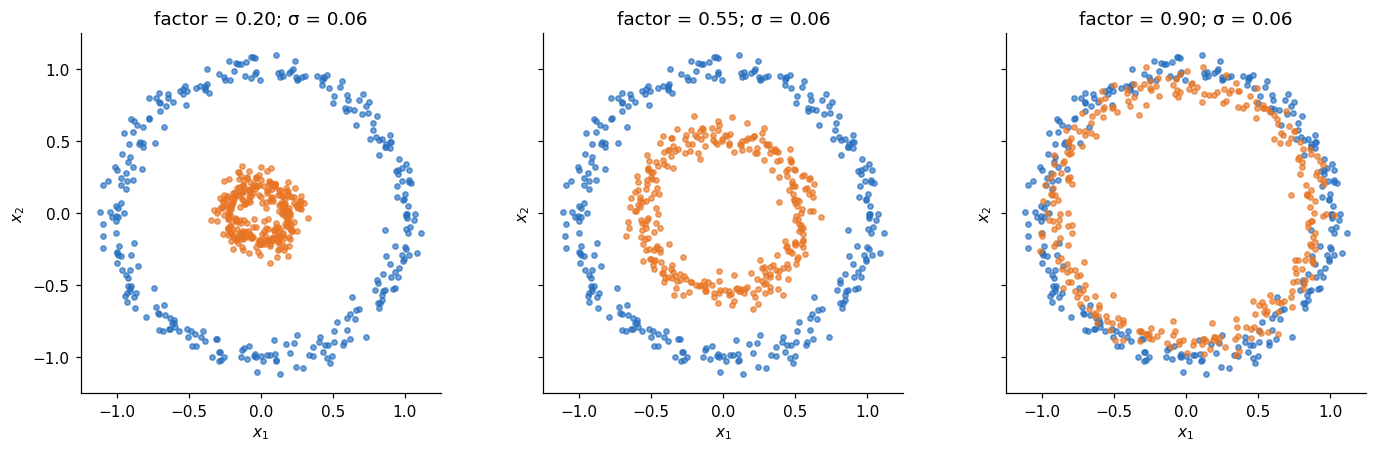
En make_circles, factor relaciona el radio del círculo interior con el exterior. Un valor cercano a uno acerca los anillos. La cantidad de ruido puede permanecer fija mientras el problema se vuelve más difícil por una separación menor.
Conservaremos las semillas y la perturbación base. Cada clase conserva su radio teórico antes del ruido; las coordenadas observadas ya no caen exactamente sobre ese radio.
La diferencia de radios teóricos es 0.80, 0.45 y 0.10, respectivamente.
4.4.1 Cómo leer este resultado
En el último panel, la diferencia de radios es \(0.10\) y la desviación del ruido por coordenada es \(0.06\). Esa comparación ayuda a explicar el solapamiento, pero no es una fórmula para calcular la tasa de error: el desplazamiento radial depende de las dos coordenadas.
Si la separación radial es amplia, una característica de radio y un clasificador sencillo pueden bastar. Si los anillos se solapan, ni siquiera una representación apropiada garantiza separar todas las observaciones. Cambia primero la dificultad geométrica y después el ruido; así sabrás qué condición explica un deterioro.
4.5 Grupos: dispersión, orientación y densidad
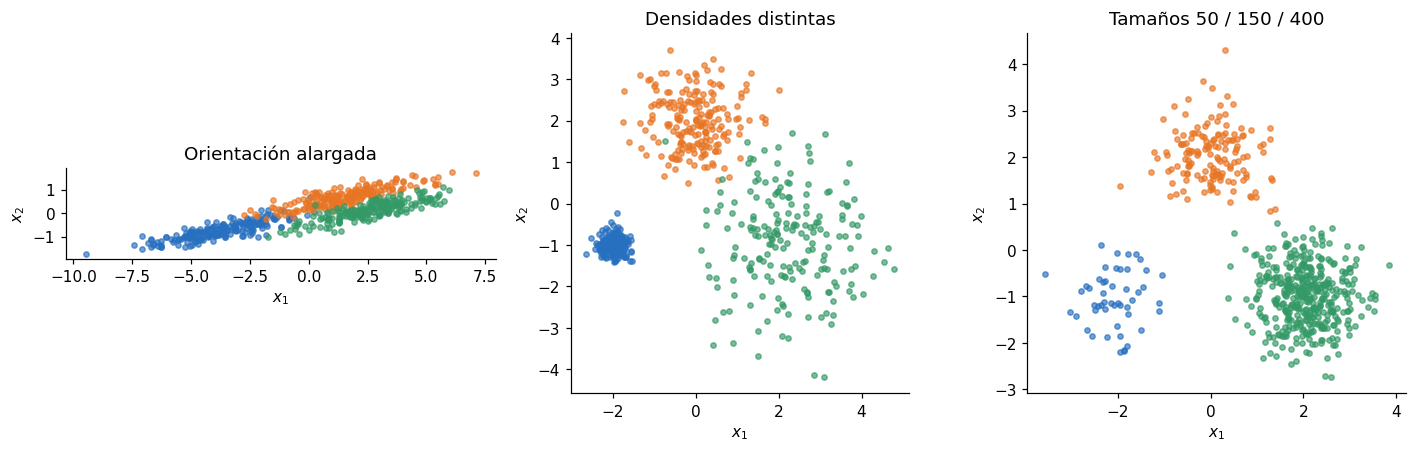
El tamaño de una nube, su forma y su número de observaciones son tres controles distintos. Usaremos centros fijos. Primero cambiaremos la dispersión común; después construiremos grupos alargados, dispersiones diferentes y tamaños desiguales.
Estas variantes permiten revisar supuestos de los métodos de agrupamiento. Por ejemplo, la distancia euclídea favorece ciertos tipos de geometría, y los métodos basados en densidad dependen de la escala y de la concentración local de puntos.
centros = np.array([[-2., -1.], [0., 2.], [2., -1.]])X_grupos, y_grupos = make_blobs(n_samples=600, centers=centros, cluster_std=1, random_state=SEMILLA)fig, axes = plt.subplots(1, 3, figsize=(13, 4), sharex=True, sharey=True)for ax, sigma inzip(axes, [.25, .8, 1.4]): nube(ax, centros[y_grupos] + sigma*(X_grupos-centros[y_grupos]), y_grupos,f'Dispersión = {sigma:.2f}') ax.set(xlim=(-6, 6), ylim=(-5, 6))plt.show()A = np.array([[1.5, .8], [.2, .35]])variantes = {'Orientación alargada': (X_grupos @ A.T, y_grupos),'Densidades distintas': make_blobs(n_samples=600, centers=centros, cluster_std=[.2, .65, 1.1], random_state=SEMILLA),'Tamaños 50 / 150 / 400': make_blobs(n_samples=[50,150,400], centers=centros, cluster_std=.6, random_state=SEMILLA),}fig, axes = plt.subplots(1, 3, figsize=(13, 4))for ax, (nombre, (X, y)) inzip(axes, variantes.items()): nube(ax, X, y, nombre)plt.show()print('En el tercer panel cambió la frecuencia de los grupos, manteniendo una dispersión común de 0.6.')
En el tercer panel cambió la frecuencia de los grupos, manteniendo una dispersión común de 0.6.
4.5.1 Decisiones para reutilizar estos datos
En la primera fila, el aumento de dispersión reduce la separación entre grupos. En la segunda, la transformación lineal cambia orientación y escala; el segundo panel cambia la concentración de los puntos, y el tercero cambia cuántas observaciones aporta cada grupo.
No concluyas que una nube pequeña es una anomalía ni que un grupo disperso contiene datos incorrectos. Ambos fueron generados deliberadamente. Si vas a comparar métodos, declara qué variante utilizas y qué criterio importa: recuperar etiquetas simuladas, detectar densidades, mantener estabilidad frente al ruido o describir la estructura sin etiquetas. Son objetivos diferentes.
4.6 Características informativas, redundantes y de ruido
make_classification permite separar estas funciones. Una característica informativa participa en la construcción de los grupos de clase. Una redundante es una combinación lineal de las informativas. Una repetida duplica una columna. Las restantes introducen variación adicional independiente en el mecanismo del generador.
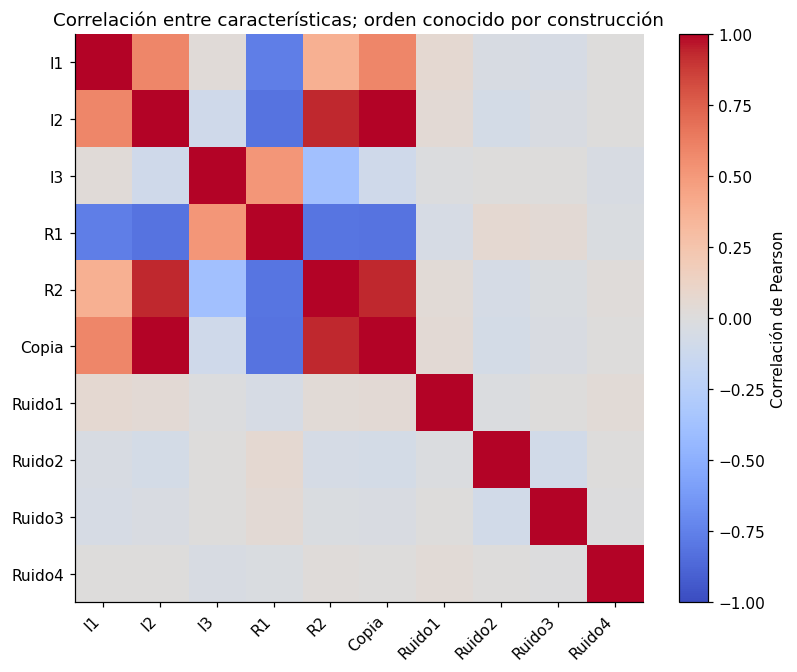
Con shuffle=False conservamos ese orden para inspeccionarlo. Conocer la construcción es un privilegio de la simulación: en un conjunto real no basta una correlación para declarar que una variable es útil, redundante o irrelevante.
X_f, y_f = make_classification(n_samples=800, n_features=10, n_informative=3, n_redundant=2, n_repeated=1, n_clusters_per_class=2, shuffle=False, flip_y=0, random_state=SEMILLA)nombres_f = ['I1','I2','I3','R1','R2','Copia','Ruido1','Ruido2','Ruido3','Ruido4']tabla_f = pd.DataFrame(X_f, columns=nombres_f)display(tabla_f.head().round(3))fig, ax = plt.subplots(figsize=(8, 6))im = ax.imshow(tabla_f.corr(), cmap='coolwarm', vmin=-1, vmax=1)ax.set_xticks(range(10), nombres_f, rotation=45, ha='right')ax.set_yticks(range(10), nombres_f)ax.set_title('Correlación entre características; orden conocido por construcción')fig.colorbar(im, ax=ax, label='Correlación de Pearson')plt.show()print('Clases:', np.bincount(y_f), '| Tres informativas, dos redundantes, una copia y cuatro de ruido.')
I1
I2
I3
R1
R2
Copia
Ruido1
Ruido2
Ruido3
Ruido4
0
-1.724
-0.275
1.365
3.052
-0.088
-0.275
1.677
-0.492
0.016
-0.087
1
-0.900
-0.164
1.016
1.860
-0.096
-0.164
1.568
1.290
0.808
-0.973
2
-0.996
-0.578
0.529
1.889
-0.225
-0.578
0.359
0.568
-0.699
-0.871
3
-0.296
0.002
-1.405
-0.875
0.226
0.002
1.705
-0.301
1.615
0.997
4
-0.894
-1.875
0.616
2.918
-0.894
-1.875
0.408
0.453
-1.400
0.207
Clases: [400 400] | Tres informativas, dos redundantes, una copia y cuatro de ruido.
4.6.1 Cómo leer este resultado
La copia reproduce una columna y aparece una correlación de magnitud uno con ella. Las columnas redundantes pueden mostrar relaciones fuertes, aunque una combinación de varias variables no tiene por qué presentar correlación perfecta con cada una por separado. Las correlaciones pequeñas de las columnas de ruido no son exactamente cero debido al tamaño finito de la muestra.
Esta construcción permite estudiar selección de variables y sensibilidad a información repetida. Ajusta esas decisiones con entrenamiento y validación. La tabla de correlaciones anterior describe el conjunto sintético; no la estamos utilizando para seleccionar variables de un modelo evaluado en prueba.
Si representas únicamente dos de las diez características, recuerda que puedes ocultar información de separación. Un gráfico bidimensional no demuestra por sí solo que todo el problema sea inseparable.
4.7 Comparar fronteras con un protocolo explícito
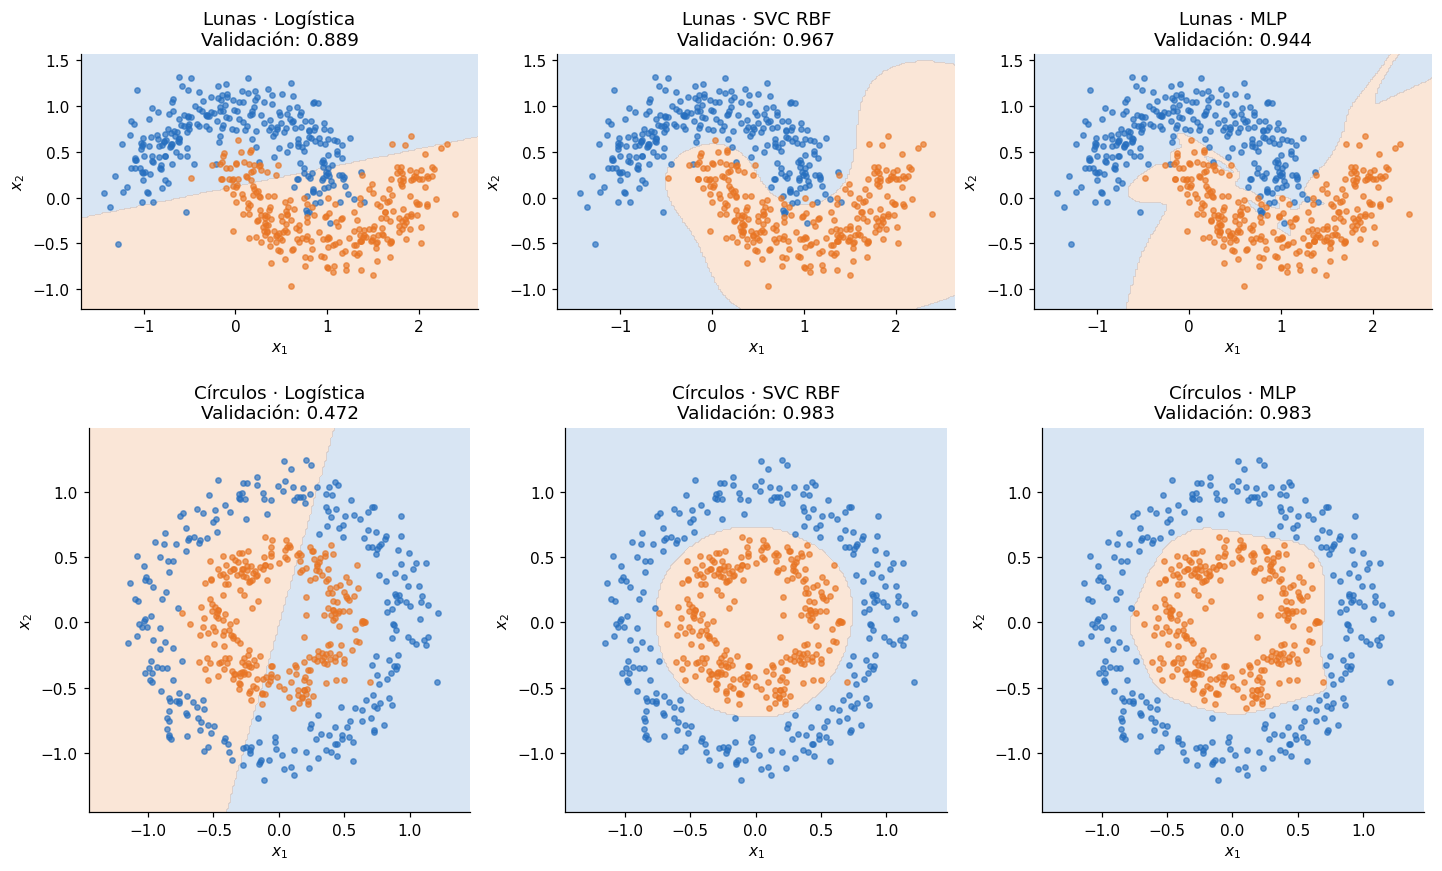
Probemos regresión logística, una máquina de vectores de soporte con kernel RBF y una red neuronal pequeña. Fijamos sus configuraciones antes de observar los resultados. Para cada problema, el entrenamiento ajusta el escalado y el modelo; la validación selecciona el candidato mediante exactitud balanceada; la prueba evalúa únicamente al seleccionado.
En clasificación binaria, la exactitud balanceada es el promedio del recall de ambas clases. Aquí ayuda a mantener un criterio que también será útil cuando cambien las frecuencias. Los conjuntos están balanceados por construcción. El escalado se ajusta dentro del Pipeline, usando exclusivamente el entrenamiento.
4.7.1 La red pequeña usa PyTorch
Conservamos dos capas ocultas de doce unidades tanh, regularización L2 0,01 y optimización de lote completo LBFGS hasta 5 000 iteraciones. La salida es un logit y la pérdida BCE estable; la penalización es \(0,01\sum W^2/(2n)\), excluyendo sesgos. El adaptador solo permite integrar la red en el mismo pipeline de escalado de entrenamiento: la red y el optimizador son nativos de PyTorch.
La inicialización y la implementación de LBFGS cambian frente a scikit-learn; por tanto se regeneran fronteras y métricas. Se mantiene el presupuesto prefijado, sin elegir épocas con prueba. Logística, SVC y todos los generadores permanecen como comparadores y recursos de ML.
class MLPPyTorch(ClassifierMixin,BaseEstimator):def__init__(self,alpha=.01,max_iter=5000,random_state=SEMILLA):self.alpha=alpha;self.max_iter=max_iter;self.random_state=random_statedef fit(self,X,y): torch.manual_seed(self.random_state);self.classes_=np.unique(y);self.n_features_in_=X.shape[1]self.red_=nn.Sequential(nn.Linear(X.shape[1],12),nn.Tanh(),nn.Linear(12,12),nn.Tanh(),nn.Linear(12,1)).double()for m inself.red_.modules():ifisinstance(m,nn.Linear):nn.init.xavier_uniform_(m.weight);nn.init.zeros_(m.bias) a=torch.as_tensor(X,dtype=torch.float64);b=torch.as_tensor(y[:,None],dtype=torch.float64) opt=torch.optim.LBFGS(self.red_.parameters(),lr=1.,max_iter=self.max_iter,max_eval=int(self.max_iter*1.25),tolerance_grad=1e-5,tolerance_change=np.finfo(float).eps,line_search_fn='strong_wolfe')def closure(): opt.zero_grad(set_to_none=True);penalizacion=sum((m.weight**2).sum() for m inself.red_.modules() ifisinstance(m,nn.Linear)) loss=F.binary_cross_entropy_with_logits(self.red_(a),b)+self.alpha*penalizacion/(2*len(a));loss.backward();return loss opt.step(closure);self.red_.eval();returnselfdef predict_proba(self,X):with torch.inference_mode():p=self.red_(torch.as_tensor(X,dtype=torch.float64)).sigmoid().numpy().ravel()return np.column_stack([1-p,p])def predict(self,X):returnself.classes_[(self.predict_proba(X)[:,1]>.5).astype(int)]
La tabla ejecutada muestra la comparación actual. En un empate se conserva el primer candidato del orden declarado. Una diferencia en esta muestra no demuestra superioridad general del framework ni de la familia.
4.7.3 Repetir el experimento: variación entre semillas
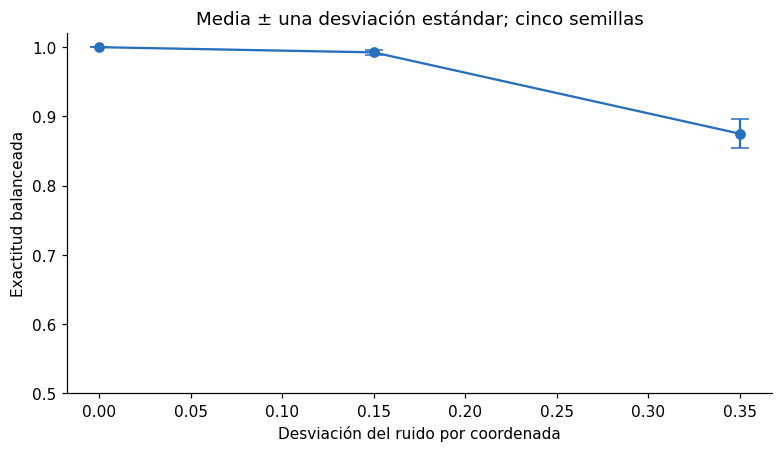
Ahora mantendremos un SVC RBF fijo y cambiaremos exclusivamente el ruido de las lunas. Usaremos cinco semillas. Dentro de cada repetición conservaremos los puntos, la perturbación y la partición para los tres niveles de ruido.
Este es un estudio de sensibilidad previamente definido: no elegiremos un nivel de ruido «ganador» para reportarlo como resultado real. Las barras representan una desviación estándar entre cinco realizaciones; no son intervalos de confianza ni una garantía sobre futuras muestras.
La media pasó de 1.000 sin perturbación a 0.875 con \(\sigma=0.35\). La caída es coherente con el solapamiento observado. El entrenamiento, la configuración y el tamaño se mantuvieron controlados; la dispersión entre semillas recuerda que la muestra también importa.
Para un estudio más sólido puedes aumentar las repeticiones, comparar diferencias emparejadas por semilla y definir el análisis antes de observarlo. Si además ajustas hiperparámetros, añade una validación interna: las mismas muestras usadas para elegirlos no proporcionan una evaluación final independiente.
4.8 Desbalance: una exactitud alta puede ser insuficiente
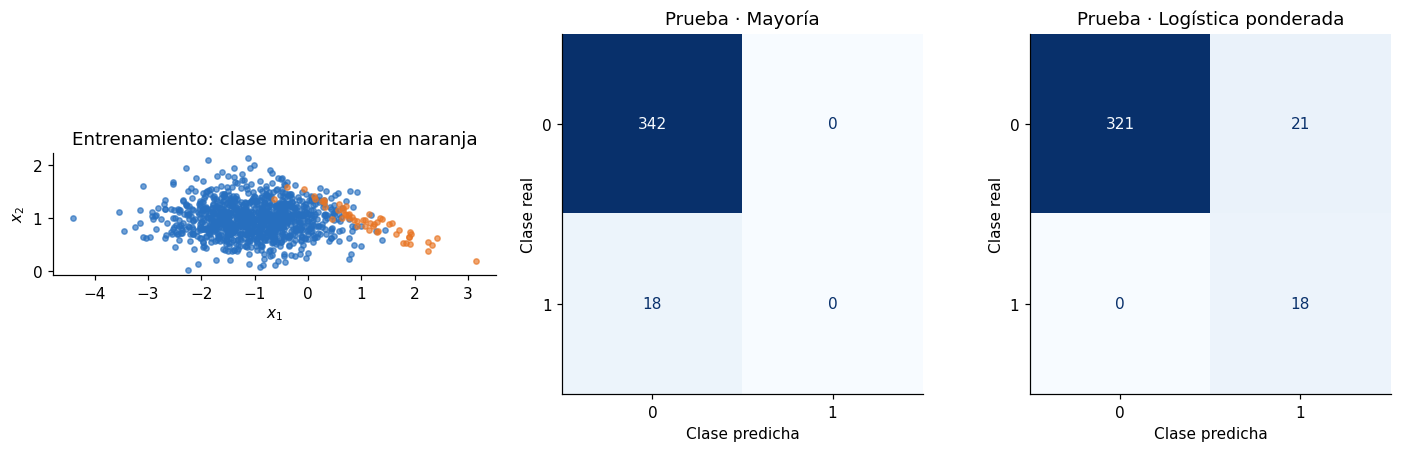
Construiremos dos clases con frecuencias aproximadas de 95 % y 5 %. Compararemos una referencia que siempre predice la mayoría con una logística ordinaria y otra que asigna pesos inversos a las frecuencias de entrenamiento.
Seleccionaremos por exactitud balanceada en validación. El umbral de las logísticas permanecerá en \(0.5\). Cambiar pesos y cambiar umbrales son decisiones diferentes; ambas deberían basarse en validación y en el costo de los errores. Aquí no se ha definido un costo de negocio, por lo que el criterio es ilustrativo.
Frecuencias del conjunto: {np.int64(0): np.int64(1710), np.int64(1): np.int64(90)}
4.8.1 Cómo leer este resultado y elegir un criterio
La referencia mayoritaria alcanzó una exactitud de 0.950 en prueba, con recall cero para la clase 1 y exactitud balanceada \(0.5\). Ese resultado muestra cuánto puede ocultar una métrica dominada por la frecuencia de una clase.
La selección de validación fue Logística ponderada. En prueba obtuvo exactitud balanceada 0.969 y recall de la clase 1 1.000. Su matriz contiene 18 positivos detectados, 0 positivos omitidos y 21 falsas alarmas. Lee esos conteos junto con las métricas: una mejora de detección puede venir acompañada de más falsas alarmas.
La prueba contiene solo 18 observaciones positivas. Acertarlas todas no garantiza un recall perfecto en la población: la estimación tiene incertidumbre, especialmente con pocos ejemplos de la minoría.
Si omitir un positivo cuesta mucho, el recall tendrá peso en la decisión. Si revisar falsas alarmas resulta costoso, también necesitarás precisión y capacidad de revisión. Una ponderación automática no determina esos costos. En un uso posterior, estudia curvas precisión–recall y elige el umbral en validación; evalúa la decisión completa una sola vez en prueba.
4.9 Ruido en las etiquetas: controlar cuántas cambian
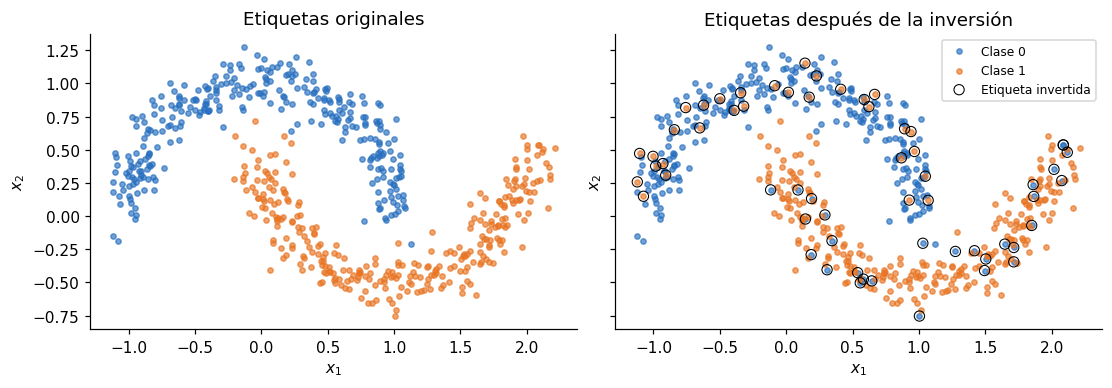
Ahora conservamos las coordenadas de las lunas e invertimos exactamente el 10 % de las etiquetas binarias. La máscara de alteración permite identificar qué cambió; esa información existe únicamente porque hicimos la simulación.
Este mecanismo difiere de make_classification(flip_y=...): allí una fracción de etiquetas recibe una asignación aleatoria que puede coincidir con la original. Por eso flip_y=0.10 no implica que exactamente el 10 % de las etiquetas termine diferente. Nuestra función invierte etiquetas binarias y sí garantiza el número de cambios solicitado, redondeado al entero más próximo.
X_e, y_e = make_moons(n_samples=600, noise=.10, random_state=SEMILLA)y_alterado, mascara_e = invertir_etiquetas(y_e, proporcion=.1, semilla=17)fig, axes = plt.subplots(1, 2, figsize=(10,4), sharex=True, sharey=True)nube(axes[0], X_e, y_e, 'Etiquetas originales')nube(axes[1], X_e, y_alterado, 'Etiquetas después de la inversión')axes[1].scatter(X_e[mascara_e,0], X_e[mascara_e,1], s=45, facecolors='none', edgecolors='black', linewidths=.7, label='Etiqueta invertida')axes[1].legend(fontsize=8)plt.show()assert np.array_equal(y_e[~mascara_e], y_alterado[~mascara_e])assert np.sum(y_e != y_alterado) ==60print('Etiquetas distintas: 60 de 600. Las coordenadas permanecen iguales.')
Etiquetas distintas: 60 de 600. Las coordenadas permanecen iguales.
4.9.1 Decisión ante etiquetas inconsistentes
Los círculos negros muestran observaciones cuyas etiquetas ahora contradicen parcialmente la geometría original. Un modelo flexible podría ajustar esas excepciones y elevar su resultado de entrenamiento. Para decidir si eso ayuda, necesitas etiquetas de evaluación que correspondan al objetivo: ¿quieres recuperar la regla original o predecir el etiquetado ruidoso que recibirás en producción?
Conserva la respuesta original solo como referencia de simulación. En datos reales, una etiqueta que parece extraña puede ser correcta; revisa el proceso de anotación y casos concretos antes de corregirla. No conviertas una predicción del modelo en «verdad» por conveniencia.
4.10 Categorías, multietiqueta y salidas múltiples
Una clasificación multiclase asigna una categoría por observación, como los tres colores de la galería. Una clasificación multietiqueta permite varias categorías simultáneas: un documento puede tratar dos temas. Una regresión de salidas múltiples predice varias cantidades numéricas por observación.
Estos problemas requieren objetivos, formas de salida y métricas diferentes. En multietiqueta, una exactitud que exige acertar toda la fila es más estricta que calcular aciertos por etiqueta. Antes de escoger una pérdida, decide qué cuenta como acierto en la aplicación.
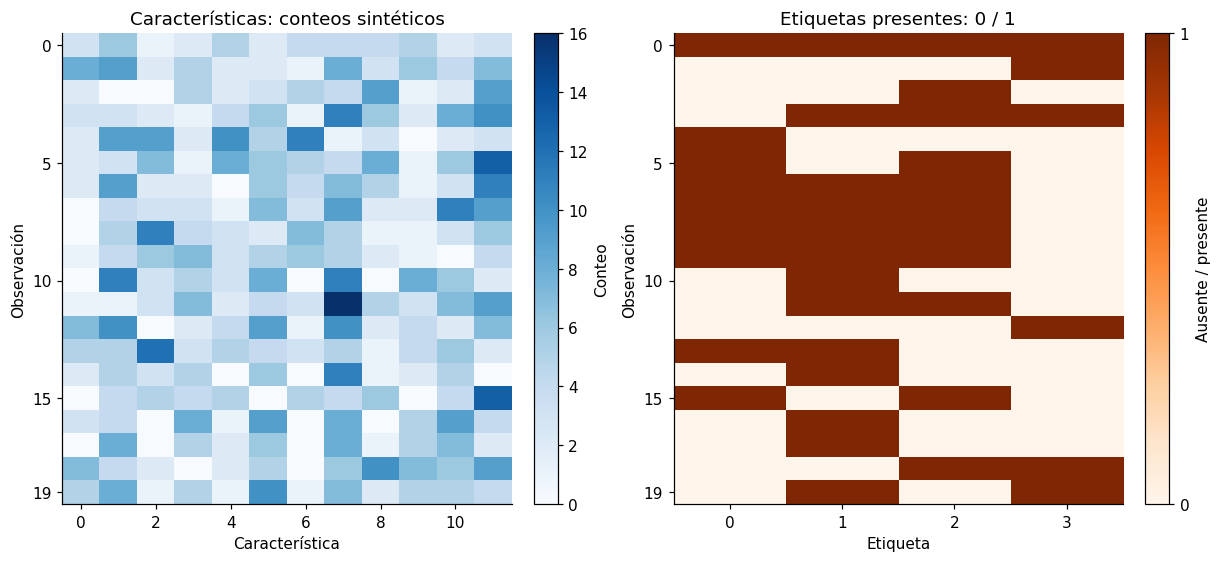
Multietiqueta: X (200, 12) Y (200, 4) | Regresión de dos salidas: X (200, 6) Y (200, 2)
4.10.1 Cómo leer este resultado
La matriz derecha contiene filas con varias posiciones activas. n_labels=2 controla la distribución usada para sortear la cantidad de etiquetas; no obliga a tener exactamente dos en cada fila. En esta realización, la media observada fue 2.06. El mecanismo descarta cantidades incompatibles con el número de clases y, aquí, filas sin etiquetas; por eso la media observada tampoco tiene que ser exactamente el parámetro.
Los valores de X_ml son conteos producidos por un generador. Sirven para ensayar un formato parecido a una representación de documentos, pero no contienen lenguaje real. Para redes neuronales necesitarás una salida y una pérdida compatibles con varias etiquetas simultáneas. Para la regresión de dos salidas, la última dimensión representa dos cantidades continuas.
4.10.2 Columnas categóricas dentro de la tabla
Las categorías también pueden ser características de entrada, como un canal de atención o un segmento. No son necesariamente la respuesta. Construiremos una tabla mixta con dos columnas nominales y una continua, y una respuesta binaria sorteada a partir de una probabilidad conocida:
\[p(y=1\mid X)=\frac{1}{1+\exp(-z)},\quad z=-1+0.8x+\text{efecto del canal}+0.7\,\mathbb{1}_{\text{recurrente}}.\]
Los nombres y efectos son ficticios. Esta simulación prueba formatos y combinación de entradas; no estima comportamientos comerciales reales. Aunque conozcamos \(p\), una observación puede tener respuesta cero o uno. Esa variación Bernoulli no representa una etiqueta capturada incorrectamente.
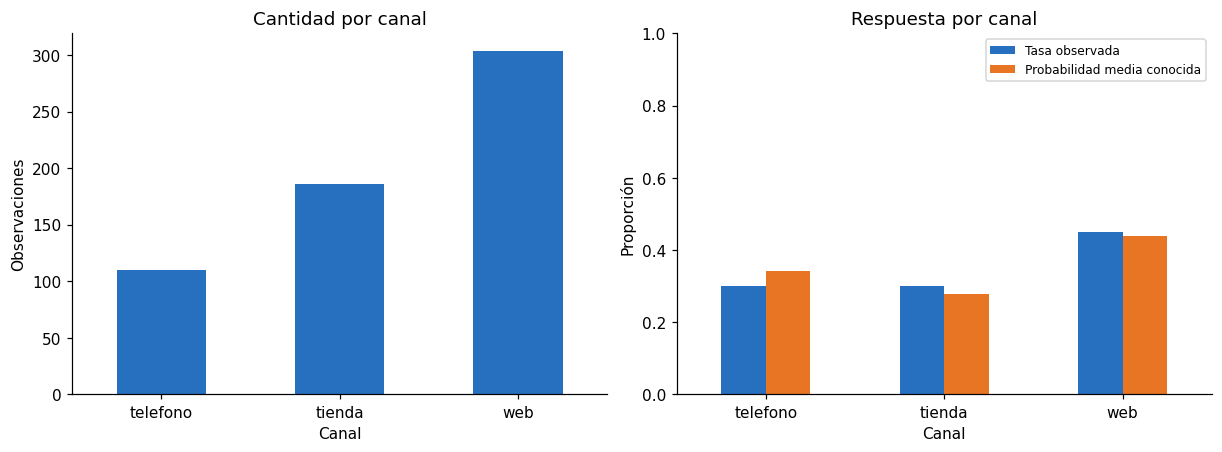
columnas_cat,y_cat,p_cat=generar_tabla_categorica(n=600,semilla=81)tabla_cat=pd.DataFrame(columnas_cat)tabla_cat['respuesta']=y_catdisplay(tabla_cat.head())resumen_cat=(tabla_cat.assign(probabilidad_conocida=p_cat).groupby('canal') .agg(n=('respuesta','size'),tasa_observada=('respuesta','mean'), probabilidad_media=('probabilidad_conocida','mean')))display(resumen_cat.round(3))fig,axes=plt.subplots(1,2,figsize=(11,4))resumen_cat['n'].plot.bar(ax=axes[0],color=COLORES[0],rot=0)axes[0].set(title='Cantidad por canal',xlabel='Canal',ylabel='Observaciones')resumen_cat[['tasa_observada','probabilidad_media']].rename(columns={'tasa_observada':'Tasa observada','probabilidad_media':'Probabilidad media conocida'}).plot.bar( ax=axes[1],rot=0,color=COLORES[:2])axes[1].set(title='Respuesta por canal',xlabel='Canal',ylabel='Proporción',ylim=(0,1))axes[1].legend(fontsize=8)plt.show()print('Tipos:', tabla_cat.dtypes.to_dict())
La primera gráfica permite ver que los canales tienen frecuencias distintas. La segunda contrasta la proporción de respuestas positivas observada con el promedio de las probabilidades que produjeron esas mismas observaciones. No tienen que coincidir exactamente: una corresponde a respuestas sorteadas y otra a sus probabilidades.
No asignes a web, tienda y telefono los números 0, 1 y 2 como si expresaran una distancia u orden natural. Una codificación one-hot es una opción para métodos que requieren entradas numéricas; algunas bibliotecas permiten variables categóricas de manera nativa. Las transformaciones se ajustan con entrenamiento y deben contemplar categorías nuevas. En una red, también puedes estudiar embeddings para estas entradas, con evaluación independiente.
La diferencia de tasas por canal es descriptiva. No demuestra una relación causal: también intervienen el segmento y la intensidad, además del mecanismo explícito que construimos. La probabilidad conocida se conserva para auditar la simulación; no debe entrar como característica al intentar aprender la respuesta a partir de las columnas disponibles.
4.11 Regresión lineal: recuperar una relación conocida
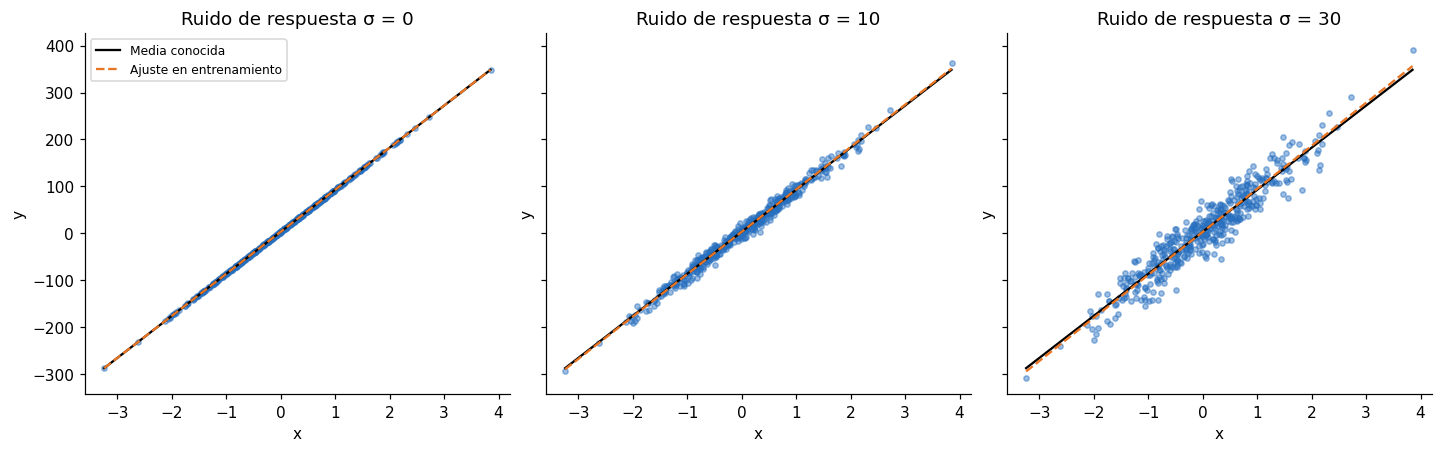
make_regression produce un problema lineal con un número controlado de variables informativas. Podemos obtener sus coeficientes y añadir nosotros mismos ruido de respuesta. Conservaremos \(X\) y una perturbación normal \(\varepsilon\) para comparar tres niveles:
La escala de los coeficientes determina la amplitud de la señal. El parámetro de ruido está en las unidades de \(y\); el efecto de \(\sigma=10\) depende de la señal con la que lo compares.
El coeficiente verdadero es 89.679. Sin ruido, el ajuste recupera la recta salvo precisión numérica. Con ruido aparecen diferencias de estimación y errores de predicción: para \(\sigma=30\), el RMSE de validación fue 29.107. Esa dispersión no demuestra que falte una relación no lineal, porque la media generadora sigue siendo lineal.
El RMSE tiene las unidades de la respuesta. Si cambias sus unidades, cambiará su valor numérico. Para decidir si la desviación es aceptable, relaciona el error con una tolerancia de la aplicación y con una referencia sencilla. Para estudiar recuperación de coeficientes, repite semillas y cambia también la cantidad de observaciones.
4.12 Más relaciones: curvas y cambios de pendiente
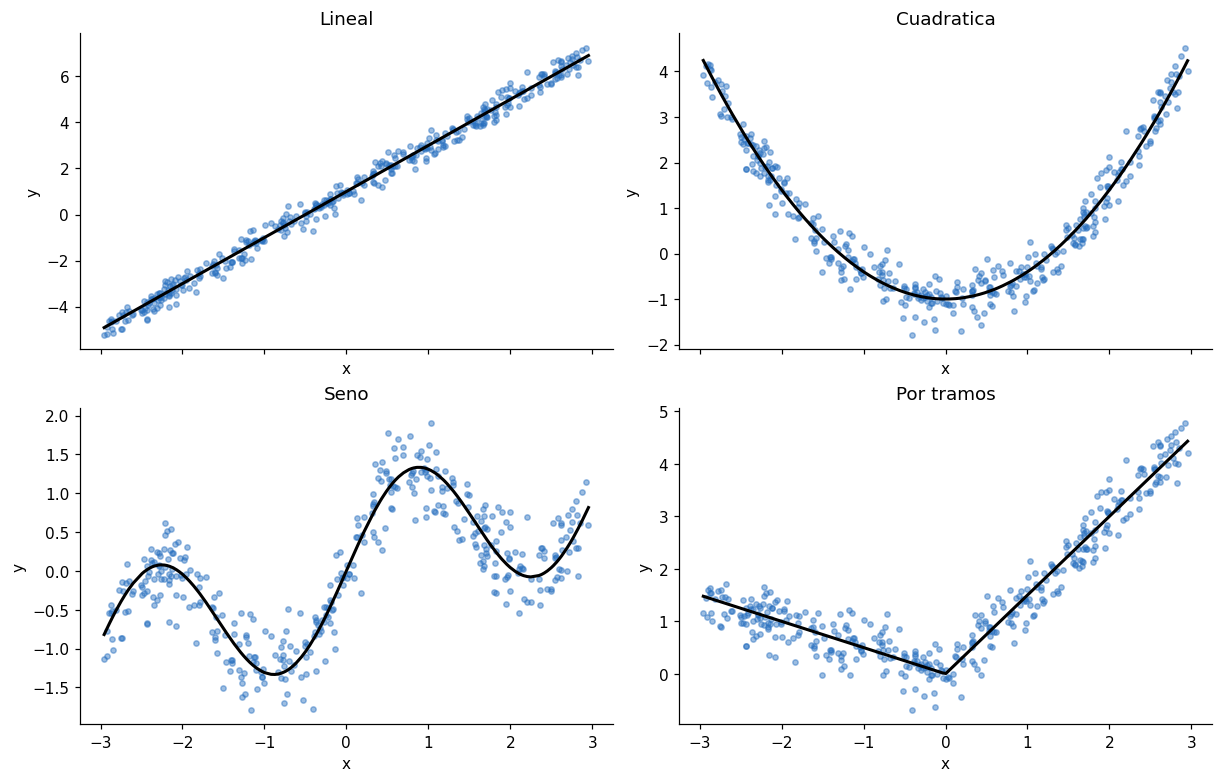
Una función propia permite separar la forma de la media del ruido. Nuestra función devuelve cuatro objetos: características, respuesta observada, media conocida y desviación del ruido. Los últimos dos ayudan a interpretar la simulación; normalmente no estarán disponibles con datos reales.
Las relaciones por tramos prueban cambios de pendiente, la cuadrática introduce simetría y la sinusoidal combina oscilación con tendencia. Mantendremos el mismo \(x\) y la misma perturbación para comparar sus formas.
fig, axes = plt.subplots(2, 2, figsize=(11,7), sharex=True)for ax, relacion inzip(axes.flat, ['lineal','cuadratica','seno','por_tramos']): X, y, media, sigma = generar_regresion(relacion=relacion, ruido=.3) orden = np.argsort(X[:,0]) ax.scatter(X[:,0], y, s=12, alpha=.45, color=COLORES[0]) ax.plot(X[orden,0], media[orden], color='black', linewidth=2) ax.set(title=relacion.replace('_',' ').capitalize(), xlabel='x', ylabel='y')plt.show()print('La línea negra representa la media conocida; en los cuatro paneles σ = 0.3.')
La línea negra representa la media conocida; en los cuatro paneles σ = 0.3.
4.12.1 Decisiones sobre representación
En la cuadrática, un modelo lineal con solo \(x\) no expresa la curvatura, pero añadir \(x^2\) cambia su capacidad. En la relación por tramos, una sola pendiente no describe ambos lados del origen. En la sinusoidal, extrapolar fuera de \([-3,3]\) necesita supuestos adicionales: la muestra no demuestra que la oscilación continúe.
Estos ejemplos son apropiados para comparar ingeniería de características, árboles, kernels y redes pequeñas. Separa entrenamiento y validación antes de ajustar transformaciones. Si añades \(x^2\), documenta que esa decisión proviene del conocimiento de la simulación; con datos reales debería estar sustentada o validada.
4.13 Friedman 1: una superficie con interacciones
El problema de Friedman 1 utiliza características uniformes en \([0,1]\). Con cinco variables, su media es
El producto \(x_1x_2\) crea una interacción: el efecto de una variable depende de la otra. Compararemos una regresión lineal y un bosque aleatorio con configuración fija. La validación seleccionará por RMSE; la prueba evaluará al seleccionado y a la referencia lineal previamente declarada.
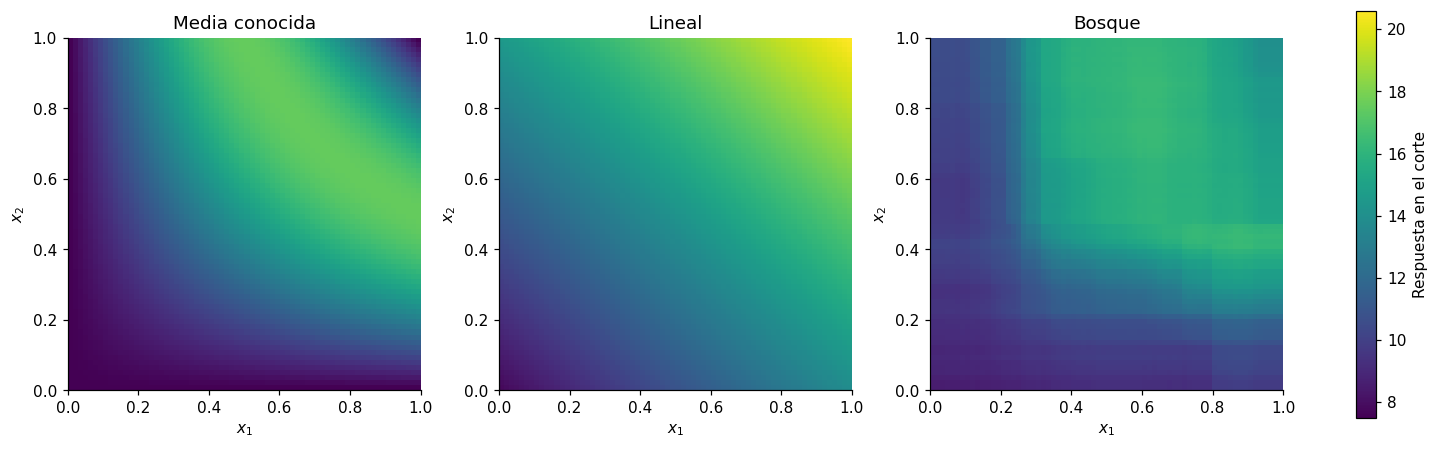
Para visualizar cinco dimensiones haremos un corte: variaremos \(x_1\) y \(x_2\) y fijaremos las restantes en \(0.5\). Es una vista de la función sobre ese plano, no una descripción completa de todos los datos.
X_fr, y_fr = make_friedman1(n_samples=1200, n_features=5, noise=1.5, random_state=SEMILLA)def media_friedman(X):return10*np.sin(np.pi*X[:,0]*X[:,1]) +20*(X[:,2]-.5)**2+10*X[:,3] +5*X[:,4]tr_fr, va_fr, te_fr = dividir(X_fr, y_fr)modelos_fr = {'Lineal': LinearRegression(),'Bosque': RandomForestRegressor(n_estimators=180, min_samples_leaf=3, random_state=SEMILLA, n_jobs=1)}val_fr = {}for nombre, modelo in modelos_fr.items(): modelo.fit(X_fr[tr_fr], y_fr[tr_fr]) val_fr[nombre] = rmse(y_fr[va_fr], modelo.predict(X_fr[va_fr]))ganador_fr =min(val_fr, key=val_fr.get)display(pd.DataFrame({'Modelo': list(val_fr), 'RMSE validación': list(val_fr.values())}).round(3))filas_fr = []for nombre indict.fromkeys(['Lineal', ganador_fr]): pred = modelos_fr[nombre].predict(X_fr[te_fr]) filas_fr.append({'Modelo': nombre, 'RMSE prueba': rmse(y_fr[te_fr],pred),'MAE prueba': mean_absolute_error(y_fr[te_fr],pred)})display(pd.DataFrame(filas_fr).round(3))g1, g2 = np.meshgrid(np.linspace(0,1,70), np.linspace(0,1,70))corte = np.full((g1.size,5), .5)corte[:,0], corte[:,1] = g1.ravel(), g2.ravel()superficies = {'Media conocida': media_friedman(corte),**{nombre: modelo.predict(corte) for nombre, modelo in modelos_fr.items()}}vmin, vmax =min(z.min() for z in superficies.values()), max(z.max() for z in superficies.values())fig, axes = plt.subplots(1,3,figsize=(13,4))for ax, (nombre,z) inzip(axes, superficies.items()): im=ax.imshow(z.reshape(g1.shape), extent=[0,1,0,1], origin='lower', vmin=vmin,vmax=vmax,cmap='viridis',aspect='equal') ax.set(title=nombre,xlabel='$x_1$',ylabel='$x_2$')fig.colorbar(im,ax=axes,label='Respuesta en el corte')plt.show()comprobaciones.update({'fr_ganador':ganador_fr,'fr_lineal':f'{filas_fr[0]["RMSE prueba"]:.3f}','fr_elegido':f'{filas_fr[-1]["RMSE prueba"]:.3f}','fr_oraculo':f'{rmse(y_fr[te_fr],media_friedman(X_fr[te_fr])):.3f}'})print('RMSE de la media generadora en prueba:', comprobaciones['fr_oraculo'])
Modelo
RMSE validación
0
Lineal
2.656
1
Bosque
2.138
Modelo
RMSE prueba
MAE prueba
0
Lineal
2.841
2.254
1
Bosque
2.148
1.717
RMSE de la media generadora en prueba: 1.513
4.13.1 Cómo leer las superficies y los errores
La selección por validación fue Bosque. En prueba, la referencia lineal obtuvo RMSE 2.841 y el seleccionado 2.148. La regresión lineal produce un plano en este corte y no representa la interacción sinusoidal. El bosque introduce regiones constantes y puede aproximar parte de la curvatura; tampoco reproduce exactamente la función conocida.
Evaluar la propia media generadora contra las respuestas ruidosas dio RMSE 1.513. Con ruido normal de desviación \(1.5\), el error cuadrático esperado de esa media es \(1.5^2\) en la distribución generadora. El valor muestral fluctúa; no es una cota que todo modelo deba respetar en cada muestra finita.
El corte utiliza colores con una escala común para permitir comparación. Sin embargo, los modelos se entrenaron en puntos distribuidos en cinco dimensiones, y no exclusivamente sobre ese plano. Usa el gráfico para entender la forma y las métricas reservadas para juzgar la predicción. Este resultado favorece una representación no lineal en esta construcción; no implica que el bosque sea la mejor elección en cualquier regresión.
4.14 Heterocedasticidad: el ruido cambia con la posición
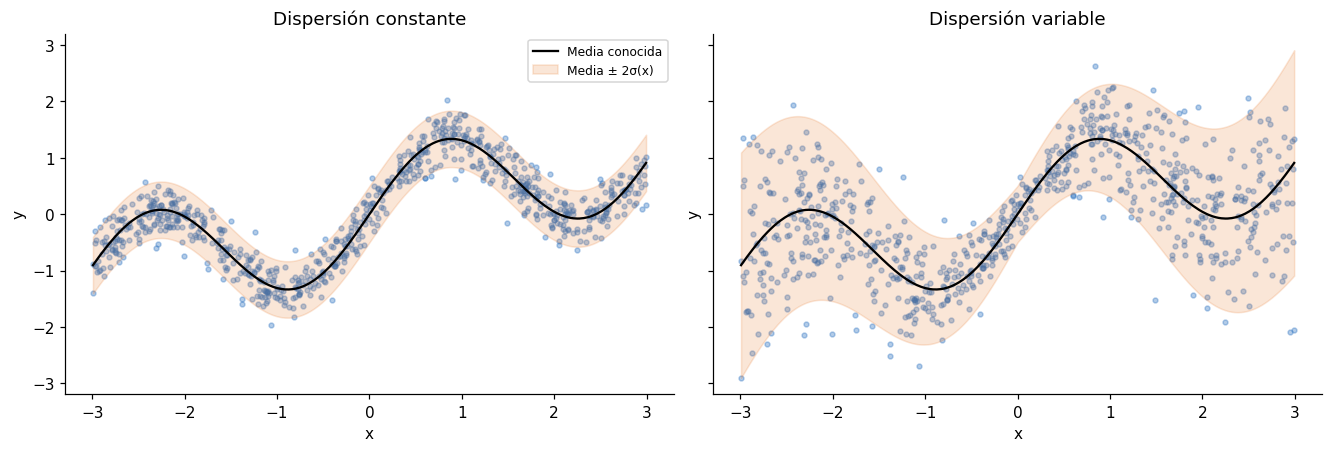
Hasta ahora la dispersión de respuesta era constante. Construiremos otra versión con \(\sigma(x)=0.25(1+|x|)\). Cerca del origen habrá menos variabilidad y hacia los extremos más, aunque la media siga siendo \(\sin(2x)+0.4x\).
La banda \(f(x)\pm2\sigma(x)\) describe variabilidad de observaciones bajo nuestro mecanismo normal conocido. Su cobertura condicional teórica es aproximadamente 95.45 %. No es un intervalo de confianza de una media estimada ni un intervalo calculado por un modelo entrenado.
En la versión de dispersión variable, el RMSE descriptivo contra la media conocida fue 0.384 en el centro y 0.899 en los extremos. No hay un modelo entrenado en esta comparación: estamos midiendo la variabilidad que introdujo el generador.
Un error global podría ocultar esta diferencia por región. Si interesa cuantificar riesgo o incertidumbre, revisa cobertura y amplitud de intervalos en distintas zonas. No atribuyas automáticamente todos los errores grandes a un mal ajuste de la media; puede haber una dispersión condicional mayor. Con datos reales, tanto la media como la dispersión deben estimarse y verificarse.
4.15 Valores atípicos: contaminar y evaluar por separado
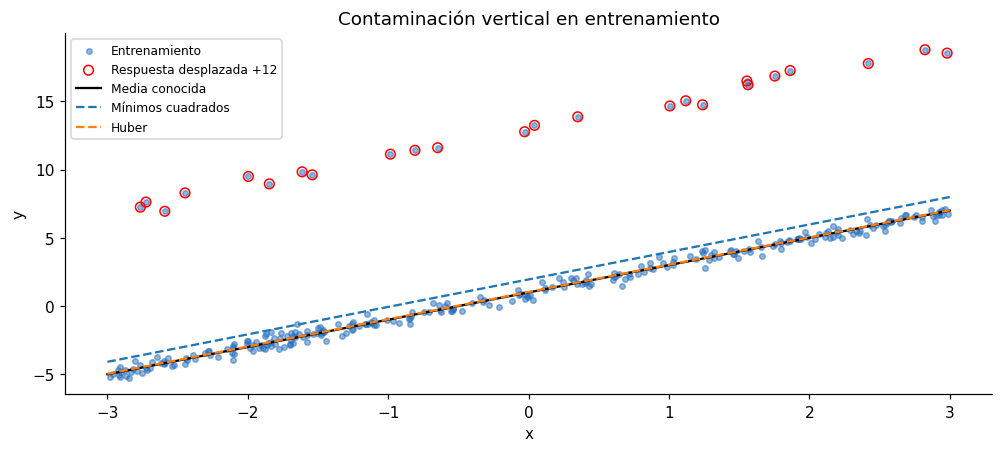
Una observación extrema puede ser válida. Aquí estudiaremos un mecanismo concreto de contaminación: modificaremos únicamente la respuesta de un 8 % del entrenamiento, sumando \(12\) unidades. Conservaremos validación y prueba limpias porque el objetivo declarado es recuperar la relación sin esa contaminación.
Compararemos mínimos cuadrados con una regresión de Huber. Su pérdida reduce la influencia de residuos grandes respecto de una pérdida puramente cuadrática; no ofrece inmunidad ante cualquier contaminación, especialmente ante puntos de alta influencia en las características. El escalado se ajusta en entrenamiento dentro de cada pipeline.
X_o,y_o,media_o,_=generar_regresion(n=500,relacion='lineal',ruido=.3,semilla=32)tr_o,va_o,te_o=dividir(X_o,y_o)y_train_o=y_o[tr_o].copy()contaminados=np.random.default_rng(33).choice(len(tr_o),round(.08*len(tr_o)),replace=False)y_train_o[contaminados]+=12modelos_o={'Mínimos cuadrados':make_pipeline(StandardScaler(),LinearRegression()),'Huber':make_pipeline(StandardScaler(),HuberRegressor(epsilon=1.35,max_iter=1000))}val_o={}for nombre,modelo in modelos_o.items(): modelo.fit(X_o[tr_o],y_train_o) val_o[nombre]=rmse(y_o[va_o],modelo.predict(X_o[va_o]))ganador_o=min(val_o,key=val_o.get)display(pd.DataFrame({'Modelo':list(val_o),'RMSE validación limpia':list(val_o.values())}).round(3))fig,ax=plt.subplots(figsize=(9,4))ax.scatter(X_o[tr_o,0],y_train_o,s=13,alpha=.5,color=COLORES[0],label='Entrenamiento')ax.scatter(X_o[tr_o[contaminados],0],y_train_o[contaminados],s=40,facecolors='none', edgecolors='red',label='Respuesta desplazada +12')grid=np.linspace(-3,3,200)[:,None]ax.plot(grid[:,0],1+2*grid[:,0],color='black',label='Media conocida')for nombre,modelo in modelos_o.items(): ax.plot(grid[:,0],modelo.predict(grid),linestyle='--',label=nombre)ax.set(xlabel='x',ylabel='y',title='Contaminación vertical en entrenamiento')ax.legend(fontsize=8)plt.show()score_o=rmse(y_o[te_o],modelos_o[ganador_o].predict(X_o[te_o]))print(f'Seleccionado: {ganador_o}; RMSE prueba limpia: {score_o:.3f}; respuestas contaminadas: {len(contaminados)}')comprobaciones.update({'out_ganador':ganador_o,'out_score':f'{score_o:.3f}','out_ols':f'{val_o["Mínimos cuadrados"]:.3f}','out_huber':f'{val_o["Huber"]:.3f}'})
4.15.1 Cómo leer este resultado y decidir qué hacer
Los mínimos cuadrados obtuvieron RMSE 1.048 en validación limpia; Huber obtuvo 0.312. Se seleccionó Huber, con RMSE 0.259 en prueba limpia. La línea de mínimos cuadrados se desplaza para reducir la penalización de las respuestas aumentadas. La referencia robusta conserva mejor la tendencia en esta contaminación concreta.
La decisión depende del objetivo. Si esos valores representan errores de captura, interesa corregir su origen o limitar su influencia. Si representan eventos reales que deseas anticipar, una evaluación exclusivamente limpia podría ocultar una necesidad importante. Repite el estudio contaminando también la evaluación cuando esa sea la distribución esperada, y declara el cambio de objetivo.
La máscara usada aquí identifica errores por construcción. No la uses como característica del modelo. En un conjunto real, revisa unidades, fuentes y trazabilidad antes de eliminar observaciones. Un valor extremo de \(x\) que sigue la relación puede ser válido; un valor extremo de \(x\) con respuesta incompatible puede tener mucha influencia. El porcentaje contaminado tampoco equivale al porcentaje de casos que un detector encontrará correctamente.
4.16 Valores faltantes: un escenario de ausencia explícito
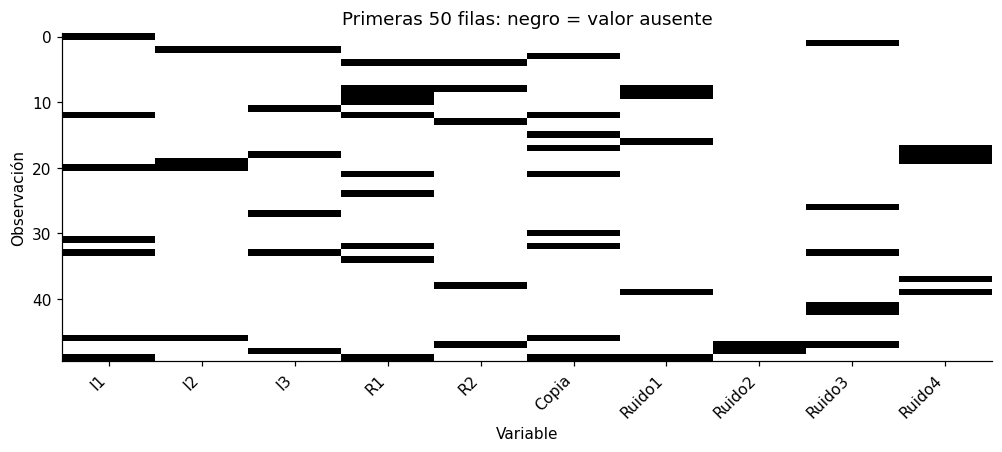
Añadiremos ausencia independiente en cada celda, con probabilidad \(0.10\). Este mecanismo se conoce como MCAR: la ausencia no depende del valor de la variable ni de otra información. La proporción realizada fluctúa, porque sorteamos cada celda y no fijamos un conteo exacto.
Es un escenario útil para depurar un pipeline de imputación. Otros mecanismos son diferentes: la ausencia puede depender de variables observadas o del valor que falta. El presente ejemplo no representa automáticamente esas situaciones.
X_na,mascara_na=agregar_faltantes(X_f,proporcion=.1,semilla=53)display(pd.DataFrame({'Variable':nombres_f,'Faltantes':mascara_na.sum(axis=0),'Proporción':mascara_na.mean(axis=0)}).round(3))fig,ax=plt.subplots(figsize=(9,4))ax.imshow(mascara_na[:50],aspect='auto',cmap='Greys',vmin=0,vmax=1,interpolation='nearest')ax.set_xticks(range(10),nombres_f,rotation=45,ha='right')ax.set(title='Primeras 50 filas: negro = valor ausente',xlabel='Variable',ylabel='Observación')plt.show()assert np.array_equal(X_na[~mascara_na],X_f[~mascara_na])comprobaciones['faltantes']=f'{mascara_na.mean():.3f}'print('Proporción total observada:',comprobaciones['faltantes'])
Variable
Faltantes
Proporción
0
I1
69
0.086
1
I2
81
0.101
2
I3
87
0.109
3
R1
73
0.091
4
R2
69
0.086
5
Copia
85
0.106
6
Ruido1
71
0.089
7
Ruido2
90
0.112
8
Ruido3
85
0.106
9
Ruido4
85
0.106
Proporción total observada: 0.099
La proporción total observada fue 0.099, frente a la probabilidad generadora \(0.10\). El gráfico muestra dispersión de ausencias entre filas y columnas. Conservamos exactamente los valores de las celdas no ausentes.
Si estudias imputación, separa los conjuntos antes de estimar medias, medianas o un modelo imputador. Ajustar esas cantidades con el conjunto completo transfiere información de evaluación al entrenamiento. Puedes variar la ausencia por columna, generar bloques de sensores sin registro o hacerla depender de una variable observada; cada variante exige documentar qué representa y qué no permite concluir.
4.17 Series temporales: tendencia, estacionalidad y dependencia
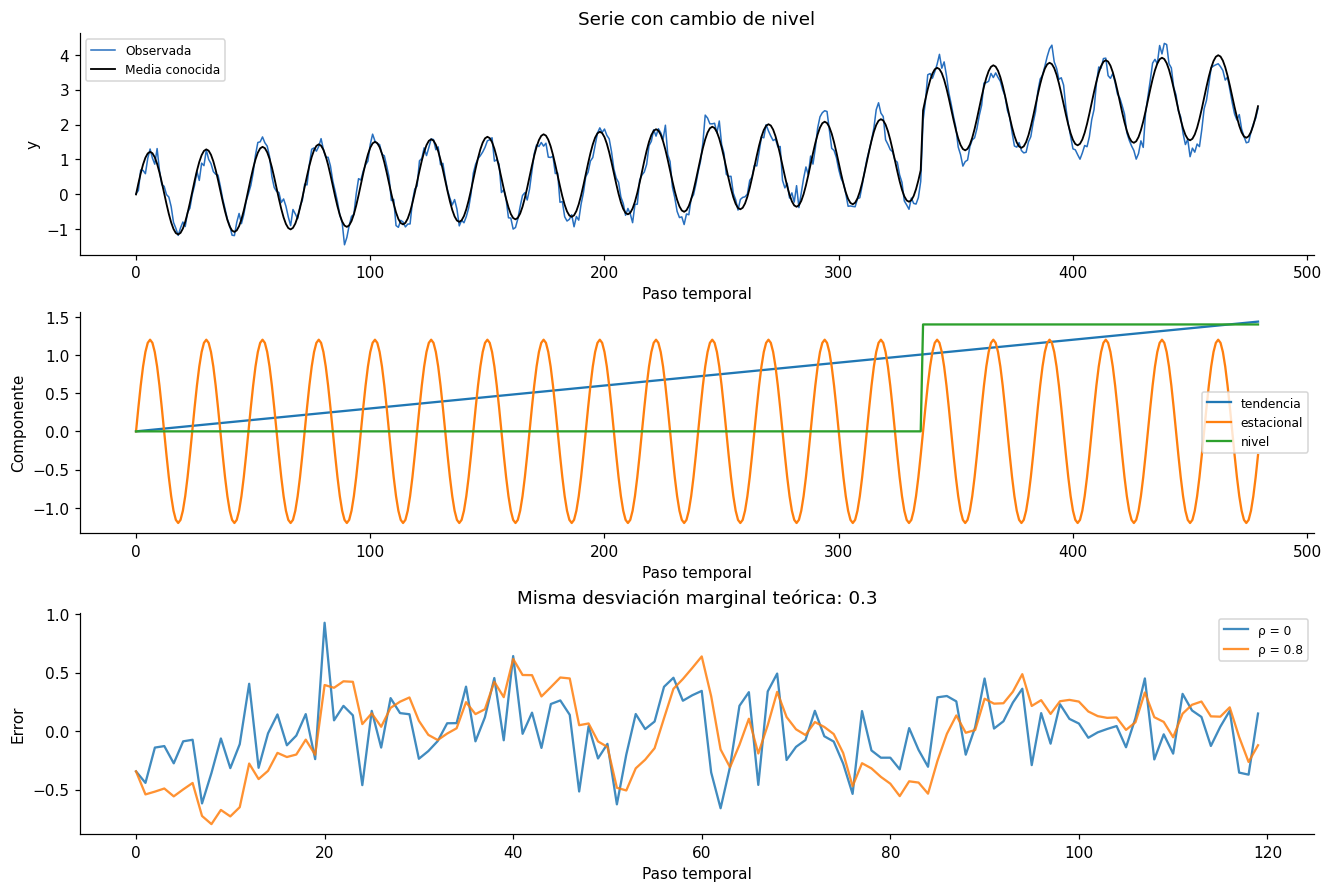
\(L_t\) introduce un cambio de nivel opcional. El componente autoregresivo, AR(1), crea dependencia entre errores consecutivos. Con \(|\rho|<1\), su varianza estacionaria es \(\sigma_u^2/(1-\rho^2)\). En nuestra función, ruido controla \(\sigma_u\), la desviación de las innovaciones, no la desviación marginal de \(e_t\).
Inicializamos el error con su distribución estacionaria. Para comparar \(\rho=0\) y \(\rho=0.8\) conservaremos la misma escala marginal del error, ajustando la de las innovaciones. Así distinguimos persistencia de aumento de amplitud. Los pasos temporales son unidades sintéticas; un periodo de 24 no significa necesariamente horas.
serie=generar_serie(cambio=336,salto=1.4,semilla=61)fig,axes=plt.subplots(3,1,figsize=(12,8))axes[0].plot(serie['t'],serie['y'],label='Observada',color=COLORES[0],linewidth=1)axes[0].plot(serie['t'],serie['media'],label='Media conocida',color='black',linewidth=1.2)axes[0].set(ylabel='y',title='Serie con cambio de nivel'); axes[0].legend(fontsize=8)axes[0].set_xlabel('Paso temporal')for nombre in ['tendencia','estacional','nivel']: axes[1].plot(serie['t'],serie[nombre],label=nombre)axes[1].set(ylabel='Componente',xlabel='Paso temporal'); axes[1].legend(fontsize=8)for rho in [0.,.8]: s=generar_serie(rho=rho,ruido=.3*np.sqrt(1-rho**2),semilla=62) axes[2].plot(s['t'][:120],s['error'][:120],label=f'ρ = {rho:g}',alpha=.85)axes[2].set(xlabel='Paso temporal',ylabel='Error',title='Misma desviación marginal teórica: 0.3')axes[2].legend(fontsize=8)plt.show()print('Cambio conocido por construcción: t = 336; salto = 1.4; periodo = 24.')
Cambio conocido por construcción: t = 336; salto = 1.4; periodo = 24.
4.17.1 Cómo leer las componentes
La primera curva combina crecimiento, oscilación, un salto y error dependiente. La segunda fila muestra qué aporta cada parte. En la tercera, el error con \(\rho=0.8\) tiende a conservar el signo durante más pasos, aunque su desviación marginal teórica sea la misma que con \(\rho=0\).
No mezcles al azar el pasado y el futuro para evaluar una predicción temporal. Una partición aleatoria puede ofrecer al modelo información de periodos posteriores y producir una evaluación que no corresponde al uso previsto. También debes distinguir una predicción de un paso de una trayectoria completa de varios pasos: la información disponible cambia.
4.17.2 Una evaluación de un paso con cambio de nivel
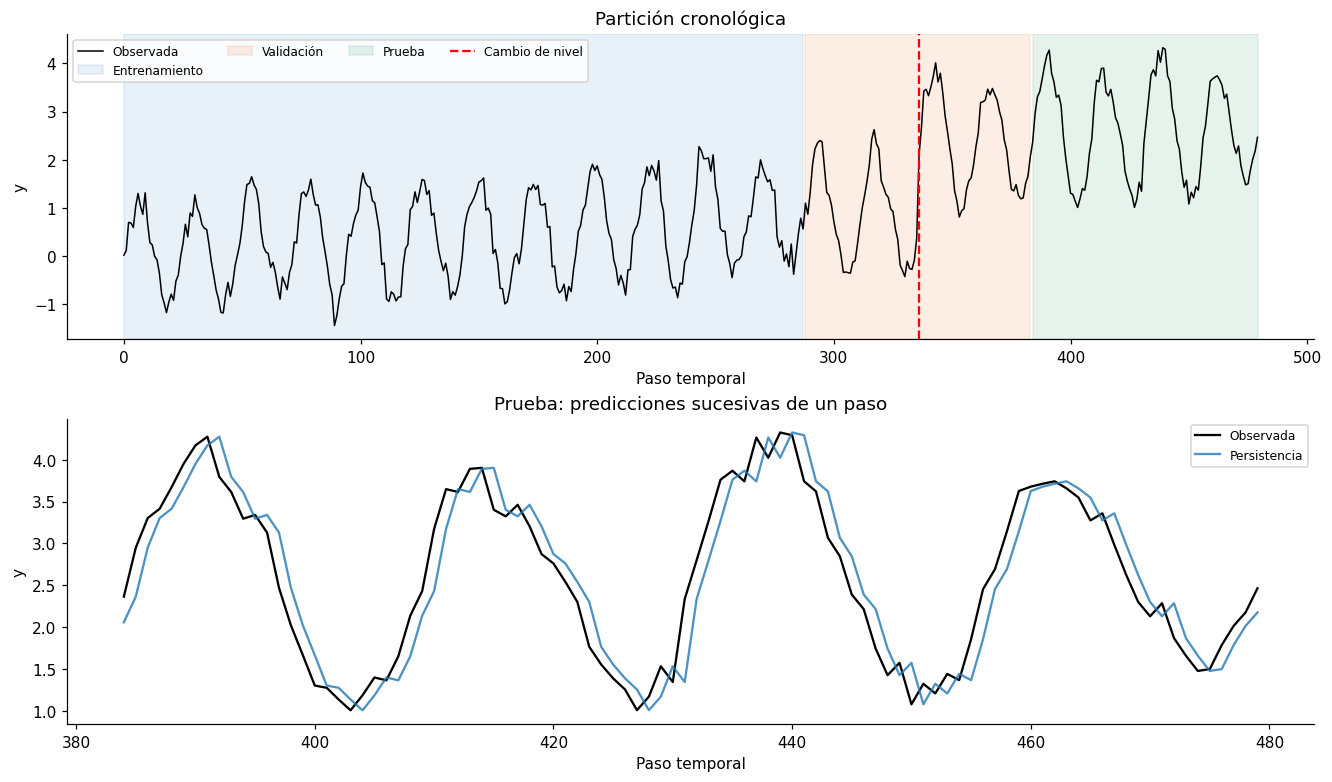
Usaremos entrenamiento \(t<288\), validación \(288\leq t<384\) y prueba \(t\geq384\). El cambio de nivel ocurre durante validación. Compararemos tres reglas declaradas:
Persistencia: predecir \(y_t\) con \(y_{t-1}\).
Estacional: predecir \(y_t\) con \(y_{t-24}\).
Tendencia y armónicos: ajustar en entrenamiento una regresión sobre \(t\), \(\sin(2\pi t/24)\) y \(\cos(2\pi t/24)\).
El periodo se conoce porque lo definimos en el generador. En datos reales habría que justificarlo o estimarlo usando información de entrenamiento. Seleccionaremos por RMSE de validación y evaluaremos al seleccionado junto con persistencia como referencia predefinida.
Las reglas de rezago usan valores observados anteriores a cada instante, incluso cuando ya estamos dentro de validación o prueba. Esto corresponde a predicciones sucesivas de un paso con observaciones que van llegando. No es un pronóstico de 96 pasos emitido al inicio del bloque.
t=serie['t']; ys=serie['y']F=np.column_stack([t,np.sin(2*np.pi*t/24),np.cos(2*np.pi*t/24)])entrenamiento=t<288; validacion=(t>=288)&(t<384); prueba=t>=384armonico=LinearRegression().fit(F[entrenamiento],ys[entrenamiento])pred_serie={'Persistencia':np.r_[np.nan,ys[:-1]],'Estacional':np.r_[np.full(24,np.nan),ys[:-24]],'Tendencia y armónicos':armonico.predict(F)}val_serie={nombre:rmse(ys[validacion],pred[validacion]) for nombre,pred in pred_serie.items()}ganador_serie=min(val_serie,key=val_serie.get)display(pd.DataFrame({'Regla':list(val_serie),'RMSE validación':list(val_serie.values())}).round(3))final_serie=[]for nombre indict.fromkeys(['Persistencia',ganador_serie]): final_serie.append({'Regla':nombre,'RMSE prueba':rmse(ys[prueba],pred_serie[nombre][prueba]),'MAE prueba':mean_absolute_error(ys[prueba],pred_serie[nombre][prueba])})display(pd.DataFrame(final_serie).round(3))fig,axes=plt.subplots(2,1,figsize=(12,7))axes[0].plot(t,ys,color='black',linewidth=1,label='Observada')axes[0].axvspan(0,287,color=COLORES[0],alpha=.1,label='Entrenamiento')axes[0].axvspan(288,383,color=COLORES[1],alpha=.12,label='Validación')axes[0].axvspan(384,479,color=COLORES[2],alpha=.12,label='Prueba')axes[0].axvline(336,color='red',linestyle='--',label='Cambio de nivel')axes[0].set(title='Partición cronológica',xlabel='Paso temporal',ylabel='y'); axes[0].legend(fontsize=8,ncol=4)axes[1].plot(t[prueba],ys[prueba],color='black',label='Observada')for nombre indict.fromkeys(['Persistencia',ganador_serie]): axes[1].plot(t[prueba],pred_serie[nombre][prueba],label=nombre,alpha=.8)axes[1].set(title='Prueba: predicciones sucesivas de un paso',xlabel='Paso temporal',ylabel='y')axes[1].legend(fontsize=8)plt.show()comprobaciones.update({'serie_ganador':ganador_serie,'serie_test':f'{final_serie[-1]["RMSE prueba"]:.3f}','serie_arm':f'{val_serie["Tendencia y armónicos"]:.3f}'})
Regla
RMSE validación
0
Persistencia
0.354
1
Estacional
0.814
2
Tendencia y armónicos
0.980
Regla
RMSE prueba
MAE prueba
0
Persistencia
0.331
0.276
4.17.3 Cómo leer este resultado y decidir un siguiente experimento
La regla seleccionada fue Persistencia, con RMSE de prueba 0.331. La regresión de tendencia y armónicos obtuvo RMSE de validación 0.980. Aunque sus características coinciden con componentes del generador, un ajuste realizado antes del salto no puede conocer el cambio de nivel futuro.
Las reglas con rezagos incorporan gradualmente el nuevo nivel a través de observaciones recientes. La referencia estacional tarda un periodo en disponer de observaciones posteriores al salto para todos sus rezagos; persistencia utiliza inmediatamente la última observación, pero no anticipa por sí sola toda la oscilación. Mira dónde ocurren los errores además de comparar su promedio.
Si el objetivo es anticipar cambios, plantea información adicional o detección de cambio con un protocolo temporal. Si necesitas pronósticos de muchos pasos, diseña otra evaluación sin usar observaciones futuras del bloque. Una LSTM o un transformer requerirían la misma definición de horizonte y disponibilidad de datos; su arquitectura no elimina la necesidad de ese protocolo.
4.18 Superficies y variedades: geometría sin categorías
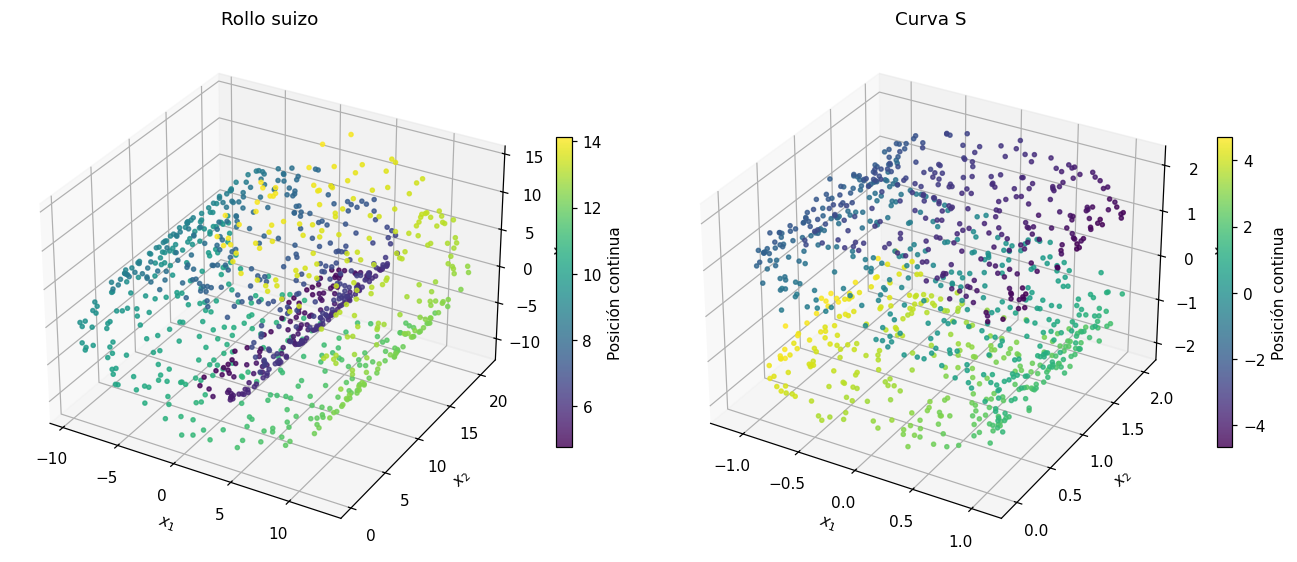
make_swiss_roll y make_s_curve generan superficies bidimensionales inmersas en tres coordenadas. El color que devuelve cada función es un parámetro continuo de posición; no es una etiqueta de clase.
Esa dimensión se refiere a las superficies ideales. Al añadir ruido a las coordenadas, los puntos se apartan de ellas: ya no están exactamente sobre una superficie bidimensional.
Estos ejemplos sirven para visualizar reducción de dimensión y representaciones. Un objetivo posible es conservar vecindades sobre la superficie. La cercanía euclídea en tres dimensiones puede acercar dos capas del rollo que están más alejadas si recorres la superficie.
fig=plt.figure(figsize=(12,5))for j,(nombre,generador) inenumerate([('Rollo suizo',make_swiss_roll),('Curva S',make_s_curve)],1): X_geo,posicion=generador(n_samples=900,noise=.05,random_state=SEMILLA) ax=fig.add_subplot(1,2,j,projection='3d') im=ax.scatter(X_geo[:,0],X_geo[:,1],X_geo[:,2],c=posicion,cmap='viridis',s=7,alpha=.8) ax.set(title=nombre,xlabel='$x_1$',ylabel='$x_2$',zlabel='$x_3$') fig.colorbar(im,ax=ax,shrink=.6,label='Posición continua')plt.show()print('Forma: (900, 3). La variable de color es continua; no hay clases en este experimento.')
Forma: (900, 3). La variable de color es continua; no hay clases en este experimento.
Para comparar métodos de reducción de dimensión, define una medida de preservación de vecindades y observa también la sensibilidad al ruido. Un dibujo visualmente atractivo no garantiza que se conserve la información necesaria para una tarea posterior. Si entrenas un autoencoder, ajusta su representación con entrenamiento y revisa la generalización sobre nuevos puntos generados de manera independiente.
4.19 Imágenes sintéticas: formas, posición y perturbación
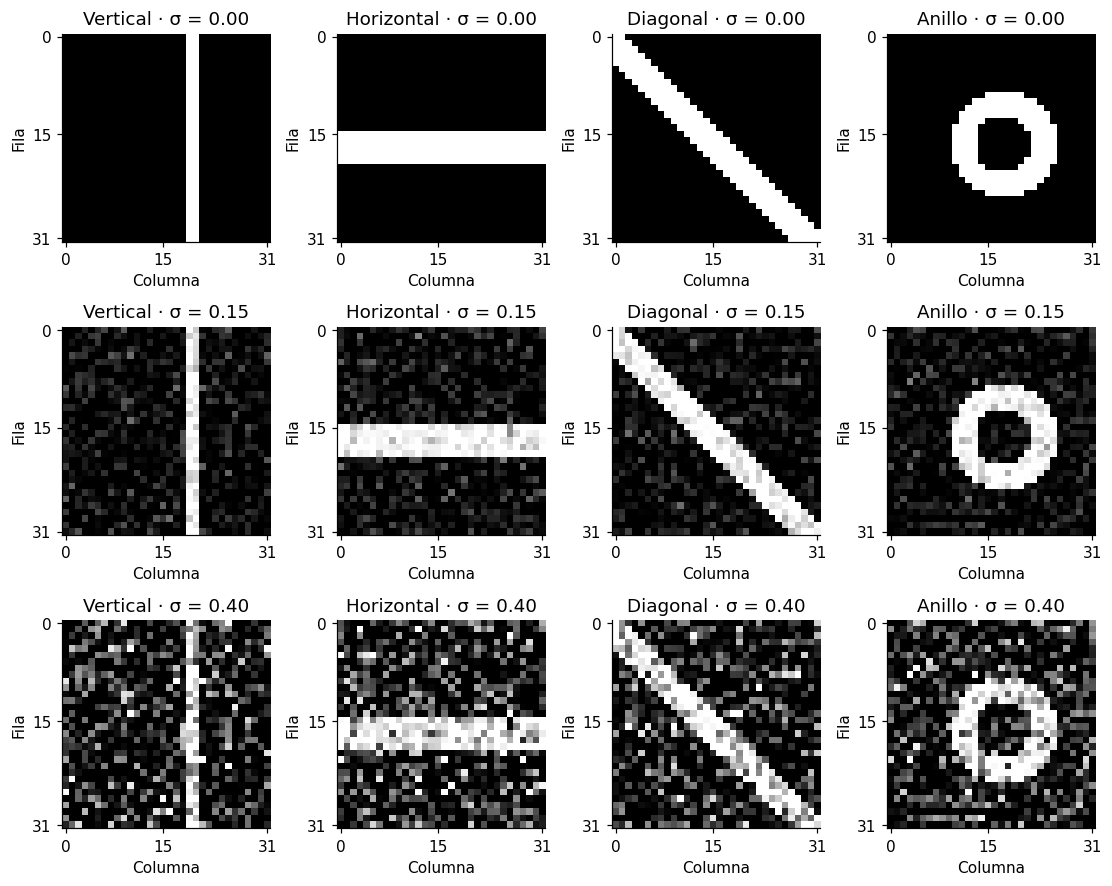
Construiremos cuatro categorías: barra vertical, barra horizontal, diagonal y anillo. Sortearemos posición y grosor dentro de rangos comunes; el anillo tendrá además radio variable. Añadiremos ruido a los píxeles y recortaremos a \([0,1]\).
El recorte hace que el ruido final ya no sea gaussiano aditivo sin restricciones: los valores negativos se acumulan en cero y los superiores a uno en uno. Conviene conocer ese detalle al interpretar histogramas o transferir parámetros.
La salida usa formato \(N\times C\times H\times W\) con un canal: (N, 1, 32, 32). Para una biblioteca que espera canales al final, puedes convertir con np.moveaxis(X, 1, -1). Para un modelo clásico puedes aplanar cada imagen, pero perderás la representación espacial explícita que aprovecha una CNN.
Cada columna conserva una forma reconocible. Al aumentar el ruido, el fondo deja de ser uniforme y aparecen variaciones dentro del trazo. Los paneles conservan la misma semilla y las variaciones geométricas; cambia la intensidad de la perturbación. Todas las imágenes comparten la misma escala de grises, lo que hace comparable su contraste.
Puedes usarlas para verificar el formato de entrada, observar errores por clase y comprobar si un pipeline aprende una tarea elemental. Cambia por separado posición, grosor, tamaño y ruido para estudiar robustez. Si varias imágenes proceden de una misma plantilla o sujeto, separa esas unidades entre entrenamiento y evaluación; distribuir versiones casi idénticas entre ambos conjuntos puede dar una evaluación demasiado favorable.
Las formas simples no representan la dificultad de fotografías reales. Un resultado alto aquí confirma que el sistema resuelve esta construcción. Para evaluar transferencia necesitarás otros datos y otro protocolo. También puedes incorporar distractores o fondos, pero evita que el fondo determine involuntariamente la etiqueta: el modelo podría aprender esa pista y fallar cuando cambie.
4.20 Elegir un generador según la pregunta
Pregunta
Opciones
Control que conviene variar
Evidencia para decidir
¿Hace falta una frontera curva?
Lunas, círculos, XOR, espirales
Ruido, separación radial, vueltas
Validación y frontera en zonas con datos
¿Importa la geometría de los grupos?
make_blobs, transformación anisotrópica
Dispersión, orientación, densidad
Estabilidad y recuperación de grupos simulados
¿El método soporta variables poco útiles?
make_classification
Informativas, redundantes, repetidas y ruido
Resultado reservado y estabilidad de selección
¿La minoría se detecta?
make_classification(weights=...)
Frecuencia, separación, pesos
Recall por clase, precisión, matriz y costos
¿Las etiquetas son confiables?
Inversión binaria, flip_y
Mecanismo y proporción de alteración
Generalización hacia el objetivo de etiquetado declarado
¿Hay varias etiquetas simultáneas?
make_multilabel_classification
Cantidad y frecuencia de etiquetas
Métricas por etiqueta y por observación
¿Se manejan columnas categóricas?
Tabla mixta con respuesta Bernoulli
Frecuencias, efectos y categorías nuevas
Codificación sin fuga y desempeño por grupo
¿Se recupera una relación lineal?
make_regression
Variables, coeficientes, ruido, muestras
Error y recuperación de parámetros
¿Se modelan curvaturas e interacciones?
Funciones propias, make_friedman1
Forma, ruido, región de entrada
Error reservado y cortes de la función
¿La dispersión cambia por región?
Regresión heterocedástica
\(\sigma(x)\)
Errores y cobertura condicional
¿La contaminación domina el ajuste?
Desplazamientos de respuesta
Proporción, magnitud y localización
Validación alineada con la distribución objetivo
¿La ausencia rompe el pipeline?
Máscara MCAR; mecanismos diseñados
Ausencia por celda, columna o bloque
Imputación ajustada sin fuga y error por escenario
¿Se conserva una geometría de baja dimensión?
Rollo suizo, curva S
Ruido y muestreo
Vecindades y utilidad posterior
¿Se anticipa una serie?
Tendencia, ciclos, AR(1), saltos
Horizonte, dependencia, cambios
Evaluación cronológica y errores por periodo
¿Se procesa bien una imagen?
Barras, diagonales y anillos
Posición, grosor, píxeles, distractores
Errores por clase y robustez a cambios declarados
Estas opciones pueden combinarse, pero una combinación modifica la pregunta. Un experimento con desbalance, etiquetas corruptas y ausencia simultánea sirve para evaluar el sistema completo; no permite atribuir cada error a un único factor sin comparaciones controladas.
4.21 Reproducibilidad y límites de uso
Guarda junto con los datos el generador, sus parámetros, la semilla, las versiones de las bibliotecas y la definición de las particiones. Para funciones propias, conserva también su versión de código. Un mismo número de semilla no garantiza resultados idénticos después de cambiar el algoritmo o la implementación.
El archivo generadores.py ofrece las funciones propias sin entrenamiento ni escritura automática de datos. Por ejemplo, para un nuevo experimento puedes llamar generar_espirales(n_por_clase=500, clases=3, vueltas=1.2, ruido=0.04, semilla=101). Revisa las formas y distribuciones después de cambiar parámetros. La siguiente comprobación verifica repetibilidad, que el generador no altera la entrada y que las imágenes cumplen su contrato de forma y rango.
import platformimport sklearna,b=generar_espirales(n_por_clase=30,semilla=101)a2,b2=generar_espirales(n_por_clase=30,semilla=101)assert np.array_equal(a,a2) and np.array_equal(b,b2)assert a.shape==(90,2) and np.array_equal(np.bincount(b),[30,30,30])entrada=np.arange(12,dtype=float).reshape(4,3)respaldo=entrada.copy()salida,mascara=agregar_faltantes(entrada,.4,semilla=5)assert np.array_equal(entrada,respaldo) and np.array_equal(np.isnan(salida),mascara)assert X_img.shape==(400,1,32,32) and X_img.dtype==np.float32assert X_img.min()>=0and X_img.max()<=1assertnotset(tr_fr)&set(va_fr) andnotset(tr_fr)&set(te_fr) andnotset(va_fr)&set(te_fr)display(pd.DataFrame({'Componente':['Python','NumPy','pandas','scikit-learn'],'Versión':[platform.python_version(),np.__version__,pd.__version__,sklearn.__version__]}))print('Comprobaciones satisfechas: repetibilidad, clases, ausencia sin mutación, imágenes y particiones disjuntas.')
Componente
Versión
0
Python
3.13.9
1
NumPy
2.3.5
2
pandas
2.3.3
3
scikit-learn
1.8.0
Comprobaciones satisfechas: repetibilidad, clases, ausencia sin mutación, imágenes y particiones disjuntas.
4.21.1 Propuestas para continuar el análisis
Círculos y representación. Compara logística sobre \((x_1,x_2)\) y sobre \((x_1,x_2,x_1^2+x_2^2)\). Mantén la partición y el ruido. Selecciona en validación y explica qué cambió en la representación.
Espirales y cantidad de datos. Mantén vueltas y ruido; cambia únicamente las observaciones por clase. Repite semillas. Relaciona estabilidad de la frontera, tiempo de entrenamiento y resultado reservado.
Desbalance y umbral. Define primero un costo para falsas alarmas y omisiones. Elige el umbral en validación y muestra los conteos de prueba. No adoptes \(0.5\) o pesos balanceados sin evaluar sus consecuencias.
Atípicos y distribución objetivo. Contrasta contaminación solo en entrenamiento con contaminación también en evaluación. Describe por qué cambia la interpretación de una mejora.
Series y horizonte. Repite la evaluación con un horizonte de 24 pasos sin usar observaciones nuevas dentro del bloque. Compara con el experimento de un paso y explica la información disponible en cada caso.
Imágenes y desplazamiento. Entrena con formas centradas y evalúa con posiciones más amplias. Decide si necesitas nuevos datos, aumentación o una arquitectura diferente. Conserva una prueba final para esa decisión.
La pregunta central de cada experimento es qué cambió, qué se mantuvo y qué evidencia permite tomar una decisión. Si conoces la regla generadora, úsala para explicar el resultado; si la decisión utilizará datos reales, verifica también que esa regla represente una situación pertinente.
4.21.2 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
Se migró exclusivamente la MLP pequeña a PyTorch. Se conservan las capas 12/12 tanh, LBFGS, coeficiente L2 0,01, particiones y selección por exactitud balanceada; se declara el cambio de inicialización y de implementación del optimizador. Las dos redes y sus escaladores se guardaron y la recarga se comprobó sobre validación. La MLP obtuvo exactitud balanceada de validación 0,9444 en lunas y 0,9833 en círculos; SVC obtuvo 0,9667 y 0,9833. La selección siguió siendo SVC en ambos casos por el criterio y desempate prefijados, con prueba 0,9611 y 0,9944. La red ajustó 1,0 en entrenamiento: su mayor flexibilidad no justificó cambiar la selección. Se conservaron todos los generadores, 22 figuras y los comparadores clásicos.
4.22 Referencias y recursos
Las funciones y los parámetros de scikit-learn se documentan en sus páginas oficiales. Los generadores propios y los experimentos de este capítulo son construcciones didácticas; no reproducen poblaciones reales.