Un embedding representa un objeto mediante un vector. Ese objeto puede ser una categoría, una palabra o una imagen. La pregunta decisiva es qué información conserva el vector y para qué decisión resulta útil.
Construiremos representaciones por búsqueda, por coocurrencias y por aprendizaje de imágenes. Compararemos distancias, dimensiones, categorías desconocidas, reconstrucción, clasificación y recuperación. Los ejemplos de lenguaje son introductorios: el desarrollo especializado de NLP pertenece a su libro propio.
Para un vocabulario de \(K\) objetos y dimensión \(d\), una tabla \(E\in\mathbb{R}^{K\times d}\) asigna al identificador \(i\) la fila \(E_i\). Los identificadores son índices: que un código sea 8 y otro 4 no indica que el primero sea el doble del segundo. Una representación one-hot multiplicada por \(E\) produce la misma fila que una consulta directa.
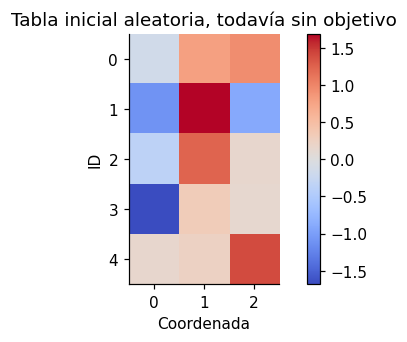
La tabla contiene \(Kd\) entradas. Si se aprende junto con un predictor, sus distancias responden al objetivo de entrenamiento. Una tabla inicializada al azar no adquiere significado por llamarse embedding. Tampoco la compresión garantiza mayor precisión o menor memoria: depende de la dimensión, el tipo numérico y la representación dispersa alternativa.
import numpy as npimport sklearnimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport sklearnfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScalerfrom sklearn.metrics import mean_squared_error, accuracy_score, balanced_accuracy_score, log_loss, ConfusionMatrixDisplayfrom IPython.display import displayimport torchfrom torch import nnfrom torch.utils.data import TensorDataset,DataLoader,WeightedRandomSamplerfrom torch.nn.utils.rnn import pad_sequence,pack_padded_sequenceimport copy,json,math,time,platformfrom pathlib import Pathtorch.set_num_threads(1)torch.use_deterministic_algorithms(True)SEMILLA=42COLORES=['#276FBF','#E87524','#339966','#9B59B6']plt.rcParams.update({'figure.dpi':110,'font.size':10,'figure.constrained_layout.use':True,'axes.spines.top':False,'axes.spines.right':False})lecturas={}def rmse(a,b):returnfloat(np.sqrt(mean_squared_error(a,b)))print('Entorno preparado; NumPy antes de PyTorch, CPU y un hilo de entrenamiento.')from sklearn.linear_model import Ridge,LogisticRegressionfrom sklearn.pipeline import make_pipelinefrom sklearn.decomposition import PCAfrom sklearn.datasets import load_digitsfrom sklearn.metrics.pairwise import cosine_similarity,pairwise_distancestorch.manual_seed(7)tabla=nn.Embedding(5,3)ids=torch.tensor([1,4,1],dtype=torch.long)onehot=torch.nn.functional.one_hot(ids,5).float()assert torch.allclose(tabla(ids),onehot@tabla.weight)display(pd.DataFrame(tabla.weight.detach().numpy(),columns=['e1','e2','e3']))print('Identificadores:',ids.tolist(),'→ forma:',tuple(tabla(ids).shape),'→ parámetros:',tabla.weight.numel())fig,ax=plt.subplots(figsize=(6,3));im=ax.imshow(tabla.weight.detach(),cmap='coolwarm');ax.set(xlabel='Coordenada',ylabel='ID',title='Tabla inicial aleatoria, todavía sin objetivo');fig.colorbar(im,ax=ax);plt.show()
Entorno preparado; NumPy antes de PyTorch, CPU y un hilo de entrenamiento.
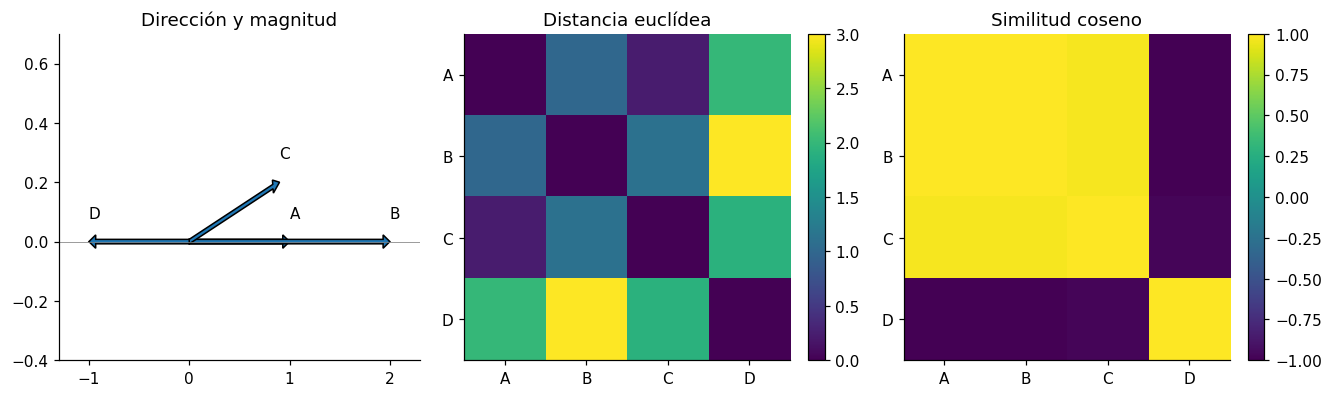
La distancia euclídea considera dirección y magnitud. La similitud coseno compara dirección y requiere vectores de norma distinta de cero:
\[s(a,b)=\frac{a^\top b}{\|a\|\|b\|}.\]
Al normalizar ambos vectores a norma uno, \(\|a-b\|^2=2-2s(a,b)\): sus rankings coinciden. Sin esa normalización pueden diferir. En un vector cero el coseno es indefinido; una biblioteca puede devolver un valor por convenio, pero debemos decidir qué significa para la aplicación.
V=np.array([[1.,0.],[2.,0.],[.9,.2],[-1.,0.]])nombres=['A','B','C','D'];dist=pairwise_distances(V);sim=cosine_similarity(V)display(pd.DataFrame({'objeto':nombres[1:],'distancia a A':dist[0,1:],'coseno con A':sim[0,1:]}))fig,axs=plt.subplots(1,3,figsize=(12,3.5))for nombre,v inzip(nombres,V):axs[0].arrow(0,0,*v,width=.015,length_includes_head=True);axs[0].text(v[0],v[1]+.08,nombre)axs[0].set(xlim=(-1.3,2.3),ylim=(-.4,.7),title='Dirección y magnitud');axs[0].axhline(0,color='gray',lw=.5)for ax,M,t inzip(axs[1:],[dist,sim],['Distancia euclídea','Similitud coseno']): im=ax.imshow(M,cmap='viridis');ax.set(xticks=range(4),xticklabels=nombres,yticks=range(4),yticklabels=nombres,title=t);fig.colorbar(im,ax=ax)plt.show()Q=np.array([[np.cos(.7),-np.sin(.7)],[np.sin(.7),np.cos(.7)]])assert np.allclose(pairwise_distances(V@Q),dist)unit=V/np.linalg.norm(V,axis=1,keepdims=True)assert np.allclose(pairwise_distances(unit)**2,2-2*sim)print('Más cercano a A por distancia:',nombres[1+np.argmin(dist[0,1:])],'; por coseno:',nombres[1+np.argmax(sim[0,1:])])
objeto
distancia a A
coseno con A
0
B
1.000000
1.000000
1
C
0.223607
0.976187
2
D
2.000000
-1.000000
Más cercano a A por distancia: C ; por coseno: B
18.2.1 Cómo leer este resultado
C está más cerca de A en distancia; B tiene la misma dirección que A. Ninguna medida es universalmente correcta. Si la magnitud representa intensidad útil, normalizar puede borrarla; si representa un efecto de escala irrelevante, conservarla puede distorsionar la búsqueda.
La rotación verificada conserva todas las distancias. Por eso no debemos atribuir un significado fijo a cada eje de un embedding sin evidencia adicional. Una proyección a dos dimensiones facilita inspección, pero puede alterar vecindades.
18.3 Categorías: aprender interacciones y reconocer lo desconocido
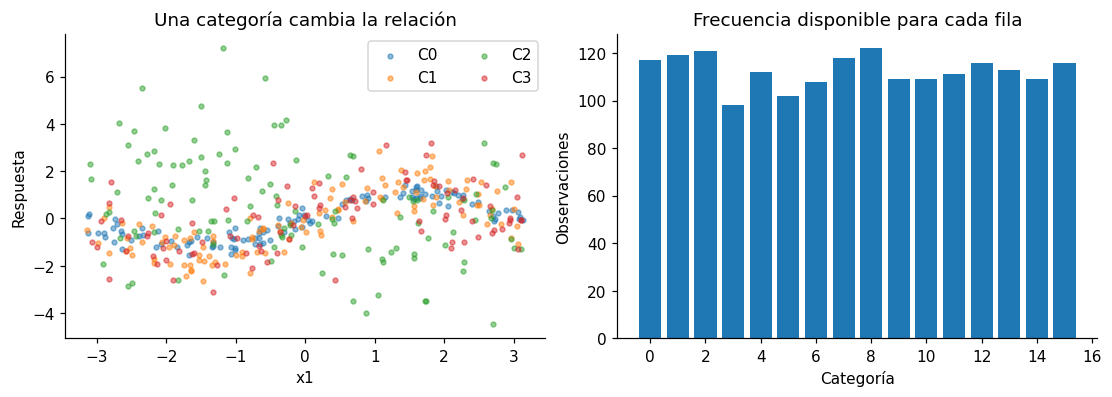
Generamos una respuesta continua con dos entradas numéricas y 16 categorías conocidas. Cada categoría tiene coeficientes propios: y = a_categoria × sin(x1) + b_categoria × x2 + ruido. Es una construcción controlada para observar interacciones.
El vocabulario se ajusta solo con entrenamiento. Reservamos ID 0 para desconocidos y fijamos su vector en cero mediante padding_idx=0. Aquí usamos esa opción para una fila de respaldo; no estamos confundiendo una categoría desconocida con padding de secuencias. Validación y prueba contienen categorías nuevas diferentes. No podremos aprender sus coeficientes sin observaciones o atributos adicionales.
rng=np.random.default_rng(42);coef=rng.uniform(-2,2,size=(20,2))def crear_categorias(n,conocidas=True): c=rng.integers(0,16,n) if conocidas else rng.integers(16,18,n) x=np.column_stack([rng.uniform(-np.pi,np.pi,n),rng.normal(size=n)]) y=coef[c,0]*np.sin(x[:,0])+coef[c,1]*x[:,1]+rng.normal(0,.1,n)return x,c,yxtr,ctr,ytr=crear_categorias(1800)xva,cva,yva=crear_categorias(400);xvu,cvu,yvu=crear_categorias(100,False)xte,cte,yte=crear_categorias(400)xtu=np.column_stack([rng.uniform(-np.pi,np.pi,100),rng.normal(size=100)])ctu=rng.integers(18,20,100);ytu=coef[ctu,0]*np.sin(xtu[:,0])+coef[ctu,1]*xtu[:,1]+rng.normal(0,.1,100)vocab={int(c):i+1for i,c inenumerate(np.unique(ctr))}def codificar(c):return torch.tensor([vocab.get(int(k),0) for k in c],dtype=torch.long)escala=StandardScaler().fit(xtr)def tensores(x,c):return torch.tensor(escala.transform(x),dtype=torch.float32),codificar(c)Ttr=tensores(xtr,ctr);Tva=tensores(xva,cva);Tvu=tensores(xvu,cvu)assertnotset(cvu)&set(ctu) andset(vocab)==set(range(16))display(pd.DataFrame({'partición':['entrenamiento','validación conocida','validación nueva','prueba conocida','prueba nueva'],'n':[1800,400,100,400,100],'categorías':[16,16,2,16,2]}))fig,axs=plt.subplots(1,2,figsize=(10,3.5))for c inrange(4): m=ctr==c;axs[0].scatter(xtr[m,0],ytr[m],s=10,alpha=.5,label=f'C{c}')axs[0].set(xlabel='x1',ylabel='Respuesta',title='Una categoría cambia la relación');axs[0].legend(ncol=2)axs[1].bar(range(16),np.bincount(ctr,minlength=16));axs[1].set(xlabel='Categoría',ylabel='Observaciones',title='Frecuencia disponible para cada fila');plt.show()
partición
n
categorías
0
entrenamiento
1800
16
1
validación conocida
400
16
2
validación nueva
100
2
3
prueba conocida
400
16
4
prueba nueva
100
2
18.3.1 Dimensión, capacidad y criterio de selección
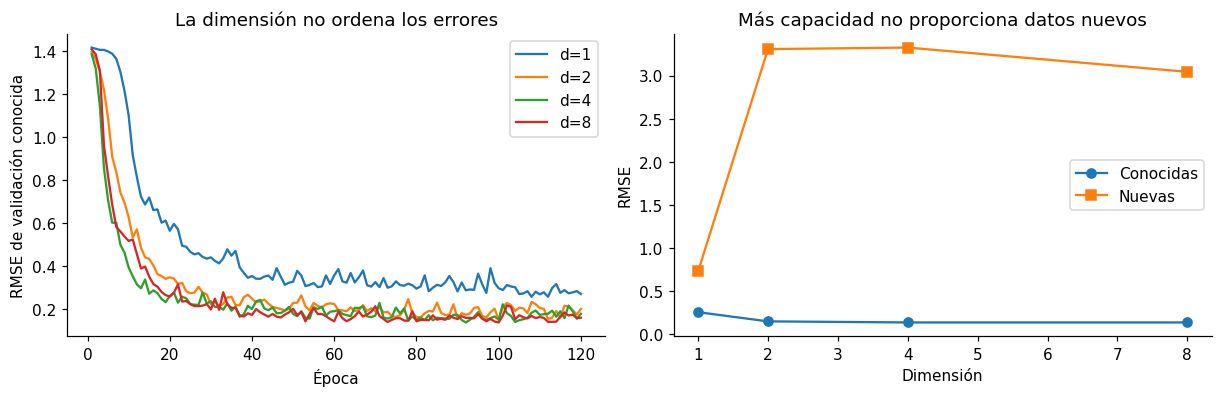
Entrenamos dimensiones 1, 2, 4 y 8 con el mismo predictor, semilla, lotes y 120 épocas. Elegimos cada checkpoint por RMSE de validación en categorías conocidas; después elegimos la dimensión por ese mismo criterio. La validación de categorías nuevas es un diagnóstico de respaldo, no el criterio usado para seleccionar.
La dimensión cambia el número de parámetros y la optimización. Este experimento con una semilla no demuestra que una dimensión sea superior en toda población. Tampoco repetir consultas sobre la misma validación equivale a obtener nuevas evaluaciones independientes.
Ver implementación y registro del experimento
class RegresorEmbedding(nn.Module):def__init__(self,d):super().__init__();self.embedding=nn.Embedding(17,d,padding_idx=0)self.red=nn.Sequential(nn.Linear(d+2,32),nn.Tanh(),nn.Linear(32,32),nn.Tanh(),nn.Linear(32,1))def forward(self,x,c):returnself.red(torch.cat([x,self.embedding(c)],dim=1)).squeeze(1)def predecir_cat(modelo,t): modelo.eval()with torch.no_grad():return modelo(*t).numpy()modelos_cat={};historias_cat={};filas_cat=[]for d in [1,2,4,8]: torch.manual_seed(7);modelo=RegresorEmbedding(d);opt=torch.optim.Adam(modelo.parameters(),lr=.01) loader=DataLoader(TensorDataset(*Ttr,torch.tensor(ytr,dtype=torch.float32)),batch_size=128,shuffle=True,generator=torch.Generator().manual_seed(7)) mejor=np.inf;hist=[]for ep inrange(1,121): modelo.train()for xb,cb,yb in loader: opt.zero_grad();loss=nn.functional.mse_loss(modelo(xb,cb),yb);loss.backward();opt.step() rv=rmse(yva,predecir_cat(modelo,Tva));rt=rmse(ytr,predecir_cat(modelo,Ttr));hist.append((ep,rt,rv))if rv<mejor:mejor=rv;estado=copy.deepcopy(modelo.state_dict());ep_mejor=ep modelo.load_state_dict(estado);modelos_cat[d]=modelo;historias_cat[d]=np.array(hist) filas_cat.append({'dimensión':d,'parámetros':sum(p.numel() for p in modelo.parameters()),'época':ep_mejor,'RMSE conocida':mejor,'RMSE nueva':rmse(yvu,predecir_cat(modelo,Tvu))})tabla_cat=pd.DataFrame(filas_cat);display(tabla_cat)d_cat=int(tabla_cat.loc[tabla_cat['RMSE conocida'].idxmin(),'dimensión']);elegido_cat=modelos_cat[d_cat]assert torch.count_nonzero(elegido_cat.embedding.weight[0])==0fig,axs=plt.subplots(1,2,figsize=(11,3.5))for d,h in historias_cat.items():axs[0].plot(h[:,0],h[:,2],label=f'd={d}')axs[0].set(xlabel='Época',ylabel='RMSE de validación conocida',title='La dimensión no ordena los errores');axs[0].legend()axs[1].plot(tabla_cat['dimensión'],tabla_cat['RMSE conocida'],'o-',label='Conocidas');axs[1].plot(tabla_cat['dimensión'],tabla_cat['RMSE nueva'],'s-',label='Nuevas');axs[1].set(xlabel='Dimensión',ylabel='RMSE',title='Más capacidad no proporciona datos nuevos');axs[1].legend();plt.show()lecturas['cat_dim']=str(d_cat);lecturas['cat_val']=f'{tabla_cat["RMSE conocida"].min():.3f}'
dimensión
parámetros
época
RMSE conocida
RMSE nueva
0
1
1234
108
0.257291
0.730263
1
2
1283
100
0.150637
3.308090
2
4
1381
92
0.138165
3.325704
3
8
1577
100
0.138152
3.044446
18.3.2 Cómo leer este resultado
Se eligió dimensión 8, con RMSE de validación conocida 0.138. Lee las curvas para distinguir aprendizaje, fluctuación y sobreajuste. El mejor checkpoint puede aparecer antes de la última época.
Las categorías nuevas comparten el vector de respaldo. Fijarlo en cero no obliga a que la red produzca la media poblacional: el predictor aún recibe las entradas numéricas, y su respuesta en ese punto depende de lo aprendido con filas conocidas. La curva de categorías nuevas no mejora de forma ordenada al aumentar dimensión. Aumentar la dimensión no informa al modelo sobre sus coeficientes. En una aplicación real conviene agregar atributos del objeto, obtener observaciones, usar un respaldo explícito o abstenerse; crear al azar una fila nueva no resuelve el problema.
18.3.3 Prueba y baselines que explican la ganancia
Comparamos la red elegida con un regresor que omite la categoría y otro con one-hot e interacciones explícitas. El segundo conoce la forma matemática del generador; es un baseline deliberadamente favorable para comprobar si una solución simple basta. Las tres alternativas se fijan antes de consultar prueba.
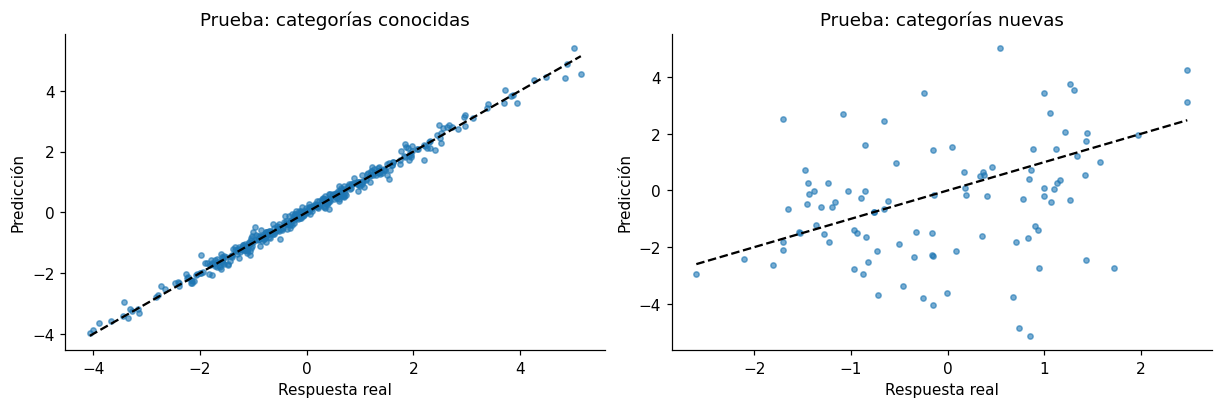
La red obtiene RMSE 0.146 en categorías conocidas y 2.010 en nuevas. El gráfico conserva la misma tarea, pero cambia la información disponible sobre la categoría. La tabla permite contrastar esa brecha con una solución que nunca recibió IDs y con la que incorpora la ecuación del generador.
No es una demostración de superioridad del embedding frente a one-hot. Si las interacciones conocidas resuelven la tarea con menos complejidad, son una alternativa razonable. El embedding resulta útil cuando aprender interacciones compartidas aporta valor bajo el protocolo de evaluación pertinente.
En categorías conocidas, one-hot con las interacciones del generador obtiene RMSE 0.104, menor que 0.146 de la red. En nuevas, el respaldo del embedding también queda por detrás del modelo sin categoría (1.228) y del de interacciones (1.115). Para este generador conservaría la solución con interacciones en conocidos y revisaría por separado el respaldo; la dimensión elegida no justifica usar su vector desconocido sin controles.
18.3.5 Inspeccionar la tabla aprendida
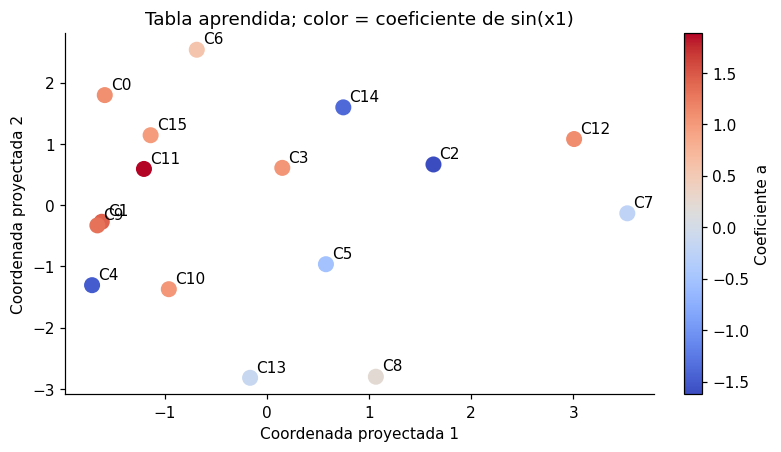
Proyectaremos solo las filas conocidas. El color representa un coeficiente del generador y permite observar una relación posible; no convierte el primer componente en un estimador de ese coeficiente. Si la dimensión elegida es 1, mostramos el eje original con segunda coordenada cero.
E=elegido_cat.embedding.weight.detach().numpy()[1:]proy=PCA(n_components=2).fit_transform(E) if E.shape[1]>1else np.column_stack([E[:,0],np.zeros(16)])fig,ax=plt.subplots(figsize=(7,4));im=ax.scatter(proy[:,0],proy[:,1],c=coef[:16,0],cmap='coolwarm',s=90)for i,z inenumerate(proy):ax.annotate(f'C{i}',z,xytext=(4,4),textcoords='offset points')ax.set(xlabel='Coordenada proyectada 1',ylabel='Coordenada proyectada 2',title='Tabla aprendida; color = coeficiente de sin(x1)');fig.colorbar(im,ax=ax,label='Coeficiente a');plt.show()
18.4 Palabras: un laboratorio pequeño de coocurrencias
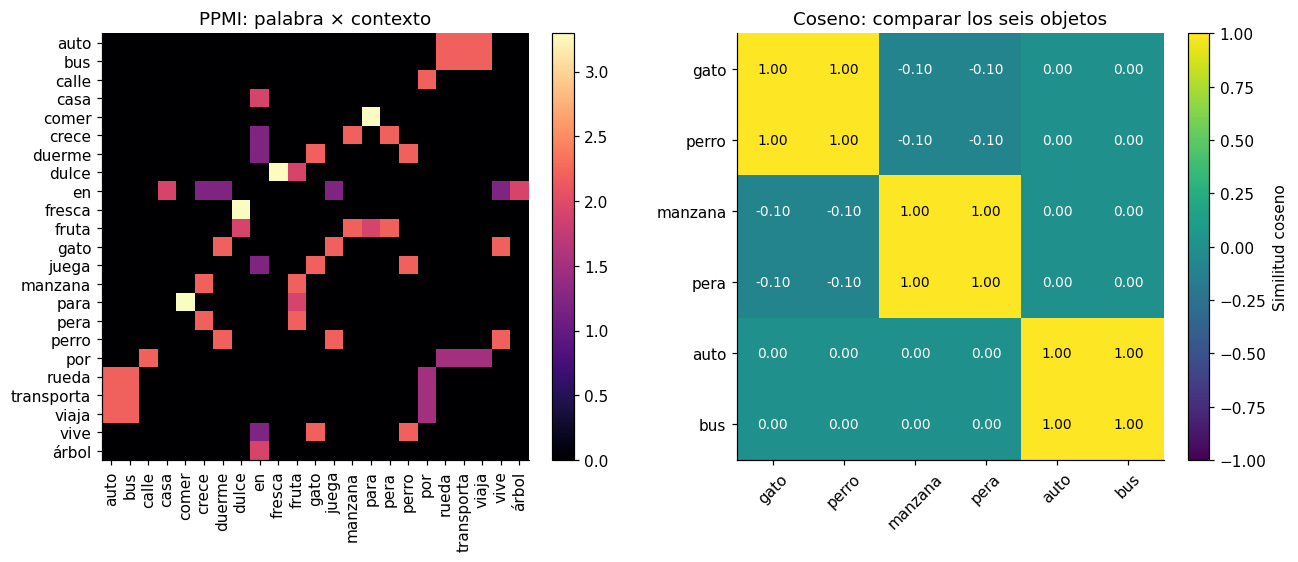
Un embedding de palabras puede obtenerse sin una red. Construiremos un corpus deliberadamente regular, contaremos vecinos inmediatos y calcularemos información mutua puntual positiva:
Una factorización SVD produce una representación de dimensión reducida. Este ejemplo enseña la relación entre contexto y vector; no reproduce el entrenamiento de word2vec ni constituye una evaluación de lenguaje real. El corpus contiene todos los ejemplos disponibles y no tiene una prueba independiente de generalización.
corpus=[]for par,contextos in [(['gato','perro'],['vive en casa','juega en casa','duerme en casa']),(['manzana','pera'],['crece en árbol','fruta para comer','fruta dulce fresca']),(['auto','bus'],['viaja por calle','rueda por calle','transporta por calle'])]:for w in par:for contexto in contextos:corpus.append((w+' '+contexto).split())palabras=sorted({w for frase in corpus for w in frase});indice={w:i for i,w inenumerate(palabras)}C=np.zeros((len(palabras),len(palabras)))for frase in corpus:for j,w inenumerate(frase):for k in [j-1,j+1]:if0<=k<len(frase):C[indice[w],indice[frase[k]]]+=1P=C/C.sum();den=P.sum(1)[:,None]*P.sum(0)[None,:]PPMI=np.zeros_like(P);m=P>0;PPMI[m]=np.maximum(np.log(P[m]/den[m]),0)U,S,VT=np.linalg.svd(PPMI,full_matrices=False);W=U[:,:8]*np.sqrt(S[:8])sim_w=cosine_similarity(W);consultas=['gato','manzana','auto'];vecinos=[]for w in consultas: i=indice[w];orden=np.argsort(-sim_w[i]);orden=orden[orden!=i][:3]for j in orden:vecinos.append({'consulta':w,'vecino':palabras[j],'coseno':sim_w[i,j]})display(pd.DataFrame(vecinos));print('Corpus:',len(corpus),'frases; vocabulario:',len(palabras),'palabras; dimensión:',W.shape[1])fig,axs=plt.subplots(1,2,figsize=(12,5))im=axs[0].imshow(PPMI,cmap='magma');axs[0].set(title='PPMI: palabra × contexto',xticks=range(len(palabras)),xticklabels=palabras,yticks=range(len(palabras)),yticklabels=palabras);axs[0].tick_params(axis='x',rotation=90);fig.colorbar(im,ax=axs[0])objetos=['gato','perro','manzana','pera','auto','bus'];ind=[indice[w] for w in objetos]im2=axs[1].imshow(sim_w[np.ix_(ind,ind)],cmap='viridis',vmin=-1,vmax=1)axs[1].set(title='Coseno: comparar los seis objetos',xticks=range(6),xticklabels=objetos,yticks=range(6),yticklabels=objetos);axs[1].tick_params(axis='x',rotation=45)for i inrange(6):for j inrange(6):axs[1].text(j,i,f'{sim_w[ind[i],ind[j]]:.2f}',ha='center',va='center',fontsize=9,color='black'if sim_w[ind[i],ind[j]]>.5else'white')fig.colorbar(im2,ax=axs[1],label='Similitud coseno');plt.show()
La matriz de cosenos permite identificar las parejas con contextos compartidos sin depender de una proyección a dos dimensiones. Las parejas comparten contextos porque así diseñamos el corpus. La similitud observada demuestra que el procedimiento reconoce esa construcción; no demuestra comprensión ni una geometría estable en textos de otros dominios. La ventana, la frecuencia, la polisemia y los sesgos del corpus pueden cambiar los vecinos.
Una representación estática asigna la misma fila a una palabra en todos los contextos. Los modelos contextuales construyen una representación que depende de la secuencia. Ese cambio se desarrolla en Atención y transformers; tokenización avanzada y aplicaciones lingüísticas pertenecen al libro de NLP.
18.4.2 Secuencias, padding y pooling
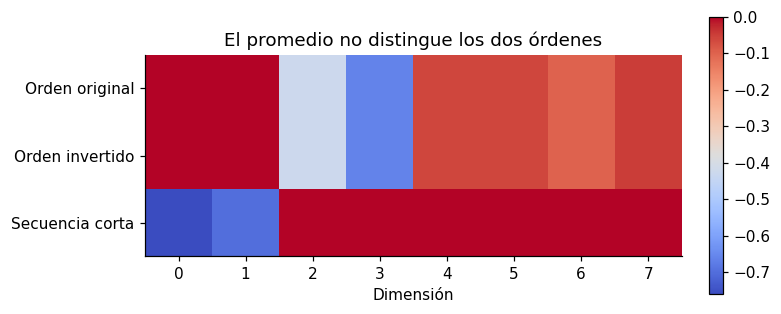
Una secuencia de IDs con forma (N,L) se convierte en (N,L,d). Promediar sobre posiciones conserva una representación fija, pero pierde el orden. Excluir padding requiere una máscara obtenida de longitudes o del token reservado. Si contamos el padding en el denominador, el vector cambia al agregar posiciones vacías.
frases=[['gato','vive','en','casa'],['casa','en','vive','gato'],['auto','viaja']]vocab_w={w:i+1for i,w inenumerate(palabras)}emb_w=nn.Embedding.from_pretrained(torch.tensor(np.vstack([np.zeros((1,8)),W]),dtype=torch.float32),freeze=True,padding_idx=0)secuencias=[torch.tensor([vocab_w[w] for w in frase]) for frase in frases]ids_pad=pad_sequence(secuencias,batch_first=True,padding_value=0);mascara=ids_pad.ne(0)vectores=emb_w(ids_pad);pool=(vectores*mascara.unsqueeze(-1)).sum(1)/mascara.sum(1,keepdim=True)assert torch.allclose(pool[0],pool[1]);ingenuo=vectores.mean(1)print('IDs:',tuple(ids_pad.shape),'→ vectores:',tuple(vectores.shape),'→ pooling:',tuple(pool.shape))display(pd.DataFrame({'frase':[' '.join(f) for f in frases],'longitud':mascara.sum(1).numpy(),'norma correcta':pool.norm(dim=1).numpy(),'norma contando padding':ingenuo.norm(dim=1).numpy()}))fig,ax=plt.subplots(figsize=(7,2.8));im=ax.imshow(pool.numpy(),cmap='coolwarm');ax.set(yticks=range(3),yticklabels=['Orden original','Orden invertido','Secuencia corta'],xlabel='Dimensión',title='El promedio no distingue los dos órdenes');fig.colorbar(im,ax=ax);plt.show()
18.5 Imágenes: reconstruir, clasificar y recuperar son tareas distintas
Usamos load_digits: 1797 imágenes de 8×8 píxeles con intensidades de 0 a 16. Dividir por 16 aplica una escala documentada; no estima estadísticas de evaluación. Separamos entrenamiento, validación y prueba con estratificación, pero la partición aleatoria no garantiza separación por escritor ni estima transferencia a otro dominio.
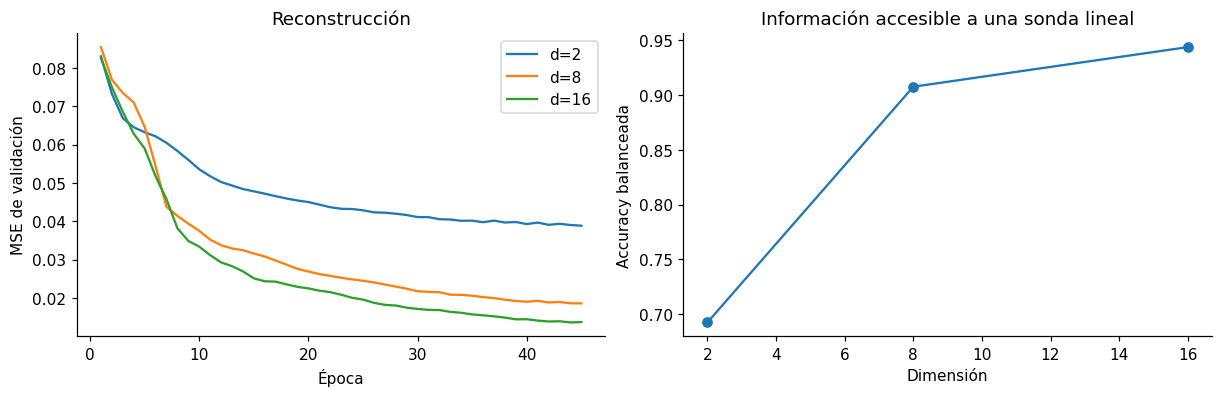
Un autoencoder aprenderá códigos de dimensiones 2, 8 y 16 sin recibir etiquetas. El checkpoint de cada uno se elige por MSE de reconstrucción en validación. Luego congelamos los códigos y ajustamos una regresión logística con etiquetas de entrenamiento: es una sonda lineal. Elegimos la dimensión por accuracy balanceada de validación de la sonda. Las etiquetas intervienen en esa selección, aunque no en el entrenamiento del autoencoder.
Finalmente evaluamos la representación elegida y un baseline de píxeles. Ambos tienen su escalador ajustado solo con entrenamiento. La reconstrucción puede mejorar sin facilitar clasificación: son objetivos diferentes.
Ver implementación y registro del experimento
digits=load_digits();imagenes=digits.data.astype('float32')/16;etiquetas=digits.targetitr,rest=train_test_split(np.arange(len(imagenes)),test_size=.4,stratify=etiquetas,random_state=42)iva,ite=train_test_split(rest,test_size=.5,stratify=etiquetas[rest],random_state=42)A=[torch.tensor(imagenes[i]) for i in [itr,iva,ite]]class Autoencoder(nn.Module):def__init__(self,d):super().__init__();self.encoder=nn.Sequential(nn.Linear(64,32),nn.ReLU(),nn.Linear(32,d))self.decoder=nn.Sequential(nn.Linear(d,32),nn.ReLU(),nn.Linear(32,64),nn.Sigmoid())def forward(self,x):returnself.decoder(self.encoder(x))def codigos(modelo,x): modelo.eval()with torch.no_grad():return modelo.encoder(x).numpy()ae_modelos={};sondas={};filas_ae=[];hist_ae={}for d in [2,8,16]: torch.manual_seed(11);ae=Autoencoder(d);opt=torch.optim.Adam(ae.parameters(),lr=.01) loader=DataLoader(TensorDataset(A[0]),batch_size=128,shuffle=True,generator=torch.Generator().manual_seed(11)) mejor=np.inf;h=[]for ep inrange(1,46): ae.train()for (xb,) in loader:opt.zero_grad();loss=nn.functional.mse_loss(ae(xb),xb);loss.backward();opt.step() ae.eval()with torch.no_grad():rv=float(nn.functional.mse_loss(ae(A[1]),A[1]));rt=float(nn.functional.mse_loss(ae(A[0]),A[0])) h.append((ep,rt,rv))if rv<mejor:mejor=rv;estado=copy.deepcopy(ae.state_dict());mejor_ep=ep ae.load_state_dict(estado);ae_modelos[d]=ae;hist_ae[d]=np.array(h) sonda=make_pipeline(StandardScaler(),LogisticRegression(C=1,max_iter=2000)).fit(codigos(ae,A[0]),etiquetas[itr]);sondas[d]=sonda bal=balanced_accuracy_score(etiquetas[iva],sonda.predict(codigos(ae,A[1]))) filas_ae.append({'dimensión':d,'parámetros AE':sum(p.numel() for p in ae.parameters()),'época':mejor_ep,'MSE reconstrucción validación':mejor,'accuracy balanceada sonda validación':bal})tabla_ae=pd.DataFrame(filas_ae);display(tabla_ae)d_img=int(tabla_ae.loc[tabla_ae['accuracy balanceada sonda validación'].idxmax(),'dimensión']);ae=ae_modelos[d_img];sonda=sondas[d_img]fig,axs=plt.subplots(1,2,figsize=(11,3.5))for d,h in hist_ae.items():axs[0].plot(h[:,0],h[:,2],label=f'd={d}')axs[0].set(xlabel='Época',ylabel='MSE de validación',title='Reconstrucción');axs[0].legend()axs[1].plot(tabla_ae['dimensión'],tabla_ae['accuracy balanceada sonda validación'],'o-');axs[1].set(xlabel='Dimensión',ylabel='Accuracy balanceada',title='Información accesible a una sonda lineal');plt.show()lecturas['img_dim']=str(d_img)
dimensión
parámetros AE
época
MSE reconstrucción validación
accuracy balanceada sonda validación
0
2
4354
45
0.038827
0.692381
1
8
4744
45
0.018574
0.907698
2
16
5264
44
0.013599
0.943889
18.5.1 Cómo leer este resultado
La selección por clasificación elige dimensión 16. Compara las dos gráficas antes de atribuir utilidad al código: un menor error de píxel no es una medida de separación de clases. La sonda también tiene límites: un código útil para un clasificador no lineal puede recibir una puntuación modesta con una sonda lineal.
18.5.2 Inspección visual y evaluación reservada
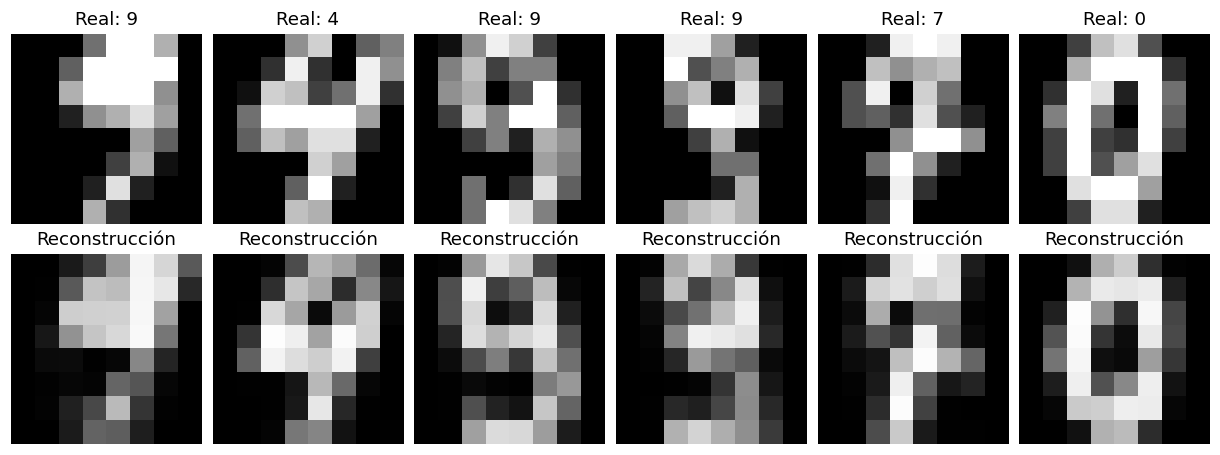
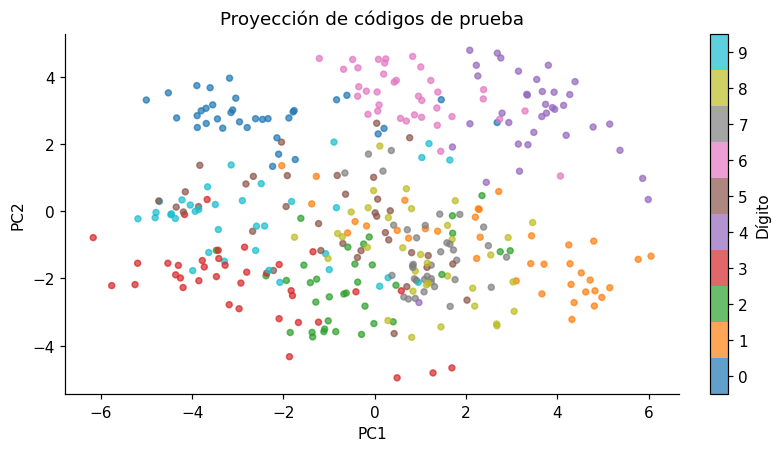
Mostramos seis imágenes de prueba fijadas por su posición, sin escoger las reconstrucciones más favorables. La proyección PCA se ajusta en códigos de entrenamiento y solo transforma prueba. Los colores son etiquetas para interpretar, no entradas del autoencoder.
Ztr=codigos(ae,A[0]);Zte=codigos(ae,A[2])pixel=make_pipeline(StandardScaler(),LogisticRegression(C=1,max_iter=2000)).fit(imagenes[itr],etiquetas[itr])res_img=[]for nombre,p in [('Píxeles + sonda lineal',pixel.predict(imagenes[ite])),('Embedding + sonda lineal',sonda.predict(Zte))]: res_img.append({'caso':'imágenes','grupo':'prueba','modelo':nombre,'métrica':'accuracy balanceada','valor':balanced_accuracy_score(etiquetas[ite],p)})display(pd.DataFrame(res_img))with torch.no_grad():recon=ae(A[2]).numpy()fig,axs=plt.subplots(2,6,figsize=(11,4))for j inrange(6): axs[0,j].imshow(imagenes[ite[j]].reshape(8,8),cmap='gray',vmin=0,vmax=1);axs[0,j].set_title(f'Real: {etiquetas[ite[j]]}') axs[1,j].imshow(recon[j].reshape(8,8),cmap='gray',vmin=0,vmax=1);axs[1,j].set_title('Reconstrucción') axs[0,j].axis('off');axs[1,j].axis('off')plt.show()pca=PCA(n_components=2).fit(Ztr);proy=pca.transform(Zte)fig,ax=plt.subplots(figsize=(7,4));im=ax.scatter(proy[:,0],proy[:,1],c=etiquetas[ite],cmap='tab10',vmin=-.5,vmax=9.5,s=15,alpha=.7);ax.set(xlabel='PC1',ylabel='PC2',title='Proyección de códigos de prueba');fig.colorbar(im,ax=ax,ticks=range(10),label='Dígito');plt.show()lecturas['img_test']=f'{res_img[1]["valor"]:.3f}';lecturas['img_pixel']=f'{res_img[0]["valor"]:.3f}'
caso
grupo
modelo
métrica
valor
0
imágenes
prueba
Píxeles + sonda lineal
accuracy balanceada
0.963642
1
imágenes
prueba
Embedding + sonda lineal
accuracy balanceada
0.927505
18.5.3 Cómo leer este resultado
La sonda sobre embeddings alcanza accuracy balanceada 0.928; el baseline de píxeles alcanza 0.964. Esta comparación incorpora la información descartada por la compresión y el objetivo de reconstrucción. En esta ejecución gana el baseline de píxeles por aproximadamente 3.6 puntos porcentuales. El código de 16 dimensiones reduce la entrada a una cuarta parte, pero esa compresión tiene un costo de clasificación en esta prueba; no se justifica presentarla como una mejora de precisión.
PCA muestra solo dos componentes. Clases que se superponen en la figura pueden separarse en dimensiones descartadas, y grupos visuales no prueban por sí solos utilidad predictiva. Las reconstrucciones revelan detalles borrados y trazos suavizados que una media de MSE oculta.
18.6 Recuperación: vecinos con referencias separadas
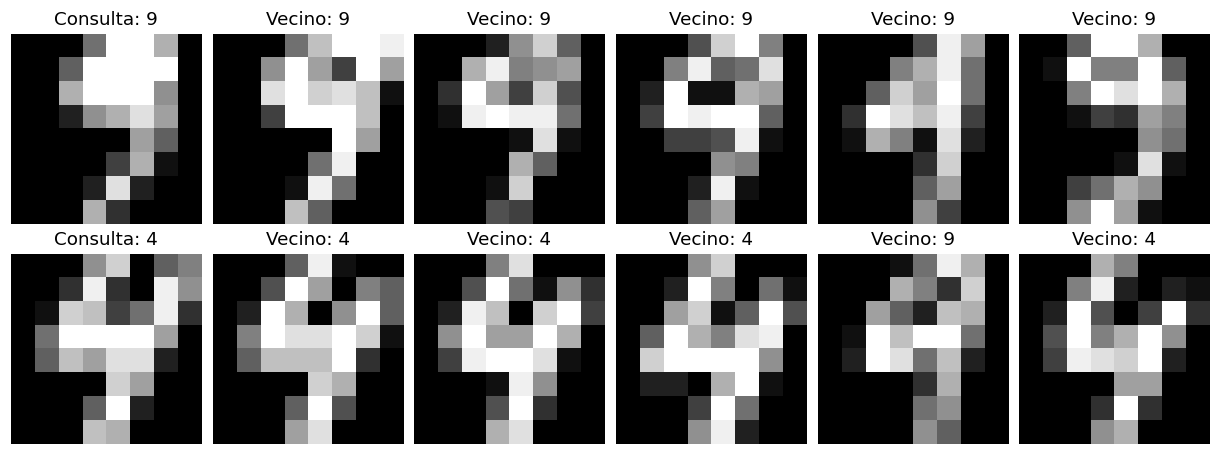
Cada consulta de prueba busca cinco vecinos únicamente entre imágenes de entrenamiento. Fijamos k=5 antes de consultar las etiquetas de prueba. Comparamos distancia euclídea y coseno como diagnóstico declarado; no elegimos retrospectivamente una medida a partir de esta prueba.
La precisión@5 es la proporción de referencias que comparten el dígito de la consulta, promediada sobre consultas. No es accuracy de clasificación ni recall. El uso de etiquetas define qué consideramos relevante; en una búsqueda por estilo de escritura el criterio podría ser distinto.
assert np.all(np.linalg.norm(Ztr,axis=1)>0) and np.all(np.linalg.norm(Zte,axis=1)>0)vecinos_img={};res_rec=[]for medida in ['euclidean','cosine']: distancias=pairwise_distances(Zte,Ztr,metric=medida);nn_idx=np.argsort(distancias,axis=1)[:,:5];vecinos_img[medida]=nn_idx precision=float(np.mean(etiquetas[itr][nn_idx]==etiquetas[ite,None])) res_rec.append({'caso':'recuperación','grupo':'prueba','modelo':medida,'métrica':'precisión@5','valor':precision})display(pd.DataFrame(res_rec))fig,axs=plt.subplots(2,6,figsize=(11,4))for fila,q inenumerate([0,1]): axs[fila,0].imshow(imagenes[ite[q]].reshape(8,8),cmap='gray',vmin=0,vmax=1);axs[fila,0].set_title(f'Consulta: {etiquetas[ite[q]]}');axs[fila,0].axis('off')for j,r inenumerate(vecinos_img['euclidean'][q],start=1): axs[fila,j].imshow(imagenes[itr[r]].reshape(8,8),cmap='gray',vmin=0,vmax=1);axs[fila,j].set_title(f'Vecino: {etiquetas[itr[r]]}');axs[fila,j].axis('off')plt.show()resultados=pd.concat([res_cat,pd.DataFrame(res_img),pd.DataFrame(res_rec)],ignore_index=True);resultados.to_csv('resultados.csv',index=False)lecturas['rec_e']=f'{res_rec[0]["valor"]:.3f}';lecturas['rec_c']=f'{res_rec[1]["valor"]:.3f}'protocolo={'semilla':42,'categorias':{'dimension':d_cat,'seleccion':'RMSE de validación conocida','desconocido':0},'imagenes':{'dimension':d_img,'seleccion':'accuracy balanceada de sonda en validación','train':itr.tolist(),'validacion':iva.tolist(),'prueba':ite.tolist()},'recuperacion':{'k':5,'referencias':'solo entrenamiento','medidas':['euclidean','cosine']},'versiones':{'numpy':np.__version__,'sklearn':sklearn.__version__,'torch':torch.__version__}}Path('protocolo.json').write_text(json.dumps(protocolo,ensure_ascii=False,indent=2),encoding='utf-8')
caso
grupo
modelo
métrica
valor
0
recuperación
prueba
euclidean
precisión@5
0.938333
1
recuperación
prueba
cosine
precisión@5
0.935556
20987
18.6.1 Cómo leer este resultado
La precisión@5 es 0.938 con distancia euclídea y 0.936 con coseno. Una diferencia indica que magnitud y orientación ordenan vecinos de manera distinta. Las dos primeras consultas muestran qué aspecto tienen esos vecinos; la tabla usa todas las consultas y evita concluir a partir de dos ejemplos.
Las consultas comparten las mismas referencias y proceden de una única partición. Estas cifras son descriptivas de este experimento; no justifican afirmar una superioridad general ni estimar confianza tratando cada vecino como una observación independiente.
18.7 Decisiones que debe sostener la representación
Evidencia
Interpretación posible
Decisión o comprobación
Buen error en conocidos y malo en nuevos
Falta información sobre objetos nuevos
Atributos adicionales y política de respaldo
Más dimensiones sin mejor validación
Capacidad o detalle innecesario para la tarea
Preferir dimensión pequeña tras repetir semillas
Reconstrucción buena y sonda débil
El objetivo conserva píxeles sin separar etiquetas
Revisar objetivo o evaluar otra sonda
PCA atractiva y métricas pobres
La proyección es una vista parcial
Medir en el espacio original
Vecinos cambian al normalizar
La magnitud influye en el ranking
Definir relevancia y validar distancia
Pooling confunde órdenes
Se descartó estructura secuencial
Encoder de secuencias o atención
Un embedding reutilizable debe viajar con su vocabulario, transformación de entrada, dimensión, versión y reglas para desconocidos. En representaciones entrenadas con etiquetas también hay que registrar qué tarea definió su geometría. La transferencia se valida con datos de la nueva tarea.
18.7.1 Qué actualiza el entrenamiento y qué puede transferirse
Una consulta a la tabla devuelve filas; al retropropagar, las categorías presentes en el lote reciben gradientes de ese uso. Categorías frecuentes suelen acumular más oportunidades de actualización. El gradiente procede de la tarea: dos IDs pueden acercarse porque permiten predicciones parecidas, aunque representen objetos distintos en otro contexto. La frecuencia y la regularización deben analizarse junto con la geometría.
Representación
Cómo se obtiene
Qué se conserva al reutilizarla
Tabla de categorías
Supervisión de una tarea y vocabulario de IDs
Tabla, vocabulario, significado de IDs y respaldo
Palabras estáticas
Contextos o un objetivo lingüístico
Vocabulario, segmentación y convenciones de consulta
Secuencias contextuales
Encoder que usa la secuencia completa o su pasado
Encoder, tokenización, máscara y regla de pooling
Imágenes
Reconstrucción, supervisión o contraste
Encoder, escala, tamaño, canales y transformación
Congelar un encoder mantiene sus parámetros, pero no garantiza utilidad en otro dominio. Ajustarlo modifica su geometría: referencias almacenadas para búsqueda pueden quedar incompatibles con consultas nuevas. En un índice de recuperación hay que conservar la versión del encoder y regenerar referencias cuando corresponda.
Para una tabla con un millón de objetos y 64 coordenadas float32, solo las entradas de la tabla requieren 256 MB decimales; gradientes y estado del optimizador añaden memoria. Esta cuenta no incluye el resto de la red. La dimensión se decide considerando utilidad, costo y estabilidad, no mediante una fórmula universal.
18.8 Actividades de análisis
Repite el experimento categórico con frecuencias muy desiguales. Compara error por categoría y tamaño de muestra antes de aumentar dimensión.
Cambia el respaldo de desconocidos y define una validación con categorías completamente nuevas. Explica qué información habilita cada opción.
Introduce una palabra en dos familias de contextos del corpus. Observa sus vecinos y distingue polisemia de ruido.
Evalúa una sonda no lineal sobre los códigos de imagen sin modificar el autoencoder. Selecciona con validación y reserva una prueba nueva si ya inspeccionaste esta.
Compara recuperación por dígito y por estilo. Define etiquetas de relevancia antes de elegir una distancia.
18.9 Contrato común y persistencia
Los índices de vocabulario, desconocidos y padding forman parte de la entrada. Un embedding es un parámetro aprendido, no una distancia semántica certificada. Se conservan tareas y particiones del capítulo, y las visualizaciones se interpretan como diagnósticos de esta muestra.
Esta ejecución conserva el desarrollo didáctico y las recetas del capítulo. El cierre registra entorno, tablas y pesos en artefactos_pytorch/. Los estados serializados se recargan en una copia de la arquitectura y se comprueba identidad de parámetros y buffers; esa comprobación de persistencia no sustituye una evaluación de inferencia ni demuestra calidad predictiva. Los pesos guardados no incluyen todos los estados necesarios para reanudar exactamente el experimento.
from pathlib import Pathimport json,hashlib,copy,shutil,platformimport torchartefactos_cierre=Path('artefactos_pytorch');artefactos_cierre.mkdir(exist_ok=True)modulos_cierre=[];vistos_cierre=set()for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,torch.nn.Module) andid(objeto_cierre) notin vistos_cierre: vistos_cierre.add(id(objeto_cierre));estado_cierre={k:v.detach().cpu().clone() for k,v in objeto_cierre.state_dict().items()}assertall(torch.isfinite(v).all() for v in estado_cierre.values() if v.is_floating_point()),nombre_cierre ruta_cierre=artefactos_cierre/f'{nombre_cierre}-estado.pt';torch.save({'state_dict':estado_cierre},ruta_cierre) copia_cierre=copy.deepcopy(objeto_cierre).cpu();copia_cierre.load_state_dict(torch.load(ruta_cierre,map_location='cpu',weights_only=True)['state_dict'])assertall(torch.equal(v.cpu(),estado_cierre[k]) for k,v in copia_cierre.state_dict().items()) modulos_cierre.append({'variable':nombre_cierre,'clase':type(objeto_cierre).__name__,'parametros':sum(p.numel() for p in objeto_cierre.parameters()),'recarga_estado':True})for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,pd.DataFrame) andlen(objeto_cierre)<100000:objeto_cierre.to_csv(artefactos_cierre/f'tabla-{nombre_cierre}.csv',index=False)for ruta_cierre inlist(Path('.').iterdir()):if ruta_cierre.is_file() and ruta_cierre.suffix in ['.csv','.json','.joblib']:shutil.copy2(ruta_cierre,artefactos_cierre/ruta_cierre.name)registro_cierre={'python':platform.python_version(),'torch':str(torch.__version__),'numpy':np.__version__,'sklearn':sklearn.__version__,'modulos':modulos_cierre,'alcance':'identidad de parámetros/buffers al recargar; no reanudación completa','archivos':{p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in artefactos_cierre.iterdir() if p.is_file()}}(artefactos_cierre/'cierre-armonizacion.json').write_text(json.dumps(registro_cierre,ensure_ascii=False,indent=2),encoding='utf-8')print('Estados recargados y verificados:',len(modulos_cierre),'| archivos registrados:',len(registro_cierre['archivos']))
Estados recargados y verificados: 4 | archivos registrados: 10
18.9.1 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
En categorías conocidas, embedding+MLP obtuvo RMSE 0,1462 frente a 0,1044 de one-hot con interacciones; en categorías nuevas, 2,0105 frente a 1,1147 y 1,2285 de la referencia sin categoría. El embedding no aseguró ventaja ni una salida útil para IDs nuevos. En imágenes, la sonda sobre píxeles alcanzó exactitud balanceada 0,9636 y la del embedding 0,9275. Recuperación precisión@5 fue 0,9383 euclídea y 0,9356 coseno. Se conserva el desarrollo sobre geometría y representaciones sin atribuir significado semántico universal a distancias o PCA.
La armonización verificó identidad de parámetros y buffers tras recarga de 4 módulos presentes al cierre; archivó 10 archivos con SHA-256. Esta prueba no incluye reanudación exacta del optimizador ni sustituye las evaluaciones predictivas del capítulo.