25  Aprendizaje autosupervisado

Serie Deep Learning · del perceptrón a los transformers.

Una tarea pretexto construye su objetivo desde el propio dato. Estudiaremos rotación y contraste entre dos vistas, y evaluaremos sus representaciones con un clasificador lineal y pocas etiquetas. Reducir la pérdida pretexto no garantiza mejorar la tarea final: esa relación se mide, no se presupone.

25.1 1. Entorno y protocolo

Usamos PyTorch para el backbone y las tareas pretexto. Se conserva la regresión logística de scikit-learn como linear probe, porque su función es medir separabilidad con una regla lineal, no reemplazar la red principal. Los helpers quedan plegados. La ejecución registrada es CPU y usa una semilla por configuración.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}

25.2 2. Digits y separación antes de crear vistas

Conservamos las 1 797 imágenes Digits, su ampliación 8×8→32×32 por repetición y el test histórico del 20 % de una permutación con semilla 0. Ampliar no añade detalle. Del desarrollo se reservan imágenes originales completas para validación pretexto: las cuatro rotaciones de una imagen nunca se reparten entre train y val.

El original mezclaba las vistas rotadas antes de separar validación. Corregir esa dependencia modifica el protocolo. Las etiquetas de dígito no se usan para el gradiente pretexto; se reservan para el probe, sus diagnósticos y el dibujo de clases. El test histórico ya se había observado antes: esta etapa no lo convierte en evaluación externa nunca consultada.

from sklearn.datasets import load_digits
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.decomposition import PCA
from sklearn.metrics import silhouette_score
d=load_digits();x=np.kron(d.images,np.ones((4,4))).astype(np.float32)[:,None]/16;y=d.target
orden=np.random.default_rng(0).permutation(len(y));corte=int(.8*len(y));dev=orden[:corte];ite=orden[corte:]
p=np.random.default_rng(42).permutation(len(dev));corte_val=int(.85*len(dev));itr=dev[p[:corte_val]];iva=dev[p[corte_val:]]
assert not(set(itr)&set(iva) or set(itr)&set(ite) or set(iva)&set(ite))
np.savez_compressed(ARTEFACTOS/'particiones.npz',train=itr,val=iva,test=ite)
print('Imágenes originales train/val/test:',len(itr),len(iva),len(ite))
class Backbone(nn.Module):
    def __init__(self):
        super().__init__();self.capas=nn.Sequential(nn.Conv2d(1,16,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Conv2d(16,32,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Conv2d(32,64,3,padding=1),nn.ReLU(),nn.AdaptiveAvgPool2d(1),nn.Flatten())
    def forward(self,x):return self.capas(x)
semilla();base=inicializar(Backbone());brot=copy.deepcopy(base);bcon=copy.deepcopy(base)
assert all(torch.equal(base.state_dict()[k],brot.state_dict()[k]) and torch.equal(base.state_dict()[k],bcon.state_dict()[k]) for k in base.state_dict())
print('Embedding 64; pesos iniciales de los tres backbones iguales')
Imágenes originales train/val/test: 1221 216 360
Embedding 64; pesos iniciales de los tres backbones iguales

25.2.1 De dónde sale la supervisión cuando no hay etiquetas de clase

«Sin etiquetas humanas» no significa «sin objetivo». En rotación elegimos una transformación y conocemos cuál aplicamos. En contraste conocemos qué dos vistas proceden del mismo original. Esa información supervisa una tarea construida por nosotros, aunque no indique si el objeto es un tres o un ocho.

Separamos tres funciones: el backbone \(h=f_\theta(x)\) produce la representación; una cabeza o proyector \(z=g_\phi(h)\) adapta esa representación a la tarea pretexto; un evaluador posterior mide su utilidad para otra tarea. Minimizar la pérdida de rotación prueba ajuste a orientación. El probe posterior pregunta si la representación facilita reconocer dígitos. Las respuestas pueden diferir.

La elección de vistas define qué diferencias intentamos ignorar. Dos recortes que eliminan todo el objeto no forman necesariamente una pareja útil. Rotar un seis puede parecer un nueve. Una invariancia útil para reconocer textura puede ser perjudicial para distinguir orientación. Por eso la política de aumentación forma parte de la hipótesis científica, no de un preprocesamiento neutro.

25.3 3. Tarea pretexto de rotación

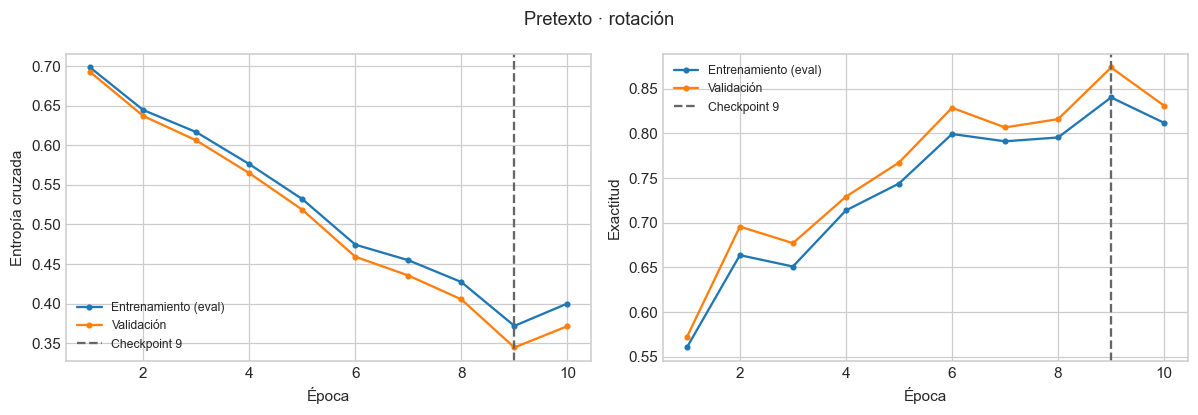
Cada imagen produce cuatro objetivos de orientación: 0°,90°,180°,270°. Conservamos diez épocas, lote 32 y Adam 0,001, seleccionando el checkpoint por CE de validación. Que un dígito sea simétrico o cambie de apariencia al girar puede dificultar este objetivo; la utilidad para clasificar dígitos debe medirse por separado.

Se conserva el identificador de fuente junto con cada rotación. Así el diagnóstico por dígito no mezcla etiquetas después de un barajado. Adivinar una orientación puede ser útil en otros contextos; aquí es un objetivo auxiliar para aprender la representación.

def rotaciones(indices):
    imagenes=[];angulos=[];fuentes=[]
    for j in indices:
        for k in range(4):imagenes.append(np.rot90(x[j],k,axes=(-2,-1)).copy());angulos.append(k);fuentes.append(j)
    return np.stack(imagenes),np.array(angulos),np.array(fuentes)
xr,yr,ir=rotaciones(itr);xv,yv,iv=rotaciones(iva)
rot=nn.Sequential(brot,nn.Linear(64,4)).to(DEVICE);nn.init.xavier_uniform_(rot[1].weight);nn.init.zeros_(rot[1].bias)
hr,rr=entrenar(rot,conjunto(xr,yr),conjunto(xv,yv),10,lote=32,nombre='rotacion');curvas(hr,'Pretexto · rotación',rr['mejor_epoca']);lectura(hr,rr)
xrt,yrt,irt=rotaciones(ite);rt=evaluar(rot,conjunto(xrt,yrt));aciertos=rt['logits'].argmax(1)==yrt
assert np.array_equal(y[irt],np.repeat(y[ite],4))
display(pd.DataFrame([{'digito':i,'n_rotaciones':int((y[irt]==i).sum()),'exactitud_rotacion':float(aciertos[y[irt]==i].mean())} for i in range(10)]))
rotacion 1/10: CE val=0.6926, acc val=0.5718
rotacion 2/10: CE val=0.6371, acc val=0.6956
rotacion 3/10: CE val=0.6061, acc val=0.6771
rotacion 4/10: CE val=0.5648, acc val=0.7292
rotacion 5/10: CE val=0.5185, acc val=0.7674
rotacion 6/10: CE val=0.4591, acc val=0.8287
rotacion 7/10: CE val=0.4354, acc val=0.8067
rotacion 8/10: CE val=0.4052, acc val=0.8160
rotacion 9/10: CE val=0.3444, acc val=0.8738
rotacion 10/10: CE val=0.3713, acc val=0.8310

Lectura del experimento. Se ejecutaron 10 épocas; el checkpoint seleccionado por CE de validación corresponde a la época 9, con CE 0.3444. Al cierre, la brecha de exactitud train−val es -1.92 puntos porcentuales. Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.

digito n_rotaciones exactitud_rotacion
0 0 156 0.724359
1 1 148 0.851351
2 2 188 0.893617
3 3 112 0.937500
4 4 168 0.815476
5 5 128 0.632812
6 6 148 0.831081
7 7 108 0.944444
8 8 120 0.800000
9 9 164 0.987805

25.4 4. Dos vistas y NT-Xent

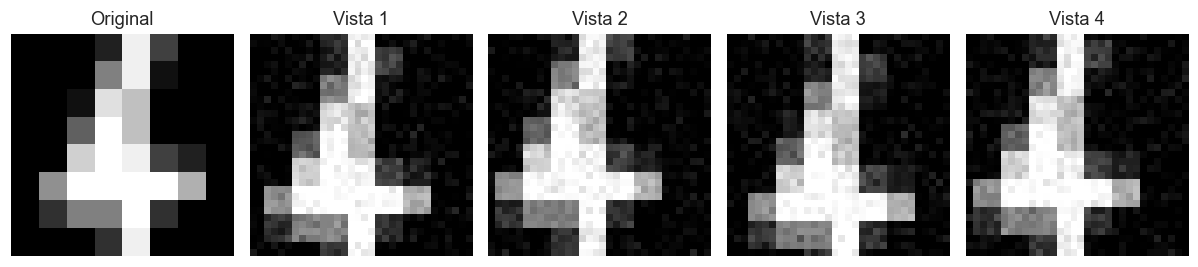
Conservamos ruido gaussiano 0,05 y desplazamientos enteros de −3…3 con roll. Es desplazamiento circular: el contenido reaparece por el otro borde. La hipótesis es que ambas vistas mantengan suficiente identidad; no se garantiza para cualquier transformación.

El backbone produce 64 valores; el proyector 64→32 ReLU→16 se utiliza sólo para el objetivo contrastivo. Normalizamos su salida y calculamos similitud coseno. Con \(B\) originales hay \(2B\) vistas: la pareja positiva está a distancia B en el arreglo concatenado; la diagonal propia se excluye. Otros originales pueden pertenecer al mismo dígito: son negativos de instancia, no necesariamente de clase. La temperatura 0,3 modifica la escala de los scores, no la cantidad de negativos.

def aumentar(img,rng):
    desplazamiento=rng.integers(-3,4,size=2)
    return np.clip(np.roll(img,desplazamiento,axis=(-2,-1))+rng.normal(0,.05,img.shape).astype(np.float32),0,1)
fig,axes=plt.subplots(1,5,figsize=(11,2.6));rng=np.random.default_rng(2)
for i,ax in enumerate(axes):ax.imshow(x[itr[3],0] if i==0 else aumentar(x[itr[3]],rng)[0],cmap='gray');ax.set_title('Original' if i==0 else f'Vista {i}');ax.axis('off')
fig.tight_layout();plt.show()
class Contrastivo(nn.Module):
    def __init__(self,b):super().__init__();self.backbone=b;self.proyector=nn.Sequential(nn.Linear(64,32),nn.ReLU(),nn.Linear(32,16))
    def forward(self,x):return self.proyector(self.backbone(x))
con=Contrastivo(bcon).to(DEVICE)
def ntxent(z,temperatura=.3):
    n=len(z);assert n%2==0 and n>=4;z=F.normalize(z,dim=1)
    scores=z@z.T/temperatura;scores=scores.masked_fill(torch.eye(n,dtype=torch.bool,device=z.device),float('-inf'))
    positivos=(torch.arange(n,device=z.device)+n//2)%n
    return F.cross_entropy(scores,positivos)
control=torch.tensor([[1.,0],[0,1],[1,0],[0,1]],device=DEVICE)
np.testing.assert_allclose(float(ntxent(control)),np.log(1+2*np.exp(-1/.3)),rtol=1e-5)
def vistas(indices,seed):
    rng=np.random.default_rng(seed)
    return np.stack([aumentar(x[j],rng) for j in indices]),np.stack([aumentar(x[j],rng) for j in indices])
av,bv=vistas(iva,22);val_dl=DataLoader(TensorDataset(torch.from_numpy(av),torch.from_numpy(bv)),batch_size=32,shuffle=False,drop_last=True)
@torch.inference_mode()
def medir_contrastivo(m):
    m.eval();valores=[]
    for a,b in val_dl:valores.append(float(ntxent(m(torch.cat([a,b]).to(DEVICE)))))
    return float(np.mean(valores))
opt=torch.optim.Adam(con.parameters(),lr=.001);rng=np.random.default_rng(3);hist=[];mejor=float('inf');inicio=time.perf_counter()
for ep in range(1,9):
    con.train();indices=rng.permutation(itr);perdidas=[]
    for inicio_lote in range(0,len(indices)-31,32):
        ids=indices[inicio_lote:inicio_lote+32];a=np.stack([aumentar(x[j],rng) for j in ids]);b=np.stack([aumentar(x[j],rng) for j in ids])
        opt.zero_grad(set_to_none=True);loss=ntxent(con(torch.from_numpy(np.concatenate([a,b])).to(DEVICE)))
        if not torch.isfinite(loss):raise FloatingPointError('NT-Xent no finita')
        loss.backward();opt.step();perdidas.append(float(loss.detach()))
    valor=medir_contrastivo(con);hist.append({'epoca':ep,'ntxent_train_online':float(np.mean(perdidas)),'ntxent_val_fija':valor})
    if valor<mejor:mejor=valor;estado=copy.deepcopy(con.state_dict());epoca_mejor=ep
    print('Contrastivo',ep,'NT-Xent val',round(valor,4),flush=True)
con.load_state_dict(estado);con.eval();hc=pd.DataFrame(hist);hc.to_csv(ARTEFACTOS/'contrastivo-historial.csv',index=False)
fig,ax=plt.subplots(figsize=(8,3.5));ax.plot(hc.epoca,hc.ntxent_train_online,label='Train online · vistas nuevas');ax.plot(hc.epoca,hc.ntxent_val_fija,label='Val · vistas y lotes fijos');ax.axvline(epoca_mejor,color='.4',ls='--');ax.set(xlabel='Época',ylabel='NT-Xent');ax.legend();fig.tight_layout();plt.show()
print('Checkpoint contrastivo:',epoca_mejor,'· segundos:',time.perf_counter()-inicio)

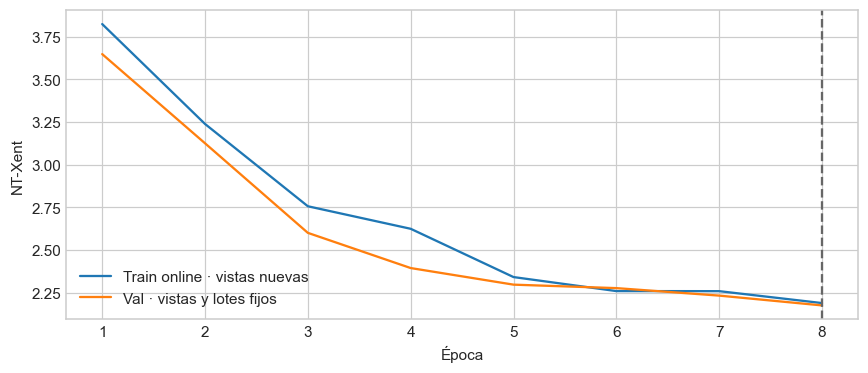
Contrastivo 1 NT-Xent val 3.6475
Contrastivo 2 NT-Xent val 3.125
Contrastivo 3 NT-Xent val 2.6002
Contrastivo 4 NT-Xent val 2.394
Contrastivo 5 NT-Xent val 2.2967
Contrastivo 6 NT-Xent val 2.2764
Contrastivo 7 NT-Xent val 2.2325
Contrastivo 8 NT-Xent val 2.1751

Checkpoint contrastivo: 8 · segundos: 44.011322700000164

25.4.1 NT-Xent con cuatro vistas: seguir el denominador

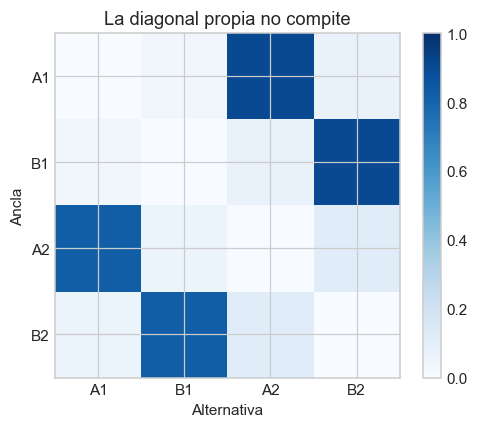
De dos originales A y B creamos \(A_1,B_1,A_2,B_2\). Para el ancla \(A_1\), el positivo es \(A_2\) y los otros dos originales visibles actúan como negativos de instancia. La propia ancla se excluye. Si \(s_{ik}\) es coseno y \(j\) identifica su pareja:

\[\ell_i=-\log\frac{\exp(s_{ij}/\tau)}{\sum_{k\ne i}\exp(s_{ik}/\tau)},\qquad L=\frac1{2B}\sum_{i=1}^{2B}\ell_i.\]

El positivo sí aparece en el denominador. Con B originales, cada ancla tiene un positivo y \(2B-2\) negativos. Es frecuente equivocarse excluyendo la pareja o normalizando sobre la diagonal. El orden del arreglo importa al construir índices, aunque no cambie la identidad conceptual de las parejas.

En este ejemplo cada vector tiene dos coordenadas. Las dos vistas de A apuntan casi al eje horizontal y las de B al vertical. Después de normalizar, calculamos todos los cosenos, la tabla de probabilidades y una pérdida por ancla. No se trata de embeddings aprendidos ni de una validación de Digits: son números elegidos para comprender la operación.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_ntxent_cuatro():
    z=torch.tensor([[1.,0.],[0.,1.],[.98,.2],[.2,.98]],dtype=torch.float64,requires_grad=True)
    zn=torch.nn.functional.normalize(z,dim=1);sim=zn@zn.T;pares=torch.tensor([2,3,0,1]);mascara=torch.eye(4,dtype=torch.bool)
    logits=(sim/.3).masked_fill(mascara,-torch.inf);logp=logits.log_softmax(1);individual=-logp[torch.arange(4),pares];loss=individual.mean()
    manual=-torch.log(torch.exp(sim[0,2]/.3)/torch.exp(sim[0,[1,2,3]]/.3).sum())
    torch.testing.assert_close(manual,individual[0]);loss.backward();assert torch.isfinite(z.grad).all()
    display(pd.DataFrame({'ancla':['A1','B1','A2','B2'],'positivo':['A2','B2','A1','B1'],'p_positivo':logp.exp()[torch.arange(4),pares].detach().numpy(),'perdida':individual.detach().numpy(),'norma_grad_z':z.grad.norm(dim=1).numpy()}))
    colapsada=torch.ones(4,2,dtype=torch.float64);colapsada=torch.nn.functional.normalize(colapsada,dim=1);lc=(colapsada@colapsada.T/.3).masked_fill(mascara,-torch.inf)
    valor=torch.nn.functional.cross_entropy(lc,pares);assert np.isclose(valor.item(),np.log(3))
    print('Pérdida real de esta cuenta:',loss.item(),'; todos iguales:',valor.item(),'; log(3):',np.log(3))
    fig,ax=plt.subplots(figsize=(5,4));im=ax.imshow(logp.exp().detach().numpy(),vmin=0,vmax=1,cmap='Blues');ax.set(xticks=range(4),xticklabels=['A1','B1','A2','B2'],yticks=range(4),yticklabels=['A1','B1','A2','B2'],xlabel='Alternativa',ylabel='Ancla',title='La diagonal propia no compite');fig.colorbar(im,ax=ax);fig.tight_layout();plt.show()
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_ntxent_cuatro()
ancla positivo p_positivo perdida norma_grad_z
0 A1 A2 0.898900 0.106583 0.115286
1 B1 B2 0.898900 0.106583 0.115286
2 A2 A1 0.822917 0.194900 0.328528
3 B2 B1 0.822917 0.194900 0.328528
Pérdida real de esta cuenta: 0.15074140372797912 ; todos iguales: 1.0986122886681098 ; log(3): 1.0986122886681098

25.4.2 Qué presión ejerce la pérdida y qué no garantiza

Para el score de similitud, \(\partial\ell_i/\partial s_{ik}=(p_{ik}-\mathbb1[k=j])/\tau\). El positivo recibe presión para aumentar su compatibilidad; un negativo con probabilidad alta recibe más presión para reducirla. Esta es la derivada respecto del score: el gradiente de cada vector también atraviesa normalización, producto escalar y las contribuciones de otras anclas.

Si todos los vectores coinciden, cada alternativa permitida recibe probabilidad \(1/(2B-1)\) y la pérdida vale \(\log(2B-1)\). Eso permite detectar falta de discriminación entre instancias. No demuestra por sí solo que el optimizador vaya a salir de cualquier estado colapsado ni que una pérdida menor separe clases semánticas.

Una temperatura pequeña hace la distribución más concentrada y cambia la escala del gradiente. No se debe comparar su pérdida bruta con la de otra temperatura como si ambas fueran el mismo objetivo. Tampoco equivale a añadir ejemplos negativos. En lotes mayores cambian las alternativas y la escala de referencia \(\log(2B-1)\).

El proyector permite que el espacio utilizado por el contraste difiera de la representación reutilizada. Descartarlo es una elección del protocolo, no una ley: podríamos evaluar h y z con probes prefijados. La comparación debe declarar cuál se conserva, qué dimensión tiene y cómo se ajusta el evaluador.

25.5 5. ¿Se separan parejas de instancia?

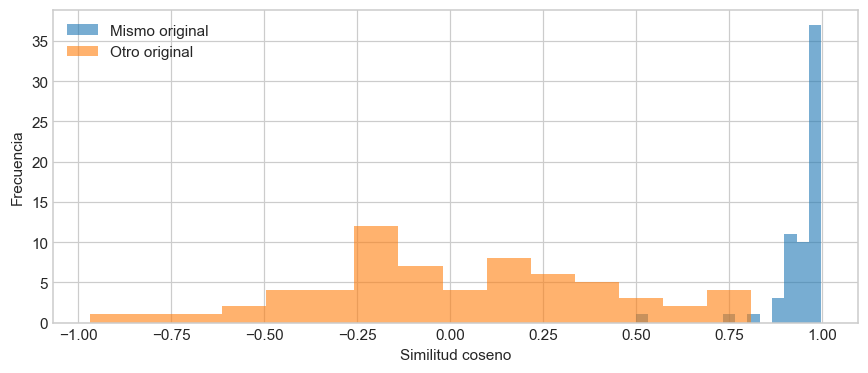
Evaluamos 64 imágenes prefijadas del test con vistas nuevas, sin modificar el checkpoint. Los negativos se obtienen por una permutación sin puntos fijos: ninguna imagen se empareja accidentalmente consigo misma. El histograma no demuestra separabilidad de clases ni calidad para otra tarea; mide semejanza entre las vistas declaradas.

@torch.inference_mode()
def extraer(m,imagenes):
    m.eval();salida=[]
    for i in range(0,len(imagenes),128):salida.append(m(torch.from_numpy(imagenes[i:i+128]).to(DEVICE)).cpu().numpy())
    return np.concatenate(salida)
ids=np.random.default_rng(9).choice(ite,64,replace=False);a,b=vistas(ids,10)
ea=extraer(con,a);eb=extraer(con,b);ea/=np.maximum(np.linalg.norm(ea,axis=1,keepdims=True),1e-12);eb/=np.maximum(np.linalg.norm(eb,axis=1,keepdims=True),1e-12)
negativos=np.roll(np.arange(64),1);assert (negativos!=np.arange(64)).all()
positivo=(ea*eb).sum(1);negativo=(ea*eb[negativos]).sum(1)
fig,ax=plt.subplots(figsize=(8,3.5));ax.hist(positivo,bins=15,alpha=.6,label='Mismo original');ax.hist(negativo,bins=15,alpha=.6,label='Otro original');ax.set(xlabel='Similitud coseno',ylabel='Frecuencia');ax.legend();fig.tight_layout();plt.show()
print('Similitud media positiva/negativa:',positivo.mean(),negativo.mean())

Similitud media positiva/negativa: 0.9456482 0.025087234

25.6 6. Linear probe con pocas etiquetas

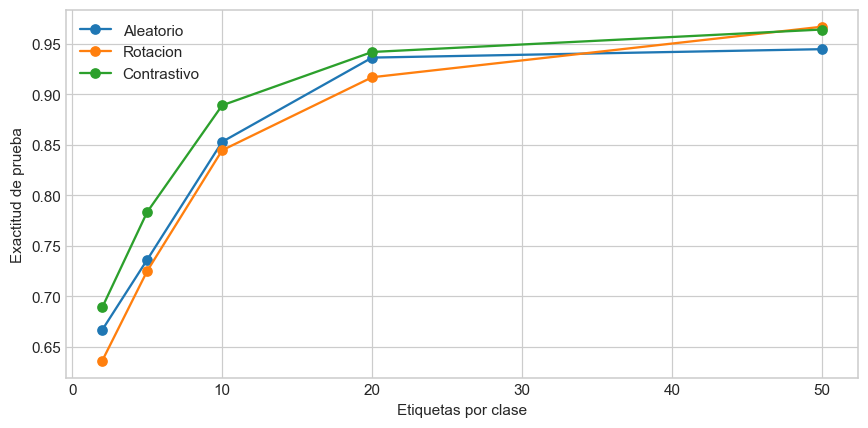
Congelamos los tres backbones y usamos exactamente los mismos identificadores etiquetados por presupuesto: 2,5,10,20,50 por clase. Las selecciones son anidadas por clase y semilla 7. La regresión logística mantiene C=1 y máximo 2 000 iteraciones; estandarizamos sus características sólo con las muestras de entrenamiento del probe, para explicitar el efecto de la escala sobre la penalización. Es un cambio respecto del probe sin escalado del original.

No llamamos “techo máximo posible” al probe con todas las etiquetas: es una referencia con ese clasificador. Para seleccionar representación usamos exactitud de validación con el presupuesto prefijado de diez etiquetas por clase, antes de ver las curvas de test. La selección no se cambia después.

backbones={'Aleatorio':base,'Rotacion':brot,'Contrastivo':bcon};emb={}
for nombre,b in backbones.items():
    b.eval()
    for p in b.parameters():p.requires_grad=False
    emb[nombre]={k:extraer(b,x[ids]) for k,ids in [('train',itr),('val',iva),('test',ite)]}
rng=np.random.default_rng(7);orden_clase={i:rng.permutation(np.flatnonzero(y[itr]==i)) for i in range(10)}
def pocos(n):return np.concatenate([orden_clase[i][:n] for i in range(10)])
def probe(e,ids):
    clf=make_pipeline(StandardScaler(),LogisticRegression(C=1,max_iter=2000));clf.fit(e['train'][ids],y[itr][ids]);return clf
validacion={nombre:probe(e,pocos(10)).score(e['val'],y[iva]) for nombre,e in emb.items()};ganador=max(validacion,key=validacion.get)
print('Exactitud validación, 10/clase:',validacion,'· elegido:',ganador)
filas=[]
for n in [2,5,10,20,50]:
    for nombre,e in emb.items():
        ids=pocos(n);clf=probe(e,ids);filas.append({'backbone':nombre,'etiquetas_por_clase':n,'n_etiquetas':len(ids),'acc_test':clf.score(e['test'],y[ite])})
tabla=pd.DataFrame(filas);display(tabla);tabla.to_csv(ARTEFACTOS/'probes.csv',index=False)
fig,ax=plt.subplots(figsize=(8,4))
for nombre,g in tabla.groupby('backbone',sort=False):ax.plot(g.etiquetas_por_clase,g.acc_test,'-o',label=nombre)
ax.set(xlabel='Etiquetas por clase',ylabel='Exactitud de prueba');ax.legend();fig.tight_layout();plt.show()
filas=[]
for nombre,e in emb.items():
    clf=probe(e,np.arange(len(itr)));filas.append({'backbone':nombre,'n_etiquetas':len(itr),'acc_test':clf.score(e['test'],y[ite])})
todas=pd.DataFrame(filas);display(todas);todas.to_csv(ARTEFACTOS/'probes-todas.csv',index=False)
Exactitud validación, 10/clase: {'Aleatorio': 0.8796296296296297, 'Rotacion': 0.8703703703703703, 'Contrastivo': 0.9027777777777778} · elegido: Contrastivo
backbone etiquetas_por_clase n_etiquetas acc_test
0 Aleatorio 2 20 0.666667
1 Rotacion 2 20 0.636111
2 Contrastivo 2 20 0.688889
3 Aleatorio 5 50 0.736111
4 Rotacion 5 50 0.725000
5 Contrastivo 5 50 0.783333
6 Aleatorio 10 100 0.852778
7 Rotacion 10 100 0.844444
8 Contrastivo 10 100 0.888889
9 Aleatorio 20 200 0.936111
10 Rotacion 20 200 0.916667
11 Contrastivo 20 200 0.941667
12 Aleatorio 50 500 0.944444
13 Rotacion 50 500 0.966667
14 Contrastivo 50 500 0.963889

backbone n_etiquetas acc_test
0 Aleatorio 1221 0.958333
1 Rotacion 1221 0.972222
2 Contrastivo 1221 0.966667

25.6.1 Leer el probe sin atribuirle más de lo que mide

Con diez etiquetas por clase y diez clases, el ajuste supervisado del probe usa cien ejemplos. No son cien imágenes por clase ni un ajuste supervisado de todo el backbone. Congelar la red impide que ese pequeño conjunto cambie sus pesos; solo se entrena el clasificador lineal y su escalado se estima en esos ejemplos.

Una representación puede favorecer una frontera curva y recibir una puntuación modesta con una regla lineal. A la inversa, un backbone aleatorio puede ofrecer una expansión útil al probe. Por eso incluimos esa referencia y no interpretamos cualquier acierto como efecto del preentrenamiento. La referencia con todas las etiquetas permite observar el coste de escasez bajo ese clasificador, sin llamarla techo absoluto.

Los presupuestos anidados conservan los mismos ejemplos iniciales al añadir etiquetas. Así se reduce una diferencia de composición, pero una sola semilla no describe la variabilidad de quién recibió etiqueta. Para estimarla se repetiría el muestreo de etiquetas con semillas prefijadas. El conjunto de prueba sigue fuera de esa elección.

Decisión guiada: si mejora la tarea pretexto y el probe no mejora, no aumente automáticamente épocas. Compruebe primero qué diferencias obligan a ignorar las vistas, si el proyector concentra la señal útil y si el probe recibió muestras suficientes. Cada hipótesis pide otro contraste; una PCA atractiva no lo sustituye.

25.7 7. PCA y separación de clases: describir, no confirmar por decreto

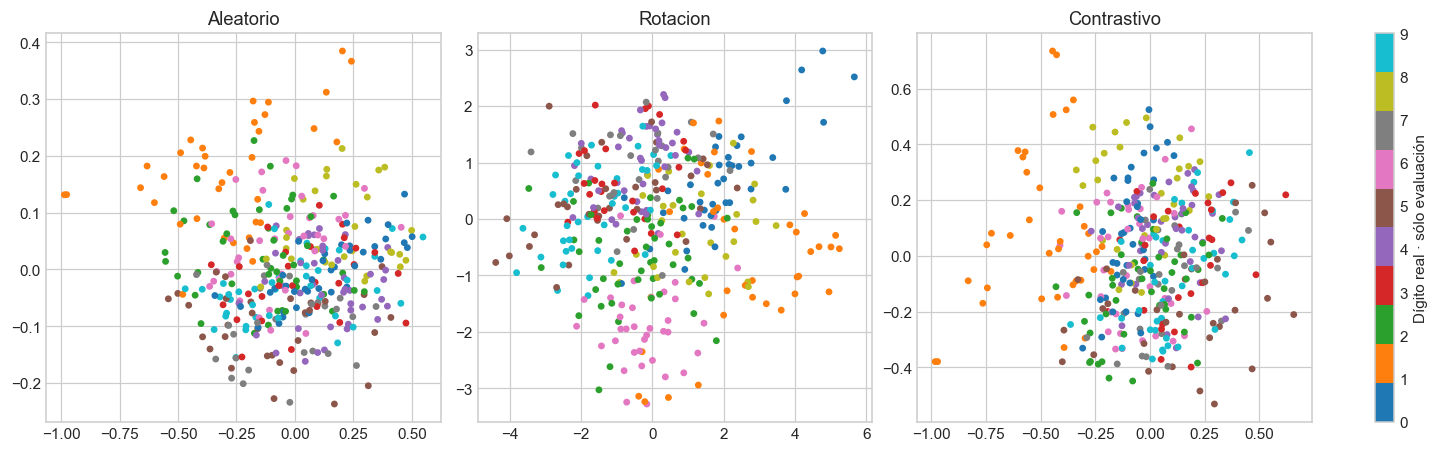
PCA se ajusta con embeddings de entrenamiento y transforma prueba; no usa sus etiquetas. El color y silhouette sí usan las etiquetas de prueba para describir la representación ya fijada. Una proyección 2D puede ocultar estructura del espacio original. Un silhouette mayor no garantiza un mejor clasificador ni establece la causa de una diferencia.

Las tareas pretexto pueden aprender invariancias útiles o perjudiciales. Rotar dígitos puede introducir ambigüedad y los negativos de instancia pueden incluir ejemplos de la misma clase. Se deben leer las curvas y las cifras efectivas, sin asumir que el contraste ganará al backbone aleatorio.

fig,axes=plt.subplots(1,3,figsize=(13,4),layout='constrained');filas=[]
for ax,(nombre,e) in zip(axes,emb.items()):
    pca=PCA(n_components=2).fit(e['train']);z=pca.transform(e['test']);disp=ax.scatter(z[:,0],z[:,1],c=y[ite],cmap='tab10',s=12,vmin=0,vmax=9);ax.set_title(nombre)
    filas.append({'backbone':nombre,'silhouette_64d_test':silhouette_score(e['test'],y[ite]),'varianza_pca2_train':float(pca.explained_variance_ratio_.sum())})
fig.colorbar(disp,ax=axes,label='Dígito real · sólo evaluación');plt.show();separacion=pd.DataFrame(filas);display(separacion);separacion.to_csv(ARTEFACTOS/'separacion.csv',index=False)

backbone silhouette_64d_test varianza_pca2_train
0 Aleatorio -0.054348 0.862692
1 Rotacion 0.061780 0.602934
2 Contrastivo 0.073671 0.611369

25.8 8. Guardar la representación y continuar

El artefacto conserva el backbone seleccionado por validación, sin el proyector de la tarea contrastiva. Guardamos también el criterio y el contrato de entrada. La recarga se comprueba sobre imágenes de validación. Reutilizarlo con ajuste fino sería otro experimento: un frozen probe y una adaptación completa no responden exactamente la misma pregunta.

elegido=backbones[ganador];ruta=ARTEFACTOS/'backbone-seleccionado.pt'
torch.save({'state_dict':{k:v.detach().cpu().clone() for k,v in elegido.state_dict().items()},'tipo':ganador},ruta)
nuevo=Backbone().to(DEVICE);nuevo.load_state_dict(torch.load(ruta,map_location=DEVICE,weights_only=True)['state_dict']);nuevo.eval()
np.testing.assert_allclose(extraer(elegido,x[iva[:32]]),extraer(nuevo,x[iva[:32]]),rtol=1e-5,atol=1e-6)
(ARTEFACTOS/'contrato.json').write_text(json.dumps({'entrada':'NCHW float32 Digits /16, repetir 4x','forma':[1,32,32],'embedding':64,'ganador_validacion':ganador,'presupuesto_seleccion':10,'sha256':hashlib.sha256(ruta.read_bytes()).hexdigest(),'fuentes_rotacion_disjuntas':True,'negativos_sin_identidad':True,'ntxent_control_analitico':True}),encoding='utf-8')
print('Backbone guardado y recargado:',ganador)
Backbone guardado y recargado: Contrastivo

25.8.1 Lectura de la ejecución registrada

Se conservan rotación diez épocas, contraste ocho, probes de 2/5/10/20/50 etiquetas por clase y referencia con todas las etiquetas. Se separan fuentes antes de generar rotaciones, se conserva alineación de metadatos y se evitan negativos emparejados consigo mismos. NT-Xent se verifica contra un control analítico. Validación contrastiva usa vistas y lotes fijos. Se declara el escalado del probe ajustado sólo en su entrenamiento. La selección por validación con diez etiquetas/clase eligió contraste; las curvas y PCA se informan sin forzar una mejora universal. PCA se ajusta en train y silhouette sólo evalúa. Backbone recargado y comprobado.

Resultados CPU del 15 de octubre de 2026; vuelva a contrastar la lectura si cambia datos, versión o semilla.

25.9 9. Ejercicios y límites

  1. Prefije temperaturas contrastivas y seleccione con validación pretexto o con un probe declarado; no elija por test.
  2. Compare desplazamiento circular y relleno cero como hipótesis de invariancia.
  3. Repita presupuestos y semillas de pocas etiquetas para medir variabilidad.
  4. Compare probe congelado y ajuste completo con iguales identificadores etiquetados y validación.

Son imágenes Digits de baja resolución original, lotes de 32 y preentrenamiento corto: no es una reproducción a escala de SimCLR. No existe una garantía de que más separación visual, menor pérdida pretexto o más etiquetas produzcan una mejora monótona en cada muestra de prueba.

25.10 Referencias