Un archivo de audio es una secuencia de muestras con una frecuencia de muestreo. Antes de entrenar hay que distinguir valores, tiempo, frecuencia, intensidad y duración. Cambiar cualquiera de esas convenciones puede modificar la tarea aunque el tensor mantenga su forma.
Construiremos señales escuchables, compararemos espectrogramas y filtros mel, entrenaremos clasificadores de tonos y dígitos de voz humana con hablantes separados, además de un modelo CTC sobre secuencias acústicas sintéticas. El laboratorio CTC enseña alineación y decodificación, pero no reconoce voz humana. La evaluación de reconocimiento de voz se desarrollará con ejemplos explícitos de transcripciones y métricas, sin atribuirlos a un sistema ASR real.
Se requieren NumPy, pandas, SciPy, Matplotlib, scikit-learn y PyTorch en CPU. Continúa Pipelines y Secuencia a secuencia. Los modelos lingüísticos y aplicaciones de texto se amplían en el libro propio de NLP.
24.1 Muestras, segundos y amplitud
Para frecuencia \(f_s\), la muestra \(n\) corresponde al tiempo \(n/f_s\). Un segundo a 8 kHz contiene 8000 muestras. La frecuencia de muestreo no es la frecuencia del sonido: un tono de 400 Hz puede representarse a distintas tasas si se respeta el ancho de banda.
La amplitud de estos ejemplos está en unidades digitales, no en presión sonora calibrada. El RMS resume energía media; los picos permiten detectar recorte. Normalizar cada archivo por su máximo puede borrar diferencias de intensidad útiles y amplificar silencios o ruido. Por eso debemos declarar el procedimiento y la unidad relevante.
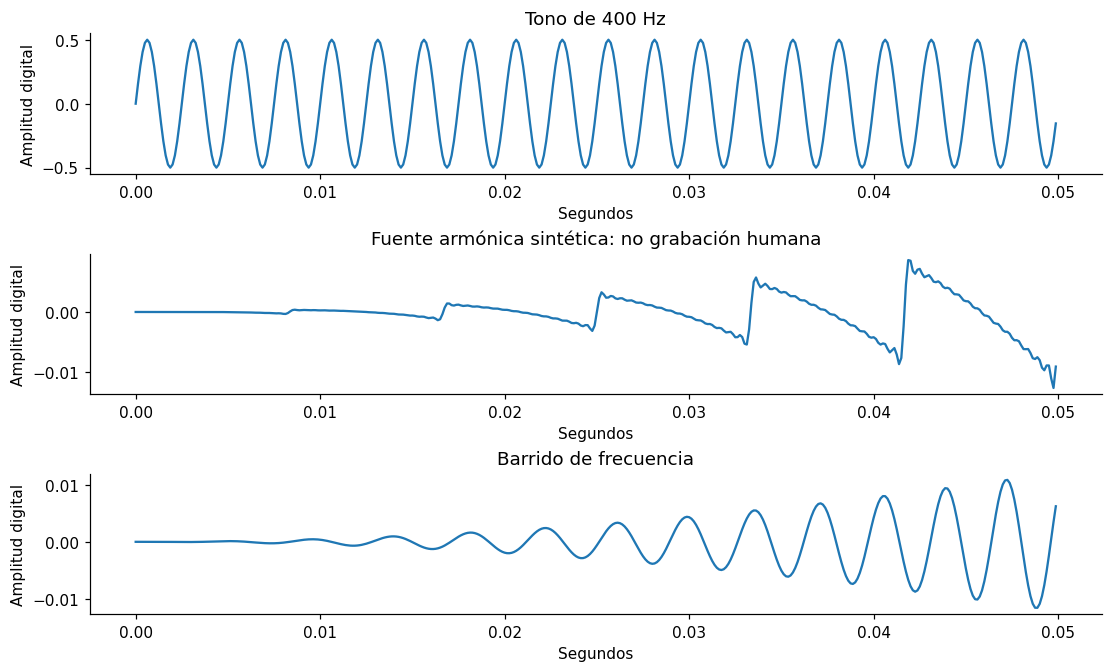
import numpy as npimport sklearn#| code-fold: true#| code-summary: "Ver implementación del experimento"import numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport sklearn,scipyfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_score,balanced_accuracy_score,log_loss,ConfusionMatrixDisplay,roc_auc_score,average_precision_score,f1_scorefrom sklearn.preprocessing import StandardScalerfrom IPython.display import displayimport torchfrom torch import nnfrom torch.utils.data import DataLoader,TensorDatasetimport copy,json,math,time,itertoolsfrom pathlib import Pathtorch.set_num_threads(1);torch.use_deterministic_algorithms(True)SEMILLA=42;lecturas={};COLORES=['#276FBF','#E87524','#339966','#9B59B6']plt.rcParams.update({'figure.dpi':110,'font.size':10,'figure.constrained_layout.use':True,'axes.spines.top':False,'axes.spines.right':False})def tensor(x,dtype=torch.float32):return torch.tensor(x,dtype=dtype)def probas(modelo,x): modelo.eval()with torch.no_grad():return modelo(x).softmax(-1).numpy()def ajustar_clasificador(modelo,x,y,xv,yv,epocas=45,lr=.003,seed=7): opt=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr) loader=DataLoader(TensorDataset(x,y),batch_size=64,shuffle=True,generator=torch.Generator().manual_seed(seed)) mejor=np.inf;hist=[];inicio=time.perf_counter()for ep inrange(1,epocas+1): modelo.train();suma=0.;cuenta=0for xb,yb in loader: opt.zero_grad();loss=nn.functional.cross_entropy(modelo(xb),yb);loss.backward();opt.step();suma+=float(loss.detach())*len(xb);cuenta+=len(xb) pv=probas(modelo,xv);lv=log_loss(yv.numpy(),pv,labels=np.arange(pv.shape[1]));hist.append((ep,suma/cuenta,lv,balanced_accuracy_score(yv,pv.argmax(1))))if lv<mejor:mejor=lv;estado=copy.deepcopy(modelo.state_dict());checkpoint=ep modelo.load_state_dict(estado)return np.array(hist),checkpoint,time.perf_counter()-inicioprint('NumPy y scikit-learn importados antes de PyTorch; CPU, un hilo y semillas explícitas.')from scipy import signalfrom scipy.io import wavfilefrom IPython.display import AudioFS=8000;t=np.arange(FS)/FStono=.5*np.sin(2*np.pi*400*t)armonica=sum((.3/k)*np.sin(2*np.pi*120*k*t) for k inrange(1,16))envolvente=np.sin(np.pi*np.clip(t,0,1))**2;voz_sintetica=armonica*envolventechirp=.5*signal.chirp(t,f0=200,t1=1,f1=2500)*envolventefor nombre,a in [('tono-400.wav',tono),('armonicos.wav',voz_sintetica),('barrido.wav',chirp)]:wavfile.write(nombre,FS,np.round(np.clip(a,-1,1)*32767).astype(np.int16))display(pd.DataFrame({'señal':['tono','armónicos','barrido'],'muestras':[len(tono)]*3,'segundos':[1]*3,'RMS':[np.sqrt(np.mean(a*a)) for a in [tono,voz_sintetica,chirp]],'pico':[np.max(np.abs(a)) for a in [tono,voz_sintetica,chirp]]}))fig,axs=plt.subplots(3,1,figsize=(10,6))for ax,a,nombre inzip(axs,[tono,voz_sintetica,chirp],['Tono de 400 Hz','Fuente armónica sintética: no grabación humana','Barrido de frecuencia']):ax.plot(t[:400],a[:400]);ax.set(xlabel='Segundos',ylabel='Amplitud digital',title=nombre)plt.show();display(Audio(filename='tono-400.wav',normalize=False));display(Audio(filename='armonicos.wav',normalize=False));display(Audio(filename='barrido.wav',normalize=False))
NumPy y scikit-learn importados antes de PyTorch; CPU, un hilo y semillas explícitas.
señal
muestras
segundos
RMS
pico
0
tono
8000
1
0.353553
0.500000
1
armónicos
8000
1
0.163309
0.525053
2
barrido
8000
1
0.216506
0.500000
24.1.1 Cómo leer y escuchar este resultado
La periodicidad del tono se ve en el tiempo; el barrido cambia frecuencia y no conserva el mismo periodo. La fuente armónica tiene una frecuencia fundamental y múltiplos, pero carece del aparato vocal, articulación y variación de una voz humana. Escucharla permite conectar forma y sonido sin convertirla en una muestra representativa de hablantes.
Los reproductores usan la tasa almacenada en el WAV. Los gráficos mantienen la amplitud original y los audios no se normalizan al reproducir. Los archivos se incluyen para comparar ambos modos de inspección.
24.2 Aliasing y remuestreo: cambiar la tasa exige filtrar
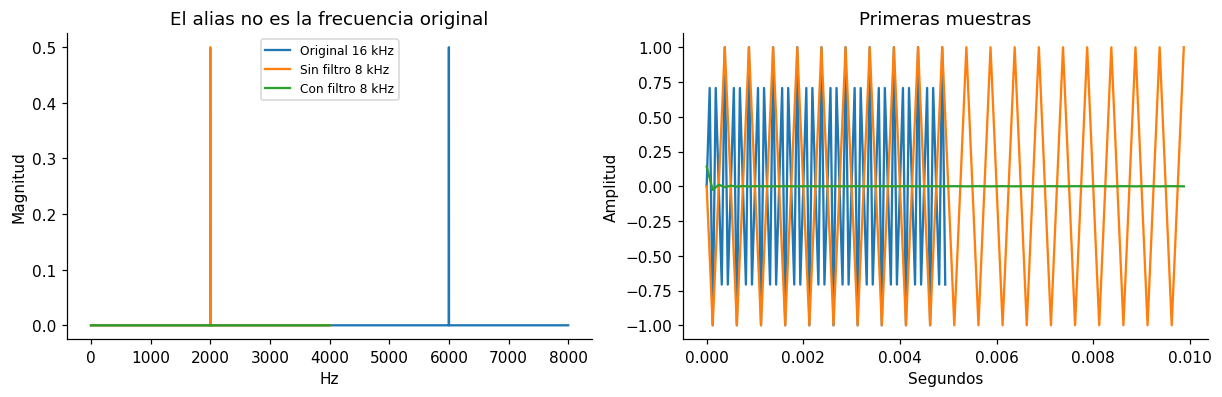
Un tono de 6 kHz puede representarse a 16 kHz. Si conservamos una de cada dos muestras sin filtrar y declaramos 8 kHz, aparece como 2 kHz: la frecuencia original está por encima del nuevo límite de Nyquist. El remuestreo con filtro atenúa contenido que no puede conservarse. Ese filtro no reconstruye información que ya se perdió por aliasing en la captura original.
fs_original=16000;tt=np.arange(fs_original)/fs_original;original=np.sin(2*np.pi*6000*tt)ingenuo=original[::2];filtrado=signal.resample_poly(original,1,2)def espectro(a,fs):return np.fft.rfftfreq(len(a),1/fs),np.abs(np.fft.rfft(a))/len(a)fig,axs=plt.subplots(1,2,figsize=(11,3.5))for a,fs,nombre in [(original,16000,'Original 16 kHz'),(ingenuo,8000,'Sin filtro 8 kHz'),(filtrado,8000,'Con filtro 8 kHz')]: f,s=espectro(a,fs);axs[0].plot(f,s,label=nombre);axs[1].plot(np.arange(80)/fs,a[:80],label=nombre)axs[0].set(xlabel='Hz',ylabel='Magnitud',title='El alias no es la frecuencia original');axs[0].legend(fontsize=8);axs[1].set(xlabel='Segundos',ylabel='Amplitud',title='Primeras muestras');plt.show()print('Pico sin filtro:',espectro(ingenuo,8000)[0][np.argmax(espectro(ingenuo,8000)[1])],'Hz; RMS filtrado:',round(float(np.sqrt(np.mean(filtrado**2))),4))
Pico sin filtro: 2000.0 Hz; RMS filtrado: 0.0017
24.3 Ventanas y espectrogramas
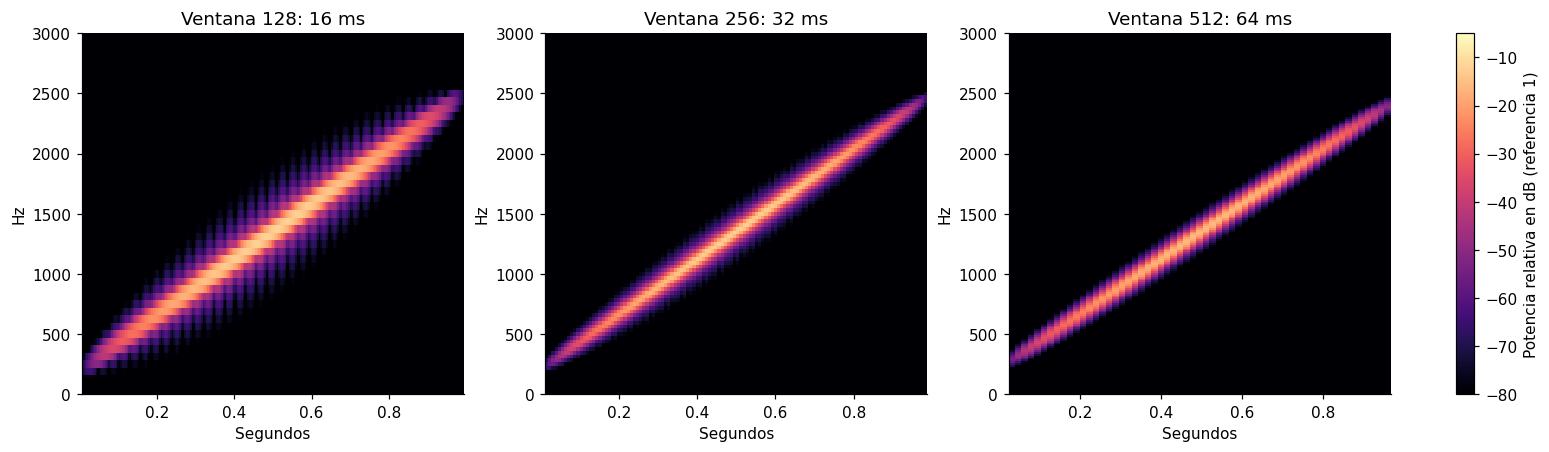
La FFT global informa frecuencias, pero no cuándo ocurren. La STFT analiza ventanas superpuestas. Para ventana de \(L\) muestras y salto \(H\), sus escalas aproximadas son \(L/f_s\) segundos y \(f_s/L\) Hz entre bins. Usamos ventana Hann, sin completar bordes en la comparación.
Una ventana larga separa frecuencias cercanas, pero mezcla cambios en el tiempo. Una corta localiza transiciones y tiene menor resolución de frecuencia. El salto controla densidad temporal y solapamiento; hacerlo pequeño no recupera resolución que la ventana no tiene.
fig,axs=plt.subplots(1,3,figsize=(14,4));filas=[]for ax,L inzip(axs,[128,256,512]): f,ts,Z=signal.stft(chirp,FS,window='hann',nperseg=L,noverlap=L-L//4,boundary=None,padded=False) db=10*np.log10(np.maximum(np.abs(Z)**2,1e-10));im=ax.pcolormesh(ts,f,db,cmap='magma',vmin=-80,vmax=-5,shading='auto');ax.set(xlabel='Segundos',ylabel='Hz',ylim=(0,3000),title=f'Ventana {L}: {L/FS*1000:.0f} ms') filas.append({'ventana':L,'salto':L//4,'milisegundos':L/FS*1000,'separación bins Hz':FS/L,'frames':len(ts)})fig.colorbar(im,ax=axs,label='Potencia relativa en dB (referencia 1)');plt.show();display(pd.DataFrame(filas))
ventana
salto
milisegundos
separación bins Hz
frames
0
128
32
16.0
62.500
247
1
256
64
32.0
31.250
122
2
512
128
64.0
15.625
59
24.3.1 Mel, logaritmo y coeficientes cepstrales
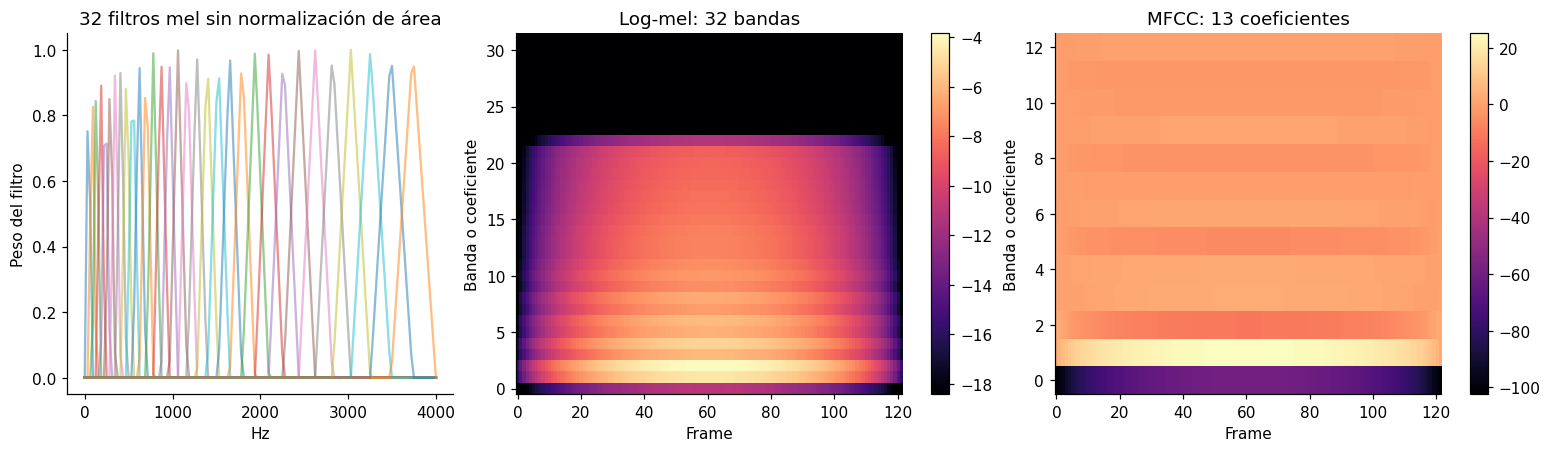
Una escala mel organiza filtros con separación que cambia con la frecuencia. Usamos la convención \(m(f)=2595\log_{10}(1+f/700)\) y filtros triangulares. La potencia de la STFT se combina por filtro y se transforma con logaritmo. «Log-mel» describe ambas decisiones, no una medición calibrada de sonoridad.
MFCC agrega una transformada coseno a energías log-mel y conserva algunos coeficientes. Reduce dimensión y mezcla bandas: no equivale a conservar una imagen del espectrograma. Distintas bibliotecas usan convenciones diferentes de escala, normalización, centrado y logaritmo; un checkpoint necesita las mismas que su entrenamiento.
from scipy.fft import dctNFFT=256;HOP=64;NMEL=32;freq=np.fft.rfftfreq(NFFT,1/FS)mel=lambda f:2595*np.log10(1+f/700)hz=lambda m:700*(10**(m/2595)-1)puntos=hz(np.linspace(mel(0),mel(FS/2),NMEL+2));filtros=np.zeros((NMEL,len(freq)))for i inrange(NMEL):filtros[i]=np.maximum(0,np.minimum((freq-puntos[i])/(puntos[i+1]-puntos[i]),(puntos[i+2]-freq)/(puntos[i+2]-puntos[i+1])))def logmel(a): f,ts,Z=signal.stft(a,FS,window='hann',nperseg=NFFT,noverlap=NFFT-HOP,boundary=None,padded=False)return np.log(np.maximum(filtros@np.abs(Z)**2,1e-8)).astype('float32')lm=logmel(voz_sintetica);mfcc=dct(lm,type=2,axis=0,norm='ortho')[:13]fig,axs=plt.subplots(1,3,figsize=(14,4));axs[0].plot(freq,filtros.T,alpha=.5);axs[0].set(xlabel='Hz',ylabel='Peso del filtro',title='32 filtros mel sin normalización de área')for ax,M,nombre inzip(axs[1:],[lm,mfcc],['Log-mel: 32 bandas','MFCC: 13 coeficientes']):im=ax.imshow(M,origin='lower',aspect='auto',cmap='magma');ax.set(xlabel='Frame',ylabel='Banda o coeficiente',title=nombre);fig.colorbar(im,ax=ax)plt.show();print('Log-mel:',lm.shape,'; MFCC:',mfcc.shape,'; duración ventana:',NFFT/FS,'s')
Generamos 900 grabaciones independientes de medio segundo. Tres clases tienen frecuencias centrales de 350, 750 y 1500 Hz con variación de ±8 %, fase y amplitud aleatorias, un armónico y ruido leve. Cada grabación recibe un ID antes de la partición 60/20/20. No creamos ventanas que compartan la misma grabación entre particiones.
Entrenaremos una CNN sobre log-mel y la compararemos con un baseline que detecta el pico de FFT y elige la frecuencia central más cercana. El generador hace que ese baseline sea especialmente favorable: no necesitamos una red para detectar tres tonos separados. El experimento permite evaluar procesamiento y ruido, no reconocimiento de voz o eventos reales.
El log-mel se estandariza con media y desviación globales de entrenamiento. Se mantienen al transformar validación, prueba y perturbaciones. Para duraciones variables necesitaríamos máscaras o un procedimiento de recorte explícito; aquí todas las señales duran 0.5 segundos.
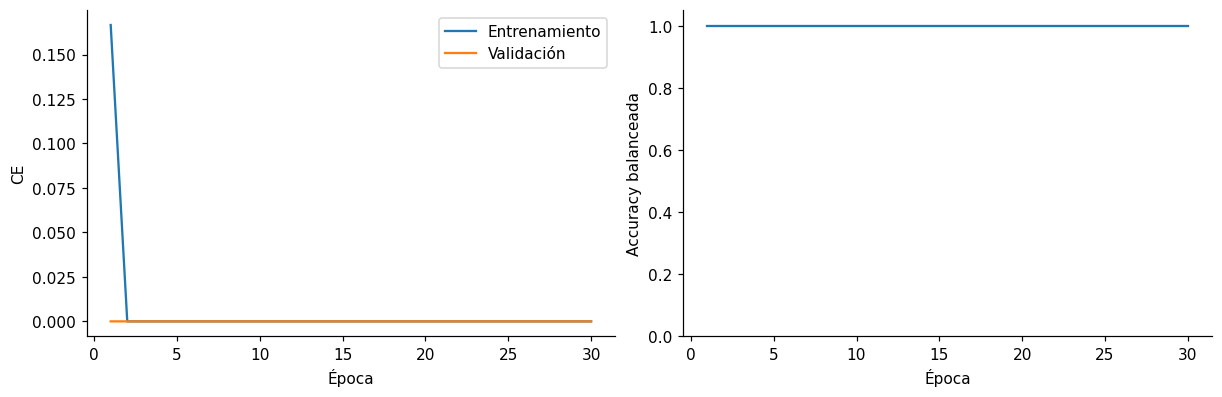
rng=np.random.default_rng(42);centros=np.array([350,750,1500]);n=900;clases=np.repeat(np.arange(3),n//3);t_audio=np.arange(FS//2)/FSaudios=[]for c in clases: f=centros[c]*rng.uniform(.92,1.08);fase=rng.uniform(0,2*np.pi);amp=rng.uniform(.2,.8) a=amp*(np.sin(2*np.pi*f*t_audio+fase)+.2*np.sin(2*np.pi*2*f*t_audio+fase));a+=rng.normal(0,.02,len(a));audios.append(a)audios=np.array(audios);tr,rest=train_test_split(np.arange(n),test_size=.4,stratify=clases,random_state=42);va,te=train_test_split(rest,test_size=.5,stratify=clases[rest],random_state=42)LM=np.stack([logmel(a) for a in audios]);mu=LM[tr].mean();sd=LM[tr].std();XL=tensor(((LM-mu)/sd)[:,None]);YL=tensor(clases,torch.long)class ClasAudio(nn.Module):def__init__(self):super().__init__();self.red=nn.Sequential(nn.Conv2d(1,8,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Conv2d(8,16,3,padding=1),nn.ReLU(),nn.Flatten(),nn.Linear(16*(NMEL//2)*(LM.shape[2]//2),3))def forward(self,x):returnself.red(x)print('Espectrogramas:',tuple(XL.shape),'→ tras pooling:',tuple(nn.MaxPool2d(2)(XL[:1]).shape))torch.manual_seed(7);cnn=ClasAudio();hist,ep,seg=ajustar_clasificador(cnn,XL[tr],YL[tr],XL[va],YL[va],30,.003)ep_audio=epfig,axs=plt.subplots(1,2,figsize=(11,3.5));axs[0].plot(hist[:,0],hist[:,1],label='Entrenamiento');axs[0].plot(hist[:,0],hist[:,2],label='Validación');axs[0].set(xlabel='Época',ylabel='CE');axs[0].legend()axs[1].plot(hist[:,0],hist[:,3]);axs[1].set(xlabel='Época',ylabel='Accuracy balanceada',ylim=(0,1.05));plt.show()print('Checkpoint:',ep,'; entrenamiento y validación CPU:',round(seg,2),'segundos')
Checkpoint: 2 ; entrenamiento y validación CPU: 7.47 segundos
24.4.1 Prueba bajo ruido declarado
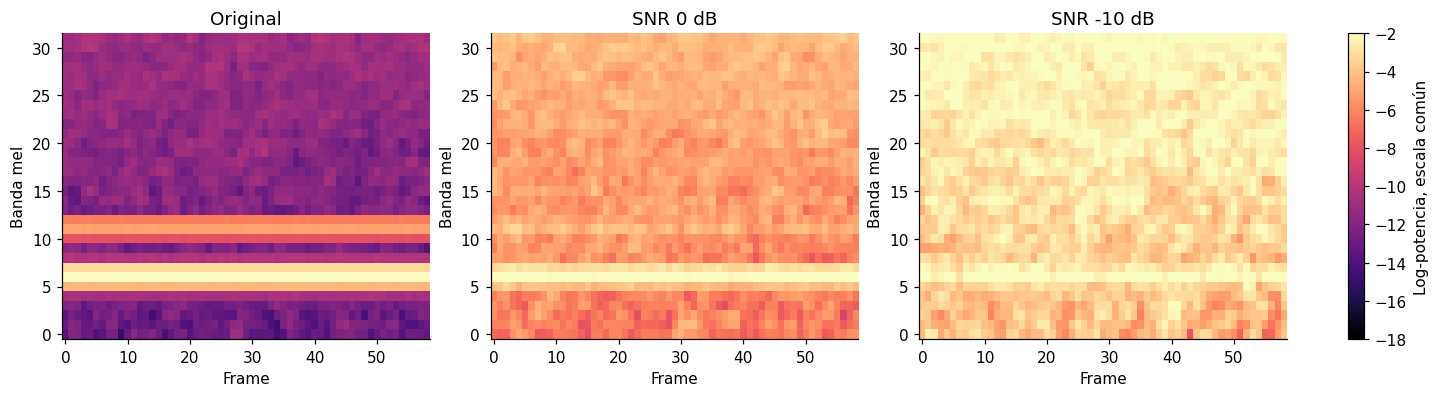
Evaluaremos prueba original y dos condiciones añadidas de ruido: SNR de 0 dB y −10 dB. La varianza añadida se calcula a partir de la energía de cada señal; la SNR se refiere a señal original frente al ruido añadido, por lo que no elimina el ruido leve que ya contiene el generador. Las condiciones se fijan antes de ver resultados y no se utilizan para elegir otro checkpoint.
Una reducción de accuracy exige revisar qué cambia en log-mel y en el baseline. Las etiquetas se conservan porque los tonos originales siguen siendo la fuente de clase; esto no prueba que cualquier transformación de audio preserve etiquetas.
def baseline_fft(a): magnitud=np.abs(np.fft.rfft(a,axis=1));f=np.fft.rfftfreq(a.shape[1],1/FS);pico=f[magnitud.argmax(1)]return np.abs(pico[:,None]-centros[None,:]).argmin(1)rng_noise=np.random.default_rng(99);condiciones={'Original':audios[te]}for snr in [0,-10]: potencia=np.mean(audios[te]**2,axis=1,keepdims=True);ruido=rng_noise.normal(size=audios[te].shape)*np.sqrt(potencia/10**(snr/10));condiciones[f'SNR {snr} dB']=audios[te]+ruidores_audio=[];p_audio={}for nombre,a in condiciones.items(): x=tensor(((np.stack([logmel(v) for v in a])-mu)/sd)[:,None]);p=probas(cnn,x);p_audio[nombre]=pfor modelo,pred in [('CNN log-mel',p.argmax(1)),('Pico FFT',baseline_fft(a))]:res_audio.append({'caso':'tonos','grupo':nombre,'modelo':modelo,'métrica':'balanceada','valor':balanced_accuracy_score(clases[te],pred)})tabla_audio=pd.DataFrame(res_audio);display(tabla_audio.pivot(index='grupo',columns='modelo',values='valor'))fig,axs=plt.subplots(1,3,figsize=(13,3.5))for ax,(nombre,a) inzip(axs,condiciones.items()):im=ax.imshow(logmel(a[0]),origin='lower',aspect='auto',cmap='magma',vmin=-18,vmax=-2);ax.set(title=nombre,xlabel='Frame',ylabel='Banda mel')fig.colorbar(im,ax=axs,label='Log-potencia, escala común');plt.show()fig,ax=plt.subplots(figsize=(5,4));ConfusionMatrixDisplay.from_predictions(clases[te],p_audio['SNR -10 dB'].argmax(1),ax=ax,cmap='Blues',colorbar=False);ax.set(title='CNN: prueba SNR −10 dB',xlabel='Clase predicha',ylabel='Clase real');plt.show()lecturas['audio_clean']=f'{tabla_audio[(tabla_audio.grupo=="Original")&(tabla_audio.modelo=="CNN log-mel")].valor.iloc[0]:.3f}';lecturas['audio_noise']=f'{tabla_audio[(tabla_audio.grupo=="SNR -10 dB")&(tabla_audio.modelo=="CNN log-mel")].valor.iloc[0]:.3f}'
modelo
CNN log-mel
Pico FFT
grupo
Original
1.000000
1.0
SNR -10 dB
0.333333
1.0
SNR 0 dB
0.722222
1.0
24.4.2 Cómo leer este resultado
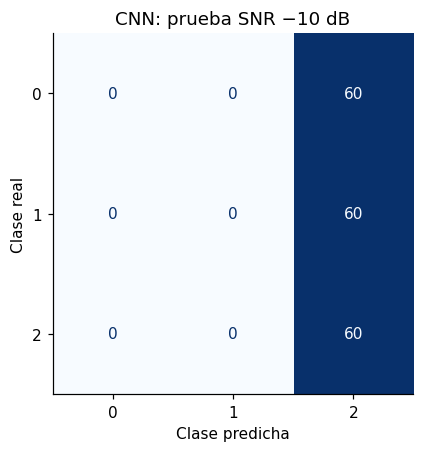
La CNN alcanza accuracy balanceada 1.000 en originales y 0.333 bajo −10 dB de ruido añadido. Los espectrogramas usan una escala común para observar cuánto se eleva el fondo; cambiar automáticamente colores por panel ocultaría parte de esa diferencia.
El baseline mantiene una relación explícita con el generador. Si supera a la CNN en ruido, el problema puede estar en la representación y distribución de entrenamiento, no en falta de capas. Una red que solo vio ruido leve no tiene garantizada robustez a niveles distintos. Para audio real, variar ruido blanco no representa todas las salas, micrófonos, interferencias ni hablantes.
En esta ejecución la CNN cae a 0.333, equivalente a la referencia balanceada de tres clases, mientras el pico de FFT conserva su ventaja. No validaría el clasificador neuronal para ruido fuerte con esta evidencia. Antes de ampliar la red, revisaría representación y aumentación con validación que incluya esa condición.
24.5 Voz humana: dígitos y hablantes separados
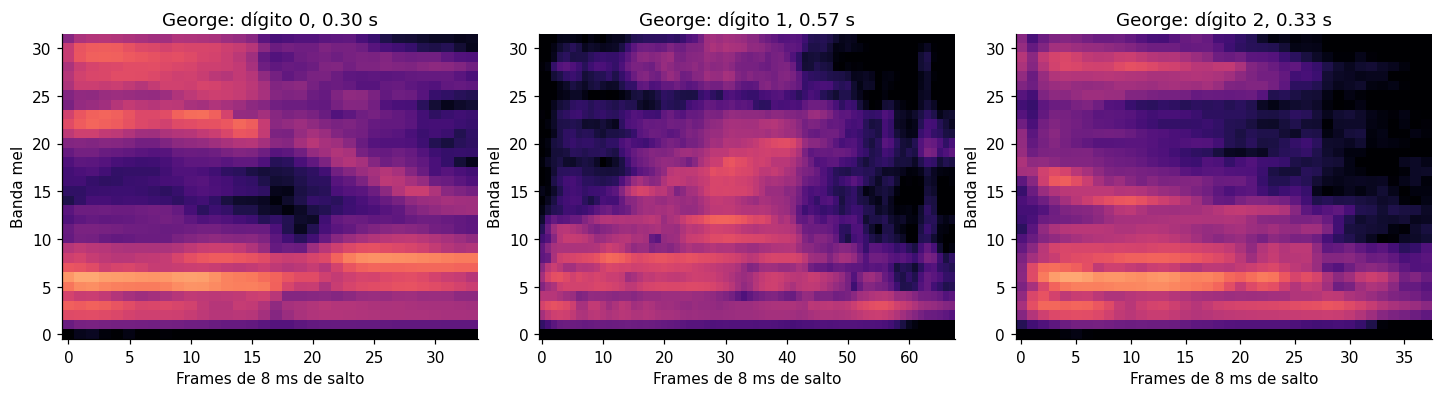
Añadimos 120 grabaciones originales de los dígitos ingleses 0, 1 y 2 de Free Spoken Digit Dataset. Usamos índices 0–9 de cuatro hablantes. George y Jackson aportan entrenamiento, Nicolas validación y Theo prueba. Esta partición por hablante es propia del laboratorio y no reproduce la partición oficial del corpus.
La tarea es clasificar una palabra aislada entre tres dígitos conocidos. No transcribe frases ni evalúa CTC con voz humana. Reservar un hablante prueba transferencia a esa persona bajo sus condiciones de grabación; con cuatro personas y un único hablante de prueba, no estimamos el comportamiento de toda una población.
Ver preparación y entrenamiento con voz humana
import zipfile,io,hashlibfrom scipy.io import wavfilefrom scipy import signalfrom scipy.fft import dctfrom sklearn.pipeline import make_pipelinefrom sklearn.linear_model import LogisticRegressionfrom IPython.display import AudioFS=8000;NFFT=256;HOP=64;NMEL=32freq=np.fft.rfftfreq(NFFT,1/FS);mel=lambda f:2595*np.log10(1+f/700);hz=lambda m:700*(10**(m/2595)-1)puntos=hz(np.linspace(mel(0),mel(FS/2),NMEL+2));filtros=np.zeros((NMEL,len(freq)))for i inrange(NMEL):filtros[i]=np.maximum(0,np.minimum((freq-puntos[i])/(puntos[i+1]-puntos[i]),(puntos[i+2]-freq)/(puntos[i+2]-puntos[i+1])))def logmel_voz(a): _,_,Z=signal.stft(a,FS,window='hann',nperseg=NFFT,noverlap=NFFT-HOP,boundary=None,padded=False)return np.log(np.maximum(filtros@np.abs(Z)**2,1e-8)).astype('float32')manifest_voz=pd.read_csv('manifest-voz.csv');vondas=[];vlm=[];vfeat=[]with zipfile.ZipFile('voz-digitos.zip') as z:for fila in manifest_voz.itertuples(): blob=z.read(fila.archivo);assert hashlib.sha256(blob).hexdigest()==fila.sha256 fs,a=wavfile.read(io.BytesIO(blob));assert fs==FS and a.ndim==1and a.dtype==np.int16 a=a.astype('float32')/32768;assertlen(a)>=NFFT L=logmel_voz(a);cep=dct(L,type=2,axis=0,norm='ortho')[:13];vondas.append(a);vlm.append(L);vfeat.append(np.r_[cep.mean(1),cep.std(1)])vfeat=np.array(vfeat);vlabels=manifest_voz.digito.to_numpy();vtrain=np.flatnonzero(manifest_voz.particion=='entrenamiento');vval=np.flatnonzero(manifest_voz.particion=='validacion');vtest=np.flatnonzero(manifest_voz.particion=='prueba')assertnotset(manifest_voz.hablante.iloc[vtrain])&set(manifest_voz.hablante.iloc[vtest])display(manifest_voz.groupby(['particion','hablante','digito']).size().unstack(fill_value=0))display(pd.DataFrame({'hablante':manifest_voz.hablante,'segundos':[len(a)/FS for a in vondas]}).groupby('hablante').agg(['min','max','mean']))fig,axs=plt.subplots(1,3,figsize=(13,3.5))for ax,c inzip(axs,range(3)): i=int(vtrain[np.flatnonzero(vlabels[vtrain]==c)[0]]);L=vlm[i];ax.imshow(L,origin='lower',aspect='auto',cmap='magma',vmin=-18,vmax=-2);ax.set(title=f'George: dígito {c}, {len(vondas[i])/FS:.2f} s',xlabel='Frames de 8 ms de salto',ylabel='Banda mel');display(Audio(vondas[i],rate=FS,normalize=False))plt.show()
digito
0
1
2
particion
hablante
entrenamiento
george
10
10
10
jackson
10
10
10
prueba
theo
10
10
10
validacion
nicolas
10
10
10
segundos
min
max
mean
hablante
george
0.298000
0.672625
0.506750
jackson
0.439750
0.643500
0.533312
nicolas
0.184375
0.553625
0.348992
theo
0.194500
0.527000
0.297325
24.5.1 Preparar sin borrar duración ni contar relleno
Cada espectrograma conserva su longitud real. La CNN recibirá lotes completados hasta el más largo, con máscara temporal. Aplicamos la máscara tras ambas convoluciones y calculamos un promedio solo de posiciones válidas; también excluimos padding de las estadísticas de entrenamiento.
El baseline utiliza media y desviación de trece MFCC sobre frames reales, con escalador y regresión logística. Sus tres valores de C se seleccionan por log-loss de validación. La CNN se selecciona por la misma métrica tras 40 épocas. Ninguna utiliza a Theo para ajustar o elegir decisiones.
El promedio de frames del baseline descarta orden. La CNN utiliza vecindarios tiempo–frecuencia antes del promedio, pero su pooling global también descarta gran parte del orden. Son clasificadores de palabras aisladas, no decoders de transcripción.
Ver preparación y entrenamiento con voz humana
vm=np.concatenate([vlm[i].ravel() for i in vtrain]).mean();vs=np.concatenate([vlm[i].ravel() for i in vtrain]).std()vdatos=[(tensor((L-vm)/vs),int(c)) for L,c inzip(vlm,vlabels)]def lote_voz(batch): longitud=max(x.shape[1] for x,c in batch);X=torch.zeros(len(batch),1,NMEL,longitud);mask=torch.zeros(len(batch),1,1,longitud);y=[]for i,(x,c) inenumerate(batch):X[i,0,:,:x.shape[1]]=x;mask[i,0,0,:x.shape[1]]=1;y.append(c)return X,mask,torch.tensor(y,dtype=torch.long)class CNNVoz(nn.Module):def__init__(self):super().__init__();self.c1=nn.Conv2d(1,8,3,padding=1);self.c2=nn.Conv2d(8,16,3,padding=1);self.pool=nn.AvgPool2d((2,1));self.fc=nn.Linear(16,3)def forward(self,x,mask): h=self.c1(x).relu()*mask;h=self.pool(h);h=self.c2(h).relu()*mask resumen=h.sum((2,3))/(mask.sum((2,3))*h.shape[2]);returnself.fc(resumen)def prob_voz(m,ids): m.eval();x,mask,y=lote_voz([vdatos[i] for i in ids])with torch.no_grad():return m(x,mask).softmax(-1).numpy()torch.manual_seed(67);voz=CNNVoz();opt=torch.optim.Adam(voz.parameters(),lr=.003);loader=DataLoader([vdatos[i] for i in vtrain],batch_size=16,shuffle=True,collate_fn=lote_voz,generator=torch.Generator().manual_seed(67))mejor_voz=np.inf;hist_voz=[]for ep inrange(1,41): voz.train();suma=0.;n=0for x,mask,y in loader: opt.zero_grad();loss=nn.functional.cross_entropy(voz(x,mask),y);loss.backward();opt.step();suma+=float(loss.detach())*len(y);n+=len(y) p=prob_voz(voz,vval);lv=log_loss(vlabels[vval],p);hist_voz.append((ep,suma/n,lv,balanced_accuracy_score(vlabels[vval],p.argmax(1))))if lv<mejor_voz:mejor_voz=lv;estado=copy.deepcopy(voz.state_dict());ep_voz=epvoz.load_state_dict(estado);baselines=[]for c in [.1,1,10]: b=make_pipeline(StandardScaler(),LogisticRegression(C=c,max_iter=2000)).fit(vfeat[vtrain],vlabels[vtrain]);baselines.append((log_loss(vlabels[vval],b.predict_proba(vfeat[vval])),c,b))lv,c_voz,bvoz=min(baselines,key=lambda x:x[0]);filas_voz=[];preds_voz={}for nombre,p in [('CNN log-mel con máscara',prob_voz(voz,vtest)),('MFCC + logística',bvoz.predict_proba(vfeat[vtest]))]: preds_voz[nombre]=pfor met,v in [('balanceada',balanced_accuracy_score(vlabels[vtest],p.argmax(1))),('log-loss',log_loss(vlabels[vtest],p))]:filas_voz.append({'caso':'voz humana aislada','grupo':'Theo: hablante reservado','modelo':nombre,'métrica':met,'valor':float(v)})display(pd.DataFrame(filas_voz));print('Checkpoint CNN:',ep_voz,'; C seleccionado con Nicolas:',c_voz)fig,axs=plt.subplots(1,3,figsize=(14,4));h=np.array(hist_voz);axs[0].plot(h[:,0],h[:,1],label='George/Jackson');axs[0].plot(h[:,0],h[:,2],label='Nicolas');axs[0].set(xlabel='Época',ylabel='CE',title='Validación en otro hablante');axs[0].legend()for ax,(nombre,p) inzip(axs[1:],preds_voz.items()):ConfusionMatrixDisplay.from_predictions(vlabels[vtest],p.argmax(1),ax=ax,cmap='Blues',colorbar=False);ax.set_title(nombre,fontsize=10);ax.set(xlabel='Clase predicha',ylabel='Clase real')plt.show()# Cambiar el ancho del padding no debe alterar la predicción.x,mask,y=lote_voz([vdatos[vtest[0]]]);voz.eval()with torch.no_grad(): a=voz(x,mask);b=voz(nn.functional.pad(x,(0,20)),nn.functional.pad(mask,(0,20)))assert torch.allclose(a,b,atol=1e-5)print('Invariancia al padding adicional verificada.')resultados_voz=pd.DataFrame(filas_voz);resultados_voz.to_csv('resultados-voz.csv',index=False)protocolo_voz={'fuente':'FSDD','manifest':'manifest-voz.csv','train_hablantes':['george','jackson'],'validacion_hablante':'nicolas','prueba_hablante':'theo','n':120,'digitos':[0,1,2],'checkpoint_CNN':ep_voz,'C_logistica':c_voz,'media_train':float(vm),'sd_train':float(vs),'criterio':'log-loss en Nicolas','particion_oficial':False}lecturas['voz_cnn']=f'{filas_voz[0]["valor"]:.3f}';lecturas['voz_base']=f'{filas_voz[2]["valor"]:.3f}'
caso
grupo
modelo
métrica
valor
0
voz humana aislada
Theo: hablante reservado
CNN log-mel con máscara
balanceada
0.333333
1
voz humana aislada
Theo: hablante reservado
CNN log-mel con máscara
log-loss
7.405700
2
voz humana aislada
Theo: hablante reservado
MFCC + logística
balanceada
0.533333
3
voz humana aislada
Theo: hablante reservado
MFCC + logística
log-loss
0.929859
Checkpoint CNN: 40 ; C seleccionado con Nicolas: 0.1
Invariancia al padding adicional verificada.
24.5.2 Cómo leer este resultado
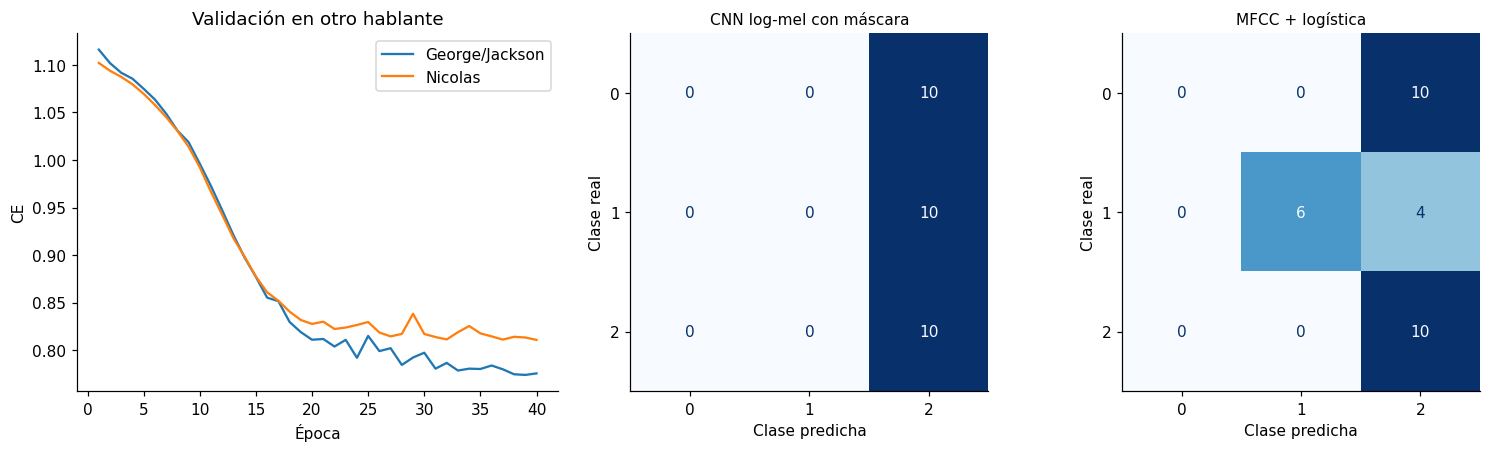
En el hablante reservado, la CNN alcanza accuracy balanceada 0.333 y MFCC con logística 0.533. Las matrices muestran qué dígitos se confunden; la tabla añade log-loss para revisar las probabilidades. Un clasificador puede acertar lo mismo y asignar probabilidades muy diferentes.
Las curvas de entrenamiento y validación pertenecen a hablantes distintos. Una brecha puede reflejar cambio de hablante, canal o acento, además de sobreajuste. No podemos aislar esos factores con esta selección de cuatro personas. El siguiente paso razonable es ampliar hablantes y repetir particiones completas por persona, sin escoger retrospectivamente a Theo porque su resultado sea conveniente.
La prueba contiene treinta grabaciones de una sola persona. No constituye treinta hablantes independientes ni un benchmark oficial de FSDD. Las grabaciones son palabras aisladas en inglés, con poco silencio; estos resultados no estiman reconocimiento de habla continua en español ni robustez de un ASR general.
Los resultados de voz, el manifiesto y el protocolo permiten reconstruir qué datos sostuvo cada decisión.
La CNN acierta diez de treinta grabaciones y el baseline dieciséis. El promedio global de la CNN reduce tanto tiempo como frecuencia: al compartir filtros y promediar bandas puede perder la ubicación absoluta de patrones espectrales. Esta es una hipótesis de arquitectura para comprobar, no una causa establecida por la matriz. Compararía pooling solo temporal y características que conserven bandas usando validación y un nuevo hablante de prueba. Ninguna alternativa actual justifica declarar resuelto el reconocimiento de estos dígitos entre hablantes.
24.6 Del reconocimiento de voz a la alineación
En reconocimiento de voz, la entrada contiene muchos frames acústicos y la transcripción una secuencia más corta. No conocemos necesariamente qué frames corresponden a cada símbolo. Un sistema puede usar encoder-decoder o un objetivo de alineación como CTC. Nuestro siguiente laboratorio recibe vectores acústicos sintéticos por frame para aislar esa segunda idea.
El proceso de una tarea real incluye captura, remuestreo, representación, encoder acústico, vocabulario, decodificación y normalización de transcripciones. Si una persona aparece en varios fragmentos, debe separarse según el objetivo: generalizar a hablantes nuevos exige reservar hablantes, no únicamente fragmentos. La tasa de muestreo y la normalización utilizadas por un modelo preentrenado forman parte de su contrato.
24.7 CTC: sumar caminos compatibles
CTC añade un símbolo blank, distinto de un espacio de texto, silencio etiquetado o PAD. Un camino tiene una etiqueta por frame; al colapsarlo, primero se fusionan repeticiones consecutivas y después se eliminan blanks. Así, a,a,blank,a produce aa, mientras a,a,a produce a.
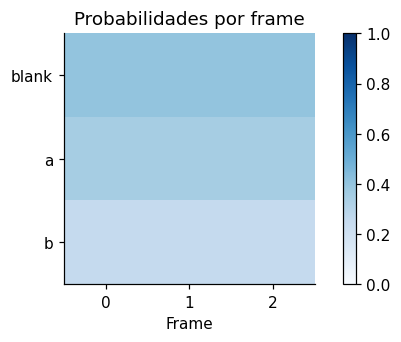
La probabilidad de una transcripción suma las probabilidades de todos los caminos que colapsan a ella. Elegir el camino más probable y después colapsarlo no siempre produce la transcripción más probable. El siguiente ejemplo enumera todos los caminos de tres frames; esa enumeración exacta es viable aquí y crece exponencialmente en una grabación larga.
BLANK=0;letras={0:'∅',1:'a',2:'b',3:'c'}def colapsar(camino):return [v for i,v inenumerate(camino) if v!=BLANK and (i==0or v!=camino[i-1])]for p in [[1,1,0,1],[1,1,1],[0,1,0,2,2]]:print([letras[v] for v in p],'→',''.join(letras[v] for v in colapsar(p)))P=np.array([[.4,.35,.25],[.4,.35,.25],[.4,.35,.25]]);sumas={}for camino in itertools.product(range(3),repeat=3): salida=tuple(colapsar(camino));pr=float(np.prod(P[np.arange(3),camino]));sumas[salida]=sumas.get(salida,0)+prassert np.isclose(sum(sumas.values()),1)ranking=sorted(sumas.items(),key=lambda x:-x[1]);display(pd.DataFrame({'salida':[''.join(letras[v] for v in k) or'(vacía)'for k,p in ranking],'probabilidad':[p for k,p in ranking]}))print('Greedy:',colapsar(P.argmax(1)),'; transcripción más probable:',ranking[0][0])fig,ax=plt.subplots(figsize=(6,3));im=ax.imshow(P.T,cmap='Blues',vmin=0,vmax=1);ax.set(xticks=range(3),xlabel='Frame',yticks=range(3),yticklabels=['blank','a','b'],title='Probabilidades por frame');fig.colorbar(im,ax=ax);plt.show()
['a', 'a', '∅', 'a'] → aa
['a', 'a', 'a'] → a
['∅', 'a', '∅', 'b', 'b'] → ab
salida
probabilidad
0
a
0.308875
1
b
0.185625
2
ab
0.157500
3
ba
0.157500
4
(vacía)
0.064000
5
aa
0.049000
6
aba
0.030625
7
bb
0.025000
8
bab
0.021875
Greedy: [] ; transcripción más probable: (1,)
24.7.1 Longitudes y pérdida CTC
La pérdida recibe log-probabilidades de forma (T,N,C), longitudes reales de entrada y objetivos sin blank. Para \(U\) símbolos y \(R\) repeticiones adyacentes iguales, hacen falta al menos \(U+R\) frames: símbolos iguales deben poder separarse por blank. Una entrada más corta produce una alineación imposible.
Usaremos zero_infinity=False para detectar imposibilidades en vez de ocultarlas con pérdida cero. Verificaremos la condición de longitud antes de entrenar. El padding completa lotes, pero las longitudes impiden contarlo como frames reales.
La versión clásica del objetivo suma caminos usando probabilidades por frame condicionadas en la representación del encoder. No necesita una anotación exacta de tiempos; eso no significa que pueda aprender transcripciones correctas con pares incorrectos.
ctc=nn.CTCLoss(blank=0,reduction='mean',zero_infinity=False)def construir_acustica(n,rng): datos=[];objetivos=[];prototipos=np.eye(4,6,dtype='float32')for i inrange(n): objetivo=rng.integers(1,4,int(rng.integers(2,6))).tolist();frames=[]for v in objetivo: frames.extend([prototipos[0]+rng.normal(0,.08,6) for _ inrange(int(rng.integers(1,3)))]) frames.extend([prototipos[v]+rng.normal(0,.15,6) for _ inrange(int(rng.integers(2,5)))]) frames.extend([prototipos[0]+rng.normal(0,.08,6) for _ inrange(2)]) datos.append(tensor(np.array(frames)));objetivos.append(torch.tensor(objetivo,dtype=torch.long))returnlist(zip(datos,objetivos))rng_ctc=np.random.default_rng(123);ctr=construir_acustica(600,rng_ctc);cva=construir_acustica(120,rng_ctc);cte=construir_acustica(120,rng_ctc)from torch.nn.utils.rnn import pad_sequence,pack_padded_sequence,pad_packed_sequencedef lote_ctc(batch): x,y=zip(*batch);lx=torch.tensor([len(a) for a in x]);ly=torch.tensor([len(a) for a in y])for a,b inzip(x,y):assertlen(a)>=len(b)+int((b[1:]==b[:-1]).sum())return pad_sequence(x,batch_first=True),lx,torch.cat(y),lyclass ModeloCTC(nn.Module):def__init__(self):super().__init__();self.encoder=nn.GRU(6,24,batch_first=True,bidirectional=True);self.salida=nn.Linear(48,4)def forward(self,x,l): packed=pack_padded_sequence(x,l.cpu(),batch_first=True,enforce_sorted=False);out,_=self.encoder(packed);out,_=pad_packed_sequence(out,batch_first=True)returnself.salida(out).log_softmax(-1).transpose(0,1)print('Primer par: frames',tuple(ctr[0][0].shape),'→ objetivo',ctr[0][1].tolist())imposible=torch.zeros(1,1,4).log_softmax(-1)valor=ctc(imposible,torch.tensor([1,1]),torch.tensor([1]),torch.tensor([2]));assert torch.isinf(valor);print('Alineación imposible detectada:',float(valor))
Cada transcripción contiene entre dos y cinco símbolos. Los frames incluyen patrones asociados a cada símbolo y separadores; el encoder bidireccional puede usar contexto pasado y futuro de la grabación completa. No es un modelo de streaming.
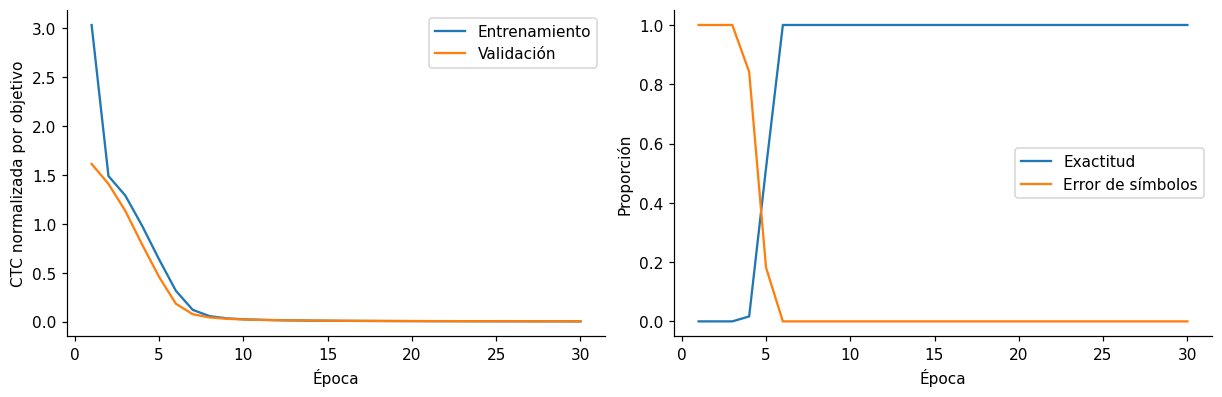
Entrenamos 30 épocas, Adam 0.003 y lotes de 32, con clipping de norma 1. Elegimos checkpoint por pérdida CTC de validación. Registramos también exactitud de transcripción con greedy para comprobar si la pérdida coincide con una mejora de salida. Las secuencias de símbolos pueden repetirse entre particiones, pero sus observaciones acústicas son nuevas: el objetivo es reconocer nuevas realizaciones del vocabulario, no transcripciones nunca vistas.
def distancia_edicion(a,b): dp=np.zeros((len(a)+1,len(b)+1),dtype=int);dp[:,0]=np.arange(len(a)+1);dp[0,:]=np.arange(len(b)+1)for i inrange(1,len(a)+1):for j inrange(1,len(b)+1):dp[i,j]=min(dp[i-1,j]+1,dp[i,j-1]+1,dp[i-1,j-1]+(a[i-1]!=b[j-1]))returnint(dp[-1,-1])def evaluar_ctc(modelo,datos): modelo.eval();suma=0.;n=0;pred=[]with torch.no_grad():for inicio inrange(0,len(datos),64): batch=datos[inicio:inicio+64];x,lx,y,ly=lote_ctc(batch);lp=modelo(x,lx);loss=ctc(lp,y,lx,ly);suma+=float(loss)*len(batch);n+=len(batch) caminos=lp.argmax(-1).T pred.extend([colapsar(p[:int(l)].tolist()) for p,l inzip(caminos,lx)]) ref=[y.tolist() for x,y in datos];exacta=float(np.mean([a==b for a,b inzip(ref,pred)]));ter=sum(distancia_edicion(a,b) for a,b inzip(ref,pred))/sum(map(len,ref))return suma/n,exacta,ter,predtorch.manual_seed(41);modelo_ctc=ModeloCTC();opt=torch.optim.Adam(modelo_ctc.parameters(),lr=.003)loader=DataLoader(ctr,batch_size=32,shuffle=True,collate_fn=lote_ctc,generator=torch.Generator().manual_seed(41));hist_ctc=[];mejor=np.inffor ep inrange(1,31): modelo_ctc.train();suma=0.;n=0for x,lx,y,ly in loader: opt.zero_grad();loss=ctc(modelo_ctc(x,lx),y,lx,ly);assert torch.isfinite(loss);loss.backward();nn.utils.clip_grad_norm_(modelo_ctc.parameters(),1.);opt.step();suma+=float(loss.detach())*len(x);n+=len(x) lv,exacta,ter,p=evaluar_ctc(modelo_ctc,cva);hist_ctc.append((ep,suma/n,lv,exacta,ter))if lv<mejor:mejor=lv;estado=copy.deepcopy(modelo_ctc.state_dict());ep_ctc=epmodelo_ctc.load_state_dict(estado);hist_ctc=np.array(hist_ctc)fig,axs=plt.subplots(1,2,figsize=(11,3.5));axs[0].plot(hist_ctc[:,0],hist_ctc[:,1],label='Entrenamiento');axs[0].plot(hist_ctc[:,0],hist_ctc[:,2],label='Validación');axs[0].set(xlabel='Época',ylabel='CTC normalizada por objetivo');axs[0].legend()axs[1].plot(hist_ctc[:,0],hist_ctc[:,3],label='Exactitud');axs[1].plot(hist_ctc[:,0],hist_ctc[:,4],label='Error de símbolos');axs[1].set(xlabel='Época',ylabel='Proporción');axs[1].legend();plt.show()print('Checkpoint por CTC:',ep_ctc)
Checkpoint por CTC: 30
24.8.1 Búsqueda por prefijos: sumar caminos sin enumerarlos todos
Una búsqueda CTC mantiene, para cada prefijo, probabilidad de terminar en blank y en símbolo. Si el siguiente símbolo coincide con el último, debe distinguir repetición dentro del mismo tramo de repetición separada por blank. Usaremos ancho 5, fijo antes de prueba, sin modelo de lenguaje. No es el beam autoregresivo del capítulo anterior: aquí agregamos probabilidades de caminos compatibles con un prefijo.
Verificamos la implementación con el ejemplo de tres frames: con ancho suficiente, debe coincidir con la enumeración exacta. En secuencias largas el ancho limita la búsqueda y puede descartar una transcripción que después sería competitiva.
def prefijos_ctc(P,width=5): haces={(): (1.,0.)}for fila in P: nuevos={}def agregar(pref,b=0.,nb=0.): a,c=nuevos.get(pref,(0.,0.));nuevos[pref]=(a+b,c+nb)for pref,(pb,pnb) in haces.items(): agregar(pref,b=(pb+pnb)*fila[0])for c inrange(1,len(fila)):if pref and pref[-1]==c: agregar(pref,nb=pnb*fila[c]);agregar(pref+(c,),nb=pb*fila[c])else:agregar(pref+(c,),nb=(pb+pnb)*fila[c]) haces=dict(sorted(nuevos.items(),key=lambda kv:-sum(kv[1]))[:width]) escala=max(sum(v) for v in haces.values())if escala>0:haces={k:(b/escala,nb/escala) for k,(b,nb) in haces.items()}returnlist(max(haces,key=lambda k:sum(haces[k])))asserttuple(prefijos_ctc(P,100))==ranking[0][0]lp,exacta,ter,greedy_preds=evaluar_ctc(modelo_ctc,cte);beam_preds=[]modelo_ctc.eval()with torch.no_grad():for x,y in cte: pr=modelo_ctc(x[None],torch.tensor([len(x)])).exp()[:,0].numpy();beam_preds.append(prefijos_ctc(pr,5))refs=[y.tolist() for x,y in cte];res_ctc=[]for nombre,p in [('Greedy',greedy_preds),('Prefijos ancho 5',beam_preds)]: ex=float(np.mean([a==b for a,b inzip(refs,p)]));er=sum(distancia_edicion(a,b) for a,b inzip(refs,p))/sum(map(len,refs))for met,v in [('exactitud transcripción',ex),('error de símbolos',er)]:res_ctc.append({'caso':'CTC sintético','grupo':'prueba','modelo':nombre,'métrica':met,'valor':v})display(pd.DataFrame(res_ctc));display(pd.DataFrame({'referencia':[''.join(letras[v] for v in s) for s in refs[:8]],'greedy':[''.join(letras[v] for v in s) for s in greedy_preds[:8]],'beam':[''.join(letras[v] for v in s) for s in beam_preds[:8]]}))with torch.no_grad(): x,y=cte[0];post=modelo_ctc(x[None],torch.tensor([len(x)])).exp()[:,0].numpy()fig,ax=plt.subplots(figsize=(10,3));im=ax.imshow(post.T,aspect='auto',cmap='Blues',vmin=0,vmax=1);ax.set(xlabel='Frame real',yticks=range(4),yticklabels=['blank','a','b','c'],title='Posteriores CTC de la primera muestra de prueba');fig.colorbar(im,ax=ax,label='Probabilidad por frame');plt.show()lecturas['ctc_exact']=f'{res_ctc[0]["valor"]:.3f}';lecturas['ctc_beam']=f'{res_ctc[2]["valor"]:.3f}'
caso
grupo
modelo
métrica
valor
0
CTC sintético
prueba
Greedy
exactitud transcripción
1.0
1
CTC sintético
prueba
Greedy
error de símbolos
0.0
2
CTC sintético
prueba
Prefijos ancho 5
exactitud transcripción
1.0
3
CTC sintético
prueba
Prefijos ancho 5
error de símbolos
0.0
referencia
greedy
beam
0
cba
cba
cba
1
ccb
ccb
ccb
2
acb
acb
acb
3
caac
caac
caac
4
ac
ac
ac
5
caabb
caabb
caabb
6
abbba
abbba
abbba
7
ca
ca
ca
24.8.2 Cómo leer este resultado
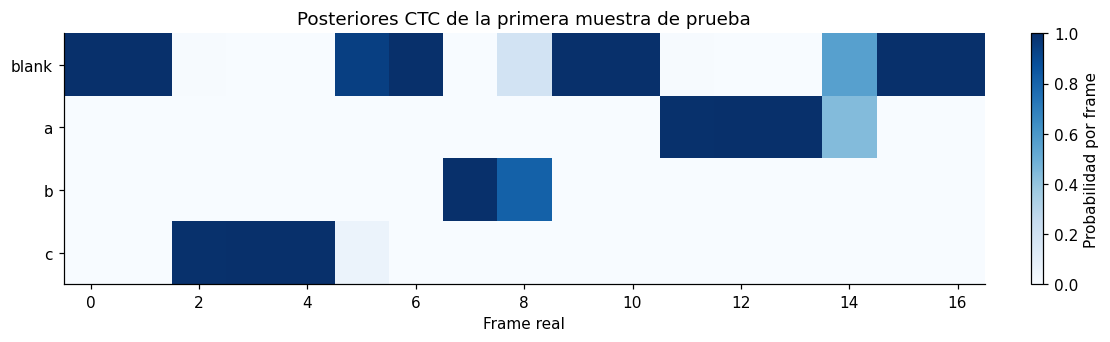
La exactitud de transcripción es 1.000 con greedy y 1.000 con búsqueda de prefijos. Si coinciden, este laboratorio no demuestra una ventaja del beam; la verificación exacta anterior sí demuestra por qué sumar caminos puede cambiar una decisión. El mapa permite observar cómo blank separa emisiones y cómo una referencia corta corresponde a varios frames.
No hemos usado WAV humanos ni un vocabulario lingüístico. El éxito en estos patrones construidos no es una métrica de reconocimiento de voz. En una aplicación real también habría pronunciaciones, habla continua, variación de canal, vocabulario y errores de transcripción.
24.9 WER, CER y normalización de transcripciones
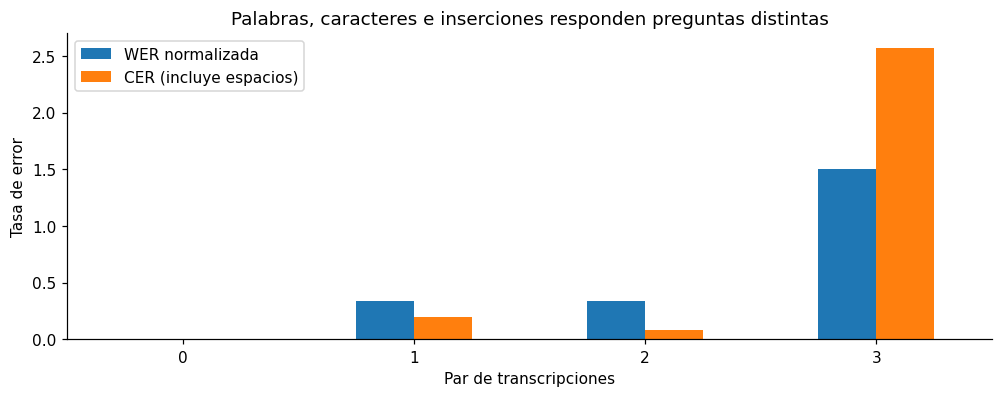
La tasa de error de palabras es (sustituciones + eliminaciones + inserciones) / palabras de referencia. CER aplica la misma distancia a caracteres. Ambas agregan conteos sobre todas las referencias antes de dividir; promediar tasas por frase asigna otro peso. Pueden superar 1 cuando hay muchas inserciones.
No son porcentajes de frases correctas ni accuracy por token. Antes de calcularlas hay que definir tratamiento de mayúsculas, signos, tildes, números y espacios. Mostraremos transcripciones inventadas para verificar esos efectos; no son predicciones del modelo CTC sintético.
import unicodedatapares=[('Abre la puerta','abre la puerta'),('enciende la luz','enciende luz'),('llama a mamá','llama a mama'),('uno dos','uno dos tres cuatro cinco')]def normalizar(s):return' '.join(s.lower().split())filas_wer=[];errores_pal=0;total_pal=0;errores_car=0;total_car=0for referencia,hipotesis in pares: r,h=normalizar(referencia),normalizar(hipotesis);ep=distancia_edicion(r.split(),h.split());ec=distancia_edicion(list(r),list(h)) errores_pal+=ep;total_pal+=len(r.split());errores_car+=ec;total_car+=len(r) filas_wer.append({'referencia':referencia,'hipótesis':hipotesis,'WER normalizada':ep/len(r.split()),'CER (incluye espacios)':ec/len(r),'WER sin normalizar':distancia_edicion(referencia.split(),hipotesis.split())/len(referencia.split())})display(pd.DataFrame(filas_wer));print('WER de corpus:',round(errores_pal/total_pal,4),'CER de corpus:',round(errores_car/total_car,4))assert distancia_edicion(['uno','dos'],['uno','dos','tres','cuatro','cinco'])/2==1.5fig,ax=plt.subplots(figsize=(9,3.5));pd.DataFrame(filas_wer)[['WER normalizada','CER (incluye espacios)']].plot.bar(ax=ax,rot=0);ax.set(xlabel='Par de transcripciones',ylabel='Tasa de error',title='Palabras, caracteres e inserciones responden preguntas distintas');plt.show()resultados=pd.concat([tabla_audio,pd.DataFrame(res_ctc),resultados_voz],ignore_index=True);resultados.to_csv('resultados.csv',index=False);pd.DataFrame(filas_wer).to_csv('ejemplos-wer-cer.csv',index=False)protocolo={'tonos':{'fs':FS,'nfft':NFFT,'hop':HOP,'mel':NMEL,'media_train':float(mu),'sd_train':float(sd),'train':tr.tolist(),'validacion':va.tolist(),'prueba':te.tolist(),'checkpoint':ep_audio,'snr_declarada':[0,-10]},'ctc':{'semilla':123,'train':600,'validacion':120,'prueba':120,'checkpoint':ep_ctc,'blank':0,'beam':5,'vocabulario':letras,'voz_humana':False},'WER':{'normalizacion':'minúsculas y espacios; conserva tildes','CER_incluye_espacios':True,'transcripciones':'inventadas para comprobar métricas'},'versiones':{'torch':torch.__version__,'scipy':scipy.__version__}}protocolo['voz_real']=protocolo_vozPath('protocolo.json').write_text(json.dumps(protocolo,ensure_ascii=False,indent=2),encoding='utf-8')
referencia
hipótesis
WER normalizada
CER (incluye espacios)
WER sin normalizar
0
Abre la puerta
abre la puerta
0.000000
0.000000
0.333333
1
enciende la luz
enciende luz
0.333333
0.200000
0.333333
2
llama a mamá
llama a mama
0.333333
0.083333
0.333333
3
uno dos
uno dos tres cuatro cinco
1.500000
2.571429
1.500000
WER de corpus: 0.4545 CER de corpus: 0.4583
11064
24.9.1 Interpretar antes de decidir
Una tilde puede cambiar una palabra completa en WER y un solo carácter en CER. Normalizar mayúsculas elimina un tipo de discrepancia, pero no determina automáticamente qué cambios son aceptables en el producto. Si una orden contiene un nombre o un número, una sola sustitución puede ser más relevante que varias diferencias de puntuación.
Además de WER y CER, un ASR debería medir exactitud de campos importantes, errores por hablante y condición, latencia y conducta ante silencio o audio fuera de dominio. La evaluación de streaming necesita declarar cuánto futuro utiliza el sistema. Este encoder bidireccional procesa la grabación completa; su costo y resultados no equivalen a una aplicación en tiempo real.
24.10 Encoders acústicos y adaptación de modelos
Clasificación de una palabra, alineación de una transcripción y generación de texto requieren recorridos diferentes. También podemos cambiar el encoder sin cambiar necesariamente el objetivo final.
Preentrenamiento sobre audio con un objetivo autosupervisado y posterior adaptación
Exactitud de transcripción sin una adaptación evaluada
Encoder-decoder
Salida condicionada en la secuencia y sus símbolos previos
Alineación correcta ni ausencia de errores generativos
Estos diseños no se ejecutan aquí salvo la GRU. Para adaptar un checkpoint hay que verificar tasa de muestreo, normalización, longitudes después del encoder, vocabulario, blank si usa CTC y contexto futuro permitido. Entrenar una cabeza con símbolos de otro idioma modifica el problema y necesita datos reservados del destino.
Un modelo de lenguaje puede mejorar el ranking de transcripciones, pero también favorecer frases frecuentes que no fueron pronunciadas. Se deben comparar resultados acústicos y resultados con esa ayuda bajo la misma referencia, distinguiendo ganancia de decodificación de ganancia del encoder. El texto y sus modelos especializados se desarrollan en el libro de NLP; el contrato acústico y su evaluación permanecen en este capítulo.
24.11 Preparación reutilizable y decisiones
Hallazgo
Qué revisar
Acción razonable
Frecuencias imposibles tras conversión
Tasa y filtrado
Corregir remuestreo antes de ajustar
Audio recortado
Picos y rango digital
Revisar captura y escalado
Red débil bajo ruido
SNR, representación y entrenamiento
Validar aumentación compatible con la tarea
Pérdida CTC infinita
Longitudes y símbolos repetidos
Corregir pares imposibles; no ocultarlos
Greedy y beam distintos
Suma de caminos y costo
Validar búsqueda en datos reservados
WER cambiante con normalización
Convención de transcripción
Fijar y documentar la regla
Buen promedio y fallas por hablante
Partición y distribución
Evaluar grupos pertinentes
Para batches variables, las muestras de waveform se completan y se guarda longitud en muestras; después de STFT, subsampling o convolución se recalculan longitudes en frames. No se pueden pasar longitudes en segundos a CTC ni reutilizar las de waveform como si fueran frames. Un cambio en el stride modifica ese contrato.
La aumentación de volumen, ruido, reverberación o velocidad requiere comprobar etiquetas. Cambiar velocidad modifica duración y puede modificar pitch según la implementación; pitch shifting y time stretching no son la misma transformación. Si la tarea depende de tono, una transformación válida para palabras puede cambiar nuestra clase de frecuencia.
24.12 Actividades
Sustituye ruido blanco por interferencia tonal y conserva la misma SNR. Compara FFT y CNN sin presuponer el mismo resultado.
Construye duraciones variables y verifica las máscaras después de transformar a frames. Mantén las grabaciones completas en una sola partición.
Incrementa símbolos repetidos en CTC y calcula el mínimo de frames requerido. Inspecciona blank antes de añadir capas.
Compara un encoder unidireccional con el bidireccional bajo el mismo presupuesto. Explica qué contexto necesita cada uno.
Define un corpus humano con permiso de uso y separación por hablante. Antes de entrenar, fija normalización, vocabulario y métricas.
Cambia la política de números y puntuación en los ejemplos de WER. Identifica qué mejora procede de evaluación y cuál de transcripción.
24.13 Contrato común y persistencia
La frecuencia de muestreo, duración, espectrograma y normalización forman parte del dato. Se conservan tanto las señales sintéticas como el pequeño laboratorio FSDD de palabras humanas aisladas, separado por hablante. Ninguno acredita reconocimiento de habla continua. Se registran las versiones y estados de PyTorch.
Esta ejecución conserva el desarrollo didáctico y las recetas del capítulo. El cierre registra entorno, tablas y pesos en artefactos_pytorch/. Los estados serializados se recargan en una copia de la arquitectura y se comprueba identidad de parámetros y buffers; esa comprobación de persistencia no sustituye una evaluación de inferencia ni demuestra calidad predictiva. Los pesos guardados no incluyen todos los estados necesarios para reanudar exactamente el experimento.
from pathlib import Pathimport json,hashlib,copy,shutil,platformimport torchartefactos_cierre=Path('artefactos_pytorch');artefactos_cierre.mkdir(exist_ok=True)modulos_cierre=[];vistos_cierre=set()for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,torch.nn.Module) andid(objeto_cierre) notin vistos_cierre: vistos_cierre.add(id(objeto_cierre));estado_cierre={k:v.detach().cpu().clone() for k,v in objeto_cierre.state_dict().items()}assertall(torch.isfinite(v).all() for v in estado_cierre.values() if v.is_floating_point()),nombre_cierre ruta_cierre=artefactos_cierre/f'{nombre_cierre}-estado.pt';torch.save({'state_dict':estado_cierre},ruta_cierre) copia_cierre=copy.deepcopy(objeto_cierre).cpu();copia_cierre.load_state_dict(torch.load(ruta_cierre,map_location='cpu',weights_only=True)['state_dict'])assertall(torch.equal(v.cpu(),estado_cierre[k]) for k,v in copia_cierre.state_dict().items()) modulos_cierre.append({'variable':nombre_cierre,'clase':type(objeto_cierre).__name__,'parametros':sum(p.numel() for p in objeto_cierre.parameters()),'recarga_estado':True})for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,pd.DataFrame) andlen(objeto_cierre)<100000:objeto_cierre.to_csv(artefactos_cierre/f'tabla-{nombre_cierre}.csv',index=False)for ruta_cierre inlist(Path('.').iterdir()):if ruta_cierre.is_file() and ruta_cierre.suffix in ['.csv','.json','.joblib','.pt','.wav','.npz']:shutil.copy2(ruta_cierre,artefactos_cierre/ruta_cierre.name)registro_cierre={'python':platform.python_version(),'torch':str(torch.__version__),'numpy':np.__version__,'sklearn':sklearn.__version__,'modulos':modulos_cierre,'alcance':'identidad de parámetros/buffers al recargar; no reanudación completa','archivos':{p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in artefactos_cierre.iterdir() if p.is_file()}}(artefactos_cierre/'cierre-armonizacion.json').write_text(json.dumps(registro_cierre,ensure_ascii=False,indent=2),encoding='utf-8')print('Estados recargados y verificados:',len(modulos_cierre),'| archivos registrados:',len(registro_cierre['archivos']))
Estados recargados y verificados: 4 | archivos registrados: 16
24.13.1 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
Se conservaron waveform, espectrograma, aliasing/remuestreo, clasificación bajo ruido, palabras humanas aisladas FSDD y la GRU con CTC sintético. En FSDD se mantienen 120 grabaciones de dígitos 0/1/2, entrenamiento con George/Jackson, validación Nicolas y prueba Theo; las huellas de los archivos y la invariancia al padding se comprueban. Treinta grabaciones de una persona no constituyen treinta hablantes ni un benchmark oficial. El contrato distingue muestras, frames, longitudes y blank. Se guardaron sonidos y tablas junto a los estados, conservando la diferencia entre métrica de entrenamiento, decodificación y normalización WER/CER.
La armonización verificó identidad de parámetros y buffers tras recarga de 4 módulos presentes al cierre; archivó 16 archivos con SHA-256. Esta prueba no incluye reanudación exacta del optimizador ni sustituye las evaluaciones predictivas del capítulo.