Recomendar significa ordenar opciones para una persona en un contexto. Predecir una calificación, recuperar productos y elegir diez elementos para una pantalla son tareas distintas: cambian los datos, la pérdida y la evaluación. Un clic registra una interacción bajo cierta exposición; no demuestra satisfacción ni rechazo de lo que no se mostró.
Construiremos un catálogo sintético con usuarios, categorías, exposición desigual y productos nuevos. Compararemos popularidad, contenido, factorización y una interacción neuronal. Después separaremos recuperación, ordenamiento y diversidad. El catálogo pequeño permite evaluar todas las opciones y detectar cambios engañosos en las métricas. No se pretende reproducir un servicio comercial.
Exposición, posición y disponibilidad afectan la señal
Impresión sin clic
Se mostró y no hubo interacción
Puede depender del contexto, no de desagrado
Ausencia de registro
No conocemos interacción
No constituye un negativo confirmado
En calificaciones suele utilizarse RMSE; para listas importan Recall@K, NDCG@K y restricciones del catálogo. Una menor RMSE no garantiza mejor ordenamiento. Aquí la unidad es usuario con al menos un positivo futuro elegible, la etiqueta es clic y la tarea es recomendar productos aún no consumidos.
Definimos ventanas globales de entrenamiento, validación y prueba. No mezclamos eventos al azar: perfiles y popularidad se construyen con el pasado disponible. La misma persona aparece en varias ventanas porque evaluamos eventos futuros de usuarios conocidos. Los usuarios nuevos se reportan aparte.
import numpy as npimport sklearnimport json, copy, platformfrom pathlib import Pathimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom IPython.display import display, Markdownimport torchfrom torch import nnimport torch.nn.functional as Ftorch.set_num_threads(1)torch.manual_seed(42)plt.rcParams.update({'figure.figsize':(9,4),'font.size':11,'axes.spines.top':False,'axes.spines.right':False})def lectura(s):display(Markdown('### Cómo leer este resultado\n\n'+s))print('Python',platform.python_version(),'| NumPy',np.__version__,'| PyTorch',torch.__version__,'| CPU')
Python 3.13.9 | NumPy 2.3.5 | PyTorch 2.14.1+cpu | CPU
30.2 Un generador con exposición y preferencia separadas
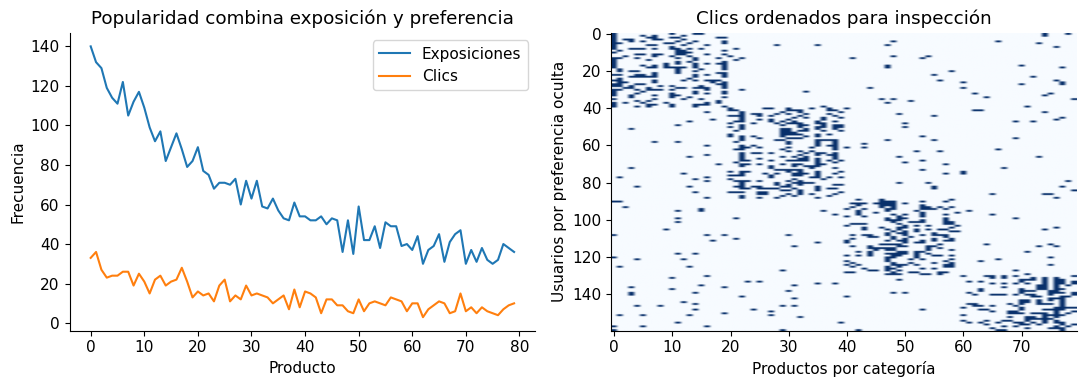
Hay 160 usuarios conocidos, 20 nuevos, 80 productos iniciales y 20 incorporados en prueba. Cuatro categorías están disponibles como metadatos. El simulador asigna una preferencia principal a cada usuario, pero los modelos no reciben esa preferencia oculta: reciben clics y categorías.
Cada ventana muestra hasta 32 productos no consumidos previamente. Algunos IDs reciben más exposición; la probabilidad de clic es 0.72 en la categoría preferida y 0.055 en las demás. Conservamos impresiones sin clic, aunque entrenaremos con positivos y negativos muestreados. Esta decisión no utiliza toda la información de exposición y limita la interpretación.
rng=np.random.default_rng(30)NU,NI,WU,WI=180,100,160,80category=np.arange(NI)%4;preference=rng.integers(0,4,NU)weights=1/(1+np.arange(NI)/10);rows=[];consumed=[set() for _ inrange(NU)]for window,users,n in [('train',range(WU),WI),('validation',range(WU),WI),('test',range(NU),NI)]:for u in users: ids=np.array([i for i inrange(n) if i notin consumed[u]]) prob=weights[ids]/weights[ids].sum()for i in rng.choice(ids,min(32,len(ids)),replace=False,p=prob): click=int(rng.random() < (.72if category[i]==preference[u] else.055)) rows.append((window,u,int(i),int(category[i]),click))if click:consumed[u].add(int(i))events=pd.DataFrame(rows,columns=['window','user','item','category','click'])positive={w:events.query('window==@w and click==1')[['user','item']].to_numpy() for w in ['train','validation','test']}history=[set(positive['train'][positive['train'][:,0]==u,1]) for u inrange(NU)]history_test=[history[u]|set(positive['validation'][positive['validation'][:,0]==u,1]) for u inrange(NU)]assertset(positive['train'][:,1])==set(range(WI))assertset(positive['train'][:,0])==set(range(WU))assertall(not history[u]&set(positive['validation'][positive['validation'][:,0]==u,1]) for u inrange(NU))summary=events.groupby('window',sort=False).agg(impressions=('click','size'),clicks=('click','sum'),users=('user','nunique'))display(summary)fig,ax=plt.subplots(1,2,figsize=(11,4))counts=events.query('window=="train"').groupby('item').agg(shown=('click','size'),clicks=('click','sum')).reindex(range(WI),fill_value=0)ax[0].plot(counts.shown,label='Exposiciones');ax[0].plot(counts.clicks,label='Clics');ax[0].legend();ax[0].set(title='Popularidad combina exposición y preferencia',xlabel='Producto',ylabel='Frecuencia')matrix=np.zeros((WU,WI));matrix[positive['train'][:,0],positive['train'][:,1]]=1ax[1].imshow(matrix[np.argsort(preference[:WU])][:,np.argsort(category[:WI])],aspect='auto',cmap='Blues');ax[1].set(title='Clics ordenados para inspección',xlabel='Productos por categoría',ylabel='Usuarios por preferencia oculta');plt.tight_layout();plt.show()lectura(f'Hay {len(positive["train"])} clics de entrenamiento sobre {summary.loc["train","impressions"]} impresiones. Mayor frecuencia de clics puede proceder de más oportunidades. El orden por preferencia oculta se usa solo en la visualización: no entra en entrenamiento ni selección.')
impressions
clicks
users
window
train
5120
1102
160
validation
5120
905
160
test
5760
899
180
30.2.1 Cómo leer este resultado
Hay 1102 clics de entrenamiento sobre 5120 impresiones. Mayor frecuencia de clics puede proceder de más oportunidades. El orden por preferencia oculta se usa solo en la visualización: no entra en entrenamiento ni selección.
30.3 Métricas para listas completas
Sean \(R_u\) los positivos futuros y \(L_u^K\) la lista recomendada:
Con relevancia binaria, \(DCG@K=\sum_{r=1}^{K}rel_r/\log_2(r+1)\) y \(NDCG=DCG/IDCG\). El ranking ideal utiliza \(\min(K,|R_u|)\) relevantes. Promediamos por usuario, no por evento. Si no hay positivos elegibles, Recall queda indefinido y se excluye al usuario indicando población.
Cobertura es la fracción del catálogo que aparece en alguna lista. Diversidad es número de categorías distintas dividido entre cuatro: una definición explícita, no una medida universal de satisfacción. La cuota de productos populares utiliza el top 20 calculado en entrenamiento. Catálogo y población forman parte del protocolo.
pop=np.bincount(positive['train'][:,1],minlength=NI).astype(float);head=set(np.argsort(-pop,kind='stable')[:20])profiles=np.zeros((NU,4))for u inrange(NU):for i in history[u]:profiles[u,category[i]]+=1profiles/=np.maximum(profiles.sum(1,keepdims=True),1)content=profiles[:,category]+.001*pop[None,:]/pop.max();popular=np.tile(pop,(NU,1))def relevant(window,u): a=positive[window];returnset(a[a[:,0]==u,1])def candidates(window,u): h=history if window=='validation'else history_test;n=WI if window=='validation'else NIreturn np.array([i for i inrange(n) if i notin h[u]],dtype=int)def rank(scores,window,u,k=10,pool=None): ids=candidates(window,u) if pool isNoneelse np.asarray(pool,dtype=int)# No se recomiendan IDs sin puntuación entrenada. ids=ids[np.isfinite(scores[u,ids])]return ids[np.argsort(-scores[u,ids],kind='stable')[:k]]def list_metrics(lists,window,users,n): rows=[];shown=[]for u in users: rel=relevant(window,u)ifnot rel:continue listing=np.asarray(lists[u]);hits=np.isin(listing,list(rel)).astype(float) dcg=np.sum(hits/np.log2(np.arange(len(hits))+2));ideal=np.sum(1/np.log2(np.arange(min(10,len(rel)))+2)) cold=rel&set(range(WI,NI)) rows.append({'user':u,'recall':hits.sum()/len(rel),'precision':hits.sum()/10,'ndcg':dcg/ideal,'diversity':len(set(category[listing]))/4,'head_share':np.mean([i in head for i in listing]),'cold_recall':len(set(listing)&cold)/len(cold) if cold else np.nan}) shown.extend(listing) detail=pd.DataFrame(rows);out=detail.drop(columns='user').mean().to_dict() out.update(users=len(detail),cold_users=int(detail.cold_recall.notna().sum()),coverage=len(set(shown))/n)return out,detaildef evaluate(scores,window,users=range(WU)):return list_metrics({u:rank(scores,window,u) for u in users},window,users,WI if window=='validation'else NI)assert np.isclose(1/(1+1/np.log2(3)),.6131471927654584)display(pd.DataFrame([{'model':name,**evaluate(s,'validation')[0]} for name,s in [('Popularidad',popular),('Contenido',content)]]).round(3))
model
recall
precision
ndcg
diversity
head_share
cold_recall
users
cold_users
coverage
0
Popularidad
0.210
0.119
0.158
0.959
1.00
NaN
160
0
0.200
1
Contenido
0.604
0.336
0.554
0.250
0.27
NaN
160
0
0.938
30.4 Factorización: embeddings y BPR
Una tabla aprende \(p_u\) por usuario y \(q_i\) por producto; factorización usa \(s(u,i)=p_u^Tq_i+b_i\). Una categoría es un atributo observado y un embedding de ID es un parámetro aprendido. Un ID nuevo no dispone de entrenamiento.
BPR compara un positivo observado \(i\) con un producto \(j\) no observado hasta el corte:
\[\mathcal L_{BPR}=-\log\sigma(s(u,i)-s(u,j)).\]
El negativo no significa rechazo. Para muestrearlo consultamos solo historia y catálogo de entrenamiento; excluir futuros positivos usando prueba introduciría información futura. Se usa un negativo uniforme por positivo y época y weight decay 0.0001.
30.5 Interacción neuronal
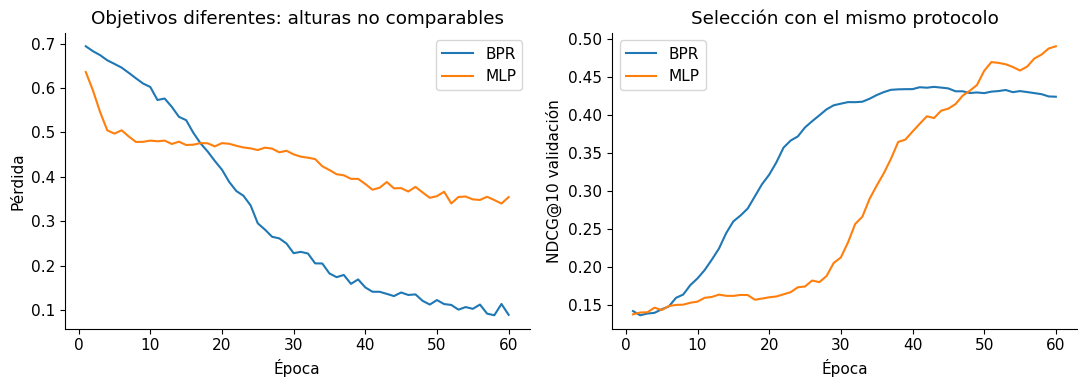
El segundo modelo concatena embeddings y los combina mediante MLP. Utiliza cuatro negativos por positivo y BCE con logits. El ratio artificial impide interpretar la sigmoide como probabilidad de compra. Ambos tienen embeddings de dimensión 16, Adam 0.01 y 60 épocas; seleccionamos cada checkpoint por NDCG@10 de validación.
La comparación incluye arquitectura, objetivo y muestreo. No aísla el efecto de cambiar únicamente producto interno por MLP. Las pérdidas tienen escalas distintas y no sirven para elegir entre modelos.
Código
class Recommender(nn.Module):def__init__(self,kind):super().__init__();self.kind=kind;self.users=nn.Embedding(WU,16);self.items=nn.Embedding(WI,16);self.bias=nn.Embedding(WI,1) nn.init.normal_(self.users.weight,std=.1);nn.init.normal_(self.items.weight,std=.1);nn.init.zeros_(self.bias.weight)if kind=='MLP':self.mlp=nn.Sequential(nn.Linear(32,32),nn.ReLU(),nn.Linear(32,1))def forward(self,u,i): p,q=self.users(u),self.items(i)return (p*q).sum(-1)+self.bias(i).squeeze(-1) ifself.kind=='BPR'elseself.mlp(torch.cat([p,q],-1)).squeeze(-1)def model_scores(model): model.eval();scores=np.full((NU,NI),-np.inf)with torch.no_grad(): u=torch.arange(WU).repeat_interleave(WI);i=torch.arange(WI).repeat(WU) scores[:WU,:WI]=model(u,i).numpy().reshape(WU,WI) scores[WU:,:WI]=pop[:WI] # Fallback para usuario desconocido.return scoresnegative_pool=[np.array([i for i inrange(WI) if i notin history[u]]) for u inrange(WU)]models={};training=[];selection=[]for kind in ['BPR','MLP']: torch.manual_seed(302if kind=='BPR'else303);gen=np.random.default_rng(304if kind=='BPR'else305) model=Recommender(kind);opt=torch.optim.Adam(model.parameters(),lr=.01,weight_decay=.0001);best=-np.inffor epoch inrange(1,61): model.train();losses=[];pairs=positive['train'][gen.permutation(len(positive['train']))]for start inrange(0,len(pairs),512): batch=pairs[start:start+512];u=torch.tensor(batch[:,0]);i=torch.tensor(batch[:,1])if kind=='BPR': j=torch.tensor([gen.choice(negative_pool[int(x)]) for x in batch[:,0]]) loss=F.softplus(-(model(u,i)-model(u,j))).mean()else: neg=np.array([[gen.choice(negative_pool[int(x)]) for _ inrange(4)] for x in batch[:,0]]) uu=torch.cat([u,u.repeat_interleave(4)]);ii=torch.cat([i,torch.tensor(neg.reshape(-1))]);y=torch.cat([torch.ones(len(u)),torch.zeros(4*len(u))]) loss=F.binary_cross_entropy_with_logits(model(uu,ii),y) opt.zero_grad();loss.backward();opt.step();losses.append(loss.item()) val=evaluate(model_scores(model),'validation')[0] training.append({'model':kind,'epoch':epoch,'loss':np.mean(losses),'val_ndcg':val['ndcg']})if val['ndcg']>best:best=val['ndcg'];state=copy.deepcopy(model.state_dict());best_epoch=epoch model.load_state_dict(state);models[kind]=model;selection.append({'model':kind,'epoch':best_epoch,'val_ndcg':best,'parameters':sum(x.numel() for x in model.parameters())})curves=pd.DataFrame(training);selected=pd.DataFrame(selection);display(selected.round(4))fig,ax=plt.subplots(1,2,figsize=(11,4))for kind,g in curves.groupby('model'): ax[0].plot(g.epoch,g.loss,label=kind);ax[1].plot(g.epoch,g.val_ndcg,label=kind)ax[0].set(title='Objetivos diferentes: alturas no comparables',xlabel='Época',ylabel='Pérdida');ax[1].set(title='Selección con el mismo protocolo',xlabel='Época',ylabel='NDCG@10 validación')for a in ax:a.legend()plt.tight_layout();plt.show()lectura('; '.join(f'{r.model}: checkpoint {r.epoch}, NDCG de validación {r.val_ndcg:.3f}'for r in selected.itertuples())+'. Cada checkpoint se eligió sin consultar prueba. Una menor BCE frente a BPR no indica mejor ranking: sus pérdidas representan problemas distintos.')
model
epoch
val_ndcg
parameters
0
BPR
43
0.4376
3920
1
MLP
60
0.4910
5009
30.5.1 Cómo leer este resultado
BPR: checkpoint 43, NDCG de validación 0.438; MLP: checkpoint 60, NDCG de validación 0.491. Cada checkpoint se eligió sin consultar prueba. Una menor BCE frente a BPR no indica mejor ranking: sus pérdidas representan problemas distintos.
30.6 Ver los embeddings y auditar una lista
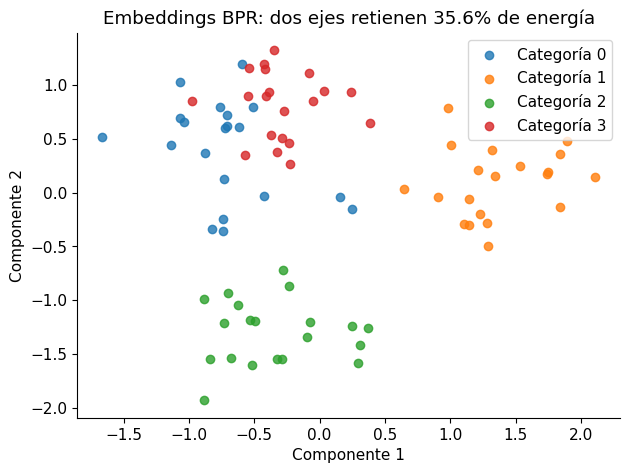
Un embedding no viene con un significado fijo por coordenada. En factorización, aplicar la misma rotación ortogonal a vectores de usuario y producto conserva sus productos internos. Por eso interpretamos relaciones y scores, no nombres inventados para cada dimensión.
Proyectamos embeddings BPR de productos a dos componentes mediante SVD centrada. El color usa categorías conocidas del catálogo, no etiquetas de prueba. La fracción de energía retenida ayuda a recordar cuánto se pierde al mirar dos ejes. La cercanía en este plano no sustituye el score completo ni prueba causalidad.
También inspeccionamos usuario 0, prefijado, en validación. Mostramos tres listas y marcamos clics reservados solo para leer el resultado. No añadimos esas etiquetas al historial del perfil.
vectors=models['BPR'].items.weight.detach().numpy();centered=vectors-vectors.mean(0)_,singular,basis=np.linalg.svd(centered,full_matrices=False);xy=centered@basis[:2].T;energy=np.sum(singular[:2]**2)/np.sum(singular**2)fig,ax=plt.subplots(figsize=(7,5))for cat inrange(4): ids=np.flatnonzero(category[:WI]==cat);ax.scatter(xy[ids,0],xy[ids,1],label=f'Categoría {cat}',alpha=.8)ax.set(title=f'Embeddings BPR: dos ejes retienen {energy:.1%} de energía',xlabel='Componente 1',ylabel='Componente 2');ax.legend();plt.show()user=0;example_rows=[]for name,s in [('Popularidad',popular),('Contenido',content),('BPR',model_scores(models['BPR']))]:for position,i inenumerate(rank(s,'validation',user),1): example_rows.append({'model':name,'rank':position,'item':int(i),'category':int(category[i]),'future_click':int(i in relevant('validation',user))})example=pd.DataFrame(example_rows);display(example)hist_cat=np.bincount(category[list(history[user])],minlength=4)lectura(f'La proyección conserva {energy:.1%} de la energía centrada. El historial del usuario 0 contiene clics por categoría {hist_cat.tolist()}; contenido aprovecha este patrón directamente. La tabla permite identificar aciertos, repetición de categorías y productos ignorados. Una lista individual ilustra mecanismos, pero no sustituye el promedio ni la incertidumbre por usuario.')
model
rank
item
category
future_click
0
Popularidad
1
1
1
0
1
Popularidad
2
17
1
0
2
Popularidad
3
2
2
0
3
Popularidad
4
6
2
0
4
Popularidad
5
7
3
0
5
Popularidad
6
9
1
1
6
Popularidad
7
4
0
0
7
Popularidad
8
5
1
0
8
Popularidad
9
13
1
0
9
Popularidad
10
3
3
0
10
Contenido
1
4
0
0
11
Contenido
2
16
0
0
12
Contenido
3
8
0
1
13
Contenido
4
24
0
1
14
Contenido
5
40
0
0
15
Contenido
6
32
0
1
16
Contenido
7
36
0
0
17
Contenido
8
56
0
0
18
Contenido
9
28
0
0
19
Contenido
10
44
0
0
20
BPR
1
7
3
0
21
BPR
2
27
3
0
22
BPR
3
8
0
1
23
BPR
4
19
3
0
24
BPR
5
40
0
0
25
BPR
6
16
0
0
26
BPR
7
4
0
0
27
BPR
8
31
3
0
28
BPR
9
58
2
0
29
BPR
10
32
0
1
30.6.1 Cómo leer este resultado
La proyección conserva 35.6% de la energía centrada. El historial del usuario 0 contiene clics por categoría [4, 0, 0, 2]; contenido aprovecha este patrón directamente. La tabla permite identificar aciertos, repetición de categorías y productos ignorados. Una lista individual ilustra mecanismos, pero no sustituye el promedio ni la incertidumbre por usuario.
30.7 Prueba: una lista, varias consecuencias
En prueba ya están disponibles los 100 productos. Filtramos clics de entrenamiento y validación. Pesos y perfiles permanecen estimados solo con entrenamiento; no se reentrena con validación. Esta política de actualización explícita difiere de un servicio que aprende tras cada clic.
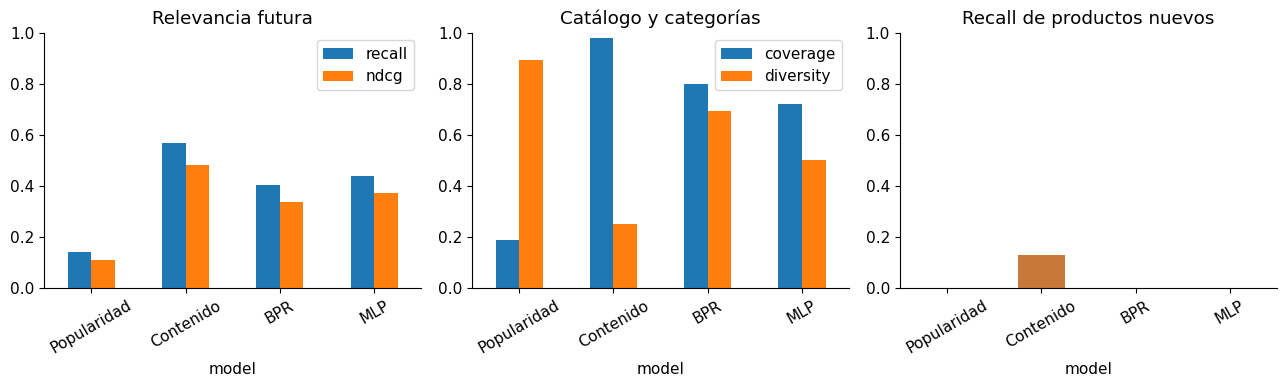
BPR y MLP no puntúan productos nuevos: los excluyen. Contenido puede hacerlo porque las categorías están disponibles al lanzamiento. La comparación evalúa este requisito del sistema, no solamente un catálogo de IDs conocidos.
scores={'Popularidad':popular,'Contenido':content,'BPR':model_scores(models['BPR']),'MLP':model_scores(models['MLP'])}records=[];details={}for name,s in scores.items(): met,detail=evaluate(s,'test');records.append({'model':name,**met});details[name]=detailresults=pd.DataFrame(records).set_index('model');display(results.round(3))fig,ax=plt.subplots(1,3,figsize=(13,4));results[['recall','ndcg']].plot.bar(ax=ax[0],rot=30);results[['coverage','diversity']].plot.bar(ax=ax[1],rot=30);results.cold_recall.plot.bar(ax=ax[2],rot=30,color='#c87939')for a,title inzip(ax,['Relevancia futura','Catálogo y categorías','Recall de productos nuevos']):a.set(title=title,ylim=(0,1))plt.tight_layout();plt.show()winner=results.ndcg.idxmax()lectura(f'Mayor NDCG@10: {winner}, {results.loc[winner,"ndcg"]:.3f}. BPR obtiene Recall {results.loc["BPR","recall"]:.3f} frente a popularidad {results.loc["Popularidad","recall"]:.3f}. Contenido recupera {results.loc["Contenido","cold_recall"]:.3f} de positivos de productos nuevos; BPR {results.loc["BPR","cold_recall"]:.3f}. Elegir solo por el promedio ocultaría la limitación de IDs. Estas métricas describen clics del simulador, no satisfacción causal.')
recall
precision
ndcg
diversity
head_share
cold_recall
users
cold_users
coverage
model
Popularidad
0.143
0.074
0.109
0.892
1.000
0.000
158
98
0.19
Contenido
0.567
0.270
0.484
0.253
0.134
0.129
158
98
0.98
BPR
0.404
0.189
0.339
0.693
0.294
0.000
158
98
0.80
MLP
0.438
0.206
0.374
0.502
0.373
0.000
158
98
0.72
30.7.1 Cómo leer este resultado
Mayor NDCG@10: Contenido, 0.484. BPR obtiene Recall 0.404 frente a popularidad 0.143. Contenido recupera 0.129 de positivos de productos nuevos; BPR 0.000. Elegir solo por el promedio ocultaría la limitación de IDs. Estas métricas describen clics del simulador, no satisfacción causal.
30.7.2 Por qué contenido es una referencia fuerte aquí
El generador asigna afinidad principal a una categoría disponible como metadato. Un perfil de conteos tiene, por diseño, información especialmente útil para recuperar esa regla. Esto explica su ventaja sin declarar que contenido domina siempre a filtrado colaborativo. Las redes de IDs necesitan estimar afinidades desde una matriz dispersa y además no puntúan productos nuevos.
La decisión para este escenario sería empezar por contenido y comprobar requisitos adicionales antes de añadir una red. Para estudiar una ventaja colaborativa habría que introducir preferencias no explicadas por categorías, historial suficiente y un protocolo nuevo fijado antes de consultar resultados. Cambiar el simulador después de ver prueba para hacer ganar a la red invalidaría la comparación.
30.7.3 Incertidumbre por usuario
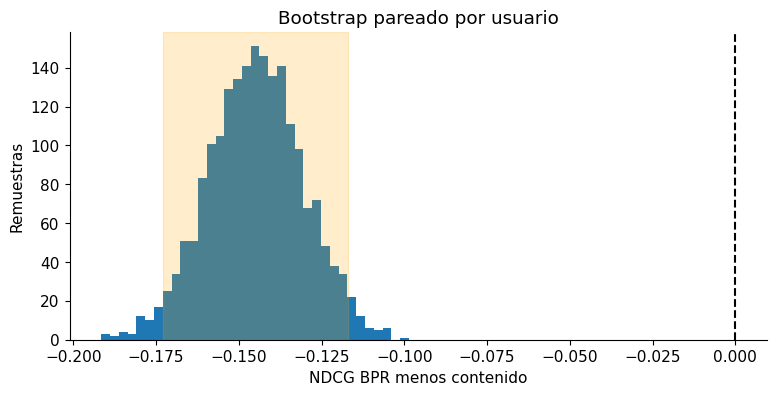
Remuestreamos usuarios completos conservando la pareja BPR–contenido. El bootstrap refleja variación de esta población simulada condicionada a los modelos entrenados; no incluye otras semillas, otros generadores ni sesgo de exposición. Los productos de una lista no se tratan como observaciones independientes.
paired=details['BPR'][['user','ndcg']].merge(details['Contenido'][['user','ndcg']],on='user',suffixes=('_bpr','_content'))delta=(paired.ndcg_bpr-paired.ndcg_content).to_numpy();gen=np.random.default_rng(306)boot=delta[gen.integers(0,len(delta),(2000,len(delta)))].mean(1);ci=np.quantile(boot,[.025,.975])fig,ax=plt.subplots();ax.hist(boot,bins=35);ax.axvline(0,color='black',ls='--');ax.axvspan(*ci,color='orange',alpha=.2);ax.set(title='Bootstrap pareado por usuario',xlabel='NDCG BPR menos contenido',ylabel='Remuestras');plt.show()lectura(f'Diferencia media {delta.mean():.3f}; intervalo percentil del 95% [{ci[0]:.3f}, {ci[1]:.3f}], {len(delta)} usuarios. '+('El intervalo cruza cero: no sostiene una ventaja clara en esta población.'if ci[0]<=0<=ci[1] else'El intervalo no cruza cero bajo este protocolo; no demuestra superioridad fuera del simulador.')+' Este análisis no se utiliza para volver a seleccionar hiperparámetros sobre prueba.')
30.7.4 Cómo leer este resultado
Diferencia media -0.145; intervalo percentil del 95% [-0.173, -0.117], 158 usuarios. El intervalo no cruza cero bajo este protocolo; no demuestra superioridad fuera del simulador. Este análisis no se utiliza para volver a seleccionar hiperparámetros sobre prueba.
30.8 Muestrear candidatos cambia la dificultad
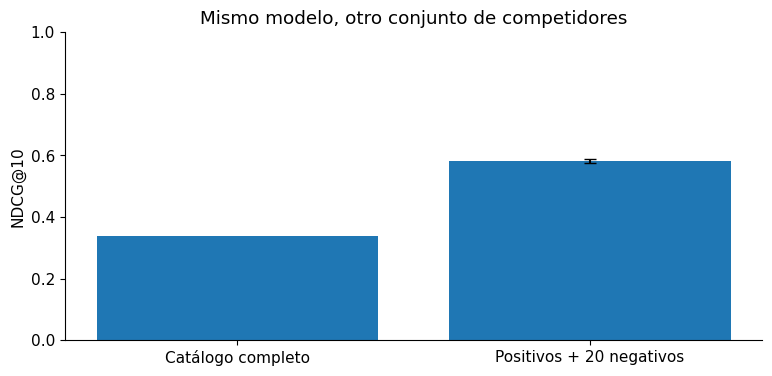
Algunas evaluaciones agregan todos los positivos y unos pocos negativos aleatorios. Así eliminan competidores y pueden aumentar métricas sin mejorar el modelo. Construimos cinco paneles con los positivos futuros y 20 negativos por usuario y mantenemos K=10. Conocer etiquetas para formar el panel es válido en esta demostración de evaluación; no sería un generador de candidatos desplegable.
No se mezclan estos resultados con métricas de catálogo completo. La variación entre paneles refleja muestreo de candidatos, no incertidumbre de entrenamiento.
sample_rows=[]for seed inrange(5): gen=np.random.default_rng(400+seed);lists={}for u inrange(WU): rel=relevant('test',u);non=np.array([i for i in candidates('test',u) if i notin rel]);pool=sorted(rel)+list(gen.choice(non,min(20,len(non)),replace=False)) lists[u]=rank(scores['BPR'],'test',u,pool=pool) sample_rows.append({'seed':seed,**list_metrics(lists,'test',range(WU),NI)[0]})sampled=pd.DataFrame(sample_rows)fig,ax=plt.subplots();ax.bar(['Catálogo completo','Positivos + 20 negativos'],[results.loc['BPR','ndcg'],sampled.ndcg.mean()]);ax.errorbar([1],[sampled.ndcg.mean()],yerr=[sampled.ndcg.std(ddof=1)],fmt='none',color='black',capsize=4);ax.set(ylim=(0,1),ylabel='NDCG@10',title='Mismo modelo, otro conjunto de competidores');plt.show()lectura(f'NDCG completo {results.loc["BPR","ndcg"]:.3f}; panel muestreado {sampled.ndcg.mean():.3f}, desviación entre paneles {sampled.ndcg.std(ddof=1):.3f}. Ningún parámetro cambió. Informar una mejora sin declarar candidatos sería engañoso; productos nuevos siguen sin puntuación en BPR incluso si el panel los incluye.')
30.8.1 Cómo leer este resultado
NDCG completo 0.339; panel muestreado 0.581, desviación entre paneles 0.006. Ningún parámetro cambió. Informar una mejora sin declarar candidatos sería engañoso; productos nuevos siguen sin puntuación en BPR incluso si el panel los incluye.
30.9 Recuperación y ordenamiento
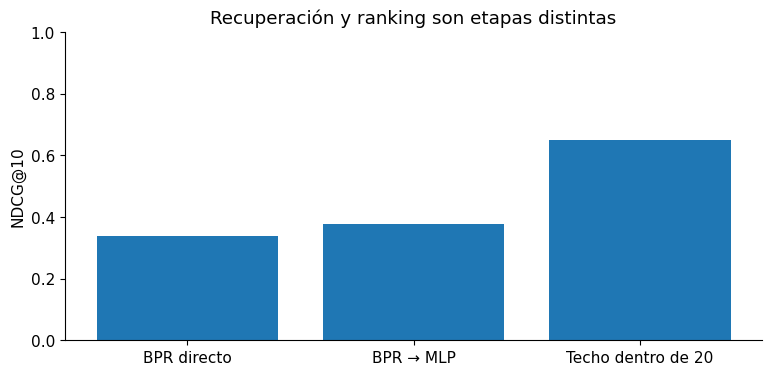
Un sistema grande puede recuperar cientos de candidatos con embeddings y ordenar ese subconjunto mediante un modelo más costoso. Si el relevante no llega al pool, el reranker no puede recuperarlo. Aquí BPR recupera 20 candidatos y MLP ordena diez.
flowchart LR
 A[Historial hasta el corte] --> B[Recuperar candidatos]
 B --> C[Filtrar vistos y no disponibles]
 C --> D[Ordenar por puntuación]
 D --> E[Ajustar diversidad]
 E --> F[Mostrar y registrar exposición]
Calculamos también el techo con ordenamiento ideal dentro del pool; usa etiquetas solo como diagnóstico. El catálogo pequeño se puntúa exhaustivamente: no se implementa ANN ni se mide latencia. Al escalar habría que evaluar recall de búsqueda, memoria, actualización y tiempo de respuesta.
retrieval=[];reranked={};oracle_lists={}for u inrange(WU): pool=rank(scores['BPR'],'test',u,k=20);rel=relevant('test',u)if rel:retrieval.append(len(set(pool)&rel)/len(rel)) reranked[u]=rank(scores['MLP'],'test',u,pool=pool) oracle_lists[u]=np.array(sorted(pool,key=lambda i:(i notin rel,int(i)))[:10])two=list_metrics(reranked,'test',range(WU),NI)[0];ceiling=list_metrics(oracle_lists,'test',range(WU),NI)[0]fig,ax=plt.subplots();ax.bar(['BPR directo','BPR → MLP','Techo dentro de 20'],[results.loc['BPR','ndcg'],two['ndcg'],ceiling['ndcg']]);ax.set(ylim=(0,1),ylabel='NDCG@10',title='Recuperación y ranking son etapas distintas');plt.show()lectura(f'Recall de candidatos@20 {np.mean(retrieval):.3f}; NDCG reranking {two["ndcg"]:.3f}; BPR directo {results.loc["BPR","ndcg"]:.3f}; techo del pool {ceiling["ndcg"]:.3f}. '+('El reranker empeora el ranking: agregar una etapa no justifica implementarla.'if two['ndcg']<results.loc['BPR','ndcg'] else'La mejora observada requiere valorar también el coste de la etapa adicional.')+' El techo con etiquetas no es un modelo entrenado ni un resultado desplegable.')
30.9.1 Cómo leer este resultado
Recall de candidatos@20 0.542; NDCG reranking 0.377; BPR directo 0.339; techo del pool 0.649. La mejora observada requiere valorar también el coste de la etapa adicional. El techo con etiquetas no es un modelo entrenado ni un resultado desplegable.
30.10 Diversidad: una restricción explícita
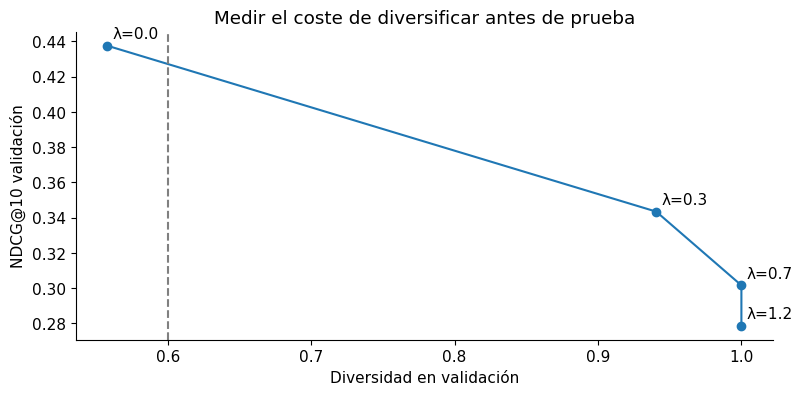
Normalizamos scores finitos por usuario y aplicamos una regla voraz: score menos λ por cada producto ya seleccionado de la misma categoría. Probamos λ=0, 0.3, 0.7 y 1.2 en validación. El criterio prefijado es maximizar NDCG entre reglas con diversidad media ≥0.60; si ninguna cumple, escoger mayor diversidad y declarar incumplimiento.
Ese umbral es una decisión didáctica de producto, no una constante estadística. El modelo de IDs sigue sin recuperar productos nuevos. Mayor variedad no demuestra mayor satisfacción; el intercambio con relevancia debe mostrarse.
def diverse_lists(s,window,lam): out={}for u inrange(WU): ids=candidates(window,u);ids=ids[np.isfinite(s[u,ids])];z=(s[u,ids]-s[u,ids].mean())/max(s[u,ids].std(),1e-6) selected=[];counts=np.zeros(4)for _ inrange(min(10,len(ids))): j=int(np.argmax(z-lam*counts[category[ids]]));i=int(ids[j]);selected.append(i);counts[category[i]]+=1;ids=np.delete(ids,j);z=np.delete(z,j) out[u]=np.array(selected)return outtrade=pd.DataFrame([{'lambda':lam,**list_metrics(diverse_lists(scores['BPR'],'validation',lam),'validation',range(WU),WI)[0]} for lam in [0,.3,.7,1.2]])feasible=trade[trade.diversity>=.60];chosen=feasible.sort_values('ndcg',ascending=False).iloc[0] iflen(feasible) else trade.sort_values('diversity',ascending=False).iloc[0]lam=float(chosen['lambda']);diverse_test=list_metrics(diverse_lists(scores['BPR'],'test',lam),'test',range(WU),NI)[0]fig,ax=plt.subplots();ax.plot(trade.diversity,trade.ndcg,'o-')for _,r in trade.iterrows():ax.annotate(f'λ={r["lambda"]}',(r.diversity,r.ndcg),xytext=(4,5),textcoords='offset points')ax.axvline(.60,color='gray',ls='--');ax.set(xlabel='Diversidad en validación',ylabel='NDCG@10 validación',title='Medir el coste de diversificar antes de prueba');plt.show()display(trade[['lambda','ndcg','diversity','coverage']].round(3))lectura(f'λ elegido {lam:.1f}, diversidad de validación {chosen.diversity:.3f}. En prueba diversidad pasa de {results.loc["BPR","diversity"]:.3f} a {diverse_test["diversity"]:.3f}, NDCG de {results.loc["BPR","ndcg"]:.3f} a {diverse_test["ndcg"]:.3f}. '+('El umbral se cumplió en validación.'iflen(feasible) else'Ninguna regla cumplió el umbral; hace falta revisar el objetivo antes de implementar.')+' La decisión requiere aceptar explícitamente este intercambio.')
lambda
ndcg
diversity
coverage
0
0.0
0.438
0.558
1.000
1
0.3
0.343
0.941
0.988
2
0.7
0.302
1.000
0.962
3
1.2
0.279
1.000
0.975
30.10.1 Cómo leer este resultado
λ elegido 0.3, diversidad de validación 0.941. En prueba diversidad pasa de 0.693 a 0.949, NDCG de 0.339 a 0.289. El umbral se cumplió en validación. La decisión requiere aceptar explícitamente este intercambio.
30.11 Arranque en frío: personas y productos
Una persona nueva necesita popularidad, preferencias declaradas con consentimiento o contexto observable. Un producto nuevo puede usar categoría, texto o imagen mediante un encoder de contenido. Aquí contenido conoce categorías al lanzamiento, pero la persona nueva no tiene perfil y recibe popularidad como fallback.
Evaluamos los 20 usuarios incorporados en prueba aparte. No añadimos sus clics de prueba al perfil antes de recomendarlos. Simular actualización tras el primer clic requeriría otro corte y otra definición de tarea.
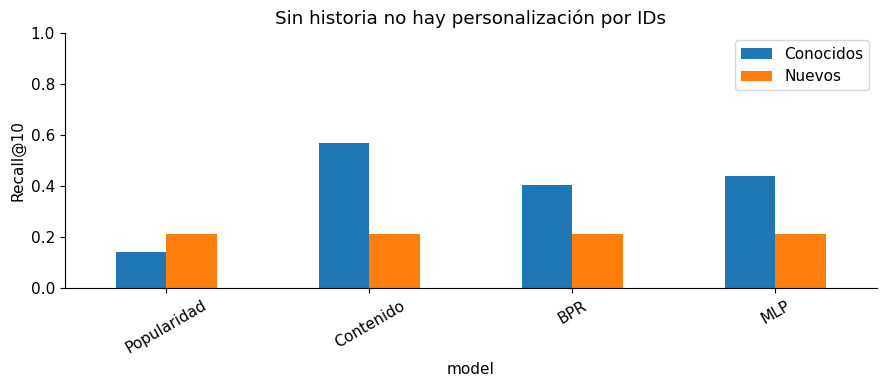
cold_results=pd.DataFrame([{'model':name,**evaluate(s,'test',range(WU,NU))[0]} for name,s in scores.items()]).set_index('model');display(cold_results.round(3))fig,ax=plt.subplots();pd.DataFrame({'Conocidos':results.recall,'Nuevos':cold_results.recall}).plot.bar(ax=ax,rot=30);ax.set(ylim=(0,1),ylabel='Recall@10',title='Sin historia no hay personalización por IDs');plt.tight_layout();plt.show()lectura(f'BPR conocido: Recall {results.loc["BPR","recall"]:.3f}; fallback para personas nuevas {cold_results.loc["BPR","recall"]:.3f}. Aumentar dimensiones no crea historia para un ID desconocido. Popularidad y contenido sin perfil comparten un orden semejante; la decisión relevante es diseñar onboarding, contexto o una política de entrada medible.')
recall
precision
ndcg
diversity
head_share
cold_recall
users
cold_users
coverage
model
Popularidad
0.212
0.14
0.204
1.0
1.0
0.0
20
10
0.1
Contenido
0.212
0.14
0.204
1.0
1.0
0.0
20
10
0.1
BPR
0.212
0.14
0.204
1.0
1.0
0.0
20
10
0.1
MLP
0.212
0.14
0.204
1.0
1.0
0.0
20
10
0.1
30.11.1 Cómo leer este resultado
BPR conocido: Recall 0.404; fallback para personas nuevas 0.212. Aumentar dimensiones no crea historia para un ID desconocido. Popularidad y contenido sin perfil comparten un orden semejante; la decisión relevante es diseñar onboarding, contexto o una política de entrada medible.
30.12 Sesgo, causalidad y decisiones
El log depende de la política que mostró opciones. Imitar clics puede reforzar popularidad y reducir oportunidades de productos menos expuestos. Nuestro generador no modela posición, precio, satisfacción, abandono ni efectos de largo plazo. Evaluación offline no estima automáticamente el efecto de cambiar política.
Hallazgo
Decisión
Comprobación adicional
Contenido recupera nuevos productos
Mantener ruta de contenido o híbrida
Calidad de metadatos al lanzamiento
Mejora ranking pero baja cobertura
Revisar restricciones
Segmentos y distribución de exposición
Reranker no mejora
Conservar sistema simple
Coste y varias semillas
Métrica sube al muestrear candidatos
Separar protocolos
Candidatos, filtrado y K
Personas nuevas fallan
Diseñar fallback
Consentimiento y actualización
Una prueba A/B debe medir un objetivo de producto y guardrails como abandono o concentración. Evaluación off-policy exige supuestos y propensiones identificables; dividir por popularidad no resuelve el problema. Modelos secuenciales incorporan orden del historial; optimizar decisiones con efectos futuros conecta con Aprendizaje por refuerzo.
30.13 Registro reproducible
Guardamos impresiones, resultados por usuario, curvas, selección y pesos. Los archivos sirven para inspección e inferencia didáctica. El esquema de IDs, perfiles y filtrado también forma parte del sistema: los pesos solos no reproducen una recomendación.
example.to_csv('ejemplo-listas.csv',index=False)events.to_csv('interacciones.csv',index=False);results.to_csv('resultados.csv');cold_results.to_csv('usuarios-nuevos.csv')curves.to_csv('curvas-entrenamiento.csv',index=False);selected.to_csv('seleccion.csv',index=False);trade.to_csv('diversidad-validacion.csv',index=False);sampled.to_csv('evaluacion-muestreada.csv',index=False)pd.concat([d.assign(model=name) for name,d in details.items()]).to_csv('resultados-usuarios.csv',index=False)for name,model in models.items(): torch.save(model.state_dict(),f'modelo-{name.lower()}.pt');clone=Recommender(name);clone.load_state_dict(torch.load(f'modelo-{name.lower()}.pt',weights_only=True))assert np.allclose(model_scores(clone)[:WU,:WI],scores[name][:WU,:WI])protocol={'seed_generator':30,'users_known':WU,'users_new':NU-WU,'items_initial':WI,'items_new':NI-WI,'selection':'validation NDCG@10; first tie','k':10,'candidates':'all available unseen products; untrained ID items excluded in BPR/MLP','profiles':'train only; no refit','negative_sampling':'uniform train catalog minus train positives; never future labels','BPR_negatives':1,'MLP_negatives':4,'epochs':60,'embedding_dim':16,'diversity_lambda':lam,'diversity_threshold':.6,'bootstrap_users':2000,'torch':torch.__version__}Path('protocolo.json').write_text(json.dumps(protocol,ensure_ascii=False,indent=2),encoding='utf-8')print('Registros guardados; carga de ambos modelos verificada.')
Registros guardados; carga de ambos modelos verificada.
30.14 Contrato común y persistencia
En recomendación, el catálogo disponible, el filtrado de productos vistos y el corte temporal forman parte de la métrica. Se conservan los modelos BPR/MLP, sus negativos y el tratamiento de usuarios y productos nuevos. La recarga no sustituye el esquema de IDs ni los perfiles de entrenamiento necesarios para reproducir un ranking.
Esta ejecución conserva el desarrollo didáctico y las recetas del capítulo. El cierre registra entorno, tablas y pesos en artefactos_pytorch/. Los estados serializados se recargan en una copia de la arquitectura y se comprueba identidad de parámetros y buffers; esa comprobación de persistencia no sustituye una evaluación de inferencia ni demuestra calidad predictiva. Los pesos guardados no incluyen todos los estados necesarios para reanudar exactamente el experimento.
from pathlib import Pathimport json,hashlib,copy,shutil,platformimport torchartefactos_cierre=Path('artefactos_pytorch');artefactos_cierre.mkdir(exist_ok=True)modulos_cierre=[];vistos_cierre=set()for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,torch.nn.Module) andid(objeto_cierre) notin vistos_cierre: vistos_cierre.add(id(objeto_cierre));estado_cierre={k:v.detach().cpu().clone() for k,v in objeto_cierre.state_dict().items()}assertall(torch.isfinite(v).all() for v in estado_cierre.values() if v.is_floating_point()),nombre_cierre ruta_cierre=artefactos_cierre/f'{nombre_cierre}-estado.pt';torch.save({'state_dict':estado_cierre},ruta_cierre) copia_cierre=copy.deepcopy(objeto_cierre).cpu();copia_cierre.load_state_dict(torch.load(ruta_cierre,map_location='cpu',weights_only=True)['state_dict'])assertall(torch.equal(v.cpu(),estado_cierre[k]) for k,v in copia_cierre.state_dict().items()) modulos_cierre.append({'variable':nombre_cierre,'clase':type(objeto_cierre).__name__,'parametros':sum(p.numel() for p in objeto_cierre.parameters()),'recarga_estado':True})for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,pd.DataFrame) andlen(objeto_cierre)<100000:objeto_cierre.to_csv(artefactos_cierre/f'tabla-{nombre_cierre}.csv',index=False)for ruta_cierre inlist(Path('.').iterdir()):if ruta_cierre.is_file() and ruta_cierre.suffix in ['.csv','.json','.joblib','.pt','.wav','.npz']:shutil.copy2(ruta_cierre,artefactos_cierre/ruta_cierre.name)registro_cierre={'python':platform.python_version(),'torch':str(torch.__version__),'numpy':np.__version__,'sklearn':sklearn.__version__,'modulos':modulos_cierre,'alcance':'identidad de parámetros/buffers al recargar; no reanudación completa','archivos':{p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in artefactos_cierre.iterdir() if p.is_file()}}(artefactos_cierre/'cierre-armonizacion.json').write_text(json.dumps(registro_cierre,ensure_ascii=False,indent=2),encoding='utf-8')print('Estados recargados y verificados:',len(modulos_cierre),'| archivos registrados:',len(registro_cierre['archivos']))
Estados recargados y verificados: 2 | archivos registrados: 28
30.14.1 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
Se conservaron los cortes temporales, el catálogo disponible, los comparadores de contenido/popularidad, BPR, MLP y el ajuste de diversidad elegido en validación. Los controles distinguen catálogo completo, candidatos muestreados y usuarios nuevos sin historia; las métricas offline no estiman por sí solas un efecto causal del servicio. Se conservaron las comprobaciones de recarga originales de ambos recomendadores y se archivaron también sus pesos y resultados por usuario.
La armonización verificó identidad de parámetros y buffers tras recarga de 2 módulos presentes al cierre; archivó 28 archivos con SHA-256. Esta prueba no incluye reanudación exacta del optimizador ni sustituye las evaluaciones predictivas del capítulo.
30.15 Ejercicios para tomar decisiones
Exposición uniforme. Reconstruir con pesos constantes. ¿Cuánto de la popularidad procede de exposición? Repetir todos los cortes, no modificar solo prueba.
Preferencias mixtas. Asignar dos afinidades por usuario sin entregarlas al modelo. Comparar diversidad cuando variedad forma parte del generador.
Negativos. Comparar muestreo uniforme con proporcional a popularidad. No excluir futuros positivos; mantener catálogo y K.
Contenido inductivo. Construir un encoder de categorías y reservar productos completos. Separar generalización a IDs de generalización a atributos.
Calificaciones. Añadir señal explícita, entrenar MSE y estudiar si RMSE y NDCG seleccionan el mismo checkpoint.
Semillas. Reentrenar cinco veces; separar variabilidad de optimización del bootstrap por usuario. No elegir la mejor semilla en prueba.
Servicio. Simular productos retirados, bloqueos e IDs desconocidos. Informar errores de catálogo y latencia además de relevancia.
El informe debe declarar tarea, cortes, población, candidatos, filtrado, K, negativos, selección y límites. La pregunta es qué decisión sostiene la evidencia.