5  Perceptrón y MLP

Una flor descrita por dos medidas y una imagen descrita por 64 intensidades parecen problemas distintos. En ambos casos podemos preguntar qué combinación de entradas permite separar las clases. Empezaremos con una frontera recta y veremos qué cambia cuando introducimos capas ocultas y activaciones no lineales.

El recorrido conserva los casos de las clases: compuertas AND, OR y XOR, Iris, puntos separados por una recta, espirales, medias lunas y dígitos. NumPy permite ver las operaciones del perceptrón; las redes entrenables se desarrollan con PyTorch. Scikit-learn aporta datos, particiones, escalado y métricas.

5.1 Qué vas a poder decidir

  • Distinguir una neurona de umbral fijo, el perceptrón clásico y un clasificador lineal entrenado por gradiente.
  • Reconocer cuándo una frontera lineal resulta insuficiente y qué aporta una capa oculta.
  • Seguir el paso de una matriz de datos a tensores, logits, pérdida y predicciones.
  • Separar ajuste, selección y evaluación final, leyendo curvas, fronteras, errores y métricas por clase.
  • Guardar y recuperar el modelo elegido junto con su contrato de entrada.

Las convenciones del libro y los capítulos de tensores, datasets y generación de datos sirven de apoyo. Aquí anticipamos el ciclo de entrenamiento; su derivación se desarrolla en pérdida y retropropagación.

5.2 Preparación del entorno

Los experimentos centrales utilizan datos incluidos en scikit-learn o generados localmente. El dispositivo se elige al ejecutar: CPU permite seguir todos los ejemplos; si CUDA está disponible, modelo y lotes se trasladan juntos. Las semillas controlan fuentes concretas de azar, sin prometer resultados idénticos entre versiones o dispositivos.

from pathlib import Path
from copy import deepcopy
import json
import random
import platform
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.colors import ListedColormap
from sklearn.datasets import (load_iris, load_digits, make_moons, make_circles,
    make_classification, make_blobs, make_gaussian_quantiles,
    make_multilabel_classification)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import (accuracy_score, balanced_accuracy_score, f1_score,
    classification_report, confusion_matrix, ConfusionMatrixDisplay)
import sklearn
import torch
from torch import nn
from torch.utils.data import TensorDataset, DataLoader
from IPython.display import display, Markdown

def fijar_semilla(semilla=42):
    random.seed(semilla)
    np.random.seed(semilla)
    torch.manual_seed(semilla)
    if torch.cuda.is_available():
        torch.cuda.manual_seed_all(semilla)

fijar_semilla()
torch.set_num_threads(2)
dispositivo = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS = Path('artefactos_pytorch')
ARTEFACTOS.mkdir(exist_ok=True)
plt.rcParams.update({'figure.dpi': 115, 'axes.spines.top': False,
                     'axes.spines.right': False, 'font.size': 10})
COLORES = ['#2878a5', '#da7845']
mapa = ListedColormap(COLORES)
print('Python:', platform.python_version(), '| PyTorch:', torch.__version__)
print('NumPy:', np.__version__, '| scikit-learn:', sklearn.__version__)
print('Dispositivo:', dispositivo)
Python: 3.13.9 | PyTorch: 2.14.1+cpu
NumPy: 2.3.5 | scikit-learn: 1.8.0
Dispositivo: cpu

5.3 De sumar entradas a tomar una decisión

Una neurona calcula una suma ponderada y un sesgo. Para una observación con dos variables:

\[z=x_1w_1+x_2w_2+b.\]

La función escalón devuelve 1 si \(z\geq0\) y 0 en otro caso. El sesgo desplaza la frontera \(z=0\); los pesos determinan su orientación. Que la salida sea 0 o 1 no significa que hayamos estimado una probabilidad.

5.3.1 AND: una regla que construimos a mano

En una neurona de McCulloch–Pitts fijamos pesos y umbral. Con pesos 0.5 y umbral 1, solo la entrada (1,1) alcanza el umbral. No hay entrenamiento: diseñamos la regla y comprobamos sus cuatro posibilidades.

X_logica = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=np.float32)
y_and = np.array([0, 0, 0, 1])
y_or = np.array([0, 1, 1, 1])
y_xor = np.array([0, 1, 1, 0])
salida_and = (X_logica @ np.array([0.5, 0.5]) >= 1).astype(int)
display(pd.DataFrame({'x1': X_logica[:, 0], 'x2': X_logica[:, 1],
                      'AND esperado': y_and, 'AND calculado': salida_and}))
assert np.array_equal(salida_and, y_and)
x1 x2 AND esperado AND calculado
0 0.0 0.0 0 0
1 0.0 1.0 0 0
2 1.0 0.0 0 0
3 1.0 1.0 1 1

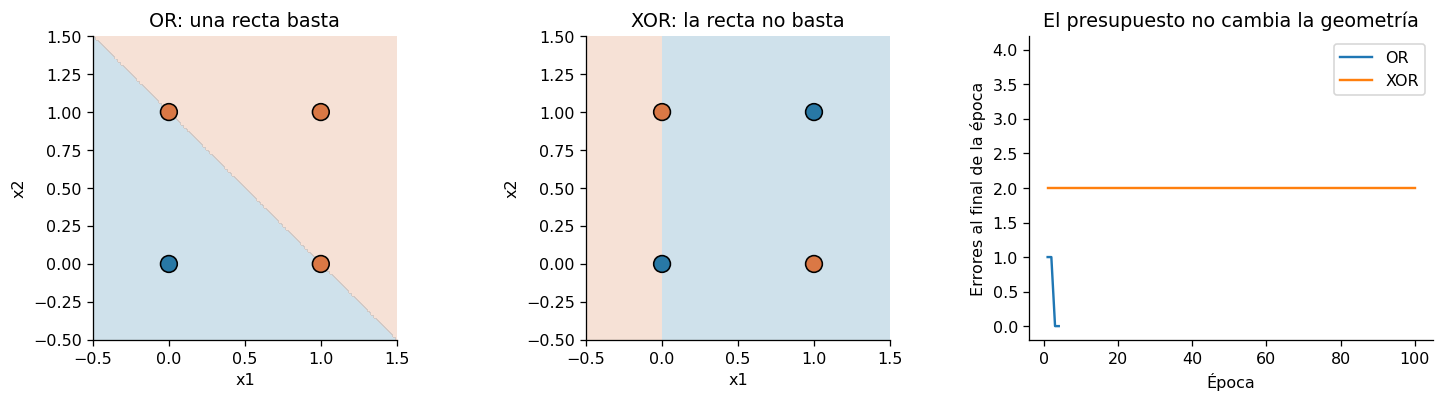
5.3.2 OR: aprender la frontera con correcciones

El perceptrón clásico sí modifica pesos. Para cada observación calcula \(\hat y\), obtiene \(e=y-\hat y\) y actualiza:

\[w\leftarrow w+\eta e x,\qquad b\leftarrow b+\eta e.\]

La tasa \(\eta\) multiplica la corrección; no es un porcentaje de aciertos. Empezar este algoritmo con ceros es válido para una sola unidad. Más adelante, inicializar de forma idéntica todas las unidades ocultas de una MLP impediría romper su simetría.

Guardaremos los errores cometidos durante cada pasada y los errores del modelo al final de ella. No son lo mismo: una actualización al final puede corregir una equivocación anterior. Detendremos el algoritmo si completa una pasada sin actualizaciones.

class PerceptronSimple:
    def __init__(self, learning_rate=0.1, epochs=100):
        self.learning_rate = learning_rate
        self.epochs = epochs

    def predict(self, X):
        return (np.asarray(X) @ self.weights + self.bias >= 0).astype(int)

    def fit(self, X, y):
        self.weights = np.zeros(X.shape[1], dtype=np.float64)
        self.bias = 0.0
        self.historia = []
        for epoca in range(1, self.epochs + 1):
            actualizaciones = 0
            for xi, objetivo in zip(X, y):
                error = int(objetivo) - int(self.predict(xi))
                self.weights += self.learning_rate * error * xi
                self.bias += self.learning_rate * error
                actualizaciones += int(error != 0)
            errores_finales = int(np.sum(self.predict(X) != y))
            self.historia.append((epoca, actualizaciones, errores_finales))
            if actualizaciones == 0:
                break
        return self

per_or = PerceptronSimple(learning_rate=0.1, epochs=10).fit(X_logica, y_or)
per_xor = PerceptronSimple(learning_rate=0.1, epochs=100).fit(X_logica, y_xor)
display(pd.DataFrame({'x1': X_logica[:, 0], 'x2': X_logica[:, 1],
    'OR': y_or, 'perceptrón OR': per_or.predict(X_logica),
    'XOR': y_xor, 'perceptrón XOR': per_xor.predict(X_logica)}))
print('OR: pesos', per_or.weights, '| sesgo', per_or.bias)
print('OR: épocas recorridas', len(per_or.historia))
print('XOR: errores al terminar', np.sum(per_xor.predict(X_logica) != y_xor))
assert np.array_equal(per_or.predict(X_logica), y_or)
x1 x2 OR perceptrón OR XOR perceptrón XOR
0 0.0 0.0 0 0 0 1
1 0.0 1.0 1 1 1 1
2 1.0 0.0 1 1 1 0
3 1.0 1.0 1 1 0 0
OR: pesos [0.1 0.1] | sesgo -0.1
OR: épocas recorridas 4
XOR: errores al terminar 2
def malla_2d(X, margen=0.3, puntos=180):
    a = np.linspace(X[:, 0].min()-margen, X[:, 0].max()+margen, puntos)
    b = np.linspace(X[:, 1].min()-margen, X[:, 1].max()+margen, puntos)
    xx, yy = np.meshgrid(a, b)
    return xx, yy, np.c_[xx.ravel(), yy.ravel()].astype('float32')

fig, axes = plt.subplots(1, 3, figsize=(13, 3.6))
xx, yy, rejilla = malla_2d(X_logica, 0.5)
for ax, modelo, objetivo, titulo in zip(axes[:2], [per_or, per_xor],
        [y_or, y_xor], ['OR: una recta basta', 'XOR: la recta no basta']):
    ax.contourf(xx, yy, modelo.predict(rejilla).reshape(xx.shape),
                levels=[-0.5, 0.5, 1.5], cmap=mapa, alpha=0.22)
    ax.scatter(*X_logica.T, c=objetivo, cmap=mapa, edgecolors='black', s=110)
    ax.set(xlabel='x1', ylabel='x2', title=titulo, aspect='equal')
for modelo, nombre in [(per_or, 'OR'), (per_xor, 'XOR')]:
    h = np.asarray(modelo.historia)
    axes[2].plot(h[:, 0], h[:, 2], label=nombre)
axes[2].set(xlabel='Época', ylabel='Errores al final de la época',
            title='El presupuesto no cambia la geometría', ylim=(-0.2, 4.2))
axes[2].legend()
plt.tight_layout(); plt.show()

5.3.3 Cómo leer este resultado

En OR, tres vértices de la tabla pertenecen a una clase y el restante a la otra: una recta puede separarlos. En XOR, los vértices positivos son opuestos. Sus envolventes convexas se cruzan con las de los negativos; ninguna recta separa correctamente los cuatro.

El fallo de una ejecución aislada no probaría imposibilidad. Aquí la imposibilidad se deduce de la geometría. La exactitud concreta del perceptrón al detenerse depende del orden y del presupuesto; no tiene por qué predecir siempre la misma clase. Tampoco podemos convertir este ejercicio en una medida de generalización: hemos utilizado las cuatro entradas posibles de la tabla tanto para construir como para comprobar la regla.

La decisión es cambiar la representación o el modelo. Añadir, por ejemplo, \(x_1x_2\) como característica también permitiría resolver XOR con una combinación lineal de las nuevas variables. Una MLP aprenderá una transformación mediante unidades ocultas.

5.4 Iris: qué significa una frontera en unidades observables

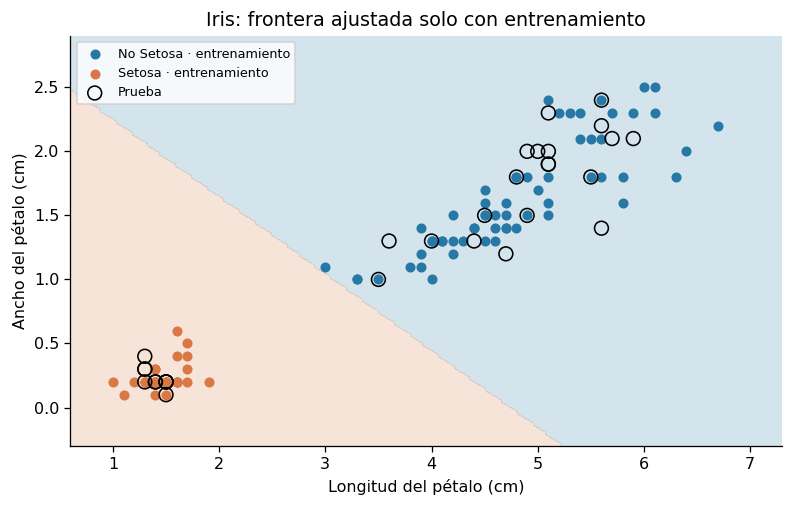
Usaremos longitud y ancho del pétalo, en centímetros, para distinguir Setosa de las otras dos especies. Separamos 60/20/20 de forma estratificada: el perceptrón se ajusta con entrenamiento; validación y prueba no modifican sus pesos. En este caso fijamos presupuesto y tasa de antemano, por lo que validación solo informa el diagnóstico.

El escalador se estima exclusivamente con entrenamiento. Dibujaremos en centímetros, transformando la malla antes de predecir. Así evitamos interpretar una frontera estandarizada como si sus ejes conservaran las unidades originales.

def indices_60_20_20(y, semilla=42, estratificar_prueba=True):
    indices = np.arange(len(y))
    desarrollo, prueba = train_test_split(indices, test_size=0.2,
        random_state=semilla, stratify=y if estratificar_prueba else None)
    entrenamiento, validacion = train_test_split(desarrollo, test_size=0.25,
        random_state=semilla, stratify=y[desarrollo])
    assert not (set(entrenamiento) & set(validacion) or
                set(entrenamiento) & set(prueba) or set(validacion) & set(prueba))
    assert len(entrenamiento)+len(validacion)+len(prueba) == len(y)
    return entrenamiento, validacion, prueba

iris = load_iris()
X_iris = iris.data[:, [2, 3]].astype('float32')
y_iris = (iris.target == 0).astype('int64')
tr_i, va_i, te_i = indices_60_20_20(y_iris)
escala_iris = StandardScaler().fit(X_iris[tr_i])
modelo_iris = PerceptronSimple(0.1, 100).fit(
    escala_iris.transform(X_iris[tr_i]), y_iris[tr_i])
tabla_iris = []
for nombre, ids in [('Entrenamiento', tr_i), ('Validación', va_i), ('Prueba', te_i)]:
    pred = modelo_iris.predict(escala_iris.transform(X_iris[ids]))
    tabla_iris.append({'partición': nombre, 'n': len(ids),
        'exactitud': accuracy_score(y_iris[ids], pred),
        'F1 Setosa': f1_score(y_iris[ids], pred, zero_division=0)})
display(pd.DataFrame(tabla_iris).round(3))
xx, yy, rejilla = malla_2d(X_iris, 0.4)
fig, ax = plt.subplots(figsize=(7, 4.5))
ax.contourf(xx, yy, modelo_iris.predict(escala_iris.transform(rejilla)).reshape(xx.shape),
            levels=[-0.5, 0.5, 1.5], cmap=mapa, alpha=0.2)
for clase, nombre in [(0, 'No Setosa'), (1, 'Setosa')]:
    ids = tr_i[y_iris[tr_i] == clase]
    ax.scatter(*X_iris[ids].T, color=COLORES[clase], label=nombre+' · entrenamiento', s=28)
ax.scatter(*X_iris[te_i].T, facecolors='none', edgecolors='black', s=75, label='Prueba')
ax.set(xlabel='Longitud del pétalo (cm)', ylabel='Ancho del pétalo (cm)',
       title='Iris: frontera ajustada solo con entrenamiento')
ax.legend(fontsize=8); plt.tight_layout(); plt.show()
nueva = np.array([[2.0, 0.5]], dtype='float32')
print('Flor [2.0, 0.5] cm:', 'Setosa' if modelo_iris.predict(escala_iris.transform(nueva))[0] else 'No Setosa')
partición n exactitud F1 Setosa
0 Entrenamiento 90 1.0 1.0
1 Validación 30 1.0 1.0
2 Prueba 30 1.0 1.0

Flor [2.0, 0.5] cm: Setosa

5.4.1 Qué decide este ejemplo y qué deja abierto

Lee la tabla junto a la frontera: una exactitud alta es compatible con que esta distinción concreta sea sencilla usando pétalos. No demuestra que el mismo perceptrón separe Versicolor de Virginica, ni que dos variables basten para cualquier problema botánico.

La muestra nueva ilustra una llamada al modelo; carece de etiqueta observada y no constituye una validación adicional. En prueba hay pocas flores: un solo error cambia apreciablemente el porcentaje. Antes de aumentar complejidad conviene comprobar qué clases estamos intentando separar y dónde aparecen los errores.

5.5 De la recta a una MLP

Una capa densa calcula \(Z=XW+b\). Si \(X\) tiene forma (N,D), una capa de D entradas y H salidas produce (N,H). PyTorch guarda Linear.weight como (H,D) y aplica internamente la transposición correspondiente.

Con una activación no lineal entre capas, la MLP transforma las coordenadas antes de decidir. Si eliminamos todas las activaciones, apilar capas densas sigue siendo una transformación afín: más capas por sí solas no resuelven XOR.

5.5.1 Logits, probabilidades y etiquetas

Tarea Salida del modelo Objetivo Pérdida Conversión para interpretar
Binaria Un logit por observación, (N,1) Float 0/1, (N,1) BCEWithLogitsLoss Sigmoid y umbral prefijado 0.5
Multiclase C logits, (N,C) Entero de clase, (N,) CrossEntropyLoss Softmax para probabilidades; argmax para clase

Un logit puede tomar cualquier valor real. Las pérdidas reciben logits directamente: no añadimos una sigmoid o softmax dentro de la red antes de estas pérdidas. Para decidir clase binaria, comparar el logit con cero equivale a comparar su sigmoid con 0.5. Una salida transformada a [0,1] no queda calibrada automáticamente.

class MLP(nn.Module):
    def __init__(self, entradas, ocultas, salidas, activacion='relu'):
        super().__init__()
        capas = []
        anterior = entradas
        for ancho in ocultas:
            capas.append(nn.Linear(anterior, ancho))
            capas.append(nn.ReLU() if activacion == 'relu' else nn.Tanh())
            anterior = ancho
        capas.append(nn.Linear(anterior, salidas))
        self.red = nn.Sequential(*capas)

    def forward(self, x):
        return self.red(x)

def tensor_x(X):
    return torch.as_tensor(np.asarray(X), dtype=torch.float32)

@torch.inference_mode()
def probabilidades(modelo, X, binaria=True):
    modelo.eval()
    logits = modelo(tensor_x(X).to(next(modelo.parameters()).device))
    p = torch.sigmoid(logits).squeeze(1) if binaria else torch.softmax(logits, dim=1)
    return p.cpu().numpy()

def clases(modelo, X, binaria=True):
    p = probabilidades(modelo, X, binaria)
    return (p >= 0.5).astype(int) if binaria else p.argmax(axis=1)

# Comprueba el contrato dimensional antes de entrenar.
ejemplo = MLP(2, [8, 4], 1, 'tanh')
print(ejemplo)
print('Entrada:', tuple(tensor_x(X_logica).shape),
      '| logits:', tuple(ejemplo(tensor_x(X_logica)).shape))
print('Parámetros entrenables:', sum(p.numel() for p in ejemplo.parameters()))
assert ejemplo(tensor_x(X_logica)).shape == (4, 1)
MLP(
  (red): Sequential(
    (0): Linear(in_features=2, out_features=8, bias=True)
    (1): Tanh()
    (2): Linear(in_features=8, out_features=4, bias=True)
    (3): Tanh()
    (4): Linear(in_features=4, out_features=1, bias=True)
  )
)
Entrada: (4, 2) | logits: (4, 1)
Parámetros entrenables: 65

5.5.2 XOR: ver una actualización antes de automatizarla

En el primer entrenamiento escribimos el ciclo completo. zero_grad() limpia gradientes anteriores; backward() calcula los del lote actual y step() actualiza los parámetros. train() y eval() cambian el comportamiento de capas como dropout o BatchNorm; estas capas no aparecen todavía, pero conservaremos la distinción desde el principio. Desactivar gradientes al evaluar es otra operación diferente.

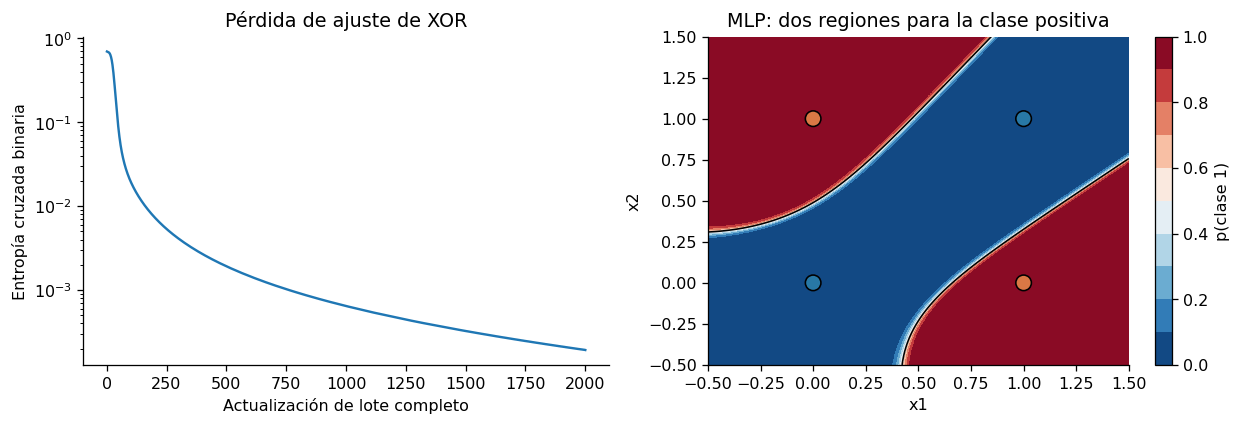
Usamos la arquitectura 2→8→4→1 con tanh y 2000 actualizaciones de lote completo prefijadas. No hay validación independiente en una tabla lógica de cuatro entradas: evaluamos capacidad de representar XOR, sin presentar una estimación de generalización. El presupuesto finito no garantiza que cualquier inicialización converja.

fijar_semilla(42)
modelo_xor = MLP(2, [8, 4], 1, 'tanh').to(dispositivo)
entradas_xor = tensor_x(X_logica).to(dispositivo)
objetivos_xor = torch.tensor(y_xor, dtype=torch.float32, device=dispositivo).reshape(-1, 1)
perdida_binaria = nn.BCEWithLogitsLoss()
optimizador = torch.optim.Adam(modelo_xor.parameters(), lr=0.02)
historia_xor = []
for epoca in range(1, 2001):
    modelo_xor.train()
    optimizador.zero_grad(set_to_none=True)
    logits = modelo_xor(entradas_xor)
    perdida = perdida_binaria(logits, objetivos_xor)
    perdida.backward()
    optimizador.step()
    historia_xor.append(float(perdida.detach().cpu()))

p_xor = probabilidades(modelo_xor, X_logica)
display(pd.DataFrame({'x1': X_logica[:, 0], 'x2': X_logica[:, 1],
    'XOR': y_xor, 'p(clase 1)': p_xor, 'predicción': (p_xor >= 0.5).astype(int)}).round(4))
fig, axes = plt.subplots(1, 2, figsize=(11, 3.8))
axes[0].plot(np.arange(1, 2001), historia_xor)
axes[0].set(xlabel='Actualización de lote completo', ylabel='Entropía cruzada binaria',
            title='Pérdida de ajuste de XOR', yscale='log')
xx, yy, rejilla = malla_2d(X_logica, 0.5)
p = probabilidades(modelo_xor, rejilla).reshape(xx.shape)
im = axes[1].contourf(xx, yy, p, levels=np.linspace(0, 1, 11), cmap='RdBu_r', vmin=0, vmax=1)
axes[1].contour(xx, yy, p, levels=[0.5], colors='black', linewidths=1)
axes[1].scatter(*X_logica.T, c=y_xor, cmap=mapa, s=95, edgecolors='black')
axes[1].set(title='MLP: dos regiones para la clase positiva', xlabel='x1', ylabel='x2')
fig.colorbar(im, ax=axes[1], label='p(clase 1)'); plt.tight_layout(); plt.show()
x1 x2 XOR p(clase 1) predicción
0 0.0 0.0 0 0.0002 0
1 0.0 1.0 1 0.9996 1
2 1.0 0.0 1 1.0000 1
3 1.0 1.0 0 0.0002 0

5.5.3 Cómo leer este resultado

Comprueba primero las cuatro filas: acertarlas muestra que esta ejecución representó la tabla. La frontera permite entender cómo lo hizo: las unidades ocultas construyen regiones que una única recta no puede separar. La superficie dibujada entre los vértices es una extensión elegida por el modelo; la tabla XOR no define etiquetas para esas coordenadas continuas.

Una pérdida decreciente acompaña el ajuste, pero no convierte las probabilidades extremas en evidencia sobre datos nuevos. Cuando todos los vértices ya están bien clasificados, la entropía cruzada todavía puede disminuir al aumentar la confianza. Por eso pérdida y exactitud no son intercambiables.

5.6 Un ciclo común para los experimentos con validación

Ahora pasamos de una tabla exhaustiva a muestras de una distribución. Cada experimento tendrá tres particiones. El escalador aprende media y desviación en entrenamiento; el mejor estado se elige por pérdida de validación; prueba se consulta después de fijar esa decisión.

TensorDataset agrupa entradas y objetivos; DataLoader organiza lotes y baraja solo entrenamiento. Los objetivos binarios son float con una columna; los multiclase son enteros sin esa columna. La última tanda puede tener menos observaciones: agregamos pérdidas ponderándolas por su tamaño para que no pese lo mismo que una tanda completa.

El historial de entrenamiento se calcula al final de cada época en modo evaluación, con los pesos de ese instante. Así se puede comparar con validación sin mezclar el promedio de pérdidas de lotes cuyos pesos iban cambiando. El checkpoint contiene una copia independiente de los tensores; guardar solo una referencia al state_dict no congelaría el mejor estado.

def crear_cargador(X, y, binaria, lote, barajar=False, semilla=42):
    objetivo = torch.as_tensor(y, dtype=torch.float32 if binaria else torch.long)
    if binaria:
        objetivo = objetivo.reshape(-1, 1)
    datos = TensorDataset(tensor_x(X), objetivo)
    generador = torch.Generator().manual_seed(semilla)
    return DataLoader(datos, batch_size=lote, shuffle=barajar,
                      generator=generador, num_workers=0)

@torch.inference_mode()
def evaluar(modelo, cargador, criterio, binaria):
    modelo.eval()
    suma, aciertos, n = 0.0, 0, 0
    for Xb, yb in cargador:
        Xb, yb = Xb.to(dispositivo), yb.to(dispositivo)
        logits = modelo(Xb)
        suma += criterio(logits, yb).item() * len(yb)
        pred = (logits >= 0).to(yb.dtype) if binaria else logits.argmax(dim=1)
        aciertos += int((pred == yb).sum().item())
        n += len(yb)
    return {'loss': suma/n, 'accuracy': aciertos/n}

def entrenar(modelo, Xtr, ytr, Xva, yva, *, binaria=True, lr=0.001,
             epocas=500, lote=64, paciencia=40, optimizador='adam', semilla=42):
    ajuste = crear_cargador(Xtr, ytr, binaria, lote, True, semilla)
    lectura_tr = crear_cargador(Xtr, ytr, binaria, 512)
    lectura_va = crear_cargador(Xva, yva, binaria, 512)
    criterio = nn.BCEWithLogitsLoss() if binaria else nn.CrossEntropyLoss()
    modelo.to(dispositivo)
    opt = (torch.optim.Adam(modelo.parameters(), lr=lr) if optimizador == 'adam'
           else torch.optim.SGD(modelo.parameters(), lr=lr))
    mejor_loss, mejor_epoca, espera = float('inf'), 0, 0
    historia = []
    for epoca in range(1, epocas+1):
        modelo.train()
        for Xb, yb in ajuste:
            Xb, yb = Xb.to(dispositivo), yb.to(dispositivo)
            opt.zero_grad(set_to_none=True)
            loss = criterio(modelo(Xb), yb)
            loss.backward()
            opt.step()
        tr = evaluar(modelo, lectura_tr, criterio, binaria)
        va = evaluar(modelo, lectura_va, criterio, binaria)
        if not np.isfinite([tr['loss'], va['loss']]).all():
            raise FloatingPointError('Pérdida no finita: revisar el experimento.')
        historia.append({'epoca': epoca, 'train_loss': tr['loss'],
            'val_loss': va['loss'], 'train_accuracy': tr['accuracy'],
            'val_accuracy': va['accuracy']})
        if va['loss'] < mejor_loss:
            mejor_loss, mejor_epoca = va['loss'], epoca
            mejor_estado = deepcopy(modelo.state_dict())
            espera = 0
        else:
            espera += 1
        if espera >= paciencia:
            break
    modelo.load_state_dict(mejor_estado)
    modelo.eval()
    restaurada = evaluar(modelo, lectura_va, criterio, binaria)['loss']
    assert np.isclose(restaurada, mejor_loss, rtol=1e-5, atol=1e-7)
    return pd.DataFrame(historia), mejor_epoca

def dibujar_historia(historia, mejor_epoca, titulo):
    fig, axes = plt.subplots(1, 2, figsize=(11, 3.4))
    for prefijo, nombre in [('train', 'Entrenamiento'), ('val', 'Validación')]:
        axes[0].plot(historia.epoca, historia[prefijo+'_loss'], label=nombre)
        axes[1].plot(historia.epoca, historia[prefijo+'_accuracy'], label=nombre)
    for ax in axes:
        ax.axvline(mejor_epoca, color='black', ls='--', alpha=.6,
                   label=f'Checkpoint: época {mejor_epoca}')
        ax.set_xlabel('Época'); ax.legend(fontsize=8)
    axes[0].set(ylabel='Entropía cruzada', title=titulo+' · pérdida')
    axes[1].set(ylabel='Exactitud', title=titulo+' · aciertos', ylim=(0, 1.03))
    plt.tight_layout(); plt.show()

resultados = []
particiones = []
def registrar_particiones(nombre, ids_por_parte):
    for parte, ids in zip(['entrenamiento', 'validacion', 'prueba'], ids_por_parte):
        particiones.extend({'experimento': nombre, 'indice': int(i),
                            'particion': parte} for i in ids)

def informe_final(nombre, modelo, Xtr, ytr, Xva, yva, Xte, yte,
                  historia, epoca, binaria=True):
    filas = []
    for parte, X, y in [('Entrenamiento', Xtr, ytr), ('Validación', Xva, yva), ('Prueba', Xte, yte)]:
        pred = clases(modelo, X, binaria)
        filas.append({'partición': parte, 'n': len(y),
            'exactitud': accuracy_score(y, pred),
            'exactitud balanceada': balanced_accuracy_score(y, pred),
            'F1 macro': f1_score(y, pred, average='macro', zero_division=0)})
    tabla = pd.DataFrame(filas)
    display(tabla.round(3))
    final = tabla.iloc[-1]
    resultados.append({'experimento': nombre, 'checkpoint_epoca': int(epoca),
        'epocas_recorridas': len(historia), 'n_train': len(ytr), 'n_val': len(yva),
        'n_test': len(yte), 'test_accuracy': float(final['exactitud']),
        'test_f1_macro': float(final['F1 macro'])})
    historia.to_csv(ARTEFACTOS/(nombre+'_historia.csv'), index=False)
    return tabla
5.6.1 Qué mirar antes de aumentar el tamaño de la red

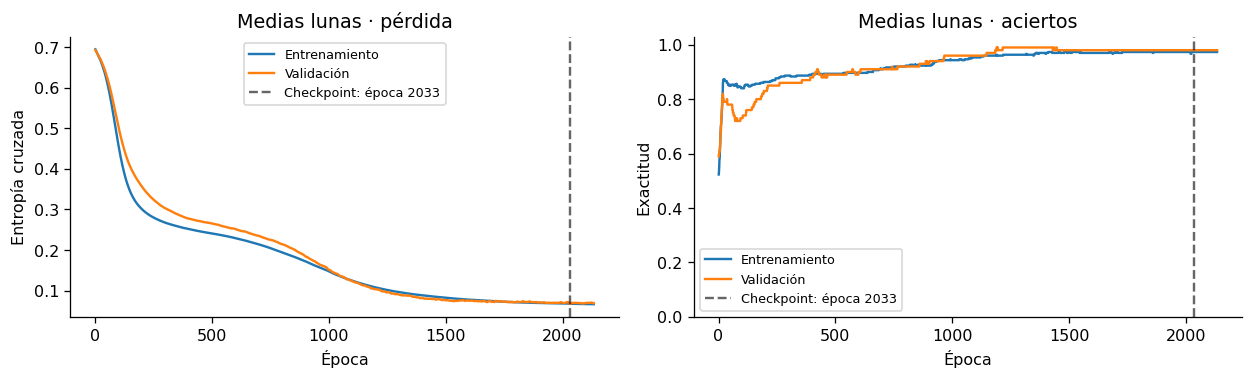
Un error alto en entrenamiento y validación puede señalar una representación insuficiente o un ajuste incompleto; la curva ayuda a distinguirlos, pero no identifica por sí sola la causa. Si entrenamiento sigue mejorando y validación empeora, conservar el último estado contradice el criterio que acabamos de fijar. Restaurar el mínimo no borra la información del historial: la línea vertical muestra qué modelo se utilizará después.

El umbral binario queda fijo en 0.5. No lo modificaremos al observar la matriz de confusión de prueba. La selección de umbrales y otras métricas se desarrolla en evaluación de modelos.

5.7 Una recta conocida: separar representación y algoritmo

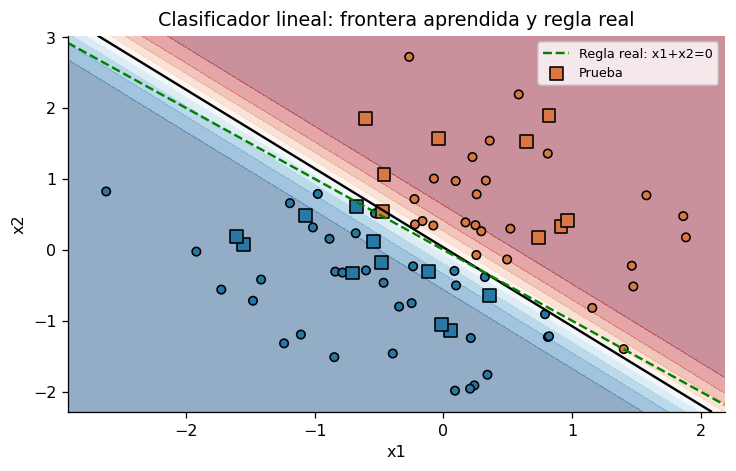
Generamos 100 puntos normales y asignamos clase 1 cuando \(x_1+x_2>0\). Una sola capa Linear(2,1) produce un clasificador logístico entrenado con entropía cruzada: comparte una frontera lineal con el perceptrón, pero no su regla de corrección por errores.

Fijamos SGD, tasa 0.1, lote completo y un máximo de 1000 épocas. Seleccionamos por validación con paciencia de 80 épocas. La frontera verdadera es conocida y puede dibujarse: una comparación útil que no está disponible en todos los problemas reales.

rng = np.random.RandomState(42)
X_recta = rng.randn(100, 2).astype('float32')
y_recta = (X_recta.sum(axis=1) > 0).astype('int64')
tr_r, va_r, te_r = indices_60_20_20(y_recta)
escala_recta = StandardScaler().fit(X_recta[tr_r])
Rtr, Rva, Rte = [escala_recta.transform(X_recta[i]).astype('float32') for i in [tr_r, va_r, te_r]]
fijar_semilla()
modelo_recta = MLP(2, [], 1)
h_recta, e_recta = entrenar(modelo_recta, Rtr, y_recta[tr_r], Rva, y_recta[va_r],
    lr=0.1, epocas=1000, lote=len(Rtr), paciencia=80, optimizador='sgd')
registrar_particiones('recta', [tr_r, va_r, te_r])
tabla_recta = informe_final('recta', modelo_recta, Rtr, y_recta[tr_r], Rva,
    y_recta[va_r], Rte, y_recta[te_r], h_recta, e_recta)
xx, yy, rejilla = malla_2d(X_recta, .3)
fig, ax = plt.subplots(figsize=(6.5, 4.2))
p = probabilidades(modelo_recta, escala_recta.transform(rejilla)).reshape(xx.shape)
ax.contourf(xx, yy, p, levels=np.linspace(0, 1, 11), cmap='RdBu_r', alpha=.45)
ax.contour(xx, yy, p, levels=[.5], colors='black')
ax.plot([xx.min(), xx.max()], [-xx.min(), -xx.max()], '--', color='green', label='Regla real: x1+x2=0')
ax.scatter(*X_recta[tr_r].T, c=y_recta[tr_r], cmap=mapa, s=28, edgecolors='black')
ax.scatter(*X_recta[te_r].T, c=y_recta[te_r], cmap=mapa, marker='s', s=65, edgecolors='black', label='Prueba')
ax.set(xlim=(xx.min(), xx.max()), ylim=(yy.min(), yy.max()),
       xlabel='x1', ylabel='x2', title='Clasificador lineal: frontera aprendida y regla real')
ax.legend(fontsize=8); plt.tight_layout(); plt.show()
partición n exactitud exactitud balanceada F1 macro
0 Entrenamiento 60 1.00 1.000 1.000
1 Validación 20 1.00 1.000 1.000
2 Prueba 20 0.95 0.944 0.949

5.7.1 Cómo leer este resultado

La recta negra depende de una muestra de entrenamiento; la verde describe el generador. Que no coincidan exactamente no demuestra falta de capacidad: pueden faltar observaciones próximas a la frontera y el presupuesto de optimización es finito. Compara dónde están los desacuerdos antes de añadir capas. Un ejemplo situado muy cerca de la regla tiene menos margen geométrico, aunque aquí las etiquetas no tengan ruido.

5.8 Espirales: una representación que sí exige curvar la frontera

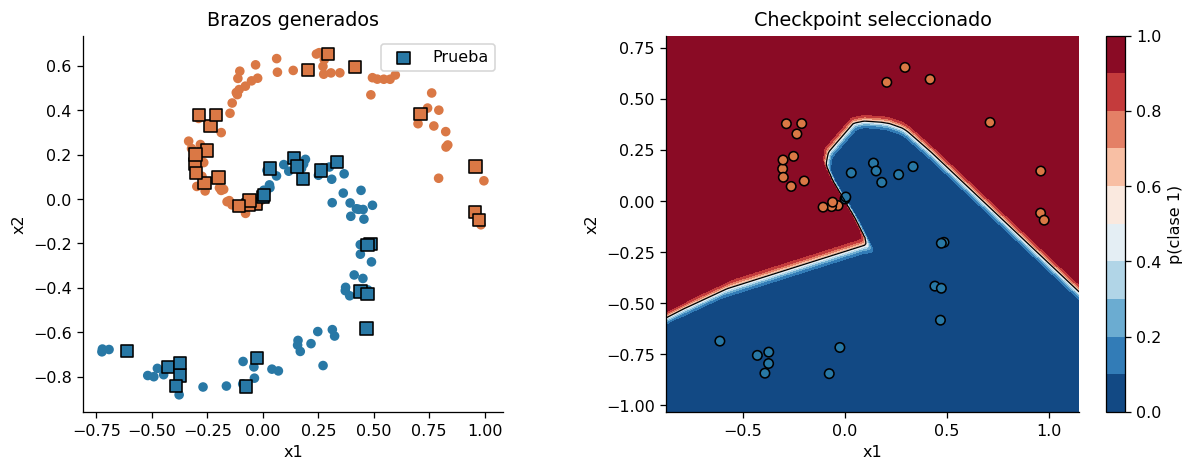
Generamos dos brazos de cien puntos y una MLP 2→16→8→1 con ReLU. El radio crece de 0 a 1 y el ángulo cambia con el brazo, más ruido normal de desviación 0.2. La semilla del generador es independiente de la del modelo para que un cambio de arquitectura no regenere los datos.

Los dos brazos incluyen un punto en el origen con etiquetas distintas: las mismas coordenadas no pueden recibir dos clases diferentes de un clasificador determinista. Una exactitud imperfecta puede reflejar esta ambigüedad, no solo una red demasiado pequeña.

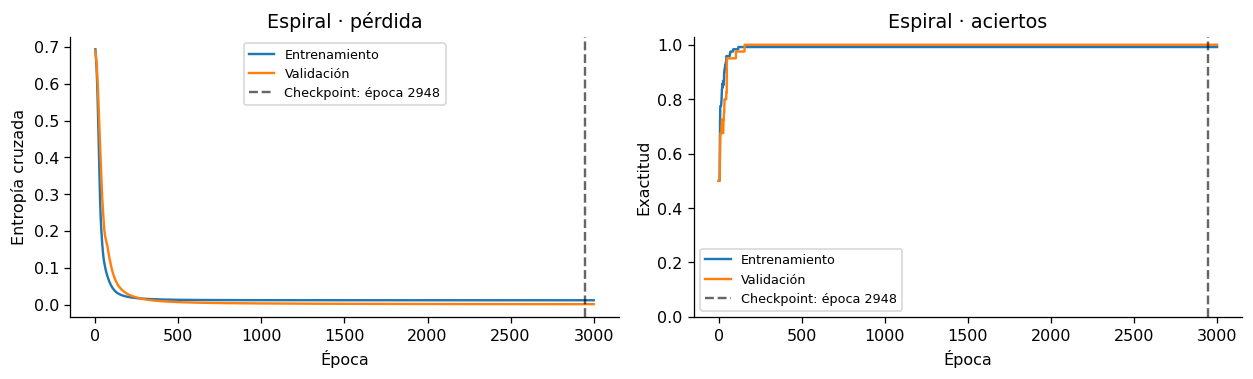
Fijamos Adam 0.01, lote completo, máximo de 3000 épocas y paciencia de 150. Prueba procede del mismo mecanismo sintético; este experimento no demuestra extrapolación fuera de los brazos observados.

def generar_espiral(puntos=100, clases=2, semilla=42):
    rng = np.random.RandomState(semilla)
    X = np.zeros((puntos*clases, 2), dtype='float32')
    y = np.zeros(puntos*clases, dtype='int64')
    for clase in range(clases):
        ids = slice(puntos*clase, puntos*(clase+1))
        radio = np.linspace(0, 1, puntos)
        angulo = np.linspace(clase*4, (clase+1)*4, puntos) + rng.randn(puntos)*.2
        X[ids] = np.c_[radio*np.sin(angulo), radio*np.cos(angulo)]
        y[ids] = clase % 2
    return X, y

X_esp, y_esp = generar_espiral()
tr_e, va_e, te_e = indices_60_20_20(y_esp)
escala_esp = StandardScaler().fit(X_esp[tr_e])
Etr, Eva, Ete = [escala_esp.transform(X_esp[i]).astype('float32') for i in [tr_e, va_e, te_e]]
fijar_semilla()
modelo_esp = MLP(2, [16, 8], 1)
h_esp, e_esp = entrenar(modelo_esp, Etr, y_esp[tr_e], Eva, y_esp[va_e],
    lr=.01, epocas=3000, lote=len(Etr), paciencia=150)
registrar_particiones('espiral', [tr_e, va_e, te_e])
tabla_esp = informe_final('espiral', modelo_esp, Etr, y_esp[tr_e], Eva,
    y_esp[va_e], Ete, y_esp[te_e], h_esp, e_esp)
dibujar_historia(h_esp, e_esp, 'Espiral')
xx, yy, rejilla = malla_2d(X_esp, .15)
fig, axes = plt.subplots(1, 2, figsize=(11, 4.2))
axes[0].scatter(*X_esp[tr_e].T, c=y_esp[tr_e], cmap=mapa, s=25)
axes[0].scatter(*X_esp[te_e].T, c=y_esp[te_e], cmap=mapa, marker='s', s=60, edgecolors='black', label='Prueba')
axes[0].set(title='Brazos generados', xlabel='x1', ylabel='x2', aspect='equal')
axes[0].legend()
p = probabilidades(modelo_esp, escala_esp.transform(rejilla)).reshape(xx.shape)
im = axes[1].contourf(xx, yy, p, levels=np.linspace(0, 1, 11), cmap='RdBu_r')
axes[1].contour(xx, yy, p, levels=[.5], colors='black', linewidths=.8)
pred_esp = clases(modelo_esp, Ete)
fallos = te_e[pred_esp != y_esp[te_e]]
axes[1].scatter(*X_esp[te_e].T, c=y_esp[te_e], cmap=mapa, edgecolors='black', s=35)
if len(fallos):
    axes[1].scatter(*X_esp[fallos].T, facecolors='none', edgecolors='yellow', s=130, linewidths=2, label='Error en prueba')
axes[1].set(title='Checkpoint seleccionado', xlabel='x1', ylabel='x2', aspect='equal')
if len(fallos):
    axes[1].legend(fontsize=8)
fig.colorbar(im, ax=axes[1], label='p(clase 1)')
plt.tight_layout(); plt.show()
display(Markdown(f'### Lectura de la ejecución\n\nLa prueba contiene {len(te_e)} puntos y '
    f'**{len(fallos)} errores**; el checkpoint elegido corresponde a la época **{e_esp}**. '
    + ('No aparecen anillos amarillos porque esta muestra no contiene fallos. Eso no elimina la ambigüedad del origen ni garantiza acierto poblacional perfecto.'
       if len(fallos) == 0 else 'Los anillos amarillos señalan los errores de esta muestra, sin utilizarlos para volver a elegir el modelo.')))
partición n exactitud exactitud balanceada F1 macro
0 Entrenamiento 120 0.992 0.992 0.992
1 Validación 40 1.000 1.000 1.000
2 Prueba 40 1.000 1.000 1.000

5.8.1 Lectura de la ejecución

La prueba contiene 40 puntos y 0 errores; el checkpoint elegido corresponde a la época 2948. No aparecen anillos amarillos porque esta muestra no contiene fallos. Eso no elimina la ambigüedad del origen ni garantiza acierto poblacional perfecto.

5.8.2 Cómo leer este resultado

Lee el mínimo de validación antes de mirar el final de la curva. Si la pérdida de ajuste sigue bajando después de ese mínimo, la decisión acordada sigue siendo restaurar el checkpoint, aunque la superficie final de otra época pudiera parecer más atractiva.

Cuando existen errores en prueba, la figura de la derecha los identifica con anillos amarillos. Busca si se concentran cerca del origen, en zonas donde los brazos se aproximan o lejos de las muestras de entrenamiento. Estas observaciones generan hipótesis distintas: ambigüedad del generador, falta de datos o representación insuficiente. El gráfico no permite adjudicar todos los fallos a una sola causa.

No uses estas etiquetas de prueba para cambiar el ancho o el número de épocas y volver a presentar la misma prueba como independiente. Un nuevo experimento se diseña con entrenamiento y validación; si la prueba ya influyó en la decisión, hará falta otra evaluación reservada.

5.9 Medias lunas: seguir el protocolo de principio a fin

Usamos make_moons(n_samples=500, noise=0.2, random_state=0), las capas ocultas (10,5) y ReLU. Reservamos para prueba un 20% estratificado con semilla 42. Del 80% de desarrollo reservamos ahora un cuarto para validación: quedan 300 observaciones de ajuste, 100 de validación y 100 de prueba.

La escala se estima en entrenamiento para no transferir información de las particiones reservadas. Validación permite seleccionar una época sin utilizar prueba; ese papel debe quedar definido antes de mirar resultados. Cambiar a la vez escala, particiones e inicialización impediría atribuir una diferencia a un único componente.

Fijamos Adam 0.001, lote de 200, máximo de 3000 épocas y paciencia de 100. El objetivo es hacer visible la decisión sobre el estado del modelo, no demostrar que esa configuración sea óptima.

X_moon, y_moon = make_moons(n_samples=500, noise=.2, random_state=0)
X_moon = X_moon.astype('float32')
tr_m, va_m, te_m = indices_60_20_20(y_moon)
escala_moon = StandardScaler().fit(X_moon[tr_m])
Mtr, Mva, Mte = [escala_moon.transform(X_moon[i]).astype('float32') for i in [tr_m, va_m, te_m]]
fijar_semilla()
modelo_moon = MLP(2, [10, 5], 1)
h_moon, e_moon = entrenar(modelo_moon, Mtr, y_moon[tr_m], Mva, y_moon[va_m],
    lr=.001, epocas=3000, lote=200, paciencia=100)
registrar_particiones('moons', [tr_m, va_m, te_m])
tabla_moon = informe_final('moons', modelo_moon, Mtr, y_moon[tr_m], Mva,
    y_moon[va_m], Mte, y_moon[te_m], h_moon, e_moon)
dibujar_historia(h_moon, e_moon, 'Medias lunas')
partición n exactitud exactitud balanceada F1 macro
0 Entrenamiento 300 0.977 0.977 0.977
1 Validación 100 0.980 0.980 0.980
2 Prueba 100 0.970 0.970 0.970

xx, yy, rejilla = malla_2d(X_moon, .35)
p = probabilidades(modelo_moon, escala_moon.transform(rejilla)).reshape(xx.shape)
pred_moon = clases(modelo_moon, Mte)
fig, axes = plt.subplots(1, 2, figsize=(11, 4))
im = axes[0].contourf(xx, yy, p, levels=np.linspace(0, 1, 11), cmap='RdBu_r', alpha=.7)
axes[0].contour(xx, yy, p, levels=[.5], colors='black', linewidths=1)
axes[0].scatter(*X_moon[tr_m].T, c=y_moon[tr_m], cmap=mapa, alpha=.4, s=15)
axes[0].scatter(*X_moon[te_m].T, c=y_moon[te_m], cmap=mapa, edgecolors='black', s=35)
fallos = te_m[pred_moon != y_moon[te_m]]
axes[0].scatter(*X_moon[fallos].T, facecolors='none', edgecolors='yellow', s=110, linewidths=1.8)
axes[0].set(xlabel='x1', ylabel='x2', title='Prueba sobre la frontera elegida')
ConfusionMatrixDisplay.from_predictions(y_moon[te_m], pred_moon, ax=axes[1],
    cmap='Blues', colorbar=False, display_labels=['Clase 0', 'Clase 1'])
axes[1].set_title('Prueba: conteos, no porcentajes')
axes[1].set(xlabel='Clase predicha', ylabel='Clase verdadera')
plt.tight_layout(); plt.show()
fila_m = tabla_moon.iloc[-1]
display(Markdown(f'### Lectura de la ejecución\n\nEl checkpoint es la época **{e_moon}** de {len(h_moon)} recorridas. '
    f'En las {len(te_m)} observaciones de prueba la exactitud es **{fila_m["exactitud"]:.1%}**, '
    f'con **{int(np.sum(pred_moon != y_moon[te_m]))} errores**. '
    f'El gap de exactitud entre entrenamiento y validación del estado restaurado es '
    f'{tabla_moon.iloc[0]["exactitud"]-tabla_moon.iloc[1]["exactitud"]:.3f}. '
    'El gap resume una diferencia; su signo aislado no diagnostica sobreajuste. Contrasta con las pérdidas y con la localización de los errores.'))
cm_moon = confusion_matrix(y_moon[te_m], pred_moon, labels=[0, 1])
display(Markdown(f'Respecto a la clase 1 hay **{cm_moon[0,1]} falsos positivos** '
    f'y **{cm_moon[1,0]} falsos negativos**. Aunque la exactitud los suma como errores, '
    'sus costes podrían ser distintos en otra aplicación; aquí no hemos definido esos costes.'))

5.9.1 Lectura de la ejecución

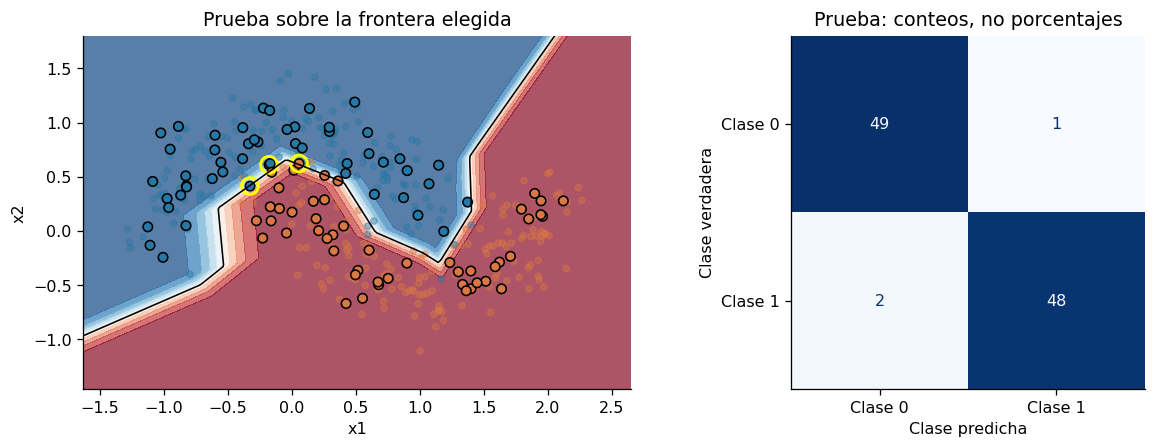
El checkpoint es la época 2033 de 2133 recorridas. En las 100 observaciones de prueba la exactitud es 97.0%, con 3 errores. El gap de exactitud entre entrenamiento y validación del estado restaurado es -0.003. El gap resume una diferencia; su signo aislado no diagnostica sobreajuste. Contrasta con las pérdidas y con la localización de los errores.

Respecto a la clase 1 hay 1 falsos positivos y 2 falsos negativos. Aunque la exactitud los suma como errores, sus costes podrían ser distintos en otra aplicación; aquí no hemos definido esos costes.

5.9.2 De la métrica a una decisión

La matriz permite distinguir falsos positivos y falsos negativos respecto a la clase 1; la exactitud solo suma aciertos. En estas medias lunas las clases están equilibradas, pero los costes de equivocarse no están definidos. No podemos deducir de aquí qué umbral convendría en una aplicación con costes asimétricos.

Los puntos ruidosos pueden cruzar la región que sugiere la geometría global. Si los errores aparecen allí, ensanchar la red para perseguir cada observación puede empeorar validación. Si ambas curvas se estancan con pérdidas altas, sí conviene investigar el ajuste o la representación. La siguiente decisión se contrasta con validación, sin buscar una frontera que acomode retrospectivamente los puntos de prueba.

5.10 Distinguir diez dígitos: cambia la salida, no el ciclo

load_digits contiene imágenes de 8×8 píxeles con intensidades entre 0 y 16. Es Digits, no MNIST. Aplanamos cada imagen a 64 entradas y dividimos por 16 usando la escala documentada del conjunto: no estimamos esa constante con prueba.

Usamos la MLP 64→64→32→10 con tanh y reservamos prueba mediante train_test_split(..., test_size=0.2, random_state=42), sin estratificar esa primera separación. Dentro del desarrollo reservamos validación estratificada. La arquitectura tiene diez logits finales y CrossEntropyLoss recibe etiquetas enteras de 0 a 9; las clases son excluyentes, no diez etiquetas binarias independientes.

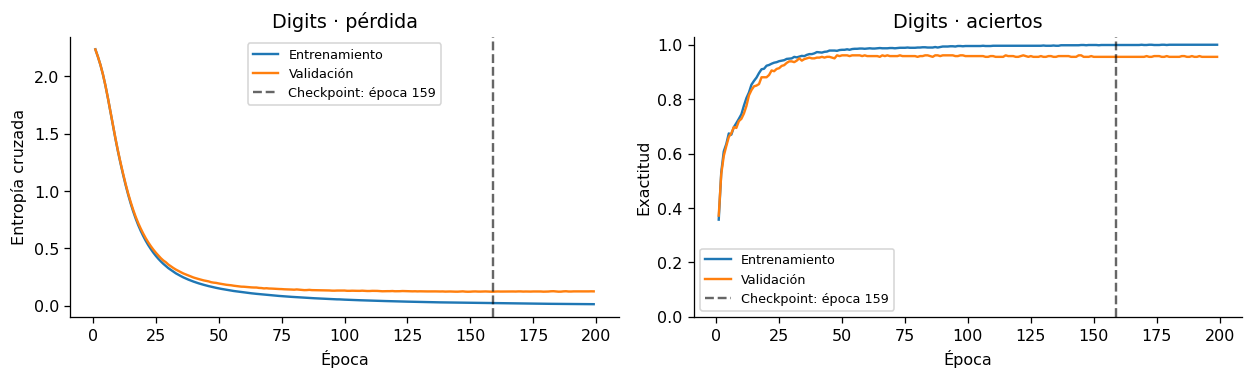
El presupuesto es Adam 0.001, lote 200, máximo de 500 épocas y paciencia de 40. El ajuste utiliza 1077 imágenes, validación 360 y prueba 360. Las proporciones por clase pueden diferir ligeramente, por lo que revisaremos también soportes y métricas por clase.

digits = load_digits()
X_dig = (digits.data/16.0).astype('float32')
y_dig = digits.target.astype('int64')
tr_d, va_d, te_d = indices_60_20_20(y_dig, estratificar_prueba=False)
fijar_semilla()
modelo_dig = MLP(64, [64, 32], 10, 'tanh')
print(modelo_dig)
print('Parámetros:', sum(p.numel() for p in modelo_dig.parameters()))
print('Logits para tres imágenes:', tuple(modelo_dig(tensor_x(X_dig[:3])).shape))
h_dig, e_dig = entrenar(modelo_dig, X_dig[tr_d], y_dig[tr_d],
    X_dig[va_d], y_dig[va_d], binaria=False, lr=.001, epocas=500, lote=200, paciencia=40)
registrar_particiones('digits', [tr_d, va_d, te_d])
tabla_dig = informe_final('digits', modelo_dig, X_dig[tr_d], y_dig[tr_d],
    X_dig[va_d], y_dig[va_d], X_dig[te_d], y_dig[te_d], h_dig, e_dig, False)
dibujar_historia(h_dig, e_dig, 'Digits')
MLP(
  (red): Sequential(
    (0): Linear(in_features=64, out_features=64, bias=True)
    (1): Tanh()
    (2): Linear(in_features=64, out_features=32, bias=True)
    (3): Tanh()
    (4): Linear(in_features=32, out_features=10, bias=True)
  )
)
Parámetros: 6570
Logits para tres imágenes: (3, 10)
partición n exactitud exactitud balanceada F1 macro
0 Entrenamiento 1077 0.999 0.999 0.999
1 Validación 360 0.956 0.956 0.955
2 Prueba 360 0.969 0.970 0.971

pred_dig = clases(modelo_dig, X_dig[te_d], False)
probs_dig = probabilidades(modelo_dig, X_dig[te_d], False)
assert probs_dig.shape == (len(te_d), 10)
assert np.allclose(probs_dig.sum(axis=1), 1, atol=1e-6)
reporte = pd.DataFrame(classification_report(y_dig[te_d], pred_dig,
    labels=np.arange(10), output_dict=True, zero_division=0)).T
display(reporte.round(3))
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
ConfusionMatrixDisplay.from_predictions(y_dig[te_d], pred_dig,
    labels=np.arange(10), ax=axes[0], cmap='Blues', colorbar=False)
axes[0].set_title('Digits: conteos por clase')
cm = confusion_matrix(y_dig[te_d], pred_dig, labels=np.arange(10))
fracciones = cm / cm.sum(axis=1, keepdims=True)
ConfusionMatrixDisplay(fracciones, display_labels=np.arange(10)).plot(
    ax=axes[1], cmap='Blues', colorbar=False, values_format='.2f')
axes[1].set_title('Digits: fracción por clase verdadera')
for ax in axes:
    ax.set(xlabel='Clase predicha', ylabel='Clase verdadera')
plt.tight_layout(); plt.show()

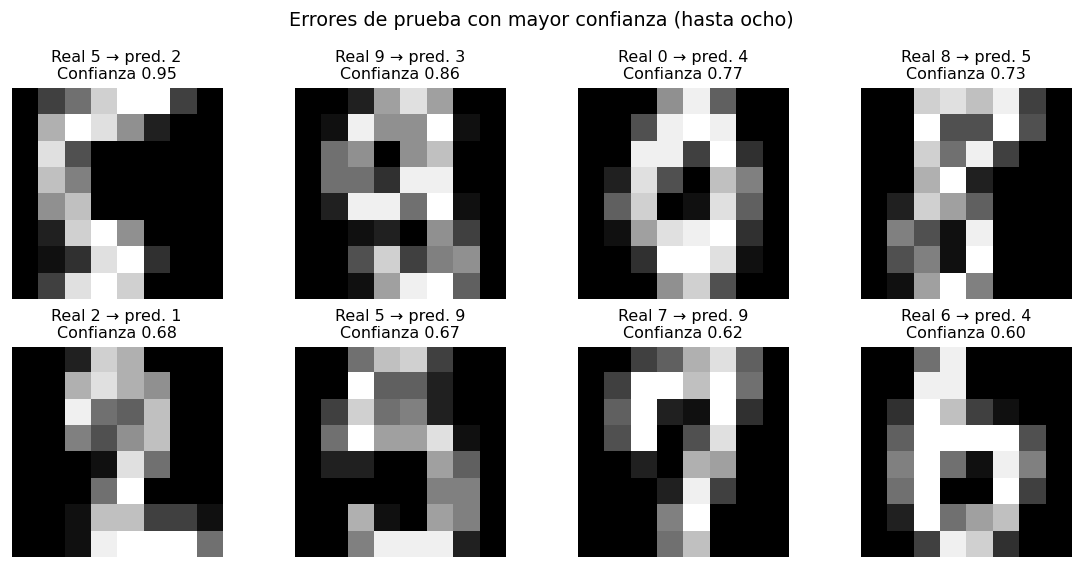
errores = np.flatnonzero(pred_dig != y_dig[te_d])
orden = np.argsort(-probs_dig[errores].max(axis=1))
mostrar = errores[orden[:8]]
if len(mostrar):
    fig, axes = plt.subplots(2, 4, figsize=(10, 5))
    for ax in axes.ravel():
        ax.axis('off')
    for ax, i in zip(axes.ravel(), mostrar):
        ax.imshow(X_dig[te_d[i]].reshape(8, 8), cmap='gray', vmin=0, vmax=1)
        ax.set_title(f'Real {y_dig[te_d[i]]} → pred. {pred_dig[i]}\n'
                     f'Confianza {probs_dig[i].max():.2f}', fontsize=10)
    fig.suptitle('Errores de prueba con mayor confianza (hasta ocho)')
    plt.tight_layout(); plt.show()
else:
    print('Esta muestra de prueba no contiene errores; no implica error poblacional cero.')
reporte.to_csv(ARTEFACTOS/'digits_reporte.csv')
display(Markdown(f'### Lectura de la ejecución\n\nSe restauró la época **{e_dig}** de {len(h_dig)}. '
    f'La prueba contiene {len(te_d)} imágenes, con **{len(errores)} errores** y '
    f'exactitud **{accuracy_score(y_dig[te_d], pred_dig):.1%}**. '
    'Las dos matrices muestran los mismos aciertos y fallos con escalas distintas. '
    'La galería selecciona errores por confianza para diagnóstico; no constituye una muestra representativa del desempeño.'))
precision recall f1-score support
0 1.000 0.970 0.985 33.000
1 0.966 1.000 0.982 28.000
2 0.970 0.970 0.970 33.000
3 0.971 0.971 0.971 34.000
4 0.958 1.000 0.979 46.000
5 0.957 0.936 0.946 47.000
6 0.971 0.971 0.971 35.000
7 1.000 0.971 0.985 34.000
8 0.967 0.967 0.967 30.000
9 0.950 0.950 0.950 40.000
accuracy 0.969 0.969 0.969 0.969
macro avg 0.971 0.970 0.971 360.000
weighted avg 0.970 0.969 0.969 360.000

5.10.1 Lectura de la ejecución

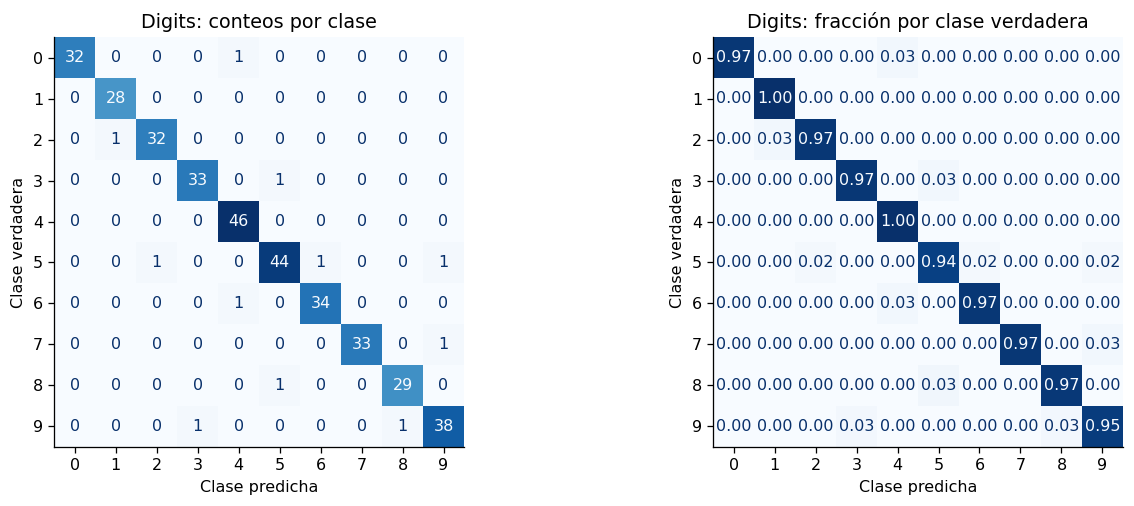
Se restauró la época 159 de 199. La prueba contiene 360 imágenes, con 11 errores y exactitud 96.9%. Las dos matrices muestran los mismos aciertos y fallos con escalas distintas. La galería selecciona errores por confianza para diagnóstico; no constituye una muestra representativa del desempeño.

5.10.2 Cómo leer el informe por clase

En la matriz, las filas son etiquetas verdaderas y las columnas son predicciones. La normalización por fila responde qué fracción de cada clase termina en cada predicción: su diagonal es el recall por clase. La matriz de conteos conserva el tamaño de muestra que esa normalización oculta.

La precisión de una clase pregunta qué proporción de las imágenes predichas como esa clase era correcta. El recall pregunta qué proporción de las imágenes verdaderas de esa clase recuperamos. La exactitud es la proporción global de aciertos. F1 macro promedia el F1 de las diez clases sin ponderar por soporte; no significa lo mismo que la exactitud ni que F1 ponderado.

La galería ayuda a identificar trazos ambiguos, pero no demuestra la causa de un error. Equivocarse con confianza alta tampoco basta, por sí solo, para cuantificar calibración. Antes de decidir entre más datos, otra representación o una CNN, formularíamos una hipótesis y un nuevo contraste en desarrollo. El uso de vecindarios espaciales se retoma en fundamentos de CNN.

5.11 Guardar el modelo que realmente elegimos

Guardaremos el state_dict del checkpoint restaurado de Digits, la arquitectura y el contrato de entrada. Recuperar solo pesos sin reconstruir la misma red o aplicar la misma escala produciría otra función.

El ejemplo es un artefacto de inferencia. Reanudar exactamente el entrenamiento requeriría además estado del optimizador, época y estados aleatorios. Las particiones y versiones se registran por separado para poder auditar el experimento. Solo cargamos el archivo que acabamos de crear.

config_dig = {'entradas': 64, 'ocultas': [64, 32], 'salidas': 10, 'activacion': 'tanh'}
ruta_modelo = ARTEFACTOS/'digits_mlp.pt'
torch.save({'state_dict': {k: v.detach().cpu().clone() for k, v in modelo_dig.state_dict().items()},
    'arquitectura': config_dig, 'checkpoint_epoca': int(e_dig),
    'entrada': {'forma': [None, 64], 'dtype': 'float32', 'escala': 'intensidad / 16'},
    'clases': list(range(10))}, ruta_modelo)
recuperado = torch.load(ruta_modelo, map_location='cpu', weights_only=True)
modelo_recargado = MLP(**recuperado['arquitectura'])
modelo_recargado.load_state_dict(recuperado['state_dict'])
modelo_recargado.eval()
with torch.inference_mode():
    muestra = tensor_x(X_dig[va_d[:16]])
    original = modelo_dig(muestra.to(dispositivo)).cpu()
    recarga = modelo_recargado(muestra)
assert torch.allclose(original, recarga, atol=1e-5, rtol=1e-5)
print('Archivo:', ruta_modelo.as_posix())
print('Máxima diferencia entre logits originales y recargados:',
      float((original-recarga).abs().max()))
pd.DataFrame(resultados).to_csv(ARTEFACTOS/'resultados.csv', index=False)
pd.DataFrame(particiones).to_csv(ARTEFACTOS/'particiones.csv', index=False)
protocolo = {'semilla_modelos': 42, 'semilla_particiones': 42,
    'seleccion': 'minima perdida de validacion; restaurar pesos',
    'umbral_binario': .5, 'dispositivo': str(dispositivo),
    'versiones': {'python': platform.python_version(), 'torch': str(torch.__version__),
                 'numpy': np.__version__, 'sklearn': sklearn.__version__},
    'presupuestos': {'xor': {'epochs_fixed': 2000, 'lr': .02},
        'recta': {'epochs_max': 1000, 'patience': 80, 'lr': .1, 'optimizer': 'SGD'},
        'espiral': {'epochs_max': 3000, 'patience': 150, 'lr': .01},
        'moons': {'epochs_max': 3000, 'patience': 100, 'lr': .001, 'batch': 200},
        'digits': {'epochs_max': 500, 'patience': 40, 'lr': .001, 'batch': 200}},
    'limite': 'una semilla por modelo; no compara rendimiento aislado entre frameworks'}
(ARTEFACTOS/'protocolo.json').write_text(json.dumps(protocolo, ensure_ascii=False, indent=2), encoding='utf-8')
display(pd.DataFrame(resultados).round(3))
Archivo: artefactos_pytorch/digits_mlp.pt
Máxima diferencia entre logits originales y recargados: 0.0
experimento checkpoint_epoca epocas_recorridas n_train n_val n_test test_accuracy test_f1_macro
0 recta 1000 1000 60 20 20 0.950 0.949
1 espiral 2948 3000 120 40 40 1.000 1.000
2 moons 2033 2133 300 100 100 0.970 0.970
3 digits 159 199 1077 360 360 0.969 0.971

5.11.1 Qué comprobamos al recuperar el archivo

La igualdad de logits en las mismas entradas comprueba que el guardado y la recarga preservan la función hasta tolerancia numérica. No valida el rendimiento en otra población, ni convierte los índices de clase en nombres si estos no se documentaron. La comprobación usa validación, sin abrir otra ronda de decisiones sobre prueba.

Para los modelos de coordenadas, el escalador también tendría que viajar con los pesos. Digits utiliza una constante de escala conocida, que sí queda escrita en el contrato. En pipelines y MLOps se desarrolla ese empaquetado con mayor alcance.

5.12 Galería de problemas para seguir practicando

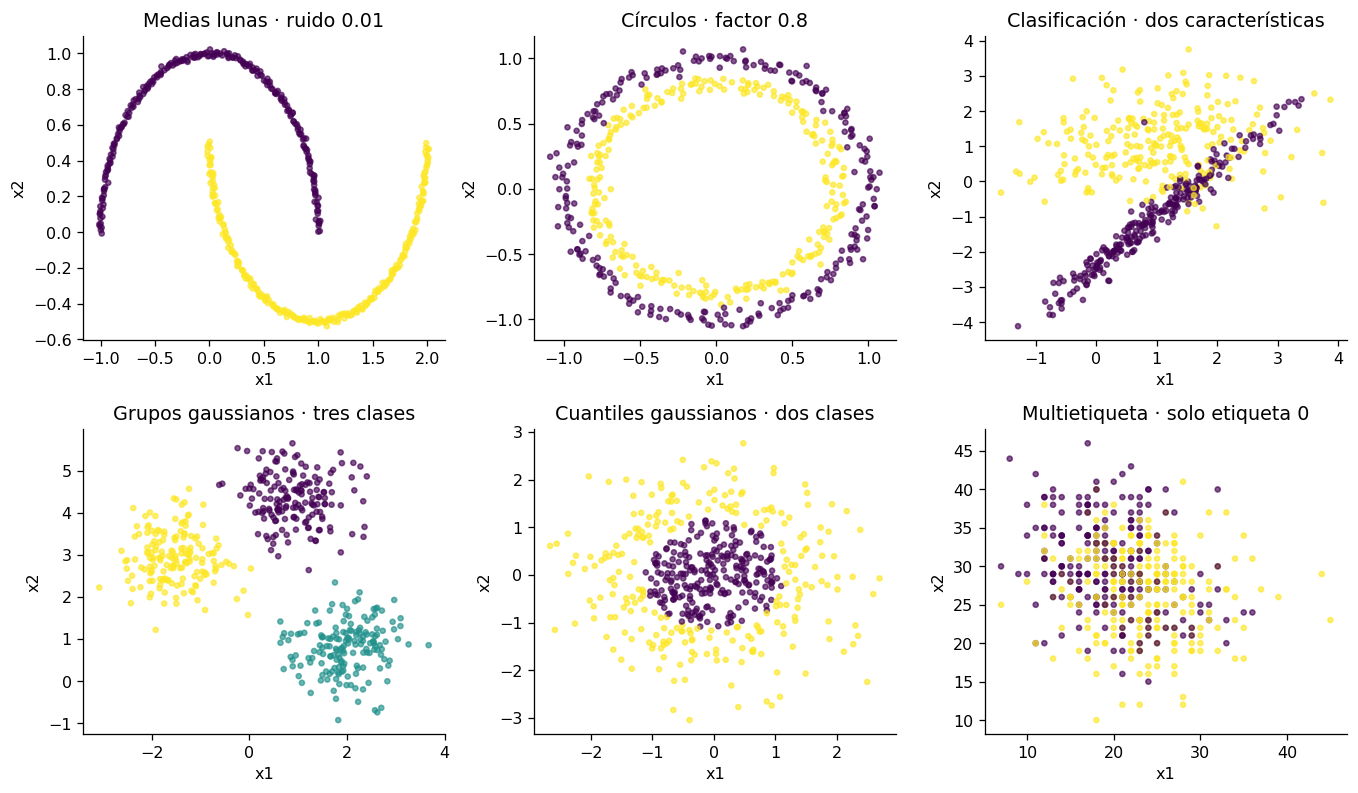
Conservamos la variedad de generadores de las clases, reunida en una sola figura para comparar geometrías. Esta galería no entrena modelos ni estima su dificultad de forma universal. Los parámetros elegidos pueden producir problemas más fáciles o más difíciles.

make_classification no garantiza separabilidad lineal. make_gaussian_quantiles asigna clases por regiones de una distribución normal. En el caso multietiqueta se colorea solo la presencia de la etiqueta 0: reducir toda la matriz de etiquetas a una columna no resuelve el problema multietiqueta completo.

galeria = [
    (*make_moons(n_samples=500, noise=.01, random_state=0), 'Medias lunas · ruido 0.01'),
    (*make_circles(n_samples=500, noise=.04, factor=.8, random_state=0), 'Círculos · factor 0.8'),
    (*make_classification(n_samples=500, n_features=2, n_redundant=0,
        n_informative=2, n_clusters_per_class=1, random_state=0), 'Clasificación · dos características'),
    (*make_blobs(n_samples=500, centers=3, cluster_std=.6, random_state=0), 'Grupos gaussianos · tres clases'),
    (*make_gaussian_quantiles(n_samples=500, n_classes=2, random_state=0), 'Cuantiles gaussianos · dos clases')]
X_multi, Y_multi = make_multilabel_classification(n_samples=500, n_features=2,
    n_classes=3, n_labels=2, random_state=0)
galeria.append((X_multi, Y_multi[:, 0], 'Multietiqueta · solo etiqueta 0'))
fig, axes = plt.subplots(2, 3, figsize=(12, 7))
for ax, (Xg, yg, titulo) in zip(axes.ravel(), galeria):
    ax.scatter(*Xg.T, c=yg, cmap='viridis', s=10, alpha=.65)
    ax.set(title=titulo, xlabel='x1', ylabel='x2')
plt.tight_layout(); plt.show()
print('Multietiqueta: forma completa de Y:', Y_multi.shape,
      '| ejemplos con más de una etiqueta:', int((Y_multi.sum(axis=1)>1).sum()))

Multietiqueta: forma completa de Y: (500, 3) | ejemplos con más de una etiqueta: 269

5.12.1 Qué elegir para el siguiente experimento

Las medias lunas y los círculos permiten estudiar no linealidad con fronteras distintas. Los grupos gaussianos permiten variar solapamiento y número de clases. Los cuantiles invitan a pensar en distancia al centro. La clasificación multietiqueta requiere varias salidas sigmoid y objetivos por etiqueta: no se convierte en multiclase usando softmax.

Para cambiar ruido, desbalance o valores atípicos con un protocolo común, utiliza el capítulo de generación de datos. Antes de entrenar otra red, escribe qué aspecto del problema quieres poner a prueba y qué observación te haría cambiar de decisión.

5.12.2 Rostros: conservar la exploración sin confundirla con reconocimiento

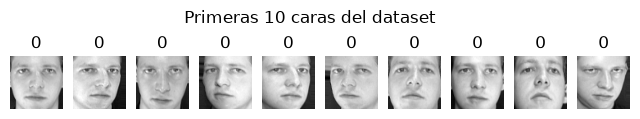
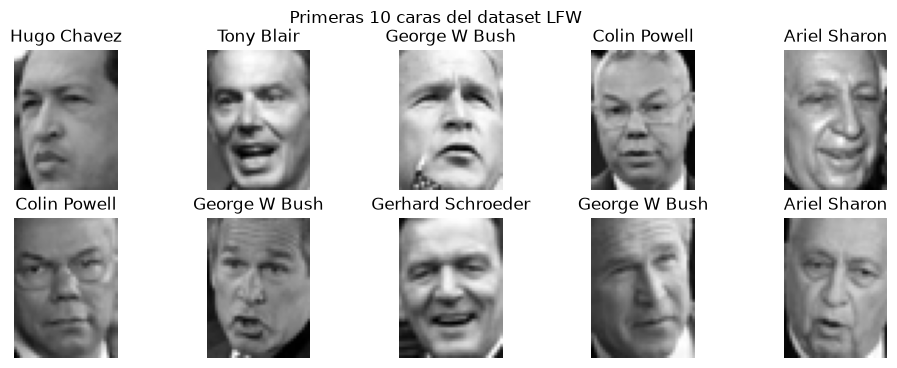
Las clases también exploraban Olivetti y LFW. Se conservan a continuación sus láminas de referencia procedentes de las salidas guardadas del material anterior. No se han vuelto a descargar ni se han utilizado para entrenar los modelos de este capítulo. La exploración y las condiciones de uso de datasets se tratan en datasets de referencia.

Olivetti contiene 400 imágenes de 64×64 de 40 personas. El subconjunto LFW mostrado en la exploración previa utilizó min_faces_per_person=70 y resize=0.4: no representa toda la base LFW. Mostrar rostros y etiquetas sirve para inspeccionar estructura y diversidad; no acredita un sistema de identificación ni rendimiento biométrico.

Olivetti · lámina de la exploración original

Olivetti · lámina de la exploración original.

LFW · subconjunto de la exploración original

LFW · subconjunto de la exploración original.

5.13 Decisiones que deja el capítulo

El perceptrón muestra cómo una corrección local modifica una frontera lineal. XOR muestra un límite de esa representación; una MLP puede cambiarla, pero necesita activaciones no lineales. Los ejemplos con muestras introducen otra pregunta: no basta con poder ajustar, hay que decidir qué estado conservar y cómo evaluar su comportamiento fuera del ajuste.

Las curvas, matrices y mapas tienen papeles distintos. Las curvas ayudan a elegir y diagnosticar entrenamiento; las matrices localizan tipos de error; las fronteras permiten relacionarlos con la geometría en dos dimensiones. Ninguna figura identifica por sí sola una causa, y una única semilla no describe toda la variabilidad del procedimiento.

El paso siguiente es entender cómo se obtiene cada gradiente y cómo la pérdida relaciona errores con cambios de parámetros. Esa es la pregunta del capítulo de pérdida y retropropagación.

5.14 Taller: formular una hipótesis antes de ejecutar

  1. Sustituye las activaciones de XOR por identidades. Explica primero qué transformación queda y después comprueba las cuatro filas. No interpretes un fallo numérico como única prueba del límite geométrico.
  2. En medias lunas, compara dos niveles de ruido manteniendo arquitectura y presupuesto. Define nuevas particiones de desarrollo y una evaluación reservada antes de experimentar; informa soporte y errores, no solo exactitud.
  3. Repite un experimento con tres semillas prefijadas. Elige el procedimiento con validación y resume variabilidad sin escoger retrospectivamente la mejor semilla de prueba.
  4. En Digits, identifica la clase con menor recall en validación. Formula una intervención y compruébala allí. Explica por qué elegirla a partir de la galería de errores de prueba cambiaría el papel estadístico de esa prueba.
  5. Recupera el artefacto de Digits y omite deliberadamente dividir intensidades por 16. Compara logits sobre datos de desarrollo y explica por qué conservar la arquitectura no basta para conservar el predictor.

5.15 Referencias