Quieres recibir una imagen con un solo dígito manuscrito y devolver un número entre 0 y 9. La parte interesante empieza antes de entrenar: debes saber cómo se ve la entrada, qué significan sus dimensiones y cómo conservar esa preparación al guardar la red. Trabajarás con MNIST y cerrarás el recorrido leyendo un PNG nuevo desde disco.
Tiempo estimado de lectura: 55 minutos, más cerca de 2 minutos de ejecución en CPU.
Nivel: Básico. Tipo de capítulo: teórico-aplicado.
Herramientas: PyTorch, torchvision, NumPy, pandas, matplotlib, scikit-learn y Pillow para archivos de imagen.
Al terminar podrás explorar los dígitos, preparar sus tensores, explicar el tamaño de cada capa, elegir una versión por validación y revisar sus errores en prueba. También podrás guardar pesos e información de entrada, reconstruir la red y predecir a partir de un archivo nuevo.
Primero observarás los datos y sus etiquetas. Después construirás la CNN, seguirás sus curvas y examinarás una representación interna. Abrirás prueba al cerrar las decisiones y guardarás el modelo. El último paso será usar el archivo guardado con una imagen que tú puedes sustituir por la tuya.
TipLo que necesitas recordar
Concepto
En una línea
Dónde se explica
Tensor, forma, lote y época
Organización de números, sus dimensiones y unidad de trabajo
13.2 Conocer los dígitos antes de construir la red
NotaClasificación multiclase y etiqueta
La clasificación multiclase elige una categoría entre varias opciones. La etiqueta es la categoría que conocemos para un ejemplo. Aquí cada imagen tiene una etiqueta entera entre 0 y 9 y la red produce diez puntuaciones.
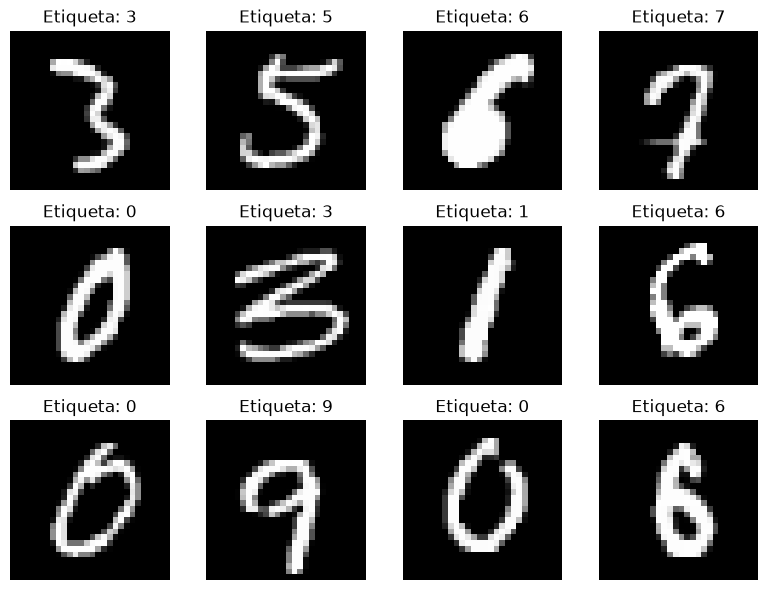
MNIST reúne imágenes de dígitos en gris, de 28 × 28 píxeles. El fondo suele ser oscuro y el trazo claro. La misma cifra puede escribirse con inclinaciones y grosores diferentes; reconocer un 2 exige aprender algo más que una plantilla fija de 784 posiciones.
Los datos se atribuyen a Yann LeCun, Corinna Cortes y Christopher J. C. Burges. Se descargan con torchvision.datasets.MNIST desde su fuente de distribución. La documentación de MNIST en Keras identifica su licencia como CC BY-SA 3.0. Las muestras aquí mostradas conservan esa atribución; las figuras señalan cuándo se transforman sus intensidades o su tamaño.
Usarás un subconjunto estratificado de 15000 de las 60000 imágenes oficiales de desarrollo: 12000 para entrenamiento y 3000 para validación. La prueba oficial conserva sus 10000 imágenes. Es una selección para trabajar con rapidez en CPU; sus índices se guardan para poder repetirla.
La primera celda configura el entorno y la semilla. El apoyo documentado, apoyo_cnn.py, se muestra completo en el desplegable final.
from pathlib import Pathimport copyimport jsonimport platformimport timeimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport torchimport torchvisionfrom PIL import Image, ImageDrawfrom torch import nnfrom torch.nn import functional as Ffrom IPython.display import displayimport apoyo_cnn as apoyoSEMILLA =42np.random.seed(SEMILLA)torch.manual_seed(SEMILLA)torch.set_num_threads(2)dispositivo = torch.device("cpu")artefactos = Path("artefactos_pytorch")artefactos.mkdir(exist_ok=True)versiones = {"python": platform.python_version(), "torch": str(torch.__version__),"torchvision": torchvision.__version__, "numpy": np.__version__,"pandas": pd.__version__, "dispositivo": str(dispositivo), "hilos": 2,}print(versiones)
La salida python, torch, torchvision y dispositivo registra dónde se ejecutó este ejemplo. La comparación de cifras tiene sentido junto con esa configuración y la semilla 42.
Carga ahora MNIST y observa doce imágenes del entrenamiento en su orden de selección. La tabla de frecuencias te permitirá comparar la cantidad de cada dígito en ajuste y validación.
El dígito 1 es el más frecuente del ajuste, con 1348 imágenes, y el 5 tiene 1084. Validación conserva esa diferencia: 337 unos y 271 cincos. Las escrituras de la galería muestran por qué contar ejemplos y mirar sus trazos son comprobaciones complementarias antes de entrenar.
13.3 Preparar una entrada que la CNN pueda usar
NotaPreprocesamiento
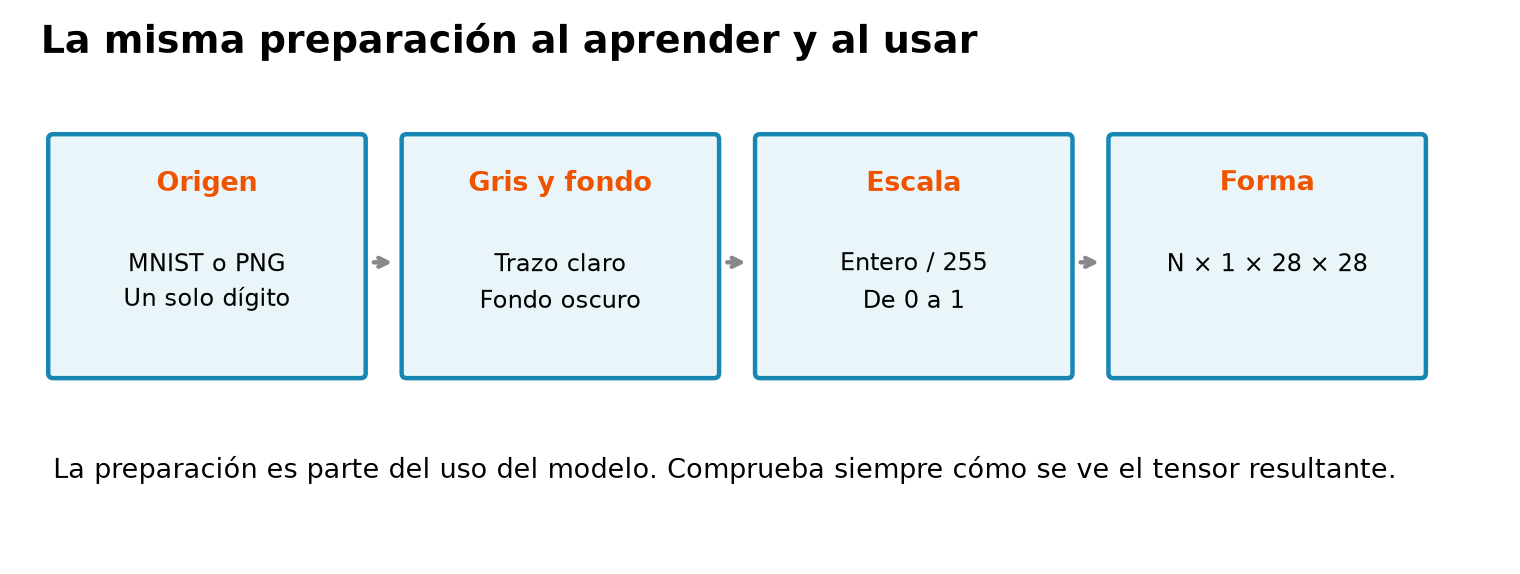
El preprocesamiento transforma el dato recibido en la entrada que utiliza el modelo. Aquí consiste en mantener un canal de gris, convertir intensidades a float32, dividir por 255 y organizar el lote como (N, 1, 28, 28).
Piensa en medir una receta siempre con la misma taza. Si al usarla cambias de unidad, las cantidades significan otra cosa. Del mismo modo, la red aprenderá con intensidades entre 0 y 1 y debe recibir esa escala al predecir. Un gris original de 128 se convierte en 128 / 255 ≈ 0.501961.
Las etiquetas se conservan como enteros long. La CE recibe diez logits por imagen y un entero que indica cuál corresponde al dígito real. Softmax se usará después para leer las probabilidades. De esta manera cada posición de salida tiene un significado fijo: la primera corresponde a 0 y la última a 9.
La preparación de entrenamiento y la de uso convergen en la misma forma.
Comprueba un valor intermedio y las formas de los tensores. La celda de datos ya creó las entradas listas para usar; aquí verificas sus propiedades.
La entrada tiene forma (12000, 1, 28, 28), tipo torch.float32 y rango de 0.0 a 1.0. Las etiquetas tienen forma (12000,) y tipo torch.int64, equivalente al long que necesita esta CE. El valor 128 se transforma en 0.501961, igual que la cuenta de la receta de escala.
13.4 Por qué usar una CNN en este problema
En una MLP, una neurona de la primera capa recibe los 784 píxeles. En la CNN, cada filtro empieza mirando nueve vecinos y reutiliza sus pesos sobre el resto del dígito. Un segmento del 7 puede estar unas posiciones más arriba o abajo; compartir la operación permite buscar trazos semejantes en varias posiciones.
El capítulo anterior comparó ambos diseños con prendas. Aquí concentrarás el trabajo en una sola CNN para seguir todas las etapas de uso. El razonamiento espacial se mantiene: combinar trazos locales antes de reunirlos en una decisión para el dígito completo.
13.5 La arquitectura, capa por capa
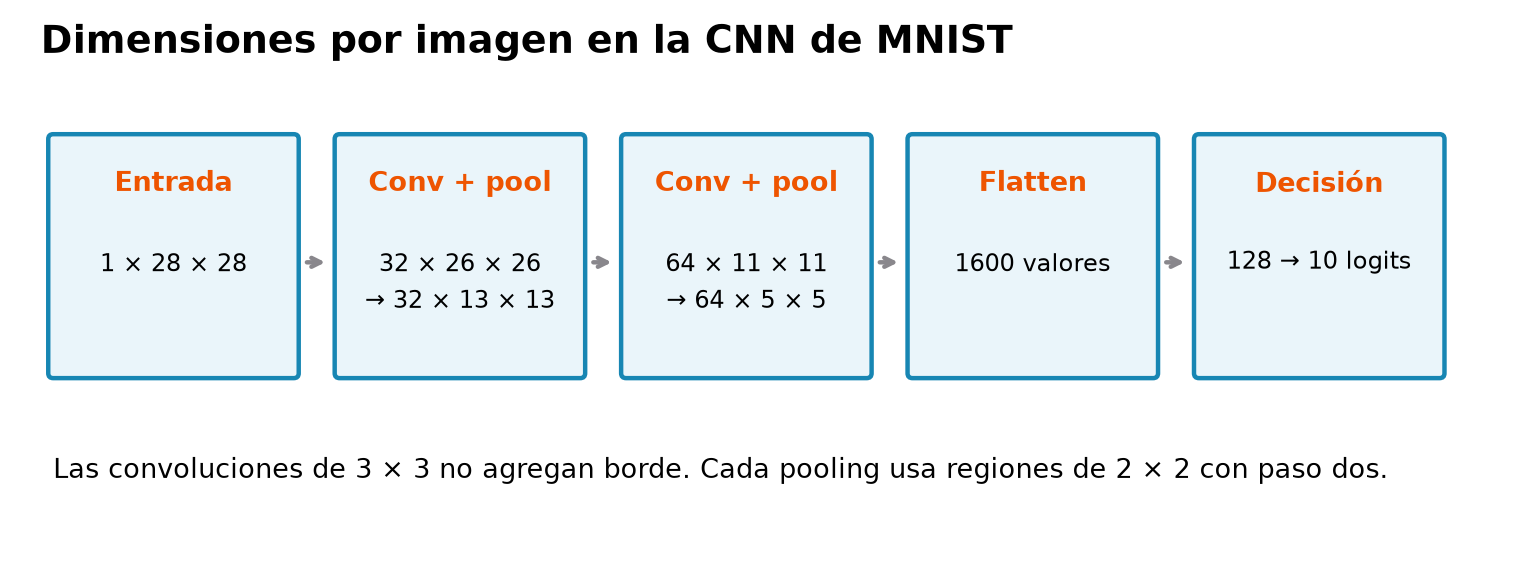
Usaremos dos convoluciones de 3 × 3 sin padding. La primera produce 32 mapas de 26 × 26; un pooling de 2 los resume a 13 × 13. La segunda produce 64 mapas de 11 × 11 y otro pooling los reduce a 5 × 5.
Flatten reorganiza 64 × 5 × 5 = 1600 valores por imagen. Una capa densa los combina en 128 activaciones, seguida de ReLU y dropout 0.5. La salida produce diez logits. Durante entrenamiento dropout desactiva aleatoriamente activaciones; durante evaluación se usa la representación completa, como viste en regularización.
Las dimensiones van cambiando mientras se conserva el número de imágenes del lote.
Construye la red y recórrela con dos imágenes de ceros. Cada fila de la tabla describe una transformación y su número de parámetros; esa comprobación detecta errores de tamaño antes de entrenar.
def crear_cnn():"""Devuelve la arquitectura de MNIST sin pesos aprendidos."""return nn.Sequential( nn.Conv2d(1, 32, 3), nn.ReLU(), nn.MaxPool2d(2), nn.Conv2d(32, 64, 3), nn.ReLU(), nn.MaxPool2d(2), nn.Flatten(), nn.Linear(1600, 128), nn.ReLU(), nn.Dropout(0.5), nn.Linear(128, 10), )modelo = crear_cnn()modelo.eval()entrada = torch.zeros(2, 1, 28, 28)filas = []with torch.inference_mode():for capa in modelo: entrada = capa(entrada) filas.append({"Capa": type(capa).__name__, "Salida": str(tuple(entrada.shape)),"Parámetros": sum(p.numel() for p in capa.parameters())})display(pd.DataFrame(filas))print("Parámetros totales:", sum(p.numel() for p in modelo.parameters()))
Capa
Salida
Parámetros
0
Conv2d
(2, 32, 26, 26)
320
1
ReLU
(2, 32, 26, 26)
0
2
MaxPool2d
(2, 32, 13, 13)
0
3
Conv2d
(2, 64, 11, 11)
18496
4
ReLU
(2, 64, 11, 11)
0
5
MaxPool2d
(2, 64, 5, 5)
0
6
Flatten
(2, 1600)
0
7
Linear
(2, 128)
204928
8
ReLU
(2, 128)
0
9
Dropout
(2, 128)
0
10
Linear
(2, 10)
1290
Parámetros totales: 225034
La tabla permite seguir el lote de dos imágenes hasta (2, 10). Después del segundo pooling quedan 64 mapas de 5 × 5; Flatten reúne sus 1600 valores. La red suma 225034 parámetros y la primera capa densa reúne 204928 de ellos. Dropout conserva la forma (2, 128) y añade cero parámetros entrenables.
13.6 Entrenar y conservar la mejor versión
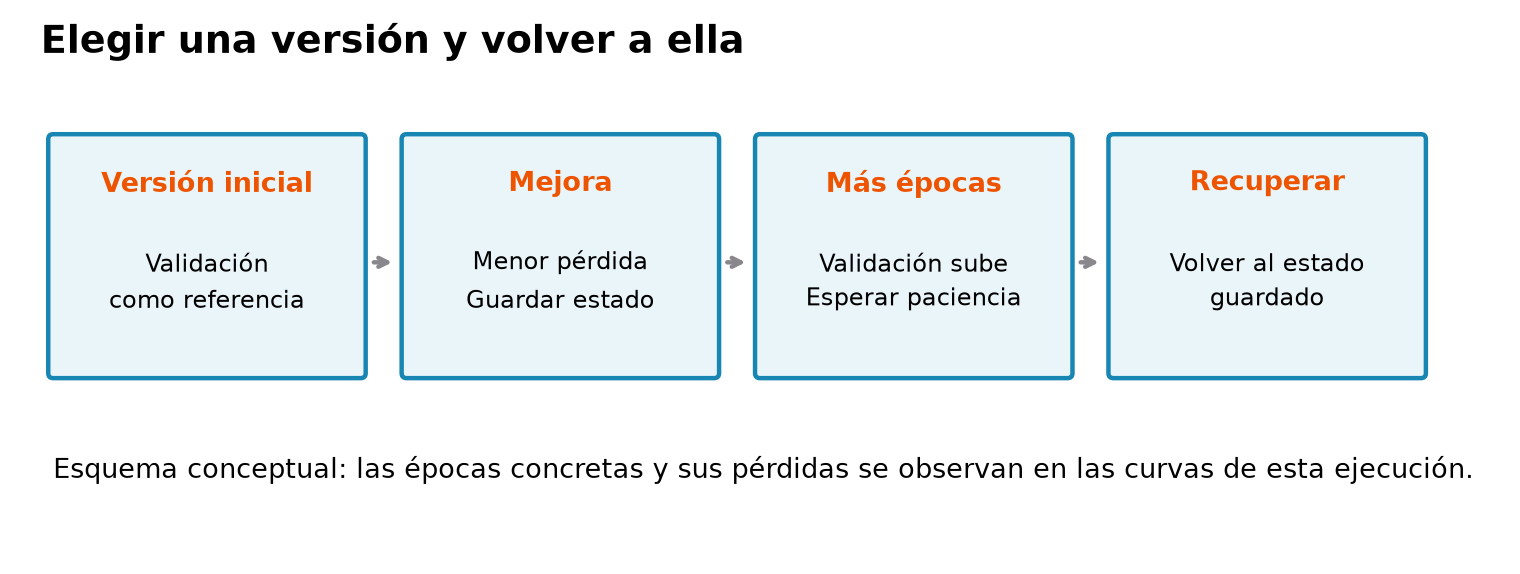
La CNN empezará con pesos nuevos y aprenderá con las 12000 imágenes de ajuste. Usará Adam, tasa 0.001, lotes de 128, máximo inicial de 60 épocas y paciencia 5. La pérdida de validación decide qué estado guardar. Al final se restaura ese estado aunque se hayan ejecutado épocas posteriores.
La analogía es conservar el borrador que mejor funciona en una revisión, en lugar de entregar automáticamente el último que escribiste. La validación hace esa revisión; la prueba queda para el informe del trabajo terminado.
El estado elegido corresponde al mínimo de validación.
La siguiente celda ejecuta el ciclo de cinco acciones del Apéndice A. La función de apoyo recibe entrenamiento y validación, conserva el mejor state_dict y devuelve el historial. También comprueba que la mejor época quede antes del máximo; si llega al límite, amplía el presupuesto antes de continuar.
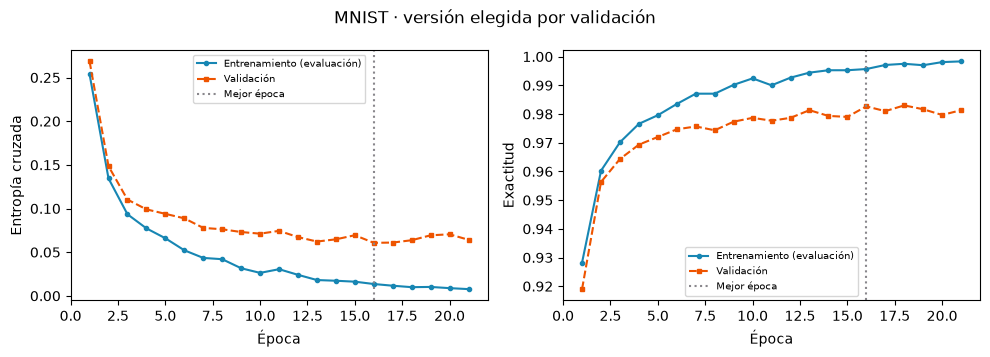
La mejor versión corresponde a la época 16, con CE de validación 0.060688. La ejecución llegó a la 21 y se detuvo tras cinco épocas sin un nuevo mínimo. La comprobación 16 < 60 dio True, de modo que la versión elegida quedó dentro del presupuesto. El ajuste medido tardó 81.80 segundos.
La pérdida y la exactitud de entrenamiento se miden sobre imágenes usadas para ajustar los pesos. Las dos curvas se calculan en modo evaluación al cerrar cada época, con el mismo estado de red, para compararlas con validación.
apoyo.curvas(historial, "MNIST · versión elegida por validación", resumen["mejor_epoca"])
Figura 13.2: Aprendizaje de la CNN de MNIST
En la época 21, la pérdida de entrenamiento es 0.007704 y la de validación 0.064182. La segunda supera el mínimo 0.060688 de la época 16, aunque entrenamiento siga ajustándose. Las exactitudes finales son 99.83 % y 98.13 %, respectivamente; esa separación permite observar la adaptación creciente a las imágenes conocidas.
13.7 Mirar una representación intermedia
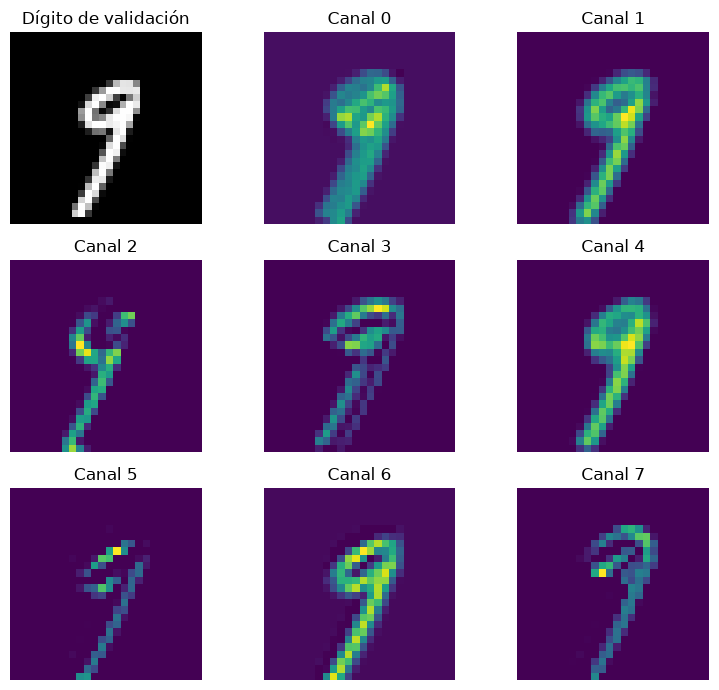
Antes de abrir prueba, utiliza un dígito de validación y observa ocho de los 32 mapas de la primera convolución después de ReLU. Es como mirar las piezas que produjo el primer paso de un ensamblaje: la salida final combinará esas piezas con otras transformaciones.
La siguiente celda muestra la imagen y los mapas con escalas independientes. Observa en qué posiciones aparecen respuestas positivas y en cuáles quedan ceros.
modelo.eval()with torch.inference_mode(): muestra = validacion.tensors[0][:1].to(dispositivo) mapas = modelo[1](modelo[0](muestra))[0].cpu()figura, ejes = plt.subplots(3, 3, figsize=(8, 7))ejes.flat[0].imshow(muestra[0, 0].cpu(), cmap="gray")ejes.flat[0].set_title("Dígito de validación")for indice, eje inenumerate(list(ejes.flat)[1:]): eje.imshow(mapas[indice], cmap="viridis") eje.set_title(f"Canal {indice}")for eje in ejes.flat: eje.axis("off")figura.tight_layout()plt.show()print("Mapas de primera capa:", tuple(mapas.shape))
Figura 13.3: Representaciones de una imagen de validación
Mapas de primera capa: (32, 26, 26)
La primera capa produce (32, 26, 26) para el dígito observado. La figura muestra ocho de esos 32 canales después de ReLU. Busca las posiciones de los trazos en la entrada y en cada mapa: algunos canales conservan respuestas alrededor de zonas distintas del mismo número.
13.8 Evaluar el clasificador terminado
Ya elegiste la versión con validación. La celda siguiente procesa una vez las 10000 imágenes oficiales de prueba y guarda sus probabilidades. La tabla resume CE y exactitud; las figuras e informes siguientes reutilizan esas predicciones.
La versión de la época 16 alcanzó 98.49 % de exactitud en las 10000 imágenes de prueba, con CE 0.051716. La cifra de prueba evalúa la versión ya elegida, mientras que el 0.060688 de validación fue el criterio para escogerla. Mantener separados esos papeles permite explicar de dónde sale cada número.
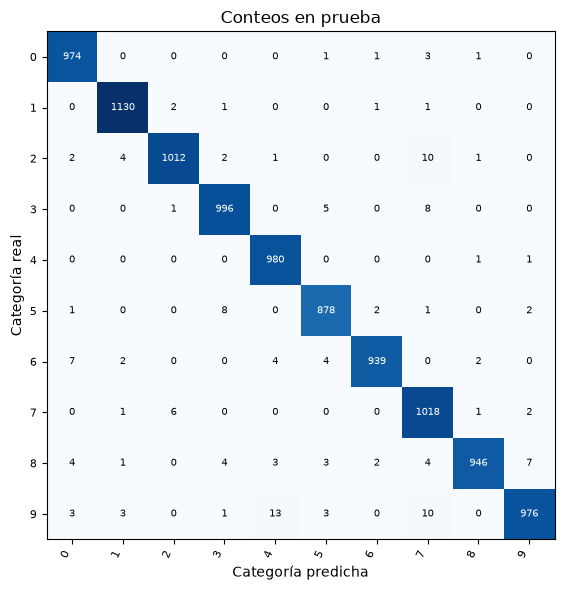
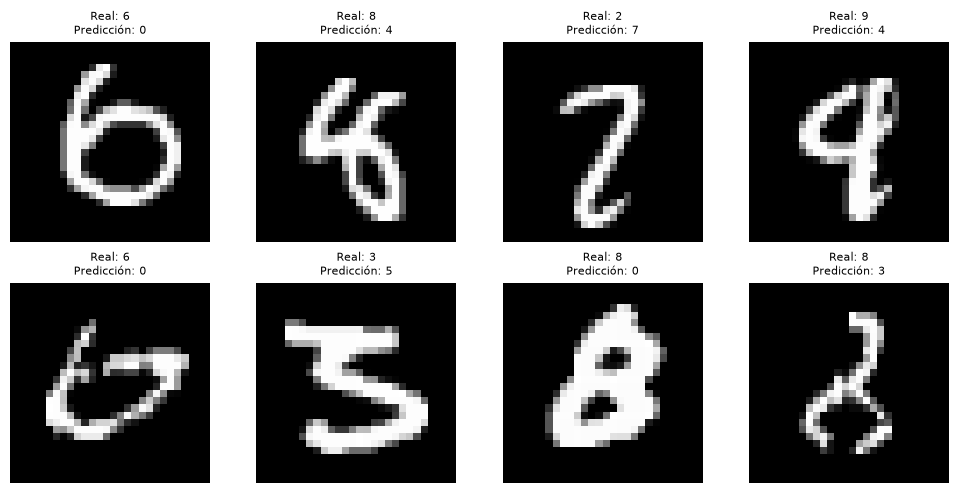
La matriz cruza el dígito real de cada fila con el predicho de cada columna. La tabla por categoría añade precisión, sensibilidad y F1; el promedio macro trata los diez dígitos con el mismo peso. La galería muestra los primeros ocho errores en el orden de prueba.
La CNN cometió 151 errores. El dígito 9 tiene la menor sensibilidad, 0.9673, y la confusión individual más frecuente es 9 predicho como 4, con 13 casos. El dígito 7 tiene precisión 0.9649 y sensibilidad 0.9903: recupera casi todos los sietes reales, pero también recibe ejemplos de otros dígitos. Relaciona esos resultados con las escrituras que aparecen en la galería.
13.9 Guardar números y conservar su significado
NotaInferencia y metadatos
La inferencia utiliza un modelo ya ajustado para producir respuestas. Los metadatos describen la información que acompaña sus pesos: qué arquitectura reconstruir, cómo preparar una imagen y qué categoría corresponde a cada salida.
Guardar solo números es como conservar una receta sin indicar las unidades. El state_dict contiene los pesos aprendidos; el código de la arquitectura permite colocarlos en las capas correctas. Los metadatos completan el significado de la entrada y la salida.
Guarda ambos en mnist-cnn.pt, crea otra red con la misma estructura y carga su estado. Para comprobar la reconstrucción, compara sus logits con los del modelo original sobre 32 imágenes de validación. Usa eval() y inference_mode() porque esta etapa solo predice.
Diferencia máxima de logits al recargar: 0.0
Forma y etiquetas guardadas: [1, 28, 28] ['0', '1', '2', '3', '4', '5', '6', '7', '8', '9']
La diferencia máxima de logits después de reconstruir y recargar fue 0.0 en las 32 imágenes de control. El paquete conserva la forma [1, 28, 28] y las etiquetas ordenadas de 0 a 9. Esa coincidencia comprueba que los pesos guardados se colocaron en la misma arquitectura y producen las mismas puntuaciones.
13.10 Leer un dígito nuevo desde un PNG
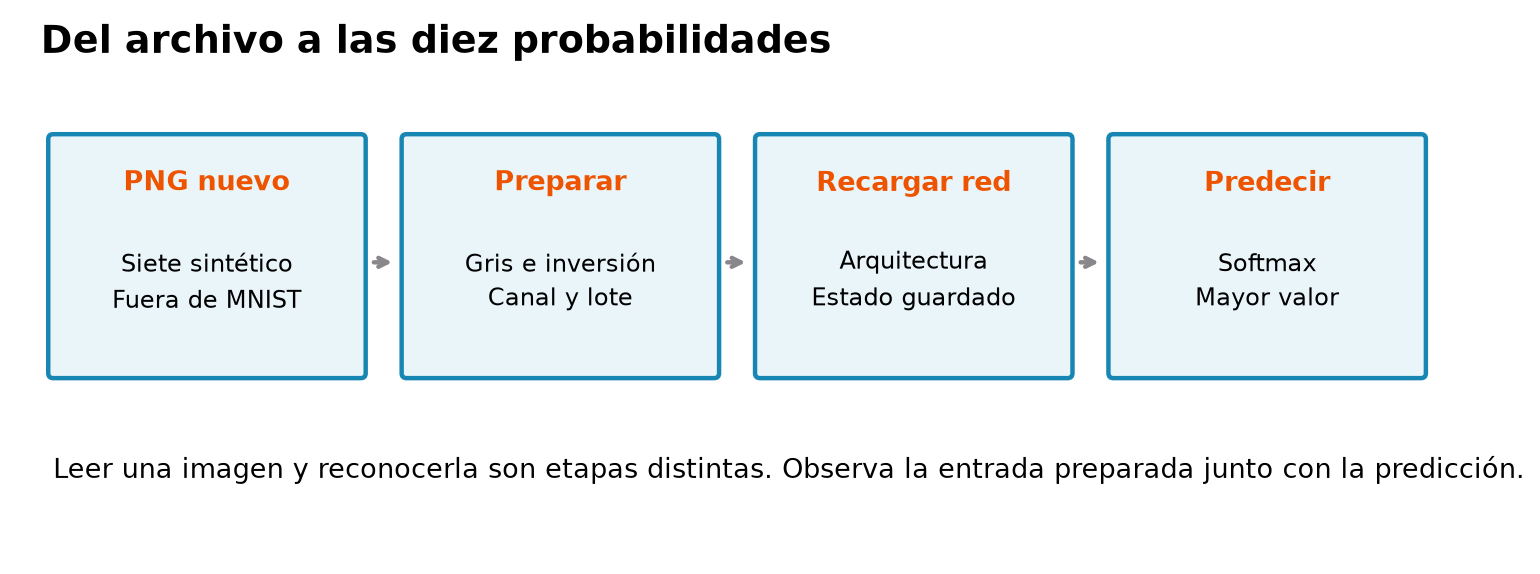
Prepararemos un 7 sintético: un trazo horizontal unido a uno diagonal sobre fondo claro. Se dibuja aquí, así que conoces su categoría y su procedencia. Es un ejemplo de entrada externa al entrenamiento, diferente de las imágenes reservadas de MNIST.
La función cargar_digito abre un archivo, lo convierte a gris y lo redimensiona a 28 × 28. Para fondo claro y trazo oscuro, invertir=True aplica 1 - intensidad, acercando su presentación al fondo oscuro con el que se entrenó la red.
Del archivo nuevo a la respuesta de la red recargada.
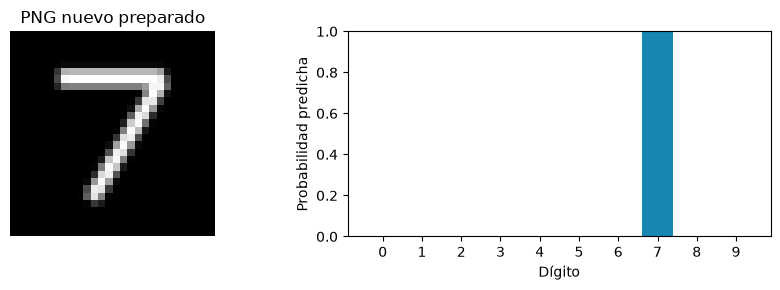
La siguiente celda crea el PNG y lo pasa por la red recargada. Puedes sustituir la ruta por tu archivo y elegir la inversión según el fondo. La gráfica muestra todas las probabilidades, no solo la respuesta elegida.
El archivo dibujado representa un 7 y la red recargada predijo 7. La probabilidad mostrada para esa categoría fue 0.999969; la siguiente respuesta visible, para 2, fue 0.000030. Observa el trazo claro sobre fondo oscuro de la figura: ya pasó por la preparación que exige la CNN. Este resultado recorre con éxito la ruta archivo–tensor–red–predicción.
13.11 Un error de etiquetas que conviene reconocer
Las imágenes son decimales, pero las etiquetas de esta CE deben ser enteras. Vamos a convertir deliberadamente las etiquetas de un lote a float32 para ver el mensaje real. El error se captura y el notebook continúa con la forma correcta de usarlas.
RuntimeError: expected target dtype to be Long or Byte, but got Float
Tipo correcto de etiquetas: torch.int64
El mensaje real indica expected target dtype to be Long or Byte, but got Float. La salida correcta mantiene torch.int64: las etiquetas identifican posiciones enteras de las diez salidas. El error fue provocado a propósito y capturado, así que el notebook sigue su ejecución normal.
Lo que ves
Qué pasó
Cómo se arregla
El mensaje pide Long y encuentra Float
Se cambiaron etiquetas enteras por decimales
Conserva la etiqueta entera o usa .long()
La imagen preparada tiene el fondo invertido
La convención visual difiere de MNIST
Revisa la imagen después de cargar_digito y elige invertir
El tamaño de una capa al cargar no coincide
Se reconstruyó otra arquitectura
Usa las mismas capas, filtros y dimensiones de la red guardada
13.12 Alcance y siguientes comprobaciones
MNIST está centrado, tiene un solo dígito por imagen y una resolución pequeña. La exactitud de su prueba describe ese conjunto. Fotografías con varios números, fondos complejos o escrituras distintas necesitan datos representativos y otra evaluación.
El PNG sintético sirve para recorrer la lectura y la inferencia, no para estimar una exactitud externa. Su inversión corrige contraste, pero no resuelve automáticamente centrado, grosor ni encuadre. Los mapas internos tienen escala independiente y muestran respuestas espaciales, sin asignar un significado humano fijo a cada canal. El archivo guardado permite predecir; reanudar exactamente el entrenamiento exigiría también conservar el estado del optimizador.
13.13 Ejercicios
Calcula por qué la segunda convolución recibe 32 canales y produce 64 mapas de 11 × 11.
Explica qué versión se recupera si la época 9 tiene menor pérdida de validación que la 14.
Busca en la matriz una confusión frecuente y relaciónala con los ejemplos de escritura mostrados.
Dibuja un dígito propio y observa el archivo preparado antes de predecir. Documenta fondo y encuadre.
Compara las probabilidades del archivo propio con el mismo archivo invertido. Mantén fijo el modelo.
Enumera lo que debes conservar para usar la red en otro equipo.
TipOrientaciones
El primer pooling deja 32 mapas de 13 × 13; un kernel de 3 sin borde reduce cada eje a 11. Los 64 filtros deciden el número de mapas de salida.
Se recupera la época 9 por la regla de menor CE, aunque la ejecución haya llegado a la 14.
Observa filas y columnas concretas y plantea una hipótesis sobre los trazos de esos dígitos para contrastarla en ejemplos nuevos.
Usa un solo dígito, evita recortarlo y comprueba que el tensor lo muestra con trazo claro sobre fondo oscuro.
La inversión cambia las intensidades de entrada sin cambiar los pesos. La diferencia indica sensibilidad a esa preparación.
Arquitectura, state_dict, preparación de entrada, orden de etiquetas y versiones de referencia.
13.14 Glosario de este capítulo
Término
Significado
Clasificación multiclase
Elegir una categoría entre varias
Etiqueta
Respuesta conocida para un ejemplo
Preprocesamiento
Preparación del dato para que tenga la forma, escala y presentación esperadas
Inferencia
Producir predicciones con un modelo ajustado
Metadatos
Información para reconstruir el modelo e interpretar entradas y salidas
La CNN recuperó la época 16 por validación y alcanzó 98.49 % en prueba, con 151 errores que pudiste localizar por dígito. Después reconstruiste sus 225034 parámetros desde disco y verificaste una diferencia de logits de 0.0. La predicción del 7 nuevo cerró el recorrido: además de entrenar, conservaste cómo preparar una entrada y cómo interpretar la salida.
El siguiente capítulo, arquitecturas CNN, estudiará cómo cambia el recorrido de la información al conectar los bloques de otra manera. Conservarás la separación entre datos para ajustar, elegir y evaluar que acabas de utilizar.
"""Apoyo para los experimentos CNN de la Biblioteca BIT.Reúne carga oficial de datos, entrenamiento con validación y gráficos.La semilla y el dispositivo los decide el notebook. Ninguna función usa pruebapara ajustar pesos ni elegir una época. Los valores devueltos permiten escribirlas interpretaciones en el texto del capítulo, después de ejecutar."""from pathlib import Pathimport contextlibimport copyimport ioimport timeimport matplotlib.pyplot as pltimport numpy as npimport pandas as pdimport torchfrom sklearn.metrics import classification_report, confusion_matrixfrom sklearn.model_selection import train_test_splitfrom torch.nn import functional as Ffrom torch.utils.data import DataLoader, TensorDatasetfrom torchvision.datasets import FashionMNIST, MNISTdef datos(nombre, cantidad, semilla):"""Carga MNIST o Fashion-MNIST y devuelve tensores, etiquetas e índices. Recibe el nombre, el tamaño del subconjunto de desarrollo y la semilla. Descarga los archivos oficiales con torchvision la primera vez y después los reutiliza desde la caché. Devuelve un diccionario con entrenamiento, validación (20 % del subconjunto), prueba oficial e índices de desarrollo. """ clase = FashionMNIST if nombre =="fashion"else MNIST raiz = Path.home() /".cache"/"bit-datasets"with contextlib.redirect_stdout(io.StringIO()):with contextlib.redirect_stderr(io.StringIO()): desarrollo = clase(raiz, train=True, download=True) prueba = clase(raiz, train=False, download=True) etiquetas = desarrollo.targets.numpy() indices = np.arange(len(etiquetas)) elegidos, _ = train_test_split( indices, train_size=cantidad, stratify=etiquetas, random_state=semilla ) ajuste, validacion = train_test_split( elegidos, test_size=0.2, stratify=etiquetas[elegidos], random_state=semilla )assertnotset(ajuste).intersection(validacion) imagenes = desarrollo.data.unsqueeze(1).float() /255 entrada_prueba = prueba.data.unsqueeze(1).float() /255return {"entrenamiento": TensorDataset(imagenes[ajuste], desarrollo.targets[ajuste]),"validacion": TensorDataset(imagenes[validacion], desarrollo.targets[validacion]),"prueba": TensorDataset(entrada_prueba, prueba.targets),"indices_ajuste": ajuste,"indices_validacion": validacion, }def cargador(conjunto, semilla, mezclar=False, lote=128):"""Recibe datos, semilla y opciones; devuelve lotes con generador explícito.""" generador = torch.Generator().manual_seed(semilla)return DataLoader( conjunto, batch_size=lote, shuffle=mezclar, generator=generador, num_workers=0 )@torch.inference_mode()def evaluar(modelo, conjunto, dispositivo, semilla):"""Recibe modelo y datos; devuelve CE media, exactitud, etiquetas y probabilidades.""" modelo.eval() total =0.0 salidas = [] etiquetas = []for entrada, respuesta in cargador(conjunto, semilla): logits = modelo(entrada.to(dispositivo)) total += F.cross_entropy( logits, respuesta.to(dispositivo), reduction="sum" ).item() salidas.append(logits.cpu()) etiquetas.append(respuesta) logits = torch.cat(salidas) reales = torch.cat(etiquetas)assert torch.isfinite(logits).all()return {"perdida": total /len(conjunto),"exactitud": (logits.argmax(1) == reales).float().mean().item(),"reales": reales.numpy(),"probabilidades": logits.softmax(1).numpy(), }def entrenar(modelo, ajuste, validacion, dispositivo, semilla, maximo=60, paciencia=5, tasa=0.001):"""Ajusta con Adam y restaura el mejor estado según CE de validación. Recibe modelo, dos conjuntos, dispositivo, semilla y presupuesto. Devuelve historial por época y resumen. Las curvas de ajuste también se miden en modo evaluación al cerrar la época, sobre datos usados para aprender. Si el mínimo queda en el borde se amplía el máximo, conservando el modelo y el optimizador. Si exige más de 1100 segundos o 240 épocas, se detiene con un error para revisar el diseño antes de abrir prueba. """ modelo.to(dispositivo) optimizador = torch.optim.Adam(modelo.parameters(), lr=tasa) lotes = cargador(ajuste, semilla, mezclar=True) historial = [] mejor =float("inf") estado =None espera =0 limite = maximo inicio = time.perf_counter()for epoca inrange(1, 241): modelo.train()for entrada, respuesta in lotes: entrada = entrada.to(dispositivo) respuesta = respuesta.to(dispositivo) optimizador.zero_grad(set_to_none=True) perdida = F.cross_entropy(modelo(entrada), respuesta)assert torch.isfinite(perdida) perdida.backward() optimizador.step() medidas_ajuste = evaluar(modelo, ajuste, dispositivo, semilla) medidas_val = evaluar(modelo, validacion, dispositivo, semilla) historial.append({"epoca": epoca, "perdida_ajuste": medidas_ajuste["perdida"],"perdida_validacion": medidas_val["perdida"],"exactitud_ajuste": medidas_ajuste["exactitud"],"exactitud_validacion": medidas_val["exactitud"], })if medidas_val["perdida"] < mejor: mejor = medidas_val["perdida"] mejor_epoca = epoca estado = copy.deepcopy(modelo.state_dict()) espera =0else: espera +=1if time.perf_counter() - inicio >1100:raiseRuntimeError("Revisar presupuesto CPU antes de abrir prueba")if espera >= paciencia:breakif epoca == limite:if mejor_epoca < limite:break limite *=2print("Máximo ampliado a", limite)assert mejor_epoca < limite, "Ampliar presupuesto antes de evaluar prueba" modelo.load_state_dict(estado) modelo.eval() resumen = {"mejor_epoca": mejor_epoca, "epocas_ejecutadas": epoca,"maximo_final": limite, "perdida_validacion": mejor,"segundos": time.perf_counter() - inicio,"parametros": sum(p.numel() for p in modelo.parameters()), }print("Mejor época < máximo:", mejor_epoca, "<", limite, "=", mejor_epoca < limite)return pd.DataFrame(historial), resumendef curvas(historial, titulo, mejor_epoca):"""Recibe historial, título y época elegida; dibuja CE y exactitud comparables.""" figura, ejes = plt.subplots(1, 2, figsize=(10, 3.6))for eje, medida, nombre inzip( ejes, ["perdida", "exactitud"], ["Entropía cruzada", "Exactitud"] ): eje.plot(historial.epoca, historial[medida +"_ajuste"], "-o", color="#1786B3", label="Entrenamiento (evaluación)", markersize=3) eje.plot(historial.epoca, historial[medida +"_validacion"], "--s", color="#EE5400", label="Validación", markersize=3) eje.axvline(mejor_epoca, color="#89878C", linestyle=":", label="Mejor época") eje.set(xlabel="Época", ylabel=nombre) eje.legend(fontsize=7) figura.suptitle(titulo) figura.tight_layout() plt.show()def diagnostico(resultado, nombres, imagenes):"""Recibe predicciones e imágenes; devuelve matriz y tabla de métricas por clase. Dibuja matriz con conteos y hasta ocho errores. Reutiliza las predicciones calculadas al abrir prueba, sin volver a evaluar el modelo. """ reales = resultado["reales"] probabilidades = resultado["probabilidades"] predichos = probabilidades.argmax(1) matriz = confusion_matrix(reales, predichos, labels=np.arange(len(nombres))) reporte = classification_report( reales, predichos, target_names=nombres, output_dict=True, zero_division=0 ) figura, eje = plt.subplots(figsize=(7, 6)) eje.imshow(matriz, cmap="Blues") eje.set_xticks(range(len(nombres)), nombres, rotation=65, ha="right", fontsize=8) eje.set_yticks(range(len(nombres)), nombres, fontsize=8) eje.set(xlabel="Categoría predicha", ylabel="Categoría real", title="Conteos en prueba")for i inrange(len(nombres)):for j inrange(len(nombres)): eje.text(j, i, str(matriz[i, j]), ha="center", va="center", fontsize=7, color="white"if matriz[i, j] > matriz.max() /2else"black") eje.grid(False) figura.tight_layout() plt.show() errores = np.flatnonzero(reales != predichos)[:8] figura, ejes = plt.subplots(2, 4, figsize=(10, 5))for eje, indice inzip(ejes.flat, errores): eje.imshow(imagenes[indice, 0], cmap="gray") eje.set_title(f"Real: {nombres[reales[indice]]}\nPredicción: {nombres[predichos[indice]]}", fontsize=8, )for eje in ejes.flat: eje.axis("off") figura.tight_layout() plt.show()return matriz, pd.DataFrame(reporte).T.loc[nombres + ["macro avg"]]