12  Fundamentos de CNN

Serie Deep Learning · del perceptrón a los transformers.

Una imagen conserva relaciones de vecindad que una capa densa no impone. Construiremos la operación local, verificaremos dimensiones y parámetros, y compararemos una CNN con una MLP sobre Fashion-MNIST. La pregunta final es qué evidencia justifica elegir una arquitectura con el presupuesto observado.

12.1 1. Entorno y protocolo

Usamos PyTorch para las redes, NumPy para cálculos explícitos y scikit-learn para particiones y métricas. El orden de importación evita conflictos entre bibliotecas numéricas en algunos entornos Windows. La caché histórica de datos se lee sin depender de su framework de origen.

Dependencias: PyTorch, torchvision, NumPy, pandas, Matplotlib, scikit-learn y Pillow. Instálelas en el mismo entorno del kernel de Jupyter (python -m pip install torch torchvision numpy pandas matplotlib scikit-learn pillow). La ejecución registrada usa CPU; el código selecciona CUDA cuando está disponible. Los pesos preentrenados y los datos que no estén en caché requieren acceso a sus servidores oficiales.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}

12.1.1 Un contrato de entrenamiento que podemos inspeccionar

nn.Module produce logits de forma (N, K). CrossEntropyLoss recibe esos logits y etiquetas enteras long de forma (N,); aplica internamente el cálculo estable equivalente a log-softmax y entropía cruzada. No añadimos softmax antes de la pérdida ni convertimos las etiquetas a one-hot. Softmax se utiliza al interpretar la predicción.

Cada lote ejecuta zero_grad → forward → backward → step. train() activa dropout y el comportamiento de entrenamiento de BatchNorm; eval() cambia esos comportamientos y inference_mode() evita construir el grafo. Son operaciones distintas. Las curvas train/val se calculan al final de la época, ambas en eval. Se conserva además la pérdida online, que usa pesos cambiantes y dropout: no se debe comparar como si fuera la misma medición.

El checkpoint minimiza exclusivamente la CE de validación, copia parámetros y buffers de state_dict y se restaura antes del informe. La prueba queda fuera de la función de entrenamiento. El tiempo incluye las mediciones de cada época, pero excluye descargas. Una semilla fija reduce variación; no sustituye varias repeticiones ni garantiza identidad entre versiones, dispositivos o frameworks.

Los historiales, contratos y pesos se guardan en artefactos_pytorch/. La recarga reconstruye la arquitectura y comprueba logits sobre validación. El archivo de pesos no incluye una sesión de optimización para reanudar exactamente un entrenamiento.

12.2 2. La imagen como tensor

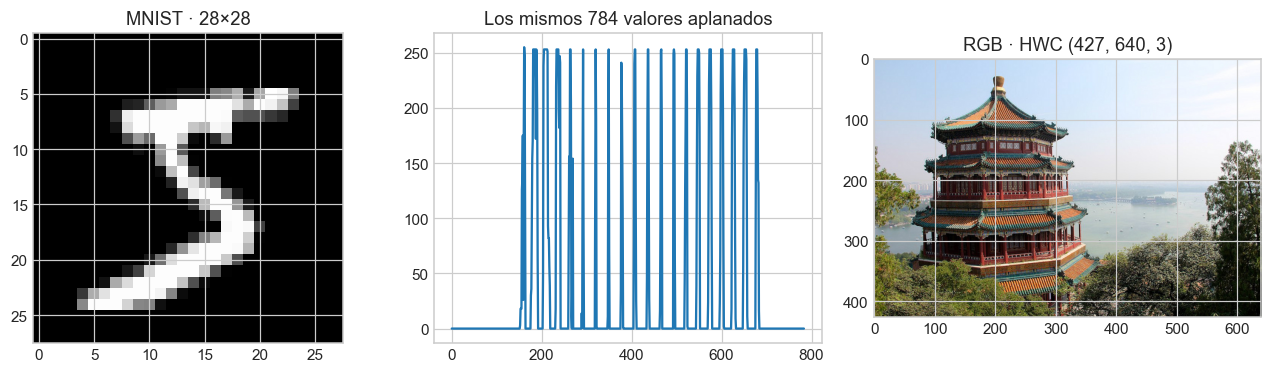
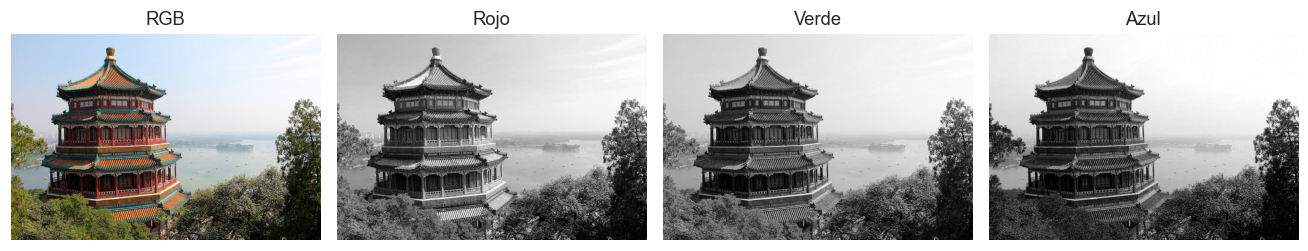
Una imagen en gris tiene alto y ancho; RGB añade tres canales. PyTorch recibe NCHW: número de imágenes, canales, alto y ancho. Un arreglo RGB leído con PIL suele ser HWC: cambiar de orden requiere permute o moveaxis, no un reshape que mezcle posiciones. Aplanar conserva valores y un orden de lectura, pero elimina de la arquitectura la restricción de conectar solamente vecinos.

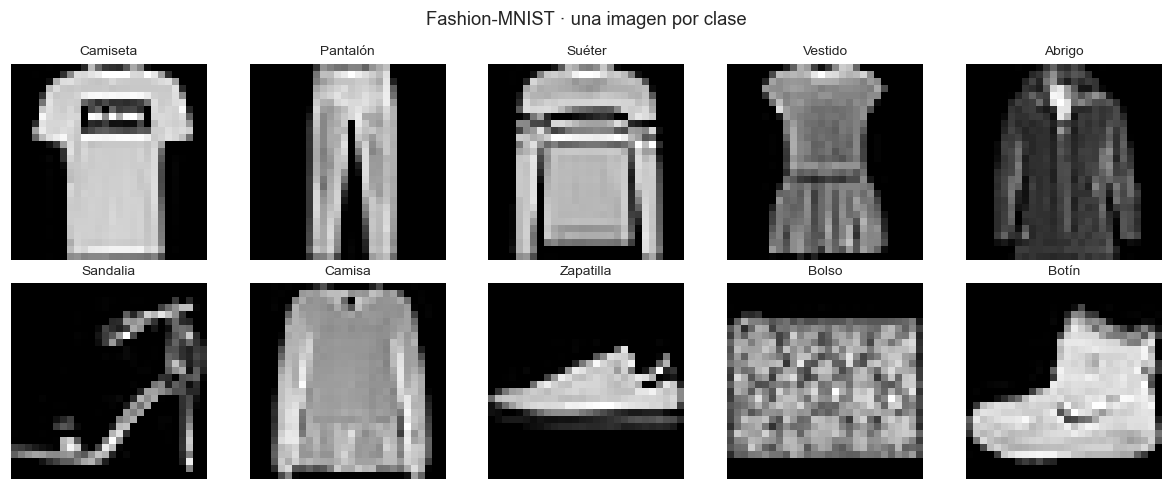
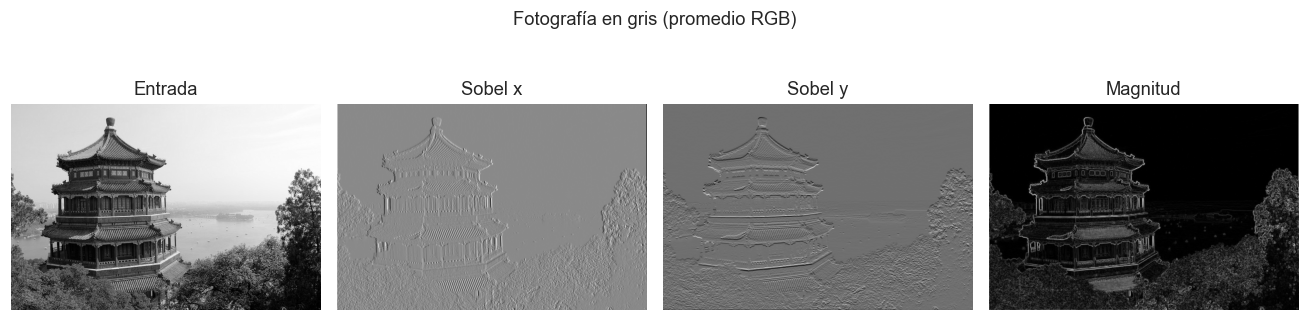
MNIST permite observar trazos; Fashion-MNIST será el experimento de clasificación. Ambos conservan 60 000 imágenes de desarrollo y 10 000 de prueba. La fotografía RGB es una muestra incluida en scikit-learn; no forma parte del entrenamiento.

from sklearn.datasets import load_sample_image
xm,ym,_,_=mnist()
xf,yf,xt,yt=mnist('fashion')
nombres=['Camiseta','Pantalón','Suéter','Vestido','Abrigo','Sandalia','Camisa','Zapatilla','Bolso','Botín']
foto=load_sample_image('china.jpg')
fig,axes=plt.subplots(1,3,figsize=(12,3.5))
axes[0].imshow(xm[0],cmap='gray');axes[0].set_title('MNIST · 28×28')
axes[1].plot(xm[0].ravel());axes[1].set_title('Los mismos 784 valores aplanados')
axes[2].imshow(foto);axes[2].set_title(f'RGB · HWC {foto.shape}')
fig.tight_layout();plt.show()
fig,axes=plt.subplots(1,4,figsize=(12,3))
axes[0].imshow(foto);axes[0].set_title('RGB')
for i,ax in enumerate(axes[1:]): ax.imshow(foto[:,:,i],cmap='gray');ax.set_title(['Rojo','Verde','Azul'][i])
for ax in axes: ax.axis('off')
fig.tight_layout();plt.show()
rgb=torch.from_numpy(foto.copy()).permute(2,0,1).unsqueeze(0).float()/255
print('HWC → NCHW:',foto.shape,'→',tuple(rgb.shape))
galeria(xf,yf,nombres,'Fashion-MNIST · una imagen por clase')

HWC → NCHW: (427, 640, 3) → (1, 3, 427, 640)

12.3 3. Del producto interno a un filtro compartido

En estas bibliotecas se calcula correlación cruzada: el kernel no se invierte. Para un canal, cada salida es la suma de productos entre un parche y el mismo filtro, más un sesgo opcional. La convolución matemática invierte el kernel; el nombre convencional de la capa no debe ocultar esta diferencia. Un filtro escrito a mano expresa una decisión nuestra; un filtro entrenable ajusta sus pesos con gradientes.

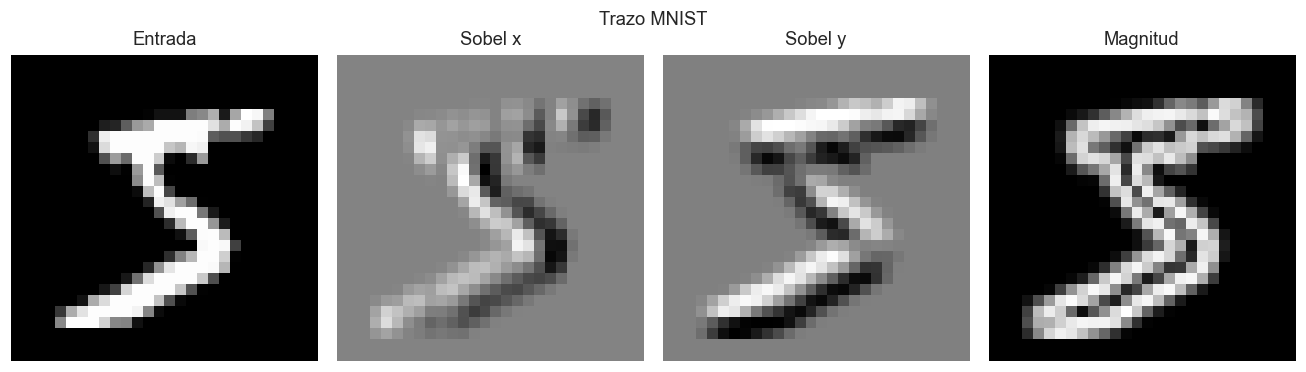
Primero comprobamos una matriz pequeña para poder repetir el cálculo a mano. Después aplicamos Sobel horizontal y vertical. El signo indica orientación de contraste; la magnitud combina ambas respuestas. Una respuesta fuerte señala contraste local, no la presencia demostrada de un objeto.

def correlacion_manual(a,k):
    h,w=a.shape;kh,kw=k.shape
    return np.array([[np.sum(a[i:i+kh,j:j+kw]*k) for j in range(w-kw+1)] for i in range(h-kh+1)],dtype=np.float32)
a=np.arange(1,17,dtype=np.float32).reshape(4,4);k=np.array([[1,0],[0,-1]],dtype=np.float32)
manual=correlacion_manual(a,k)
calculada=F.conv2d(torch.tensor(a)[None,None],torch.tensor(k)[None,None]).squeeze().numpy()
np.testing.assert_allclose(manual,calculada)
print('Entrada:\n',a,'\nKernel:\n',k,'\nSalida:\n',manual)
print('Primera salida: 1×1 + 2×0 + 5×0 + 6×(−1) =',manual[0,0])
def filtrar(imagen,kernel,stride=1,padding=1):
    x=torch.as_tensor(np.asarray(imagen).copy(),dtype=torch.float32)[None,None]
    w=torch.as_tensor(kernel,dtype=torch.float32)[None,None]
    return F.conv2d(x,w,stride=stride,padding=padding)[0,0].numpy()
sx=np.array([[-1,0,1],[-2,0,2],[-1,0,1]],dtype=np.float32);sy=sx.T
gris=foto.mean(2)/255
for imagen,titulo in [(xm[0]/255,'Trazo MNIST'),(gris,'Fotografía en gris (promedio RGB)')]:
    gx=filtrar(imagen,sx);gy=filtrar(imagen,sy)
    fig,axes=plt.subplots(1,4,figsize=(12,3.4))
    for ax,m,t in zip(axes,[imagen,gx,gy,np.hypot(gx,gy)],['Entrada','Sobel x','Sobel y','Magnitud']):
        ax.imshow(m,cmap='gray');ax.set_title(t);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
Entrada:
 [[ 1.  2.  3.  4.]
 [ 5.  6.  7.  8.]
 [ 9. 10. 11. 12.]
 [13. 14. 15. 16.]] 
Kernel:
 [[ 1.  0.]
 [ 0. -1.]] 
Salida:
 [[-5. -5. -5.]
 [-5. -5. -5.]
 [-5. -5. -5.]]
Primera salida: 1×1 + 2×0 + 5×0 + 6×(−1) = -5.0

12.3.1 Patrones controlados y filtros clásicos

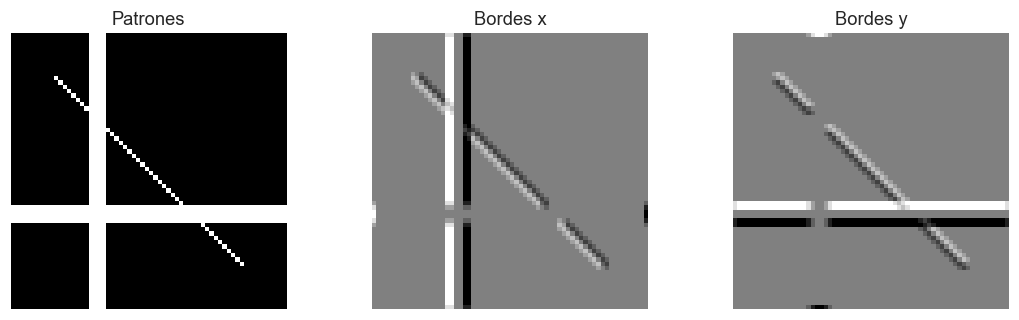
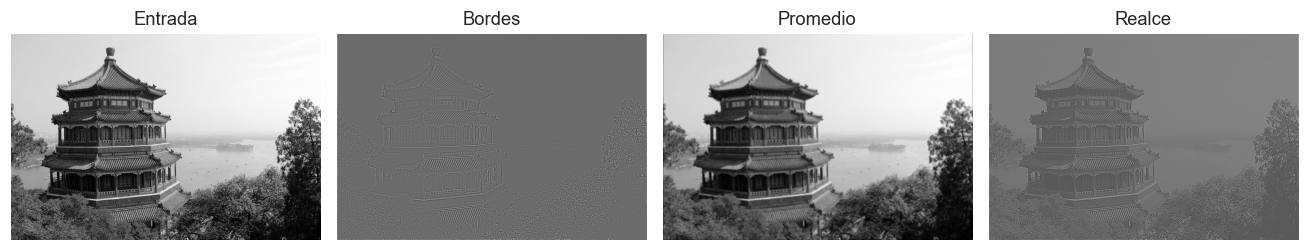
Una imagen sintética separa la orientación del borde de la complejidad del fondo. El desenfoque promedia vecinos y puede eliminar ruido junto con detalles útiles; el realce aumenta contrastes y también puede amplificar ruido. El promedio RGB de esta demostración no es una conversión fotométrica de luminancia.

sintetica=np.zeros((64,64),dtype=np.float32);sintetica[:,18:22]=1;sintetica[40:44,:]=1
for i in range(10,54): sintetica[i,i]=1
fig,axes=plt.subplots(1,3,figsize=(10,3))
for ax,m,t in zip(axes,[sintetica,filtrar(sintetica,sx),filtrar(sintetica,sy)],['Patrones','Bordes x','Bordes y']):
    ax.imshow(m,cmap='gray');ax.set_title(t);ax.axis('off')
fig.tight_layout();plt.show()
kernels={'Bordes':np.array([[-1,-1,-1],[-1,8,-1],[-1,-1,-1]]),
         'Promedio':np.ones((3,3))/9,'Realce':np.array([[0,-1,0],[-1,5,-1],[0,-1,0]])}
fig,axes=plt.subplots(1,4,figsize=(12,3.4));axes[0].imshow(gris,cmap='gray');axes[0].set_title('Entrada')
for ax,(t,w) in zip(axes[1:],kernels.items()): ax.imshow(filtrar(gris,w),cmap='gray');ax.set_title(t)
for ax in axes: ax.axis('off')
fig.tight_layout();plt.show()

12.4 4. Dimensiones, stride y pooling

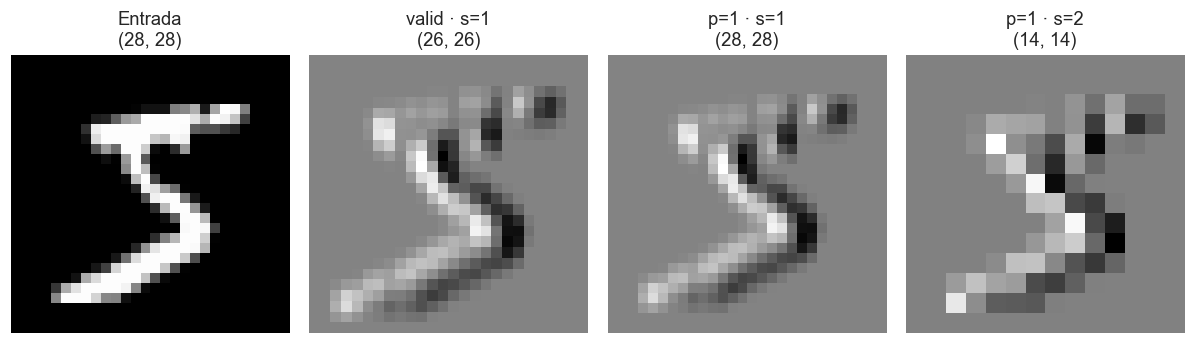
Para cada eje espacial, con dilatación \(d\), kernel \(k\), padding simétrico \(p\) y stride \(s\):

\[H_{out}=\left\lfloor\frac{H_{in}+2p-d(k-1)-1}{s}+1\right\rfloor.\]

Con \(k=3,d=1,s=1\), padding=1 conserva el tamaño. Con stride 2 lo reduce aproximadamente a la mitad. Especificamos padding entero: padding="same" de PyTorch no admite stride mayor que uno. No confundamos obtener el mismo tamaño con aplicar los mismos píxeles de padding que otra biblioteca: SAME puede repartirlos asimétricamente.

Max-pooling conserva el máximo local; average-pooling conserva el promedio. No aprenden pesos. Ambos descartan información y pueden perder trazos pequeños; no garantizan invariancia completa a traslaciones.

img=xm[0].astype(np.float32)/255
fig,axes=plt.subplots(1,4,figsize=(11,3))
casos=[('Entrada',img),('valid · s=1',filtrar(img,sx,1,0)),('p=1 · s=1',filtrar(img,sx,1,1)),('p=1 · s=2',filtrar(img,sx,2,1))]
for ax,(t,m) in zip(axes,casos): ax.imshow(m,cmap='gray');ax.set_title(f'{t}\n{m.shape}');ax.axis('off')
fig.tight_layout();plt.show()
v=torch.tensor([[1.,2,0,4],[3,1,2,0],[0,5,1,2],[2,1,3,4]])[None,None]
mx=F.max_pool2d(v,2);av=F.avg_pool2d(v,2)
torch.testing.assert_close(mx,torch.tensor([[[[3.,4],[5,4]]]]))
torch.testing.assert_close(av,torch.tensor([[[[1.75,1.5],[2,2.5]]]]))
print('Entrada pooling:\n',v[0,0].numpy(),'\nMáximo:\n',mx[0,0].numpy(),'\nPromedio:\n',av[0,0].numpy())
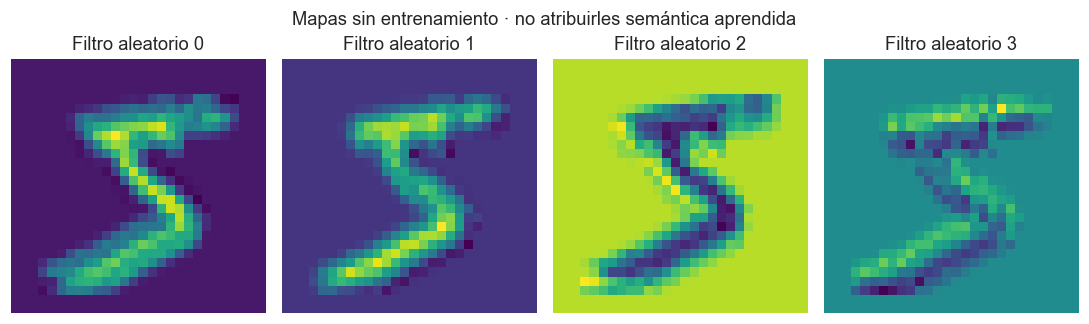
semilla();conv=nn.Conv2d(1,4,3,padding=1)
with torch.inference_mode(): mapas=conv(torch.tensor(img)[None,None])[0].numpy()
fig,axes=plt.subplots(1,4,figsize=(10,3))
for i,ax in enumerate(axes): ax.imshow(mapas[i],cmap='viridis');ax.set_title(f'Filtro aleatorio {i}');ax.axis('off')
fig.suptitle('Mapas sin entrenamiento · no atribuirles semántica aprendida');fig.tight_layout();plt.show()
Entrada pooling:
 [[1. 2. 0. 4.]
 [3. 1. 2. 0.]
 [0. 5. 1. 2.]
 [2. 1. 3. 4.]] 
Máximo:
 [[3. 4.]
 [5. 4.]] 
Promedio:
 [[1.75 1.5 ]
 [2.   2.5 ]]

12.5 5. Una CNN mínima que podemos contar

Una convolución con sesgo tiene \((k_h k_w C_{in}+1)C_{out}\) parámetros; una capa lineal tiene \((D_{in}+1)D_{out}\). El número de parámetros de la convolución no depende de H y W, pero su coste de cómputo sí. Tras aplanar, las dimensiones espaciales afectan al tamaño de la capa densa. Por eso compartir pesos no basta para afirmar que cualquier CNN es pequeña.

minima=nn.Sequential(nn.Conv2d(1,8,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Flatten(),nn.Linear(8*14*14,32),nn.ReLU(),nn.Linear(32,10))
esperados=(3*3*1+1)*8+(8*14*14+1)*32+(32+1)*10
assert parametros(minima)==esperados
z=torch.zeros(2,1,28,28);filas=[]
for capa in minima:
    z=capa(z);filas.append({'capa':type(capa).__name__,'salida':str(tuple(z.shape)),'parametros':parametros(capa)})
display(pd.DataFrame(filas));print('Total calculado y verificado:',esperados)
capa salida parametros
0 Conv2d (2, 8, 28, 28) 80
1 ReLU (2, 8, 28, 28) 0
2 MaxPool2d (2, 8, 14, 14) 0
3 Flatten (2, 1568) 0
4 Linear (2, 32) 50208
5 ReLU (2, 32) 0
6 Linear (2, 10) 330
Total calculado y verificado: 50618

12.6 6. Comparación MLP–CNN en Fashion-MNIST

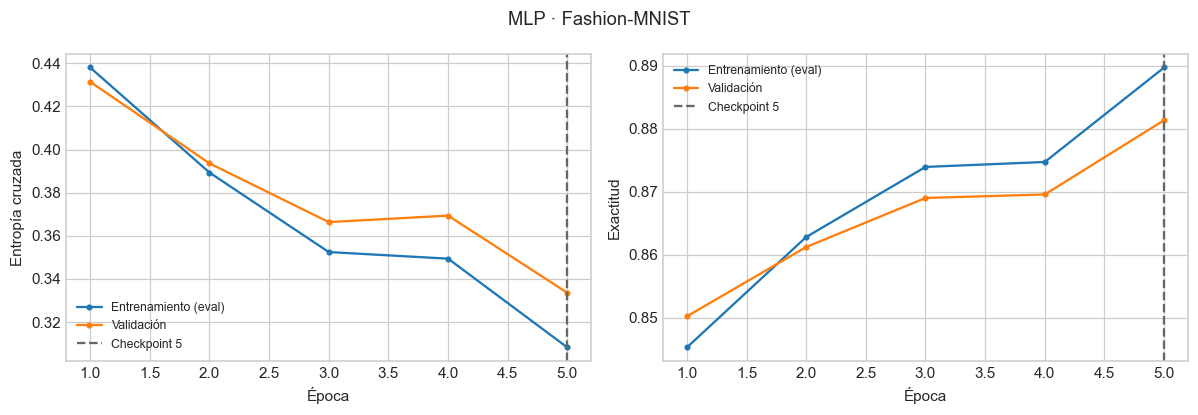
Conservamos las 60 000 imágenes originales, reservamos 15 % estratificado para validación (semilla 42) y mantenemos intactas las 10 000 de prueba. Ambas redes reciben píxeles en [0,1], cinco épocas, lotes de 128 y Adam con tasa 0,001. Se selecciona cada checkpoint con validación. No se pretende aislar solamente el framework: la inicialización y el checkpoint se explicitan y pueden cambiar los resultados históricos.

La MLP usa 128 unidades ocultas. La CNN usa filtros 16 y 32, pooling tras cada bloque y una capa de 64 unidades. Las dos producen diez logits. La comparación evalúa estas configuraciones, no toda la familia de redes densas frente a toda la familia de CNN.

indices=np.arange(len(xf));itr,iva=train_test_split(indices,test_size=.15,random_state=SEED,stratify=yf)
x=xf[:,None].astype(np.float32)/255;test_x=xt[:,None].astype(np.float32)/255
train=conjunto(x[itr],yf[itr]);val=conjunto(x[iva],yf[iva]);test=conjunto(test_x,yt)
np.savez_compressed(ARTEFACTOS/'particiones.npz',train=itr,val=iva,test=np.arange(len(xt)))
def crear_mlp(): return nn.Sequential(nn.Flatten(),nn.Linear(784,128),nn.ReLU(),nn.Linear(128,10))
def crear_cnn(): return nn.Sequential(nn.Conv2d(1,16,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Conv2d(16,32,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Flatten(),nn.Linear(32*7*7,64),nn.ReLU(),nn.Linear(64,10))
modelos={};historias={};resumenes={}
for nombre,fabrica in [('mlp',crear_mlp),('cnn',crear_cnn)]:
    semilla();m=inicializar(fabrica());h,r=entrenar(m,train,val,5,nombre=nombre)
    modelos[nombre]=m;historias[nombre]=h;resumenes[nombre]=r
    curvas(h,nombre.upper()+' · Fashion-MNIST',r['mejor_epoca']);lectura(h,r)
mlp 1/5: CE val=0.4314, acc val=0.8502
mlp 2/5: CE val=0.3936, acc val=0.8612
mlp 3/5: CE val=0.3663, acc val=0.8690
mlp 4/5: CE val=0.3693, acc val=0.8696
mlp 5/5: CE val=0.3335, acc val=0.8813

Lectura del experimento. Se ejecutaron 5 épocas; el checkpoint seleccionado por CE de validación corresponde a la época 5, con CE 0.3335. Al cierre, la brecha de exactitud train−val es +0.84 puntos porcentuales. Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.

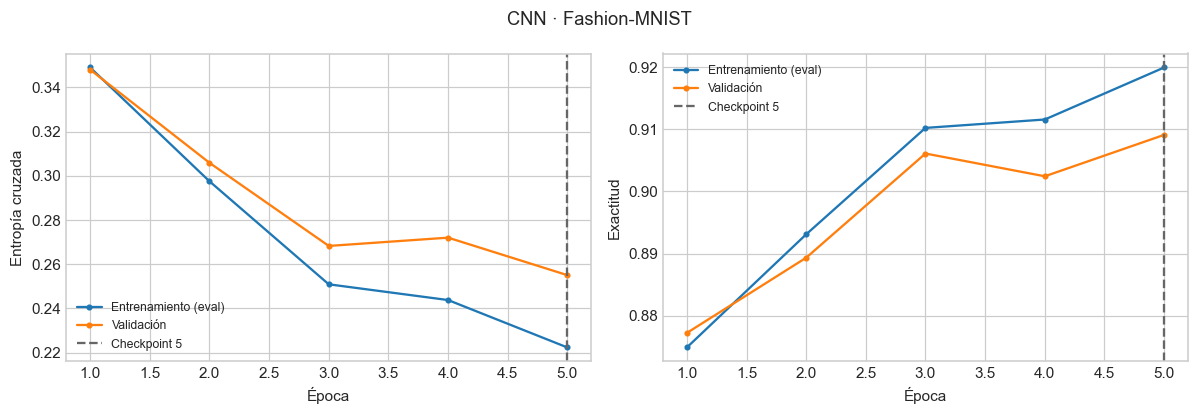
cnn 1/5: CE val=0.3480, acc val=0.8772
cnn 2/5: CE val=0.3059, acc val=0.8893
cnn 3/5: CE val=0.2683, acc val=0.9061
cnn 4/5: CE val=0.2720, acc val=0.9024
cnn 5/5: CE val=0.2551, acc val=0.9091

Lectura del experimento. Se ejecutaron 5 épocas; el checkpoint seleccionado por CE de validación corresponde a la época 5, con CE 0.2551. Al cierre, la brecha de exactitud train−val es +1.08 puntos porcentuales. Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.

12.7 7. Métricas, errores y decisión

Se cierra la selección antes de evaluar prueba. La CE usa toda la distribución; la exactitud mira el argmax. Pueden moverse en direcciones distintas si cambian las probabilidades de los ejemplos difíciles. El tiempo depende del equipo y de las evaluaciones incluidas. Para decidir, contrastamos desempeño, tamaño y coste, y después miramos dónde falla la CNN.

filas=[];resultados={}
for nombre,m in modelos.items():
    rr=evaluar(m,test);resultados[nombre]=rr
    filas.append({**resumenes[nombre],'ce_test':rr['ce'],'acc_test':rr['exactitud'],'macro_f1_test':f1_score(rr['y'],rr['logits'].argmax(1),average='macro')})
tabla=pd.DataFrame(filas);display(tabla);tabla.to_csv(ARTEFACTOS/'comparacion.csv',index=False)
delta=100*(resultados['cnn']['exactitud']-resultados['mlp']['exactitud'])
display(Markdown(f'**Resultado observado.** CNN−MLP = {delta:+.2f} puntos de exactitud en prueba. Evalúe esa diferencia junto con parámetros y segundos; una sola partición y semilla no permiten declarar una ventaja universal. La elección para otro dominio requiere una evaluación nueva.'))
diagnostico(resultados['cnn'],nombres,test_x,'CNN · Fashion-MNIST')
modelo mejor_epoca epocas ce_val segundos parametros entrenables ce_test acc_test macro_f1_test
0 mlp 5 5 0.333487 11.204496 101770 101770 0.371648 0.8702 0.867178
1 cnn 5 5 0.255055 109.941806 105866 105866 0.283189 0.8974 0.896593

Resultado observado. CNN−MLP = +2.72 puntos de exactitud en prueba. Evalúe esa diferencia junto con parámetros y segundos; una sola partición y semilla no permiten declarar una ventaja universal. La elección para otro dominio requiere una evaluación nueva.

              precision    recall  f1-score   support

    Camiseta     0.8719    0.8370    0.8541      1000
    Pantalón     0.9801    0.9860    0.9831      1000
      Suéter     0.7996    0.8780    0.8370      1000
     Vestido     0.8506    0.9450    0.8953      1000
      Abrigo     0.8937    0.7400    0.8096      1000
    Sandalia     0.9807    0.9630    0.9717      1000
      Camisa     0.7451    0.7280    0.7365      1000
   Zapatilla     0.9450    0.9450    0.9450      1000
       Bolso     0.9675    0.9830    0.9752      1000
       Botín     0.9481    0.9690    0.9585      1000

    accuracy                         0.8974     10000
   macro avg     0.8982    0.8974    0.8966     10000
weighted avg     0.8982    0.8974    0.8966     10000

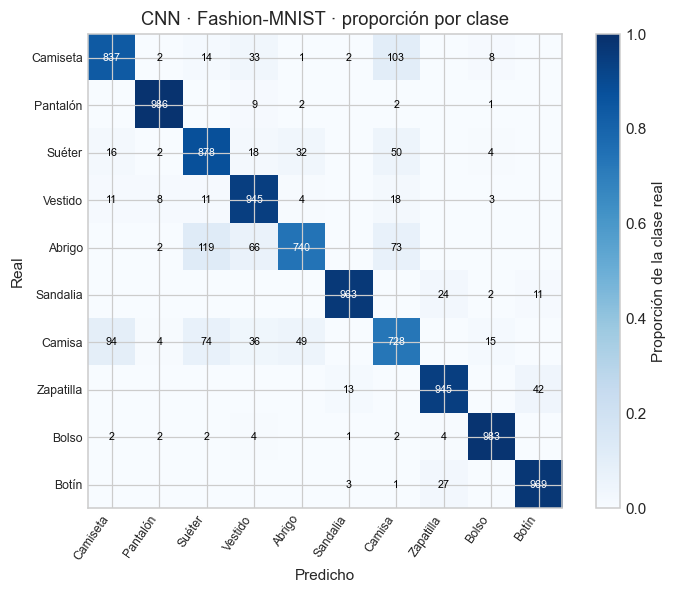
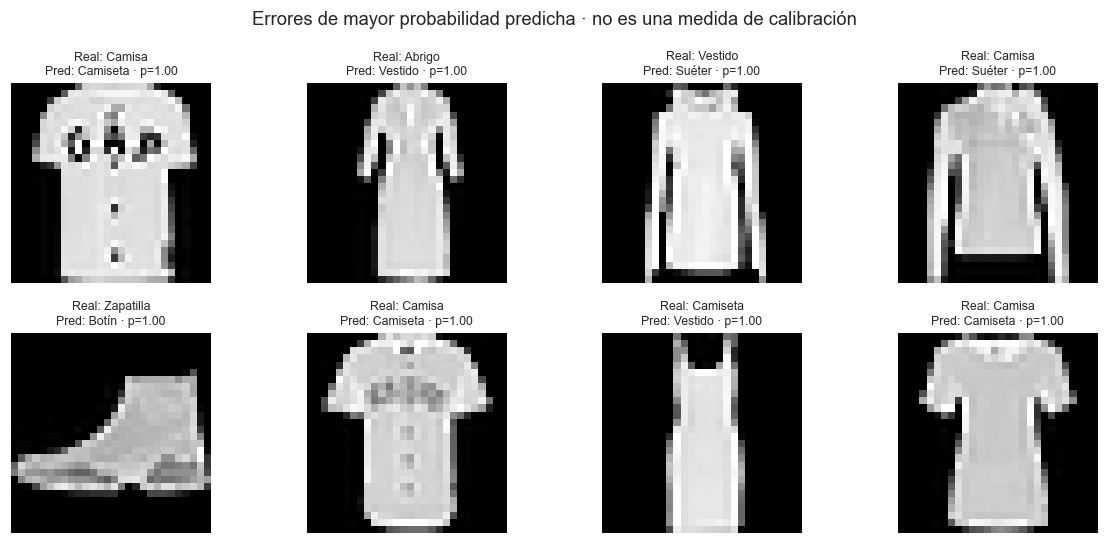
Decisión después de medir. Exactitud 89.74%; macro-F1 0.8966; 1026 errores de 10000. El menor recall corresponde a Camisa (72.80%). La confusión más frecuente es Abrigo → Suéter (119 casos). Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test.

array([[837,   2,  14,  33,   1,   2, 103,   0,   8,   0],
       [  0, 986,   0,   9,   2,   0,   2,   0,   1,   0],
       [ 16,   2, 878,  18,  32,   0,  50,   0,   4,   0],
       [ 11,   8,  11, 945,   4,   0,  18,   0,   3,   0],
       [  0,   2, 119,  66, 740,   0,  73,   0,   0,   0],
       [  0,   0,   0,   0,   0, 963,   0,  24,   2,  11],
       [ 94,   4,  74,  36,  49,   0, 728,   0,  15,   0],
       [  0,   0,   0,   0,   0,  13,   0, 945,   0,  42],
       [  2,   2,   2,   4,   0,   1,   2,   4, 983,   0],
       [  0,   0,   0,   0,   0,   3,   1,  27,   0, 969]])

12.8 8. Qué muestran las activaciones

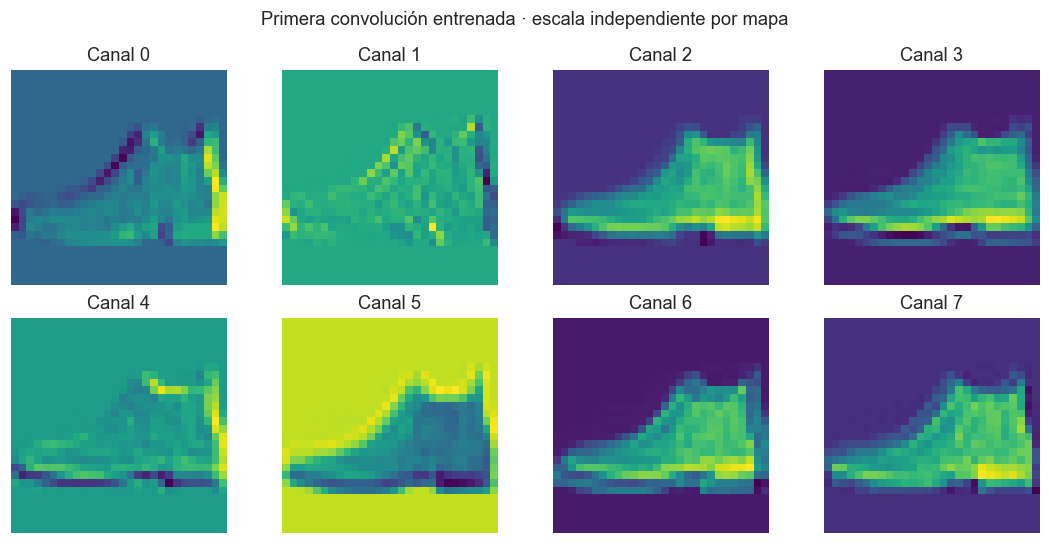
Inspeccionamos la primera convolución del checkpoint entrenado, antes de ReLU. Una escala por mapa permite ver estructura, pero no comparar amplitudes entre filtros. Estos mapas muestran respuesta local; no prueban una explicación causal de la predicción. Para contrastar sensibilidad habría que intervenir la entrada y medir el efecto con un protocolo definido.

cnn=modelos['cnn'];cnn.eval()
with torch.inference_mode(): mapas=cnn[0](test.tensors[0][:1].to(DEVICE))[0].cpu().numpy()
fig,axes=plt.subplots(2,4,figsize=(10,5))
for i,ax in enumerate(axes.flat): ax.imshow(mapas[i],cmap='viridis');ax.set_title(f'Canal {i}');ax.axis('off')
fig.suptitle('Primera convolución entrenada · escala independiente por mapa');fig.tight_layout();plt.show()
recargada=guardar(cnn,crear_cnn,'cnn-fashion',{'entrada':'NCHW float32','forma':[1,28,28],'escala':'uint8 / 255','clases':nombres,'seleccion':'min CE validacion'},val)

Recarga verificada: artefactos_pytorch\cnn-fashion.pt bytes: 427205

12.8.1 Lectura de la ejecución registrada

La CNN obtuvo 89.74% y la MLP 87.02%: diferencia de +2.72 puntos porcentuales en prueba. La CNN usa 1.04 veces los parámetros y el ajuste medido tomó 9.8 veces el tiempo. La diferencia de coste no se explica sólo por el tamaño de los pesos: la convolución reutiliza filtros en muchas posiciones. Esto motiva estudiar el compromiso entre error y cómputo con presupuestos prefijados, sin volver a escoger hiperparámetros sobre este test.

Cifras de la ejecución CPU del 15 de octubre de 2026; si cambia datos, versión o semilla, vuelva a contrastar esta lectura con las nuevas salidas.

12.9 9. Ejercicios y continuidad

  1. Calcule la salida con kernel 5 y stride 2 antes de ejecutarla; compruebe qué borde se descarta.
  2. Sustituya max-pooling por promedio y compare validación manteniendo el resto fijo.
  3. Cambie la capa densa por global average pooling y estime primero los parámetros.
  4. Para una comparación formal, repita con semillas prefijadas y resuma dispersión, sin escoger la mejor con prueba.

El capítulo 13 desarrolla el ciclo de clasificación, persistencia e inferencia. El 14 compara estructuras y el 15 estudia el uso de pesos preentrenados.

12.10 Referencias