19  Redes recurrentes

Serie Deep Learning · del perceptrón a los transformers.

Una RNN comparte una regla de actualización y un estado a lo largo de la secuencia. Estudiaremos demanda, un sensor y polaridad de reseñas. El valor no está en obtener un único accuracy: cada dominio exige unidades, baseline y lectura de errores distintos.

19.1 1. Entorno y reproducibilidad

Se requieren PyTorch, NumPy, pandas, Matplotlib y scikit-learn. La ejecución registrada usa CPU. Se conservan los experimentos y presupuestos docentes; los cambios necesarios de escala y protocolo se declaran, sin atribuir sus efectos sólo al framework.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}

19.1.1 Contrato recurrente

La forma es (N,L,F) con batch_first=True; los estados siguen (capas,N,H). Cada ventana comienza con estado cero y no hereda información de otras muestras. En LSTM se distinguen estado oculto y celda. La salida final es lineal para regresión o un logit para BCE estable; sigmoid sólo interviene en inferencia binaria.

Inicializamos matrices de entrada con Xavier y cada bloque recurrente ortogonalmente; en LSTM fijamos el sesgo efectivo de olvido en +1, sin duplicarlo entre los dos sesgos de PyTorch. El conteo de parámetros incluye ambos. La variante GRU de PyTorch aplica la puerta reset en una posición algebraica distinta de algunas implementaciones: no se promete equivalencia de pesos o resultados con otra biblioteca.

Adam usa tasa 0,001. Guardamos y restauramos el mínimo de pérdida de validación, calculando train/val en eval al cierre de cada época. La prueba queda fuera del ajuste. Los artefactos se recargan y contrastan sobre validación. Son archivos de inferencia, no una sesión completa de optimización reanudable. Una semilla y un presupuesto corto no permiten declarar superioridad universal.

Código
class Secuencia(nn.Module):
    def __init__(self,tipo='RNN',entrada=1,ocultas=16,vocabulario=None):
        super().__init__();self.tipo=tipo
        self.embedding=nn.Embedding(vocabulario,32) if vocabulario is not None else None
        self.recurrente={'RNN':nn.RNN,'LSTM':nn.LSTM,'GRU':nn.GRU}[tipo](32 if self.embedding is not None else entrada,ocultas,batch_first=True)
        self.salida=nn.Linear(ocultas,1)
        # Inicialización explícita: Xavier de entrada; ortogonal por puerta recurrente.
        puertas={'RNN':1,'LSTM':4,'GRU':3}[tipo]
        for nombre,p in self.recurrente.named_parameters():
            if 'weight_ih' in nombre: nn.init.xavier_uniform_(p)
            elif 'weight_hh' in nombre:
                for bloque in p.chunk(puertas,0): nn.init.orthogonal_(bloque)
            else: nn.init.zeros_(p)
        # Orden LSTM i,f,g,o. Sólo un sesgo de olvido recibe +1; no sumarlo dos veces.
        if tipo=='LSTM':
            with torch.no_grad(): self.recurrente.bias_ih_l0[ocultas:2*ocultas].fill_(1)
        nn.init.xavier_uniform_(self.salida.weight);nn.init.zeros_(self.salida.bias)
        if self.embedding is not None: nn.init.uniform_(self.embedding.weight,-.05,.05)
    def forward(self,x):
        if self.embedding is not None: x=self.embedding(x.long())
        _,estado=self.recurrente(x)
        h=estado[0] if self.tipo=='LSTM' else estado
        return self.salida(h[-1]).squeeze(-1)

def datos(x,y,tokens=False):
    return TensorDataset(torch.as_tensor(x,dtype=torch.long if tokens else torch.float32),torch.as_tensor(y,dtype=torch.float32))

@torch.inference_mode()
def medir(m,ds,tipo='regresion'):
    m.eval();zs=[];ys=[];suma=0.
    for x,y in cargador(ds,64):
        x=x.to(DEVICE);y=y.to(DEVICE);z=m(x)
        loss=F.mse_loss(z,y,reduction='sum') if tipo=='regresion' else F.binary_cross_entropy_with_logits(z,y,reduction='sum')
        suma+=loss.item();zs.append(z.cpu().numpy());ys.append(y.cpu().numpy())
    z=np.concatenate(zs);y=np.concatenate(ys);assert np.isfinite(z).all()
    r={'loss':suma/len(ds),'z':z,'y':y}
    if tipo!='regresion':
        p=torch.from_numpy(z).sigmoid().numpy();r.update(p=p,acc=float(((p>=.5)==y).mean()))
    return r

def ajustar(m,tr,va,nombre,epocas,lote=32,tipo='regresion',lr=.001,clip=None):
    m=m.to(DEVICE);opt=torch.optim.Adam(m.parameters(),lr=lr);dl=cargador(tr,lote,True)
    h=[];mejor=float('inf');inicio=time.perf_counter()
    for ep in range(1,epocas+1):
        m.train();normas=[];recortados=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE);opt.zero_grad(set_to_none=True);z=m(x)
            loss=F.mse_loss(z,y) if tipo=='regresion' else F.binary_cross_entropy_with_logits(z,y)
            if not torch.isfinite(loss): raise FloatingPointError(nombre+' pérdida no finita')
            loss.backward()
            if clip is not None:
                norma=float(nn.utils.clip_grad_norm_(m.parameters(),clip));normas.append(norma);recortados+=norma>clip
            opt.step()
        a=medir(m,tr,tipo);b=medir(m,va,tipo)
        fila={'epoca':ep,'loss_train':a['loss'],'loss_val':b['loss']}
        if tipo!='regresion':fila.update(acc_train=a['acc'],acc_val=b['acc'])
        if clip is not None:fila.update(norma_media=float(np.mean(normas)),fraccion_clipping=recortados/len(dl))
        h.append(fila)
        if b['loss']<mejor:mejor=b['loss'];pesos=copy.deepcopy(m.state_dict());mejor_ep=ep
        print(nombre,ep,'val',round(b['loss'],5),flush=True)
    m.load_state_dict(pesos);m.eval();h=pd.DataFrame(h);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    r={'modelo':nombre,'mejor_epoca':mejor_ep,'min_val_loss':mejor,'parametros':parametros(m),'epocas':epocas,'segundos':time.perf_counter()-inicio}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(r,indent=2),encoding='utf-8')
    return m,h,r

def graficar(h,r,titulo,binario=False):
    fig,axes=plt.subplots(1,2 if binario else 1,figsize=(11,3.5) if binario else (7,3.5));axes=np.atleast_1d(axes)
    axes[0].plot(h.epoca,h.loss_train,label='Train (eval)');axes[0].plot(h.epoca,h.loss_val,label='Val')
    axes[0].axvline(r['mejor_epoca'],ls='--',color='.4');axes[0].set(xlabel='Época',ylabel='BCE' if binario else 'MSE');axes[0].legend()
    if binario:
        axes[1].plot(h.epoca,h.acc_train,label='Train (eval)');axes[1].plot(h.epoca,h.acc_val,label='Val');axes[1].set(xlabel='Época',ylabel='Exactitud');axes[1].legend()
    fig.suptitle(titulo);fig.tight_layout();plt.show()
    display(Markdown(f"**Checkpoint:** época {r['mejor_epoca']} de {len(h)}, mínimo de validación {r['min_val_loss']:.5f}. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización."))

def salvar(m,fabrica,nombre,contrato,ds):
    p=ARTEFACTOS/f'{nombre}.pt';torch.save({'state_dict':{k:v.detach().cpu().clone() for k,v in m.state_dict().items()},'contrato':contrato},p)
    nuevo=fabrica().to(DEVICE);nuevo.load_state_dict(torch.load(p,map_location=DEVICE,weights_only=True)['state_dict']);nuevo.eval();m.eval()
    x=ds.tensors[0][:32].to(DEVICE)
    with torch.inference_mode():torch.testing.assert_close(m(x),nuevo(x),rtol=1e-5,atol=1e-6)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(dict(contrato,sha256=hashlib.sha256(p.read_bytes()).hexdigest()),indent=2),encoding='utf-8')
    print('Recarga comprobada:',nombre)

def ventana(serie,L):
    indices=np.arange(L,len(serie));x=np.array([serie[i-L:i] for i in indices],dtype=np.float32)[...,None]
    return x,np.asarray(serie[L:],dtype=np.float32),indices

def resumen_regresion(real,pred,base,nombre):
    filas=[]
    for etiqueta,p in [(nombre,pred),('Persistencia',base)]:
        filas.append({'modelo':etiqueta,'rmse':float(np.sqrt(np.mean((real-p)**2))),'mae':float(np.mean(np.abs(real-p))),'sesgo_real_menos_pred':float(np.mean(real-p))})
    t=pd.DataFrame(filas);display(t)
    display(Markdown(f"**Comparación observada:** RMSE de {nombre} {t.iloc[0].rmse:.4f}, persistencia {t.iloc[1].rmse:.4f}. Diferencia persistencia−red = {t.iloc[1].rmse-t.iloc[0].rmse:+.4f}. El signo describe este ensayo; no establece que una red recurrente sea necesaria para esta serie."))
    return t

19.1.2 Por qué una fila aislada no representa una secuencia

Supongamos que dos sensores marcan hoy 5 °C. Uno viene de 1, 2 y 3 °C; el otro de 9, 8 y 7 °C. La misma lectura actual puede acompañar tendencias opuestas. Una regla que solo recibe el último valor no puede distinguirlas; una ventana o un estado sí puede conservar información adicional. Tener esa información no garantiza que la red aprenda a utilizarla.

Una RNN aplica una celda repetidamente. En cada paso recibe la observación nueva \(x_t\) y el resumen anterior \(h_{t-1}\); produce \(h_t\). Los pesos se comparten entre pasos: una secuencia de cien lecturas no crea cien matrices independientes. Esa reutilización permite procesar distintas longitudes, aunque la capacidad del estado y la dificultad de optimización sigan siendo limitadas.

En una tarea muchos a uno, como clasificar una reseña, la salida utiliza el estado final o una agregación. En uno a uno por instante, cada estado puede producir una salida. En pronóstico con ventanas, cada muestra contiene un pasado y un objetivo definido respecto de ese pasado. Estas tareas comparten la celda, pero no la pérdida, la alineación ni la información disponible.

El estado oculto no es una temperatura ni una etiqueta. Es una representación aprendida. Sus coordenadas solo adquieren utilidad dentro del predictor. Reiniciarlo entre muestras trata cada ventana como un caso independiente; transportarlo a la ventana siguiente cambia el procedimiento y exige controlar orden, fronteras de serie y separación de particiones.

19.2 2. Estado oculto y BPTT

\[h_t=\tanh(W_{ih}x_t+b_{ih}+W_{hh}h_{t-1}+b_{hh}).\]

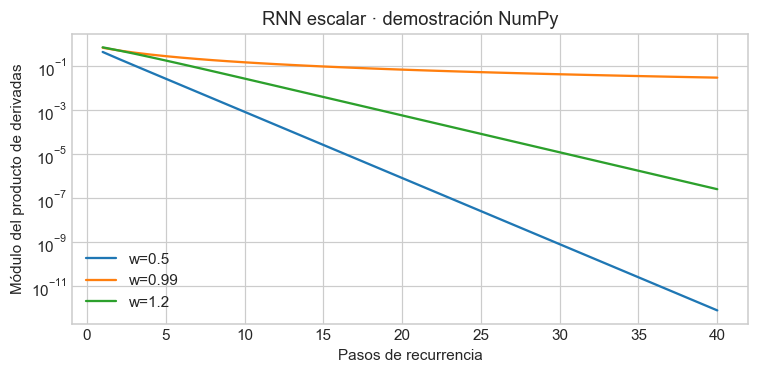
La memoria es una representación de tamaño fijo, no una copia del pasado. El gradiente a través del tiempo contiene productos de jacobianos; las derivadas de tanh también importan. Un peso mayor que uno no demuestra explosión en todo régimen: la saturación puede reducir su derivada. La figura escalar siguiente aísla ese mecanismo, no mide una red entrenada.

def producto(w,pasos,h=.6):
    acumulado=1.;valores=[]
    for _ in range(pasos): h=np.tanh(w*h);acumulado*=w*(1-h*h);valores.append(acumulado)
    return np.array(valores)
fig,ax=plt.subplots(figsize=(7,3.5))
for w in [.5,.99,1.2]:ax.semilogy(np.arange(1,41),np.abs(producto(w,40))+1e-15,label=f'w={w}')
ax.set(xlabel='Pasos de recurrencia',ylabel='Módulo del producto de derivadas',title='RNN escalar · demostración NumPy');ax.legend();fig.tight_layout();plt.show()
# Comprobar el primer paso con la derivada analítica.
np.testing.assert_allclose(producto(.5,1)[0],.5*(1-np.tanh(.5*.6)**2))

19.2.1 Desplegar tres pasos antes de usar una capa recurrente

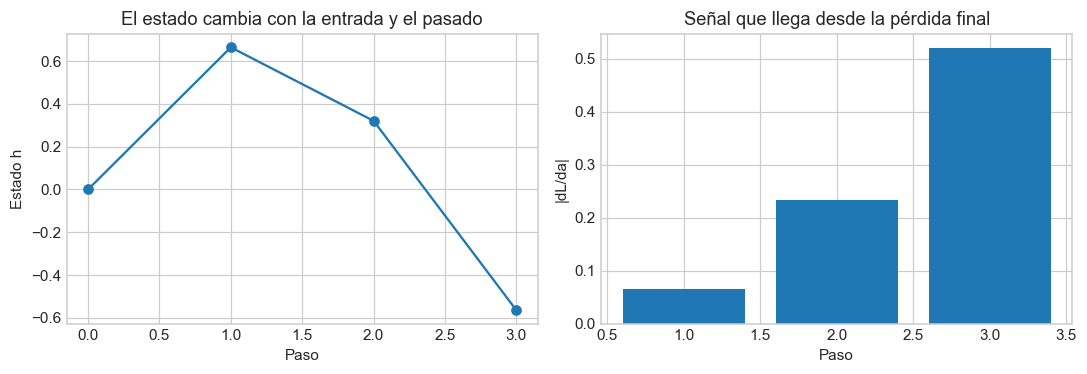
Tomemos una celda escalar \(a_t=u x_t+w h_{t-1}\), \(h_t=\tanh(a_t)\), con \(h_0=0\), \(u=0,8\), \(w=0,5\) y entradas \([1,0,-1]\). En el primer paso, \(a_1=0,8\) y \(h_1\approx0,664\). El segundo no recibe señal nueva, pero conserva parte del pasado: \(a_2\approx0,332\), \(h_2\approx0,320\). En el tercero compiten la entrada negativa y la memoria positiva: \(a_3\approx-0,640\), \(h_3\approx-0,565\).

La secuencia inversa contiene los mismos números y, sin embargo, cambia el estado final. La celda no calcula una media conmutativa. El parámetro \(w\) regula la interacción con el pasado, pero tanh también interviene: no podemos describir la memoria multiplicando únicamente potencias de \(w\).

Para un objetivo final \(y=0,2\) usamos \(L=\tfrac12(h_3-y)^2\). Definimos \(\delta_t=\partial L/\partial a_t\). La regla de la cadena da:

\[\delta_3=(h_3-y)(1-h_3^2),\qquad \delta_t=w\delta_{t+1}(1-h_t^2).\]

Como la misma matriz se utiliza en todos los pasos, sus contribuciones se suman:

\[\frac{\partial L}{\partial u}=\sum_t\delta_t x_t,\qquad \frac{\partial L}{\partial w}=\sum_t\delta_t h_{t-1}.\]

No son tres redes entrenadas por separado. BPTT recorre hacia atrás el grafo desplegado y acumula esas contribuciones en dos parámetros compartidos. La tabla siguiente contrasta la cuenta manual con autograd; no entrena un predictor ni incorpora datos de prueba.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_rnn_desplegada():
    x=np.array([1.,0.,-1.]);u=.8;w=.5;y=.2;h=[0.];a=[]
    for v in x:
        a.append(u*v+w*h[-1]);h.append(np.tanh(a[-1]))
    delta=np.zeros(3);delta[-1]=(h[-1]-y)*(1-h[-1]**2)
    for t in [1,0]:delta[t]=w*delta[t+1]*(1-h[t+1]**2)
    gu=float(delta@x);gw=float(delta@np.array(h[:-1]))
    ut=torch.tensor(u,dtype=torch.float64,requires_grad=True);wt=torch.tensor(w,dtype=torch.float64,requires_grad=True);ht=torch.tensor(0.,dtype=torch.float64)
    for v in x:ht=torch.tanh(ut*float(v)+wt*ht)
    loss=.5*(ht-y)**2;loss.backward()
    np.testing.assert_allclose([gu,gw],[ut.grad.item(),wt.grad.item()],atol=1e-12)
    display(pd.DataFrame({'paso':[1,2,3],'entrada':x,'preactivacion':a,'estado':h[1:],'delta':delta,'aporte_grad_u':delta*x,'aporte_grad_w':delta*np.array(h[:-1])}))
    print({'perdida':loss.item(),'grad_u':gu,'grad_w':gw,'u_tras_SGD_0.1':u-.1*gu,'w_tras_SGD_0.1':w-.1*gw})
    fig,ax=plt.subplots(1,2,figsize=(10,3.5));ax[0].plot(range(4),h,'o-');ax[0].set(xlabel='Paso',ylabel='Estado h',title='El estado cambia con la entrada y el pasado')
    ax[1].bar([1,2,3],np.abs(delta));ax[1].set(xlabel='Paso',ylabel='|dL/da|',title='Señal que llega desde la pérdida final');fig.tight_layout();plt.show()
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_rnn_desplegada()
paso entrada preactivacion estado delta aporte_grad_u aporte_grad_w
0 1 1.0 0.800000 0.664037 -0.065324 -0.065324 -0.000000
1 2 0.0 0.332018 0.320333 -0.233694 -0.000000 -0.155181
2 3 -1.0 -0.639833 -0.564786 -0.520832 0.520832 -0.166840
{'perdida': 0.2924488893597071, 'grad_u': 0.45550819333849757, 'grad_w': -0.3220211382956274, 'u_tras_SGD_0.1': 0.7544491806661503, 'w_tras_SGD_0.1': 0.5322021138295627}

19.2.2 Lo que significa una señal pequeña hacia el pasado

En esta cuenta, los pasos tempranos reciben una señal menor. Una perturbación en la primera entrada atraviesa más derivadas hasta llegar a la pérdida final. En una red vectorial aparecen productos de jacobianos: dirección, activación y pesos intervienen juntos. Una norma pequeña dificulta aprender dependencias largas; una norma grande puede volver inestables las actualizaciones.

El recorte de gradientes del capítulo 7 limita una norma grande antes de actualizar; no recupera una señal que ya se volvió diminuta ni demuestra que la memoria aprendida sea adecuada. Tampoco eliminar tanh sería una solución general: cambiaría la familia de funciones y su estabilidad.

Ejercicio resuelto de interpretación: si invertir las entradas modifica \(h_3\), sabemos que esta función es sensible al orden. Todavía no sabemos si aprendió el orden relevante para una tarea. Para medirlo necesitamos objetivos que dependan de él y controles comparables. Esa distinción evita atribuir comprensión temporal a cualquier estado recurrente.

19.3 3. Demanda sintética y tiempo reservado

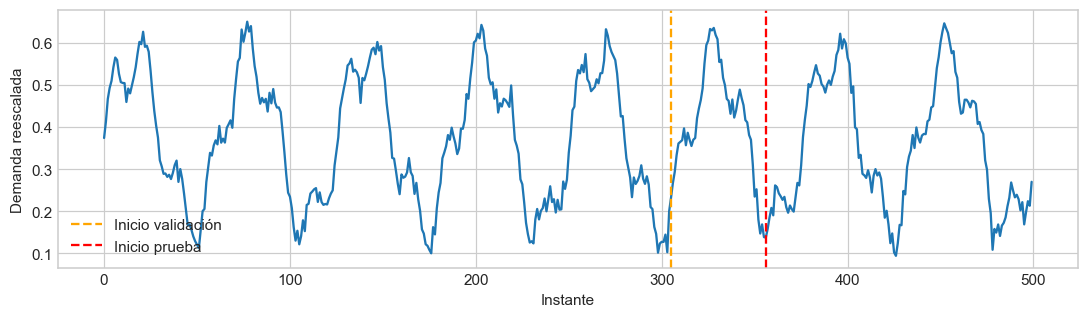
Conservamos 500 puntos, dos componentes periódicas y ruido, con ventana 20 y doce épocas. No llamamos “semanal” a una frecuencia que no corresponde a siete observaciones. La escala usa exclusivamente el tramo de entrenamiento, en lugar del mínimo y máximo de toda la serie. Los valores de prueba pueden salir del rango de desarrollo.

El test mantiene los últimos 30 % de los objetivos históricos. Del desarrollo se reserva el último 15 % como validación. Las ventanas pueden compartir observaciones de contexto conocidas antes del objetivo: evaluamos un paso adelante con actualización observada, no un pronóstico libre de muchos pasos. Ningún objetivo de prueba se utiliza para entrenar o seleccionar checkpoint.

T=500;t=np.linspace(0,50,T);cruda=np.sin(t)+.35*np.sin(3.5*t)+.08*np.random.default_rng(0).normal(size=T)
L=20;objetivos=np.arange(L,T);corte_test=L+int(.7*(T-L));corte_val=L+int(.85*(corte_test-L))
minimo=float(cruda[:corte_val].min());amplitud=float(np.ptp(cruda[:corte_val]));demanda=.1+.55*(cruda-minimo)/amplitud
x,y,idx=ventana(demanda,L);tr=idx<corte_val;va=(idx>=corte_val)&(idx<corte_test);te=idx>=corte_test
trd,vld,ted=[datos(x[m],y[m]) for m in [tr,va,te]]
np.savez_compressed(ARTEFACTOS/'demanda-particiones.npz',train=idx[tr],val=idx[va],test=idx[te],corte_val=corte_val,corte_test=corte_test)
fig,ax=plt.subplots(figsize=(10,3));ax.plot(demanda);ax.axvline(corte_val,color='orange',ls='--',label='Inicio validación');ax.axvline(corte_test,color='red',ls='--',label='Inicio prueba');ax.set(xlabel='Instante',ylabel='Demanda reescalada');ax.legend();fig.tight_layout();plt.show()
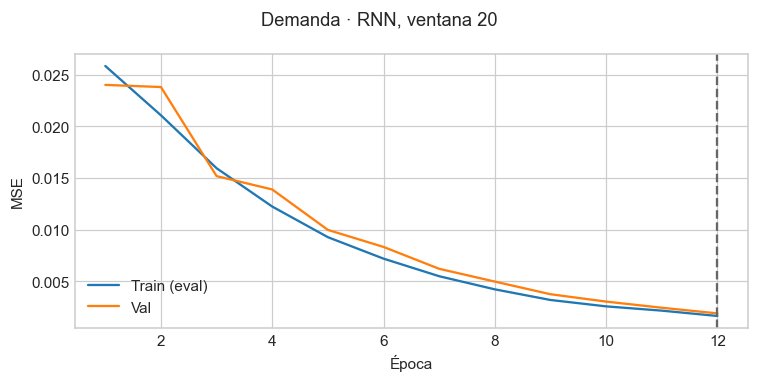
semilla();red,h,r=ajustar(Secuencia(),trd,vld,'demanda-L20',12);graficar(h,r,'Demanda · RNN, ventana 20')
rr=medir(red,ted);real=y[te];pred=rr['z'];naive=x[te,-1,0]
tabla=resumen_regresion(real,pred,naive,'RNN-L20');tabla.to_csv(ARTEFACTOS/'demanda-metricas.csv',index=False)
fig,axes=plt.subplots(1,2,figsize=(11,3.5));axes[0].plot(idx[te],real,label='Real');axes[0].plot(idx[te],pred,label='RNN');axes[0].plot(idx[te],naive,label='Último valor',alpha=.5);axes[0].legend();axes[0].set(xlabel='Instante objetivo',ylabel='Demanda reescalada')
residuos=real-pred;axes[1].hist(residuos,bins=24);axes[1].axvline(0,color='red',ls='--');axes[1].set(xlabel='Real − predicho',ylabel='Frecuencia');fig.tight_layout();plt.show()

demanda-L20 1 val 0.02401
demanda-L20 2 val 0.0238
demanda-L20 3 val 0.01518
demanda-L20 4 val 0.01389
demanda-L20 5 val 0.00998
demanda-L20 6 val 0.00833
demanda-L20 7 val 0.00621
demanda-L20 8 val 0.00498
demanda-L20 9 val 0.00375
demanda-L20 10 val 0.00304
demanda-L20 11 val 0.00245
demanda-L20 12 val 0.0019

Checkpoint: época 12 de 12, mínimo de validación 0.00190. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización.

modelo rmse mae sesgo_real_menos_pred
0 RNN-L20 0.043932 0.034958 0.006682
1 Persistencia 0.031621 0.024955 0.000911

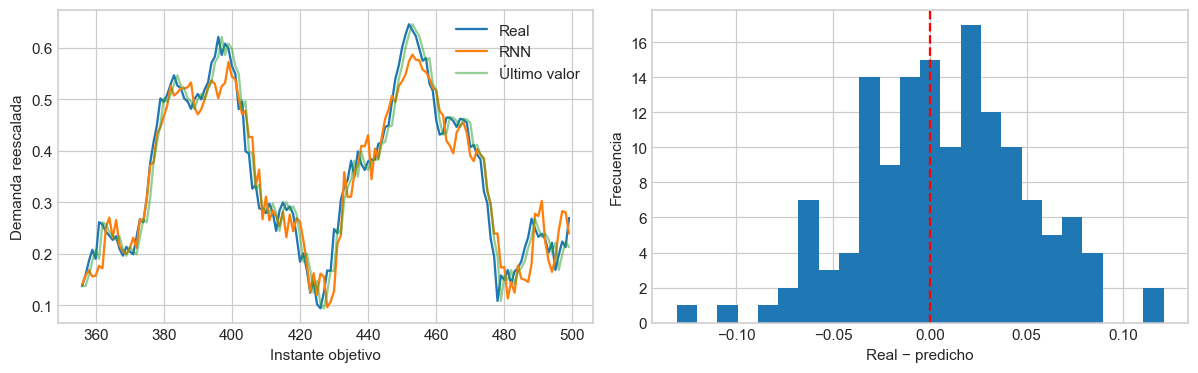
Comparación observada: RMSE de RNN-L20 0.0439, persistencia 0.0316. Diferencia persistencia−red = -0.0123. El signo describe este ensayo; no establece que una red recurrente sea necesaria para esta serie.

19.3.1 Picos y comparación de ventanas

El percentil 80 de entrenamiento define alta demanda antes de mirar prueba. Se informa cuántos días cumplen el criterio y el error condicionado; no se redefine el umbral con el test ni se declara aceptable un error sin una tolerancia del dominio.

Para ventana 10 conservamos los mismos instantes de inicio de validación y prueba. El número de parámetros recurrentes no depende de L con dimensión oculta fija. Se conservan diez épocas para esta variante: la comparación combina longitud y presupuesto histórico, por lo que no aísla exclusivamente el efecto de contexto.

umbral=float(np.quantile(y[tr],.8));alta=real>=umbral
filas=[]
for nombre,sel in [('Alta demanda',alta),('Resto',~alta)]:
    filas.append({'tramo':nombre,'n':int(sel.sum()),'rmse_red':float(np.sqrt(np.mean((real[sel]-pred[sel])**2))) if sel.any() else None,'rmse_persistencia':float(np.sqrt(np.mean((real[sel]-naive[sel])**2))) if sel.any() else None})
display(pd.DataFrame(filas));pd.DataFrame(filas).to_csv(ARTEFACTOS/'demanda-picos.csv',index=False)
x10,y10,i10=ventana(demanda,10);tr10=i10<corte_val;va10=(i10>=corte_val)&(i10<corte_test);te10=i10>=corte_test
assert np.array_equal(i10[te10],idx[te])
semilla();red10,h10,r10=ajustar(Secuencia(),datos(x10[tr10],y10[tr10]),datos(x10[va10],y10[va10]),'demanda-L10',10)
pred10=medir(red10,datos(x10[te10],y10[te10]))['z'];assert parametros(red10)==parametros(red)
display(pd.DataFrame({'ventana':[20,10],'epocas':[12,10],'parametros':[parametros(red),parametros(red10)],'rmse_test':[float(np.sqrt(np.mean((real-pred)**2))),float(np.sqrt(np.mean((real-pred10)**2)))]}))
salvar(red,Secuencia,'demanda',{'tipo':'RNN','entrada':'N,L,1 float32','ventana':20,'escala_min_train':minimo,'escala_amplitud_train':amplitud,'transformacion':'.1+.55*(x-min)/amplitud','checkpoint':'min MSE val','pronostico':'un paso con observaciones previas'},vld)
tramo n rmse_red rmse_persistencia
0 Alta demanda 25 0.047482 0.025884
1 Resto 119 0.043149 0.032699
demanda-L10 1 val 0.05062
demanda-L10 2 val 0.03002
demanda-L10 3 val 0.0238
demanda-L10 4 val 0.01749
demanda-L10 5 val 0.01359
demanda-L10 6 val 0.01059
demanda-L10 7 val 0.00847
demanda-L10 8 val 0.00715
demanda-L10 9 val 0.0062
demanda-L10 10 val 0.00549
ventana epocas parametros rmse_test
0 20 12 321 0.043932
1 10 10 321 0.069762
Recarga comprobada: demanda

19.4 4. Sensor de cámara fría

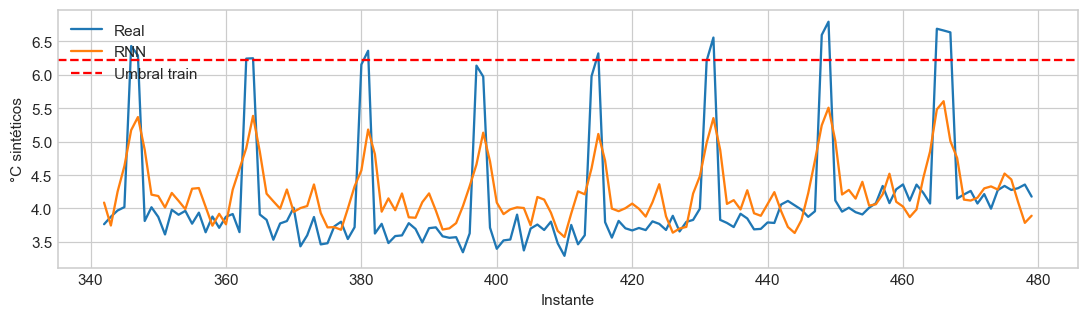
Conservamos deriva, oscilación, picos y ruido, ventana 20 y diez épocas. Los valores representan grados Celsius sintéticos; no son datos de un equipo real ni definen una alarma normativa. Escalamos entrada y objetivo con media y desviación del entrenamiento para evitar confundir saturación de tanh con incapacidad de la arquitectura; devolvemos las predicciones a °C.

El umbral de evento se fija con el percentil 90 de objetivos de entrenamiento. El informe de eventos responde otra pregunta que RMSE: recuperar temperaturas altas. Una predicción suavizada puede tener un error medio moderado y omitir picos.

tt=np.linspace(0,80,480);temperatura=4+.4*np.sin(tt/6)+(np.sin(tt*2.2)>.92)*2.5+.15*np.random.default_rng(1).normal(size=len(tt))
xs,ys,isensor=ventana(temperatura,20);c_test=20+int(.7*len(ys));c_val=20+int(.85*(c_test-20))
st=isensor<c_val;sv=(isensor>=c_val)&(isensor<c_test);ss=isensor>=c_test
media=float(temperatura[:c_val].mean());desv=float(temperatura[:c_val].std());xsn=(xs-media)/desv;ysn=(ys-media)/desv
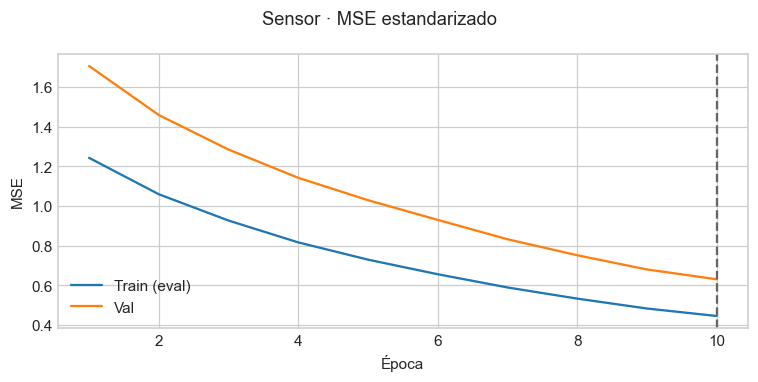
semilla();sensor,hs,rs=ajustar(Secuencia(),datos(xsn[st],ysn[st]),datos(xsn[sv],ysn[sv]),'sensor',10);graficar(hs,rs,'Sensor · MSE estandarizado')
ps=medir(sensor,datos(xsn[ss],ysn[ss]))['z']*desv+media
metricas_sensor=resumen_regresion(ys[ss],ps,xs[ss,-1,0],'Sensor-RNN');metricas_sensor.to_csv(ARTEFACTOS/'sensor-metricas.csv',index=False)
corte=float(np.quantile(ys[st],.9));evt=ys[ss]>=corte;hat=ps>=corte
print('Umbral fijado en train:',corte,'°C');print(classification_report(evt.astype(int),hat.astype(int),labels=[0,1],target_names=['Estable','Temperatura alta'],digits=4,zero_division=0))
fig,ax=plt.subplots(figsize=(10,3));ax.plot(isensor[ss],ys[ss],label='Real');ax.plot(isensor[ss],ps,label='RNN');ax.axhline(corte,color='red',ls='--',label='Umbral train');ax.set(xlabel='Instante',ylabel='°C sintéticos');ax.legend();fig.tight_layout();plt.show()
salvar(sensor,Secuencia,'sensor',{'ventana':20,'media_train':media,'desviacion_train':desv,'umbral_evento_train':corte,'salida':'estandarizada; invertir con media/desv'},datos(xsn[sv],ysn[sv]))
sensor 1 val 1.70682
sensor 2 val 1.45935
sensor 3 val 1.28492
sensor 4 val 1.14221
sensor 5 val 1.02929
sensor 6 val 0.92981
sensor 7 val 0.83218
sensor 8 val 0.75129
sensor 9 val 0.67956
sensor 10 val 0.63002

Checkpoint: época 10 de 10, mínimo de validación 0.63002. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización.

modelo rmse mae sesgo_real_menos_pred
0 Sensor-RNN 0.605151 0.470778 -0.100973
1 Persistencia 0.872207 0.430239 0.000840

Comparación observada: RMSE de Sensor-RNN 0.6052, persistencia 0.8722. Diferencia persistencia−red = +0.2671. El signo describe este ensayo; no establece que una red recurrente sea necesaria para esta serie.

Umbral fijado en train: 6.21421480178833 °C
                  precision    recall  f1-score   support

         Estable     0.9130    1.0000    0.9545       126
Temperatura alta     0.0000    0.0000    0.0000        12

        accuracy                         0.9130       138
       macro avg     0.4565    0.5000    0.4773       138
    weighted avg     0.8336    0.9130    0.8715       138

Recarga comprobada: sensor

19.5 5. Reseñas IMDB: muchos tokens, una etiqueta

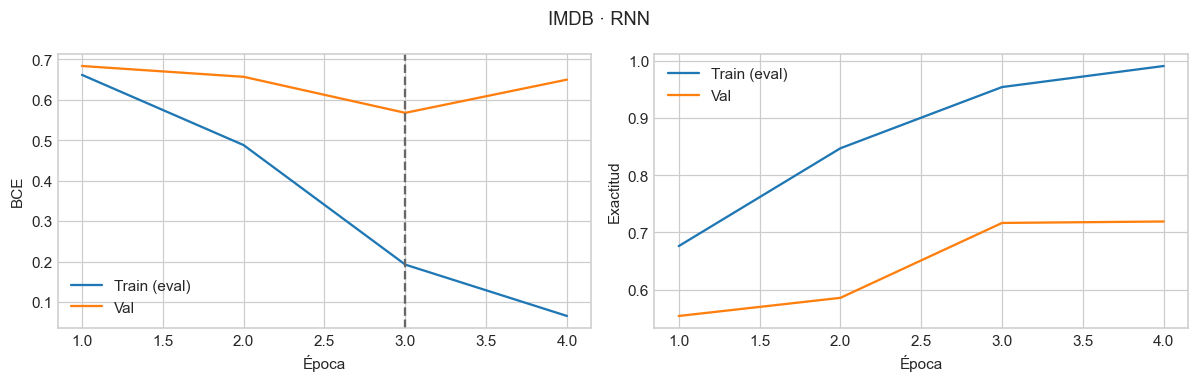
Conservamos vocabulario 4 000, longitud 80, embedding 32, RNN 32, 8 000 reseñas de desarrollo, cuatro épocas y 4 000 de prueba. La lectura del archivo de datos no importa TensorFlow: reproduce la permutación histórica con semilla 113, desplazamiento de índices +3, inicio 1 y desconocido 2. Se conservan los últimos 80 tokens y padding anterior 0. Decir que se elimina el final sería incorrecto para este recorte.

Para mantener el experimento histórico, el token 0 tiene embedding entrenable y no se usa máscara ni packing: la red procesa los 80 pasos. Es una decisión de representación que otro estudio puede cambiar. Este caso introduce secuencias de lenguaje; el tratamiento especializado de NLP pertenece al libro reservado para ese tema.

cache=Path.home()/'.keras'/'datasets'/'imdb.npz'
if not cache.exists():
    cache.parent.mkdir(parents=True,exist_ok=True);urllib.request.urlretrieve('https://storage.googleapis.com/tensorflow/tf-keras-datasets/imdb.npz',cache)
# El archivo oficial guarda listas de longitud variable como objetos NumPy.
with np.load(cache,allow_pickle=True) as d:
    tx=d['x_train'];ty=d['y_train'];vx=d['x_test'];vy=d['y_test']
rng=np.random.RandomState(113);ot=np.arange(len(tx));rng.shuffle(ot);ov=np.arange(len(vx));rng.shuffle(ov)
def codificar(secuencias,orden,n):
    salida=np.zeros((n,80),dtype=np.int64)
    for i,j in enumerate(orden[:n]):
        tokens=[1]+[int(w)+3 for w in secuencias[j]];tokens=[w if w<4000 else 2 for w in tokens][-80:]
        salida[i,-len(tokens):]=tokens
    return salida
tx=codificar(tx,ot,8000);vx=codificar(vx,ov,4000);ty=ty[ot[:8000]];vy=vy[ov[:4000]]
trt=datos(tx[:6800],ty[:6800],True);vlt=datos(tx[6800:],ty[6800:],True);tet=datos(vx,vy,True)
np.savez_compressed(ARTEFACTOS/'imdb-particiones.npz',train_original=ot[:6800],val_original=ot[6800:8000],test_original=ov[:4000])
semilla();texto,ht,rt=ajustar(Secuencia(ocultas=32,vocabulario=4000),trt,vlt,'imdb-rnn',4,lote=64,tipo='binaria');graficar(ht,rt,'IMDB · RNN',True)
pt=medir(texto,tet,'binaria');prob=pt['p'];hat=(prob>=.5).astype(int)
rr={'y':vy,'logits':np.stack([np.zeros_like(pt['z']),pt['z']],1),'probabilidades':np.stack([1-prob,prob],1),'ce':pt['loss'],'exactitud':pt['acc']}
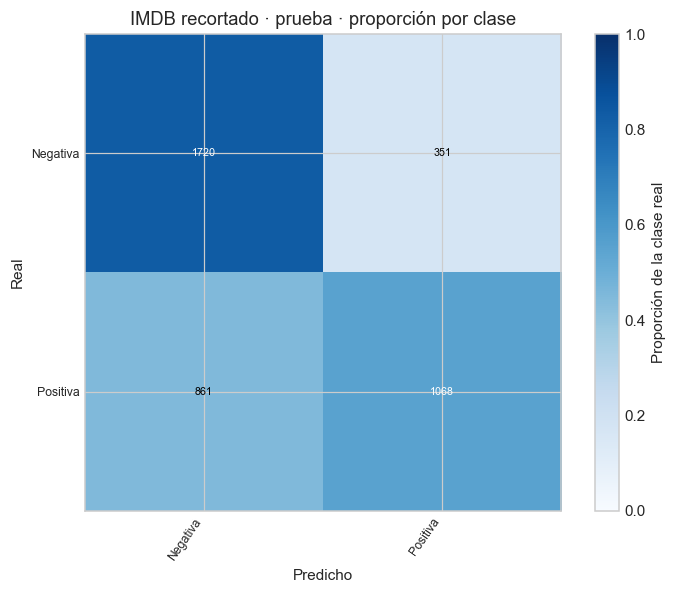
diagnostico(rr,['Negativa','Positiva'],titulo='IMDB recortado · prueba')
errores=hat!=vy;conf=np.maximum(prob,1-prob)
print('Errores con probabilidad máxima ≥0,90:',int((errores&(conf>=.9)).sum()))
(ARTEFACTOS/'imdb-metricas.json').write_text(json.dumps({'exactitud':pt['acc'],'bce':pt['loss'],'macro_f1':f1_score(vy,hat,average='macro'),'errores_seguros':int((errores&(conf>=.9)).sum())}),encoding='utf-8')
salvar(texto,lambda:Secuencia(ocultas=32,vocabulario=4000),'imdb-rnn',{'vocabulario':4000,'longitud':80,'recorte':'ultimos tokens','padding':'anterior, token 0 entrenable','indice_inicio':1,'indice_desconocido':2,'offset':3,'salida':'logit binario'},vlt)
imdb-rnn 1 val 0.68341
imdb-rnn 2 val 0.65672
imdb-rnn 3 val 0.56767
imdb-rnn 4 val 0.64976

Checkpoint: época 3 de 4, mínimo de validación 0.56767. La última época no sustituye este mínimo. Las curvas se miden al cierre en eval; la pérdida de entrenamiento no es una garantía de generalización.

              precision    recall  f1-score   support

    Negativa     0.6664    0.8305    0.7395      2071
    Positiva     0.7526    0.5537    0.6380      1929

    accuracy                         0.6970      4000
   macro avg     0.7095    0.6921    0.6887      4000
weighted avg     0.7080    0.6970    0.6905      4000

Decisión después de medir. Exactitud 69.70%; macro-F1 0.6887; 1212 errores de 4000. El menor recall corresponde a Positiva (55.37%). La confusión más frecuente es Positiva → Negativa (861 casos). Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test.

Errores con probabilidad máxima ≥0,90: 122
Recarga comprobada: imdb-rnn

19.5.1 Lectura de la ejecución registrada

Se conservan demanda L20/L10, sensor e IMDB, sus presupuestos y particiones históricas de prueba. La escala y los umbrales ahora se ajustan sólo con entrenamiento; se explicita el pronóstico de un paso y se alinean objetivos temporales. IMDB conserva últimos 80 tokens, padding anterior y permutación oficial 113; SHA-256 oficial comprobado: 69664113be75683a8fe16e3ed0ab59fda8886cb3cd7ada244f7d9544e4676b9f. El checkpoint se restaura antes de prueba. La persistencia obtuvo menor RMSE que la RNN en demanda: no se oculta ni se fuerza una ventaja. Recargas de demanda, sensor y texto comprobadas.

Ejecución CPU del 15 de octubre de 2026; contraste esta lectura si cambia datos, semilla o versión.

19.5.2 Del error medio a una omisión que importa

Consideremos temperaturas verdaderas \([2,2,2,8]\). La predicción A, \([2,2,2,5]\), tiene RMSE 1,5; la B, \([4,4,4,8]\), tiene RMSE \(\sqrt3\approx1,73\). Si el evento se define antes de evaluar como temperatura mayor o igual que 7, A omite el único evento y B lo recupera. B no es mejor en todos los sentidos: comete más error en los casos ordinarios. El objetivo de uso debe indicar qué compromiso resulta aceptable.

En demanda, la persistencia es fuerte cuando la señal cambia despacio y se observa el valor anterior. Si la RNN pierde frente a ella, revise primero horizonte, ruido, escala y presupuesto; no atribuya automáticamente la derrota a falta de neuronas. En el sensor, contraste RMSE con errores en eventos y sus conteos. En IMDB, una F1 favorable puede coexistir con dependencia del recorte de tokens y del padding.

Para una nueva decisión, escriba una hipótesis comprobable: «la ventana corta omite el ciclo», «la pérdida media prioriza lecturas ordinarias» o «el relleno afecta el estado». Diseñe el contraste en desarrollo manteniendo los demás controles. Los resultados de prueba de este capítulo describen modelos ya fijados; no son el lugar para escoger retrospectivamente la hipótesis ganadora.

19.6 6. Decidir con unidades y baselines

La demanda compara RMSE con persistencia y separa días altos. El sensor añade recall de eventos con un umbral fijado antes de prueba. IMDB añade F1 por clase y errores seguros. Esas cifras no se promedian en una “exactitud de la RNN”. Un error positivo real−predicho indica subestimación; una cola en el histograma orienta una revisión del sesgo, sin garantizar que todas las series deban tener residuo cero.

Si persistencia empata o gana, la red no justificó complejidad por esa métrica y presupuesto. Si omite picos, revise el objetivo y el coste del error usando desarrollo. Para dependencias mayores, el capítulo siguiente contrasta puertas LSTM y GRU; no supone que siempre resuelvan el problema.

19.7 Referencias