34  MLOps

Serie Deep Learning · del perceptrón a los transformers.

Un modelo llega a operación cuando sus pesos, preprocesamiento, contrato de entrada, versión y criterios de seguimiento pueden inspeccionarse juntos. Construimos una CNN Fashion-MNIST y un servicio local, verificamos recarga y entradas, y distinguimos una alarma de drift de una decisión de reentrenar.

34.1 1. Entrenamiento, selección y artefacto

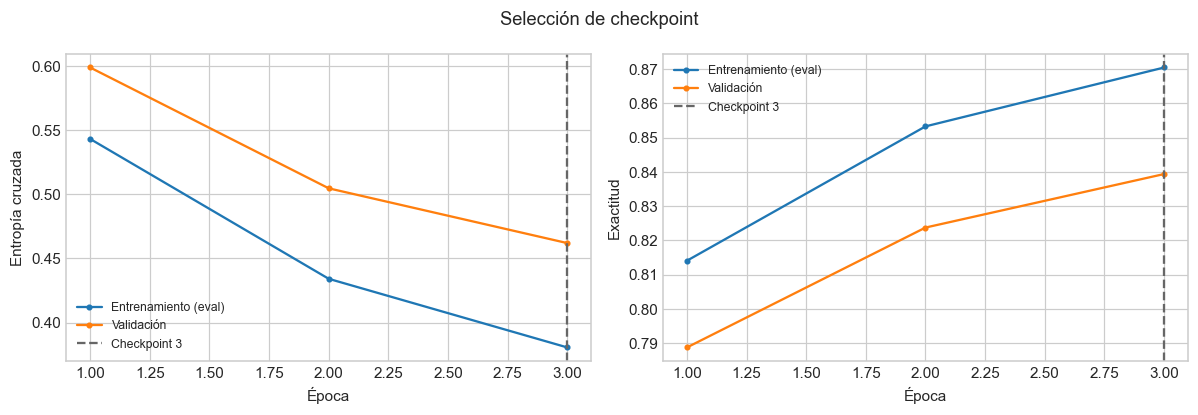
Se mantienen 6 400 ejemplos de entrenamiento, 1 600 de validación, tres épocas y lote 128. La CNN usa convolución de 16 filtros, pooling y densa de 32 unidades. Se restaura el mínimo CE de validación antes de guardar. Los primeros 2 000 casos de prueba describen el modelo ya fijado y los escenarios de monitoreo, sin participar en su selección.

En PyTorch un state_dict contiene parámetros y buffers, no el código de la arquitectura. La versión del artefacto incluye una fábrica identificada, contrato, versiones del entorno y huella SHA-256. Estos datos permiten comprobar qué se cargó; no equivalen a un sistema completo de registro ni a reanudar exactamente la optimización.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}
from scipy.stats import ks_2samp
def arquitectura():return nn.Sequential(nn.Conv2d(1,16,3),nn.ReLU(),nn.MaxPool2d(2),nn.Flatten(),nn.Linear(2704,32),nn.ReLU(),nn.Linear(32,10))
xa,ya,xt,yt=mnist('fashion');x_tr=xa[:,None].astype(np.float32)/255;x_te=xt[:,None].astype(np.float32)/255;y_tr=ya;y_te=yt
train=conjunto(x_tr[:6400],y_tr[:6400]);val=conjunto(x_tr[6400:8000],y_tr[6400:8000]);test=conjunto(x_te[:2000],y_te[:2000])
semilla();modelo=inicializar(arquitectura());historia,info=entrenar(modelo,train,val,3,128,nombre='fashion-cnn-v1');curvas(historia,'Selección de checkpoint',info['mejor_epoca'])
version='fashion_cnn_v1';ruta=ARTEFACTOS/f'{version}.pt'
contrato={'model_version':version,'architecture':'Conv16-k3-pool-Dense32-10-v1','train_n':6400,'val_n':1600,'checkpoint':info['mejor_epoca'],'selection':'minimum validation CE','input':'uint8 (N,28,28) externo; float32 NCHW interno','scale':'uint8 / 255','rejection_threshold':.45,'max_batch':256,'torch':str(torch.__version__)}
modelo_prod=guardar(modelo,arquitectura,version,contrato,val)
metadatos=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest());(ARTEFACTOS/'metadata.json').write_text(json.dumps(metadatos,ensure_ascii=False,indent=2),encoding='utf-8')
resultado=evaluar(modelo_prod,test);display(pd.DataFrame([{'CE_test':resultado['ce'],'exactitud_test':resultado['exactitud']}]))
pd.DataFrame([{'ce_test':resultado['ce'],'exactitud_test':resultado['exactitud']}]).to_csv(ARTEFACTOS/'test.csv',index=False)
fashion-cnn-v1 1/3: CE val=0.5988, acc val=0.7887
fashion-cnn-v1 2/3: CE val=0.5046, acc val=0.8237
fashion-cnn-v1 3/3: CE val=0.4619, acc val=0.8394

Recarga verificada: artefactos_pytorch\fashion_cnn_v1.pt bytes: 351529
CE_test exactitud_test
0 0.457937 0.8395

34.2 2. Contrato de inferencia y recarga

La entrada pública admite una imagen 28×28 o un lote de hasta 256 imágenes. Debe contener intensidades enteras de 0 a 255. Se valida antes de convertir a uint8: convertir primero ocultaría negativos o valores mayores por desbordamiento. Se rechazan lotes vacíos, formas incorrectas, NaN, fracciones y texto. Después se escala y añade el canal NCHW.

La salida contiene clase, diez probabilidades y rechazo por confianza inferior a 0,45. Este umbral es una política didáctica prefijada: la probabilidad máxima no acredita calibración ni garantiza que las predicciones aceptadas sean correctas. La inferencia usa eval() e inference_mode() y no entrena.

def preprocesar(instancias):
    a=np.asarray(instancias)
    if a.dtype.kind not in 'iuf':raise ValueError('Intensidades numéricas requeridas')
    if a.ndim==2:a=a[None]
    if a.ndim!=3 or a.shape[1:]!=(28,28) or not 1<=len(a)<=256:raise ValueError('Forma esperada (28,28) o (N,28,28), 1≤N≤256')
    if not np.isfinite(a).all() or (a<0).any() or (a>255).any() or not np.equal(a,np.floor(a)).all():raise ValueError('Intensidades enteras finitas de 0 a 255')
    return torch.from_numpy(np.ascontiguousarray(a[:,None],dtype=np.float32)/255).to(DEVICE)

@torch.inference_mode()
def inferir(instancias,red=modelo_prod,umbral=.45):
    red.eval();prob=red(preprocesar(instancias)).softmax(1).cpu().numpy();clases=prob.argmax(1);conf=prob[np.arange(len(prob)),clases]
    return [{'clase':int(c),'confianza':float(k),'rechazar':bool(k<umbral),'probs':fila.tolist()} for c,k,fila in zip(clases,conf,prob)]

class ServicioModelo:
    def __init__(self,ruta,metadata):
        self.metadata=json.loads(Path(metadata).read_text(encoding='utf-8'))
        if hashlib.sha256(Path(ruta).read_bytes()).hexdigest()!=self.metadata['sha256']:raise ValueError('Huella del artefacto distinta del registro')
        self.modelo=arquitectura().to(DEVICE);self.modelo.load_state_dict(torch.load(ruta,map_location=DEVICE,weights_only=True)['state_dict']);self.modelo.eval()
        self.n_consultas=0;self.confianzas=[]
    def predecir(self,payload):
        if not isinstance(payload,dict) or 'instances' not in payload:raise ValueError('Falta instances')
        out=inferir(payload['instances'],self.modelo,self.metadata['rejection_threshold']);self.n_consultas+=len(out);self.confianzas.extend(r['confianza'] for r in out)
        return {'model':self.metadata['model_version'],'predictions':out}

servicio=ServicioModelo(ruta,ARTEFACTOS/'metadata.json');respuesta=servicio.predecir({'instances':xt[:3]});print(json.dumps(respuesta,ensure_ascii=False)[:650])
assert servicio.n_consultas==3
np.testing.assert_allclose([r['probs'] for r in respuesta['predictions']],resultado['probabilidades'][:3],rtol=1e-5,atol=1e-6)
invalidos=[np.zeros((27,28)),np.empty((0,28,28)),np.full((28,28),-1),np.full((28,28),256),np.full((28,28),.5),np.full((28,28),np.nan),np.full((28,28),'hola')]
for entrada in invalidos:
    try:servicio.predecir({'instances':entrada})
    except ValueError:pass
    else:raise AssertionError('Entrada inválida aceptada')
assert servicio.n_consultas==3,'Una petición rechazada no debe contarse como inferencia'
print('Siete entradas inválidas rechazadas y recarga consistente.')
{"model": "fashion_cnn_v1", "predictions": [{"clase": 9, "confianza": 0.8150824308395386, "rechazar": false, "probs": [1.4289316823123954e-05, 0.00011484784045023844, 0.0005605979240499437, 0.00038693431997671723, 0.00017525286239106208, 0.007799140177667141, 0.0026173060759902, 0.16284634172916412, 0.010402691550552845, 0.8150824308395386]}, {"clase": 2, "confianza": 0.9856128096580505, "rechazar": false, "probs": [3.0604107450926676e-05, 6.768705134163611e-06, 0.9856128096580505, 2.738921466516331e-05, 0.001347105484455824, 5.012860810893471e-07, 0.012911010533571243, 3.503765526602365e-07, 6.231257430044934e-05, 1.2377722669043578e-06]}, {
Siete entradas inválidas rechazadas y recarga consistente.

34.3 3. Servicio local y API futura

El servicio se simula dentro del proceso: no abre un puerto ni mide red, autenticación, concurrencia o carga. Un endpoint POST /v1/prediccion podría envolver el mismo contrato {"instances": imagen_o_lote}. El límite de lote, tiempo máximo, versión y tratamiento de errores deben conservarse al añadir HTTP.

Registrar consultas no exige conservar imágenes crudas. Este ejemplo acumula conteos y confianza en memoria; un servicio real necesita almacenamiento, política de acceso y retención apropiados. La huella detecta una diferencia de contenido respecto del registro local, pero no autentica por sí sola a quien creó el modelo.

34.4 4. Monitoreo: tres cambios diferentes

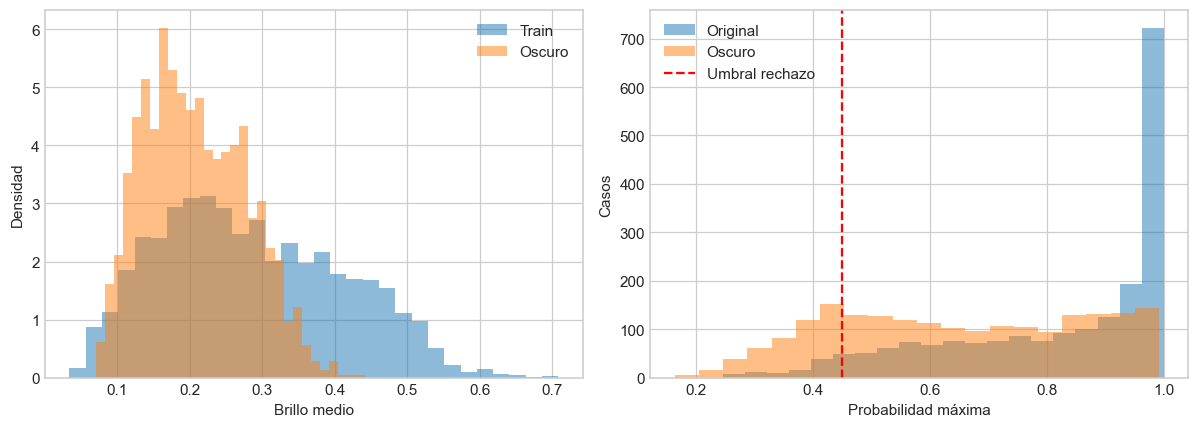
  • Data drift: cambia \(p(x)\). Simulamos imágenes más oscuras.
  • Concept drift: cambia \(p(y\mid x)\). Simulamos que la clase camisa se recodifica como camiseta.
  • Drift de predicción: cambia la distribución del score o clase predicha; es un síntoma, no un diagnóstico causal.

KS sobre brillo medio compara una característica univariada. No demuestra ausencia de otros cambios ni que el modelo haya fallado. La transformación oscura y el cambio de etiqueta son escenarios controlados; sus resultados no pronostican lo que ocurrirá en un servicio real. Un p-valor pequeño tampoco cuantifica por sí solo la relevancia práctica.

brillo_ref=x_tr[:4000].mean((1,2,3));brillo_ok=x_te[:2000].mean((1,2,3));oscuro=np.clip(x_te[:2000]*.55+.05,0,1);brillo_dr=oscuro.mean((1,2,3))
filas=[]
for nombre,bri in [('Referencia de prueba',brillo_ok),('Oscurecimiento',brillo_dr)]:
    ks=ks_2samp(brillo_ref,bri);filas.append({'escenario':nombre,'n':len(bri),'KS':ks.statistic,'p':ks.pvalue})
drift=pd.DataFrame(filas);display(drift);drift.to_csv(ARTEFACTOS/'drift.csv',index=False)
pred=resultado['logits'].argmax(1);y_cambio=y_te[:2000].copy();y_cambio[y_cambio==6]=0
ro=evaluar(modelo_prod,conjunto(oscuro,y_te[:2000]));prob_osc=ro['probabilidades'];conf=resultado['probabilidades'].max(1);conf_osc=prob_osc.max(1)
operacion=pd.DataFrame([{'escenario':'Original','exactitud':(pred==y_te[:2000]).mean(),'rechazo':(conf<.45).mean()},
 {'escenario':'Oscuro','exactitud':ro['exactitud'],'rechazo':(conf_osc<.45).mean()},
 {'escenario':'Etiqueta camisa→camiseta','exactitud':(pred==y_cambio).mean(),'rechazo':(conf<.45).mean()}])
display(operacion);operacion.to_csv(ARTEFACTOS/'escenarios.csv',index=False)
fig,ax=plt.subplots(1,2,figsize=(11,4));ax[0].hist(brillo_ref,bins=30,alpha=.5,density=True,label='Train');ax[0].hist(brillo_dr,bins=30,alpha=.5,density=True,label='Oscuro');ax[0].set(xlabel='Brillo medio',ylabel='Densidad');ax[0].legend()
ax[1].hist(conf,bins=20,alpha=.5,label='Original');ax[1].hist(conf_osc,bins=20,alpha=.5,label='Oscuro');ax[1].axvline(.45,color='red',ls='--',label='Umbral rechazo');ax[1].set(xlabel='Probabilidad máxima',ylabel='Casos');ax[1].legend();fig.tight_layout();plt.show()
escenario n KS p
0 Referencia de prueba 2000 0.01425 9.482863e-01
1 Oscurecimiento 2000 0.31725 4.105127e-119
escenario exactitud rechazo
0 Original 0.8395 0.0505
1 Oscuro 0.8365 0.2300
2 Etiqueta camisa→camiseta 0.7700 0.0505

34.5 5. Una alarma que abre una revisión

Se prefija una regla didáctica: al menos 500 consultas y KS de brillo superior a 0,10. La alarma propone revisar sensor, preproceso, mezcla de clases y etiquetas; no entrena automáticamente. El umbral no fue calibrado como garantía de una tasa de falsas alarmas. Con ventanas repetidas hay dependencia temporal y multiplicidad: se necesita un diseño de monitoreo propio.

def alarma(n,ks):return {'revisar':bool(n>=500 and ks>.10),'accion':'abrir revisión; no reentrenar automáticamente','regla':'n>=500 y KS>0.10'}
alarmas=[dict(escenario=r.escenario,**alarma(r.n,r.KS)) for r in drift.itertuples()];display(pd.DataFrame(alarmas))
(ARTEFACTOS/'alarmas.json').write_text(json.dumps(alarmas,ensure_ascii=False,indent=2),encoding='utf-8')
assert alarma(499,.9)['revisar']==False and alarma(500,.11)['revisar']==True
escenario revisar accion regla
0 Referencia de prueba False abrir revisión; no reentrenar automáticamente n>=500 y KS>0.10
1 Oscurecimiento True abrir revisión; no reentrenar automáticamente n>=500 y KS>0.10

34.5.1 Lectura de la ejecución registrada

Ejecución CPU del 15 de octubre de 2026.

La CNN quedó seleccionada en época 3 mediante validación. La recarga conserva logits y se comprueba la huella del artefacto; siete entradas inválidas fueron rechazadas antes de convertir tipos o contar inferencias. El contrato externo es imagen/lote de intensidades enteras 0–255, con forma y tamaño acotados; el tensor interno usa NCHW.

En los 2 000 casos de prueba, exactitud original 0,8395 y rechazo 0,0505. Al oscurecer, KS de brillo fue 0,3173, exactitud 0,8365 y rechazo 0,2300: un cambio de entrada marcado no produjo aquí una gran caída de exactitud, aunque sí alteró cobertura. Con recodificación camisa→camiseta, exactitud 0,7700 y rechazo inalterado 0,0505: el score no revela por sí solo el cambio de etiqueta. La regla prefijada de monitoreo abre revisión; no reentrena ni publica un servicio. Son escenarios locales y no una validación de producción.

34.5.2 Un caso completo: candidato, decisión y reversión

Un modelo nuevo no se promueve solo porque termina de entrenar. Necesita un identificador, datos y transformaciones asociados, una regla de aceptación prefijada y una forma de regresar a la versión anterior. El registro conserva artefactos; un alias indica cuál se utiliza. Cambiar el alias es una decisión operacional distinta de crear un archivo de pesos.

Para recorrer el ciclo sin simular tráfico real, usamos un caso binario pequeño e independiente del clasificador de imágenes. La primera población tiene poca variación en la segunda característica; la nueva tiene más dispersión, pero conserva la misma relación condicional entre características y etiqueta. Es un cambio de distribución de entradas, no una redefinición artificial del objetivo. El candidato aprende con datos nuevos y una muestra histórica. Cada versión ajusta su propia normalización usando exclusivamente su entrenamiento.

Antes de evaluar, fijamos esta regla didáctica: el candidato debe reducir la entropía cruzada de validación al menos 0.005 y no perder más de 0.05 de sensibilidad positiva con umbral 0.5. Son márgenes de este ejercicio, no una política universal. La decisión se toma en validación; la prueba se consulta después para describir el resultado de esa política, sin reajustarla. La sensibilidad puede ser inestable con pocos positivos: una aplicación real necesita tamaño de muestra y tolerancias acordes con su riesgo.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_mlops_ciclo():
    from pathlib import Path
    import json, hashlib
    carpeta=Path('artefactos_pytorch')/'ciclo_docente';carpeta.mkdir(parents=True,exist_ok=True)
    def datos(n,dispersion,seed):
        r=np.random.default_rng(seed);x=r.normal(size=(n,2));x[:,1]*=dispersion
        p=1/(1+np.exp(-(2*x[:,0]+.6*x[:,1]-.5)))
        y=(r.random(n)<p).astype(np.float32)
        return torch.tensor(x,dtype=torch.float32),torch.tensor(y)
    xa,ya=datos(400,.2,3401);xn,yn=datos(400,1.5,3402)
    xv,yv=datos(300,1.5,3403);xt,yt=datos(300,1.5,3404)
    def entrenar(x,y,version):
        media=x.mean(0);escala=x.std(0).clamp_min(1e-6)
        modelo=torch.nn.Linear(2,1);opt=torch.optim.Adam(modelo.parameters(),lr=.04)
        for _ in range(150):
            opt.zero_grad();loss=torch.nn.functional.binary_cross_entropy_with_logits(modelo((x-media)/escala).squeeze(1),y);loss.backward();opt.step()
        paquete={'state_dict':modelo.state_dict(),'media':media,'escala':escala,'version':version}
        ruta=carpeta/f'{version}.pt';torch.save(paquete,ruta)
        huella=hashlib.sha256(ruta.read_bytes()).hexdigest()
        manifiesto={'version':version,'archivo':ruta.name,'sha256':huella,'n_entrenamiento':len(x),'datos_sha256':hashlib.sha256(x.numpy().tobytes()+y.numpy().tobytes()).hexdigest(),'umbral':.5,'semantica':'probabilidad de clase positiva'}
        (carpeta/f'{version}.json').write_text(json.dumps(manifiesto,indent=2),encoding='utf8')
        return manifiesto
    v1=entrenar(xa,ya,'v1');v2=entrenar(torch.cat([xn,xa[:100]]),torch.cat([yn,ya[:100]]),'v2')
    def predecir(manifiesto,x):
        ruta=carpeta/manifiesto['archivo']
        assert hashlib.sha256(ruta.read_bytes()).hexdigest()==manifiesto['sha256']
        paquete=torch.load(ruta,weights_only=True,map_location='cpu')
        modelo=torch.nn.Linear(2,1);modelo.load_state_dict(paquete['state_dict']);modelo.eval()
        with torch.no_grad():return modelo((x-paquete['media'])/paquete['escala']).squeeze(1).sigmoid()
    def evaluar(manifiesto,x,y):
        p=predecir(manifiesto,x)
        ce=torch.nn.functional.binary_cross_entropy(p,y).item()
        positivos=y==1;recall=((p>=.5)&positivos).sum().item()/positivos.sum().item()
        return ce,recall
    m1=evaluar(v1,xv,yv);m2=evaluar(v2,xv,yv)
    aprobado=m2[0]<=m1[0]-.005 and m2[1]>=m1[1]-.05
    seleccion=v2 if aprobado else v1
    filas=[]
    for nombre,manifiesto in [('Vigente',v1),('Candidato',v2)]:
        ce,rec=evaluar(manifiesto,xv,yv);filas.append([nombre,'validacion',ce,rec])
    # La regla ya quedó aplicada; esta evaluación no cambia la selección.
    ce,rec=evaluar(seleccion,xt,yt);filas.append([seleccion['version'],'prueba de la seleccion',ce,rec])
    display(pd.DataFrame(filas,columns=['version','particion','CE','sensibilidad']))
    decision={'aprobado':bool(aprobado),'activa':seleccion['version'],'regla':{'mejora_ce_minima':.005,'perdida_sensibilidad_maxima':.05},'validacion_v1':m1,'validacion_v2':m2}
    (carpeta/'decision.json').write_text(json.dumps(decision,indent=2),encoding='utf8')
    print('Decisión de la regla:',decision)
    # Ensayo mecánico independiente de la aprobación: v1 -> v2 -> v1.
    alias=carpeta/'alias-ensayo.json'
    def apuntar(manifiesto):
        # Primero verificar carga y contrato; después reemplazar el puntero local.
        predecir(manifiesto,xv[:2])
        temporal=alias.with_suffix('.tmp');temporal.write_text(json.dumps(manifiesto),encoding='utf8');temporal.replace(alias)
    def servir(x):return predecir(json.loads(alias.read_text(encoding='utf8')),x)
    apuntar(v1);antes=servir(xv[:12]);apuntar(v2);durante=servir(xv[:12]);apuntar(v1);despues=servir(xv[:12])
    assert torch.equal(antes,despues)
    display(pd.DataFrame({'v1 antes':antes,'v2 durante ensayo':durante,'v1 restaurada':despues}))
    print('Reversión local comprobada; máxima diferencia:',(antes-despues).abs().max().item())
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_mlops_ciclo()
version particion CE sensibilidad
0 Vigente validacion 0.504473 0.659574
1 Candidato validacion 0.474536 0.595745
2 v1 prueba de la seleccion 0.420247 0.750000
Decisión de la regla: {'aprobado': False, 'activa': 'v1', 'regla': {'mejora_ce_minima': 0.005, 'perdida_sensibilidad_maxima': 0.05}, 'validacion_v1': (0.5044727325439453, 0.6595744680851063), 'validacion_v2': (0.47453612089157104, 0.5957446808510638)}
v1 antes v2 durante ensayo v1 restaurada
0 0.333411 0.450400 0.333411
1 0.048630 0.074885 0.048630
2 0.536927 0.448028 0.536927
3 0.959876 0.898202 0.959876
4 0.405337 0.305965 0.405337
5 0.185837 0.168298 0.185837
6 0.500658 0.379282 0.500658
7 0.982617 0.885953 0.982617
8 0.545431 0.491878 0.545431
9 0.153009 0.151711 0.153009
10 0.532487 0.361193 0.532487
11 0.951285 0.877428 0.951285
Reversión local comprobada; máxima diferencia: 0.0

34.5.3 Lectura del caso de promoción

En esta ejecución, el candidato reduce la CE de validación de 0.5045 a 0.4745, pero la sensibilidad cae de 0.6596 a 0.5957: pierde aproximadamente 0.0638, por encima del margen de 0.05. La regla lo rechaza y conserva v1. La mejora de una métrica agregada no compensa automáticamente la pérdida en el objetivo protegido. No se modifica el margen después de ver este resultado. El ensayo operacional restaura v1 con diferencia máxima de probabilidades igual a cero; esa comprobación técnica no altera el rechazo del candidato.

La salida distingue dos conclusiones. La regla de calidad acepta o rechaza el candidato de esta ejecución. El ensayo de reversión comprueba que podemos restaurar exactamente las predicciones de v1, aunque la regla haya rechazado v2. Este segundo recorrido ocurre en un registro local de práctica; no constituye una promoción aprobada ni un despliegue real.

El hash verifica integridad respecto del manifiesto que conservamos. No demuestra procedencia confiable si un atacante puede modificar ambos, y no sustituye permisos ni firmas. El paquete incluye normalización porque pesos correctos con una escala equivocada constituyen otro modelo. Restaurar únicamente pesos sin su contrato no sería una reversión completa.

34.5.4 Decidir después de la publicación

Una secuencia operativa razonada separa cuatro momentos. Primero, el candidato supera controles de contrato y una evaluación reservada. Después, una ejecución en paralelo permite comparar respuestas con la versión vigente sin alterar decisiones de usuarios. Luego puede asignarse una fracción controlada de solicitudes, con límites operacionales y de calidad prefijados. Finalmente se amplía o se revierte. Estos dos últimos pasos se describen como diseño: aquí no existe un servidor ni tráfico de producción.

Un aumento de latencia con calidad estable apunta a capacidad o servicio. Un cambio en entradas sin etiquetas abre una revisión de cobertura; no prueba por sí solo degradación. Cuando llegan etiquetas, una caída de sensibilidad puede justificar revisar umbral, población y datos faltantes antes de reentrenar. El umbral es parte de la versión y requiere su propia validación. Ajustarlo sobre incidentes observados y reportar el mismo conjunto como prueba introduciría optimismo.

Si se decide volver atrás, registre motivo, hora, versión retirada y restaurada, ventana afectada y comprobación posterior. Revertir el predictor no deshace decisiones ya tomadas ni corrige datos que cambiaron de esquema. Mantenga una salida segura para entradas incompatibles y un responsable que interprete la alarma. El objetivo de MLOps es poder explicar y controlar el cambio completo, además de almacenar modelos.

34.6 6. Ciclo de vida, promoción y reversión

Dato → entrenamiento → evaluación → registro → servicio → monitoreo → revisión. Cada transición necesita responsables y evidencia. Una candidata v2 se entrena con datos nuevos y datos de ancla, conserva validación para decidir y una evaluación reservada para confirmar. Reutilizar continuamente la misma prueba para ajustar convierte esa prueba en parte del desarrollo.

Pieza Decisión que debe quedar registrada
Datos y código Qué versiones generaron el artefacto y qué particiones se usaron
Registro Pesos, arquitectura, contrato, entorno, huella y métricas
Promoción Criterios prefijados de calidad global y grupos críticos
Servicio Versión efectiva, entradas admitidas, límite y errores
Observación Tiempo, rechazos, errores con etiqueta y cambios de distribución
Reversión Cómo restaurar v1 y comprobar su contrato

Este capítulo implementa artefacto, servicio local y alarma. No implementa una plataforma CI/CD, registro remoto ni publicación. Un reentrenamiento produce una candidata; no sustituye silenciosamente el modelo en servicio.

34.7 7. Decisiones y límites

Si cambia brillo y cae exactitud, investigue el cambio de entrada antes de elegir una intervención. Si cambian etiquetas pero no entrada ni predicciones, la confianza puede permanecer idéntica mientras cambia exactitud: se necesitan etiquetas para detectar ese problema. Si aumenta rechazo, revise cobertura y coste de los casos rechazados; no baje el umbral para esconder la alarma.

Tres épocas y una sola partición no certifican calidad de producción. El experimento conserva su utilidad al hacer explícitos selección, contrato y límites de observación.

34.8 8. Ejercicios

  1. Registre tasa de rechazo por lotes de veinte y analice su variación.
  2. Añada varianza espacial al monitor y compare reglas AND/OR sobre ventanas reservadas.
  3. Escriba criterios de promoción y reversión antes de entrenar v2.
  4. Diseñe un control de calidad con etiquetas tardías y explique qué no puede observar mientras espera.

34.9 Referencias