28  Difusión y flow matching

Serie Deep Learning · del perceptrón a los transformers.

Separaremos tres mecanismos: corromper una imagen, aprender a estimar el ruido e integrar un proceso de generación. Después entrenaremos un campo de velocidades sobre ocho grupos de puntos. Los objetivos y dominios son distintos; no se comparará su calidad con una sola cifra.

28.1 1. Entorno, datos y reservas

Usamos PyTorch, NumPy, pandas, Matplotlib y scikit-learn. Conservamos Digits ampliado 8×8→16×16 y el test histórico del 10 % de una permutación semilla 0. Del desarrollo se separa validación para elegir checkpoint; no se usa test para ese fin. Los píxeles pasan a [−1,1]. La ampliación no añade detalle.

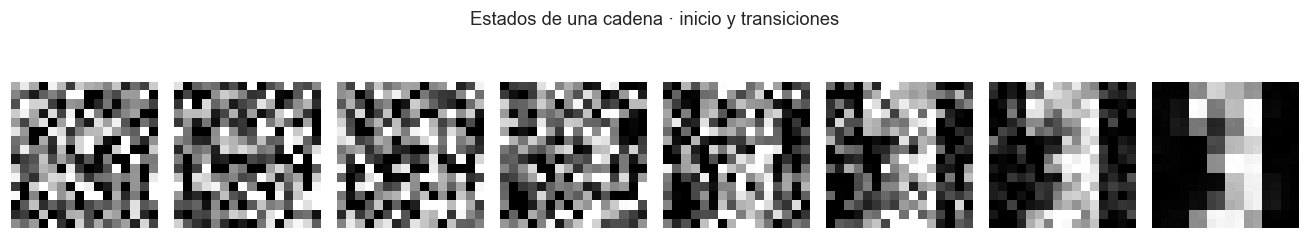
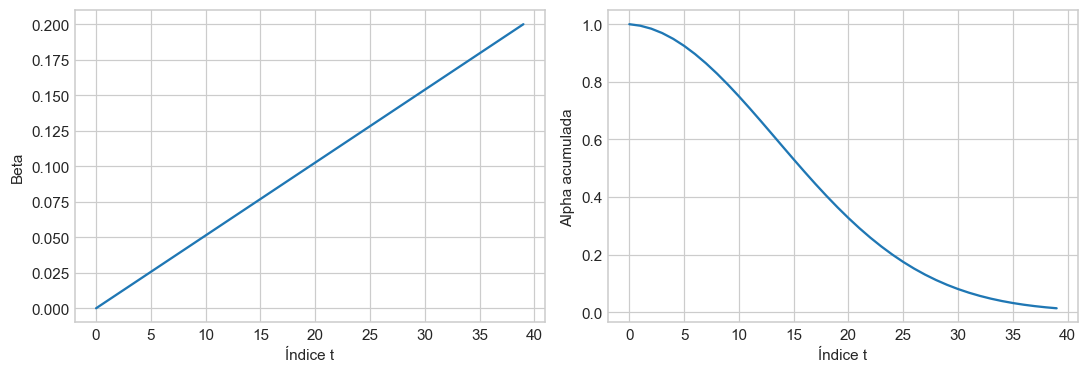
Se conservan 40 niveles de difusión, 3 000 actualizaciones con lote 64, quince épocas del juez auxiliar y 2 000 actualizaciones de flow matching con lote 256. La ejecución registrada es CPU. No son reproducciones a escala de modelos de imágenes de alta resolución.

Código
from pathlib import Path
import json, time, copy, hashlib, platform, gzip, struct, urllib.request
import numpy as np
import pandas as pd
import sklearn
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, confusion_matrix, f1_score
import matplotlib.pyplot as plt
from IPython.display import display, Markdown
from PIL import Image
import torch
from torch import nn
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset, Dataset

SEED=42
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(2)
DEVICE=torch.device('cuda' if torch.cuda.is_available() else 'cpu')
ARTEFACTOS=Path('artefactos_pytorch'); ARTEFACTOS.mkdir(exist_ok=True)
plt.style.use('seaborn-v0_8-whitegrid')
plt.rcParams.update({'figure.dpi':110,'font.size':10})
print({'python':platform.python_version(),'torch':str(torch.__version__),
       'numpy':np.__version__,'sklearn':sklearn.__version__,'dispositivo':str(DEVICE),
       'hilos_cpu':torch.get_num_threads(),'semilla':SEED})

def semilla(n=SEED):
    np.random.seed(n); torch.manual_seed(n)

def parametros(modelo):
    return sum(p.numel() for p in modelo.parameters())

def inicializar(modelo):
    # Conv y capas ocultas ReLU: He; salida lineal: Xavier explícito.
    for m in modelo.modules():
        if isinstance(m,(nn.Conv2d,nn.Linear)):
            nn.init.kaiming_normal_(m.weight,nonlinearity='relu')
            if m.bias is not None: nn.init.zeros_(m.bias)
    lineales=[m for m in modelo.modules() if isinstance(m,nn.Linear)]
    if lineales: nn.init.xavier_uniform_(lineales[-1].weight)
    return modelo.to(DEVICE)

def conjunto(x,y):
    return TensorDataset(torch.as_tensor(np.ascontiguousarray(x),dtype=torch.float32),
                         torch.as_tensor(np.asarray(y),dtype=torch.long))

def cargador(ds,lote=128,mezclar=False):
    return DataLoader(ds,batch_size=lote,shuffle=mezclar,num_workers=0,
                      generator=torch.Generator().manual_seed(SEED))

@torch.inference_mode()
def evaluar(modelo,ds,lote=128):
    modelo.eval(); perdidas=0.; aciertos=0; logits=[]; etiquetas=[]
    for x,y in cargador(ds,lote):
        x=x.to(DEVICE);y=y.to(DEVICE);z=modelo(x)
        perdidas+=F.cross_entropy(z,y,reduction='sum').item()
        aciertos+=(z.argmax(1)==y).sum().item()
        logits.append(z.cpu());etiquetas.append(y.cpu())
    z=torch.cat(logits);y=torch.cat(etiquetas)
    assert torch.isfinite(z).all(), 'Logits no finitos'
    return {'ce':perdidas/len(ds),'exactitud':aciertos/len(ds),
            'logits':z.numpy(),'y':y.numpy(),'probabilidades':z.softmax(1).numpy()}

def entrenar(modelo,train,val,epocas,lote=128,lr=1e-3,paciencia=None,nombre='modelo',
             modo_train=None,incluir_inicial=False):
    # El optimizador se construye DESPUÉS de fijar requires_grad.
    optimizador=torch.optim.Adam([p for p in modelo.parameters() if p.requires_grad],lr=lr)
    dl=cargador(train,lote,True); historial=[]; mejor=float('inf'); pesos=None; espera=0
    inicio=time.perf_counter();epoca_mejor=None
    if incluir_inicial:
        inicial=evaluar(modelo,val,lote); mejor=inicial['ce']
        pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=0
    for epoca in range(1,epocas+1):
        modelo.train()
        if modo_train is not None: modo_train(modelo)
        suma=0.;aciertos=0
        for x,y in dl:
            x=x.to(DEVICE);y=y.to(DEVICE)
            optimizador.zero_grad(set_to_none=True)
            z=modelo(x);perdida=F.cross_entropy(z,y)
            if not torch.isfinite(perdida): raise FloatingPointError(nombre+' pérdida no finita')
            perdida.backward();optimizador.step()
            suma+=perdida.item()*len(y);aciertos+=(z.argmax(1)==y).sum().item()
        # Comparar curvas en el MISMO modo eval y al cierre de cada época.
        tr=evaluar(modelo,train,lote);va=evaluar(modelo,val,lote)
        historial.append({'epoca':epoca,'ce_online':suma/len(train),
             'acc_online':aciertos/len(train),'ce_train':tr['ce'],'ce_val':va['ce'],
             'acc_train':tr['exactitud'],'acc_val':va['exactitud']})
        if va['ce']<mejor:
            mejor=va['ce'];pesos=copy.deepcopy(modelo.state_dict());epoca_mejor=epoca;espera=0
        else: espera+=1
        print(f"{nombre} {epoca}/{epocas}: CE val={va['ce']:.4f}, acc val={va['exactitud']:.4f}",flush=True)
        if paciencia is not None and espera>=paciencia: break
    modelo.load_state_dict(pesos);modelo.eval()
    h=pd.DataFrame(historial);h.to_csv(ARTEFACTOS/f'{nombre}-historial.csv',index=False)
    resumen={'modelo':nombre,'mejor_epoca':epoca_mejor,'epocas':len(h),'ce_val':mejor,
             'segundos':time.perf_counter()-inicio,'parametros':parametros(modelo),
             'entrenables':sum(p.numel() for p in modelo.parameters() if p.requires_grad)}
    (ARTEFACTOS/f'{nombre}-entrenamiento.json').write_text(json.dumps(resumen,indent=2),encoding='utf-8')
    return h,resumen

def curvas(h,titulo,mejor=None):
    fig,axes=plt.subplots(1,2,figsize=(11,3.8))
    for ax,a,b,t in [(axes[0],'ce_train','ce_val','Entropía cruzada'),
                     (axes[1],'acc_train','acc_val','Exactitud')]:
        ax.plot(h.epoca,h[a],'-o',label='Entrenamiento (eval)',ms=3)
        ax.plot(h.epoca,h[b],'-o',label='Validación',ms=3)
        if mejor is not None: ax.axvline(mejor,color='.4',ls='--',label=f'Checkpoint {mejor}')
        ax.set(xlabel='Época',ylabel=t);ax.legend(fontsize=8)
    fig.suptitle(titulo);fig.tight_layout();plt.show()

def lectura(h,res):
    e=res['mejor_epoca'];ultima=h.iloc[-1]
    texto=(f"**Lectura del experimento.** Se ejecutaron {len(h)} épocas; el checkpoint seleccionado "
           f"por CE de validación corresponde a la época {e}, con CE {res['ce_val']:.4f}. "
           f"Al cierre, la brecha de exactitud train−val es "
           f"{100*(ultima.acc_train-ultima.acc_val):+.2f} puntos porcentuales. "
           "Una brecha describe este conjunto y este presupuesto; no identifica por sí sola su causa. ")
    if e==0: texto+='El ajuste fino no mejoró la CE inicial: se conserva el punto de partida de la fase congelada.'
    elif e<len(h): texto+='La última época no es el modelo recuperado: prolongar este ensayo no redujo el mínimo de validación.'
    else: texto+='El mínimo está en el límite del presupuesto; no demuestra que más épocas mejorarían el resultado.'
    display(Markdown(texto))

def diagnostico(resultado,nombres,imagenes=None,titulo='Prueba'):
    y=resultado['y'];p=resultado['probabilidades'];pred=p.argmax(1);k=len(nombres)
    print(classification_report(y,pred,labels=np.arange(k),target_names=nombres,digits=4,zero_division=0))
    cm=confusion_matrix(y,pred,labels=np.arange(k));normal=cm/np.maximum(cm.sum(1,keepdims=True),1)
    fig,ax=plt.subplots(figsize=(7,5.5));im=ax.imshow(normal,vmin=0,vmax=1,cmap='Blues')
    ax.set_xticks(range(k),nombres,rotation=55,ha='right',fontsize=8)
    ax.set_yticks(range(k),nombres,fontsize=8);ax.set(xlabel='Predicho',ylabel='Real',title=titulo+' · proporción por clase')
    for i in range(k):
        for j in range(k):
            if cm[i,j]: ax.text(j,i,str(cm[i,j]),ha='center',va='center',fontsize=7,color='white' if normal[i,j]>.5 else 'black')
    fig.colorbar(im,ax=ax,label='Proporción de la clase real');fig.tight_layout();plt.show()
    err=np.flatnonzero(y!=pred)
    peor=int(np.argmin(np.diag(normal)))
    fuera=cm.copy();np.fill_diagonal(fuera,0);i,j=np.unravel_index(fuera.argmax(),fuera.shape)
    display(Markdown(f"**Decisión después de medir.** Exactitud {resultado['exactitud']:.2%}; "
        f"macro-F1 {f1_score(y,pred,average='macro'):.4f}; {len(err)} errores de {len(y)}. "
        f"El menor recall corresponde a **{nombres[peor]}** ({normal[peor,peor]:.2%}). "
        +(f"La confusión más frecuente es {nombres[i]} → {nombres[j]} ({fuera[i,j]} casos). " if len(err) else '')+
        "Esto orienta una revisión de etiquetas, cobertura y costes por clase; no autoriza volver a seleccionar con este test."))
    if imagenes is not None and len(err):
        confianza=p.max(1);orden=err[np.argsort(-confianza[err])][:8]
        fig,axes=plt.subplots(2,4,figsize=(11,5))
        for ax,idx in zip(axes.flat,orden):
            img=np.asarray(imagenes[idx]);img=np.moveaxis(img,0,-1) if img.ndim==3 and img.shape[0] in [1,3] else img
            ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
            ax.set_title(f'Real: {nombres[y[idx]]}\nPred: {nombres[pred[idx]]} · p={confianza[idx]:.2f}',fontsize=8);ax.axis('off')
        for ax in list(axes.flat)[len(orden):]: ax.axis('off')
        fig.suptitle('Errores de mayor probabilidad predicha · no es una medida de calibración')
        fig.tight_layout();plt.show()
    return cm

def guardar(modelo,fabrica,nombre,contrato,val):
    ruta=ARTEFACTOS/f'{nombre}.pt'
    estado={k:v.detach().cpu().clone() for k,v in modelo.state_dict().items()}
    torch.save({'state_dict':estado,'contrato':contrato,'torch':str(torch.__version__)},ruta)
    cargado=fabrica().to(DEVICE)
    paquete=torch.load(ruta,map_location=DEVICE,weights_only=True)
    cargado.load_state_dict(paquete['state_dict']);cargado.eval()
    # Comprobar recarga sobre validación; nunca seleccionar con prueba.
    muestra=next(iter(cargador(val,32)))[0].to(DEVICE);modelo.eval()
    with torch.inference_mode(): torch.testing.assert_close(modelo(muestra),cargado(muestra),rtol=1e-5,atol=1e-6)
    contrato=dict(contrato,sha256=hashlib.sha256(ruta.read_bytes()).hexdigest(),bytes=ruta.stat().st_size)
    (ARTEFACTOS/f'{nombre}-contrato.json').write_text(json.dumps(contrato,indent=2,ensure_ascii=False),encoding='utf-8')
    print('Recarga verificada:',ruta,'bytes:',ruta.stat().st_size)
    return cargado

def mnist(nombre='mnist'):
    cache=Path.home()/'.keras'/'datasets'
    if nombre=='mnist' and (cache/'mnist.npz').exists():
        with np.load(cache/'mnist.npz',allow_pickle=False) as d:
            return d['x_train'],d['y_train'],d['x_test'],d['y_test']
    from torchvision.datasets import MNIST,FashionMNIST
    clase=MNIST if nombre=='mnist' else FashionMNIST
    # Leer la caché histórica IDX sin importar TensorFlow.
    if nombre=='fashion' and (cache/'fashion-mnist'/'train-images-idx3-ubyte.gz').exists():
        def idx(f,imagenes):
            with gzip.open(cache/'fashion-mnist'/f,'rb') as h: b=h.read()
            magic,n=struct.unpack('>II',b[:8]);assert magic==(2051 if imagenes else 2049)
            return np.frombuffer(b,dtype=np.uint8,offset=16 if imagenes else 8).reshape((n,28,28) if imagenes else (n,)).copy()
        return (idx('train-images-idx3-ubyte.gz',True),idx('train-labels-idx1-ubyte.gz',False),
                idx('t10k-images-idx3-ubyte.gz',True),idx('t10k-labels-idx1-ubyte.gz',False))
    a=clase(str(Path.home()/'.cache'/'bit-datasets'),train=True,download=True)
    b=clase(str(Path.home()/'.cache'/'bit-datasets'),train=False,download=True)
    return a.data.numpy(),a.targets.numpy(),b.data.numpy(),b.targets.numpy()

def galeria(x,y,nombres,titulo):
    fig,axes=plt.subplots(2,5,figsize=(11,4.5))
    for i,ax in enumerate(axes.flat):
        j=np.flatnonzero(y==i%len(nombres))[0];img=x[j]
        if img.ndim==3 and img.shape[0] in [1,3]: img=np.moveaxis(img,0,-1)
        ax.imshow(img.squeeze(),cmap='gray' if img.squeeze().ndim==2 else None)
        ax.set_title(nombres[i%len(nombres)],fontsize=9);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
{'python': '3.13.9', 'torch': '2.14.1+cpu', 'numpy': '2.3.5', 'sklearn': '1.8.0', 'dispositivo': 'cpu', 'hilos_cpu': 2, 'semilla': 42}
from sklearn.datasets import load_digits
d=load_digits();x01=np.kron(d.images,np.ones((2,2))).astype(np.float32)[:,None]/16;x=x01*2-1;y=d.target
orden=np.random.default_rng(0).permutation(len(x));corte=int(.9*len(x));dev=orden[:corte];ite=orden[corte:]
orden_dev=np.random.default_rng(42).permutation(dev);cv=int(.85*len(dev));itr=orden_dev[:cv];iva=orden_dev[cv:]
assert not(set(itr)&set(iva) or set(itr)&set(ite) or set(iva)&set(ite))
np.savez_compressed(ARTEFACTOS/'particiones.npz',train=itr,val=iva,test=ite)
T=40;betas=np.linspace(1e-4,.2,T).astype(np.float32);alphas=1-betas;abar=np.cumprod(alphas).astype(np.float32)
fig,axes=plt.subplots(1,2,figsize=(10,3.5));axes[0].plot(betas);axes[0].set(xlabel='Índice t',ylabel='Beta');axes[1].plot(abar);axes[1].set(xlabel='Índice t',ylabel='Alpha acumulada');fig.tight_layout();plt.show()
print('Alpha acumulada inicial/final:',abar[0],abar[-1],'· amplitud de señal final:',np.sqrt(abar[-1]))

Alpha acumulada inicial/final: 0.9999 0.013522105 · amplitud de señal final: 0.11628459

28.2 2. Corrupción y comprobación algebraica

\[x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon.\]

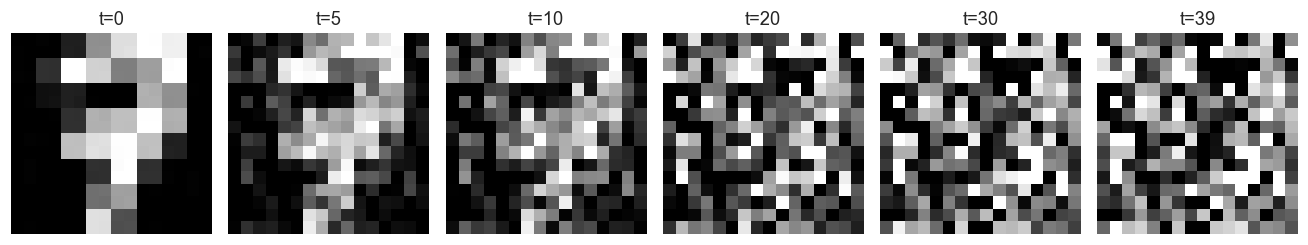
Alpha acumulada pondera potencia bajo el modelo probabilístico; la amplitud de señal se multiplica por su raíz. El índice 0 ya aplica la primera beta: no es una observación exactamente limpia. Conocer el ruido real permite despejar x₀, pero eso sólo comprueba álgebra, no la capacidad de un denoiser ni de un sampler.

El nivel terminal conserva algo de señal: empezar generación desde una normal estándar es una aproximación a ese extremo. No se afirma que el schedule finito produzca exactamente el prior. La galería recorta sólo para mostrar intensidades; los tensores ruidosos no se acotan artificialmente durante entrenamiento.

def corromper(xx,t,ruido):
    a=abar[np.asarray(t)].reshape(-1,1,1,1);return np.sqrt(a)*xx+np.sqrt(1-a)*ruido
rng=np.random.default_rng(2800);ejemplo=x[itr[3:4]];eps=rng.normal(size=ejemplo.shape).astype(np.float32)
fig,axes=plt.subplots(1,6,figsize=(12,2.5))
for ax,t in zip(axes,[0,5,10,20,30,39]):ax.imshow(np.clip((corromper(ejemplo,[t],eps)[0,0]+1)/2,0,1),cmap='gray',vmin=0,vmax=1);ax.set_title(f't={t}');ax.axis('off')
fig.tight_layout();plt.show()
t=25;xt=corromper(ejemplo,[t],eps);rec=(xt-np.sqrt(1-abar[t])*eps)/np.sqrt(abar[t])
np.testing.assert_allclose(rec,ejemplo,atol=1e-6);print('Inversión con ruido conocido · error máximo:',float(np.abs(rec-ejemplo).max()))

Inversión con ruido conocido · error máximo: 1.7881393432617188e-07

28.2.1 De la cadena de ruido a la fórmula directa

Un paso de corrupción usa \(x_t=\sqrt{\alpha_t}x_{t-1}+\sqrt{1-\alpha_t}\epsilon_t\), con ruidos normales independientes y \(\alpha_t=1-\beta_t\). Al sustituir pasos anteriores, el coeficiente de la señal se multiplica; las varianzas de los términos independientes se suman. El resultado es \(q(x_t|x_0)=N(\sqrt{\bar\alpha_t}x_0,(1-\bar\alpha_t)I)\), donde \(\bar\alpha_t=\prod_{s=1}^t\alpha_s\). Esta identidad permite generar un nivel arbitrario sin simular todos los pasos anteriores.

Por ejemplo, con \(x_0=(1,-1)\), \(\bar\alpha_t=0.64\) y \(\epsilon=(0.5,-0.5)\), obtenemos \(x_t=(1.1,-1.1)\). Si conocemos el ruido exacto, podemos despejar la señal. Durante generación no conocemos ni la imagen original ni ese ruido: el modelo debe estimarlo a partir de la observación ruidosa y el tiempo.

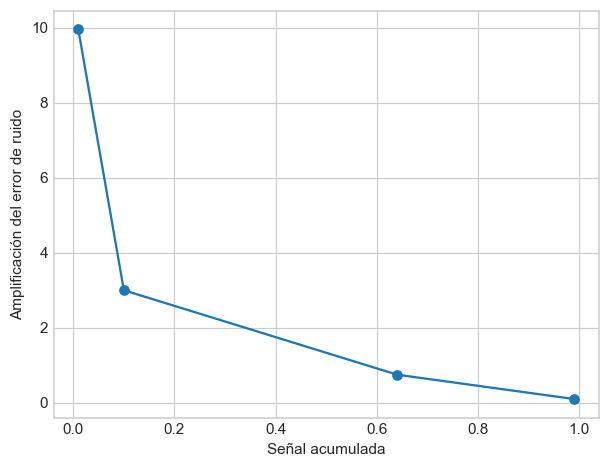
Con error de predicción \(\delta=\widehat\epsilon-\epsilon\), el error de señal reconstruida es \(-\sqrt{(1-\bar\alpha_t)/\bar\alpha_t}\,\delta\). La misma equivocación al predecir ruido se amplifica más cuando queda poca señal. Por eso una MSE agregada puede ocultar dificultades en los extremos del schedule.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_difusion_error():
    x0=np.array([1.,-1.]);eps=np.array([.5,-.5]);delta=np.array([.1,-.1])
    filas=[]
    for abar in [.99,.64,.1,.01]:
        xt=np.sqrt(abar)*x0+np.sqrt(1-abar)*eps
        recuperada=(xt-np.sqrt(1-abar)*eps)/np.sqrt(abar)
        estimada=(xt-np.sqrt(1-abar)*(eps+delta))/np.sqrt(abar)
        amplificacion=np.sqrt((1-abar)/abar)
        assert np.allclose(recuperada,x0)
        assert np.allclose(estimada-x0,-amplificacion*delta)
        filas.append([abar,amplificacion,np.linalg.norm(estimada-x0)])
    display(pd.DataFrame(filas,columns=['alpha acumulada','amplificacion','error de reconstruccion']))
    plt.plot([r[0] for r in filas],[r[1] for r in filas],'o-');plt.xlabel('Señal acumulada');plt.ylabel('Amplificación del error de ruido');plt.show()
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_difusion_error()
alpha acumulada amplificacion error de reconstruccion
0 0.99 0.100504 0.014213
1 0.64 0.750000 0.106066
2 0.10 3.000000 0.424264
3 0.01 9.949874 1.407125

Minimizar error cuadrático de ruido conduce idealmente a su esperanza condicional dado \((x_t,t)\), no a recuperar cada ruido individual con certeza. Varias imágenes y ruidos pueden dar observaciones parecidas. El muestreador convierte predicciones sucesivas en una trayectoria; su discretización y el error del modelo son dos fuentes distintas de fallo.

En DDIM determinista, una transición a un nivel anterior \(s\) combina \(\widehat x_0\) y el ruido predicho: \(x_s=\sqrt{\bar\alpha_s}\widehat x_0+\sqrt{1-\bar\alpha_s}\widehat\epsilon\). Los dos coeficientes deben corresponder al destino de ese paso. Saltar índices manteniendo la fórmula de un paso contiguo cambia la dinámica. Un control con ruido conocido comprueba el álgebra, pero no demuestra calidad del denoiser aprendido.

28.3 3. Denoiser condicionado al tiempo

Conservamos la U-Net docente: canales 24/48/64, dos pooling, interpolación y concatenaciones de salto. Se añade t/40 como canal espacial constante; no es un embedding sinusoidal ni un modelo de texto. La salida predice ruido sin sigmoid: el ruido gaussiano no está limitado a [0,1].

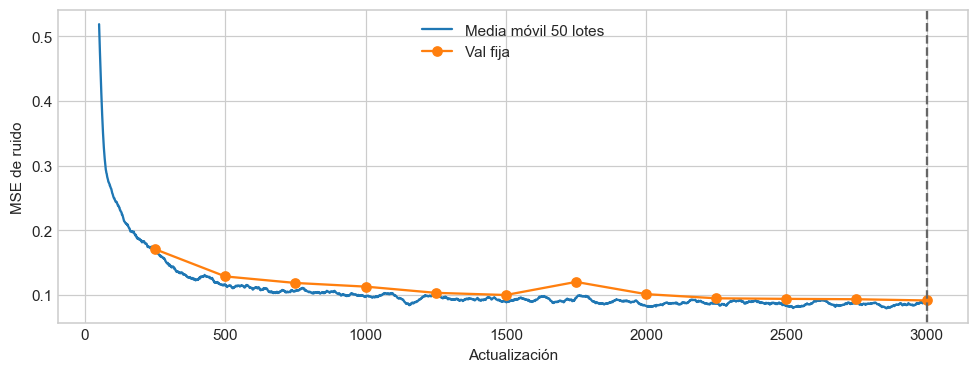
Cada lote vuelve a sortear originales, tiempos y ruido. Registramos MSE del lote, sin confundirlo con un acumulador interno de la biblioteca. Cada 250 pasos evaluamos una reserva con ruido y tiempos fijos, y restauramos su mínimo. Una reducción de este MSE no certifica fidelidad ni cobertura de las muestras finales.

class Denoiser(nn.Module):
    def __init__(self):
        super().__init__();self.e1=nn.Conv2d(2,24,3,padding=1);self.e2=nn.Conv2d(24,48,3,padding=1);self.cuello=nn.Conv2d(48,64,3,padding=1)
        self.d2=nn.Conv2d(112,48,3,padding=1);self.d1=nn.Conv2d(72,24,3,padding=1);self.salida=nn.Conv2d(24,1,1)
    def forward(self,x,t):
        canal=t.reshape(-1,1,1,1).expand(-1,1,16,16);a=F.relu(self.e1(torch.cat([x,canal],1)));b=F.relu(self.e2(F.max_pool2d(a,2)));z=F.relu(self.cuello(F.max_pool2d(b,2)))
        z=F.relu(self.d2(torch.cat([F.interpolate(z,size=(8,8),mode='nearest'),b],1)))
        z=F.relu(self.d1(torch.cat([F.interpolate(z,size=(16,16),mode='nearest'),a],1)))
        return self.salida(z)
def lote(ids,rng,n=64,tmin=0,tmax=40):
    indices=rng.choice(ids,n,replace=True);t=rng.integers(tmin,tmax,n);ruido=rng.normal(size=(n,1,16,16)).astype(np.float32)
    return corromper(x[indices],t,ruido),t.astype(np.float32)/T,ruido
vx,vt,ve=lote(iva,np.random.default_rng(2801),256)
semilla();denoiser=Denoiser().to(DEVICE);opt=torch.optim.Adam(denoiser.parameters(),lr=.001);rng=np.random.default_rng(SEED);hist=[];validacion=[];mejor=float('inf');inicio=time.perf_counter()
@torch.inference_mode()
def predecir_ruido(xx,tt):
    denoiser.eval();sal=[]
    for i in range(0,len(xx),64):sal.append(denoiser(torch.from_numpy(xx[i:i+64]).to(DEVICE),torch.from_numpy(tt[i:i+64]).to(DEVICE)).cpu().numpy())
    return np.concatenate(sal)
for paso in range(1,3001):
    xx,tt,ee=lote(itr,rng);denoiser.train();opt.zero_grad(set_to_none=True)
    pred=denoiser(torch.from_numpy(xx).to(DEVICE),torch.from_numpy(tt).to(DEVICE));loss=F.mse_loss(pred,torch.from_numpy(ee).to(DEVICE))
    if not torch.isfinite(loss):raise FloatingPointError('Denoiser no finito')
    loss.backward();opt.step();hist.append(float(loss.detach()))
    if paso%250==0:
        valor=float(np.mean((predecir_ruido(vx,vt)-ve)**2));validacion.append({'paso':paso,'mse_val_fija':valor})
        if valor<mejor:mejor=valor;estado=copy.deepcopy(denoiser.state_dict());paso_mejor=paso
        print('Difusión',paso,'MSE val',round(valor,5),flush=True)
denoiser.load_state_dict(estado);denoiser.eval();segundos=time.perf_counter()-inicio
pd.DataFrame({'paso':np.arange(1,3001),'mse_lote':hist}).to_csv(ARTEFACTOS/'denoiser-historial.csv',index=False)
v=pd.DataFrame(validacion);v.to_csv(ARTEFACTOS/'denoiser-validacion.csv',index=False)
fig,ax=plt.subplots(figsize=(9,3.5));ax.plot(np.arange(50,3001),np.convolve(hist,np.ones(50)/50,mode='valid'),label='Media móvil 50 lotes');ax.plot(v.paso,v.mse_val_fija,'-o',label='Val fija');ax.axvline(paso_mejor,ls='--',color='.4');ax.set(xlabel='Actualización',ylabel='MSE de ruido');ax.legend();fig.tight_layout();plt.show()
Difusión 250 MSE val 0.17041
Difusión 500 MSE val 0.12833
Difusión 750 MSE val 0.11823
Difusión 1000 MSE val 0.11256
Difusión 1250 MSE val 0.10294
Difusión 1500 MSE val 0.09958
Difusión 1750 MSE val 0.11985
Difusión 2000 MSE val 0.10093
Difusión 2250 MSE val 0.09447
Difusión 2500 MSE val 0.09363
Difusión 2750 MSE val 0.09302
Difusión 3000 MSE val 0.09115

28.4 4. Error según nivel de ruido

Los buckets separan t=0…9,10…19,20…29,30…39. Cada medición extrae 300 corrupciones con reemplazo del conjunto indicado: no son 300 imágenes originales independientes si la reserva es menor. Se incluye el baseline que predice ruido cero. Los niveles de t tienen distinta dificultad y menor error a ruido alto no implica que los detalles finos sean fáciles de generar.

filas=[]
for nombre,ids in [('Train',itr),('Test',ite)]:
    rng=np.random.default_rng(2810 if nombre=='Train' else 2811)
    for a,b in [(0,10),(10,20),(20,30),(30,40)]:
        xx,tt,ee=lote(ids,rng,300,a,b);p=predecir_ruido(xx,tt)
        filas.append({'particion':nombre,'t_min':a,'t_max_exclusivo':b,'mse_red':float(np.mean((p-ee)**2)),'mse_ruido_cero':float(np.mean(ee**2))})
tabla=pd.DataFrame(filas);display(tabla);tabla.to_csv(ARTEFACTOS/'ruido-buckets.csv',index=False)
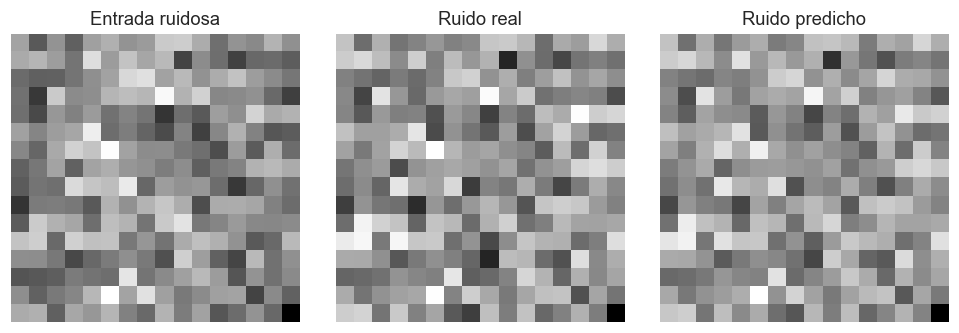
xx,tt,ee=lote(ite,np.random.default_rng(2812),1,20,21);p=predecir_ruido(xx,tt)
fig,axes=plt.subplots(1,3,figsize=(9,3))
for ax,im,titulo in zip(axes,[xx[0,0],ee[0,0],p[0,0]],['Entrada ruidosa','Ruido real','Ruido predicho']):ax.imshow(im,cmap='gray');ax.set_title(titulo);ax.axis('off')
fig.tight_layout();plt.show()
particion t_min t_max_exclusivo mse_red mse_ruido_cero
0 Train 0 10 0.192434 0.998576
1 Train 10 20 0.071446 1.002093
2 Train 20 30 0.040554 1.008471
3 Train 30 40 0.012381 0.999548
4 Test 0 10 0.196295 0.991823
5 Test 10 20 0.071729 1.001545
6 Test 20 30 0.039882 0.995748
7 Test 30 40 0.013013 1.006823

28.5 5. DDIM con transiciones consistentes

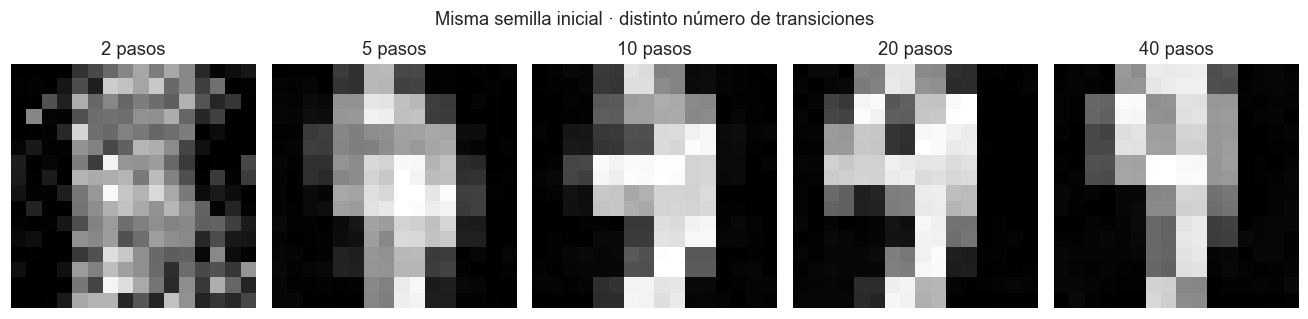
El sampler elige una secuencia de índices descendentes. Para pasar de t a s utiliza sus propias alphas acumuladas, no repite una transición de un paso como si se hubieran visitado los índices omitidos. Con \(a=\bar\alpha_t\) y \(b=\bar\alpha_s\):

\[\sigma=\eta\sqrt{\frac{1-b}{1-a}(1-a/b)},\qquad x_s=\sqrt b\,\hat x_0+\sqrt{1-b-\sigma^2}\,\hat\epsilon+\sigma z.\]

El extremo final usa alpha acumulada uno. Se recorta la estimación de x₀ a [−1,1] y se declara esa decisión. Eta cero elimina el ruido nuevo de las transiciones; repetir el mismo inicio debe reproducir el resultado bajo operaciones deterministas. No demuestra mejor fidelidad ni convierte difusión en flow matching.

def ddim(n,pasos=40,seed=0,eta=1):
    assert 1<=pasos<=40 and 0<=eta<=1
    rng=np.random.default_rng(seed);xx=rng.normal(size=(n,1,16,16)).astype(np.float32);traza=[xx[0,0].copy()]
    tiempos=np.linspace(39,0,pasos).round().astype(int);assert len(np.unique(tiempos))==pasos
    for j,t in enumerate(tiempos):
        siguiente=int(tiempos[j+1]) if j+1<len(tiempos) else -1
        a=float(abar[t]);b=float(abar[siguiente]) if siguiente>=0 else 1.;assert b>=a
        eps=predecir_ruido(xx,np.full(n,t/40,dtype=np.float32));x0=np.clip((xx-np.sqrt(1-a)*eps)/np.sqrt(a),-1,1)
        sigma=eta*np.sqrt(max((1-b)/(1-a)*(1-a/b),0));direccion=np.sqrt(max(1-b-sigma*sigma,0))*eps
        xx=(np.sqrt(b)*x0+direccion+sigma*rng.normal(size=xx.shape)).astype(np.float32);traza.append(xx[0,0].copy())
    assert np.isfinite(xx).all();return xx,np.stack(traza)
def tira(imgs,titulo):
    fig,axes=plt.subplots(1,len(imgs),figsize=(12,2.4))
    for ax,im in zip(np.atleast_1d(axes),imgs):ax.imshow(np.clip((im+1)/2,0,1),cmap='gray',vmin=0,vmax=1);ax.axis('off')
    fig.suptitle(titulo);fig.tight_layout();plt.show()
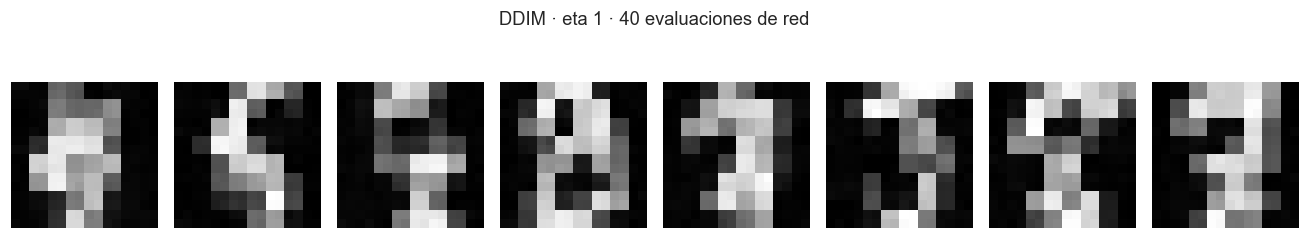
generadas,traza=ddim(8);tira(generadas[:,0],'DDIM · eta 1 · 40 evaluaciones de red')
_,camino=ddim(1,seed=1);tira(camino[np.linspace(0,len(camino)-1,8).astype(int)],'Estados de una cadena · inicio y transiciones')
fig,axes=plt.subplots(1,5,figsize=(12,3));costes=[]
for ax,pasos in zip(axes,[2,5,10,20,40]):
    inicio=time.perf_counter();im,_=ddim(1,pasos,7,1);costes.append({'pasos':pasos,'evaluaciones_red':pasos,'segundos':time.perf_counter()-inicio})
    ax.imshow((im[0,0]+1)/2,cmap='gray',vmin=0,vmax=1);ax.set_title(f'{pasos} pasos');ax.axis('off')
fig.suptitle('Misma semilla inicial · distinto número de transiciones');fig.tight_layout();plt.show()
a,_=ddim(4,20,10,0);b,_=ddim(4,20,10,0);np.testing.assert_allclose(a,b,atol=1e-6)
pd.DataFrame(costes).to_csv(ARTEFACTOS/'coste-muestreo.csv',index=False);print('DDIM eta0 repetido · diferencia máxima:',float(np.abs(a-b).max()))

DDIM eta0 repetido · diferencia máxima: 0.0

28.6 6. Juez auxiliar: diagnóstico limitado

Conservamos el CNN 16/32 y quince épocas, con checkpoint por validación separada. Se informa su exactitud sobre reales reservados antes de usar su confianza en muestras. Un juez débil o fuera de distribución puede ser seguro sobre imágenes irreales. Su confianza no es FID ni un techo de calidad; tampoco se compara directamente con la del capítulo VAE, que usa otros datos de ajuste y otro modelo.

Las galerías, número de evaluaciones y error de ruido responden preguntas diferentes. No se inventa una curva de “calidad generativa” a partir de esos números.

def crear_juez():return nn.Sequential(nn.Conv2d(1,16,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Conv2d(16,32,3,padding=1),nn.ReLU(),nn.AdaptiveAvgPool2d(1),nn.Flatten(),nn.Linear(32,10))
semilla();juez=inicializar(crear_juez());hj,rj=entrenar(juez,conjunto(x01[itr],y[itr]),conjunto(x01[iva],y[iva]),15,lote=32,nombre='juez')
real=evaluar(juez,conjunto(x01[ite],y[ite]));print('Exactitud juez en reales reservados:',real['exactitud'])
falsas,_=ddim(100,40,12,1);rf=evaluar(juez,conjunto((falsas+1)/2,np.zeros(100,dtype=int)))
print('Confianza media reales/generadas:',real['probabilidades'].max(1).mean(),rf['probabilidades'].max(1).mean())
juez 1/15: CE val=2.2875, acc val=0.1481
juez 2/15: CE val=2.2626, acc val=0.1975
juez 3/15: CE val=2.2280, acc val=0.3045
juez 4/15: CE val=2.1996, acc val=0.2510
juez 5/15: CE val=2.1690, acc val=0.2387
juez 6/15: CE val=2.0957, acc val=0.5885
juez 7/15: CE val=2.0256, acc val=0.4156
juez 8/15: CE val=1.9758, acc val=0.4074
juez 9/15: CE val=1.8632, acc val=0.4321
juez 10/15: CE val=1.7810, acc val=0.6008
juez 11/15: CE val=1.6741, acc val=0.6337
juez 12/15: CE val=1.6044, acc val=0.6091
juez 13/15: CE val=1.5267, acc val=0.6461
juez 14/15: CE val=1.4215, acc val=0.7531
juez 15/15: CE val=1.3919, acc val=0.6379
Exactitud juez en reales reservados: 0.7111111111111111
Confianza media reales/generadas: 0.3049537 0.23177993

28.7 7. Flow matching en dos dimensiones

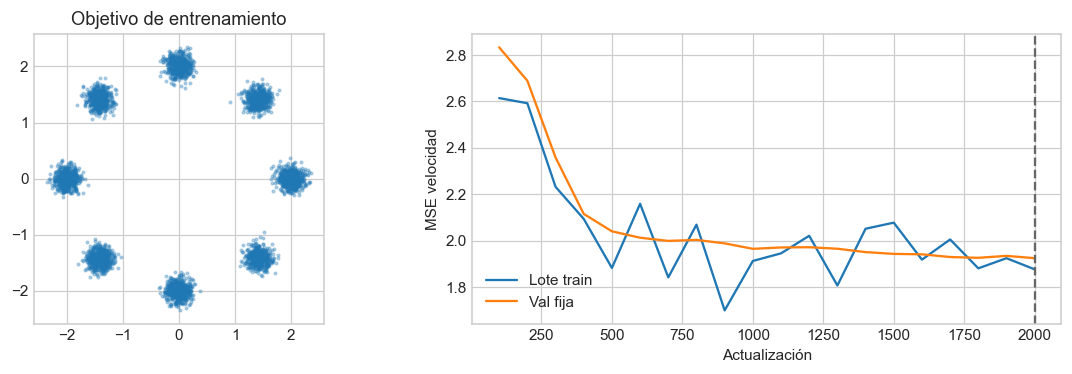
El segundo dominio tiene ocho gaussianas de centro conocido. Se conservan 4 096 puntos train,1 024 val y1 024 test, red tanh 3→64→64→2 y 2 000 actualizaciones, lote 256. Con extremos independientes \(x_0\sim N(0,I)\) y \(x_1\) de datos, usamos \(x_t=(1-t)x_0+tx_1\) y objetivo \(u=x_1-x_0\).

La regresión aprende la velocidad media condicionada a posición y tiempo, no una ruta única por ejemplo. La validación utiliza pares fijos y selecciona MSE de velocidad cada cien pasos. Para generar integramos Euler de 0 a1. La aleatoriedad se encuentra en el punto inicial; esa integración posterior es determinista.

rng=np.random.default_rng(2801);angulos=np.arange(8)*2*np.pi/8;centros=2*np.column_stack([np.cos(angulos),np.sin(angulos)]).astype(np.float32)
def puntos(n,rng):return centros[rng.integers(0,8,n)]+rng.normal(0,.12,(n,2)).astype(np.float32)
trainfm=puntos(4096,rng);valfm=puntos(1024,rng);testfm=puntos(1024,rng)
def pares(destino,rng,n=None):
    fin=destino if n is None else destino[rng.integers(0,len(destino),n)]
    origen=rng.normal(size=fin.shape).astype(np.float32);t=rng.uniform(0,1,(len(fin),1)).astype(np.float32)
    return np.concatenate([(1-t)*origen+t*fin,t],1),fin-origen
semilla(2802);velocidad=nn.Sequential(nn.Linear(3,64),nn.Tanh(),nn.Linear(64,64),nn.Tanh(),nn.Linear(64,2)).to(DEVICE);opt=torch.optim.Adam(velocidad.parameters(),lr=.001)
entrada_val,objetivo_val=pares(valfm,np.random.default_rng(2803));curvas=[];mejor_fm=float('inf')
for paso in range(1,2001):
    xx,yy=pares(trainfm,rng,256);velocidad.train();opt.zero_grad(set_to_none=True);p=velocidad(torch.from_numpy(xx).to(DEVICE));loss=F.mse_loss(p,torch.from_numpy(yy).to(DEVICE));loss.backward();opt.step()
    if paso%100==0:
        velocidad.eval()
        with torch.inference_mode():valor=float(F.mse_loss(velocidad(torch.from_numpy(entrada_val).to(DEVICE)),torch.from_numpy(objetivo_val).to(DEVICE)))
        curvas.append({'paso':paso,'mse_lote':float(loss.detach()),'mse_val_fija':valor})
        if valor<mejor_fm:mejor_fm=valor;pesos_fm=copy.deepcopy(velocidad.state_dict());paso_fm=paso
velocidad.load_state_dict(pesos_fm);velocidad.eval();curvas=pd.DataFrame(curvas);curvas.to_csv(ARTEFACTOS/'flow-historial.csv',index=False)
fig,axes=plt.subplots(1,2,figsize=(11,3.5));axes[0].scatter(trainfm[:,0],trainfm[:,1],s=3,alpha=.3);axes[0].set(title='Objetivo de entrenamiento',aspect='equal')
axes[1].plot(curvas.paso,curvas.mse_lote,label='Lote train');axes[1].plot(curvas.paso,curvas.mse_val_fija,label='Val fija');axes[1].axvline(paso_fm,ls='--',color='.4');axes[1].set(xlabel='Actualización',ylabel='MSE velocidad');axes[1].legend();fig.tight_layout();plt.show()
28.7.1 Una trayectoria de flow matching que sí podemos resolver

En el laboratorio se aprende una velocidad. Para entender qué significa, consideremos primero una dimensión: \(x_0\sim N(0,1)\) y \(x_1\sim N(m,1)\), independientes. La interpolación de entrenamiento es \(x_t=(1-t)x_0+tx_1\) y su objetivo individual es \(u=x_1-x_0\). La red no recibe la pareja completa: aprende la velocidad condicional \(v(x,t)=E[u|x_t=x]\).

En este caso, \(E[x_t]=tm\), \(a(t)=Var(x_t)=(1-t)^2+t^2\) y \(Cov(u,x_t)=2t-1\). La regresión gaussiana da

\[v(x,t)=m+\frac{2t-1}{a(t)}(x-tm).\]

La solución de la ecuación diferencial que parte de un valor \(z\) es \(x(t)=tm+\sqrt{a(t)}z\). Al final vale \(m+z\): se conserva la varianza inicial y se desplaza la media. Las trayectorias de la ODE no son necesariamente las parejas rectas individuales usadas para entrenar; reproducen sus distribuciones intermedias mediante una velocidad condicional.

Código
import numpy as np
import sklearn
import pandas as pd
import matplotlib.pyplot as plt
import torch
from IPython.display import display
def doc_flujo_integracion():
    rng=np.random.default_rng(28);z=rng.normal(size=1024);m=2.
    def velocidad(x,t):
        a=(1-t)**2+t*t
        return m+(2*t-1)/a*(x-t*m)
    filas=[];fig,axes=plt.subplots(1,2,figsize=(10,3))
    for pasos in [4,16,64]:
        x=z.copy();tray=[x[:5].copy()]
        for j in range(pasos):
            x=x+velocidad(x,j/pasos)/pasos;tray.append(x[:5].copy())
        error=np.sqrt(np.mean((x-(m+z))**2))
        filas.append([pasos,x.mean(),x.std(),error])
        axes[0].plot(np.linspace(0,1,pasos+1),np.array(tray)[:,0],label=f'Euler {pasos}')
    t=np.linspace(0,1,200)
    axes[0].plot(t,t*m+np.sqrt((1-t)**2+t*t)*z[0],'k--',label='Solución exacta')
    axes[0].set_xlabel('Tiempo');axes[0].set_ylabel('Una trayectoria');axes[0].legend()
    axes[1].plot([r[0] for r in filas],[r[3] for r in filas],'o-');axes[1].set_xlabel('Pasos de Euler');axes[1].set_ylabel('RMSE frente a solución exacta')
    plt.tight_layout();plt.show()
    display(pd.DataFrame(filas,columns=['pasos','media final','desviacion final','error de integracion']))
    assert filas[-1][3]<filas[0][3]
with torch.random.fork_rng(devices=[]):
    torch.random.default_generator.manual_seed(15102026)
    doc_flujo_integracion()

pasos media final desviacion final error de integracion
0 4 1.994742 0.717876 0.279182
1 16 1.993261 0.919983 0.077070
2 64 1.992842 0.977224 0.019828

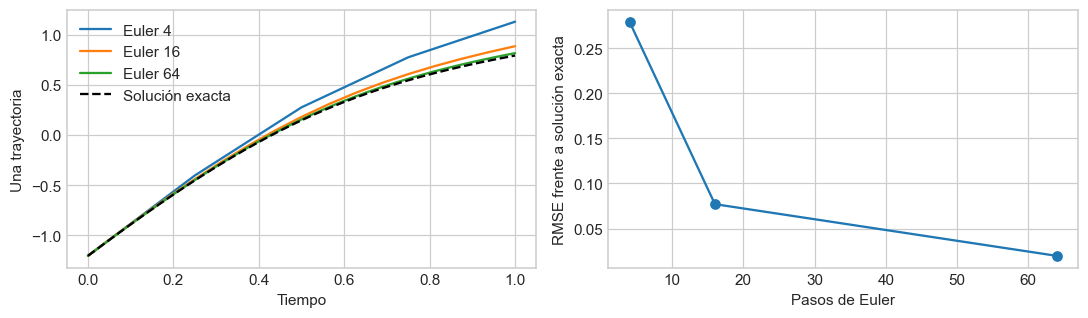
En el caso exacto, pasar de 4 a 16 y 64 pasos reduce el RMSE aproximadamente de 0.2792 a 0.0771 y 0.0198. La desviación final pasa de 0.7179 a 0.9200 y 0.9772: Euler con pocos pasos contrae demasiado la distribución. La media ya está cerca de dos, de modo que observar solo la media ocultaría ese defecto. Como la velocidad no se aprendió, estos cambios se atribuyen al integrador.

Aquí la velocidad es exacta; al aumentar pasos aislamos el error de integración. En el modelo aprendido de ocho grupos también existe error del campo. Si 16 y 64 pasos producen una cobertura semejante y deficiente, seguir aumentando pasos puede gastar cómputo sin corregir esa velocidad. Si las trayectorias cambian mucho al refinar la malla, la integración merece atención antes de modificar la red.

Para comparar difusión y flow matching, mantenga claras las unidades de trabajo. Una evaluación del campo no equivale automáticamente al tiempo de otra arquitectura. Registre llamadas a la red y tiempo en el mismo equipo, además de cobertura y calidad. En ambos métodos, una pérdida de entrenamiento menor puede coexistir con muestras pobres; interprete la relación entre objetivo local, trayectoria numérica y distribución final.

28.8 8. Integración, cobertura y distancia proyectada

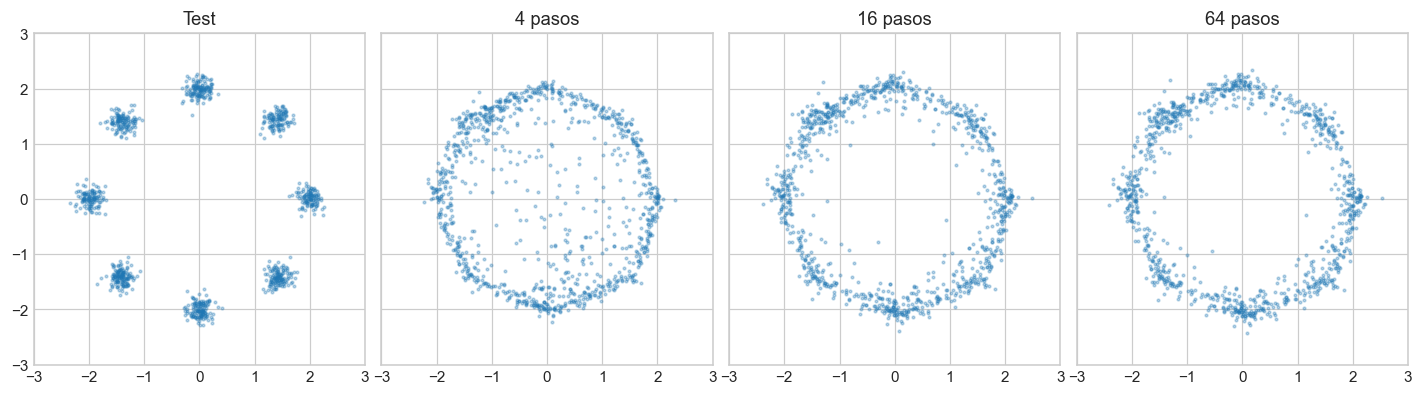
Prefijamos 4/16/64 pasos y el mismo ruido inicial de 1 024 puntos. El procedimiento final es 64 pasos, sin elegirlo por test. La distancia proyectada promedia diferencias entre cuantiles empíricos en 64 direcciones unitarias fijas, con tamaños de muestra iguales. No caracteriza toda distribución posible ni es una métrica de imágenes.

Medimos también fracción a distancia ≤0,5 de algún centro y modos con al menos diez muestras cercanas. Los centros provienen del simulador; no son un detector universal de modos desconocidos. Cubrir ocho centros puede coexistir con demasiados puntos intermedios.

@torch.inference_mode()
def integrar(origen,pasos):
    xx=torch.from_numpy(origen.copy()).to(DEVICE);traza=[xx.cpu().numpy().copy()];dt=1/pasos
    for j in range(pasos):xx=xx+dt*velocidad(torch.cat([xx,torch.full((len(xx),1),j*dt,device=DEVICE)],1));traza.append(xx.cpu().numpy().copy())
    return xx.cpu().numpy(),np.stack(traza)
base=np.random.default_rng(2804).normal(size=(1024,2)).astype(np.float32);direcciones=np.random.default_rng(2805).normal(size=(64,2));direcciones/=np.linalg.norm(direcciones,axis=1,keepdims=True)
def metricas(xx):
    dist=np.linalg.norm(xx[:,None]-centros[None],axis=2);cerca=dist.min(1)<=.5;cuentas=np.bincount(dist.argmin(1)[cerca],minlength=8)
    sw=np.abs(np.sort(xx@direcciones.T,axis=0)-np.sort(testfm@direcciones.T,axis=0)).mean()
    return {'wasserstein_proyectada':float(sw),'fraccion_cerca':float(cerca.mean()),'modos_con_10':int((cuentas>=10).sum())}
filas=[{'metodo':'Gaussiana','pasos':0,**metricas(base)}];muestras={};trazas={}
for pasos in [4,16,64]:
    m,tr=integrar(base,pasos);muestras[pasos]=m;trazas[pasos]=tr;filas.append({'metodo':'Flow matching Euler','pasos':pasos,**metricas(m)})
tfm=pd.DataFrame(filas);display(tfm);tfm.to_csv(ARTEFACTOS/'resultados-flow-matching.csv',index=False)
fig,axes=plt.subplots(1,4,figsize=(13,3.5),sharex=True,sharey=True)
for ax,xx,titulo in zip(axes,[testfm,muestras[4],muestras[16],muestras[64]],['Test','4 pasos','16 pasos','64 pasos']):ax.scatter(xx[:,0],xx[:,1],s=3,alpha=.3);ax.set(title=titulo,aspect='equal',xlim=(-3,3),ylim=(-3,3))
fig.tight_layout();plt.show()
fig,ax=plt.subplots(figsize=(6,5))
for j in range(12):ax.plot(trazas[64][:,j,0],trazas[64][:,j,1],alpha=.7)
ax.scatter(centros[:,0],centros[:,1],marker='x',color='black');ax.set(title='Doce trayectorias del campo aprendido',aspect='equal');fig.tight_layout();plt.show()
metodo pasos wasserstein_proyectada fraccion_cerca modos_con_10
0 Gaussiana 0 0.487531 0.137695 8
1 Flow matching Euler 4 0.173193 0.586914 8
2 Flow matching Euler 16 0.121016 0.741211 8
3 Flow matching Euler 64 0.118111 0.765625 8

28.9 9. Guardar y comprobar los dos modelos

El denoiser necesita el schedule y la escala de imagen; el campo de velocidad necesita tiempo continuo y el integrador prefijado. Quitar ruido a DDIM no convierte un predictor de epsilon en ese campo de velocidades. Guardamos contratos separados y verificamos la recarga de ambas funciones sobre entradas de validación.

torch.save({'state_dict':{k:v.cpu().clone() for k,v in denoiser.state_dict().items()},'T':40,'betas':betas.tolist()},ARTEFACTOS/'denoiser.pt')
nuevo=Denoiser().to(DEVICE);nuevo.load_state_dict(torch.load(ARTEFACTOS/'denoiser.pt',map_location=DEVICE,weights_only=True)['state_dict']);nuevo.eval()
with torch.inference_mode():torch.testing.assert_close(nuevo(torch.from_numpy(vx[:8]).to(DEVICE),torch.from_numpy(vt[:8]).to(DEVICE)),denoiser(torch.from_numpy(vx[:8]).to(DEVICE),torch.from_numpy(vt[:8]).to(DEVICE)))
torch.save({'state_dict':{k:v.cpu().clone() for k,v in velocidad.state_dict().items()}},ARTEFACTOS/'flow.pt')
nueva=nn.Sequential(nn.Linear(3,64),nn.Tanh(),nn.Linear(64,64),nn.Tanh(),nn.Linear(64,2)).to(DEVICE);nueva.load_state_dict(torch.load(ARTEFACTOS/'flow.pt',map_location=DEVICE,weights_only=True)['state_dict']);nueva.eval()
with torch.inference_mode():torch.testing.assert_close(nueva(torch.from_numpy(entrada_val[:16]).to(DEVICE)),velocidad(torch.from_numpy(entrada_val[:16]).to(DEVICE)))
(ARTEFACTOS/'contrato.json').write_text(json.dumps({'difusion_actualizaciones':3000,'paso_checkpoint':paso_mejor,'mse_val_fija':mejor,'T':40,'segundos_difusion':segundos,'DDIM_eta0_repetible':True,'inversion_algebraica_verificada':True,'flow_actualizaciones':2000,'paso_flow_checkpoint':paso_fm,'mse_val_flow':mejor_fm,'flow_integracion_final':64,'recargas_verificadas':True}),encoding='utf-8')
371

28.9.1 Lectura de la ejecución registrada

Ejecución CPU del 15 de octubre de 2026.

Se ejecutaron 3 000 actualizaciones del denoiser y 2 000 del campo de flow matching. El checkpoint de difusión quedó en el paso 3 000, con MSE de validación fija 0,09115. La inversión algebraica del proceso directo, la repetibilidad DDIM eta=0 y las dos recargas se comprobaron. En prueba, el MSE de ruido fue mayor para tiempos pequeños; no se transforma esa métrica en una garantía de calidad visual.

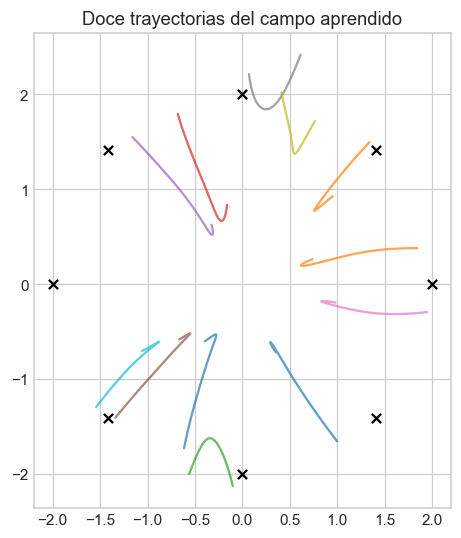
En flow matching, Wasserstein proyectada bajó de 0,4875 (gaussiana inicial) a 0,1732/0,1210/0,1181 con Euler de 4/16/64 pasos. La fracción dentro del radio prefijado de los centros fue 0,5869/0,7412/0,7656. Sin embargo, las figuras muestran masa entre los ocho grupos: contar ocho centros con al menos diez vecinos no demuestra ocho modos bien separados. Refinar Euler produjo un cambio pequeño de 16 a 64 pasos, pero no corrigió por sí solo esa limitación del campo aprendido. No se incrementó el entrenamiento después de mirar prueba. Los tiempos del sampler son una medición local por presupuesto, sin intervalos ni extrapolación a producción.

28.10 10. Decisiones y límites

Si baja MSE de ruido pero las imágenes siguen deficientes, revise el objetivo, schedule y sampler con un protocolo de validación nuevo. Si un campo fijo cambia mucho al refinar Euler, investigue error numérico. Una trayectoria suave no demuestra fidelidad. Los dominios de imágenes y puntos no se comparan como si compartieran arquitectura y métrica.

28.11 Referencias

La distinción entre campo condicional y marginal sigue Lipman et al., Flow Matching for Generative Modeling. El ejemplo gaussiano unidimensional tiene solución analítica y se usa para aislar el error numérico.