Un modelo puede estar correctamente implementado y fallar porque sus datos cambian de forma, se escalan dos veces o se preparan con información del futuro. El pipeline convierte esas decisiones en un recorrido explícito: qué entra, qué se aprende en entrenamiento, qué se conserva y qué se reutiliza al predecir.
Construiremos un ejemplo tabular completo y lo conectaremos con datasets, dataloaders, imágenes y secuencias. En cada caso revisaremos formas, estadísticas, métricas y fallos observables. El propósito es que puedas explicar el resultado y localizar una decisión incorrecta, además de encadenar funciones.
Para interpretar los ejemplos: entrenamiento ajusta; validación selecciona; prueba evalúa la decisión fijada. Exactitud es fracción de aciertos; recall mide qué fracción de positivos se recupera. Las definiciones completas están en Evaluación; no es necesario adelantar todo ese capítulo para seguir el experimento.
9.1 Tres recorridos que comparten un contrato
Durante entrenamiento, los datos ajustan imputadores, escaladores, vocabularios y pesos. Durante validación, aplicamos lo ya ajustado para seleccionar decisiones. Durante inferencia, recibimos datos nuevos y reutilizamos las mismas transformaciones y el predictor elegido.
Un Pipeline de scikit-learn agrupa transformaciones y estimador; no decide por nosotros qué variables están disponibles, qué partición es correcta ni qué etiquetas son confiables. Un dataloader de PyTorch organiza lectura y lotes; tampoco convierte una evaluación contaminada en una evaluación independiente.
Etapa
Qué recibe
Qué produce
Pregunta de control
Contrato
Columnas, unidades o tensores
Entradas verificadas
¿Es la información disponible al predecir?
Partición
Observaciones y sus dependencias
Entrenamiento, validación y prueba
¿Se separaron personas, grupos o futuro cuando corresponde?
Preparación
Entrenamiento
Estadísticas y vocabularios ajustados
¿Se excluyó evaluación del ajuste?
Lotes
Entradas transformadas
Tensores y máscaras
¿Las formas y la mezcla de muestras son correctas?
Ajuste
Lotes y objetivo
Parámetros y checkpoints
¿La pérdida coincide con la tarea?
Evaluación
Predicciones reservadas
Métricas y errores
¿La selección ocurrió antes de mirar prueba?
Inferencia
Datos nuevos
Predicciones
¿Se conservaron transformaciones y esquema?
Este contrato incluye unidades y significado, no solo tipos. Una columna puede seguir siendo numérica después de cambiar de pesos a miles de pesos y alterar completamente la entrada del modelo.
import numpy as npimport sklearnimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport sklearnfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScalerfrom sklearn.metrics import mean_squared_error, accuracy_score, balanced_accuracy_score, log_loss, ConfusionMatrixDisplayfrom IPython.display import displayimport torchfrom torch import nnfrom torch.utils.data import TensorDataset,DataLoader,WeightedRandomSamplerfrom torch.nn.utils.rnn import pad_sequence,pack_padded_sequenceimport copy,json,math,time,platformfrom pathlib import Pathtorch.set_num_threads(1)torch.use_deterministic_algorithms(True)SEMILLA=42COLORES=['#276FBF','#E87524','#339966','#9B59B6']plt.rcParams.update({'figure.dpi':110,'font.size':10,'figure.constrained_layout.use':True,'axes.spines.top':False,'axes.spines.right':False})lecturas={}def rmse(a,b):returnfloat(np.sqrt(mean_squared_error(a,b)))print('Entorno preparado; NumPy antes de PyTorch, CPU y un hilo de entrenamiento.')from sklearn.compose import ColumnTransformerfrom sklearn.pipeline import Pipeline,make_pipelinefrom sklearn.impute import SimpleImputerfrom sklearn.preprocessing import OneHotEncoderfrom sklearn.linear_model import LogisticRegressionfrom sklearn.ensemble import HistGradientBoostingClassifierfrom sklearn.dummy import DummyClassifierfrom sklearn.model_selection import StratifiedKFold,GridSearchCV,GroupShuffleSplitimport joblibprint('Disponibles: preparación por columnas, búsqueda dentro del pipeline y dataloaders.')
Entorno preparado; NumPy antes de PyTorch, CPU y un hilo de entrenamiento.
Disponibles: preparación por columnas, búsqueda dentro del pipeline y dataloaders.
9.2 Una tabla mixta con ausencia y respuesta probabilística
Generaremos 1 500 registros ficticios de uso de un servicio. La respuesta, incidencia, se sortea a partir de uso, importe, antigüedad, canal y segmento. Los nombres facilitan la lectura, pero los coeficientes son inventados: no representan un servicio real.
Después de generar la respuesta introduciremos ausencia independiente en características. Conservaremos un identificador de registro para trazabilidad y lo excluiremos del predictor. La respuesta se guarda aparte. Separaremos 60/20/20 con estratificación, suponiendo registros independientes en este primer caso.
rng=np.random.default_rng(42);n=1500uso=rng.normal(size=n);importe=rng.lognormal(4,.6,n);antiguedad=rng.uniform(0,12,n)canal=rng.choice(['web','tienda','telefono'],n,p=[.5,.3,.2])segmento=rng.choice(['nuevo','recurrente'],n,p=[.6,.4])logit=-1+.9*uso-.006*(importe-60)+.08*(antiguedad-6)+.6*(canal=='web')+.7*(segmento=='recurrente')p=1/(1+np.exp(-logit));y=rng.binomial(1,p)X=pd.DataFrame({'uso':uso,'importe':importe,'antiguedad':antiguedad,'canal':canal,'segmento':segmento})for nombre in ['uso','importe','antiguedad']: X.loc[rng.random(n)<.10,nombre]=np.nanfor nombre in ['canal','segmento']: X.loc[rng.random(n)<.04,nombre]=np.nanids=np.arange(n)tr,resto=train_test_split(ids,test_size=.4,stratify=y,random_state=42)va,te=train_test_split(resto,test_size=.5,stratify=y[resto],random_state=42)display(X.head())display(pd.DataFrame({'Tipo':X.dtypes.astype(str),'Ausencia entrenamiento':X.iloc[tr].isna().mean(),'Ausencia validación':X.iloc[va].isna().mean(),'Ausencia prueba':X.iloc[te].isna().mean()}).round(3))fig,axes=plt.subplots(1,2,figsize=(11,4))axes[0].hist(X.iloc[tr].importe.dropna(),bins=30,color=COLORES[0])axes[0].set(title='Entrenamiento: importe',xlabel='Unidades ficticias',ylabel='Registros')pd.crosstab(X.iloc[tr].canal,y[tr],normalize='index').plot.bar(ax=axes[1],stacked=True,color=COLORES[:2],rot=0)axes[1].set(title='Frecuencia de respuesta por canal',xlabel='Canal',ylabel='Proporción')plt.show()print('Particiones:',len(tr),len(va),len(te),'| Frecuencia de clase 1 en entrenamiento:',round(y[tr].mean(),3))
uso
importe
antiguedad
canal
segmento
0
0.304717
38.870012
11.568164
telefono
nuevo
1
-1.039984
37.533653
9.789163
web
nuevo
2
0.750451
120.915026
NaN
web
nuevo
3
0.940565
66.564671
10.429102
telefono
recurrente
4
-1.951035
48.084492
10.881687
web
nuevo
Tipo
Ausencia entrenamiento
Ausencia validación
Ausencia prueba
uso
float64
0.109
0.09
0.127
importe
float64
0.091
0.10
0.067
antiguedad
float64
0.097
0.08
0.077
canal
object
0.031
0.05
0.037
segmento
object
0.044
0.05
0.023
Particiones: 900 300 300 | Frecuencia de clase 1 en entrenamiento: 0.409
9.2.1 Cómo leer los datos antes de ajustar
El importe tiene una distribución asimétrica, coherente con el generador lognormal. La ausencia realizada no es exactamente la probabilidad generadora. Las proporciones por canal describen la muestra; no demuestran causalidad, porque también intervienen otras variables y el mecanismo que definimos.
Antes de imputar, pregunta por qué falta cada dato. En este ejemplo la ausencia es independiente; en una aplicación puede revelar fallos de captura o depender del valor. Antes de excluir un identificador, pregunta si representa una unidad repetida: puede ser necesario para separar grupos, aunque no se utilice como entrada.
9.3 Preparación por columnas: ajustar una vez, aplicar después
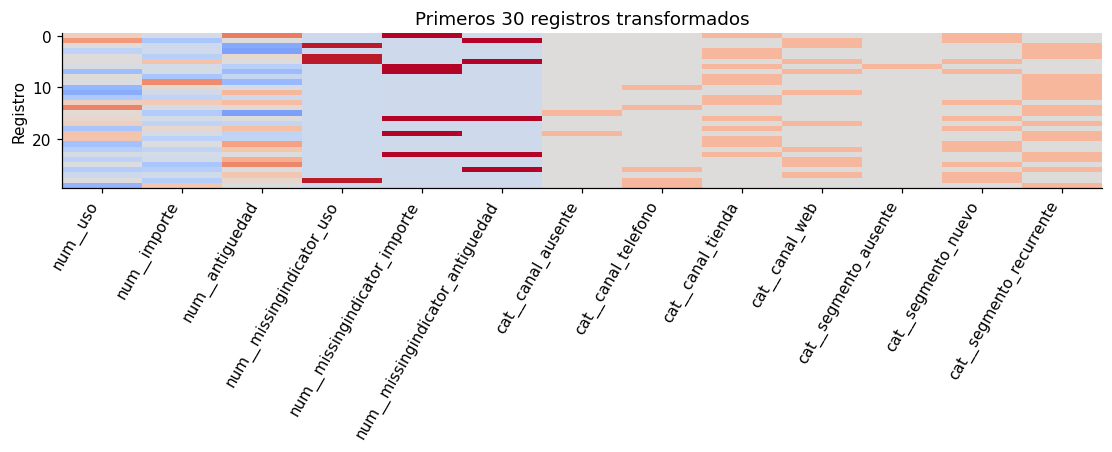
Para columnas numéricas, usaremos mediana e indicadores de ausencia, y después escalado. Para las nominales, imputaremos una categoría explícita ausente y aplicaremos one-hot. handle_unknown='ignore' permite recibir categorías nuevas produciendo ceros en su bloque; no enseña al modelo qué significa esa categoría.
El ColumnTransformer selecciona por nombres y concatena resultados. El pipeline completo se ajusta con entrenamiento. Las medianas, medias, desviaciones y categorías quedan dentro del objeto. Los indicadores binarios también serán escalados aquí; esa es una decisión explícita, no un requisito universal.
La tabla de cinco columnas se convirtió en 13 características. El aumento proviene de indicadores de ausencia y categorías, no de nuevas observaciones. La comprobación de medianas muestra exactamente qué partición aportó las estadísticas.
En una validación cruzada, este ajuste debe repetirse dentro de cada pliegue usando solo su entrenamiento. Transformar una vez toda la tabla y después hacer CV permite que las estadísticas incorporen observaciones reservadas. El efecto en una métrica puede ser pequeño o grande; la independencia del procedimiento importa aunque la cifra apenas cambie.
9.4 Una búsqueda sobre el sistema completo
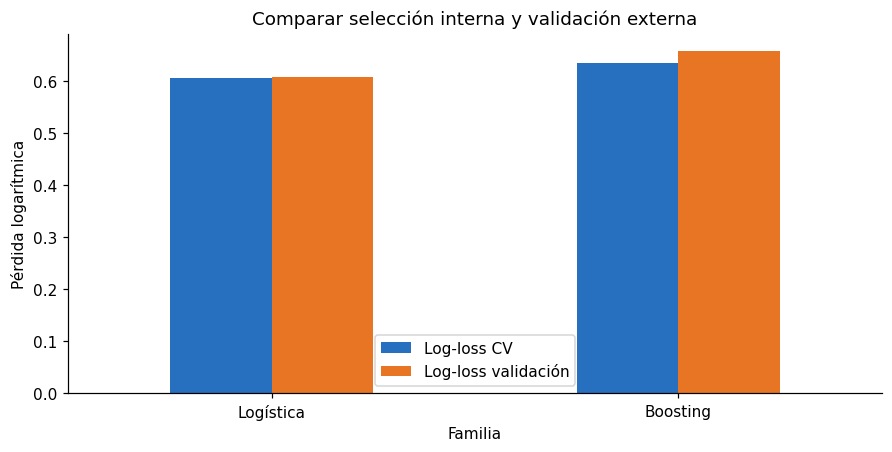
Compararemos logística con tres valores de C y un clasificador de boosting con dos límites de hojas. La búsqueda interna usará tres pliegues sobre las 900 observaciones de entrenamiento. Su criterio será pérdida logarítmica; scikit-learn la expresa como neg_log_loss para conservar la convención de maximizar puntajes.
Cada candidato contiene su preparación. Usaremos validación externa para elegir entre las dos familias mediante log-loss, sin modificar el umbral \(0.5\). El boosting recibirá el mismo escalado por consistencia del ejemplo; los árboles no suelen necesitarlo para conservar sus particiones.
La validación seleccionó Logística, con log-loss 0.6079. El criterio utiliza probabilidades: una clasificación errónea con alta confianza pesa más que una probabilidad cercana al umbral. La exactitud balanceada añade otra lectura, pero no cambió nuestra regla de selección.
El máximo interno de una búsqueda participa en la elección y puede ser optimista; la validación externa aporta otra muestra. Aquí se usó también para comparar familias. No es una tercera prueba independiente. Los resultados corresponden a esta muestra y a cinco candidatos; no demuestran que se haya explorado toda la capacidad de cada familia.
9.5 La información del futuro puede ganar una comparación incorrecta
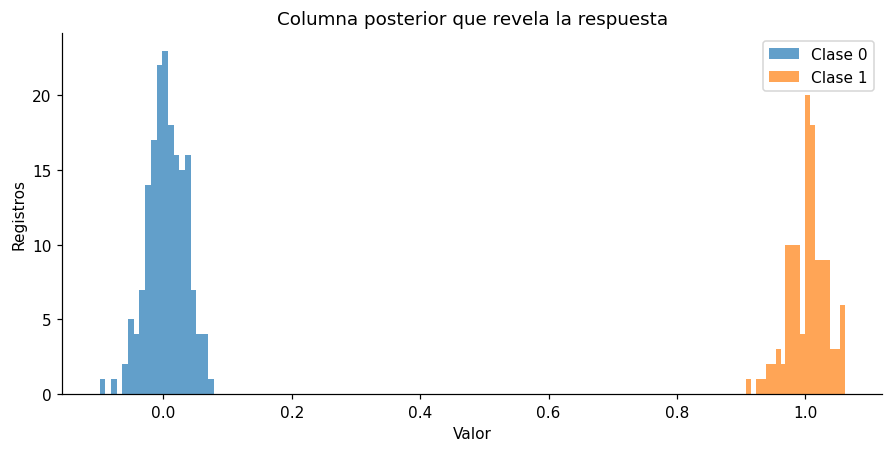
Construiremos una columna que copia casi exactamente la respuesta. Representaría un dato generado después de la incidencia. Una preparación impecable no puede convertirla en una variable disponible antes de predecir.
Este es un anti-ejemplo deliberado sobre entrenamiento y validación: mostraremos su métrica para reconocer el problema, no para elegirlo. La prueba principal permanece reservada. Los controles de disponibilidad deben existir antes de la búsqueda.
X_fuga=X.copy()X_fuga['resultado_posterior']=y+np.random.default_rng(9).normal(0,.03,len(y))fuga=Pipeline([('imputar',SimpleImputer(strategy='median')),('modelo',LogisticRegression(max_iter=1000))])fuga.fit(X_fuga.iloc[tr][['resultado_posterior']],y[tr])pred_fuga=fuga.predict_proba(X_fuga.iloc[va][['resultado_posterior']])[:,1]fig,ax=plt.subplots(figsize=(8,4))ax.hist(X_fuga.loc[va[y[va]==0],'resultado_posterior'],bins=20,alpha=.7,label='Clase 0')ax.hist(X_fuga.loc[va[y[va]==1],'resultado_posterior'],bins=20,alpha=.7,label='Clase 1')ax.set(title='Columna posterior que revela la respuesta',xlabel='Valor',ylabel='Registros');ax.legend()plt.show()lecturas['fuga']=f'{log_loss(y[va],pred_fuga):.4f}'print('Log-loss del anti-ejemplo:',lecturas['fuga'],'| No se utiliza para seleccionar ni inferir.')
Log-loss del anti-ejemplo: 0.0183 | No se utiliza para seleccionar ni inferir.
El anti-ejemplo obtuvo log-loss 0.0183, pero utiliza la respuesta disfrazada de característica. Una mejora extraordinaria exige revisar qué produjo la variable y cuándo estaría disponible. Excluir solo la columna llamada target no basta si otras columnas la revelan.
También puede haber fuga mediante agregaciones calculadas con futuro, selección de variables sobre todo el conjunto o versiones duplicadas de una misma muestra entre particiones. El pipeline protege el ajuste de sus componentes cuando recibe una partición adecuada; no reconoce automáticamente esos significados.
9.6 Unidades repetidas: filas nuevas o entidades nuevas
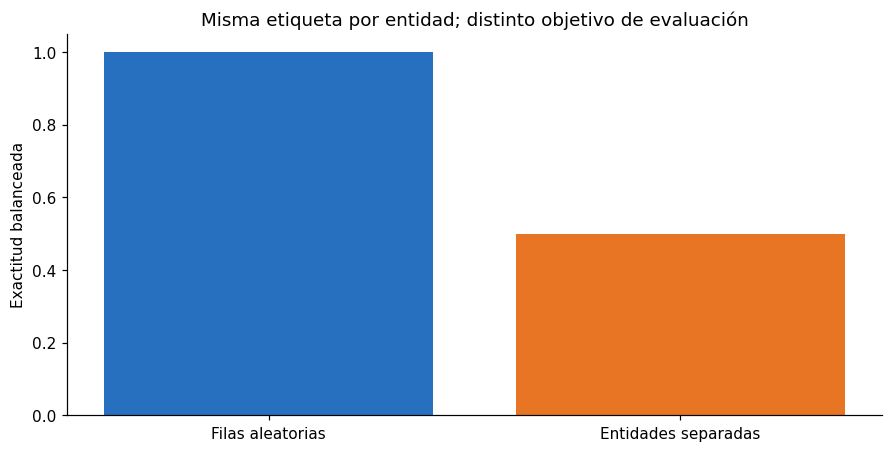
En otro experimento, cada entidad tendrá ocho registros y una etiqueta fija sorteada por entidad. El identificador permite memorizarla. Compararemos una partición aleatoria por filas con una separación por entidades completas.
Son preguntas distintas. Si predecirás registros nuevos de entidades conocidas, su historia puede ser información legítima. Si necesitas generalizar a entidades nuevas, repartir las mismas entre entrenamiento y evaluación produce una evidencia demasiado favorable para ese objetivo.
rng_g=np.random.default_rng(14)entidad=np.repeat(np.arange(60),8);etiqueta_entidad=rng_g.integers(0,2,60)yg=etiqueta_entidad[entidad];Xg=pd.DataFrame({'entidad':entidad.astype(str)})gtr,gva=train_test_split(np.arange(len(yg)),test_size=.3,stratify=yg,random_state=42)htr,hva=next(GroupShuffleSplit(1,test_size=.3,random_state=42).split(Xg,yg,groups=entidad))filas_g=[]for nombre,a,b in [('Filas aleatorias',gtr,gva),('Entidades separadas',htr,hva)]: mg=make_pipeline(OneHotEncoder(handle_unknown='ignore'),LogisticRegression(C=100,max_iter=1000)) mg.fit(Xg.iloc[a],yg[a]) solapan=len(set(entidad[a])&set(entidad[b])) filas_g.append({'Partición':nombre,'Entidades compartidas':solapan,'Balanceada evaluación':balanced_accuracy_score(yg[b],mg.predict(Xg.iloc[b]))})display(pd.DataFrame(filas_g).round(3))fig,ax=plt.subplots(figsize=(8,4))ax.bar([f['Partición'] for f in filas_g],[f['Balanceada evaluación'] for f in filas_g],color=COLORES[:2])ax.set(ylim=(0,1.05),ylabel='Exactitud balanceada',title='Misma etiqueta por entidad; distinto objetivo de evaluación')plt.show()lecturas['grupos_filas']=f'{filas_g[0]["Balanceada evaluación"]:.3f}'lecturas['grupos_nuevos']=f'{filas_g[1]["Balanceada evaluación"]:.3f}'
Partición
Entidades compartidas
Balanceada evaluación
0
Filas aleatorias
55
1.0
1
Entidades separadas
0
0.5
La evaluación por filas obtuvo 1.000; la separación de entidades obtuvo 0.500. El mecanismo no contiene una regla que explique etiquetas de identidades nuevas: se sortearon. La diferencia se entiende observando qué identidades estaban disponibles, no buscando un clasificador más complejo.
Para series temporales, el equivalente es definir pasado disponible y horizonte. Si construyes ventanas que se solapan, una separación descuidada puede compartir observaciones o etiquetas futuras. La distancia entre bloques debe responder al horizonte y al mecanismo de dependencia; no existe un embargo universal válido para toda serie.
9.7 De la tabla al dataloader de una red
Tomaremos la transformación ajustada con entrenamiento y construiremos un TensorDataset. Entradas float32 tendrán forma (N, D) y respuestas (N, 1), compatibles con BCE con logits. El loader de entrenamiento mezclará índices con un generador sembrado; el de validación conservará las observaciones y no aplicará transformaciones aleatorias.
Usaremos num_workers=0 para que el ejemplo sea portable en notebooks. Aumentar procesos puede acelerar lectura costosa, pero requiere controlar semillas de trabajadores y comportamiento de la plataforma. En este dataset pequeño, los datos ya están en memoria.
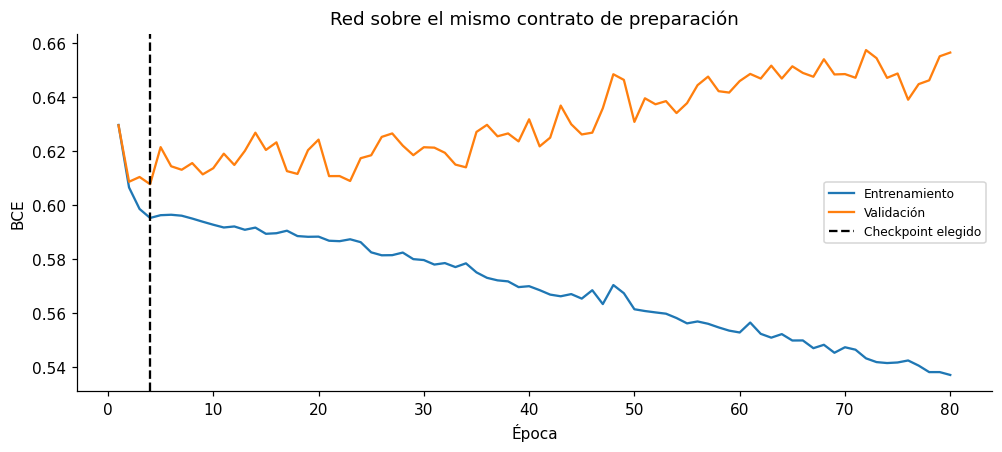
datos_train=TensorDataset(torch.tensor(Ztr,dtype=torch.float32),torch.tensor(y[tr,None],dtype=torch.float32))datos_val=TensorDataset(torch.tensor(Zva,dtype=torch.float32),torch.tensor(y[va,None],dtype=torch.float32))loader=DataLoader(datos_train,batch_size=64,shuffle=True,generator=torch.Generator().manual_seed(7),num_workers=0,drop_last=False)loader_val=DataLoader(datos_val,batch_size=128,shuffle=False,num_workers=0)xb,yb=next(iter(loader))print('Lote:',tuple(xb.shape),xb.dtype,'| Respuesta:',tuple(yb.shape),yb.dtype)print('Lotes por época:',len(loader),'| Último lote:',len(tr)%64)torch.manual_seed(7)red=nn.Sequential(nn.Linear(Ztr.shape[1],16),nn.Tanh(),nn.Linear(16,1))opt=torch.optim.Adam(red.parameters(),lr=.01);loss_fn=nn.BCEWithLogitsLoss()historia=[];mejor=float('inf');estado=Nonefor epoca inrange(1,81): red.train()for xb,yb in loader: opt.zero_grad(set_to_none=True);loss=loss_fn(red(xb),yb);loss.backward();opt.step() red.eval()with torch.no_grad(): lt=float(loss_fn(red(datos_train.tensors[0]),datos_train.tensors[1])) lv=float(loss_fn(red(datos_val.tensors[0]),datos_val.tensors[1])) historia.append({'Época':epoca,'BCE entrenamiento':lt,'BCE validación':lv})if lv<mejor:mejor=lv;estado=copy.deepcopy(red.state_dict());epoca_mejor=epocared.load_state_dict(estado)h=pd.DataFrame(historia)fig,ax=plt.subplots(figsize=(9,4));ax.plot(h['Época'],h['BCE entrenamiento'],label='Entrenamiento');ax.plot(h['Época'],h['BCE validación'],label='Validación')ax.axvline(epoca_mejor,color='black',linestyle='--',label='Checkpoint elegido')ax.set(xlabel='Época',ylabel='BCE',title='Red sobre el mismo contrato de preparación');ax.legend(fontsize=8);plt.show()lecturas['red_epoch']=str(epoca_mejor);lecturas['red_val']=f'{mejor:.4f}'print('Checkpoint elegido:',epoca_mejor,'| BCE validación:',lecturas['red_val'])
Lote: (64, 13) torch.float32 | Respuesta: (64, 1) torch.float32
Lotes por época: 15 | Último lote: 4
Checkpoint elegido: 4 | BCE validación: 0.6076
La red conservó la época 4, con BCE de validación 0.6076. Este recorrido ilustra lotes, modos y checkpoint; no sustituye la selección principal de familias ya declarada. No evaluaremos esta red en prueba ni la elegiremos retrospectivamente porque una curva parezca atractiva.
La pérdida de época se calculó sobre todas las observaciones, no promediando sin pesos los promedios de lotes desiguales. train() y eval() controlan capas como dropout o BatchNorm; no_grad() controla el registro de gradientes. Son decisiones distintas, aunque en esta red sencilla no haya capas cuyo comportamiento cambie entre modos.
La figura muestra que, después del checkpoint temprano, la pérdida de entrenamiento sigue bajando mientras validación empeora y fluctúa. Continuar hasta la última época produce un ajuste más favorable a entrenamiento, sin mejorar el criterio reservado. El pipeline correcto permite medir ese deterioro; no lo evita por sí mismo.
9.7.1 Muestreo: cambiar la mezcla también cambia el entrenamiento
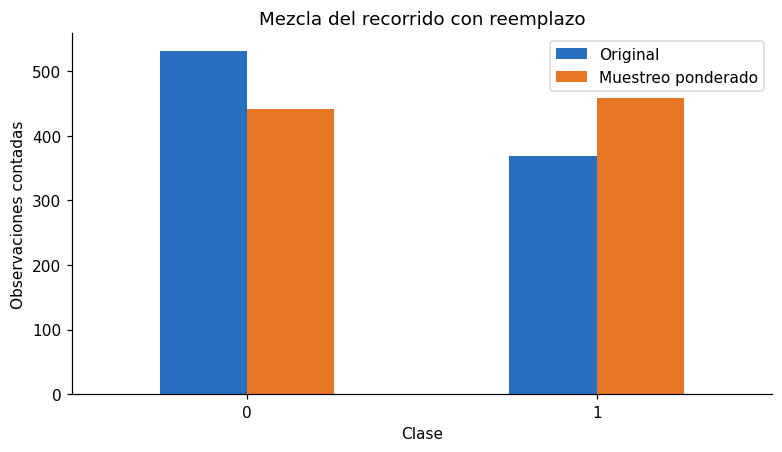
Un sampler puede aumentar presencia de una clase minoritaria sin crear observaciones nuevas. Mostraremos muestreo inverso a la frecuencia, con reemplazo. Ese reemplazo permite que un registro aparezca varias veces y que otros no aparezcan durante el recorrido.
No aplicaremos simultáneamente este muestreo y una pérdida ponderada en el ajuste anterior: hacerlo cambiaría otra vez el objetivo. La evaluación conserva la distribución original. Si necesitas probabilidades calibradas, cambiar frecuencias de entrenamiento exige comprobarlas sobre la distribución de uso.
conteos=np.bincount(y[tr]);pesos=1/conteos[y[tr]]sampler=WeightedRandomSampler(torch.tensor(pesos,dtype=torch.double),num_samples=len(tr),replacement=True,generator=torch.Generator().manual_seed(11))seleccionados=np.array(list(sampler));frecuencias=np.bincount(y[tr][seleccionados],minlength=2)tabla_sampler=pd.DataFrame({'Clase':[0,1],'Original':conteos,'Muestreo ponderado':frecuencias})display(tabla_sampler)fig,ax=plt.subplots(figsize=(7,4));tabla_sampler.set_index('Clase').plot.bar(ax=ax,rot=0,color=COLORES[:2]);ax.set(ylabel='Observaciones contadas',title='Mezcla del recorrido con reemplazo');plt.show()print('Índices únicos sorteados:',len(np.unique(seleccionados)),'de',len(tr))
Clase
Original
Muestreo ponderado
0
0
532
441
1
1
368
459
Índices únicos sorteados: 565 de 900
9.8 Padding y máscaras: el cero puede ser un dato real
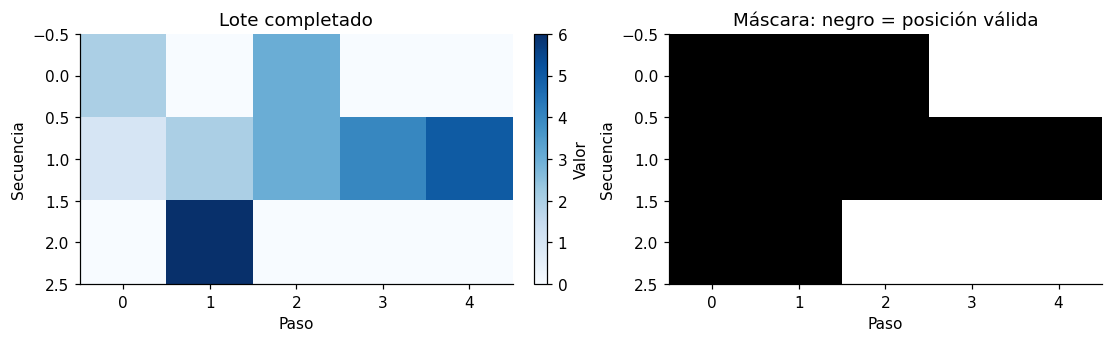
Para agrupar secuencias de longitudes distintas debemos completar el lote hasta una longitud común. El relleno no representa una observación. Una máscara construida con longitudes distingue posiciones válidas incluso si su valor real es cero.
Usaremos tres secuencias con ceros legítimos. Compararemos su media real con una media que incorpora el relleno. En una red secuencial, la máscara puede intervenir en pérdida, atención o pooling; una capa recurrente también puede usar secuencias empaquetadas para evitar recorrer padding.
secuencias=[torch.tensor([2.,0.,3.]),torch.tensor([1.,2.,3.,4.,5.]),torch.tensor([0.,6.])]longitudes=torch.tensor([len(s) for s in secuencias])relleno=pad_sequence(secuencias,batch_first=True,padding_value=0.)mascara=torch.arange(relleno.shape[1])[None,:]<longitudes[:,None]media_correcta=(relleno*mascara).sum(1)/longitudesmedia_ingenua=relleno.mean(1)display(pd.DataFrame({'Longitud':longitudes.numpy(),'Media válida':media_correcta.numpy(),'Media incluyendo padding':media_ingenua.numpy()}))fig,axes=plt.subplots(1,2,figsize=(10,3))im=axes[0].imshow(relleno.numpy(),aspect='auto',cmap='Blues');fig.colorbar(im,ax=axes[0],label='Valor')axes[1].imshow(mascara.numpy(),aspect='auto',cmap='Greys',vmin=0,vmax=1)for ax,titulo inzip(axes,['Lote completado','Máscara: negro = posición válida']):ax.set(title=titulo,xlabel='Paso',ylabel='Secuencia')plt.show()assert mascara.sum()==sum(len(s) for s in secuencias)assert mascara[0,1] and relleno[0,1]==0print('Para RNN con una característica:',tuple(relleno.unsqueeze(-1).shape),'| Fracción de padding:',round(float((~mascara).float().mean()),3))
Longitud
Media válida
Media incluyendo padding
0
3
1.666667
1.0
1
5
3.000000
3.0
2
2
3.000000
1.2
Para RNN con una característica: (3, 5, 1) | Fracción de padding: 0.333
La media ingenua desplaza dos resultados hacia cero. Excluir valores iguales a cero también sería incorrecto: eliminaría datos reales. El criterio procede de las longitudes, no del contenido.
Cuando calcules una pérdida por token, suma solo posiciones válidas y divide por su cantidad. Si promedias primero por secuencia, estarás asignando un peso distinto a secuencias largas y cortas. Ambas convenciones pueden tener sentido, pero deben declararse. El capítulo de secuencia a secuencia distinguirá además token correcto y secuencia completa correcta.
9.9 Aumentación: una transformación puede cambiar la etiqueta
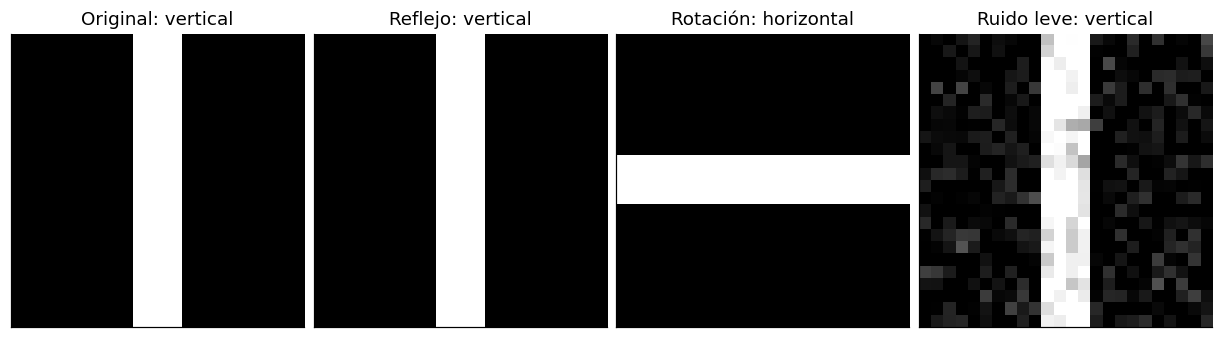
En una imagen sintética, una barra vertical sigue siendo vertical tras un reflejo horizontal. Una rotación de 90 grados la convierte en horizontal. Si conservas la etiqueta «vertical» después de esa rotación, produces una inconsistencia deliberada.
La validez de una aumentación depende de la tarea. En una detección, también deben transformarse cajas; en segmentación, máscaras; en una serie, una alteración temporal puede cambiar el horizonte o el significado. Las transformaciones aleatorias de entrenamiento y el procesamiento de inferencia deben estar definidos por separado.
imagen=np.zeros((24,24));imagen[:,10:14]=1variantes=[('Original: vertical',imagen),('Reflejo: vertical',np.fliplr(imagen)), ('Rotación: horizontal',np.rot90(imagen)),('Ruido leve: vertical',np.clip(imagen+np.random.default_rng(9).normal(0,.12,imagen.shape),0,1))]fig,axes=plt.subplots(1,4,figsize=(11,3))for ax,(nombre,img) inzip(axes,variantes):ax.imshow(img,cmap='gray',vmin=0,vmax=1);ax.set_title(nombre);ax.set_xticks([]);ax.set_yticks([])plt.show()print('La tercera transformación requiere cambiar la etiqueta si las categorías son vertical/horizontal.')
La tercera transformación requiere cambiar la etiqueta si las categorías son vertical/horizontal.
9.10 Reajustar, evaluar y conservar el recorrido
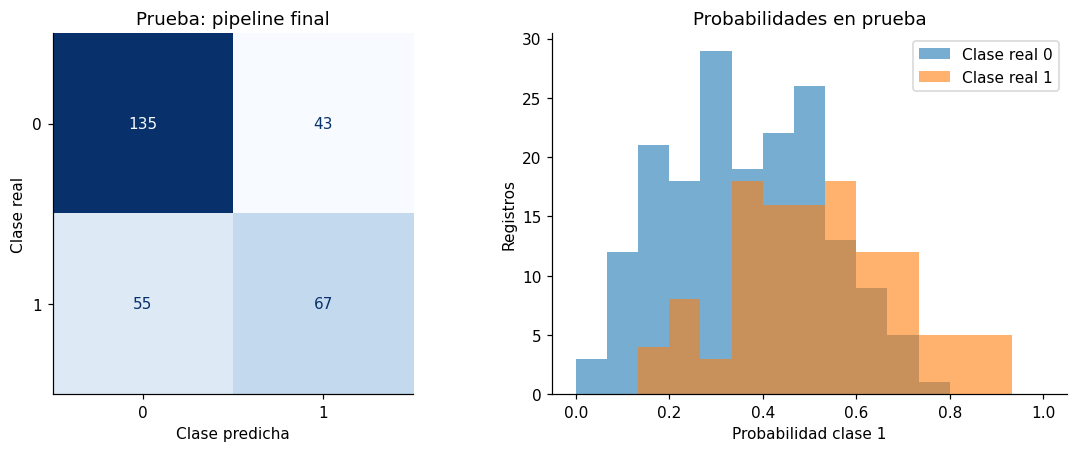
Reajustaremos el candidato principal seleccionado sobre entrenamiento más validación. Sus estadísticas y categorías se estimarán nuevamente en esas 1 200 observaciones. La prueba no interviene. Evaluaremos log-loss, exactitud balanceada y una matriz con umbral fijo; una referencia mayoritaria proporcionará un punto de comparación.
Persistiremos el pipeline completo con joblib, no solo el clasificador. La demostración carga únicamente el archivo que acabamos de crear. La consistencia de predicciones antes y después de la carga verificará que preparación y predictor se conservaron juntos.
desarrollo=np.r_[tr,va]final=copy.deepcopy(buscadores[ganador].best_estimator_).fit(X.iloc[desarrollo],y[desarrollo])prob_test=final.predict_proba(X.iloc[te])[:,1]base=DummyClassifier(strategy='prior').fit(X.iloc[desarrollo],y[desarrollo]);prob_base=base.predict_proba(X.iloc[te])[:,1]resultados=pd.DataFrame([{'Modelo':nombre,'Log-loss':log_loss(y[te],prob),'Balanceada':balanced_accuracy_score(y[te],prob>=.5)}for nombre,prob in [('Frecuencia',prob_base),(ganador,prob_test)]])display(resultados.round(4))fig,axes=plt.subplots(1,2,figsize=(10,4))ConfusionMatrixDisplay.from_predictions(y[te],prob_test>=.5,ax=axes[0],cmap='Blues',colorbar=False)axes[0].set(title='Prueba: pipeline final',xlabel='Clase predicha',ylabel='Clase real')for k in [0,1]:axes[1].hist(prob_test[y[te]==k],bins=np.linspace(0,1,16),alpha=.6,label=f'Clase real {k}')axes[1].set(title='Probabilidades en prueba',xlabel='Probabilidad clase 1',ylabel='Registros');axes[1].legend()plt.show()joblib.dump(final,'pipeline-inferencia.joblib')recuperado=joblib.load('pipeline-inferencia.joblib')assert np.allclose(prob_test,recuperado.predict_proba(X.iloc[te])[:,1])resultados.to_csv('resultados.csv',index=False)lecturas['test_loss']=f'{resultados.iloc[1]["Log-loss"]:.4f}';lecturas['test_bal']=f'{resultados.iloc[1]["Balanceada"]:.4f}'print('Persistencia verificada: predicciones iguales; modelo y preparación se guardaron juntos.')
Modelo
Log-loss
Balanceada
0
Frecuencia
0.6756
0.5000
1
Logística
0.5836
0.6538
Persistencia verificada: predicciones iguales; modelo y preparación se guardaron juntos.
La prueba dio log-loss 0.5836 y exactitud balanceada 0.6538 para Logística. La matriz permite discutir falsas alarmas y omisiones bajo el umbral declarado. El histograma muestra distribución de probabilidades; no basta para demostrar calibración.
La decisión es conservar este sistema para la distribución simulada, con sus límites de evaluación. Cambiar después el umbral, las variables o la familia sería una nueva selección que necesita evidencia adecuada. El archivo persistido permite repetir inferencia; no reemplaza el código, las versiones, los datos ni el protocolo necesario para reconstruir entrenamiento.
9.11 Inferencia: verificar esquema y detectar novedad
El pipeline espera cinco columnas. Validaremos su presencia y el tipo numérico de las continuas. El ColumnTransformer selecciona por nombre, de modo que un reordenamiento no cambia la preparación. Una columna ausente sí debe detener el recorrido; una categoría nueva podrá codificarse, pero quedará registrada como novedad.
Un servicio real también debe comprobar unidades, rangos, identificadores y disponibilidad temporal. Un esquema que acepta números no puede saber por sí solo que una medida cambió de unidad.
def verificar_esquema(tabla): faltan=set(numericas+categoricas)-set(tabla.columns)if faltan:raiseValueError('Faltan columnas: '+', '.join(sorted(faltan)))for nombre in numericas:ifnot pd.api.types.is_numeric_dtype(tabla[nombre]):raiseTypeError('Debe ser numérica: '+nombre)return tabla[numericas+categoricas]nuevo=pd.DataFrame({'uso':[.2,-.7],'importe':[60.,np.nan],'antiguedad':[2.,9.],'canal':['aplicacion','web'],'segmento':['nuevo','recurrente']})codificador=final.named_steps['preparar'].named_transformers_['cat'].named_steps['codificar']conocidas={col:set(cats) for col,cats inzip(categoricas,codificador.categories_)}reporte={col:sorted(set(nuevo[col].dropna())-conocidas[col]) for col in categoricas}antes=final.named_steps['preparar'].named_transformers_['num'].named_steps['escalar'].mean_.copy()prob_nueva=final.predict_proba(verificar_esquema(nuevo))[:,1]assert np.array_equal(antes,final.named_steps['preparar'].named_transformers_['num'].named_steps['escalar'].mean_)assert np.allclose(prob_nueva,final.predict_proba(verificar_esquema(nuevo[nuevo.columns[::-1]]))[:,1])display(nuevo.assign(probabilidad=prob_nueva))print('Categorías nuevas:',reporte)try:verificar_esquema(nuevo.drop(columns='importe'))exceptValueErroras error:print('Rechazo esperado:',error)metadata={'columnas':numericas+categoricas,'seleccion':ganador,'parametros':buscadores[ganador].best_params_,'semilla':42,'particiones':{'train':tr.tolist(),'validacion':va.tolist(),'prueba':te.tolist()},'versiones':{'numpy':np.__version__,'sklearn':sklearn.__version__,'torch':torch.__version__},'criterio':'log-loss de validación; umbral fijo 0.5','prueba':resultados.to_dict('records')}Path('protocolo.json').write_text(json.dumps(metadata,ensure_ascii=False,indent=2),encoding='utf-8')assertnotset(tr)&set(va) andnotset(tr)&set(te) andnotset(va)&set(te)print('Esquema, orden, estadísticas inmutables en inferencia y particiones verificados.')
uso
importe
antiguedad
canal
segmento
probabilidad
0
0.2
60.0
2.0
aplicacion
nuevo
0.320827
1
-0.7
NaN
9.0
web
recurrente
0.398102
Categorías nuevas: {'canal': ['aplicacion'], 'segmento': []}
Rechazo esperado: Faltan columnas: importe
Esquema, orden, estadísticas inmutables en inferencia y particiones verificados.
La categoría aplicacion no existía en ajuste. La predicción sigue el contrato de ceros para su bloque, pero no tenemos datos para atribuirle un efecto propio. Conservar una salida numérica no demuestra que el sistema generalice bien hacia esa novedad. Su frecuencia y sus errores, cuando lleguen etiquetas, merecen seguimiento.
Las estadísticas permanecieron iguales al predecir. Reajustar un escalador sobre cada lote nuevo cambia el sistema y rompe la correspondencia con el entrenamiento. Si decides actualizarlo, necesitas un procedimiento de actualización, evaluación y versionado; no debe ocurrir silenciosamente dentro de predict.
9.12 Decisiones y ejercicios
Hallazgo
Acción que permite investigar
Forma transformada inesperada
Inspeccionar categorías, indicadores y nombres antes de entrenar
Métrica casi perfecta con dato posterior
Revisar disponibilidad y retirar información que revela la respuesta
Caída al separar entidades
Distinguir memorizar entidades conocidas de generalizar a nuevas
Media de secuencia desplazada
Revisar máscara y denominador de agregación
Aumentación cambia la clase
Cambiar política o transformar también el objetivo
Novedad de categorías en inferencia
Registrar frecuencia y definir estrategia para desconocidas
Cambia la ausencia por columna manteniendo el modelo y la partición. Explica si la pérdida responde a menor información o a la receta de imputación.
Compara imputación con y sin indicadores. Selecciona dentro de validación y conserva una nueva prueba si cambias la decisión después de leer la actual.
Implementa batches de longitud similar y mide fracción de padding y tiempo; conserva exactamente las mismas secuencias y evaluación.
Repite el experimento por entidades con una característica que sí explique parte de su etiqueta. Distingue esa señal de la memorización de identidad.
Define un contrato de imagen o serie con unidades, formas y transformaciones permitidas. Verifica ejemplos nuevos y casos inválidos.
El recorrido útil es el que permite explicar de dónde procedió cada estadística y qué información estuvo disponible en cada decisión. El resultado final pertenece al sistema completo: datos, preparación, selección y predictor.
9.13 Contrato común y persistencia
El pipeline tabular conserva transformaciones y estimador clásico juntos. Dataset y DataLoader de PyTorch organizan ejemplos y lotes, mientras máscaras y longitudes describen entradas variables. No se reemplaza el estimador clásico por una red para uniformar artificialmente el libro.
Esta ejecución conserva el desarrollo didáctico y las recetas del capítulo. El cierre registra entorno, tablas y pesos en artefactos_pytorch/. Los estados serializados se recargan en una copia de la arquitectura y se comprueba identidad de parámetros y buffers; esa comprobación de persistencia no sustituye una evaluación de inferencia ni demuestra calidad predictiva. Los pesos guardados no incluyen todos los estados necesarios para reanudar exactamente el experimento.
from pathlib import Pathimport json,hashlib,copy,shutil,platformimport torchartefactos_cierre=Path('artefactos_pytorch');artefactos_cierre.mkdir(exist_ok=True)modulos_cierre=[];vistos_cierre=set()for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,torch.nn.Module) andid(objeto_cierre) notin vistos_cierre: vistos_cierre.add(id(objeto_cierre));estado_cierre={k:v.detach().cpu().clone() for k,v in objeto_cierre.state_dict().items()}assertall(torch.isfinite(v).all() for v in estado_cierre.values() if v.is_floating_point()),nombre_cierre ruta_cierre=artefactos_cierre/f'{nombre_cierre}-estado.pt';torch.save({'state_dict':estado_cierre},ruta_cierre) copia_cierre=copy.deepcopy(objeto_cierre).cpu();copia_cierre.load_state_dict(torch.load(ruta_cierre,map_location='cpu',weights_only=True)['state_dict'])assertall(torch.equal(v.cpu(),estado_cierre[k]) for k,v in copia_cierre.state_dict().items()) modulos_cierre.append({'variable':nombre_cierre,'clase':type(objeto_cierre).__name__,'parametros':sum(p.numel() for p in objeto_cierre.parameters()),'recarga_estado':True})for nombre_cierre,objeto_cierre inlist(globals().items()):ifisinstance(objeto_cierre,pd.DataFrame) andlen(objeto_cierre)<100000:objeto_cierre.to_csv(artefactos_cierre/f'tabla-{nombre_cierre}.csv',index=False)for ruta_cierre inlist(Path('.').iterdir()):if ruta_cierre.is_file() and ruta_cierre.suffix in ['.csv','.json','.joblib']:shutil.copy2(ruta_cierre,artefactos_cierre/ruta_cierre.name)registro_cierre={'python':platform.python_version(),'torch':str(torch.__version__),'numpy':np.__version__,'sklearn':sklearn.__version__,'modulos':modulos_cierre,'alcance':'identidad de parámetros/buffers al recargar; no reanudación completa','archivos':{p.name:hashlib.sha256(p.read_bytes()).hexdigest() for p in artefactos_cierre.iterdir() if p.is_file()}}(artefactos_cierre/'cierre-armonizacion.json').write_text(json.dumps(registro_cierre,ensure_ascii=False,indent=2),encoding='utf-8')print('Estados recargados y verificados:',len(modulos_cierre),'| archivos registrados:',len(registro_cierre['archivos']))
Estados recargados y verificados: 2 | archivos registrados: 13
9.13.1 Lectura de la ejecución registrada
Ejecución CPU del 15 de octubre de 2026.
El pipeline seleccionado sigue siendo logística, con log-loss de prueba 0,58362 y exactitud balanceada 0,65380, frente a 0,67564 y 0,5 de frecuencia. El escalado, imputación y codificación se conservan con el estimador. Las figuras mantienen los controles de fuga por datos posteriores, separación por entidades, padding y aumentación que cambia una clase. La red es un comparador, no una sustitución obligatoria del pipeline clásico. Se preservaron las comprobaciones de esquema e inferencia, y los archivos enlazados apuntan ahora a los artefactos de esta ejecución.
La armonización verificó identidad de parámetros y buffers tras recarga de 2 módulos presentes al cierre; archivó 13 archivos con SHA-256. Esta prueba no incluye reanudación exacta del optimizador ni sustituye las evaluaciones predictivas del capítulo.